Compute-Optimal Is Not Cluster-Optimal: Systems-Aware Scaling for Sparse Mixture-of-Experts 精读
Amazon AGI Foundations · arXiv:2608.10605 · 2026-08-11 作者:Soumajyoti Sarkar, Yuxin Tang, Sheng Zha
研究动机与背景
Compute-optimal scaling law(Kaplan et al., 2020;Hoffmann et al., 2022)是把训练算力预算翻译成"模型多大、数据多少"的标准工具:预算 $C$ 一定,$N$ 与 $D$ 就能从一条预测 loss 曲线上一次解出,且曲线能外推到远超拟合区间的规模。
但它有一个从未被质疑的隐含假设:算力预算是与架构无关的常数。本文指出该假设在真实集群上是错的——两个"预测 loss 相同"的架构,一旦算上各自能达到的 Model FLOPs Utilization(MFU)与最优并行布局,实际训练吞吐可差好几倍(Rajbhandari et al., 2022)。行业于是形成割裂的两段式流程:先用 scaling law 选模型和数据,再让系统团队在给定尺寸下调硬件效率——Kimi-K2 报告即典型;Anthony et al. (2024) 把 hidden size、head 数、词表对齐到 GPU kernel 结构,FlashAttention 换 IO-aware 调度,也都是"模型尺寸已定之后"的动作。
作者的目标是把系统阶段折叠进 scaling law 阶段,让一次优化同时选出架构、token 预算和并行执行布局,并实例化到稀疏 MoE。选 MoE 是因为它的旋钮天然同时作用于 loss 与系统效率:把稠密 FFN 换成 $E$ 个专家、每 token 路由到 $K$ 个,就把决定每 token 算力的激活参数 $N_{\text{act}}$ 与决定显存的总参数 $N_{\text{tot}}$ 解耦了。已有稀疏 MoE scaling law 都在忽略系统效率的前提下优化这些旋钮:Abnar et al. (2025) 指出稀疏度 $S$ 引入了 $(N,D)$-only 定律看不见的额外最优点;Ludziejewski et al. (2025) 发现固定每 token 算力下增加专家数能降 loss 却膨胀显存压力,而算力预算从不为此收费;Wan et al. (2026) 论证"每 token model FLOPs"作为公平性度量本身不充分。
本文把这条线推到底,给出一个反直觉的核心观察:在拟合区间内,纯 model-FLOPs 预算下 MoE 稀疏度不存在内点最优——拟合 loss 随稀疏度单调下降,最优解永远贴在数据支撑的上边界;稀疏度的最优点只有在集群系统约束下才会出现。作者把这套联合优化命名为 MOSAIC(Model Optimization via Systems-Aware TraIning Co-design)。
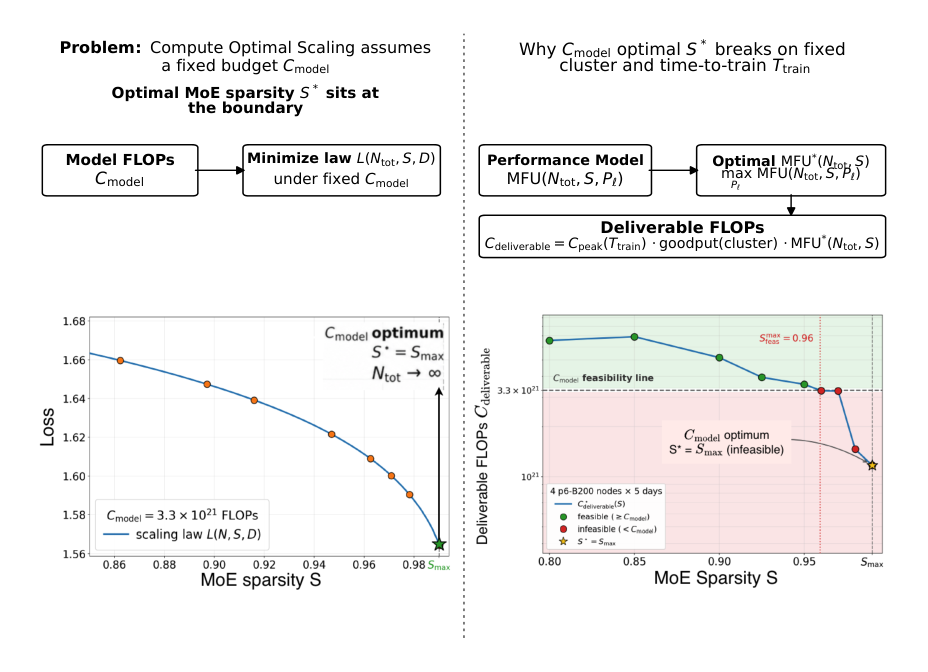
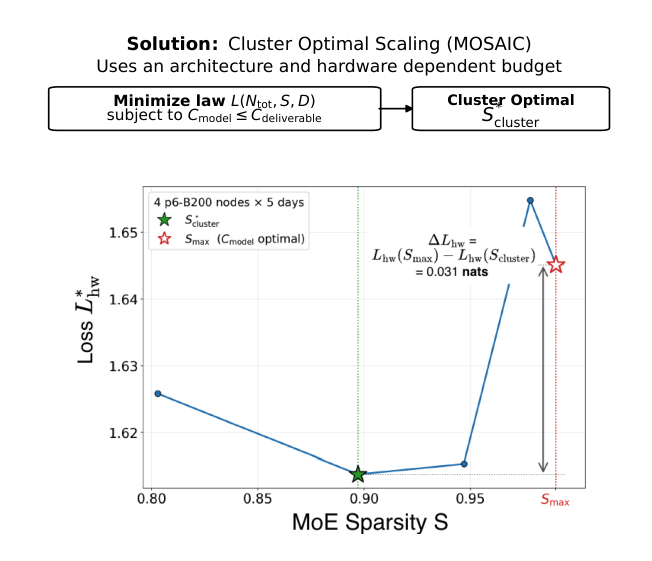
三条贡献:(1) 一条新的四维 MoE 预训练联合 scaling law,显式暴露系统侧旋钮,并证明 model-FLOPs 最优稀疏度是边界解;(2) 算子级解析性能模型,在最高 18B 激活参数的网格上验证,MFU 预测 MAPE 每个 sweep 都低于 15%;(3) 把两者耦合进 MOSAIC,在 B200 集群上按固定 GPU 小时预算搜索架构网格,并用最高 250B 总参数的实跑验证——loss 最优配置并非产出 model FLOPs 最多的那个。
核心方法:MOSAIC 的抽象形式化
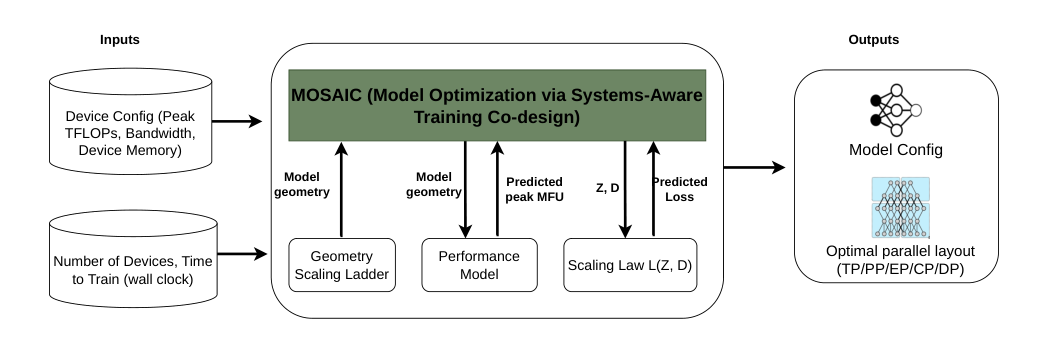
从硬件预算到可交付 model FLOPs
model FLOPs 预算把每个分配当作同等昂贵:$C_{\text{model}}(Z,D) = 6N(Z)D$,$N(Z)$ 是每 token 激活的参数量。真实集群上这式子漏掉了一个取决于架构及其执行计划的乘性系统效率因子。$N_{\text{dev}}$ 台设备、每台峰值吞吐 $F_{\text{peak}}$,在窗口 $T_{\text{train}}$ 内给出原始硬件天花板 $C_{\text{peak}} = F_{\text{peak}} N_{\text{dev}} T_{\text{train}}$,其中只有一部分变成有用的模型计算。
MFU 是集群峰值吞吐中被转化为"模型数学上必需的 FLOPs"的比例。设 $P_\ell$ 指定模型如何切分与调度,$t_{\text{iter}}$ 为处理 $B_{\text{global}} T_{\text{seq}}$ 个 token 的一次优化器步墙钟时间,则
$$\mathrm{MFU}(Z, P_\ell, B) = \frac{6\, N(Z)\, B_{\text{global}}\, T_{\text{seq}}}{t_{\text{iter}}(Z, P_\ell, B)\, N_{\text{dev}}\, F_{\text{peak}}} \tag{1}$$
分子只统计模型数学上必需的 FLOPs,故激活重计算虽真的在硬件上执行却拿不到任何信用——这是 MFU 区别于 HFU 之处,也是 MFU 才是跟踪 time-to-loss 的指标的原因。它捕捉 kernel 质量、计算通信重叠、流水线气泡、专家并行 all-to-all 等所有单步执行效率因素。再乘 goodput 系数 $\eta_{\text{good}}$(墙钟里真正在训练而非 checkpoint / 故障恢复 / 等数据的比例),定义可交付 model FLOPs:
$$C_{\text{deliverable}}(Z, P_\ell, B) = C_{\text{peak}} \cdot \mathrm{MFU}(Z, P_\ell, B) \cdot \eta_{\text{good}}(N_{\text{dev}}) \tag{2}$$
与传统算力预算不同,$C_{\text{deliverable}}$ 依赖架构与执行它的布局。候选配置 $(Z, D)$ 在窗口内可训练当且仅当
$$C_{\text{model}}(Z, D) \le \max_{P_\ell \in \mathcal{P}_{\text{feas}}(Z,B)} C_{\text{deliverable}}(Z, P_\ell, B) \tag{3}$$
联合架构-系统优化
MOSAIC 把硬件感知的模型优化形式化为 MINLP,联合优化三个耦合选择:架构 $Z$(取自有限集 $\mathcal{Z}_{\text{disc}}$,各自带着几何诱导的 scaling law 维度)、token 数 $D$、执行计划 $P_\ell$。可行执行计划集合为
$$\mathcal{P}_{\text{feas}}(Z,B) = \left\{ P_\ell \in \mathcal{P}_{\text{disc}}(N_{\text{dev}}) : \mathrm{Mem}(Z, P_\ell, B) \le M_{\text{dev}} \right\} \tag{4}$$
优化问题为
$$\min_{Z \in \mathcal{Z}_{\text{disc}},\, D} L(Z, D) \quad \text{s.t.} \quad C_{\text{model}}(Z,D) \le \max_{P_\ell \in \mathcal{P}_{\text{feas}}(Z,B)} C_{\text{deliverable}}(Z, P_\ell, B) \tag{5}$$
执行计划只通过内层最大化进入问题,故外层只对 $(Z, D)$ 优化;系统约束全塞在 $\mathcal{P}_{\text{feas}}$ 里,保证内层最大值永不返回不可行计划。等价地,为每个架构挑选最优可行计划
$$P_\ell^\star(Z) = \arg\max_{P_\ell \in \mathcal{P}_{\text{feas}}(Z,B)} C_{\text{deliverable}}(Z, P_\ell, B) \tag{6}$$
式 (5) 是双层非凸 MINLP:双层来自内嵌最大化,混合整数来自布局度数与离散架构集,非凸来自 $\mathrm{MFU}(\cdot)$、$\mathrm{Mem}(\cdot)$ 的非线性。附录 D.2 的三条结构性质(含对 $D$ 的闭式消元)使问题能靠枚举精确求解,无需通用 MINLP 求解器——后者在这里也无从下手,因为 MFU 与 Mem 是标定出的查找表而非符号函数。
关键技术细节(一):稀疏 MoE 架构与训练配方
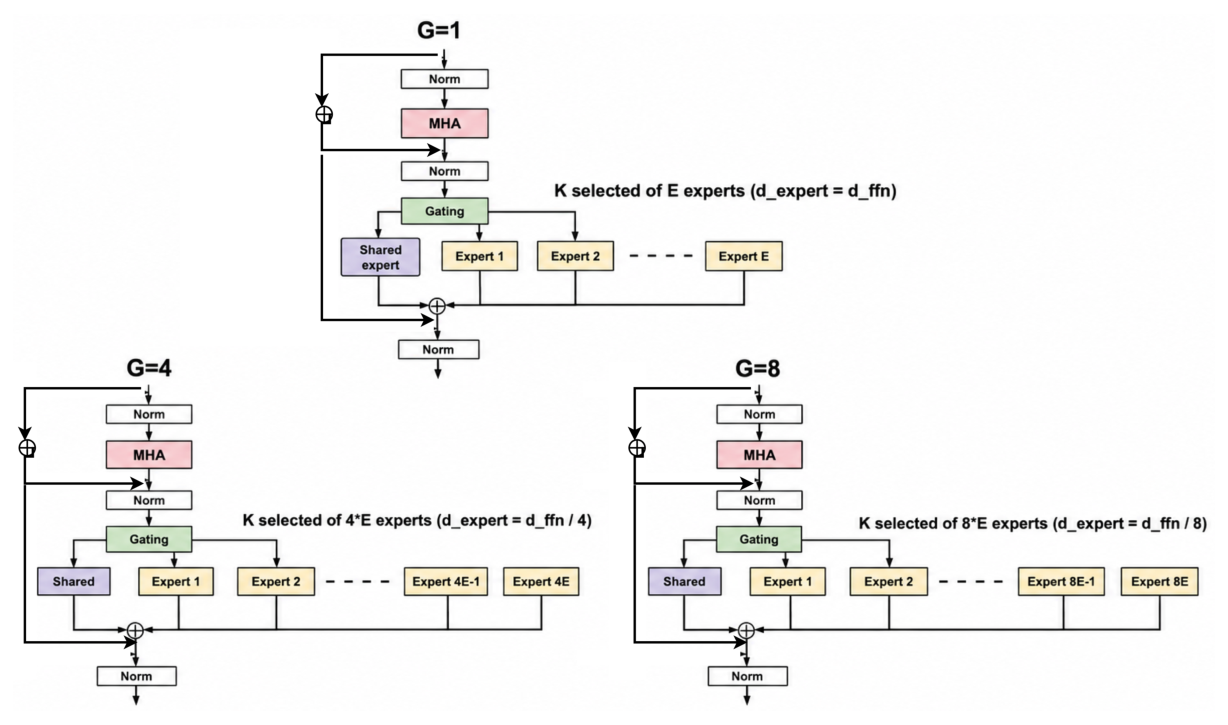
所有 run 都是 decoder-only transformer,每个 FFN 层换成 MoE 层,第一个 block 保持稠密。沿用 DeepSeek-V3 / DeepSeekMoE 设计,每个 MoE 层除 $K$ 个路由专家外还带一个始终激活的共享专家。注意力是 gated attention(Qiu et al., 2025),每个 SDPA head 输出在输出投影前过 head 特定 sigmoid 门;pre-LayerNorm + SwiGLU,embedding 不绑权重,不用 QK layernorm。
每个专家是两层前馈网络 $f_i(x) = W_i^{(2)}\sigma(W_i^{(1)}x)$,$W_i^{(1)} \in \mathbb{R}^{d_{\text{expert}} \times d}$,$W_i^{(2)} \in \mathbb{R}^{d \times d_{\text{expert}}}$。$d_{\text{ff}}$(参考稠密 FFN 宽度)与 $d_{\text{expert}}$(单专家宽度)被刻意分成两个符号,因为稀疏 MoE 层可把参考 FFN 切成更窄的专家。MoE 层输出为门控加权和:
$$y(x) = \sum_{i \in \mathcal{T}_K(x)} \tilde{\pi}_i(x)\, f_i(x), \qquad \mathcal{T}_K(x) = \mathrm{TopK}\big(s(x)\big) \tag{7}$$
由此定义专家切分因子
$$G := \frac{d_{\text{ff}}}{d_{\text{expert}}} \tag{8}$$
$G$ 度量参考稠密 FFN 被切得多细:$G=1$ 退回 Clark et al. (2022) 的设定(每个专家即全宽 FFN),$G>1$ 对应细粒度专家。注意这与 Krajewski et al. (2024) 的 granularity 不同:本文在三个 $G$ 面板中保持 top-$K$ 不变,故 $G$ 升高时 $N_{\text{act}}$ 是缩小的。
路由与负载均衡
token-to-expert 失衡会累积成 loss 尖峰与有效参数量退化,因此稳定性系于路由配方。作者在 Wang et al. (2025b) 的 auxiliary-loss-free load balancing(LFLB)上做了三处修改。基础形式是 sigmoid 亲和度打分加每专家偏置:
$$s_i(x) = s_i'(x) + \phi_i = \sigma(\theta_i(x)) + \phi_i, \qquad \theta_i(x) = \tilde{w}_{r,i}^\top x \tag{9}$$
sigmoid 解耦了各专家 logit,避免共享 softmax 竞争导致的 logit 无界增长。偏置 $\phi$ 不是可学参数,而是仅由路由统计量驱动的控制器状态。三处修改:
(a)RMS 归一化的失衡控制器。 设 $n_i$ 为 batch 内路由到专家 $i$ 的 token 数、$\bar n$ 为均值,用归一化违反量而非原始符号更新偏置,使修正幅度正比于失衡的形状而非 batch 绝对大小,并在每次更新后中心化:
$$u_i = \frac{\bar n - n_i}{\sqrt{E^{-1}\sum_j (\bar n - n_j)^2} + \varepsilon}, \qquad \phi_i \leftarrow \phi_i + \mu_b u_i \tag{10}$$
(b)Gumbel proposal-correction 采样器。 先在干净分数上做随机 top-$M$ 提议,再在提议集内用带偏置分数做 top-$K$ 修正:
$$\mathcal{C}_t = \mathrm{TopM}_i\big(\log s'_{t,i} + \tau g_{t,i}\big), \quad g_{t,i} \sim \mathrm{Gumbel}(0,1) \tag{11}$$
$$\mathcal{T}_{K,t} = \mathrm{TopK}_{i \in \mathcal{C}_t}\big(s_{t,i}\big), \qquad M = \min(\rho K, E) \tag{12}$$
依据是 Gumbel-max 定理:对 $K=1$,$\arg\max_i(\log p_i + \tau g_i) \sim \mathrm{Categorical}(p_i^{1/\tau}/\sum_j p_j^{1/\tau})$,top-$K$ 扩展给出无放回精确采样(Yellott, 1977;Kool et al., 2019)。噪声只加在 top-$M$ 候选池以免远尾专家靠噪声中签,并在 batch 内按专家中心化 $\tilde g_{t,i} = g_{t,i} - \frac{1}{T}\sum_t g_{t,i}$;作者强调这破坏了严格采样语义,应视为启发式方差控制。
(c)路由器行归一化。 每次前向对 $W_r$ 的行做 $\ell_2$ 归一化到 $c_r=1.0$,使路由依赖方向对齐而非范数漂移。
负载均衡因此完全由偏置控制器 + 噪声承担,不加 batch 级负载均衡损失;保留的辅助项只有序列级辅助损失(系数 1e-3)与 router z-loss(系数 1e-4):
$$\mathcal{L}_z = \frac{1}{T}\sum_{t=1}^{T}\Big(\log \sum_{i=1}^{E} e^{\Theta_{t,i}}\Big)^2 \tag{13}$$
超参:$\tau = 0.01$,$\rho = 12$,$\mu_b = 10^{-3}$,$\varepsilon = 10^{-4}$。作者报告这种低温采样在 18B 激活参数以上的长周期 run 里克服了"专家饿死"尖峰,且优于 Singh et al. (2026) 在开头多加稠密层的做法(后者在同等 $N_{\text{act}}$ 下削减容量)。
关键技术细节(二):G-augmented 联合 scaling law
先看可分离形式
作者先照搬 Abnar et al. (2025) 的可分离 Chinchilla 式定律,稀疏度按本文定义 $S = 1 - N_{\text{act}}/N_{\text{tot}}$(与该文的 $1-K/E$ 不同):
$$L(N_{\text{tot}}, S, D) = \underbrace{\frac{a}{N_{\text{tot}}^{\alpha}}}_{\text{capacity}} + \underbrace{\frac{b}{D^{\beta}}}_{\text{data}} + \underbrace{\frac{c}{(1-S)^{\lambda}}}_{\text{sparsity floor}} + \underbrace{\frac{j}{(1-S)^{\delta} N_{\text{tot}}^{\gamma}}}_{\text{interaction}} + e \tag{14}$$
$S \to 0$ 时前两项退回 Chinchilla 形式。按每个 $G$ 分层独立拟合、留出各层内 $N_{\text{act}}$ 前 10% 的最大模型测向上外推,四个 $G$ 的留出 RMSE 在 0.0002–0.0037 loss 单位之间,相对误差不到半个百分点。
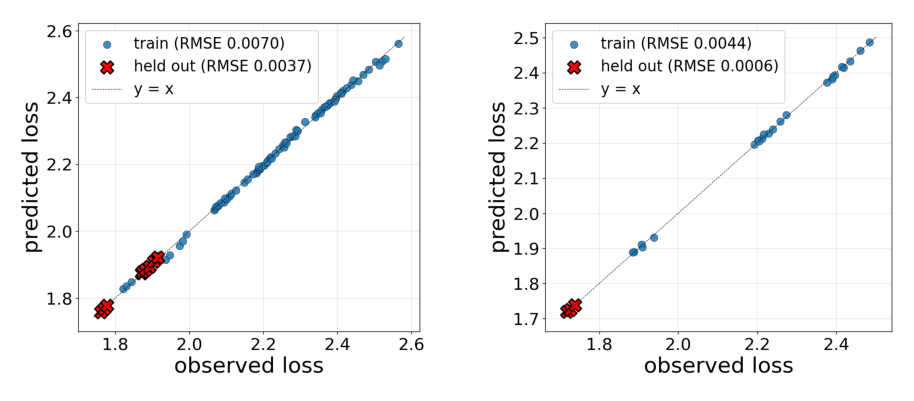
但 parity 图同时暴露一个问题:拟合系数在不同 $G$ 间漂移很大,没有单一一组 $(N_{\text{tot}}, S, D)$ 系数能同时描述所有专家切分因子——这正是必须把 $G$ 写进定律本身的信号。
为什么 $G$ 必须独立成轴
$G$ 与 $S$ 只因都调制 $N_{\text{tot}}$ 与 $N_{\text{act}}$ 才看似耦合,经验上在本文网格上近乎正交:$\log G$ 与 $\log N_{\text{tot}}$、$S$、$\log N_{\text{act}}$ 的 Pearson 相关系数绝对值都不超过 0.02。
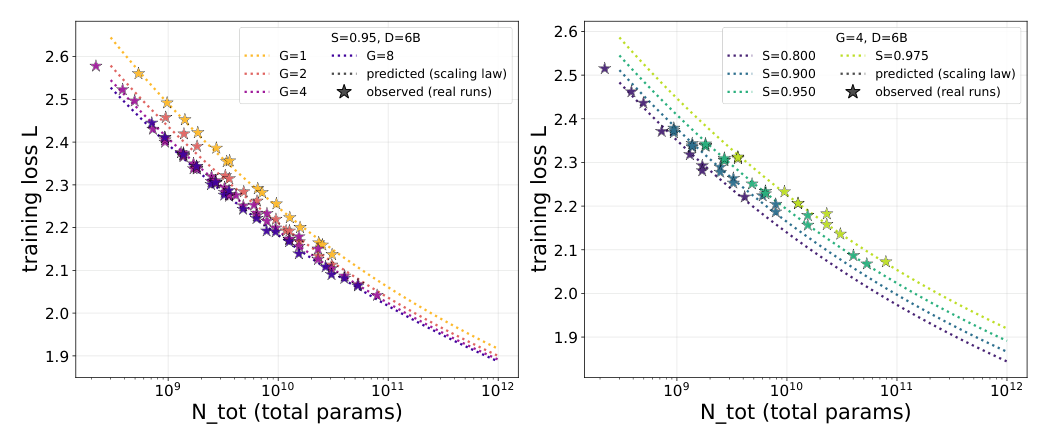
曲线扇形张开说明 $G$ 与 $S$ 的作用不是刚性平移而是依赖 $N_{\text{tot}}$,这种耦合可分离定律无法表达。于是把 $G$、$S$、$N_{\text{tot}}$ 绑进单一交互项:
$$L(N_{\text{tot}}, S, D, G) = \frac{a}{N_{\text{tot}}^{\alpha}} + \frac{b}{D^{\beta}} + \frac{c}{(1-S)^{\lambda}} + \frac{j}{(1-S)^{\delta} N_{\text{tot}}^{\gamma} G^{\eta}} + e \tag{15}$$
$G$ 只出现在交互项分母,故固定 $(N_{\text{tot}}, S, D)$ 下提高 $G$ 会缩小稀疏度惩罚、拉低预测 loss。把 $G$ 放进联合耦合项而非折进有效参数量,是保持跨 $G$ 拟合平衡的关键。
拟合结果与可辨识性
在 $G \in \{1,2,4,6,8\}$ 网格上拟合,各层留出 $N_{\text{act}}$ 前 10% 的 run 作验证,在 log 系数空间用 L-BFGS-B 最小化 Huber 目标($\delta_{\text{Huber}} = 0.1$)。
| 系数 | 取值 | 95% BCa CI | 可辨识性 |
|---|---|---|---|
| $a$ | 8.462 | [8.24, 8.85] | ridge |
| $b$ | 88.32 | [87.8, 89.9] | ridge |
| $c$ | 0.1828 | [0.181, 0.184] | ridge |
| $j$ | 0.7123 | [0.710, 0.713] | ridge |
| $e$ | 0.3129 | [0.307, 0.316] | ridge |
| $\alpha$ | 0.1048 | [0.104, 0.106] | ridge |
| $\beta$ | 0.2070 | [0.206, 0.208] | identified |
| $\lambda$ | 0.1249 | [0.119, 0.138] | ridge |
| $\delta$ | 0.5567 | [0.550, 0.577] | ridge |
| $\gamma$ | 0.1702 | [0.167, 0.174] | ridge |
| $\eta$ | +0.9513 | [+0.911, +0.954] | identified |
只有 $\eta$ 与 $\beta$ 被数据唯一钉住($G$ 和 $D$ 各自只在定律的一个位置出现,没有别的系数能吸收);其余系数坐落在一条近乎平坦的可辨识性脊上,表中的紧区间低估了真实的跨盆地散布。$\eta \approx 0.95$ 因此是本文最稳健的观察:更大的 $G$ 折扣掉稀疏度在固定容量下施加的 loss 惩罚;500 次 warm-start wild bootstrap 给出的区间 [+0.91, +0.95] 明显大于零。
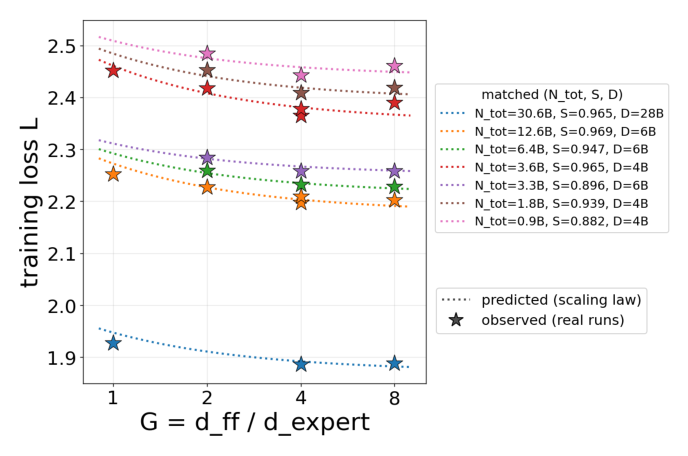
作者诚实地指出:预测随 $G$ 单调下降,而实测 run 只降到 $G=4$、在 $G=8$ 处于噪声内持平或略微反转,因此不宣称一条普适的专家切分因子定律。定律把"最粗与最细专家的差距随序列变宽"归因于稀疏度经由 $(1-S)^{-\delta}$ 起作用而非 $N_{\text{tot}}$ 本身。
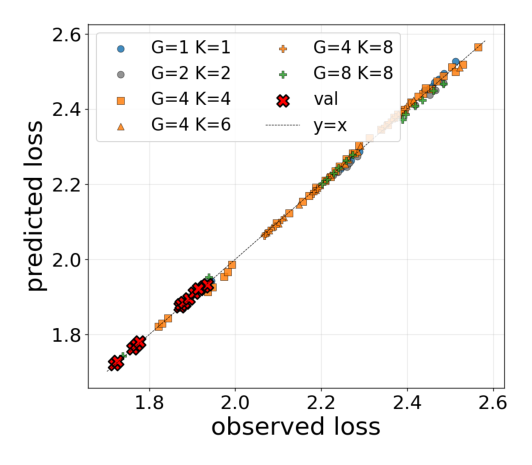
拟合形式还具备良好 scaling law 的性质:对 $N_{\text{tot}}$、$D$、$G$ 单调递减,对 $S$ 凸且 $S \to 1$ 时惩罚陡增;$N_{\text{tot}}, D \to \infty$ 且固定 $S$ 时 loss 趋于 $e + c(1-S)^{-\lambda}$——稀疏度地板在无穷规模下依然存在,稠密极限的不可约项是 $e_\infty = e + c \approx 0.50$ 而非 $e$。
关键技术细节(三):性能模型 ScalePlan
设计原则与微基准
设计原则是:每一项都必须追溯到硬件规格、实测 kernel 或 collective 计时、或调度方程,绝不允许手调常数。轻量解析骨架(FLOPs、collective 算法方程、1F1B 调度)与目标硬件上的微基准配对。两种无法从无竞争微基准中恢复的效应——小模型上 CPU dispatch 受限的执行、大 collective 上的跨节点 straggler 与重叠——各自被隔离进一个显式标注的修正项,而不是把 fudge factor 撒遍每个组件。
基准组件:稠密 GEMM(按 $(M,N,K)$ 与精度索引的实际利用率);Grouped GEMM(融合 GroupedLinear 算子,按本地专家数、grouped tile $M_{\text{expert}} = \lceil T_{\text{seq}} B_{\text{micro}} K / E \rceil$ 与专家形状索引——至关重要,因为专家 MLP 跑的是许多小 tile,当成单个稠密 GEMM 计价会在 dropless 区间把利用率高估近一个数量级);FlashAttention 后端 SDPA;MoE 路由与逐元素算子;融合 vocab-parallel 交叉熵(完全落在最后一个 pipeline stage);NCCL collectives 的有效总线带宽曲线(覆盖 NVSwitch 与 EFA、连续与跨步 rank 布局,与解析估计最高差 8×);每 kernel 的 CPU dispatch gap。
迭代时间模型
每迭代时间 = block 计算项 + 流水线气泡项 + 词表阶段项 + 暴露的 DP/PP collective 时间 + 优化器步。三处偏离朴素 roofline:
计算 vs dispatch。 小模型且 micro-batch 为 1 时 block kernel 极小(每个 GEMM < 0.1 ms),单 microbatch 要发射数万 kernel,CPU 来不及入队导致 GPU 饥饿,故每 microbatch 墙钟建模为
$$t_{\text{mb}} = \max(t_{\text{cmp}}, t_{\text{disp}}), \quad t_{\text{block}} = n_{\text{mb}} t_{\text{mb}}, \quad n_{\text{mb}} = \frac{B_{\text{global}}}{P_{\text{DP}} B_{\text{micro}}} \tag{16}$$
其中 $t_{\text{disp}} = L_{\text{stage}} \kappa(E_{\text{loc}}) t_{\text{gap}} + t_{\text{host}}$ 是 CPU dispatch 下界,kernel 计数律 $\kappa(E_{\text{loc}}) = \kappa_0 + \kappa_1 E_{\text{loc}}$ 随本地专家数增长(主导发射数的是 permutation、拷贝、bias-add 等周边 kernel 而非融合专家 GEMM)。$\max$ 让该项自限:大模型 kernel 足够大能藏住 dispatch。
流水线气泡。 1F1B 下对 $n_{\text{mb}}$ 个 microbatch、$P_{\text{PP}}$ 个阶段、$P_{\text{VPP}}$ 路交错:
$$f_{\text{bubble}} = \frac{P_{\text{PP}} - 1}{P_{\text{VPP}}\, n_{\text{mb}}}, \qquad t_{\text{bubble}} = f_{\text{bubble}} t_{\text{block}} \tag{17}$$
每个 rank 在 warmup/cooldown 期间空转 $(P_{\text{PP}}-1)/P_{\text{VPP}}$ 个 microbatch 槽——这个爬坡就是气泡的全部。它取代了此前既重复计入 fill/drain、又用 clamp 低估小 batch 区间的加权平均表达式。
词表阶段失衡。 token embedding 在第一阶段、LM head 加交叉熵在最后一阶段,而 1F1B 由最慢阶段配速,最后阶段的余量 $t_{\text{last}}$ 每 microbatch 暴露一次并拉长爬坡:
$$t_{\text{vocab}} = (n_{\text{mb}} - 1)\max(t_{\text{first}}, t_{\text{last}}) + t_{\text{first}} + t_{\text{last}} \tag{18}$$
外加一项 $t_{\text{last}} n_{\text{mb}} f_{\text{bubble}}$ 的爬坡项。它对深流水线 MoE 配置至关重要,此前完全没被计价。
唯一的标定项
唯一被拟合的项是跨节点 straggler 与重叠修正,乘在解析迭代时间上:
$$t_{\text{iter}}^{\text{cal}} = \chi_{\text{sys}}\, t_{\text{iter}}^{\text{analytic}} \tag{19}$$
$$\chi_{\text{sys}} = 1 + c_{\text{A2A}} \frac{t_{\text{A2A}}}{t_{\text{iter}}}\mathbb{1}\big[N_{\text{node}}^{\text{EP}} > 1\big] + c_{\text{PP}}\big(N_{\text{node}}^{\text{PP}} - 1\big) + c_{\text{ovl}}\,\mathbb{1}\big[P_{\text{PP}} \ge N_{\text{gpu/node}},\, N_{\text{node}}^{\text{PP}} = 1\big] \tag{20}$$
$N_{\text{node}}^{\text{EP}}$、$N_{\text{node}}^{\text{PP}}$ 计数 EP 与 PP 组跨越多少节点。三个驱动量各绑定一个物理量:(i) 跨节点 A2A straggler 按"专家 all-to-all 已占该步多大比例"放大惩罚,仅当 EP 组跨节点时生效;(ii) 深流水线项随节点跳数增长;(iii) 节点内重叠信用($c_{\text{ovl}} < 0$)只对单节点内的深流水线生效。估计器以 ScalePlan(github.com/dmlc/ScalePlan)开源。
为什么 model-FLOPs 最优是边界解
固定 $G$、令 $N_{\text{act}} = (1-S)N_{\text{tot}}$、预算 $C_{\text{model}} = 6N_{\text{act}}D$,纯 model-FLOPs 优化问题为
$$\min_{N_{\text{tot}}, S, D} L(N_{\text{tot}}, S, D, G) \quad \text{s.t.}\quad 6(1-S)N_{\text{tot}}D = C_{\text{model}},\ N_{\text{tot}}, D>0,\ S \in [0,1) \tag{21}$$
在 $C_{\text{model}} \in \{3\times10^{19}, 6\times10^{19}, 10^{20}, 3\times10^{20}, 6\times10^{20}\}$ 上求解,得到三条单调趋势:$N_{\text{tot}}^\star(S)$ 上升、$N_{\text{act}}^\star(S)$ 下降、$L^\star(S)$ 在每个预算下单调下降。
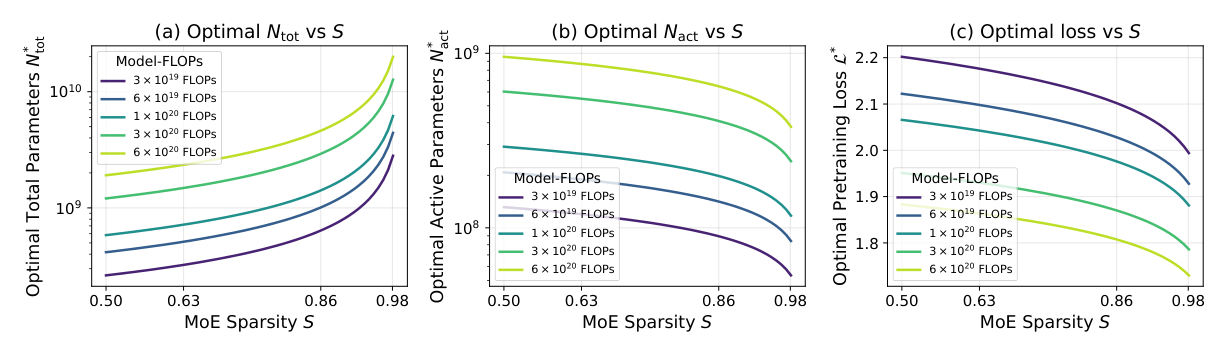
因为 $L^\star(S)$ 在标定区间内单调下降,内点条件 $\partial L^\star/\partial S = 0$ 无解,最优稀疏度落在数据支撑上边界 $S = S_{\max}$——纯 model-FLOPs 优化退化成"把 $S$ 调到架构空间允许的最大值"。而实践者买的不是 model FLOPs,是固定集群上固定窗口的 GPU 小时,最终在意的是训完时的 loss。
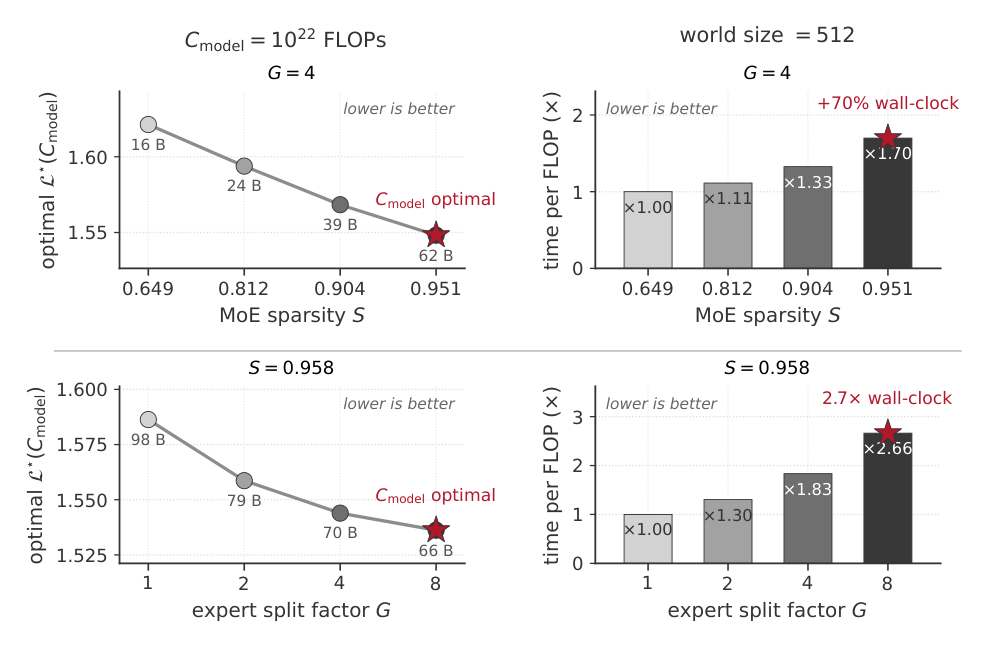
在 $C_{\text{model}} = 10^{22}$、world size 512 下:上排随稀疏度上升,最优 loss 单调下降($N_{\text{tot}}$ 依次 16B / 24B / 39B / 62B),但每 FLOP 墙钟时间升到 ×1.00 / ×1.11 / ×1.33 / ×1.70(+70%);下排随 $G$ 从 1 到 8,最优 loss 下降($N_{\text{tot}}$ 依次 98B / 79B / 70B / 66B),每 FLOP 墙钟时间升到 ×1.00 / ×1.30 / ×1.83 / ×2.66(2.7×)。$C_{\text{model}}$ 最优的配置恰恰是系统上最慢的那个。与 Kimi K2 的稀疏度 law(固定激活参数)及 Abnar et al. (2025) 的建议(固定总参数)不同,本文既不固定 $N_{\text{act}}$ 也不固定 $N_{\text{tot}}$。
实验设置
数据与配方。 纯文本 next-token-prediction 预训练,语料 mC4 英文部分,GPT-2 BPE 分词器(词表 50,257);bf16 权重与激活 + fp32 优化器主副本;AdamW,weight decay 0.1,$\beta_1=0.9$、$\beta_2=0.999$、$\epsilon=10^{-14}$,不裁剪梯度,WSD 调度(约 100M token warmup、最后 20% 步线性衰减到零);$T_{\text{seq}}=2048$,dropless;fan-in 投影初始化 $\mathcal{N}(0, 0.006^2)$,输出侧残差投影按深度缩放为 $\mathcal{N}(0, (0.006/\sqrt{2L_{\text{layers}}})^2)$。与 Chinchilla 一致,所有 run 对 token 单遍通过,用最终 checkpoint 的平滑训练 loss 作拟合目标。
学习率不做逐 run 扫描,而从一条以 model FLOPs 为轴的幂律读出,以免混淆 scaling law 拟合:
$$\mathrm{lr}^\star(C_{\text{model}}) = 3.30\, C_{\text{model}}^{-0.199}, \qquad C_{\text{model}} = 6 N_{\text{act}} D \tag{22}$$
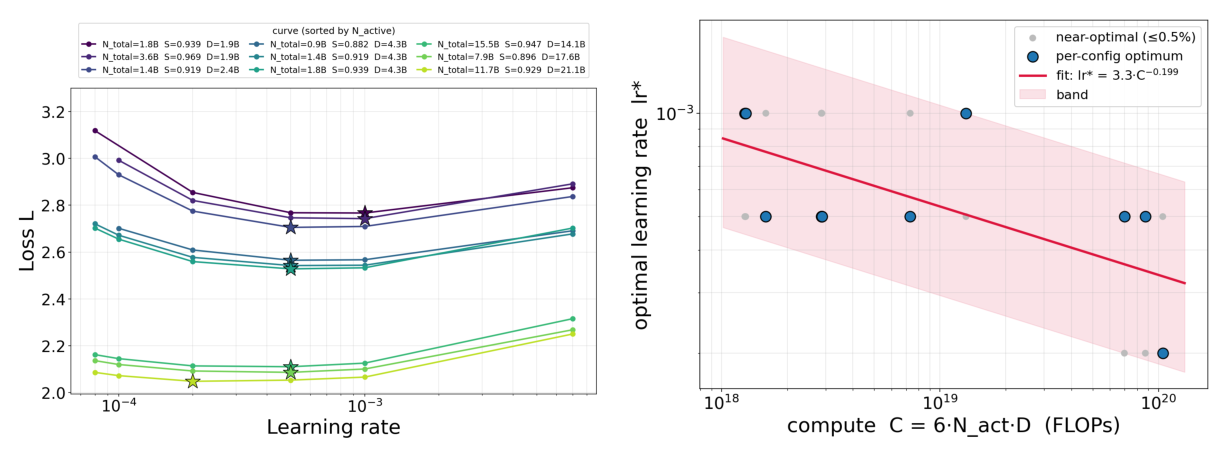
pilot sweep 验证:条件于 $C_{\text{model}}$ 后,近最优学习率对 $N_{\text{tot}}$、稀疏度、$N_{\text{act}}/D$ 划分无系统性残差依赖;衰减指数与 Tian et al. (2026) 拟合的 −0.153 接近。
scaling 数据集覆盖。 共 150 次从头训练的稀疏 MoE run:
| 量 | 最小 | 中位 | 最大 |
|---|---|---|---|
| 总参数 $N_{\text{tot}}$ (B) | 0.22 | 5.34 | 79.24 |
| 激活参数 $N_{\text{act}}$ (B) | 0.104 | 0.339 | 2.72 |
| 稀疏度 $S$ | 0.499 | 0.944 | 0.981 |
| 专家切分因子 $G$ | 1 | – | 8 |
| 专家数 $E$ | 8 | – | 512 |
| Top-K | 1 | – | 8 |
| $L_{\text{layers}}$ | 8 | – | 24 |
| 残差宽度 $d$ | 1024 | – | 3072 |
| 训练 token $D$ (B) | 2.88 | 5.76 | 56.38 |
| TPP = $D/N_{\text{act}}$ | 10.8 | – | 70 |
| 算力(非 embedding FLOPs) | $1.9\times10^{18}$ | – | $8.1\times10^{20}$ |
按 $G$ 分层的覆盖范围:
| $G$ | $N_{\text{tot}}$ (B) | $N_{\text{act}}$ (B) | $S$ | $D$ (B) | $L_{\text{layers}}$ | $E$, $K$ |
|---|---|---|---|---|---|---|
| 1 | 0.54–30.91 | 0.152–1.179 | 0.72–0.98 | 3.84–28.19 | {8,12,16} | $E\in\{8\text{–}128\}$, $K\in\{1,2\}$ |
| 2 | 0.95–12.65 | 0.124–0.387 | 0.87–0.97 | 3.84–5.76 | {8,12,16} | $E\in\{32\text{–}128\}$, $K\in\{1,2\}$ |
| 4 | 0.22–79.24 | 0.110–2.723 | 0.50–0.98 | 2.88–56.38 | {8,12,16,24} | $E\in\{12\text{–}384\}$, $K\in\{2,4,6,8\}$ |
| 8 | 0.71–53.0 | 0.104–2.52 | 0.85–0.98 | 3.84–50.00 | {8,12,16,24} | $E\in\{96\text{–}512\}$, $K\in\{2,4,8\}$ |
按骨架族的覆盖($D$ 由外层 Chinchilla 式预算决策与 $(L_{\text{layers}}, d)$ 绑定):
| $L_{\text{layers}}$ | $d$ | run 数 | $D$ (B) | $N_{\text{tot}}$ (B) | $G$ 取值 |
|---|---|---|---|---|---|
| 8 | 1024 | 52 | 2.88–7.68 | 0.22–7.14 | {1,2,4,6,8} |
| 12 | 1536 | 56 | 5.76–11.52 | 0.73–25.20 | {1,2,4,6,8} |
| 16 | 2048 | 39 | 28.19–56.38 | 4.13–45.66 | {1,2,4,8} |
| 24 | 3072 | 4 | 50.00 | 40.16–79.24 | {4,8} |
几何缩放阶梯。 因为 $S$ 与 $G$ 派生自离散几何、不能直接设定,搜索需要封闭的可实现架构集合。阶梯把骨架归约到单个种子 $q$:$L_{\text{layers}} = n_{\text{head}} = 4q$,$d_{\text{head}}=128$ 故 $d = n_{\text{head}} d_{\text{head}}$,$d_{\text{ff}} = 2.5d$。sweep 与所有实验共用同一阶梯,同一族几何既拟合定律又被框架搜索。
| $q$ | $L_{\text{layers}}$ | $n_{\text{head}}$ | $d$ | $d_{\text{ff}}$ | $N_{\text{tot}}$ (B)* | $N_{\text{act}}$ (B)* | $S$ |
|---|---|---|---|---|---|---|---|
| 4 | 16 | 16 | 2048 | 5120 | 15.5 | 0.7 | 0.954 |
| 6 | 24 | 24 | 3072 | 7680 | 53.2 | 2.3 | 0.957 |
| 8 | 32 | 32 | 4096 | 10240 | 127.3 | 5.4 | 0.958 |
| 10 | 40 | 40 | 5120 | 12800 | 250.0 | 10.4 | 0.958 |
| 12 | 48 | 48 | 6144 | 15360 | 433.7 | 17.9 | 0.959 |
| 14 | 56 | 56 | 7168 | 17920 | 690.5 | 28.2 | 0.959 |
| 16 | 64 | 64 | 8192 | 20480 | 1032.8 | 41.9 | 0.959 |
| 18 | 72 | 72 | 9216 | 23040 | 1472.8 | 59.5 | 0.960 |
(*非 embedding 参数量,在示例配置 $E=128$、$K=3$、$G=4$ 下给出。)
硬件与训练栈。 全部 run 跑在 AWS p6-b200.48xlarge(每节点 8 张 B200,节点内 NVLink 双向最高 14.4 TB/s,节点间第四代 EFA 3.2 Tbps)。训练栈是 PyTorch Lightning + NeMo + Megatron-Core;启用 grouped-GEMM 专家路径、交叉熵融合、专家并行 all-to-all dispatcher、shared-expert overlap,细粒度激活重计算作为 MFU 搜索的一个 sweep 轴。作者明确故意不开 parallel folding 与 DeepEP,测的是标准栈。
主要实验结果
性能模型验证
验证跨三个 sweep:$q=4$(0.7B $N_{\text{act}}$ / 16B $N_{\text{tot}}$,32 GPU)、$q=8$(5.4B / 127B,256 与 512 GPU)、$q=12$(18B / 434B,512 GPU)。每个数据点配对一组并行配置(ep/pp/dp/tp/cp 与 mbs)与其实测及预测 MFU;扫描全局 batch size,限制 tp=1、cp=1。
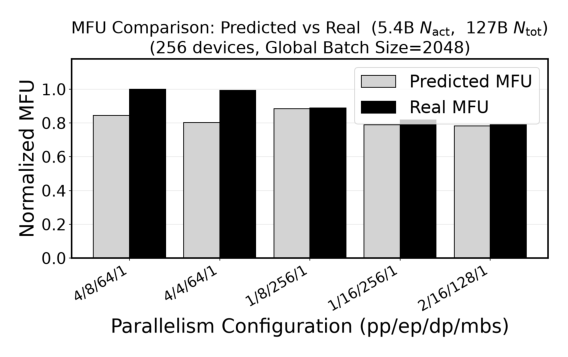
预测在绝对量级而不仅排序上准确。 MAPE 为 700M / 5.4B / 18B = 9.6% / 9.0% / 13.2%,全部低于 15%。排序对照:Top-5 重合率在 5.4B 与 18B 上 100%、700M 上 80%;Top-10 在 5.4B 与 18B 上 100%、700M 上 90%。唯一失手是两个几乎并列的低 MFU 配置互换位置——即便相邻点排错序,模型仍能可靠浮出高吞吐区间。
固定 $C_{\text{peak}}$ 下的最优分配
搜索包络(输入是训练窗口、设备类型及其峰值 FLOPs 与显存、设备数,外加 batch 包络):
| 输入 | 取值 |
|---|---|
| 硬件 | 32 台 p6 节点($N_{\text{dev}} = 256$) |
| 每设备峰值 $F_{\text{peak}}$ | 2.25 PFLOPs(bf16 稠密) |
| 墙钟 $T_{\text{train}}$ | 20 天 |
| 每设备显存上限 $M_{\text{dev}}$ | 179 GB |
| Goodput $\eta_{\text{good}}$ | 1.0 |
| 原始硬件天花板 $C_{\text{peak}}$ | $9.95\times10^{23}$ FLOPs |
| 全局 / 序列 batch | $B_{\text{global}}=1024$,$T_{\text{seq}}=2048$ |
| loss 定律 | 式 (15) 的联合 $L(N_{\text{tot}},S,D,G)$ |
| 外层架构网格 | $q\in\{8,10,12,14,16,18\}$,$K\in\{1,2,4,6,8\}$,$E\in\{4,6,8,16,24,32,48,96,128,192,256,384,512\}$,$G\in\{1,2,4,8\}$ |
| 内层布局搜索 | $P_{\text{TP}}, P_{\text{CP}}, P_{\text{EP}}, P_{\text{PP}}, P_{\text{DP}}$,$B_{\text{micro}}\in\{1,2,4\}$,激活重计算 $\in$ |
额外加一条几何护栏 $S \ge 0.7$,token 预算按 TPP $= D/N_{\text{act}} \in [40,150]$ 扫描(训练数据 TPP 最高只到 70)。返回最优解的 model FLOPs 约为最大拟合 run 的 150 倍——一次相当大的外推,作者认为定律支撑的是配置排序而非绝对值。唯一 loss 最优配置:
| $L_{\text{layers}}$ | $E$ | $K$ | $G$ | $N_{\text{act}}$ (B) | $S$ | TPP | $D$ (T) | MFU (%) | Loss | pp | ep | mb | cp | tp |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 48 | 96 | 2 | 4 | 14.5 | 0.956 | 98 | 1.42 | 12.38 | 1.3898 | 8 | 8 | 4 | 1 | 1 |
(MFU 列是最优可行执行计划的预测峰值 MFU,非实测值。)
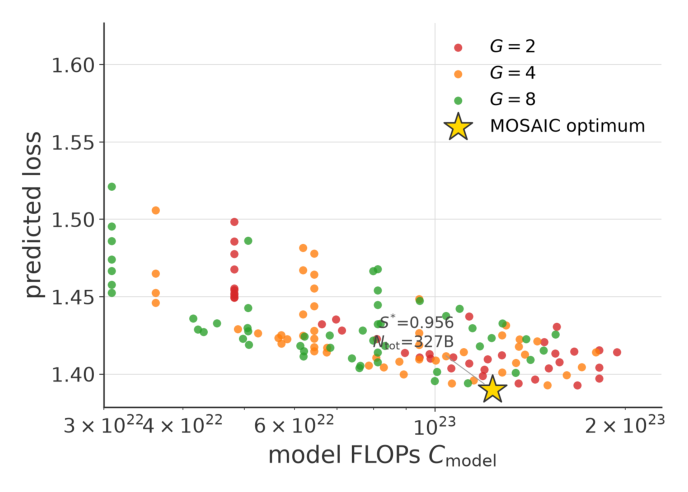
这是全文最锋利的一张图。既然硬件天花板对所有候选相同,一个几何落到更靠右唯一途径是维持更高 MFU。$G$ 恰好给这个散布排了序:$G=8$ 几何挤在低 $C_{\text{model}}$ 端、中位 MFU 接近 8%,较粗的 $G=2$ 几何冲到右端 13–20%——更高的 $G$ 从同一天花板里交付更少的有用算力,因为专家 dispatch 与 combine 通信吃掉了本该留给模型的 FLOPs。只看 model FLOPs 会把最细的专家读成"最便宜",但在固定天花板下它们恰恰是集群喂得最少的那批:转化出最多 model FLOPs 的候选是更稠密的 $G=2$、$E=32$ 几何($1.94\times10^{23}$),loss 仍高于最优解;最优配置只花 $1.23\times10^{23}$(少约 36%)就达到 $L=1.3898$。
最优 $S$ 与 $G$ 随预算的移动
两个预算 sweep:固定 32 节点、窗口取 {10, 20, 30, 40} 天;固定 30 天窗口、集群取 {16, 32, 64, 128} 节点(每个节点数重跑性能模型)。
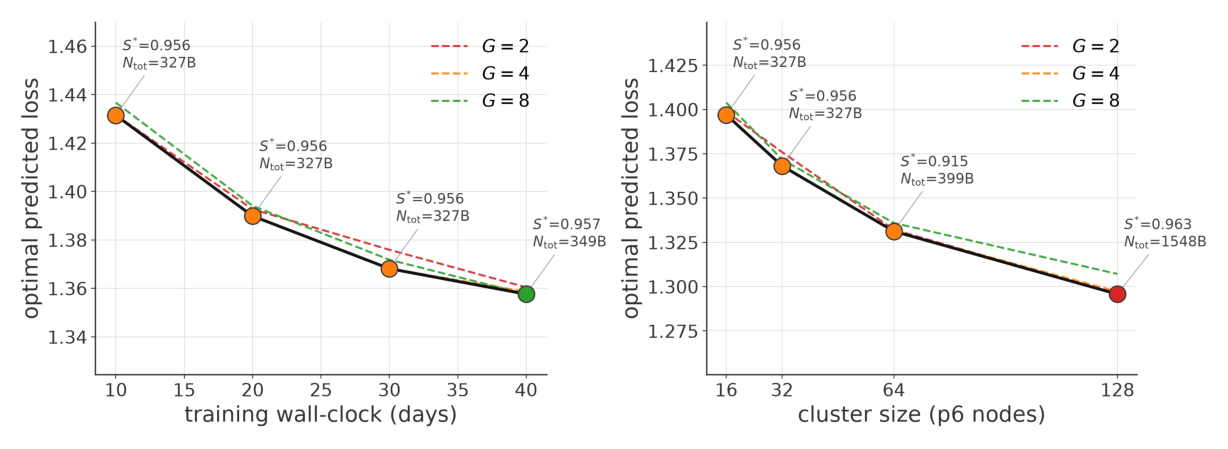
结果:$G^\star$ 在大多数预算下为 4($G=8$ 只在最长窗口、$G=2$ 只在最大节点预算出现,且往往接近并列);$S^\star$ 停在 0.915–0.963 的宽平台上、不随预算变尖,与 Figure 4 中 model-FLOPs 最优的单调趋势形成对照;$N_{\text{act}}^\star$ 在天数 sweep 上稳定在 14–15B,在两个最大节点预算上增长到 34B 与 58B。这些结论是在没有对模型维度施加任何显式上限下得到的:显存地板约束总参数,GPU 小时成本为高 $S$ 与高 $G$ 的 MFU 退化和 all-to-all 惩罚收费,系统约束本身就让内点稀疏度浮现。
从预测排序到实测 loss
最后检验预测排序能否迁移到真实训练:取 8 节点(64 GPU)跑 10 天的小预算包络,枚举可行网格,从排序预测中选四个配置实跑。
| 排名(loss) | $L_{\text{layers}}$ | $E$ | $K$ | $G$ | $N_{\text{act}}$ (B) | $N_{\text{tot}}$ (B) | $S$ | 预测 MFU (%) | 归一化实测 MFU | pp | ep | cp | tp | mbs |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| ID 1 | 40 | 128 | 2 | 4 | 8.5 | 250.0 | 0.966 | 14.0 | 0.84 | 4 | 8 | 1 | 1 | 4 |
| ID 2 | 40 | 128 | 2 | 8 | 5.6 | 126.4 | 0.956 | 11.6 | 0.69 | 4 | 8 | 1 | 1 | 4 |
| ID 3 | 40 | 32 | 2 | 4 | 8.5 | 66.0 | 0.872 | 21.8 | 0.91 | 4 | 8 | 1 | 1 | 4 |
| ID 4 | 32 | 32 | 2 | 2 | 7.3 | 65.8 | 0.889 | 23.3 | 1.0 | 4 | 8 | 1 | 1 | 4 |
四个 run 全局 batch size 固定 1024,峰值学习率按式 (22) 分配。实测 MFU 完全复现预测排序;预测 MFU 归一化得 0.60 / 0.50 / 0.94 / 1.00,对应实测 0.84 / 0.69 / 0.91 / 1.00——排序一致但预测散布更宽(解析模型系统性偏乐观)。
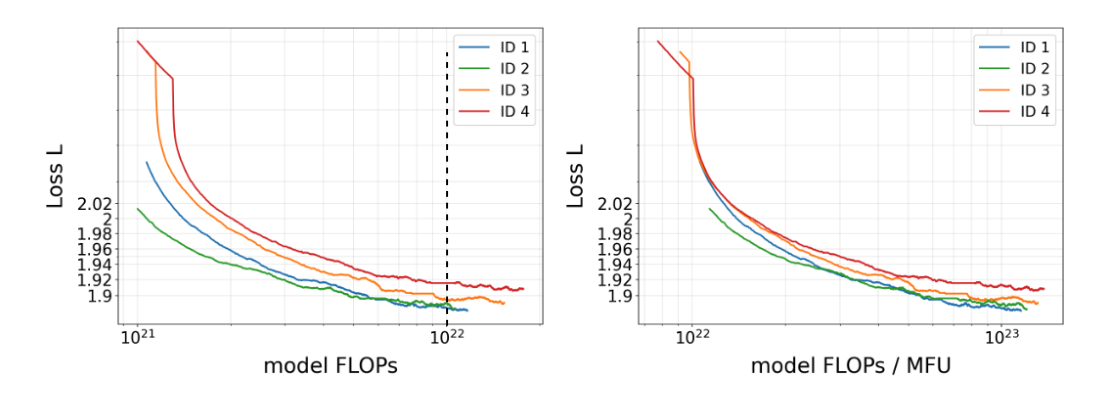
四个 run 各训 200B token 以上,最大 model FLOPs 约为拟合集最大预算($8.1\times10^{20}$)的 15–20 倍,是在拟合区间之外检验排序。两条读数:
- ID 3 与 ID 4 隔离了专家切分因子:总参数几乎相同(66.0B vs 65.8B)、稀疏度接近(0.872 vs 0.889),$G=4$ 的 run 在两个轴上都低于 $G=2$。
- ID 1 与 ID 2 的排序在两轴之间翻转:per-FLOP 轴上到约 $10^{22}$ model FLOPs 之前 $G=8$、低 $N_{\text{act}}$ 的 ID 2 领先(5.6B vs 7–8.5B 的激活量把曲线推向"更少 model FLOPs 达到给定 loss"),此后收敛到轨迹宽度内;换成 $C_{\text{cost}} = C_{\text{model}}/(\mathrm{MFU}\,\eta_{\text{good}})$ 轴后,ID 1 因 MFU 更高(0.84 vs 0.69)、同样硬件买到约 1.2 倍模型计算量而明显领先。
这个排序翻转就是 MOSAIC 要捕捉的 co-design 效应本身,作者定位为早期验证。
消融与分析
可辨识性分析。 400 次全新重启的扫描显示 loss 曲面存在一条宽而近乎平坦的脊:$(a,\alpha)$、$(j,\gamma,\delta)$、$(c,\lambda)$ 在近乎恒定的目标值上互相权衡。作者承认 $S\to1$ 时 $L\to\infty$ 是形式强加而非测量到的,要钉住 $(c,\lambda,\delta)$ 需要 $S$ 接近 0.999 的 run,本文网格没有。
并行设计规则(附录 F.2)。 (1) 主导杠杆是流水线填充比 $r_{\text{fill}} = n_{\text{mb}}/P_{\text{PP}}$,它解释了实测 MFU 中最高 3.1×(18B)与 2.1×(700M)的布局散布——$r_{\text{fill}}$ 趋近 1 时吞吐塌陷、$\ge 4$ 后饱和(18B sweep 在 $P_{\text{PP}}=16$ 下 MFU 随 $r_{\text{fill}}$ 攀升后稳定在约 10–12%)。(2) 专家 all-to-all 属于 scale-up 域:EP 在节点边界内有益、越过则有害(5.4B sweep 中 $P_{\text{EP}}$ 从 8 到 16 掉落)。(3) FFN 并行预算花在专家并行而非专家张量并行,因为前者每层一次 all-to-all、后者加两次 all-reduce。落地做法是固定 $P_{\text{TP}}=1$、$P_{\text{EP}}$ 设到 scale-up 域,再选让 $r_{\text{fill}}\ge4$ 的 $(P_{\text{PP}}, B_{\text{micro}})$——作者称其为"NVL8 上 700M–18B 无显存压力时的 MFU 最优布局"而非硬件无关定律。
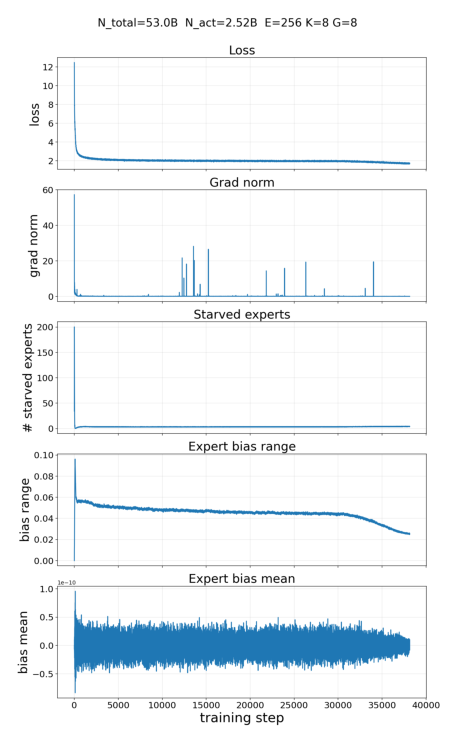
训练动态。 "饿死"指某专家收到的 token 少于均匀分配应得量的 5%。四个最大模型上 loss 平滑下降、饿死专家数早期塌到接近零、偏置极差稳定收缩,说明控制器在最大规模下仍维持稳定路由——这正是把最终 checkpoint loss 当作可比拟合目标的前提。
结构性质(附录 D.2)。 三条:(1) 在 $(\log N_{\text{tot}}, \log D, \log(1-S), \log G)$ 下目标 $L$ 凸,因为它是 posynomial;(2) 非凸性完全居于约束而非目标;(3) $D$ 只进入目标与 FLOPs 预算,不进入显存上限或布局乘积,故最大可行 $D$ 有闭式解
$$D^\star(Z, P_\ell) = \frac{F_{\text{peak}} N_{\text{dev}} T_{\text{train}} \mathrm{MFU}(Z,P_\ell,B)\, \eta_{\text{good}}(N_{\text{dev}})}{6 N_{\text{act}}(N_{\text{tot}}, S)} \tag{23}$$
因为 $L$ 对 $D$ 单调递减,最优解必把式 (3) 取到等号。三条性质让双层规划坍缩成"枚举阶梯几何 → 为每个几何选 MFU 最大的可行计划 → 由式 (23) 定 $D$ → 用式 (15) 打分"的单阶段搜索,返回精确最优而非启发式解。
最优资源分配律(附录 D.3)。 离散最优能否总结成闭式分配律?对固定架构归约精确——把式 (23) 代入定律得
$$L^\star(Z, C_{\text{peak}}) = L_\infty(Z) + \frac{\Psi(Z)}{C_{\text{peak}}^{\beta}}, \qquad \Psi(Z) = b\left(\frac{6N_{\text{act}}(Z)}{\mathrm{MFU}^\star(Z)\,\eta_{\text{good}}}\right)^{\beta} \tag{24}$$
$L_\infty(Z)$ 收集式 (15) 中不含 $D$ 的三项与常数 $e$。连续最优解则需额外假设(显存松弛内点、局部布局不变、$\mathrm{MFU}^\star$ 可微)。记 MFU 对数斜率 $\omega_N, \omega_S, \omega_G$($\omega_G>0$ 表示专家变细时 MFU 下降)、$r \equiv 1-S$、$N \equiv N_{\text{tot}}$、四项为 $L_{\text{cap}}, L_{\text{data}}, L_{\text{sp}}, L_{\text{int}}$,平稳性条件为
$$\alpha L_{\text{cap}} = \beta L_{\text{data}}(1 - \omega_N - \gamma\omega_G/\eta), \quad \lambda L_{\text{sp}} = \beta L_{\text{data}}(1 - \omega_S - \delta\omega_G/\eta), \quad \eta L_{\text{int}} = \beta \omega_G L_{\text{data}} \tag{25}$$
第三式要求 $\omega_G>0$:若系统不对更细专家施加惩罚($\omega_G=0$)该式无解,目标对 $G$ 严格递减、最优解落在最大可行 $G$ 上——这就是"边界解"在闭式层面的根源。再假设对数斜率在同一系统区间内近似恒定($\mathrm{MFU}^\star \simeq m_0(N/N_0)^{\omega_N}(r/r_0)^{\omega_S}(G/G_0)^{-\omega_G}$),最优解沿区间局部路径移动:
$$r^\star \propto (N^\star)^{\alpha/\lambda}, \qquad D^\star \propto (N^\star)^{\alpha/\beta}, \qquad G^\star \propto (N^\star)^{(\alpha-\gamma-\alpha\delta/\lambda)/\eta} \tag{26}$$
记 $p=\alpha/\lambda$、$\varrho=\alpha/\beta$、$g=(\alpha-\gamma-\alpha\delta/\lambda)/\eta$、$\nu = [(1-\omega_N)+(1-\omega_S)p+\varrho+\omega_G g]^{-1}$,同一路径用采购预算表达:
$$N^\star \propto C_{\text{peak}}^{\nu}, \quad 1-S^\star \propto C_{\text{peak}}^{p\nu}, \quad D^\star \propto C_{\text{peak}}^{\varrho\nu}, \quad G^\star \propto C_{\text{peak}}^{g\nu} \tag{27}$$
这些关系条件于固定硬件、设备数、batch 包络与系统区间;布局切换、显存边界、拓扑变化都会改变对数斜率并产生不同的分配相位。作者明确把这一节定位为未来工作。
核心贡献总结
- 概念上:打破"算力预算是架构无关常数"的隐含假设,用 $C_{\text{deliverable}}$ 取代 $C_{\text{model}}$,并证明该替换定性改变 MoE 处方——从边界稀疏度变为内点稀疏度。
- 建模上:四维联合定律把专家切分因子作为独立轴写进交互项,$\eta \approx 0.95$ 是被数据唯一钉住的系数,量化"更细专家软化稀疏惩罚的速率"。
- 系统上:算子级性能模型只含一个显式标注的拟合项;MAPE < 15%,Top-5/Top-10 排序重合率基本 100%,以 ScalePlan 开源。
- 决策上:耦合成可精确枚举求解的单阶段 MINLP($D$ 闭式消元),返回架构 + 并行布局的联合最优,并用最高 250B 总参数的 staged run 验证预测 MFU 排序与"loss 排序在两轴间翻转"。
与已归档相关工作的对比
MobileMoE MobileMoE: Scaling On-Device Mixture of Experts(Meta AI,2026-05-26)
关系:独立并发(本文未引用 MobileMoE,两者殊途同归)· 已加载对方精读
- 共同关注的问题:同一 root cause——面向服务器的 MoE scaling law 只对 FLOPs 计价,其架构处方在真实部署基质上要么不可行、要么不最优。MobileMoE 说"现有 law 假设充裕硬件,端侧却同时受算力与内存双重约束";本文说"model FLOPs 漏掉了一个依赖架构的系统效率乘子"。两者都发现:不把部署资源写进约束,最优解就退化成"越稀疏越细越好"。
- 相近的技术骨架:流程图可抽象重合——(1) 在显式暴露 MoE 几何轴的扩展形式上拟合 loss 定律;(2) 写下硬件资源函数;(3) 解该约束下的受限最小化得到可部署离散几何。MobileMoE 是 $\mathcal{L}(N_{\text{act}}, D, \hat E, x)$ 配显存 proxy $\mathcal{M} = \frac{b_w}{8}N_{\text{total}} + \frac{b_{\text{kv}}}{8}\cdot2Tn_l n_{\text{kv}}d_h \le M$,本文是 $L(N_{\text{tot}},S,D,G)$ 配 $C_{\text{deliverable}}$。两者甚至独立推出同一条"细粒度专家收益快速递减":前者定 $g=8$,后者得 $G^\star=4$。
- 本文的差异与可比实验:MobileMoE 是静态容量约束(装进 ~5GB DRAM 后不再影响优化),本文是动态吞吐约束,依赖并行布局、必须内嵌一层执行计划最大化;因此本文的可行边界随集群规模与窗口移动(Figure 11),而 MobileMoE 的最优 $E$ 只随手机内存单调移动。甜点数值天差地别($E\in\{4,8\}$、sub-billion 激活 vs $S^\star\in[0.915,0.963]$、$N_{\text{act}}^\star$ 14–58B),但结构结论一致:加上硬件约束后稀疏度出现内点最优。
RankMixer RankMixer(ByteDance,2025-07-21)
关系:独立并发(本文未引用 RankMixer,且分属 LLM 预训练与工业排序两个领域)· 已加载对方精读
- 共同关注的问题:RankMixer 的诊断是"排序模型的人工特征交叉模块继承自 CPU 时代,算子 memory-bound、MFU 常只有个位数,参数放大后成本近似线性增长、scaling law 收益难以兑现"。剥掉领域外衣,root cause 与本文相同:FLOPs / 参数量不是正确的计价单位,MFU 才是。
- 相近的技术骨架:两者都把 MFU 提为架构决策的一等公民,且都用实测 MFU 判定胜负。RankMixer 的做法是手工重设计算子(无参数 multi-head token mixing 替代自注意力、per-token FFN 替代共享 FFN),把 memory-bound 的图改成 compute-bound,MFU 从 4.5% 拉到 45%。
- 本文的差异与可比实验:本文不改算子,而是把 MFU 预测器塞进架构选择的目标函数,在给定曲面上做约束优化——两者互补,RankMixer 改变 MFU 曲面本身,本文在曲面上求解(本文也承认"更广的 kernel 级改动可能把最优 $G$ 变成预算的可预测函数")。验证形态相反:RankMixer 有线上 A/B(Douyin 1B 部署、+0.3% 活跃天数)而无预测定律,本文有可外推定律而只有离线 staged run。两者 MFU 量级互相印证(4.5% 起点、本文最优解预测 12.38%):真实 MFU 远低于直觉。
Prescriptive Scaling Laws for Data Constrained Training Prescriptive Scaling Laws for Data Constrained Training(Cornell,2026-05-02)
关系:显式引用但原文未展开对比(仅在 Introduction 一句话提及)· 已加载对方精读
- 共同关注的问题:本文 Introduction 原话:"More recent prescriptive scaling laws recommend the optimal scaling dimensions under additional data constraints (Lovelace et al., 2026), yet none of these constraints price in the systems efficiency of the prescribed architecture." 两篇 root cause 结构同构:Chinchilla 的处方失效,是因为真正 binding 的约束不是它建模的那个——前者瓶颈从 compute 转向 data,"无限唯一 token"假设崩塌;本文瓶颈是集群兑现的吞吐,"架构无关算力预算"假设崩塌。
- 相近的技术骨架:都走"把 binding 资源显式写进定律 → 重推处方 → 证明处方与旧定律定性不同"。Lovelace 等加加性过拟合惩罚 $P\cdot R_D^\delta\cdot (N/U_D)^\kappa$,把多 epoch 的 $R^2$ 从 0.58 提到 0.95,得出"超过算力阈值后应扩大模型、减少 epoch";本文加可交付 FLOPs 约束,得出"最优稀疏度从边界变内点"。两者都把新约束强度孤立成可读的量:前者是单系数 $P$(强 weight decay 削减约 70%),后者是 $\eta\approx0.95$ 与 $\omega_G$。
- 本文的差异与可比实验:Lovelace 等的新约束外生且架构无关,优化仍闭式可解;本文的新约束内生且架构相关,只能退到离散枚举 + 内嵌布局最大化——这也是本文只能在附录 D.3 靠额外假设凑闭式分配律的原因。数据规模上前者训 300+ 模型(15M–1B、最高 16 epoch),本文约 150 个 MoE run(TPP 10.8–70),并把过训练区间列为空白——恰是前者所在的区间。
讨论与局限性
值得借鉴的设计。 其一,把"预算"从常数升格为架构的函数,是可迁移到任何"scaling law 指导架构选型"场景的元方法——只要架构维度会显著改变 MFU 或显存,纯 FLOPs 排序就不可信。其二,性能模型的工程纪律:除一个显式标注的跨节点 straggler 修正外,每一项都必须追溯到实测微基准。其三,$D$ 的闭式消元(式 23)把双层 MINLP 塌成可枚举问题,"先证明约束在最优处取等号"的技巧普遍适用。其四,"验证配置排序而非 loss 数值"是外推区间下诚实又有用的评估立场。
局限与争议。 最重的一条是作者自陈:返回的精确架构条件于所选几何阶梯、硬件平台与训练配方,且部分最优点需大幅外推(20 天包络最优解的 model FLOPs 约为最大拟合 run 的 150 倍),因此证据更强地支持"硬件感知排序与 co-design 原则"而非任何单一几何作为普适集群最优。第二,非辨识系数的不确定性没有传播进离散架构搜索——11 个系数里只有 $\eta$ 与 $\beta$ 被钉住,搜索却把点估计当确定曲面用。第三,性能模型镜像的是相当基础的 Megatron-Core 栈,"最优 $G$ 无单调趋势"本身可能是该栈系统惩罚的产物。第四,$G\le8$ 上限与被限制的 TPP(10.8–70)意味着过训练区间完全未覆盖——而这恰是当今前沿模型最常处的区间,也是结论最可能被翻转的地方。第五,全局 batch size 固定 1024 不进入决策空间,$\eta_{\text{good}}$ 全程设为 1.0,而附录 F.3 自列的 host 侧 stall 恰说明该假设偏乐观,这也是解析模型高估 MFU 的部分原因。
工业落地价值。 论文没有线上业务指标,但工程可迁移性直接:ScalePlan 输入模型规格 + 集群规格就能枚举执行计划、按预测 MFU 排序并给出显存占用,可直接替代"先拍模型尺寸、再让系统团队试布局"的两段式流程;附录 F.2 三条布局规则能立刻缩小 MoE 训练的布局搜索空间。对自建集群做 MoE 预训练的团队,本文最实用的一句话是:在拍定稀疏度与专家粒度之前,先测一遍这些几何在你自己集群上的 MFU;FLOPs 账本上最划算的那个,很可能是墙钟上最慢的那个。