EMO: Frustratingly Easy Progressive Training of Extendable MoE 精读¶
USC-ISI · MBZUAI-IFM · arXiv:2605.13247v2 · 2026-05-13(v2 于 2026-05-14) 作者:Linghao Jin, Chufan Shi, Huijuan Wang, Nuan Wen, Zhengzhong Liu, Eric Xing, Xuezhe Ma
研究动机与背景¶
稀疏 MoE 的承诺,以及它兑现不了的那部分¶
稀疏 Mixture-of-Experts(MoE)把模型容量与每 token 计算量解耦:把 Transformer 的 FFN 换成 $E$ 个专家,每个 token 只路由到其中 $k$ 个,于是参数量可以随 $E$ 涨,而每 token FLOPs 只随 $k$ 涨。这条路径支撑了 GLaM、Mixtral、Kimi K2、DeepSeek-V4 等一批最强的模型。
本文要指出的是:这个解耦只在 FLOPs 这一层成立,在 wall-clock 那一层并不成立。当 $E$ 增长时,有三类系统开销随专家池规模一起涨:
- 专家并行的 all-to-all 通信(Lepikhin et al., 2021;Rajbhandari et al., 2022);
- 参数、梯度、优化器状态的聚合显存(Fedus et al., 2022);
- 每专家 GEMM 变小导致的 GPU 利用率下降,以及路由 kernel 本身的开销(Gale et al., 2023;Yan et al., 2026)。
作者在自己的训练栈上量化了这个缺口。固定 top-$k=8$、固定激活参数量,把 $E$ 从 8 加到 128,理论 FLOPs 完全不变,但实测每步 wall-clock:
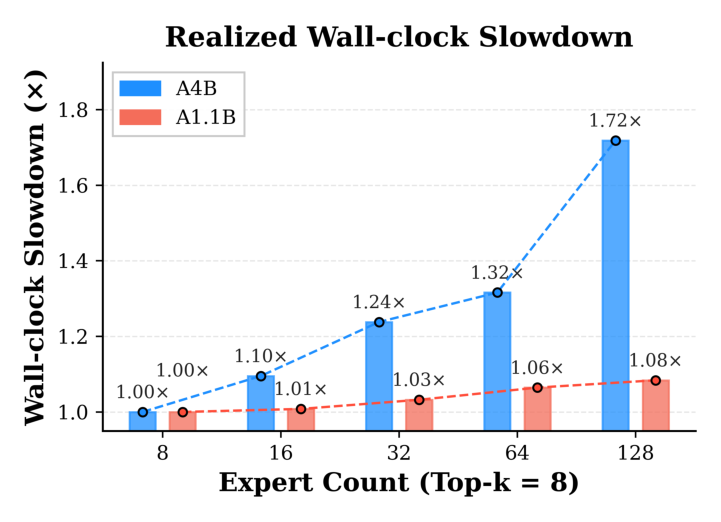
| $E$ | 8 | 16 | 32 | 64 | 128 |
|---|---|---|---|---|---|
| Wall-clock 放慢($N_{\text{act}}=1.1$B,A1.1B) | 1.00× | 1.01× | 1.03× | 1.06× | 1.08× |
| Wall-clock 放慢($N_{\text{act}}=4$B,A4B) | 1.00× | 1.10× | 1.24× | 1.32× | 1.72× |
关键读数是:激活规模越大,这个缺口越宽。在 A1.1B 上把 $E$ 拉到 128 只慢 1.08×,看着可以忽略;但到 A4B 就变成 1.72×,而且作者预期它会随激活规模继续恶化。作者把这个 FLOPs–wall-clock 的错配命名为 MoE efficiency paradox(MoE 效率悖论)。
论文的切入角度:专家是"可寻址的参数化记忆"¶
面对效率悖论,通常的应对是做系统优化(更好的 dispatcher、通信-计算重叠、grouped GEMM、block-sparse、kernel fusion)。本文换了一个角度提问:
训练真的从第一步就需要全部 $E$ 个专家吗?
作者引入的视角是把每个专家看成一个参数化记忆单元:一个专门化的子网络,存储并检索与某个数据子集相关的模式(Shazeer et al., 2017;Roller et al., 2021;Bengio et al., 2013)。在这个视角下,当训练数据还很少时,一个巨大的专家池既没必要也不经济——它放大了通信和显存开销,却提供了一份此刻还用不上的容量;随着数据量增长,额外的专家(记忆)才开始变得有价值。
这个直觉与已有的 MoE scaling law 是自洽的:compute-optimal 的专家数随 token 预算增长(Ludziejewski et al., 2025;Clark et al., 2022)。于是作者提出核心原则:
MoE 容量应当作为一块可扩展记忆,随数据一起渐进增长。
由此得到 EMO(Extendable Mixture-of-Experts):一个在训练过程中分多阶段增量扩张专家池的渐进训练框架。它从一个小 MoE(或稠密模型)出发,通过多次 upcycling 式扩展长成大 MoE。
作者明确地把 EMO 与三条既有路线做了区分:路由与负载均衡的工作、系统层优化的工作、以及 sparse upcycling 的工作——这三条线全都在训练过程中把 $E$ 固定住;EMO 让 $E$ 随数据增长,并且不依赖标准 MoE 层之外的任何架构改造或辅助目标(这正是标题里 "frustratingly easy" 的由来)。
预备知识¶
MoE 与效率悖论的形式化¶
给定 token 表示 $x$,路由器给出专家上的概率分布,只激活 top-$k$:
$$\text{MoE}(x) = \sum_{i \in \mathcal{K}(x)} p_i(x) \cdot E_i(x) \tag{1}$$
其中 $\mathcal{K}(x) \subset \{1, \dots, E\}$、$|\mathcal{K}(x)| = k$ 是被选中的专家下标,$p_i(x)$ 是归一化的路由权重。因为实践中 $k \ll E$,每 token FLOPs 随 $k$ 走,参数量因而可以准独立于计算量增长。
每步 FLOPs 为:
$$\text{FLOPs}_{\text{step}} \approx 6 \cdot B \cdot N_{\text{act}} \tag{2}$$
$B$ 是 batch size,激活参数量 $N_{\text{act}}$ 只随激活专家数 $k$ 走,而不随总专家池 $E$ 走。稠密 Transformer 里每个参数都参与每次前向,FLOPs 与 wall-clock 高度一致;MoE 打破了这个对应关系——这就是式 (2) 与 Figure 1 之间的裂缝。
Sparse Upcycling¶
与其从零训练 MoE,sparse upcycling(Komatsuzaki et al., 2023)从一个预训练好的稠密 checkpoint 出发,把 FFN 权重复制到所有专家上来初始化 MoE:
$$E_1(x) := E_2(x) := \cdots := E_E(x) := \text{FFN}(x) \tag{3}$$
当所有专家相同、路由均匀时,这个初始化保持了原稠密模型的行为。但作者指出:单步 upcycling 在专家数很大时过于激进(aggressive),效率也不够——一次性从稠密跳到 $E=128$,等于立刻承担了全部大 $E$ 的 wall-clock 成本。EMO 正是把这"一步跳"改造成"多步爬"。
核心方法:EMO 总览¶
EMO 用固定的激活专家数 $k$ 配合多步扩张的总专家数 $E$,平滑地从小 MoE/稠密模型走到大 MoE。
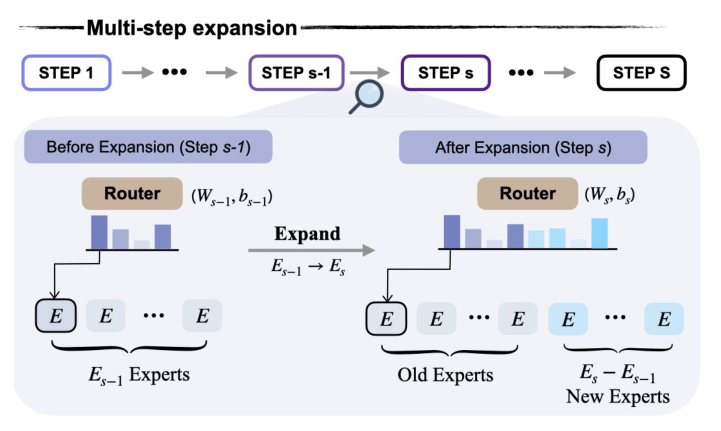
Algorithm 1(EMO: Progressive MoE Training)
输入: 初始模型 θ(0),初始专家数 E0;总 token 预算 D;最终阶段专家数 E_S
输入: 扩张调度 {(E_s, d_s)}_{s=1..S}          ▷ §3.1: 由 scaling law 计算最优 token 数
输出: 训练完成的模型 θ(S),专家数 E_S

1: for s = 1 to S do
2:     θ(s-1) ← Expand(θ(s-1), E_{s-1} → E_s)   ▷ §3.3: 新专家 / 路由器初始化
3:     θ(s)   ← Train(θ(s-1), d_s tokens)
4: end for
5: return θ(S)
框架只需要回答两个设计问题:
- 何时扩张(每阶段分多少 token)——§3.1、§3.2;
- 如何初始化扩张——§3.3。
作者对第一个问题的表述很直接:训练在小 $E$ 上停留太久,模型就浪费了后续扩容容量所需的数据;扩张太早,则整个 run 的大部分时间都要承担完整的大 $E$ wall-clock 成本。
关键技术细节(一):专家感知的 token 分配¶
Step 1:拟合稀疏度 scaling law¶
标准的 compute-optimal scaling law(Hoffmann et al., 2022)把 loss 建模为:
$$L(N, D) = aN^{-\alpha} + bD^{-\beta} + c \tag{4}$$
其中 $a, b$ 是尺度系数,$\alpha, \beta$ 是 scaling 指数,$c$ 是不可约熵下界。这个形式对 EMO 不够用:它把所有相同激活规模的模型一视同仁,而 EMO 里同一个 $N_{\text{act}}$ 在不同阶段服务于完全不同的专家配置。
作者因此改用 Ludziejewski et al. (2025) 的 unified MoE scaling law,联合建模激活参数、总专家数与数据量:
$$L(N_{\text{act}}, E, D) = m(E) N_{\text{act}}^{\mu(E)} + n(E) D^{\nu(E)} + c \tag{5}$$
系数与指数都被显式参数化为 $E$ 的函数:
$$m(E) = aE^{\delta},\quad n(E) = bE^{\omega},\quad \mu(E) = \alpha + \gamma \ln E,\quad \nu(E) = \beta + \zeta \ln E \tag{6}$$
物理含义上,指数 $\nu(E)$ 是整个方法的枢纽:它控制 loss 随额外 token 下降的速度。$\nu$ 依赖 $E$ 就意味着最优的 data-to-parameter 比例会随专家数增加而移动——这正是"多少数据配多少专家"这件事可被求解的前提。
附录 D 里 $E$ 实际用的是 Clark et al. (2022) 的单调变换 $\hat{E}$(避免 $E$ 很小或很大时指数项发散):
$$\frac{1}{\hat{E}} = \frac{1}{E - 1 + \left(\frac{1}{E_{\text{start}}} - \frac{1}{E_{\text{max}}}\right)^{-1}} + \frac{1}{E_{\text{max}}} \tag{7}$$
作者用与主实验完全相同的数据,在 $E \in \{1, 2, 4, \dots, 256\}$、多个 $N_{\text{act}}$ 与 $D$ 的网格上拟合式 (5)。拟合按 Hoffmann et al. (2022) 的做法:Huber loss(阈值 0.01)+ LBFGS,再对初始化与系数约束做网格搜索选模。拟合质量 $R^2 = 0.9957$、训练集 RMSE $= 0.0085$、held-out RMSE $= 0.0092$。
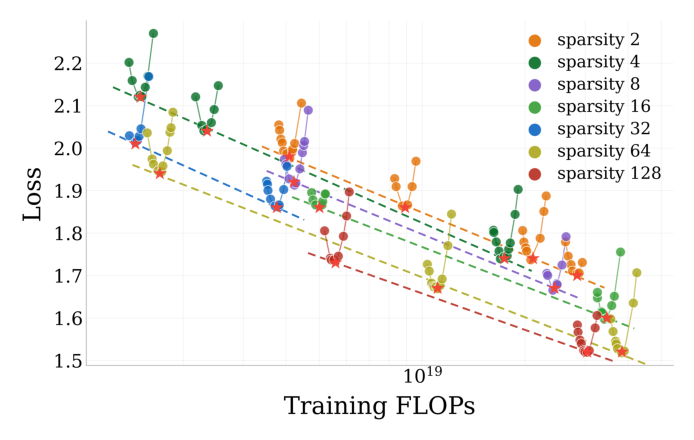
Figure 3 是这条律在本文数据集上的可视化:横轴训练 FLOPs、纵轴 loss,每条虚线是一个稀疏度($E$)下的 compute-optimal 前沿,红星标出各自的最优点。关键结构是这些前沿并不重合:$E$ 越大,前沿越低,但需要的 FLOPs 也越大——最优点系统性地沿横轴右移。这正是"专家越多,值得配的数据越多"的图形化表述。
Step 2:求每个 $E$ 的 compute-optimal 累计 token 数¶
因为 $N_{\text{act}}$ 全程固定,loss 在阶段 $s$ 只依赖 $E_s$ 与累计 token 数 $D_s$。在固定算力 $F$ 下求解每个专家数的 compute-optimal token 数:
$$D_s^* = \arg\min_D L(N_{\text{act}}, E_s, D) \quad \text{s.t.} \quad F = 6 N_{\text{act}} D \tag{8}$$
$D_s^*$ 的语义是:假如整个训练都用 $E_s$ 个专家,最优的累计 token 数是多少。附录 D 给出闭式解:代入 $N_{\text{act}} = F/(6D)$ 后令导数为零,
$$D^*(F, E) = \left( \frac{n(\hat{E})\,\nu(\hat{E})}{m(\hat{E})\,\mu(\hat{E})} \right)^{-\frac{1}{\mu(\hat{E}) + \nu(\hat{E})}} \left( \frac{F}{6} \right)^{\frac{\mu(\hat{E})}{\mu(\hat{E}) + \nu(\hat{E})}} \tag{9}$$
因为本文固定了 $N_{\text{act}} = \bar{N}_{\text{act}}$,实际做法是沿 $F$ 扫过 compute-optimal 解族,挑出其 $N_{\text{act}}^*$ 恰好等于 $\bar{N}_{\text{act}}$ 的那一个。Figure 4b 就是这个操作的图示:横轴训练 FLOPs、纵轴 $N_{\text{act}}^*$,每个 $E$ 一条线,一条 $N_{\text{act}}^* = 0.846$B 的水平线与它们相交(红星),交点的 FLOPs 再换算成 $D^*$。
Step 3:归一化成扩张调度¶
把累计最优值差分成增量:
$$d_s^* = D_s^* - D_{s-1}^*, \qquad D_0^* = 0 \tag{10}$$
再按总预算 $D_{\text{total}}$ 归一化:
$$d_s = D_{\text{total}} \cdot \frac{d_s^*}{\sum_{s'=1}^{S} d_{s'}^*} \tag{11}$$
直觉是:$D_s^*$ 刻画了"$E_s$ 个专家的模型在最优 scaling 下需要多少数据",而差分 $d_s^*$ 反映了"从 $E_{s-1}$ 扩到 $E_s$ 时,新增容量正当地要求多少额外数据"。归一化保证总预算被遵守,同时保留 scaling law 给出的相对比例。
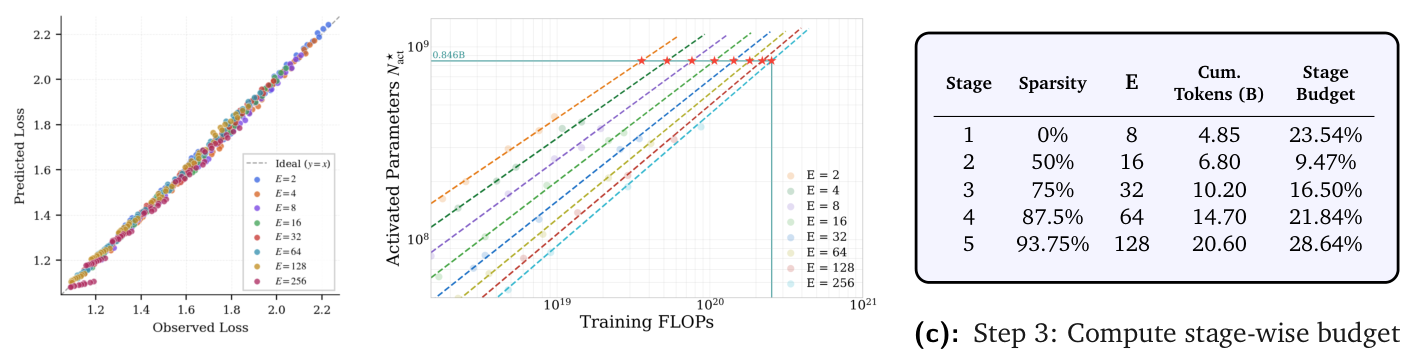
主实验解出的调度(Figure 4c):
| Stage | 稀疏度 $1-k/E$ | $E$ | 累计最优 tokens (B) | 阶段预算占比 | 折算绝对量($D_{\text{total}}=1.92$T) | 折算步数(共 240K) |
|---|---|---|---|---|---|---|
| 1 | 0% | 8 | 4.85 | 23.54% | ≈452B | ≈56.5K |
| 2 | 50% | 16 | 6.80 | 9.47% | ≈182B | ≈21.6K |
| 3 | 75% | 32 | 10.20 | 16.50% | ≈317B | ≈39.6K |
| 4 | 87.5% | 64 | 14.70 | 21.84% | ≈419B | ≈52.4K |
| 5 | 93.75% | 128 | 20.60 | 28.64% | ≈550B | ≈68.7K |
两个值得注意的结构:
- Stage 1 是完全稠密的 MoE:$E=8$ 而 $k=8$,稀疏度 0%,所有专家全激活。所以"从稠密模型开始 upcycle"在这里是字面意义上的。
- 分配不是单调的:Stage 2 只拿到 9.47%,比 Stage 1 的 23.54% 少得多。这是式 (10) 的直接后果——$E=8$ 与 $E=16$ 两条 $D^*$ 曲线离得近(4.85→6.80,只差 1.95B),而后面越扩间距越大(3.40 / 4.50 / 5.90B)。整体形状是"前端塞满便宜的小 $E$ 训练,把大 $E$ 留到最后",最后一个阶段独占 28.64%。
关键技术细节(二):扩张时机的经验验证¶
Scaling law 说了每阶段该分多少 token,但这个预测点是否真的落在质量–成本曲面的有利区域?作者用一个隔离单次扩张边界的对照实验来检验:把 $E=16$ 的模型在总预算的 25% / 50% / 75% 三个固定位置扩到 $E=32$,而 scaling law 推出的扩张点约在 45%。
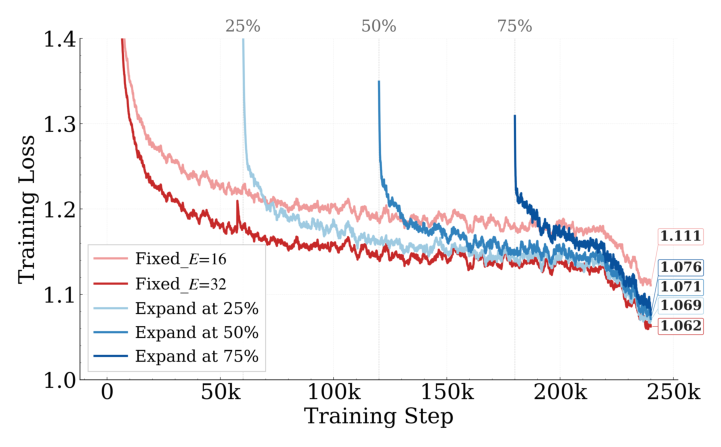
| 配置 | 最终训练 loss | 相对 Fixed_E=32 |
|---|---|---|
| Fixed_E=16 | 1.111 | +0.049 |
| Expand @25% | 1.069 | +0.007 |
| Expand @50% | 1.071 | +0.009 |
| Expand @75% | 1.076 | +0.014 |
| Fixed_E=32 | 1.062 | — |
结论分析:三个扩张点的最终 loss 全部落在 Fixed_E=16 与 Fixed_E=32 之间,说明渐进扩张确实在两者之间做插值而没有塌到下界。更关键的是曲率:25%→50% 的 loss 差只有 0.002,而 50%→75% 的差扩大到 0.007——即质量–成本曲线在 25–50% 区间相对平坦,越过 50% 后陡然变差。scaling law 给出的 ~45% 恰好落在这段平坦区的末端:它拿到了早扩张的绝大部分质量收益,同时避开了最早(25%)方案的全部 wall-clock 代价。
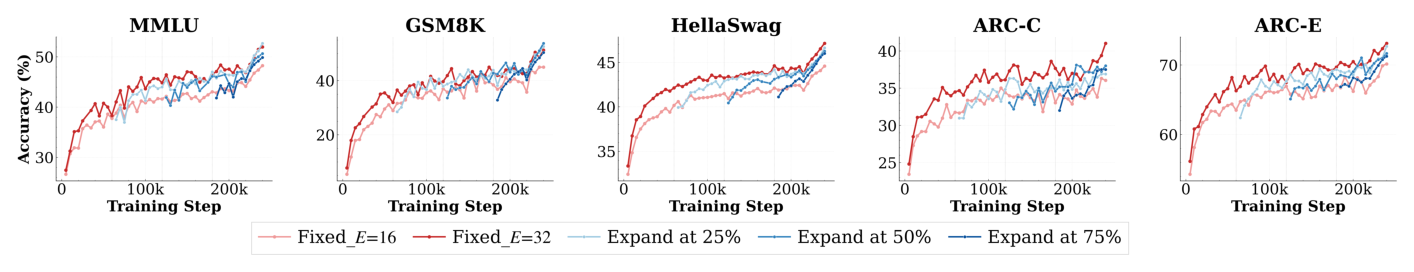
下游评测(Table 1,240K 步末检查点)复现了同一模式,而且比 loss 更乐观:
| Model | MMLU | HellaSwag | ARC-C | ARC-E | PIQA | BoolQ | GSM8K | SIQA | OBQA | COPA | WinoGrande | NQ (EM) | TriviaQA (EM) | RACE-H | RACE-M |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Fixed_E=16 | 48.27 | 44.59 | 36.05 | 70.15 | 73.01 | 59.02 | 44.96 | 41.91 | 27.40 | 74.00 | 58.48 | 9.11 | 22.58 | 40.05 | 57.17 |
| Fixed_E=32 | 51.98 | 47.14 | 41.03 | 73.11 | 73.78 | 71.71 | 51.25 | 41.56 | 27.80 | 76.00 | 60.46 | 11.86 | 27.52 | 39.59 | 55.15 |
| Expand @25% | 52.70 | 46.63 | 36.91 | 72.69 | 73.83 | 70.09 | 52.62 | 41.76 | 29.00 | 75.00 | 60.93 | 10.78 | 27.03 | 40.57 | 55.50 |
| Expand @50% | 50.66 | 46.27 | 38.03 | 71.67 | 73.78 | 69.42 | 53.75 | 41.66 | 27.80 | 75.00 | 60.85 | 10.53 | 26.49 | 40.25 | 55.22 |
| Expand @75% | 49.88 | 46.01 | 37.51 | 71.25 | 73.83 | 66.33 | 50.34 | 42.17 | 26.60 | 73.00 | 61.64 | 10.06 | 24.93 | 39.85 | 54.60 |
Expand@25% 在 MMLU(52.70 vs 51.98)与 GSM8K(52.62 vs 51.25)上反超 Fixed_E=32,在 HellaSwag / ARC-E 上持平;即便最晚的 Expand@75% 也远好于 Fixed_E=16。这说明 loss 上那 0.007 的差距在下游任务上并不构成实质劣势,反倒有单项反超——训练 loss 低估了渐进扩张的下游收益。
Takeaway 1(原文):质量–成本权衡在 scaling-law 预测的扩张点附近是有利的:比 $d_s^*$ 晚扩张会迅速损失质量,而大幅提前扩张则边际收益递减。
关键技术细节(三):专家扩展与初始化¶
考虑一次把专家数从 $E_{s-1}$ 增到 $E_s$ 的扩张步,有三样东西需要初始化:新专家权重、路由器权重、路由器 bias。设第 $s-1$ 步的参数为
$$\theta_{s-1} = \{\theta_i^{\text{old}}\}_{i=1}^{E_{s-1}}, \quad W_{s-1} \in \mathbb{R}^{E_{s-1} \times d_r}, \quad b_{s-1} \in \mathbb{R}^{E_{s-1}} \tag{12}$$
扩张后变为
$$\theta_s = \{\theta_i^{\text{old}}\}_{i=1}^{E_{s-1}} \cup \{\theta_j^{\text{new}}\}_{j=E_{s-1}+1}^{E_s}, \quad W_s = \begin{bmatrix} W_{s-1} \\ W^{\text{new}} \end{bmatrix}, \quad b_s = \begin{bmatrix} b_{s-1} \\ b^{\text{new}} \end{bmatrix} \tag{13}$$
其中 $W^{\text{new}} \in \mathbb{R}^{(E_s - E_{s-1}) \times d_r}$、$b^{\text{new}} \in \mathbb{R}^{E_s - E_{s-1}}$ 对应新增专家。注意这个操作只在专家维度上拼接行,路由器的输入维度 $d_r$ 与骨干网络完全不变——这是"frustratingly easy"的技术兑现:没有动态计算图手术,没有辅助目标,没有额外的架构组件。
主实验的默认选择是:新专家与路由器权重用 Gaussian 初始化,所有路由器 bias 重置为 0,优化器状态在每次扩张时重置,并配一段短的学习率 warmup(500 步)。
实验设置¶
架构:decoder-only Transformer MoE,16 层,hidden 2048,16 个 query head / 4 个 KV head,SwiGLU,RMSNorm,RoPE base 100000,MoE 层之前有 1 个 dense 层。每个 MoE 层含 1 个 shared expert + 一个 routed 专家池,每 token 激活 top-$k=8$ 个 routed 专家;routed 专家 hidden 维度 768。路由器用 sigmoid 打分函数并启用 router bias,entropy-based load balancing,系数 $10^{-4}$。
规模:激活参数 1.1B(含 embedding),$E \in \{8, 16, 32, 64, 128\}$,$E=128$ 时总参数 9.6B(即 9.6B-A1.1B)。EMO 五阶段逐级倍增 $8 \to 16 \to 32 \to 64 \to 128$。
训练超参:global batch size 8M tokens,context length 8192,总计 240K 优化器步 = 1.92T tokens。AdamW,$\beta_1 = 0.9$、$\beta_2 = 0.95$、$\epsilon = 10^{-8}$,weight decay 0.05,梯度裁剪 1.0,peak LR $9 \times 10^{-4}$。学习率用 warm-stable-decay(WSD):2K 步 warmup、一段常数阶段、在总预算 90% 处开始线性衰减到 0.01 倍。中间各阶段只做 500 步 warmup 并保持在常数学习率上,所以扩张不会在 LR 调度上引入不连续;衰减只发生在最后一个阶段。
基础设施:32 张 NVIDIA H200(4 节点 × 8 卡)+ 数据并行。BF16 混合精度、FlashAttention-3、fused transformer-block kernel、selective activation recomputation;multi-source sequence packing(best-fit-decreasing 启发式)+ document masking 降低 padding 浪费;MoE 侧重算路由器激活以省显存。作者强调这是为了在一个已经高度优化的训练栈上验证 EMO——避免"因为 baseline 系统实现差所以显得渐进训练有效"。
数据:web / code / math / 多语混合语料。
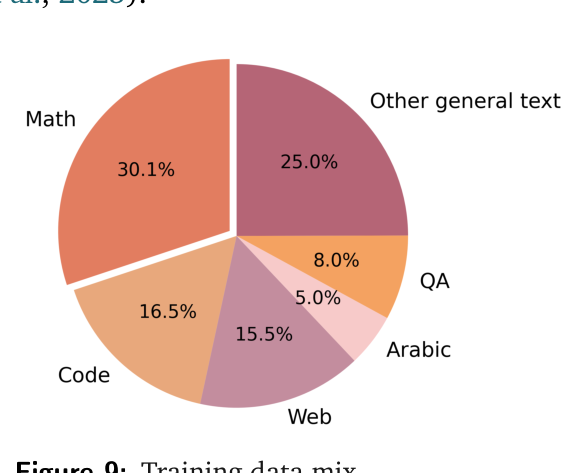
配比为 Math 30.1%、Other general text 25.0%、Code 16.5%、Web 15.5%、QA 8.0%、Arabic 5.0%。验证 PPL 每 5K 步在 web / 多语 / code / academic 等 held-out 切片上评测;下游评测同样每 5K 步跑一次,覆盖 BoolQ、HellaSwag、NQ、PIQA、SIQA、WinoGrande、OpenBookQA、ARC-E、ARC-C、RACE、COPA、MMLU、Arabic MMLU、TruthfulQA、GSM8K。所有下游评测用 LM Evaluation Harness 默认模板,因为全是 base 模型故一律贪心解码(temperature = 0)。
Baseline:三个从零训练的固定专家池模型 Fixed_E=16 / 32 / 128,总 token 预算与超参完全一致。
Scaling law 实验设置:使用与主实验相同的 tokenizer、数据配比、context length、优化器族、路由器设计与验证协议,但扫的是更小的激活规模与 $E \in \{2, 4, 8, 16, 32, 64, 128, 256\}$。注意:这组 scaling 实验把 top-$k$ 固定为 2(而非主实验的 8),目的是在改变总专家池的同时控制稀疏激活。
主要实验结果¶
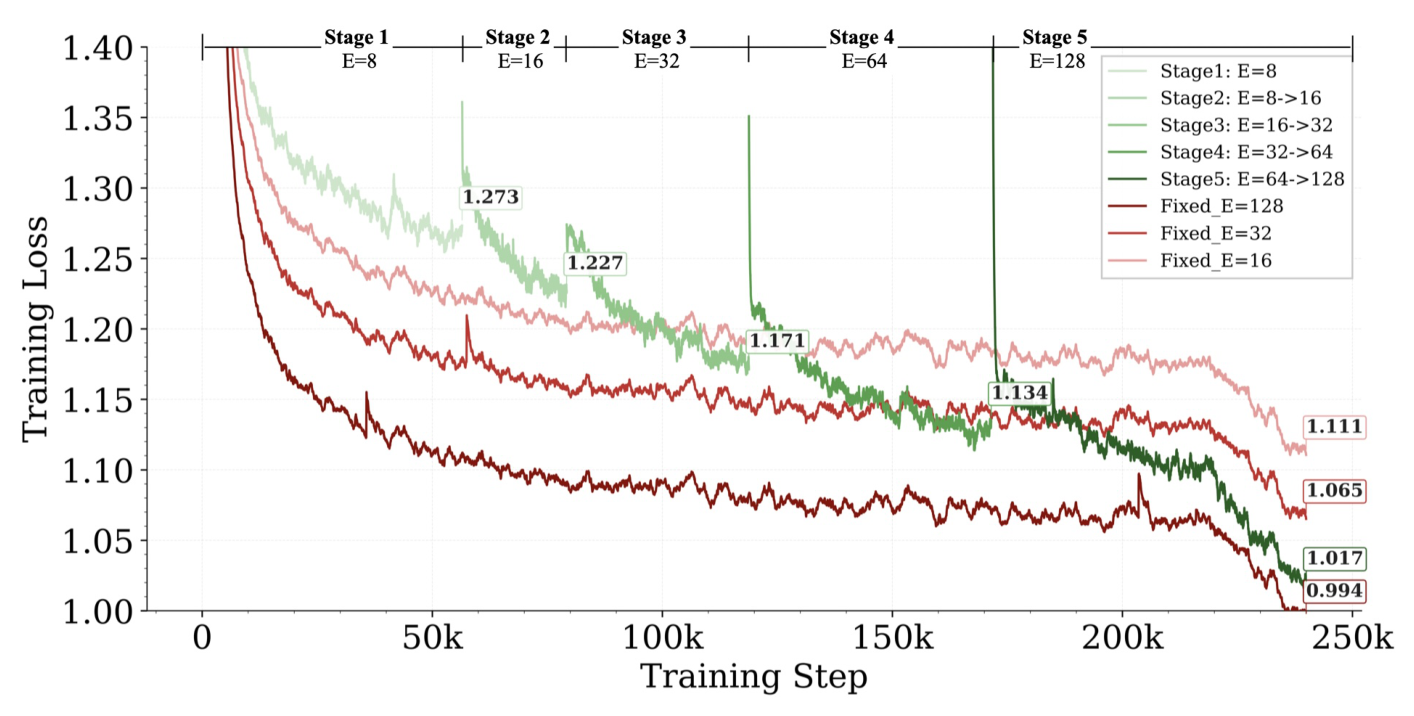
| 模型 | 最终训练 loss | 与 Fixed_E=128 的相对差 |
|---|---|---|
| Fixed_E=16 | 1.111 | +11.8% |
| Fixed_E=32 | 1.065 | +7.1% |
| EMO(8→16→32→64→128) | 1.017 | +2.3% |
| Fixed_E=128 | 0.994 | — |
EMO 各阶段末的 loss 为:Stage 1($E=8$)1.273 → Stage 2 1.227 → Stage 3 1.171 → Stage 4 1.134 → Stage 5 1.017。
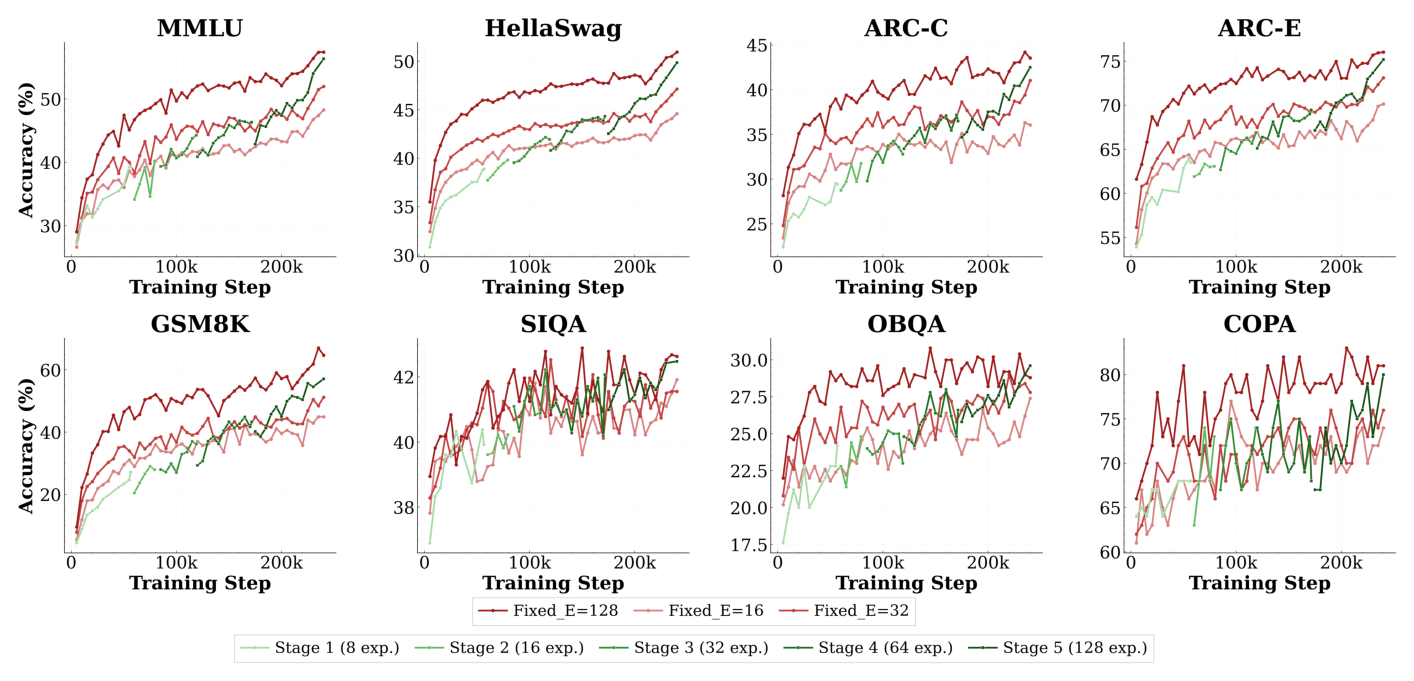
结论分析:EMO 从一个远小的专家池($E=8$)起步,最终进入了与 Fixed_E=128 同一个低 loss 区间(1.017 vs 0.994,2.3% 相对差),同时节省 10% GPU 小时;而它对 Fixed_E=32(1.065)与 Fixed_E=16(1.111)是明确的领先。这说明渐进扩张既绕开了小专家池的容量瓶颈,又避免了全程使用最大专家池的成本。
从曲线形态还能读出两件事:
- 每次扩张都会产生一个瞬时 loss spike(Figure 7 中四根尖峰清晰可见,Stage 5 的最高),但 loss 在约 10K 步内恢复——说明新增专家是被快速整合进来的,而不是造成了持续的优化不稳定。
- 交叉点很晚。EMO 的绿色曲线在前 ~170K 步一直高于 Fixed_E=32 的粉线,直到 Stage 5($E=128$)开始才迅速下穿,并在最后的 LR decay 段完成反超。换句话说,渐进训练的收益几乎全部兑现在最后一个阶段,中途看曲线会误判为方法失败——这是一个实操上很重要的观察。
主下游评测(Table 2,末检查点,准确率 %):
| Model | MMLU | HellaSwag | ARC-C | ARC-E | PIQA | BoolQ | GSM8K | SIQA | OBQA | COPA | WinoGrande | NQ (EM) | TriviaQA (EM) | RACE-H | RACE-M |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Fixed_E=16 | 48.27 | 44.59 | 36.05 | 70.15 | 73.01 | 59.02 | 44.96 | 41.91 | 27.40 | 74.00 | 58.48 | 9.11 | 22.58 | 40.05 | 57.17 |
| Fixed_E=32 | 51.98 | 47.14 | 41.03 | 73.11 | 73.78 | 71.71 | 51.25 | 41.56 | 27.80 | 76.00 | 60.46 | 11.86 | 27.52 | 39.59 | 55.15 |
| Fixed_E=128 | 57.40 | 50.95 | 43.53 | 76.03 | 76.44 | 74.89 | 64.73 | 42.63 | 28.80 | 81.00 | 63.06 | 16.34 | 39.11 | 40.31 | 56.20 |
| Stage 1 ($E=8$) | 39.29 | 38.88 | 29.44 | 63.51 | 69.91 | 66.85 | 27.14 | 39.92 | 24.20 | 68.00 | 56.99 | 5.65 | 14.62 | 37.36 | 52.51 |
| Stage 2 (8→16) | 40.21 | 39.81 | 31.76 | 63.09 | 70.13 | 67.80 | 27.98 | 40.23 | 24.80 | 73.00 | 56.20 | 5.24 | 13.98 | 37.91 | 51.95 |
| Stage 3 (16→32) | 44.27 | 41.93 | 32.79 | 66.89 | 71.27 | 69.72 | 36.16 | 41.15 | 23.00 | 74.00 | 57.85 | 7.23 | 17.76 | 38.51 | 53.20 |
| Stage 4 (32→64) | 46.34 | 44.33 | 36.48 | 69.47 | 73.50 | 70.52 | 43.29 | 42.07 | 26.60 | 68.00 | 58.56 | 8.64 | 22.21 | 39.71 | 54.81 |
| Stage 5 (64→128) | 56.34 | 49.86 | 42.49 | 75.18 | 74.81 | 70.40 | 57.09 | 42.48 | 29.60 | 80.00 | 61.88 | 13.35 | 33.77 | 40.39 | 55.92 |
结论分析:
- EMO 最终 checkpoint 相对 Fixed_E=32 全面领先(MMLU +4.36、GSM8K +5.84、TriviaQA +6.25),相对 Fixed_E=128 在多数任务上接近(MMLU 56.34 vs 57.40,ARC-C 42.49 vs 43.53,ARC-E 75.18 vs 76.03),并在 OBQA(29.60 vs 28.80)与 RACE-H(40.39 vs 40.31)上略胜。
- GSM8K 是最大的例外:57.09 vs 64.73,差 7.64 个点;TriviaQA 也差 5.34 点(33.77 vs 39.11);BoolQ 差 4.49 点。作者的解释是,推理密集型任务可能更受益于全程暴露大专家池——推理技能需要更长时间在专家之间组织起来。这与 §5.3 的记忆实验互相印证。
- 阶段性跃迁高度非线性:Stage 1→2 几乎没有进步(MMLU 39.29→40.21,TriviaQA 甚至从 14.62 掉到 13.98),Stage 4→5 却是巨大跳跃(MMLU 46.34→56.34,GSM8K 43.29→57.09)。这部分是最后阶段本身预算最大(28.64%),部分是 WSD 的学习率衰减只发生在最后阶段——两个因素在实验设计里是混淆的,论文没有把它们拆开。
Takeaway 2(原文):EMO 表明大专家池 MoE 的性能并不需要从第一步就付出大专家池 MoE 的成本;渐进扩张恢复了最终容量收益的大部分,同时显著降低了早期训练开销。
消融与分析¶
扩张初始化策略¶
针对 $16 \to 32$ 的扩张,作者比较三种策略:
- Gaussian init:新专家与路由器参数随机初始化;
- Gaussian init with router bias = 0:随机初始化新专家与路由器权重,同时把路由器 bias 重置为 0 以清除既有的负载均衡状态;
- Copy from old ckpts:从已有 checkpoint 复制新专家与路由器参数(即 upcycling 式)。
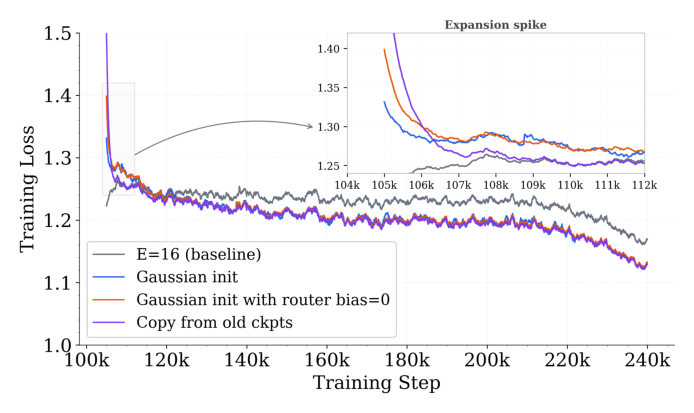
结论分析:三种策略最终 loss 都收敛到 ~1.12–1.13,全部大幅优于未扩张的 $E=16$ 基线(灰线,~1.165)——说明 EMO 的收益不依赖某个脆弱的初始化选择。差异只体现在扩张边界的瞬时 spike 上:
- Copy from old ckpts 起始 spike 最高,但稳定得最快(紫线在放大图里最早回落到最低);
- bias-reset 变体的 spike 比纯 Gaussian init 更大,原因很具体:重置 router bias 丢掉了上一阶段学到的负载均衡行为,token 分配被突然改变;
- 三者在 warmup 之后收敛到相近的 loss。
由于总 token 预算远超 spike 区间,作者在主实验里出于简洁性选了 bias-reset 变体。
优化器状态同样做了对照:扩张时既可以延续上一阶段的状态,也可以重置。作者发现延续带来的改善是边际的——差异在约 500 步 warmup 后消失。于是选择重置,从而避免新专家给 Adam 的动量缓冲增加行时的维度不匹配处理。
Takeaway 3(原文):EMO 对扩张边界的初始化与优化器状态处理都是鲁棒的:专家学得很快,选择主要影响瞬时 spike 的大小。
专家利用率¶
作者在 5K 条验证序列上收集每个 MoE 路由器的 per-expert token 数,比较 Fixed_E=128 与渐进扩展模型($64 \to 128$)。
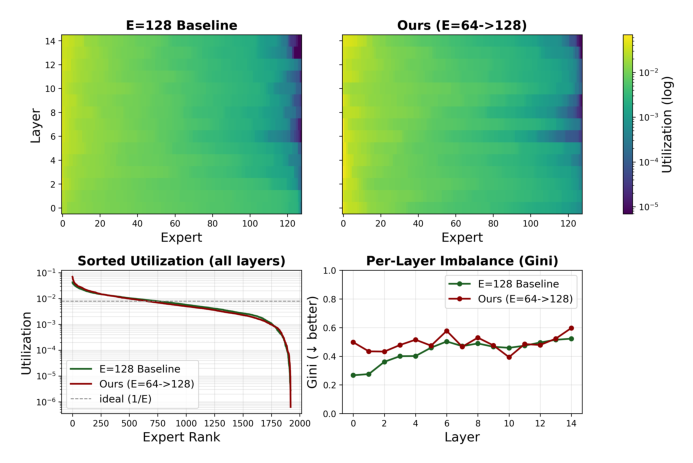
结论分析:两者分布形态高度相似——中间层与最后几层的专家承载相对更大的负载。定量上,Gini 系数基线 0.44,扩展模型 0.50,约 14% 的相对差距,且差距集中在中间层:新初始化的专家在扩张时从父专家继承了略微更不均匀的路由权重。关键在于没有任何一层出现坍塌,且聚合后的利用率曲线(左下)几乎完全重合。也就是说,尽管新专家的训练时间短得多,渐进扩张仍达到了与从零训练相近的路由行为。
MoE 作为可扩展记忆¶
这一节是全文动机的直接检验:如果专家真的是"可寻址的参数化记忆",那么增加专家池应当主要改善知识存储与检索能力。作者在 scaling law 网格里取出多个模型(激活参数 33M / 69M / 107M / 181M / 246M,$E$ 从 2 到 256)评测三类任务。
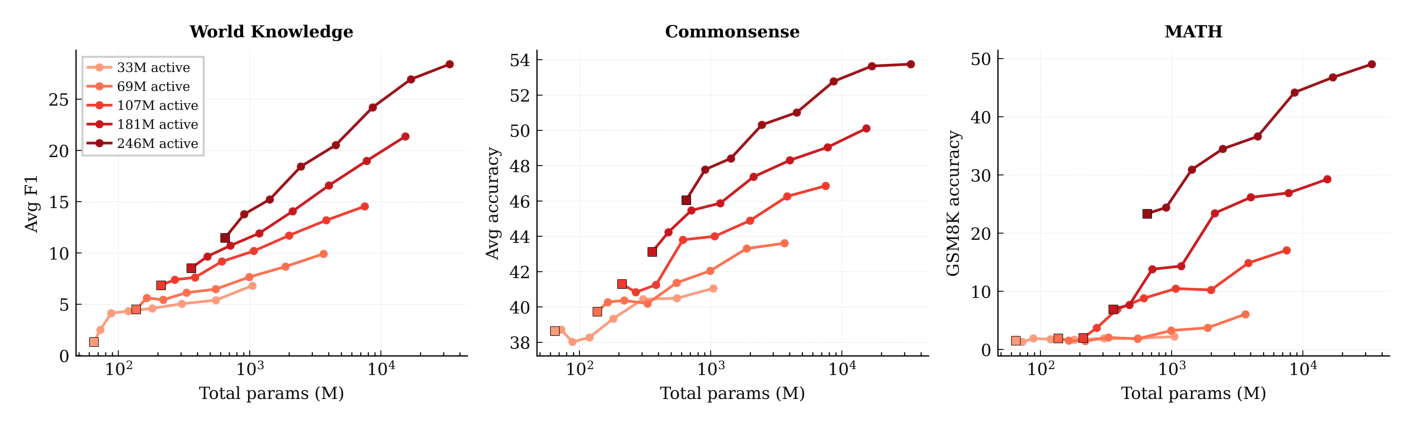
结论分析(横轴为总参数量,即 $E$ 的代理量):
- World Knowledge(TriviaQA / NQ 平均 F1):所有激活规模下,总参数增大都带来近似对数线性的单调提升(246M active 从约 4 涨到约 28.5)。这是对"专家 = 额外参数化记忆"最直接的支持。
- Commonsense(平均准确率):趋势相同但斜率较缓,且在大总参数端开始饱和(246M active 曲线在 $10^4$M 后从 53.7 走平到 53.8)。
- MATH(GSM8K):明显需要门槛——只有当总参数量足够大时才起飞(246M active 在总参 $10^3$M 附近才从 23 跳到 31,然后一路到 49),小激活规模的曲线几乎贴地。
这组结果同时解释了主实验中的那个例外:GSM8K 上 Fixed_E=128 更强,是因为数学/推理能力最依赖"专家池全程可用、有足够时间在专家之间组织结构",而 EMO 让 $E=128$ 只在最后 28.64% 的 token 上存在。这是一个诚实且有机制解释的负面结果。
核心贡献总结¶
- 命名并量化了 MoE efficiency paradox:FLOPs 不随 $E$ 涨但 wall-clock 涨,且随激活规模放大而恶化(A1.1B 上 1.08×,A4B 上 1.72×)。这个量化本身就有价值,因为它说明"MoE 免费扩容"在真实训练栈上是错的。
- 提出"MoE 容量 = 可扩展记忆"的原则与 EMO 框架:多阶段扩张专家池,固定 $k$,不引入任何标准 MoE 层之外的架构或辅助目标。
- 把 scaling law 从"选配置"变成"排时间表":用显式含 $E$ 的稀疏度 scaling law($R^2 = 0.9957$)解出每个 $E$ 的 compute-optimal 累计 token 数,差分归一化成阶段预算——这是把 scaling law 沿训练时间轴微分使用的做法,与传统"一次性解出 $(N, D)$"不同。
- 1.92T token / 9.6B-A1.1B / 32×H200 的完整规模验证:最终 loss 1.017 vs Fixed_E=128 的 0.994(2.3% 相对差),下游多数任务持平,GPU 小时省 10%。
- 三条鲁棒性结论:对初始化策略鲁棒、对优化器状态处理鲁棒、扩张后专家利用率不坍塌(Gini 0.50 vs 0.44)。
与已归档相关工作的对比¶
时序说明:本文投稿于 2026-05-13(v2 2026-05-14),而本库的抓取覆盖始于 2026-04-06,因此归档里绝大多数论文晚于本文。下面两篇都发表在本文之后,本文在结构上不可能引用它们——这不是"应引未引",而是时序使然。已用
content.txt全文检索确认:本文参考文献中不含这两篇的 arXiv ID 或模型名。
Compute-Optimal Is Not Cluster-Optimal: Systems-Aware Scaling for Sparse Mixture-of-Experts Compute-Optimal Is Not Cluster-Optimal: Systems-Aware Scaling for Sparse Mixture-of-Experts(Amazon AGI Foundations,2026-08-11)¶
关系:独立并发 / 同一问题的后继(本文 2026-05-13 早于对方 2026-08-11 近 3 个月,本文未引用亦不可能引用;两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文诊断出的 root cause 完全一致——MoE 的 model-FLOPs 预算与真实集群的 wall-clock 成本脱钩。EMO 用 Figure 1 把它量化成"固定 FLOPs 下 $E$ 从 8 到 128 慢 1.72×"并命名为 efficiency paradox;MOSAIC 用 MFU 把同一裂缝写成式 $C_{\text{deliverable}} = C_{\text{peak}} \cdot \mathrm{MFU} \cdot \eta_{\text{good}}$,指出"两个预测 loss 相同的架构实际吞吐可差几倍"。两者都拒绝了"先用 scaling law 选尺寸、再让系统团队调效率"的两段式流程。
- 相近的技术骨架:两者都把稀疏度显式写进 scaling law 的指数里,再在算力约束下解 compute-optimal 分配。EMO 用 $L(N_{\text{act}}, E, D) = m(\hat{E})N_{\text{act}}^{\mu(\hat{E})} + n(\hat{E})D^{\nu(\hat{E})} + c$,MOSAIC 用四维 $L(N_{\text{tot}}, S, D, G)$;两者的关键洞察也一致——只看 model FLOPs 会得到错误的稀疏度处方:MOSAIC 证明纯 model-FLOPs 预算下拟合 loss 随稀疏度单调下降、最优解永远贴在数据支撑的边界(无内点解),EMO 则从另一侧说明"FLOPs 相同不代表成本相同,所以不该从第一步就付满 $E$"。
- 本文的差异与推进:EMO 把这条 scaling law 沿训练时间轴微分使用,MOSAIC 把它沿硬件约束轴静态求解。MOSAIC 的输出是一组配置 $(Z, D, P_\ell)$——选定一个稀疏度 $S^* \approx 0.915$–$0.963$、粒度 $G^* = 4$ 然后一训到底;EMO 的输出是一张时间表 $\{(E_s, d_s)\}$,稀疏度从 0% 一路走到 93.75%。用 MOSAIC 的语言说,EMO 相当于承认"最优稀疏度是 $D$ 的函数,而 $D$ 在训练中是递增的,所以最优稀疏度也应当递增"——这个动态维度是 MOSAIC 的 MINLP formulation 里没有的。
- 可比的方法 / 实验差异:MOSAIC 拟合了 ~150 次 from-scratch run(104M–2.7B 激活、至多 79B 总参),并额外配一个算子级性能模型(MFU 预测 MAPE < 15%)把系统效率显式建模进优化;EMO 只在 $E \in \{2,\dots,256\}$ 的小网格上拟合($R^2 = 0.9957$),系统侧完全靠端到端实测的 wall-clock(Figure 1)与 10% GPU 小时节省来体现,没有性能模型也没有并行布局搜索。反过来,EMO 的最终验证规模(1.92T token 单次完整预训练)比 MOSAIC 的四次分阶段验证 run 更接近一次真实的生产预训练。两者是明显互补的:MOSAIC 的 ScalePlan 可以直接为 EMO 的每个阶段挑并行布局,而 EMO 的阶段调度可以给 MOSAIC 的静态解加上时间维。
MobileMoE MobileMoE: Scaling On-Device Mixture of Experts(Meta AI,2026-05-26)¶
关系:独立并发(本文 2026-05-13 早于对方 2026-05-26 仅 13 天,两者不可能互相引用;同源 scaling law、不同优化对象)· 已加载对方精读
- 共同关注的问题:两篇都在问"专家数 $E$ 到底该取多少",并且都拒绝把 $E$ 当成一个随手调的超参。EMO 的约束是训练期的 wall-clock 与显存/通信;MobileMoE 的约束是部署期的手机内存 footprint 与推理 FLOPs。共享的 root cause 是同一个:总参数(决定内存/通信)与激活参数(决定 FLOPs)在 MoE 里被解耦,因此单看 FLOPs 会系统性地高估大专家池的性价比。
- 相近的技术骨架:两者用的几乎是同一族 scaling law。MobileMoE 的 $\mathcal{L}(N_{\text{act}}, D, \hat{E}, x) = A_x\hat{E}^{\delta_x}N_{\text{act}}^{\alpha_x + \gamma_x \ln \hat{E}} + B_x\hat{E}^{\omega_x}D^{\beta_x + \zeta_x \ln \hat{E}} + c_x$ 与 EMO 的式 (5)–(6) 逐项对应,连 $\hat{E}$ 的单调变换式都是同一个(都来自 Clark et al., 2022)。两者也都是"拟合含 $\hat{E}$ 的联合律 → 在一个额外约束下解出最优专家配置"这一条流程。
- 本文的差异与推进:MobileMoE 解的是一个静态最优点,EMO 解的是一条轨迹。MobileMoE 从律里读出 $E=8$、粒度 $g=8$、一个 shared expert 的最优配置,然后用四阶段配方(PT→MT→SFT→INT4 QAT)把这个固定架构训到底;EMO 则让 $E$ 本身成为训练进程的函数,把 $D^*(E)$ 差分成阶段预算。两者对同一条律的用法正好正交:MobileMoE 用它选 $E$,EMO 用它选什么时候换 $E$。值得注意的是 MobileMoE 的结论"适中稀疏度最优"与 EMO 的"最终稀疏度 93.75%"并不矛盾——前者受手机内存硬约束,后者在数据中心里只受 wall-clock 软约束。
- 可比的方法 / 实验差异:MobileMoE 用 ~6T token 训 0.3/0.5/0.9B 激活的模型族并做了真机 profiling(Galaxy S25 / iPhone 16 Pro 上 prefill 快 1.8–3.8×);EMO 是 1.1B 激活 / 1.92T token 单条 run + 一次 $16 \to 32$ 的隔离对照。两者都缺少对方的一半:MobileMoE 没有触碰"训练期成本",EMO 没有报告任何推理侧收益——EMO 省下的 10% 是 GPU 小时,最终产出的仍然是一个 $E=128$ 的模型,推理成本与 Fixed_E=128 完全相同。这一点在读 EMO 时容易被"省 10%"的表述带偏。
Step 2.5 剔除的近似候选与理由(终端日志):
- AIR-MoE AIR-MoE(MPI Tübingen,2026-05-06) —— 唯一一篇早于本文的强候选(早 7 天,本文理论上可引而未引)。同样以"专家池很大时的开销"为出发点,但 root cause 不同:AIR-MoE 的瓶颈是路由器的 $O(E)$ 内积打分本身变成主导 FLOPs,本文的瓶颈是 all-to-all / 优化器状态显存 / 小 GEMM。解法路径也完全不同——AIR-MoE 是 IVF 式近似路由索引(架构内),EMO 是训练调度(架构外)。属于"问题相似但解法差异大",剔除。
- Arch-Warmup Arch-Warmup(Pluralis Research,2026-06-15,晚于本文 1 个月) —— 解法骨架高度同构:同样是"训练中渐进解锁架构容量"(它长深度,EMO 长专家池),甚至同样观察到解锁边界的瞬时 loss spike。但问题 root cause 实质偏离:Arch-Warmup 要解决的是 Edge-of-Stability 曲率超标导致的 loss spike / 发散(训练稳定性),EMO 要解决的是 wall-clock 成本(训练效率),并且 EMO 把 spike 当作 10K 步内自愈的良性现象、完全没做曲率分析。问题不同构,剔除。
- LLaDA MoE v2 LLaDA MoE v2(RUC,2026-08-04,晚于本文近 3 个月) —— 同样系统刻画 MoE 的稀疏度/粒度 scaling 行为,但对象是 diffusion LM 的 scaling 特性刻画,且给出的是静态配置处方(稀疏激活、$G=8$–16、shared ratio 33.3%),无渐进扩展维度。解法路径部分重合但问题域偏离,剔除。
- Prescriptive Scaling Laws for Data Constrained Training Prescriptive Scaling Laws for Data Constrained Training(Cornell,2026-05-02,早于本文) —— 同样在 Chinchilla 形式上加项并给出处方式配置,但针对的是多 epoch 数据重复的过拟合惩罚,与专家池 / 稀疏度无关。剔除。
讨论与局限性¶
值得借鉴的设计¶
把 scaling law 沿训练时间轴微分使用是本文最可迁移的方法论。传统用法是"给定预算 $C$,一次性解出 $(N, D)$";本文的用法是"给定一族容量配置 $\{E_s\}$,解出每个配置的 $D_s^*$,然后把差分当作时间表"。这个模式并不限于专家数——任何"容量维度可以在训练中途扩张、且该维度已被写进某条 scaling law 指数里"的场景(层数、序列长度、词表、embedding 维度)都能套用同一套三步法。
方法的简洁性是真实的。式 (12)–(13) 表明扩张只是在专家维度上拼行,路由器输入维度与骨干完全不变;配合"中间阶段不做 LR 衰减、只 warmup 500 步"的 WSD 调度,EMO 可以嵌进任何已有的 MoE 训练栈而不需要动态计算图手术。这和大量需要辅助 loss / 特殊初始化 / 架构改造的"渐进训练"工作形成对比。
实验诚实度较高:作者主动报告了 GSM8K 上落后 7.64 点,并给出了机制解释(§5.3 的记忆实验),而没有把它藏进平均分里。Gini 系数 0.50 vs 0.44 的劣化也如实报告。
局限与争议¶
-
作者自陈的两条:(a) scaling law 拟合没有显式建模优化超参(学习率、batch size、优化器设置);(b) 实验规模仍小于前沿 MoE 系统(1.1B 激活 / 9.6B 总参,对比 Kimi K2、DeepSeek-V4 的量级)。
-
scaling law 的标定条件与使用条件不一致——这是最实质的方法论缺口。附录 B.2 明确写了 scaling 实验固定 top-$k=2$,而主实验用 top-$k=8$ 且额外带 1 个 shared expert;Figure 12 显示 scaling 网格的激活规模是 33M–246M,而主实验是 1.1B——Figure 4b 里那条选定线是 $N_{\text{act}}^* = 0.846$B,已经外推到网格之外。也就是说,这条律是在一个稀疏度模式与激活规模都不同的区域标定的,却被用来给主实验开处方。论文没有做交叉验证来说明这个外推是安全的。
-
10% 的节省与 2.3% 的 loss 差之间的兑换率没有被论证。EMO 省 10% GPU 小时、付出 2.3% 相对 loss 与 GSM8K 上 7.64 点。这个交易是否划算,取决于剩下 10% 算力用来做什么——如果拿去多训 10% 的 token,是否就补回来了?论文没有做这个"等 GPU 小时"的对照(例如让 Fixed_E=128 只训 90% 预算,再与 EMO 比)。在缺少等成本对照的情况下,"matches the performance while improving wall-clock efficiency" 的表述是偏乐观的。
-
收益来源与 WSD 调度混淆。Stage 4→5 的巨大跃迁(MMLU 46.34→56.34)同时叠加了三件事:最后阶段预算最大(28.64%)、$E$ 翻倍到 128、以及学习率衰减恰好在总预算 90% 处开始(即完全落在 Stage 5 内)。论文没有把 LR decay 的贡献从专家扩张的贡献里剥离。一个自然的对照是让 Fixed_E=32 也在同一位置衰减——它确实衰减了(Figure 7 末尾粉线也在掉),但无法据此判断 EMO 的最后一跳里有多少来自 $E$、多少来自 LR。
-
成本模型只覆盖了训练侧。EMO 最终交付的是一个 $E=128$ 的模型,推理期的显存与 all-to-all 成本与 Fixed_E=128 一模一样。所以效率悖论只在训练阶段被缓解了一半——如果部署才是主要成本中心(多数工业场景如此),EMO 提供不了帮助。这也是它与 MobileMoE / RotaryQuant 那类推理侧工作的分工边界。
-
正文存在一处数据不一致:Introduction 写 "1.065 for the fixed-E=64 baseline",但 §4.1 明确 baseline 是 $E \in \{16, 32, 128\}$,且 Figure 7 把 1.065 标注在 Fixed_E=32 上。应以 §4.1 与 Figure 7 为准,Introduction 处为笔误。
-
缺少与 sparse upcycling 的直接对照。§2.3 花了一节论证"单步 upcycling 在专家数大时过于激进",但主实验的三个 baseline 全是 from-scratch 的 Fixed_E,没有一个是"稠密 → 一步 upcycle 到 $E=128$"。这恰恰是 EMO 最该击败的对手(它同样省早期成本),论文却没有跑。§5.1 的 "Copy from old ckpts" 只是在单次 $16 \to 32$ 边界上的初始化消融,不能替代这个对照。
方法论可扩展性¶
正面看,EMO 没有引入任何会在 scaling 时成为瓶颈的固化组件——它不压缩、不离散化、不解耦两阶段,扩张操作本身是 $O(1)$ 的行拼接,理论上可以一直扩下去。负面看,它的处方完全依赖那条 scaling law 的外推可靠性,而论文自陈该律未建模优化超参;一旦扩到前沿规模(batch size、LR schedule、并行布局都会显著变化),阶段边界的位置是否还落在质量–成本曲线的平坦区,是完全开放的问题。作者把"扩到更大激活与总参规模"列为首要 future work,是恰当的。