LLaDA MoE v2: Scaling Mixture-of-Experts Diffusion Language Models 精读¶
arXiv:2608.03457v1 · 2026-08-04 · Preprint
作者:Fengqi Zhu, Shaoxuan Xu, Jingyang Ou, Zebin You, Yipeng Xing, Huabin Liu, Xiaolu Zhang, Jun Zhou, Zhenzhong Lan, Yankai Lin, Wayne Xin Zhao, Jianguo Li, Chongxuan Li, Ji-Rong Wen
机构:中国人民大学高瓴人工智能学院(Gaoling School of AI, RUC)、北京大模型与智能治理重点实验室、下一代智能搜索与推荐工程研究中心(教育部)、蚂蚁集团(Ant Group)。第一作者在蚂蚁集团实习期间完成本工作,通讯作者为李崇轩与文继荣。
一、研究动机与背景¶
1.1 两条语言建模路线的分歧¶
大语言模型的进步主要来自"规模":模型、数据、算力增长时性能以系统且可预测的方式提升(Kaplan et al., 2020;Hoffmann et al., 2022)。这一进程绝大部分沿着自回归(AR)范式展开——把文本序列的分布沿固定的从左到右顺序分解为 next-token 条件概率。
扩散语言模型(diffusion language models, dLLMs)提供了另一种概率形式:通过一个迭代去噪过程定义分布,由一个双向模型重建被破坏序列中的掩码 token,从而允许每一步并行解码多个 token。近期的 dLLM 已经能够匹配强 AR 模型的能力,无论是从头预训练(Nie et al., 2025; 2026b;a)还是从预训练 AR checkpoint 适配而来(Bie et al., 2025;Ye et al., 2025)。
1.2 本文要补的洞:MoE dLLM 的 scaling 行为无人刻画¶
问题在于:要真正兑现 dLLM 的潜力,必须理解它在训练预算增长时的行为。而现状是一个明显的空隙:
- 已有的 dLLM scaling 研究几乎只覆盖稠密(dense)架构(Nie et al., 2025;Ni et al., 2025b 的 Quokka;von Rütte et al., 2026;Sahoo et al., 2026);
- AR 文献早已广泛采用 MoE Transformer(Shazeer et al., 2017;Lepikhin et al., 2020;Fedus et al., 2022;Dai et al., 2024;Tian et al., 2026 的 Ling;Yang et al., 2025 的 Qwen3),在相同 per-token 算力下把模型容量扩到远超稠密模型的水平;
- MoE dLLM 已经开始出现(Zhu et al., 2025 的 LLaDA MoE;Feng et al., 2026 的 dMoE;Zhang et al., 2026),但它们的设计基本上直接继承 AR 的实践。
作者的核心论断是:AR 经验是有用的先验,但不能假定可以直接迁移。理由是 dLLM 与 AR 在三个层面本质不同:
- dLLM 优化的是掩码去噪目标而非 next-token 预测;
- 监督只落在被掩码的位置上(在常用的均匀 timestep 采样下,期望上只有一半 token 被预测);
- 每次预测所依赖的条件是一个被破坏的序列,而不是一个因果前缀——这意味着 MoE 的 router 是在"随噪声水平和掩码模式变化的去噪状态"上做路由,而不是在因果前缀上。
因此 MoE dLLM 的 scaling 行为处于"未被刻画"(undercharacterized)的状态。
1.3 三个待回答的问题与总览¶
本文系统刻画 MoE dLLM 在不同算力尺度下的 scaling 行为与架构设计,提出三个问题:
- 最优的 batch size 与 learning rate 如何随算力变化?
- 固定算力预算应如何在"激活的模型侧计算"与"训练 token 数"之间分配?
- 得到的激活预算应如何分解为路由稀疏度、专家粒度与共享容量?
论文用 Table 1 汇总了全部经验发现与证据来源:
Table 1: MoE dLLM 的经验发现
| 类别 | 发现 | 证据 |
|---|---|---|
| 优化(Optimization) | 最优 batch size 随算力的增长比 AR 模型更陡 | Figs. 1, 2 |
| 优化 | 最优 learning rate 随算力的衰减比 AR 模型更快 | Figs. 1, 2 |
| 算力分配 | 最优算力分配接近均衡,但略微偏向数据侧 | Fig. 3 |
| 算力分配 | MoE dLLM 的前沿比稠密 dLLM 前沿更偏数据侧 | Table 2 |
| MoE 架构 | 更大尺度上,更低的激活比率越发有利 | Fig. 4a |
| MoE 架构 | 适中的专家粒度 $G = 8$–$16$ 跨尺度稳健 | Fig. 4b |
| MoE 架构 | 最优共享专家比率跨尺度稳定在 $S = 33.3\%$ | Fig. 4c |
| Scale-up 验证 | 用少 35% 的预训练 token 在部分任务上逼近 Qwen3 | Table 3 |
| Scale-up 验证 | 在显著更低算力下匹配或超越 7B-A1B | Fig. 5 |
| Scale-up 验证 | SFT 后在 8 项任务中的 7 项超越 SDAR Chat | Table 4 |
据此,作者训练了 LLaDA MoE v2——一个 30B-A3B(总参 30B、激活 3B)的 MoE dLLM,从头在 23.5T token 上训练。它用约 Qwen3 65% 的预训练 token,在若干知识、推理与代码 benchmark 上逼近 Qwen3 30B-A3B;仅经过标准 SFT(不做 RL)后,在 8 项推理与代码 benchmark 中的 7 项上超越 SDAR Chat 30B-A3B。
二、预备知识¶
2.1 掩码扩散语言模型¶
设 $x_0 = (x_0^1, \dots, x_0^L)$ 为长度 $L$ 的干净 token 序列,$\texttt{[MASK]}$ 为掩码 token。前向过程在每个位置独立地破坏序列:在噪声水平 $t \in [0,1]$ 下,token $x_0^i$ 以概率 $t$ 被替换为 $\texttt{[MASK]}$,否则保持不变,产生被破坏状态 $x_t$。
一个双向 Transformer $p_\theta$ 被训练来逆转该过程,即在给定被破坏状态的条件下预测每个掩码位置上的干净 token。噪声水平从均匀分布采样时,训练最小化去噪目标:
$$\mathcal{L}(\theta) = -\mathbb{E}_{x_0,\, t,\, x_t}\left[\frac{1}{t}\sum_{i=1}^{L}\mathbb{1}\left[x_t^i = \texttt{[MASK]}\right]\log p_\theta\left(x_0^i \mid x_t\right)\right] \tag{1}$$
该目标是数据负对数似然的一个上界。式 (1) 中的 $1/t$ 是重要性权重,用于补偿不同噪声水平下被掩码位置数量的差异;指示函数 $\mathbb{1}[\cdot]$ 表明损失只在掩码位置累计——这正是后文"有效监督量少于名义 token 数"论断的来源。推理时,生成从一个全掩码序列出发,通过迭代去噪步骤逐步解掩码。
2.2 MoE Transformer 的三个架构变量¶
MoE Transformer 用 $n_e$ 个路由专家加一个轻量 router 替换前馈网络,从而把模型容量与 per-token 计算解耦:总参数量随 $n_e$ 增长,而每个 token 只被其中一小部分处理。具体地,router 为每个 token 激活 top-$n_a$ 个路由专家并组合其输出。此外,每个 token 都额外被一个共享专家处理,其中间宽度为 $d_{\text{share}} = n_s d_{\text{expert}}$。
论文用三个变量参数化该架构(这是全文架构分析的坐标系):
-
激活比率(activation ratio) $$A = \frac{n_a + n_s}{n_e + n_s} \tag{$A$}$$ 即每 token 激活的专家容量占比,控制路由稀疏度与路由专家池大小;
-
专家粒度(expert granularity) $$G = \frac{2 d_{\text{model}}}{d_{\text{expert}}} \tag{$G$}$$ 控制路由容量如何被切分为专家($G$ 越大专家越细);
-
共享专家比率(shared-expert ratio) $$S = \frac{n_s}{n_a + n_s} \tag{$S$}$$ 控制激活的专家容量中分配给共享通路的比例。
注意 $n_s$ 的定义是以"一个路由专家的宽度"为单位度量的共享容量,而非共享专家的物理个数($d_{\text{share}} = n_s d_{\text{expert}}$)。
2.3 算力度量:为什么用 $C = MD$ 而不是 $6ND$¶
稠密模型研究常用 $C \approx 6ND$($N$ 为非嵌入参数量,$D$ 为训练 token 数),其前提是所有参数都参与处理每个 token。这一前提对 MoE 不成立。因此本文沿用已有 MoE scaling 研究的做法(Bi et al., 2024;Ludziejewski et al., 2025;Tian et al., 2026),采用
$$C = M D \tag{9}$$
其中 $M$ 为激活的非嵌入训练 FLOPs / token。完整的算力表达式见 §六(附录 A.1 摘录)。
三、核心方法:MoE dLLM 的三段式 scaling 框架¶
论文分三阶段构建 scaling 框架:先标定与算力相关的 batch size 与 learning rate;再估计"激活模型侧计算 vs 训练数据"的最优分配;最后把得到的模型侧预算分解为激活比率、专家粒度与共享专家比率。这是一条严格的串行依赖链——后一阶段的实验都在前一阶段拟合出的最优配置下进行。
3.1 超参数 scaling law($B^*$ 与 $\eta^*$)¶
动机的精确化。 AR 模型的超参数 scaling 已被充分研究(Bi et al., 2024;Li et al., 2025a),但 dLLM 是否服从同样的算力依赖律未知。关键差异在于:由于每次更新只监督被采样到的掩码位置,名义 token batch size 并不直接对应预测目标的数量——在常用的均匀 timestep 采样下,期望上只有一半 token 被预测。这种"有效监督的削减"会改变梯度噪声水平、优化稳定性与学习率敏感性。
实验设置。 在 158M / 1B / 3.6B 三个模型尺度上,算力预算跨 $10^{18}$ 到 $3\times10^{20}$ FLOPs,联合搜索名义 token batch size $B$ 与峰值学习率 $\eta$。
拟合结果。
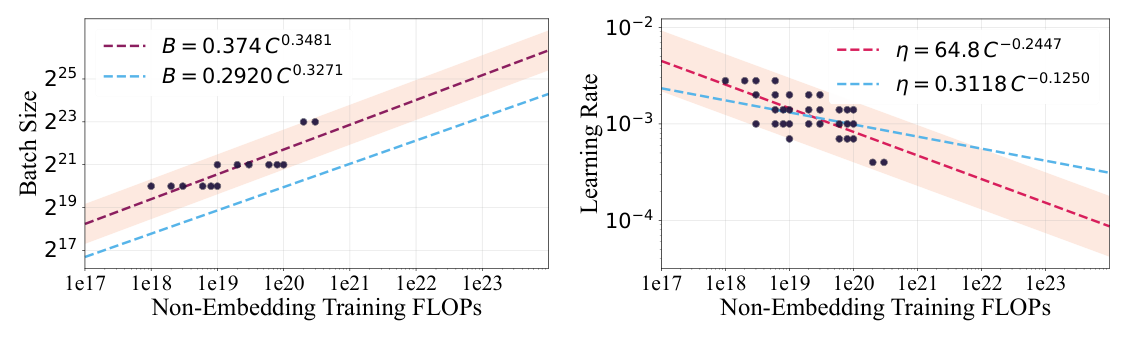
$$B^* = 0.374 \cdot C^{0.3481}, \qquad \eta^* = 64.8 \cdot C^{-0.2447} \tag{2}$$
作为对照,DeepSeek LLM 的 AR 律为 $B = 0.2920\,C^{0.3271}$ 与 $\eta = 0.3118\,C^{-0.1250}$(Figure 1 中的蓝色虚线)。
外推验证。 为检验拟合的 dLLM 专属律能否外推到拟合区间之外,作者把联合搜索从 $3\times10^{20}$ 继续推到 $6\times10^{20}$ FLOPs:
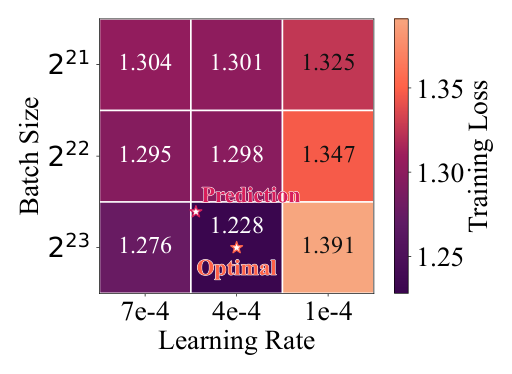
Figure 2 的 loss 网格($6\times10^{20}$ FLOPs,训练 loss):
| $B \backslash \eta$ | $7\times10^{-4}$ | $4\times10^{-4}$ | $1\times10^{-4}$ |
|---|---|---|---|
| $2^{21}$ | 1.304 | 1.301 | 1.325 |
| $2^{22}$ | 1.295 | 1.298 | 1.347 |
| $2^{23}$ | 1.276 | 1.228 | 1.391 |
拟合律给出的推荐点落在二维超参平面上最优观测配置的附近,且周边 loss 未显示出明显更好的替代方案。这支持把拟合律作为该尺度下算力依赖超参的实用估计。
结论:高算力偏好更大 batch 与更快的学习率衰减。 dLLM 与 AR 的方向一致——最优 batch size 随算力次线性增长、最优学习率随算力下降。但标定值有系统性差异:本文的 dLLM 拟合具有略陡的 batch size 指数(0.3481 vs 0.3271)与明显更快的学习率衰减($-0.2447$ vs $-0.1250$)。举例来说,在 $C = 10^{20}$ FLOPs 处:
| 量 | DeepSeek LLM(AR) | 本文(dLLM) |
|---|---|---|
| 最优学习率 | $9.86\times10^{-4}$ | $8.27\times10^{-4}$ |
| 最优名义 batch size | 1.02M token | 3.43M token |
学习率接近,但最优 batch size 相差 3.4 倍。作者把这个 batch size 差距归因于前文所述"每个名义 token 上的有效监督被削减"——为了达到相同的有效监督/梯度信噪比,dLLM 需要更大的名义 batch。因此结论是:AR scaling 可以作为有用的先验,但当拟合出的趋势发生分歧时,不能替代 dLLM 专属的标定。后续全部实验都采用本文拟合的 dLLM 超参律。
3.2 算力分配 scaling law(IsoFLOP)¶
dLLM 特有的分配逻辑。 对 MoE dLLM 而言,模型–数据权衡与 AR 版本不同:每个名义 token 只有在被掩码时才贡献一个预测目标;而 router 作用在随噪声水平与掩码模式变化的被破坏状态上,而非因果前缀。相对 AR 训练,固定的名义 token 预算因此提供更少的监督目标、却对应更多变的条件与路由状态集合。额外的 token 可以同时改善"去噪目标的覆盖"与"router 输入的覆盖",赋予数据侧投入一种 dLLM 特有的边际价值。
实验设置。 模型侧用激活非嵌入 FLOPs/token $M$ 度量,数据侧为训练 token 数 $D$,$C = MD$。在 $10^{17}$ 到 $10^{20}$ 训练 FLOPs 的固定预算下扫描分配。每个预算下取扫描内 loss 最低的分配点,拟合前沿 $M^*(C)$ 与 $D^*(C)$。
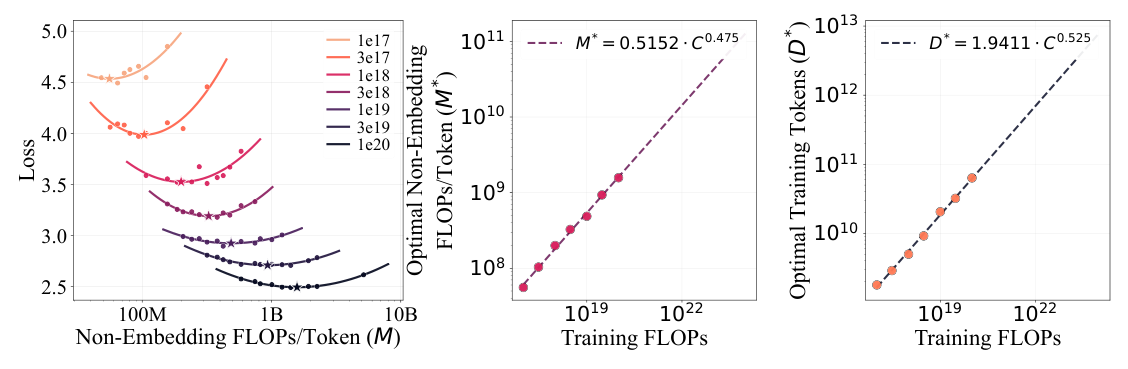
Figure 3 左图给出 U 形的 IsoFLOP 曲线:小模型即使看到更多 token 也受容量限制,大模型则因同样预算下能训的 token 更少而变得数据受限。星号标记的即各预算下的经验最优分配 $(M^*(C), D^*(C))$。两条前沿在 log–log 空间中近似线性,拟合得:
$$M^*(C) = 0.5152 \cdot C^{0.475}, \qquad D^*(C) = 1.9411 \cdot C^{0.525} \tag{3}$$
与代表性分配律的横向对比(Table 2):
| Scaling law | 建模范式 | 架构 | 模型前沿 | 数据前沿 |
|---|---|---|---|---|
| Kaplan (Kaplan et al., 2020) | AR | Dense | $M^*\propto C^{0.73}$ | $D^*\propto C^{0.27}$ |
| Chinchilla (Hoffmann et al., 2022) | AR | Dense | $M^*\propto C^{0.49}$ | $D^*\propto C^{0.51}$ |
| DeepSeek LLM (Bi et al., 2024) | AR | Dense | $M^*\propto C^{0.5243}$ | $D^*\propto C^{0.4757}$ |
| Llama 3 (Grattafiori et al., 2024) | AR | Dense | $M^*\propto C^{0.463}$ | $D^*\propto C^{0.537}$ |
| SMDM (Nie et al., 2025) | AR | Dense | $M^*\propto C^{0.644}$ | $D^*\propto C^{0.356}$ |
| Ling (Tian et al., 2026) | AR | Dense | $M^*\propto C^{0.5422}$ | $D^*\propto C^{0.4578}$ |
| Ling (Tian et al., 2026) | AR | MoE | $M^*\propto C^{0.5095}$ | $D^*\propto C^{0.4905}$ |
| SMDM (Nie et al., 2025) | Diffusion | Dense | $M^*\propto C^{0.634}$ | $D^*\propto C^{0.366}$ |
| Quokka (Ni et al., 2025b) | Diffusion | Dense | $M^*\propto C^{0.514}$ | $D^*\propto C^{0.486}$ |
| DLMs (von Rütte et al., 2026) | Diffusion | Dense | $M^*\propto C^{0.566}$ | $D^*\propto C^{0.434}$ |
| Ours | Diffusion | MoE | $M^*\propto C^{0.475}$ | $D^*\propto C^{0.525}$ |
结论:接近均衡、略偏数据侧。 两条前沿的指数都接近 0.5,数据侧指数 0.525 略大于模型侧的 0.475,即最优 token 预算的增长快于激活模型侧计算。
作者用两组"受控对照"把架构效应与建模目标效应分离开来,这是 Table 2 最有价值的读法:
- Ling 在 AR 下对比 dense 与 MoE:模型/数据指数从 0.5422/0.4578 → 0.5095/0.4905,说明稀疏激活把 AR 前沿推向数据侧;
- SMDM 在 dense 架构下对比 AR 与 dLLM:指数从 0.644/0.356 → 0.634/0.366,展示同样的偏数据方向。
本文的设定同时叠加了"稀疏激活"与"dLLM 目标",其数据侧指数 0.525 大于所有现存的稠密 dLLM 前沿——与上述两个方向的叠加一致。由此得到一条简洁的分配规则:MoE dLLM 的边际算力,相对更应该花在增加训练 token 上,而不是提高每 token 的激活非嵌入 FLOPs。
不过,沿着这条前沿只固定了总的激活模型侧预算 $M^*(C)$,而专家数、专家宽度与激活模式仍未确定——这正是 §3.3 要解决的。
3.3 MoE 架构 scaling law($A$ / $G$ / $S$)¶
dLLM 专属的设计问题。 把固定预算翻译为 MoE 架构,对 dLLM 而言是一个特殊问题,因为 router 作用在随噪声水平与掩码模式变化的掩码去噪状态上。
实验设计(严格的单变量受控扫描)。 对每个参考算力尺度 $C$,把激活模型侧预算固定为 $M^*(C)$,一次只扫描一个架构维度,其余两个尽可能保持不变(受离散配置限制)。五个参考预算为 $C \in \{6\times10^{17},\, 2\times10^{18},\, 6\times10^{18},\, 2\times10^{19},\, 6\times10^{19}\}$ FLOPs。
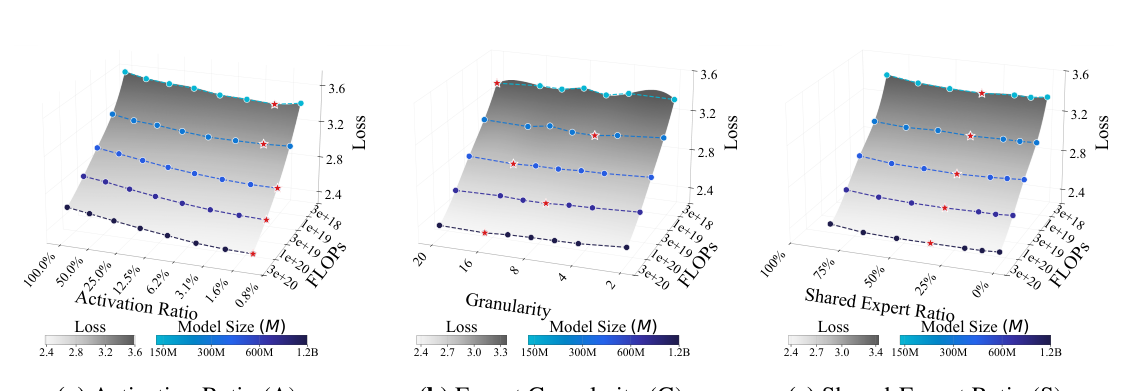
(a) 激活比率:更大尺度偏好更稀疏的激活。 在固定 $M^*(C)$ 下,降低 $A$ 通常降低训练 loss,且这个收益随算力增大而更显著。但在最小的预算下存在一个例外:次稀疏的设置略优于最稀疏的设置。作者的解释是——极端稀疏的路由暴露出一个更大的路由专家池,需要足够的训练算力才能被有效优化。这一趋势表明 MoE dLLM 在更大尺度上能越来越好地利用这份专家容量。扫描的候选覆盖 $n_e \in \{2,4,8,16,32,64,128,256\}$,对应 $A \in \{100\%, 60\%, 33.3\%, 17.6\%, 9.1\%, 4.6\%, 2.3\%, 1.2\%\}$。
(b) 专家粒度:$G = 8$–$16$ 稳健。 $G$ 在各算力尺度上没有单调趋势,说明它不是一个主要的 scaling 方向。它主要体现一种权衡:更粗的专家提供更强的单体变换但更少的路由选择;更细粒度的专家增加路由选择但专家更窄。对 MoE dLLM 而言,这个权衡尤其相关,因为掩码去噪同时需要"对被破坏上下文的多样化专业分工"和"足够的专家表达力"。经验上 $G = 8$ 到 $G = 16$ 是本文扫描中的稳健区间,但确切最优点不随算力系统性变化。扫描候选为 $G \in \{2,4,6,8,12,16,20\}$(对应 $n_e \in \{64,128,192,256,384,512,640\}$、$n_a \in \{2,4,6,8,12,16,20\}$、$n_s \in \{1,2,3,4,6,8,10\}$)。
(c) 共享专家比率:$S = 33.3\%$ 跨尺度保持最优。 所有算力尺度下 loss 曲线都是 U 形,且最小值都落在 $S = 33.3\%$。这与 AR MoE 设计形成鲜明对照:
| 体系 | 共享专家比率 $S$ |
|---|---|
| DeepSeekMoE (Dai et al., 2024) | 25% |
| Qwen3 (Yang et al., 2025) | 0%(无共享专家) |
| Ling (Tian et al., 2026) | 从 16.7% 递减到 8.3%,据此提出固定"一个共享专家"规则 |
| 本文(MoE dLLM) | 33.3%,跨尺度稳定 |
也就是说,本文的 dLLM 扫描偏好一条容量随激活模型预算成比例增长的共享通路,而不是一个"相对贡献随尺度递减的固定共享组件"。由此导出一条区别于 AR 启发式的 dLLM 专属规则:
每两个单位的路由激活容量,配约一个单位的共享激活容量。
扫描候选为 $(n_a, n_s)$ 组合 $\{(12,0), (11,1), (10,2), (8,4), (6,6), (4,8), (2,10)\}$,对应 $S \in \{0, 8.3\%, 16.7\%, 33.3\%, 50\%, 66.7\%, 83.3\%\}$;此时 $n_e = 256$ 固定。由于 $n_s$ 出现在 $A$ 的分母中,这种重分配会导致激活比率有轻微漂移,作者认为可忽略且不影响受控对比。
四、关键技术细节(附录摘录)¶
4.1 算力核算(Appendix A.1)¶
设 $n_{\text{layer}}$ 为层数、$d_{\text{model}}$ 为隐层维度、$s$ 为序列长度、$r_{kv} = n_{kv\text{heads}} / n_{\text{heads}}$。使用 SwiGLU 时,每个路由专家的三个投影矩阵含 $3 d_{\text{model}} d_{\text{expert}}$ 参数,共享专家含 $3 d_{\text{model}} d_{\text{share}} = 3 n_s d_{\text{model}} d_{\text{expert}}$ 参数。忽略 bias 与归一化参数,总的与激活的非嵌入参数量为:
$$P_{\text{nonemb}} = n_{\text{layer}}\left[2 d_{\text{model}}^2 (1 + r_{kv}) + d_{\text{model}} n_e + 3 d_{\text{model}}\left(n_e d_{\text{expert}} + d_{\text{share}}\right)\right] \tag{4}$$
$$P_{\text{act,nonemb}} = n_{\text{layer}}\left[2 d_{\text{model}}^2 (1 + r_{kv}) + d_{\text{model}} n_e + 3 d_{\text{model}}\left(n_a d_{\text{expert}} + d_{\text{share}}\right)\right] \tag{5}$$
第一项对应 Q/K/V/O 投影;第二项对应 router(它要为每个 token 给全部 $n_e$ 个路由专家打分,因此在激活量中也是全量);最后一项对应路由专家与共享专家。输入嵌入矩阵与独立的 LM head 各含 $V d_{\text{model}}$ 参数,合计 $2 V d_{\text{model}}$ 计入总/激活参数报告,但不计入上述非嵌入量。
把一次乘加计为 2 FLOPs,单层的前向 FLOPs/token 近似为:
$$F_{\text{attn}} = 4 d_{\text{model}}^2 (1 + r_{kv}) + 4 s\, d_{\text{model}} \tag{6}$$
$$F_{\text{MoE}} = 2 d_{\text{model}} n_e + 6 d_{\text{model}}\left(n_a d_{\text{expert}} + d_{\text{share}}\right) \tag{7}$$
其中 $F_{\text{attn}}$ 的两项分别对应注意力投影与两次序列级注意力矩阵乘。把反向近似为前向的两倍,定义激活非嵌入 FLOPs/token:
$$M = 3 n_{\text{layer}}\left[4 d_{\text{model}}^2 (1 + r_{kv}) + 4 s\, d_{\text{model}} + 2 d_{\text{model}} n_e + 6 d_{\text{model}}\left(n_a d_{\text{expert}} + d_{\text{share}}\right)\right] \tag{8}$$
该核算省略了输入嵌入、LM head、归一化、非线性与注意力 softmax。最后,$D$ 表示训练中处理的名义 token 总数(包括掩码与可见位置),算力预算 $C = MD$(式 9)。一个关键说明:掩码与可见 token 产生相同的 Transformer 计算,所以采样到的破坏水平只改变被监督的预测目标数量,不改变被核算的 FLOPs——这正是"名义 batch size ≠ 有效监督量"能够成立、又不干扰算力核算的前提。
4.2 MoE 实现细节(Appendix A.2)¶
每层都把分组查询注意力(GQA)与一个 MoE 前馈块配对,后者由路由专家 + 单个共享专家组成,全部实现为 SwiGLU 网络(唯一例外是架构实验中某些省略共享专家的配置)。
路由在每层对每个 token 独立进行。给定 token 表示 $h$,线性 router 产生 logits $r(h) \in \mathbb{R}^{n_e}$ 与路由分数 $p(h) = \mathrm{softmax}(r(h))$。设 $\mathcal{T}(h)$ 为 $n_a$ 个最大路由分数的下标集合,对被选中的分数重归一化:
$$w_i(h) = \frac{p_i(h)}{\sum_{j\in\mathcal{T}(h)} p_j(h)}, \qquad i \in \mathcal{T}(h) \tag{10}$$
路由专家输出为:
$$E_{\text{route}}(h) = \sum_{i\in\mathcal{T}(h)} w_i(h)\, E_i(h) \tag{11}$$
路由与共享两条通路以 $E_{\text{share}}(h) + \lambda E_{\text{route}}(h)$ 组合,其中 $\lambda$ 平衡两条通路的输出尺度(共享专家比率实验中的"纯路由"配置省略共享项且不使用缩放因子)。
对 $n_s > 0$ 的配置,$\lambda$ 通过在初始化时匹配共享与路由通路的期望输出范数来估计(沿用 Liu et al., 2025 的 gate scaling 启发式)。把宽度 $n_s d_{\text{expert}}$ 的共享专家视为 $n_s$ 个专家宽度单元,并假设初始化时所有专家输出范数相等且两两正交,则共享通路的范数正比于 $\sqrt{n_s}$,而未缩放的路由通路范数正比于 $(\sum_{i\in\mathcal{T}(h)} w_i(h)^2)^{1/2}$。用 $r(h)\sim\mathcal{N}(0, I_{n_e})$ 近似 router logits 的初始化分布,得:
$$\lambda = \mathbb{E}_{r(h)\sim\mathcal{N}(0, I_{n_e})}\left[\frac{\sqrt{n_s}}{\left(\sum_{i\in\mathcal{T}(h)} w_i(h)^2\right)^{1/2}}\right] \tag{12}$$
期望通过 Monte Carlo 采样近似,对每个带共享专家的架构配置独立估计。
router 与模型联合训练,总目标为:
$$\mathcal{L} = \mathcal{L}_{\text{diff}} + \alpha_{\text{aux}} \mathcal{L}_{\text{bal}} + \alpha_z \mathcal{L}_z \tag{13}$$
其中 $\mathcal{L}_{\text{diff}}$ 为式 (1) 的去噪目标,$\mathcal{L}_{\text{bal}}$ 为负载均衡辅助损失,$\mathcal{L}_z$ 为 router z-loss;系数固定为 $\alpha_{\text{aux}} = 0.01$、$\alpha_z = 0.001$,在所有 scaling 与架构扫描中保持不变。
4.3 三组扫描的实验协议¶
超参数扫描(A.3)。 三个模型尺度 158M / 1B / 3.6B,算力 $10^{18}$–$3\times10^{20}$ FLOPs,序列长度 4096,AdamW $(\beta_1,\beta_2) = (0.9, 0.95)$、weight decay 0.1。学习率线性 warmup 2000 步到峰值 $\eta$,保持到最后 10% 训练算力后用 cosine 衰减到 $0.1\eta$。
Table 5:超参数扫描的模型架构与搜索网格
| Model scale | $n_{\text{layer}}$ | $d_{\text{model}}$ | $n_{\text{heads}}$ | $n_{kv\text{heads}}$ | $n_e$ | $n_a$ | $n_s$ | $d_{\text{expert}}$ |
|---|---|---|---|---|---|---|---|---|
| 158M | 6 | 256 | 8 | 2 | 64 | 4 | 1 | 256 |
| 1B | 10 | 640 | 10 | 2 | 64 | 4 | 1 | 640 |
| 3.6B | 16 | 1024 | 16 | 4 | 64 | 4 | 1 | 1024 |
| Model scale | $C$ (FLOPs) | $B$ 网格 | $\eta$ 网格 |
|---|---|---|---|
| 158M | $\{1,2,3,6,8\}\times10^{18}$ | $\{2^{17}, 2^{18}, 2^{19}, 2^{20}\}$ | $\{1, 1.4, 2, 2.8\}\times10^{-3}$ |
| 1B | $\{1,2,3,6,8,10\}\times10^{19}$ | $\{2^{18}, 2^{19}, 2^{20}, 2^{21}\}$ | $\{0.7, 1, 1.4, 2\}\times10^{-3}$ |
| 3.6B | $\{0.8,1,2,3\}\times10^{20}$ | $\{2^{21}, 2^{22}, 2^{23}\}$ | $\{1, 4, 7\}\times10^{-4}$ |
每个 run 的 loss 定义为其分配算力最后 0.5% 上的平均训练 loss。每个算力预算下取最小平均 loss,把 loss 不超过该最小值 0.25% 的配置视为近最优(near-optimal,沿用 Bi et al., 2024),并把所有近最优配置纳入 log–log 线性回归——这一点很关键:不是只用单个最优点拟合,从而降低单点噪声的影响。
算力分配扫描(A.4)。 IsoFLOP 预算 $10^{17}$–$10^{20}$ FLOPs,与超参实验共用同一预训练数据、去噪目标与优化器;$B$ 与 $\eta$ 按拟合的超参律设定。候选模型架构覆盖 60M 到 7.5B 共 25 种配置(全部固定 $n_e = 64$、$n_a = 4$、$n_s = 1$,即 $A = 7.7\%$、$S = 20\%$,只变 $n_{\text{layer}}$/$d_{\text{model}}$/$d_{\text{expert}}$)。由于不同分配下的优化器步数不同,warmup 长度按 run 自适应:设 $T$ 为该分配隐含的总优化步数,线性 warmup 步数为 $T_{\text{warm}} = \max(0.01T, 100)$(100 步的下限保证最小 warmup 以维持优化稳定性),峰值保持到最后 10% 步数后 cosine 衰减到峰值的 10%。每个模型分到的 token 预算为 $D = C/M$。模型侧最优点用 log–log 线性回归拟合,数据侧前沿由 $D^*(C) = C/M^*(C)$ 导出。
MoE 架构扫描(A.5)。 五个参考预算 $C \in \{6\times10^{17}, 2\times10^{18}, 6\times10^{18}, 2\times10^{19}, 6\times10^{19}\}$。为使架构选择能代表大规模预训练常见的过训练(overtraining)区间,每个候选训练 $3D^*(C)$ 名义 token(约 $3C$ 训练 FLOPs),并把超参律在实际训练预算 $3C$ 处求值得到 $B$ 与 $\eta$:
Table 10:MoE 架构扫描的公共训练配置
| $C$ | $M^*(C)$ | $3D^*(C)$ | $B$ | $\eta$ |
|---|---|---|---|---|
| $6\times10^{17}$ | $1.43\times10^{8}$ | $1.26\times10^{10}$ | 1,048,576 | $2.2\times10^{-3}$ |
| $2\times10^{18}$ | $2.54\times10^{8}$ | $2.36\times10^{10}$ | 1,310,720 | $1.7\times10^{-3}$ |
| $6\times10^{18}$ | $4.28\times10^{8}$ | $4.20\times10^{10}$ | 2,097,152 | $1.3\times10^{-3}$ |
| $2\times10^{19}$ | $7.59\times10^{8}$ | $7.91\times10^{10}$ | 3,145,728 | $9.4\times10^{-4}$ |
| $6\times10^{19}$ | $1.28\times10^{9}$ | $1.41\times10^{11}$ | 4,194,304 | $7.0\times10^{-4}$ |
三个扫描的骨干配置($n_{\text{layer}}/d_{\text{model}}/n_{\text{heads}}/n_{kv\text{heads}}$)在各预算下分别为 8/256/8/2、8/448/8/2、10/512/16/4、12/640/16/4、15/768/16/4。
"保持 $M^*(C)$ 不变"的构造方式(忽略 router 的微小贡献):
- 激活比率扫描:固定骨干、$n_a$、$n_s$、$d_{\text{expert}}$,只变路由专家数 $n_e$——每 token 的激活专家计算不变,而总参数量随 $A$ 下降而增长;
- 专家粒度扫描:变 $d_{\text{expert}}$,同时反比例缩放 $n_e$、$n_a$、$n_s$,从而保持 $A$、$S$ 以及路由与共享的激活宽度 $n_a d_{\text{expert}}$、$n_s d_{\text{expert}}$;
- 共享专家比率扫描:固定 $n_e$ 与 $d_{\text{expert}}$,通过改变 $n_s$ 与 $n_a$ 在共享与路由通路间重分配固定的激活专家宽度 $(n_a + n_s) d_{\text{expert}}$。
五、大规模训练:LLaDA MoE v2 30B-A3B¶
5.1 模型架构¶
Table 6:LLaDA MoE v2 30B-A3B 架构
| 总参数 | 激活参数 | $n_{\text{layer}}$ | $d_{\text{model}}$ | $n_{\text{heads}}$ | $n_{kv\text{heads}}$ | $n_e$ | $n_a$ | $n_s$ |
|---|---|---|---|---|---|---|---|---|
| 30.6B | 3.4B | 32 | 3072 | 32 | 4 | 128 | 8 | 4 |
骨干为 32 层、隐层 3072,使用 GQA(32 个 query head、4 个 KV head),词表 157,184。所有 Transformer 层都使用 MoE 前馈块。
按架构 scaling 的建议取 $(A, G, S) = (9.09\%,\, 8,\, 33.3\%)$:128 个细粒度路由专家、top-8 路由、共享容量 $n_s = 4$(即宽度 $4 d_{\text{expert}}$ 的单个共享专家)。$G = 8$ 给出 $d_{\text{expert}} = d_{\text{model}}/4$,于是 $d_{\text{share}} = 4 d_{\text{expert}} = d_{\text{model}}$。该离散配置产生:
$$A = \frac{8 + 4}{128 + 4} = 9.09\%, \qquad S = \frac{4}{8 + 4} = 33.3\%$$
5.2 预训练(五阶段)¶
从头预训练共 23.5T 名义 token,语料由大规模高质量网页文本构建,经历收集原始文本、去除样板与低质文档、去重、有害内容过滤的标准流程。
Table 7:五阶段预训练调度
| Stage | 训练阶段 | Tokens | 上下文长度 | RoPE base | 峰值 LR |
|---|---|---|---|---|---|
| 1 | Base pretraining 1 | 10T | 4K | 10,000 | $1.5\times10^{-4}$ |
| 2 | Base pretraining 2 | 10T | 4K | 10,000 | $1.0\times10^{-4}$ |
| 3 | Pretraining annealing | 2T | 4K | 10,000 | $5.0\times10^{-5}$ |
| 4 | Context extension | 500B | 32K | 500,000 | $1.0\times10^{-5}$ |
| 5 | Long-context annealing | 1T | 32K | 500,000 | $7.0\times10^{-6}$ |
细节:Stage 1 与 2 从同一来源语料抽取两份独立的 10T token 样本,其中 Stage 2 的混合配比略微加重数学推理与代码数据;Stage 3 用清洗、去重、有害过滤后构建的 1T token 退火语料训两个 epoch得到 2T 训练 token;Stage 4/5 主要使用长度可达 32K 的长文本数据。
训练用 BF16 精度,AdamW $(\beta_1, \beta_2) = (0.9, 0.95)$、weight decay 0.1。全局名义 token batch size 为 33,554,432($2^{25}$)token。每个阶段使用独立的学习率调度,前 2,000 优化步从 0 线性 warmup 到该阶段峰值;Stage 1–4 在其分配算力的最后 10% 用 cosine 把学习率衰减到下一阶段的峰值,Stage 5 则衰减到 $5.0\times10^{-6}$。Stage 3→4 转换处把 RoPE base 从 10,000 提到 500,000 以把上下文从 4K 扩到 32K。
整个预训练消耗约 460,000 NVIDIA B200 GPU 小时。
5.3 Base 模型 benchmark 结果¶
作者与五个代表性 dLLM / AR baseline 对比。尺度匹配最接近的是 SDAR Sci(由 Qwen3 continued pretraining 得到)与 Qwen3 30B-A3B(强 AR MoE)。LLaDA MoE v2 从头训练 23.5T token,是 SDAR Sci 的 37.05T 的 63%、Qwen3 的 36T 的 65%。
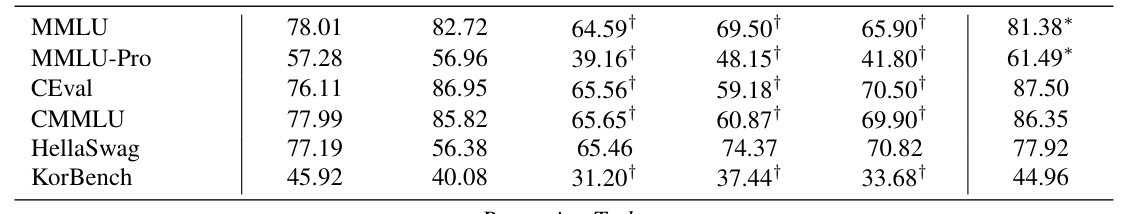
Table 3:Base 模型 benchmark 结果
| LLaDA MoE v2 | SDAR Sci | LLaDA MoE | Dream 7B | LLaDA 8B | Qwen3 | |
|---|---|---|---|---|---|---|
| Architecture | MoE | MoE | MoE | Dense | Dense | MoE |
| Modeling | Diffusion | Diffusion | Diffusion | Diffusion | Diffusion | AR |
| Method | Pretrain | CPT | Pretrain | CPT | Pretrain | Pretrain |
| # Total Params | 30B | 30B | 7B | 7B | 8B | 30B |
| # Activated Params | 3B | 3B | 1B | 7B | 8B | 3B |
| # Trained Tokens | 23.5T | 36 + 1.05T | 21T | 18 + 0.58T | 2.3T | 36T |
| General | ||||||
| MMLU | 78.01 | 82.72 | 64.59† | 69.50† | 65.90† | 81.38∗ |
| MMLU-Pro | 57.28 | 56.96 | 39.16† | 48.15† | 41.80† | 61.49∗ |
| CEval | 76.11 | 86.95 | 65.56† | 59.18† | 70.50† | 87.50 |
| CMMLU | 77.99 | 85.82 | 65.65† | 60.87† | 69.90† | 86.35 |
| HellaSwag | 77.19 | 56.38 | 65.46 | 74.37 | 70.82 | 77.92 |
| KorBench | 45.92 | 40.08 | 31.20† | 37.44† | 33.68† | 44.96 |
| Reasoning | ||||||
| GSM8K | 83.93 | 86.13 | 66.41† | 77.79† | 70.70† | 91.81∗ |
| MATH | 54.72 | 48.52 | 36.10† | 39.60† | 27.30† | 59.04∗ |
| OlympiadBench | 28.74 | 24.44 | 10.07† | 10.22† | 6.85† | 30.96 |
| Coding | ||||||
| CRUXEval | 50.62 | 53.00 | 38.94 | 40.31 | 36.38 | 56.88 |
| MBPP | 71.00 | 60.40 | 52.40† | 56.20† | 38.20† | 74.40∗ |
| MultiPL-E | 53.78 | 33.66 | 41.13† | 27.60† | 23.61† | 66.53∗ |
| HumanEval | 50.00 | 33.54 | 45.73† | 57.90† | 33.50† | 52.44 |
| LiveCodeBench v6 | 31.86 | 39.87 | 16.18† | 14.87† | 2.53† | 49.18 |
| BigCodeBench | 41.84 | 33.86 | 21.23† | 18.33† | 13.42† | 45.70 |
(加粗为所评估 dLLM 中的最优值。)
结果分析。 在全部 15 个 benchmark 上,LLaDA MoE v2 取得所评估 dLLM 中最高的平均分 58.60,比 SDAR Sci 高 3.78 分,比更小的 dLLM baseline 至少高 12.44 分。
值得注意的是优势的分布结构:相对 SDAR Sci 的优势在代码任务上尤为突出——HumanEval +16.46、BigCodeBench +7.98——而这是在"从头预训练"对"从 AR checkpoint 初始化"的不利起点下取得的。这一点有解释力:从 AR checkpoint 继续预训练(CPT)能廉价继承 AR 的知识型能力(因此 SDAR Sci 在 MMLU/CEval/CMMLU 上明显更高),但在需要并行、双向重写的代码生成上,从头以去噪目标训练反而更占优。
对比 Qwen3,LLaDA MoE v2 在中文知识 benchmark(CEval $-11.39$、CMMLU $-8.36$)与部分代码任务(MultiPL-E $-12.75$、LiveCodeBench v6 $-17.32$)上差距较大,但在若干推理与代码 benchmark 上非常接近:OlympiadBench $-2.22$、HumanEval $-2.44$、MMLU-Pro $-4.21$、KorBench $+0.96$(反超)。考虑到只用了 65% 的预训练 token,这支持了 scaling-law 指导设计的有效性。
5.4 算力受控对比:scaling law 指导到底值多少¶
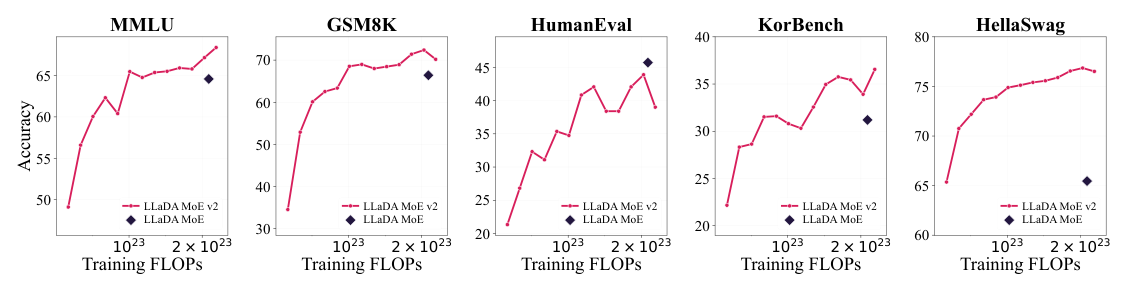
Figure 5 把 LLaDA MoE v2 30B-A3B 在不同训练 FLOPs 下的表现与 LLaDA MoE 7B-A1B(一个未经 scaling law 指导开发的 MoE dLLM)对比。在覆盖知识、数学与代码的多个 benchmark 上,30B-A3B 模型在显著更低的算力预算下达到与 7B-A1B 相当或更好的表现:
- 在 MMLU、GSM8K、KorBench 上,用约 50% 的训练 FLOPs 即超过 LLaDA MoE 7B-A1B;
- 在 HellaSwag 上,用不到 10% 的训练 FLOPs 就超过它。
这是本文最有说服力的一组证据——它不是"更大模型更好"的平凡结论,而是在算力受控的横轴上直接展示了"scaling law 指导"这一变量本身的价值:把预训练算力转换为下游性能的效率被显著提高了。
5.5 监督微调(SFT)¶
从 LLaDA MoE v2 30B-A3B base checkpoint 出发,在 7M 条指令–回复样本(主要是单轮数学推理与代码生成任务)上微调 3 个 epoch。数据处理沿用预训练的一般流程(去除畸形/低质样本、去重、过滤有害内容),并用统一对话模板格式化,打包为不重叠的 8K token 训练序列。
关键的目标构造:把 prompt 与 response 拼接,但式 (1) 的前向掩码过程只作用于 response token,prompt 作为未破坏的条件上下文保留,去噪损失只在被掩码的 response 位置计算。MoE 负载均衡损失与 router z-loss 在 SFT 期间仍然启用,系数不变($\alpha_{\text{aux}} = 0.01$、$\alpha_z = 0.001$)。
优化:AdamW $(\beta_1,\beta_2) = (0.9, 0.999)$(注意与预训练的 0.95 不同)、weight decay 0.1、梯度裁剪 1.0,全局 batch size 512 序列。学习率在前 8% 步数线性 warmup 到 $5.0\times10^{-6}$,随后 cosine 衰减到最小 $1.0\times10^{-6}$。SFT 之后不做任何 RL 阶段,用最终 checkpoint 作为 instruct 模型。
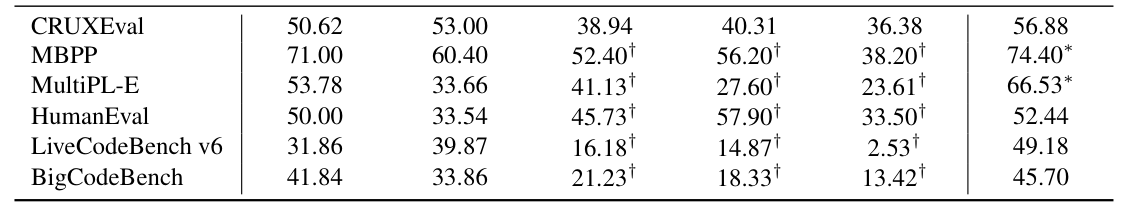
Table 4:SFT 结果
| | Reasoning | | | | Code | | | | | Model | Math | Olympiad | AIME24 | AIME25 | MBPP | LCB v6 | BigCode | MultiPL-E | | --- | --- | --- | --- | --- | --- | --- | --- | --- | | Qwen3 | 89.80∗ | 57.26 | 32.80∗ | 21.60∗ | 85.48 | 31.50 | 41.14 | 66.60 | | SDAR Chat | 77.80† | 34.93 | 16.70† | 10.80† | 71.60† | 21.70† | 39.39 | 45.00 | | LLaDA MoE v2 | 80.02 | 46.44 | 30.00 | 20.00 | 81.03 | 27.75 | 35.53 | 67.52 |
结果分析。 与 SDAR Chat 相比,LLaDA MoE v2 在全部 4 个推理 benchmark 与 4 个代码 benchmark 中的 3 个上胜出(唯一失手是 BigCodeBench 35.53 vs 39.39),即 8 项中的 7 项。差距最大的是 Olympiad(+11.51)、AIME24(+13.30)、MultiPL-E(+22.52)。
与 Qwen3 相比,尽管预训练 token 更少、且没有 Qwen3 所使用的额外 RL 阶段,LLaDA MoE v2 在 AIME 24/25($-2.80$ / $-1.60$)、MBPP($-4.45$)、LiveCodeBench($-3.75$)上仍然接近,并在 MultiPL-E 上反超(67.52 vs 66.60)。这说明该模型仅靠 SFT 就获得了较强的推理与代码能力,也暗示 RL 是尚未兑现的增量空间(作者明确把 RL 整合留作 future work)。
5.6 评测协议(Appendix B.4)¶
评测细节对可比性影响很大,值得单独记录:
- Base 模型(Table 3):多选题用条件似然(MMLU、MMLU-Pro、CEval、CMMLU、HellaSwag),其余任务用条件生成。AR 模型按其从左到右分解计算条件对数似然;LLaDA MoE v2 沿用 SMDM / LLaDA / 前代 LLaDA MoE 的似然评估协议;SDAR 用 Block Diffusion(Arriola et al., 2025)的方法估计条件似然。
- 每个模型优先报告其官方发表的结果;若某 benchmark 结果不可得,才用作者统一评测配置下的得分。这解释了 Table 3 中大量的 ∗ / † 标注。
- Instruct 模型(Table 4):全部通过条件生成评测。生成长度上限 1,024 token;对 MATH、OlympiadBench、AIME 2024/2025 提高到 4,096 token(因为 1,024 不足以产出最终答案)。
- 采样方式:LLaDA MoE v2 使用半自回归(semi-autoregressive)采样,block size = 64,总去噪步数等于生成长度;SDAR 按其推荐的 block diffusion 解码,block size = 4,采样步数同样等于生成长度。
值得注意:"总去噪步数 = 生成长度"意味着评测时并未利用 dLLM 的并行解码加速——即每步只等效解出一个 token 的预算。这是一个保守(有利于质量、不利于速度)的设置,也意味着本文报告的分数没有体现 dLLM 的推理吞吐优势,论文全文也未报告任何解码延迟/吞吐数据。
六、核心贡献总结¶
- 首次系统刻画 MoE dLLM 的 scaling 行为,覆盖优化超参、模型–数据分配、MoE 架构三个维度,并明确给出与 AR 趋势的定量差异(而非定性断言)。
- 三条可直接落地的 dLLM 专属规则:
- $B^* = 0.374\,C^{0.3481}$、$\eta^* = 64.8\,C^{-0.2447}$(比 AR 更陡的 batch 增长、更快的 LR 衰减);
- $M^*\propto C^{0.475}$、$D^*\propto C^{0.525}$(边际算力更该花在数据上);
- $(A \downarrow \text{随尺度}, G \in [8,16], S = 33.3\%)$——尤其 $S = 33.3\%$ 与 AR 界"一个固定共享专家"的主流启发式明确相反。
- 大规模验证:LLaDA MoE v2 30B-A3B 从头训练 23.5T token,在算力受控对比下用 ≤50% FLOPs 超越未经指导的前代 LLaDA MoE 7B-A1B;仅 SFT(无 RL)即在 8 项任务的 7 项上超越 SDAR Chat 30B-A3B。
- 实验协议的严谨性:受控单变量扫描 + 保持 $M^*(C)$ 不变的构造 + 近最优点集体回归 + 过训练区间($3D^*$)下选架构,使得架构结论对"实际大规模预训练常处于过训练区间"这一现实有针对性。
七、与已归档相关工作的对比¶
MobileMoE MobileMoE: Scaling On-Device Mixture of Experts(Meta AI, 2026-05-26)¶
关系:独立并发(本文未引用 MobileMoE,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文面对的 root cause 完全一致——服务器端 AR MoE 沉淀下来的架构启发式(专家数、粒度、要不要共享专家)在换了约束条件之后是否还成立,没人验证过。LLaDA MoE v2 换的是"建模目标"(掩码去噪 + 双向 router 输入);MobileMoE 换的是"部署约束"(端侧联合内存 + 算力约束)。两者都指出现有 MoE 设计"largely inherit AR / server-side practice",都认为这是不能默认迁移的先验。
- 相近的技术骨架:两者的方法流程图几乎可以叠合——(1) 定义同一组三维 MoE 设计空间(稀疏度 / 专家数、专家粒度、共享专家);(2) 在固定"激活侧预算"的前提下做单变量受控扫描;(3) 用扫描结果拟合 / 导出一条 scaling law;(4) 用该 law 选定一个具体架构,从头训练一个大规模模型族并做完整评测。连三个设计因子的定义都高度同构:MobileMoE 的 $(E, g, s)$ 对应本文的 $(A, G, S)$。
- 本文的差异与推进:(a) 约束轴不同——MobileMoE 的 scaling law 显式把总参数/内存 footprint 作为一等公民($\mathcal{L}(N_{\text{act}}, D, \hat{E}, x)$ 含 $\hat E^{\delta}$ 项),因为端侧内存是硬约束;本文的 law 只以训练算力 $C$ 为自变量,内存不进入目标。(b) 本文多做了一层"超参律 → 分配律 → 架构律"的串行标定,MobileMoE 直接在固定超参下扫架构。(c) 本文把共享专家比率视为一个连续可扫的比例变量并给出 $S = 33.3\%$ 的定量最优,而 MobileMoE 的共享专家是二元的 $s \in \{\checkmark, \times\}$ 消融。
- 可比的方法 / 实验差异(结论对比很有意思):
- 专家粒度:MobileMoE 发现细粒度显著更优但 $g = 8$ 后收益递减,最终选 $g = 8$;本文发现 $G$ 无单调趋势、$G = 8$–$16$ 稳健,最终也选 $G = 8$。两条完全不同的路线在粒度上收敛到同一个数。
- 稀疏度:MobileMoE 因内存约束只敢用"适中稀疏度"($E \in \{4,8\}$ 是端侧甜点);本文在无内存约束下发现越稀疏越好且随尺度加剧($A$ 一路降到 9.09%,$n_e = 128$)。这正是"约束轴不同"导致的结论分叉——如果不区分部署约束就直接引用某一方的结论,会得到相反的建议。
- 共享专家:MobileMoE 把 8 个激活路由专家中的 4 个换成一个 $4\times$ 大小的共享专家(等价 $S = 50\%$),结论是"有共享专家更好";本文在同一位置给出更精细的答案——U 形曲线的最优在 $S = 33.3\%$,$S = 50\%$ 已在下降段。本文的 30B-A3B 恰好落在 $n_a = 8$、$n_s = 4$,与 MobileMoE 的 top-4 + $4\times$ 共享形成一个有趣的对照。
Scaling Properties of Continuous Diffusion Spoken Language Models Scaling Properties of Continuous Diffusion Spoken Language Models(Apple, 2026-04-27)¶
关系:独立并发(本文未引用该工作)· 已加载对方精读
- 共同关注的问题:两篇都在问同一件事——扩散目标下的语言模型,是否继承了 AR 语言模型的 scaling law?如果不继承,新的指数是多少? 两者都明确把"AR 的 scaling 结论不能默认迁移到 diffusion"作为立论起点,并都通过 IsoFLOP 扫描给出新的、可外推的拟合。
- 相近的技术骨架:(1) 跨多个数量级的算力扫 IsoFLOP;(2) 拟合 $(N, D)$ 或 $(M, D)$ → loss 的 scaling 关系并读出最优分配趋势;(3) 用拟合结果外推到一个远超扫描范围的大模型并做实证验证(Apple 外推到 16B,本文外推到 30B-A3B / 23.5T token)。
- 本文的差异与推进:(a) 扩散类型不同——Apple 做的是 continuous diffusion(在 log-mel 上做 velocity 参数化的连续扩散,式 $\mathcal{L} = \mathbb{E}[\min(\mathrm{SNR}(t),\psi)\|v_\theta - v_t\|^2]$),本文是离散掩码扩散(式 (1));(b) 架构维度——Apple 是稠密 MM-DiT,本文的核心增量恰恰是 MoE 这一稀疏轴,且给出了 $A$/$G$/$S$ 的架构级 scaling,这是 Apple 那篇完全没有覆盖的层面;(c) 本文额外标定了超参律($B^*$、$\eta^*$),Apple 未把超参作为 scaling 变量。
- 可比的方法 / 实验差异:两者在"最优分配随算力如何漂移"上给出了方向一致但语境不同的观察——Apple 发现最优 token-per-parameter 比 $r^*$ 随算力减小(与 Chinchilla 一致,即模型侧相对更吃算力),而本文的 MoE dLLM 前沿反而偏向数据侧($D^*\propto C^{0.525}$ vs $M^*\propto C^{0.475}$)。本文对此给出的机制解释是"稀疏激活 + 掩码监督稀释"的叠加,而 Apple 那篇的连续扩散没有掩码监督稀释问题、也没有稀疏激活,这恰好构成一个自洽的交叉验证:偏数据侧的倾向来自 MoE + masked-denoising 这两个因素,而不是"扩散"本身。另一处值得对照的是结论口径:Apple 的结论相当悲观(纯 SLM 路线在现有算力下继续 scale 不切实际,部分指标外推后仍达不到真实数据基线),而本文的结论是乐观的(65% token 即逼近 Qwen3)——差别在于语音的语义密度远低于文本(80 帧/秒 vs 4 文本 token/秒,约 20× 的序列长度劣势)。
Compute Optimal Tokenization Compute Optimal Tokenization(Meta FAIR, 2026-05)¶
关系:独立并发(本文未引用该工作)· 已加载对方精读
- 共同关注的问题:两者都在挑战 Chinchilla 型模型–数据分配律的"单位"与"适用范围"。Compute Optimal Tokenization 指出"20 token/参数"里的 token 是相对 BPE 测出来的人造单位,换个压缩率的 tokenizer 结论就会漂;本文指出 $C \approx 6ND$ 与 AR 分配指数的前提(全参数激活、每 token 一个监督目标)在 MoE dLLM 下双双失效。两者的 root cause 同构:把某个被默认为常量的建模选择显式变成 scaling law 的自变量。
- 相近的技术骨架:都是"大规模 IsoFLOP 网格 → 重新拟合分配前沿 → 得到修正后的经验法则"。FAIR 训了 988 个 latent tokenized + 320 个 subword 模型($5\times10^{18}$–$2\times10^{21}$ FLOPs、50M–7B 参数)把 Chinchilla 的"20 token/参数"推广为 tokenizer 无关的"~60 byte/参数";本文在 $10^{17}$–$10^{20}$ FLOPs 上扫 25 种架构把 AR 的 $M^*/D^*$ 指数重标定为 0.475/0.525。
- 本文的差异与推进:FAIR 改的是数据侧的计量单位(压缩率 $T$),本文改的是模型侧的算力计量($C = MD$ 而非 $6ND$)与监督密度(只有掩码位置产生梯度)。一个有意思的错位是:FAIR 的结论是"更大的训练预算反而应该用更细粒度的 tokenizer",本文的结论是"更大的预算应该用更稀疏的路由 + 更多 token"——两者都指向随尺度增长应该往"更多、更细的离散单元"方向走,只是一个作用在输入切分上,一个作用在专家切分上。
- 可比的方法 / 实验差异:FAIR 的实验密度(1,308 个模型)远高于本文(本文未报告总 run 数,但从 Table 5/8/9/10–13 推算,超参扫描约 3 尺度 × 4–6 预算 × 12–16 网格点、分配扫描 25 架构 × 8 预算、架构扫描 5 预算 × (8+7+7) 候选,量级在数百 run),但本文额外提供了一次 30B-A3B / 23.5T token 的真实大规模落地验证,这是 FAIR 那篇止步于 7B 所没有的。两者的可信度来源因此不同:一个靠拟合样本量,一个靠外推后的实证兑现。
Step 2.5 被剔除的近似候选(记录门槛):
- Kimi K3 Kimi K3(Moonshot AI):同为超大 MoE 技术报告且同样讨论架构选择,但其问题是"沿序列/深度/专家三条正交轴扩展信息流",解法是架构组合创新,没有 scaling law 拟合 → 设计决策这条骨架,问题与解法均不同构。
- Practical Scaling Laws: Converting Compute into Performance in a Data-Constrained World(Arena Physica)与 Prescriptive Scaling Laws for Data Constrained Training(Cornell):都是 scaling law 论文,但研究对象是 loss 曲线的函数形式(加 overfitting / 多 epoch 惩罚项以提高 $R^2$),不产出架构或超参的设计配方,也无大规模 scale-up 验证。表面同域、root cause 不同。
- Bridging Compute- and Data-Optimal Pretraining Bridging Compute- and Data-Optimal Pretraining(Harvard):同样做模型–数据分配,但 root cause 是数据受限下的 token 复用有效性(token effectiveness $\eta$),与本文"掩码监督稀释 + 稀疏激活"的机制无关。
- Scaling Laws for Behavioral Foundation Models over User Event Sequences Scaling Laws for Behavioral Foundation Models(Unbox AI):同为"AR LLM scaling law 是否迁移到新领域",~600 个 iso-FLOP run,但缺少架构维度扫描与大规模落地验证,深筛时判为骨架偏离。
- PowLU PowLU(Ling Team, Ant Group):同机构、同为 LLM 预训练底层组件研究,但解法是激活函数设计以抑制离群值,与 scaling 标定无关。
八、讨论与局限性¶
8.1 值得借鉴的设计¶
- "AR 先验 + 领域标定"的方法论姿态。 本文没有走"推翻 AR 经验"的极端叙事,而是反复强调"方向一致、标定不同"。这是一个更可复用的模板:对任何换了训练目标 / 架构 / 部署约束的新范式,先假设方向继承,再定量测量偏移量,最后只在偏移显著的维度上另立规则。$B^*$ 指数只从 0.3271 挪到 0.3481(小),但在 $10^{20}$ FLOPs 处 batch size 就差了 3.4×(大)——指数的小差异在外推时被放大,这是 scaling law 类工作最容易被忽视的实践要点。
- "保持激活预算不变"的受控扫描构造。 §4.3 中三种扫描各自的"如何在改变一个维度时保持 $M^*(C)$ 不变"的构造方式(改 $n_e$ / 反比例缩放 / 固定 $(n_a+n_s)d_{\text{expert}}$ 重分配)非常干净,是这类架构消融最容易做错的地方,值得直接照搬。
- 在过训练区间选架构。 用 $3D^*(C)$(约 $3C$ FLOPs)而非 $D^*(C)$ 训练架构候选,并把超参律在 $3C$ 处求值,这个细节承认了"实际大规模预训练总是过训练"的现实。很多 scaling 论文在 compute-optimal 点上选架构,然后在过训练区间部署,属于分布外使用。
- 算力受控的价值证明(Figure 5)。 用"同一 benchmark、横轴为训练 FLOPs、对比有无 scaling law 指导的两个模型"来证明方法论本身的价值,比单纯报告"新模型更强"有说服力得多,值得作为技术报告的标准做法。
8.2 局限与争议¶
- 作者自述的核心局限:维度间的交互未被捕捉。 论文明确写道"Our experiments vary the scaling dimensions separately and therefore do not capture their interactions"。这是一个实质性的缺口——例如"最优 $S$ 是否依赖于 $A$"是完全合理的疑问,而共享专家扫描本身就承认改变 $n_s$ 会让 $A$ 轻微漂移。更麻烦的是,架构扫描是在固定的分配律下做的,而分配律又是在固定的架构($n_e = 64$、$n_a = 4$、$n_s = 1$,即 $A = 7.7\%$、$S = 20\%$)下拟合的——这条串行链条存在互为前提的循环:用 $S = 20\%$ 的架构拟合出的分配律,被用来指导得出"$S = 33.3\%$ 最优"的结论,但作者没有回过头用 $S = 33.3\%$ 重新拟合分配律以检验自洽性。
- 拟合区间与外推跨度的落差极大。 分配律在 $10^{17}$–$10^{20}$ FLOPs 上拟合,架构律在 $6\times10^{17}$–$6\times10^{19}$ 上拟合,而 LLaDA MoE v2 的实际训练算力约在 $10^{23}$ 量级(Figure 5 的横轴)——外推跨度达到 3–5 个数量级。超参律做了一次到 $6\times10^{20}$(2×)的外推验证,但架构律与分配律都没有对应的中间尺度验证。"$S = 33.3\%$ 跨尺度稳定"这个结论只在覆盖两个数量级的五个预算上成立,是否延伸到 $10^{23}$ 属于信念而非证据。
- $A$ 的"越稀疏越好"结论与最终选择之间存在张力。 Figure 4(a) 的趋势是激活比率越低越好,扫描一直到 $A = 1.2\%$($n_e = 256$),但最终模型取 $A = 9.09\%$($n_e = 128$)。论文没有解释为什么不取更稀疏的配置——合理猜测是显存 / 通信 / 负载均衡等工程约束,但这个决策的依据完全没有交代,削弱了"从 law 到设计"链条的完整性。
- 数据侧结论的可信度依赖于"同一语料"假设。 数据侧指数 0.525 略大于 0.475 的差距本身不大(0.05),而 IsoFLOP 最优点的定位对 loss 曲线的平坦程度非常敏感。论文没有报告拟合的置信区间或 $R^2$,也没有做 bootstrap / 留一验证。相比之下 Table 2 中被引用的多篇工作的指数差异(0.463 到 0.73)跨度远大于本文与最近邻 baseline 的差距,因此"MoE dLLM 前沿更偏数据侧"这一定性结论比其定量取值更可靠。
- dLLM 的核心卖点——并行解码效率——完全没有被评测。 论文全篇没有任何推理延迟、吞吐或每 token 解码步数的数据;相反,评测协议明确把"总去噪步数 = 生成长度",即主动放弃了并行加速。这使得整篇论文实际上只论证了"MoE dLLM 在质量上能逼近 AR MoE",而没有回答"付出的额外代价(双向注意力无法用 KV cache、需要多步去噪)是否被并行解码收益抵消"。对于一个把 dLLM 作为 AR 替代路线来推广的技术报告,这是一个显著的缺口。
- 与 Qwen3 的对比存在多处不可控变量。 训练语料不同(且不公开)、tokenizer 不同(157,184 vs Qwen3 的 151,936 量级)、Qwen3 多一个 RL 阶段、部分数字直接取自各自原论文而非统一评测。"65% token 逼近 Qwen3"因此是一个受语料质量强烈影响的说法——不能排除本文语料质量更高的可能。中文 benchmark 上高达 8–11 分的落差(CEval、CMMLU)也提示语料构成差异可能相当大。
- SFT 数据规模与领域偏窄。 7M 条样本、"主要是单轮数学推理与代码生成",且不做 RL。Table 4 只评了推理与代码,没有指令跟随(IFEval)、多轮对话、安全等维度。因此"SFT 后是一个强 instruct 模型"的说法覆盖面有限。
8.3 工业落地视角¶
本文由蚂蚁集团与人大联合完成(一作在蚂蚁实习期间完成),属于有真实算力投入的工业级技术报告而非纯学术研究:约 460,000 B200 GPU 小时的预训练投入、23.5T token、五阶段调度、32K 上下文扩展,都是可直接参考的工程配方。对于任何计划训练 MoE dLLM 的团队,最直接可复用的是:
- 三条 scaling 律的具体系数(可直接代入自己的算力预算求 $B$、$\eta$、$M$、$D$);
- $(A, G, S) = (9.09\%, 8, 33.3\%)$ 这一组已被 30B 规模验证过的架构点;
- 五阶段数据调度与各阶段峰值学习率的具体数值(含"上一阶段衰减到下一阶段峰值"的衔接技巧);
- SFT 中"只对 response 加掩码、保持 prompt 未破坏"的目标构造,以及 MoE 辅助损失在 SFT 期间保持启用的做法。
论文本身没有任何线上部署或 A/B 数据,因此工业价值体现在训练配方的可复现性上,而非业务收益。