Bridging Compute- and Data-Optimal Pretraining
研究动机与背景
经典 scaling law(Kaplan et al., 2020;Hoffmann et al., 2022)刻画预训练 loss 如何随模型规模 $N$ 与数据量 $D$ 下降,并据此给出 compute-optimal 的算力分配方案。但这套公式内嵌了一个数据充裕假设(data-abundance assumption):新鲜 token 可以自由取用,预训练语料 $D$ 会随算力自然增长。
这个假设正在失效。算力仍以指数速率增长(Sevilla et al., 2022),而高质量预训练数据既有限又昂贵(Villalobos et al., 2024)。预训练正在进入一个经典 scaling law 从未设计过的区间:$D$ 有界,多出来的算力只能花在从 $D$ 派生出的 derived tokens $D'$ 上——多 epoch 重复、改写(paraphrase)、蒸馏等。核心问题因此变成:
对一个规模为 $N$ 的模型,在固定语料 $D$ 上训练时,额外的算力还能降多少 loss?
作者用两个极限来框定这个问题:
- Compute-optimal scaling $\mathcal{L}^{\text{Chin}}$:数据无限、算力是瓶颈,即经典 scaling law 所刻画的区间;
- Data-optimal scaling $\mathcal{L}^{D}$:数据固定、算力无限,是"在给定语料 $D$ 上,任何形式的额外训练所能达到的渐近下界"。
现代预训练恰好落在这两个极限之间。本文提出 Compute-Data (CD) scaling laws 来统一二者,其核心是一个 effectiveness function(token 有效性函数) $\eta^{\text{strat}} \in [0,1]$:给定一种数据扩增策略(改写或重复),它量化一个 derived token 相对于一个 fresh token 值多少——$\eta=1$ 意味着 derived token 与新鲜数据等价,$\eta=0$ 意味着毫无价值。
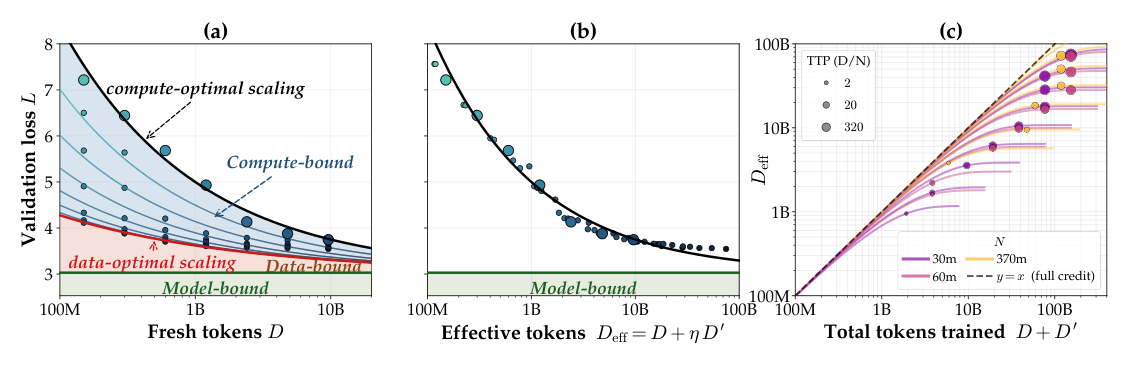
作者的贡献可归纳为三点:
- 统一的 CD-scaling 框架:用 $\eta^{\text{strat}}$ 把 compute-optimal 与 data-optimal 两端连续地桥接起来;
- derived token 的有效性随规模衰减:在 Dolma-3 上跨 14M–600M 模型拟合 $\eta$,发现它远非常数,而是随 $N$、TPP、$D'/D$ 联合衰减,并随语料扩增而饱和;
- 三条实践推论:(a) 识别 compute-bound / data-bound / model-bound 三个区间,告诉从业者当前是哪种资源在卡;(b) 给定 $(N,D)$ 给出最优 compute–data 分配,把 Chinchilla 的纯算力优化推广为联合 compute–data Pareto 前沿;(c) 给出何时该重复、何时该改写、以及各自该做多少的处方。
核心方法:CD-Scaling Law
从 Chinchilla 到 CD
经典 Chinchilla scaling law 为:
$$\mathcal{L}^{\text{Chin}}(N, D) \;=\; E + \frac{A}{N^{\alpha}} + \frac{B}{D^{\beta}} \tag{1}$$
其中 $N$ 是参数量,$D$ 是每个只被看一次的新鲜 token 数。为容纳合成与增强数据,本文把 Eq. (1) 扩展为共享同一组常数 $(E, A, B, \alpha, \beta)$ 的 compute–data (CD) scaling law:
$$\mathcal{L}^{\text{CD}}(N, D, D') \;=\; E + \frac{A}{N^{\alpha}} + \frac{B}{\bigl(D + \eta^{\text{strat}}(N, \text{TPP}, D'/D)\cdot D'\bigr)^{\beta}} \tag{2}$$
$D'$ 是某种数据扩增策略产生的额外 token。$\eta \in [0,1]$ 预测 $D'$ 中一个 derived token 相当于 $D$ 中多少个 fresh token。注意一个关键的建模选择:$\eta$ 被参数化为 $(N, \text{TPP}, D'/D)$ 而非 $(N, D, D')$ ——TPP $= D/N$ 是 tokens-per-parameter 比,衡量新鲜数据相对模型容量的可得性,也正是 Chinchilla scaling 惯用的单位;$r = D'/D$ 是扩增比,在多 epoch 情形下就是额外 epoch 数;$N$ 单独保留以刻画模型容量本身。
三个自然极限
Eq. (2) 有三个极限,正是"桥接"的含义所在:
- $D' = 0$:退化回经典 scaling law $\mathcal{L}^{\text{Chin}}$;
- $D \to \infty$:第三项归零,剩下 model-bound floor $\mathcal{L}^{N} = E + A/N^{\alpha}$,即规模为 $N$ 的模型在无限新鲜数据下能达到的最低 loss;
- $D' \to \infty$(固定 $D$):定义 data-optimal scaling $\mathcal{L}^{D}$,即在固定语料 $D$ 上投入无限算力于 derived token 所能达到的最低 loss。
$\eta$ 的经验刻画
在指定函数形式之前,作者先经验性地测量 $\eta$。做法是:先用 Eq. (1) 在 1-epoch run 上拟合出常数 $(E, A, B, \alpha, \beta)$;对每个重复/改写 run,定义 $\eta_{\text{emp}}$ 为"代入 Eq. (2) 后能复现观测 loss 的唯一取值"。预期 $\eta_{\text{emp}} \in [0,1]$,但当 1-epoch 拟合低估了某个 run 的 loss 时它可以超过 1(残差被吸收进 $\eta_{\text{emp}}$,这是本文自陈的一处方法学隐患)。
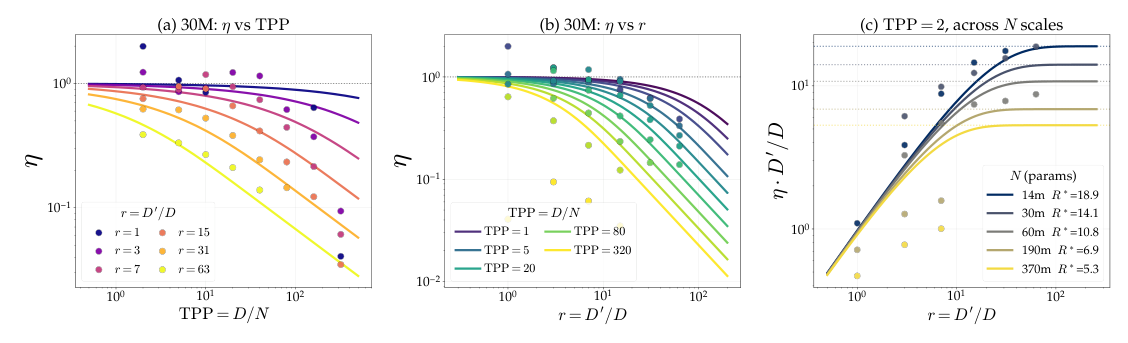
三条经验观察:
- (a) $\eta_{\text{emp}}$ 随 TPP 衰减,且衰减随 $r$ 增大而变陡;
- (b) $\eta_{\text{emp}}$ 随 $r$ 衰减,衰减速率取决于 TPP:TPP 小时缓慢,TPP 大时急剧;
- (c) 真正决定总 loss 的不是 $\eta$ 而是有效 derived 数据 $\eta \cdot D'$(归一化后即 $\eta \cdot r$)。这个量并非无限增长,而是 $\lim_{r \to \infty} \eta \cdot r$ 饱和;饱和上限与饱和速率都依赖 $N$,更大的模型饱和值更低、饱和更快。
作者特别强调:这个平台是 $\eta$ 的本质属性,不是欠拟合造成的——无论加多少 derived token,loss 曲线都会拉平,因此任何让 $\eta \cdot D'$ 发散的函数形式都被排除。
$\eta$ 的函数形式与饱和天花板 $R^*$
上述观察给出三个约束:(i) $r \to 0$ 时 $\eta_{\text{emp}} \to 1$;(ii) $r \to \infty$ 时 $\eta \cdot r$ 收敛到有限极限;(iii) 饱和行为依赖 TPP 与 $N$。满足前两条的函数族中,作者采用指数饱和形式:
$$\eta \;=\; \frac{R^{*}}{r}\left(1 - e^{-r/R^{*}}\right) \tag{3}$$
由此得到恒等式 $\lim_{r\to\infty} \eta \cdot r = R^{*}$,所以 $R^{*}$ 可解读为饱和天花板(saturation ceiling):规模为 $D$ 的语料通过数据扩增所能产出的最大 fresh-equivalent token 数,以 $D$ 的倍数表示。这意味着总有效 token 在 $D' \to \infty$ 时收敛到 $D_{\text{eff}} = D(1 + R^{*})$,代回 Eq. (2) 即得 data-optimal scaling 的闭式:
$$\mathcal{L}^{D}(N, D) \;=\; E + \frac{A}{N^{\alpha}} + \frac{B}{\bigl[D\,(1 + R^{*}(D, N))\bigr]^{\beta}} \tag{4}$$
$R^{*}$ 本身取幂律形式:
$$R^{*}(D, N) \;=\; K \cdot (D/N)^{\rho} \cdot N^{\sigma} \tag{5}$$
$\rho$ 控制 $R^{*}$ 随 TPP 收紧的速率,$\sigma$ 控制随 $N$ 收紧的速率。Eq. (3) 与 Eq. (5) 共同确定 $\eta$,代回 Eq. (2) 得到完整的 CD-scaling law,共 8 个常数:5 个 Chinchilla 参数 $(E, A, B, \alpha, \beta)$ + 3 个策略特定参数 $(K, \rho, \sigma)$。
一个重要的定位:Muennighoff et al. (2025) 的 data-constrained scaling law 正是 $R^{*}$ 为常数、与 $(D, N)$ 无关的特例;Kim et al. (2025) 的 data-optimal 极限则是 $D' \to \infty$ 的特例。CD-scaling law 把这两条线索与 Hoffmann et al. (2022)($D'=0$ 极限)统一在一个公式里。
关键技术细节:拟合流程
作者沿用 Besiroglu et al. (2024) 的拟合流程,在 log-loss 空间用数值稳定的 LSE 等价形式工作:
$$\log \mathcal{L}(N, D, D') \;=\; \mathrm{LSE}\bigl(e,\; a - \alpha \log N,\; b - \beta \log(D + \eta \cdot D')\bigr) \tag{6}$$
它与 Eq. (2) 在 $(E, A, B) = (e^{e}, e^{a}, e^{b})$ 下代数等价但数值更稳。拟合细节:
- 目标:对 $\log \mathcal{L}$ 残差最小化 Huber loss,$\delta = 0.1$——对典型残差是二次权重,对大一个数量级的离群点则抑制其影响;
- 优化器:L-BFGS + strong-Wolfe line search;从参数的对数间隔网格初始化,取 in-sample 最优种子,跨 30+ 随机种子最优解可复现到 4 位有效数字;
- 联合拟合:全部 11 个参数 $(E, A, B, \alpha, \beta) + (\log K, \rho, \sigma)_{\text{rep}} + (\log K, \rho, \sigma)_{\text{para}}$ 在 1-epoch + repetition + paraphrase 汇总数据上一次性联合优化;初始化网格对 $\rho_{\text{para}}, \sigma_{\text{para}}$ 的符号做双向覆盖,所有网格最终都落进同一个负 $(\rho_{\text{para}}, \sigma_{\text{para}})$ 盆地;
- 迭代残差裁剪:少数噪声小尺度点会主导拟合,作者用 Besiroglu et al. (2024) 的残差裁剪迭代变体——拟合、丢掉残差最大的单点、重拟合,共 $k$ 步。标准 Hampel 离群规则在未裁剪拟合上识别出 14 个离群点,作者取整为 $k=15$(约裁掉 4% 数据)。被裁掉的点全都是 14M / 30M 的小尺度 1-epoch 与 repetition run,与 Besiroglu et al. 对 Chinchilla 本身识别出的离群点属同一类;
- 置信区间:对训练 run 做有放回重采样并重拟合,重复 200 次取 95% CI。
Table 2:离群裁剪 sweep(汇总 $n=356$ 个拟合残差点,per-source RMSE 在保留点上计算,$k=15$ 为最终采用行)
| $k$ | n kept | $\beta$ | $\log K_{\text{rep}}$ | $\sigma_{\text{rep}}$ | $\log K_{\text{para}}$ | $\sigma_{\text{para}}$ | 1-ep RMSE | rep RMSE | para RMSE |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 356 | 0.298 | 15.92 | −0.63 | 31.57 | −1.34 | 0.076 | 0.046 | 0.027 |
| 5 | 351 | 0.371 | 11.85 | −0.44 | 31.29 | −1.32 | 0.062 | 0.042 | 0.024 |
| 10 | 346 | 0.420 | 11.15 | −0.41 | 31.08 | −1.31 | 0.052 | 0.038 | 0.023 |
| 15 | 341 | 0.437 | 10.96 | −0.41 | 31.02 | −1.33 | 0.043 | 0.035 | 0.024 |
| 20 | 336 | 0.456 | 10.82 | −0.42 | 31.02 | −1.34 | 0.039 | 0.031 | 0.024 |
| 25 | 331 | 0.472 | 10.71 | −0.42 | 31.03 | −1.35 | 0.035 | 0.029 | 0.022 |
| 30 | 326 | 0.482 | 10.64 | −0.42 | 31.03 | −1.36 | 0.030 | 0.027 | 0.020 |
可以看到 $\sigma_{\text{rep}}$ 与 $\sigma_{\text{para}}$ 在 $k \ge 5$ 后已相当稳定(分别稳定在 −0.41 至 −0.44、−1.31 至 −1.36),$\beta$ 则随裁剪单调抬升——说明小尺度离群点主要在压低数据项指数。
实验设置
- 架构与基础设施:全部预训练 run 使用 OLMo3(Olmo et al., 2025)架构与训练框架;
- 规模网格:$N$ 从 14M 到 600M(14M / 30M / 60M / 100M / 190M / 370M / 600M),新鲜数据 $D$ 从 30M 到 30B token,derived token $D'$ 从 30M 到 120B token;
- 语料:新鲜 token 从 Dolma-3 150B 语料(
allenai/dolma3_mix-150B-1025)采样,且小的 $D$ 始终是大的 $D$ 的严格子集(保证嵌套、可比); - 训练配置:序列长度 4096,batch size 512(梯度累积 64),AdamW $(\beta_1, \beta_2) = (0.9, 0.95)$,梯度裁剪 1.0,cosine 学习率 + warmup(warmup 1B token,最小 LR 比 $\alpha_f = 0.1$),BF16 (AMP),softmax 辅助损失系数 $1\times10^{-5}$;
- 超参搜索:学习率 $\in \{1e\text{-}4, 3e\text{-}4, 1e\text{-}3, 3e\text{-}3\}$、weight decay $\in \{0.1, 0.2, 0.4, 0.8, 1.6\}$ 在 $N \in \{30\text{M}, 370\text{M}\}$ 上做全网格,取 validation loss 最优配置;其余模型规模在该配置附近做局部网格;
- 主指标:5M 篇 Dolma-3 文档留出集上的 validation loss。
两种数据扩增策略
- Multi-epoch(重复)(Muennighoff et al., 2025):把原语料重复多个 epoch,此时 $r = D'/D$ 就是额外 epoch 数;
- Paraphrasing(改写/增强)(Maini et al., 2024;Kang et al., 2025):用 SmolLM2-1.7B-Instruct(Allal et al., 2025)把 $D$ 中每篇文档改写,每篇最多采样 16 个改写版本,风格从 {question, math(不适用时用 wiki), FAQ, table} 中均匀抽取——这个四风格混合是 Niklaus et al. (2026) 先前分析中最有效的组合。模型在 fresh $D$ 与改写 $D'$ 的混合上训练一个 epoch。改写文档始终派生自 $D$ 中的文档,且小的改写语料嵌套于大的之中。
重要口径说明:作者不把改写生成所耗的 FLOPs 计入训练算力,理由是改写可异步离线完成、不属于训练循环。这一口径直接影响改写策略的性价比结论(见"讨论与局限性")。
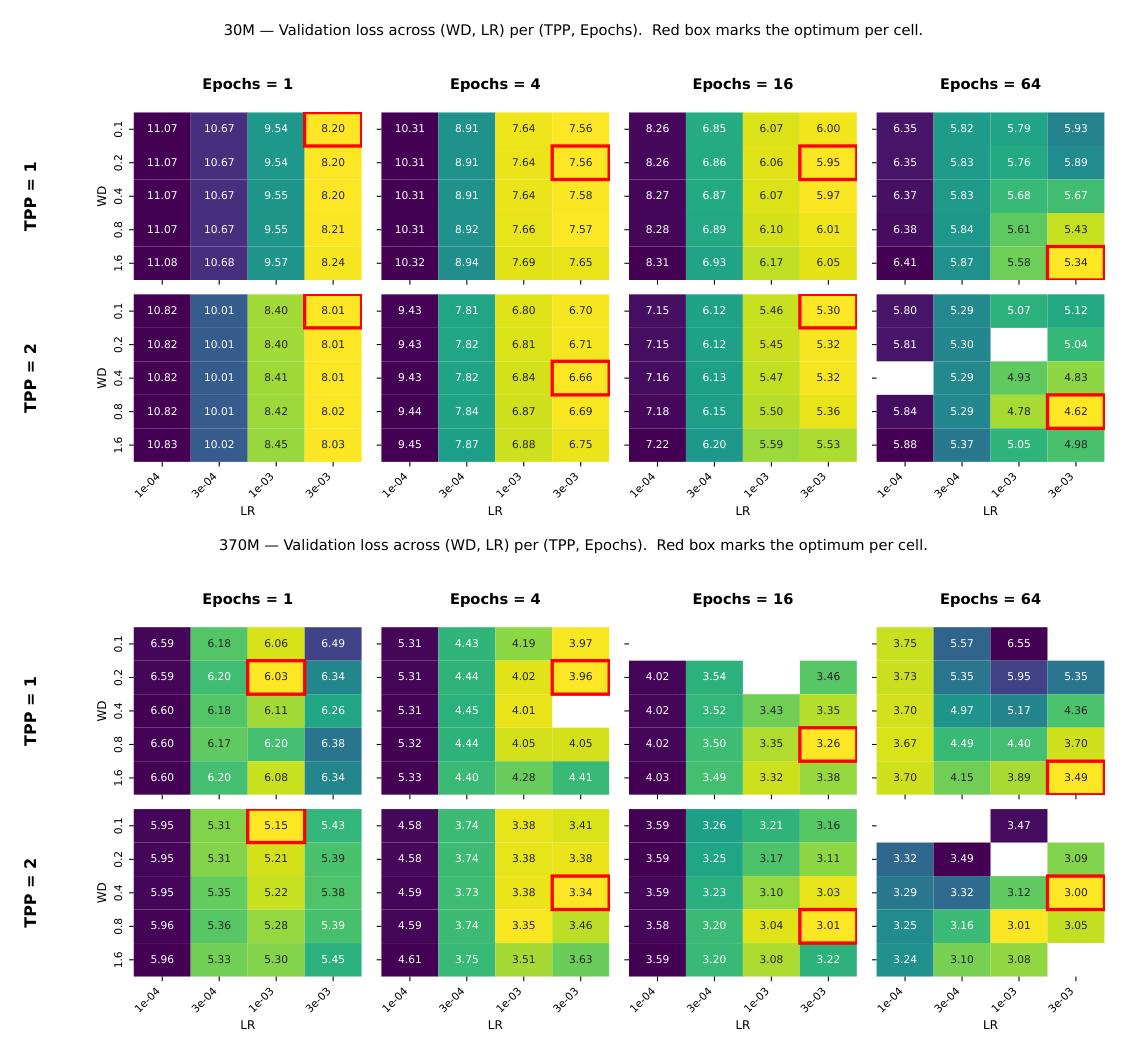
超参网格(Figure 12)本身就是一条独立发现:epoch 数越低所需 weight decay 越小,随着数据重复增加必须提高 weight decay;30M 模型在高 epoch 下需要高达 1.6 的 WD,这与 Kim et al. (2025) 的观察一致。
主要实验结果
拟合质量
Table 1:拟合出的 CD-scaling 参数与 95% CI(上:1-epoch Chinchilla 参数;下:per-strategy CD 参数。RMSE 在 $\log \mathcal{L}$ 上,按 1-epoch / repetition / paraphrase 分开报告)
| $E$ | $A$ | $B$ | $\alpha$ | $\beta$ | RMSE$_{\text{1ep}}$ |
|---|---|---|---|---|---|
| 1.35 [1.0, 1.6] |
205 [90, 676] |
16,597 [7,677, 34,475] |
0.283 [0.22, 0.37] |
0.435 [0.40, 0.47] |
0.043 |
| 策略 | $\log K$ | $\rho$ | $\sigma$ | RMSE |
|---|---|---|---|---|
| Repetition | 10.93 [9.7, 13.5] |
−0.42 [−0.71, −0.15] |
−0.41 [−0.55, −0.35] |
0.035 |
| Paraphrase | 30.50 [30.4, 30.8] |
−1.52 [−1.71, −1.22] |
−1.30 [−1.35, −1.26] |
0.024 |
结论分析:两个策略的 $\rho$ 与 $\sigma$ 都显著为负,这是全文最关键的定量结论——$R^{*}$ 随 TPP 和 $N$ 双双收紧,即用算力替代数据的能力随模型规模和数据可得性同时衰减。改写的衰减指数($\rho=-1.52$、$\sigma=-1.30$)在数值上比重复($-0.42$、$-0.41$)陡峭约 3 倍:改写在小模型 / 低数据预算下天花板极高,但一旦模型变大或数据变多就迅速失效。这直接解释了后面 Figure 4 / Figure 8 的策略交叉边界。
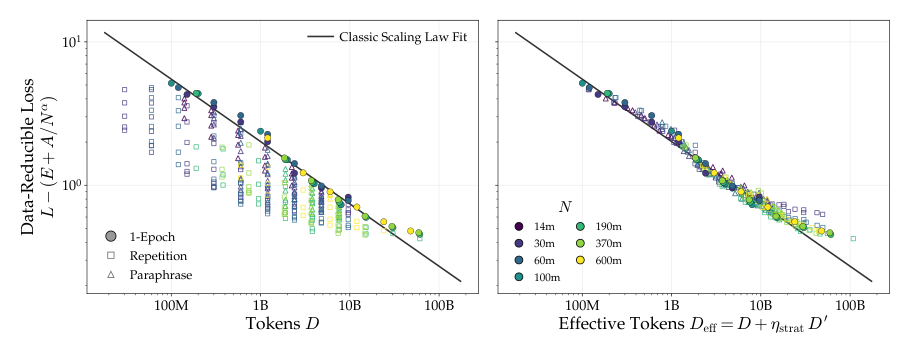
Figure 3 是本文最有说服力的可视化:左图中重复/改写 run 系统性地落在经典 scaling 拟合线之下(因为它们额外训练了 $D'$),右图用 $D_{\text{eff}} = D + \eta_{\text{strat}} D'$ 重新作横轴后,所有策略、所有规模的点重新塌回同一条经典 scaling 直线。这正是 $\eta$ 作为"换算汇率"的语义验证。
跨尺度外推验证
拟合 Eq. (3) 的一个现实动机是:用便宜的小模型 run 预测昂贵的大模型 run。作者仅用 $N \in \{14, 30\}$M 重新拟合,然后预测 $N \in \{60, 100, 190, 370, 600\}$M 的留出 loss。留出集的模型规模比拟合中用到的任何规模都大 2–20 倍,TPP 高达约 160(8× Chinchilla),$r$ 高达 63(64 epochs)。
Table 5/6:跨拟合集规模的验证(在 $N \le N_{\max}$ 上重拟合,预测所有 $N > N_{\max}$ 的留出点,RMSE 报告在 $\log \mathcal{L}$ 上)
| $N_{\max}$ | 拟合用规模 | $n_{\text{fit}}$ | $n_{\text{held}}$ | $\beta$ | in-sample RMSE | held-out RMSE |
|---|---|---|---|---|---|---|
| 30M | 14M, 30M | 103 | 204 | 0.34 | 0.048 | 0.079 |
| 60M | 14M, 30M, 60M | 173 | 134 | 0.35 | 0.047 | 0.049 |
| 100M | 14M, 30M, 60M, 100M | 180 | 127 | 0.35 | 0.046 | 0.050 |
| 190M | 14M, 30M, 60M, 100M, 190M | 235 | 72 | 0.49 | 0.054 | 0.057 |
结论分析:最小拟合集(仅 14M+30M)的留出 RMSE 为 0.079,对比 in-sample 0.048;一旦 $N_{\max} \ge 60$M,留出 RMSE 就落到 0.049–0.057,与 in-sample RMSE 同量级,且恢复出的 $\beta$ 与全量拟合值相差在 0.03 以内。这说明 CD-scaling law 能跨一个数量级的模型规模稳定外推——从业者可以在小模型上以适度预算拟合 Eq. (3),然后直接读出生产规模下的 $R^{*}(D, N)$,预判额外数据还能带来多少 loss 下降。
消融:函数形式的选择
Table 3:$\eta$ 的函数形式排名(在 108 个多 epoch 点上的 LOO RMSE,backbone $(B,\beta)$ 冻结在 Stage-1 锚点;$\log R^* = \log K + \rho\log(D/N) + \sigma\log N$)
| 形式 | $\eta \cdot r$ 的形状 | $n_{\text{par}}$ | LOO RMSE |
|---|---|---|---|
| constant $\eta$ | $c\,r$ | 1 | 0.035 |
| power in $r$ | $c\,r\cdot r^{-\gamma}$ | 2 | 0.032 |
| sat in $r$ | $c\,r/(1 + b\,r)$ | 2 | 0.029 |
| exp-decay, $R(D/N)$ | $\eta_0\, r \cdot e^{-r/R}$ | 3 | 0.026 |
| sat $\times (D/N)$, $b(N)$ | $c(D/N)^{-\gamma} r/(1 + b_0 (N/N_0)^{\kappa} r)$ | 4 | 0.029 |
| exp-sat, $R^{*}(D/N)$ | $R^{*}(1 - e^{-r/R^{*}})$ | 2 | 0.026 |
| sat, $R^{*}(D,N)$ | $R^{*} r/(R^{*} + r)$ | 3 | 0.021 |
| exp-sat, $R^{*}(D,N)$(本文) | $R^{*}(1 - e^{-r/R^{*}})$ | 3 | 0.020 |
| tanh, $R^{*}(D,N)$ | $R^{*}\tanh(r/R^{*})$ | 3 | 0.019 |
结论分析:凡是让 $R^{*}$ 通过 Eq. (5) 依赖 $(D,N)$ 的三种形式(sat、exp-sat、tanh)在任意参数量下都碾压其余形式。常数-$R^{*}$ 基线(即 Muennighoff et al., 2025)在相同参数量下 LOO RMSE 相对高约 40%,被明确拒绝——这证实 $R^{*}$ 的 $(D,N)$ 依赖是承重结构,而非锦上添花。本文选择 exp-sat 而非 LOO RMSE 微弱更优的 tanh($\Delta = 0.001$,统计上不可区分),理由是它是 data-repetition 的规范形式、精确满足 $\eta(0)=1$、且从下方单调逼近 $R^{*}$ 渐近线。
Table 4:$R^{*}$ 的逐项消融(固定 exp-sat 形状,从 $\log R^{*}$ 中移除各项)
| 消融 | $\log R^{*}$ | LOO RMSE |
|---|---|---|
| 原始 | $\log K + \rho\log(D/N) + \sigma\log N$ | 0.020 |
| ↳ 移除 $N^{\sigma}$ | $\log K + \rho\log(D/N)$ | 0.026 |
| ↳ 移除 $(D/N)^{\rho}$ | $\log K + \sigma\log N$ | 0.025 |
| ↳ 移除二者 | $\log K$ | 0.028 |
结论分析:两个指数各自单独必要,同时使用严格优于任一单独使用;移除二者即退回常数-$R^{*}$ 基线。Figure 2(a,c) 给出了机制解释:$\eta$ 对 $D/N$ 的依赖与对 $N$ 的依赖不可互相吸收——TPP 刻画数据可得性,$N$ 刻画模型容量,两者在饱和行为上扮演不同角色。
策略对比:饱和天花板 $R^{*}$
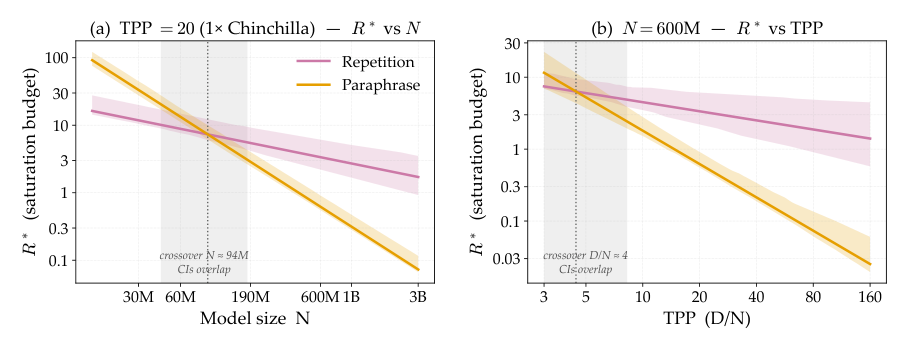
因为拟合的是 $R^{*}$ 而非只有点估计,作者可以进一步问策略差异是否统计显著。在 Chinchilla 最优预算(TPP $=20$)下,重复与改写的 CI 在交叉点附近($N \approx 94$M)重叠,但改写在 $N \lesssim 50$M 显著取胜、重复在 $N \gtrsim 190$M 显著取胜;固定 $N = 600$M 时,小 TPP 处 CI 重叠(改写并无显著优势),TPP $\gtrsim 8$ 之后重复显著取胜。
Loss 到下游能力的传导
一个自然的质疑是:CD-scaling law 全程用 validation loss 说话,但不同训练方式(尤其是改写数据)下,loss 还是不是下游能力的有效代理?
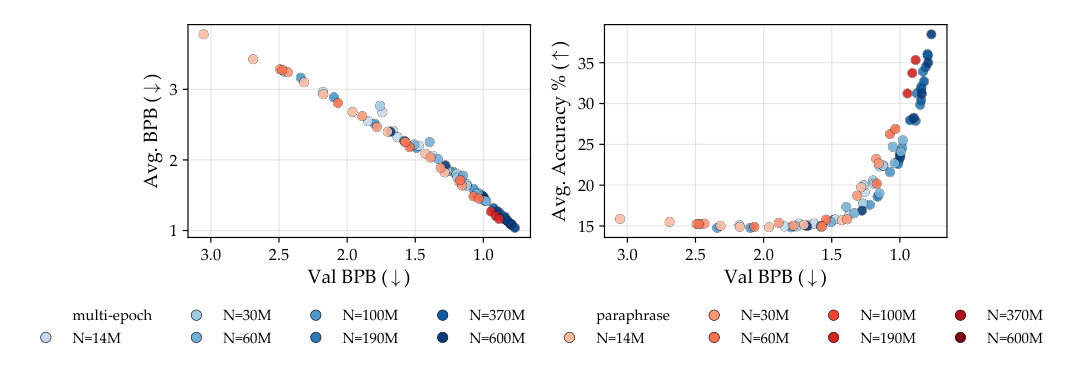
评测分两组:GSM8K、TriviaQA、HumanEval 等在中小规模上准确率近乎随机,故沿用 Gadre et al. (2024) 的做法改写为语言建模任务,报告给定 prompt 下 gold response 的 BPB(bits-per-byte)——它在小规模上仍具区分度;准确率类任务则报告 LAMBADA、HellaSwag、OpenBookQA、RACE、SQuAD 的平均准确率。
结论分析:两组指标下,所有策略、所有模型规模的 run 都落在以 validation BPB 为自变量的单一曲线上。这意味着 validation loss 是下游能力的充分统计量(sufficient statistic),与训练配置无关。这条结论对全文至关重要——它使得"用 loss 做优化目标"的整套 CD 框架具有下游意义,而不是只在优化一个代理数字。
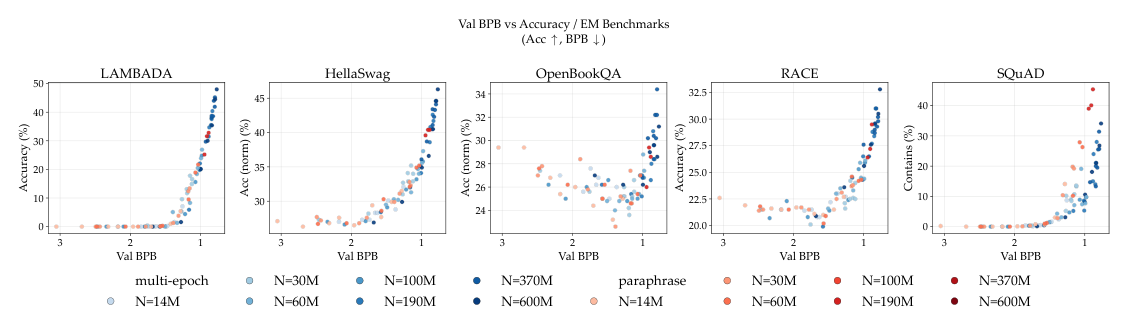
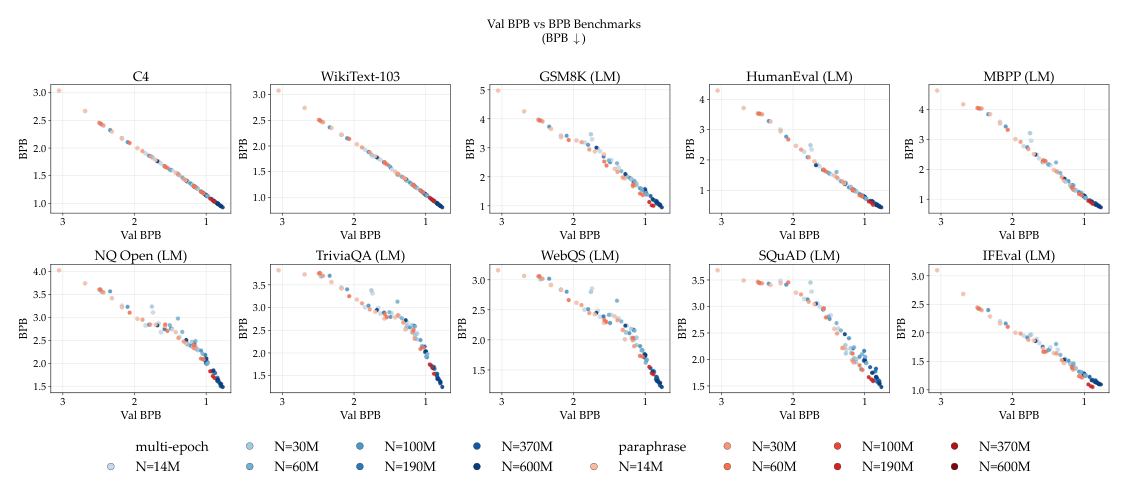
逐任务分解(Figure 9 / Figure 10)进一步确认:这不是平均值掩盖了个别任务的错位——每一个任务上都成立。
CD-Scaling Law 的三条推论
推论一:Compute-Data Pareto 最优分配
在 Chinchilla scaling 下,算力由 $(N,D)$ 通过 $C \approx 6ND$ 唯一确定,没有自由度。而把 $C$ 从 $D$ 解耦(通过多 epoch 或改写)后就多出一个维度,得到 $(C, D)$ 上的二维 loss 曲面,其中 $C \approx 6N(D + D')$。
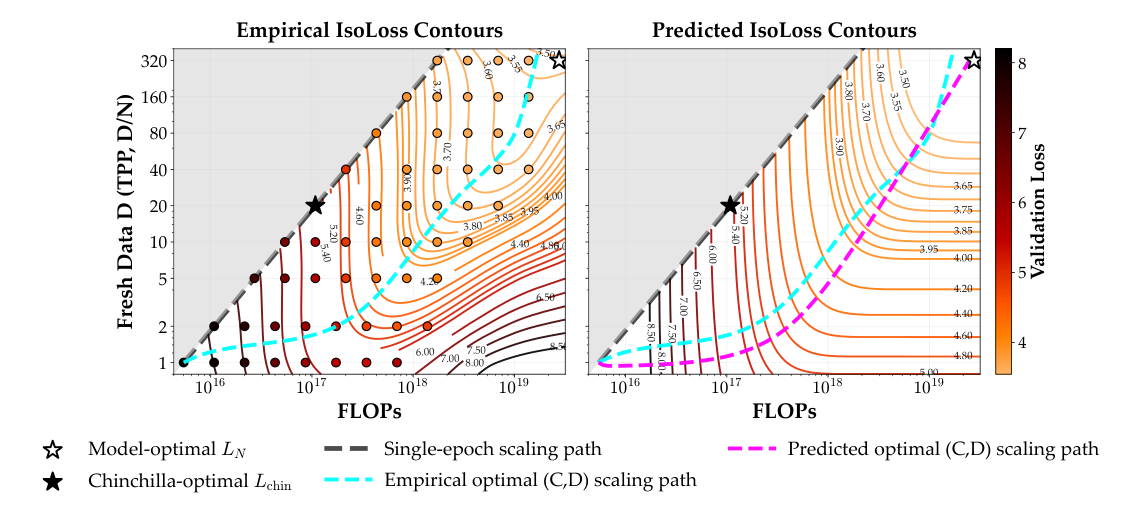
经验 Pareto 前沿是非平凡的:青色曲线沿经验曲面做最陡下降追踪出 loss 最小化路径。沿着它,等高线在两个方向上都急剧弯折,意味着单独增加 $C$ 或单独增加 $D$ 都几乎不改变 loss——既然任一资源都无法单独降 loss,这条线就是真正的 compute-data Pareto 前沿。它给出的资源分配指导是:
- 数据稀缺、低算力区(左下):增加算力远比增加新鲜数据有效,即便在数据本来就稀缺时也是如此;
- 随 $C$ 增长,前沿转向等比例扩算力与数据;
- 再往后进入新鲜数据主导的盆地,进一步增加算力收益递减。
CD-scaling law 预测的最陡下降路径(右图品红线)与经验 Pareto 曲线高度吻合,从而把 Chinchilla 的纯算力优化推广成联合 compute–data 优化。
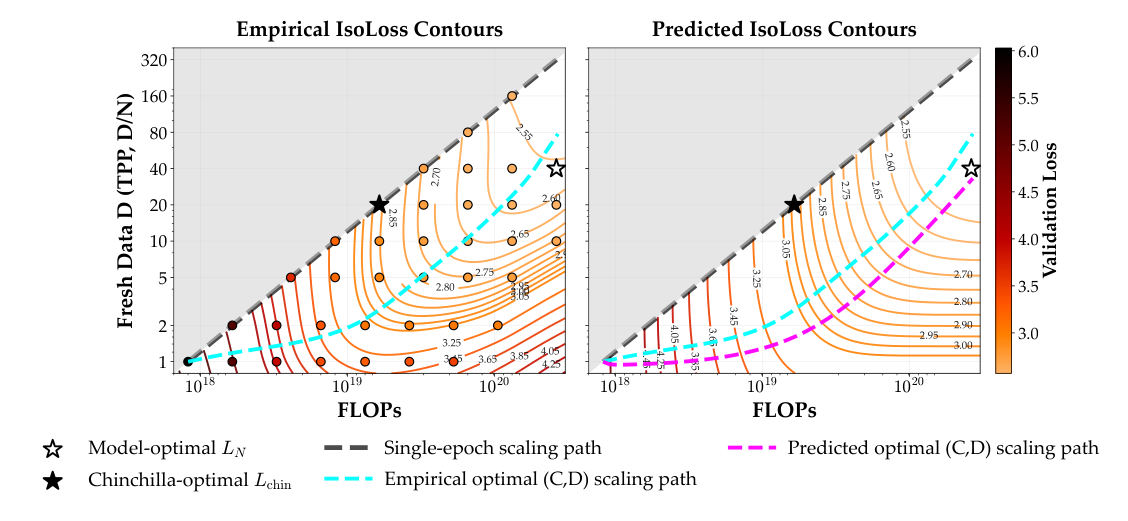
Figure 11 在 $N = 370$M 上复现了同样结论,说明该现象不是 30M 特有的。
推论二:三个训练区间
把 validation loss 对新鲜数据(而非训练算力)作图,用颜色表示算力预算 $C \approx 6N(D+D')$,CD-scaling 的三个极限 $\mathcal{L}^{\text{Chin}}$($D'=0$)、$\mathcal{L}^{D}$($D' \to \infty$)、$\mathcal{L}^{N}$($D \to \infty$)就成为三条边界曲线,把 $(\mathcal{L}, D)$ 平面切成三个区域:
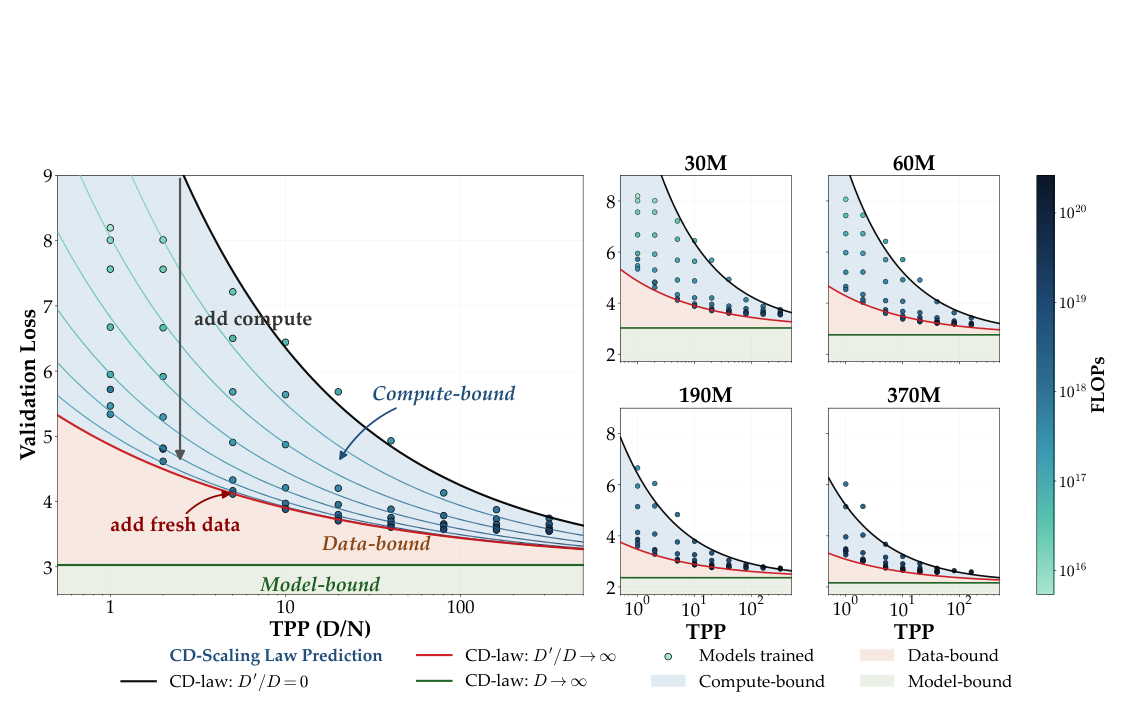
- Compute-bound(介于 $\mathcal{L}^{\text{Chin}}$ 与 $\mathcal{L}^{D}$ 之间):给定 $D$,额外的 $D'$ 仍能降 loss,算力是约束资源;
- Data-bound(介于 $\mathcal{L}^{D}$ 与 $\mathcal{L}^{N}$ 之间):$D'$ 已饱和到 $R^{*}D$,只有新增数据才能继续降 loss;
- Model-bound(在 $\mathcal{L}^{N}$ 处):算力与数据都已饱和,模型容量 $N$ 是约束资源。
关键验证:预测的 data-optimal 前沿 $\mathcal{L}^{D}$ 与训练 run 观测到的 $D' \to \infty$ 渐近线重合,说明 CD-scaling 的饱和极限正确刻画了经验极限。
Compute-bound 区间随 TPP 与 $N$ 同时收缩:$\mathcal{L}^{\text{Chin}}$ 与 $\mathcal{L}^{D}$ 之间的垂直间隙由 $R^{*}$ 决定。$R^{*}$ 大时 data-optimal 前沿远低于 compute-optimal 前沿,此时花在 $D'$ 上的算力回报丰厚;$R^{*}$ 小时两条前沿几乎重合,花在 $D'$ 上的算力基本无效。Figure 7 左右两图分别确认了拟合出的 CD-scaling law 正确刻画了这种沿 TPP 和沿 $N$ 的收缩速率。
推论三:何时重复、何时改写、各做多少
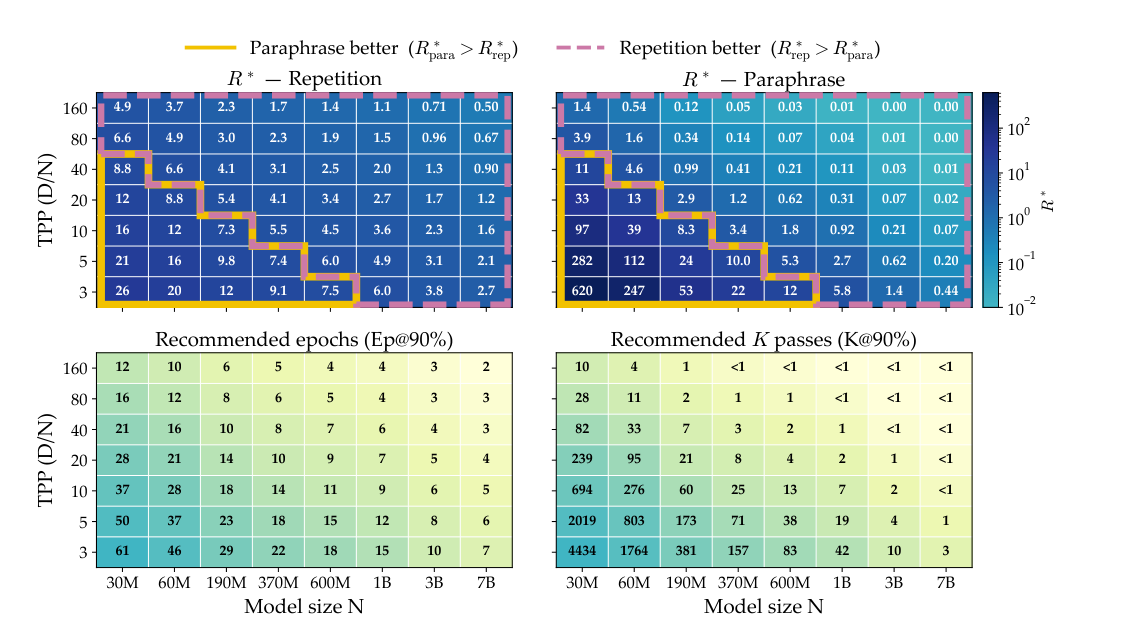
Table:饱和天花板 $R^{*}$ — Repetition(行为 TPP $=D/N$,列为模型规模 $N$)
| TPP \ $N$ | 30M | 60M | 190M | 370M | 600M | 1B | 3B | 7B |
|---|---|---|---|---|---|---|---|---|
| 160 | 4.9 | 3.7 | 2.3 | 1.7 | 1.4 | 1.1 | 0.71 | 0.50 |
| 80 | 6.6 | 4.9 | 3.0 | 2.3 | 1.9 | 1.5 | 0.96 | 0.67 |
| 40 | 8.8 | 6.6 | 4.1 | 3.1 | 2.5 | 2.0 | 1.3 | 0.90 |
| 20 | 12 | 8.8 | 5.4 | 4.1 | 3.4 | 2.7 | 1.7 | 1.2 |
| 10 | 16 | 12 | 7.3 | 5.5 | 4.5 | 3.6 | 2.3 | 1.6 |
| 5 | 21 | 16 | 9.8 | 7.4 | 6.0 | 4.9 | 3.1 | 2.1 |
| 3 | 26 | 20 | 12 | 9.1 | 7.5 | 6.0 | 3.8 | 2.7 |
Table:饱和天花板 $R^{*}$ — Paraphrase
| TPP \ $N$ | 30M | 60M | 190M | 370M | 600M | 1B | 3B | 7B |
|---|---|---|---|---|---|---|---|---|
| 160 | 1.4 | 0.54 | 0.12 | 0.05 | 0.03 | 0.01 | 0.00 | 0.00 |
| 80 | 3.9 | 1.6 | 0.34 | 0.14 | 0.07 | 0.04 | 0.01 | 0.00 |
| 40 | 11 | 4.6 | 0.99 | 0.41 | 0.21 | 0.11 | 0.03 | 0.01 |
| 20 | 33 | 13 | 2.9 | 1.2 | 0.62 | 0.31 | 0.07 | 0.02 |
| 10 | 97 | 39 | 8.3 | 3.4 | 1.8 | 0.92 | 0.21 | 0.07 |
| 5 | 282 | 112 | 24 | 10.0 | 5.3 | 2.7 | 0.62 | 0.20 |
| 3 | 620 | 247 | 53 | 22 | 12 | 5.8 | 1.4 | 0.44 |
结论分析:两张表的对比极为直观。改写的 $R^{*}$ 在小模型 + 低 TPP 的左下角高得惊人(30M、TPP=3 时 $R^{*}=620$,意味着理论上可从语料榨出 620 倍的等效新鲜 token),但沿两个方向衰减极快——到 7B、TPP=160 时已趋近 0.00,完全失效。重复的 $R^{*}$ 则平缓得多(从 26 衰减到 0.50)。两者的交叉边界(图中黄/粉分界线)呈明显的阶梯状:改写在左下(小 $N$、低数据预算)取胜,重复在右上取胜。
Table:推荐 epoch 数(Ep@90%,重复策略达到 90% $R^{*}$ 所需)
| TPP \ $N$ | 30M | 60M | 190M | 370M | 600M | 1B | 3B | 7B |
|---|---|---|---|---|---|---|---|---|
| 160 | 12 | 10 | 6 | 5 | 4 | 4 | 3 | 2 |
| 80 | 16 | 12 | 8 | 6 | 5 | 4 | 3 | 3 |
| 40 | 21 | 16 | 10 | 8 | 7 | 6 | 4 | 3 |
| 20 | 28 | 21 | 14 | 10 | 9 | 7 | 5 | 4 |
| 10 | 37 | 28 | 18 | 14 | 11 | 9 | 6 | 5 |
| 5 | 50 | 37 | 23 | 18 | 15 | 12 | 8 | 6 |
| 3 | 61 | 46 | 29 | 22 | 18 | 15 | 10 | 7 |
Table:推荐改写 pass 数(K@90%)
| TPP \ $N$ | 30M | 60M | 190M | 370M | 600M | 1B | 3B | 7B |
|---|---|---|---|---|---|---|---|---|
| 160 | 10 | 4 | 1 | <1 | <1 | <1 | <1 | <1 |
| 80 | 28 | 11 | 2 | 1 | 1 | <1 | <1 | <1 |
| 40 | 82 | 33 | 7 | 3 | 2 | 1 | <1 | <1 |
| 20 | 239 | 95 | 21 | 8 | 4 | 2 | 1 | <1 |
| 10 | 694 | 276 | 60 | 25 | 13 | 7 | 2 | <1 |
| 5 | 2019 | 803 | 173 | 71 | 38 | 19 | 4 | 1 |
| 3 | 4434 | 1764 | 381 | 157 | 83 | 42 | 10 | 3 |
三条实践要点:
- 推荐 epoch 数随模型规模与数据预算增长而下降。把拟合的 law 外推到大模型规模表明,广为流传的 "4-epoch 法则" 只对中等规模模型(约 3B)、约 1× Chinchilla 数据规模成立——在 7B、TPP=160 处推荐值已降到 2 epoch,而在 30M、TPP=3 处高达 61 epoch。
- 小模型与小数据预算下应优先改写。具体地,改写在 $N \lesssim 600$M 且数据预算 $< 1\times$ Chinchilla 时胜过重复。
- 外推表明改写在 $N \ge 7$B 且大数据预算($\ge 4\times$ Chinchilla)下失效。
核心贡献总结
- CD-scaling law(Eq. 2):以 8 个常数统一 compute-optimal($D'=0$)、data-optimal($D'\to\infty$)、model-bound($D\to\infty$)三个极限,把 Hoffmann et al. (2022)、Muennighoff et al. (2025)、Kim et al. (2025) 三条线索收编为特例。
- token 有效性函数 $\eta$ 的可辨识函数形式:指数饱和形式(Eq. 3)+ 幂律饱和天花板 $R^{*}(D,N)$(Eq. 5),并通过 9 种候选形式的 LOO 排名与逐项消融证明 $(D,N)$ 依赖是承重的。
- "用算力换数据的能力随规模衰减"这一定量结论:$\rho, \sigma$ 显著为负,且改写的衰减比重复陡约 3 倍。
- 可外推性:仅用 14M–60M 的小模型 run 拟合即可在大一个数量级的规模上保持 RMSE 0.049–0.057。
- 可直接查表的工程处方:$N \times$ TPP 网格上的 $R^{*}$、推荐 epoch 数、推荐改写 pass 数。
与已归档相关工作的对比
Prescriptive Scaling Laws for Data Constrained Training Prescriptive Scaling Laws for Data Constrained Training (Cornell University, 2026-05-02)
关系:显式引用但原文未展开对比(Related Work 中仅一句话带过,无方法/指标层比较)· 已加载对方精读
-
共同关注的问题:两篇论文指向完全相同的 root cause——算力增长快于高质量数据供给,Chinchilla 的"每个 token 只看一次"假设在数据受限区间失效,因而需要一条能描述"在固定语料上继续投入算力"的 scaling law。两者都以 Muennighoff et al. (2023/2025) 的 effective-data 形式为主要靶子,都指出该形式在高重复区系统性地失真。
-
相近的技术骨架:两者的方法流程图高度重合——(1) 在 $(N, U_D/D, \text{重复或扩增量})$ 三维网格上训练数百个模型(本文 341 个拟合点跨 14M–600M;Lovelace 300+ 模型跨 15M–1B);(2) 先在 1-epoch run 上锚定 Chinchilla 常数;(3) 做残差分析找出重复带来的额外代价的函数形式;(4) 用 Huber loss 在 log 空间联合拟合;(5) 由拟合出的 law 反解 compute-optimal 分配处方并给出工程建议。连技术细节都撞车:都用 Huber loss、都以残差分析驱动函数形式选择、都发现强 weight decay 显著改善模型对重复的鲁棒性(本文 Figure 12 观察到重复越多所需 WD 越高、30M 需要 WD 1.6;Lovelace 定量证明 $\lambda=1.0$ 把过拟合系数 $P$ 削减约 70%)。
-
本文的差异与推进:分歧在把重复的代价放在公式的哪一侧。Lovelace 用加性过拟合惩罚项 $P \cdot R_D^{\delta} \cdot (N/U_D^{\gamma})^{\kappa}$ 附加在 Chinchilla 之外,重复 token 被赋予双重角色(继续降低数据项,同时累积惩罚);本文则用乘性有效性函数 $\eta$ 直接折算 derived token 的"汇率",把一切压进数据项内部。这带来两条实质差异:(1) 本文的形式在结构上无法表达 loss 随 epoch 回升——$\eta \in [0,1]$ 只能让 loss 单调趋近 $\mathcal{L}^{D}$ 渐近线,而 Lovelace 的加性惩罚正是为捕捉"loss 先降后升"而设计的(其 Figure 3 显示 $N=500$M 处观测 loss 明显回升,只有加性惩罚能跟上);(2) 反过来,本文的框架覆盖了重复之外的 derived-token 策略(改写),并用同一函数族参数化不同策略,还额外推导出 data-optimal 闭式 $\mathcal{L}^{D}$ 与 compute/data/model-bound 三区间划分——这些 Lovelace 都没有。
-
可比的方法/实验差异:语料上本文用 Dolma-3(OLMo3 架构),Lovelace 用 FineWeb sample-10BT(Llama 2 架构,序列长度 512 vs 本文 4096)。规模上 Lovelace 上探到 1B 且做了 prescriptive validation(把各 law 推荐的配置真训出来对比:$U_D=500$M、$C=2\times10^{19}$ 时其推荐的 2.2B×3ep 达到 perplexity 17.73,优于 Chinchilla 推荐的 670M×10ep 的 18.90),本文止步 600M 且未做这类"按处方训练"的闭环验证,只做了留出集 RMSE 外推。两者的工程结论方向一致但侧重不同:Lovelace 强调"超过某个算力阈值后应扩模型、减 epoch"(前沿回弯);本文强调"推荐 epoch 数随 $N$ 与 TPP 增大而下降,4-epoch 法则只对约 3B / 1× Chinchilla 成立"——两者本质上是同一现象的两种表述,一个从过拟合惩罚看,一个从有效性饱和看,构成一组罕见的相互印证的独立并发证据。
被剔除的近似候选(说明门槛):
- Compute Optimal Tokenization(FAIR at Meta,BLT 字节级 scaling law):同样是"给 Chinchilla 增加一个轴并重拟合",但 root cause 是 tokenizer 导致 token 单位不可比(把 20 tokens/param 推广为 ~60 bytes/param),与"新鲜数据有限"无关,也不存在 derived-token / 数据扩增的概念 → 剔除。
- Scaling Laws for Behavioral Foundation Models over User Event Sequences(Unbox AI,行为基础模型 scaling law):同为 compute-optimal $D/N$ 配比研究且同样发现"评测指标本身是 scaling law 的一部分",但问题域是推荐行为序列建模的 embedder/backbone 参数分配,完全没有数据受限、重复或合成扩增的维度 → 剔除。
- MEDA(MEDA,Kuaishou):问题面上确实是"多 epoch 重复训练撞上过拟合墙",与本文 $\eta$ 衰减 / $R^{*}$ 饱和现象同源,但解法是"每个 epoch 重新初始化 embedding 层"这一训练技巧,不是可外推的参数化定律,方法流程图无法与本文抽象重合 → 剔除。
- Scaling Properties of Continuous Diffusion Spoken Language Models(Apple,连续扩散语音语言模型 scaling law):仅共享"拟合 scaling law + isoFLOP 分析"这一过宽共性,任务域与 root cause 均不同 → 剔除。
讨论与局限性
值得借鉴的设计
- 把"策略"参数化进定律而非并列比较。本文最漂亮的一步是不把重复和改写当成两个要横向评测的方案,而是当作同一条定律的两组参数 $(K, \rho, \sigma)$。这样一来"哪个策略更好"就从主观判断变成了 $R^{*}_{\text{rep}}$ 与 $R^{*}_{\text{para}}$ 的数值比较,还能借重采样 CI 回答"差异是否显著"——这是把方法论从 benchmark 竞赛提升为可测量科学的范式。
- $\eta$ 作为"汇率"的语义。Figure 3 右图那种"换算后所有点塌回同一条线"的验证方式,比任何拟合优度数字都更有说服力,值得在其他建模工作中复用。
- 换元的选择。把 $\eta$ 参数化为 $(N, \text{TPP}, r)$ 而非 $(N, D, D')$ 看似只是换元,实则决定了外推行为——Table 4 证明 TPP 依赖与 $N$ 依赖不可互相吸收。
局限与争议
- $\eta$ 会吸收 1-epoch 拟合的残差,因而 $\eta_{\text{emp}}$ 可以超过 1(作者自陈)。这意味着整套拟合的质量受制于 1-epoch run 的质量:如果基线 scaling law 在某个区域拟合不准,误差会被记账成"derived token 特别有效/无效"。这是乘性折算方案相对加性惩罚方案的结构性弱点。
- 无法表达 loss 回升。如上文对比所述,$\eta \in [0,1]$ 的形式只能单调逼近 $\mathcal{L}^{D}$,无法刻画过度重复导致 loss 实际上升的区间。在极高 epoch 或强过参数化场景下,这个模型会系统性地过于乐观。
- 超参搜索只覆盖 lr 与 weight decay。batch size、序列长度、schedule 全部固定,而它们原则上都会与 $\eta$ 交互——尤其考虑到 Figure 12 已显示 WD 与重复次数强烈耦合,其他正则化超参很可能同样耦合。
- 改写的算力口径存疑。作者明确不把改写生成的 FLOPs 计入训练算力,理由是可异步离线完成。但用 SmolLM2-1.7B-Instruct 为每篇文档生成最多 16 个改写版本,其推理成本在小模型场景下可能超过训练本身——考虑到 30M/TPP=3 的推荐 pass 数高达 4434,这个口径下"改写在小模型上大胜"的结论需要谨慎解读。这是本文最值得商榷的一处。
- 规模天花板。实证只到 600M,7B 及以上的结论(包括"改写在 $N\ge7$B 失效"这一颇具实践指导性的论断)全部依赖外推。作者坦承即便消耗了超过 250k H100-hours,也只能在中小规模上为两种策略拟合定律。这也是与 Lovelace(上探 1B 且做了按处方训练的闭环验证)相比最明显的短板。
- 仅覆盖两种扩增策略。自蒸馏、合成结构化数据(Lee et al., 2026)等均未探索;策略组合是否能产生高于任一单一策略的有效 $\eta$,也完全是开放问题。
未来方向
作者点出的最有价值的延伸是:从语料统计量直接预测 $\eta$。目前 $\eta$ 必须逐策略经验拟合(代价是 250k H100-hours),若能用 token 多样性、$n$-gram 重叠、困惑度分布等摘要统计量预测 $\eta$,从业者就能在投入算力之前评估某个扩增策略在给定语料上的价值——这会让整个框架从"事后解释"变成"事前决策工具",实用性提升一个量级。
对推荐/工业场景的迁移价值
尽管本文是纯 LLM 预训练的学术研究(无工业 A/B),其框架对推荐系统的大模型化有直接迁移价值:推荐场景同样面临"算力充裕但高质量行为数据有限"的结构,且多 epoch 重复训练(参见 MEDA)与合成数据增强(参见 SCALR)都是既有实践。$R^{*}(D,N) = K(D/N)^{\rho}N^{\sigma}$ 这一"饱和天花板随模型规模与数据可得性双向收紧"的形式,以及"先扩算力、再等比例扩数据与算力"的 Pareto 路径,都可以作为推荐大模型算力/数据配比决策的先验假设去验证。