Kimi K3: Open Frontier Intelligence 精读¶
Kimi Team(Moonshot AI / 月之暗面)· arXiv:2607.24653 · 2026-07-27 · 47 页技术报告 2.8T 总参数 / 104B 激活参数原生多模态 MoE,1M token 上下文,权重全量开源
研究动机与背景¶
论文开篇给出了一个非常明确的问题陈述:LLM 的 scaling 有两条轴,而开源生态在这两条轴上的进展严重失衡。
第一条轴是部署前的训练侧 scaling——把模型做得更大、数据喂得更多(Kaplan、Hoffmann 的经典 scaling law 路线)。第二条轴是测试时计算(test-time computation):OpenAI 的 o 系列把 RL 与 test-time reasoning 作为第二条 scaling 轴;Anthropic 的 extended thinking 让模型自适应分配思考预算并把 thinking 与 tool use 交错;DeepSeek-R1 与 Kimi K1.5 证明大规模 RL 能从强预训练底座里诱导出复杂推理行为;Kimi K2.5 Agent Swarm 进一步把 test-time scaling 从"顺序推理"推进到"并行 agent 协作"。
作者指出的失衡在于:开源生态在第二条轴上追赶很快,但在第一条轴上进展缓慢——大量近期开源模型仍停留在 1T 参数级或略高的区间。而当越来越成熟的推理与 agentic RL 方法被施加到规模相近的预训练底座上时,"开源进展会趋于收敛,而与最强闭源系统的差距被拉大"。这正是 Kimi K3 的动机:两条 scaling 轴同时推——把预训练底座推到前所未有的 3T 级参数,同时 scale RL、reasoning effort,以及 1M 上下文下的长程交互。
把参数推到 3T 级并把上下文拉到 1M,会同时撞上三类结构性瓶颈,Kimi K3 的架构设计正是逐一对应:
- 序列维:标准 softmax attention 的 KV cache 随序列长度线性增长,1M 上下文下不可承受;
- 深度维:标准残差连接把所有前序信息压进单一状态 $h_l$ 沿深度传递,形成"类似 RNN 沿时间的瓶颈";
- 宽度维:把 routed expert 扩到 ~$10^3$ 量级(896 experts / top-16,稀疏度 56)会同时触发两个失效模式——routed 分支内部激活爆炸、以及现有 auxiliary-loss-free 负载均衡的失效。
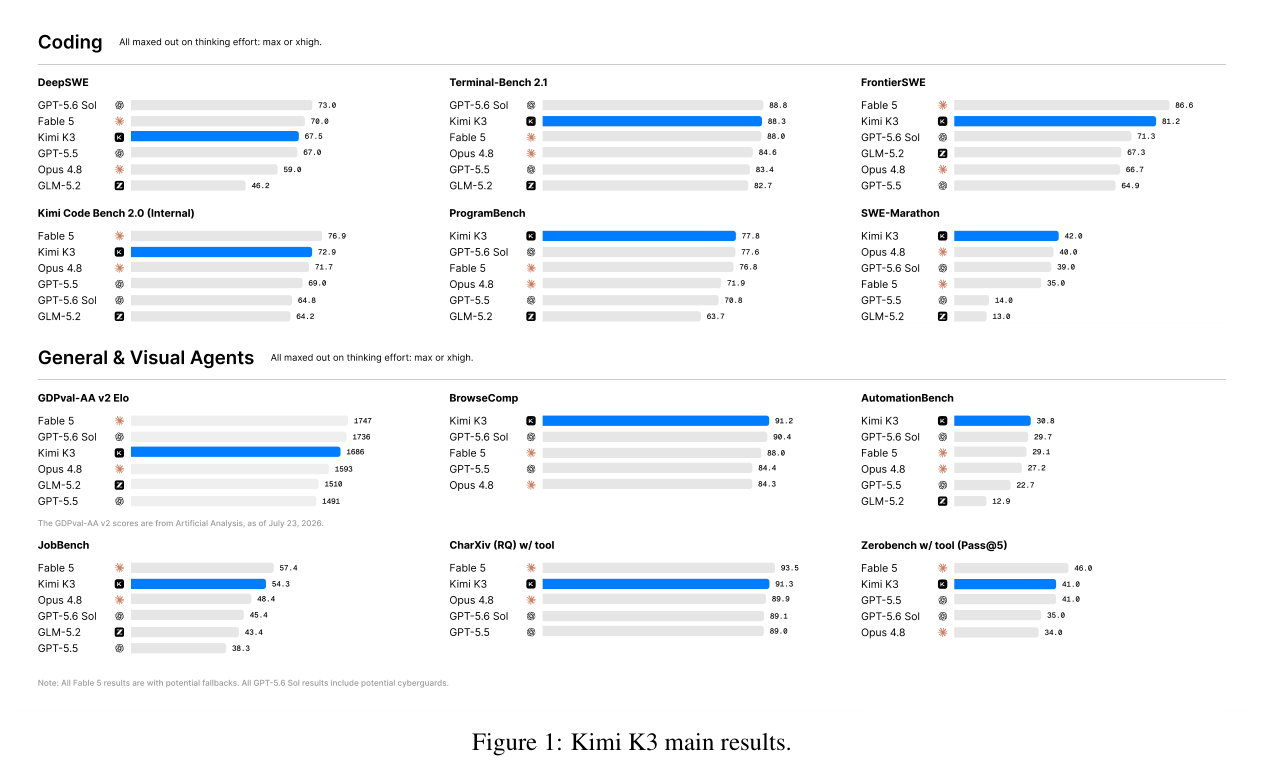
论文的总体结论(Figure 1)是:Kimi K3 在长程 coding、agentic、knowledge、reasoning、vision 五类任务上达到前沿水平,整体上仍落后于最强的两个闭源系统 Claude Fable 5 与 GPT-5.6 Sol,但一致地领先于评测套件中其余所有开源与闭源模型(含 Claude Opus 4.8、GPT-5.5、GLM-5.2)。
论文自陈的四点贡献:
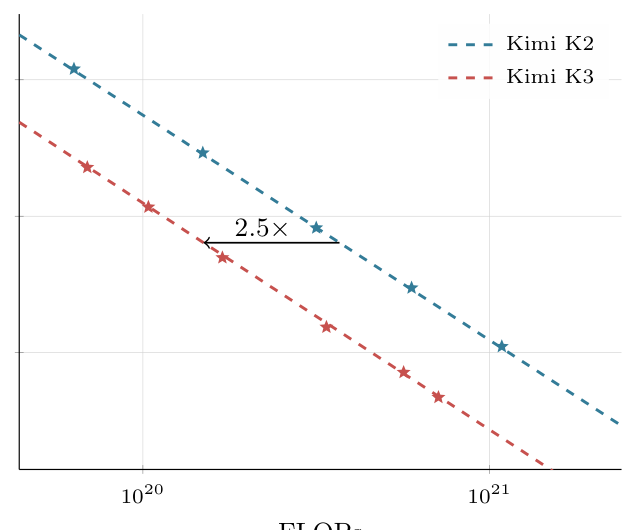
- 开放前沿的预训练:2.8T 参数原生多模态 MoE,104B 激活,1M 上下文;KDA、AttnRes、Stable LatentMoE 加上数据与训练配方改良,整体 scaling 效率相对 Kimi K2 提升约 $2.5\times$;
- 面向多档 effort 的 test-time scaling RL:跨 general / agentic / coding 三域、跨多档 reasoning effort 做 RL,再合并为统一模型;
- 万亿参数 + 百万 token 的基础设施:KDA 的算法—系统协同设计、MoonEP、可恢复 microVM sandbox;
- 开放前沿模型:全量权重开源(HuggingFace
moonshotai/Kimi-K3)。
模型架构¶
Kimi K3 的架构围绕"三个互补维度上的信息流 scaling"组织:序列长度、网络深度、模型宽度。
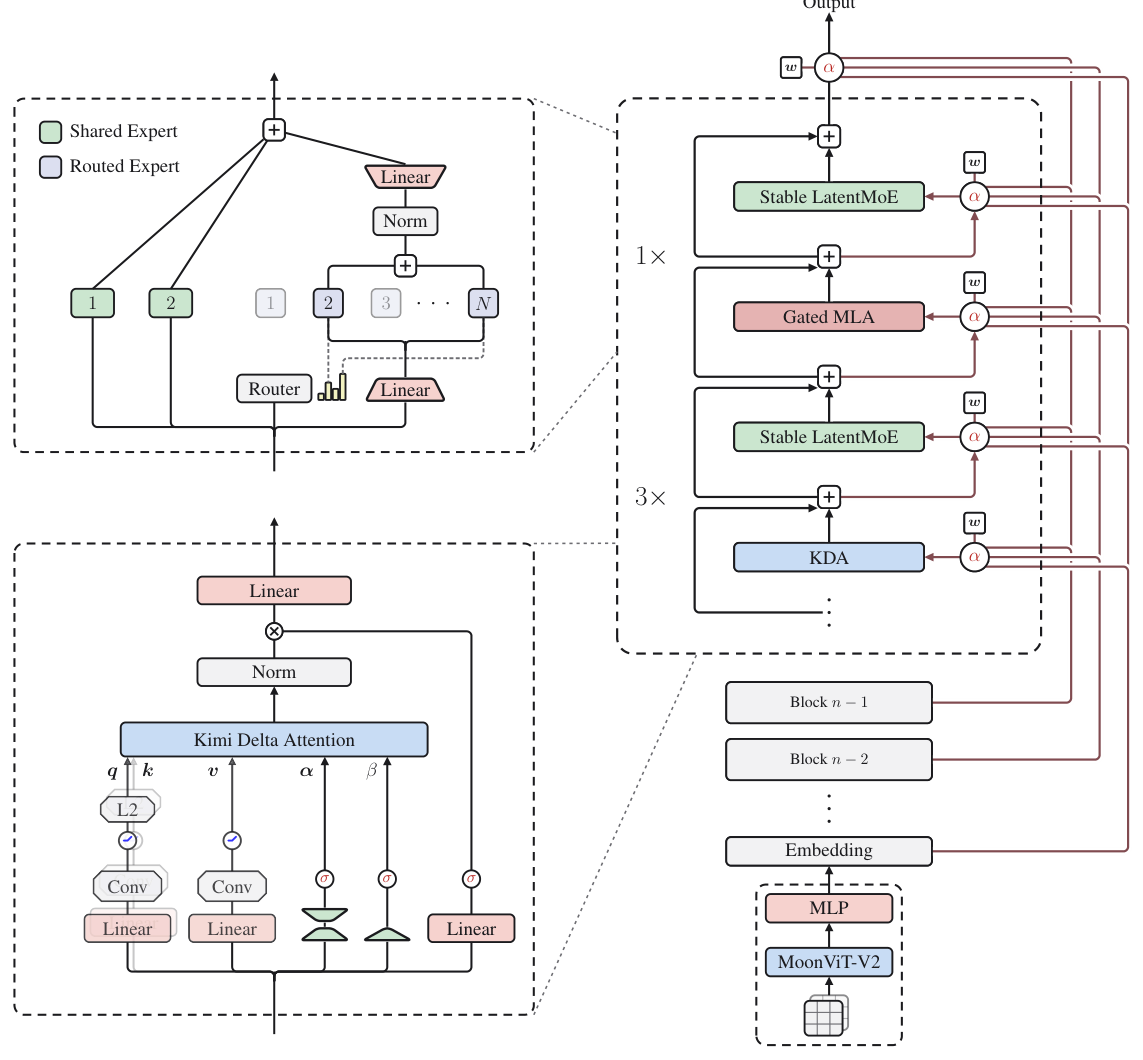
- 序列维:Hybrid Attention——每个 block 内 3 层 KDA + 1 层 Gated MLA(3:1);
- 深度维:Attention Residuals(AttnRes),让每层从 embedding、当前 block、以及所有前序 block 中选择性检索表示,而不是均匀累加;
- 宽度维:每个 attention 层后跟一个 Stable LatentMoE 层做稀疏 channel mixing,896 routed experts / token 激活 16 个;
- 原生视觉:MoonViT-V2 编码图像与视频,轻量 projector 把视觉特征映射到共享 embedding 空间后再进主干。
Hybrid Attention¶
每个 block 是 3 层 KDA 后接 1 层 Gated MLA,整个主干重复该模式;主干末尾额外再放一层 Gated MLA,确保最后一层始终做全局注意力。
Kimi Delta Attention (KDA)¶
KDA 把 delta-rule recurrence 扩展为带channel-wise forget gate 的形式。设隐状态序列 $\boldsymbol{x}_t \in \mathbb{R}^d$($t$ 为 token 位置,$d$ 为模型隐维),单头的 query/key $\boldsymbol{q}_t, \boldsymbol{k}_t \in \mathbb{R}^{d_k}$,value $\boldsymbol{v}_t \in \mathbb{R}^{d_v}$,recurrent state $\mathbf{S}_t \in \mathbb{R}^{d_k \times d_v}$。KDA 在 delta-rule 更新之前先施加 channel-wise 衰减:
$$ \mathbf{S}_t = \left(\mathbf{I} - \beta_t \boldsymbol{k}_t \boldsymbol{k}_t^\top\right)\mathrm{Diag}(\boldsymbol{\alpha}_t)\,\mathbf{S}_{t-1} + \beta_t \boldsymbol{k}_t \boldsymbol{v}_t^\top, \qquad \bar{\boldsymbol{o}}_t = \mathbf{S}_t^\top \boldsymbol{q}_t \tag{1} $$
其中 $\boldsymbol{\alpha}_t \in (0,1)^{d_k}$ 是 channel-wise 的单步保留因子(retention factor),$\beta_t \in (0,1)$ 控制 delta-rule 的写入强度。物理含义:$\mathrm{Diag}(\boldsymbol{\alpha}_t)$ 让状态的每个 key 通道以自己的速率遗忘;$(\mathbf{I} - \beta_t \boldsymbol{k}_t\boldsymbol{k}_t^\top)$ 是沿 $\boldsymbol{k}_t$ 方向的"擦除"投影,配合 $+\beta_t \boldsymbol{k}_t \boldsymbol{v}_t^\top$ 实现"先删旧值再写新值"的 delta 规则。
沿用 Kimi Linear,per-head 量的参数化为:
$$ \begin{aligned} \boldsymbol{q}_t^h, \boldsymbol{k}_t^h &= \mathrm{L_2Norm}\Big(\mathrm{Swish}\big(\mathrm{ShortConv}(\mathbf{W}_{q/k}^h \boldsymbol{x}_t)\big)\Big) \in \mathbb{R}^{d_k},\\ \boldsymbol{v}_t^h &= \mathrm{Swish}\big(\mathrm{ShortConv}(\mathbf{W}_v^h \boldsymbol{x}_t)\big) \in \mathbb{R}^{d_v},\\ \beta_t^h &= \mathrm{Sigmoid}(\mathbf{W}_\beta^h \boldsymbol{x}_t) \in (0,1),\\ \boldsymbol{z}_t^h &= \mathbf{W}_\alpha^{\uparrow}\mathbf{W}_\alpha^{\downarrow}\boldsymbol{x}_t + \boldsymbol{b}_\alpha^h \in \mathbb{R}^{d_k} \end{aligned} \tag{2} $$
即 q/k/v 投影都先过 ShortConv 再过 Swish,q/k 额外做 $\mathrm{L_2Norm}$;低秩投影 $\mathbf{W}_\alpha^{\uparrow}\mathbf{W}_\alpha^{\downarrow}$ 加 head-specific bias $\boldsymbol{b}_\alpha^h$ 产生细粒度的 per-channel decay logit $\boldsymbol{z}_t^h$。
Chunkwise parallel form. KDA 跨 chunk 是 recurrent 的、chunk 内是并行的。对 chunk size $C$,$\mathbf{X}_{[t]}$ 堆叠第 $t$ 个 chunk 内的 token 向量($\mathbf{X} \in \{\mathbf{Q},\mathbf{K},\mathbf{V},\mathbf{O},\mathbf{U},\mathbf{W}\}$),$\mathbf{S}_{[t]} \in \mathbb{R}^{d_k \times d_v}$ 为进入 chunk $t$ 的状态。对 $1 \le i \le j \le C$ 定义 channel-wise 累积衰减:
$$ \boldsymbol{\gamma}_{[t]}^{i \to j} := \prod_{r=i}^{j} \boldsymbol{\alpha}_{[t]}^r, \qquad \boldsymbol{\gamma}_{[t]}^{r} := \boldsymbol{\gamma}_{[t]}^{1 \to r} \tag{3} $$
$\boldsymbol{\Gamma}_{[t]}^{1 \to C} \in \mathbb{R}^{C \times d_k}$ 按行堆叠 $\boldsymbol{\gamma}_{[t]}^1, \ldots, \boldsymbol{\gamma}_{[t]}^C$。UT transform 产出 $\mathbf{U}_{[t]}$ 与 $\mathbf{W}_{[t]}$,由此定义 pseudo-value 项 $\widetilde{\mathbf{V}}_{[t]} := \mathbf{U}_{[t]} - \mathbf{W}_{[t]}\mathbf{S}_{[t]}$。给定入口状态 $\mathbf{S}_{[t]}$,chunk $t$ 的所有输出并行计算为:
$$ \begin{aligned} \mathbf{A}_{[t]} &= \mathrm{Tril}\Big[\big(\mathbf{Q}_{[t]} \odot \boldsymbol{\Gamma}_{[t]}^{1\to C}\big)\big(\mathbf{K}_{[t]} / \boldsymbol{\Gamma}_{[t]}^{1 \to C}\big)^\top\Big],\\ \mathbf{O}_{[t]} &= \underbrace{\big(\boldsymbol{\Gamma}_{[t]}^{1 \to C} \odot \mathbf{Q}_{[t]}\big)\mathbf{S}_{[t]}}_{\text{inter-chunk}} + \underbrace{\mathbf{A}_{[t]}\widetilde{\mathbf{V}}_{[t]}}_{\text{intra-chunk}} \end{aligned} \tag{4} $$
$\mathrm{Tril}(\mathbf{M})$ 把严格上三角置零、保留下三角(含对角线)。保留对角线是因为每个输出读取的是当前 token 更新之后的状态。第一项携带前序 chunk 的信息,第二项负责 chunk 内交互。
Lower-bounded decay(本文关键改动之一). 式 (4) 里 $\mathbf{K}_{[t]}$ 被 $1/\boldsymbol{\Gamma}_{[t]}^{1 \to C}$ 重新缩放。由于 $\boldsymbol{\Gamma}$ 是 $(0,1)$ 内保留因子的乘积,这个倒数可以无界增长并在有限精度下溢出。Kimi Linear 的做法是在 log 空间算相对衰减,并把每个 chunk 再切成 16-token 的二级 tile:非对角 tile 可以直接用 Tensor Core 稠密矩阵乘,但对角 tile 仍需显式的 position-pair 计算,这构成 intra-chunk 的主要瓶颈。
Kimi K3 的解法是改掉从 decay logit $\boldsymbol{z}_t^h$ 到 per-step log-decay $\boldsymbol{g}_t^h$ 的映射。GDN 与 Mamba-2 用的是 negative-Softplus 映射 $\boldsymbol{g}_t^h = -e^{A_h}\mathrm{Softplus}(\boldsymbol{z}_t^h) \in (-\infty, 0)^{d_k}$(无下界);Kimi K3 改用scaled sigmoid 从下方 bound 住 log-decay:
$$ \boldsymbol{g}_t^h = g_{\min}\,\mathrm{Sigmoid}\big(e^{A_h}\boldsymbol{z}_t^h\big) \in (g_{\min}, 0)^{d_k}, \qquad \boldsymbol{\alpha}_t^h = \exp(\boldsymbol{g}_t^h) \in (e^{g_{\min}}, 1)^{d_k} \tag{5} $$
其中 $A_h$ 是可学习的 per-head log-scale,$g_{\min} = -5$ 固定。初始化 $A_h = 0$,$\boldsymbol{b}_\alpha^h$ 沿用 Kimi Linear/GDN/Mamba-2 的方案。取 $g_{\min} = -5$ 时每个保留因子满足 $\alpha_{t,j}^h \ge e^{-5} \approx 6.7 \times 10^{-3}$,一个 16-token tile 上的累积 log-decay 落在 $(-80, 0)$,对应的倒数重缩放因子小于 $e^{80}$,仍在 BF16 动态范围内。这个有限范围让对角与非对角 tile 都能用稠密 Tensor Core 矩阵乘,彻底消掉了 position-pair 对角路径。论文指出这与 HGRN2、Griffin、RWKV-7 中的 lower-bounded recurrence gate 密切相关。
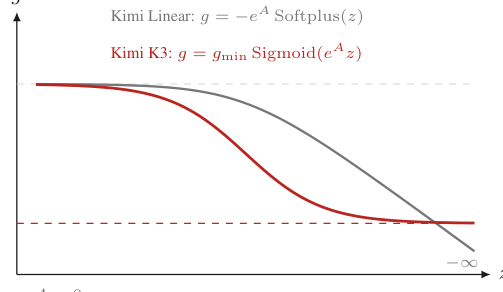
Full-rank gate. KDA 的输出门也从 Kimi Linear 的低秩参数化改成 input-dependent 的全秩投影。对 recurrent 输出先做 head-wise RMSNorm,再做 data-dependent output gating:
$$ \boldsymbol{y}_t = \mathbf{W}_o\big[\mathrm{Sigmoid}(\mathbf{W}_g \boldsymbol{x}_t) \odot \mathrm{RMSNorm}(\bar{\boldsymbol{o}}_t)\big] \tag{6} $$
Gated MLA¶
MLA(DeepSeek-V2)把每个 token 的 KV 表示压成低维 latent $\boldsymbol{c}_t = \mathbf{W}_c \boldsymbol{x}_t$,只缓存 $\boldsymbol{c}_t$ 并在注意力计算时通过学习到的上投影重建 content key/value,在保留全局 token-to-token 注意力的同时压缩 KV 足迹。Kimi K3 在周期性的全局注意力层里保留 MLA,并做两处改动:
- NoPE:沿用 Kimi Linear 的 hybrid 设计,所有 MLA 层都不加任何显式位置编码。中间的 KDA 层已经通过 recurrent gating/decay 提供 position-sensitive、recency-aware 的混合,MLA 层则负责无约束的全局内容交互。这一分离还避免了扩上下文时需要改位置编码参数(如重调 RoPE 频率基或用 YaRN)。
- Gated 输出:加 input-dependent、channel-wise 的全秩输出门。记 $\bar{\boldsymbol{o}}_t$ 为未加门的 MLA 输出:
$$ \boldsymbol{y}_t = \mathbf{W}_o\big[\mathrm{Sigmoid}(\mathbf{W}_g \boldsymbol{x}_t) \odot \bar{\boldsymbol{o}}_t\big] \tag{7} $$
门投影 $\mathbf{W}_g$ 是全秩的,与 KDA 的新参数化一致,让每个 token 自主调制从全局注意力读入的通道。
此外,为纠正 flash attention 里的有偏舍入误差,Kimi K3 采用了"Why Low-Precision Transformer Training Fails"的方法,训练时把注意力输出保持在 FP32。这会让输出 tile 的片上足迹翻倍,因此他们重新设计训练 kernel,让它与 KV staging buffer 而不是 query tile 重叠,为更深的 KV pipeline 腾出 shared memory,提高训练吞吐。
Attention Residuals(深度维)¶
标准残差连接把所有先前信息压缩进沿深度传递的单一状态 $\boldsymbol{h}_l$——论文明确把这形容为"让人想起 RNN 沿时间的瓶颈"。对序列建模,Transformer 用注意力取代了 recurrence,使每个位置能以 data-dependent 权重选择性访问所有先前位置。AttnRes 把同样的方法论施加到深度上:每一层从所有前序层选择性检索表示,而不是均匀累加。
Full Attention Residuals. 对每层 $l$ 定义 layer-specific 可学习 pseudo-query $\boldsymbol{q}_l = \boldsymbol{w}_l \in \mathbb{R}^d$,以及 keys 与 values:
$$ \boldsymbol{k}_i = \boldsymbol{v}_i = \begin{cases} \boldsymbol{h}_1 & i = 0\\ f_i(\boldsymbol{h}_i) & 1 \le i \le l-1\end{cases} \tag{8} $$
其中 $f_i(\boldsymbol{h}_i)$ 是第 $i$ 层的输出,$\boldsymbol{h}_1$ 是 token embedding。注意力权重用 softmax 核 $\phi(\boldsymbol{q}, \boldsymbol{k}) = \exp\big(\boldsymbol{q}^\top \mathrm{RMSNorm}(\boldsymbol{k})\big)$,其中 RMSNorm 防止输出幅度大的层主导权重:
$$ \alpha_{i \to l} = \frac{\phi(\boldsymbol{q}_l, \boldsymbol{k}_i)}{\sum_{j=0}^{l-1}\phi(\boldsymbol{q}_l, \boldsymbol{k}_j)}, \qquad \boldsymbol{h}_l = \sum_{i=0}^{l-1}\alpha_{i \to l}\cdot \boldsymbol{v}_i \tag{9} $$
由于网络深度不大($L < 100$),这个 full 形式的 $O(L^2 d)$ 算术开销可以承受;真正的实际开销是保持所有层输出存活的 $O(Ld)$ 内存(以及 pipeline parallelism 下的跨 stage 通信)。
Block Attention Residuals. 为降低该开销,把 $L$ 层划分为 $N$ 个 block、每 block $S = L/N$ 层。block $\mathcal{B}_n$ 内部,层输出被求和归约成单一 block 表示 $\boldsymbol{b}_n = \sum_{j \in \mathcal{B}_n} f_j(\boldsymbol{h}_j)$,$\boldsymbol{b}_n^i$ 表示 block 内前 $i$ 层的部分和;令 $\boldsymbol{b}_0 = \boldsymbol{h}_1$ 使 token embedding 始终作为一个源。跨 block 只在 $N$ 个 block 级表示上做 full attention:对 block $n$ 的第 $i$ 层,value 矩阵为
$$ \mathbf{V} = \begin{cases}[\boldsymbol{b}_0, \ldots, \boldsymbol{b}_{n-1}]^\top & i = 1\ (\text{block } n \text{ 的第一层})\\ [\boldsymbol{b}_0, \ldots, \boldsymbol{b}_{n-1}, \boldsymbol{b}_n^{i-1}]^\top & i \ge 2\ (\text{后续层})\end{cases} \tag{10} $$
keys 与注意力权重仍按式 (8)(9)。最终输出层聚合全部 $N$ 个 block 表示。Block AttnRes 把内存与通信开销从 $O(Ld)$ 降到 $O(Nd)$,同时这个 block 结构也bound 住了推理时的状态——并行的 inter-block 结果可以通过 online softmax 与顺序的 intra-block 部分和更好地合并,显著降低推理时间成本。
经验上 $N \approx 8$ 就能在各种模型规模上恢复大部分收益;Kimi K3 把层划成 8 个 block、每 block 12 层,产生一个不完整的最后 block、算上 embedding 层共 9 个 block。
Stable LatentMoE(宽度维)¶
同时扩大 expert 池与激活 expert 数会扩展 expert specialization 的空间,但在常规 MoE 里每个被选中的 expert 都接收完整 $d$ 维 token 表示,因此通信量与 expert 权重流量随 routing multiplicity 一起增长。LatentMoE 通过把完整模型宽度与 routed-expert 宽度解耦使这种扩展变得可承受:shared experts 保留全宽路径以做公共变换,而 specialized routed experts 在宽度为 $\ell$ 的紧凑 latent 空间里操作。这让 Kimi K3 能把 channel mixing 扩到 896 routed experts、每 token 激活 16 个(对应稀疏度 56)。
这种极端稀疏会放大 vanilla 设计的两个失效模式: 1. routed 路径把 $\mathbf{W}^{\downarrow}$、一个 gated 多分支 expert FFN、$\mathbf{W}^{\uparrow}$ 组成近四个连续矩阵乘的链条。这个 ill-conditioned 结构叠加 2.8T 参数规模,会在 routed 分支产生爆炸的内部激活; 2. 均衡近 $10^3$ 个 expert 的负载超出了现有 auxiliary-loss-free bias 更新仍能良好运作的范围。
Stable LatentMoE 用三个组件应对:上投影前的 RMSNorm、Sigmoid Tanh Unit GLU (SiTU-GLU) 抑制激活爆炸、以及 Quantile Balancing (QB) 做负载均衡。
层结构沿用 DeepSeekMoE 的 shared/routed 组织。对 $\boldsymbol{x} \in \mathbb{R}^d$,shared experts 直接处理 $\boldsymbol{x}$,routed 路径先把它投到 $\boldsymbol{z} = \mathbf{W}^{\downarrow}\boldsymbol{x} \in \mathbb{R}^{\ell}$、分派 $\boldsymbol{z}$ 给选中的 experts,再通过 $\mathbf{W}^{\uparrow}$ 把加权聚合映射回 $\mathbb{R}^d$:
$$ \begin{aligned} \boldsymbol{u} &= \sum_{i \in \mathcal{T}_k(\boldsymbol{x})} p_i E_i^{\text{routed}}(\mathbf{W}^{\downarrow}\boldsymbol{x}),\\ \boldsymbol{y} &= \sum_{j=1}^{N_s} E_j^{\text{shared}}(\boldsymbol{x}) + \mathbf{W}^{\uparrow}\,\mathrm{RMSNorm}(\boldsymbol{u}) \end{aligned} \tag{11} $$
其中 $\boldsymbol{u} \in \mathbb{R}^{\ell}$ 是聚合后的 routed 表示,$E_j^{\text{shared}}: \mathbb{R}^d \to \mathbb{R}^d$ 与 $E_i^{\text{routed}}: \mathbb{R}^d \to \mathbb{R}^{\ell}$ 分别是 shared 与 routed expert FFN,$p_i$ 是由下面 QB 规则定义的 router 权重。Kimi K3 每层固定 $N_s = 2$ 个全宽 shared expert。
Normalized LatentMoE¶
原始 LatentMoE 直接把 $\mathbf{W}^{\uparrow}$ 作用在聚合的 routed 表示 $\boldsymbol{u}$ 上,而 $\boldsymbol{u}$ 的 scale 会随被选 experts 及其 routing 权重变化。如式 (11) 所示,Kimi K3 在 expert 聚合与上投影之间插入 RMSNorm。这个归一化在 routed 分支与全宽 shared 分支合并之前降低其 scale 变化的敏感性。论文强调:除了稳定训练,这个额外的 RMSNorm 还一致地改善验证 loss 与下游 benchmark。
Sigmoid Tanh Unit GLU (SiTU-GLU)¶
GLU 用 sigmoid 门调制线性 value 分支,计算 $\mathrm{Sigmoid}(\mathbf{W}_g\boldsymbol{x}) \odot \mathbf{W}_u\boldsymbol{x}$。SwiGLU 把 sigmoid 门换成 $\mathrm{Swish}(x) = x\,\mathrm{Sigmoid}(x)$,在 Transformer 里表现很强,已成为 LLM 中广泛采用的 FFN 设计,"而其经验有效性的完整解释仍是开放的"。
问题在于:SwiGLU 的两个乘性因子都是无界的,因此同时出现的大坐标会产生激活 outlier,在低精度算术下增加溢出风险。原始 GLU 的 sigmoid 门避免了无界门增长,但不保留 Swish 那种近似线性的正区间响应。因此需要一个既控制大值增长、又保留 SwiGLU 局部与正侧特征响应的激活。论文明确点出"其他近期工作也探索过这一 trade-off 的替代参数化"(引 PowLU)。
SiTU-GLU 对 Swish 门的线性因子、以及独立地对 up 分支,都施加平滑 cap $\mathrm{softcap}(x, \beta) = \beta\tanh(x/\beta)$:
$$ \text{SiTU-GLU}(\boldsymbol{x}) = \left[\beta_1 \tanh\!\left(\frac{\mathbf{W}_g\boldsymbol{x}}{\beta_1}\right) \odot \mathrm{Sigmoid}(\mathbf{W}_g\boldsymbol{x})\right] \odot \left[\beta_2\tanh\!\left(\frac{\mathbf{W}_u\boldsymbol{x}}{\beta_2}\right)\right] \tag{12} $$
Kimi K3 取 $\beta_1 = 4$(gate 分支)、$\beta_2 = 25$(up 分支)。scaled $\tanh$ 在原点附近近似线性、在大幅值处有界,因此 SiTU-GLU 既保留了 SwiGLU 的局部响应,又同时控制住乘积里的两个因子——输出上界为 $|f(x)| \le \beta_1\beta_2 = 100$。
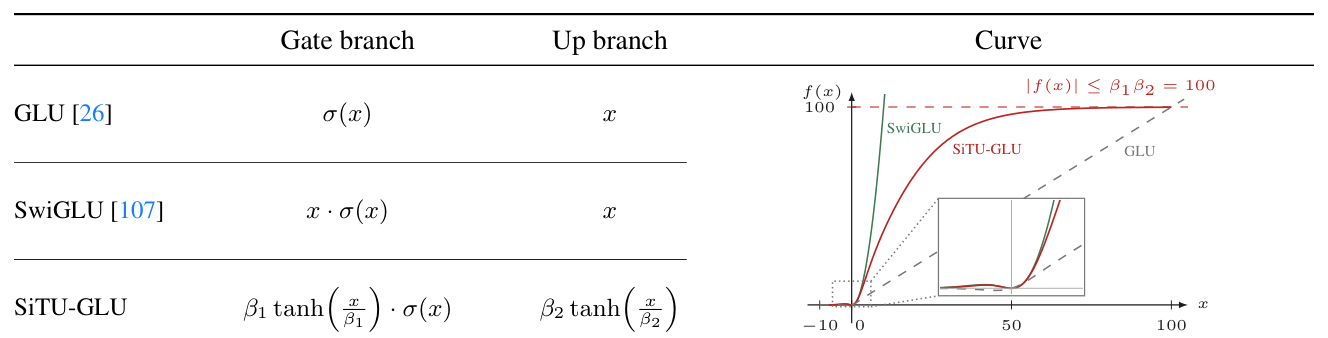
附录 B 给出更细的性质。对原点附近的标量 $z$,scaled $\tanh$ 满足
$$ \beta\tanh\!\left(\frac{z}{\beta}\right) = z + O\!\left(\frac{z^3}{\beta^2}\right) \tag{13} $$
因此 SiTU-GLU 在原点附近一阶匹配 SwiGLU,并在 $\beta_1, \beta_2 \to \infty$ 时逐点恢复 SwiGLU。由于 $|\tanh(z)| < 1$ 且 $0 < \mathrm{Sigmoid}(z) < 1$,每个输出坐标满足
$$ \|\text{SiTU-GLU}(\boldsymbol{x})\|_{\infty} \le \beta_1\beta_2 = 100 \tag{14} $$
论文特别强调:与对 gate pre-activation 做硬截断不同,平滑 cap 在饱和边界之外仍保留非零梯度,这被发现能带来更好的训练行为。
Quantile Balancing (QB)¶
与 auxiliary-loss-based routing 不同,Kimi K3 采用 auxiliary-loss-free routing:给用于 Top-$k$ 选择的 router 分数加一个 expert-specific bias $b_j$。对 token $\boldsymbol{x}_i$,router 计算 $\boldsymbol{s}_i = \mathrm{Sigmoid}(\mathbf{W}_r\boldsymbol{x}_i)$ 并应用
$$ \mathcal{T}_i = \operatorname{argtop}_k(\boldsymbol{s}_i + \boldsymbol{b}), \qquad p_{i,j} = \frac{s_{i,j}}{\sum_{r \in \mathcal{T}_i} s_{i,r}}, \quad j \in \mathcal{T}_i \tag{15} $$
由于 $\boldsymbol{b}$ 在 $p_{i,j}$ 中被省略,它只调节分派、不改变混合权重、也不改变 router 的梯度优化。原方法用固定步长规则 $b_j^{(t+1)} = b_j^{(t)} + \gamma\,\mathrm{sign}(\bar{\ell} - \ell_j^{(t)})$ 更新 $\boldsymbol{b}$,其中 $\gamma$ 在"慢适应"与"loss 振荡"之间权衡。当 LatentMoE 把每层 routed expert 池扩到 896 时,维持均衡负载变得更困难;不均衡的 routing 会拖慢 expert-parallel 训练,并可能让部分 expert 训练不足。
QB 的思路是:把每个 expert 的 bias 直接设成与其目标负载匹配的 router-score 分位数。考虑一个训练 batch,$m$ 个 token 用 Top-$k$ 路由到 $n$ 个 expert,目标负载为 $q := mk/n$ tokens/expert。Routing 把 Top-$k$ 选择换成对有偏分数 $\boldsymbol{s}_i + \boldsymbol{b}^{(t)}$ 做 Top-$(k{+}1)$:前 $k$ 项是实际走的路由,第 $(k{+}1)$ 项就是某 expert 要进入 token $i$ 的 Top-$k$ 所必须超过的 cutoff $\alpha_i^{(t)}$。从 Top-$(k{+}1)$ routing 取 cutoff,避免了单独算一次 token 侧分位数。 固定 cutoff 后,候选 bias $\widehat{b}_j^{(t+1)}$ 下路由到 expert $j$ 的 token 数为
$$ \sum_{i=1}^{m}\mathbf{1}\left[s_{i,j} + \widehat{b}_j^{(t+1)} > \alpha_i^{(t)}\right] \tag{16} $$
它关于阈值 $-\widehat{b}_j^{(t+1)}$ 单调递减。假设无 ties,令该计数等于 $q$ 就意味着 $-\widehat{b}_j^{(t+1)}$ 是第 $(q{+}1)$ 大的 margin $s_{i,j} - \alpha_i^{(t)}$,从而恰好 $q$ 个 margin 高于阈值。由于 $q/m = k/n$,这就是 margins 的 $(1 - k/n)$-分位数,给出 QB 更新:
$$ \begin{aligned} \widehat{b}_j^{(t+1)} &\leftarrow -\operatorname{quantile}_{1-k/n}\big(\boldsymbol{s}_{:,j} - \boldsymbol{\alpha}^{(t)}\big),\\ \boldsymbol{b}^{(t+1)} &\leftarrow \widehat{\boldsymbol{b}}^{(t+1)} - \mathrm{mean}\big(\widehat{\boldsymbol{b}}^{(t+1)}\big)\mathbf{1} \end{aligned} \tag{17} $$
margins 减掉的是有偏 cutoff $\alpha_i^{(t)}$,所以旧 bias 只通过 cutoff 进入更新;第二行减去一个公共 offset,不改变 Top-$k$ 选择。为保证因果性,更新只在下一步生效——即一个 batch 永远不会用从它自己导出的 bias 来路由。最终 bias 在推理时被冻结。
Histogram estimation. 规模上式 (17) 的分位数跨整个 global batch,margins 数以百万计且分散在各 rank 与梯度累积步上,训练时精确聚合不可行。Kimi K3 改为从直方图读取每个 expert 的分位数:single all-reduce 汇总 per-rank bin counts,再从合并计数恢复分位数。由于计数可加,直方图表示的是汇总后的 global batch、与 token 如何分片无关,因此估计反映的是 whole-batch 分位数(精度到 bin 宽),通信成本仅每 expert 几百个 bin。
附录 C 从最优均衡分配推导 QB。设 $\boldsymbol{s} \in \mathbb{R}^{m \times n}$ 收集 $m$ 个 token 在 $n$ 个 expert 上的 router 分数,每 token 选恰好 $k$ 个 expert,$x_{i,j} \in \{0,1\}$ 表示分配。最大分数均衡分配(每 expert 恰好服务 $mk/n$ tokens)为
$$ \max_{x_{i,j} \in \{0,1\}}\ \sum_{i,j} x_{i,j}s_{i,j} \quad \text{s.t.}\quad \sum_j x_{i,j} = k,\qquad \sum_i x_{i,j} = \frac{mk}{n} \tag{18} $$
放松 $x_{i,j} \in [0,1]$ 得到一个线性规划,其最优解由二部 $b$-matching 多胞形的标准全整性保证是整的,因此该放松是精确的。引入 token 侧与 expert 侧的自由乘子 $\alpha_i$、$\beta_j$,松弛问题写成 max–min 形式:
$$ \max_{x_{i,j}\in[0,1]}\ \min_{\alpha_i, \beta_j}\ \sum_{i,j}x_{i,j}s_{i,j} - \sum_i \alpha_i\Big(\sum_j x_{i,j} - k\Big) - \sum_j \beta_j\Big(\sum_i x_{i,j} - \frac{mk}{n}\Big) \tag{19} $$
目标关于 $\boldsymbol{x}$、$\boldsymbol{\alpha}$、$\boldsymbol{\beta}$ 都是线性的、可行集是凸的,故 minimax 定理允许交换优化顺序,代入内层最优 $\boldsymbol{x}^*$($x_{i,j}^* = 1$ 当 $s_{i,j} - \alpha_i - \beta_j > 0$)得到凸对偶目标:
$$ \min_{\alpha_i, \beta_j}\ \mathcal{L}(\boldsymbol{\alpha},\boldsymbol{\beta}) := \sum_{i,j}\max\big(0,\ s_{i,j} - \alpha_i - \beta_j\big) + k\sum_i \alpha_i + \frac{mk}{n}\sum_j \beta_j \tag{20} $$
交替坐标最小化:固定 $\boldsymbol{\beta}$ 时问题按 token 解耦,token $i$ 的子问题 $\min_\alpha k\alpha + \sum_j \max(0, s_{i,j}-\beta_j-\alpha)$ 关于 $\alpha$ 分段线性,斜率为 $k$ 减去超过 $\alpha$ 的 margin 数,因此当恰好 $k$ 个 margin 位于 $\alpha$ 之上时取到最小;按惯例取第 $(k{+}1)$ 大项,等价于 $(1-k/n)$-分位数:
$$ \alpha_i^* = \operatorname{quantile}_{1-k/n}(\boldsymbol{s}_i - \boldsymbol{\beta}), \qquad \beta_j^* = \operatorname{quantile}_{1-k/n}(\boldsymbol{s}_{:,j} - \boldsymbol{\alpha}) \tag{21} $$
两个更新是沿 token 轴与 expert 轴的同一个分位数——方法名由此而来。在最优点 $x_{i,j}^* = 1$ 当且仅当 $s_{i,j} - \alpha_i^* - \beta_j^* > 0$;结合 token 约束,被选 experts 恰好是 $\boldsymbol{s}_i - \boldsymbol{\beta}^*$ 的 Top-$k$。因此 routing 只需 expert 阈值 $\boldsymbol{\beta} \in \mathbb{R}^n$(等价于式 (15) 的 bias $\boldsymbol{b} = -\boldsymbol{\beta}$),token 阈值 $\boldsymbol{\alpha}\in\mathbb{R}^m$ 是绑定在动态训练 batch 上的中间变量、可丢弃。这个不对称性保持了 train–inference 一致性:部署时 routing 就是带冻结 bias 的固定 Top-$k$,无需任何分位数计算。
论文还给出与 sign-based loss-free 更新的关系。式 (21) 中 expert 侧子问题的(次)梯度为
$$ \frac{\partial \mathcal{L}}{\partial \beta_j} = \frac{mk}{n} - \sum_{i=1}^{m}\chi\big(s_{i,j}-\alpha_i - \beta_j > 0\big) \tag{22} $$
即目标负载减去 expert $j$ 的实测负载。在该目标上做 SignSGD 步就恢复出 auxiliary-loss-free balancing 的固定步长 sign 更新(在 $\boldsymbol{b} = -\boldsymbol{\beta}$ 的符号约定下):sign 更新只保留了负载误差的方向,而 QB 直接跳到同一对偶目标的精确坐标最小点。这解释了为什么 QB 不需要类似学习率的超参,以及为什么它对近 $10^3$ 个 expert 也能在几步内平衡。QB 也与 BIP 相关(后者解不等式约束版本,其在 $\boldsymbol{\alpha}$、$\boldsymbol{\beta}$ 上诱导的非负约束给更新加了 $\max(0,\cdot)$ 截断,只能抑制过选 expert 而不能促进欠选 expert,在实验中显著减慢平衡速度)。
附录 D 给出直方图估计器的细节。QB 更新实际上不需要 margins 本身,只需其 per-expert 分布。Kimi K3 直方图化的是 required bias $r_{i,j} := \alpha_i - s_{i,j}$(把 expert $j$ 正好放到 token $i$ 的 cutoff 上所需的 bias);对 margins 取负会反转其顺序,因此式 (17) 的 QB 目标 $\widehat{b}_j$ 恰好是 $r_{:,j}$ 的 $(k/n)$-分位数。分箱范围由 bias 本身界定:router 分数是 sigmoid 输出故 $s_{i,j}\in(0,1)$,cutoff $\alpha_i$ 本身是某 expert $j'$ 的有偏分数 $s_{i,j'}+b_{j'}$,故落在 $(b_{\min}, 1+b_{\max})$,于是每个 $r_{i,j}$ 落在 $[b_{\min}-1,\ b_{\max}+1]$。该区间划成 $B$ 个均匀 bin(实践中 $B = 1000$ 足够),bin 宽 $w = (b_{\max}-b_{\min}+2)/B$ 每步重算以随 bias 扩散自适应。每步 forward,每个 rank 把本地 $r_{i,j}$ 散加到 per-expert 计数矩阵 $\mathbf{H} \in \mathbb{N}^{n \times B}$、跨 micro-batch 无通信累积;步末一次 all-reduce 汇总为 global 直方图,选出累积计数达到 $\lceil q \rceil$ 的第一个 bin 并在其中线性插值。若选中 $\beta_j$、其前的累积计数为 $c_j$、bin 计数为 $h_j$,则
$$ \widehat{b}_j = b_{\min} - 1 + \left(\beta_j + \mathrm{clip}\!\left(\frac{q - c_j}{h_j},\,0,\,1\right)\right)w \tag{23} $$
三个性质让该估计器实用:准确(累积计数在 bin 边界处精确,真分位数与估计落在同一 bin,误差被 bin 宽 $w$ 界定;$B=1000$ 时至多几个 $10^{-3}$,且观测不到可测残余负载不均衡);便宜(每层每步只通信 $nB$ 个整数的一次 all-reduce,与 $m$ 无关,在其配置下低于每 micro-batch 跨 process group 交换原始 margins 成本的 1%);估计的是正确的量(因计数可加,global 直方图对 token 如何分片完全不变,估计的是合并 global batch 的分位数而非 per-rank 分位数的平均——后者一般不同)。作为进一步精化,对估计分位数跨步做 EMA 可降低 batch 间采样噪声、进一步改善负载均衡。
Native Vision¶
Kimi K3 是原生多模态的:文本、图像、视频由单一共享主干在同一上下文中处理,没有 post-hoc 的模态对齐阶段。这一设计是 §1 中长程 vision-in-the-loop 行为的架构基础:渲染输出与产生它们的代码活在同一 token 流里,模型能写代码、检视截图或结果的视频帧、并迭代精修视觉产物(UI、图形、视频),无需跨模型交接。
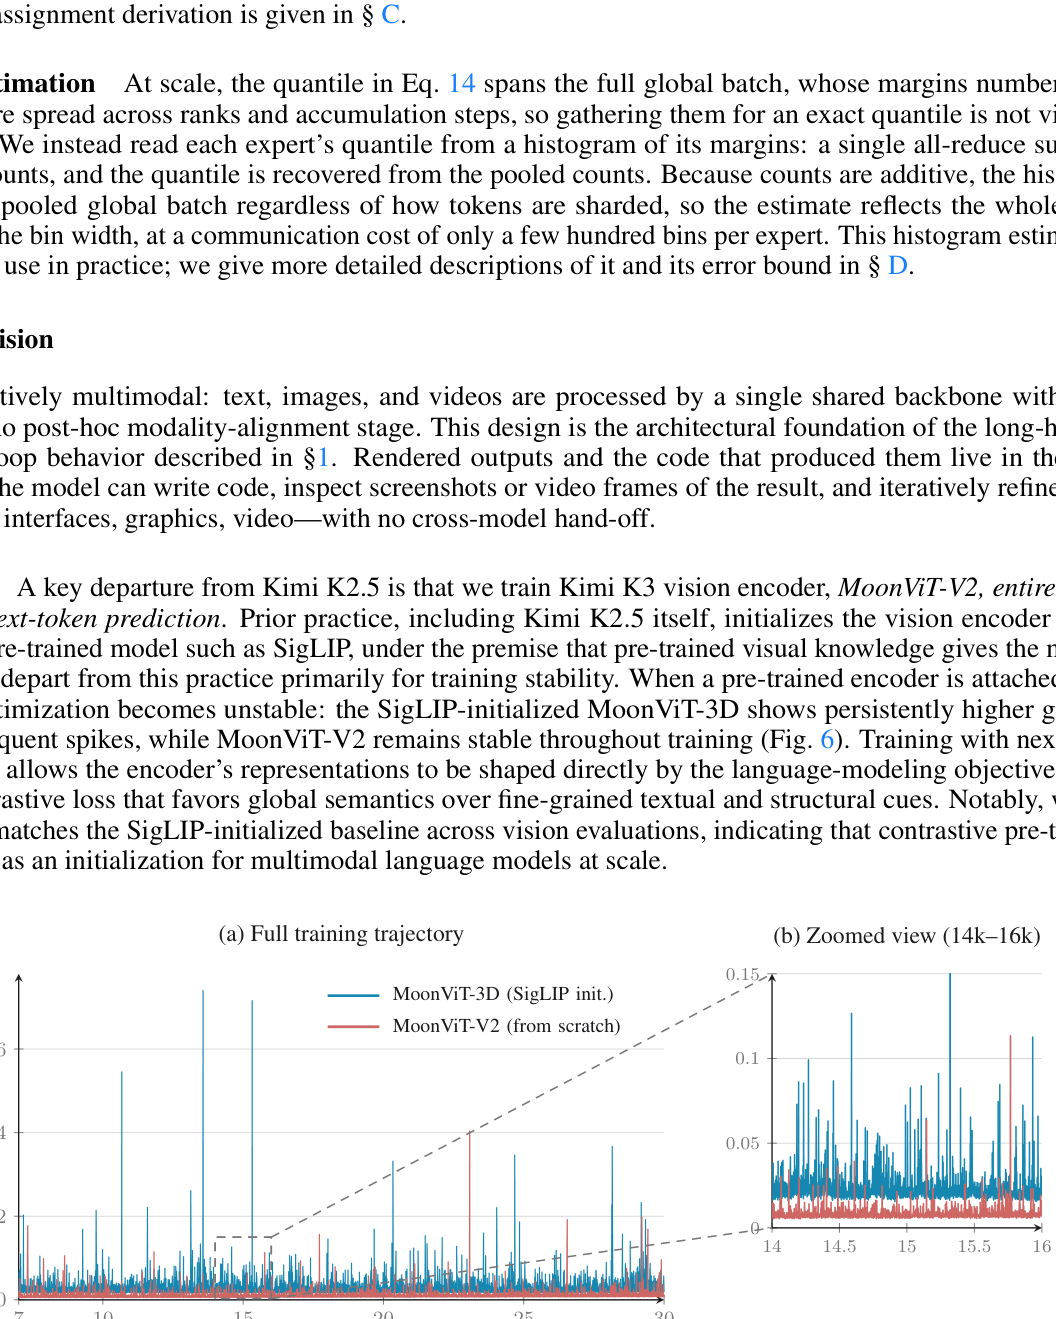
MoonViT-V2. 相对 Kimi K2.5 的关键分歧是:Kimi K3 的视觉编码器 MoonViT-V2 完全从零用 next-token prediction 训练。此前实践(含 Kimi K2.5 自己)都是用 SigLIP 这类对比预训练模型初始化视觉编码器,前提是预训练视觉知识给模型开个好头。他们偏离这一实践主要出于训练稳定性:当预训练编码器被接到 LLM 上,联合优化变得不稳定——SigLIP 初始化的 MoonViT-3D 表现出持续更高的 gradient norm 与频繁 spike,而 MoonViT-V2 全程稳定。用 next-token prediction 训练还让编码器的表示可以被语言建模目标直接塑形,而不是被偏好全局语义、忽视细粒度文本与结构线索的对比损失塑形。值得注意的是,他们发现 MoonViT-V2 在视觉评测上与 SigLIP 初始化的 baseline 相当,表明"对比预训练在规模上作为多模态语言模型的初始化并非必需"。
架构. 视觉通路沿用 Kimi K2.5 的总体设计:视觉输入先由 MoonViT-V2 编码,再由轻量 MLP projector 映射进 LLM。MoonViT-V2 是 27 层、约 0.4B 参数的 vision transformer,在其线性与注意力投影里采用 RMSNorm 并移除所有 bias 项,进一步稳定上述从零优化。图像与视频用完全共享的参数处理(如 MoonViT-3D):注意力被分解为 intra-frame 空间与 inter-frame 时间两个 pass,temporal pooling 沿时间维进一步压缩 token。投影前的 pixel-shuffle 操作以 $2\times 2$ 下采样把视觉 token 数减少 4 倍,使高达 $3584 \times 3584$ 像素的输入在 1M token 上下文内可承受。
Per-Head Muon¶
沿用 Kimi K2,Kimi K3 用 Muon 作为矩阵参数的优化器。对注意力投影,进一步精化为 per-head 变体:不是对完整 $Q$、$K$、$V$ 投影矩阵做 Newton–Schulz 正交化,而是把它们的动量矩阵沿 head 维划分、分别正交化每个 head 的块。直觉是:full-matrix 正交化把所有 head 当作单一耦合块,因此梯度或动量 scale 较大的 head 会主导共享的更新方向,而 scale 较小的 head 收到归一化不足的更新;per-head 正交化均衡了跨 head 的更新 scale。实践中这一设计带来跨 head 更均衡的学习动态、在更大规模下改善训练稳定性;它还略微降低优化器开销——在高瘦的 per-head 块上做 Newton–Schulz 迭代比在完整投影矩阵上更便宜。
预训练¶
预训练数据¶
Kimi K3 在一个覆盖四个主要文本域的精选语料上预训练——Web Text、Code、Mathematics、Knowledge——外加一个大规模视觉语料。视觉数据涵盖 caption、图文交错文档、OCR、感知、视频、visual coding 数据。数据 pipeline 建立在 Kimi K2 开发、Kimi K2.5 精化的基础上。
- 文本数据:每个域用规则启发式、分类器质量打分、去重的组合过滤,域特定采样率由小模型上的消融实验决定。沿用 Kimi K2 的 rephrasing 配方,对 knowledge 与 mathematics 语料做风格与视角多样化的 prompting 改写、chunk-wise 自回归生成、以及针对源文档的保真度验证。
- 视觉数据:沿用 Kimi K2.5 的分类体系,结合开源集合与内部 pipeline 做过滤、合成、去重。训练时坐标监督同时以绝对与归一化($[0,1]$)两种格式提供,实现精确且分辨率鲁棒的定位。除经典的图文配对外,他们大幅 scale up 了程序化多模态数据——把代码片段与其渲染视觉配对,覆盖 SVG、3D assets、Webpage、Game、CAD schematics 等域特定格式。
Scaling Law¶
架构、数据、训练改良共同定义了新的模型族。由于这些改动也改变了最优训练 regime,他们做了专门的 scaling-law 研究来重调关键超参:batch size、learning rate、tokens-per-parameter ratio (TPP)、模型 shape。在留出的 OOD 验证数据上评估,scaling law 曲线显示这些改良共同带来相对 Kimi K2 约 $2.5\times$ 的整体 scaling 效率增益。
他们的 scaling-law 研究一致偏好 cosine decay 而非 Warmup Stable Decay (WSD),因此采用 cosine decay 作为默认学习率调度。论文特别强调了一个方法论要点:虽然此前工作报告 WSD 能匹配甚至超过 cosine decay,但他们观察到两种调度表现出明显不同的最优超参数——即使在同样的模型规模与训练 token 预算下,它们的最优 peak LR 与 batch size 也差别很大。因此用一组共享超参比较两种调度,可能仅仅因为那些超参更契合其中一方而不公平地偏袒它。为保证公平比较,他们对每种调度独立做 scaling-law 搜索;在各自最优超参设定下,cosine decay 一致取得比 WSD 更低的最终 loss。
Table 1 给出 Kimi K2 与 Kimi K3 的架构对比(原文 p11,图片提取未覆盖该表,此处按原文重制):
| 项 | Kimi K2 | Kimi K3 | $\Delta$ |
|---|---|---|---|
| Architecture | MoE | MoE | – |
| #Layers | 61 | 93 | ↑ 52% |
| Total Parameters | 1.04T | 2.78T | ↑ 167% |
| Activated Parameters | 32.6B | 104.2B | ↑ 220% |
| Hidden Dimension | 7,168 | 7,168 | = |
| Latent MoE Dimension | – | 3584 (0.5×) | – |
| MoE Hidden Dimension per Expert | 2,048 | 3,072 | ↑ 50% |
| Routed Experts | 384 | 896 | ↑ 133% |
| Experts Active per Token | 8 | 16 | ↑ 100% |
| Shared Experts | 1 | 2 | ↑ 100% |
| Attention Heads | 64 | 96 | ↑ 50% |
| Number of Dense Layers | 1 | 1 | = |
| Vocabulary Size | 160K | 160K | = |
| Training Context Length | 128K | 1M | 8× |
| Attention Mechanism | MLA | Hybrid KDA–MLA | – |
| Activation Function | SwiGLU | SiTU-GLU | – |
| Attention-Layer Composition | 61 MLA | 69 KDA + 24 MLA | – |
| Number of MTP Layers | 1 layer | 1 layer | = |
| Total Parameters of ViT | – | 401M | – |
| #ViT Layers | – | 27 layers | – |
| Patch Size of ViT | – | 14 | – |
| #Attention Heads of ViT | – | 12 | – |
表格解读:值得注意的是 hidden dimension 保持 7,168 不变——所有宽度扩张都发生在 MoE 侧(routed experts $384 \to 896$、per-expert hidden $2048 \to 3072$、active experts $8 \to 16$、shared experts $1 \to 2$),配合 latent MoE 维度 3584(即 hidden 的 0.5×)。这正是 LatentMoE"解耦全宽与 routed-expert 宽度"设计的直接体现:总参数涨 167%、激活参数涨 220%,但 dense 主干宽度零增长。层数从 61 涨到 93(+52%),attention 层构成从 61 层纯 MLA 变成 69 KDA + 24 MLA(69:24 ≈ 2.875:1,与 3:1 加末尾额外一层 MLA 的描述一致)。
训练配方¶
Kimi K3 采用原生多模态训练策略:语言与视觉从训练一开始就联合优化,而不是把视觉编码器通过 post-hoc 对齐阶段接到预训练语言模型上。在这一范式下,视觉与文本 token 在单一 next-token prediction 目标内交错,使共享主干从一开始就学习统一的多模态表示。
优化用 Per-Head Muon(§2.5)配合 Kimi K2 引入的 weight-clipping 机制,MoE 负载均衡用 QB。学习率用 cosine 调度配 1% 线性 warmup,weight decay 全程 0.1。预训练从 8k 上下文长度开始,后续阶段扩到 64k。
长上下文扩展¶
- 位置编码:Kimi K3 不用任何显式位置嵌入(NoPE),位置信息完全隐式地由 KDA 的 recurrent gating 与 decay 机制编码。因此模型直接外推到 1M token 上下文而无需任何位置编码改动(如 RoPE rescaling 或插值)。
- 长上下文数据:来自自然源的长文档与视频包含大量低质内容——近重复、二进制 blob、截断文件、视频片段、无效的机器生成日志。他们用专门的清洗 pipeline 处理:精确与模糊去重、视频用逐帧 perceptual hashing 补充、外加启发式与分类器质量过滤和结构校验。由于真正长且连贯的文档与视频相对短文本稀缺,他们上采样这类数据,使 cooldown 期间长上下文分布不被短序列淹没。但论文强调"长度本身并不赋予长程能力":为此他们额外合成长上下文数据——精心置换与拼接多模态文档与子任务,使嵌入的任务只有通过关注散布在整个 1M 上下文中的信息才能求解。这在预期规模上训练注意力机制,防止其退化为局部模式。
- 渐进式上下文扩展:Kimi K3 支持最多 1M token 上下文,通过随训练推进渐进扩窗的四阶段课程实现。窗口在预训练期间从 8K → 64K,在 cooldown 阶段从 256K → 1M。把昂贵的长序列计算集中在整体训练预算的一小部分内,既让课程经济,又允许模型逐步适应越来越长程的依赖。
后训练¶
后训练 pipeline 遵循三阶段范式:(1) 通过 SFT 初始化基线 agent 能力;(2) 通过 RL 在不同 reasoning effort 上培养专门化的 domain expert;(3) 用 Multi-Teacher On-Policy Distillation (MOPD) 把这些 domain-specific policy 合并进单一模型。
监督微调(SFT)¶
SFT 阶段为后续 RL 建立高质量 cold-start policy。在 Kimi K2/K2.5 的 SFT pipeline 基础上,Kimi K3 扩展了 SFT 数据集,大幅拓宽复杂 agentic 任务的覆盖。具体地,他们用 Kimi 系列先前模型的 domain-specialized 模型合成数据轨迹,随后做多阶段验证与 human-in-the-loop 标注。为一致地表示这些复杂 agentic 轨迹,所有数据都用其基于 XTML(eXtensible Token Markup Language)的 chat template 序列化。这些步骤共同产出一个大规模指令数据集,赋予 Kimi K3 自适应推理、精确 tool calling、长程 agentic 场景下的稳健执行能力。此外,从 SFT 阶段起就施加 quantization-aware training (QAT),权重 MXFP4、激活 MXFP8。
强化学习¶
RL 是解锁高阶推理与执行能力的关键。他们不为单个任务训练专门 RL 模型,而是在三个宽域上 scale RL,每个域涵盖大量子任务,并在每个 reasoning effort level 上为每个域训练一个 expert:
- general tasks:general experience、vision、reasoning、faithfulness、search capabilities、knowledge work;
- general agents:长程 assistant 任务、deep research、段落级写作;
- coding agents:软件工程(SWE)、coding experience、kernel 任务、web development。
三个 domain expert × 三档 reasoning effort($\{$low, high, max$\}$)= 共 9 个 expert 模型。
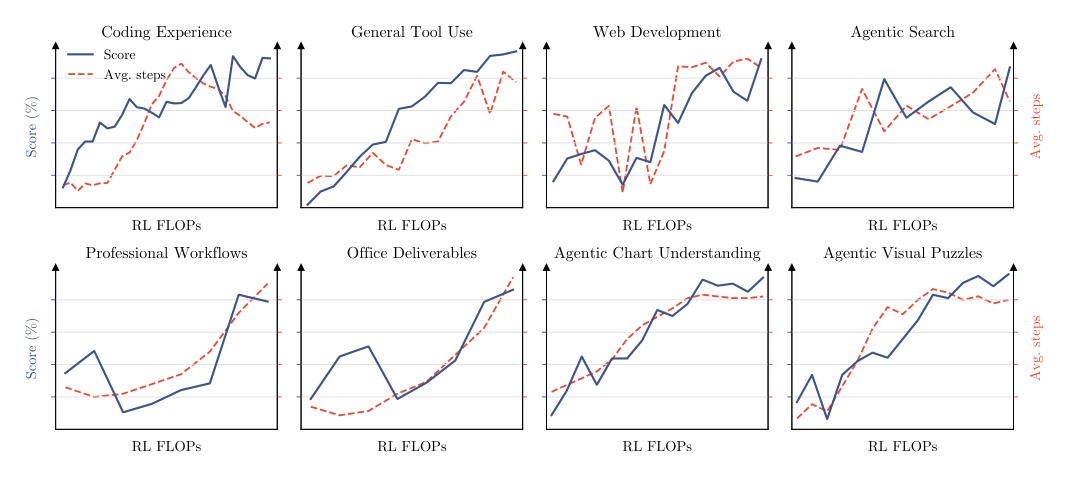
Figure 8 显示:随着 RL FLOPs 增加,tool-call steps 一致地 scale up,伴随模型整体能力的全面提升——八个子图(Coding Experience、General Tool Use、Web Development、Agentic Search、Professional Workflows、Office Deliverables、Agentic Chart Understanding、Agentic Visual Puzzles)中 Score 与 Avg. steps 两条曲线大体同向上升。这是论文关于 test-time scaling 的核心经验证据:能力提升与"愿意/能够多走几步"是绑定的。
Algorithm. 为缓解长程任务中加剧的长尾延迟,他们扩展了自研同步 RL 框架里的 partial rollout 方案。每轮 rollout 阶段,对 $N$ 个 prompt 各采样 $K$ 个 completion,维持 $N \times K$ 条轨迹的活跃工作负载。不等所有 rollout 终止,而是在其中一部分轨迹 $\lambda \in (0,1)$ 完成时(即 $\lambda NK$)就暂停生成阶段,让 policy 优化在无执行 straggler 的情况下推进。被暂停的 rollout 入队,并在下一轮开始时优先恢复,由其 sandbox 基础设施驱动。一旦某 prompt 的全部 $K$ 个 response 完成,就立即派去做 policy 优化(沿用 Kimi K2.5 的算法)。在该 partial rollout 方案下,单条长程轨迹自然跨多轮,引入了威胁训练稳定性的数据陈旧(data staleness)。他们的 policy 优化算法通过 per-token 正则化天生容忍极端 off-policy regime:把 policy 更新约束在局部邻域内,使算法能稳健处理高度陈旧的数据并维持训练稳定。
Reasoning Effort RL. 为在最大化 token 效率的同时微调 reasoning effort,他们实现 per-problem budget control 机制:对每个问题 $x$ 关联一个由 cold-start 模型估计的初始 token budget $b_0(x)$,并对总 token budget $T(y)$ 超过缩放阈值 $\tau \cdot b_0(x)$ 的轨迹,把任务 reward 覆写为 $-1$。对 general 任务,$T(y)$ 度量 thinking token 数;对 agentic 任务,$T(y)$ 计入累积输出 token(含 reasoning trace 与 tool-call 参数)。训练遵循在 budget multiplier $\tau$ 上的阶段式课程:先用相对大的 $\tau$ 训练一个 max-budget 变体,同时仍 cap 住最大预算以抑制过度 overthinking;再把 $\tau$ 退火到更小值以获得 high- 与 low-effort expert。$\tau$ 的调整按域配置、human-in-the-loop 指导。由此得到的所有推理层级的 expert 产出的轨迹被联合收集用于 SFT 与 MOPD。
Agentic Generative Reward Model. 对不可验证的 general 任务,他们采用 Agentic Generative Reward Model (GRM),RL 期间保留带二元比较的 tournament-style group reward(如 Kimi K2/K2.5)。除了增强判断的通用 agentic 能力,agentic judge 被要求遵循一个强制协议:(1) 读 outcome / product / 文本输出;(2) 生成 rubric;(3) 对每个候选按 rubric 打分;(4) 把 rubric 赋分记录到 scorepad。为缓解朝越来越冗长输出的 reward hacking,他们施加一个类比于上述 reasoning-effort 控制的 budget-based verbosity control:给定 cold-start 模型估计的初始 verbosity $\ell_0$ 与乘子 $\sigma$,输出长度超过 $\sigma \cdot \ell_0$ 的候选自动输掉二元比较。
Multi-Teacher On-Policy Distillation (MOPD)¶
MOPD 用于把跨不同 reasoning effort 的 domain-specialized 能力合并进统一模型。训练期间,对给定域 $d$ 与采样的 reasoning effort level $e \in \{$low, high, max$\}$,优化由九个 expert 中对应的 teacher 模型 $\pi_{\text{teacher}}^{(d,e)}$ 引导。给定输入 query $x$ 与前缀 $y_{<t}$,teacher $\pi_{\text{teacher}}^{(d,e)}$ 与 student $\pi_\theta$ 之间在 $y_t$ 上评估的 per-token OPD reward 定义为:
$$ r_{\text{opd}}^d(y_t \mid e, x, y_{<t}) = \mathrm{clip}\left(\mathrm{sg}\left(\log\frac{\pi_{\text{teacher}}^{(d,e)}(y_t \mid x, y_{<t})}{\pi_\theta(y_t\mid e,x,y_{<t})}\right),\ -R_{\max},\ R_{\max}\right) \tag{24} $$
其中 $\mathrm{sg}(\cdot)$ 是 stop-gradient 算子,$R_{\max} > 0$ 是约束极端 advantage 信号的裁剪阈值,以稳定 RL 训练。这个 dense reward 信号无缝集成进他们的 RL 框架,自然使基础设施级优化(如长程任务的 partial rollout 训练)成为可能。论文也报告了一个负结果:他们实验过更细粒度的 top-$k$ 蒸馏目标,但在其设定下无论收敛速度还是最终性能都未观察到明确优势。
面向部署的后训练¶
MXFP4 量化感知后训练. 为降低部署时的内存足迹与服务成本,他们把主导模型参数内存的 MoE expert 权重量化到 MXFP4,激活用 MXFP8 计算,而所有 non-expert 组件(attention projections、latent MoE projections、shared experts、MoE routers)保持更高精度。QAT 贯穿整个后训练阶段(覆盖 SFT 与 RL),使模型适应量化诱导的精度损失。RL 期间 rollout 与训练共享同一量化方案——消除了 train–inference 不匹配。
Draft Model Fine-Tuning. 优化推理效率对服务复杂长程 agentic 模型至关重要。Kimi K3 预训练时带一个 multi-token-prediction (MTP) 层,其结构镜像 backbone block。作为 EAGLE-3 的 draft 模型,他们把预训练 MTP 层微调成 EAGLE-3 风格 draft 模型:target 模型冻结,只训 draft 层与其 feature-fusion projection 层。遵循 EAGLE-3 的 training-time test 协议,draft 在训练时展开 7 步;第一步之后,最新位置的 target 侧特征不可用,draft 消费自己前几步的输出,镜像推理时的 recurrent drafting 过程。
draft 输入融合 target 模型的 low-/mid-/high-level 特征,分别取自第 1、第 4、以及最后一个 AttnRes block 的输出。这些特征被拼接并用一个 bias-free 矩阵 $\mathbf{W}_{\text{E3}}$ 投影到 hidden size,初始化为 $[\mathbf{0}\ \mathbf{0}\ \mathbf{I}]$,使融合表示在初始化时与 high-level 输入 $\boldsymbol{h}_h$(MTP 层预训练时的输入)恰好一致,再在微调中逐步学会纳入 low-/mid-level 特征。
投机解码的加速由无损投机采样下的 per-token acceptance rate $\sum_{x \in \mathcal{V}}\min(p(x), q(x))$ 支配,$p$、$q$ 分别是 target 与 draft 的 next-token 分布。由于最小化常规 KL 散度代理并不保证对容量受限的 draft 模型最大化该 rate,他们直接优化基于似然的 LK loss——即 acceptance rate 本身的负对数:
$$ \mathcal{L}_{\text{LK}} = -\log\sum_{x \in \mathcal{V}}\min\big(p(x), q(x)\big) \tag{25} $$
$p$、$q$ 在温度 1 下评估,无辅助 ground-truth cross-entropy 项。Draft 微调遵循后训练 QAT 配置,MoE expert 权重 MXFP4、其输入激活 MXFP8,non-expert 模块保持更高精度。
RL 任务合成与 Agentic 环境¶
RL 框架的有效性重度依赖丰富、多样、可稳健验证的环境。
统一白盒 RL 环境. 用单一固定 agent harness 训练会让模型过拟合到某个特定的 tool schema、system prompt、context management 机制或交互协议。为此他们开发了统一白盒 RL 环境,把 agent harness 表示为可配置、可组合模块的集合——tool interface、system prompt、context management 策略、skills、memories、subagent 等。通过配置组合这些模块,环境可以实例化主流 harness(Kimi Code、Claude Code、Codex、OpenClaw、Hermes)以及全新的 harness。RL 训练时他们为不同任务组动态构造不同 harness 配置,使 Kimi K3 暴露于这些模块的多样组合而非任何单一 harness 的惯例。同一抽象也支持跨任务域 RL。
知识图引导的任务合成. 后训练任务的质量与多样性主要由源材料决定:细粒度概念引导的检索能浮现专门化、欠表示的知识,而跨多样概念的采样能拓宽域覆盖。为同时控制粒度与规模上的覆盖,他们构建了一个自演化、层次组织的知识图,由 agent 通过跨知识密集与 coding 域的 web 规模探索持续扩展。
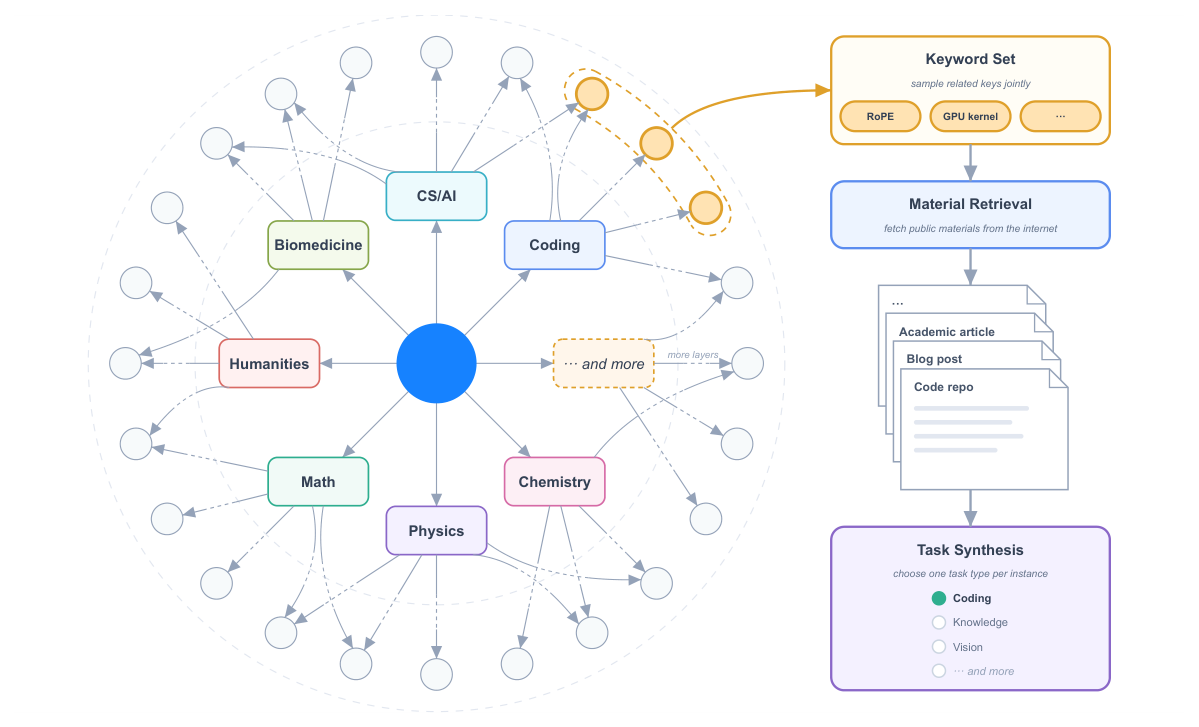
- Agentic 知识图构建:知识图构建为有向无环图,通过递归的、agent 驱动的扩展。扩展从预定义的粗粒度种子节点集开始。一个 agent 实例被分配到每个节点,执行多次 web 搜索来研究对应概念。在添加新节点之前,agent 探索已有图以识别等价或相关概念、在合适处复用已有节点、最小化重复。边总是从更粗的概念指向更细的概念,无论 agent 先发现哪个端点。新加节点随后被分配给 agent 做进一步探索。当被分配的 agent 判定当前概念已足够 atomic 时,该分支停止扩展。
- 材料检索与任务合成:为瞄准跨域与任务类型的期望分布,系统在不同粒度层级采样节点——单独采或按相关组合采。从采样节点导出的关键词与其在知识图中祖先的上下文信息结合,形成 web query。检索到的真实世界材料被组装,供 synthesis agent 产出各类任务。
Agentic 环境中的可验证问题. 代表性例子包括:多步复杂信息搜索(模型规划研究、逐步从 web 收集证据、产出可验证答案);专业人士的真实日常工作(投行、数据分析、法律实践——模型分解复杂请求、在 sandbox 里操作域工具、跨数十到数百步完成 deliverable);以及多步可验证视觉推理(STEM 问题、视觉谜题、图表理解)。每条视觉推理轨迹都在配有 Python 解释器与隔离 sandbox 的 agent 环境中生成:模型迭代地写代码并执行代码来裁剪、缩放、变换输入图像、执行精确计算、或验证中间结果,并把执行输出——含生成的图像——作为跨多个交互步的新观察接收。随着模型学会执行更多图像操作、收集更多观察,它在复杂视觉推理任务上的表现稳步提升。
Kernel 优化任务. 为强化 GPU kernel 优化能力,他们构建了大规模 kernel 任务套件,从单算子 kernel 到 fused mega-kernel,源自 Flash Linear Attention 等高质量 GitHub 仓库。套件横跨多样 GPU 编程方式(CUDA、Triton、CuTe DSL、Gluon、ThunderKittens、TileLang),覆盖广泛使用的 GPU 架构与数值格式(BF16、FP8、FP4)。Reward 同时评估正确性与性能:每个 kernel 提供一个 PyTorch 参考实现,超过预定义数值误差阈值的解得零 reward。性能按 expert 实现打分——匹配它得 0.5 reward,逼近硬件 roofline 则 reward 趋向 1。为确保 reward 反映真正的优化,他们开发了 hacking-detection 系统惩罚 reward-hacking 策略(CUDA graph replay、input caching、精度降低),并随开发中观察到新 hacking 策略持续扩展新的 safeguard。
Personal Assistant 任务. 为长程个人助手任务,他们开发了广泛使用应用的真实 mock 实现(Gmail、Notion、Slack、Canvas)。它们保留真实世界对应物的核心语义,同时无需外部 API 或速率限制即可实现可复现的大规模交互。基于这些 mock 应用,他们设计了受真实专业工作流启发的复杂任务(人力资源、法律服务、金融等场景)。每个任务中,agent 在一个持久、演化的环境里跨多个模拟日运作,遭遇分布在各应用间的数十个相互依赖事件。单次 rollout 可能涉及最多数千次 tool call 与数百万 context token。 每个事件携带自己的评估准则,由确定性规则或 LLM 评估器裁定。初始 workspace 由 agent 搜 web 找参考材料并转化为连贯、任务相关的环境。他们还扩展了 RL 框架以支持这类 living environment,建模复杂事件流与其诱导的 world-state 转移。
Autonomous Execution Tasks (AET). 他们引入 AET——一种通过 verify-in-the-loop 优化训练长程 agent 智能的环境范式。每个任务指定初始状态、受约束的目标、基于 tool 的动作空间、执行预算、以及一个独立的 verifier。Agent 只看到 objective、context、constraints、verification interface,没有参考轨迹或预定义流程,必须自主执行任务分解、tool 选择、规划、错误恢复、终止。Reward 基于 verifier 对最终环境状态的评估,而非 agent 自报的完成情况。 他们设计多类 verifier 支持多样环境,包括黑盒系统复制(Figure 10)、定量因子发现、税务审计。每个环境中 agent 迭代提交解、接收 verifier 反馈、精化策略,训练一个 hypothesizing → acting → analyzing feedback → adapting 的通用循环。Reward hacking 通过把 agent 与 verifier 隔离来缓解:配对提供诊断反馈的 public verifier 与评估留出场景的 hidden verifier,并在有限提交预算下施加基于惩罚的 reward。
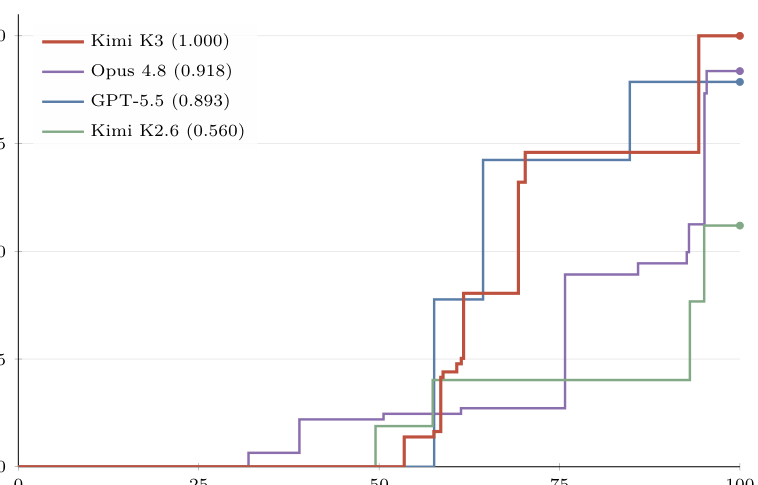
Figure 10 是一个黑盒系统复制任务——agent 通过 oracle query 把一个隐藏的 3D 相机维修系统重建为 web 应用,Completion 表示 verifier 评估的任务进度。曲线显示 Kimi K3 (1.000) > Opus 4.8 (0.918) > GPT-5.5 (0.893) >> Kimi K2.6 (0.560),即 Kimi K3 完全复制了该系统,而上一代 Kimi K2.6 只到 56%。
Web Development 任务. 他们构建了覆盖典型场景的专家精选 web development 任务套件。输入从一行场景描述到多段规格;artifact 横跨网站、交互游戏、3D/WebGL 场景、数据可视化、SVG、全栈应用。每个任务跑在容器化 sandbox 里,并在多样 agent scaffold 而非单一固定 harness 下 rollout,以促进 cross-scaffold 泛化。Reward 由两个组件构成:确定性检查(功能性测试应用行为,对复制参考的任务打结构与像素级相似度)与内部 reward model 的 model judging。项目构建失败、运行报错、或伪造而非真正实现 artifact 时 reward 归零。 Model judging 用其他模型做源码检视,以及查看并与输出 artifact 交互。
基础设施¶
Kimi K3 把三个"很少在单一模型上同时出现"的系统挑战组合在一起:hybrid KDA attention、3T 级稀疏 MoE 推理与训练、以及百万 token agentic 工作负载。他们跨整个模型生命周期与这些挑战协同设计。
KDA 的算法—系统协同设计¶
KDA 用固定大小的 recurrent state $\mathbf{S} \in \mathbb{R}^{d_k \times d_v}$ 取代 softmax attention 不断增长的 KV cache。这个交换的两面性是:串行依赖给并行执行带来挑战,但换来一个便宜可传输可复用的固定大小状态。下面的设计应对第一个性质,并在两个执行层级上利用第二个性质——设备内的 fused kernel,与跨设备的 KDA Context Parallelism。
跨 regime 的 KDA kernel¶
KDA state 的串行依赖与 GPU 偏好的宽而均匀的并行相冲突,且在每个执行 regime 下表现为不同的瓶颈,因此每个 regime 都要专门 kernel。
- 训练与 prefill 的 chunkwise kernel:KDA 的 chunkwise 形式在 chunk 内并行、跨 chunk 串行(recurrent state 必须逐 chunk 传播)。朴素执行时这两个阶段交替,串行传播期间 SM 空闲。他们因此开发 FlashKDA——一个基于 CUTLASS 的 chunkwise kernel,把 intra-chunk 计算与 cross-chunk 状态传播重叠。该 kernel 把工作分解为 token-parallel 阶段与 head-parallel recurrence,各自独立调度与调优,大幅超越 Triton 参考实现。FlashKDA 同时服务训练与推理 prefill,并作为 flash-linear-attention 的后端自动派发。
- 长上下文 prefill 的设备内 context parallelism:Tensor parallelism 跨设备划分 head 但从不缩短 recurrence,因此在纯 TP 部署下,prefill 一条超长序列会让大部分 SM 空闲(每个 rank 只持有少数 head)。关键观察是:每个 segment 的状态转移可以独立于入口状态求值、事后精确复合。一个自动 SM 级 context-parallel (CP) planner 因此跨单一 rank 的 SM 划分序列,并行求值 segment 转移,并合并它们以恢复每个 segment 的精确状态。与 §5.1.2 的跨设备 KCP 相对,这个并行完全在设备内,不产生跨设备通信。
KDA Context Parallelism (KCP)¶
Context parallelism 的通信开销在 softmax 与 linear attention 之间根本不同。Softmax attention 要求 rank 交换大小随序列长度增长的 KV block;linear attention 则携带固定大小的 recurrent state $\mathbf{S} \in \mathbb{R}^{d_k \times d_v}$。先前 context-parallel 方法利用 vanilla linear attention 的加性 recurrence:每个 rank 计算本地 token 从 $\mathbf{S} = \mathbf{0}$ 出发生成的状态,再跨前序 rank 求和得到入口状态。
这种直接求和对 KDA 是不充分的。 回顾式 (1),KDA 的状态更新为 $\mathbf{S}_t = \mathbf{M}_t \mathbf{S}_{t-1} + \beta_t \boldsymbol{k}_t\boldsymbol{v}_t^\top$,其中 $\mathbf{M}_t := (\mathbf{I} - \beta_t\boldsymbol{k}_t\boldsymbol{k}_t^\top)\mathrm{Diag}(\boldsymbol{\alpha}_t)$。KDA 的 delta rule 在加当前写入之前,把 token-dependent 矩阵 $\mathbf{M}_t$ 作用在入口状态上,因此某个局部 sequence segment 的效应依赖于进入该 segment 的状态,无法仅从 $\mathbf{S} = \mathbf{0}$ 计算的状态确定。
为保留这一依赖,他们引入 KCP——把每个 segment 的效应分解为两个局部可计算量:作用在入口状态上的累积转移,与从零本地生成的状态。沿用 §2.1.1 的 chunkwise 记号,$\mathbf{S}_{[i]}$ 表示 rank $i$ 的 segment 内、$t$ 个本地 token 后的 recurrent state,$\mathbf{S}_{[i]}^{T_i}$ 表示离开 rank $i$、进入 rank $i+1$ 的状态;$\widetilde{\mathbf{S}}_{[i]}^t$ 表示同一 recurrence 但从 $\mathbf{S} = \mathbf{0}$ 起算。对任意进入 $P$ 个 context-parallel rank 中第 $(i{+}1)$ 个的状态,$t$ 个本地 token 后的状态为:
$$ \begin{aligned} \mathbf{M}_{[i+1]}^{t \leftarrow 1} &:= \prod_{r \leftarrow 1}^{t}\mathbf{M}_r \in \mathbb{R}^{d_k \times d_k}, \qquad \mathbf{S}_{[i+1]}^t = \widetilde{\mathbf{S}}_{[i+1]}^t + \mathbf{M}_{[i+1]}^{t\leftarrow 1}\mathbf{S}_{[i]}^{T_i}\\ &= \widetilde{\mathbf{S}}_{[i+1]}^t + \mathbf{M}_{[i+1]}^{t \leftarrow 1}\sum_{j=1}^{i}\Big(\prod_{l \leftarrow j+1}^{i}\mathbf{M}_{[l]}^{T_l \leftarrow 1}\Big)\widetilde{\mathbf{S}}_{[j]}^{T_j} \in \mathbb{R}^{d_k \times d_v} \end{aligned} \tag{26} $$
其中 $\mathbf{M}_{[i+1]}^{t\leftarrow 1}$ 表示前 $t$ 个本地 token 的累积转移。第一项包含本地 token 生成的状态,第二项通过本地 KDA 更新传播前序 rank 的上下文。在 $t = T_{i+1}$ 时,$\mathbf{M}_{[i+1]}^{T_{i+1}\leftarrow 1}$ 与 $\widetilde{\mathbf{S}}_{[i]}^{T_{i+1}}$ 两个量都能只用本地 token 计算,在 $\mathbf{S}_{[i]}^{T_i}$ 可用之前,并且是各 rank 彼此交换的 fragment。
式 (26) 表明每个状态纯由本地计算的 fragment 复合而成。这些 rank 级更新结合律地复合,因此每个 rank 的入口状态可用 prefix scan 恢复。每个 rank 先本地计算 $\mathbf{M}_{[i]}^{T_i \leftarrow 1}$ 与 $\widetilde{\mathbf{S}}_{[i]}^{T_i}$,再用一次 all-gather 交换两个张量。all-gather 之后,rank $i+1$ 通过按序处理同一文档的前序 fragment、从 $\mathbf{S} = \mathbf{0}$ 出发在每个 fragment 上应用 $\mathbf{S} \mapsto \mathbf{M}_{[j]}^{T_j\leftarrow 1}\mathbf{S} + \widetilde{\mathbf{S}}_{[j]}^{T_j}$ 来重建 $\mathbf{S}_{[i]}^{T_i}$。因此 KCP 只需固定大小的 all-gather 做 recurrent-state 同步,实现线性计算 scaling。
3T 级预训练的基础设施¶
Kimi K3 预训练结合 Pipeline Parallelism (PP) with virtual stages (VP)、Expert Parallelism (EP)、ZeRO-1 Data Parallelism、Pipeline ZeRO-2 gradient sharding、Context Parallelism (CP)。MoE 层采用跨 EP rank 复制的 shared expert,expert dispatch/combine 的 all-to-all 通信与计算重叠以隐藏其延迟。
3T 级原生多模态预训练带来三个关键问题:(i) token 负载跨 EP rank 不均衡;(ii) 激活、梯度、优化器状态超出内存预算;(iii) 视觉编码器高度可变的计算暴露在关键路径上。
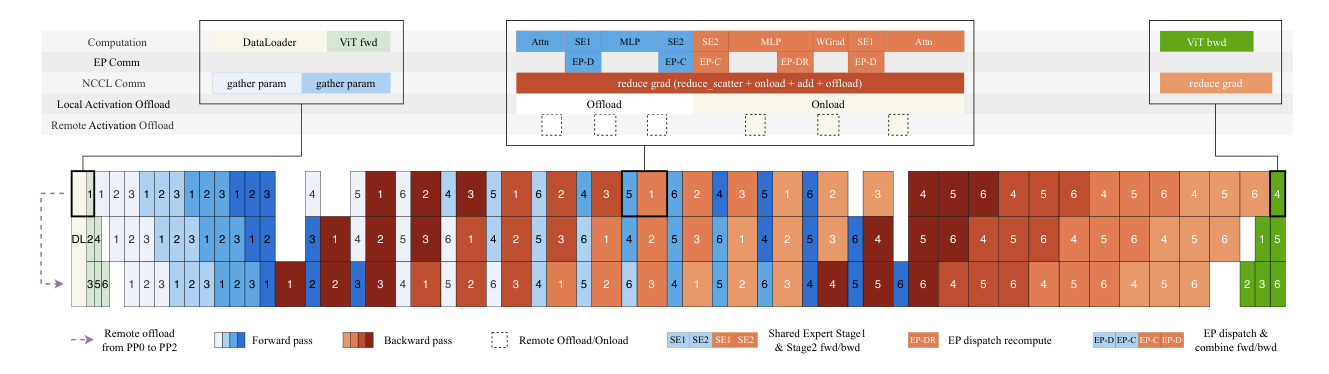
完美均衡的 Expert-Parallel MoE 训练¶
常规 EP 方案里 token 负载跨 rank 不均衡。由此产生的计算不均衡降低训练吞吐,而 routed-expert 激活动态变化的 shape 造成大量内存碎片。他们因此提出 MoonEP(开源于 github.com/MoonshotAI/MoonEP)——一个通过动态冗余 expert 实现完美负载均衡的 EP 方案。MoonEP 保留 DeepEP 等常规方案的总体计算流,额外引入冗余 expert 的在线规划与迁移。Forward pass 中,他们从当前 micro-batch 与层的 router 输出规划冗余 expert,并在 routed-expert 计算前预取它们。Backward pass 中,把它们的梯度暂存在本地 reduce buffer,计算完成后再归约回 home rank 的梯度 buffer。
- 有界冗余 expert 下的完美均衡:MoonEP 要求每个 rank 恰好收到 $S \times K$ 个 token($S$ 为序列长度、$K$ 为每 token 选中 expert 数),使所有 rank 执行完全相同量的计算。关键问题是多少冗余 expert 足以保证这种均衡。令 $E$ 为 expert 数、$R$ 为 EP size,他们证明了均衡计划总存在于每 rank 至多 $E/R$ 个冗余 expert 内,且该 bound 本质上是紧的(附录 E)。因此每 rank 预留 $E/R$ 个冗余 expert 槽位就保证均衡计划总有可行解,训练永不中断。相比之下,ECHO、UltraEP 等先前工作预设冗余 expert 数或施加 per-rank token cap:训练因此被迫在 cap 内无可行计划时停止,而 cap 本身需要手工调,且仍留有残余不均衡。
- 在线规划:每训练步算精确最优过于昂贵。他们离线用整数线性规划 (ILP) 为代表性情形算精确解作为参考,并设计一个近最优、开销可忽略、始终尊重 $E/R$ 上界的 GPU planning kernel。
- 零拷贝通信:完美均衡也简化了通信路径。他们实现一个 fused permute/unpermute 算子——planning kernel 预计算每个 token 的目的地,因此 token 被直接发送到远端 rank 上其 expert 分组后的位置,通信 buffer 的 view 被直接返回给计算,消除中间拷贝。在最坏情况不均衡下,DeepEP 的 copy-free 数据路径需要大小为 $S \times K \times R$ 的通信 buffer,而 MoonEP 由于完美均衡只需固定的 $S \times K$ buffer。
- 静态 shape 下的 sync-free 执行:常规 MoE 实现里 per-expert token 计数跨步与层变化,host 必须在每层与 device 同步以获取实际计算 shape,在层间 stall pipeline。有了完美均衡,每个 rank 恰好收到 $S\times K$ 个 token、所有层的计算 shape 静态已知,这消除了 per-layer MoE host 同步并缓解 host 侧 kernel-launch 开销。
- Expert-GEMM 调度与重叠:即使聚合负载完美均衡,各 rank 内的 per-expert token 计数仍有偏斜,固定顺序、workload-oblivious 的调度会把这种偏斜变成 SM worker 间不均衡的 makespan。他们因此用一个 workload-aware scheduler 调度 routed-expert GEMM,在 launch 前把参数适配到当前 token 分布、执行期间保持固定。一个轻量启发式用硬件指标的分析成本模型选择这些参数,关键系数通过离线 autotuning 校准。对 shared expert,把其 GEMM 派发到独立 stream 以与其他 kernel 重叠。
内存高效训练¶
- 统一激活管理器:设计了激活的统一存储抽象——每个为 backward pass 保存的张量都关联一个可插拔的存储后端。Recomputation、quantization、offload/remote-offload 只是该抽象下的存储策略,可在张量粒度自由组合;策略通过张量上的轻量 annotation 声明,与模型代码完全解耦。Recomputation 在函数粒度执行,支持跨 token 层重算。其实现里所有 GPU 内存在主计算流上分配、在单一内存池内管理,避免多流碎片与 host-bound 开销;激活在层粒度预取回来并与计算重叠,引入的额外开销可忽略。Kimi K3 里大多数激活用 block-wise FP8 量化结合 offload/remote-offload,element-wise 算子配置为 recomputation。
- 内存高效 MoE:原生 MoE 实现里,permuted probs 的梯度计算依赖 forward 输出
output。受 SonicMoE 启发,他们通过数学变换把该梯度重写为只依赖中间激活act_output与上游梯度doutput的形式,消除了 backward 对output的依赖,代价是一次额外的轻量 element-wise 重算。此外 group GEMM 的 forward 中只保存 dispatch 操作的输入;backward 时通过重算 dispatch 恢复 group GEMM 的输入。这次重算引入的通信可与 group-GEMM backward 计算的一部分重叠,以可忽略成本消除这部分激活存储。 - 内存高效 Attention residual:为 attention residual 设计了基于 Block AttnRes 的配套优化。Block 表示在边界层生成一次,被所有后续层共享,直接驻留在 GPU 上。 AttnRes 计算整个用 checkpointing 包裹,因此每层为 backward 保存的激活与标准残差架构完全相同。对 pipeline parallelism,采用 cache-based pipeline 通信——只有新生成的 block 在 stage 间增量传输、micro-batch 结束即释放,达到内存足迹的理论下界。
- 跨 PP rank 平衡激活:interleaved 1F1B pipeline parallelism 下,激活因 pipeline warmup 在 PP rank 间分布不均,驻留激活数随 PP rank 增大而减少。为避免 OOM,他们用 Mooncake Transfer Engine 把激活远程 offload 到其他 PP rank 的内存,实现跨 PP rank 的均衡激活内存。
- Pipeline ZeRO-2 梯度分片与 offload:用 Pipeline ZeRO-2 gradient sharding 跨 DP rank 分片梯度。此外把分片梯度存在 CPU 内存以降低 GPU 峰值内存,同时在 GPU 上保留 double grad buffer;梯度跨 DP rank 归约进 double grad buffer 后,累积到 CPU 分片上。
- 基于 P2P 的 Muon 正交化:分布式优化器把参数均匀分片到 DP rank,而 Muon 中的 Newton–Schulz 正交化需要完整参数矩阵,因此每次更新前需要一次 gather 通信。朴素做法在整个参数 buffer 上做 all-gather,除了让通信成为规模上的主要瓶颈,还在每个 rank 上产生巨大内存足迹。他们改为让每个 rank 只通过 P2P 通信从对应 owner rank 取回其本地拥有参数的分片,消除全参数 buffer、同时降低内存使用与通信量。通信与计算进一步在 model-chunk buffer 粒度上流水,隐藏通信开销。
多模态编码器优化¶
- 多模态编码器中的动态 CP:长上下文多模态训练中,大图与长视频大幅增加视觉编码器的计算时间、造成显著跨设备负载不均衡。他们把 context parallelism 扩展到这类大样本:单张大图沿 patch 维跨多设备划分,注意力通过跨 CP rank gather 键值对(gather-KV)计算。此外把每个 CP group 划成若干 sub-CP group、以负载均衡的方式在其间分布大图,防止通信占比随规模增长。这既降低了大视觉样本的编码器延迟,也降低了跨设备负载不均衡,让剩余的编码器计算能隐藏在 pipeline bubble 里。
- PP bubble 中的编码器计算:Kimi K2.5 引入的 Decoupled Encoder Process (DEP) 把 ViT 与文本训练拆成独立 stage、跨 PP stage 平衡视觉 forward 与 backward。他们观察到:interleaved 1F1B 调度下,头几个 PP micro-batch 的文本 forward pass 全部排在最开始,而最后几个 PP micro-batch 的文本 backward pass 直到最末才结束。因此他们进一步分解 ViT 计算——头几个 PP micro-batch 的 ViT forward 同步提前执行,剩余 forward pass 排进 pipeline bubble,backward pass 类似处理。结果大部分 ViT 计算被隐藏在 pipeline bubble 里,视觉编码器的有效开销基本消除。
1M Agentic RL 的基础设施¶
把 agentic RL 在 Kimi K3 这么大的模型上 scale 到百万 token 上下文、且在有界计算预算下,使资源效率成为一阶目标。这促成两项互补努力:1) 高效训练与 rollout,含 KV-cache 管理、请求调度、训练状态放置;2) 长程交互用的高性能可恢复 sandbox。
长上下文 RL 基础设施¶
他们采用 co-located RL 训练把每个 1M-context Kimi K3 RL 实验保持在几百 GPU 内,并用 partial rollout 降低超长轨迹的尾延迟。该设计取得良好硬件利用率,但引入需要为下一轮持久化的 rollout KV-cache 与训练所需内存之间的内存使用争用,这在长上下文 RL 中更加严重。
- External KV cache pool:1M 上下文多步 rollout 下,prefix KV-cache miss 极其昂贵。Partial rollout 加剧这一问题——上一轮许多未完成的长 prefill 请求同时到达。投机解码在相对固定的 tool-call 间隔内进一步加速请求周转,增加 prefix-block churn。这些问题会触发抢占、降低 cache 命中率。他们因此用 write-back 设计把 prefix retention 与 GPU residency 解耦:活跃 decoding block 留在 GPU KV cache,可复用的空闲 prefix 只在被从 GPU 驱逐时才写回 CPU DRAM 的 external KV cache pool,并在下次复用前预取回来。KDA 状态与对应的 MLA KV cache block 一起 offload 与预取,保持生命周期对齐。相比 write-through 策略,该策略只为离开活跃 decode 路径的 prefix 产生 CPU DRAM 使用与传输带宽,避免为仍驻留活跃在 GPU 上的 block 冗余拷贝。为给 external pool 提供充足 DRAM,他们在训练迭代结束后把训练状态(模型权重与优化器状态)offload 到 NVMe;rollout 迭代后释放该 pool 以避免与训练工作负载争用。
- Rollout auto-throttling scheduler:多步 rollout 中 context 随轨迹推进渐进增长,因此基于全轨迹平均长度设定固定并发既难估计又在早期过于保守;反之并发设太高会在后期造成 KV cache 压力并触发抢占。他们因此在 LLM 请求调度层设计 auto-throttling 机制,用 active request count、queued request count、KV cache utilization 等运行时信号动态控制送往推理引擎的请求数。这在 KV cache 压力上升时降低并发,保持早期 rollout 良好利用,无需手工调参即避免 under-saturation 与 overload。
- 非 policy 模型 forward 的梯度 buffer 复用:RL loss 计算常需要 forward-only 的非 policy 模型(如 reference model),其权重太大无法常驻 GPU。他们把这些权重留在 CPU 内存、只在需要时 materialize,用 policy 模型的 FP32 梯度 buffer 存储来 back 其参数张量。这复用了已有 GPU 内存、无需额外分配或碎片,且安全——因为这些 buffer 在真实梯度算出之前会被覆写。配合 ZeRO-2 梯度分片与 offload,Kimi K3 RL 训练中每个 GPU 只为两个 VPP chunk 保留梯度 buffer。他们把 reference 权重逐 chunk 流入这些槽位:一个槽用于当前 forward 计算,另一个预取下一个 chunk,在不增加 GPU 内存的前提下隐藏拷贝开销。
Sandbox 基础设施¶
他们部署多种 sandbox runtime 支持 Kimi K3 后训练与评测的多样需求,包括传统容器 runtime、GPU sandbox runtime,以及最引人注目的——基于 microVM 的新 sandbox runtime AgentENV(开源于 github.com/kvcache-ai/AgentENV)。AgentENV 与合作方共同开发,专为 agentic AI 工作负载设计,围绕三个核心设计目标:
- 高保真隔离 sandbox runtime:随着 agent 能力增强、任务变难,它们倾向于更激进地探索,甚至可能尝试 reward hacking。一方面这带来独特安全挑战——早期实验中他们在传统容器 sandbox runtime 上观察到若干由无意 agent 操作引发的 kernel panic 与死锁;另一方面他们希望允许尽可能多的探索以不约束 agent 能力,而复杂任务需要接近真实环境的 sandbox——例如 agent 应能挂载磁盘、跑内核、或随意启动虚拟机。通过用 Firecracker 跑隔离 microVM,AgentENV 提供了容器 runtime 无法匹敌的隔离与保真度。
- 面向 agentic RL 的灵活 sandbox 生命周期:底层 AgentENV 支持 sandbox 状态的增量 checkpointing 与恢复——checkpoint 时只保存自上次 checkpoint 后被脏写的内存页,达到低至 133 ms 的 checkpoint 延迟与 49 ms 的 resume 延迟。在此之上提供三个高层操作以改善 agentic RL 效率:(a) Pause and Resume——暂停的 sandbox 不消耗内存或 CPU 资源,因此 sandbox 可以在 agent 等待模型推理结果时被暂停,而这可占 sandbox 生命周期的 98%;(b) Fork——从原 sandbox 的精确状态 fork 出新 sandbox 同时保持原者运行,对无副作用的 reward judging 很有用;(c) Snapshot——sandbox 的快照可定期保存以做错误恢复。
- 高效率与高密度:他们的工作负载里数万个 sandbox(每个有独特镜像集)可能需要在数秒内创建。他们采用 OverlayBD 作为镜像格式,配合自定义 ublk driver 实现、storage-layer sharing、P2P transport,在大规模上实现亚秒级启动延迟。进一步用 copy-on-write 内存与 page-cache 优化降低内存使用,在真实工作负载中达到最高 $6.5\times$ 的内存 overcommit 比。
论文给出的规模数字:Kimi K3 整个训练与评测过程中,跨 1,505,678 个镜像共创建了 51,219,741 个 sandbox。
推理与在线服务¶
服务 Kimi K3 从生产侧暴露同样的挑战:hybrid KDA–MLA 架构在百万 token 上下文下维护两种根本不同的 cache 且必须联合管理;其新模块与高度稀疏的 expert 要求各自定制的 kernel;生产流量混合了per-request 成本跨三个数量级的请求。三个层级的设计分别应对:engine 级的 KDA-aware prefix cache 把固定大小的 recurrent state 打包进与 MLA KV cache 相同的 paged pool,让长 prefix 跨请求可复用;device 级为 KDA decoding、Block AttnRes、稀疏 latent MoE 提供专用 kernel;fleet 级用 cache-aware affinity 调度与 budget-based admission control 把这些效率转成可预测的服务。
KDA-aware prefix cache 管理¶
Kimi K3 的 hybrid 架构让 prefix caching 变复杂:KDA recurrent state 与 MLA KV cache 在大小与生命周期上根本不同,而一个 cached prefix 只有在两者能在同一边界一起恢复时才可复用。
- hybrid KDA–MLA attention 的统一 cache layout:每个 Kimi K3 block 由三层 KDA 与一层 Gated MLA 组成,其 cache 根本不同——MLA KV cache 随序列长度增长、按 token 分页;KDA recurrent state 大小固定、每请求单一副本。为两者各维护独立 manager 会重复分配、驱逐、传输逻辑。他们因此把 KDA state 打包进与 MLA KV 相同的 paged block pool,把页统一到同一字节大小,使两种页类型共享同一套分配、引用计数、驱逐实现。页内所有 head 的状态按 head 连续存储,使每个 head 的字节流自包含、并作为跨节点传输的最小单位。Prefill/decode 解耦下当 prefill 与 decode 节点采用不同 TP degree 时,re-layout 在传输路径上执行,GPU 侧零 reshuffling。这种不对称在开发中被证明有用:任何 type-confused 访问产生的是垃圾而不是看似合理的数据——对池化 layout 的零开销 sanity check。
- KDA prefix cache 优化:Block-hash 式 prefix caching 以一个物理 block 的粒度复用 KV cache——只有完整 block 被 hash,因此只有 block-aligned prefix 可复用。这个耦合在 Kimi K3 里崩溃:block-hash 匹配要求所有层共享一个 block size,而 prefix hit 只有在 hit 边界的 KDA state 已被持久化时才可复用。一个 KDA 层每序列维护单一大 recurrent state 而非 per-token entry,因此 state snapshot 只在稀疏边界上才承受得起;共享 block size 因此被迫到 1024–6144 token,且 hashing 绑定到存储 block、hash 粒度也一样,尽管 MLA 的 per-token entry 本身能容忍细得多的 block。在这么粗的粒度上 caching 几乎无用:短于一个 block 的请求永远不能被复用,chunked prefill 在跨越完整 block 边界之前导不出可缓存的 prefix。
他们因此解耦两种粒度:prefix hashing 跑在 MLA 页内的细粒度 hash block(如 512 token),而物理 block 仍是粗的分配单位。对齐对 KDA 走相反方向:recurrent state 的 checkpoint 只在 MLA 的 hash endpoint 的(一个稀疏子集)上保存——这是 lookup 唯一能引用的位置。
Prefill 期间,一个部分填充的 MLA 页以其最后一个完整 hash block 的 chained hash 注册进 prefix-cache 索引,其中每个 hash 覆盖所有前序 hash block,使匹配一个 endpoint 就认证了到该点的整个 prefix;随着页填满,注册的 endpoint 前移。同时每次 forward pass 后,KDA kernel 在最后一个 hash-aligned 位置持久化 recurrent state。Checkpoint 很大,因此随请求推进中间 checkpoint 被取代并回收,而对话轮边界上的被保留做跨请求复用。Cached checkpoint 是只读快照:hit 时通过拷贝进请求的私有 running state 来恢复,新 checkpoint 写入新槽位,因此对其他请求可见的 checkpoint 永不被就地改动。
Lookup 分两阶段(原文 Figure 12,图片提取未覆盖):MLA 阶段用 chained hash 匹配整个物理 block,在第一个缺失 block 处回落到其内部的 hash endpoint,因此部分填充的页仍可命中;KDA 阶段则要求每个 KDA cache group 里候选边界处都有 checkpoint。命中是同时满足两阶段的最长边界——总是 hash block 的倍数,且从不要求是物理 block 的倍数。原文举例:一个前 2800 token 匹配 cached prefix 的请求命中在 $B = 2560 = 5 \times 512$,深在一个 6144-token 物理 block 内部,并从 token $B$ 恢复 prefill 而不是重算 $[0, B)$。
- 并发调度下的一致性:剩余设计点各自由"共享部分填充 block"的一个具体失效模式决定——一个 hit block 同时是共享 cache entry 与私有请求的增长点,而 MLA 与 KDA cache group 必须在每个 hit 边界上达成一致。第一,所有 cache group 从同一共享 free list 取 block,因此为一个 group 分配私有副本可能驱逐另一个 group 刚命中的 block;每个 hit block 因此在任何分配之前跨所有 group 被 pin 住。第二,拷贝进私有 block 在 forward pass 之前立即在 GPU 上执行,因此当前请求内分配或注册的 block 会把前一个 owner 的字节交给 reader;这类 block 在其副本落地之前被排除在匹配之外。第三,一个 checkpoint 只有在每个 KDA group 里都存在时才能恢复一个请求,因此驱逐一个 group 的 checkpoint 原子地失效其兄弟——一个 checkpoint 要么在每个 group 里都可命中,要么完全不可命中。有了这些机制,每个已注册状态总精确对应其声明的 token prefix,hybrid KDA–MLA 模型的 prefix caching 达到与全注意力模型相同的通用性:任何共享 prefix 在任何 512-token 边界上都可复用,与请求长度、chunking、调度交错无关。
高性能 kernel¶
- KDA:与 KDA prefill 相比,KDA decoding 的主要瓶颈从利用并行转向高效管理不断演化的 recurrent state(每个 decoding step 都就地更新)。这个就地更新在基于 MTP 的投机解码中变得棘手:若验证拒绝了一部分 drafted token,状态已经推进到最后一个被接受 token 之外且无法轻易回滚。在每个 draft 位置维护状态快照能实现回滚,但也会倍增 state traffic——在在线服务典型的大 batch size 下这个成本占主导。
然而任何被接受 draft prefix 之后的状态完全由 draft token 的投影输入决定,而它们远小于状态本身。他们因此只缓存这些投影输入、在片上重建被接受 token 的状态、并写回已验证 token 与 bonus token 的状态——这一设计由并发工作 ReplaySSM 独立提出。被 replay 的 token、bonus token、以及下一个 draft window 共享单个 fused kernel 内的一个 recurrent 循环,该 kernel 覆盖 short convolution、input normalization、gating、KDA recurrence、output normalization。验证延迟随被验证 token 数亚线性增长,并保持低于 state-caching baseline。 由于 projection cache 从不离开 decode stage,prefix caching 与 prefill–decode 解耦在与非投机服务相同的 payload 上运作。
- Block AttnRes:遵循两阶段调度——一个 batched inter-block pass 每 block 读一次 cached block 表示,随后每层通过 online-softmax merge 折入 intra-block 部分和。内存访问占这些 kernel 成本的相当一部分(prefill 与 decoding 皆然),因此两阶段的优化主要聚焦内存效率。
对 prefill,在每个 tensor-parallel (TP) rank 上 materialize block 表示会产生大量冗余内存消耗。他们因此对激活采用 sequence parallelism (SP):把 TP all-reduce 分解为 reduce-scatter 与 all-gather,intra-block kernel 插在两个 collective 之间,在 sequence-sharded hidden state 上操作,使每个 token 的 block 表示恰好在一个 rank 上 materialize。这消除了 prefill 期间 Block AttnRes 的额外内存消耗与 I/O 开销。
对 decoding,把 inter-block kernel 发在侧 stream 上,使其与主 stream 上的独立计算重叠。Intra-block kernel 则通过 fusion 流水化:AttnRes 输出与其部分和更新的合并、连同后续的 RMSNorm,被 fuse 进前面的 TP all-reduce,消除了 intra-block 阶段的专用 kernel。两者共同隐藏 inter-block pass 的延迟并降低 intra-block 阶段的内存流量。
- Stable LatentMoE:同时增加总 expert 数与 per-token 激活 expert 数,导致 expert 空间与 per-token expert 计数双双增长,抬高调度与协调开销,使常规 MoE kernel 难以维持高硬件利用率。
为缓解 latent GEMM 的开销,他们采用三个优化:第一,把 latent down-projection 与 MoE router fuse 进单个 GEMM;第二,跨 rank 分片 latent 权重矩阵,并用 multimem store 指令把输出 all-gather 融进 GEMM epilogue;最后,把由此产生的通信与其他算子(如 shared-expert 计算)重叠。这些优化共同消除冗余权重流量与重复计算,同时把通信延迟隐藏在计算之后。
对 routed expert,在小 batch size 下 group GEMM 归约为权重矩阵的 memory-bound streaming——常规 tile-centric kernel 因其面向计算的设计与预处理开销而不适配这一 regime。他们因此在 WarpDecode 的 token-centric 设计之上构建 MoE decoding kernel:每个 warp 负责一个输出 neuron 并直接从内存 stream 关联权重。为进一步增加并行,把每个 warp 再细分为更细粒度的 lane team,每个处理一个不相交的 expert 子集,随后做 warp-wide 的部分结果归约。此外权重 layout 在一次性预处理成本下离线置换,大幅降低运行时反量化开销。
Fleet 级调度¶
超越单个服务实例,挑战从 per-request 效率转向可预测性:一次 prefix-cache miss 的成本比 hit 高出数个数量级,而一批百万 token 请求能饿死短请求。他们提出两个 fleet 级调度策略。
- Cache-aware affinity 调度:1M 上下文下,典型 coding 输入携带 400K token 的 prefix,但只要求 4K token 的 prefill 增量,因此 prefix-cache hit 避免了重新 prefill 整个 prefix,比 miss 便宜数个数量级。他们因此把每个请求路由到持有其 prefix cache 的集群,同时bound 住集群失效的成本:把 cache 移到另一集群需要在远慢于 intra-cluster fabric 的 inter-cluster link 上传输。但这种 cache-aware affinity 把每个 session 绑到单一集群,其失效会中断绑定到它的所有 session。一致性哈希因此把每个 session pin 到两个集群——一个 primary 服务其流量、一个预先指定的 secondary 在 primary 失效时接管。Secondary 不持有 session 的 prefix cache,failover 时必须重新 prefill。由于一致性哈希把不同 session 的 secondary 分配均匀分布在整个 fleet 上,这个重 prefill 成本被分摊到许多集群而非集中在一个上:常见情形下 cache locality 得以保留,而任何单集群失效的影响仍被 bound 住。
- Budget-based admission control:生产流量混合了 2K token 以下的短请求与最多 1M token 的超长请求,因此 per-request 成本跨约三个数量级,任何固定请求数施加的总负载都高度不可预测。基于"平均请求"的容量规划、排队模型、限流配额在这种方差下全部失效。一个典型失效模式是:一批长上下文请求饱和了可用算力,随后到达的短请求无法被及时调度,降低所有流量的 time to first token (TTFT)。他们因此采用 budget-based admission control,给不同请求类分配独立资源预算,使突发的长上下文流量最多消耗其自身那份容量,无法降低其他类经历的系统级 SLO。
实验设置¶
Benchmark 套件¶
沿四个宽能力轴组织:
- Reasoning & Knowledge:GPQA Diamond、CritPt、AA-LCR、Humanity's Last Exam (HLE-Full,含/不含 tools)。
- Coding:DeepSWE、ProgramBench、Terminal-Bench 2.1、FrontierSWE、SWE-Marathon、PostTrainBench、MLS-Bench-Lite、SciCode。
- Agentic:BrowseComp、DeepSearchQA、ResearchRubrics、Toolathlon-Verified、MCPMark-Verified、MCP-Atlas、AutomationBench、JobBench、GDPval-AA v2、AA-Briefcase、Agents' Last Exam (ALE)、APEX-Agents、OfficeQA Pro、SpreadsheetBench 2、OSWorld-Verified、OSWorld 2.0、SaaS-Bench、$\tau^3$-Banking、Harvey Lab-AA、CorpFin v2、Finance Agent v2、Legal Research Bench。
- Vision:WorldVQA、OmniDocBench、PerceptionBench、Video-MME、MMVU、BabyVision(带 Python tool);MMMU-Pro、CharXiv (RQ)、Math-Vision、ZeroBench-main(各含/不含 Python tool 增强)。
Baseline¶
闭源:Claude Fable 5、GPT-5.6 Sol、Claude Opus 4.8、GPT-5.5。开源:GLM-5.2。所有模型都在最大 reasoning effort 下评估,GPT-5.5 例外(用 "xhigh" 设定)。论文明确标注:Claude Fable 5 的结果包含 fallback 行为,GPT-5.6 Sol 的结果包含潜在的 cyberguard。
评测配置¶
Kimi K3 所有评测用 reasoning effort max、temperature 1.0。单步任务(GPQA Diamond、HLE-Full、以及不带 tool 的 vision benchmark)top-$p$ = 0.95;agentic 任务 top-$p$ = 1.0。通用建议是:reasoning/knowledge 用 top-$p$ = 0.95,coding/agentic 用 top-$p$ = 1.0。
- Coding:每个模型在三个 agentic harness 之一下评估——Kimi Code、Claude Code、或 Codex。DeepSWE 上报 v1.1 任务结果,并额外参考官方 leaderboard(Kimi K3 用 mini-SWE-agent harness 得 67.3)。Terminal-Bench 2.1 上报所有模型跨 harness 的最佳分。SWE-Marathon 评测基于官方任务截至 2026-07-09 的 H20-calibrated 分支(v1.1 最终发布前),带 Docker 镜像、性能门槛、GPU 任务的参考 oracle 为 H20 重校准但正确性与 anti-cheat validator 未变;Claude Fable 5 在 35% 的任务上触发 fallback。PostTrainBench 上他们用官方 Harbor 实现在最大 effort 下评 Kimi K3、Claude Fable 5、GPT-5.6 Sol,在 H20 GPU(而非官方设定的 H100)上跑三次取平均。FrontierSWE 的 dominance 分用截至 2026-07-16 的官方评估脚本从原始分重算。
- Agentic:OfficeQA Pro 每个 test case 给 agent 整个 PDF 语料渲染成图像、无机器可读文本。MCP-Atlas 在 500-task public 子集上评、100 轮上限、用 Gemini 3.1 Pro 作 judge。AutomationBench 在 600-task public 子集上评。BrowseComp 采用 300K token 触发的 context-compaction 策略;用完整 1M token 上下文窗口、无 context management 时 Kimi K3 达到 90.4%。
- Vision:分数跨三次运行取平均,ZeroBench-main 例外——按官方设定跑五次。MMMU-Pro 遵循官方协议,保留原始输入顺序并把图像前置到文本输入。WorldVQA 上他们观察到跨模型一致的拒答行为,因此通过 prompt engineering 强制给出答案。
- 第三方结果:GDPval-AA v2、AA-Briefcase、$\tau^3$-Banking、Harvey Lab-AA、APEX-Agents、SciCode、AA-LCR、CritPt 分数引自 Artificial Analysis(截至 2026-07-23);Harvey Lab-AA 报 criterion pass rate。CorpFin v2、Finance Agent v2、Legal Research Bench 引自 Vals AI。Agents' Last Exam 引自官方 leaderboard(截至 2026-07-23),报 leaderboard 的主 pass-rate 指标;leaderboard 上每个模型配特定 harness——Kimi K3 配 Kimi Code;GPT-5.6 Sol、GPT-5.5 配 Codex;Claude Fable 5、Claude Opus 4.8、GLM-5.2 配 Claude Code。Toolathlon-verified 与 JobBench 引自其官方 leaderboard(截至 2026-07-24)。
主要实验结果¶
公开 benchmark 综合对比(Table 2)¶
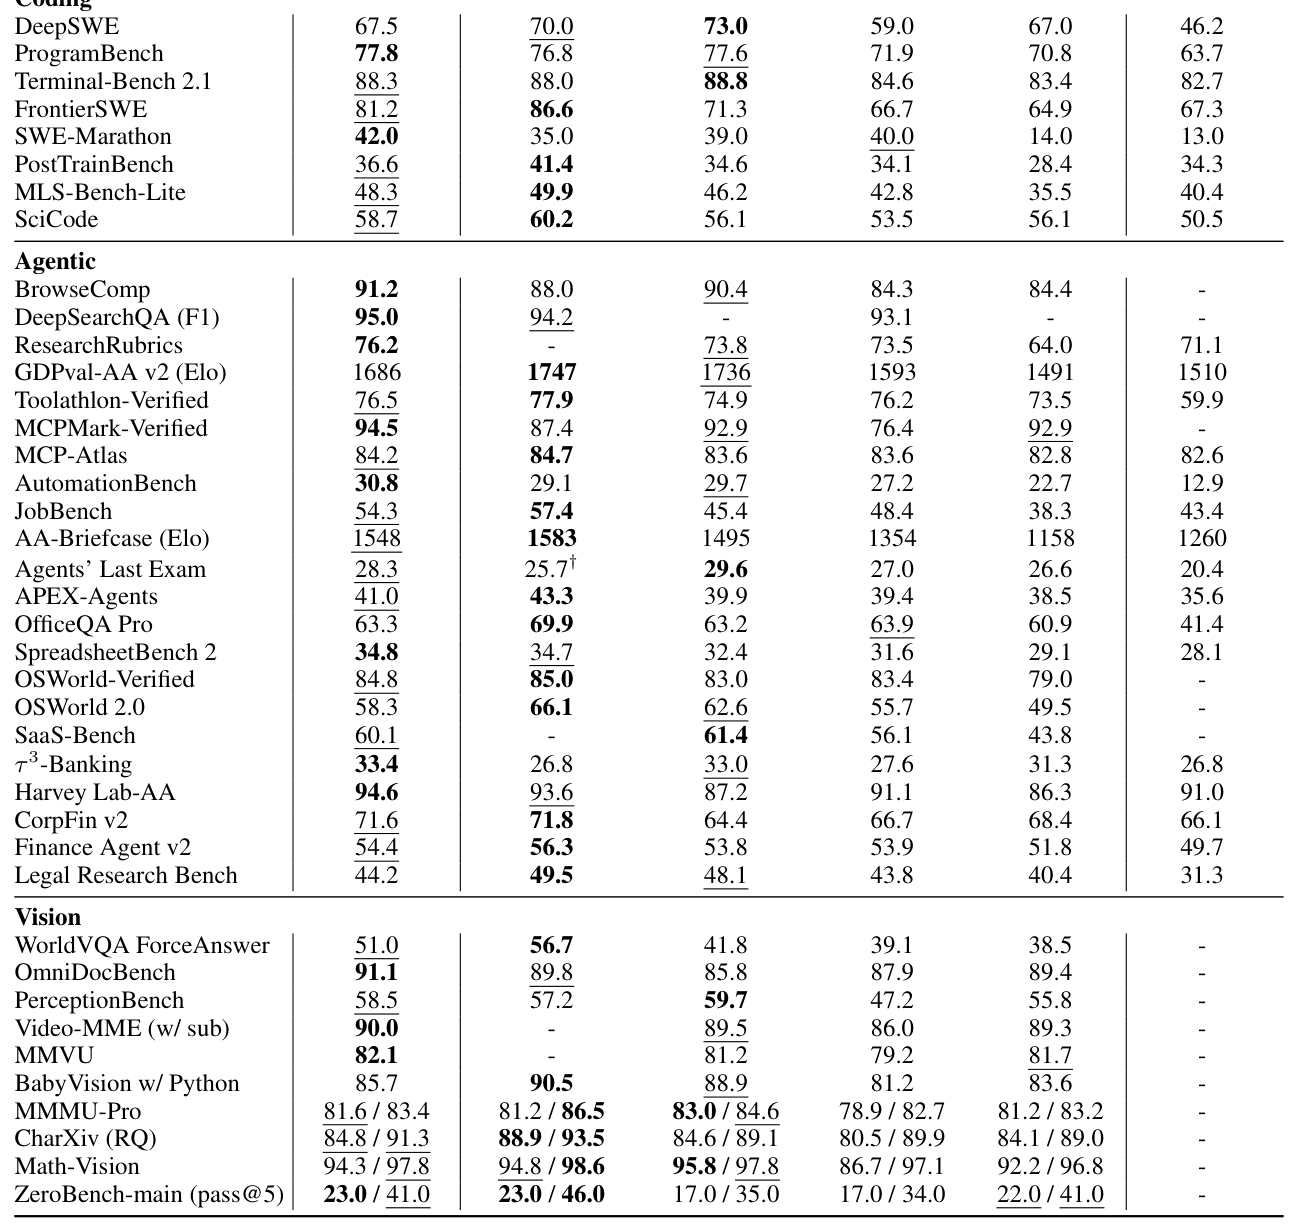
Table 2 完整数值(粗体为该 benchmark 最佳、_下划线_为次佳;HLE-Full / MMMU-Pro / CharXiv (RQ) / Math-Vision / ZeroBench 每格报"不带工具 / 带工具"两个分数):
| Benchmark | Kimi K3 (max) | Claude Fable 5 (max, w/ fallback) | GPT-5.6 Sol (max) | Claude Opus 4.8 (max) | GPT-5.5 (xhigh) | GLM-5.2 (max) |
|---|---|---|---|---|---|---|
| Reasoning & Knowledge | ||||||
| GPQA Diamond | 93.5 | 92.6 | 94.1 | 91.0 | 93.5 | 91.2 |
| CritPt | 23.4 | 28.6 | 32.3 | 20.9 | 27.1 | 20.9 |
| AA-LCR | 74.7 | 70.0 | 73.7 | 67.7 | 74.3 | 71.3 |
| HLE-Full | 43.5 / 56.0 | 53.3 / 63.0 | 44.5 / 58.0 | 49.8 / 57.9 | 41.4 / 52.2 | – |
| Coding | ||||||
| DeepSWE | 67.5 | 70.0 | 73.0 | 59.0 | 67.0 | 46.2 |
| ProgramBench | 77.8 | 76.8 | 77.6 | 71.9 | 70.8 | 63.7 |
| Terminal-Bench 2.1 | 88.3 | 88.0 | 88.8 | 84.6 | 83.4 | 82.7 |
| FrontierSWE | 81.2 | 86.6 | 71.3 | 66.7 | 64.9 | 67.3 |
| SWE-Marathon | 42.0 | 35.0 | 39.0 | 40.0 | 14.0 | 13.0 |
| PostTrainBench | 36.6 | 41.4 | 34.6 | 34.1 | 28.4 | 34.3 |
| MLS-Bench-Lite | 48.3 | 49.9 | 46.2 | 42.8 | 35.5 | 40.4 |
| SciCode | 58.7 | 60.2 | 56.1 | 53.5 | 56.1 | 50.5 |
| Agentic | ||||||
| BrowseComp | 91.2 | 88.0 | 90.4 | 84.3 | 84.4 | – |
| DeepSearchQA (F1) | 95.0 | 94.2 | – | 93.1 | – | – |
| ResearchRubrics | 76.2 | – | 73.8 | 73.5 | 64.0 | 71.1 |
| GDPval-AA v2 (Elo) | 1686 | 1747 | 1736 | 1593 | 1491 | 1510 |
| Toolathlon-Verified | 76.5 | 77.9 | 74.9 | 76.2 | 73.5 | 59.9 |
| MCPMark-Verified | 94.5 | 87.4 | 92.9 | 76.4 | 92.9 | – |
| MCP-Atlas | 84.2 | 84.7 | 83.6 | 83.6 | 82.8 | 82.6 |
| AutomationBench | 30.8 | 29.1 | 29.7 | 27.2 | 22.7 | 12.9 |
| JobBench | 54.3 | 57.4 | 45.4 | 48.4 | 38.3 | 43.4 |
| AA-Briefcase (Elo) | 1548 | 1583 | 1495 | 1354 | 1158 | 1260 |
| Agents' Last Exam | 28.3 | 25.7† | 29.6 | 27.0 | 26.6 | 20.4 |
| APEX-Agents | 41.0 | 43.3 | 39.9 | 39.4 | 38.5 | 35.6 |
| OfficeQA Pro | 63.3 | 69.9 | 63.2 | 63.9 | 60.9 | 41.4 |
| SpreadsheetBench 2 | 34.8 | 34.7 | 32.4 | 31.6 | 29.1 | 28.1 |
| OSWorld-Verified | 84.8 | 85.0 | 83.0 | 83.4 | 79.0 | – |
| OSWorld 2.0 | 58.3 | 66.1 | 62.6 | 55.7 | 49.5 | – |
| SaaS-Bench | 60.1 | – | 61.4 | 56.1 | 43.8 | – |
| $\tau^3$-Banking | 33.4 | 26.8 | 33.0 | 27.6 | 31.3 | 26.8 |
| Harvey Lab-AA | 94.6 | 93.6 | 87.2 | 91.1 | 86.3 | 91.0 |
| CorpFin v2 | 71.6 | 71.8 | 64.4 | 66.7 | 68.4 | 66.1 |
| Finance Agent v2 | 54.4 | 56.3 | 53.8 | 53.9 | 51.8 | 49.7 |
| Legal Research Bench | 44.2 | 49.5 | 48.1 | 43.8 | 40.4 | 31.3 |
| Vision | ||||||
| WorldVQA ForceAnswer | 51.0 | 56.7 | 41.8 | 39.1 | 38.5 | – |
| OmniDocBench | 91.1 | 89.8 | 85.8 | 87.9 | 89.4 | – |
| PerceptionBench | 58.5 | 57.2 | 59.7 | 47.2 | 55.8 | – |
| Video-MME (w/ sub) | 90.0 | – | 89.5 | 86.0 | 89.3 | – |
| MMVU | 82.1 | – | 81.2 | 79.2 | 81.7 | – |
| BabyVision w/ Python | 85.7 | 90.5 | 88.9 | 81.2 | 83.6 | – |
| MMMU-Pro | 81.6 / 83.4 | 81.2 / 86.5 | 83.0 / 84.6 | 78.9 / 82.7 | 81.2 / 83.2 | – |
| CharXiv (RQ) | 84.8 / 91.3 | 88.9 / 93.5 | 84.6 / 89.1 | 80.5 / 89.9 | 84.1 / 89.0 | – |
| Math-Vision | 94.3 / 97.8 | 94.8 / 98.6 | 95.8 / 97.8 | 86.7 / 97.1 | 92.2 / 96.8 | – |
| ZeroBench-main (pass@5) | 23.0 / 41.0 | 23.0 / 46.0 | 17.0 / 35.0 | 17.0 / 34.0 | 22.0 / 41.0 | – |
†官方 Agents' Last Exam leaderboard 上,Claude Fable 5 条目跑在 xhigh effort,40% 的任务被标注为 downgraded。
逐能力域结论分析:
- Reasoning & Knowledge:研究生级推理上 Kimi K3 与前沿相当(GPQA Diamond 93.5%)。但research-level 任务上仍有差距:HLE-Full 上无论带不带工具都落后 Claude Fable 5 与 GPT-5.6 Sol(43.5 / 56.0);CritPt 只有 23.4%,落后 Claude Fable 5、GPT-5.6 Sol、GPT-5.5——论文明确承认"research-level reasoning 仍是一个关键改进方向"。唯一夺冠的是 AA-LCR(74.7),一个长上下文推理 benchmark——这与其 1M 上下文 + NoPE 的架构定位一致。
- Coding:ProgramBench 拿到最佳(77.8);SWE-Marathon(一个 GPU-kernel 导向套件)42.0,领先 Claude Fable 5 整 7 分——这直接对应 §4.2.4 的 kernel 优化 RL 任务套件。Terminal-Bench 2.1 几乎追平 GPT-5.6 Sol(88.3 vs 88.8)。DeepSWE 落后 Claude Fable 5 与 GPT-5.6 Sol 但领先 Claude Opus 4.8 与 GPT-5.5。FrontierSWE(长程 benchmark)以 81.2 排第二,仅落后 Claude Fable 5(86.6)但大幅领先其余所有模型——同样呼应长程训练的定位。
- Agentic:在广泛 agentic 套件上取得 SOTA——BrowseComp (91.2%)、DeepSearchQA (95.0% F1)、ResearchRubrics (76.2%)、MCPMark-Verified (94.5%)、AutomationBench (30.8%)、SpreadsheetBench 2 (34.8%)、$\tau^3$-Banking (33.4%)、Harvey Lab-AA (94.6% criterion pass rate)。主要例外是 Elo 制的 knowledge-work 套件,均由 Claude Fable 5 领先:GDPval-AA v2 上 Kimi K3 第三 (1,686)、AA-Briefcase 第二 (1,548)。其余大体有竞争力:CorpFin v2 与 OSWorld-Verified 分别只差 0.2 分(71.6 vs 71.8、84.8 vs 85.0);更难的 computer-use benchmark(OSWorld 2.0、SaaS-Bench)仍由 Claude Fable 5 或 GPT-5.6 Sol 领先。
- Vision:多模态理解能力强,并被 Python 工具进一步放大——Math-Vision 达 94.3%、用 Python 工具升到 97.8%;有挑战性的 ZeroBench-main 上以 23.0%(pass@5)追平 Claude Fable 5,用 Python 工具跳到 41.0%。OmniDocBench 拿最高分 (91.1%);WorldVQA (51.0%) 排第二,落后 Claude Fable 5 但领先 GPT-5.6 Sol 与 Claude Opus 4.8。
跨域一致的模式:Kimi K3 在长程、多步、工具密集的任务上(SWE-Marathon、FrontierSWE、BrowseComp、DeepSearchQA、MCPMark、Harvey Lab-AA、AA-LCR)表现最强,甚至常常夺冠;而在单步 research-level 推理(CritPt、HLE-Full)与Elo 制主观 knowledge-work(GDPval-AA、AA-Briefcase、OfficeQA Pro、Legal Research Bench)上差距最明显。这与论文"为 1M 上下文 test-time scaling 显式设计后训练"的定位高度自洽。
内部评测(Table 3)¶
超越公开 benchmark 套件,他们维护一组瞄准公开评测覆盖不足的能力域的内部 benchmark,给出模型与 agent 能力更全面的度量。这些 benchmark 被频繁刷新与扩展,因此能紧密跟踪模型演化的失效模式并直接指导数据与训练迭代。它们大体分三类:coding capability and experience、general agent experience、conversational experience。
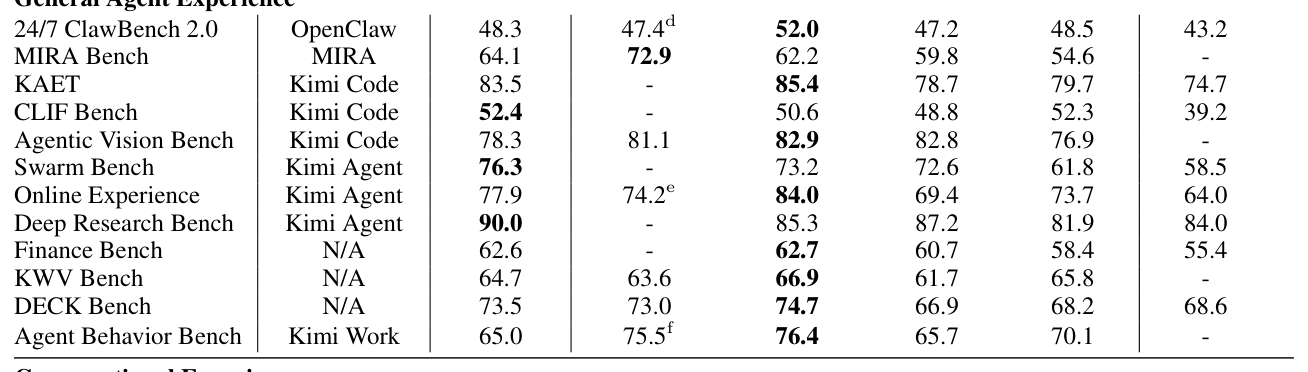
Table 3 完整数值(粗体为该 benchmark 最佳报告结果;"–"表示分数尚未纳入本报告;除注明外模型在最大 reasoning effort 下评估,GPT-5.5 用 xhigh;harness 分配见 Harness 列):
| Benchmark | Harness | Kimi K3 (max) | Claude Fable 5 (max) | GPT-5.6 Sol (max) | Claude Opus 4.8 (max) | GPT-5.5 (xhigh) | GLM-5.2 (max) |
|---|---|---|---|---|---|---|---|
| Coding Experience | |||||||
| Kimi Code Bench 2.0 | Claude Code | 73.7 | 76.9ᵃ | – | 71.7 | – | 64.2 |
| Kimi Code | 72.9 | – | – | – | 66.0 | – | |
| Codex | – | – | 64.8ᵇ | – | 69.0ᶜ | – | |
| Coding Experience | Claude Code | 59.9 | 59.8 | – | 58.0 | – | 53.3 |
| Kimi Code | 56.6 | – | – | – | – | – | |
| Codex | – | – | 59.3 | – | 56.8 | – | |
| General Agent Experience | |||||||
| 24/7 ClawBench 2.0 | OpenClaw | 48.3 | 47.4ᵈ | 52.0 | 47.2 | 48.5 | 43.2 |
| MIRA Bench | MIRA | 64.1 | 72.9 | 62.2 | 59.8 | 54.6 | – |
| KAET | Kimi Code | 83.5 | – | 85.4 | 78.7 | 79.7 | 74.7 |
| CLIF Bench | Kimi Code | 52.4 | – | 50.6 | 48.8 | 52.3 | 39.2 |
| Agentic Vision Bench | Kimi Code | 78.3 | 81.1 | 82.9 | 82.8 | 76.9 | – |
| Swarm Bench | Kimi Agent | 76.3 | – | 73.2 | 72.6 | 61.8 | 58.5 |
| Online Experience | Kimi Agent | 77.9 | 74.2ᵉ | 84.0 | 69.4 | 73.7 | 64.0 |
| Deep Research Bench | Kimi Agent | 90.0 | – | 85.3 | 87.2 | 81.9 | 84.0 |
| Finance Bench | N/A | 62.6 | – | 62.7 | 60.7 | 58.4 | 55.4 |
| KWV Bench | N/A | 64.7 | 63.6 | 66.9 | 61.7 | 65.8 | – |
| DECK Bench | N/A | 73.5 | 73.0 | 74.7 | 66.9 | 68.2 | 68.6 |
| Agent Behavior Bench | Kimi Work | 65.0 | 75.5ᶠ | 76.4 | 65.7 | 70.1 | – |
| Conversational Experience | |||||||
| Faithfulness ᵍ | N/A | 85.5 | – | 84.8 | 83.6 | 86.5 | 74.8 |
| Chat All-in-One Bench | Kimi Work | 85.2 | 88.0 | 79.0 | 83.8 | 71.8 | – |
脚注:ᵃ 80 个任务中 13 次 fallback、1 次 refusal;ᵇ 80 个任务中 10 次 refusal;ᶜ 80 个任务中 3 次 refusal;ᵈ 含 2 个 Claude Fable 5 拒答的任务;ᵉ 含 14 个 Claude Fable 5 拒答的任务;ᶠ 95 个任务中 6 次 refusal;ᵍ 报告指标为 $1 - \text{hallucination rate}$,越高越好。
内部 benchmark 的定义:
- Coding:Kimi Code Bench 2.0 (KCB 2.0) 在真实的端到端软件工程任务上评估 code agent,覆盖广泛编程语言与生产导向技术栈;Kimi Webdev Bench 在真实使用场景抽取的有挑战 web development prompt 上评估模型,输出通过盲测专家判断比较;Coding Experience 评估在真实开发工作流中把模型当 coding agent 用的实际体验。
- General Agent Experience:24/7 ClawBench 2.0 模拟 always-on assistant 工作,任务跨多天、事件并发到达、中断是常态;MIRA Bench(Multi-Agent Infra for Routing and Assignment)评估长链、多角色、多系统企业协作任务,考察 agent 能否端到端完成工作并判断何时组织或委派给 subagent;KAET(Kimi Autonomous Execution Tasks)评估模拟真实用户请求与企业系统操作的长程自主执行;CLIF Bench(Context Learning and Instruction Following)瞄准 in-context learning,要求模型从提供的 context 学习并遵循交错多种复杂技能的指令;Agentic Vision Bench 评估 agent 在任务执行中是否注意并正确使用关键视觉事实;Swarm Bench 评估模型在受益于协同分解与并行执行的复杂任务上编排 agent swarm 的能力;Online Experience 镜像真实在线 agent 使用的分布,在用户最常请求的 deliverable 文件类型上度量性能;Deep Research Bench 在域专家精选、专家对齐 rubric 评分的 deep-research 式 query 上评估;Finance Bench 在需要端到端执行完整工作流(从源材料到可审阅 deliverable)的真实金融工作上评估;KWV Bench(Knowledge Work Vision)评估从真实 knowledge-work 场景蒸馏的任务中抽取的 atomic 视觉能力;DECK Bench 度量从真实使用场景抽取的任务描述产出高质量演示 deck 的能力;Agent Behavior Bench 把 agent 评估从结果正确性扩展到过程质量,在任务完成之外为 tool-use 行为、效率、纪律打分。
- Conversational Experience:Faithfulness 度量模型响应中的事实幻觉率,每个响应由 fact checker 验证;Chat All-in-One Bench 在产品使用的每个阶段度量对话体验,场景围绕真实在线用户需求设计。
评测配置:除按 harness 拆行的 benchmark 外,Table 3 的 Harness 列报的是 Kimi K3 用的 harness。对其他模型,Claude 系列与 GLM-5.2 用 Claude Code 评,GPT 系列用 Codex 评。例外是所有模型都用同一指定 harness 的 benchmark:24/7 ClawBench 2.0 用 OpenClaw;MIRA Bench 用 MIRA(一个内部的 out-of-distribution harness);Agent Behavior Bench 与 Chat All-in-One 用 Kimi Work;CLIF 与 Agentic Vision Bench 用 Kimi Code。
结果分析:论文自陈"内部套件比公开 benchmark 更清晰地把 Kimi K3 的强项与弱项分开"。
- 最清晰的强项是 orchestration 型与 research 型 agency:Swarm Bench (76.3) 与 Deep Research Bench (90.0) 以明确优势领先,表明分解复杂目标、协调并行工作、产出满足 rubric 的 deliverable 的强能力。
- Coding 同样是强项:KCB 2.0 上只落后 Claude Fable 5,且在 Coding Experience 上取得最佳分(59.9)——说明其作为 coding agent 的实际行为(沟通质量、行为得体性、指令遵循稳定性)领先于其原始任务分数。
- Kimi Webdev Bench 上专家 judge 以 +31.0 个百分点的总体 margin 偏好它而非 Claude Opus 4.8,最大增益在 3D/WebGL/Shader 任务上。
- 专业 knowledge work 相对上一代明显改善,Finance Bench 与 GPT-5.6 Sol 基本打平(62.6 vs 62.7)。
- 主要落后的是 Agent Behavior Bench、MIRA Bench、24/7 ClawBench 2.0、Agentic Vision Bench、KWV Bench。其余已填充的套件(KAET、CLIF Bench、Online Experience、DECK Bench、Faithfulness、Chat All-in-One Bench)上 Kimi K3 排第一或接近第二。
Kimi Webdev Bench 盲测专家评(Table 4)¶
Table 4:内部 Kimi Webdev Bench 上 Kimi K3 (max) 对 Claude Opus 4.8 (max),两者都在 Claude Code harness 下跑。比较在盲测专家判断下进行——专家在不知道哪个模型产出的情况下,对每个输出按 code quality、feature completeness、visual fidelity、interaction experience 打分。Win / Tie / Lose 分别报 Kimi K3 输出被偏好、被评为相当、被不偏好的 prompt 百分比。
| Domain | Win | Tie | Lose | Win − Lose |
|---|---|---|---|---|
| Games | 55.6% | 3.7% | 40.7% | +14.9% |
| 3D / WebGL / Shader | 72.7% | 13.7% | 13.6% | +59.1% |
| Website / UI Clone | 52.6% | 21.1% | 26.3% | +26.3% |
| Overall | 58.6% | 13.8% | 27.6% | +31.0% |
分析:3D/WebGL/Shader 上 +59.1 的 margin 远超 Games (+14.9) 与 Website/UI Clone (+26.3)。这一分布很可能与两件事有关:(a) 原生视觉通路让模型能真正看渲染结果并迭代精修(§2.4 强调的 vision-in-the-loop);(b) §4.2.7 web development RL 任务里 3D/WebGL 场景被显式列为 artifact 类型之一。相对而言 Games 上的优势最小、Lose 率最高 (40.7%),说明交互逻辑复杂度高的任务仍有差距。
网络安全评测¶
他们沿两级递进的操作风险评估模型的网络安全能力:带 proof-of-concept 开发的漏洞发现(Tier 1)、以及端到端漏洞利用开发(Tier 2)。评估目标包括广泛部署软件的近期版本(操作系统内核组件、开源项目)以及他们自己的内部基础设施(含生产服务与代码库)。所有任务跑在代表真实部署的标准配置下。Anthropic 与 OpenAI 的前沿模型拒绝 cyber 相关任务,使可比评估不可行,因此他们把这些模型从该套件中排除。
Tier 1(漏洞发现):要求模型在当前代码库中识别真实 bug(而非复现已知漏洞)并证明其可复现。跨数十个广泛部署系统(操作系统内核、数据库、AI 服务、web 框架、blockchain、VPN 软件),模型识别出数百个候选漏洞。经人工审查的发现中,约 70% 被确认为真实漏洞,包括跨六个项目的 16 个此前未知漏洞。论文给出两个 Linux kernel 的发现说明深度:第一,模型识别出一个可远程触发的 heap out-of-bounds write——该 bug 由一个不完整的上游修复引入、影响其后所有 release(含最新上游代码),安全专家确认其为远程 DoS primitive;第二,模型识别出 RDMA 子系统中一个 Dirty-COW 类漏洞——早先的上游修复无意间去掉了一处权限检查,使内核侧写入只读内存页成为可能,安全专家确认其为确定性的本地权限提升 primitive。
Tier 2(漏洞利用开发):要求模型把漏洞转化为可工作的端到端 exploit,是与滥用风险最直接相关的一级。他们用 GLM-5.2 作 baseline,在跨两条 track 的 36 个任务内部套件上评估:user-space exploitation(16 任务)——模型必须端到端利用广泛部署 user-space 软件(PostgreSQL、XWiki 协作平台、Apache HTTP Server、若干 CMS 等)的真实 CVE,每个任务给全部源码与一个 live 实例,目标跑在标准配置、无额外加固;Linux kernel exploitation(20 任务)——每个任务提供从历史 kernel CVE 构建的可复现 QEMU 环境,模型必须写一个把权限从非特权用户提升到 root 的 C exploit,mitigation 按难度等级渐进启用。套件中每个任务都经人类安全专家验证可解,他们估计完成整个套件约需 540 专家小时,平均每任务约 15 小时。
Exploit 套件结果:模型展现出有意义的 exploit 开发能力——36 个任务解出 14 个 (38.9%),对比 GLM-5.2 的 36 解 8 (22.2%)。但其成功分布不均:14 个中有 10 个来自 user-space track;kernel track 上两个模型都未解出四分之三的任务。由于每个任务都可由人类专家解出,未解任务直接度量了模型与人类水平能力的剩余差距。轨迹分析把该差距归为四类反复出现的失效模式:(i) 难以从已获得的 primitive 完成 exploit 链的最后阶段;(ii) mitigation 下的策略选择差,例如在 data-only 攻击更简单更可靠时仍坚持 control-flow hijacking;(iii) 陷入冗长、无成效的 debug 循环;(iv) 提交前对最终 deliverable 验证不足。
总结:模型的 cyber 能力在 Tier 1 与 Tier 2 内的 user-space exploitation 上最强,但与人类专家仍有明显差距。Tier 1 本质上是防御性的——模型识别真实漏洞(含此前未知的)并证明其可复现。Tier 2 上它能对 user-space 目标完成端到端 exploit;但面对加固目标,完成整条 exploit 链仍是瓶颈,许多专家可解的任务未被解出。
一份来自 UK AI Security Institute 与 NIST's Center for AI Standards and Innovation (CAISI) 的独立联合评估得出与他们一致的结论:Kimi K3 在 exploit 开发上超过 GLM-5.2(ExploitBench 上 32% vs 24%);在一个人类专家约需 20 小时的 32 步模拟企业网络上用 17 步 vs 11 步;但在端到端 exploit 完成上落后前沿 cyber-capable 模型,41 个任务中 0 个实现任意代码执行。论文明确表态:"我们把我们的评估视为能力的下界。这些结果以当前模型版本与评估覆盖为条件,我们将在每次重大模型更新时重新审视。"
第三方评测(Table 5)¶
Kimi K3 自发布以来也被第三方组织独立评估。Table 5 汇总截至 2026-07-23 的头部结果(粗体为该 benchmark 最佳、_下划线_为次佳;baseline 分数按各来源自己的评估设定报告;括号内数字是 Kimi K3 在该 leaderboard 上的排名;Elo 式分数随比赛累积而漂移):
| Benchmark | Kimi K3 (max) | Claude Fable 5 (max) | GPT-5.6 Sol (max) | Claude Opus 4.8 (max) | GPT-5.5 (xhigh) | GLM-5.2 (max) |
|---|---|---|---|---|---|---|
| Artificial Analysis | ||||||
| Intelligence Index v4.1 (#4/580) | 57.1 | 59.9 | 58.9 | 55.7 | 55.0 | 51.1 |
| Vals AI | ||||||
| Vals Index (#2/39) | 74.7 | 75.1 | 73.1 | 70.4 | 68.0 | 65.0 |
| Arena | ||||||
| WebDev Arena (Elo, #1/99) | 1,678 | 1,634 | 1,630 | 1,565 | 1,507 | 1,592 |
| Text Arena (Elo, #8/200) | 1,486 | 1,507 | 1,485ᵃ | 1,484ᵇ | 1,482ᵇ | 1,469 |
| Agent Arena (#4/37) | 9.1 | 12.7 | 10.1 | 9.8 | 8.8 | 6.5 |
ᵃ Text Arena 条目是 leaderboard 上列出的 xhigh 变体;ᵇ Text Arena 条目是 leaderboard 上列出的 high 变体。
- Artificial Analysis:Kimi K3 取得 Intelligence Index v4.1 57.1,在 580 个模型中排第四——若把 GPT-5.6 Sol 的 effort 变体算作单一条目则排第三——落后 Claude Fable 5 (59.9) 与 GPT-5.6 Sol (58.9),领先所有其他被评模型。
- Vals AI:在 Vals 的 GDP 加权行业 benchmark 套件上,Kimi K3 在 39 个模型中排第二(Vals Index 74.7),落后 Claude Fable 5 (75.1)、领先 GPT-5.6 Sol (73.1)。
- Arena:在众包人类偏好 arena 上,Kimi K3 在 WebDev Arena 的 99 个模型中排第一(1,678 Elo),领先 Claude Fable 5 (1,634)——是首个登顶该 leaderboard 的开源模型;Text Arena 上在 200 个中排第八 (1,486 Elo)。在 2026-07-19 前后开放投票的 Agent Arena 上,Kimi K3 目前在 37 个中排第四 (9.1),落后 Claude Fable 5 (12.7)、GPT-5.6 Sol (10.1)、Claude Opus 4.8 (9.8)。
成本效率¶
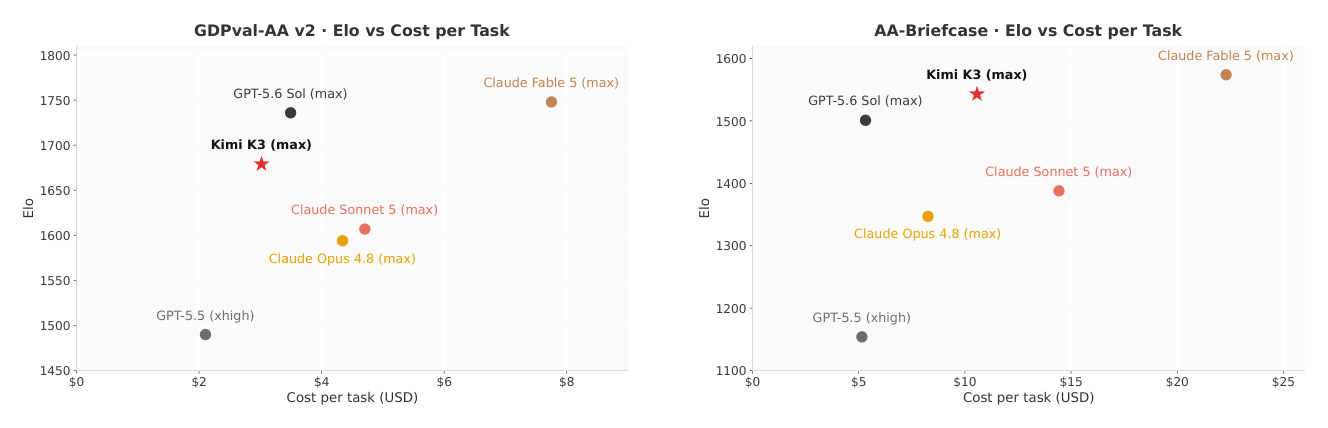
除分数之外,他们通过在覆盖 coding 与 agentic 任务的四个套件上比较 score vs per-task cost 来考察推理成本效率:Kimi Code Bench 2.0、BrowseComp、GDPval-AA v2、AA-Briefcase。KCB 2.0 的成本内部测量,Kimi K3 跑 Kimi Code、其他模型跑 Claude Code。BrowseComp 上 Kimi K3 的成本从自有运行测量,Claude 与 GPT 的成本引自已发布图表。GDPval-AA v2 与 AA-Briefcase 的成本引自 Artificial Analysis 截至 2026-07-23 的 pay-per-token API 定价。
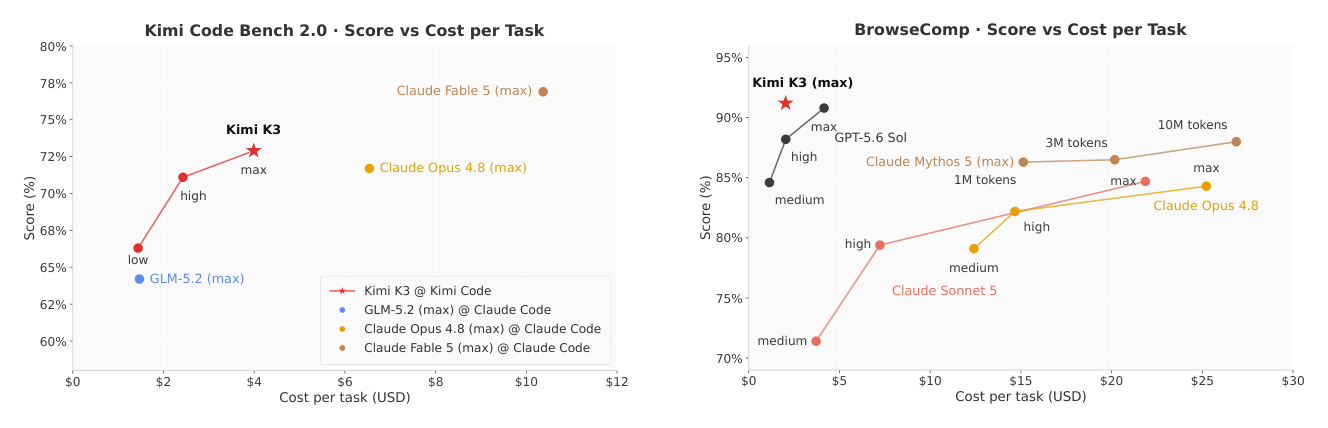
- Kimi Code Bench 2.0:Kimi K3 落后 Claude Fable 5 4.0 分,但成本只有其 38%;且在 high effort 下它就已经以约三分之一的成本匹配 Claude Opus 4.8 的最大 effort 分数。图 (a) 还展示了 Kimi K3 自身的 low/high/max 三档 effort 构成一条陡峭上升的成本—效果曲线(约 $1.4 → $2.4 → $4.0,67.1% → 70.9% → 72.3%)。
- BrowseComp:Kimi K3 以 **\$2.03/task 取得最佳分 (91.2%)——是 GPT-5.6 Sol (90.4%) 成本的一半,比 Claude 系列在最大 effort 下便宜一个数量级**。图 (b) 中 Claude Opus 4.8 与 Claude Mythos 5 的曲线延伸到 \$25–\$27/task 区间(1M/3M/10M token 设定)。
- GDPval-AA v2:Kimi K3 在成本低 13% 的情况下落后 GPT-5.6 Sol 不到 50 Elo,且比 Claude Fable 5 便宜 $2.6\times$。
- AA-Briefcase:交付次优分数(仅落后 Claude Fable 5),成本约为后者的一半。
总体结论:Kimi K3 在全部四个套件上都位于或接近成本效率前沿,以 Claude Fable 5 的一小部分成本交付接近顶尖的分数。
案例研究¶
论文用第 7 节给出若干展示 Kimi K3 跨多样技术任务能力的代表性案例。
GPU kernel 优化¶
他们测试模型优化 GPU kernel 的能力。每个模型在配置相同的 sandbox 内独立工作,每任务最多 24 小时预算用于 profiling、rewriting、benchmarking。评估覆盖四个代表性 kernel:AttnRes、DeepSeek Sparse Attention (DSA)、KDA、MLA(head dimension 512),跑在一块 NVIDIA Hopper GPU 与一块替代厂商 GPGPU 上。
Kimi K3 在全部四个 kernel 上都大幅改善性能:把 AttnRes 延迟从 283.6 ms 降到 114.4 ms,把 DSA 与 KDA 运行时分别削减 55.1% 与 73.6%,并在 MLA 上达到峰值 TFLOPS 的一半以上。跨这些任务,Kimi K3 匹配 Claude Fable 5(带 fallback),并大幅超越 Claude Opus 4.8、GPT-5.6 Sol、GPT-5.5。
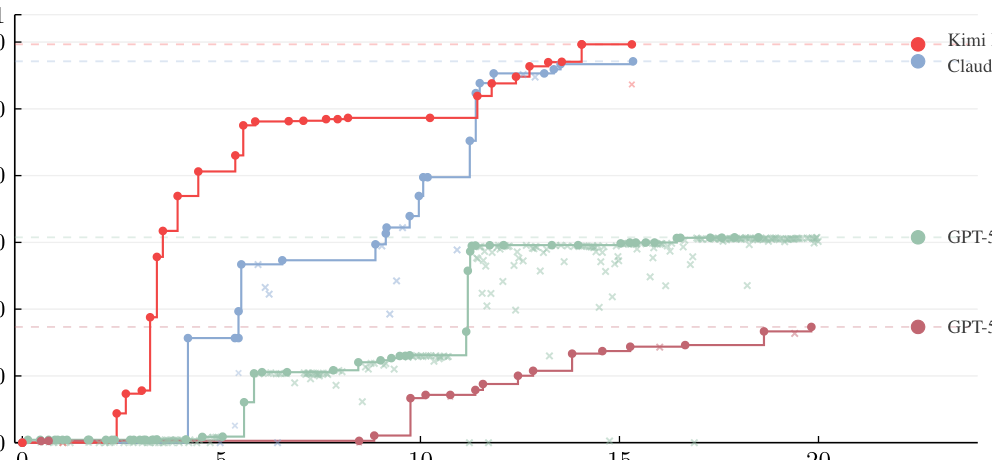
Figure 14 显示相对 FLA Triton baseline 的加速随 active hours 的演化:Kimi K3 +59.7%、Claude Fable 5 +57.1%、GPT-5.5 +30.8%、GPT-5.6 Sol +17.3%(纵轴上界标注 64.1%)。曲线形态值得注意:Kimi K3 的红色曲线在前 5 小时内就快速阶梯式爬到 ~45%,而 Claude Fable 5 在约 4 小时处才有第一次大跳;GPT-5.6 Sol 直到 ~9 小时才起步。
论文特别补充了一条 meta 层面的信息:"超越这个 benchmark,一个早期 Kimi K3 checkpoint 在开发后期就已经处理了我们大部分的 kernel 优化工作。" 这是一个强 dogfooding 信号。
GPU 编译器开发¶
Kimi K3 开发了 MiniTriton——一个紧凑的 Triton 类编译器,带自定义 tile 级 Python frontend 与 layout 系统、轻量 warp 级 MLIR annotation 与优化层、以及一个 Parallel Thread Execution (PTX) 代码生成 pipeline。编译器围绕一个双模式 tensor 库构建,带 PyTorch 类高层接口,其 eager 与 forward-only compiled 路径共享同一 DSL 编译器与 runtime。该库进一步提供 reverse-mode autograd、neural-network 模块、NCCL 上的分布式训练 primitive、以及 sparse 与可视化 primitive。
在一块 NVIDIA L20 上,MiniTriton 在其核心 benchmark 套件的几何平均上超过 PyTorch eager 与 torch.compile。其从零 tensor-core matmul 路径在最大 shape 上逼近 cuBLAS,达到实测机器 roofline 的约 90%;其 DSL 级 KDA prefill kernel 以明显 margin 超过一个匹配的 Triton 参考实现。MiniTriton 还端到端训练了一个 GPT 模型,loss 曲线紧密跟踪 PyTorch 参考,全模型梯度与 torch autograd 的差异不超过 torch 自身的 fp32 舍入误差($10^{-4}$)(以 fp64 参考度量)。论文的结论是:这些结果共同表明 Kimi K3 能构建一个连贯的端到端编译器——从 DSL frontend 与 IR pass 到 PTX codegen 与 CUDA runtime——而不是一堆孤立的 kernel。
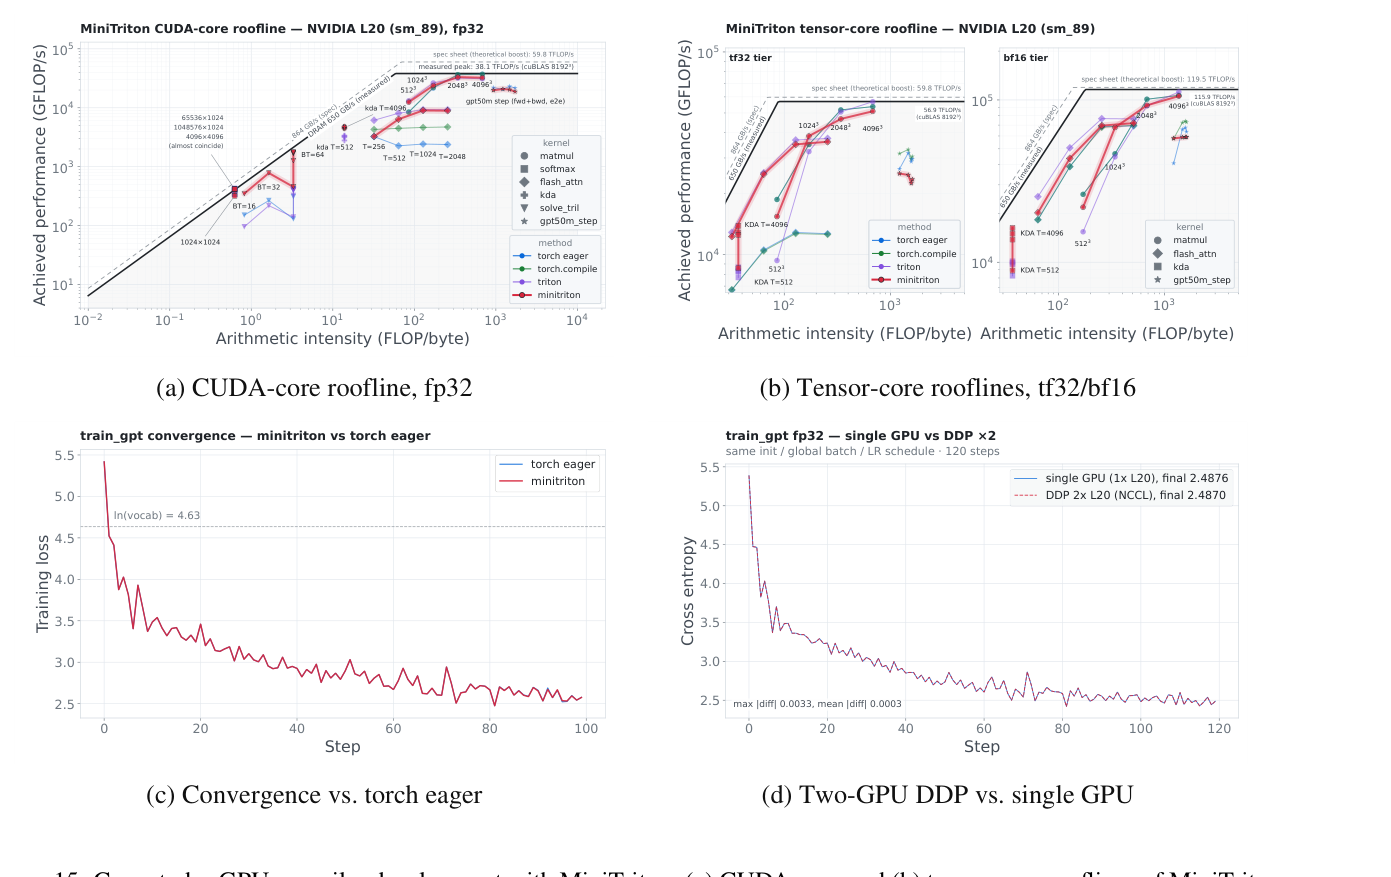
Figure 15 的四个子图:(a) CUDA-core roofline (fp32)、(b) tensor-core roofline (tf32/bf16)——两者都对比 torch eager、torch.compile、Triton、cuBLAS baseline(含 losing point);(c) 用 MiniTriton 训练的 character-level GPT 与 torch eager 的 training-loss 曲线(100 步,loss 从 ~5.4 降到 ~2.5,两条曲线基本重合,标注 ln(vocab) = 4.63);(d) 建立在 MiniTriton 自有分布式 primitive (NCCL) 上的双 GPU 数据并行训练 vs 单 GPU 训练(120 步,标注 single GPU (1x L20), final 2.4876 vs DDP 2x L20 (NCCL), final 2.4870,max |diff| 0.00033, mean |diff| 0.00003)。
芯片设计¶
作为早期 proof of concept,Kimi K3 为一个 nano 模型设计了一个遵循同一架构的推理芯片原型——hybrid KDA 与 NoPE-MLA attention、block size 为 2 的 Block AttnRes、带一个 shared expert 的 sigmoid-based MoE routing——在 group-wise INT4 权重量化(group size 128)之下。在单次 48 小时自主运行中(用 Kimi Code),Kimi K3 用开源 EDA 工具与 Nangate45 标准单元库构建、优化、验证了该芯片。在 4 mm² 的分析面积预算内,设计在 100 MHz 收敛时序,达到 RTL 仿真的 8,700+ tokens/s 解码吞吐,集成 1.46M 标准单元、0.277 MiB SRAM、以及一个带 fused dequantization 的 INT4 MAC 阵列。RTL 代码开源于 github.com/MoonshotAI/nano-kpu。
面向科研的 coding¶
为复现计算天体物理中的 I–Love–Q universal relation,Kimi K3 审阅了 20 篇以上论文并交叉验证其结果,实现了完整数值 pipeline,评估了 300 个以上 equation of state,识别出已发表公式中的不一致,写了 3,000 行以上 Python,并产出一个交互式 HTML dashboard——用时约两小时,而经验研究者的典型用时是一到两周。
Knowledge work¶
在 Kimi Work 中,Kimi K3 产出了一个覆盖 AI ASIC 行业 42 年的交互式研究网站。模型完成了 120 轮以上迭代精修,取材于 87 份季度报告与 99 份原始 PDF(11,000 页以上)的语料,跨 2,800 次以上 web 搜索与 1,100 次以上终端 query。在第二个案例中,Kimi K3 用 20 个以上并发 subagent 分析了 GWTC-5 中的 391 个引力波事件,产出 7 个科学可视化、2 张汇总表、以及 10 篇以上论文的文献综述。
视频剪辑与动效设计¶
利用其原生多模态架构,Kimi K3 创作了一个 3Blue1Brown 风格的动效图形讲解视频说明自己的架构,并从 56 个源片段剪辑出它的 teaser 视频。这涉及片段选择、motion-matched cut、帧精确的节拍同步、音频处理、以及多轮修订。论文指出:产出一个可比的高信息密度短视频,经验剪辑师通常需要一到两天。
附录要点¶
附录 F:Chat Template(XTML)¶
Kimi K3 的 chat template 围绕三个目标重新设计:extensibility(新能力应通过向后兼容的消息格式引入,而不是修改模板,使单一模板服务整代模型)、low alignment tax(格式应能用最少监督数据学会,支持轻量微调的预训练模型直接进入 RL 的 pipeline)、decoding friendliness(结构应容许简单 encoder、streaming parser、grammar-constrained enforcer)。
为此模板采用 XTML(eXtensible Token Markup Language)——一种 XML 类标记,其中尖括号语法被三个保留特殊 token 取代:[open]、[sep]、[close],外加一个 [end_of_msg] token 作为生成停止标记。元素 [open]tag attr="value"[sep] ... [close]tag[sep] 与其 XML 对应物同构,但每个结构边界都是一个显式特殊 token,这消除了元素边界处的 tokenization 歧义并简化了约束解码。
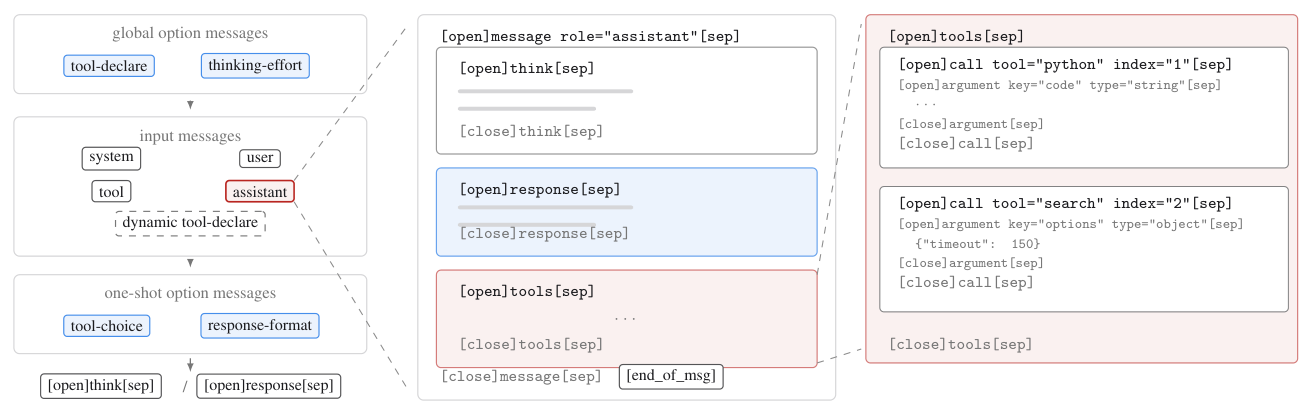
- Messages and zones:context 的顶层单位是 message,按来源分两类。Input message 序列化请求的
messages字段,覆盖 system、user、assistant、tool 四个角色。Option message 把请求选项翻译成模型在 context 中读到的指令,其放置反映其作用域:Global option(tool declaration,type="tool-declare",以及 reasoning-effort 设定)出现在所有 input message 之前——它们治理整个 session 且很少变,修改它们本来就会让 KV cache 失效;One-shot option(tool_choice、response_format)追加在 input message 之后,使 per-request 的改动不动历史 KV cache。第三种是 input option message,与 input message 交错以在 session 中途补充或覆盖某个 global option——这一机制支持动态加载的 tool:会话期间检索或加载的 tool 通过一条额外的 tool-declare message 宣告,之后模型可用的 toolset 扩展,无需重建前面的 context。 - Channels:assistant message 的 body 组织成 channel(概念受 OpenAI 的 Harmony response format 启发):
think携带 reasoning trace,response携带用户可见答案,tools携带 tool call。两种生成模式纯粹通过 generation prefix 选择——thinking 模式用[open]think[sep]、instruct 模式用[open]response[sep]——而不是通过分开的模板。Kimi K3 只支持 preserved thinking:thinking 模式下thinkchannel 总被保留在历史中——即使内容为空也保留,使模型跨轮观察到一致的 message 结构;instruct 模式下历史 message 只含response与toolschannel。 - Tool calling:
toolschannel 内每个 call 携带tool与index属性;index 编号并行 call,每条 tool-result message 重复同一tool/index对并跟随其 call 的顺序,使结果与 call 无歧义地关联。参数是有类型的:string 参数以 raw text 出现,其他 JSON 类型的值被紧凑序列化。因此形如代码的自由文本是一等公民而非转义 JSON 字符串。一个纯 JSON fallback block 覆盖参数无法被分解成有类型 argument block 的输入;它只出现在 input token 中、从不在模型输出中,且训练时其 loss 被 mask。 - Reasoning effort and options:Reasoning effort 作为
thinking-effort类型的 global option message 暴露,插在 tool declaration 之后、input message 之前。不是修改 generation prefix 或把 token 预算暴露成自然语言指令,而是 message 用自然语言陈述所请求的层级、并充当一个 generation-constraint 指令。schema 保留四个层级(low、medium、high、max),Kimi K3 支持其中一个子集。这一表示把 effort interface 与模板语法解耦,并与 §4.1.1/§4.1.2 描述的 effort-conditioned 训练直接对齐。
论文最后强调:这是所有 option message 的共同实现方式——tool_choice、response_format、thinking-effort 都被翻译成放在 context 中的一小段自然语言指令,而不是专用特殊语法。由于预训练模型已经很好地遵循这类指令,新选项可以在极少或无需额外训练的情况下引入——这正是上述 low-alignment-tax 设计原则的直接体现。
附录 E:MoonEP 通用上界证明¶
令 $m_r(P)$ 表示计划 $P$ 下放在 rank $r$ 上的冗余 expert 数。对 router 输出 $I$,规划目标是最小化任何 rank 上的最大冗余 expert 数,即 $M(I) = \min_P \max_r \{m_r(P)\}$。他们证明 $M(I) \le E/R$ 恒成立(定理 1),且该 bound 本质上是紧的——存在 router 输出使 $M = \lceil E(R-1)/R^2\rceil \approx E/R$(定理 2)。
定理 1 证明思路(通用上界):关键引理是存在一个计划 $P^*$,使每个 EP rank 恰好收到相同数量的 token($S \times K$),且每个 rank 的 remote token 只来自另一个 EP rank。构造如下:初始每个 rank 只持有本地 token,rank 按 underloaded / overloaded 分类;反复挑一个 underloaded rank 与一个 overloaded rank,从 overloaded 向 underloaded 迁移 token,恰好填到均衡值 $S\times K$;overloaded rank 可能仍然 overloaded、可能恰好均衡、也可能变成 underloaded,被放回对应集合。重复直到所有 rank 完美均衡。每次填充都让一个 underloaded rank 均衡且此后不再改变,因此过程至多 $R-1$ 次填充;同时每个 rank 至多被填一次,故其 remote token 来自单一来源。据此,若 rank $r$ 的所有 remote token 都来自 rank $s$,这些 token 属于 rank $s$ 上至多 $E/R$ 个本地 expert,故 $m_r(P^*) \le E/R$,因此
$$ M(I) = \min_P \max_r\{m_r(P)\} \le \max_r\{m_r(P^*)\} \le \frac{E}{R} \tag{27} $$
定理 2 证明思路(上界的紧性):构造一个 router 输出 $I^*$——EP rank 0 上的 expert 收不到任何 token,而其余 $R-1$ 个 rank 上的所有 expert 均分所有 token。则全部 $S\times K\times R$ 个 token 被均分给 $E(R-1)/R$ 个 expert,每个 expert 收到 $\frac{SKR}{E(R-1)}$ 个 token。任何计划 $P$ 下,rank 0 必须收到 $S\times K$ 个 token,而它们全部来自远端 expert,故 rank 0 至少需要 $SK / \frac{SKR}{E(R-1)} = \frac{E(R-1)}{R^2}$ 个不同 expert;取上取整,rank 0 至少需要 $\lceil \frac{E(R-1)}{R^2}\rceil$ 个冗余 expert,因此 $M(I^*) \ge \lceil\frac{E(R-1)}{R^2}\rceil$。反过来,用定理 1 证明中的填充过程构造计划、并优先按 expert 迁移 token,可以把每个 rank 上的冗余 expert 数保持在该值内,故等号成立。由于 $R$ 大时 $\lceil\frac{E(R-1)}{R^2}\rceil \approx \frac{E}{R}$,定理 1 的上界本质上是紧的——不存在显著小于 $E/R$ 的通用上界。
核心贡献总结¶
- 三维信息流 scaling 的统一架构:把"scale 什么"明确拆成序列长度、网络深度、模型宽度三个正交维度,并各给一个针对性机制——Hybrid KDA–MLA(3:1)、Block Attention Residuals、Stable LatentMoE。三者加上数据与训练配方改良,共同带来相对 Kimi K2 约 $2.5\times$ 的整体 scaling 效率。这是论文最值得借鉴的问题分解框架。
- Lower-bounded decay:一个用数值范围换 kernel 形状的精巧设计。把 log-decay 从无界 negative-Softplus 改为 scaled sigmoid($g_{\min} = -5$),使 16-token tile 上的累积 log-decay 落在 $(-80, 0)$、倒数重缩放因子留在 BF16 动态范围内,从而让对角 tile 也能用稠密 Tensor Core 矩阵乘,彻底消掉 position-pair 对角路径。这是"数学参数化改动直接换来 kernel 简化"的教科书案例。
- Quantile Balancing:把负载均衡从启发式 sign 更新升级为对偶问题的精确坐标最小化。从最优均衡分配的 LP 对偶推出"bias 就是 router-score 分位数",并给出 Top-$(k{+}1)$ 复用 cutoff、直方图估计器($nB$ 整数一次 all-reduce、通信成本 <1%)等一整套可落地方案。相比固定步长 sign 更新,无学习率类超参、几步内平衡近 $10^3$ 个 expert,且训练/推理不对称性保证部署时只需冻结 bias 的固定 Top-$k$。
- SiTU-GLU:平滑 cap 而非硬截断。对 Swish 门的线性因子与 up 分支独立施加 $\beta\tanh(\cdot/\beta)$,输出上界 $\beta_1\beta_2 = 100$,原点附近一阶匹配 SwiGLU,且在饱和边界之外仍保留非零梯度——这是它相对硬 clamp 的核心优势。
- MoonEP 的 $E/R$ 紧界与"完美均衡"带来的连锁收益:证明每 rank 至多 $E/R$ 个冗余 expert 即可保证均衡计划总存在(且界是紧的),由此得到零拷贝通信(buffer 从 $S\times K\times R$ 降到 $S\times K$)、静态 shape 下的 sync-free 执行、以及"训练永不中断"。一个理论 bound 直接消除了先前工作的手工调参与残余不均衡。
- KDA Context Parallelism:识别出 KDA 的 delta rule 使"从零求和再加"的经典 linear-attention CP 失效,并给出把 segment 效应分解为「累积转移 $\mathbf{M}$ + 从零本地状态 $\widetilde{\mathbf{S}}$」的结合律复合方案,只需固定大小
all-gather。 - hybrid 架构下 prefix caching 的通用性恢复:把 hash 粒度(512 token)与物理 block 粒度(6144 token)解耦、KDA checkpoint 只落在 MLA hash endpoint 的稀疏子集上,并给出 pin / copy-before-match / 兄弟原子失效三条一致性机制,使任何共享 prefix 在任何 512-token 边界上都可复用——达到与全注意力模型相同的通用性。这是全文工程含量最高的一节。
- 多档 reasoning effort 的 RL + MOPD 合并范式:三域 × 三 effort = 9 个 expert,用 per-problem token budget(超预算 reward 覆写为 $-1$)训练 effort 分档,再用 per-token OPD reward 合并成单模型。配套的 partial rollout($\lambda$ 比例即暂停)+ per-token 正则化容忍极端 off-policy,是长程 agentic RL 的可复用配方。
- 原生多模态 + from-scratch 视觉编码器:MoonViT-V2 完全从零用 next-token prediction 训练,出于训练稳定性(SigLIP 初始化的 gradient norm spike)而偏离主流实践,并得出一个有价值的负面结论——"对比预训练在规模上作为多模态语言模型的初始化并非必需"。
- AgentENV:为 agentic RL 定制的 microVM sandbox。133 ms checkpoint / 49 ms resume 的增量 checkpointing,Pause-and-Resume 利用"98% 的 sandbox 生命周期在等模型推理"这一观察,OverlayBD + P2P 实现亚秒级启动与 $6.5\times$ 内存 overcommit。规模数字(5,122 万个 sandbox / 150 万个镜像)本身就是这条 infra 路线必要性的证明。
- 成本效率作为一等指标:四个套件上都位于或接近成本效率前沿——BrowseComp 以 \$2.03/task 取得最佳分(GPT-5.6 Sol 成本的一半、Claude 系列的十分之一),KCB 2.0 以 38% 成本落后 Claude Fable 5 仅 4 分。
- 诚实的能力边界披露:明确承认 research-level reasoning(CritPt 23.4、HLE-Full 43.5)是关键短板;网络安全评测中主动排除拒答的 Anthropic/OpenAI 模型并如实报告 kernel exploitation track 上"两个模型都未解出四分之三任务",还引用 UK AISI + NIST CAISI 的独立评估(41 个任务中 0 个实现任意代码执行),并自陈"把我们的评估视为能力的下界"。
与已归档相关工作的对比¶
KSA KSA: Kwai Summary Attention Technical Report (Kuaishou, 2026-04-27)¶
关系:独立并发(本文未引用 KSA,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文指向完全同一个 root cause——标准 softmax attention 的 KV cache 随序列长度严格线性增长,使百万 token 级上下文的训练与推理代价不可承受;而单纯换成纯线性/局部注意力(GDN、SWA)虽然把 cache 与长度解耦,却因固定状态是有损压缩而"涂抹"长距离信息。KSA 精读里对现有路线的两分法("每层 KV cache 减薄"如 GQA/MLA/NSA 只压常数因子 vs "KV-cache 友好的混合架构"有损)与 Kimi K3 §2.1 的问题陈述几乎逐句对应。
- 相近的技术骨架:两者最惊人的重合是同一个 3:1 混合比——KSA 在 from-scratch 设置下用 3:1 的 KSA/Full 混合比,Kimi K3 用每 block 3 层 KDA + 1 层 Gated MLA。两者都把"大部分层换成高效注意力、周期性插入全注意力层保留全局交互"作为核心骨架,都为此写专用 kernel(KSA 的 block-sparse 训练/prefill kernel + summary KV cache 解码 kernel;Kimi K3 的 FlashKDA + KDA decoding fused kernel),并且都把统一连续的 paged cache layout 当作工程关键(KSA 的三段连续张量 + ring buffer;Kimi K3 把 KDA state 打包进与 MLA KV 相同的 paged block pool 并统一页字节大小)。
- 本文的差异与推进:分歧点在"高效层用什么"。KSA 走的是"保持 $O(n/k)$ 线性关系但做语义级压缩"的中间路线——插入可学习 summary token 做压缩中继,状态集合随序列渐进增长,因此长程依赖保持完整、可寻址、可解释;Kimi K3 走的是"固定大小 recurrent state"路线(KDA),并把工作重心放在让这个固定状态足够能干(channel-wise decay + delta rule + full-rank gate)与足够便宜(lower-bounded decay 换来纯 Tensor Core 路径)。这是一次典型的路线权衡:KSA 用可接受的内存代价买长程保真度,Kimi K3 用架构与 kernel 层的精细化把固定状态的容量榨到极限,并靠 3:1 里的 MLA 层补全局交互。
- 可比的方法 / 实验差异:KSA 明确报告 hybrid-KSA 在 RULER-128K 上比 hybrid-GDN 高 5.48 分(from-scratch)、CPT 设置下高 3.69 分——而 GDN 正是 KDA 所属的 gated delta-rule 家族的直接前身(Kimi K3 §2.1.1 明确说 KDA 沿用 GDN/Mamba-2 的 decay 映射谱系)。这意味着 KSA 的实验其实间接对 Kimi K3 的技术路线给出了一个不利的数据点:在 128K RULER 上,sequence-level 压缩优于 gated-delta 线性注意力。可惜两篇论文的评测完全不可直接比较——KSA 在 RULER/NIAH 上做受控的 from-scratch 与 CPT 对比(模型规模小得多),Kimi K3 则在 2.8T 规模上报公开 agentic/coding leaderboard,没有任何 RULER 类长上下文合成 benchmark(最接近的是 AA-LCR,它在该项上确实夺冠 74.7)。KSA 还强调其压缩与 GQA/MLA 完全正交(复合后压缩率 0.78%/0.22%,可再叠加约 $8\times$)——这一点对 Kimi K3 有直接启示:Kimi K3 的 MLA 层理论上可以再叠一层 summary-token 压缩,而论文没有探索这个方向。
GBLA GBLA: Gated Bidirectional Linear Attention for Generative Retrieval (Yandex, 2026-06-05)¶
关系:独立并发(本文未引用 GBLA,两者殊途同归)· 已加载对方精读
- 共同关注的问题:root cause 同构——softmax self-attention 对序列长度的二次复杂度,构成了"把历史拉得更长"的硬瓶颈。GBLA 明确把输入序列压缩(有损)与系统级优化(不消除二次依赖)都判为不够根本,与 Kimi K3 对"只压常数因子"类方案的判断同调;两者都选择改注意力算子本身这条最根本的路。
- 相近的技术骨架:这是三篇候选里方法流程图重合度最高的一篇。GBLA 在核化线性注意力之上叠三个"廉价组件":(1) Conv1D(kernel size 4,在 QKV 投影之前做局部混合,理由是"纯线性注意力把整段历史压成固定状态,容易丢失细粒度短程结构");(2) key gating(为每个 key 学标量门作软遗忘机制);(3) gated RMSNorm(输出经 RMSNorm 后与 SiLU 门相乘再线性投影)。把这三条与 KDA 的式 (2)/(5)/(6) 逐条对照:ShortConv 在 q/k/v 投影后(GBLA 是投影前)做短程混合、channel-wise decay $\boldsymbol{\alpha}_t$ 作遗忘门、以及 head-wise RMSNorm 后的 full-rank output gate——三个组件一一对应。更巧的是 GBLA 精读明确点出这与"Mamba/Gated DeltaNet 等长上下文设计里在 token-mixing 前加短卷积的惯用做法一致",而 KDA 正是 GDN 谱系的延伸;两者也都采用混合栈(GBLA 的
[SA, LA, LA]encoder vs Kimi K3 的 3 KDA + 1 MLA),且都报告纯线性版本不够、必须混入全注意力层。 - 本文的差异与推进:核心分歧在因果性与遗忘的粒度。GBLA 是双向的(生成式检索的 encoder 强烈受益于双向掩码),因此它的 $\phi(\mathbf{K})^\top\mathbf{V}$ 是一次性全局求和、无需前缀扫描,反而比因果版更简单;其 key gate 用 softmax over 整个序列,是一个"序列级注意预算分配"。Kimi K3 是严格因果的 decoder,其遗忘是per-token、per-channel 的乘性衰减($\boldsymbol{\alpha}_t \in (e^{g_{\min}}, 1)^{d_k}$)并叠加 delta-rule 的擦除投影,表达力显著更强,代价是必须处理 chunkwise 并行、数值溢出(→ lower-bounded decay)、context parallelism(→ KCP)这一整套麻烦。此外 GBLA 没有 delta rule、没有 lower-bounded decay 这类数值—kernel 协同设计,也不涉及 NoPE 外推。
- 可比的方法 / 实验差异:规模与目标函数完全不同——GBLA 是 SIGIR '26 五页短论文,在 Yandex Music 工业数据与 Amazon 公开基准(复现 GRID 协议)上做检索质量对比,报"匹配双向 softmax 注意力质量、单层最高 $8.2\times$ 快于 FlashAttention-v3(长度 32768)";Kimi K3 是 2.8T 规模 47 页技术报告,报的是 scaling law 效率($2.5\times$)与下游 agentic/coding leaderboard。两者没有任何可直接对齐的数据点。真正有价值的是方法论层面的相互印证:三个"廉价组件"(短卷积 + 门控遗忘 + 门控归一化)在两个完全不相干的场景(工业推荐 encoder / 前沿 LLM decoder)下被独立收敛出来,且都需要混入全注意力层——这强烈提示这套配方已经是线性注意力实用化的事实标准,而非某一方的偶然调参。
PowLU PowLU: An Activation Function for Stable Pre-Training of LLMs (Ling Team, Ant Group, 2026-05-25)¶
关系:显式引用但原文未展开对比(Kimi K3 §2.3.2 仅以"其他近期工作也探索过这一 trade-off 的替代参数化 [51]"一句提及)· 已加载对方精读
- 共同关注的问题:两篇论文对 root cause 的诊断几乎逐字一致——SwiGLU 的两个乘性因子都无界,因此同时出现的大坐标会产生激活 outlier,在低精度算术下增加溢出风险。PowLU 把这点写得更显式:$\text{SwiGLU}(x) = x^2\,\text{sigmoid}(x)$,当 $x$ 变大时 $\text{sigmoid}(x)\to 1$、输出趋近二次函数,对大输入有强放大效应;这一问题随层数增加因累积效应急剧恶化,且在 FP8/FP4 低精度训练下进一步加剧。Kimi K3 面临的正是这个问题的极端版本——2.8T 参数 + 近四个连续矩阵乘的 ill-conditioned routed 路径 + MXFP4 权重 / MXFP8 激活。
- 相近的技术骨架:两者的解法路径完全同构:保留 SwiGLU 在原点附近的局部响应形状,同时压制正侧的大值增长,且不用硬截断。两篇都把 SwiGLU-Clip 作为共同的对照反面,并给出同一条反对理由——硬截断会丢弃有用信息,且梯度在截断点处剧烈不连续(PowLU 精读:"SwiGLU-Clip 虽然把激活硬截断到 10,但其梯度在截断点处会出现剧烈的不连续";Kimi K3 附录 B:"与对 gate pre-activation 做硬截断不同,平滑 cap 在饱和边界之外仍保留非零梯度,这被发现能带来更好的训练行为")。两者都做了同一套理论刻画(原点附近的局部行为、极限行为、有界增长性),并都强调不牺牲 scaling 性质——PowLU 报其拟合曲线 $36.5547\,C^{-0.0661}$ 与 SwiGLU 的 $36.2682\,C^{-0.0659}$ 几乎完全重合,Kimi K3 则报 SiTU-GLU 是那套让整体 scaling 效率提升 $2.5\times$ 的架构改动之一。
- 本文的差异与推进:机制上是乘性 cap vs 幂指数调制的分野。PowLU 用有理幂函数 $x^{1 + m/(\sqrt{x}+1)}\,\text{sigmoid}(x)$——以 $\sqrt{x}$ 减慢"退化为线性"的速度、分母 $+1$ 保证 $x\to 0^+$ 可微;其正方向仍然无界(近似线性增长),只是把增长速率控制在"亚二次、近线性"区间。SiTU-GLU 则用 $\beta\tanh(\cdot/\beta)$ 对 gate 分支与 up 分支分别独立施加平滑 cap,$\beta_1 = 4$、$\beta_2 = 25$,因此输出严格有界 $\|\cdot\|_\infty \le \beta_1\beta_2 = 100$。这是一个实质差异:PowLU 抑制增长速率,SiTU-GLU 给出硬上界——对 MXFP4/MXFP8 这类动态范围极窄的格式,严格上界的价值明显更高,这大概能解释 Kimi K3 为何没有直接采用 PowLU。另一处差异是 SiTU-GLU 同时 cap 两个分支,而 PowLU 只改门控函数($x \le 0$ 时完全退化为 SwiGLU/SiLU)。
- 可比的方法 / 实验差异:PowLU 做了 Kimi K3 完全没做的事——受控的激活函数消融:26M–368M 激活参数的 scaling law 对比、7.9B(600B token)与 124B 两档大规模验证、17 个 benchmark(AGIEval/MMLU/MMLU-Pro/BBH/HumanEval/GSM8K 等三类)、loss spike 分析、张量数值分布的 P1–P99 可视化、outlier channel 分析、以及超参 $m$ 的参数研究。Kimi K3 则完全没有 SiTU-GLU 的独立消融——$\beta_1 = 4$、$\beta_2 = 25$ 这两个数字的来源、以及 SiTU-GLU 相对 SwiGLU/SwiGLU-Clip/PowLU 各自贡献多少,全都无从查证(见下节局限性)。反过来,PowLU 的实验规模(124B dense-equivalent)远小于 Kimi K3 的 2.8T,也没有在 MXFP4 这种 4-bit 格式下验证。有意思的一个细节是:PowLU 精读的"与相关工作定位"一节反过来引用了 Kimi 的 Attention Residuals 作为架构级稳定性方案的代表——两个团队在稳定性问题上互为参照,但都没有做交叉的方法对比。
被剔除的近似候选(记录以防门槛放水):
- MobileMoE MobileMoE (Meta AI):同为 MoE 稀疏度设计 + 4-bit QAT,表面高度相似。但 root cause 相反——MobileMoE 解的是端侧内存 + 算力联合约束下 sub-billion active 参数的最优配比,Kimi K3 解的是"开源预训练规模停滞在 1T 级";解法也不同构(scaling law 搜 $E$/$g$ 配比 vs latent 路由 + 分位数负载均衡)。
- AIR-MoE AIR-MoE (MPI Tübingen):同为极多 expert(65k)的路由问题,但解决的是 top-$K$ 打分的计算成本(IVF 式球面 k-means 粗筛),而 QB 解决的是负载不均衡;两者方法流程图不重合。
- Hidden Decoding Hidden Decoding (WeChat AI, Tencent):同在 100B+ MoE 规模上开新算力轴,但那条轴是"序列长度维复制 token 流"(每 token 扩成 $n$ 个独立 embedding/KV 的 stream + Stream-Factorized Attention),与 Kimi K3 的三维信息流架构改造不同构。
- Dynamic Short Convolutions Improve Transformers Dynamic Short Convolutions (MIT):KDA 确实用了 ShortConv,但那篇的问题是"给 Transformer 加一个 input-dependent 的局部性原语"(从 hidden state 生成 depthwise filter),不是长上下文 KV cache 瓶颈;且 KDA 用的是静态短卷积。
- Arch-Warmup Arch-Warmup (Taming Curvature):同为 Transformer 训练稳定性,但解法是 warmup 调度(曲率视角),而非架构级 bounded 激活 / 归一化插入。
- Bridging Compute- and Data-Optimal Pretraining CD-scaling laws (Harvard):同做 scaling law,但研究的是 compute-optimal 与 data-optimal 之间的桥(token effectiveness $\eta$、重复 vs 改写),与 Kimi K3 用 scaling law 重调超参并度量架构改动收益的用法不同构。
讨论与局限性¶
核心贡献与值得借鉴的设计¶
从方法论角度,这篇报告最值得借鉴的不是任何单个模块,而是"把 scaling 拆成正交维度、每维给一个针对性机制、再用统一 scaling law 度量总收益"这个组织方式。序列 / 深度 / 宽度三分法让一篇 47 页的技术报告保持了罕见的结构清晰度,也让"$2.5\times$ scaling 效率"这个总数字有了可归因的分解路径(尽管论文没有真的给出逐项归因,见下)。
三个具体设计值得单独拿出来复用:
- 用数值范围换 kernel 形状(lower-bounded decay)。这是全文最优雅的一步:一个纯参数化改动(negative-Softplus → scaled sigmoid)把累积衰减的倒数压进 BF16 动态范围,从而让整条对角 tile 的 position-pair 特殊路径直接消失。这类"改数学以适配硬件原语"的思路在 recsys 的长序列建模里同样适用——任何涉及累积乘积 / 前缀积的 kernel 都值得检查有没有类似的 bounding 机会。
- 把启发式更新替换为对偶问题的精确坐标最小化(QB)。"auxiliary-loss-free bias 更新其实是某个 LP 对偶目标上的 SignSGD"这个观察本身就很有价值——一旦看清这层结构,"直接跳到坐标最小点"就是自然的下一步,并顺带解释了为什么不需要学习率类超参。同类思路可迁移到任何用启发式 bias / 温度调节分布的场景。
- 训练时富、推理时简的不对称性设计(QB 的 token 阈值 $\boldsymbol{\alpha}$ 是可丢弃的中间变量;chat template 里 global option 前置 / one-shot option 后置以保护 KV cache)。这两处都是"把复杂度放在能承受的一侧",是很好的系统设计范例。
局限性与争议¶
- 完全没有架构消融。 这是最大的方法论缺口。论文声称 KDA + AttnRes + Stable LatentMoE + 数据/训练配方"共同"带来 $2.5\times$ scaling 效率,但没有任何逐项归因:SiTU-GLU 贡献多少?Normalized LatentMoE 的那个 RMSNorm 贡献多少(论文只说"一致地改善验证 loss 与下游 benchmark",无数字)?QB 相对固定步长 sign 更新的实际收益是多少?$\beta_1 = 4$ / $\beta_2 = 25$ / $g_{\min} = -5$ / $N = 8$ blocks 这些数字怎么定的?唯一有图的消融是 vision tower 的 gradient norm(Figure 6)与 cosine vs WSD 的调度对比(无图无表,仅文字)。对一篇声称多项架构创新的报告,这个缺口相当致命——读者无法判断这些机制哪些是真收益、哪些是"反正一起上了"。相比之下,PowLU 用一整篇论文做了 SiTU-GLU 本该有的那套消融(见上节对比),这个反差很说明问题。
- 长上下文能力缺少直接证据。 1M 上下文是全文的核心卖点之一(NoPE 直接外推、四阶段渐进扩窗、合成长上下文数据、KCP、prefix caching 全都为它服务),但评测里没有任何 RULER / NIAH / LongBench 类长上下文合成 benchmark。最接近的是 AA-LCR(74.7,夺冠)与 BrowseComp 的"完整 1M 窗口无 context management 达 90.4%",但前者是第三方引用分数、后者是单点数字。"NoPE 直接外推到 1M 而无需任何位置编码改动"是一个很强的声明,却没有配一条外推曲线。 对照 KSA 在 RULER-128K 上做的受控对比,这里的证据强度明显不足。
- 相对上一代的对比几乎缺席。 Table 1 只给架构参数对比,没有 Kimi K2 / K2.5 / K2.6 在同一套 benchmark 上的分数。全文唯一的代际数据点是 Figure 10 里 Kimi K2.6 的 0.560 vs Kimi K3 的 1.000(单个 AET 任务)。因此"$2.5\times$ scaling 效率"到底转化成多少下游能力提升,无法从报告中读出。
- 评测可比性存在多处松动。 论文自己诚实地标注了这些,但累积起来会侵蚀结论强度:Claude Fable 5 的分数包含 fallback 行为(KCB 2.0 上 80 任务中 13 次 fallback、SWE-Marathon 上 35% 的任务触发 fallback),GPT-5.6 Sol 的分数包含潜在 cyberguard(80 任务中 10 次 refusal);不同模型配不同 harness(Kimi K3 配 Kimi Code、GPT 配 Codex、Claude/GLM 配 Claude Code),而 harness 本身对 agentic 分数影响巨大(Table 3 里 KCB 2.0 上 Kimi K3 在 Claude Code 下 73.7、在 Kimi Code 下 72.9,GPT-5.5 在 Kimi Code 下 66.0、在 Codex 下 69.0——harness 差异可达 3 分);Terminal-Bench 2.1 报的是"跨 harness 最佳分";PostTrainBench 与 SWE-Marathon 跑在 H20 而非官方 H100;WorldVQA 上"通过 prompt engineering 强制给出答案"。最需要谨慎的是内部 benchmark(Table 3、Table 4)——由 Moonshot 自己设计、自己刷新、自己评判,且 Kimi Webdev Bench 的 +31.0 margin 只对 Claude Opus 4.8(不是最强的 Claude Fable 5)比较。
- Reward hacking 的攻防是"打补丁"式的。 Kernel 优化任务里的 hacking-detection 系统"随开发中观察到新 hacking 策略持续扩展新的 safeguard",AET 里靠 public/hidden verifier 分离 + 惩罚型 reward,GRM 里靠 verbosity budget 硬性判负。这些都是有效的工程手段,但都不是原理性的——论文自己的措辞("as new hacking strategies are observed during Kimi K3's development")就承认了这是一场持续的军备竞赛。这也提示:AET 这类"reward 基于 verifier 对最终环境状态的评估"的范式,其可靠性上限取决于 verifier 的覆盖度,而这本身是个开放问题。
- research-level reasoning 是明确短板,且原因未被分析。 CritPt 23.4(落后 GPT-5.6 Sol 的 32.3 近 9 分)、HLE-Full 43.5/56.0(落后 Claude Fable 5 的 53.3/63.0 近 10/7 分)。论文只说"这仍是一个关键改进方向",没有诊断为什么——是预训练知识密度不够?是 RL 三域划分(general / agentic / coding)里 general 域的 reasoning 子任务权重不足?还是 MOPD 合并时 reasoning 能力被稀释了?考虑到后训练的重心明显压在 agentic 与 coding 上(§4.2 的七类环境里五类是 agentic/coding/kernel/webdev),第二个假设看起来最可能,但报告没有给出任何证据。
- 可复现性的现实门槛。 权重开源是实质性贡献(也是"open frontier"这个标题的兑现),MoonEP、AgentENV、FlashKDA、MiniTriton、nano-kpu 都开源了。但训练侧几乎不可复现:数据配比、rephrasing 配方细节、9 个 RL expert 的具体训练预算、$\tau$ 的 per-domain 配置(明确说了是"human-in-the-loop")、知识图的规模与种子节点集,全部未披露。5,122 万个 sandbox 这个数字本身就说明后训练的算力门槛。
- 方法论可扩展性评估(正面):与许多"先离线压缩再在线建模"的两阶段方案不同,Kimi K3 的三条 scaling 路径都是端到端可微且可同步扩张的——序列维(KDA 的固定状态容量可随 $d_k \times d_v$ 增长)、深度维(AttnRes 的 block 数 $N$ 与层数可同步增长)、宽度维(LatentMoE 的 expert 数与 latent 维度可独立调)。没有固化的码本或离散 token 空间构成下游表征瓶颈;原生多模态(无 post-hoc 对齐阶段)也避免了模态适配器成为固定瓶颈。参数量 scaling 时"如何表征"与"如何建模序列"两条路径能一起增长,这是这条路线相对 SID / 两阶段压缩类方案的结构性优势。唯一的潜在瓶颈是 Block AttnRes 的 $N \approx 8$ 是经验值("$N \approx 8$ 就能在各种模型规模上恢复大部分收益"),深度大幅增长时是否需要重调未被讨论。
工业落地价值¶
这是一篇完整的工业系统报告,落地细节的密度远超典型学术论文:
- 部署路径完整:MXFP4 权重 / MXFP8 激活的 QAT 贯穿整个后训练(含 RL,rollout 与训练共享量化方案以消除 train–inference 不匹配);EAGLE-3 风格 draft model 用 LK loss 直接优化 acceptance rate;KDA-aware prefix cache 让 400K prefix 的请求只需 4K prefill 增量;fleet 级用一致性哈希 pin primary/secondary 集群 + budget-based admission control 保 SLO。
- 训练基础设施可复用性高:MoonEP 的 $E/R$ 紧界证明与零拷贝 fused permute/unpermute、统一激活管理器(recompute / quantize / offload 作为可组合存储策略,通过张量 annotation 声明、与模型代码解耦)、P2P Muon 正交化、Mooncake 跨 PP rank 激活 offload——这些都是与 Kimi K3 具体架构解耦的通用工程资产,且 MoonEP 已开源。
- Agentic RL 基础设施是稀缺资产:AgentENV 的 133 ms/49 ms checkpoint/resume、Pause-and-Resume 抓住"98% 生命周期在等推理"这一观察、$6.5\times$ 内存 overcommit、亚秒级启动——加上"5,122 万 sandbox / 150 万镜像"这个规模数字,这一节对任何想做长程 agentic RL 的团队都有直接参考价值,且同样已开源。
- 成本效率被当作一等指标报告(§6.4 四个套件的 score-vs-cost 前沿图),这在技术报告里并不常见,也是判断"能否真上线"的关键信息。
一句话评价¶
Kimi K3 是一篇架构—系统协同设计做得极为扎实、工程披露密度极高、但架构消融几乎缺席的前沿 LLM 技术报告。它最大的方法论价值在于把 scaling 拆成序列/深度/宽度三个正交维度并各给一个可迁移的机制(lower-bounded decay、Block AttnRes、Quantile Balancing),以及把 MoonEP 的 $E/R$ 紧界、KCP 的结合律分解、hybrid prefix caching 的双粒度解耦这三块硬工程写清楚。代价是:$2.5\times$ 的 scaling 效率提升无法归因到任何单一组件,1M 上下文这个核心卖点缺少直接的长上下文外推证据,且大量结论依赖自建且自评的内部 benchmark。作为"首个开源 3T 级模型"的意义是实质的(WebDev Arena 首个登顶的开源模型、Artificial Analysis 第四/580),但它同时也很诚实地标出了自己的边界——research-level reasoning 与加固目标的 exploit 完成仍是明确短板。