Hidden Decoding at Scale: Latent Computation Scaling for Large Language Models¶
研究动机与背景¶
大语言模型(LLM)的进步长期由放大 Transformer 骨干驱动——增大模型规模、训练数据与训练算力,几乎单调地带来更强的模型 [Hoffmann 2022, Kaplan 2020]。但对一个已经很强的基础模型而言,继续加宽/加深骨干代价高昂:往往意味着又一轮大规模预训练,同时抬高训练与推理成本。本文因此聚焦一个具体设定:在保持 Transformer 骨干固定不变的前提下,给每个 token 分配更多计算,让已有骨干继续变强。
这一目标与近期的推理模型 / test-time scaling 研究一脉相承:即便参数固定,为每道题多花计算就能提高准确率 [OpenAI o1, s1, Snell 2024]。而 latent-reasoning 方向进一步希望把这部分"额外思考"从可见 token(显式 CoT) 搬进模型的内部计算。
朝这个目标最主流的一条路是 recurrent-depth / looped Transformer:在每个 token 上把同一组 Transformer block 反复执行若干次 [Geiping 2025, Loopus 2026, Saunshi 2025, Zhu 2025]。它是"固定参数、增加每 token 计算"的直接手段,但难以 scale。原因在于:训练最大规模 MoE 模型依赖 pipeline parallelism(流水线并行)[GPipe, Megatron-LM, DeepSeek-V3, Kimi K2],其前提是每个输入只单向流过模型各 stage 一次;而 looped 模型会把同一 hidden state 反复送回同一批 stage,破坏了这个前提,导致流水线停顿、GPU 空转。因此 looped 模型至今停在较小规模——最大的是 40B 稠密的 LoopCoder(且未用 pipeline parallelism 训练)[iQuest-Coder],其余 looped LM 大多只有几十亿参数。Looping 缺一个"既能 scale 到超大模型、又能高效利用 GPU"的现实路径。
本文的核心观察是:沿序列维度(sequence dimension)扩展计算,比沿深度维度复用,更契合大规模训练。沿序列方向扩展,本质上就是"喂一条更长的输入",天然兼容大模型训练所用的标准优化手段。一般范式是:把每个输入 token 沿序列展开成若干 stream,在单次前向中处理这条展开后的序列,next-token 损失只加在最后一个 stream上,于是中间 stream 就承担了"额外的每 token 计算",而不新增或加宽任何 Transformer 层。一个已有实例是 Parallel Hidden Decoding Transformer (PHD) [Wu 2025]:它重复每个 token,但为了保持推理便宜,让重复 token 的 KV 是瞬态的(只在当前 token 内部帮助计算),不作为独立 KV context 保留给后续 token。而本文的 capability-scaling 设定恰恰需要持久的中间 stream 状态,跨位置保留、供后续 token 读取。
本文提出 Hidden Decoding:一种在持续预训练(Continued Pretraining, CPT) 阶段施加的序列长度扩展(sequence-length scaling) 方法,用于提升 frontier-scale LLM 的能力。两个设计选择让展开的 stream 对能力提升真正有用:
- 独立 embedding 表:为让不同 stream 有不同的初始表征,把词表 embedding 复制成 $n$ 份 per-stream 表,把每个 token $x_i$ 展开成 $(E_1(x_i), E_2(x_i), \dots, E_n(x_i))$;经 CPT 后这些表学到同一 token 的多样初始表征。
- 保留中间 stream 的 KV:让中间计算跨位置持续可用——中间 stream 的 KV 作为 context 保留下来,累积的计算供后续 token 读取。
保留所有 stream 的 KV 会让注意力代价升到 $O(n^2 L^2)$,对大模型 + 长序列不可训练。为此本文引入 Stream-Factorized Attention (SFA):把跨 stream 的注意力限制到少数几层,大多数层只在 stream 内部做注意力,从而把注意力代价从二次降到关于 $n$ 近似线性。这正是让 Hidden Decoding 能训练到 100B+ MoE 规模的关键——这个规模是此前 looped / 长度扩展方法都未触及的。
实验验证两条 scaling 结论:
- frontier 规模:在 $n{=}4$ 下训练出 WeLM-HD4-80B 与 WeLM-HD4-617B,均优于其匹配的非 HD 对照(WeLM-80B / WeLM-617B),成为首个在 100B+ MoE 规模上跑通的序列长度扩展方法。
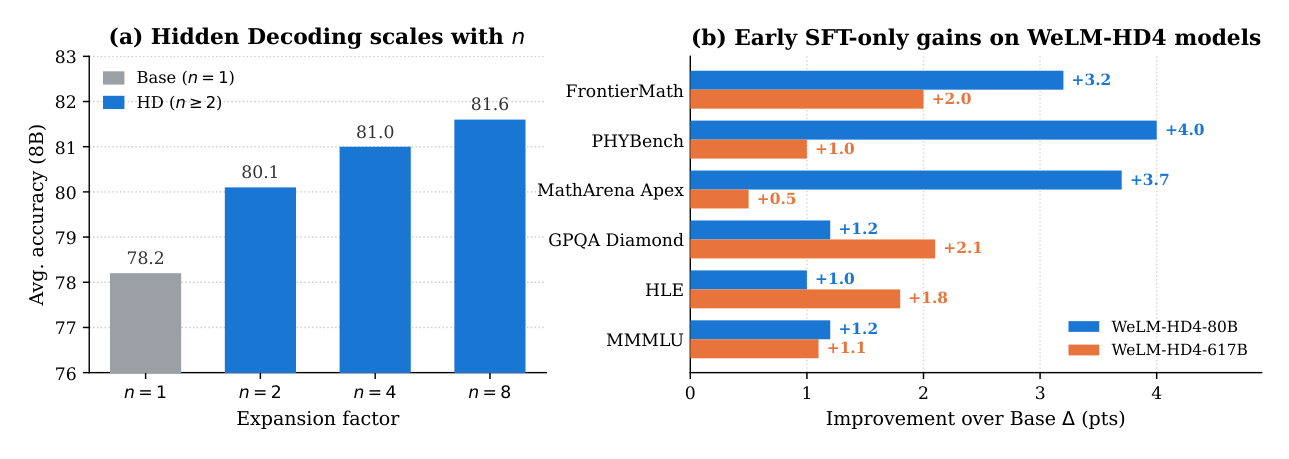
- 扩展因子 scaling:随着展开因子 $n$ 增大,收益单调增长,说明序列长度扩展是一条对 frontier-scale LLM 现实可用的固定骨干 scaling 路径。
作者为 WeChat AI Team(腾讯微信 AI)。代码与模型开源在
github.com/Tencent/Sequential-Hidden-Decoding与huggingface.co/collections/tencent/sequential-hidden-decoding。
核心方法 / 模型架构¶
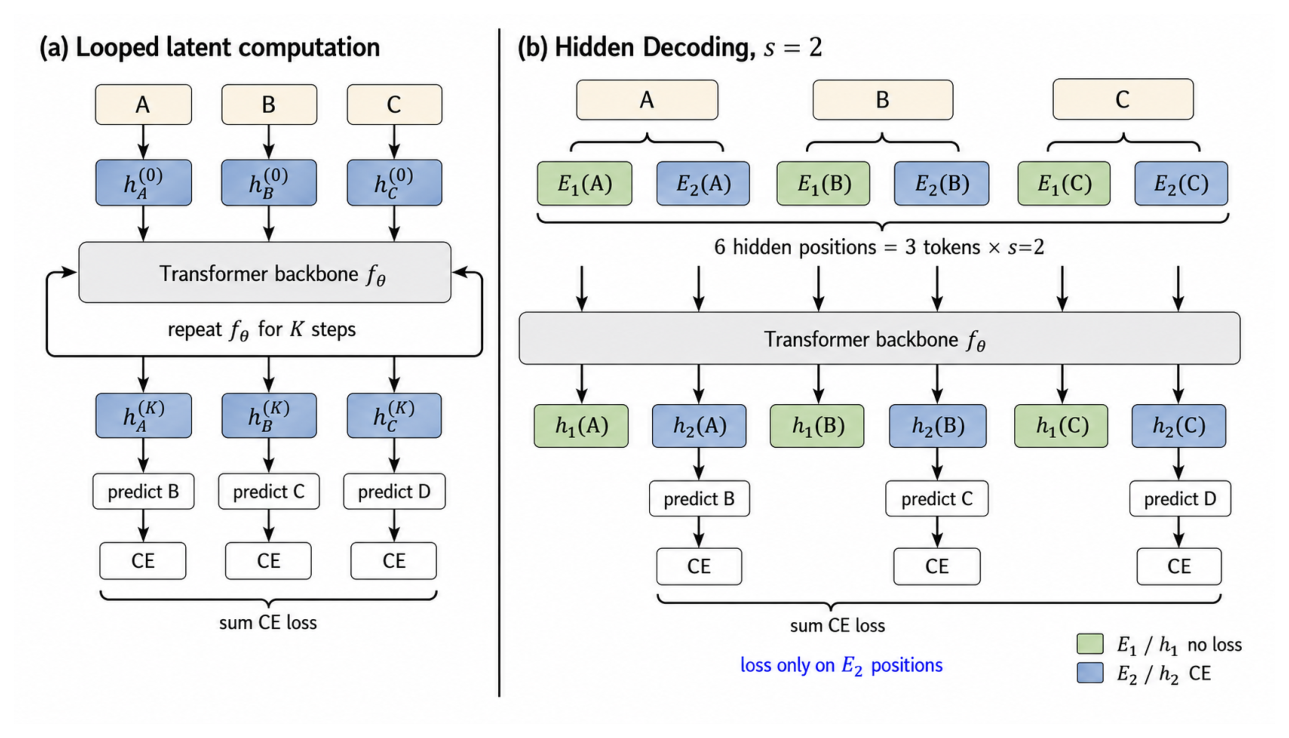
Hidden Decoding 是一种序列长度扩展方法:在不加大 Transformer 骨干的前提下,增加每个 token 接收的计算量。每个输入 token 被表示为 $n$ 条并行 stream,于是一条长度 $L$ 的序列在单次前向里被当作长度 $nL$ 的序列处理,让每个 token 在预测前经历 $n$ 步内部计算。图 2 对比了 Hidden Decoding 与 looped 计算:looped 沿深度维复用骨干,Hidden Decoding 沿序列维放置额外计算。
记号与基本设置。 标准 Transformer LM 把每个 token $x_i$ 经单一词表 embedding 表 $E$ 映成输入序列 $(E(x_1), \dots, E(x_L))$,加 RoPE 位置 [Su 2024],做因果注意力,并通过共享输出头 $g_\theta(\cdot)$ 从每个位置的 hidden state 预测下一个 token。Hidden Decoding 保持这条路径不变,只改变每个 token 如何被 embedding 进序列。
2.1 多 Stream Token 展开(Multi-Stream Token Expansion)¶
核心构造是:把标准模型的单一 embedding 表换成 $n$ 张独立的 embedding 表(称为 stream),并把它们的输出交织成一条更长的输入序列。
展开序列。 给定输入序列 $X=(x_1,\dots,x_L)$ 与 $n$ 张 embedding 表 $E_1,\dots,E_n$,构造长度 $nL$ 的展开序列 $S$,把 token $x_i$ 的 stream-$k$ 表征放到物理位置 $t=(i-1)n+k$:
$$S_t = E_k(x_i), \qquad 1 \le i \le L,\ 1 \le k \le n. \tag{1}$$
当 $n{=}2$ 时 $S=\big(E_1(x_1),E_2(x_1),E_1(x_2),E_2(x_2),\dots\big)$。展开序列在标准因果注意力下喂给同一个 Transformer,使用连续的 RoPE 位置 $0,1,\dots,nL-1$。扩展因子 $n$ 直接控制加入了多少额外的每 token 计算。
训练目标。 只有每个 token 的最后 stream $E_n(x_i)$ 受监督:从其 hidden state 经共享 LM 头 $g_\theta$ 预测下一个 token $x_{i+1}$,前 $n-1$ 条 stream 不受任何直接损失。设 $h_t$ 为物理位置 $t$ 的 hidden state,目标是仅在 final-stream 位置 $t=in$ 施加的 next-token 交叉熵:
$$\mathcal{L}(\theta) = -\sum_{i=1}^{L} \log g_\theta\big(x_{i+1}\mid h_{in}\big). \tag{2}$$
由于注意力是因果的,final stream $E_n(x_i)$ 能 attend 到同一 token 的所有更早 stream以及所有更早 token。因此前 $n-1$ 条 stream 充当中间计算状态,逐步精炼那条最终承担预测的 stream。"只监督最后 stream + 给每条 stream 独立 embedding 表"这一组合,正是赋予中间 stream"潜在计算"角色的关键——§5.1 的消融显示,若监督全部 stream 或在预测前把各 stream 输出求和,性能都会变差。
2.2 Stream-Factorized Attention(SFA)¶
在 $nL$ 个展开位置上做 dense 注意力代价是 $O(n^2 L^2)$,对大 LLM + 长序列训练开销陡增。SFA 通过让大多数层只在 stream 内部、把跨 stream 混合限制到少数层来降低代价。
Stream 与 token 索引。 对展开序列中位置 $t\in\{1,\dots,nL\}$,其 token 与 stream 索引为
$$i(t)=\lceil t/n \rceil,\qquad s(t)=\big((t-1)\bmod n\big)+1, \tag{3}$$
于是 $S_t=E_{s(t)}(x_{i(t)})$。连续的 $n$ 个位置对应连续的 token,$n$ 条 stream 在每个 block 内有序排列。
Intra-stream 与 cross-stream 层。 用式 (3) 的索引,一个 intra-stream 层把注意力限制到同一 stream 内更早的位置:
$$M^{\text{intra}}_{t,t'} = \mathbf{1}\big[\, t' \le t \ \wedge\ s(t')=s(t)\,\big], \tag{4}$$
代价为 $O(nL^2)$,而非 dense 层的 $O(n^2 L^2)$;一个 cross-stream 层则也跨 stream 注意,遵循基座模型原有的注意力模式(滑窗或全注意力)。
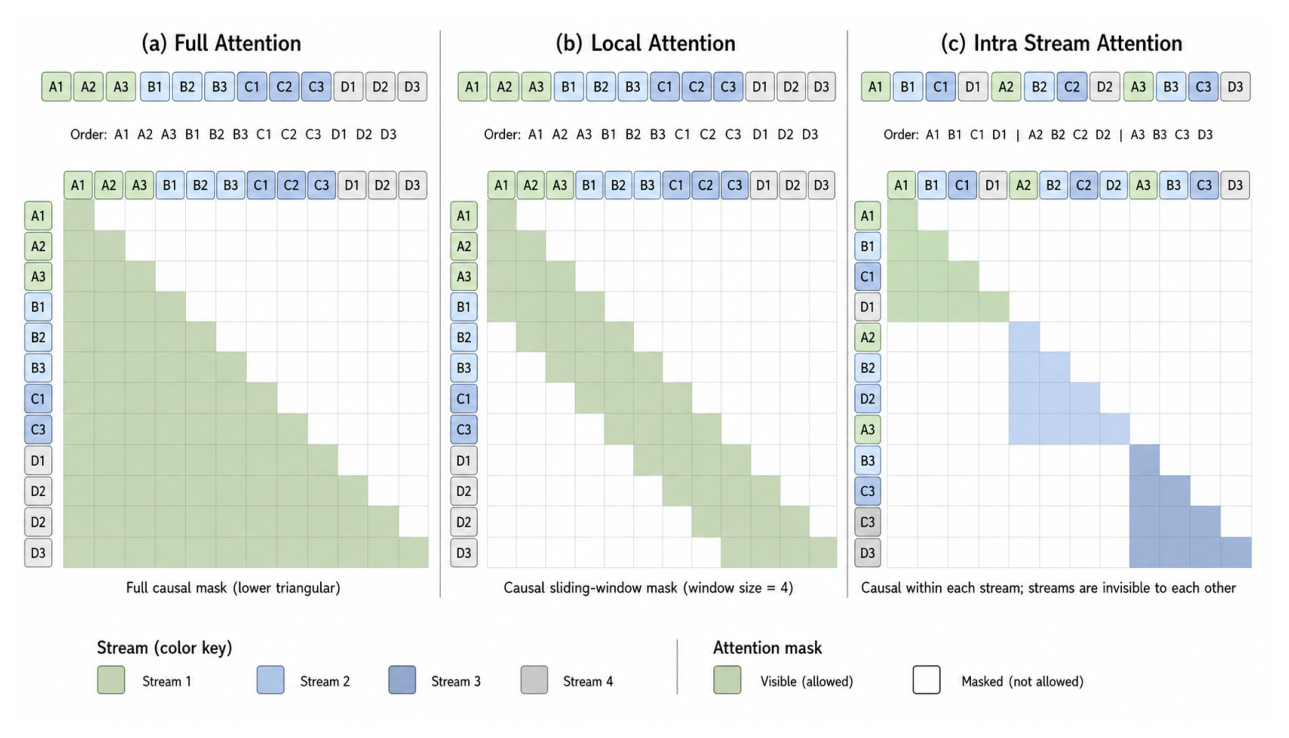
设计。 大多数层为 intra-stream,只在层的一个子集上启用 cross-stream 注意力。本文不为此新增任何注意力层——直接复用基座模型自己的注意力层作为 cross-stream 层:当基座含滑窗(SWA)层,这些层即作为local cross-stream(跨 stream 但局部);否则 cross-stream 层为full-attention。由于大多数层是 intra-stream,新增注意力代价关于 $n$ 近似线性而非二次;cross-stream 层的数量与位置是 §4 研究的设计选择。这个布局还让 CPT 更贴近 HD 展开前的 checkpoint:大多数层保留基座单 stream 因果路径,只有少数层引入跨 stream 扰动。
2.3 渐进式扩展(Progressive Expansion)¶
大扩展因子 $n$ 可直接训练,但渐进增长能为众多 embedding stream 提供更好初始化并省算力。本文按 $1\to2\to4\to8$ 逐步增长因子,每一档都从上一档收敛的 checkpoint 初始化。具体用 Cyclic Replication Initialization:从 $n$ 翻倍到 $2n$ 时,新 stream 复制已有的表:
$$E_{n+k} \leftarrow E_k, \qquad 1 \le k \le n. \tag{5}$$
于是扩展后的模型初始时复现较小模型的行为,然后平滑适配。例如 $n{=}2\to4$ 把表初始化为 $(E_1,E_2,E_1,E_2)$,$n{=}4\to8$ 为 $(E_1,E_2,E_3,E_4,E_1,E_2,E_3,E_4)$。实践中在 CPT 的预定 token 数处引入逐次扩展,让每一档先收敛再进入下一档。
关键技术细节:计算成本(§3)¶
Hidden Decoding 给每个 token 都加了计算,因此训练与服务成本必须实测。本文区分两类成本:方法固有的成本(在任何骨干上都成立)与 WeLM 骨干特有的额外节省。
3.1 训练成本¶
把每 token 展开成 $n$ stream 使长度 $L$ 序列变成 $nL$。非注意力计算随位置数近似线性增长;对展开序列做 dense 注意力则是 $O(n^2 L^2)$(即未展开注意力代价的 $n^2\times$)。SFA 靠"大多数层 intra-stream"避免了这个 dense 爆炸,把注意力代价压到关于 $n$ 近似线性。这条近似线性是方法固有属性,在任何骨干上都成立。
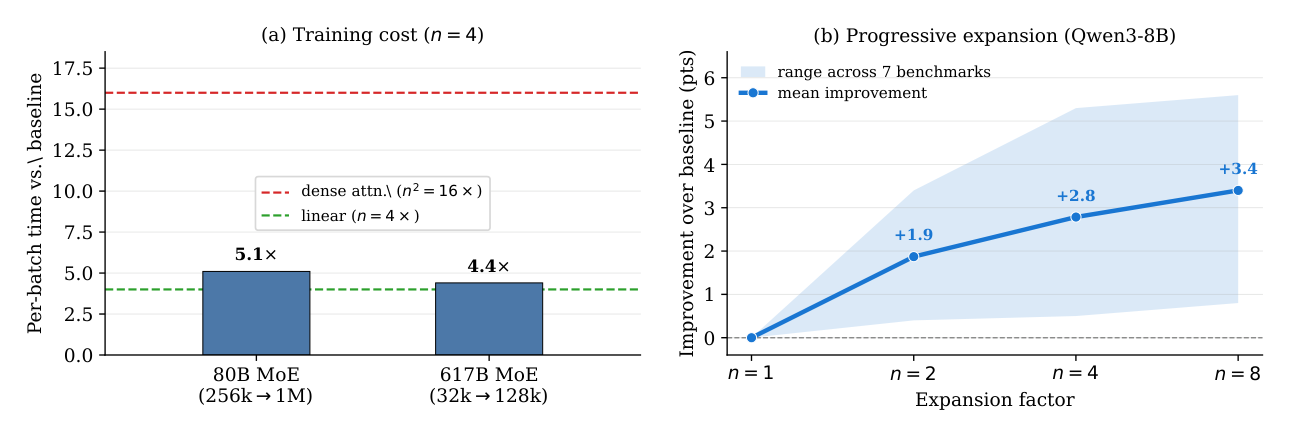
WeLM 特有的 KV-mirror 额外节省。 WeLM 骨干采用 KV-mirror 设计 [WeChat AI 2026]:标准层的 K/V 来自本层输入 hidden state,而 KV-mirror 下后段每一层用较早层的 hidden state(配自己的投影权重)计算 K/V,层按 U 形配对,最后 1/3 层 mirror 最前 1/3 层。由于 mirror 层的 K/V 只依赖早层 hidden state,训练框架在早层算好、mirror 层直接复用。因为只有 final stream 受监督,中间 stream 只通过它们加入的 K/V 才起作用;而 mirror 层的 context 已被早层固定,中间 stream 在 mirror 层无需处理——于是只让 final stream 过 mirror 层,早层仍处理全部 $n$ 条 stream。在 80B/617B 上后 1/3 层被 mirror,中间 stream 在这后 1/3 被跳过。实测:80B 32k 训练下,KV-mirror 优化把每 batch 时间从 15s 降到 12s(20% 缩减 / 1.25× 加速)。净效果是训练成本随 stream 数 $n$ 近似线性增长(图 4a 双规模验证)。
3.2 推理成本¶
Hidden Decoding 相较 looped 模型的关键优势:其额外计算是并行的。looped 模型逐步复用骨干、每步等前一步,故额外代价无法隐藏;Hidden Decoding 把计算摊在 $n$ 条 stream 上、单次前向一起处理。在大 batch 下 decoding 是 compute-bound,额外计算会拉低吞吐;在小 batch 下 decoding 受内存带宽约束、大量算力闲置,并行 stream 恰好能利用这些空闲算力,额外代价很小。唯一残余开销是更大的 KV cache——SFA 只在少数层读展开后的完整 KV,把它控制得较小。因此吞吐惩罚在延迟敏感的短输入 / 小 batch 场景最小,随更大 batch 或更长输入而增大(§4.5 实测)。
实验设置(§4.1)¶
模型。 在强预训练 checkpoint 上通过 CPT 施加 HD,骨干不加大。主 HD 模型为 WeLM-HD4-80B / WeLM-HD4-617B,由 WeLM MoE checkpoint(80B 总参 / 3B 激活;617B 总参 / 23B 激活)在 $n{=}4$ 下扩展而来,匹配非 HD 对照为 WeLM-80B / WeLM-617B。消融用较小 21B(0.7B 激活) 与 6B(0.6B 激活) MoE,渐进扩展与探针用稠密 Qwen3-8B-Base [Qwen3 2025]。
只有 embedding 表随 $n$ 增长,每 token 激活的 Transformer 参数不变:$n{=}4$ 使 617B 的 embedding 参数从 26.9B 增至 107.4B、Qwen3-8B 从 1.2B 增至 3.1B($n{=}8$ 达 5.6B)。这些是稀疏查表,不进注意力/FFN 的矩阵乘、不改变计算成本。因此在固定 Transformer 骨干、固定每 token 激活参数下做匹配对照。
主 WeLM 配置(附录 B, Table 7):
| Backbone | MoE 参数 | 激活参数 | 层数 | Hidden | Q/KV heads | Head dim | Experts/top-k | KV mirror | SFA intra/local/full |
|---|---|---|---|---|---|---|---|---|---|
| WeLM-80B | 80B | 3B | 49 | 2048 | 24/2 | 256 | 512+1 / 10 | 16 | 20 / 23 / 6 |
| WeLM-617B | 617B | 23B | 94 | 4096 | 96/8 | 128 | 512+1 / 10 | 30 | 69 / 0 / 25 |
80B 基座 context 长度 256k,617B 为 32k;617B 全注意力,故其 cross-stream 层全为 full(25/94),其余转 intra-stream。
持续预训练(Table 1)。 从基线 checkpoint 继续训练并启用展开,除 617B 长上下文阶段外用与基线相同的数据与 schedule。HD 只在训练后期加入,故 HD-only 的 token 预算在两个规模都约为完整非 HD 路径的 5.3%,即更高的每 token 成本集中在训练末段。
| Scale | Run | HD 起始 token | 8k pretrain | 32k continuation | 256k continuation | Total |
|---|---|---|---|---|---|---|
| 80B | WeLM-80B-Base | – | 17.81T | 2.01T | 0.57T | 20.39T |
| 80B | WeLM-HD4-80B-Base | 19.32T | 0 | 0.50T | 0.57T | 1.07T |
| 617B | WeLM-617B-Base | – | 14.25T | 2.20T | 0.61T | 17.06T |
| 617B | WeLM-HD4-617B-Base | 15.86T | 0 | 0.59T | 0.30T | 0.90T |
617B 的 HD 长上下文阶段用的 token 比非 HD 更少(0.30T vs 0.61T),故其增益是保守下界。
后训练范围。 早期后训练表用的是轻量早期 SFT(短 SFT schedule,无 RL),作为受控对照隔离 HD 本身效果;成熟 WeLM 发布分数不在本文范围。早期 SFT 超参(附录 D, Table 10):Adam+Muon,lr $2.0\times10^{-5}$,cosine decay,bfloat16,global batch token 4,194,304,YaRN scaling factor 8(从 32k base),rotary base 500,000,LoRA 关闭、仅 SFT。
评测(附录 C)。 两套评测:标准套(scaling/ablation/base-model,few-shot,含 MMLU/MMLU-Pro/CMMLU/C-Eval/ARC-C/HellaSwag/BBH/GSM8K/MATH/SimpleQA/CRUXEval/EvalPlus/MultiPL-E 等);早期后训练套(主 WeLM 结果,Table 2/11,多为 LLM-judge HLE 风格判分,数学集 N=32 独立运行取平均)。
主要实验结果¶
4.2 Frontier-Scale MoE 结果(Table 2)¶
比较每个 WeLM MoE checkpoint 的两种形式(除 HD 外全同),两者都用相同早期 SFT-only 后训练,隔离方法本身。Kimi K2.6(1T 总参 / 32B 激活) 作为主流 frontier 参考给出绝对分尺度。
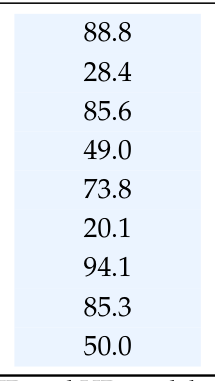
| Benchmark | WeLM-80B | WeLM-HD4-80B | WeLM-617B | WeLM-HD4-617B | Kimi K2.6 (1T-A32B) |
|---|---|---|---|---|---|
| GPQA Diamond | 87.6 | 88.8 | 89.1 | 91.2 | 90.4 |
| HLE | 27.4 | 28.4 | 33.6 | 35.4 | 36.9 |
| MMMLU | 84.4 | 85.6 | 86.4 | 87.5 | 88.0 |
| FrontierMath★ | 45.8 | 49.0 | 49.0 | 51.0 | 53.2 |
| PHYBench | 69.8 | 73.8 | 75.3 | 76.3 | 74.0 |
| MathArena Apex | 16.4 | 20.1 | 24.2 | 24.7 | 23.8 |
| HMMT‡ | 93.3 | 94.1 | 96.0 | 96.2 | 96.0 |
| IMO-AnswerBench | 85.0 | 85.3 | 87.5 | 88.5 | 91.5 |
| SciCode | 45.8 | 50.0 | 51.4 | 52.1 | 50.7 |
结论分析:Hidden Decoding 在两个规模、全部 9 个 benchmark 上均提升。 最大增益出现在难数学与科学:WeLM-HD4-80B 在 SciCode +4.2、PHYBench +4.0、FrontierMath +3.2;WeLM-HD4-617B 在 GPQA +2.1、HLE +1.8。与 Kimi K2.6 相比,WeLM-HD4-617B 在 GPQA/PHYBench/MathArena/HMMT/SciCode 更高,K2.6 在 HLE/MMMLU/FrontierMath/IMO-AnswerBench 更高。这证明 HD 能 scale 到 frontier-size MoE 并在不加大骨干下改进它们——而这正是 looped 模型难以应用的规模区间(深度复用与训练大 MoE 的 pipeline parallelism 冲突)。80B 更广的套(附录 E, Table 11)显示最大增益偏向 agentic/长任务:Terminal-Bench 2(44.9→58.4)、ARC-AGI-2(6.9→11.6)。
训练成本实测。 在 WeLM 骨干上测每 batch 时间相对未展开基线:$4\times$ 有效序列在 80B(256k→1M)仅贵 5.1×、617B(32k→128k)4.4×,都贴近 $4\times$ 线性、远低于 $16\times$ dense。这近线性成本使 WeLM-HD4-617B 可训练,而对展开序列做 dense 注意力则不可行。
Base-model 参考(Table 3)与 Table 15(附录 I)¶
后训练前,HD 也在两规模改进。Table 3(外部 base-model 对照)中 WeLM-HD4-617B-Base 在 CRUX-Input 91.75 vs WeLM-617B-Base 86.00、MMLU-Pro 73.92 vs 72.26。附录 I Table 15:80B-Base 平均 62.42→63.61、617B-Base 平均 70.60→71.12,较大增益在 SuperGPQA/MMLU-Pro 等更难推理与知识任务,且这些增益在轻量后训练后持续保留。
4.3 扩展因子 scaling(附录 G)¶
为验证扩展因子是可用的 scaling 旋钮,在稠密 Qwen3-8B-Base 上逐步扩到 $n\in\{2,4,8\}$、骨干固定。图 4b 显示平均提升几乎稳步随 $n$ 上升、每个 benchmark 都涨,最大提升达 HellaSwag +5.6、BBH/MATH +5.1。MoE 规模同趋势:80B MoE 的 MMLU 从 $n{=}1$ 的 85.1 升到 $n{=}8$ 的 87.5,Pile-test BPB 从 0.386 降到 0.378。在固定 Transformer 骨干下,扩展因子是可靠 scaling 旋钮:增大它同时改进准确率与语言建模损失。
Table 13(80B MoE 渐进扩展全量,BPB 越低越好):
| Benchmark | Shots | Base | n=2 | n=4 | n=8 |
|---|---|---|---|---|---|
| Embedding params | – | 6.1B | 12.1B | 24.2B | 48.4B |
| Training tokens | – | 1.37T | 503B | 906B | 1.01T |
| Pile-test (BPB)↓ | – | 0.386 | 0.387 | 0.382 | 0.378 |
| BBH (EM) | 3 | 87.5 | 88.3 | 90.0 | 90.6 |
| MMLU (EM) | 5 | 85.1 | 85.0 | 86.7 | 87.5 |
| C-Eval (EM) | 5 | 88.8 | 88.9 | 89.9 | 89.5 |
| SimpleQA | 5 | 16.7 | 15.1 | 17.2 | 18.4 |
| Chinese SimpleQA | 5 | 60.7 | 62.2 | 63.8 | 64.7 |
| HumanEval+ | 1 | 61.0 | 61.0 | 59.1 | 62.2 |
| MBPP+ | 1 | 67.7 | 64.4 | 70.2 | 71.2 |
| MATH | 4 | 60.4 | 58.4 | 71.4 | 71.7 |
Table 14(稠密 Qwen3-8B-Base 渐进扩展,总参固定 8B): BBH 78.8→83.9、MMLU 79.8→82.2、ARC-C 93.9→94.7、HellaSwag 79.7→85.3、GSM8K 92.5→94.6、MATH 56.0→61.1、MBPP+ 66.7→69.4($n{=}1\to8$)。少数中间因子非单调(如 MBPP+ 在 $n{=}2$ 先降后恢复),但 $n{=}8$ 整体最强。
4.4 注意力组成消融(21B MoE, Table 4)¶
测"需要多少 full cross-stream 混合"。21B 有 27 层、基座已交织 full 与滑窗层。对照三个 HD 变体(只在 full cross-stream 层数上不同:1、4、27,其余在 local 与 intra-stream 间分配)与一个无展开基线。
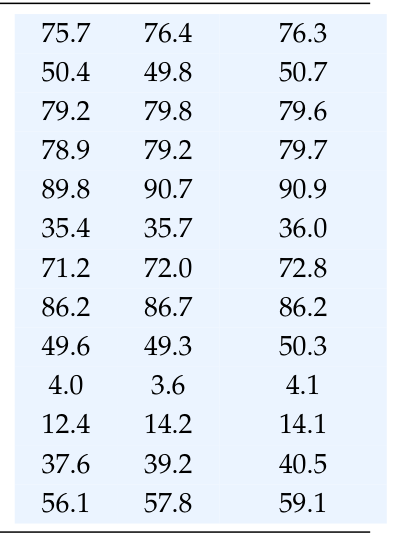
| Benchmark | Baseline | SF (1) | SF (4) | all-full (27) |
|---|---|---|---|---|
| MMLU | 74.1 | 75.7 | 76.4 | 76.3 |
| MMLU-Pro | 47.5 | 50.4 | 49.8 | 50.7 |
| CMMLU | 77.9 | 79.2 | 79.8 | 79.6 |
| C-Eval | 78.6 | 78.9 | 79.2 | 79.7 |
| ARC-C | 89.5 | 89.8 | 90.7 | 90.9 |
| SuperGPQA | 34.1 | 35.4 | 35.7 | 36.0 |
| BBH | 67.0 | 71.2 | 72.0 | 72.8 |
| GSM8K | 83.4 | 86.2 | 86.7 | 86.2 |
| MATH | 45.2 | 49.6 | 49.3 | 50.3 |
| SimpleQA | 3.7 | 4.0 | 3.6 | 4.1 |
| AA-OmniScience | 12.7 | 12.4 | 14.2 | 14.1 |
| HumanEval+ | 37.4 | 37.6 | 39.2 | 40.5 |
| MBPP+ | 55.2 | 56.1 | 57.8 | 59.1 |
| Average | 54.33 | 55.88 | 56.49 | 56.95 |
结论:每个 HD 变体平均都超无展开基线(+1.55 到 +2.62)。 all-full 最好,但更便宜的 4-full 变体接近(+2.16),1-full 变体仍改进基线(+1.55)。少数 full 层就够了:其余跨 stream 混合可 local 或跳过,让 SFA 保持便宜同时保住大部分准确率增益。 各配置层布局见附录 F Table 12:21B all-full = 0 intra / 0 local / 27 full;SF(4 full) = 10/13/4;SF(1 full) = 13/13/1;80B = 20/23/6;617B = 69/0/25。
4.5 推理吞吐(Figure 5)¶
在匹配设定下测服务成本:在同一 8 张 H20 GPU 上,对每个请求桶服务两次(HD 开 / 匹配 WeLM-80B 基线关展开),报 decoding-only 完成 TPS(排除 prefill 延迟),随输入长度桶与 batch size 变化,取 HD 相对基线的百分比。
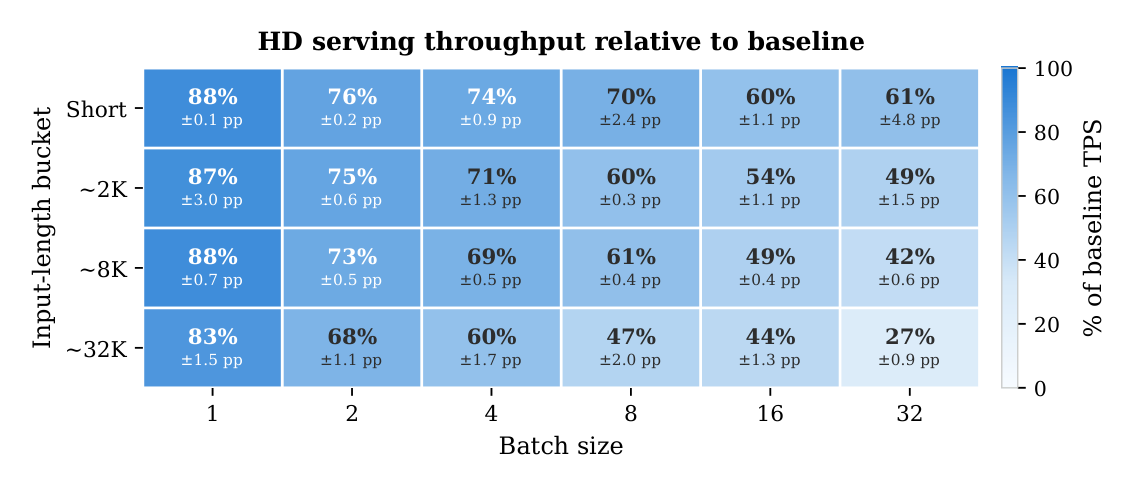
结论识别出一个实用服务窗口。 batch=1 时 HD 在所有输入桶保持基线吞吐的 83–88%;short/2k/8k 桶到 batch=4 仍保 69–88%,故延迟导向的小 batch 服务保留大部分基线 decode 吞吐。成本在长上下文 + 高 batch 显著:batch=16 时 short 输入降到 60%、2k 桶 54%、8k 桶 49%、32k 桶 44%;最大设定(32k 输入 + batch=32)保 27%。这些匹配实测支持 §3.2 成本模型:HD 对交互式 / 中等 batch 负载实用,长输入与大 batch 会更直接暴露额外的每 token 计算。(注:该服务 benchmark 未含 WeLM 特有的 KV-mirror decoding 优化,报的吞吐不含此加速。)
消融与中间 Stream 的探针分析(§5)¶
5.1 训练目标消融(6B MoE, Table 5)¶
在同一 6B 骨干上,把 final-stream 监督与更简单替代对比,以隔离"增益究竟来自什么"。变体:all-token loss(对每条 stream 都加 next-token 损失)、sum(预测前把各 stream 输出相加)、HD(只监督 final stream)。
| Method | Loss↓ | MMLU | ARC-C | C-Eval | CMMLU |
|---|---|---|---|---|---|
| Baseline | 1.908 | 53.4 | 68.7 | 58.4 | 61.2 |
| All-token loss (n=2) | 1.880 | 55.5 | 65.8 | 59.1 | 63.2 |
| Sum (n=2) | 1.877 | 55.6 | 71.9 | 61.0 | 63.3 |
| HD (n=2) | 1.874 | 56.5 | 74.3 | 61.2 | 63.7 |
| HD (n=3) | 1.857 | 58.5 | 75.7 | 62.5 | 65.9 |
结论: 所有展开变体都超无展开基线,但同一扩展因子下 HD 语言建模 loss 最低($n{=}2$ 时 1.874 vs all-token 1.880 vs sum 1.877),下游同样最好(ARC-C:HD 74.3 vs sum 71.9 vs all-token 65.8)。$n{=}3$ 进一步降 loss 到 1.857 并全面提升。这支持 final-stream 监督优于"对每条 stream 直接监督"与"显式求和 stream 输出"两种替代——中间 stream 应作为潜在计算而非各自被强行赋予预测目标。
5.2 KV 保留消融与 Stream 探针(21B MoE, Table 6)¶
KV 保留消融。 HD 默认为每条 stream 保留独立 KV cache,使后续位置能用早期中间 stream 产出的计算。对照 shared KV(PHD-like 控制 [Wu 2025]:保留 final-stream 预测目标与独立 stream 轨迹,但在 intra-stream 层用一份共享 KV cache 跨 stream)。若中间 stream 的 KV 冗余,替换成 shared KV 应无系统影响。
| Full layers | KV type | ARC | EEGPQA | MMLU | MMLU-Pro | QA-MMLU | SuperGPQA | Avg |
|---|---|---|---|---|---|---|---|---|
| 1 | Per-stream | 91.50 | 54.17 | 74.62 | 48.83 | 80.90 | 35.36 | 64.23 |
| 1 | Shared | 91.01 | 53.19 | 74.24 | 46.60 | 81.07 | 34.63 | 63.46 |
| 4 | Per-stream | 92.32 | 54.95 | 75.24 | 47.82 | 82.11 | 35.50 | 64.66 |
| 4 | Shared | 91.28 | 53.32 | 74.41 | 47.90 | 81.15 | 35.35 | 63.90 |
结论: shared KV 在两种布局下都降平均(1-full:64.23→63.46;4-full:64.66→63.90)。虽是小 $n{=}2$ 定性对照、单任务列有噪声,但平均在两布局同向下降,说明为不同 stream 保留独立 KV 状态确实改进准确率。
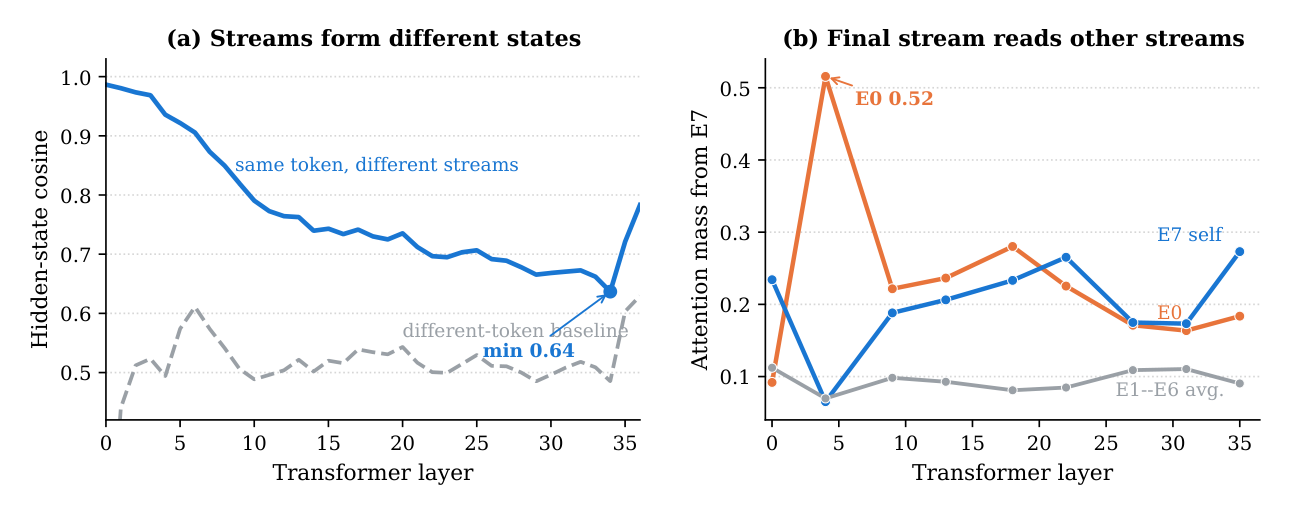
Stream 探针(Figure 6)。 分析训练好的稠密 Qwen3-8B-Base HD($n{=}8$,E7 为 final 预测 stream,E0–E6 中间)。(a) 同 token 的各 stream 在中间层分离、临近输出又部分靠拢:mean cosine 从输入的 0.987 掉到中间层 0.637、末层回升到 0.783,且始终高于 different-token 基线,把 stream 特有结构与一般 hidden-state 各向异性区分开。(b) E7 对其他 stream 分配显著注意力,尤其 E0(affinity 峰值 0.52,在若干采样层可比甚至大于自注意力),显示"从中间 stream 到预测 stream 的读取通路"。
5.3 词表空间的 LM-Head 探针(Figure 7-8)¶
把共享 LM 头施加到每条 stream 的 hidden state,看不同 stream 位置暴露的 token 候选。(a) $n{=}8$ 下中间探针的 top-1 token 常与 final stream E7 不同,最大差异率约 63%。(b) 中间探针熵更高:$n{=}8$ 时 E7 熵 2.09 bit,若干中间 stream 高于 3 bit。top-1 差异与更高熵共同表明:中间 stream 保留更宽的 token 级候选空间,final stream 才把它收敛到预测。 图 8 定性示例:早/中期探针可能偏好模板、结构或关联 token(如 "a"、"located"、"Apollo"),后期探针再向 final stream 的 token 靠拢。
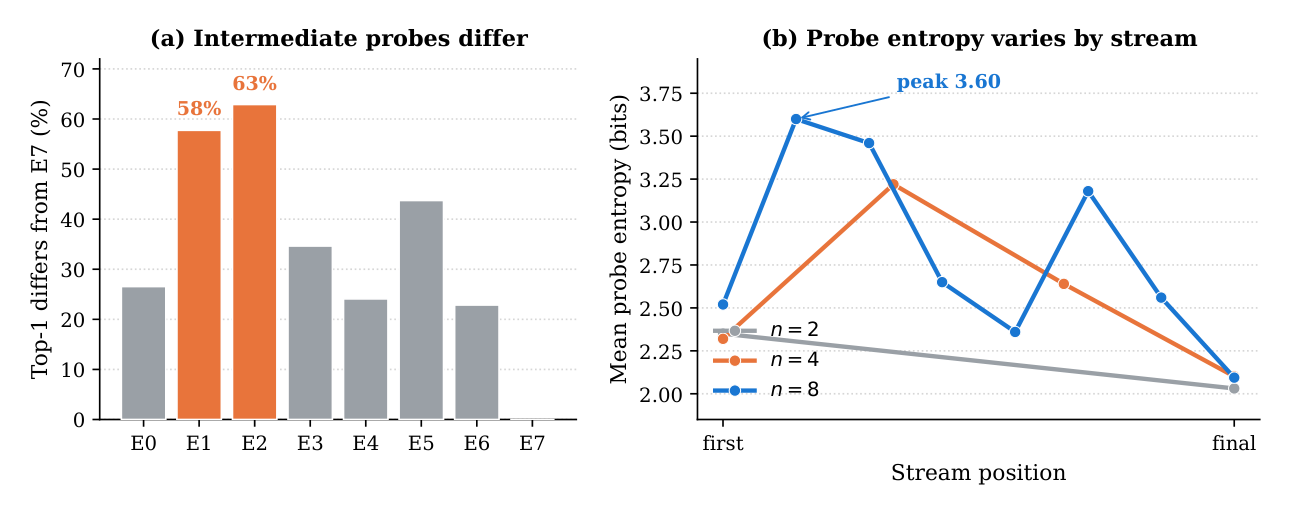
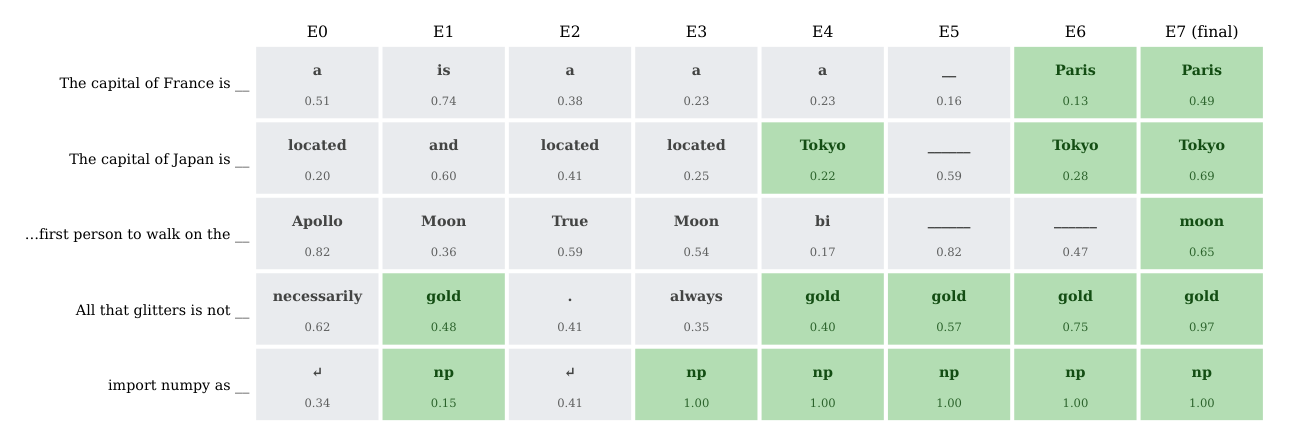
综合。 目标消融支持 final-stream 监督优于监督每条 stream 或求和其输出;KV 与注意力分析显示 stream 特有 KV 有用、stream 在 Transformer 内分离、final stream 会读其他 stream;LM-head 探针提供可解释视角——中间 stream 在 final stream 定下预测前保留更宽的 token 备选。合起来支持"更早的 stream 充当潜在计算状态" 这一角色。
CPT 启动损失(附录 H, Figure 9)¶
在独立 617B checkpoint 上比较三种 $n{=}4$ 注意力组成的 CPT 启动 loss(均从 step-16000 起启用展开):无 intra-stream 层 / 1:1 cross-/intra 布局 / 1:3 cross-/intra 布局。首个展开步 loss 分别为 1.59 / 1.45 / 1.14,"no intra > 1:1 > 1:3" 的序在共享六步窗口始终成立;1:3 布局继续训练 475 步平稳降到 0.68。这支持 intra-stream 层的设计作用:既降注意力成本,也降低从展开前 checkpoint 启动 CPT 时的启动 loss 抬升。
与已归档相关工作的对比¶
LoopCTR LoopCTR: Unlocking the Loop Scaling Power for CTR (Renmin University / Alibaba, 2026-04-21)¶
关系:独立并发(本文未引用 LoopCTR,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在解同一个 root cause——如何在保持骨干参数固定(不再加宽/加深、不再重新大规模预训练)的前提下,给模型注入一条新的"计算量"scaling 轴。LoopCTR 明确称之为"正交于 depth/width/input scaling 的第四种 scaling 维度";Hidden Decoding 称之为"固定骨干的序列长度 scaling 路径"。两者的动机叙事高度重合:加参数太贵、部署受约束,于是转而扩"每步/每 token 的内部计算"。
- 相近的技术骨架:两篇都出现了"多 stream + 共享骨干 + 只在末端监督"的骨架。LoopCTR 的 HCR 把单流 hidden state 复制成 $n$ 个并行 stream 做残差混合;Hidden Decoding 把每 token 展开成 $n$ 条 stream。两者都用"只在最后/收敛处施加主损失"的思路(LoopCTR 的 multi-depth process supervision 在每个 loop 深度监督、Hidden Decoding 只监督 final stream)。
- 本文的差异与推进:这正是一对"同问题、对立解法轴"的独立并发工作——LoopCTR 选的恰是 Hidden Decoding 论证"难以 scale 到大 MoE"的那条路(depth-recurrent looping:沿深度反复复用共享 Loop Block);Hidden Decoding 则明确避开 looping、改走序列维展开,理由就是 looping 与训练超大 MoE 的 pipeline parallelism 冲突。因此 Hidden Decoding 把这条路径推到了 100B+ MoE 的 frontier LLM 规模,而 LoopCTR 停在 CTR 的 ~1.5M 参数级、且承认最大只测到 $L{=}3$、无线上 A/B。
- 可比的方法 / 实验差异:LoopCTR 的杀手锏是 train-multi-loop / infer-zero-loop(推理时整块删掉 Loop Block、latency 缩 50–80×),把"多计算训练的好处"压回单次前向——它是把额外计算内化后在推理时省掉;Hidden Decoding 反过来在推理时保留展开($n$ 条 stream 一起前向),代价是 batch=1 保 83–88% 吞吐、大 batch 长输入更贵。两者都靠"注意力 mask 设计"控成本:LoopCTR 用非对称 prefix mask(sequential 不看 global)省 KV,Hidden Decoding 用 SFA(大多数层 intra-stream)把注意力压到近线性。领域不同(工业 CTR vs frontier 语言建模),但对"固定骨干下如何扩计算"的答卷可直接互为镜像参照。
In-Place TTT In-Place Test-Time Training (ByteDance Seed, 2026-04-08)¶
关系:独立并发(本文未引用 In-Place TTT)· 已加载对方精读
- 共同关注的问题:两篇都想在不改架构、不从头预训练的前提下,给已有强预训练骨干注入"额外的每 token 内部计算"——是一个 drop-in 增强而非新层替换。In-Place TTT 强调"架构不兼容 → 无法用于已有数十亿参数模型"这一障碍,Hidden Decoding 同样把"改进已有骨干、不再重训"作为出发点。
- 相近的技术骨架:两者都把额外计算编排进标准前向路径、复用基座已有组件(In-Place TTT 复用 MLP 的 $W_\text{down}$ 作 fast weights;Hidden Decoding 复用基座已有注意力层作 cross-stream 层、不新增层),并都用 chunk/stream 化 + 与 next-token 对齐的目标保证兼容大规模并行训练。
- 本文的差异与推进:机制路径不同——In-Place TTT 通过推理时原地更新 $W_\text{down}$(fast weights) 让模型"边读边改自己",是权重层面的动态计算;Hidden Decoding 是表征层面的静态展开(多 stream + 保留 KV),权重全程不变,额外计算体现为更长序列。In-Place TTT 主打长上下文/持续演化,Hidden Decoding 主打 CPT 阶段的能力 scaling 到 frontier MoE 规模。
- 可比的方法 / 实验差异:In-Place TTT 的额外计算是串行受限(fast-weight 更新本质逐 chunk 依赖),Hidden Decoding 的额外计算是并行($n$ stream 单次前向),这也是 Hidden Decoding 反复强调相对 looped/序列依赖方法在服务端"额外计算可隐藏在小 batch 空闲算力里"的优势来源。两者都可视作"给固定 LLM 加 latent computation"的不同流派。
讨论与局限性¶
核心贡献。 (1) frontier-scale 固定骨干 scaling:首次在 100B+ MoE 规模通过 CPT 跑通序列长度 scaling,产出 WeLM-HD4-80B / WeLM-HD4-617B,进入 looped/长度 scaling 方法此前未达的规模区间。(2) 高效序列长度展开:SFA 让大多数层 intra-stream、少数层跨 stream,把注意力代价压到近线性;80B/617B 的 $4\times$ 展开只贵 5.1×/4.4×,远低于 dense 的 16×。(3) 扩展因子 scaling:增大 $n$ 同时改进语言建模 loss 与下游准确率,$n$ 作为固定骨干的实用 scaling 旋钮成立。
值得借鉴的设计。 (a) 把额外计算从深度维搬到序列维——一个非常"工程现实"的洞察:沿序列扩展天然兼容 pipeline parallelism 与现有大模型训练栈,绕开了 looping 与流水线并行的根本冲突。这对任何想在超大 MoE 上加 per-token 计算的人都有直接启发。(b) 只监督 final stream + 独立 embedding 表:让中间 stream 自发承担"潜在计算"角色,消融证明它优于监督全部 stream 或求和输出;探针进一步给出可解释证据(中间 stream 保留更宽 token 候选、final stream 收敛之)。(c) 复用基座已有注意力层作 cross-stream 层、不新增参数,以及 Cyclic Replication Initialization 渐进扩展——都是降低 CPT 启动扰动、省算力的巧思。(d) KV-mirror + "中间 stream 跳过 mirror 层" 是与骨干共设计的额外节省样板。
局限与争议。 (1) 推理成本无法隐藏于大 batch / 长输入:Figure 5 显示 32k 输入 + batch=32 只剩 27% 基线吞吐,HD 的服务甜区局限在小 batch / 短输入,这对高吞吐服务是硬约束(与 LoopCTR 的 infer-zero-loop"推理时删掉额外计算"形成鲜明对比——HD 没有等价的推理时省计算机制,除了未集成进 decoding kernel 的 KV-mirror)。(2) embedding 参数暴涨:$n{=}4$ 使 617B 的 embedding 从 26.9B 涨到 107.4B、$n{=}8$ 稠密 8B 的 embedding 达 5.6B;虽是稀疏查表不进矩阵乘,但显存/存储成本随 $n$ 线性膨胀。(3) 受控对照用早期 SFT-only、无 RL,与成熟发布模型的最终能力有距离,且 617B 的 HD 长上下文 token 更少使其增益是保守下界——好处是对照干净、坏处是不能直接读出"上线后能拿多少绝对分"。(4) KV 保留消融只在 21B、$n{=}2$ 的小规模定性验证,单任务列有噪声;SFA 层布局(几层 full、放哪)目前靠经验设计,缺自动化搜索。(5) 中间 stream 到底"算了什么"仍是探针级观察(cosine 分离、注意力 affinity、LM-head 熵),非机制级因果证明——"latent computation"的解释停留在相关性层面。
工业落地价值。 本文本身就是一次frontier LLM 的工程落地报告:WeLM 是腾讯微信 AI 的生产级 MoE 模型系列,代码与权重开源,配套 KV-mirror 训练系统优化、H20 GPU 服务 benchmark、YaRN 长上下文扩展等都给了可复现细节。对"已有强骨干、想继续变强但重训太贵"的团队,Hidden Decoding 给出了一条只花约 5% 额外训练 token、骨干零改动的现实升级路径,尤其适合能容忍推理端小 batch/短输入服务窗口的场景。