How Model Growth, Recursion, and Boundary Operators Influence Scaling Exponents
Zixi Chen(NYU,Q Labs 实习)、Akshay Vegesna、Samip Dahal(Q Labs)、Andrew Gordon Wilson(NYU + Q Labs),arXiv 2609.19107v1,2026-09-16,cs.LG。代码:github.com/qlabs-eng/scaling-exponents。
研究动机与背景
Scaling law 把损失写成算力的幂律,其中常数项(constant)决定曲线的上下平移,指数项(exponent)决定曲线的形状。两者的实践意义完全不同:常数改进在每个规模上省下同一个倍数的算力(例如作者引用的 Muon 相对 AdamW 约 40% 的恒定算力增益),指数改进省下的倍数会随预算增大而复利增长。
作者要挑战的「conventional wisdom」是:架构改动一般只影响常数,不影响指数(Bansal et al. 2022;Hestness et al. 2017;Chen et al. 2026)。已知的指数型改进很少——Transformer 相对 LSTM 靠利用长上下文拿到更好的参数指数,MoE 标度律预测相对稠密模型的优势随预算扩大;结构化矩阵、Muon 等则只改常数。作者认为指数改进之所以「没被看见」,部分原因是超参数缩放细节本身就能决定一个干预是否改变标度律(Qiu et al. 2026 在 Muon 上的发现),而以往的生长/循环研究没有在「每个架构各自的算力最优配方」下比较。
本文的出发点是 computational depth(计算深度):给定算力预算,希望模型拥有尽可能多真正在起作用的深度,以捕捉数据中的层级结构、组合多步计算。作者识别出两种浪费深度算力的方式:
- curse of depth:pre-norm Transformer 的残差流随深度增长,每个块的更新只占残差流越来越小的比例,深层块趋于「什么也不做」;
- 过早付费:网络在训练早期先学简单模式、后期才学复杂成分(Nakkiran et al. 2019;Rahaman et al. 2019),固定深度的模型从第一步起就在为后期才需要的深度付算力。
两种浪费若随深度增大而占比上升,又因为算力最优模型随预算变深,就会随规模增长,从而表现为指数而非常数。对应的两个干预是:boundary operator(边界算子)让每个执行块都以满权重写入残差流;model growth(模型生长)让模型保持浅层直到需要更多深度时再加深。
作者注意到 looped transformer 的「prelude–core–coda」形式(Geiping et al. 2025)恰好是容纳这两种干预的统一容器:把循环次数在训练中途调大,就是一种不增加参数的深度生长;把各轮权重解绑,就是 Du et al. (2024) 的深度堆叠式生长;而不循环但保留边界算子,就是「带边界算子的普通 Transformer」。作者特别强调:循环通常用于推理时算力扩展或参数效率,本文把它当作固定训练算力下更高效训练的手段。
主要结论(Figure 2):
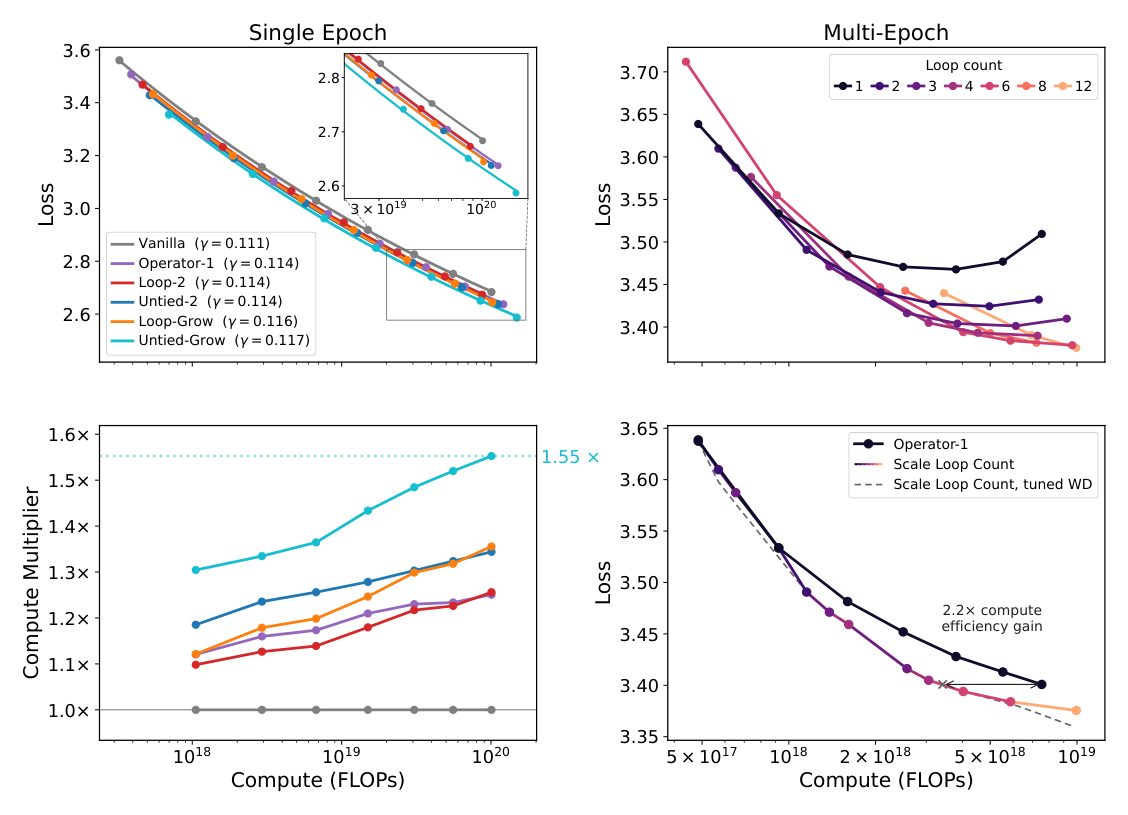
- 架构干预可以改变预训练的标度指数;指数差异最直观的读法是 compute multiplier(普通 Transformer 达到同一损失需要多少倍算力)随规模上升;
- 解绑权重的深度生长(Untied-Grow)改进指数,$10^{20}$ FLOPs 处 multiplier 1.55×,且差距随规模拉大;
- 绑定权重的循环生长(Loop-Grow)以与 Vanilla 相同的参数量拿到生长带来的指数改进,只比解绑版本差一个常数,$10^{20}$ FLOPs 处 1.36×;
- 仅在普通 Transformer 中加入边界算子(Operator-1)也改进指数,$10^{20}$ FLOPs 处 1.25×;
- 多 epoch(100M unique token × 10 epoch)下循环起正则作用,最优循环次数随算力增长,扩循环数达到「逐尺寸调过 weight decay 的 Transformer」最佳损失只需 1/2.2 的算力;
- 外推验证:7.4B 的 Untied-Grow 在最大拟合算力的 8 倍处落在预测曲线上,CORE 追平 GPT-3 13B,训练算力约少 20×;相对 Vanilla 的 1.8× 优势($1.2\times10^{21}$ FLOPs)按拟合律在 $10^{25}$ FLOPs 处达到 2.7×。
核心方法:prelude–core–coda 统一家族
统一形式
所有模型都是同一个三段式网络:prelude 把输入嵌入为表示 $e$,core 被施加 $K$ 次,coda 产出输出。
$$e = P(s), \qquad h_k = R_{\theta_k}\big(\phi(h_{k-1}, e)\big),\ k = 1,\dots,K, \qquad y = C\big(\rho(h_K, e)\big) \tag{1}$$
$P, R, C$ 分别是 prelude、core、coda;$\phi$ 与 $\rho$ 是边界算子,在每次 core 之前、以及 coda 之前把状态与 prelude 输出 $e$ 混合;$\theta_k$ 是第 $k$ 次 pass 的权重,$K$ 是循环次数。若三段分别有 $P, C, D$ 个块,一个 token 经过的块数(executed depth,执行深度)为
$$\ell = P + K C + D \tag{2}$$
作者把执行深度与存储块数(stored blocks,用来衡量模型大小)严格区分,并固定宽深比 128。
边界算子(Boundary Operator, BO)
标准 Transformer 相当于 $K=1$ 且 $\phi, \rho$ 为恒等映射。本文在各次 core pass 之间与 coda 之前统一施加:
$$\mathrm{BO}(h, e) = \mathrm{Norm}(h) + \alpha\, e \tag{3}$$
即令式 (1) 中 $\phi = \rho = \mathrm{BO}$。两部分各有用途:pre-norm 块里残差流随深度增长,每次更新只占越来越小的比例,归一化让每次 pass 都能以满权重写入;加回 prelude 输出 $e$ 让每次 pass 都以输入为条件。pass 之间做归一化在循环 Transformer 中是标准做法(Geiping et al. 2025;HRM-Text),也是 curse of depth 的已知解法;重注入输入出现在循环模型(Geiping、Parcae、Schwethelm)以及 nanochat / modded-nanogpt 这类固定深度 Transformer 里。本文的差异点:既有循环 Transformer 在 coda 前只做归一化、只在 core pass 之间重注入 $e$,本文在 coda 之前也施加同一个「归一化 + 注入」映射,并发现这一点很重要(Table 4、Figure 15a)。
循环与解绑
边界算子固定后,变体只在 core 权重 $\theta_k$ 与 pass 何时激活上不同:
- 绑定($\theta_1 = \dots = \theta_K$):looped transformer,存 $P + C + D$ 个块、执行 $P + KC + D$ 个块;
- 解绑:每次 pass 有独立 core,计算图与 FLOPs 与绑定版完全相同,但存 $P + KC + D$ 个块,等价于一个带边界算子的深 Transformer。解绑模型因此是把「深度效应」与「权重共享效应」分开的对照组。
模型生长
从较小的 $K$ 开始训练,中途调大。绑定情形下已有 core 直接被多用几次,不增加任何权重;解绑情形下把训练好的 core 复制后各自训练,即 Du et al. (2024) 的 depthwise stacking。生长只在单次训练内改变 $K$,而沿标度阶梯 prelude / core / coda 随模型尺寸一起长大。其余在既有循环 Transformer 中不统一的选择被固定:初始状态 $h_0 = 0$;循环次数固定而非采样;梯度流经每一次 pass。
Untied-Grow 的完整训练过程(原文 Algorithm 1):
输入: 训练 batch {(x_t, y_t)}_{t=1..T}; 注入尺度 α; 生长步 g; 初始 core 数 K0; 终态 Kf = m·K0 (m ≥ 2)
1: 初始化 prelude P、coda C 与 K0 个独立 core {R_θk}
2: K ← K0
3: for t = 1..T:
4:     if t = g+1:                              ▷ 训练 g 步后生长
5:         for r = 1..m-1:
6:             for j = 1..K0:  θ_{r·K0+j} ← copy(θ_j)   ▷ 堆叠一份 core 副本
7:         K ← Kf                               ▷ 激活新的解绑 core
8:     e ← P(x_t);  h ← 0
9:     for k = 1..K:
10:        h ← RMSNorm(h) + α·e                 ▷ 每次 core 前的边界算子
11:        h ← R_θk(h)                          ▷ 每次 pass 权重不同
12:    h ← RMSNorm(h) + α·e                     ▷ coda 前同样施加
13:    ŷ_t ← C(h);  L_t ← CrossEntropy(ŷ_t, y_t)
14:    用 ∇L_t 更新所有活跃参数                    ▷ 反传穿过全部 K 次 pass
变体设计:每次只动一个轴
原文 Figure 1(架构示意图未能从 PDF 提取为位图,下面用表格与流程图重绘)把最小规模下训练的六个模型排成三组「一次只改一个轴」的对照,外加两个无算子对照:
| 变体 | 边界算子 | 权重 | 生长 | 执行深度 $\ell$(最小规模) | 存储块 | 隔离的轴 |
|---|---|---|---|---|---|---|
| Vanilla | 无 | — | 无 | 6 | 6 | 基线 |
| Operator-1 | 有($K=1$) | — | 无 | 6 | 6 | 与 Vanilla 同参数同 FLOPs → 边界算子 |
| Loop-2 | 有 | 绑定 | 无($K=2$) | 8 | 6 | 与 Untied-2 同 FLOPs 同深度 → 权重共享 |
| Untied-2 | 有 | 解绑 | 无($K=2$) | 8 | 8 | 同上 |
| Loop-Grow | 有 | 绑定 | $K: 2\to4$ | 8→12 | 6 | 与 Untied-Grow 对照 → 生长 |
| Untied-Grow | 有 | 解绑(先复制再解绑) | $K: 2\to4$ | 8→12 | 12 | 同上 |
| Deep Vanilla | 无 | 解绑 | 无 | 同 Untied-2 | 同 Untied-2 | = Untied-2 去掉算子 |
| Deep Vanilla Grow | 无 | 解绑 | $K: 2\to4$ | 同 Untied-Grow | 同 Untied-Grow | = Untied-Grow 去掉算子,隔离「无算子的生长」 |
flowchart LR
  S[tokens s] --> P[Prelude P] --> E[e]
  E --> B1["BO: Norm(h)+αe"] --> C1[Core pass 1] --> B2["BO"] --> C2[Core pass 2]
  C2 -. 生长后激活 .-> B3["BO"] -.-> C3[Core pass 3] -.-> B4["BO"] -.-> C4[Core pass 4]
  C2 --> BC["BO (coda 前)"]
  C4 -.-> BC
  BC --> D[Coda] --> Y[logits]
  E -. 注入 .-> B2
  E -. 注入 .-> BC
记号 $d\ell$ 表示名义深度 $\ell$、宽度 $w = 128\ell$(d8 宽 1024)。Vanilla、Operator-1 与绑定变体在 $d\ell$ 处恰好存 $\ell$ 个块,解绑变体每多一次 pass 多存一份 core(Untied-2 在 d8 存 11 块)。
Table 2:模型深度、层划分、执行深度与存储参数量
| 深度 | P/C/D | 执行深度(K=2→4) | 宽度 | Vanilla | Loop-Grow | Untied-2 | Untied-Grow |
|---|---|---|---|---|---|---|---|
| d6 | 2/2/2 | 8→12 | 768 | 120M | 120M | 130M | 160M |
| d8 | 2/3/3 | 11→17 | 1,024 | 210M | 210M | 240M | 320M |
| d10 | 3/4/3 | 14→22 | 1,280 | 330M | 330M | 410M | 580M |
| d12 | 4/4/4 | 16→24 | 1,536 | 490M | 490M | 610M | 830M |
| d14 | 4/5/5 | 19→29 | 1,792 | 730M | 730M | 920M | 1.3B |
| d16 | 5/6/5 | 22→34 | 2,048 | 1.0B | 1.0B | 1.3B | 2.0B |
| d18 | 6/6/6 | 24→36 | 2,304 | 1.4B | 1.4B | 1.8B | 2.5B |
| d20 | 6/7/7 | 27→41 | 2,560 | 1.8B | 1.8B | 2.4B | 3.5B |
| d22 | 7/8/7 | 30→46 | 2,816 | 2.4B | 2.4B | 3.2B | 4.7B |
| d24 | 8/8/8 | 32→48 | 3,072 | 3.0B | 3.0B | 3.9B | 5.7B |
| d26 | 8/9/9 | 35→53 | 3,328 | 3.8B | 3.8B | 5.0B | 7.4B |
固定 Loop-2 / Untied-2 用第一个执行深度,生长变体用第二个。Operator-1 与 Loop-2 的存储参数同 Vanilla;Loop-2 的「有效参数」同 Untied-2;Untied-Grow 从一开始就分配全部四份解绑 core(显存按终态计)。硬件上,Operator-1 相对 Vanilla 只多一个 RMSNorm 和向量加法;Untied-2 与 Loop-2 计算图相同。
关键技术细节:逐架构的算力最优配方
标度律与 compute multiplier
Chinchilla 把损失写成参数量 $N$、训练 token 数 $T$ 与不可约下界 $E$ 的函数:
$$L(N, T) = E + (N/N_0)^{-\alpha} + (T/T_0)^{-\beta}, \qquad C \approx 6NT \tag{4}$$
每个预算下选最优 $N/T$ 分配,得到算力最优损失,它仍是幂律:
$$L(C) = E + A\left(\frac{C}{C_0}\right)^{-\gamma} \tag{5}$$
$A$、$\gamma$ 为拟合量,$C_0$ 取 Vanilla 被调参时的算力。架构因此是「以算力为索引的模型族」。比较两种架构时反解式 (5):记 $\hat{C}_A(\ell)$ 为架构 A 的拟合律达到损失 $\ell$ 所需算力,则 B 相对 A 的 compute multiplier 为
$$\pi(\ell) = \frac{\hat{C}_A(\ell)}{\hat{C}_B(\ell)}, \qquad \pi(C) = \pi\big(L_A(C)\big) \tag{6}$$
$\pi = 1.25$ 表示 A 需要 B 的 1.25 倍算力。全文 A 恒为标准 Transformer。平坦的 multiplier 曲线是常数改进,上升的曲线是指数改进。
拟合方式:先用 Huber loss 在 Vanilla 上拟合不可约损失 $E$(Hoffmann et al. 2022),其余架构共享这个 $E$,在 log–log 空间做仿射回归:
$$\log(L - E) = -\gamma \log(C / C_0) + \log A \tag{7}$$
multiplier 则由相邻两点在 log-loss / log-compute 空间线性插值得到,不外推。
训练协议
Table 1:固定架构与训练协议
| 设置 | 协议 |
|---|---|
| 上下文长度 | 2048 tokens |
| Tokenizer | GPT-2 词表 50,257,补齐到 50,304 |
| 全局 batch | 524,288 tokens(所有规模固定) |
| 形状规则 | $d\ell$ 表示名义深度 $\ell$、宽度 $w = 128\ell$ |
| 优化器 | 矩阵参数用 Muon;embedding 与 LM head 用 AdamW |
架构:pre-norm decoder-only Transformer,RoPE、SwiGLU、QK norm;无 bias、无可学习 norm 增益(可训练参数全为二维矩阵);token embedding 后与 lm head 前各有一个 RMSNorm;attention/MLP 输出投影与 lm head 零初始化,embedding 正态初始化,Q/K/V 与 MLP 输入矩阵均匀初始化。多数 run 用单节点 8×H100,d26 外推 run 用两节点。数据为 FineWeb(后续复现到 FineWeb-Edu)。
算力按模型 FLOP 估计器计算,含矩阵乘法与注意力;下文 $6TN_{\text{eff}}$ 形式只是领先阶分配恒等式。两个乘子定义:output multiplier(OM)乘在 unembedding 上;residual multiplier(RM)乘在 MLP down projection 与 attention output projection 上(与学习率、初始化尺度满足 ABC-parameterization 等价关系)。
全家族共享的三项决策(Appendix A.2)
在四阶段配方之前,先用绑定变体、1B token、匹配参数量一次性确定三件事。
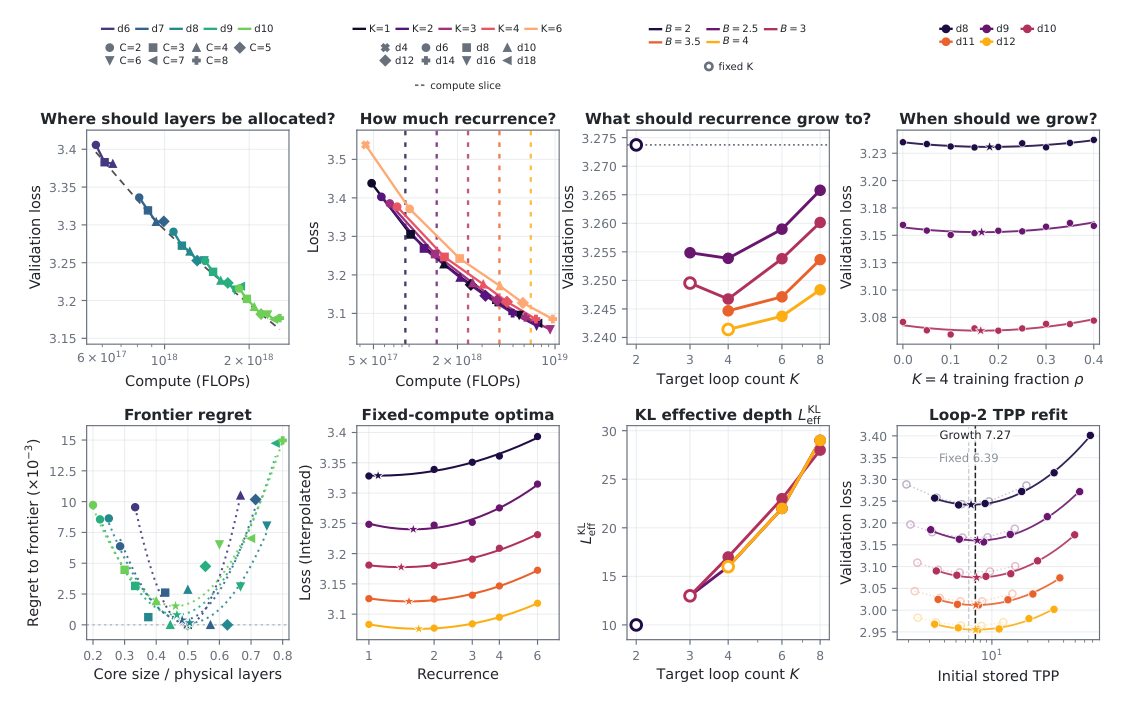
(1) 块在三段间的分配。 在多个存储深度上扫描两次 pass 的绑定模型的 core 大小,每个模型训 1B token,按共同算力前沿比较(更大的 core 每 token 执行更多块)。最优 core 占比随深度变化很小,于是三段尽量均分,余数先给 core 再给 coda。
(2) core pass 次数。 对 $K \in \{1,2,3,4,6\}$ 各训一条 1B token 的尺寸阶梯(Operator-1 基础配方),在共同预算上插值并对 $K$ 拟合:绑定与解绑的拟合最优都在 1 与 2 之间,$K = 3,4,6$ 更差。固定变体因此用 $K=2$。
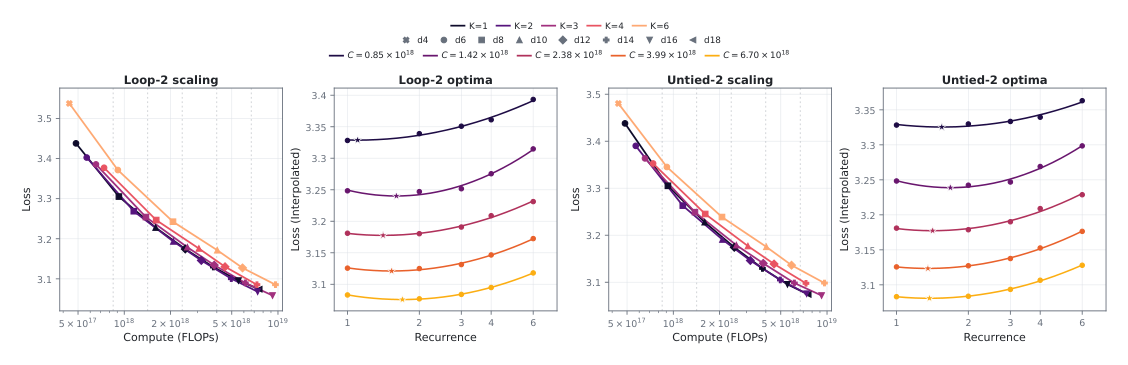
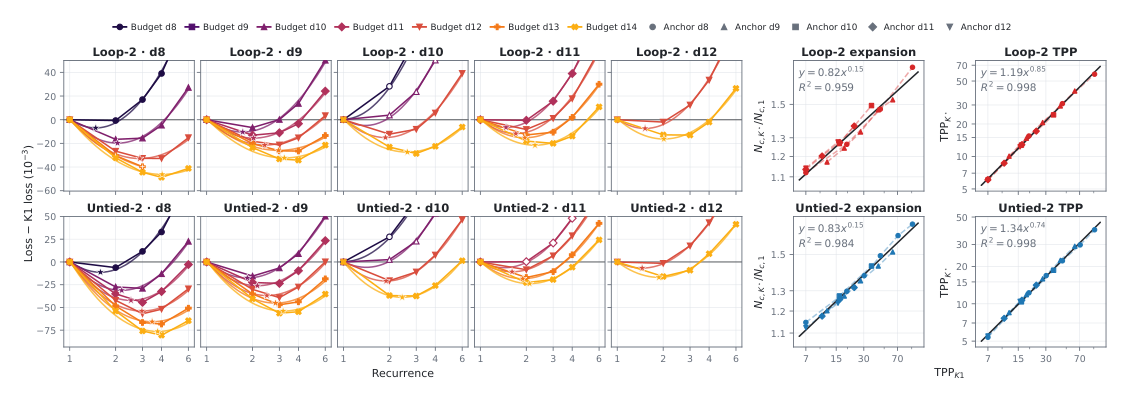
但若固定 anchor 深度、随 $K$ 增大减少 token 以保持算力,d8–d12 各 anchor 上拟合最优 $K^\star$ 随预算增长(与 Parcae 一致)——这种比较不检验「多 pass 是否胜过加大模型」。记 $N_{c,K}$ 为 compute-active 参数量(prelude、coda、输出头矩阵各计一次,core 矩阵计 $K$ 次,即使共享;不含输入 embedding 查表),扩张比 $E_K = N_{c,K}/N_{c,1}$,在 $K^\star$ 处拟合:
$$E_{K^\star} = 0.82\,\mathrm{TPP}_{K1}^{0.15}\ \text{(tied)}, \qquad E_{K^\star} = 0.83\,\mathrm{TPP}_{K1}^{0.15}\ \text{(untied)} \tag{8}$$
其中 $\mathrm{TPP}_{K1}$ 是同预算下 $K=1$ 能负担的 token 数除以该模型存储参数量($R^2$ 分别 0.959 / 0.984)。
(3) 生长目标。 从 2/3/3 划分的绑定 d8 出发、1B token,扫描生长目标 $K \in \{3,4,6,8\}$(转换点按预算定,目标越大其占训练比例越小)。生长到 4 次 pass 在每个预算都最优;更大目标能提高 logit-KL 有效深度但不稳定地改善损失。于是生长变体统一 $2 \to 4$。Deep Vanilla Grow 对普通 Transformer 块用同样的复制日程与三段划分。
生长时机与 token 分配
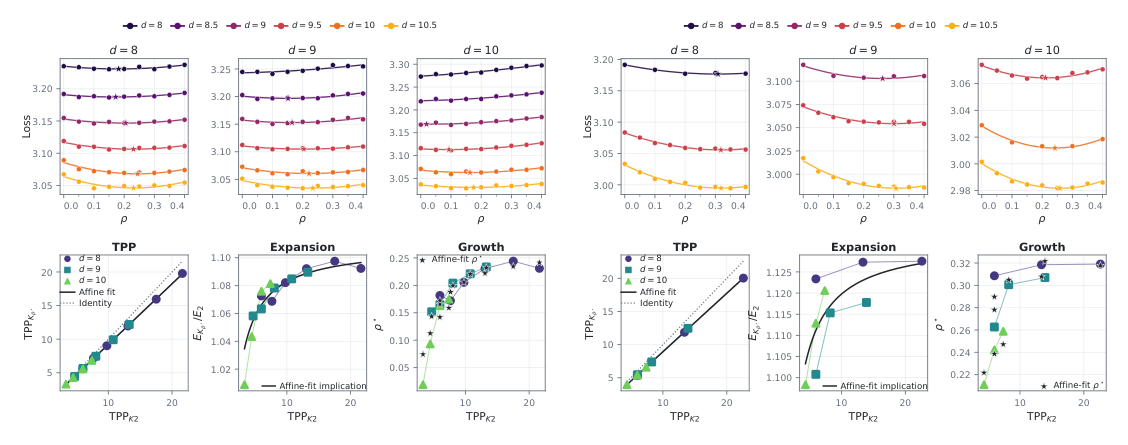
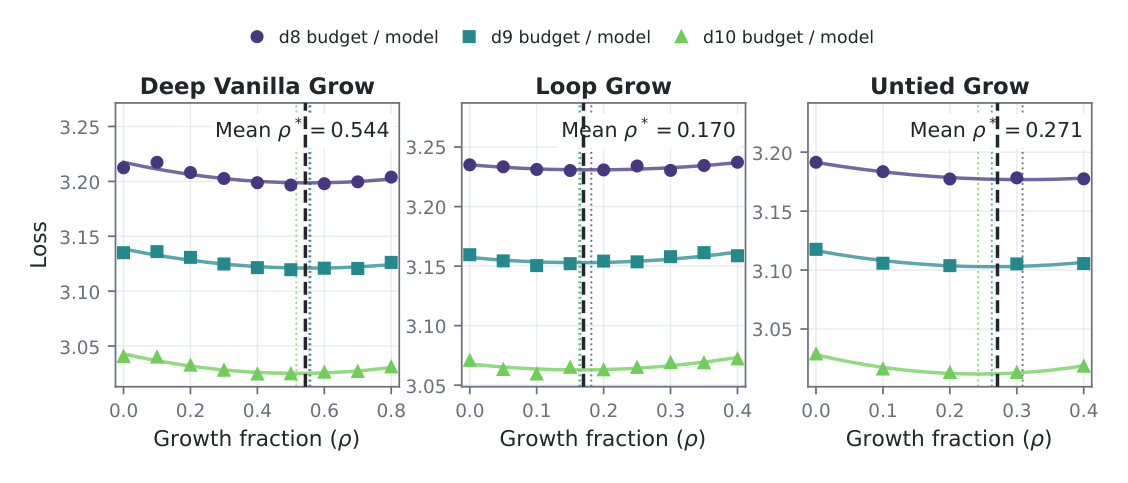
记 $\rho$ 为生长之后处理的 token 比例($\rho$ 越大转换越早)。目标固定为 4 次 pass,Loop-Grow 在 3 个 anchor 深度 × 6 个预算、Untied-Grow 在同样 anchor × 3 个预算上扫 $\rho$,二次拟合定 $\rho^\star$。预算越大一般越偏向早生长,但极小值很宽。跨深度与预算,最优处的 token 分配满足仿射关系:
$$\mathrm{TPP}_{K\rho^\star} = a\,\mathrm{TPP}_{K2} + b \tag{9}$$
两个 TPP 都用初始 $K=2$ 的存储参数作分母。$(a, b) = (0.902, 0.216)$(Loop-Grow)与 $(0.883, 0.103)$(Untied-Grow),$R^2 > 0.9999$。高 TPP 端拟合的生长比例约为 Loop-Grow 0.23–0.24、Untied-Grow 0.26–0.32。Deep Vanilla Grow 在 d8/d9/d10 的拟合比例为 0.556 / 0.559 / 0.516,极小值同样平缓、位于训练中点附近。
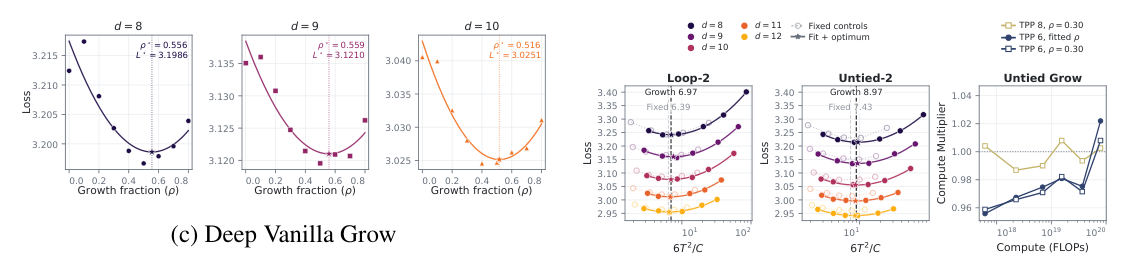
生长提高了每 token 平均算力,最优 token 分配必须重拟。以 $6T^2/C$(在 $C = 6TN_{c,\text{eff}}$ 下即「每训练平均 compute-active 参数的 token 数」)为坐标,绑定生长的平均最优从 6.39 升到 6.97,解绑从 7.43 升到 8.97——生长偏好更小的初始模型训更多 token。简化处方的消融(初始存储 TPP 8 vs 6 × 逐尺寸拟合 $\rho$ vs 常数 $\rho = 0.30$)显示 matched-loss multiplier 都接近 1:复用 TPP 6 改变算力需求 < 约 5%,把拟合 $\rho$ 换成 0.30 改变验证损失 −0.0009 到 +0.0019。
TPP 关系推导(Appendix A.3)
区分存储参数(决定 TPP)与 compute-active 参数(决定领先阶算力)。固定循环次数 $K$ 时定义:
$$\mathrm{TPP}_K = \frac{D_K}{N_{s,K}}, \qquad E_K = \frac{N_{c,K}}{N_{c,1}}, \qquad S_K = \frac{N_{s,K}}{N_{s,1}} \tag{10}$$
固定算力有 $D_K N_{c,K} = D_1 N_{c,1}$,即 $D_K = D_1/E_K$,于是
$$\mathrm{TPP}_K = \frac{D_1/E_K}{S_K N_{s,1}} = \frac{\mathrm{TPP}_{K1}}{E_K S_K} \tag{11}$$
增大循环次数通过「每 token 算力增加」降低 TPP,解绑模型还通过「存储参数增加」再降一次。绑定时 $S_K = 1$;解绑且块参数占主导时 $S_K \to E_K$;三段近似均分时两者的 $E_K \to (K+2)/3$。结合式 (8) 得到经验拟合:
$$\mathrm{TPP}_{K^\star} = 1.19\,\mathrm{TPP}_{K1}^{0.85}\ \text{(tied)}, \qquad \mathrm{TPP}_{K^\star} = 1.34\,\mathrm{TPP}_{K1}^{0.74}\ \text{(untied)} \tag{12}$$
($R^2$ 均为 0.998)即最优处的每存储参数 token 数随基线 TPP 次线性增长——多出的预算有一部分流向了循环。
从 2 到 4 次 pass 生长时,token 加权平均循环次数与 compute-active 参数为
$$\bar{K}_\rho = 2(1-\rho) + 4\rho, \qquad N_{c,K\rho} = (1-\rho)N_{c,2} + \rho N_{c,4}, \qquad C = 6 D_{K\rho} N_{c,K\rho} \tag{13}$$
两个 TPP 都用初始存储参数 $N_{s,2}$ 作分母($\mathrm{TPP}_{K\rho} = D_{K\rho}/N_{s,2}$,$\mathrm{TPP}_{K2} = D_{K2}/N_{s,2}$)。与花同样算力的固定 $K=2$ 基线比,$D_{K\rho}N_{c,K\rho} = D_{K2}N_{c,2}$,因此
$$\mathrm{TPP}_{K\rho} = \frac{E_2}{E_{K\rho}}\mathrm{TPP}_{K2}, \qquad \frac{E_{K\rho}}{E_2} = 1 + \rho\left(\frac{E_4}{E_2} - 1\right) \tag{14}$$
代入仿射律 (9):
$$\frac{E_{K\rho^\star}}{E_2} = \frac{\mathrm{TPP}_{K2}}{a\,\mathrm{TPP}_{K2} + b}, \qquad \rho^\star = \frac{E_{K\rho^\star}/E_2 - 1}{E_4/E_2 - 1} \tag{15}$$
当 $b \ll a\,\mathrm{TPP}_{K2}$ 时最优扩张趋于 $1/a$,这解释了 Figure 10 下排「先升后平台」的形状,也说明生长比例对 TPP 弱依赖。三段均分且块算力主导时 $E_4/E_2 \to 3/2$,得到极限处方 $\rho^\star \to 2(1/a - 1)$。(核对:$a = 0.902$ 给出 0.217,$a = 0.883$ 给出 0.265,与上文 Loop-Grow 0.23–0.24、Untied-Grow 0.26–0.32 的拟合值吻合。)
四阶段配方(Appendix A.4)
作者强调:指数差距只有在每个架构都调好时才有意义,否则「指数差异」可能只是「调参差异」——把 Vanilla 的配方直接搬给 Operator-1,d8 上损失差 $7.8\times10^{-3}$,并抹掉其沿阶梯的指数改进(Figure 16b)。四阶段依次为:d8 基础超参、每存储参数 token 数、生长时机(如适用)、学习率缩放规则。
Stage 1:d8 链式调参
在 d8、1B token 上一次扫一个超参,局部最优带入下一次扫描(类似 Wen et al. 2026),共两轮。
Table 3:链式调参网格(每轮 9 个 sweep,Vanilla 8 个;每个 sweep 8 个并行 run;数值型网格以当前最优为中心,第一轮按 2× 间隔、第二轮按 $\sqrt{2}$× 间隔;多个 HP 同时改善时下一轮叠加)
| 缩放族 | HP | 含义 | 初始值 |
|---|---|---|---|
| ×{1/16, 1/8, …, 8} | GLR | 全局学习率 | 0.04 |
| RM | residual multiplier | 0.5 | |
| OM | output multiplier | 1 | |
| $\alpha_{\text{emb}}$ | 注入权重 | 1 | |
| ×{1/8, 1/4, …, 16} | WTE init | embedding 初始化尺度 | 0.08 |
| UIS | 输入矩阵初始化尺度 | 0.25 | |
| ×{1, 2, …, 128} | ELRM | embedding 学习率乘子 | 0.02 |
| HLRM | head 学习率乘子 | 0.02 | |
| {0} ∪ ×{1/32, …, 2} | WD | weight decay | 0.1 |
| 离散 | Schedule | warmup {0,5,10,20};warmdown {.2,.6,.8,1} | 40;.4 |
| 离散 | Adam | $\beta_1$ {.9,.95};$\beta_2$ {.90,.98,.99};$\epsilon$ {1e-8, 1e-6} | (.8, .95);1e-10 |
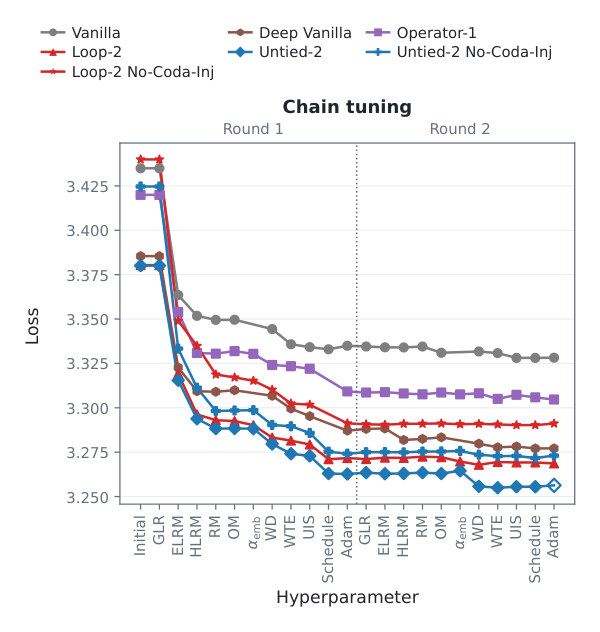
Table 5:各架构基础调参结果
| 架构 | GLR | ELRM | HLRM | RM | OM | $\alpha_{\text{emb}}$ | WD | WTE | UIS | WU | WDR | $\beta_1$ | $\beta_2$ | $\epsilon$ |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Vanilla | 0.04 | 0.453 | 0.113 | 0.25 | 0.5 | — | 0.071 | 0.007 | 0.063 | 40 | 0.6 | 0.8 | 0.95 | 1e-10 |
| Deep Vanilla | 0.04 | 0.16 | 0.057 | 0.5 | 1 | — | 0.1 | 0.005 | 0.5 | 5 | 0.8 | 0.8 | 0.99 | 1e-8 |
| Operator-1 | 0.04 | 0.905 | 0.08 | 0.5 | 1 | 1 | 0.05 | 0.113 | 0.354 | 0 | 0.8 | 0.8 | 0.98 | 1e-10 |
| Loop-2 | 0.04 | 0.32 | 0.113 | 0.25 | 1 | 0.707 | 0.05 | 0.02 | 0.044 | 40 | 1 | 0.8 | 0.95 | 1e-10 |
| Untied-2 | 0.04 | 0.16 | 0.16 | 0.25 | 1 | 1 | 0.071 | 0.01 | 0.354 | 40 | 1 | 0.8 | 0.99 | 1e-8 |
Table 4:边界算子消融(d8 基础尺寸,各自独立调参,1B token,宽度 1024、执行深度 11;runtime 为 8×H100 上的训练分钟数,不含评测与编译预热)
| 架构 | $\phi$(core 边界) | $\rho$(coda 前) | 调参后损失 | Runtime (min) |
|---|---|---|---|---|
| Deep Vanilla | $h$ | $h$ | 3.2772 | 6.49 |
| Loop-2 | BO$(h,e)$ | BO$(h,e)$ | 3.2704 | 6.54 |
| Loop-2-no-coda-inj | BO$(h,e)$ | Norm$(h)$ | 3.2912 | 6.45 |
| Untied-2 | BO$(h,e)$ | BO$(h,e)$ | 3.2563 | 6.54 |
| Untied-2-no-coda-inj | BO$(h,e)$ | Norm$(h)$ | 3.2731 | 6.53 |
| Deep Vanilla + norm | Norm$(h)$ | Norm$(h)$ | 3.2781 | 6.48 |
| Deep Vanilla + injection | $h + \alpha e$ | $h + \alpha e$ | 3.2690 | 6.52 |
结论分析:coda 前的注入是本文相对既有循环架构的新增,去掉它 Loop-2 损失 +0.021、Untied-2 +0.017,是这张表里最大的单项退化——幅度甚至超过「绑定 vs 解绑」(0.014)。单独归一化几乎无用(Deep Vanilla + norm 比 Deep Vanilla 还差 0.001),单独注入有小幅收益(−0.008),两者合起来(Untied-2)才达到最低损失,说明「归一化」与「注入」是互补而非叠加的。runtime 几乎相同(6.45–6.54 分钟),算子的硬件开销可以忽略。
Table 6:Vanilla 配方迁移探针(d8、1B token,各跑一次)
| 架构 | Vanilla 配方损失 | 相对 Vanilla ($10^{-3}$) | 自有配方损失 | 迁移遗憾 ($10^{-3}$) |
|---|---|---|---|---|
| Vanilla | 3.3275 | +0.0 | 3.3279 | −0.3 |
| Deep Vanilla | 3.2869 | −40.6 | 3.2772 | +9.8 |
| Operator-1 | 3.3135 | −14.1 | 3.3057 | +7.8 |
| Loop-2 | 3.2777 | −49.9 | 3.2704 | +7.2 |
| Untied-2 | 3.2697 | −57.9 | 3.2563 | +13.3 |
结论分析:迁移遗憾 7–13×$10^{-3}$。按自有配方计,Operator-1 相对 Vanilla 的优势是 3.3279 − 3.3057 = 22.2×$10^{-3}$,其中 7.8×$10^{-3}$(约 35%)会被「借来的配方」吃掉;Loop-2、Untied-2 的占比分别约 13%、19%。收益越小的干预(边界算子)越依赖逐架构调参,这恰好说明作者为什么坚持这样做。Vanilla 的 −0.3×$10^{-3}$ 低于采纳阈值,作者把它归为 run-to-run 噪声,这也是全文唯一一处关于训练噪声量级的直接证据。
Stage 2:拟合每存储参数 token 数(TPP)
在 5 个预算(按 d8–d12 在 TPP 7 下的训练成本命名)上,每个预算训练 anchor 附近 5 个尺寸、调 token 数保持算力,对 log loss 关于 log TPP 拟合二次曲线取顶点。
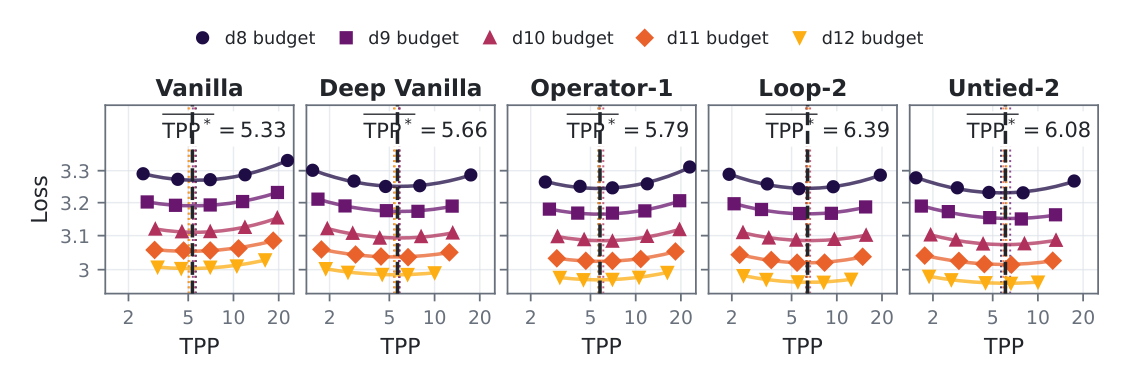
Table 7:各架构算力最优 TPP(scale-shift 检验拟合 $\log \mathrm{TPP}^\star = a + \beta \log C$,报告 $H_0: \beta = 0$ 的双侧 p 值)
| 架构 | 平均 TPP* | 取整 | p | $L^\star_{d8}$ | $L^\star_{d10}$ | $L^\star_{d12}$ |
|---|---|---|---|---|---|---|
| Vanilla | 5.33 | 5 | 0.087 | 3.270 | 3.110 | 3.003 |
| Deep Vanilla | 5.66 | 6 | 0.109 | 3.251 | 3.093 | 2.985 |
| Operator-1 | 5.79 | 6 | 0.923 | 3.244 | 3.085 | 2.971 |
| Loop-2 | 6.39 | 6 | 0.588 | 3.244 | 3.085 | 2.964 |
| Untied-2 | 6.08 | 6 | 0.760 | 3.230 | 3.073 | 2.961 |
结论分析:没有一个架构在 α=0.05 下拒绝「最优 TPP 与规模无关」,所以各取一个常数(生长变体后续重拟为 7–8)。循环/算子变体偏好略高的 TPP,作者读为参数效率更好。需注意 Vanilla 的 p=0.087 是五者中最接近拒绝的:若 Vanilla 的最优 TPP 真有轻微漂移而阶梯固定用 5,Vanilla 会在大规模处轻微偏离最优,这种偏离恰好表现为「multiplier 随规模上升」。不过 Figure 12 的曲线在顶点附近很平,这个效应量应该不大。
Stage 3:固定生长比例
推荐做法:复用 Stage 2 的 TPP 定参考预算,在 d8–d10 三个 anchor 上扫 $\rho$,二次拟合后三者平均并取一位小数。Deep Vanilla Grow 的平均最优 0.544 → 取 $\rho = 0.5$;Loop-Grow 与 Untied-Grow 的平均最优分别为 0.170、0.271(Figure 13)。但实际报告的 Untied-Grow / Loop-Grow 阶梯用的是逐尺寸拟合的 $\rho$ 与重拟的参考 TPP 8 / 7(Table 9),作者以 A.2.4 的敏感性消融说明两种做法差别很小。
Stage 4:学习率缩放规则
先在 d8–d12 上对 Vanilla 做一维扫描(Figure 14a):最优 GLR 从 d8–d10 的 0.04 降到 d11–d12 的 0.02,其余多数超参曲线很平。再对各家族在 d8–d10 上扫 GLR / OM / RM / WD(Figure 14b),对 log 最优值关于 log 存储参数回归得到漂移指数 $\beta$。GLR 敏感度最大,因此采用锚定学习率规则:
$$\mathrm{GLR}(N) = \mathrm{GLR}_{d8}\left(\frac{N}{N_{d8}}\right)^{\beta} \tag{16}$$
$N$ 为初始存储参数量,$\beta < 0$。生长变体的学习率扫描以对应固定循环规则为中心。
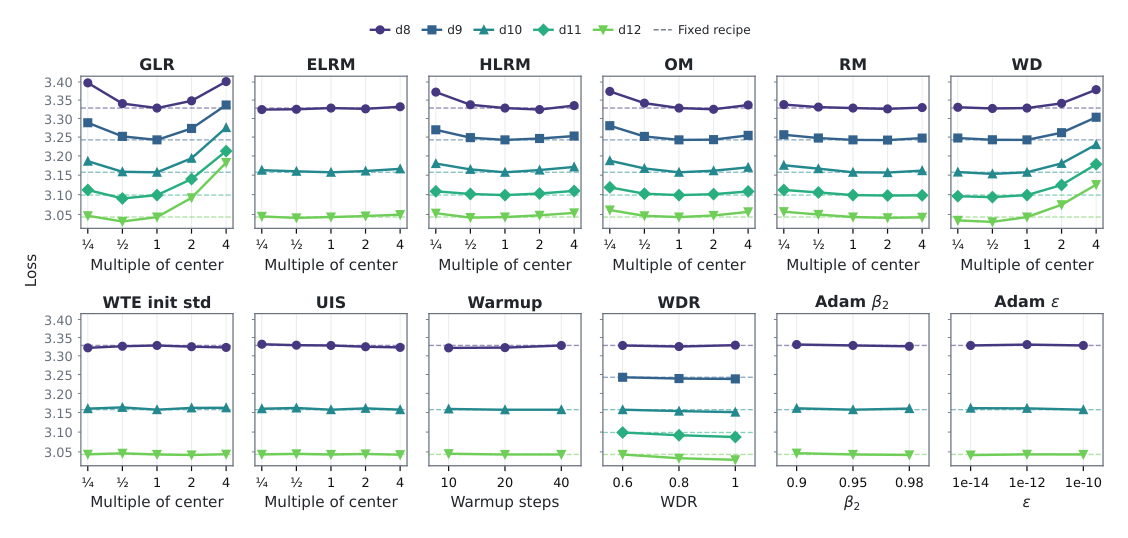
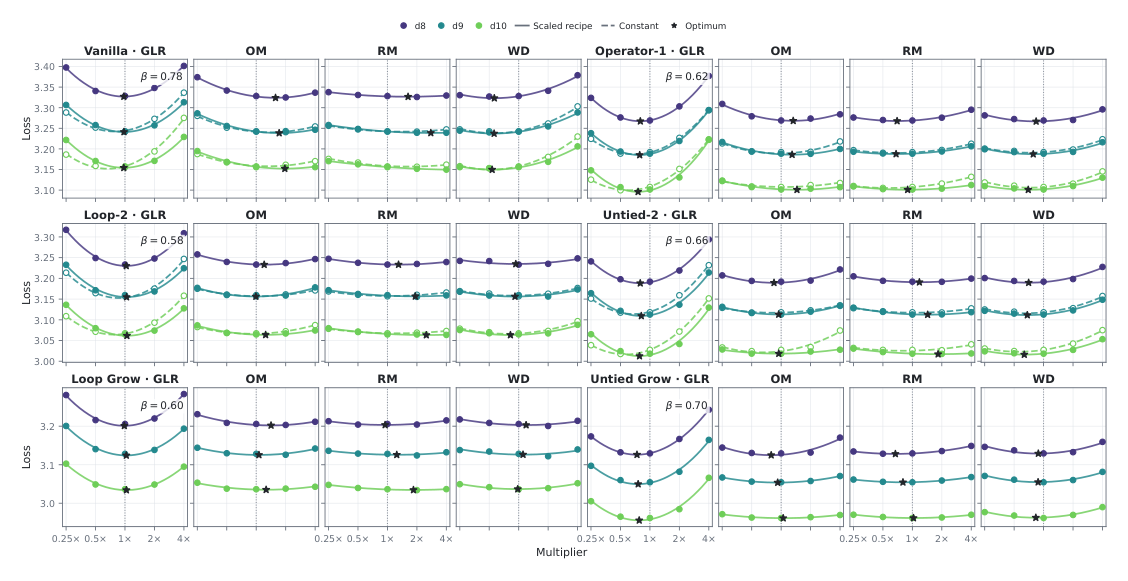
Table 8:超参漂移与敏感度($\beta$ 来自 d8–d10 二次切片最优值的回归,± 为一个回归标准误;粗体为 $|\beta| \ge 3$ 标准误;constant 配方下最优值 ∝ $N^\beta$;+GLR 配方的 GLR 列测的是相对已施加指数的残余漂移;regret 为 0.5× 与 2× 设定的平均损失减中心损失,range 为切片损失全跨度,单位均为 $10^{-3}$)
| 变体 | 配方 | GLR $\beta$ | GLR regret/range | OM $\beta$ | OM regret/range | RM $\beta$ | RM regret/range | WD $\beta$ | WD regret/range |
|---|---|---|---|---|---|---|---|---|---|
| Vanilla | constant | −0.78±0.06 | 18.7/150.0 | −0.37±0.10 | 3.5/17.6 | +0.06±0.37 | 2.3/15.2 | −0.17±0.11 | 9.4/94.0 |
| Vanilla | +GLR (β=−0.8) | −0.00±0.01 | 15.0/73.3 | +0.46±0.05 | 5.9/39.8 | +2.73±0.23 | 1.4/20.7 | −0.11±0.05 | 4.9/53.3 |
| Operator-1 | constant | −0.62±0.02 | 17.9/122.4 | −0.43±0.55 | 3.0/14.4 | −0.41±0.15 | 3.0/26.9 | −0.32±0.20 | 5.6/37.8 |
| Operator-1 | +GLR (β=−0.6) | −0.11±0.02 | 17.4/121.6 | +0.19±0.17 | 3.8/21.5 | +0.53±0.35 | 1.4/10.8 | −0.39±0.05 | 5.4/28.6 |
| Loop-2 | constant | −0.58±0.08 | 16.8/110.1 | −0.60±0.04 | 2.3/14.9 | −0.09±0.38 | 2.1/11.6 | −0.40±0.06 | 7.0/41.1 |
| Loop-2 | +GLR (β=−0.6) | +0.03±0.00 | 12.2/71.5 | +0.08±0.51 | 3.0/21.9 | +1.36±0.19 | 3.4/16.1 | −0.26±0.10 | 2.7/23.2 |
| Loop-Grow | +GLR (β=−0.6) | +0.10±0.05 | 12.2/66.3 | −0.23±0.55 | 1.4/16.9 | +1.40±0.12 | 0.4/13.6 | −0.41±0.06 | 3.9/15.5 |
| Untied-2 | constant | −0.66±0.02 | 17.3/134.1 | −0.53±0.26 | 1.9/49.7 | −0.73±0.11 | −0.4/14.2 | −0.43±0.02 | 6.2/50.4 |
| Untied-2 | +GLR (β=−0.7) | −0.04±0.07 | 14.8/111.2 | +0.20±0.13 | 2.7/10.1 | +0.84±0.01 | 1.7/12.8 | −0.20±0.03 | 5.1/35.0 |
| Untied-Grow | +GLR (β=−0.7) | +0.10±0.01 | 13.1/104.3 | +0.53±0.06 | 1.6/9.8 | +0.81±0.02 | 2.0/8.5 | −0.12±0.04 | 7.2/28.2 |
(原文粗体标记在文本提取中丢失,上表粗体按「$|\beta| \ge 3\sigma$」规则由本报告重新标注。)
结论分析:施加 GLR 规则后,Vanilla 的残余 GLR 漂移为 −0.00±0.01,已被很好校准;而 Operator-1 残余 −0.11(最优 LR 应比规则衰减得更快,即大尺寸处 LR 偏高),Untied-Grow 残余 +0.10(最优 LR 应衰减得更慢,即大尺寸处 LR 偏低)。也就是说,在 d8–d10 这个诊断区间内,残余失调是落在变体一侧而非 Vanilla 一侧——若学习率规则对谁有利,也是对 Vanilla 有利,这削弱了「指数改进来自 Vanilla 调参更差」的质疑。作者还检验了加入 OM 或 WD 缩放:相对只缩放 GLR,multiplier 变化至多约 3%(Figure 16a),于是只用 GLR 规则。注意表中 Untied-Grow 的诊断指数写作 β=−0.7,而实际阶梯(Table 9)用的是 −0.6,作者声明「诊断拟合与部署设置不同」。
Table 9:报告阶梯使用的配方(式 (16) 中除 Deep Vanilla Grow 的 d8 锚点为 0.036 外,$\mathrm{GLR}_{d8} = 0.04$;生长变体 $t_{\text{ref}} = T_0/N_{\text{ref}}$ 设定生长前的算力预算,选定转换点后重算 token 数;其余超参保持基础调参值)
| 架构 | GLR 指数 $\beta$ | Token 分配 | 训练尺寸 |
|---|---|---|---|
| Vanilla | −0.8 | TPP 5 | d6–d20,偶数 |
| Deep Vanilla | −0.7 | TPP 6 | d6–d18,偶数 |
| Operator-1 | −0.6 | TPP 6 | d6–d20,偶数 |
| Loop-2 | −0.6 | TPP 6 | d6–d18,偶数 |
| Untied-2 | −0.6 | TPP 6 | d6–d18,偶数 |
| Deep Vanilla Grow | −0.8 | $t_{\text{ref}} = 6$($\rho = 0.5$) | d6–d18,偶数 |
| Untied Grow | −0.6 | $t_{\text{ref}} = 8$ | d6–d18,偶数 |
| Loop Grow | −0.5 | $t_{\text{ref}} = 7$ | d6–d18,偶数 |
阶梯规模:Vanilla 120M–1.8B 存储参数(8 个点),循环/生长变体 7 个点。因为循环变体每 token 执行更多块、TPP 也更高,所有阶梯覆盖相近的算力范围,最大尺寸都止于约 $10^{20}$ FLOPs。比较一律在等算力下进行。
实验设置
- 预训练数据:FineWeb(主实验),FineWeb-Edu(迁移复现 + 7.4B 外推),GPT-2 tokenizer;
- 单 epoch 实验:各架构按 Table 9 训练算力最优阶梯,约 $3\times10^{17}$ 到 $1.5\times10^{20}$ FLOPs,multiplier 在 7 个 Vanilla 预算($10^{18}$–$10^{20}$)上插值;
- 外推:Untied-Grow d26(7.4B,起始 5B,生长到 7.4B),$1.23\times10^{21}$ FLOPs,两节点 16×H100,不参与任何拟合;
- 多 epoch 实验:固定 100M unique FineWeb token 训 10 epoch(共 1B token),Operator-1 家族,除 weight decay 外超参固定为调参值;网格为 Operator-1 到 Loop-12 × 120M–1.4B 参数,并在同一网格上扫 weight decay;附录另有 fresh 1B、250M×4 epoch 对照;
- 验证指标:FineWeb(或 FineWeb-Edu)验证损失;
- 下游指标:22 任务 DCLM CORE(按 nanochat 实现,每个 checkpoint 评测全部 91,037 个样本),full CORE accuracy 与 answer NLL 为主指标,17 任务过滤子集为辅助指标。
Full CORE accuracy:多选与 shared-ending 任务选平均 token loss 最低的候选;语言建模任务要求所有参考 token 都预测正确。第 $j$ 个任务原始准确率 $a_j$、随机猜测准确率 $b_j$,做 chance-centering 后等权平均:
$$c_j = \frac{a_j - b_j}{1 - b_j}, \qquad \mathrm{CORE}_{22} = \frac{1}{22}\sum_{j=1}^{22} c_j \tag{17}$$
0 表示随机水平,1 表示满分,负值表示低于随机。
Answer NLL:衡量模型给正确参考答案的概率,即使两个模型选了同一选项也能连续比较。对任务 $j$ 的样本 $i$,提示 $x_{ij}$、答案 token $y_{ij1:T_{ij}}$:
$$\ell^{\text{ans}}_{ij} = -\frac{1}{T_{ij}}\sum_{t=1}^{T_{ij}} \log p\big(y_{ijt} \mid x_{ij}, y_{ij,<t}\big), \qquad \mathrm{NLL}^{\text{ans}}_{22} = \frac{1}{22}\sum_{j=1}^{22}\left(\frac{1}{n_j}\sum_{i=1}^{n_j}\ell^{\text{ans}}_{ij}\right) \tag{18}$$
排除提示 token;按 token 平均以免长答案仅因长度获得更大损失;先任务内平均再任务间等权平均。图中简记为 CORE NLL。
冻结的 Vanilla-only 过滤:只用 8 个最终 GLR 的 Vanilla checkpoint 选任务——最大 token 量 checkpoint 的原始准确率至少高于随机 2 个百分点,且训练量与准确率的 Kendall $\tau_b \ge 0.50$。选出 17 个任务,跨架构、配方、语料固定,属事后敏感性分析。评测种子 0/1/2 只改变 few-shot 示例,不改变评测样本;训练种子没有重复。
Table 10:DCLM CORE 任务与过滤结果(MC=多选,SE=shared ending,LM=语言建模;「保留」为进入 17 任务子集)
| 任务 | 类型 | 过滤结果 |
|---|---|---|
| HellaSwag (zero-shot) / ARC-Easy / ARC-Challenge / COPA / PIQA / OpenBookQA / HellaSwag (10-shot) / AGI Eval LSAT-AR | MC | 保留 |
| CommonsenseQA | MC | 剔除:Kendall $\tau$ = 0.000 |
| BoolQ | MC | 剔除:低于随机 −4.62pp;Kendall $\tau$ = 0.286 |
| BIG-bench Language Identification | MC | 剔除:Kendall $\tau$ = 0.143 |
| Winograd / WinoGrande | SE | 保留 |
| Jeopardy / BIG-bench QA Wikidata / LAMBADA OpenAI / BIG-bench Dyck Languages / BIG-bench Operators / SQuAD / CoQA | LM | 保留 |
| BIG-bench CS Algorithms | LM | 剔除:Kendall $\tau$ = 0.500(未取整值略低于 0.50) |
| BIG-bench Repeat Copy Logic | LM | 剔除:恰为随机 +0.00pp;Kendall $\tau$ = 0.423 |
主要实验结果
单 epoch:生长与边界算子改进指数,解绑只改常数
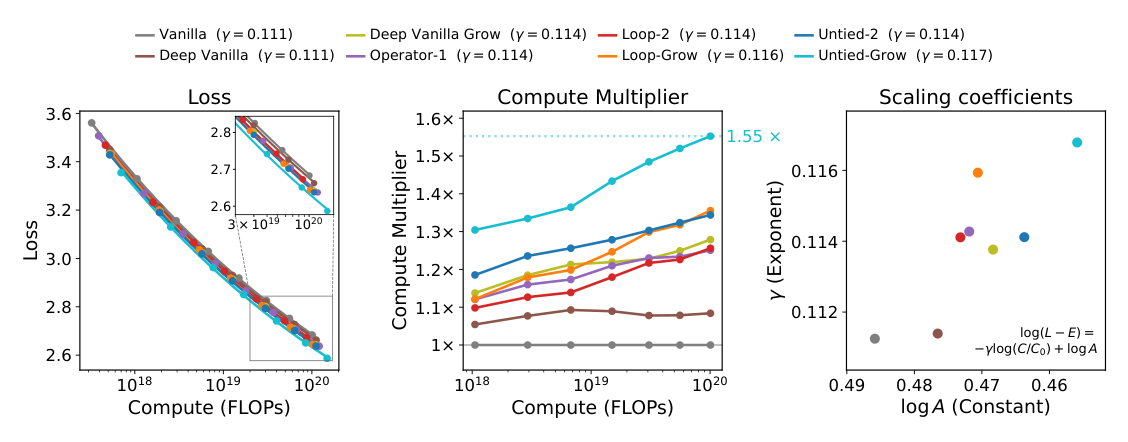
作者报告每条 log–log 斜率的回归标准误均低于 $10^{-3}$。汇总如下(指数取图例;更精确的值取自 Figure 15/16 图例;multiplier 标「约」者为本报告从 Figure 3 中栏读图所得):
| 架构 | $\gamma$ | 相对 Vanilla 的 $\Delta\gamma$ | multiplier @ $10^{18}$ | multiplier @ $10^{20}$ | 曲线形态 |
|---|---|---|---|---|---|
| Vanilla | 0.111(0.1112) | — | 1.00× | 1.00× | 基线 |
| Deep Vanilla | 0.111(0.1114) | +0.000 | 约 1.05× | 约 1.08× | 平坦(常数) |
| Deep Vanilla Grow | 0.114 | +0.003 | 约 1.14× | 约 1.28× | 上升 |
| Operator-1 | 0.114(0.1143) | +0.003 | 1.12× | 1.25× | 上升 |
| Loop-2 | 0.114(0.1141) | +0.003 | 约 1.10× | 约 1.26× | 上升 |
| Untied-2 | 0.114(0.1141) | +0.003 | 1.19× | 1.34× | 上升 |
| Loop-Grow | 0.116(0.1159) | +0.005 | 约 1.12× | 1.36× | 上升 |
| Untied-Grow | 0.117(0.1168) | +0.006 | 1.30× | 1.55× | 最快上升 |
逐条结论:
- 边界算子改进指数。Operator-1 与 Vanilla 参数量、FLOPs 完全相同,唯一差别是算子;其 multiplier 从 $10^{18}$ 的 1.12× 升到 $10^{20}$ 的 1.25×。从 Deep Vanilla 到 Untied-2(唯一差别同样是算子)也成立。作者假设:算子「救回」的块占比随深度增大,而算力最优模型随算力变深(Section 6)。
- 生长改进指数。Untied-Grow 与 Untied-2 的唯一差别是训练中途把 core pass 翻倍;前者 multiplier 从 1.30× 升到 1.55×,后者从 1.19× 升到 1.34×,于是生长相对 Untied-2 的 multiplier 从 1.09× 升到 1.16×。生长不依赖算子:Deep Vanilla Grow 相对 Deep Vanilla 在常数与指数上的平移,与 Untied-Grow 相对 Untied-2 的平移大致相同,两种改进相加而非一个使能另一个。绑定的 Loop-Grow 相对 Loop-2 在指数与常数上的增益略小。
- 解绑只改常数。Untied-2 相对 Loop-2 在 $10^{18}$ 为 1.08×、$10^{20}$ 为 1.06×;Untied-Grow 相对 Loop-Grow 为 1.16× 与 1.14×——权重共享在每个规模上都只花一个固定倍数的算力,不随预算增长。因此「绑定 + 生长」能以 Vanilla 的参数量保留生长的指数改进,只落后解绑生长一个常数。
- 更深的形状只改常数。Deep Vanilla 与 Untied-2 执行同样的块但没有算子,相对 Vanilla 稳定在约 1.08×,作者读为 Vanilla 的 128 宽深比偏宽(Kaplan et al. 2020 认为宽深比不影响常数,本文结果与之相反);但继续降低宽深比不再带来常数改进(Figure 16c)。
结论分析:这张图的说服力主要来自中栏的 multiplier 曲线而非右栏的 $\gamma$ 数值——multiplier 是逐点插值的直接观测,不依赖对 $E$ 的假设,Untied-Grow 七个点几乎单调上升、Deep Vanilla 七个点在 1.05–1.09 之间横走,两种形态在视觉上可区分。但 $\gamma$ 的差异本身很小(+0.003 到 +0.006),且是在共享 Vanilla 拟合的 $E$ 下得到的;这一点留到「讨论与局限性」详细复核。
外推:7.4B Untied-Grow 与 GPT-3 13B
指数拟合区间为 $10^{18}$–$10^{20}$ FLOPs。作者在 FineWeb-Edu 上用同一配方重跑 Vanilla 与 Untied-Grow 阶梯,基于 Llama 3 的下游标度律方法建立下游预测管线(见下文),把目标定为 Karpathy 估计的 GPT-3 13B 下游能力。预测显示 Untied-Grow d26(7.4B,起始 5B)用算力最优配方即可达到该目标,于是在最大拟合算力的约 8 倍(原文口径;$1.23\times10^{21}$ 对 $\sim1.5\times10^{20}$)处训练了这个 run。
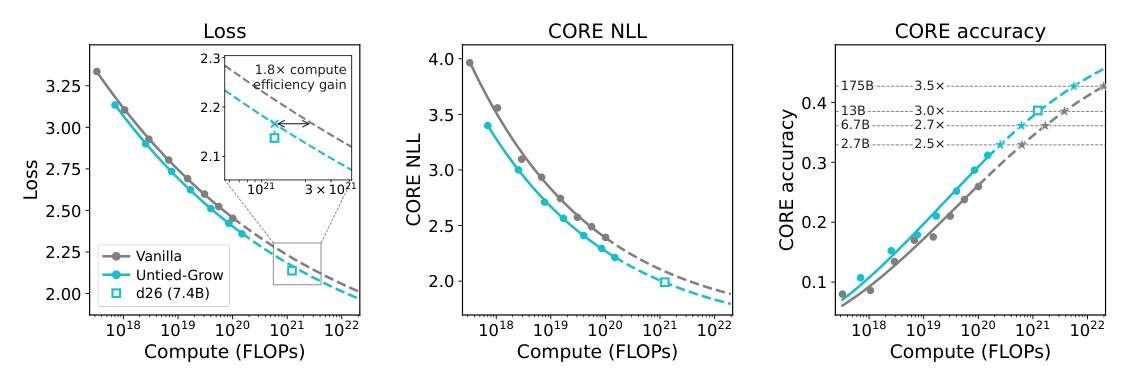
| 指标 | 预测 | 实测 d26 (7.4B) | 偏差 |
|---|---|---|---|
| FineWeb-Edu 验证损失 | 拟合曲线 | 低于预测 0.03 | −0.03 |
| CORE answer NLL | 拟合曲线 | 与预测相差 0.002 以内 | ≤0.002 |
| CORE accuracy | 0.3837 | 0.3865 ± 0.0015(评测种子标准差) | +0.0028 |
| 对比 | CORE | 训练算力 (FLOPs) |
|---|---|---|
| GPT-3 13B(Karpathy 估计) | 0.3852 | $2.31\times10^{22}$ |
| Untied-Grow d26 (7.4B) | 0.3865 | $1.23\times10^{21}$(约 1/19) |
Figure 4 右栏:在 GPT-3 各尺寸 CORE 水平线上,Vanilla 与 Untied-Grow 拟合曲线的交叉点算力比随目标升高而增大——2.7B 水平 2.5×、6.7B 水平 2.7×、13B 水平 3.0×、175B 水平 3.5×。作者据此称「指数改进延续到下游」。基于共享不可约损失的 FineWeb-Edu 拟合律,loss-matched multiplier 在 $10^{20}$ 为 1.6×、在 $1.23\times10^{21}$ 为 1.8×、在 $10^{25}$ 为 2.7×。
原文的自我限定(值得原样保留):「两个模型在不同数据上训练,GPT-3 的参考值是来自另一套评测管线的估计,因此约 20× 的差距是指示性的,而非受控比较。」 同时 C.4 说明 d26 的误差条只是评测种子标准差,不是外推本身的不确定性;GPT-3 交叉点的算力比「假设小规模关系延续到测量阶梯之外」。
结论分析:外推 run 本身是全文最有价值的单点证据——它不参与拟合,却在 12 倍左右的算力外落在(略低于)预测上,NLL 与 CORE 都命中。但它验证的是「Untied-Grow 自身的拟合律可外推」,并没有一个同算力的 Vanilla d26 对照;1.8× 这个数字里 Vanilla 那一侧同样是外推值。另外损失偏差 −0.03 的量级与两条外推曲线在该算力处的间距相当(本报告从 Figure 4 左栏插图读图估计,间距约 0.03–0.04),所以它能说明「收益没有在更大规模消失」,却不足以精确检验 $\Delta\gamma$ 的大小。按拟合律自行核对:$\Delta\gamma/\gamma \approx 0.0051/0.1146 \approx 0.045$,multiplier 每十倍算力约乘 $10^{0.045} \approx 1.11$,从 $10^{20}$ 的 1.6× 出发,$1.23\times10^{21}$ 得 1.79×、$10^{25}$ 得 1.6×$1.11^5$ ≈ 2.7×——数字与原文一致,但 $10^{25}$ 那一点是从两个数量级的拟合外推五个数量级。
FineWeb → FineWeb-Edu 迁移
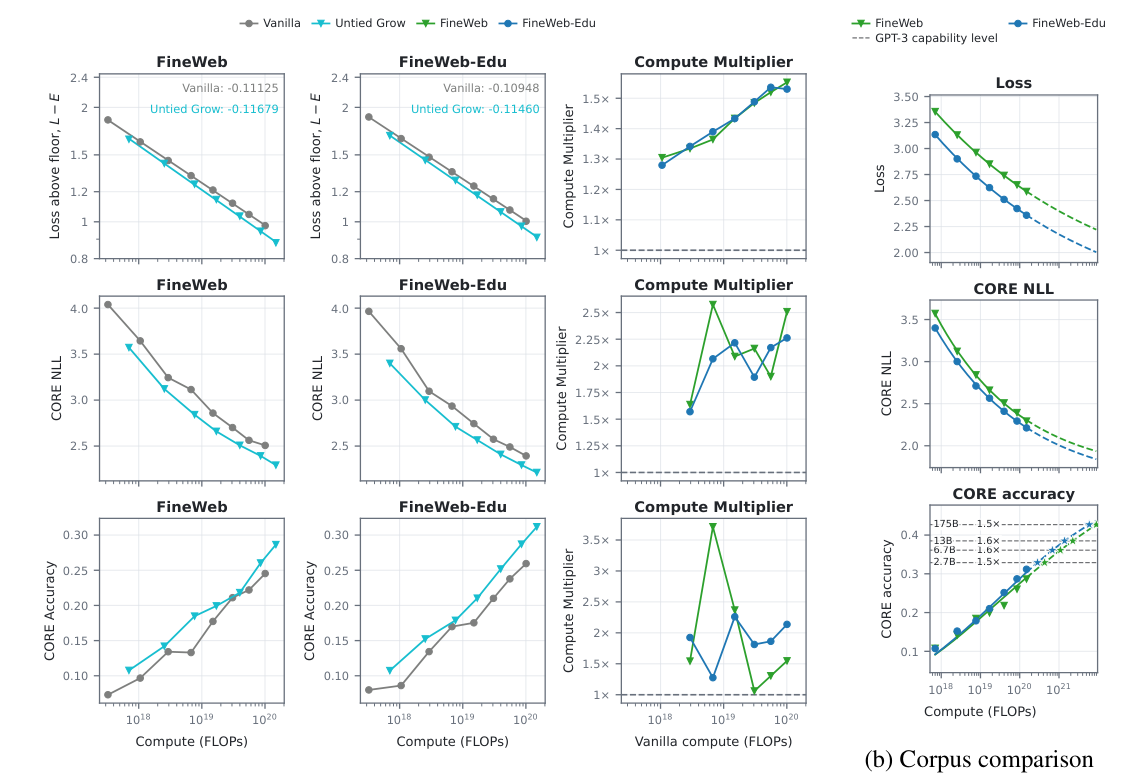
- 两个语料上 Untied-Grow 的 loss-matched multiplier 都随规模上升,拟合指数的超出量相近:FineWeb 0.1168 vs 0.1113(精确值 0.11679 vs 0.11125),FineWeb-Edu 0.1146 vs 0.1095(0.11460 vs 0.10948),各语料使用各自 Vanilla 拟合的 $E$;
- Figure 18a 的 loss multiplier 两条曲线几乎重合(FineWeb 约 1.30→1.55,FineWeb-Edu 约 1.28→1.53,读图);CORE NLL 与 CORE accuracy 的 multiplier 则剧烈波动(CORE accuracy 在 FineWeb 上从约 1.05× 到 3.7× 来回跳,读图),作者承认基于准确率的 multiplier 比基于损失的波动大得多;
- 对 Untied-Grow 自身,FineWeb-Edu 在同训练算力下下游更好:拟合 CORE 曲线投影 FineWeb 需约 1.5–1.6× 算力才能达到各 GPT-3 参考分数(外推比较,d26 不参与)。
结论分析:FineWeb-Edu 阶梯实际上是一次「换语料的独立重训」,其 loss multiplier 曲线与 FineWeb 版本高度重合,这是全文对「单种子噪声」质疑最有力的回应——两条阶梯的训练噪声彼此独立,却给出几乎相同的 multiplier 轨迹。但它共享同一套配方,因此不能回应「指数差来自配方选择」的质疑。另一方面,语料切换本身贡献了约 1.5–1.6× 的下游算力倍数,这个量级已经接近架构在 $10^{20}$ 处的 loss multiplier,是后面拆解「20× 对 GPT-3」时的重要一项。
下游:58 个 checkpoint、8 种架构
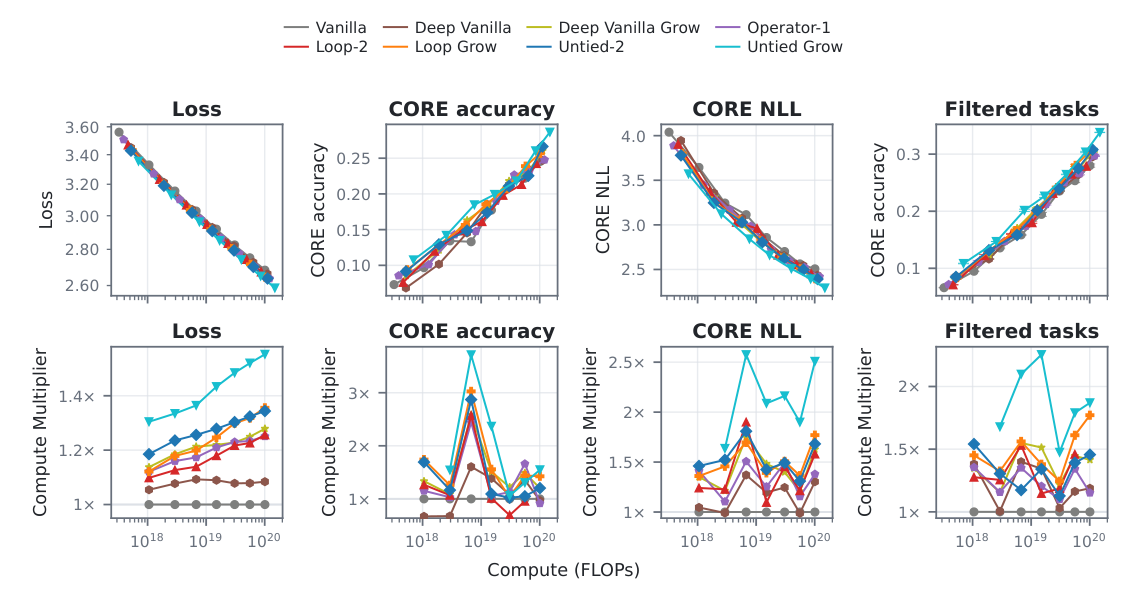
- 58 个 checkpoint 上,循环与生长变体普遍改善下游算力效率,在 answer NLL 与过滤后的 CORE accuracy 上尤为明显;full CORE accuracy 跨 checkpoint 不平滑,对应的 multiplier 波动大;
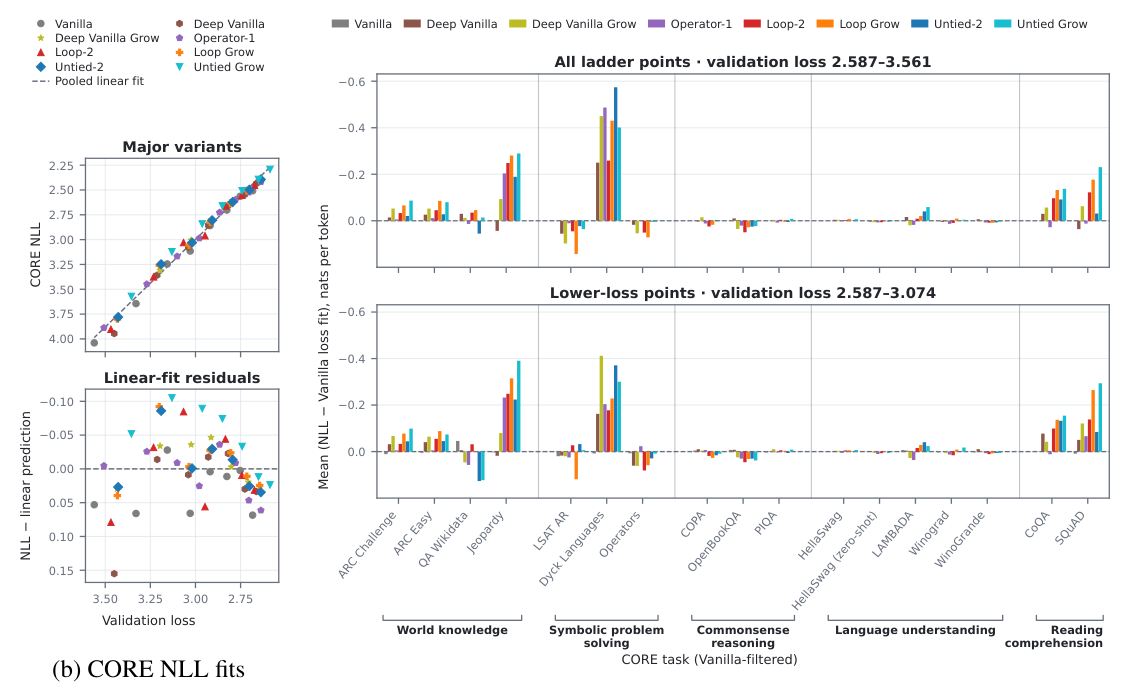
- 大部分下游改进跟随预训练损失,但仍有架构相关残差:用一条跨全部架构的线性拟合(CORE NLL vs 验证损失),Untied-Grow 的 CORE NLL 普遍低于拟合预测;
- 以每个任务单独的 Vanilla-only 线性参考看任务分解:增益不均匀,Dyck Languages(符号问题求解,残差约 −0.25 到 −0.57 nats/token,读图)与若干阅读理解任务(CoQA、SQuAD) 最突出;常识推理与语言理解类任务几乎为零。作者提醒这些残差依赖线性参考,且部分 checkpoint 在 Vanilla 的测量损失范围之外。
结论分析:Dyck Languages(括号匹配)是典型需要多步组合/栈式计算的任务,增益集中在这里与「计算深度」叙事一致;但残差图同样显示 Operator-1 在 Dyck 上的残差与生长变体同量级,而它的计算深度提升很小(见 Figure 6),所以这个下游证据支持「算子/深度有助于符号任务」,却不足以区分算子与生长各自的机制。
下游预测管线(Appendix C.4)
为预测达到目标 CORE 所需算力,作者按任务拟合三段管线(验证损失与汇总 CORE NLL 都不作为中间量):
- 算力 → 任务 NLL:对序列 $a$(架构或语料)与 17 个选中任务 $t$,用 Huber loss 拟合
$$B_{a,t}(C) = E_{a,t} + A_{a,t}\left(\frac{C}{10^{18}}\right)^{-\alpha_{a,t}} \tag{19}$$
- 任务 NLL → 准确率:每个任务一条 sigmoid,在被比较的序列间共享,目标为中心化准确率:
$$\hat{c}_t(B) = \big[1 + \exp(s_t B - b_t)\big]^{-1} \tag{20}$$
- 汇总:17 个预测任务分数平均,再乘一个共享的无截距系数 $r$ 还原 full CORE:
$$\widehat{\mathrm{CORE}}_{22,a}(C) = \frac{r}{17}\sum_t \hat{c}_t\big(B_{a,t}(C)\big) \tag{21}$$
FineWeb-Edu 架构比较的校准池为 8 个 Vanilla + 7 个 Untied-Grow checkpoint,$r = 0.86912$;语料比较用 7 + 7 个 Untied-Grow checkpoint,$r = 0.87104$。d26 被排除在所有拟合之外。
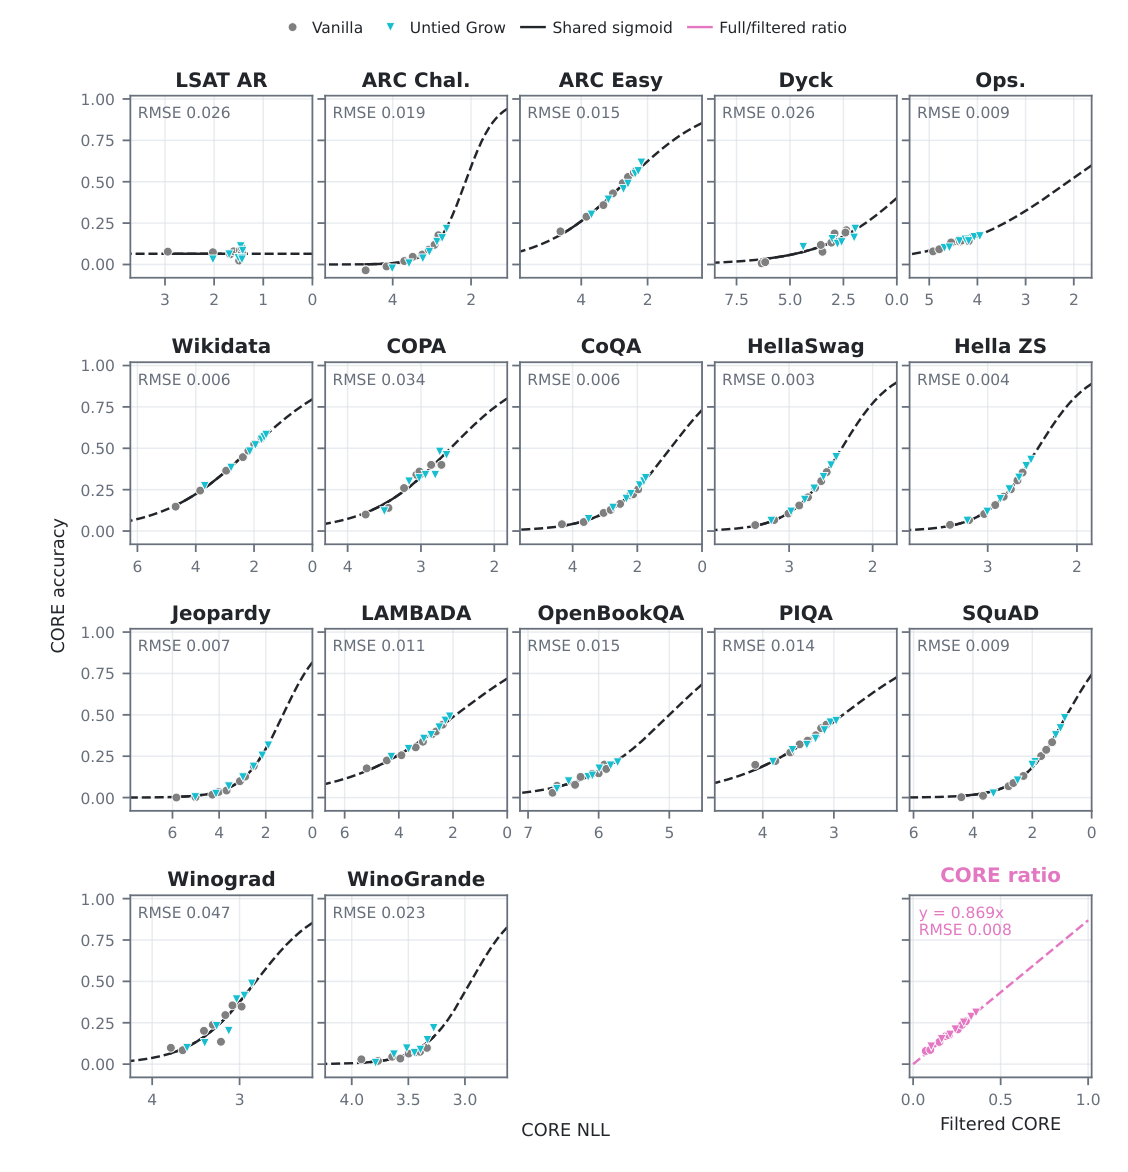
各任务 sigmoid 的 RMSE 在 0.003(HellaSwag)到 0.047(Winograd)之间;过滤分数到 full CORE 的换算 RMSE 0.008。范围说明(C.5):阶梯使用固定 batch size 与相同硬件,配方不涉及 batch size 与模型规模的联合优化。
多 epoch:最优循环次数随算力增长
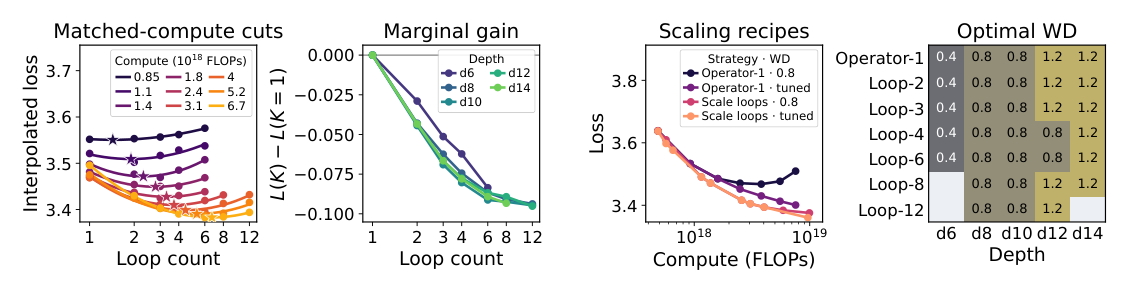
Section 4 表明在新鲜数据上,权重共享不是算力最优的,跨规模增加循环次数也不是。本节换到数据受限区间:100M unique token × 10 epoch,Operator-1 到 Loop-12、120M–1.4B 参数,同时扫 weight decay。
| 观察 | 数据 |
|---|---|
| 匹配算力下的最优循环次数 | 从最小预算约 1.4 升到最大预算约 6.7(正文口径「约 1 到约 7」) |
| 与 Operator-1 的损失差距 | 从 0.00 扩大到 0.11 |
| 固定循环次数的曲线 | 最终都过拟合并上翘,但循环越多、拐点越晚、最低点越低(Figure 2 右上) |
| 边际收益 $L(K) - L(K{=}1)$ | 每条曲线单调下降;d8 及以上各深度曲线在每个循环次数处相差不超过 0.006 |
| 扩尺寸 vs 扩循环 | 固定 WD 扩尺寸会过拟合;逐尺寸重调 WD 在 $7.5\times10^{18}$ FLOPs 只到 3.40;固定尺寸、固定 WD 扩循环次数以 1/2.2 的算力达到同一损失 |
| 在扩循环之上再调 WD | 至多再降 0.02 |
| 最优 WD 热图 | d6 为 0.4,d8–d10 为 0.8,d12 起为 1.2(Loop-4/6 在 d12 为 0.8);随深度上升,几乎不随循环次数变化 |
作者的解释:模型用它存储的参数过拟合,而不是用它执行的块过拟合。小预算下模型受算力限制,新参数优于复用参数(与新鲜数据相同);一旦存储参数开始过拟合语料,循环就成为更好的加容量方式,最优循环次数于是随算力增长。Figure 5 后两栏直接支持这一点:循环的边际收益与存储参数无关,最优 WD 跟随存储参数而非执行深度。解绑对照(同样加深度但加参数)打不过 Operator-1(Figure 24),说明在重复数据下起作用的是权重共享而非深度。
计算深度的测量
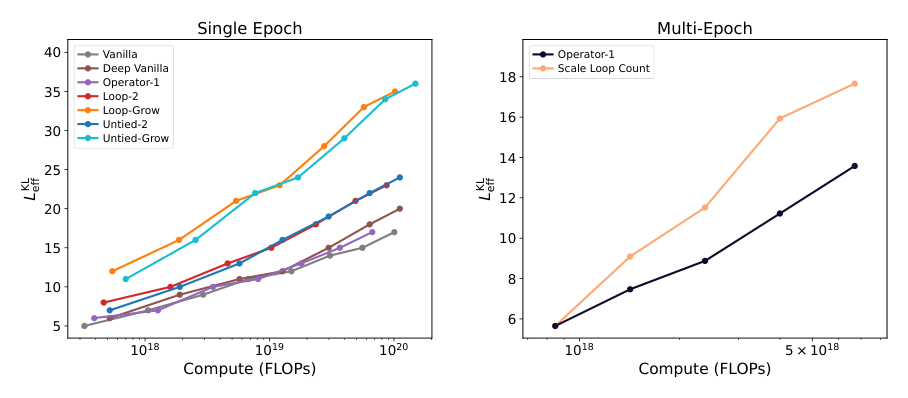
KL effective depth 的定义:用 logit lens 解码每个块之后的残差流,记录「KL 峰值之后第一个与最终输出分布 KL 距离进入 2 nats 以内的块」。作者承认这只是计算深度的代理——进入阈值不代表后续块不再改变预测,中间未被使用的块也检测不到。
| 模型对($10^{20}$ FLOPs) | KL effective depth |
|---|---|
| Deep Vanilla vs Untied-2(执行相同块,差别只在算子) | 20 vs 24 |
| Untied-2 vs Untied-Grow(差别只在生长) | 24 vs 36 |
| 多 epoch 最大预算:K=1 扩深度(调 WD) vs 扩循环次数 | 14 vs 18(读图约 13.6 vs 17.7) |
- 曲线按深度倍数分组:单 pass 模型最低,两 pass 居中,生长模型最高,在 $10^{20}$ 约为 Vanilla 的两倍;组内绑定与解绑曲线重合,权重共享不改变 KL 有效深度;
- Operator-1 基本落在 Vanilla 曲线上,算子在浅层作用很小,随模型变深差距扩大,符合假设;
- 另一条证据来自只扩宽度:固定执行深度 11、只扩宽度时,Untied-2 相对 Deep Vanilla 的改进从指数变为常数(Figure 16e),说明算子的指数改进需要深度扩展;
- 生长的三条佐证:转换时机有内点最优(太早太晚都亏损);生长模型偏好更小的起始模型训更多 token(最优 TPP 从 6 升到 7–8);Untied-Grow 的 KL 有效深度 36 对 Untied-2 的 24。
消融与分析
边界算子的组件、块分配与运行时间
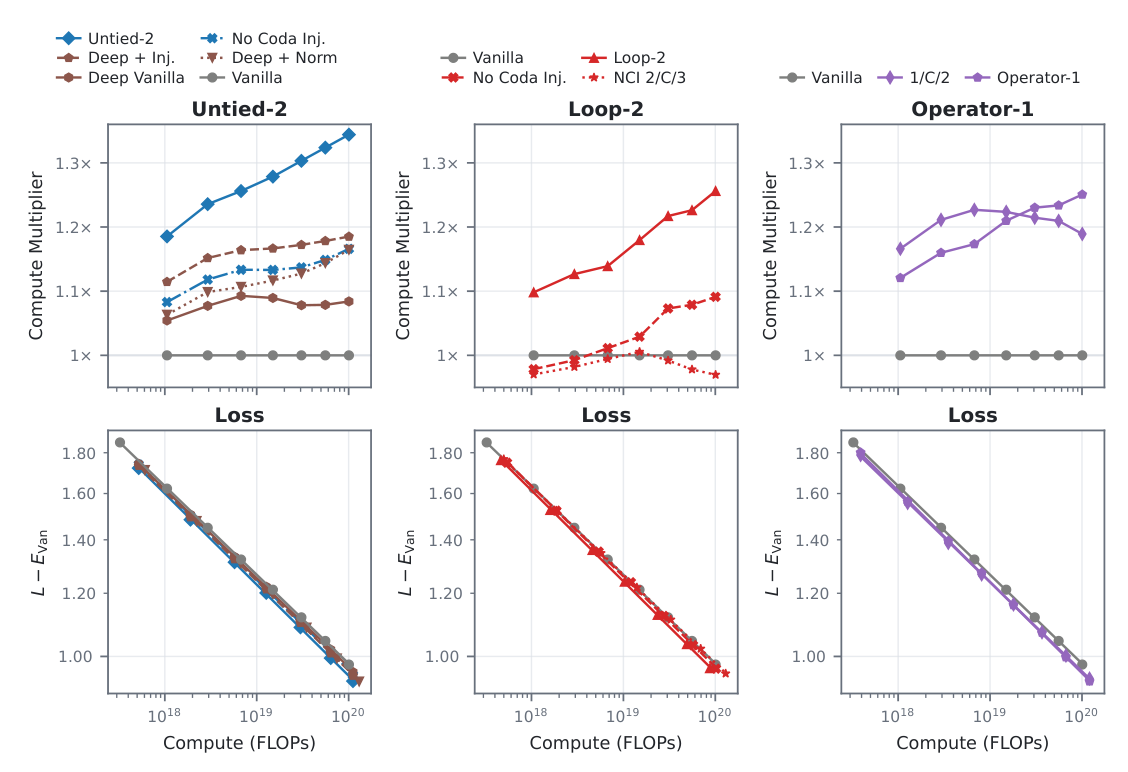
- 完整算子保留最大收益:$10^{20}$ 附近 Untied-2 约 1.34×;只用归一化、只用注入、或去掉 coda 注入,multiplier 降到约 1.17–1.19×;Deep Vanilla 维持约 1.08×。额外执行深度本身不能恢复全部收益。
- 块分配随规模变得重要:Loop-2 去掉 coda 注入后收益下降(约 1.09×);固定 prelude/coda 为 2/3 块只扩 core(NCI 2/C/3)更糟,最大预算处 multiplier 跌破 1。Operator-1 用固定的 1/C/2 分配时,早期优势在中段达到峰值后下降(约 1.23× → 1.19×,读图),而按比例分配持续改善。这些对照支持三段一起扩。
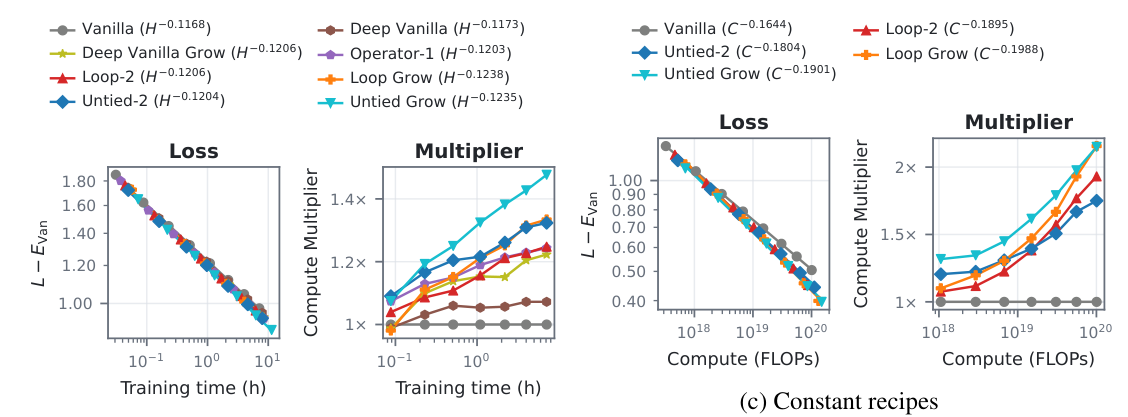
- 收益在训练时间上保留:把 FLOPs 换成记录的优化墙钟时间(不含评测与 checkpoint 开销),生长变体在匹配损失处的时间节省仍随规模增大,Untied-Grow 最大(最高约 1.48×,读图);时间轴拟合指数 Vanilla 0.1168、Deep Vanilla 0.1173、Operator-1 0.1203、Loop-2 0.1206、Untied-2 0.1204、Deep Vanilla Grow 0.1206、Loop Grow 0.1238、Untied Grow 0.1235。
配方调优改变表观收益
- 常数配方偏向循环/生长模型(Figure 15c):所有架构都用 d8 基础配方不缩放 LR 时,Vanilla 指数 0.1644,Untied-2 0.1804,Loop-2 0.1895,Untied Grow 0.1901,Loop Grow 0.1988;$10^{20}$ 处 multiplier 高达约 1.75–2.15×(读图)。这与 Table 8 中 $\beta$ 的大小顺序一致(Vanilla 最负,Loop-2 最不负),常数配方下 Vanilla 在大尺寸处学习率过高最严重。作者据此强调超参最优性对 scaling 的重要性(Qiu et al. 2026;Mlodozeniec et al. 2026)。
- Vanilla 超参缩放(Figure 16a,multiplier 相对 constant + GLR):常数配方指数 0.0974、muP OM 0.0977、muP OM + GLR 0.1085、GLR 0.1106、WDR1 + GLR 0.1106、GLR + WD 0.1110、GLR + OM 0.1115。加 OM 或 WD 缩放相对只缩 GLR 至多改变约 3%,而只做 muP OM 不缩 GLR 随规模丢失效率。
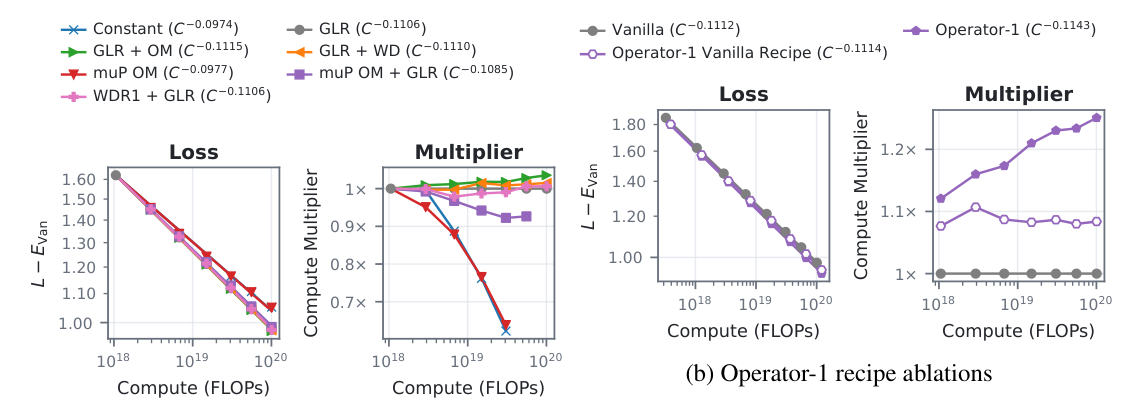
- 调参必须逐架构(Figure 16b):Operator-1 改用 Vanilla 的基础调参超参后,指数从 0.1143 降到 0.1114(Vanilla 0.1112),multiplier 从「1.12→1.25 上升」变成平坦的约 1.08×——指数改进变成常数改进。迁移基线配方会把一个架构的 scaling 改进藏起来,即使它在每个单独预算上仍然更好。
形状与扩展方向
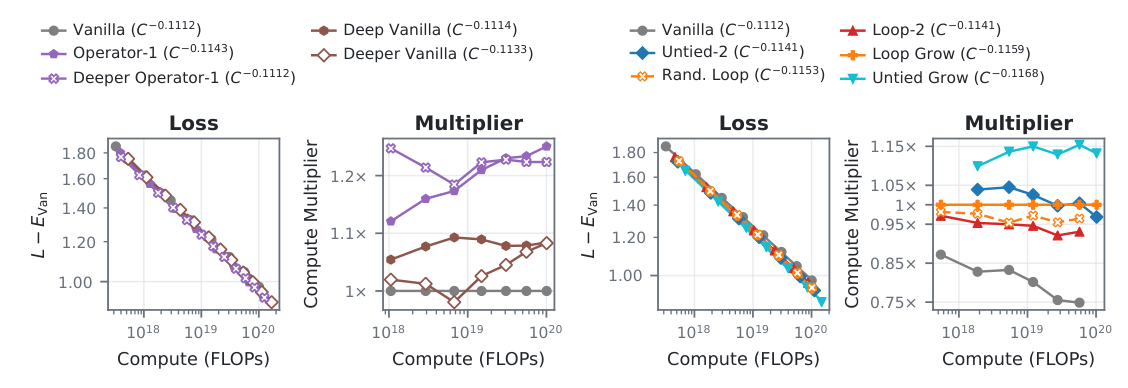
- 更深的形状不一致地改进效率(Figure 16c):Deep Vanilla 相对 Vanilla 有小幅常数改进,但更深的 1:64 宽深比阶梯(Deeper 系列)并不一致地优于对应默认形状;Deeper Operator-1 的指数回落到 0.1112,失去了 Operator-1 相对 Vanilla 的递增优势(multiplier 从约 1.25× 起、先降后回到约 1.22×,读图);Deeper Vanilla 指数 0.1133、multiplier 从约 1.02× 升到 1.08×。
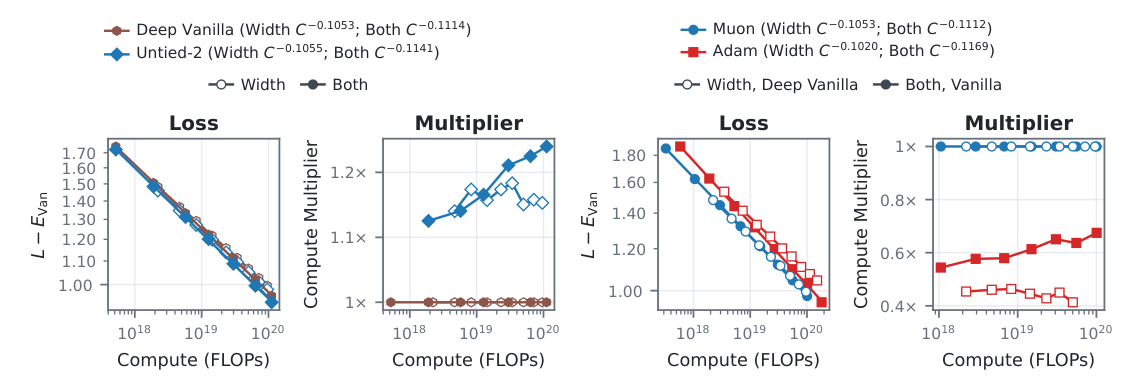
- 只扩宽度 vs 宽深同扩(Figure 16e):执行深度固定 11 时,Untied-2 仍比 Deep Vanilla 高效,但只剩更好的常数(宽度扩展指数 0.1055 vs 0.1053;宽深同扩 0.1141 vs 0.1114)。作者据此认为算子随深度增加才更有用,支持「指数改进来自计算深度增加」的假设。
随机循环与测试时 pass
- 随机循环:匹配 Loop Grow 配方,但生长后每个优化步从 $\{2,3,4,5,6\}$ 均匀采样 $K$(平均 4),算力按实际循环次数计,评测用 $K=4$。匹配算力下略差于固定 Loop Grow(指数 0.1153 vs 0.1159;Figure 16d 中随机循环相对 Loop Grow 约 0.95–0.98×,读图)。
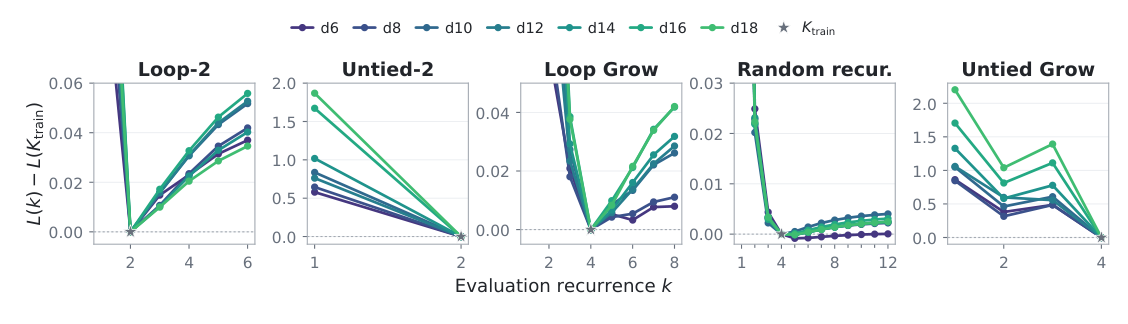
- 测试时 pass(Figure 17):随机训练确实提高对额外 pass 的容忍度——$k=8$ 相对 $k=4$ 的损失变化为 −0.0003 到 +0.0028,而固定 Loop Grow 增加 0.008–0.042;7 个随机循环 checkpoint 中 5 个在 $k=5$ 有浅极小值,但改善 < 0.001 且不随更多 pass 延续。固定 Loop-2 与 Loop Grow 都在训练时的循环次数处最优;解绑模型只能运行已分配的 core。在本设定下,随机循环主要减小额外 pass 的惩罚,而不提供持续的测试时扩展。
优化器同时影响常数与指数
Figure 16f:宽度扩展(执行深度 11 的 Deep Vanilla)下,Muon 相对 Adam 有常数改进(Adam 约 0.42–0.46×,读图;指数 0.1053 vs 0.1020),与 Qiu et al. (2026) 一致;但宽深同扩(Vanilla)下 Muon 的算力效率优势随规模缩小——Adam 相对 Muon 的 multiplier 从约 0.55× 升到约 0.68×(读图),拟合指数 Adam 0.1169 对 Muon 0.1112。作者推测 Muon 对更深网络可能不如 Adam 有效,并以此呼吁研究架构与优化器的交互。
数据重复区间的补充实验(Appendix D)
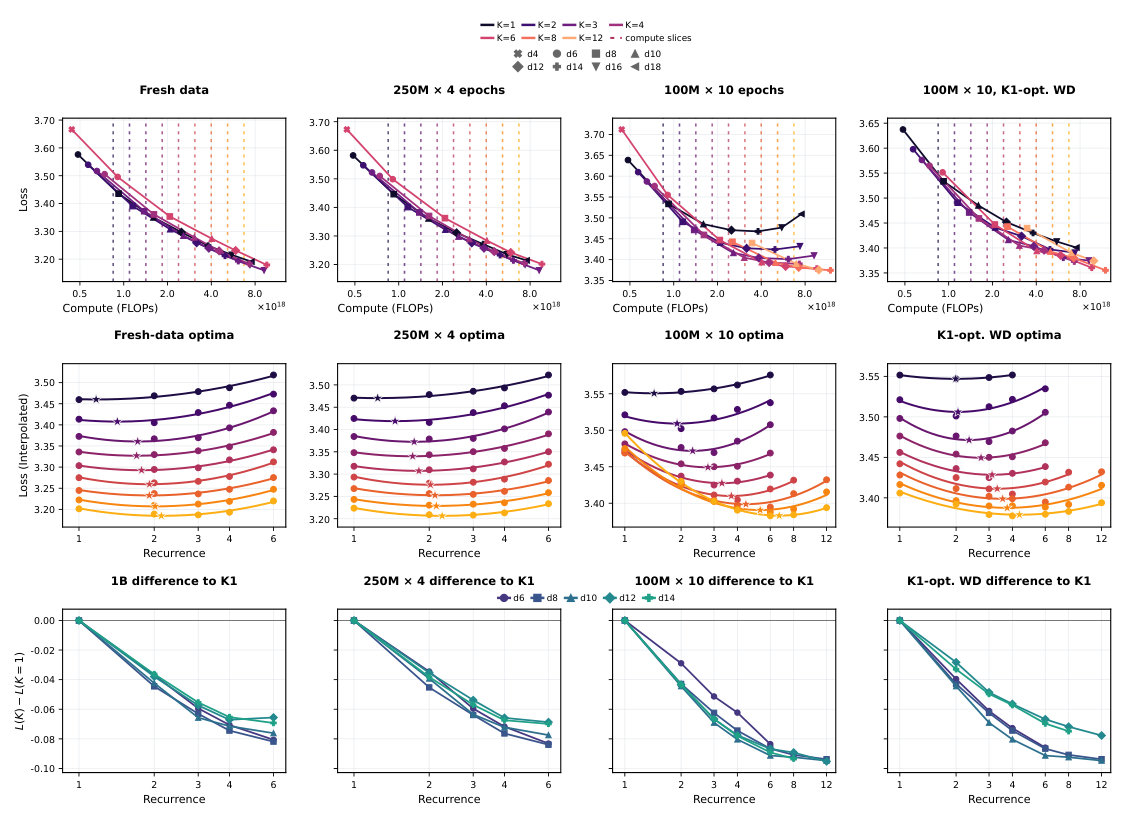
D.1 数据重复改变偏好的循环次数:约 1B token 暴露量下比较新鲜数据、250M×4、100M×10(WD 0.8)。新鲜数据与 4 epoch 下偏好循环次数在所有测量预算都保持 1–2;10 epoch 下低循环次数扩尺寸最终变差,高循环次数推迟上翘,最优循环次数随算力上升更明显。第四列按 $K=1$ 为每个尺寸选 WD 并跨 $K$ 固定:过拟合与向大 $K$ 的偏移都减弱但不消失;固定存储深度下额外 pass 持续降低损失。注意固定深度的比较随 $K$ 花更多算力,等算力比较见中排。
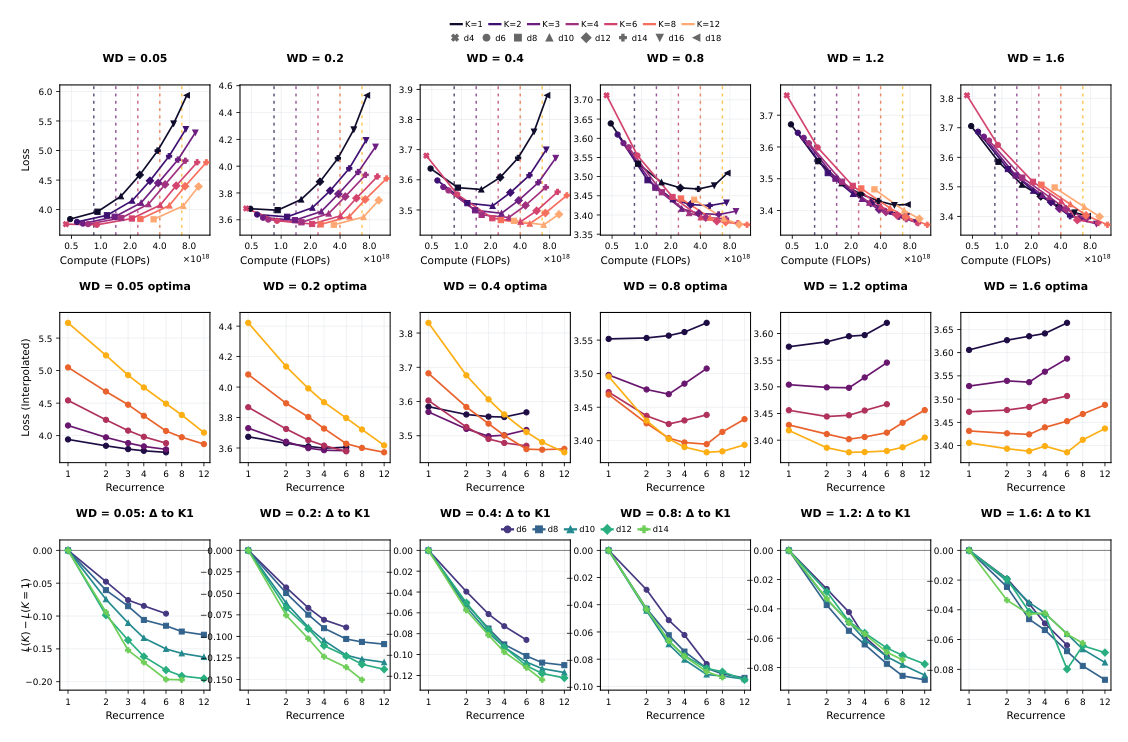
D.2 WD 与循环互补:WD ∈ {0.05, 0.2, 0.4, 0.8, 1.2, 1.6}。弱正则下随存储尺寸增长的损失上翘最强,大预算偏好高循环次数;强 WD 减弱上翘并缓和偏好的循环次数。固定存储深度下额外 pass 仍改善损失,只是幅度更小——循环收益在正则不足时最大,但调 WD 不能消除它。
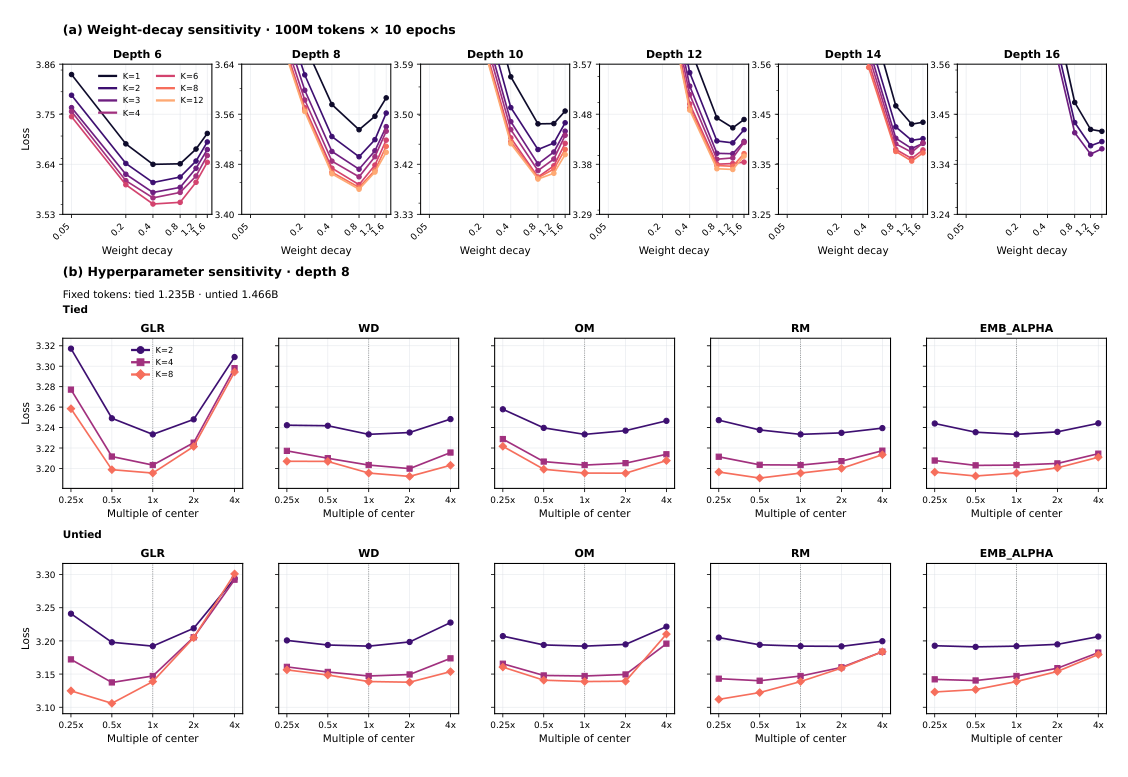
D.3 超参跨循环次数迁移:在共享网格上按 $K=1$ 选 WD 得 d6 0.4、d8–d10 0.8、d12–d14 1.2、d16–d18 1.6,偏好 WD 随存储深度变化远大于随绑定循环次数变化。新鲜数据 d8 上对 $K = 2,4,8$ 检验 GLR、WD、OM、RM、注入尺度的迁移(绑定固定 1.235B token,解绑 1.466B token):绑定模型最优值大体相似,解绑模型偏移更多,尤其在高循环次数时偏向更小的学习率与 residual multiplier。
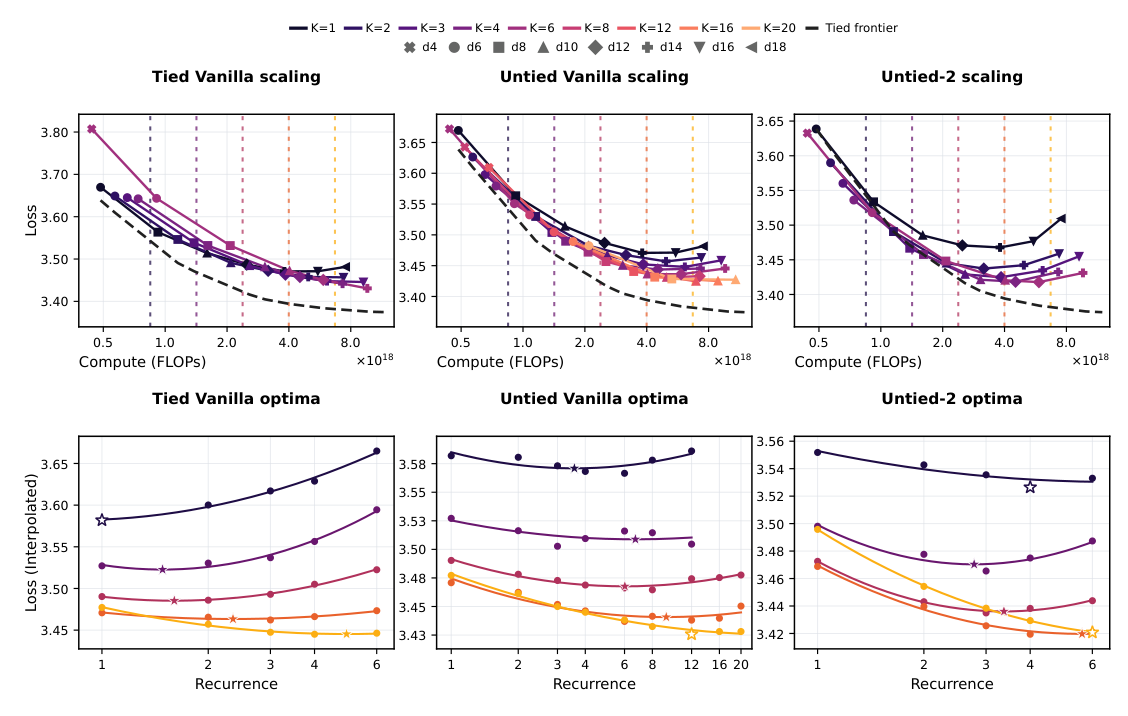
D.4 架构对照:Tied Vanilla(普通 Transformer core 共享权重重复)、Untied Vanilla(独立副本 = 更深普通 Transformer),二者用冻结的 Vanilla 配方、无算子,共享 $K=1$ 阶梯并逐深度逐循环匹配 FLOPs;第三组是带算子的解绑家族。三个家族偏好的循环次数都随预算增长——重复数据即使没有权重共享也会偏好深度;两个普通 Transformer 对照都在「绑定 + 算子」前沿之上;带算子的解绑家族在两个最小参考预算略好、在三个更大预算更差:随着「用新参数加深度」变得不那么有效,绑定循环的优势才显现。
核心贡献总结
- 「常数 vs 指数」的评估框架:把架构比较从「某预算下谁更好」改为「compute multiplier 是否随规模上升」,并主张这一区分应成为评估新架构与训练配方的标准环节。
- prelude–core–coda 统一家族 + 单轴对照:把边界算子、权重共享、生长三个轴拆成一次只动一个的匹配对照,得出「算子与生长改指数、解绑只改常数、单纯加深只改常数」的归因。
- 两个可直接复用的架构改动:在 coda 前也施加「归一化 + 注入 $e$」的边界算子(普通 Transformer 也能用,几乎零开销);以及把循环次数在训练中途 2→4 的生长(绑定版零新增参数)。
- 完整的逐架构算力最优配方:四阶段(d8 链式调参 → TPP → 生长比例 → GLR 缩放规则),附 TPP–扩张比–生长比例的闭式关系(式 (10)–(15))与迁移探针,是一份可照抄的「如何公平比较架构 scaling」的流程。
- 留出外推验证:7.4B Untied-Grow 在最大拟合算力的 8 倍处(原文口径;相对 $10^{20}$ 约 12 倍)落在预测上,CORE 达到 GPT-3 13B 水平(非受控比较)。
- 数据受限区间的循环处方:多 epoch 下最优循环次数随算力增长、扩循环比扩尺寸省 2.2× 算力且几乎不需调 WD,并用「最优 WD 跟随存储参数」给出「过拟合跟随存储参数而非执行深度」的机制证据。
与已归档相关工作的对比
SMELT SMELT: Scaling Laws for Compute-Matched MoE Looped Transformers (Tsinghua + ByteDance Seed, 2026-09-01)
关系:显式引用但原文未展开对比(仅 related work 一句「Concurrently … in our setting, by contrast, we find that weight sharing alone is not enough to improve the exponent」)· 已加载对方精读
- 共同关注的问题:两篇都问「循环/深度复用在算力匹配下能不能改变标度前沿的指数」,并都得出「能」:SMELT 的前沿指数 $\gamma$ 从 0.237 升到 0.250(+5.5%),本文 Untied-Grow 从 0.111 升到 0.117(约 +5%)。两篇对 SMELT 立论的核心——「参数匹配 ≠ 算力匹配」,循环的重复前传必须记入成本——立场完全一致:本文所有 multiplier 都在等 FLOPs 轴上插值得到,计算量按实际执行的每一次 pass 计(生长按训练平均),并另做墙钟复核(Figure 15b),从未把额外 pass 的算力记为架构收益。
- 相近的技术骨架:都用 prelude–core–coda 式中段循环、都把循环次数定在 2(SMELT 消融得出;本文新鲜数据下 $K^\star$ 在 1–2 之间),都为每个架构各自拟合标度律再在共同算力坐标上比较,都用 Huber-on-log-loss 拟合。
- 本文的差异与推进——归因上存在实质分歧:SMELT 把增益记在「循环中间一半层两次 + 更大有效深宽比 + $1/r$ 残差缩放」这个整体配方上,没有「同 FLOPs、同深度、只差是否共享权重」的解绑对照。本文恰好补上了这个对照,结论是解绑相对绑定只差一个恒定倍数(1.06–1.08×),Loop-2、Untied-2、Operator-1 的指数完全相同(0.114)——也就是说,本文设定下 Loop-2 相对 Vanilla 的指数改进全部来自边界算子,而非权重共享。这为 SMELT 的 $\gamma$ 提升提供了一个可检验的替代解释:它可能来自「更深的有效深度 + 抑制残差流膨胀的 $1/r$ 缩放」(与本文边界算子针对的是同一个 curse-of-depth 失效模式),而不是循环本身。反过来,SMELT 也对本文构成压力:SMELT 同时匹配 FLOPs、总参数与 KV cache,本文只匹配 FLOPs(存储参数随 TPP 自由浮动、KV cache 随执行深度增长而未匹配),在 SMELT 的三重口径下本文的 multiplier 是否保持不得而知。
- 可比的方法 / 实验差异:(a)不可约损失:SMELT 为两种架构各拟合 $E$(且发现 $E_{\text{SMELT}}$ 略高于 Baseline、差距小于 RMSE),本文所有架构共享 Vanilla 拟合的 $E$——在只有两个数量级的窗口里,「$\gamma$ 更大」与「$E$ 更低」难以区分,SMELT 的做法在这一点上更稳妥;(b)不确定性:SMELT 给出 cell bootstrap 的 95% 区间并拒绝引用窗口外的 $10^{22}$ 数字,本文只报告「斜率回归标准误 < $10^{-3}$」这一上界、却在摘要级叙事里引用 $10^{25}$ 处的 2.7×;(c)规模点:SMELT 4 个规模 × 3 个稀疏档、144 个端点,本文每架构 7–8 个点但有一次拟合区间外(原文称 8 倍算力)的留出验证,这是 SMELT 没有的;(d)骨干与数据:SMELT 为内部语料上的 MoE,本文为 FineWeb/FineWeb-Edu 上的稠密模型并开源代码,可复现性本文更好。
Parcae Parcae: Scaling Laws for Stable Looped Language Models (UC San Diego + Together AI, 2026-04-14)
关系:显式引用但原文未展开对比(related work 两句 + A.2.2 一句「consistent with Prairie et al.」,无头对头数据)· 已加载对方精读
- 共同关注的问题:两篇都在问「循环能不能成为一条可预测的算力扩展轴」,也都注意到残差流随循环/深度膨胀是核心障碍——Parcae 把它诊断为注入矩阵谱半径 $\rho(\mathbf{A}) \ge 1$ 导致的残差爆炸,本文把它归入 curse of depth(残差流增长导致每次更新占比缩小)。
- 相近的技术骨架:两者的修复高度同构——Parcae 用 $e = \mathrm{LN}(P(s))$ 归一化 prelude 输出、$h_{t+1} = \bar{\mathbf{A}}h_t + \bar{\mathbf{B}}e + \mathcal{R}(h_t, e)$ 做受约束注入;本文用 $\mathrm{Norm}(h) + \alpha e$ 归一化状态并注入。差别在于归一化的对象(Parcae 归一化 $e$、约束 $\mathbf{A}$ 使 $\rho < 1$;本文直接归一化 $h$,使残差流在每个边界被重置),以及本文把同一映射加到 coda 之前并证明这一处贡献最大(Table 4:去掉 coda 注入损失 +0.017~+0.021)。
- 本文的差异与推进——对 Parcae 标度律的修正:Parcae 的核心 scaling 结论是「固定参数量下最优循环次数 $\mu^\star_{\text{rec}} \propto C^{0.40}$,循环是与数据正交的扩展轴」。本文在固定 anchor 尺寸下复现了同样的趋势(Figure 9),但明确指出这种比较不检验多 pass 是否胜过加大模型;一旦模型尺寸与数据联合优化(Figure 8),新鲜数据上的最优循环次数在所有预算都停留在 1–2,跨规模增加循环次数不是算力最优的。只有进入多 epoch 数据受限区间,最优循环次数才随算力增长(Figure 5)。换言之,Parcae 的「循环前沿优于纯堆数据」建立在固定参数的约束之上,本文把它的适用范围收窄到「参数受限或数据受限」两类情形。这也与 SMELT 对 Parcae 的定位一致(「在固定参数下测循环收益,FLOPs 与 KV 随 $r$ 膨胀」)。
- 可比的方法 / 实验差异:(a)Parcae 对 Transformer 的对比是匹配参数与数据(循环模型多花算力),本文一律等 FLOPs;(b)测试时扩展结论相反:Parcae 用 per-sequence 随机深度训练,得到饱和指数衰减的测试时律;本文固定循环次数训练的模型在训练时的 $K$ 处最优,随机循环训练只让额外 pass「不那么亏」($k=8$ 时 −0.0003~+0.0028),没有持续的测试时收益;(c)Parcae 最大到 1.3B / 100B token、isoFLOP 只在 140M/370M,本文阶梯到 1.8–3.5B 存储参数、$10^{20}$ FLOPs,外推到 7.4B。
Loopie Loopie: Loop the Loopies! (IQuest Research, 2026-07-17)
关系:独立并发(本文未引用 Loopie,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都把循环从「省参数的手段」重新定义为「算力匹配下的扩展机制」,都要求循环模型与同预训练算力而非同参数量的非循环模型比较,并都声称收益随规模不消失甚至扩大——Loopie 四级阶梯上的下游增益 +1.1 / +0.6 / +1.7 / +2.2,本文 loss multiplier 从 1.30× 升到 1.55×。
- 相近的技术骨架:都在新鲜数据的大规模预训练里独立得出「$R/K = 2$ 附近最优」(Loopie 从 6B/20B,本文从 1B token 阶梯的 $K^\star \in [1,2]$),都先确定一个强的非循环参考再按同一预算回投容量。
- 本文的差异与推进:(a)匹配货币:Loopie 匹配实测 optimizer-step 墙钟,自认多做约 42% 名义 FLOPs、靠 layer-loop 省激活显存带来的 microbatch 翻倍抵掉;本文匹配 FLOPs 并额外报告墙钟 multiplier——本文的收益是算术层面的,Loopie 的收益有相当一部分是系统层面(MFU)的,两者不可直接相加。(b)归因:Loopie 的「N× 循环 vs N× 存储层」对照中 2× 存储层基线的实际算力明显更高(Loopie 自己声明),因而没有干净的等算力解绑对照;本文的等算力解绑对照显示新鲜数据上解绑优于绑定一个恒定倍数。按本文结论,Loopie 相对 vanilla MoE 的增益更可能来自「更深的有效深度 + 显存换来的吞吐」而非权重共享本身。(c)生长:Loopie 的循环次数全程固定,本文表明把 pass 数在训练后段翻倍能进一步改进指数,这是 Loopie 配方可以直接叠加的一个维度。
- 可比的方法 / 实验差异:Loopie 用 layer-loop(每层就地循环两次),本文用中段 model-loop(Loopie 论证后者在流水线并行下有环形依赖,本文的单节点/双节点训练未触及这一问题);Loopie 训练 token 取活跃参数的 1000 倍(重度过训练),本文在 TPP 5–8 的算力最优区间;Loopie 是 MoE + SPT + RL 的完整模型交付,本文只做预训练标度研究。
Step 2.5 其余相关与剔除的近似候选: - LoopCTR(LoopCTR,RUC + Alibaba)——本文未引用,跨域、无继承关系。两者都用 Entry/Loop/Exit(≈ prelude/core/coda)三段式,但 LoopCTR 的问题是「为 CTR 找第四条扩展轴 + 训多圈推零圈」,不做算力最优阶梯,解法依赖 HCR 与多深度过程监督,问题与解法均不同构,故不单列。值得记下的是一个跨域呼应:LoopCTR 把共享 Loop Block 的收益部分归为「结构性正则、对稀疏数据更不易过拟合」,其 iso-FLOPs 下 LoopCTR(3/3) 比 StackCTR(3) 高 0.0036 AUC 且参数更少;本文 Section 5 / Figure 24 给出了这一直觉在 LM 上的受控版本——只有在数据重复(过拟合受限)时绑定才胜过解绑,新鲜数据上解绑反而多赢一个恒定倍数。CTR 的 one-epoch 过拟合特性恰好更接近本文的数据受限区间,所以两者结论并不矛盾,但也提示 LoopCTR 的循环收益不应外推到数据充足的场景。 - SZP(SZP,Freiburg)——模型生长方向最接近的归档工作,本文未引用。SZP 研究「从外部小 checkpoint 做宽度 warmstart」,把基模型算力当黑箱不计入,结论是 WS 优势只在有界 token 预算与生长因子 $g_{\text{upper}}$ 内成立、TPP 越高越该从头训;本文的生长发生在同一次训练内、转换前的算力完整计入、方向是深度,结论却是生长改进指数。两者表面相反,实则设定不同(外部复用 vs 训练内调度、宽度 vs 深度、黑箱算力 vs 全额记账),且在「小生长因子($g = 2$ / 2→4 pass)+ 较低 TPP」这个处方上是一致的。未单列是因为 SZP 的问题陈述(checkpoint 复用何时划算)被本文明确「set aside」。 - EMO(EMO,USC ISI)——动机与本文的生长高度同构(「从第一步就承担全部容量,而早期数据用不上」),但轴是 MoE 专家数、目标是墙钟而非指数,最终损失还落后于固定 E=128,无指数主张,剔除。本文 Discussion 把「按网络需要的日程增长专家数」列为未来方向,EMO 可视作该方向的一个已有实例。 - DeRes(DeRes)——同样以「更陡的拟合标度指数」主张架构优越(CTR 上 0.118 vs 0.071),且改的也是层间连接,但解法是跨层注意力残差、无循环与生长,领域为 CTR,剔除。 - Small-Scale Scaling Laws(Small-Scale Experiments: Are We There Yet?,FAIR MSL)——证明标度律只在充分调参的前沿上才浮现,与本文「逐架构调参才能看到指数改进」的主张同向,但属方法论来源而非孪生工作,剔除。
讨论与局限性
复核一:「改变指数」的证据强度
规模点与拟合:每个架构 7–8 个阶梯点(Vanilla、Operator-1 为 d6–d20 共 8 点,其余 d6–d18 共 7 点),跨约 $3\times10^{17}$–$1.5\times10^{20}$ FLOPs,约 2.7 个数量级;multiplier 在 $10^{18}$–$10^{20}$ 的 7 个 Vanilla 预算上插值。每个阶梯点只训练一次(评测种子 0/1/2 只改变 few-shot 示例)。不确定性只报告了「斜率回归标准误均低于 $10^{-3}$」这一上界,没有置信区间、没有 bootstrap、没有多训练种子。
指数差 vs 拟合误差:$\Delta\gamma$ 为 +0.003(Operator-1 / Loop-2 / Untied-2 / Deep Vanilla Grow)、+0.005(Loop-Grow)、+0.0055(Untied-Grow)。若两条斜率各自标准误不超过 $10^{-3}$,差值标准误不超过约 $1.4\times10^{-3}$,于是 Untied-Grow 的差异至少约 4σ、Operator-1 至少约 2σ——相对回归残差,差异是可分辨的,Operator-1 这一档则处在边缘。但这个标准误低估了真实不确定性,至少漏掉三项:
- 共享 $E$:所有架构的 $\log(L - E)$ 都用 Vanilla 拟合的 $E$。若某变体的真实不可约损失更低,它在共享 $E$ 下就会表现为更大的 $\gamma$;两个数量级的窗口内「指数更大」与「地板更低」无法区分(二者都让 multiplier 随规模上升,只是远期行为不同)。$E$ 本身的拟合误差也没有传播进斜率标准误。SMELT 为每个架构单独拟合 $E$,本文没有报告这一敏感性检查。
- 训练噪声:单种子。唯一的噪声量级线索是 Vanilla 配方迁移探针里 −0.3×$10^{-3}$ 的「run-to-run noise」。好在 FineWeb-Edu 上独立重训的 Vanilla / Untied-Grow 阶梯给出了几乎重合的 loss multiplier 曲线(约 1.28→1.53 对 1.30→1.55),这是对训练噪声最有力的反证。
- 配方噪声——这是最关键的一项。本文自己的消融显示,与 $\Delta\gamma$ 同量级甚至更大的指数变化可以由配方或设定选择单独产生:Vanilla 常数配方 vs GLR 缩放 0.0974 vs 0.1106(Δ=0.013);Operator-1 用自有配方 vs Vanilla 配方 0.1143 vs 0.1114(Δ=0.003,恰好是其全部指数收益);同一 Vanilla 换 Adam 0.1169 vs Muon 0.1112(Δ=0.0057,与 Untied-Grow 的架构收益一样大);Operator-1 换成 1:64 更深形状后指数回落到 0.1112;1/C/2 固定分配下 Operator-1 的优势先升后降;只扩宽度时 Untied-2 的指数优势消失。学习率规则只在 d8–d10(210M–330M)三个尺寸上拟合、指数取一位小数,却要外推到 d18–d20。
综合判断:(i)「multiplier 在测量区间内随规模上升」这一观测是可信的——逐点插值、不依赖 $E$,生长变体的曲线几乎单调,且在第二个语料上复现,并被拟合区间外(原文称 8 倍、相对 $10^{20}$ 约 12 倍算力)的留出 run 部分确认(损失落在预测下方 0.03,至少说明收益没消失);(ii)「架构改变了指数」这一解释被表述得强于证据:$\Delta\gamma$ 在拟合噪声上可分辨,但与「配方/优化器/形状选择」引起的指数变化同量级,且依赖共享 $E$ 的假设。边界算子这一档(+0.003)最脆弱——换配方、换形状、换分配、只扩宽度都能把它变回常数改进;生长这一档(+0.005~+0.006)最稳,跨语料复现、跨算子(Deep Vanilla Grow)复现、有留出外推。更准确的表述是「在 Muon + 本文逐架构配方 + 128 宽深比下,生长(以及较弱地,边界算子)带来在 $10^{18}$–$10^{21}$ 范围内随规模扩大的算力倍数」。摘要里「exponential improvements in performance」的措辞也不准确:指数更大给出的是幂律(多项式)改进,正文引言用的正是「power-law improvements」。
复核二:算力对齐——同 FLOPs 还是同参数量
结论:对齐做得正确,不存在「只对齐参数而高估循环收益」的问题。
- 所有 multiplier、所有 $\gamma$ 拟合都以训练 FLOPs 为横轴;FLOP 估计器含矩阵乘法与注意力,每一次 core pass 都计入,生长变体按 token 加权的平均 compute-active 参数计(式 (13));循环变体每 token 执行更多块,其阶梯正因此在更少存储参数处就触到 $10^{20}$ FLOPs。
- 参数量没有被对齐,而是随各架构拟合的 TPP 自由浮动。循环/生长变体偏好更高 TPP(6–8 vs Vanilla 的 5),意味着同算力下它们的 compute-active 参数更少(绑定变体的存储参数还要再除以扩张比),所以收益不是靠偷偷多用参数得到的;解绑变体虽然在同一 $d\ell$ 标签下存储更多参数(d18:Untied-Grow 2.5B vs Vanilla 1.4B),但比较并不在同一标签下进行。
- 墙钟复核:Figure 15b 把横轴换成记录的优化时间(8×H100),生长变体的 multiplier 仍随规模上升(Untied-Grow 最高约 1.48×,读图),Operator-1 的算子开销几乎为零(Table 4 runtime 6.45–6.54 分钟)。这比 SMELT 的纯解析口径更进一步。
- 未对齐的部分:(a)KV cache 与推理每 token 成本——执行深度随 pass 数增长(d26 执行 35→53 层),KV cache 与解码延迟随执行层数线性增长,这正是 SMELT 坚持匹配的第三个预算,本文未讨论;(b)显存——Untied-Grow 从一开始就分配全部四份 core;(c)墙钟只在单一硬件(H100,单/双节点)上测,未涉及流水线并行下 model-loop 的环形依赖(Loopie 指出的问题)。这些影响部署判断,但不影响「训练算力效率」这一主张本身。
复核三:基线强度——GPT-3 13B 与同配方 Transformer
GPT-3 13B 是弱基线,「约 20× 追平」主要不是架构的功劳;但本文确有一个强的同配方、同数据 Transformer 对照,架构结论应以那个对照为准。
- GPT-3 对比是非受控的,作者自己承认:数据不同(FineWeb-Edu vs 2020 年的 GPT-3 混合语料)、配方不同(Muon + RoPE/SwiGLU/QK-norm + 逐架构调参 vs 2020 年配方)、GPT-3 的 CORE 是 Karpathy 在另一套管线上的估计。
- 拆解 $2.31\times10^{22} / 1.23\times10^{21} \approx 18.8\times$(用本文自己的投影做粗算):Figure 4 右栏在 13B CORE 水平处 Vanilla 需要 Untied-Grow 的 3.0× 算力(这本身是两条拟合曲线的外推);于是同配方的 Vanilla 约在 $3.7\times10^{21}$ FLOPs 就能达到 GPT-3 13B 的 CORE,比 GPT-3 13B 仍少约 6.3×。这 6.3× 里语料一项(FineWeb→FineWeb-Edu)约 1.6×(Figure 18b),其余约 4× 来自现代训练栈与评测差异。按对数份额,架构约占 20× 的 37%(log 3.0 / log 18.8),配方与数据约占 63%;若改用 loss multiplier(1.8×)而非 CORE 交叉点口径,架构份额只有约 20%。标题级的「20× less compute than GPT-3 13B」因此应当读作「现代配方 + 好语料 + 架构」的合计。
- 同配方、同数据的标准 Transformer 对照是存在且较强的:Vanilla 与所有变体在同一 FineWeb/FineWeb-Edu、同一 tokenizer、同一 Muon 训练栈上,经同样两轮链式调参、各自拟合 TPP 与 GLR 规则;迁移探针显示 Vanilla 自有配方确为最优(−0.3×$10^{-3}$ 属噪声);Table 8 显示施加规则后 Vanilla 的残余 LR 漂移为 0,而 Operator-1 / Untied-Grow 的残余漂移反而显著(−0.11 / +0.10),配方若有偏向,偏向的是 Vanilla。常数配方下循环模型的 multiplier 可虚高到约 2×,作者没有采用这个更好看的数字。这些都说明本文在「不欺负基线」上是认真的。
- Vanilla 基线仍有四处可质疑:(a)宽深比 128 偏宽——Deep Vanilla 仅靠形状就拿到平坦的约 1.08×,说明 Vanilla 的常数不是最优(作者已披露,且只影响常数);(b)最优 TPP 的规模不变性对 Vanilla 最勉强(p = 0.087,五个架构中最接近拒绝),固定 TPP 5 若在大尺寸处轻微偏离最优,恰好会表现为 multiplier 上升;(c)优化器交互——同一 Vanilla 在宽深同扩下 Adam 的指数(0.1169)明显高于 Muon(0.1112),作者推测 Muon 对更深网络效果变差;本文的算子与生长都是「让深度更可用」的干预,其指数收益有可能部分是在弥补 Muon 在深度扩展上的短板,换成 Adam 基线后收益是否仍在没有被测试;(d)固定 batch size(524K token)跨所有规模不变,C.5 承认未做 batch size 与规模的联合优化,而不同架构的最优 batch 可能不同。
其他局限与值得借鉴之处
- 理论解释偏事后:「计算深度」框架给出的两种浪费都是假设,KL effective depth 只是代理(作者自承)。而且存在一处未调和的反例——Deeper Operator-1(1:64,更深)失去了指数改进,这与「算子的收益随深度增大」的假设方向相反,正文只描述未解释。
- Loop-Grow 没有外推:留出验证只做了 Untied-Grow,参数效率最有吸引力的绑定生长只有阶梯内证据。
- 多 epoch 结论规模较小:100M unique token、最大约 $10^{19}$ FLOPs、1.4B 参数;「扩循环省 2.2×」对比的是逐尺寸调 WD 的 Operator-1 在单一预算处的损失,且多 epoch 部分没有标度律拟合。
- 下游 multiplier 噪声大:CORE accuracy 的 multiplier 在相邻预算间从约 1× 跳到 3.7×,下游结论主要应看 answer NLL。
- 值得借鉴:(1)用 multiplier 曲线的形状区分常数与指数,并坚持逐架构调参 + 迁移探针,这套评估协议本身比任何单一结论都更可复用——包括对推荐领域里「更陡的 scaling 指数」类主张(如 DeRes、ReST 的 $\Delta$AUC–FLOPs 幂律);(2)coda 前的「归一化 + 注入」几乎零开销、单项贡献最大,可以直接移植到任何 prelude–core–coda 或 Entry/Loop/Exit 式结构(例如 LoopCTR 的 Exit Block 之前);(3)「新鲜数据解绑、重复数据绑定」的处方对推荐场景尤其相关:工业 CTR / 生成式推荐普遍受 one-epoch 过拟合约束,更接近本文的数据受限区间,循环式权重共享在那里的价值可能高于在 LLM 预训练中的价值;(4)训练中途把深度翻倍的生长日程(转换点约在训练的 50%–80%,TPP 取 7–8)是低成本、可立即尝试的配方。
- 无工业部署,纯学术 + 初创实验室的预训练标度研究。