When is Warmstarting Effective for Scaling Language Models?¶
Neeratyoy Mallik、Maciej Janowski、Johannes Hog(共同一作)、Herilalaina Rakotoarison、Josif Grabocka、Frank Hutter、Aaron Klein University of Freiburg / Zuse School ELIZA / University of Technology Nuremberg / University of Helsinki / Prior Labs / ELLIS Institute Tübingen arXiv 2605.13405v1,2026-05-13,cs.LG
研究动机与背景¶
训练前沿模型的算力成本逐年攀升,一个非常自然的诉求是:当我们把模型从几百 M 扩到几 B 时,能不能把此前投在小模型上的算力回收利用? 这条路线被称为 model growth 或 warmstarting(WS)——用一个训练好的小 checkpoint 去初始化更大的模型,而不是从随机初始化重新开始。
这个想法从 Net2Net(Chen et al., 2016)和 Network Morphisms(Wei et al., 2016)起就存在,二十余篇后续工作把它推广到了 BERT(progressive stacking、bert2BERT)、CLIP(GrowCLIP)乃至现代 decoder-only LLM。但作者观察到一个尴尬的事实:WS 至今没有进入任何一条主流的生产训练流水线,它更像是一个学术话题。
论文把"为什么没人用"归因到两个被系统性忽略的因素:
- 对"函数保持"(function-preservation, FP)的过度执念。FP 要求生长后模型在第一次前向传播时的输出与基模型完全一致。自 Chen et al. (2016) 起,FP 主导了整个宽度生长范式。但 FP 的代价是:每遇到一种新架构组件(RoPE、RMSNorm、Mamba 的选择性状态空间……)就要重新推导一套保持函数不变的规则,算子设计被死死绑住。
- 对"生长如何与超参、scaling 行为交互"的分析严重不足,而且各篇论文用的生长因子 $g$(目标模型参数量 / 基模型参数量)互不一致——有人用 2×,有人用 4×,导致横向比较根本不成立。
由此作者归纳出三条阻碍 WS 落地的具体障碍:(1) 实现复杂度(算子需要架构特化,难以泛化到新组件);(2) 生长上限不明(实践者不知道一个 checkpoint 最多能长多大才不至于反受其害);(3) scaling 下的超参不透明(WS 方法 × 超参 × 模型/数据预算的三方交互没被研究,重调超参的开销可能把 WS 省下的算力全吃掉)。
本文把研究范围收缩得非常明确:给定一个可用的基模型 checkpoint,把它 WS 到更大规模。作者假设我们知道基模型训练用的数据集、可能知道部分超参,但把基模型投入的训练算力当作黑箱——这与 Liew & Kato (2025) 假设完全掌握基模型训练历史的设定不同,作者认为黑箱假设更贴近真实世界(公开发布的往往只有 checkpoint 本身)。
论文的三条贡献是:
- 把 WS 生长归纳为 shrink-zero-perturb(SZP) 这一简单、架构无关的操作,并证明精确的函数保持并非有效 WS 的必要条件;
- 经验性地确立了生长比的上界 $g_{\text{upper}}$——超过这个界,从头训练(Scratch)的收敛速度就追平甚至超过 WS;
- 用 scaling law 拟合证明:对给定的 WS 方法与基模型规模,WS 相对 Scratch 的收敛优势只在一个有界的 token 预算内成立,并能预测这个交叉点在哪。
核心方法:Warmstarting 的三轴设计空间与 SZP¶
从 Shrink-and-Perturb 到生长算子¶
FP 类方法通常混合了三种成分:克隆已有权重、缩放生长后的权重、注入噪声,而且这三者常常通过架构特化的规则耦合在一起。本文的做法是把这三个设计维度解耦,并对所有权重(1D 与 2D)一视同仁地施加。
出发点是持续学习(Continual Learning)领域的 shrink-and-perturb(SnP,Ash & Adams, 2020)。SnP 原本用于同尺寸模型的重初始化:
$$\theta^{l}_{\text{target}} = \lambda_{\text{shrink}} \cdot \theta^{l}_{\text{base}} + \mathcal{N}(0, \sigma_{\text{perturb}}^{2}) \tag{1}$$
其中 $\lambda_{\text{shrink}}$ 调节继承权重的影响力,$\sigma_{\text{perturb}}$ 是加在所有神经元上的高斯噪声标准差,$l$ 为层索引。
为了适配"目标模型比基模型大"的生长场景,本文引入一个生长函数 $G$:
$$\theta^{l}_{\text{target}} = \lambda_{\text{shrink}} \cdot G(\theta^{l}_{\text{base}}, p, q) + \mathcal{N}(0, \sigma_{\text{perturb}}^{2}) \tag{2}$$
其中 $G : \mathbb{R}^{m\times n} \times \mathbb{N} \times \mathbb{N} \to \mathbb{R}^{p\times q}$ 把基权重 $\theta^{l}_{\text{base}} \in \mathbb{R}^{m\times n}$ 映射到更大的目标形状 $p \times q$($p \ge m$,$q \ge n$),$\lambda_{\text{shrink}} \in \mathbb{R}_{>0}$,$\sigma_{\text{perturb}} \in \mathbb{R}$。
三个轴各自的物理含义(作者的原话值得保留):
- Growth($G$) 决定从基模型继承哪些结构;
- Perturbation($\sigma_{\text{perturb}}$) 负责打破对称性——它确保新增神经元能学到不同的特征,而不是单纯复制继承来的行为;
- Shrinking($\lambda_{\text{shrink}}$) 降低继承权重的幅值,抑制基表征的支配地位,让新神经元能有意义地参与学习。
作者明确指出,式 (2) 通过对每个架构组件选择合适的 $G$、$\lambda_{\text{shrink}}$、$\sigma_{\text{perturb}}$,形式上可以表示 Net2Net 这类更复杂的算子,但推导这种映射本身不在本文范围内。
为什么默认选 SZP¶
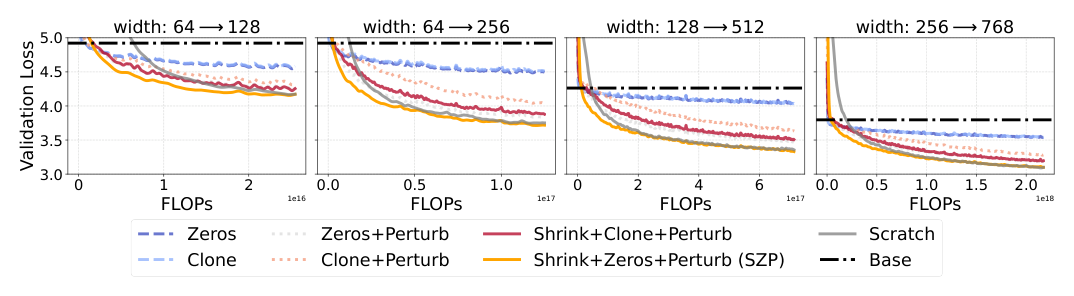
Figure 1 在四组 width 生长(64→128、64→256、128→512、256→768)上比较了设计空间的最简实例化:
- Zeros(新位置补零)与 Clone(复制已有权重)单独使用时没有显著差异;
- 各自加上扰动噪声(Zeros+Perturb、Clone+Perturb)后都有提升;
- 再加上收缩(Shrink+Zeros+Perturb、Shrink+Clone+Perturb)后进一步提升,且这个序关系在各生长比下都成立:$\text{SnP-}G \ge G + \text{Perturb} \ge G$。
值得注意的是:所有 WS 变体都能在几步之内恢复到基模型的损失水平,并且在训练早期都比 Scratch 收敛更快。差异要到"持续收敛"阶段才显现出来——而 SZP(Shrink+Zeros+Perturb)是唯一在所有模型宽度上都稳定占优的变体。
作者非常克制地声明了 SZP 的定位:SZP 并非被提出为新的 SOTA warmstarting 算法,而是一个「原则性的 baseline」,用来研究 WS 的 scaling 行为。它的价值在于:结构上对齐了标准 FP 算法(也是 clone/scale/noise 三件套),但放松了"初始化时保持基模型输出"这一硬约束,因而对任意架构都能直接实现。
理论直觉:零填充、扰动、收缩为何互补¶
考虑 $\phi(0)=0$ 的前馈网络 $h_{\ell+1} = \phi(W_\ell h_\ell + b_\ell)$。令 $P(\theta)$ 表示从宽度 $n$ 到宽度 $m > n$ 的零填充扩展(所有触及新神经元的参数置零),并把隐状态嵌入为 $\tilde h_\ell = [h_\ell;\, 0]$,则
$$\tilde{h}_{\ell+1} = \phi\left(\begin{bmatrix} W_\ell & 0 \\ 0 & 0\end{bmatrix}\begin{bmatrix} h_\ell \\ 0\end{bmatrix} + \begin{bmatrix} b_\ell \\ 0\end{bmatrix}\right) = \begin{bmatrix} h_{\ell+1} \\ 0 \end{bmatrix} \tag{3}$$
按层归纳可得 $f_{P(\theta)}(x) = f_\theta(x)$ 对所有 $x$ 成立——在这个理想化的无归一化设定里,零填充本身就精确保持了预训练函数。(对含 LayerNorm / RMSNorm 的 Transformer,精确 FP 还需要对归一化参数或相邻权重做协同缩放;因此零填充只应被视为一种"嵌入直觉"而非严格的 FP 操作。)
但这个精确嵌入同时也是束缚。令 $\mathcal{M} := \{P(\theta) : \theta \in \Theta_{\text{small}}\}$ 为嵌入的小模型流形。在 $\mathcal{M}$ 上,每个新增神经元的激活为零、出边权重也为零;由反向传播的链式法则,传回这些新神经元的误差信号恰好为零,于是
$$\nabla_{\Theta_{\text{new}}} \mathcal{L}(P(\theta)) = 0 \tag{4}$$
也就是说,纯零填充会把优化永久锁死在小模型流形上,更宽的模型根本用不上多出来的容量。
SZP 的初始化写作 $\Theta_0 = \lambda_{\text{shrink}} P(\theta^\star) + E$($0 < \lambda_{\text{shrink}} \le 1$,$E$ 为扰动)。把某一层的输入按旧(o)/新(n)坐标分块,扰动矩阵与偏置分块为 $E = \begin{bmatrix} E_{oo} & E_{on} \\ E_{no} & E_{nn}\end{bmatrix}$、$e = [e_o; e_n]$,则预激活为
$$\tilde{z} = \begin{bmatrix} \lambda_{\text{shrink}}(Wh+b) \\ 0 \end{bmatrix} + \begin{bmatrix} E_{oo}h + e_o \\ E_{no}h + e_n \end{bmatrix} + O(\|E\|^2) \tag{5}$$
下分块 $E_{no}h + e_n$ 是新增神经元能拿到的第一个非零信号:若 $E = 0$,新坐标永远静默。这就是扰动把模型推离流形 $\mathcal{M}$、激活新自由度的作用。
收缩则起互补作用。新旧通路的相对影响力(一阶近似)为
$$\frac{\|(\tilde{z})_{\text{new}}\|}{\|(\tilde{z})_{\text{old}}\|} = \frac{\|E_{no}h + e_n + O(\|E\|^2)\|}{\|\lambda_{\text{shrink}}(Wh+b) + E_{oo}h + e_o + O(\|E\|^2)\|} \tag{6}$$
当继承通路信号支配旧块扰动($\lambda_{\text{shrink}}\|Wh+b\| \gg \|E_{oo}h+e_o\|$)时简化为 $\|E_{no}h+e_n\| / (\lambda_{\text{shrink}}\|Wh+b\|)$。取 $\lambda_{\text{shrink}} < 1$ 让新神经元更容易与被复制的子网络竞争;更大的相对预激活意味着新权重在反传时产生更大的梯度,主动把优化轨迹拉离受限流形 $\mathcal{M}$。
一句话总结三者分工:零填充保存预训练模型,扰动激活新维度,收缩通过打破继承窄解的优化支配地位来加速适应。
关键技术细节¶
对照基线:Net2Net 宽度扩展¶
作者选 Net2Net 作为主要 FP baseline,理由是它 (1) 面向宽度扩展(与本文范围一致)、(2) 初始化时近似函数保持、(3) 不需要改训练目标或增加优化阶段;而且在 Du et al. (2024) 的大规模生长基准里,Net2Net 式的 direct widening 是最强的宽度扩展基线。
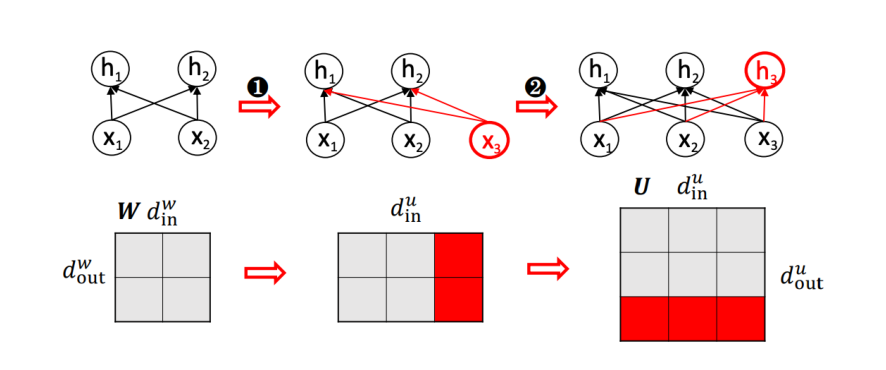
对隐藏宽度 $n$ 的 MLP 块 $h = \phi(W_{\text{in}}x)$、$y = W_{\text{out}}h$,把宽度从 $n$ 增到 $q$ 时,Net2Net 定义映射 $\pi \in \{1,\dots,n\}^q$ 将每个新单元 $j$ 指派给源单元 $\pi(j)$,令 $c_i = |\{j : \pi(j) = i\}|$ 为基单元 $i$ 的复制计数,则函数保持的加宽为
$$(W'_{\text{in}})_{j,:} = (W_{\text{in}})_{\pi(j),:} \tag{7}$$
$$(W'_{\text{out}})_{:,j} = \frac{1}{c_{\pi(j)}} (W_{\text{out}})_{:,\pi(j)} \tag{8}$$
扩展后所有副本产生相同激活,而出边权重的 $1/c$ 重缩放保证了副本贡献之和等于原单元,即 $W'_{\text{out}}\phi(W'_{\text{in}}x) = W_{\text{out}}\phi(W_{\text{in}}x)$。矩阵形式为
$$W' = L\, W\, R \tag{9}$$
其中 $R$ 复制输入维(列)、$L$ 复制输出维(行),并在其中包含 $1/c$ 重缩放。
Transformer 上的实现细节:由于本文保持 head size 固定、通过增加 head 数来扩宽,复制在完整 head 的粒度上进行——复制的 $W_q$、$W_k$、$W_v$ 行不做缩放,只对相应的 $W_o$ 列施加复制计数重缩放,这样既保留了复制 head 的 softmax 计算,又通过输出投影对其合并贡献做了平均。此外按 Net2Net 惯例对新建参数注入小高斯噪声以打破对称。
µP 超参迁移¶
WS 实验有一个隐蔽的混淆项:如果每个目标宽度都独立重调超参,改进可能来自更好的目标尺度超参,而不是生长算子本身。作者用 µP(Yang et al., 2021)解决它。µP 使用的迁移规则如下:
| 参数组 | 前向 / 初始化 | Adam 学习率 |
|---|---|---|
| Input / vector-like | $\mathrm{Var}(W) \propto 1/n$ | constant |
| Hidden / matrix-like | $\mathrm{Var}(W) \propto 1/n$ | $\propto 1/n$ |
| Output / readout | multiplier $\propto 1/n$ | constant |
| Attention logits | $q^\top k / d_{\text{head}}$ | – |
| Scalar-like | constant | constant |
其中 $n$ 是随模型宽度增长的 fan-in/fan-out 维度;attention logits 用的是每头维度 $d_{\text{head}}$,在本文的宽度扩展设定里固定为 64。除学习率外,batch size 也按宽度平方根缩放:
$$B_{\text{target}} \approx B_{\text{base}} \cdot \sqrt{\frac{n_{\text{embd@target}}}{n_{\text{embd@base}}}} \tag{10}$$
实验设置¶
合成回归 testbed(MLP)。沿用 Qiu et al. (2025) 的构造:目标函数具有幂律 Fourier 谱。每个回归 token 为输入向量 $x \in \mathbb{R}^d$ 与标量目标
$$y = f^\star(x) + \epsilon \tag{11}$$
其中 $f^\star$ 的 Fourier 系数按幂律衰减:
$$\mathbb{E}\left[|\hat{f}(\omega)|^2\right] \propto \|\omega\|^{-\alpha} \tag{12}$$
MLP 深度固定 $L = 3$,只缩放隐藏宽度 $n_{\text{embd}}$。这些 MLP 沿用了 Transformer FFN 块的参数化与归一化惯例(只是去掉了注意力),因此被当作 "Transformer MLP-only" 模型而非通用全连接网络。
| Width | 48 | 68 | 96 | 136 | 192 | 272 | 384 |
|---|---|---|---|---|---|---|---|
| Params (M) | 0.1 | 0.1 | 0.2 | 0.4 | 0.9 | 1.8 | 3.5 |
训练时长由 tokens/parameter 预算 $\tau$ 决定:$T = \tau \cdot P$,MLP 实验取 $\tau \in \{20, 35, 50\}$。超参网格是固定种子的确定性笛卡尔积:base grid(在 width=48 上评估,$8\times3\times5\times3\times2 = 720$ 组)与 main grid(用于各目标宽度,$4\times3\times3\times3\times2 = 216$ 组):
| 超参 | Base grid (width=48) | Main grid (目标宽度) |
|---|---|---|
| Learning rate | {6e-4, 8e-4, 1e-3, 1.4e-3, 1.8e-3, 3e-3, 4e-3, 5e-3} | {6e-4, 1e-3, 3e-3, 4e-3} |
| Weight decay | {0, 1e-5, 1e-2} | {0, 1e-5, 1e-2} |
| Batch size | {256, 512, 1024, 2048, 4096} | {256, 512, 1024} |
| Warmup fraction | {0.01, 0.03, 0.05} | {0.01, 0.03, 0.05} |
| Cooldown fraction | {0, 0.2} | {0, 0.2} |
语言模型设置。全部使用 LITGPT 实现的 decoder-only GPT-2 风格模型,语料 SLIMPAJAMA,只做宽度扩展(保持 head size = 64,靠加 head 数扩宽),所有模型 8 层、序列长度 1024:
| $d_{\text{model}}$ | 128 | 256 | 512 | 768 | 1280 | 2048 | 3072 |
|---|---|---|---|---|---|---|---|
| $n_{\text{head}}$ | 2 | 4 | 8 | 12 | 20 | 32 | 48 |
| Params (M) | 14 | 32 | 77 | 134 | 286 | 610 | 1200 |
优化器 AdamW,$(\beta_1,\beta_2) = (0.9, 0.95)$,$\epsilon = 10^{-8}$,梯度全局范数裁剪 1.0,weight decay 全程为零(以隔离 WS 与显式 $\ell_2$ 正则的交互)。学习率采用 warmup-stable-decay(WSD)梯形调度,warmup 分数 $w = 0.01$、衰减分数 $d = 0.20$:
$$\eta_t = \begin{cases} \eta_{\max}\dfrac{t}{wT}, & 0 \le t < wT \\[4pt] \eta_{\max}, & wT \le t < (1-d)T \\[4pt] \eta_{\max}\dfrac{T-t}{dT}, & (1-d)T \le t \le T \end{cases} \tag{13}$$
训练预算取 10 / 20 / 30 tokens per parameter,其中 20 tokens/param 对应 Chinchilla 计算最优参考预算。基尺度选中的超参(用于 µP 迁移):
| Params (M) | Selected $\eta_{\max}$ | Effective batch size |
|---|---|---|
| 14 | $3\times10^{-3}$ | 64 |
| 32 | $5\times10^{-3}$ | 128 |
| 77 | $2.5\times10^{-3}$ | 256 |
算力开销:语言模型部分共 182 次 run(32M×25、77M×40、134M×49、286M×53、610M×13、1.2B×2),合计约 39,000–50,000 GPU-hours(主要为 NVIDIA L40S 48GB,1.2B 用 H200);合成 MLP 部分约 10,143 CPU-hours(423 CPU-days)。
主要实验结果¶
超参迁移:µP 才是可用的迁移策略¶
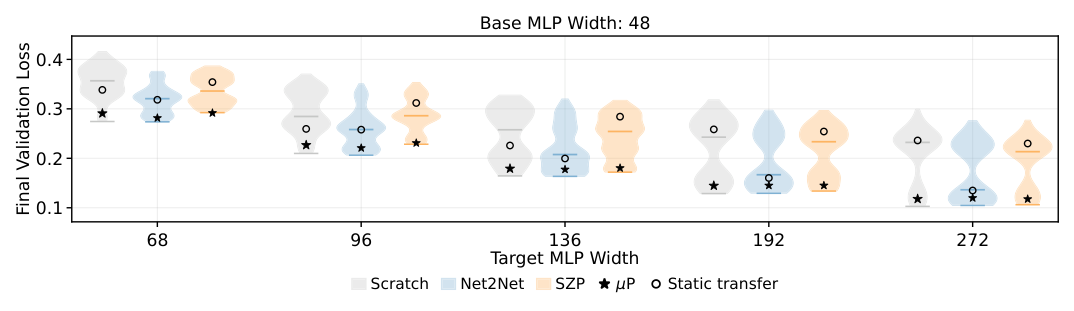
Figure 2 在 base width = 48 出发,对目标宽度 68/96/136/192/272 比较三种做法:目标宽度上的稠密网格搜索(小提琴分布)、静态迁移(空心圆,直接沿用基宽度最优配置)、µP 迁移(星号)。结论有三条:
- 预算允许时,在目标宽度上做稠密调参通常仍是最好的;
- 迁移的有效性取决于初始化方式——静态迁移随生长因子增大而变差(Scratch 与 SZP 都如此),而 Net2Net 因为函数保持的性质对静态迁移更鲁棒;
- µP 迁移在所有 run 类型上都稳定接近稠密网格的最优,并一致优于静态迁移。
这直接决定了后续所有重算力实验(尤其是 LLM run)统一采用 µP 迁移。
另一个重要观察在这里已经埋下伏笔:随着生长因子增大,Scratch / Net2Net / SZP 三者在稠密网格下能达到的最优损失开始收敛——这正是 §4.2 要展开的 WS 实践上限。
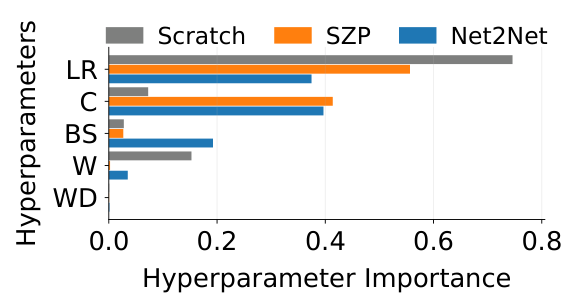
fANOVA 的超参重要性分析显示:学习率在所有设定下都是绝对主导项,其次是学习率调度形状(主要是 cooldown 分数,其次是 warmup 分数),而 weight decay 的重要性在所有实验里都接近零。作者把这归因于本基准的小模型 regime——显式 $\ell_2$ 正则相比优化与调度选择影响甚微。
SZP 的收敛表现¶
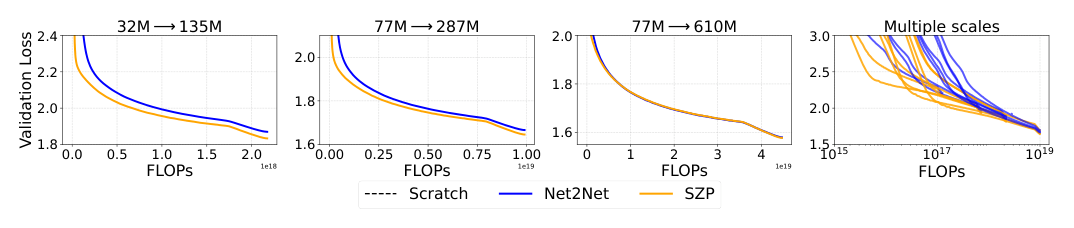
Figure 3 上排(32M→135M、77M→287M、610M→1.2B,以及多尺度汇总)显示 SZP 比 Scratch 收敛更快、最终损失更低;下排(32M→135M、77M→287M、77M→610M)显示 SZP 一致优于 FP 基线 Net2Net。最右列汇总了 10/20/30 tokens/param 三种预算下所有 base-target 配对的学习曲线(学习率调度相同),确认更快收敛在各尺度上都成立。
但本文的核心观察是那个"变化量":WS 操作(Net2Net 与 SZP)的相对收益随生长因子 $g$ 增大而递减。作者给出的机制解释是:基模型通常训练得很充分,其学到的函数占据权重空间的一个子空间,WS 的效率收益正来自对这个子空间的利用(信号保持);而对依赖 clone 的 FP 方法,由于生长权重中固有的对称性,这个子空间很难逃离。Appendix 的 Figure 7(右)用更低的 Net2Net 有效秩印证了这一点:把权重位移分解为径向(沿初始化方向)与角向(正交方向)两个分量后,SZP 的注意力层同时表现出旋转与缩放,而 Net2Net 的径向分量要稳定得多、权重调整以旋转为主。
核心发现:有界的有效生长因子 $g_{\text{upper}}$¶
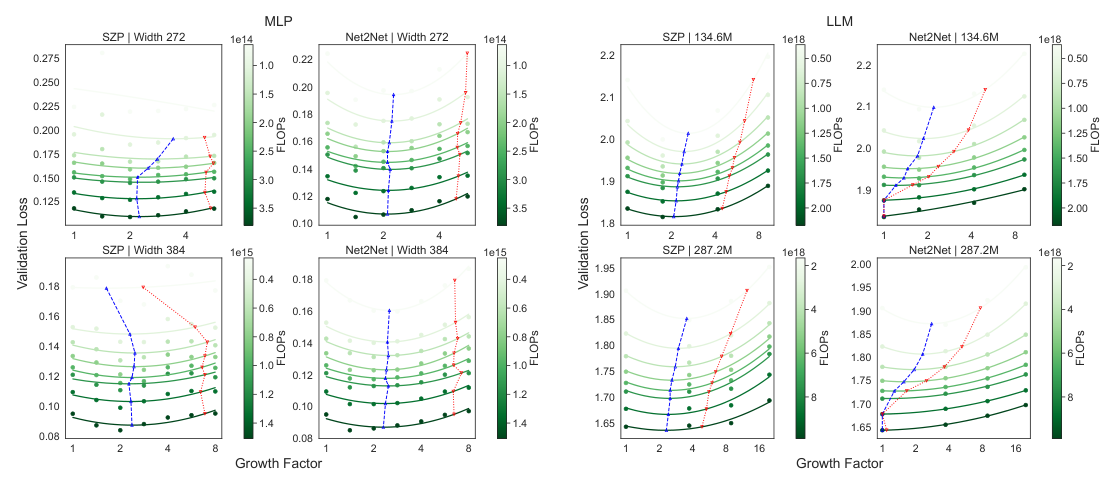
先前工作(Du et al., 2024)用 $g_{\text{opt}}$(对 IsoFLOP 损失做二次拟合后取极小值)来刻画 WS 与生长因子的关系。本文对此提出了明确的方法论批评:$g_{\text{opt}}$ 这种基于优化的刻画很难从稀疏采样中得到可靠支撑——要可靠识别 $g_{\text{opt}}$ 需要在 $g \in (1, g_{\text{opt}})$ 区间做密得多的测量。而且 Appendix H.1 补充了一个更根本的质疑:由于 $g = 1$ 对应的是"从头训"而非"从同尺寸模型 WS",二次拟合假设的那个极小值可能本身就是这个概念错位造成的假象。
作者转而提出 $g_{\text{upper}}$:WS 仍能改善 Scratch 最终验证损失的最大生长因子。读取方式极简:从 $g=1$ 处画一条水平线,交抛物线于某个 $g > 1$,那就是 $g_{\text{upper}}$。
Figure 4 在 LLM(134.6M、287.2M 目标)与 MLP(width 272、384)两套设定上重现了这个量,$g_{\text{upper}}$ 在所有设定下都被观察到。唯一的例外是 LLM 设定下的 Net2Net,其 $g_{\text{upper}} = 1$——也就是说,在完整调度预算跑完(含学习率衰减)后,Scratch 最终反超了 Net2Net。这与 Du et al. (2024) 的报告一致,也凸显了函数保持方法在更复杂架构上的短板。
作者对这一现象的解释:WS 把目标模型放进了一个由基模型学到的表征塑造的损失景观区域。$g$ 小时这个初始化提供了一个有利于高效收敛的盆地;$g$ 增大时基模型在目标架构中所占的比例递减,初始化越来越像随机初始化;超过 $g_{\text{upper}}$,继承结构施加的约束就压倒了它的收益,把 warmstarted 模型锚死在次优区域。
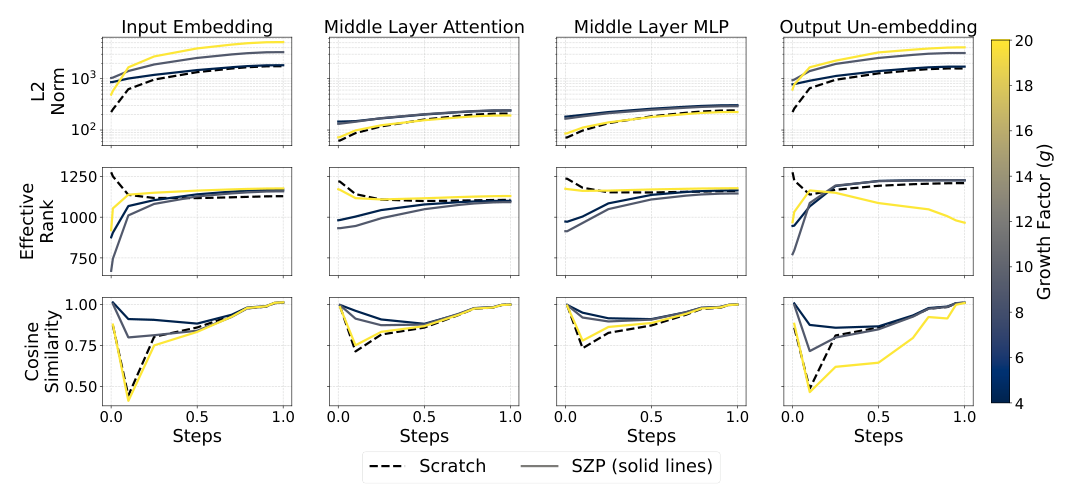
机制可解释性分析支持了这个解释:在 286M 模型上追踪输入嵌入、中层注意力/MLP、输出解嵌入的 L2 范数、有效秩与相邻 checkpoint 的余弦相似度,$g$ 越大,WS 的各项指标越趋近 Scratch,即基模型结构被逐渐稀释。作者还强调了一个重要推论:$g_{\text{upper}}$ 在不同模型规模上是稳定的——warmstarted 表征收敛到 Scratch 式行为的速率主要取决于架构比 $g$,而非绝对模型尺寸。
实践建议:当预算不允许探查 $g_{\text{upper}}$ 时,推荐 $g = 2$ 作为保守默认值。作者顺带批评了文献惯例:大量 WS 工作(Samragh et al., 2024;Ma et al., 2026)就固定用 2× 生长,却从不讨论 $g_{\text{upper}}$。
Scaling law 拟合与"何时该从头训"的等值线¶
作者取 $g \approx 2$ 的子集数据,按 Hoffmann et al. (2022) 的 Approach 3 拟合幂律参数形式:
$$L(N, D) = E + \frac{A}{N^{\alpha}} + \frac{B}{D^{\beta}} \tag{14}$$
其中 $E, A, \alpha, B, \beta$ 通过在 $\log L$ 上以 L-BFGS-B 优化 Huber loss($\delta = 10^{-3}$)拟合。对 Scratch、SZP、Net2Net 在 LLM 与 MLP 两套设定上各拟合一条,拟合参数与质量如下:
| LLM SZP | LLM Net2Net | LLM Scratch | MLP SZP | MLP Net2Net | MLP Scratch | |
|---|---|---|---|---|---|---|
| $A$ | 1038 | 1739 | 18807 | 10484 | 424 | 1437 |
| $\alpha$ | 0.439 | 0.474 | 0.629 | 1.027 | 0.737 | 0.908 |
| $B$ | 68 | 194 | 96 | 774 | 427 | 87 |
| $\beta$ | 0.257 | 0.311 | 0.267 | 0.578 | 0.555 | 0.424 |
| $E$ | 1.278 | 1.377 | 1.395 | 0.075 | 0.074 | 0.065 |
| $R^2$ | 0.9999 | 0.9929 | 0.9922 | 0.9994 | 0.9929 | 0.9922 |
所有 $R^2$ 均超过 0.99。这里有一处值得单独指出的信号:LLM 设定下 SZP 的不可约损失项 $E = 1.278$ 明显低于 Scratch 的 $1.395$ 与 Net2Net 的 $1.377$,而 SZP 的参数指数 $\alpha = 0.439$ 又小于 Scratch 的 $0.629$——即 WS 拉低了地板但也压平了参数缩放的斜率,这正是"优势随规模递减"在参数层面的体现。
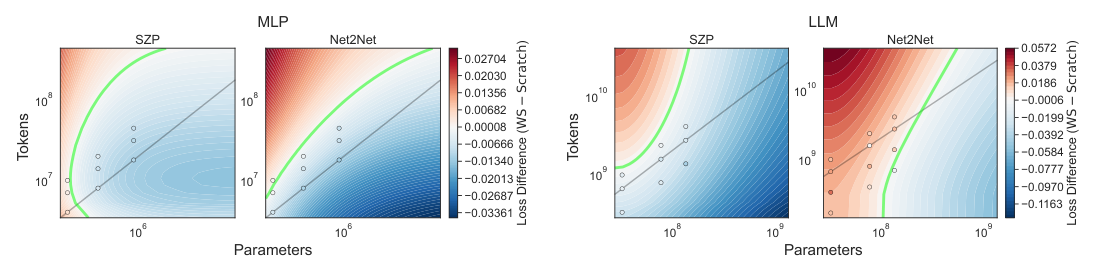
把 WS 与 Scratch 两张拟合曲面相减、画出等损失差的等值线(绿线为零差边界),Figure 5 给出两条结论:
- 零差边界在 MLP 与 LLM 上都存在,即确实存在 Scratch 优于 WS 的区域;
- 边界相对 Chinchilla 最优 tokens/param 前沿(黑实线)的位置表明:训练 tokens/param 越少,越可能保住 WS 的收益。固定模型尺寸时,tokens/parameter 越多,越应该偏向 Scratch。
分方法看:MLP 设定下 Net2Net 给出了清晰的 WS 收益前沿(符合预期,FP 本就是为 MLP 设计的),但 SZP 的有效区间更大,损失差前沿被推得离 Chinchilla 最优前沿更远;LLM 设定下 Net2Net 只剩一小块预测收益区,而 SZP 仍给出一个像样的前沿。
下游任务 sanity check¶
作者用 LIGHTEVAL 在 1.2B checkpoint 上评了六个多选基准(ARC-Challenge 25-shot、HellaSwag 10-shot、MMLU 5-shot、WinoGrande 5-shot 遵循 Open LLM Leaderboard v1 设定;OpenBookQA 与 PIQA 为 0-shot):
| Method | ARC-C | HSwag | MMLU | OBQA | PIQA | WinoG. |
|---|---|---|---|---|---|---|
| Scratch | 17.7 | 27.4 | 26.0 | 13.4 | 60.2 | 51.0 |
| SZP | 20.1 | 29.4 | 26.4 | 15.8 | 64.6 | 53.0 |
六项全面改善,说明预训练曲线上的优化优势确实传导到了下游行为。但作者自己也诚实标注:每个方法只有单一 checkpoint、没有多种子、没有显著性检验,因此只能当 sanity check 而非确定性的下游性能结论。
消融与分析¶
扰动尺度 $\sigma_{\text{perturb}}$¶
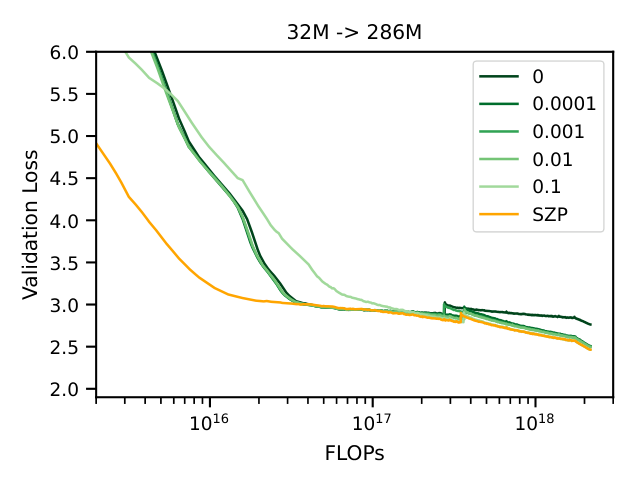
在 32M→286M 的迁移上扫描扰动尺度(其余 SZP 设置固定),默认取 $\sigma_{\text{perturb}} = 1/\sqrt{\text{width}}$:
| $\sigma_{\text{perturb}}$ | 0 | $10^{-4}$ | $10^{-3}$ | $10^{-2}$ | $10^{-1}$ | SZP ($1/\sqrt{\text{width}}$) |
|---|---|---|---|---|---|---|
| Final validation loss | 2.76 | 2.50 | 2.50 | 2.49 | 2.46 | 2.46 |
无扰动时性能显著更差(2.76 vs 2.46),印证了理论部分的判断:纯零填充无法激活新增容量。非零扰动同时改善收敛与最终损失,默认的 $1/\sqrt{\text{width}}$ 匹配了扫描中的最佳最终性能,且学习曲线显示它比多数固定尺度更早进入低损失区。作者的额外观察:噪声尺度对收敛速率的影响大于对最终泛化损失的影响。
收缩因子 $\lambda_{\text{shrink}}$¶
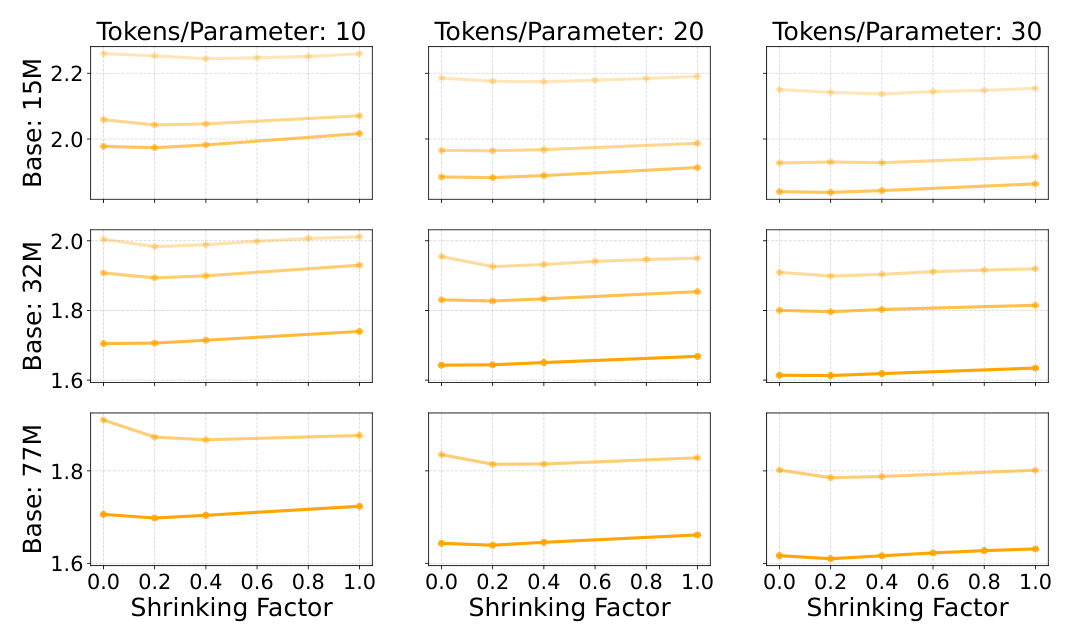
在三个基 checkpoint(15M / 32M / 77M)× 三种 token 预算(10/20/30)× 多个目标尺度上扫描 $\lambda_{\text{shrink}}$:最优值集中在低到中等收缩区间,典型为 $\lambda_{\text{shrink}} \in \{0.2, 0.4\}$。$\lambda_{\text{shrink}}$ 太接近 1 相当于不收缩,生长后模型被继承通路支配;太接近 0 又抹掉了太多预训练信号,退化成"只有扰动的生长"。0.2–0.4 附近的宽平最小值说明收缩有用但不需要精调。主实验统一取 $\lambda_{\text{shrink}} = 0.4$。
作者把这一设计与持续学习文献做了对接:DASH(Shin et al., 2024)同样用收缩缓解可塑性损失,但采用方向感知的方式——与有用特征相关的权重保留得更多,被归因为记忆噪声的分量收缩得更狠。SZP 刻意只用一个全局收缩因子,代价是不够精细,收益是架构无关、可与任意生长算子自由组合。它也可以被看作 weight clipping(Elsayed et al., 2024)这类范数控制原则的一次性初始化时刻的类比。
权重统计的机制分析¶
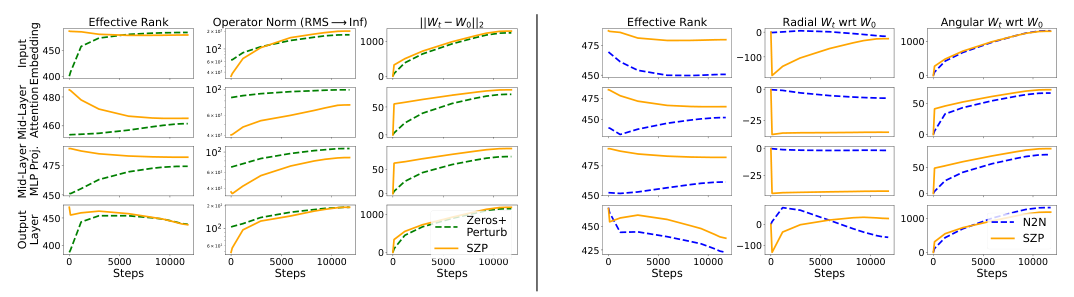
在 14M→77M 上追踪输入嵌入、中层注意力/MLP、输出解嵌入的权重统计。作者用 RMS→$L_\infty$ 算子范数(行 $L_2$ 范数最大值除以输入宽度平方根)作为比 $L_1$/$L_2$ 更有信息量的代理,理由是它对跨尺度迁移学习动力学至关重要(Filatov et al., 2025;Pethick et al., 2025)。结论:收缩不仅通过权重范数钳制保住了学到的函数(与可塑性提升相关),还提高了注意力层的有效秩(新神经元利用率更好),并允许模型从初始化处移动更远($\|W_t - W_0\|_2$ 更大)。这一点很关键——单靠零填充或克隆并不能充分打破新旧神经元之间的对称性,会把生长后模型在函数空间里困在离基模型太近的位置,表现为 Figure 1 里的损失饱和。
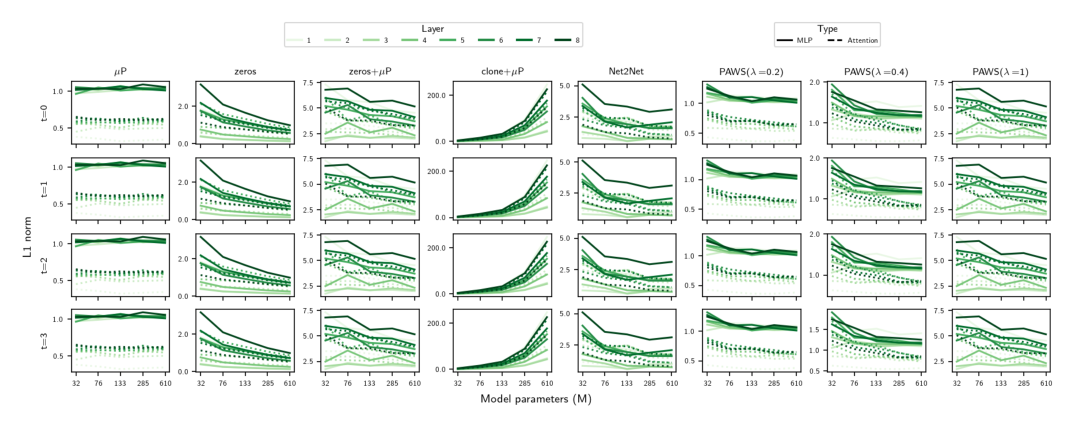
激活范数分析显示:在较大宽度上多数情况的激活会变得稳定且随宽度近似恒定(SZP 在 $\lambda_{\text{shrink}} = 0.2$ 时尤其明显),满足稳定超参迁移的条件。唯一出现随宽度增长而失控的不稳定的是把 Clone 单独作为 $G$ 的情形。
架构泛化:LLaMA 风格解码器¶
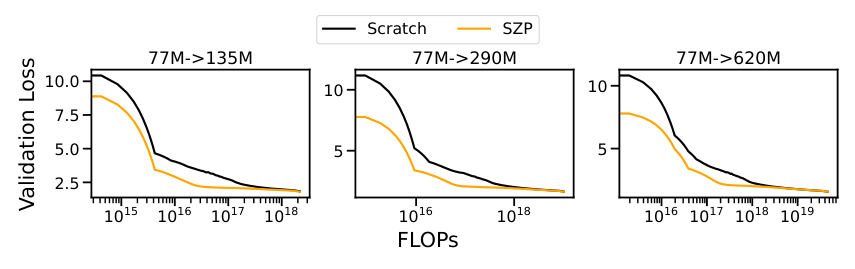
为验证 SZP 的行为不是 GPT-2 风格架构特有,作者在 LLaMA 风格解码器上重跑对比(77M→135M、77M→290M、77M→620M),保持相同的 20 tokens/param 预算与相同的基尺度超参选择协议,两者唯一的差别就是初始化。结果显示 SZP 在所有目标尺寸上都一致改善早期收敛,说明收益不绑定于特定的 decoder 实现。
用 scaling law 比较两种 WS 方法¶
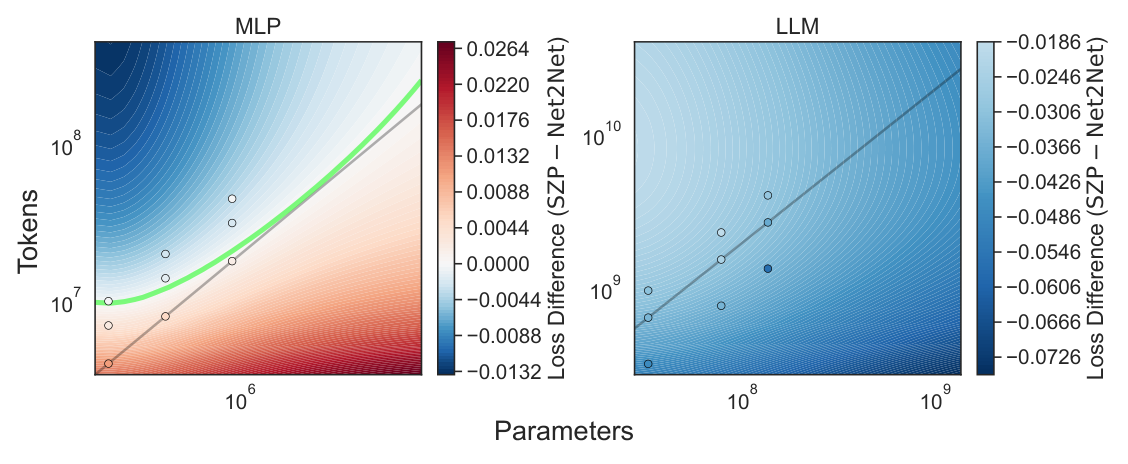
同一套拟合方法还能用来比较两种 WS 方法。LLM 设定下 SZP 被预测在所有配置上都优于 Net2Net;MLP 设定下 Net2Net 在低 token 预算处有竞争力(此时其函数保持性质收益最大),但 SZP 在更大的 token 预算下被预测更优。这与两者的设计取向完全吻合:Net2Net 保持基模型函数,因而有即时优势;SZP 让新神经元真正投入使用,随着训练预算增大、模型有更多空间去适应,这一优势才逐渐兑现。作者由此强调:scaling law 拟合能提供比"单一训练预算下的评测"丰富得多的方法间比较。
核心贡献总结¶
- 把 WS 生长算子解构成 growth × shrink × perturb 三个独立轴,用一个统一公式 (2) 覆盖了 FP 类算子的三大成分,并且对所有权重(1D/2D)一视同仁——从而摆脱了架构特化规则。
- 证伪了"初始化时函数保持是 WS 有效的必要条件":架构无关的 SZP 在 LLM 设定下一致胜过 FP 代表 Net2Net,后者在 LLM 上甚至 $g_{\text{upper}} = 1$(完全失去优势)。
- 提出并系统测量 $g_{\text{upper}}$,取代此前不可靠的 $g_{\text{opt}}$,并指出这个界在先前已发表的结果中其实早已存在,只是从未被报告。
- 用 Chinchilla 式 scaling law 把"何时该 WS"变成可预测的问题:两条拟合曲面之差的零等值线,就是 WS 与 Scratch 的分界。
- 给出四条可直接执行的实践准则:只能跑一次就取 $g = 2$;WS 应在 $\le 20$ tokens/param(即 compute-optimal 或以下)时优先;µP 是 WS 场景下的原则性超参迁移策略;未来 WS 文献应显式报告 $g_{\text{upper}}$ 并考虑收益递减的 scaling 模式。
与已归档相关工作的对比¶
Parcae Parcae: Scaling Laws For Stable Looped Language Models(UC San Diego + Together AI,2026-04-14)¶
关系:独立并发(本文投稿于 2026-05-13,Parcae 早约一个月;本文正文与参考文献中均无 Parcae、looping、recurrence 相关条目,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在追问同一个 root cause——除了"堆参数 + 堆数据"这两条 Chinchilla 正统轴之外,还存在一条「复用已有计算/结构」的扩展轴,它到底值不值得用、该用多少。本文复用的是一个训练好的小 checkpoint 的权重(沿宽度方向生长);Parcae 复用的是同一组层在深度方向的重复执行(layer looping,参数量不变而 FLOPs 线性增长)。两者都指出这条轴此前"经验上有人试、但缺乏可预测的定量刻画",因而进不了生产流水线。
- 相近的技术骨架:方法流程图几乎可以抽象重合——引入一个复用旋钮(本文的 $g$ / Parcae 的循环次数 $\mu_{\text{rec}}$)→ 在固定 FLOP 预算下做 IsoFLOP 扫描并对损失做二次拟合 → 从抛物线上读出这条轴的最优点或饱和点 → 再套 Chinchilla 参数形式 $L = E + A N^{-\alpha} + B D^{-\beta}$ 拟合出可外推的预测律 → 把律翻译成给实践者的分配建议。连细节都撞上了:本文的 $g_{\text{opt}}$/$g_{\text{upper}}$ 与 Parcae 的 $\mu_{\text{rec}}^\star$ 都是从 IsoFLOP 抛物线极值读出的量,两篇的拟合都用 Huber loss + L-BFGS,两篇的 $R^2$/外推误差都被单列为可信度证据(本文 $R^2 > 0.99$;Parcae 外推误差 0.8%–1.3%)。
- 本文的差异与推进:结论方向相反且互补。Parcae 论证的是"循环这条轴是一条正交且有效的扩展轴"——IsoFLOP 曲线存在明确的内部极小值,最优循环次数随算力遵循幂律 $\mu_{\text{rec}}^\star \propto C^{0.40}$,因此值得沿这条轴投入。本文论证的是"checkpoint 复用这条轴有一个硬上界"——超过 $g_{\text{upper}}$ 后 Scratch 反超,且优势窗口随 token 预算增大而收缩。一正一反恰好构成同一方法论的两个可能结局:同样是 IsoFLOP + 参数律,Parcae 拿到的是"该投多少",本文拿到的是"最多能投到哪"。
- 可比的方法/实验差异:Parcae 直接把复用旋钮并入了参数律(把 $N$ 换成展开循环后的有效参数量 $N(\mu_{\text{rec}})$,并进一步与 test-time 衰减项合成 8 参数统一律 $\hat L = E + X N(\mu_{\text{rec}})^{-x} + Y D^{-y} + Z e^{-zT/\mu_{\text{rec}}}$);本文则是把 $g$ 固定在 $\approx 2$ 之后,对 WS 与 Scratch 分别拟合两条律再作差,靠等值线而不是单一律来定位边界。本文在 Appendix H.1 的 "Toward a Unified Scaling Law" 里把"拟合一条同时涵盖 $N, D, g$ 的统一律"列为 future work——而这正是 Parcae 在循环轴上一个月前已经做完的事,这是两篇并发工作之间最直接的一处方法论落差。另一处差异是规模:本文最大到 1.2B / 182 次 LLM run / 39k–50k GPU-hours,Parcae 最大到 1.3B / 100B token,量级相当。
Prescriptive Scaling Laws for Data Constrained Training Prescriptive Scaling Laws for Data Constrained Training(Cornell University,2026-05-02)¶
关系:独立并发(Cornell 论文早 11 天,本文未引用,两者对"复用的边际收益何时转负"给出结构相同的答案)· 已加载对方精读
- 共同关注的问题:两篇的 root cause 是同一个形状——某种"复用"在小剂量时省算力,剂量过大后不但递减、还会反过来变差;而既有的 Chinchilla 框架无法表达这个转折点,导致实践者拿不到可执行的阈值。本文复用的是训练好的权重(warmstarting 一个 checkpoint);Cornell 复用的是训练数据(数据受限下的多 epoch 重复)。两篇都明确指出既有工作只描述了"递减回报"而没有刻画"何时该停":本文批评 $g_{\text{opt}}$ 这一优化式刻画不可靠、且文献普遍固定 2× 生长却从不讨论上界;Cornell 批评 Muennighoff 的 effective-data 公式从不建议停止重复,最多趋于平台。
- 相近的技术骨架:都是 「控制变量的大网格 → 在 Chinchilla 形式上做拟合 → 读出一个交叉阈值 → 把阈值翻译成分配处方」。两篇的基座公式完全相同(本文式 (14),Cornell 精读式 (1):$L(N,D) = E + A/N^\alpha + B/D^\beta$);两篇都刻意把结论浓缩成一个可跨配置横向对比的单一标量——本文是 $g_{\text{upper}}$,Cornell 是过拟合惩罚系数 $P$;两篇都呼吁社区把这个标量当作标准报告项。规模上也接近:Cornell 训了 300+ 模型(15M–1B 参数、50M–6B unique token、最高 16 epoch),本文 182 次 LLM run(14M–1.2B)加 2934 次 MLP run。
- 本文的差异与推进:处理转折点的技术手段不同。Cornell 走的是"改写律本身"的路线——在 Chinchilla 上加一个显式的加性过拟合惩罚项,并按 1p/2p/4p 的复杂度阶梯给出 Pareto 前沿,最完整的形式是 $L = E + A/N^\alpha + B/(U_D(1+R_D))^\beta + P \cdot R_D^\delta \cdot (N/U_D^\gamma)^\kappa$,单参数版本就把多 epoch 的 $R^2$ 从 0.58 抬到 0.95。本文则不改律的形式,而是走"拟合两条律再作差"的路线:对 WS 与 Scratch 各拟合一条标准 Chinchilla 式,用差值曲面的零等值线定位边界。Cornell 的做法能把转折点封装进单一闭式、便于外推与解释(例如把强 weight decay 削减 $P$ 约 70% 直接量化为"配置鲁棒性");本文的做法更保守但门槛更低——不需要为每种复用机制猜一个惩罚项的函数形式,代价是无法从单一律里解析地解出边界位置。
- 可比的方法/实验差异:Cornell 做了本文没做的一步处方验证——把每条 law 推荐的最优配置真的训出来做对比(例如 $U_D = 500$M、$C = 2\times10^{19}$ 时,本文 law 推荐 2.2B × 3 epoch,perplexity 17.73,明显优于 Chinchilla 推荐的 670M × 10 epoch 的 18.90),这是"prescriptive"三个字的实证兑现。本文的处方($g = 2$、$\le 20$ tokens/param)只由拟合与 IsoFLOP 观测支撑,没有"按处方训一次以验证"的闭环实验——这是本文可以直接借鉴 Cornell 的地方。反过来,本文有 Cornell 没有的机制层证据(有效秩、径向/角向权重位移、跨 $g$ 的可解释性追踪),能解释为什么复用的收益会衰减,而不只是拟合出它衰减。另外两篇的分配建议方向恰好呼应:Cornell 说"算力过阈值后应放大模型、减少 epoch",本文说"token 预算越大越该改从头训"——都是在建议超过某点后放弃复用、把算力投向"新鲜"的那一侧。
讨论与局限性¶
核心贡献的价值在于它是一篇罕见的、把方法论批评落到可执行数字上的实证研究。$g_{\text{upper}}$ 这个量本身不算全新发现(作者自己承认 Du et al., 2024 的结果里已经隐含了它),但把它从"隐含在图里"提升为"必须报告的标准量",并论证 $g_{\text{opt}}$ 的不可靠性,是实打实的方法论贡献。同样值得借鉴的是"用 scaling law 曲面之差来比较两个训练范式"这一套工具——它把"A 比 B 好吗"这个在单点预算下无从回答的问题,变成了一张可读的边界图。
几处明确的局限:
- 只做宽度生长,没有深度。作者自己在 Limitations 里承认这一点,理由是超参迁移与 scaling 行为的研究需要在宽度、训练时长、迁移设定上做大量扫描,加上深度会让算力不可承受。但真实的模型扩容几乎总是宽度与深度联动,而 Du et al. (2024) 已经指出联合缩放需要独立选择宽度与深度生长算子——SZP 在深度轴上是否同样有效、$g_{\text{upper}}$ 在复合缩放下是否还稳定,完全是未知数。
- 只比了两个生长算子。SZP vs Net2Net 的对比虽然干净,但 Net2Net 是 2016 年的方法;learned growth(Wang et al., 2023a 的 Kronecker 算子)、GradMax、以及需要 warmstart 优化器状态的 full-state 方法都被排除在外。"简单方法胜过复杂算子"这个结论的强度,因此只在"简单方法 vs 一个经典 FP 算子"的范围内成立。
- 规模上限 1.2B,且 1.2B 只有 2 次 run。作者辩称 sub-1B 的趋势与文献中 1B+ 的报告一致,暗示可迁移到更大 regime,但这终究是外推。考虑到本文的核心论点恰恰是"收益随规模递减",在最大规模上样本最稀疏是一个结构性的尴尬。
- 下游评测只是 sanity check。单 checkpoint、无多种子、无显著性检验,作者标注得很诚实,但这也意味着"WS 的优势能传导到下游"这个说法目前只有 1.2B 上一次观测的支撑。
- 黑箱基模型假设是双刃剑。把基模型的训练算力当未知量确实更贴近现实,但代价是无法分析"基模型规模 × 目标模型规模 × 两阶段各自投入的 token"这个联合 compute-optimal 前沿——而这恰恰是一个真正想省算力的团队最关心的问题。Liew & Kato (2025) 走的是另一条路(假设完全掌握基模型历史),两条路线目前谁也没覆盖对方。
- $\lambda_{\text{shrink}} = 0.4$ 与 $\sigma_{\text{perturb}} = 1/\sqrt{\text{width}}$ 是固定值而非可预测规则。消融显示它们不敏感(0.2–0.4 是宽平最小值),但作者在 Future Directions 里也承认,能否用固定规则或 scaling law 拟合来预测性地缩放这两个量仍是开放问题。
工业落地价值方面,这篇论文没有任何线上部署或 A/B 数据,是纯学术研究。但它的结论有相当直接的工程可迁移性:任何计划"把线上的小模型扩容到大模型"的团队,都可以直接拿走三条:(a) 保守取 $g = 2$;(b) 若目标训练预算显著超过 20 tokens/param,先怀疑 WS 是否还划算;(c) 跨宽度迁移超参统一走 µP,不要静态照搬。对推荐/广告场景的大模型扩容(例如把一个已上线的排序骨干从 1B 扩到 4B)而言,"$g_{\text{upper}}$ 随架构比而非绝对尺寸稳定"这个观察尤其有用——它意味着在小规模上花少量算力测出的 $g_{\text{upper}}$,有希望直接外推到生产规模。
方法论可扩展性上,本文的框架本身是良性的:设计空间 (2) 对任意架构开放,scaling law 差值等值线的工具可以套到任何"新范式 vs 旧范式"的比较上。真正的天花板不在框架,而在只做宽度、只比两个算子、$g$ 被固定后才拟合律这三处实验层面的收缩——其中第三点作者已在 Appendix H.1 列为下一步(拟合统一的 $L(N, D, g)$),而这一步在并发的 Parcae 上已经被证明是可行的。