Small-Scale Experiments: Are We There Yet?¶
FAIR at MSL Meta + NYU(Nicholas Lourie, Kyunghyun Cho, Karen Ullrich, Sanae Lotfi)。论文的靶子是一条已经被领域广泛接受的"常识":小规模实验(≤100M 参数)拟合出的 scaling law 不可靠,因此要做可信的模型侧研究就绕不开大模型。作者给出的反驳是——这条常识把混淆因子当成了本质:小模型的 scaling law 一直都在,只是它只出现在完全调优的前沿(fully tuned frontier)上,而小模型对超参极度敏感,要摸到那条前沿需要远超常人实践的搜索量。全文用 4M–268M 有效参数上约 4000 次随机搜索训练把这件事量化,进而解释"为什么大模型好调"(超参损失面的内蕴维度随规模下降),最后把三件工具打包成一套小规模实验方法论,并在"归一化层放前还是放后"这个当年花了领域三年才定论的问题上做端到端验证。
研究动机与背景¶
基础模型这五年的核心变量是 scale,而 scale 让实验极其昂贵——如今实验本身(而非最终那次训练)已经主导了模型研发的总开销(Cottier et al., 2025;Denain and Wu, 2026)。自然的解法是"小规模做实验、结论迁移到大规模",这也是 scaling law(Kaplan et al., 2020)最初的承诺。但半个十年过去,这个承诺没有兑现。
失败的现场很具体。文献中最有影响力的两项工作给出了互相矛盾的结论:Kaplan et al. (2020) 认为参数应当比数据增长快得多,直接导致早期语言模型普遍训练不足(Brown et al., 2020;Rae et al., 2022;Chowdhery et al., 2023);Hoffmann et al. (2022) 则发现参数与数据应当同速增长。Porian et al. (2024) 把这个分歧追溯到方法学选择——是否把 embedding 计入参数、learning rate 预热多久、超参是否随规模重调——而这些选择恰恰不成比例地影响小规模模型(Pearce and Song, 2024)。这场早期的不和谐预示了后来的困难:Li et al. (2025c) 综述文献后发现许多 scaling law 难以复现,尤其基于 100M 参数以下模型的 scaling law 不可靠;Li et al. (2025a) 则把这一处境概括为"scaling gap——小规模实验的洞见常常无法迁移到资源密集的生产系统"。
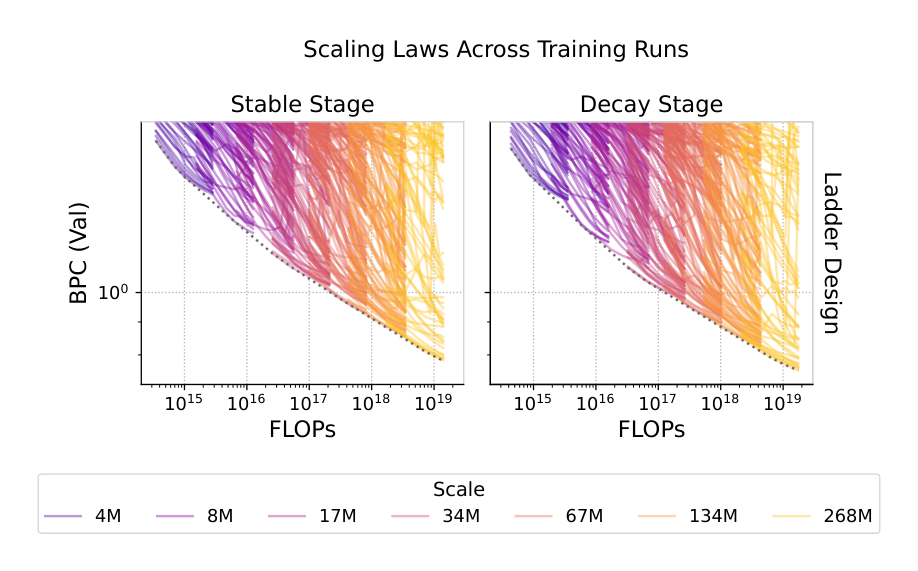
本文的答案分四层:
- 配方里只有一味主料:scaling law 的估计质量对"如何数参数""是否衰减学习率"这类细节相当鲁棒(§3.1),但对严格的超参调优极端敏感(§3.2)。常见做法在小网格上调参,而要在小模型上让 scaling law 显形,可能需要搜索数百个配置。
- scaling law 向下延伸得远超预期:低至 4M 有效参数(单卡不到一小时训完)仍然成立,这把成本压到了绝大多数学术与工业实验室都负担得起的范围。
- 给出"为什么":随着参数与数据一起增长,近最优配置占据的空间体积变大(§4.1),其几何机制是超参损失面的内蕴维度下降(§4.2)——参数带来的"维度之福"治好了超参上的"维度之咒",模型足够大时有效超参数个数掉到 1。作者的总结很精炼:小规模让你有能力充分探索超参损失面,大规模让这种探索变得不必要。
- 打包成方法论(§5),并诚实标出它的统计边界:小规模上 scaling law 存在,但纯外推会放大采样误差,不能只看谁外推出的最终 loss 更低。
背景:方法论的三条支柱¶
支柱一:noisy quadratic limit(判断"调够了没有")¶
Lourie et al. (2025a) 发现,在最优点附近,超参损失面具有三条性质:二次(二阶 Taylor 展开是良好近似)、低秩(少数几个方向解释绝大部分变化)、正态(围绕均值的加性正态噪声)。经验上这个近似在最优点周围一个相当大的区域内成立,该区域称为渐近区(asymptotic regime),调参难度、可达最佳性能这类实际问题都由它决定。
形式化地,记 $X$ 为超参、$Y$ 为验证分数、$(x^*, y^*)$ 为最优点、$H_{x^*}$ 为 Hessian:
$$L(X) \approx y^* + (X - x^*)^T H_{x^*} (X - x^*) + E, \qquad E \sim \mathcal{N}(0, \sigma) \tag{1}$$
这个条件视角在随机搜索中诱导出一个边际结构:搜索产生一个验证分数的分布,其尾部收敛到noisy quadratic 分布 $Q_{\min}(\alpha, \beta, \gamma, \sigma)$。记 $F(y; \alpha,\beta,\gamma,\sigma)$ 为其 CDF:
$$P(Y \le y) \approx F(y; \alpha, \beta, \gamma, \sigma) \qquad \text{as} \quad y \to y^* \tag{2}$$
四个参数各有明确含义:$\alpha$ 是可达的最佳性能(即 $y^*$),$\beta$ 度量分数向它集中的紧密程度,$\gamma$ 给出有效超参数个数(最优点处的内蕴维度),$\sigma$ 是随机种子带来的噪声。实践中用一个期望损失阈值 $\mathbb{E}[Y \mid X] \le \theta$ 来划定渐近区。
这个边际视角是全篇方法论可行的关键:高维损失面本身难以估计,但只用一个标量阈值就能定位渐近区,彻底绕开了估 Hessian 这件事。
支柱二:scaling law¶
沿用 Hoffmann et al. (2022) 推广的函数形式(Rosenfeld et al., 2020),把参数 $p$、数据 $d$ 与预训练 loss $L$ 关联:
$$L(p, d) = \epsilon + \frac{\zeta}{p^{\iota}} + \frac{\eta}{d^{\kappa}} \tag{3}$$
注意这个形式里没有超参——它描述的正是"完全调优前沿"上的 loss,即给定参数与数据时可达的最佳 loss(Figure 1)。但参数与数据不能独立变化,模型的梯度必须在每个样本上计算,所以两者之积决定总算力:
$$c \propto p\,d \tag{4}$$
在算力预算固定时最小化 Eq. (3),得到最优条件:
$$\frac{\iota\,\zeta}{p^{\iota}} = \frac{\kappa\,\eta}{d^{\kappa}} \tag{5}$$
与 Eq. (4) 联立,最优参数与数据都成为算力的幂律:
$$p \propto c^{\frac{\kappa}{\iota + \kappa}}, \qquad d \propto c^{\frac{\iota}{\iota + \kappa}} \tag{6}$$
代回联合律得到超额 loss 关于算力的幂律:
$$L(p, d) - \epsilon \propto c^{-\frac{\iota\kappa}{\iota + \kappa}} \tag{7}$$
Hoffmann et al. (2022) 发现平衡的参数与数据同速增长——这一结论后被多方复现(Anil et al., 2023;DeepSeek-AI et al., 2024),也正是"token-to-parameter 比"能作为"模型训得好不好"的度量的依据。在 Eq. (5) 下,同速增长只在两个 scaling 指数相等($\iota = \kappa$)时才发生;部分理论工作预测了这一等式(Bahri et al., 2024),实践中估计值也常常接近,因而有人尝试强制它以改善估计(Muennighoff et al., 2025;Li et al., 2025c)。本文会专门消融这个做法。
支柱三:perplexity–capability correspondence¶
预训练上的成功让很多人去找下游任务的 scaling law,但下游行为极不规则:涌现(Wei et al., 2022)、逆向(McKenzie et al., 2023)、甚至 U 形(Wei et al., 2023)。Lourie et al. (2025b) 发现只有约 39% 的任务能可靠 scaling。
出路在于:研究者其实不需要预测能力,只需要一个与能力对应的量。Mayilvahanan et al. (2025) 证明只要预训练数据保持不变,预训练 loss 就与能力对应——即"相同 perplexity 的模型获得相同能力",哪怕这些能力事先无法预知。本文把这一现象命名为 perplexity–capability correspondence。
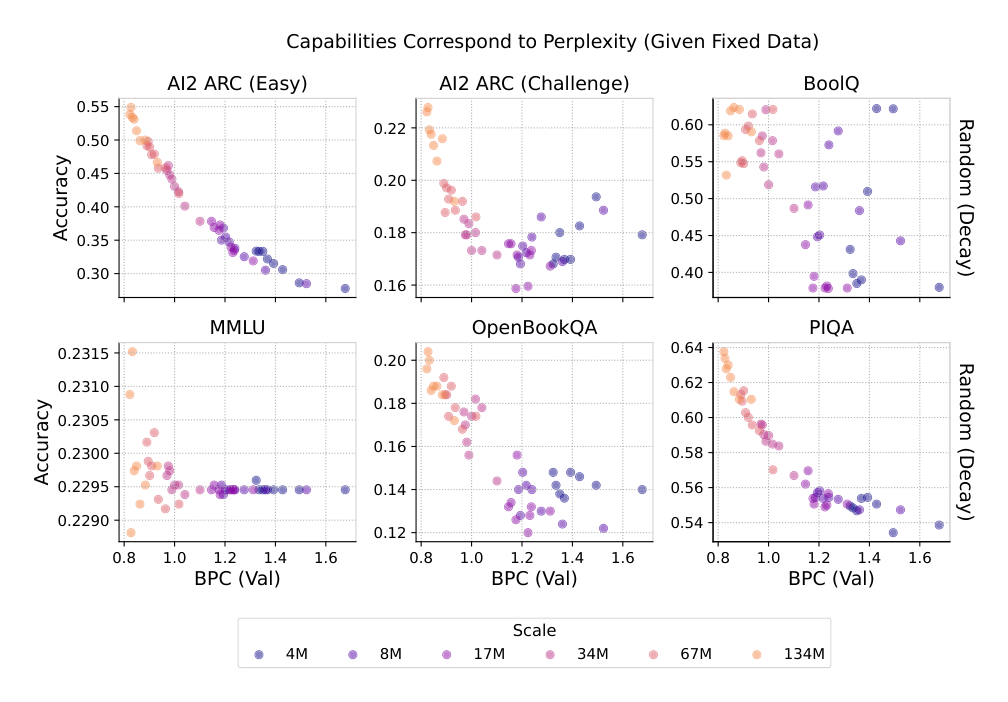
论文给了一个很好的比喻式表述:数据定义了一条能力曲线;loss 决定曲线上的一个点;scaling law 决定到达该点的代价(the scaling law sets the toll)。曲线本身在不同任务间形态各异(Figure 2 中 MMLU 几乎是平的、纵轴只在 0.2290–0.2315 间抖动,ARC-Easy 则从 0.30 单调升到 0.55),但每个任务都存在这条曲线。换言之,一个 scaling law 更好的模型,能以更低成本买到每一个 perplexity,从而买到任何能力。
实验设计¶
- 模型规模度量:使用有效参数(effective parameters),即按 FLOPs 调整后的参数量,使 $c = 6pd$ 精确成立。该计数排除 embedding 层(不产生 FLOPs)但包含 unembedding 层与 attention 的开销(Porian et al., 2024, §B):
$$N_{\text{eff}} := (3 d_{\text{ff}} + 4 d)\,d\,l + d\,v + n\,d\,l \tag{8}$$
其中 $d_{\text{ff}}$ 为 FFN 维度、$d$ 为隐藏维、$l$ 为层数、$v$ 为词表大小、$n$ 为上下文长度。
- 规模范围:$2^{22} \approx 4\text{M}$ 到 $2^{28} \approx 268\text{M}$,按 2 的幂递增;每个规模用两种实验设计构造模型——手工模型阶梯(ladder)与随机采样架构(random)。
- 训练与评估:采用 warmup-stable-decay(WSD)调度(Hu et al., 2024)。沿用 Hägele et al. (2024) 的技巧,复用主 run 的 stable 阶段,从 1/8, 2/8, …, 8/8 处的 checkpoint 分叉出衰减阶段,并在衰减前后都做评估。于是一次 sweep 就以很小的额外代价同时产出 8 个 token 预算下的 stable 与 decay 结果。
- 数据划分:训练(4M–34M)、验证(67M–134M)、测试(268M)。因此所有报告数字衡量的都是从小模型向更大留出模型的外推能力。默认把 Eq. (3) 拟合到每个(参数, 数据)预算对上取得的最佳 loss。与前人一致(Hilton et al., 2023;Li et al., 2025c),作者发现过短的训练 run 拟合很差,因此丢弃两个最小的 token 预算(1/8 与 2/8),这显著改善了验证集表现。
估计小规模 scaling law:什么才是决定性的¶
参数定义的差异几乎无关紧要¶
研究者数参数的方式沿三条轴分歧:是否计入 attention 的 FLOPs、是否计入 embedding、是否计入 unembedding。由于 embedding 与 unembedding 参数量相同,共得到六种不同计数。分歧的哲学根源是"参数 vs 算力"孰轻孰重——attention 在长上下文下消耗更多 FLOPs,而 embedding 层根本不产生 FLOPs。
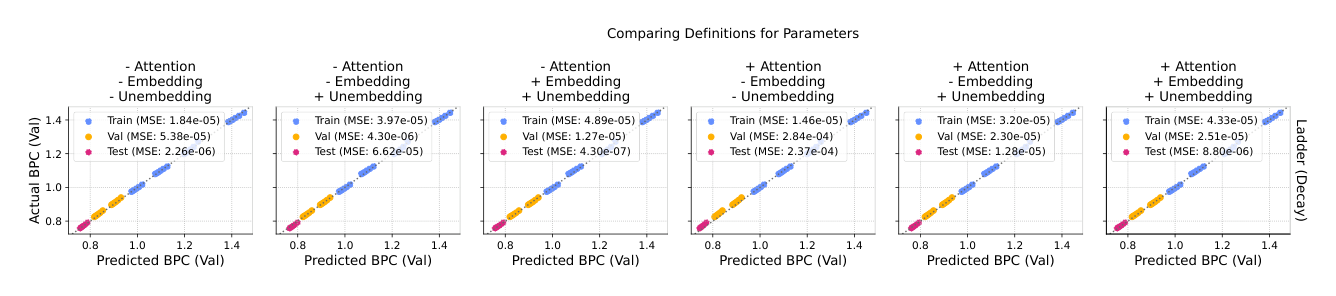
| 参数计数(Attention / Embedding / Unembedding) | Train MSE | Val MSE | Test MSE |
|---|---|---|---|
| − / − / − | 1.84e-05 | 5.38e-05 | 2.26e-06 |
| − / − / + | 3.97e-05 | 4.30e-06 | 6.62e-05 |
| − / + / + | 4.89e-05 | 1.27e-05 | 4.30e-07 |
| + / − / − | 1.46e-05 | 2.84e-04 | 2.37e-04 |
| + / − / + | 3.20e-05 | 2.30e-05 | 1.28e-05 |
| + / + / + | 4.33e-05 | 2.51e-05 | 8.80e-06 |
结论分析:六种计数每一种都给出合理的 scaling law,测试 MSE 全部落在 1e-6 到 2.4e-4 之间,相对后文超参消融跨越两个数量级的差距而言,这点波动微不足道。本文统一采用"+Attention, −Embedding, +Unembedding"的有效参数,理由不是它拟合最好,而是它与每 token 的 FLOPs 直接对应,让 $c = 6pd$ 保持精确。这一节实际上是在给一场长期存在的方法学争论降温:它值得讨论,但它不是 scaling law 成立与否的原因。
其他最佳实践只是"精修",不是"使能"¶
作者在一个朴素做法上逐级叠加三项改进:按每个(参数, 数据)预算调超参、衰减学习率、绑定 scaling 指数。
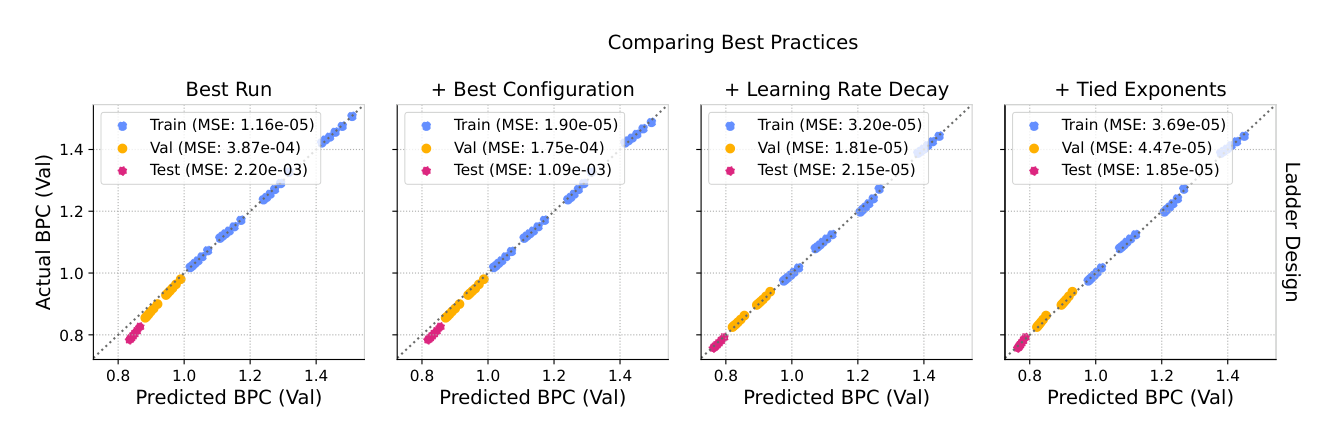
| 方法(逐级叠加,Ladder Design) | Train MSE | Val MSE | Test MSE |
|---|---|---|---|
| Best Run(每规模取最佳 run,不衰减 LR) | 1.16e-05 | 3.87e-04 | 2.20e-03 |
| + Best Configuration(按每个参数–数据预算调参) | 1.90e-05 | 1.75e-04 | 1.09e-03 |
| + Learning Rate Decay | 3.20e-05 | 1.81e-05 | 2.15e-05 |
| + Tied Exponents($\iota = \kappa$) | 3.69e-05 | 4.47e-05 | 1.85e-05 |
结论分析:最朴素的做法下 scaling law 就已经清晰可辨(虽然不精确)。按预算调参把测试 MSE 砍掉约 50%(2.20e-3 → 1.09e-3),衰减学习率则带来戏剧性的 98% 降幅(1.09e-3 → 2.15e-5)——这说明"stable 阶段的 loss"与"完整调度末端的 loss"之间存在系统性偏移,而这个偏移随规模变化,不校正会直接污染指数估计。相比之下,绑定指数是唯一不一致的改进:它让测试 MSE 略降(2.15e-5 → 1.85e-5)却让验证 MSE 变差一倍多(1.81e-5 → 4.47e-5)。作者由此不推荐把 $\iota = \kappa$ 当作稳妥的正则化手段。这些改进对拿到一个好的小规模 scaling law 很重要,但即使全部不做,law 依然在那里。
超参调优是唯一"有无之别"的那一味¶
这是全文最关键的一张图。作者固定评估口径(val 与 test 始终在整个 sweep 的最佳配置上评),只改变拟合时每个规模允许使用的配置数。
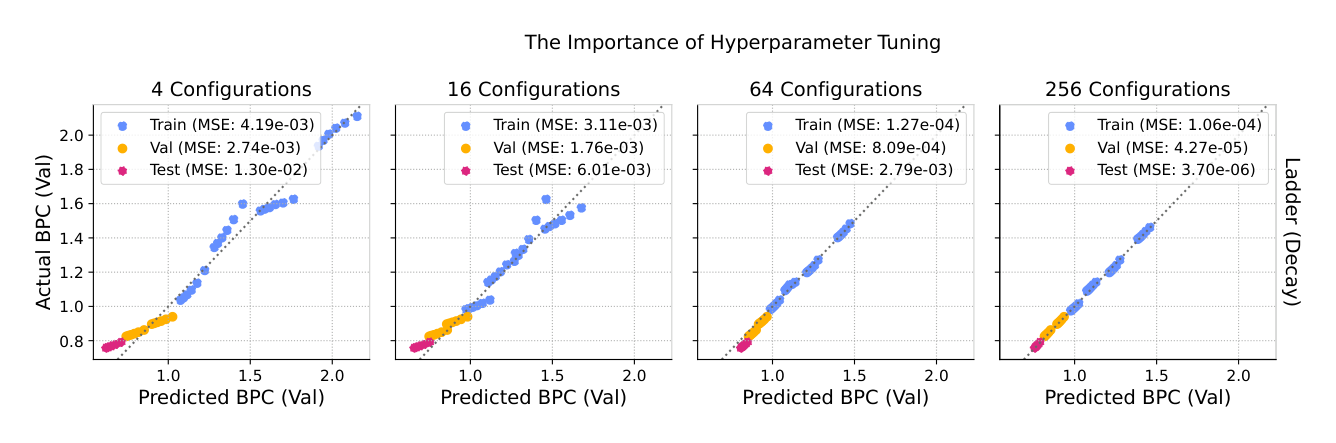
| 每规模配置数(Ladder, Decay) | Train MSE | Val MSE | Test MSE |
|---|---|---|---|
| 4 | 4.19e-03 | 2.74e-03 | 1.30e-02 |
| 16 | 3.11e-03 | 1.76e-03 | 6.01e-03 |
| 64 | 1.27e-04 | 8.09e-04 | 2.79e-03 |
| 256 | 1.06e-04 | 4.27e-05 | 3.70e-06 |
结论分析:4 个配置时 scaling law 完全不存在(测试 MSE 1.30e-2,比 256 配置差了三个半数量级);16 个配置时仍未成形,次优配置注入的噪声让它无法可靠估计;64 个配置时 law 清晰可见但外推很弱;只有到 256 个配置才拿到准确的 law。
与上一节形成尖锐对照:在上一节里,每一项改进都是在一个已经可辨认的 law 上提升精度;而这里,配置太少时根本没有东西可拟合。这条发现直接解释了为什么小规模 scaling law 如此容易被错过——揭示它所需的搜索量远超绝大多数人实际会跑的量。它同时也解释了 Li et al. (2025c) 综述里"小模型 scaling law 不可复现"的观测:那些工作大概率停在了 4–16 个配置的量级上。
超参损失面如何随规模演化¶
调参随规模变容易:近最优配置填满了更大比例的空间¶
找到一个好配置的难度取决于它们占据空间的体积比例。这个体积可以用 Monte Carlo 积分测量:均匀采样配置、统计有多少落在最优点附近——而这个过程恰恰就是随机搜索本身。
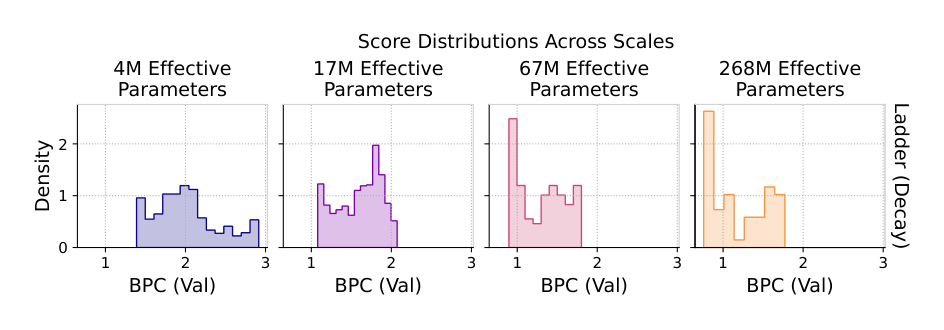
Figure 6 展示了分数分布(取最好的 85% 以排除发散 run)随规模的变化:4M 时分布宽而平,到 268M 时质量堆积成一个紧靠最佳可达 loss 的尖峰。好配置填满了空间,因而越来越容易找到。
参数与数据都在起作用¶
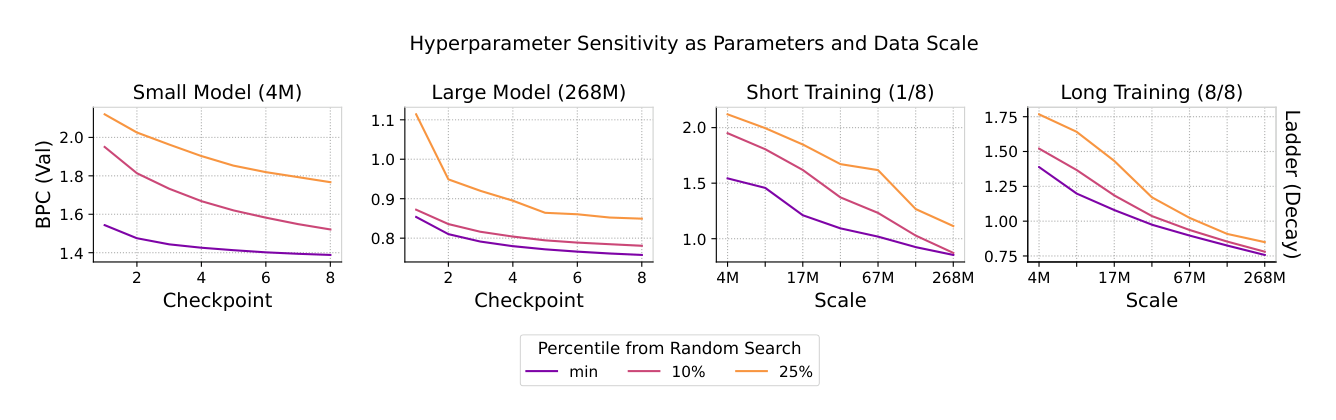
作者画出随机搜索的最小值、第 10 百分位、第 25 百分位验证 loss;第 25 百分位到最小值的间隙直接度量敏感度——间隙小意味着四分之一的随机抽样已经接近最优。四个子图给出的结论很清楚:
- 小模型(4M)上延长训练:loss 下降,但间隙只略微收窄;
- 短训练下增大模型:同样只略微收窄;
- 大模型(268M)上延长训练 或 长训练下增大模型:间隙塌缩。
所以敏感度的下降不是参数或数据单方面的功劳,而是两者协同的结果。
几何机制:损失面的内蕴维度下降¶
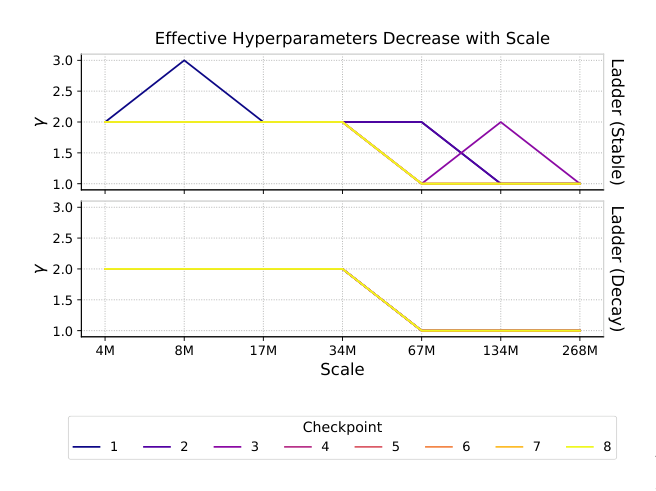
有效超参数个数 $\gamma$ 定义为超参损失面在最优点处的内蕴维度,是调参难度的主要决定因素(Lourie et al., 2025a)。作者对随机搜索结果的尾部(低于阈值 $\theta$ 的全部 loss)拟合 noisy quadratic 分布来估计每个(参数, 数据)预算下的 $\gamma$。Figure 8 的趋势毫不含糊:模型越大,有效超参数越少,最终掉到 1。也就是说,268M 规模的模型在最优点附近实际上只沿一个方向敏感——尽管名义上有 7 个(ladder)或 9 个(random/prenorm/postnorm)超参在被搜索。
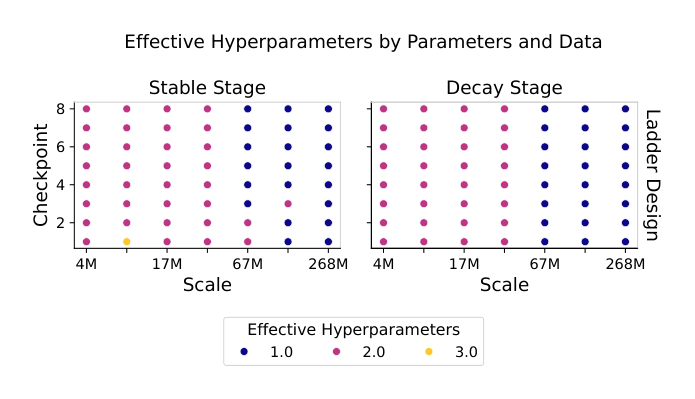
进一步把 $\gamma$ 拆成参数与数据两个维度看(Figure 9,stable 与 decay 两阶段各一张):训练过程中的各个 checkpoint 基本共享同一个内蕴维度,而增大参数明显降低 $\gamma$。结论是参数(而非数据)是降维的主要驱动力。
作者在此处保持了难得的克制,主动点出一个反直觉之处:前人工作发现,在不同架构上使用同一搜索空间时有效超参数个数保持不变(Lourie et al., 2025a, §D)。"$\gamma$ 依赖规模却不依赖架构"看起来是矛盾的;而且在替代参数化(如 maximal update parametrization,Yang et al., 2021)下,规模的影响可能改变。作者的措辞是:所有这些因素大概都会在某个点上影响 $\gamma$,本文的结果只是在典型区间上细化了先验,更好地理解这些边界是有价值的未来方向。
对实验设计的启示¶
超参损失面不是黑箱,它有丰富的定性结构:随参数与数据增长,它变得更好优化、好配置填满空间、内蕴维度下降。
能否从定性走到定量?作者的回答是"自然是慷慨的,但不纵容(nature is generous but not indulgent)"——他们在 §B 里描述了若干可解释模型(还试了更多),简单模型能捕捉损失面的粗略特征,但没有一个能刻画它的精细演化;而且最简单的那个模型(完全忽略超参如何随规模变化)已经是很强的基线。这个结果与定性图景自洽:外推到更大规模时,超参的影响本就更小,剩下可建模的变化也就更少。
由此得到实践处方:小规模高维且不宽容,超参需要广泛搜索;大规模温和且低维,好超参用标准技术就能轻松适配(DeepSeek-AI et al., 2024)。
小规模实验方法论¶
三条事实与四个诊断¶
方法论建立在三条事实之上:(1) 固定预训练数据时,能力只取决于预训练 loss;(2) 有严格超参调优时,预训练 scaling law 一直延伸到极小规模;(3) 随规模增长,模型对超参的敏感度大幅下降。
三者串成一条处方:在小规模上调优并测量,理解预训练 loss 如何变化,然后把赢家搬上去。第一条说能力对应 perplexity,所以可以按"获得该 perplexity 的成本"来评价模型;第二条说预训练律在小规模可观测;第三条说最后的放大是最容易的一步。
关键的方法论创新在于:作者不是假设这些前提成立就完事,而是要求在前提失效时能被检测出来。小规模实验的形态恰好允许这样做——可以利用预期结构、检查它何时失效、并把失效本身变成有用的诊断。例如若 noisy quadratic limit 或 scaling law 中任一个没有显形,那么超参、模型或实现多半有问题。更重要的是,这些诊断建立起的是关于"损失面如何随规模演化"的定性理解,而定性理解至关重要,因为定量方法即便建立在正确结构上也会累积微小误差。
纯外推的陷阱¶
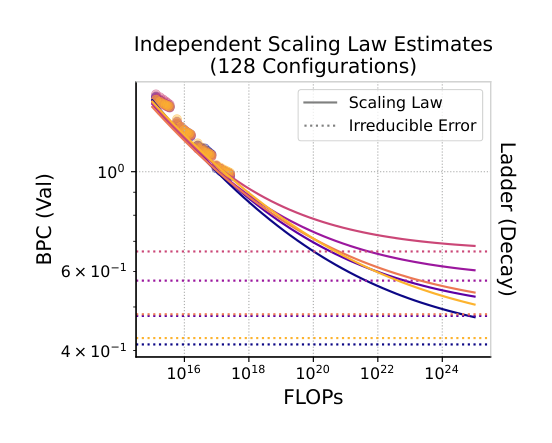
作者用 4M、8M、17M、34M 上各 128 个 run 做出多个独立的 scaling law 估计。在数据附近它们一致性很好,但随着外推距离拉长,曲线扇形散开——因为外推最终反映的是不可降低误差 $\epsilon$ 的估计值,而这个量在不同样本间变化极大。
这条限制的操作含义很硬:如果你靠外推 scaling law 来比较模型,那么在某个点之后你比较的其实是双方对 $\epsilon$ 的估计,而这种估计在律开始饱和之前都不可靠。scaling law 在小规模是存在的,比较它们也是有用的,但你不能简单地挑"外推出的最终 loss 最低"的那个模型。律在那里,统计功效不在那里。律在数据附近可靠得多。
案例研究:pre-norm vs post-norm¶
归一化层该放在残差连接之后(post-norm,Vaswani et al., 2017)还是子层之前(pre-norm,Baevski and Auli, 2018)?这个问题的历史很能说明问题:Nguyen and Salazar (2019) 的实证研究总体倾向 pre-norm,却与今日实践相反地发现 post-norm 在高资源机器翻译上更好;直到 Xiong et al. (2020) 从理论上证明 pre-norm 改善初始化处的梯度,事情才真正定论。pre-norm 的优势在更深的模型上最明显,而深模型实验最贵。领域花了近三年加一份专门的理论分析。作者要用直白的小规模实验把这个答案捞回来。
实验配置:几个分得开的规模远比许多挨得近的规模有信息量,因此只用三个:两个用来拟合、一个用来验证。post-norm 采样 511 配置 @4M、512 @34M、128 @134M;pre-norm 采样 128 @4M、34M、134M(复用 random 实验的结果)。在较小的两个规模上拟合,在最大的规模上评估。
成本论证(这段值得单独记):当参数与数据同速增长时,算力是模型规模的二次函数。因此一次 1B 参数的 run,代价等于 64 次 134M run、1024 次 34M run、或 65,536 次 4M run。整个实验的开销不过相当于几次十亿参数级别的训练。
诊断 1:调得够彻底吗?¶
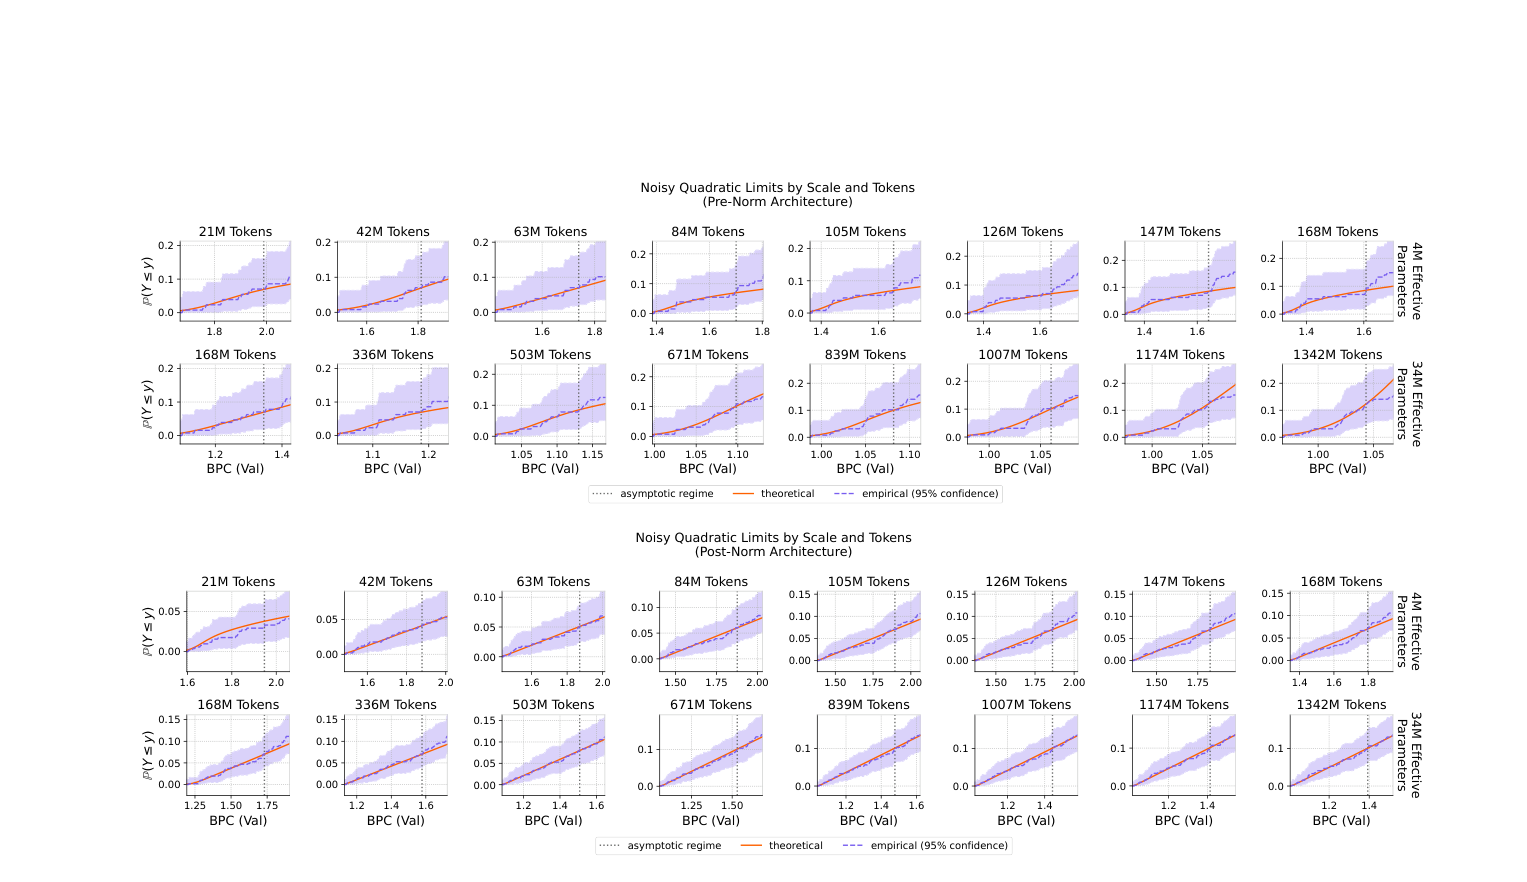
若随机搜索逼近了最优点,分数分布应收敛到 noisy quadratic(§2.1);极限不出现,通常说明搜索错过了最优点。结果:pre-norm 的极限轻松显形;post-norm 也显形,但只在尾部更深处。更小的渐近区是超参敏感度增加的早期信号。作者的评论很到位:我们似乎定位到了最优点,而调参难度本身就是第一个发现——post-norm 对超参敏感,与文献描述一致。
诊断 2:放大规模会容易吗?¶
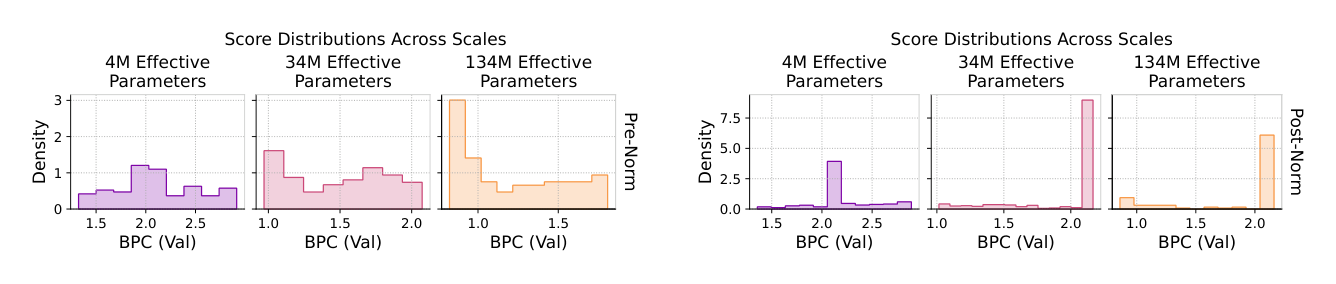
若更大的模型没有变得更不敏感,那么小→大的迁移也可能失败。两种架构的分布都朝正确方向移动,好配置占据更多空间;但 pre-norm 的变化显著,长出一个位于最优点的清晰尖峰;post-norm 只有轻微改善,且在一个次优值处始终残留着第二个尖峰。post-norm 再次暴露调参困难。
诊断 3:perplexity 还跟得住能力吗?¶
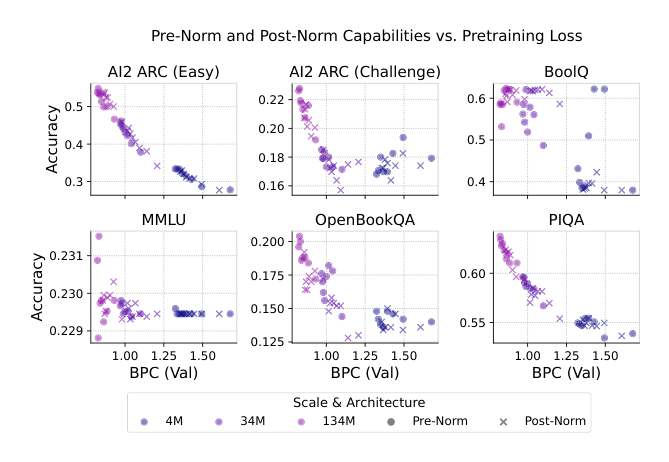
要用预训练 loss 评价模型,它必须与能力对应。这个前提在数据固定时应当成立,而且验证成本极低——在几个任务上评估远比预训练一个模型便宜。任务需要在小规模就有信号,如 AI2 ARC (Easy)。结果:无论架构如何,所有点落在同一条共同趋势上。等 loss 意味着等能力,因而更好的预训练律就意味着更具性价比的模型。这一步是把"比 loss"这件事合法化的关键——如果这张图散开了,后面所有以 loss 为准绳的比较都失效。
诊断 4:scaling law 显形了吗?¶
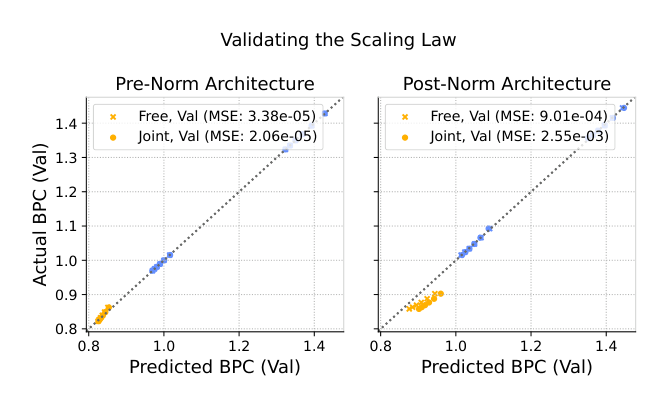
采用 §3.1 的改进(按预算调参 + 衰减学习率)拟合。由于外推主要反映噪声很大的不可降低误差(§5.2),作者同时尝试共享 $\epsilon$(joint)与各自自由(free)两种拟合:
| 架构 | Free(Val MSE) | Joint(Val MSE) |
|---|---|---|
| Pre-Norm | 3.38e-05 | 2.06e-05 |
| Post-Norm | 9.01e-04 | 2.55e-03 |
结论分析:free 与 joint 外推能力相当。pre-norm 的律极为出色(两种设定下 MSE 都在 1e-5 量级);post-norm 的律尚可但明显更差(差了 1.5–2 个数量级),作者判断它还能从进一步的超参调优中获益——超参问题第三次出现。
最终比较¶
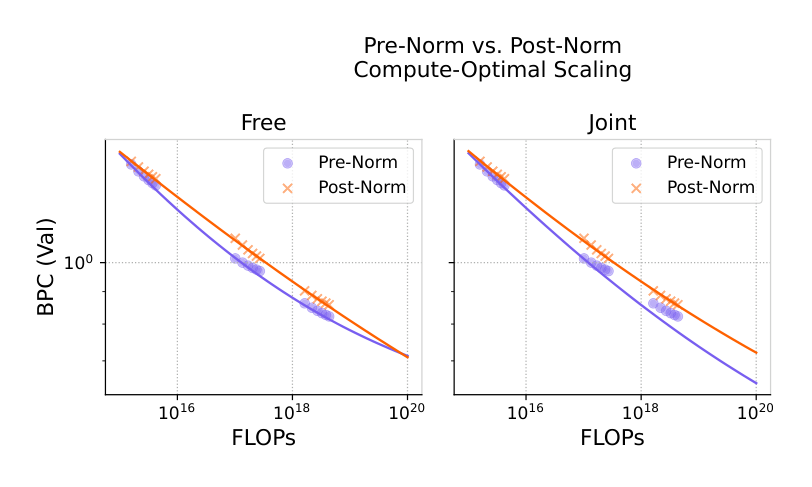
把所有规模汇总后比较两种架构的 compute-optimal scaling:在探索到的规模范围内 pre-norm 一致地 scaling 更好。但这里必须动用 §5.2 的教训,因此作者给出两种比较:
- 各自自由的 $\epsilon$:post-norm 看上去会在我们测试过的规模之外最终反超;
- 共享 $\epsilon$:pre-norm 保持更高效率,且差距随算力增大。
从整体视角出发的最终判断由三条支撑:其一,post-norm 在每一个环节都更难调——理论上更好的架构,如果找不到好超参,实践中就是更差;其二,pre-norm 在 scaling law 最可信的区域(数据附近)scaling 更好;其三,若假设两种架构最终收敛到同一 final loss,pre-norm 保持 scaling 优势。三条合起来支持 pre-norm 是更好的选择——从小规模实验中复原出了大规模的结论。
附录:为什么没有统一的定量模型¶
§B 尝试把 scaling law 与 noisy quadratic limit 缝成一个统一模型。直觉出发点是:给定任何合理的超参,当参数与数据趋于无穷时 loss 应当趋近不可降低误差 $\epsilon$。于是把每个规模上 reducible loss 的百分比增量建模为超参的二次型:
$$L(p, d) \approx \epsilon + \left(\frac{\eta}{d^{\kappa}} + \frac{\zeta}{p^{\iota}}\right)\Big(1 + \mathcal{L}X + (X - x^*)^T H_{x^*} (X - x^*)\Big) \tag{9}$$
其中 $\mathcal{L}$ 是使任意二次型都可表达所必需的残余线性项。由于 Hessian 实对称,可对角化 $H_{x^*} = U D U^T$;令 $\Lambda$ 为非零特征值构成的对角阵、$M_{x^*}$ 为 $U^T$ 中投影到对应特征向量的子矩阵、$z^* = M_{x^*} x^*$,则模型可写成低维投影空间中的二次型:
$$L(p, d) \approx \epsilon + \left(\frac{\eta}{d^{\kappa}} + \frac{\zeta}{p^{\iota}}\right)\Big(1 + \mathcal{L}X + (M_{x^*}X - z^*)^T \Lambda (M_{x^*}X - z^*)\Big) \tag{10}$$
这个形式允许在低秩约束下拟合。作者比较了若干变体(Hessian 秩一律限制在 $\gamma = 3$):static(最优点与曲率都跨规模固定);dynamic optima(曲率固定,潜在最优超参是 log 规模的线性函数 $z^* = z_0 + \log(p) z_p + \log(d) z_d$);dynamic sensitivity(最优点固定,Hessian 特征值随规模走幂律 $\lambda_i p^{\nu_i} d^{\xi_i}$);dynamic(两者都变);以及无秩约束的 polynomial 与彻底放弃可解释性的 MLP。
| 模型 | Val 67M | Val 134M | Test 268M |
|---|---|---|---|
| Scaling Law(仅预测最优超参处的 loss) | 0.000011 | 0.000025 | 0.000020 |
| Parameters and Tokens Only(忽略超参) | 0.011471 | 0.014014 | 0.019795 |
| Polynomial | 0.004452 | 0.005217 | 0.008790 |
| Static | 0.004820 | 0.005900 | 0.010027 |
| Dynamic Optima | 0.002824 | 0.004401 | 0.006630 |
| Dynamic Sensitivity | 0.005413 | 0.007185 | 0.010813 |
| Dynamic | 0.003672 | 0.006806 | 0.010102 |
| Multilayer Perceptron | 0.008866 | 0.012003 | 0.015464 |
结论分析:忽略规模对超参影响的 static 模型已经出人意料地好;改变最优点位置(dynamic optima)有帮助,而改变曲率(dynamic sensitivity)反而有害——这与"参数是降维主要驱动力、数据影响甚微"的定性图景一致。最灵活的 MLP 在此处是所有含超参模型中最差的(作者诚实注明:在类似设置下它也可能最好,排名对初始化等优化细节敏感)。最关键的一行对比是:所有变体都胜过"只看参数与 token"的基线,但没有一个逼近 scaling law 在预测最优超参处 loss 时达到的误差(0.0028 vs 0.000011,差了两个数量级)。即没有模型完全刻画了这张损失面——这也是作者说"统一模型难以捉摸,但也没有必要"的实证依据。
实验细节汇总¶
建模配方:Meta Lingua(commit 437d680)中的 Llama 变体,decoder-only,RMSNorm + SwiGLU + RoPE。数据为 FineWeb-Edu 的 100B token 子集;tokenizer 用 tiktoken 的 p50k_base(GPT-3.5 / text-davinci-003 的 BPE),词表 padding 到 50,536;上下文长度 1,024;model.multiple_of 从默认 256 改为 8(默认值大于小模型的隐藏维)。
优化:AdamW + WSD 调度,与 Lingua 不同之处是 cooldown 用线性衰减到峰值学习率的 1e-6 倍。训练直到 token 数等于目标有效参数的 32 倍——即比 Chinchilla 最优的约 20 tokens/param 多约 50%,从而同时覆盖欠训与过训区间。衰减阶段通过在 checkpoint 后延长 25% 的步数实现,因此最终结果的学习率在最后 20% 的训练上衰减。
评估:预训练用 BPC(bits-per-character),它把 loss 对 tokenization 的差异做了归一化;验证集上限制 eval.validation.max_steps = 1000。能力评估通过 Lingua 集成的 EleutherAI lm-evaluation-harness(v0.4.11),六个多选任务:AI2 ARC (Easy)、AI2 ARC (Challenge)、BoolQ、MMLU、OpenBookQA、PIQA。
随机种子全部固定(seed 0、data.seed 1、model.seed 2 等),因此数据顺序等细节保持恒定,run 之间主要只有超参不同。
非架构超参的搜索分布:
$$\begin{aligned} \texttt{batch\_size} &\sim \text{DiscreteUniform}(\{64, 128, 256, \ldots, 4096\}) \\ \texttt{lr} &\sim \text{LogUniform}(10^{-5},\, 10^{-1}) \\ \texttt{beta1} &\sim \text{LogitUniform}(0.7,\, 0.999) \\ \texttt{beta2} &\sim \text{LogitUniform}(0.9,\, 0.9999) \\ \texttt{warmup} &= \text{round}(\text{steps} \times P), \quad P \sim \text{LogUniform}(10^{-3},\, 1/8) \\ \texttt{weight\_decay} &\sim \text{LogUniform}(10^{-4},\, 10^{0}) \\ \texttt{rope\_theta} &\sim \text{LogUniform}(2^{10},\, 2^{20}) \end{aligned} \tag{11}$$
作者给出的启发式是:实值线性尺度、正值对数尺度、有界值 logit 尺度——用对每个超参恰当的尺度采样,对高效达到 noisy quadratic limit 同样重要(Lourie et al., 2025a)。warmup 按总步数的比例采样且不超过前 1/8,保证第一个 checkpoint 总是已完全预热。
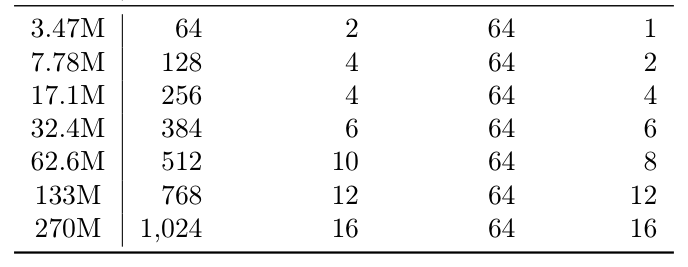
模型阶梯(Table 1):保持 head_dim 恒为 64、aspect ratio 在 32–64 之间(Porian et al., 2024)。
| $N_{\text{eff}}$ | dim | n_layers | head_dim | n_heads |
|---|---|---|---|---|
| 3.47M | 64 | 2 | 64 | 1 |
| 7.78M | 128 | 4 | 64 | 2 |
| 17.1M | 256 | 4 | 64 | 4 |
| 32.4M | 384 | 6 | 64 | 6 |
| 62.6M | 512 | 10 | 64 | 8 |
| 133M | 768 | 12 | 64 | 12 |
| 270M | 1,024 | 16 | 64 | 16 |
搜索规模:ladder 实验(排除 2 次失败 run)在 4M/8M/17M/34M/67M/134M/268M 上分别搜索 867 / 826 / 867 / 934 / 128 / 128 / 64 个配置;random 实验(排除 2 次失败)在 4M–134M 上各搜 128 / 126 / 128 / 128 / 128 / 128 个;postnorm 实验(排除 1 次失败)为 511 / 512 / 128。合计约 4,000 次训练。
架构超参的搜索分布(random / prenorm / postnorm 实验):
$$\texttt{n\_layers} = \text{round}(U^2), \quad U \sim \text{Uniform}(\sqrt{2},\, \sqrt{48}) \tag{12}$$
$$\texttt{n\_heads} \sim \text{DiscreteProportional}(\{k \mid k \text{ divides } \texttt{dim}/8,\ 1 \le k < \min(24, \texttt{dim}/8)\}) \tag{13}$$
给定有效参数量后,层数通过 Eq. (8) 反解出隐藏维(在 $d_{\text{ff}} = \frac{8}{3}d$ 下是关于 $d$ 的二次方程),再舍入到 8 的倍数。作者细致地交代了 transformer 的一系列约束:head_dim ≥ 16(常见 attention 实现要求)、head_dim 必须为偶数(RoPE 要求)、head_dim 整除 dim、dim 同时充当隐藏维与 embedding 维、矩阵维度应为 8 的倍数(GPU 效率);层数至少为 2,因为少于两层无法形成 induction head(Olsson et al., 2022);用平方根尺度是因为它能让层数与隐藏维两者都更均匀;由于小除数远比大除数常见,采样时按除数大小加权以偏向较大的 head 数。
noisy quadratic 拟合细节:eCDF 置信带用 Lourie et al. (2024) 的 LD Highest Density bands,拟合用 opda (v0.8.0)。阈值 $\theta$ 取分数分布的不同百分位,且渐近区大小随参数与数据一起增长——ladder / random / prenorm 实验中,4M/8M/17M 用 7%(checkpoint 1–6)到 8%(7–8);134M 与 268M 则从 checkpoint 1 的 12% 一路放宽到 checkpoint 8 的 50%。postnorm 的阈值明显更紧(4M 时 checkpoint 1 仅 3%),这正是"渐近区更小"的量化体现。$\alpha$ 被约束为正(BPC 恒正),$\gamma$ 被约束在 1 到名义超参个数之间(ladder 为 7,random/prenorm/postnorm 为 9)。
scaling law 拟合:用 SciPy 的 differential_evolution 最小化 MSE,$\epsilon$ 的界为 $[0,1]$,$\ln\zeta$ 与 $\ln\eta$ 的界为 $[0,10]$(在对数尺度上拟合),$\iota$ 与 $\kappa$ 的界为 $[0,1]$;popsize 取 120(联合拟合单一不可降低误差时因维度更高、耗时更长而降到 60)。
硬件:80GB NVIDIA A100 + SLURM。4M–134M 单卡训练,268M 用 8 卡数据并行。软件环境封装在 Apptainer/Singularity 容器(Ubuntu 24.04.2 LTS + CUDA 12.8 + cuDNN 9.8 + PyTorch 2.7.0+cu128)。作者还记录了工程细节:用梯度累积让 batch size 在不同 GPU 配置下可调且始终整除总 token 数;用 SDPA 替代 Flex Attention,因为后者为某些随机采样出的 transformer 形状生成不出 kernel;必须设 env.ENABLE_INTRA_NODE_COMM = "0" 以绕开当时 PyTorch 版本的一个未解决错误。
核心贡献总结¶
- 重新归因:把"小规模 scaling law 不可靠"这一广泛结论的病因从规模改判为超参。scaling law 一直延伸到 4M 有效参数,只是它只在完全调优的前沿上显形。
- 量化了配方中各成分的权重:参数定义(六种计数差异微小)与最佳实践(按预算调参 −50%、LR 衰减 −98% 测试 MSE)都只是精修;唯有超参搜索规模是"有无之别"(4 配置 1.30e-2 → 256 配置 3.70e-6)。同时给出一个反直觉的负面结论:绑定指数 $\iota = \kappa$ 不是稳妥的正则化。
- 给出机制解释:超参损失面的内蕴维度 $\gamma$ 随参数增长下降到 1,且参数比数据的作用大得多。"参数上的维度之福治好了超参上的维度之咒"是全文最具启发性的一句概括。
- 提出可证伪的诊断式方法论:把三条强假设(perplexity–capability 对应、scaling law 存在、敏感度随规模下降)各自转成一个可在小规模廉价检验的诊断,失败即信号。
- 端到端验证:用 pre-norm vs post-norm 这个曾耗费领域三年的问题作检验,从小规模实验中复原大规模结论,且总开销仅相当于几次 1B 级别的 run。
- 明确划出边界:小规模上 scaling law 存在但纯外推有统计功效上限;模型侧研究可用,数据侧研究不可用(改数据即打破 perplexity–capability 对应)。
与已归档相关工作的对比¶
Skaling: Chinchilla's Exponents Meet Kaplan's Coupling Skaling: Chinchilla's Exponents Meet Kaplan's Coupling(FAIR at Meta, 2026-08-07)¶
关系:独立并发(本文未引用 Skaling,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇同出 FAIR at Meta、发表仅隔 5 天、互不引用,却在追问同一个结构性瓶颈——用低成本实验估计出的 scaling law,为什么外推到大规模时不可信。两者都拒绝"就是得烧大模型"这个默认答案,都主张问题出在估计流程的某个可修复环节,也都把"在留出的更大规模上的预测误差"当作唯一裁判(本文用 MSE 的 Train/Val/Test 三分,Skaling 用 MAPE 的 Validation / Extrapolation N / Extrapolation D / Far Extrapolation 四分)。
- 相近的技术骨架:骨架都是"先用一个可证伪的诊断检验估计的前提,再据此修正流程,最后在留出的大规模上验证外推"。本文的诊断是 noisy quadratic limit——若随机搜索的分数分布尾部没有收敛到 noisy quadratic,说明还没摸到最优点;Skaling 的诊断是对实测 loss 曲面做无参数数值微分测混合偏导 $\partial^2 L / \partial N \partial D$——若它显著非零,加性 Chinchilla 形式就被证伪。两者都把"该怎么拟 scaling law"从习惯/审美问题变成了数据可判定的假设检验,也都以"便宜的实验其实够用"收尾:本文说 4M 模型单卡一小时,Skaling 说只训网格两条低算力边(L 形网格)可用约 1/10 拟合算力达到全网格精度。
- 本文的差异与推进:两者对 root cause 的归因是互补而非重合的。Skaling 认为病根在函数形式(加性结构隐含 $\partial^2 L/\partial N \partial D \equiv 0$,与数据矛盾),修法是把 Chinchilla 的内和整体抬到一个自由外指数上,$L = (A/N^\alpha + B/D^\beta)^k + E$,用单个额外参数恢复 $N$–$D$ 耦合;本文认为病根在数据的质量(拟合所用的每个点是否真的落在完全调优前沿上),修法是把每个规模的搜索量从常见的个位数拉到数百。值得注意的是,本文明确消融了一个 Skaling 也讨论的自由度——绑定指数 $\iota = \kappa$——并给出否定结论;而 Skaling 的立场更强,认为内指数必须保持独立、耦合应由外指数单独承担。
- 可比的方法/实验差异:Skaling 在已有的公开 scaling 网格(如 Farseer)上做二次分析,因此它无法控制那些 run 的超参是否调到位——按本文的诊断,那些网格点很可能没有一个落在完全调优前沿上,于是 Skaling 观测到的"边界处系统性鞍形残差"里,有多少来自函数形式误设、有多少来自小模型/边界处更严重的超参失调,是无法分离的。反过来,本文把全部改善都归到调优上,但它自始至终用的都是加性 Chinchilla 形式 Eq. (3),因此其残余外推误差里也可能含有 Skaling 指出的耦合缺失项。两篇合起来读的价值在于:它们各自控制了对方的混淆变量,而"先按本文的标准把超参调到前沿、再按 Skaling 的形式拟合"这个组合实验,两篇都没做。
Scaling Laws for Behavioral Foundation Models over User Event Sequences Scaling Laws for Behavioral Foundation Models over User Event Sequences(Unbox AI, 2026-06-03)¶
关系:独立并发(本文未引用,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都不提新架构,都是用数百到数千次小规模受控 run 回答"下一次实验该怎么配"的方法论论文(本文约 4,000 次训练,对方约 600 次 iso-FLOP run)。更精确的共同 root cause 是:当你用一个小规模上的代理量(预训练 loss)为大规模决策背书时,这个代理到底可不可靠、在什么条件下失效。
- 相近的技术骨架:都在同一套 Chinchilla 式 $c = 6ND$ 记账下扫描(参数, 数据)网格,都用留出的更大规模检验外推,都以"给出可执行的配方处方"而非"提出新模型"为交付物,也都发现评测口径本身会改变结论,因而必须显式地把它纳入方法论。
- 本文的差异与推进:两者对代理可靠性给出的是互为镜像的结论,这也是这组对比最有价值的地方。本文的 §2.3 与诊断 3 是正面结果:只要预训练数据固定,perplexity 与能力严格对应,跨规模、跨 pre-norm/post-norm 架构的所有点都落在同一条曲线上(Figure 13),因此"比 loss"是合法的;而对方的核心发现之一是反面结果——训练用的 sampled-softmax loss 并不是 full-catalogue 排序质量的可靠代理,"评测指标本身是 scaling law 的一部分",换指标就会改变计算最优配方(关键 batch size、冻结后最优负样本数都随之漂移)。两者其实并不冲突,而是划出了同一条边界的两侧:本文的对应关系成立于"数据固定 + 评测口径与训练口径一致",对方打破的恰是后一半条件——Stage 1 的 batch-local 候选池与 Stage 2 的千倍大全库候选池是两个不同的评测 regime,loss 与排序分数只在同一 stage 内可比。本文若要迁移到推荐/行为序列场景,诊断 3 必须按对方的口径重做,否则 perplexity–capability 对应这条支柱直接塌掉。
- 可比的方法/实验差异:拟合工具不同——对方用 iso-FLOP 抛物线/抛物面求极小点,本文用随机搜索 + noisy quadratic 分布拟合尾部。这个差异不只是技术偏好:iso-FLOP 抛物线默认每个 cell 的超参已经调好(对方每 cell 只跑三个学习率、按训练 loss 选最佳),而这正是本文证明在小规模上会致命失效的假设。按本文的量表,"每 cell 3 个学习率"落在 Figure 5 中"4 个配置"那一档——scaling law 在那里完全不可见。对方 $10^{15}$ FLOPs 一端的拟合是否可信,因此存在本文所指出的系统性风险;反过来,本文只在单一固定语料上验证了 perplexity–capability 对应,而对方的长尾 item 分布(约 $10^8$ 唯一动作、热门 item 单次训练被看数百次)是本文完全没有覆盖的数据形态。
讨论与局限性¶
值得借鉴的设计。最有方法论迁移价值的一点是把强假设转化为诊断这个思路本身:小规模实验之所以廉价,正是因为它依赖一堆强假设;而作者的做法不是回避这些假设,而是利用小规模的廉价性去反复检验它们,并把每一次失效读成关于模型的信息。post-norm 的故事就是最好的例证——它在四个诊断里每一个都表现出调参困难(渐近区更小、次优尖峰残留、scaling law 拟合更差),这些"失败"合起来构成了比任何单一指标更强的证据。第二点是 WSD + 分叉衰减 的实验设计:复用 stable 阶段、从 8 个 checkpoint 各分叉出衰减阶段,让一次 sweep 同时产出 8 个 token 预算下的 stable 与 decay 结果,这是把随机搜索成本压下来的关键工程手段,可直接搬到任何需要跑大规模超参 sweep 的场景。第三点是算力的二次律论证——参数与数据同速增长时算力是模型规模的二次函数,因此 1 次 1B run = 65,536 次 4M run——这个换算把"数百配置的搜索"从听起来奢侈变成了显然划算。
局限与争议。作者自己标出的最重要一条是限于模型侧研究:改数据会打破 perplexity–capability 对应,而一旦既没有预训练 loss 作代理、又没有可靠的下游 scaling law,小规模实验预测大规模结果的能力就非常有限;数据侧研究需要另一套技术,作者把它留给未来工作。第二条是纯外推的统计上限:Figure 10 显示独立估计在远离数据处扇形散开,比较模型时不能只看外推出的最终 loss——这实际上削弱了"小规模实验能替代大规模实验"这个主张的强度,把它降格为"小规模实验能在数据附近可靠地比较,再辅以定性判断"。第三条是 $\gamma$ 的解释张力:本文发现 $\gamma$ 随规模下降,而前人发现同一搜索空间下 $\gamma$ 跨架构不变,两者的兼容性尚未厘清;而且在 muP 等替代参数化下规模的效应可能改变——考虑到 muP 恰恰是工业界迁移超参的主流手段,这个未覆盖的情形并非边缘案例。
还有两点作者没有展开、但对读者判断适用范围很重要。其一,pre-norm/post-norm 这个案例是"答案已知"的——作者是在验证方法论能否复原一个已定论的结果,这与用它去裁决一个尚无答案的架构选择在风险上不等价,尤其是最终判断中"若假设两种架构收敛到同一 final loss"这个附加前提,在未知问题上无从验证。其二,全部结论建立在单一模型族(Llama 变体)、单一语料(FineWeb-Edu)、单一上下文长度(1,024)之上,而 rope_theta 被纳入搜索这一细节暗示长上下文可能引入额外的敏感方向;$\gamma \to 1$ 这个漂亮结论在更长上下文、MoE、或多阶段训练配方下是否还成立,是开放问题。
对推荐系统研究的直接含义(本条为归档视角的引申)。这篇论文虽是 cs.LG 的通用方法论,但对做推荐模型 scaling 的人有很硬的指导价值:其一,大量推荐侧的"scaling law"论文在每个规模上只调了个位数的配置,按 Figure 5 的量表,它们报告的 scaling 曲线很可能落在"law 尚未显形"的区间里,观察到的饱和究竟是架构瓶颈还是调参不足难以区分——这直接关系到"某架构在多大参数量后收益递减"这类结论的可信度。其二,"大模型更好调"这条结论解释了为什么工业界把小规模调出的配置直接搬到大模型上通常够用。其三也是最需要警惕的一条:本文的方法论以 perplexity–capability 对应为基石,而推荐场景的核心指标是排序质量而非 loss,候选池口径、采样负样本数都会改变 loss 与排序质量的关系(见上文与 Scaling Laws for Behavioral Foundation Models over User Event Sequences 的对比)——照搬这套方法论到推荐场景前,诊断 3 必须先重做并通过。