Task-Blind No MORE:把多任务信息流搬进统一排序骨干¶
Hello Group(陌陌)+ 中国科学技术大学 + 中科院软件所 / 中科院大学 + 北京信息科技大学,CIKM '26(Rome),2026-09-07 挂 arXiv(2609.07273v1,cs.IR)。第一作者 Yuchen Wang([email protected]),通讯作者 Yuchen Wang 与 Jun Gao(均为 Hello Group)。
核心主张:工业排序模型沿两条平行路线扩参——特征交互(Wukong、RankMixer)与行为序列(HSTU、LONGER)——最近的 OneTrans / HyFormer / MixFormer 把两者塞进同一个可堆叠骨干,解决了「序列与非序列分离」。但没有一篇处理工业排序里同样中心的需求:多任务。现有统一架构把多任务建模关在骨干之后的浅层塔里(MMoE、PLE 的门控与专家),骨干本身是任务无关(task-agnostic)的。本文提出 MORE(Multi-task cO-evolving Ranking modEl),把多任务信息流放进骨干内部:引入贯穿所有 block 的 Anchor Token(Shared Anchors 编码跨任务共性,Private Anchors 编码每任务先验),每个 block 里 Anchor 依次 ①以任务条件化的 query 跨注意力读行为序列、②在 task-boundary mask 下与非序列 token 做 MLP-Mixer 式 token mixing、③经 FiLM 式 per-task 分支增强。陌陌 Nearby Feed 90 天线上日志离线实验里七任务全胜;两周线上 A/B 六项指标全部 p<0.05;配合请求级共享计算,P99 打分延迟降约 30%,已上线。
一、研究动机与背景¶
1.1 两条平行的扩参路线,与统一骨干的兴起¶
工业排序模型的演进沿着两个互不相交的方向:
- 特征交互扩参:Wukong、RankMixer 把交互骨干做大,提升高阶特征交叉能力;更早的谱系是 Wide & Deep、DeepFM、xDeepFM、DCN/DCN-V2、AutoInt、FiBiNET、HiFormer、InterFormer;
- 行为序列扩参:从 DIN/DIEN 的 target attention,到自注意力架构(BST、SASRec),到检索式终身序列建模(SIM、TWIN),再到端到端万级序列的 LONGER、STCA 与生成式 transduction 的 HSTU。
论文指出这两条路线在生产流水线里架构上仍然分离,造成异质信号的晚融合(late fusion),序列与非序列特征之间无法双向交互。近期的统一架构因此把序列建模与特征交互放进同一个可堆叠骨干:
- HyFormer 引入 Global Tokens 作为序列与非序列信号之间的语义接口,交替执行「长序列上的 cross-attention」与「MLP-Mixer 式 token mixing」以实现双向信息流;
- MixFormer 提出 co-scaling 挑战——稠密容量与序列容量争夺同一份算力预算——并把两者统一进单一参数化,在 FLOPs 与序列长度两个轴上表现出更好的 scaling 行为;
- OneTrans 用统一 tokenizer 把两类信号映到同一 token 空间,通过金字塔堆叠渐进压缩序列信息。
1.2 被遗漏的第三个维度:多任务¶
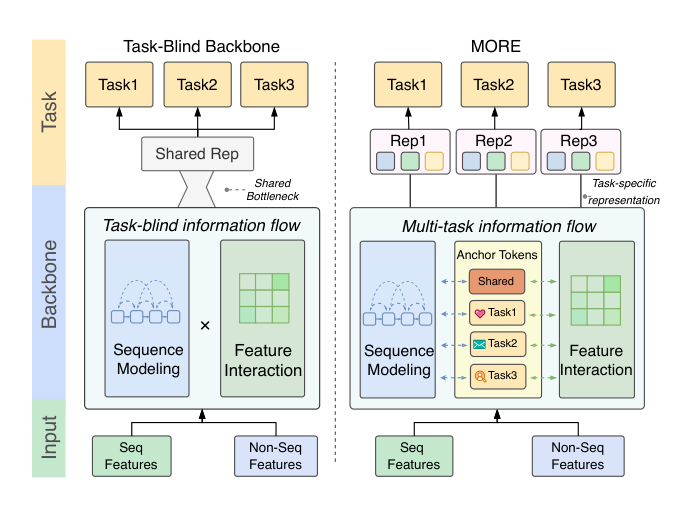
论文的切入点是:这三者都提升了精度与可扩展性,但骨干仍然是任务无关的。工业排序场景几乎必然是多任务的——同一个模型要同时服务语义异质的多种行为。MMoE、PLE、AITM、PEPNet 等把多任务建模推进了很多,但任务差异化一律被限制在骨干之后的预测塔里。作者由此推出三条具体局限:
① 任务盲的序列读取与特征交互(Task-blind sequence reading and feature interaction)。 任务信号只在预测头处进入,从不塑造骨干内部如何组织信息。序列读取无法以「我在服务哪个任务」为条件,特征交互也无法按任务偏好调整聚合方式。论文举的例子很具体:点击率依赖曝光新近度与视觉显著性,而评论率依赖内容深度与话题相关性;一个任务无关的共享 query 会把两种需求混成对同一段行为历史的无差别读取。
② 任务差异化之前的结构性瓶颈(Structural bottleneck before task differentiation)。 因为所有任务共享同一份骨干输出,任务特定的特征偏好在任何任务差异化开始之前就被压进了单一语义空间。MMoE / PLE 这类后置塔的门控与专家机制只是在这个已经被压缩过的表示上做浅层路由——它们能对一组固定的基向量重新加权,却无法重建那些在骨干处理阶段从未形成过的任务感知特征组织。作者强调:瓶颈是结构性的,不是路由容量问题。
③ 多任务收益随扩参递减(Diminishing multi-task returns from scaling)。 扩深度、扩宽度、扩序列长度主要放大的是共享表征容量;新增参数服务于任务无关的特征交叉,而非任务特定的信号分离。论文声称实证观察到:任务无关的统一骨干把参数增长转化为多任务 GAUC 收益的转化率显著低于任务感知的替代方案(对应 §4.4 的 Figure 3)。
1.3 与最接近的已有工作的关系¶
Related Work 末尾点了一句关键的话:「Recent attempts to inject task signals into earlier backbone layers [14] still share interaction parameters across all tasks and leave behavior-sequence updates undifferentiated per task」。[14] 是 INFNet(arXiv:2508.11565,A Task-aware Information Flow Network for Large-Scale Recommendation Systems)——名字里同样带「task-aware information flow」,是本文唯一承认的同路线前作。MORE 的差异化声明落在两点:不共享交互参数(per-task CrossAttn 投影、per-task Enhancing 分支)与每任务差异化的行为序列读取。这条差异化声明本身没有实验支撑——论文没有把 INFNet 放进 Table 1 的基线里。
二、问题形式化¶
设 $\mathcal{U}$、$\mathcal{C}$ 分别为用户空间与物品空间。对用户 $u\in\mathcal{U}$,行为历史是一条含多种行为类型的序列,候选集为 $\{c_1,\dots,c_C\}$。记 $\mathbf{S}$ 为用户历史行为序列特征,非序列特征 $\mathbf{NS}$ 包含用户画像、候选属性与上下文特征。系统需要输出 $T$ 个任务的预测分(如 click、like、comment、greet、chat):
$$\hat{y}_1,\dots,\hat{y}_T = f(\mathbf{S},\mathbf{NS};\Theta) \tag{1}$$
参数 $\Theta$ 通过最小化加权二元交叉熵优化,$\lambda_t$ 为任务特定的损失权重:
$$\mathcal{L}=\sum_{t=1}^{T}\lambda_t\,\mathcal{L}_{\mathrm{BCE}}(\hat{y}_t,y_t) \tag{2}$$
记号冲突(原文未澄清):这里的 $\lambda_t$ 是任务损失权重,而 §3.4.3 的 Eq. (15)(16) 又用 $\boldsymbol{\lambda}_t$ 表示 FiLM 的缩放向量。两者同名不同义,读原文时需注意。论文也从未给出 $\lambda_t$ 的具体取值或调参方式——在一个 13 任务联合优化的系统里,任务权重通常是最敏感的超参之一。
三、核心方法:MORE¶
3.1 框架总览¶
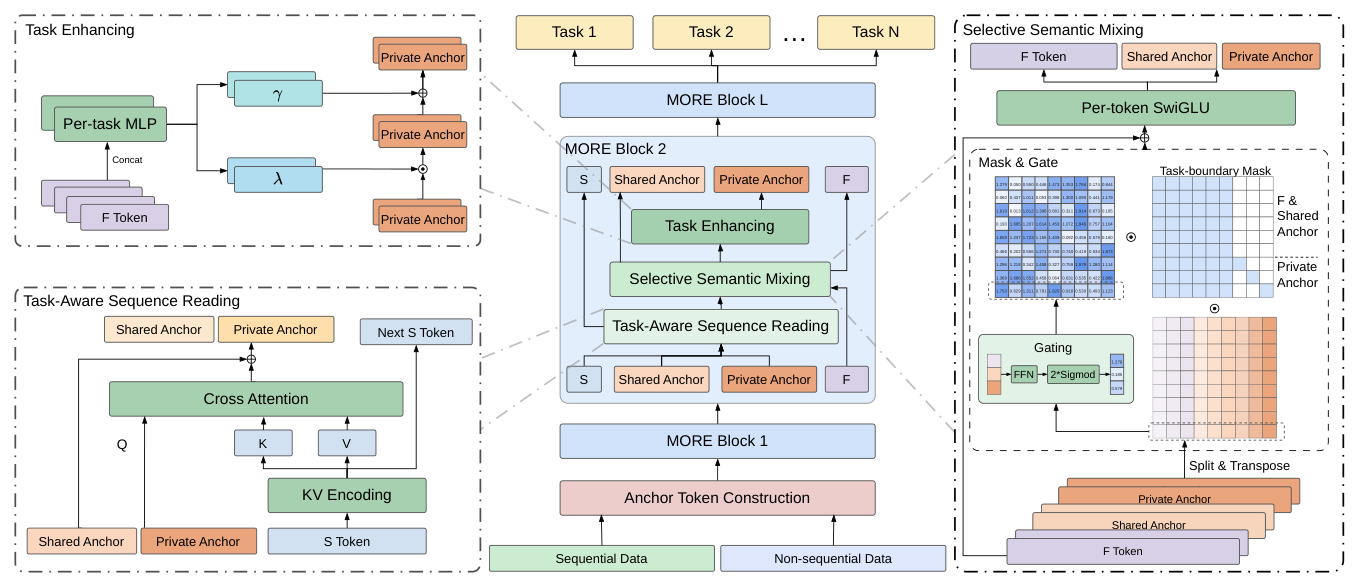
MORE 由三部分组成:输入表示层、$L$ 个可堆叠的 MORE Block、$T$ 个预测塔。每个 MORE Block 含三个顺序更新 Anchor Token 的子模块:
- Task-Aware Sequence Reading:经 cross-attention 从行为序列抽取任务感知信号;
- Selective Semantic Mixing:Anchor Token 与非序列 token $\mathbf{F}$ 做全局语义交互,施加 task-boundary mask 隔离任务边界;
- Task Enhancing:通过任务特定的独立分支把判别性信息嵌进每个 Private Anchor。
堆叠 $L$ 个 block 后,每个任务塔接收对应的 Private Anchor,再加上来自 Shared Anchors 与非序列 token 的共享语义做多任务预测。MORE 另用请求级共享计算维持工业部署效率。
3.2 输入表示¶
MORE 把排序请求的信号组织成两类 token:编码多行为历史的序列 token,与编码用户画像、候选属性、上下文的非序列 token,两者映到同一个 $d$ 维空间。Anchor Token 再从这两类输入派生,作为贯穿骨干的显式多任务状态。
3.2.1 任务感知的多行为序列编码¶
用户行为历史含 $T$ 种类型(click、interact、chat 等)。论文指出:只编码 item 级位置而不区分行为类型,会削弱后续层里的 per-task 结构。MORE 采用笛卡尔积编码(Cartesian product encoding):把每个 item 的行为组合表示成长度为 $T$ 的二值指示向量,映射到唯一的 action combination ID;每个 item–ID 对产生一个独立的序列 token:
$$\mathbf{s}_n=\mathbf{e}_{\text{item}}(i_n)+\mathbf{e}_{\text{action}}(\text{cid}_n)+\mathbf{e}_{\text{time}},\qquad n=1,\dots,N \tag{3}$$
其中 $\mathbf{e}_{\text{item}}(i_n)$ 是 item $i_n$ 的 embedding,$\mathbf{e}_{\text{action}}(\text{cid}_n)$ 是行为组合 ID 的 embedding,$\mathbf{e}_{\text{time}}$ 是编码时序的可学习位置 embedding。$\mathbf{S}\in\mathbb{R}^{N\times d}$ 把不同的行为类型组合切成不同的 token,为 Task-Aware Sequence Reading 提供细粒度输入,并在每个位置缓解跨任务梯度冲突。
注意:笛卡尔积编码的行为组合空间理论上是 $2^T$;论文未说明实际 vocabulary 大小、是否做了长尾组合的截断或哈希。
3.2.2 非序列语义 token¶
对每个候选,用户画像、候选属性、上下文特征被 embed 后分组为非序列 token 矩阵 $\mathbf{F}\in\mathbb{R}^{M\times d}$。在骨干里,$\mathbf{F}$ 在 Selective Semantic Mixing 阶段为 Anchor Token 提供上下文语义,在 Task Enhancing 阶段向 Private Anchor 注入判别性信息。
3.2.3 Anchor Token 构造¶
Anchor Token 是贯穿所有骨干层的多任务信息跨模块载体。初始化方式是:把 $\mathbf{S}$ 的均值池化行为摘要与 $\mathbf{F}$ 的展平非序列语义拼接,再经一个 MLP 投影并切分:
$$\mathbf{h}=\mathrm{Concat}\big(\mathrm{MeanPool}(\mathbf{S}),\ \mathrm{Flatten}(\mathbf{F})\big),\qquad \mathbf{A}_1,\dots,\mathbf{A}_{K+T}=\mathrm{Split}\big(\mathrm{MLP}(\mathbf{h})\big) \tag{4}$$
前 $K$ 个输出构成 Shared Anchors $\mathbf{A}_s\in\mathbb{R}^{K\times d}$ 承载跨任务语义,其余 $T$ 个构成 Private Anchors $\mathbf{A}_p\in\mathbb{R}^{T\times d}$,每任务一个。再加一个可学习的任务先验 embedding $\boldsymbol{\pi}_t\in\mathbb{R}^d$ 强化任务判别性:
$$\mathbf{A}_p^{(t)}=\mathbf{A}_p^{(t)}+\boldsymbol{\pi}_t,\qquad t=1,\dots,T \tag{5}$$
3.3 MORE Block¶
3.3.1 Task-Aware Sequence Reading¶
同一段行为历史对不同任务携带不同的判别信号。Task-Aware Sequence Reading 让 Anchor Token 以不同层次读取共享行为序列:Shared Anchors 读任务共享的一般信息,Private Anchors 读任务相关信号。
给定序列 $\mathbf{S}\in\mathbb{R}^{N\times d}$ 与 Anchor Token $\mathbf{A}=[\mathbf{A}_s;\mathbf{A}_p]$,每个 block 先更新共享序列并形成当前层的 cross-attention KV:
$$\tilde{\mathbf{S}}=\mathrm{SwiGLU}(\mathbf{S}),\qquad \mathbf{K}=\tilde{\mathbf{S}}\mathbf{W}_K,\qquad \mathbf{V}=\tilde{\mathbf{S}}\mathbf{W}_V \tag{6}$$
$\mathbf{W}_K,\mathbf{W}_V\in\mathbb{R}^{d\times d}$,$\mathbf{K},\mathbf{V}\in\mathbb{R}^{N\times d}$ 构成序列记忆。更新后的 $\tilde{\mathbf{S}}$ 会前传到下一层,因此序列表示随 block 深度演化。
为给 Anchor Token 提供跨 block 的序列记忆,MORE 维护一个序列寄存器(sequence register)$\boldsymbol{\eta}\in\mathbb{R}^d$,初始化为零;每个 block 末尾累积当前层序列的压缩摘要:
$$\boldsymbol{\eta}\leftarrow \mathrm{LN}\big(\boldsymbol{\eta}+\mathrm{MLP}(\mathrm{Pool}(\tilde{\mathbf{S}}))\big) \tag{7}$$
Anchor Token 随后查询共享序列记忆。cross-attention 之后,每个 Shared Anchor 与每个 Private Anchor 都被寄存器经各自独立的 SwiGLU 门增强,使每个位置对同一份序列摘要给出不同解读:
$$\hat{\mathbf{A}}_s^{(k)}=\mathrm{CrossAttn}\big(\mathbf{A}_s^{(k)},\mathbf{K},\mathbf{V}\big)+\mathrm{SwiGLU}_k(\boldsymbol{\eta}),\qquad k=1,\dots,K \tag{8}$$
$$\hat{\mathbf{A}}_p^{(t)}=\mathrm{CrossAttn}_p^{(t)}\big(\mathbf{A}_p^{(t)},\mathbf{K},\mathbf{V}\big)+\mathrm{SwiGLU}_t(\boldsymbol{\eta}),\qquad t=1,\dots,T \tag{9}$$
$\mathrm{SwiGLU}_k$ 与 $\mathrm{SwiGLU}_t$ 分别是 per-anchor 与 per-task 的门控投影。注意 Eq. (9) 里的 $\mathrm{CrossAttn}_p^{(t)}$ 带上标 $t$,即每个任务有独立的 cross-attention 参数(这正是 MORE 相对 INFNet 声称的差异点:不共享交互参数);而 Eq. (8) 的 Shared Anchor cross-attention 不带上标,各 Shared Anchor 共享一套投影。共享寄存器捕捉跨 block 的全局序列演化,独立门控让每个 anchor 选择性抽取与自身角色最相关的信号。
参数量含义:$T$ 套独立的 $\mathrm{CrossAttn}$ 是 MORE 相对统一骨干基线的主要额外参数来源。论文在 §4.2 承认 MORE 的 132M 参数高于 OneTrans 的 108.65M,把差额归因于「per-task query projections 与 task-boundary isolation」。
3.3.2 Selective Semantic Mixing¶
序列读取之后,Anchor Token 已吸收序列信息,但与非序列 token $\mathbf{F}$ 的交互尚未建立。论文的关键论点:如果所有 token 在 mixing 时无差别融合,不同 Private Anchor 的任务特定语义会互相稀释。受 RankMixer 启发,Selective Semantic Mixing 用一个轻量的 MLP-Mixer 式 token-mixing 操作,在保持任务边界的前提下用非序列语义丰富 anchor。
序列读取输出与 $\mathbf{F}$ 拼成统一 token 矩阵:
$$\mathbf{G}=\big(\mathbf{F};\ \hat{\mathbf{A}}_s;\ \hat{\mathbf{A}}_p^{(1)},\dots,\hat{\mathbf{A}}_p^{(T)}\big)\in\mathbb{R}^{H\times d} \tag{10}$$
其中 $H=M+K+T$,$d_h=d/H$。把 $\mathbf{G}$ 的 embedding 维切成 $H$ 个大小为 $d_h$ 的 head,并转置 head 轴与 token 轴,得到三维张量 $\tilde{\mathbf{G}}\in\mathbb{R}^{H\times H\times d_h}$,轴含义为 (head, token, subspace)。第 $i$ 个 head 切片 $\tilde{\mathbf{g}}_i=\tilde{\mathbf{G}}_{i,:,:}\in\mathbb{R}^{H\times d_h}$ 收集了全部 $H$ 个 token 在第 $i$ 个子空间的表示。为自适应校准每个通道的重要性,每个切片过一个 MLP 门产出 per-token 分数:
$$m_i=\mathrm{MLP}_i(\tilde{\mathbf{g}}_i)\in\mathbb{R}^H,\qquad \mathrm{Gate}=(m_1,\dots,m_H)\in\mathbb{R}^{H\times H} \tag{11}$$
为保证 Private Anchors 在整个迭代过程中严格互不可见,MORE 构造 task-boundary mask $\mathbf{M}\in\{0,1\}^{H\times H}$:$\mathbf{F}$ 与 Shared Anchors 对所有 token 可见,而每个 Private Anchor 只对自己可见。对每个 head $i$,门向量 $m_i$ 与 mask 的第 $i$ 行 $\mathbf{M}_{i,:}$ 逐元素相乘形成联合权重 $\in\mathbb{R}^H$,沿 $d_h$ 广播后作用到 head 切片;所有门控切片再转置回来、跨 head 拼接以恢复 token 布局:
$$\hat{\mathbf{g}}_i=\tilde{\mathbf{g}}_i\odot\big(m_i\odot \mathbf{M}_{i,:}\big)\in\mathbb{R}^{H\times d_h},\quad i=1,\dots,H;\qquad \hat{\mathbf{G}}=\mathrm{Reshape}\big(\hat{\mathbf{g}}_1,\dots,\hat{\mathbf{g}}_H\big)\in\mathbb{R}^{H\times d} \tag{12}$$
随后经两层 per-token FFN 与残差做全局语义融合:
$$\mathbf{G}_{\mathrm{mid}}=\mathrm{Norm}\big(\mathrm{PFFN}_1(\hat{\mathbf{G}})+\mathbf{G}\big),\qquad \mathbf{G}_{\mathrm{out}}=\mathrm{Norm}\big(\mathrm{PFFN}_2(\mathbf{G}_{\mathrm{mid}})+\mathbf{G}_{\mathrm{mid}}\big) \tag{13}$$
配合 task-boundary mask,PFFN 允许全局语义流动而不跨越任务边界。$\mathbf{G}_{\mathrm{out}}$ 再沿 token 轴切分,逆转 Eq. (10):
$$\big(\mathbf{F},\mathbf{A}_s,\bar{\mathbf{A}}_p^{(1)},\dots,\bar{\mathbf{A}}_p^{(T)}\big)=\mathrm{Split}(\mathbf{G}_{\mathrm{out}}) \tag{14}$$
数值自洽性检查:按 §4.1.4 的默认配置 $M=15$、$K=8$、$T=9$,得 $H=15+8+9=32$,$d_h=d/H=256/32=8$——整除,配置自洽。这也复现了 RankMixer「head 数 = token 数」的设计。
一个被论文忽略的细节:Eq. (12) 的 mask 是乘性门控 mask而非 softmax attention mask,它把被屏蔽 token 的贡献直接置零,而 Eq. (13) 的 $\mathrm{PFFN}_1$ 又是 per-token FFN、$+\mathbf{G}$ 的残差把未经 mask 的原始 $\mathbf{G}$ 加了回来。严格说,残差通路上 Private Anchor 之间的隔离由 mask 保证(它们本来就在不同 token 位),但 mask 真正屏蔽的是「其他 Private Anchor 在本 token 的子空间切片上的贡献」——论文对这一点的形式化只给了 Eq. (12) 一行,没有画出 $\mathbf{M}$ 的完整矩阵,也没有说明 mask 对 Shared Anchor 行与 $\mathbf{F}$ 行的具体取值是否全 1。
3.3.3 Task Enhancing¶
Mixing 阶段对所有 token 施加相同的全局 mixing。作为下游预测的任务特定 anchor,Private Anchors 需要更丰富的任务特定语义。受 FiLM 启发,Task Enhancing 通过独立的 per-task 增强分支,把 $\mathbf{F}$ 里的高维判别信息注入每个 Private Anchor,扩展任务特定表示的语义容量。对第 $t$ 个任务,一个独立 MLP 从非序列特征聚合条件参数:
$$(\boldsymbol{\lambda}_t,\boldsymbol{\gamma}_t)=\mathrm{Split}\big(\mathrm{MLP}_t(\mathrm{Concat}(\mathbf{F}))\big),\qquad \boldsymbol{\lambda}_t,\boldsymbol{\gamma}_t\in\mathbb{R}^d \tag{15}$$
Private Anchor 随后以 FiLM 式仿射调制 + 残差更新:
$$\mathbf{A}_p^{(t)}=\mathrm{Norm}\big(\bar{\mathbf{A}}_p^{(t)}\odot\boldsymbol{\lambda}_t+\boldsymbol{\gamma}_t\big)+\bar{\mathbf{A}}_p^{(t)} \tag{16}$$
3.3.4 Block Stacking¶
$L$ 个 MORE Block 顺序堆叠,block 内的 Reading / Mixing / Enhancing 递归更新隐状态。第 $l$ 层的完整递推:
$$ \begin{aligned} \big(\hat{\mathbf{A}}^{(l)},\mathbf{S}^{(l)}\big)&=\mathrm{Reading}\big(\mathbf{A}^{(l-1)},\mathbf{S}^{(l-1)}\big),\\ \big(\mathbf{F}^{(l)},\mathbf{A}_s^{(l)},\bar{\mathbf{A}}_p^{(l)}\big)&=\mathrm{Mixing}\big(\mathbf{F}^{(l-1)},\hat{\mathbf{A}}^{(l)}\big),\\ \mathbf{A}_p^{(l)}&=\mathrm{Enhancing}\big(\mathbf{F}^{(l)},\bar{\mathbf{A}}_p^{(l)}\big). \end{aligned} \tag{17} $$
经过 $L$ 个 block 后,$\mathbf{F}$ 与 $\mathbf{A}_s$ 充当跨任务全局表示,$\mathbf{A}_p^{(t)}$ 编码任务特定语义特征。每个任务塔接收对应的 Private Anchor,加上来自 $\mathbf{F}$ 与 $\mathbf{A}_s$ 的共享语义——既保留跨任务上下文,又保持任务特定预测。
值得注意:MORE 并没有取消后置的任务塔,只是把塔的输入从「单一共享表示」换成了「任务特定 Private Anchor + 共享语义」。这与 OneRank 这类「彻底消除 encoder–predictor 切分、用动态匹配打分取代 MLP 塔」的路线不同(见第十节)。
3.4 请求级训练与推理¶
工业排序里单个请求通常涉及数千候选。在逐候选(per-candidate)部署下,每个候选独立前传,用户侧序列编码与共享特征计算被重复 $C$ 次。
受 HSTU 的请求级组织启发,MORE 采用请求级共享计算统一训练与推理的样本组织:一个请求下的 $C$ 个候选被聚合成单个样本——用户侧序列 $\mathbf{S}$ 只编码一次并广播,per-candidate 的 $\mathbf{F}$ 与 Anchor Token 沿 item 维组织。推理时候选被切成 mini-batch,每个 mini-batch 内用户侧计算在所有候选间共享。
论文强调这与 MORE Block 的内部状态结构天然对齐:$\mathbf{S}$ 是用户级共享状态,经逐层变换演化而不依赖候选信息(Eq. 6);per-candidate 差异只通过 $\mathbf{F}$ 与 Anchor Token 表达,不参与序列前向计算。因此请求级共享计算不需要对骨干做任何架构适配,把线上打分延迟降低约 30%。
这是 MORE 架构里最扎实、也最可迁移的一点:把「用户级状态」与「候选级状态」在架构层面显式分离,使请求级摊销成为免费午餐。但正因为「不需要架构适配」,这一收益并非 Anchor Token 机制独有——任何把用户侧序列塔与候选侧解耦的统一骨干(包括 HyFormer 的 Global Token 接口、OneTrans 的金字塔压缩)原则上都能做同样的摊销。详见第十一节的复核 4。
四、实验设置¶
4.1 数据集¶
离线实验在陌陌的 Nearby Feed 上进行——一个社交多媒体信息流,用户在其中发现附近陌生人的帖子并与感兴趣的人建立连接。数据集来自连续 90 天的线上推荐日志用于训练,紧随其后的一天用于评估。输入特征包括序列特征(用户近期多类型行为历史)与非序列特征(用户画像、候选内容属性、场景上下文)。
全文没有任何公开学术数据集实验——所有结论都建立在陌陌的私有日志上,外部无法复现。
4.2 任务与指标¶
模型联合优化十三个任务,覆盖浏览、互动与社交连接,包括 click、like、comment、follow、greet、reply、avatar-click 与 deep chat(至少五轮的对话)等。主指标是 GAUC(Group AUC):按用户算 AUC 再跨用户平均,反映个体级排序质量。
任务数量三处不一致(论文未调和):§4.1.2 说「thirteen tasks」;§4.1.4 说「9 个 Private Anchors 对应 core tasks」,而 §3.3 明确写 Private Anchor「one per task」(即 $T$=任务数);Table 1 只报告七个任务。三个数字(13 / 9 / 7)之间没有任何解释。若 $T=9$,则有 4 个被联合优化的任务没有自己的 Private Anchor,这与 Eq. (5) 的 $t=1,\dots,T$ 定义直接冲突;若 $T=13$,则 $H=15+8+13=36$ 无法整除 $d=256$。按整除性反推,$T=9$ 才自洽,也就是说方法描述里的「one per task」在实际配置里并不成立。
4.3 基线¶
基线跨两个范式:
- 两阶段基线(序列编码与特征交互分离):参考配置是 Transformer + RankMixer;变体把特征交互模块换成 Wukong 或 DCN-v2,把序列编码器换成 HSTU。STCA 单列,因为它把序列编码与 RankMixer 式特征交互集成进单一流水线。
- 统一骨干基线:MixFormer、HyFormer、OneTrans。
「All methods are reimplemented in the same framework with identical training data, schedule, evaluation protocol, and hyperparameter budget.」——注意措辞是预算相同,不是「每个模型各自调到最优」。
4.4 实现细节¶
MORE 默认 $L_{\text{block}}=2$ 个 MORE Block,隐藏维 $d=256$,$M=15$ 个非序列 token,17 个 Anchor Token(8 个 Shared + 9 个 Private,对应核心任务)。用 Adam 优化,batch size 1024,在多 GPU 数据并行集群上训练。§4.4 的 scaling 研究联合扩 layer 数与隐藏维,参数量从约 0.1B 扩到 0.9B,per-example 前向 FLOPs 从约 1.4G 扩到 11G。
未报告的超参:学习率、训练步数/epoch 数、序列长度 $N$、任务损失权重 $\lambda_t$、head 数、warmup、正则、随机种子数。
五、主要实验结果¶
Table 1: Offline GAUC comparison on seven tasks. Transformer+RankMixer 报绝对 GAUC,其余行报相对变化。Params 为 dense 参数,FLOPs 为 per-example 前向计算量。
| Method | Category | Click | Like | Comment | Greet | Reply | Avatar-click | Deep Chat | Params | FLOPs/Ex. |
|---|---|---|---|---|---|---|---|---|---|---|
| Transformer+RankMixer | Two-Stage | 0.7863 | 0.6892 | 0.6979 | 0.7279 | 0.8388 | 0.7073 | 0.8444 | 77.85M | 1.92G |
| Transformer+Wukong | Two-Stage | +0.03% | -0.27% | -0.65% | -0.53% | -0.15% | -0.36% | -0.46% | 79.01M | 1.90G |
| HSTU+RankMixer | Two-Stage | +0.09% | -0.23% | -0.57% | -0.34% | -0.10% | -0.25% | -0.24% | 77.19M | 1.76G |
| Transformer+DCN-v2 | Two-Stage | +0.12% | +0.53% | -0.04% | -0.02% | -0.16% | +0.17% | -0.47% | 111.78M | 1.68G |
| STCA | Two-Stage | +0.13% | +0.66% | +0.38% | -0.01% | +0.02% | +0.06% | -0.07% | 88.21M | 2.36G |
| MixFormer | Unified | +0.29% | +1.13% | +0.89% | +1.25% | +0.49% | +0.70% | +0.15% | 98.68M | 4.65G |
| HyFormer | Unified | +0.43% | +0.89% | +1.09% | +1.32% | +0.42% | +0.82% | +0.08% | 153M | 2.16G |
| OneTrans | Unified | +0.38% | +1.15% | +0.80% | +1.44% | +0.58% | +0.86% | +0.11% | 108.65M | 1.73G |
| MORE | Task-Aware Unified | +0.44% | +1.47% | +1.26% | +1.58% | +0.62% | +1.02% | +0.33% | 132M | 1.85G |
逐组分析(原文):
- 单独替换特征交互或序列建模组件,对多任务排序的收益有限且不稳定。 把 RankMixer 换成 Wukong 或 DCN-v2 会让多数任务退化——DCN-v2 让 Deep Chat 掉 -0.47%,印证 RankMixer 作为特征交互骨干的优势;把 Transformer 换成 HSTU 做序列编码只有 Click 受益(+0.09%),其余任务全退化。
- STCA 把序列编码与特征交互集成进单一流水线,相对完全分离的基线提升了互动级任务(Like +0.66%、Comment +0.38%),但其骨干仍是任务无关的,Greet(-0.01%)与 Deep Chat(-0.07%)这类更深的社交任务变化可忽略甚至为负。
- 统一序列-特征骨干进一步缓解了这一局限:MixFormer、HyFormer、OneTrans 在每个任务上都有提升,OneTrans 在 Greet 上达 +1.44%,HyFormer 在 Comment 上达 +1.09%。但三者跨任务的提升模式高度相似,与「骨干任务无关、只在预测头分叉」一致。
- MORE 在 Table 1 的全部七个任务上领先(Greet +1.58%、Like +1.47%、Deep Chat +0.33%),在「行为序列信号需要任务特定读取」的互动与社交任务上增益尤其明显。
效率权衡: MORE 参数增至 132M(仍低于 HyFormer 的 153M),但 per-example FLOPs(1.85G)低于参考基线(1.92G),也远低于 STCA(2.36G)、HyFormer(2.16G)与 MixFormer(4.65G)。相对 FLOPs 更低的 OneTrans(1.73G),MORE 只多 0.12G/example,却在所有任务上胜出。效率来自「用一组紧凑的 Anchor Token 注入多任务容量」而非复制骨干或大幅增加 token mixing。
独立复核(本报告新增): 三个统一骨干(MixFormer / HyFormer / OneTrans)之间的差距其实很小。按七任务算术平均,MORE +0.96%、OneTrans +0.76%、HyFormer +0.72%、MixFormer +0.70%,即 MORE 相对最强公开统一骨干(OneTrans)的领先只有 0.20 个百分点,而 OneTrans 相对 MixFormer 的领先已有 0.06 个百分点。同时 MORE 的参数量比 OneTrans 高 21.5%(132M vs 108.65M)——论文摘要里「under comparable parameter and FLOPs budgets」的「comparable」在参数轴上是一个 21% 的差距,且没有做等参对照(唯一的等参证据是 Figure 3,见第七节,但那条曲线给出的等参差距远小于 0.20pp)。所有数字均为单次运行,无种子、无方差、无置信区间。
六、消融实验¶
Table 2: Ablation study on MORE components. Interaction 为 like / comment / greet 的平均 GAUC;Average 为 Click、Interaction、Chat 三列的算术平均。(相对完整 MORE 的变化)
| Configuration | Click | Interaction | Chat | Average |
|---|---|---|---|---|
| Ablation of Token Process | ||||
| w/o Cartesian Encoding | -0.06% | -0.10% | -0.08% | -0.08% |
| w/o Anchor From Context | -0.08% | -0.04% | -0.17% | -0.10% |
| Ablation of Seq Reading | ||||
| w/o Private Seq Reading | -0.15% | -0.19% | -0.12% | -0.15% |
| w/o Seq Register | -0.02% | -0.01% | -0.13% | -0.05% |
| Ablation of Mixing and Enhancing | ||||
| w/o Boundary Gating Mask | -0.16% | -0.34% | -0.11% | -0.21% |
| w/o Task Enhancing | -0.11% | -0.13% | -0.17% | -0.14% |
| Ablation of all Components | ||||
| BaseArch | -0.23% | -0.38% | -0.39% | -0.33% |
原文分析: 两个 Token Process 组件让模型从最初阶段就获得多任务感知,移除后各任务一致下降 0.04%–0.10%。Private Seq Reading 用 per-task 独立参数增强每个 private anchor 的行为序列感知;Seq Register 建立序列寄存器、维持低层序列细节。Boundary Gating Mask 隔离不同 Private Anchor 之间的信息流(Eq. 12),在保留全局语义交互的同时防止跨任务语义污染。Task Enhancing 通过轻量的独立 per-task 分支注入判别信息,贡献 0.11%–0.17% GAUC。
单组件中 Boundary Gating Mask 移除后的平均退化最大,在 Interaction 上掉 0.34%。原文给出的机制解释是:「Without the mask, gradient signals from high-frequency tasks dominate shared mixing weights, diluting the representations that interaction and social tasks rely on.」 因此 mixing 阶段的任务边界控制,比 reading 或 enhancing 阶段单独的 per-task 容量更关键。
全部六个组件移除后,模型退化为 BaseArch——一个只保留多个预测头做多任务打分的任务无关统一骨干,平均 GAUC 下降 0.33%。原文称这体现了各组件对最终性能的累积贡献。
6.1 独立复核(本报告核心)¶
(a)Table 2 的内部算术自洽。 逐行验算 Average 是否等于三列均值:BaseArch $(-0.23-0.38-0.39)/3=-0.3333$,报 -0.33 ✓;w/o Boundary Gating Mask $(-0.16-0.34-0.11)/3=-0.2033$,报 -0.21(四舍五入到 -0.20 更准,但差 0.007pp,属排版取整);其余行同量级。Table 2 的 Average 列定义与实际计算一致,可以放心用来折算。
(b)折回 Table 1 口径。 把 Table 1 的 MORE 行按 Table 2 的三列定义重算:Click = +0.44%;Interaction = mean(1.47, 1.26, 1.58) = +1.4367%;Chat = Deep Chat = +0.33%;Average = +0.7356%。加上 BaseArch 的 -0.33%,得
$$\text{BaseArch}_{\text{Table-1 口径}} = 0.7356\% - 0.33\% = \mathbf{+0.4056\%}$$
而同一口径下三个公开统一骨干为:OneTrans +0.5400%、HyFormer +0.5367%、MixFormer +0.5100%。
折算合法性检验(三项): 1. 加性 vs 乘性:严格应为 $(1+a)(1+b)-1$。乘性结果 0.40313% vs 加性 0.40556%,差 0.0024pp,可忽略。 2. Interaction 列的加权口径:Table 2 定义 Interaction 为「like/comment/greet 的平均 GAUC」的相对变化,而我用的是三个相对变化的算术平均。用 Table 1 的绝对 GAUC 基线(0.6892 / 0.6979 / 0.7279)做正确加权后,MORE 为 +1.4386%(vs 未加权 +1.4367%),OneTrans +1.1343%(vs +1.13%)——差 ≤0.005pp,同样可忽略。 3. Table 2 的参照系:论文未明写,但所有消融行均为负、且 BaseArch 定义为「移除全部组件」,唯一自洽的读法是相对完整 MORE。
结论:折算成立,用户转述属实。 BaseArch 的 +0.41% 确实低于 OneTrans / HyFormer 的 约 +0.54%(分别低 0.134pp 与 0.131pp),也低于 MixFormer 的 +0.51%。因此那 0.33 个点不能整体读作 Anchor 机制的架构价值——它是相对于一个弱于所有公开统一骨干的自建底座测出来的。MORE 相对最强公开统一骨干的真实增量是 +0.196pp(Table-2 三列口径)/ +0.200pp(七任务均值口径),两种算法高度一致。
(c)逐任务折算揭示 BaseArch 有多弱。 把 BaseArch 折回 Table 1 的三个口径:
| Click | Interaction | Chat (Deep Chat) | Average | |
|---|---|---|---|---|
| MORE | +0.44% | +1.437% | +0.33% | +0.736% |
| BaseArch(折算) | +0.21% | +1.057% | -0.06% | +0.406% |
| OneTrans | +0.38% | +1.130% | +0.11% | +0.540% |
| HyFormer | +0.43% | +1.100% | +0.08% | +0.537% |
| MixFormer | +0.29% | +1.090% | +0.15% | +0.510% |
| Transformer+RankMixer(参考) | 0.00% | 0.000% | 0.00% | 0.000% |
BaseArch 在 Deep Chat 上是 -0.06%——不仅低于全部三个统一骨干,还低于两阶段参考基线本身。 Deep Chat 恰恰是本文在摘要与线上 A/B 里作为「深度社交连接」标杆的旗舰任务。这意味着:MORE 在旗舰任务上的 +0.33% 里,有 0.39pp 是把自家底座从「比两阶段基线还差」拉回正常水位,只有 +0.22pp 是相对 OneTrans 的净增量。
(d)消融归因之和 = 可解释空间的 2.21 倍(UniCon 同型病理)。 六个单组件消融的 Average 退化之和为 -0.73pp,而全部移除只掉 -0.33pp:
$$\frac{|{-0.73}|}{|{-0.33}|}=\mathbf{2.21\times}$$
这与归档里 UniCon(2609.03290)被复核出的 2.1 倍几乎相同。两种解释都指向同一个问题:要么六个组件之间高度冗余(任意一个被拿掉,其余五个能补回大半),要么单组件消融没有等参对照(拿掉一个组件顺带减少了参数量,掉分里混着容量损失)。论文对此没有任何讨论,且没有报告任何消融变体的参数量与 FLOPs——包括 BaseArch。
七、Scaling 分析¶
为检验 MORE 的任务感知机制在不同模型容量下是否仍然有效,scaling 研究联合调整 MORE Block 数与隐藏维,覆盖约 0.1B 到 0.9B 参数。任务无关基线是一个按 HyFormer 设计交替「序列 cross-attention」与「token mixing」的统一骨干,扩到同样的参数区间但不含任务感知组件。每个配置在同样的数据上独立训练、同一协议评估。Figure 3 报告相对线上生产模型的全任务平均 GAUC 提升,分别对参数量与 per-example 前向 FLOPs 作图。
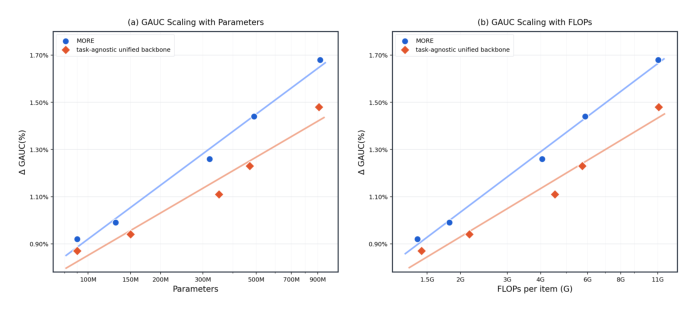
原文结论: 拟合趋势显示 MORE 在参数与算力两个轴上都 scale 得更有效,在可比预算下始终高于任务无关统一骨干。任务无关基线也随规模提升,但增长更慢,说明额外容量与算力被转化为多任务 GAUC 收益的效率更低。「At the smallest configuration both approaches yield comparable GAUC; as capacity grows the gap widens」——确认任务无关的扩参无法替代 per-task 信号分离。
7.1 独立复核¶
从图上读数(近似):最小配置处(约 0.1B)MORE ≈ +0.92%、任务无关基线 ≈ +0.87%,差距约 0.05pp;最大配置处(约 0.9B)分别为 ≈ +1.69% 与 ≈ +1.48%,差距约 0.21pp。
由此产生两个论文自身未调和的问题:
- 等参差距与 Table 1 的差距对不上。 Table 1 的 MORE 是 132M,落在 Figure 3 最左侧两点之间,而论文自己承认「最小配置两者 GAUC 相当」。也就是说,在 Table 1 所用的规模上,MORE 相对一个 HyFormer 式任务无关骨干的等参优势只有约 0.05–0.08pp,而 Table 1 却报出相对 HyFormer 的 0.20pp(Avg3)/ 0.24pp(Mean7)优势——两者相差 3–4 倍。 二者参照系不同(Figure 3 用「线上生产模型」、Table 1 用 Transformer+RankMixer),论文没有给出任何换算桥梁,所以无法判断这个差异来自参照系、来自 Figure 3 基线比 Table 1 的 HyFormer 更强(把 Figure 3 与 Table 1 按 Mean7 对齐后,Figure 3 的任务无关基线在 130M 处约 +0.90%,而 Table 1 的 HyFormer 在 153M 处只有 +0.72%),还是来自单次运行的噪声。无论哪种解释,Table 1 里 MORE 相对 HyFormer 的差距都比 Figure 3 的等参证据大得多。
- 任务感知带来的参数效率倍数是有限的。 从图上看,任务无关基线在约 500M 处达到 MORE 在约 300M 处的水平,在约 900M 处(+1.48%)超过 MORE 在约 500M 处(+1.43%)。也就是说,MORE 的任务感知机制大致相当于 1.5–2 倍参数量的收益——真实但不戏剧性,且与「0.2pp 的离线净增量」量级自洽。
另外:Figure 3 只有 5 个数据点、无误差棒、无拟合系数(斜率/$R^2$),正文也没有给出任何数值表格。所有「scale 得更有效」的结论都建立在两条肉眼拟合线上。
八、线上 A/B 与部署¶
MORE 在陌陌 Nearby Feed 推荐场景中对照生产环境的 DLRM 式排序模型评估。两周线上 A/B,均衡流量分桶;实验期间指标稳定、无退化趋势。
Table 3: Online A/B test results on Momo Nearby Feed over two weeks. MORE 替换生产排序模型。
| Metric | Relative Lift |
|---|---|
| Usage Duration | +3.0% |
| Click | +2.8% |
| Like | +2.0% |
| Comment | +3.6% |
| Greet | +2.5% |
| Deep Chat | +2.0% |
六项主要线上指标覆盖 session 级参与度、浅层互动与深度社交连接,全部改进具统计显著性(p<0.05)。原文解读:使用时长 +3.0% 反映社交发现场景里整体参与度的提升;Click(+2.8%)、Like(+2.0%)、Comment(+3.6%)表明模型推出了更相关的内容、提升互动质量;Greet(+2.5%)与 Deep Chat(+2.0%)代表更强的社交匹配——模型推出了用户更愿意打招呼、也更可能持续对话的人。
部署与延迟: 配合 §3.5 的请求级共享计算,MORE 相对其逐候选服务基线把 P99 打分延迟降低约 30%,满足高并发推荐服务的延迟约束。收益来自 mini-batch 内跨候选共享用户侧序列计算,摊薄统一骨干的 per-candidate 成本。MORE 已上线并服务该场景的线上流量。
九、核心贡献总结¶
- 识别出统一排序骨干里的一个结构性缺口:多任务建模被限制在后置预测头,骨干本身任务无关;并分析了由此产生的任务特定信息流、表征容量与 scaling 效率三方面局限。
- 提出 MORE:一个任务感知的统一骨干,用 Anchor Token(Shared Anchors 承载跨任务语义 + Private Anchors 承载每任务先验)让多任务信号与序列、特征表示在所有骨干层共演化,每个 block 内有显式的任务边界隔离。因为架构把用户级序列状态与per-candidate anchor 状态分离,还顺带支持请求级并行打分,把线上延迟降约 30% 且无需修改模型。
- 实验:大规模工业数据上七任务在可比 FLOPs 预算下全部正增益;参数与算力的扩展被转化为多任务收益的效率高于任务无关方案;数千万 MAU 社交平台上的线上 A/B 在浏览、互动、深度社交三个层面一致提升;已生产部署。
十、与已归档相关工作的对比¶
OneRank OneRank: Unified Transformer-Native Ranking Architecture for Multi-Task Recommendation(中国人民大学高瓴 + Shopee + NTU, 2026-06-15)¶
关系:独立并发(本文未引用 OneRank,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇给出的 root cause 几乎逐字同构。OneRank 称之为「编码器–预测器($\mathcal{F}$–$\mathcal{G}$)分离」:Transformer 只当任务无关编码器 $\mathbf{Z}=\mathcal{F}(\mathbf{X})$,任务特异信号在共享表示里被纠缠丢失,下游只剩「建模容量受限」的静态前馈任务塔去做解纠缠;本文称之为「task-blind backbone / structural bottleneck before task differentiation」,并同样强调这是结构性而非路由容量问题。两者都把 MMoE/PLE 归为「在已压缩表示上做浅层路由」。
- 相近的技术骨架:两者的核心手法可以画成同一张流程图——把一组跨样本共享的可学习「任务 token」注入骨干、让它们贯穿整个栈、并用一个使任务 token 之间互不可见的结构化 mask 阻断跨任务污染、最后从这些 token 的输出读出每任务表示。MORE 的 Private Anchor $\mathbf{A}_p^{(t)}$ + task-boundary mask(「each Private Anchor is only visible to itself」)与 OneRank 的任务 token $\mathbf{t}_k$ + 结构化注意力 mask(Eq. 4 的「$\mathbf{t}_k^{(i)}$ 只能注意用户上下文、候选 embedding 与它自己」)是同一个设计。MORE 的 Shared Anchor 对应 OneRank 前置于所有候选组的共享用户上下文前缀。
- 本文的差异与推进:(1) MORE 把序列做成独立演化的用户级状态流(Eq. 6–7 的 $\tilde{\mathbf{S}}$ 与寄存器 $\boldsymbol{\eta}$),Anchor 只以 cross-attention 去读——这换来请求级摊销与 P99 -30%;OneRank 把历史、偏好锚、候选–任务组拼成一条长序列跑单一 self-attention 栈,规模只到 2 层 / 4.9M。(2) MORE 在非序列侧引入 RankMixer 式 token-mixing 与 FiLM 式 per-task 增强,OneRank 没有对应模块。(3) 反过来,OneRank 在两个方面更彻底:它用动态匹配打分($s_k^i=\mathbf{z}_k^\top\mathbf{r}_k^i$)取消了静态 MLP 任务塔,而 MORE 仍保留 $T$ 个预测塔——按 MORE 自己的论证逻辑,保留塔就等于保留了一部分「后置浅层路由」;它还用策略性梯度解耦把跨任务注意力变成「只读记忆」,在允许前向知识迁移的同时阻断反向梯度冲突。
- 可比的方法 / 实验差异:最尖锐的一点是跨任务可见性的处理。OneRank 把它当作可配置设计轴,给出 Parallel(互不可见)/ Null(全可见)/ Cascade(稠密→稀疏单向)/ Hybrid 四种 mask 策略并论证不同场景适配不同策略;MORE 则硬编码为完全互不可见(相当于 OneRank 的 Parallel),其唯一相关消融「w/o Boundary Gating Mask」是把 mask 整个拿掉(相当于 Null),从未测试 Cascade / Hybrid 这类中间态。在陌陌 click → greet → deep chat 这条天然存在稠密到稀疏级联的社交漏斗上,这是一个明显的未探索维度。实验上两者不可直接比较:OneRank 在 Shopee 私有数据上做,MORE 在陌陌私有数据上做,均无公开数据集;线上 A/B 分别为 Shopee GMV/UU +1.01%(7 天)与陌陌使用时长 +3.0%(14 天)。
IntHQ IntHQ: Task-Interactive Hierarchical Query on Dual-Stream Representations(DreamX, Alibaba Group / 高德, 2026-08-10)¶
关系:独立并发(本文未引用 IntHQ,两者殊途同归)· 已加载对方精读
- 共同关注的问题:IntHQ 的「来源坍缩(source collapse)」定义是「任务信号注入太晚、在共享空间被稀释」,与 MORE 的第②条局限(「任务特定特征偏好在任何任务差异化开始之前就被压进单一语义空间」)是同一句话的两种写法。IntHQ 进一步论证:上下文计算的角色是「把序列压缩成能持续的东西」,任务计算的角色是「在当前情境下做判别」,两种角色对同一组参数有不同最优点,因此必须活在解耦的参数空间里——这正是 MORE 给 Private Anchor 配 per-task $\mathrm{CrossAttn}_p^{(t)}$ 与 per-task Enhancing 分支的动机,只是 MORE 没有把它讲成一个原理。
- 相近的技术骨架:IntHQ 的 DSD(双流解耦)与 MORE 的 Anchor Token 机制几乎是同一个模块:任务 token 构成独立于上下文流的第二条流,用参数不相交的注意力核,逐层以 cross-attention 查询上下文流的 KV,且 KV 取自当前层输入而非自注意力输出,使两步计算可并行;上下文流的残差更新里完全没有任务项(task-free)。对照 MORE 的 Eq. (6)(8)(9):$\mathbf{K},\mathbf{V}$ 来自 $\tilde{\mathbf{S}}=\mathrm{SwiGLU}(\mathbf{S})$,Anchor 做 Query,而 $\tilde{\mathbf{S}}$ 独立前传到下一层、不接收来自 Anchor 的任何回写——两者的信息流拓扑完全一致(上下文单向流向任务流)。
- 本文的差异与推进:(1) MORE 面向判别式排序 + 非序列特征交互,因此多出 Selective Semantic Mixing 这条把 $\mathbf{F}$ 与 anchor 混合的通路;IntHQ 面向生成式推荐 + 大标签空间(InfoNCE / 采样 softmax),没有非序列 token 侧的 mixing。(2) 跨任务交互方向相反:IntHQ 的 TIM 主动加入任务 token 之间的因果自注意力(via 能看到已实现的 where/when/how,反向屏蔽),并明确批评 OneRank 的梯度解耦「会丢掉有用的跨任务信号」;MORE 则彻底禁止 Private Anchor 互相可见,并把这条禁令做成最大收益的单组件(-0.34% on Interaction)。同一条设计轴上两篇给出相反的答案,且都只用最终指标佐证。(3) IntHQ 有 HQ(分层查询)——在深度轴上做注意力选层;MORE 只取最后一层 Private Anchor,未探索深度选择。
- 可比的方法 / 实验差异:方法论上最值得对照的是「root cause 有没有被直接测量」。 IntHQ 用信息论定理(坍缩分解 $R_{\text{TAE}}(z)-R^\star=\sum_k I(\mathcal{A};y_k\mid z)+\mathrm{TC}(y\mid\mathcal{A})$,两项依赖关系不相交因而需要不同结构去治)加命题 2 的共享块折中代价二次型上界给出可证伪诊断,并在 §4.1 用逐层线性探针实证建立层级坍缩;MORE 对同一类主张(「task-blind」「information flow」)没有任何理论刻画,也没有任何探针/梯度/表示层测量(详见第十一节复核 2)。工业证据上两者可比:IntHQ 高德全量上线 UVCTR +1.60%、30k QPS / 40ms、encoder FLOPs 低于所有基线;MORE 陌陌上线、六项指标 p<0.05、P99 -30%。
Step 2.5 被剔除的近似候选(保留剔除理由,防止门槛放水) - PTDG PTDG(Huawei,2026-09-04,早于本文 3 天且未被引用):同为多任务、同样存在「root cause 从未被测量」的病理,但其 root cause 是转化漏斗上的信号侵蚀,解法(实例级低秩任务依赖图 + GCN)完全活在任务塔空间,与 MORE 的「把任务信号搬进骨干」方向相反。方法论同类现象,非问题+解法双同构 → 作为讨论素材(第十一节),不作孪生。 - UniCon UniCon(Meituan,2026-09-03,未被引用):同属统一骨干家族,且同样出现「退化变体跑不过公开基线」([email protected] vs OneTrans [email protected])与「消融归因之和 ≈ 可解释空间 2.1 倍」。但其 root cause 是序列/非序列切分本身是特征工程遗留,是单任务 CTR 问题,与多任务信息流无关。→ 讨论素材。 - HubMixer HubMixer(Kuaishou,2026-08-28):同样的退化变体病理(去 hub 自注意力后 0.8232 < RankMixer 0.8238),但它是单任务特征交互的 token mixing 方法,问题不同构。→ 讨论素材。 - UniR2 UniR2(Kuaishou,2026-07-27):有「任务特定可见性掩码」(DQ-PCA),但问题是统一生成式召回与排序,不是骨干任务盲。 - HA-MoE HA-MoE(Google,2026-07-30):与本文共享 FiLM 式仿射调制这一手法,但调制信号是内容异质性,且作用在 MMoE 专家输出上——依然是后置塔内的改造,与 MORE 的 root cause 相反。 - RankUp RankUp(Tencent,2026-04-20):MetaFormer 排序器里确实加了 task-specific token,但诊断的 root cause 是有效秩坍缩,task token 只是五个正交技巧之一。
十一、讨论与局限性¶
11.1 值得借鉴的设计¶
- 用户级状态 / 候选级状态的架构性分离:$\mathbf{S}$ 在 Eq. (6) 里演化时完全不依赖候选信息,per-candidate 差异全部由 $\mathbf{F}$ 与 Anchor Token 承载。这个不变式一旦成立,请求级摊销就是免费的——不需要任何架构适配。这是全文最干净、最可迁移的工程 insight。
- 序列寄存器 $\boldsymbol{\eta}$ + per-anchor 独立门控:用一个 $d$ 维状态跨 block 累积序列摘要,再让每个 anchor 用自己的 SwiGLU 去解读它,是一种极廉价的「跨层记忆 + 角色分化」组合(Eq. 7–9)。消融显示它单独贡献很小(Average -0.05%),但在 Chat 上有 -0.13%,说明它主要救的是稀疏深层任务。
- 笛卡尔积行为编码:把「行为类型组合」而非单一行为类型编成 token ID,让同一 item 在不同行为组合下成为不同 token,是一个便宜且明确指向多任务的输入侧改造。
11.2 四点必须独立复核的问题(本报告结论)¶
复核 1:Table 2 → Table 1 的折算是否成立?成立,且结论比转述更严重。¶
见 §6.1。三项合法性检验(加性 vs 乘性差 0.0024pp;Interaction 加权口径差 ≤0.005pp;Table 2 参照系唯一自洽读法为「相对完整 MORE」)全部通过。BaseArch 折回 Table-1 口径为 +0.4056%,低于 OneTrans 的 +0.5400% 与 HyFormer 的 +0.5367%,也低于 MixFormer 的 +0.5100%。因此那 0.33 个点不能作为架构价值读,MORE 相对最强公开统一骨干的净增量是 +0.196pp(三列口径)/ +0.200pp(七任务均值口径)。
比转述更严重的两点:
- BaseArch 在 Deep Chat 上折算为 -0.06%,低于两阶段参考基线本身,而 Deep Chat 正是全文标榜的旗舰社交任务;
- 六个单组件消融的退化之和 -0.73pp 是全消融 -0.33pp 的 2.21 倍,与 UniCon 的 2.1 倍如出一辙,说明归因空间被系统性超额分配。
复核 2:消融变体是否重新调过参?没有任何证据表明调过,而且论文的措辞暗示恰恰相反。¶
- §4.1.3 唯一的公平性声明是针对基线的:「identical training data, schedule, evaluation protocol, and hyperparameter budget」——是「预算相同」,不是「各自调到最优」;
- §4.3 关于消融只字未提训练配置、重新调参、参数量或 FLOPs;
- §4.4 的「Each configuration is trained independently on the same data and evaluated under the same protocol」只覆盖 scaling 配置,不覆盖消融;
- 全文出现 0 次 seed / variance / std / confidence / interval,Table 1、Table 2、Figure 3 全部无误差棒,唯一的显著性声明是 Table 3 那一句针对线上的 p<0.05。
因此七个消融变体(含 BaseArch)都是单配置、单次运行、未重新调参、未做等参对照的结果。在 0.05–0.33pp 这个量级上,这些数字无法与种子噪声区分。
复核 3:「task-blind」这个 root cause 有没有被直接测量?基本没有——只有第三条子主张有一个聚合指标层面的间接证据。¶
统计全文(去参考文献):「information flow」出现 16 次、「task-agnostic」18 次、「task-aware」25 次、「task-blind」9 次;而 「gradient」只出现 2 次,两次都是断言:
- §3.3.1:笛卡尔积编码「mitigating cross-task gradient conflicts at each position」;
- §4.3:「Without the mask, gradient signals from high-frequency tasks dominate shared mixing weights, diluting the representations that interaction and social tasks rely on」。
这两条都是梯度层面的机制断言,全文没有一张梯度范数曲线、没有任务间梯度夹角/冲突率统计、没有高频任务权重占比的度量。 同样为零的还有:attention map 可视化(0)、表示相似度/CKA 分析(0)、线性探针(0)、互信息或信息论刻画(0)。没有任何实验验证「Private Anchor 真的对同一段行为历史读出了不同的东西」——而这恰恰是标题、摘要、贡献列表反复承诺的东西。
唯一被直接测量的 root cause 子主张是第③条(多任务收益随扩参递减):Figure 3 用 MORE 与一个 HyFormer 式任务无关骨干的两条 scaling 曲线,把「转化效率更低」做成了可观测量。但它仍是聚合指标层面的论证(ΔGAUC vs 参数量),不是机制层面的测量;且只有 5 个点、无误差棒、无拟合系数、正文无数值。
与归档的对照:PTDG(2609.04862)的「signal erosion」断言 12 次、测量 0 次;本文的「information flow」断言 16 次、机制层面测量 0 次——病理同型,量级更甚。反例是同轴的 IntHQ(2608.09634):它把三重坍缩写成信息论定理,并用逐层线性探针实证建立层级坍缩。IntHQ 证明这条轴上的机制测量是可做的,本文只是没做。
复核 4:线上 A/B 与离线增量是否自洽?量级差 15 倍,但两者根本不可比——因为对照组不同。¶
线上对照组是现网系统,不是 BaseArch,也不是任何离线基线。 §4.5 原文:「MORE is evaluated in the Nearby Feed recommendation scenario of Momo against the production DLRM-style ranking model」。Table 3 的 +2.0%~+3.6% 因此是「MORE 换掉整套遗留生产栈」的总收益,里面打包了:统一骨干(相对 DLRM 式的架构换代)、请求级训练/推理重组、笛卡尔积多行为编码、更大的容量,以及 Anchor 机制本身。它没有隔离出那 0.2pp 的任务感知增量。 全文没有 MORE vs OneTrans / HyFormer 的线上 A/B,也没有 MORE vs BaseArch 的线上 A/B。
因此「离线 0.2pp vs 线上六项全显著」并不构成矛盾,但也不构成互相印证——它们测的是两件不同的事。量级上:MORE 相对 Table-1 参考基线的七任务均值 +0.96% 是相对 GAUC 变化,落在 GAUC≈0.79 上约为 0.0055 的绝对 GAUC 提升,用来解释 +3.0% 时长是合理的;但相对 OneTrans 的 +0.20% 相对提升只对应约 0.0015 绝对 GAUC,那不是被 A/B 测过的东西。论文自己也从未声称线上结果验证了架构主张——但摘要把两者并列陈述,读者极易误读。
统计与护栏的缺失同样值得记:
- Table 3 只有点估计,无置信区间、无每指标 p 值、无绝对量级、无流量规模/桶数、无 A/A 检验;唯一的显著性表述是一句涵盖全部六项的「All reported improvements are statistically significant (p<0.05)」;
- 零护栏/反向指标。六项全是同向正指标。在一个社交发现产品里,Greet 与 Deep Chat 恰恰是最容易以体验为代价被推高的指标(骚扰率、举报率、被打招呼方的负反馈、内容多样性、广告收入),论文对此一项未报;稳定性的唯一证据是定性的一句「metrics remain stable throughout the experiment with no degradation trend」;
- 全文 0 次 guardrail / confidence / interval。
复核 4b:P99 延迟 -30% 是怎么来的?与质量增益是同一套配置吗?是自比,不是他比;配置未披露。¶
- 对照物:§4.5 明写「compared to its per-candidate serving baseline」——是 MORE 自己以逐候选方式服务,不是生产系统,也不是任何基线模型。「MORE 比现网快 30%」是误读。
- 机制归属:请求级组织的出处是 HSTU(§3.5 原文「Inspired by the request-level organization in HSTU」),且论文自己强调它「requires no architectural adaptation of the backbone」。这句话是双刃剑:既然不需要架构适配,任何把用户侧序列塔与候选侧解耦的统一骨干都能拿到同样的摊销——包括 HyFormer(Global Token 接口)与 OneTrans(金字塔压缩)。因此 -30% 不能算作 Anchor Token 机制的架构优势,而是一个正交的服务优化。
- 配置一致性:未披露。Table 1 的质量配置是 $L=2$、$d=256$、132M、1.85G FLOPs/example,但 §4.5 从未说明线上部署的是哪个规模(scaling 研究一直做到 0.9B)。也没有绝对延迟数(ms)、QPS、候选数 $C$、mini-batch 大小、GPU 型号或成本。更微妙的是:Table 1 的 FLOPs 是 per-example 前向,不反映请求级摊销,所以「FLOPs 比参考基线低」与「P99 低 30%」用的是两套互不换算的口径。
11.3 其他局限¶
- 零公开数据集。全部结论建立在陌陌私有 Nearby Feed 日志上,外部完全不可复现,且 Table 1 的所有基线都是作者自己的重实现——在一个「BaseArch 跑不过公开基线」的语境里,基线实现质量本身就是一个未被验证的自由度。
- 任务数量三处不一致(13 / 9 / 7),且按 $H=M+K+T$ 与 $d_h=d/H$ 的整除性反推只有 $T=9$ 自洽,这与 §3.3 的「Private Anchors, one per task」定义冲突(见 §4.2 的注)。
- 未与最接近的已引用前作 INFNet 做实验对比。Related Work 用一句话把 INFNet 打发了(「still share interaction parameters across all tasks」),但 INFNet 不在 Table 1 里,这条差异化声明因此没有任何实验支撑。
- 两条并发的同构工作(OneRank、IntHQ)均未被引用,其中 OneRank 的「任务 token + 互不可见 mask」与本文的「Private Anchor + task-boundary mask」是同一设计,早于本文近三个月。
- 跨任务可见性只测了两个极端。硬编码的完全隔离 vs 完全拿掉 mask,没有测 OneRank 式的 Cascade / Hybrid 中间态——而陌陌的 click → greet → deep chat 是一条天然的稠密到稀疏漏斗,正是 Cascade masking 的教科书场景。
- 超参披露不足:学习率、训练步数、序列长度 $N$、行为组合词表规模、任务损失权重 $\lambda_t$、head 数全部缺失。在 13 任务联合优化里,$\lambda_t$ 通常比架构本身更影响结果。
- 方法论可扩展性方面本文表现良好:MORE 是端到端单阶段架构,没有「先离线压缩再在线建模」这类固化瓶颈;参数量扩展时 Anchor 容量、序列建模容量与特征交互容量可以同步增长,且 0.1B→0.9B 的曲线验证了这一点。这是相对 SIF/IAT 那类两阶段范式的实质优势。
11.4 综合判断¶
MORE 是一篇工程落地扎实、架构干净、但证据链在关键环节断裂的工业论文。它真正立住的是三件事:统一骨干确实全面优于两阶段(Table 1 的统一组 vs 两阶段组差距 0.5pp 以上,稳健);任务感知机制在扩参时确实比任务无关骨干转化率更高(Figure 3,虽只有 5 点无误差棒);用户级/候选级状态分离带来的请求级摊销是真实且可迁移的工程收益。
它没有立住的是标题与摘要承诺的那件事:「多任务信息流」从未被测量。全文 16 次断言 information flow、25 次 task-aware,却没有一次去看 Private Anchor 到底读到了什么、任务梯度到底怎么冲突、表示到底有没有分化。相对最强公开统一骨干的净增量只有 0.2pp(且以 +21.5% 参数为代价、无等参对照、无方差),而全消融的自建底座甚至跑不过 OneTrans/HyFormer——这意味着那 0.33pp 里有约 0.13pp 只是在补齐底座与公开 SOTA 的差距。线上六项显著且已上线是硬证据,但对照组是遗留生产栈,无法为架构主张背书;P99 -30% 是对自家朴素服务方式的自比,且机制借自 HSTU、按论文自述对任何解耦骨干都成立。
读这篇的正确姿势:把 §3.5 的请求级共享计算与 §3.2.1 的笛卡尔积行为编码当作可直接借用的工程配方;把 Anchor Token + task-boundary mask 当作 OneRank / IntHQ 同一条设计轴上的第三个数据点(并注意三者在「跨任务可见性」上给出了互相矛盾的答案,且都只用最终指标佐证);把 Table 1/2/3 的所有数字当作单次运行、无方差、私有数据的观测值来看待。