UniCon: A Unified Context-Centric Modeling Paradigm for CTR Prediction¶
美团(Meituan,北京),9 位作者全部 @meituan.com 署名(Gu Tang、Mengxi Wu 的联系邮箱分别落在 sjtu / buaa 域名,但机构行统一写 Meituan),投稿 KDD '27,arXiv 2609.03290,2026-09-03。
本文面向工业搜索广告的 CTR 精排,提出把"上下文单元"(context unit)而不是 item token / 特征 token 作为统一建模的基本单位:一次曝光里被共同展示的一组 item,连同该次请求的意图、环境信号和用户 token,构成一个结构上同构的单元;历史侧是已观测的曝光列表,目标侧是由当前候选集初始化的"目标潜在上下文单元"。堆叠的 UniConBlock 交替做 intra-context(Locality)与 inter-context(Dynamics)注意力,块间用 target-aware 的上下文级 Top-K 压缩裁剪历史。在美团搜索广告一年期生产数据上离线 AUC 相对生产基线 +0.0139,7 天 20% 流量线上 A/B 拿到 RPM +3.09%、CTR +2.07%、营收 +2.95%(双侧检验 $p \le 0.01$)。
一、研究动机与背景¶
1.1 统一建模的现状与本文指认的错位¶
大模型的 scaling 经验(Brown et al. [1]、Kaplan [3]、Hoffmann [4])正被搬进工业搜广推:CTR 排序模型从"各自为战的专家模块"转向统一建模框架。作者把已有路线归为两类:
- 可扩展特征交互骨干:RankMixer [13]、Zenith [18]、Wukong [12]、SUAN、TokenMixer-Large [19] 重新设计排序骨干,用 GPU 友好算子换更大容量。但它们主要处理特征 token 间的交互,行为序列要么不在主要射程内,要么被单独一条路径处理,同一次历史曝光里的 item 不会被显式地分组。
- 序列与非序列的统一建模:OneTrans [14]、HyFormer [15]、EST [16]、MixFormer [21] 把行为序列和非序列特征放进共享或耦合的 Transformer 通路。OneTrans 用统一 tokenization 加金字塔堆叠与缓存,HyFormer 交替做序列解码与全局特征交互。但它们的组织与加速仍然以单个行为 token / 特征 token / query token 为中心,曝光边界是隐式的。
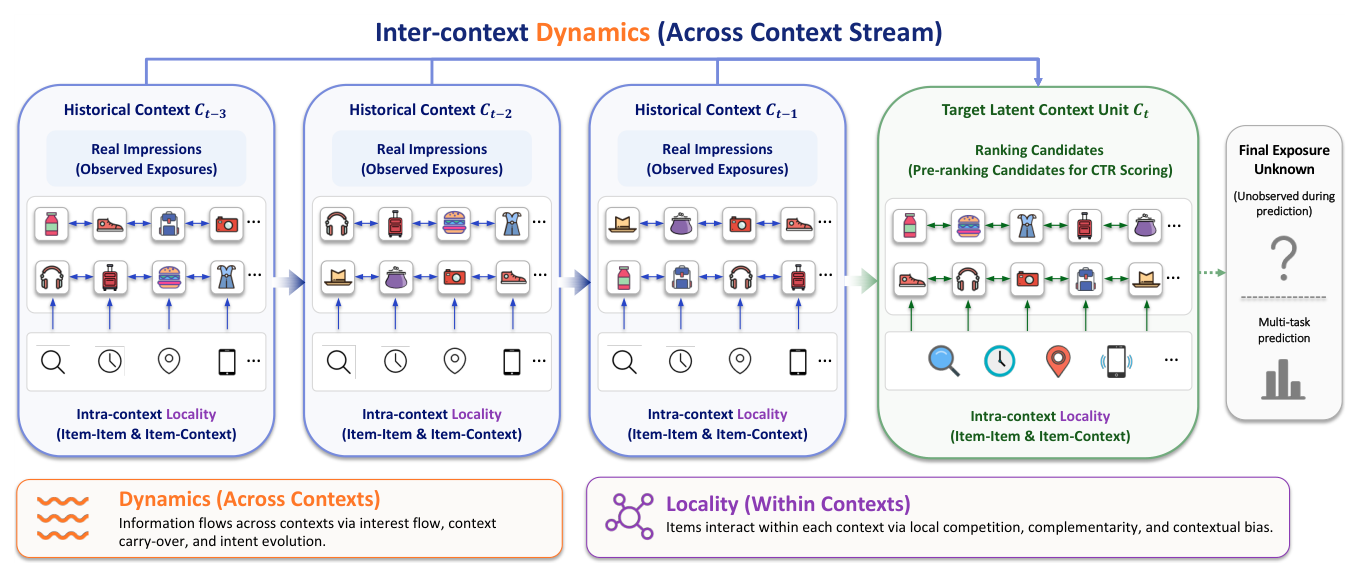
作者的核心批评是:"序列信号 vs 非序列信号"这个二分本身来自遗留的特征工程流水线,而不是来自用户真实的决策过程。 历史行为被编码成行为序列,当前候选、用户属性、请求信号被当成非序列排序特征、逐条 pointwise 打分。但每一次用户动作都发生在某个请求 / 展示上下文里,这个上下文同时决定了"当时有哪些可选项"和"最终产生了什么反馈"。因此一条行为轨迹本质上是一串结构同构的上下文单元;已观测的历史上下文与当前目标上下文唯一的区别只是结果已观测还是待预测。把它们拆成序列分支和非序列分支,等于在模型交互开始之前就人为制造了异质性。
1.2 强上下文场景下的具体损失¶
在电商货架、瀑布流、搜索结果页这类强上下文场景里,用户对某个 item 的反馈不只取决于 item 本身,还取决于它与同屏其他 item 的局部竞争与互补。一个被拍平的 token 序列会把"同一展示列表内的共现"和"跨列表的时间邻近"混为一谈。
原文举的例子非常具体,值得原样保留:在搜索结果页上,用户点了一家便宜且近的咖啡店,可能只是因为同屏展示的其他选项更贵或更远,这并不代表他无条件偏好这家店;在后续某个上下文里,当一家更契合其长期偏好的精品咖啡店与可比选项一同展示时,他可能改选后者。保留这两个展示上下文,模型才能把每次点击相对于当时展示的替代项去解释,并追踪用户表达出的偏好如何随上下文演化。
1.3 贡献自述¶
- 上下文中心化的形式化:按"共同展示"把 item 连同其意图与环境信号分组成上下文单元,把已观测历史上下文与当前候选置于同一结构 schema 之下,用一个目标潜在上下文单元桥接"已观测历史"与"未观测目标展示上下文"。
- 层级化上下文建模:intra-context 与 inter-context 两级交互层分别捕捉 Locality 与 Dynamics,在单一架构内统一"上下文内决策结构"与"跨上下文演化"。
- 可扩展实现与工业验证:无 padding 的变长注意力 + 上下文级序列压缩 + 编译式动态形状部署,支撑大规模训练与服务,并通过离线实验与线上 A/B 验证。
1.4 与上下文建模谱系的关系(原文 §2.2)¶
原文把已有上下文建模按"上下文的类型"归了几类,并说明自己与它们的分工:
- 实例级:ContextNet [28] 用上下文信息细化特征 embedding;DCIN [29]、Deep Context Interest Network [30] 建模用户行为与其所处决策 / 展示环境的交互。
- 候选感知:CIM [31] 把候选集编码成上下文向量,使 CTR 预测能反映当前请求里可获得的替代项。
- 会话结构:DSIN [37] 把行为序列切成 session,建模 session 内与跨 session 的兴趣依赖。原文明确区分:DSIN 的 session 结构捕捉的是时间上的兴趣组织,而 UniCon 的每个上下文单元由同一条件下被共同展示的 item 定义。
- 页面 / 列表级:RACP [32] 把曝光商品与页面反馈表示成上下文化的 page-wise 序列;DPIN [33] 建模候选、位置、用户与上下文信号之间的交互;经典点击模型 [34–36] 说明 examination、位置偏置和列表上下文都会影响观测到的点击。
作者的定位是:上述方法大多专精于一种上下文类型,或者是在保留"行为序列 / 目标 item / 特征字段"这一主输入抽象的前提下额外引入上下文信号;UniCon 则把上下文边界本身当成模型组织的一部分——它决定信号如何分组、intra / inter 交互如何执行、变长执行与压缩如何施加。在 UniCon 里,context 是架构的结构单位,而不是又一个特征来源。
二、核心方法 / 模型架构¶
2.1 总览¶
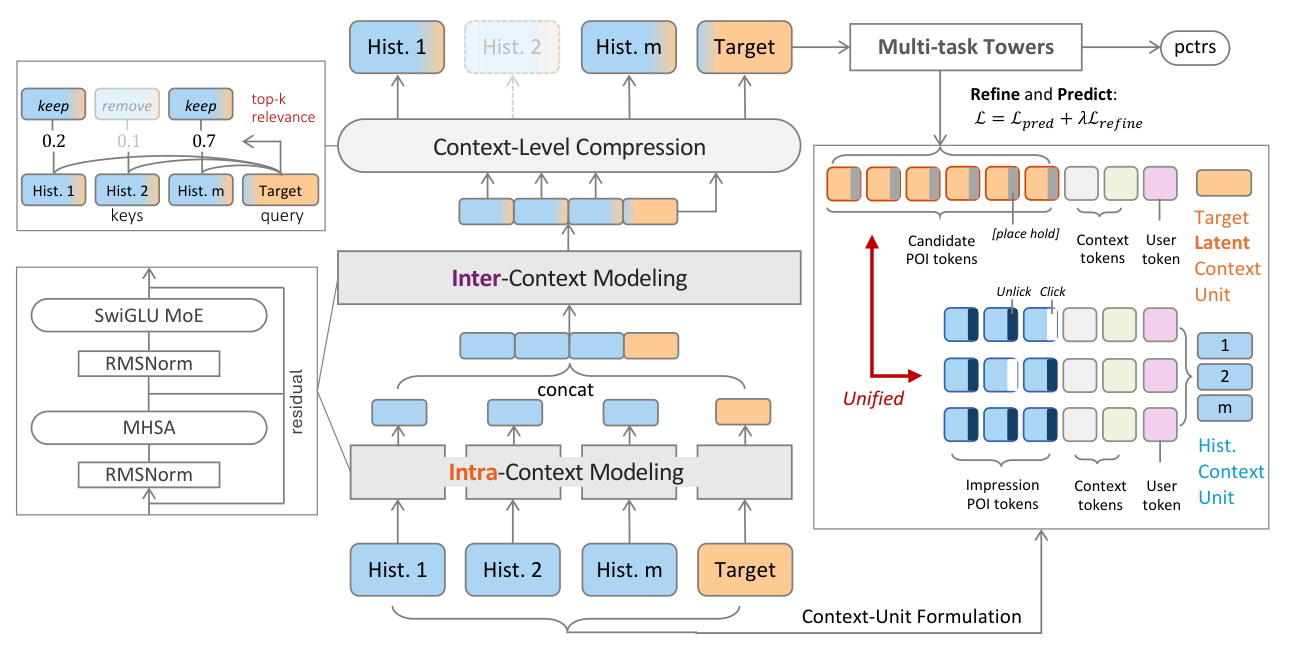
每个输入实例被组织为:一串已观测的历史上下文单元 + 一个由候选集初始化的目标潜在上下文单元。这个共享层级既保留了历史展示结构,又给上下文建模提供了统一 schema。堆叠的 UniConBlock 交替执行 intra-context 与 inter-context 交互,块间插入 target-aware 上下文压缩,最后接多任务预测头。
2.2 上下文单元的构造(§3.2.1)¶
一个上下文单元包含三类输入:
- Item 侧:item 身份、展示顺序、静态属性。
- 上下文信号:意图、query、类目偏好、时间、位置、设备、环境。
- 用户侧:以动态统计特征为主,另有少量静态属性(如性别),聚合成一个 user token。因为静态属性只占该组的小部分,把它放进每个上下文单元只带来很小的冗余存储。
关键的 schema 对齐设计:UniCon 在每一个 item token 里都保留同一个 feedback 分量。对已观测的历史单元,这个分量用 logged click label 的 embedding 实例化;因为排序时目标反馈不可得,候选 token 的对应分量填入一个可学习的 placeholder embedding,该 placeholder 与模型联合优化,不携带任何未来点击信息。这是"历史侧与目标侧同构"能够成立的具体机制。
所有特征在进入 UniCon 前先 tokenize:每个 item 映射成一个 item token,每类上下文信息映射成一个 context token,用户侧特征映射成一个 user token。对 token 组 $g$,线性 tokenizer 把其相关特征 embedding 聚合成统一表示:
$$ \mathbf{z}_g = \mathrm{Tokenizer}_g\big([\mathbf{e}_{g,1}; \ldots; \mathbf{e}_{g,n_g}]\big) = \mathbf{W}_g[\mathbf{e}_{g,1}; \ldots; \mathbf{e}_{g,n_g}] + \mathbf{b}_g \tag{1} $$
其中 $[\cdot;\cdot]$ 表示拼接,$\mathbf{z}_g \in \mathbb{R}^d$。上下文单元 $C$ 的 token 序列为:
$$ \mathbf{Z}_C = [\mathbf{z}^{item}_1, \ldots, \mathbf{z}^{item}_{N_C}, \mathbf{z}^{ctx}_1, \ldots, \mathbf{z}^{ctx}_{K_C}, \mathbf{z}^{usr}] \tag{2} $$
$\mathbf{z}^{usr}$ 是 user token,$N_C$ 与 $K_C$ 分别是该单元的 item token 数与 context token 数。
2.3 历史—目标结构对齐(§3.2.2)¶
在共享 schema 下,历史侧由从已观测曝光列表重建的上下文单元组成,包含其 item 顺序、用户侧特征、上下文信号与反馈;目标侧只有一个目标潜在上下文单元,由候选集与当前用户侧 / 上下文信号初始化——因为排序发生在真实展示列表产生之前,最终展示列表不可得。训练期间,来自曝光与绝对位置的多任务监督进一步引导这个候选初始化的单元去学习生产日志里记录的真实展示列表的曝光模式与位置结构。
2.4 目标上下文监督:三个预测头(§3.2.3)¶
UniCon 采用 MMoE 式多任务框架 [22],三个头分别预测点击、曝光、绝对位置。作者说明这些目标服务两个互补目的:其一,因为目标展示列表在排序前不可得,曝光与绝对位置监督把候选初始化的目标潜在单元推向最终展示列表所反映的潜在上下文结构;其二,通过捕捉"哪些 item 被共同曝光、它们如何排布",被细化的上下文表示反过来给 CTR 预测提供更有信息量的上下文信号。
三个头的训练集合与梯度隔离规则被写得很细,这些细节对后文的归因复核很关键:
- click 头:只在进入最终展示列表的候选上训练,并且以 logged 绝对位置的 embedding 为条件。
- exposure 头:在完整候选集上训练,label 表示该候选是否进入最终曝光列表。
- position 头:只在已曝光候选上训练,预测其绝对曝光位置。
- 梯度隔离:曝光预测不喂进 click 头;click loss 的梯度被阻断不流向 position 头。辅助头只通过共享的上下文表示影响 CTR。
- 服务期:UniCon 对每个候选在所有可行绝对位置上求值,产出 position-conditioned 的 CTR 估计。
作者自己给了一条重要的诚实说明:因为曝光与位置标签由在任的生产策略生成,这些目标是把目标单元正则化到已记录的展示分布上,而不是识别某个与策略无关的最优上下文。
总目标:
$$ \mathcal{L} = \mathcal{L}_{clk} + \lambda_{exp}\mathcal{L}_{exp} + \lambda_{pos}\mathcal{L}_{pos} \tag{3} $$
其中 $\mathcal{L}_{exp}$ 在所有目标候选上计算,$\mathcal{L}_{clk}$ 是在已曝光候选于其 logged 绝对位置上的二分类损失,$\mathcal{L}_{pos}$ 是已曝光候选的绝对位置预测损失,$\lambda_{exp}, \lambda_{pos}$ 控制辅助任务权重。
2.5 统一上下文建模架构(§3.3)¶
设计要满足两个结构性要求:历史与目标上下文需要共享 schema;同时上下文边界必须在信息随时间传播时保持显式。作者给出两个反例说明为什么要分两级:全局 Transformer 能建模跨 token 依赖,但会把上下文内共现与跨上下文邻近混同;而彼此独立的上下文编码器保住了 Locality,却丢掉了 Dynamics。UniCon 因此在一个共享上下文序列上交替 intra 与 inter 两级交互。
2.5.1 共享上下文序列表示¶
tokenize 之后,把历史上下文单元与目标潜在上下文单元拼成一个结构化的变长输入:
$$ \mathbf{X} = [\mathbf{Z}_{C^h_1}, \mathbf{Z}_{C^h_2}, \ldots, \mathbf{Z}_{C^h_M}, \mathbf{Z}_{C^t}] \tag{4} $$
模型由堆叠的上下文建模块构成:
$$ \mathbf{H}^0 = \mathbf{X}, \qquad \mathbf{H}^\ell = \mathrm{UniConBlock}_\ell(\mathbf{H}^{\ell-1}), \quad \ell = 1, \ldots, L \tag{5} $$
每个块更新完整的上下文单元序列,同时保持其组织结构。打分时读取目标单元里每个候选 token 的最终表示 $\mathbf{h}^L_i$,送入三个跨候选共享的任务头:
$$ \hat{y}^{clk}_{i,p} = f_{clk}([\mathbf{h}^L_i; \mathbf{e}^{pos}_p]), \quad \hat{y}^{exp}_i = f_{exp}(\mathbf{h}^L_i), \quad \hat{\mathbf{p}}^{pos}_i = f_{pos}(\mathbf{h}^L_i) \tag{6} $$
作者强调:共享 schema 并不等于把候选池当成一个已观测的展示列表——历史单元保留 logged 边界与反馈,目标单元始终是 latent 的。共享 schema 的收益是,从已观测上下文里学到的交互模式可以迁移到目标表示上,而不需要一条单独的"序列到候选"融合通路。
2.5.2 层级化 intra / inter 交互¶
Intra-context 交互:第一级独立处理每个历史上下文单元与目标潜在上下文单元。令 $\mathcal{C} = \{C^h_1, \ldots, C^h_M, C^t\}$,$\mathbf{H}^{\ell-1}_C$ 为第 $\ell$ 块之前单元 $C$ 的 token 表示:
$$ \widetilde{\mathbf{H}}^\ell_C = \mathrm{IntraAttn}_\ell(\mathbf{H}^{\ell-1}_C), \quad C \in \mathcal{C} \tag{7} $$
注意力被限制在每个上下文边界内,捕捉其 item、反馈、user token 与上下文信号之间的 Locality。历史反馈因此被相对于同一次展示里的替代项与条件来解释,目标候选则在当前用户状态与环境下被相互比较。边界的作用是防止相邻的两次展示被当成局部竞争者。
Inter-context 交互:第二级把独立编码后的各单元按输入顺序拼接,送入 inter-context 注意力:
$$ \mathbf{H}^\ell = \mathrm{InterAttn}_\ell\big([\widetilde{\mathbf{H}}^\ell_{C^h_1}, \ldots, \widetilde{\mathbf{H}}^\ell_{C^h_M}, \widetilde{\mathbf{H}}^\ell_{C^t}]\big) \tag{8} $$
这一层让历史单元与目标单元交换"用户兴趣与展示条件如何变化"的信息,时序顺序帮助区分持久偏好与上下文诱导的选择。
两级交互都用 pre-norm Transformer 块(RMSNorm [23] + 自注意力 + SwiGLU dense MoE [24])。intra 注意力被限制在单元边界内,inter 注意力跨越整个输入实例。作者明确区分:骨干里的 dense MoE 属于上下文骨干,与目标侧的 MMoE 预测头是两回事。
附录 A 给出完整方程。对 stage $s \in \{\mathrm{intra}, \mathrm{inter}\}$,设 $\mathbf{X}^\ell_s$ 为其输入:
$$ \mathbf{U}^\ell_s = \mathbf{X}^\ell_s + \mathrm{MHSA}^\ell_s\big(\mathrm{RMSNorm}^\ell_{s,1}(\mathbf{X}^\ell_s)\big), \qquad \mathcal{B}^\ell_s(\mathbf{X}^\ell_s) = \mathbf{U}^\ell_s + \mathrm{DenseMoE}^\ell_s\big(\mathrm{RMSNorm}^\ell_{s,2}(\mathbf{U}^\ell_s)\big) \tag{15} $$
intra 阶段对每个单元独立应用,且同一套 intra 参数在所有单元间共享,靠 segment offset 阻止注意力跨界:
$$ \widetilde{\mathbf{H}}^\ell_C = \mathcal{B}^\ell_{\mathrm{intra}}(\mathbf{H}^{\ell-1}_C), \quad C \in \{C^h_1, \ldots, C^h_M, C^t\} \tag{16} $$
inter 阶段先拼接再作用:
$$ \mathbf{G}^\ell = [\widetilde{\mathbf{H}}^\ell_{C^h_1}, \ldots, \widetilde{\mathbf{H}}^\ell_{C^h_M}, \widetilde{\mathbf{H}}^\ell_{C^t}], \qquad \mathbf{H}^\ell = \mathcal{B}^\ell_{\mathrm{inter}}(\mathbf{G}^\ell) \tag{17} $$
每个 dense MoE 含 $E$ 个 SwiGLU 专家(略去偏置):
$$ \mathcal{E}_e(\mathbf{X}) = \big(\mathrm{SiLU}(\mathbf{X}\mathbf{W}_{g,e}) \odot (\mathbf{X}\mathbf{W}_{u,e})\big)\mathbf{W}_{d,e}, \quad \mathbf{\Pi}(\mathbf{X}) = \mathrm{softmax}(\mathbf{X}\mathbf{W}_r), \quad \mathrm{DenseMoE}(\mathbf{X}) = \sum_{e=1}^{E} \mathbf{\Pi}_{:,e}(\mathbf{X}) \odot \mathcal{E}_e(\mathbf{X}) \tag{18} $$
与稀疏专家路由不同,所有专家都参与这个 dense 混合,混合权重与专家变换与上下文骨干联合学习。
三、高效计算与生产推理(§3.4)¶
3.1 上下文感知的序列压缩¶
随着历史曝光累积,历史上下文单元数会变得很大。若每个 inter-context 层都在完整 token 序列上做注意力,复杂度为 $O(LN^2)$($L$ 是块数,$N$ 是式 (4) 的初始总 token 数)。但很多较老的历史上下文与当前目标潜在单元关系很弱。UniCon 因此在第一个块做完整的 inter-context 交互,之后逐块施加上下文感知压缩:保住第一块的完整上下文建模,同时为后续全局交互逐步缩短序列。
一个直接的选择是复用 inter-context 注意力算出来的 attention score,但变长注意力算子遵循 FlashAttention 式的 online softmax [27],不会显式物化完整注意力矩阵,这些分数拿不到。UniCon 于是用一个轻量近似:取目标单元的 query 向量与每个历史上下文的 key 向量,做均值池化得到上下文级紧凑表示:
$$ \mathbf{q}^\ell_t = \mathrm{MeanPool}(\mathbf{Q}^\ell_{C^t}), \qquad \mathbf{k}^\ell_m = \mathrm{MeanPool}(\mathbf{K}^\ell_{C^h_m}) \tag{9} $$
相关性分数由 query-key 相似度给出:
$$ s^\ell_m = \frac{(\mathbf{q}^\ell_t)^\top \mathbf{k}^\ell_m}{\sqrt{d}}, \quad C^h_m \in \mathcal{C}^{\ell-1} \tag{10} $$
按分数在第 $\ell$ 块保留固定比例 $r_\ell$ 的历史上下文单元,保留数 $K_\ell = \lceil r_\ell |\mathcal{C}^{\ell-1}_h| \rceil$:
$$ K_\ell = \big\lceil r_\ell |\mathcal{C}^{\ell-1}_h| \big\rceil, \quad \mathcal{S}^\ell = \mathrm{TopK}(\{s^\ell_m \mid C^h_m \in \mathcal{C}^{\ell-1}_h\}, K_\ell), \quad \mathcal{C}^\ell_{keep} = \{C^h_m \mid m \in \mathcal{S}^\ell\} \cup \{C^t\} \tag{11} $$
训练用 Gumbel-TopK + straight-through estimator:前向施加硬 TopK mask 并剪掉未选中的上下文单元,反向用连续松弛的梯度;服务时用同样的硬 TopK 但不做松弛。保留集成为下一块的输入上下文集。设 $N_\ell$ 为第 $\ell$ 次压缩后保留的 token 数,$N_0 = N$,同一保留比例近似控制 token 长度 $N_\ell \approx r_\ell N_{\ell-1}$。由于第一块在完整序列上计算,主导的全局注意力开销从 $O(LN^2)$ 降到:
$$ O\!\left(N^2 \sum_{\ell=0}^{L-1} \prod_{j=1}^{\ell} r_j^2\right) \tag{12} $$
其中 $\ell = 0$ 时连乘项定义为 1,对应完整的第一块。取固定比例 $r_1 = \cdots = r_{L-1} = r$ 时化为 $O(N^2 \sum_{\ell=0}^{L-1} r^{2\ell})$,这个几何级数被 $1/(1-r^2)$ 界住,于是注意力开销上界是 $O(N^2/(1-r^2))$ 而非 $O(LN^2)$——从"随深度线性增长"变成"与深度无关的常数上界",这是整个压缩设计的理论卖点。
服务实现把分数计算、硬 TopK 选择、历史上下文 gather 融合成一个算子,直接产出下一个 UniConBlock 消费的紧凑上下文序列,省掉中间结果物化,减少显存流量与 kernel launch 开销;这些节省在每两个相邻全局交互块之间反复发生。
3.2 变长注意力算子¶
标准实现里变长上下文通常靠 padding 到定长 + 定制 attention mask,既在无效 token 上浪费算力,又只能通过 mask 弱地表达上下文边界。UniCon 的两级都用变长注意力算子:token 存成连续 segment,注意力边界由 segment offset 指定,遵循 FlashAttention [27] 的 IO-aware 精确注意力原则,同时把 segment offset 暴露出来表示上下文边界。
关键在于两级的 segment 定义不同。intra-context 时每个上下文单元是一个变长 segment:
$$ \mathcal{B}_{intra} = \{\mathrm{span}(C^h_1), \ldots, \mathrm{span}(C^h_M), \mathrm{span}(C^t)\} \tag{13} $$
注意力在每个 segment 内独立计算,不同单元的 token 无法互相 attend,且不依赖稠密的自定义 mask。inter-context 时边界切换到输入实例级:
$$ \mathcal{B}_{inter} = \{\mathrm{span}(C^h_1, \ldots, C^h_M, C^t)\} \tag{14} $$
同一实例内的所有 token 都能交互。两套 segment 定义分别实现了 Locality 所需的上下文单元隔离与 Dynamics 所需的实例级交互,两个阶段都不做 padding。
3.3 生产推理(§3.4.3)¶
这一节是本文工业成色的主要证据来源,四项优化覆盖特征、算子、运行时:
- 候选分片(Candidate sharding):生产实现把每个目标侧分片限制在 300 个候选。规模为 $N_{cand}$ 的候选池按 hash 划分成 $\lceil N_{cand}/300 \rceil$ 个分片,每片独立构成一个目标潜在上下文单元,推理后再合并各自的 position-conditioned 分数。训练与服务使用同一套划分流程。
- 特征抽取:设计
FeatureColumnCollector,把此前散落各处的特征抽取逻辑整合成统一的、graph-compatible 组件,从注册的 feature column 构造模型输入,并移除阻碍图导出的、不可序列化的 Python 侧抽取路径;集中化还避免了冗余的特征收集与变换。 - 并行 dense MMoE 执行:多任务预测头用 dense MMoE 结构,朴素实现会分别 launch 各专家 MLP。作者用 cuBLAS 原语与自定义 CUDA kernel 并行化专家计算:第一层投影把所有专家权重打包成一次融合矩阵乘;因为中间的 SwiGLU 激活使两层 MLP 投影无法塌缩成单个线性算子,第二层投影改用 batched matmul 并行处理多个专家。语义上仍是 dense MMoE,但省掉了算子分发与中间显存开销。
- AOT 编译式服务:用 AOTInductor 导出完整推理图,通过 C++ 运行时执行编译产物,把 Python 从在线推理路径上彻底移除 [26]。动态形状编译保住了变长执行能力——上下文数、候选数、context token 数不同的请求都不必退回定长 padding 输入。
四、实验设置¶
4.1 数据与指标(§4.1)¶
- 数据:美团搜索广告,按时序取一年期生产窗口;紧随其后的两天分别作验证集与测试集。三个划分没有重叠请求,所有特征构造不使用未来信息。
- 规模:唯一用户数与唯一 item 数都在数亿量级;每条输入历史可含数百个上下文单元,每个单元不到十个 item;每个生产候选分片最多 300 个候选。
- 离线指标:AUC 衡量全局排序质量,LogLoss 衡量概率校准,GAUC 在请求级、在已曝光候选上计算——只含正样本或只含负样本的请求因 AUC 无定义而被剔除,其余请求级 AUC 按样本数加权。
- 线上指标:RPM(每千次展现营收)、CTR、总营收。
4.2 Baseline 设置(§4.2)——本文最需要细读的一段¶
三组基线:
- 生产基线:
Base是线上生产排序模型,在一个组合式排序架构里融合 DIN 式行为建模 [8] + SENET 式特征重标定 [9] + DCN-V2 特征交叉 [10]。 - Scaling 基线:OneTrans 与 HyFormer 是联合建模序列行为与非序列排序特征的统一 CTR 架构 [14, 15],RankMixer 通过硬件高效的特征 mixing 扩展排序 [13]。
- Scaling + context 基线:再用成熟上下文模块加强上述骨干,得到 OneTrans+CIM、HyFormer+DSIN+CIM、RankMixer+DSIN+CIM。DSIN 提供 session 感知的历史建模,CIM 引入候选感知的上下文交互 [31, 37]。作者说明为什么不做 OneTrans+DSIN:DSIN 会重复或替换 OneTrans 原生的历史序列路径,而不是充当一个正交的上下文模块;CIM 则是在不改变该路径的前提下增强候选侧上下文。
公平性声明的原文措辞是:"All baselines use the same data, raw feature fields, and training resources as UniCon. Architectures that do not natively support context hierarchy receive the same fields organized according to their original designs. We sweep multiple parameter settings for each research baseline and report the highest-AUC configuration in Table 1."
这句话枚举了数据、原始特征字段、训练资源三项,并且为每个研究基线扫了多组参数取最高 AUC 配置;但它没有提到训练目标 / 损失函数。 后文 §7 的归因复核会回到这一点。
4.3 训练配置(§4.3)¶
- 全部模型在 16 张 NVIDIA A100 上训练,batch size 1600,优化器 AdamW [25]。
- token 维度 512,4 个注意力头;UniCon-Small / Mid / Large 分别堆叠 3 / 6 / 12 个 UniConBlock。
- scaling 研究用未压缩模型;主离线与线上实验用压缩版 UniCon-Large,$r_\ell = 0.5$,训练期用 Gumbel-TopK + straight-through 估计与前向硬剪枝,服务期用硬 TopK。
- GFLOPs 在平均输入长度下测量,所有基线在同一验证集上选型。
- 噪声阈值(重要):作者明确规定 AUC 差异在 0.0003 以内视为正常的 run-to-run 波动,大于 0.0003 的 AUC 提升才算明确的离线增益。
- 进入精排的完整候选池被保留、不做负采样。分片内候选顺序被随机打乱,既不使用先前模型的分数也不使用其排序位置作为输入。训练与服务使用同一套 hash 分片流程。历史上下文单元按时序排列,超过配置最大长度时先保留最近的单元,再做上下文感知压缩。
五、主要实验结果¶
5.1 整体离线对比(Table 1)¶
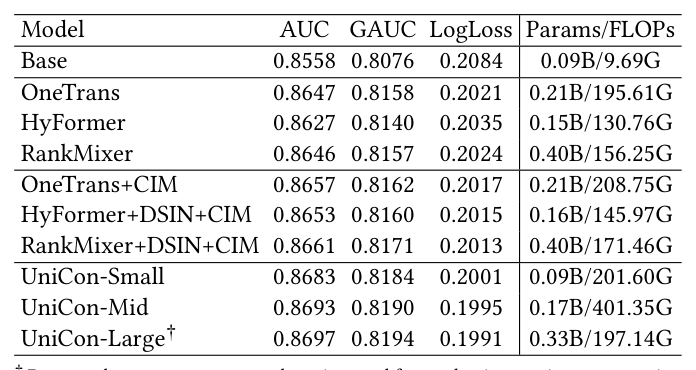
| Model | AUC | GAUC | LogLoss | Params/FLOPs |
|---|---|---|---|---|
| Base | 0.8558 | 0.8076 | 0.2084 | 0.09B / 9.69G |
| OneTrans | 0.8647 | 0.8158 | 0.2021 | 0.21B / 195.61G |
| HyFormer | 0.8627 | 0.8140 | 0.2035 | 0.15B / 130.76G |
| RankMixer | 0.8646 | 0.8157 | 0.2024 | 0.40B / 156.25G |
| OneTrans+CIM | 0.8657 | 0.8162 | 0.2017 | 0.21B / 208.75G |
| HyFormer+DSIN+CIM | 0.8653 | 0.8160 | 0.2015 | 0.16B / 145.97G |
| RankMixer+DSIN+CIM | 0.8661 | 0.8171 | 0.2013 | 0.40B / 171.46G |
| UniCon-Small | 0.8683 | 0.8184 | 0.2001 | 0.09B / 201.60G |
| UniCon-Mid | 0.8693 | 0.8190 | 0.1995 | 0.17B / 401.35G |
| UniCon-Large† | 0.8697 | 0.8194 | 0.1991 | 0.33B / 197.14G |
† 表示用于生产服务的上下文压缩版本;压缩在训练与推理都开启,把计算从 801.29 GFLOPs 降到 197.14 GFLOPs。
原文结论:UniCon 在三个离线指标上都优于 scaling 基线及其上下文增强变体。加 DSIN 或 CIM 确实改善了对应骨干,但这些组合仍是通过分离的或外挂的模块来组织序列与目标侧上下文。相比之下 UniCon-Small 就已经在 AUC 上超过每一个研究基线,说明上下文单元组织与层级交互比"往已有骨干上挂上下文模块"更有效。性能随容量继续提升,压缩后的生产版 UniCon-Large 在 197.14 GFLOPs 下保住了最强的整体质量。
我的补充分析(Table 1 的三个未被原文讨论的读数):
- 参数效率的宣称成立,但计算量口径被略过了。 UniCon-Small 在 0.09B 参数下达到 0.8683,比 0.40B 的 RankMixer+DSIN+CIM(0.8661)高 +0.0022,参数少 4.4 倍——这是真的。但 UniCon-Small 的 201.60 GFLOPs 高于除 OneTrans+CIM(208.75G)之外的所有基线,是 RankMixer+DSIN+CIM(171.46G)的 1.18 倍、Base(9.69G)的 20.8 倍。原文的"UniCon-Small already exceeds every research baseline"是按参数说的,不是按算力说的。
- 真正算力可比的一对是 UniCon-Small(201.60G)vs OneTrans+CIM(208.75G):0.8683 vs 0.8657,+0.0026。这是全表里最接近 compute-matched 的对照,仍高于 0.0003 噪声带,但比"+0.0139 vs Base"温和得多。
- UniCon 内部三档不是同一算力曲线:Mid(0.17B)401.35G 反而高于 Large(0.33B)197.14G,因为 Large 是压缩版而 Mid 不是。所以 Small→Mid→Large 这条曲线混合了"容量增长"与"是否压缩"两个变量,不能直接当成干净的 scaling 序列读(干净的 scaling 曲线在 §4.6 的 Fig. 3,用的是未压缩模型)。
5.2 消融实验(Table 2)¶
消融在压缩版 UniCon-Large 配置上做。原文对每个变体的构造描述:
- w/o Context Organization:移除显式上下文组织但保留上下文信息——把每个 context token 表示加到其关联的 item token 上,结果 item token 作为拍平序列处理。该变体参数量相同、GFLOPs 可比,因此隔离出的是"显式上下文边界"本身的效果。
- w/o Target Context Unification:保留历史上下文单元,但把目标侧上下文表示拆解成各个非序列特征的独立 token,破坏历史侧与目标侧的共享结构组织。
- w/o Context Modeling:移除层级上下文建模,改用参数匹配的全局 token 级骨干处理拍平后的历史与目标 token。
- w/o Intra-Context:只移除 intra-context 交互。每个被移除的 intra 层用一个额外的 inter 层替换,Transformer 总深度与参数量都保持不变。
- 另外分别与联合消融曝光与绝对位置目标,以及把上下文压缩与"不压缩"和"基于时间的截断"比较。
| Variant | AUC | ΔAUC | GAUC | ΔGAUC | LogLoss |
|---|---|---|---|---|---|
| UniCon-Large | 0.8697 | — | 0.8194 | — | 0.1991 |
| w/o Context Organization | 0.8687 | −0.0010 | 0.8179 | −0.0015 | 0.1997 |
| w/o Target Context Unification | 0.8690 | −0.0007 | 0.8189 | −0.0005 | 0.1998 |
| w/o Context Modeling | 0.8637 | −0.0060 | 0.8150 | −0.0044 | 0.2032 |
| w/o Intra-Context | 0.8673 | −0.0024 | 0.8168 | −0.0026 | 0.2004 |
| w/o Exposure Loss | 0.8665 | −0.0032 | 0.8172 | −0.0022 | 0.2012 |
| w/o Position Loss | 0.8693 | −0.0004 | 0.8189 | −0.0005 | 0.1996 |
| w/o Aux. Loss | 0.8663 | −0.0034 | 0.8170 | −0.0024 | 0.2013 |
| w/o Compression | 0.8698 | +0.0001 | 0.8195 | +0.0001 | 0.1991 |
| Time Truncation | 0.8691 | −0.0006 | 0.8191 | −0.0003 | 0.1994 |
原文的分析:移除上下文组织使三个指标都变差,说明显式上下文归属有价值;把目标侧上下文表示拆成独立特征 token 也降低性能,说明共享的上下文单元接口减少了历史与目标输入之间的结构错配;在参数匹配骨干里拍平历史与目标 token、去掉层级上下文建模造成最大的退化;只移除 intra-context 交互在深度与参数量都匹配的条件下仍使所有指标变差,把 Locality 建模的收益与"单纯多加容量"区分开。曝光预测贡献大于绝对位置预测,两者都改善目标侧表示,同时移除产生辅助任务消融里最大的下降。长上下文处理方面,上下文压缩与未压缩模型的差距落在正常波动内却用了远少的算力;它相对基于时间的截断的优势也支持 target-aware 选择优于固定的近期性规则。
分析的可信度问题在 §7 单独展开。
5.3 Scaling 实验(§4.6)¶
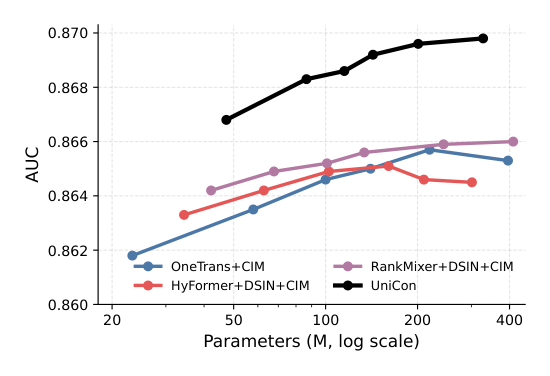
Fig. 3 比较未压缩的 UniCon 与代表性统一 / 上下文增强 scaling 基线(OneTrans+CIM、HyFormer+DSIN+CIM、RankMixer+DSIN+CIM)。
- UniCon 从约 0.05B 到 0.33B 参数呈现稳定增益,AUC 从 0.8668 提升到 0.8698(跨越约 6.6 倍参数,总提升 +0.0030)。
- 在同样的 0.33B 参数下,上下文压缩把计算从 801.29 GFLOPs 降到 197.14 GFLOPs,同时保住 0.8697 的 AUC。
- 曲线显示 UniCon 在可比参数区间内对基线保持明显且一致的差距,作者据此认为上下文单元组织在容量增大时仍然有用,而不是只在某一个工作点上受益。
值得注意的一个读数:从 0.05B 到 0.33B 的 6.6 倍参数只换来 +0.0030 AUC,而"上下文压缩 vs 不压缩"的差是 −0.0001、"辅助损失开关"的差是 −0.0034。也就是说在这条曲线上,一个正交的辅助监督项抵得上把模型放大 6 倍还多。 这个对比原文没有提。
5.4 压缩权衡(§4.7)¶
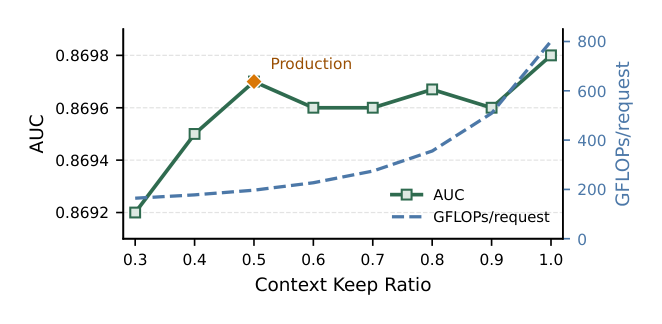
在同一评估设置与平均输入长度下扫固定保留比例 $r$:
| Keep ratio $r$ | AUC |
|---|---|
| 1.0(不压缩) | 0.8698 |
| 0.5(生产设置) | 0.8697 |
| 0.4 | 0.8695 |
| 0.3 | 0.8692 |
$r \in [0.5, 1.0]$ 时 AUC 稳定在 0.8696–0.8698。把 $r$ 从 1.0 降到生产设置 0.5,AUC 从 0.8698 变到 0.8697(落在 0.0003 噪声带内),profiled 计算量减少 75.4%。更激进的压缩会让最后几个块只剩下近乎单个历史上下文单元,削弱跨上下文交互,AUC 相应地在 $r = 0.4$ 降到 0.8695、$r = 0.3$ 降到 0.8692。
这是全文内部一致性最好的一组实验:只在 UniCon 自身内部变动一个超参,不涉及任何基线设置,结论(0.5 是拐点、再往下 Dynamics 被破坏)与机制解释自洽。
5.5 服务效率(§4.8)¶
从定长、未压缩的基线出发,在生产 UniCon-Large 上逐步开启两项优化:
| 配置 | 吞吐提升 | AUC 影响 |
|---|---|---|
| 定长 + 未压缩(基线) | — | — |
| + 变长注意力(§3.4.2) | +64.5% | AUC 不变 |
| + 上下文感知序列压缩(§3.4.1) | +258.1%(相对基线)/ +117.6%(相对仅变长注意力) | AUC 差 0.0001 |
尽管 GFLOPs 高于生产 Base,部署满足延迟 SLA。
5.6 候选分片的影响(附录 B)¶
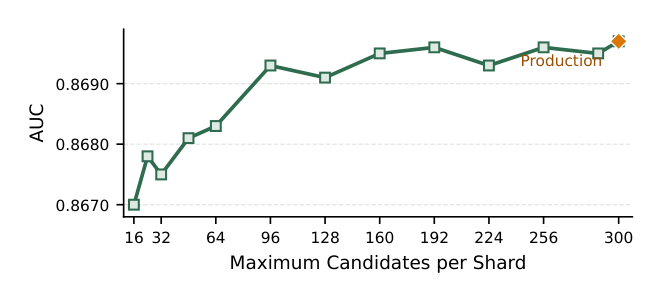
全集建模保住了所有目标侧交互,但计算与显存随候选数增长;分片限制了这个开销并支持独立执行,代价是把交互限制在每个分片内。作者只改 UniCon-Large 的最大分片大小,架构与评估设置固定。
| 每分片最大候选数 | AUC |
|---|---|
| 16 | 0.8670 |
| 64 | 0.8683 |
| 160–300 | 与 0.8697 相差在 0.0004 以内 |
| 300(生产) | 0.8697 |
原文解释:更小的分片更常把相关或竞争的候选拆开,削弱了目标潜在上下文单元可获得的上下文证据。生产上限因此定为 300,更大的请求按同一套训练 / 服务规则做 hash 划分。
这组实验的价值被原文低估了——见 §7.4。
5.7 线上 A/B(§4.9)¶
| 项 | 原文口径 |
|---|---|
| 场景 | 美团搜索广告 |
| 时长 | 7 天 |
| 流量 | 20% 分配给 UniCon-Large |
| 统计口径 | 报告整个实验期的累计变化(cumulative changes) |
| RPM | +3.09% |
| CTR | +2.07% |
| 营收(revenue) | +2.95% |
| 显著性 | 三项均在双侧检验下显著,$p \le 0.01$ |
| 延迟 | 相对 Base 上升,但仍在生产 SLA 内 |
| 护栏 | 其他护栏指标无显著退化(未给出具体指标与数值) |
原文对指标语义的说明:RPM 衡量每千次展现营收,revenue 衡量总收入,两者分别刻画变现效率与总体业务影响。
六、核心贡献总结¶
- 把统一的单位从 token 换成 context。已有统一架构(OneTrans / HyFormer / MixFormer)统一的是"序列 token 与特征 token 进同一个骨干";UniCon 主张真正该被统一的是请求上下文,历史与目标之间唯一的合法差异是"结果是否已观测"。这个 reframing 本身是清晰、可证伪、且能落成具体架构的。
- 目标潜在上下文单元 + 对齐的 feedback 分量,是让"历史—目标同构"在排序时刻真正可执行的关键机制:历史 item token 的 feedback 分量填 logged click,候选 token 填可学习 placeholder,schema 完全对齐而不泄露未来信息。
- 上下文边界既是建模边界又是计算边界。同一套 segment offset,在 intra 阶段表达"单元内隔离"、在 inter 阶段表达"实例内全连",既省掉 padding 又省掉稠密 mask;上下文级 Top-K 压缩把注意力开销从 $O(LN^2)$ 压到 $O(N^2/(1-r^2))$。这一条是本文最扎实、最可复用的部分。
- 完整的生产推理路径:变长算子 + 融合的 score-TopK-gather 算子 + 并行 dense MMoE + AOTInductor 编译式 C++ 运行时(Python 移出在线路径)+ 动态形状,最终在 197.14 GFLOPs(相对未压缩 801.29)下守住 SLA。
七、独立复核:命名主张的净贡献有多大,以及主表是否公允¶
本节是我在原文结论之外做的独立核算,因为 Table 1 与 Table 2 放在一起读时出现了原文没有处理的矛盾。
7.1 直接检验命名主张的两项消融,幅度贴着作者自定的噪声底¶
作者在 §4.3 自己规定:AUC 差异在 0.0003 以内算 run-to-run 波动。而 Table 2 里唯一直接检验"上下文中心化"这个命名主张、且控制了参数量与深度的两项是:
w/o Context Organization−0.0010 = 噪声底的 3.3 倍;w/o Target Context Unification−0.0007 = 噪声底的 2.3 倍。
两项合计 0.0017(还是在忽略两者重叠的乐观假设下)。论文没有报告任何方差、置信区间或多种子重复,每个格子看上去是单次运行。在自己声明 ±0.0003 波动的前提下,一个 0.0007 的差值大致只有 2σ 量级。也就是说,标题里 "Unified Context-Centric Modeling Paradigm" 这个命名所指的两项设计,其证据强度是全表最弱的两项之一(另一项是 w/o Position Loss −0.0004)。
7.2 一个正交的辅助监督比命名主张贡献大 2 倍¶
w/o Aux. Loss −0.0034,是 w/o Context Organization 的 3.4 倍、w/o Target Context Unification 的 4.9 倍、两者之和的 2.0 倍。其中曝光损失单独就占 −0.0032,位置损失只有 −0.0004(贴着噪声底)。
关键在于:曝光头与位置头在概念上与"上下文单元"是正交的。 曝光头是"该候选是否进入最终曝光列表"的逐候选二分类;位置头是"该候选的绝对曝光位置"的逐候选多分类。两者都不需要上下文单元 schema 才能定义,任何在完整候选池上打分的排序模型都能加上它们。作者自己在 §3.2.3 也承认这两个目标是把目标单元正则化到在任生产策略的展示分布上,而不是识别策略无关的最优上下文——这更像是一种策略蒸馏 / 位置先验注入,而非"上下文中心化"的推论。
7.3 基线是否一视同仁地开启辅助损失:论文没有说,而这决定了主表的解释¶
这是本次复核最重要的一条。核对 §4.2 的原文措辞,公平性声明逐项枚举了:
- ✅ same data
- ✅ same raw feature fields
- ✅ same training resources
- ✅ 每个研究基线扫多组参数、取最高 AUC 配置
- ❌ 训练目标 / 损失函数:全文没有任何一处说明基线是否也带曝光头与位置头
而且不只是辅助损失。§3.2.3 + 式 (6) 写明 UniCon 的 click 头以 logged 绝对位置的 embedding 为条件 $\hat{y}^{clk}_{i,p} = f_{clk}([\mathbf{h}^L_i; \mathbf{e}^{pos}_p])$,服务时对每个候选在所有可行位置上求值;而 §4.1 说 GAUC 是在已曝光候选上、请求级计算的。位置是列表排序里最强的 CTR 信号之一。基线按 §4.2 是"organized according to their original designs"——OneTrans / HyFormer / RankMixer 的原始设计里都没有 position-conditioned click head。论文没有说明基线是否被补上等价的位置条件化。
把这两点和数字放在一起,结论就很直接:
UniCon-Large 相对最强研究基线 RankMixer+DSIN+CIM 的增益是 0.8697 − 0.8661 = +0.0036;而
w/o Aux. Loss显示辅助监督单独贡献 +0.0034。
如果基线没有开辅助损失,那么整个 +0.0036 的主表优势几乎完全落在辅助监督的贡献区间内,"上下文中心化范式"相对最强基线的边际贡献可以低到 +0.0002——落在作者自己划定的 0.0003 噪声带以内。如果基线开了辅助损失,那么 +0.0036 确实归于架构,但接下来 §7.5 的自相矛盾又会浮现。论文没有提供任何信息让读者判断是哪一种情况,而这两种情况对"范式"这个命名主张的支持强度截然不同。
7.4 消融幅度之和是主表空间的 2.1 倍,作者未做自洽性检查¶
把 Table 2 里各项归因相加:
$$ \underbrace{0.0034}_{\text{Aux. Loss}} + \underbrace{0.0024}_{\text{Intra-Context}} + \underbrace{0.0010}_{\text{Context Org.}} + \underbrace{0.0007}_{\text{Target Unif.}} = 0.0075 $$
而 UniCon-Large 相对最强基线的全部空间只有 0.0036。也就是说消融归因之和是可用空间的 2.1 倍。这只能有两种解释:要么各项消融大量重叠(去掉 A 之后模型仍能靠 B 补偿,所以单项 Δ 不可加),要么基线本身已经共享了其中某些组件(那就更需要说明基线的目标函数设置)。作者两种都没讨论。
7.5 w/o Context Modeling −0.0060 这个最大幅度的数字,被 Table 1 自己驳倒¶
w/o Context Modeling 是"参数匹配的全局 token 级骨干处理拍平的历史与目标 token",AUC 0.8637、参数 0.33B。但 Table 1 里:
- OneTrans:0.8647,0.21B 参数
- RankMixer:0.8646,0.40B 参数
UniCon 自己实现的"拍平版"以 0.33B 参数输给了 0.21B 的 OneTrans 整整 0.0010——而 OneTrans 恰恰就是一个精心设计的拍平式统一骨干。如果这个内部拍平变体继承了 UniCon 的辅助损失(它是从 UniCon-Large 上做减法得来的,应当继承),那它带着 +0.0034 的辅助监督优势仍然输给不带辅助监督的 OneTrans,说明这个拍平实现远未调到位;如果基线也开了辅助损失,那这个拍平变体相对 OneTrans 的劣势就更纯粹是实现质量问题。无论哪种情况,−0.0060 都不能被当作"层级上下文架构的真实价值"来读——它更像是一个未调优 strawman 与调优模型之间的差距。
换言之,Table 1 与 Table 2 给出的两条归因通道互相不自洽:一条说架构值 +0.0036(相对最强基线),一条说架构值 +0.0060(相对内部拍平变体),而后者的参照物比一个更小的公开基线还差。至少有一条通道在高估架构的贡献,论文没有提供区分二者的数据。
7.6 但范式并非空壳:附录 B 的剂量—反应曲线是全文最干净的正面证据¶
前面几条都是减分项,但有一组数据支持"目标侧上下文确实携带信号",而且它不受基线公平性问题的影响,也不受辅助损失开关的影响——就是被作者塞进附录 B、当作效率权衡讨论的 Fig. 5 候选分片实验:
| 每分片候选数 | 16 | 64 | 160–300 | 300 |
|---|---|---|---|---|
| AUC | 0.8670 | 0.8683 | 与 0.8697 差 ≤0.0004 | 0.8697 |
这里只变一个量:目标潜在上下文单元里同时被打分的候选数。架构、参数、训练目标、辅助损失、数据全部固定。结果是一条单调的剂量—反应曲线,16→300 的总跨度 +0.0027。
这比 Table 2 里任何一项开关式消融都是更强的因果证据:开关式消融只能说"拿掉会变差",而剂量—反应能说"给得越多越好,且单调"。而且 +0.0027 大于 w/o Context Organization 与 w/o Target Context Unification 之和(0.0017),也远大于噪声底。它直接支持了本文最核心的那句直觉——用户对一个 item 的反馈取决于同屏的替代项。
只是这条证据支持的是"候选集上下文(Locality)有用"这个较窄的命题(CIM [31] 这条线也在主张它),而不是标题里"把历史与目标统一到同一 context 单元 schema"这个更宽的范式主张。
7.7 复核结论¶
"部分命中『引入新信号 ≠ 收益来源』"这个判断成立,而且比初判更严重一档。 具体分层:
- 命名主张(Unified Context-Centric Modeling Paradigm)的净贡献没有被证据确立。 上界是相对最强基线的 +0.0036,而这个数完全被一个正交辅助监督的 +0.0034 覆盖;下界在"基线未开辅助损失"的假设下可以掉进 0.0003 噪声带。论文自己的两项直接消融合计只有 +0.0017。
- 基线是否一视同仁开启辅助损失:论文没有说,且公平性声明的措辞(data / raw feature fields / training resources)明显把训练目标排除在外。 更严重的是 position-conditioned click head 的信息优势也未说明基线是否等价配置。在这两点澄清之前,主表对比不能被当作范式主张的公允证据。
w/o Context Modeling−0.0060 不可采信,因为该拍平变体输给了参数更少的公开基线 OneTrans。- 仍然成立的部分:附录 B 的候选分片剂量—反应曲线(+0.0027 单调)干净地证明了目标侧候选集上下文有真实信号;§4.7 压缩比曲线与 Time Truncation 对比(+0.0006)干净地证明了 target-aware 上下文级选择优于近期性截断;§4.8 的吞吐提升与 §3.4.3 的编译式部署是可复现的工程贡献;线上 A/B 是真实收益。
因此我的判断是:这是一篇工程与部署都很扎实、但"范式"这个命名超出了其证据支撑范围的论文。 我给 reading_score = 7 而不是沿用摘要档的 8——扣的这一档完全落在实验严谨度上(基线目标函数不明、单次运行的核心消融贴着自定噪声底、最大幅度消融自相矛盾),而不落在工业价值或方法论可扩展性上,后两者都是本文的强项。
7.8 线上 A/B 口径核实¶
逐条核对用户关心的几个点:
- 时长 / 流量:7 天、20% 流量分配给 UniCon-Large。属实,§4.9 明写。20% 是行业里偏大的桶,7 天覆盖完整周周期,口径合理。
- 置信区间:没有。三个指标只报了点估计和"两侧检验 $p \le 0.01$",没有给任何置信区间、标准误或绝对基数(日均展现量、样本量都未披露)。
- 对照组:原文未在 §4.9 明确命名对照组,但可从"Latency increases relative to the Base"以及全文 Base 被定义为"the online production ranking model"推断,对照是线上生产模型 Base(DIN + SENET + DCN-V2 组合架构)。这是合理推断而非明写。
- 指标独立性存疑:RPM +3.09% 与 revenue +2.95% 在一个固定流量桶里高度相关——总营收 ≈ RPM × 展现数,两者只差一个展现量因子。所以这不是三个独立证据,实质上是两个(变现效率 + 点击率),第三个数字几乎是前者的复述。
- 是否全量上线:论文没有任何"已全量部署 / fully deployed"的表述。 能找到的最强间接证据是 Table 1 脚注称压缩版是 "the version used for production serving",以及 Fig. 4 / Fig. 5 里标注的 "Production" 工作点($r = 0.5$、分片 300),说明生产配置已确定;§3.4.3 的整节生产推理优化也指向真实部署。但"7 天 20% A/B 之后是否推全"这一点原文没有交代,不能替用户断言已全量。
- 护栏:只有一句"no significant degradation in other guardrail metrics",未列出是哪些护栏指标,也未给数值。广告场景常见的广告主侧指标(CPC、ROI、转化率)与用户体验指标一个都没报。
八、与已归档相关工作的对比¶
SIF SIF: Sample Is Feature — 从 Item-Level 到 Sample-Level 的统一大规模推荐模型(Meituan, 2026-04-17)¶
关系:独立并发 + 同公司未引用(本文 37 条参考文献里没有任何一篇美团自家工作)· 已加载对方精读
- 共同关注的问题:两篇论文对根因的表述几乎逐字重合。SIF 的第二条动机原话是"模型容量扩展受困于序列 vs 非序列特征的结构异质性——历史 token 只是单字段 item embedding,而当前请求 token 是多字段拼接后的丰富表征,把二者塞进同一注意力空间会产生信息密度不对称";UniCon 的核心批评是"历史行为与当前请求在输入组织层面只差结果是否已观测,把它们拆成序列 / 非序列分支等于人为制造异质性"。同一个 root cause,同一家公司,相差 4.5 个月。
- 相近的技术骨架:两者都(1)把历史序列的原子从 item 抬升到"整次请求"级别的富单元,(2)让历史单元与目标单元共享同一 schema,(3)在这个二维结构上跑两级分解注意力。SIF 的 SIF Block 沿行做 Token-level Mixer(同一样本内 $T$ 个 sub-token 交互)、沿列做 Sample-level Mixer($L+1$ 个样本跨时间交互);UniCon 的 UniConBlock 做 intra-context(单元内 token 交互)与 inter-context(跨单元交互)。这是同一张方法流程图的两个实例。 连"目标侧要用一个特殊构造对齐到历史侧表示空间"的问题两者都碰到了:SIF 用 $W_{res}^{(g,k)}$ 投影 + $\mathcal{L}_{align}$ 对齐损失(式 18),UniCon 用可学习 placeholder 填充 feedback 分量。
- 本文的差异与推进:(1) 单元的定义不同——SIF 的单元是"一次历史交互对应的完整原始样本"(仍是一个 item + 它的全部特征快照),UniCon 的单元是"一次曝光里被共同展示的一整组 item",因此 UniCon 能表达 SIF 表达不了的同屏局部竞争与互补;(2) 端到端 vs 两阶段——SIF 必须先离线用 HGAQ 把 raw sample 量化成 Token Sample,压缩器与下游模型不能完全联合优化(归档 rubric 里点名的"先压缩再建模"扩展性隐患);UniCon 不做离线量化,只在块间做可微的 Gumbel-TopK 剪枝,表征与序列建模能力随参数量一起扩张;(3) 目标侧统一的彻底程度——SIF 的 target token sample 仍是"当前请求的特征",候选之间不互相交互;UniCon 把整个候选集组织成一个目标潜在上下文单元,候选之间显式互相 attend,并用曝光 / 位置监督把它推向真实展示列表结构。
- 可比的方法 / 实验差异:两者都在美团数据上、都对 HyFormer 报增益。SIF 相对 HyFormer 最多 +0.88% GAUC,线上 +2.03% CTR / +1.21% CVR / +1.35% GMV per session(外卖排序);UniCon 相对 HyFormer 离线 AUC 0.8627→0.8697(+0.0070),线上 +2.07% CTR / +3.09% RPM(搜索广告)。两篇跑在同一家公司的不同业务线上,用了不同的基线快照,因此数字不可直接相比;但更值得注意的是 UniCon 完全没有引用 SIF——同一家公司在同一条"抬升序列建模原子"的技术轴上、相隔 4.5 个月发表的两篇工作互不引用,是本文 related work 的一处实质缺口。(美团在库工作还包括 MTGR MTGR、DIG DIG、NSGR NSGR、NONTP NONTP,UniCon 也都未引。)
TMallGS TMallGS: Scaling Unified Feature and Sequence Modeling(Taobao & Tmall Group of Alibaba, 2026-07-15)¶
关系:独立并发,且在同一个设计问题上得出相反结论 · 已加载对方精读
- 共同关注的问题:两篇都在问"统一 Transformer 排序骨干该如何对待异构输入"。TMallGS 把它命名为 The Heterogeneity Gap(异构性鸿沟):搜索输入跨度极大(短 query 到长尾行为),强行用统一注意力处理会触发梯度冲突,深层自注意力还会像低通滤波器一样稀释高频硬信号(如 query-item 匹配分)。UniCon 面对的是同一现象,但给出相反的诊断:异质性本身是遗留特征工程的产物,不是数据的固有属性。
- 相近的技术骨架:两者都重新设计了统一骨干的 token 组织与注意力边界,都做请求级(而非逐候选)的序列构造以避免上下文冗余编码,都在骨干之上叠了正交的上下文 / 偏置处理。
- 本文的差异与推进(核心是三处正面冲突):
- 参数共享 vs 参数分离。TMallGS 用 Per-Field 异构 QKV 投影(每个域独立的 $\mathbf{W}_Q^{\phi}, \mathbf{W}_K^{\phi}, \mathbf{W}_V^{\phi}$),理由是"标准 Transformer 把所有 token 投影到共享潜空间,忽略了各域的流形差异";UniCon 反其道而行,intra-context 的同一套参数被所有上下文单元共享(附录 A 明写 "The same intra-context parameters are shared across these units"),理由正是要让"从已观测上下文学到的交互模式迁移到目标表示"。
- 候选之间该不该互相看见。TMallGS 的 Context-Dominant Visibility Mask 明确规定 Candidate Independence:$\mathbf{M}_{ij} = -\infty$ 当 $i, j$ 都是候选且 $i \ne j$,理由是防止候选间信息泄露与 shortcut learning。而 UniCon 的目标潜在上下文单元其全部立论就是候选必须互相 attend(intra-context Locality 作用在候选集上),并用附录 B 的分片剂量—反应曲线(16→300 候选,AUC 0.8670→0.8697)来论证候选越多越好。这是同一个 mask 设计位上的正面对撞。
-
上下文该内化还是外挂。TMallGS 用一个"正交解耦的 Context-Aware Bias Net"把系统性偏置从真实意图里剥出来,并用 Decoupled FiLM Late Fusion 保护显式交叉信号;UniCon 的 §4.4 恰好把这类做法概括为"往已有骨干上挂上下文模块"(attaching context modules to existing backbones)并宣称自己更优。
-
可比的方法 / 实验差异:TMallGS 是天猫搜索精排、线上 +1.52% GMV;UniCon 是美团搜索广告、线上 +3.09% RPM / +2.07% CTR。两者的场景都是"query 约束强、同屏竞争强"的搜索排序,却在"是否共享参数""候选可见性"上做出相反选择并各自拿到线上正收益——说明这两个设计维度上很可能不存在通用最优解,而是与业务的候选集构造方式、位置偏置强度强相关。UniCon 未引 TMallGS,读者也拿不到二者的直接对比。
HubMixer HubMixer: Progressive Latent Hub Mixing(Kuaishou + Tsinghua, 2026-08-28)¶
关系:独立并发(早本文 6 天,未被引用),且存在完全平行的归因病理 · 已加载对方精读
- 共同关注的问题:两篇都指认"在异构 token 上做扁平的全对全混合"是错的。HubMixer 的原话是推荐特征 token 本质异构(user-age / historical-click / item-category / context / statistical token 语义不同、稀疏模式不同),有用的交互往往稀疏且样本相关,直接扁平混合会把容量摊薄在大量弱相关 token 对上;UniCon 的原话是"a flat token sequence can conflate co-occurrence within the same display list with temporal proximity across different lists"。两者都认为扁平序列丢失了应有的分组结构。
- 相近的技术骨架:两者的解法都是在扁平 mixer 之上强加一层两级分组层级,先把 token 归约到一个更小的中间层、在那里做交互、再回到 token 空间。HubMixer 是 induction($H=16$ 个 latent hub 作 query 做 cross-attention)→ interaction(hub 空间自注意力)→ readout(token-conditioned 写回);UniCon 是 intra-context(单元内归约)→ inter-context(单元间交互)→ 下一块继续。
- 本文的差异与推进:分组从哪里来是根本差异。HubMixer 的 hub 是跨样本共享的可学习潜在原型(加一个由 token 均值生成的输入条件残差),分组语义完全靠模型自己学出来,没有任何外部锚定;UniCon 的分组是由生产日志白送的——一次曝光就是一个单元,边界是客观事实,零学习成本、零歧义,而且这个边界同时当成变长注意力的 segment offset 用,直接带来算力收益。"用免费的、语义确定的真实边界替代学出来的潜在边界"是 UniCon 相对这条路线的实质推进。
- 可比的方法 / 实验差异(值得对照阅读的是两者共有的归因病理):HubMixer 的自身消融显示
w/o hub interaction变体(0.8232 平均 AUC)低于 RankMixer(0.8238)与 TokenMixer(0.8241),也就是说它宣传的"latent hub 组织原则"本身并不是收益来源,全部边际来自在压缩 hub 空间重新引入 content-adaptive 自注意力。UniCon 呈现的是同一类问题的镜像:它宣传的"上下文中心化"两项直接消融只有 −0.0010 / −0.0007,而正交的曝光 / 位置辅助损失是 −0.0034(详见 §7);并且它的w/o Context Modeling拍平变体(0.8637 @ 0.33B)同样低于公开基线 OneTrans(0.8647 @ 0.21B)——与 HubMixer 的w/o hub interaction掉到 RankMixer 之下是完全一样的形状。两篇独立工作在两家不同公司、用两套不同数据,同时出现"内部消融的退化变体跑不过外部公开基线"的现象,提示这类工业排序论文的内部 strawman 普遍未被调优到与公开基线同等水平。
九、讨论与局限性¶
9.1 值得借鉴的设计¶
- 把结构边界同时用作建模边界与计算边界,是本文最漂亮的一手。同一个 segment offset,在 intra 阶段表达单元隔离、在 inter 阶段表达实例内全连,既避免了稠密 mask 的显存开销,又避免了 padding 的算力浪费。任何有天然分组结构(session、页面、订单、对话轮次)的场景都能直接复用这个模式。
- 对齐的 feedback 分量 + 可学习 placeholder,是把"历史与目标同构"从口号落到实处的最小机制,且天然不泄露未来信息。
- 压缩相关性分数的工程约束驱动设计:因为 FlashAttention 式 online softmax 不物化注意力矩阵,作者退而用 Q/K 均值池化的近似分数——这是一个很典型的"算子约束反过来塑造算法"的案例,值得记住。
- 服务时对每个候选在所有可行位置求值,把 position-conditioned CTR 变成一个真正可用的输出,而不是训练期的 debias trick。
9.2 局限与争议¶
- 命名主张与证据强度不匹配(最主要的问题,详见 §7):直接检验"context-centric"的两项消融合计 +0.0017,小于正交辅助损失的 +0.0034,也小于相对最强基线的全部空间 +0.0036;论文未说明基线是否同样开启辅助损失与 position-conditioned click head。
- 消融为单次运行、无方差:在自定 0.0003 噪声底之下,多项核心消融只有 2–3σ 量级,却承担着支撑范式主张的责任。
w/o Context Modeling的 strawman 嫌疑:0.33B 的内部拍平变体输给 0.21B 的 OneTrans。- 辅助监督是策略蒸馏,存在反馈闭环风险:曝光与位置标签由在任生产策略产生,作者自己承认这是"正则化到已记录的展示分布"。这意味着模型的一部分收益来自模仿当前线上策略的展示决策。短期 A/B 会因此显得好看,但长期反复迭代可能把系统锁死在现有策略的分布里(policy lock-in),而论文只做了 7 天实验,看不到这个风险。
- 对上下文单元质量的隐含依赖没有被讨论:整套方法建立在"曝光边界干净可得"之上。冷启用户(历史单元极少)、跨端 / 跨场景拼接的曝光日志、以及曝光日志本身的丢失率,都会直接侵蚀单元质量,论文没有任何鲁棒性分析或冷启分析。
- 候选分片是有损的且被低估了:分片到 16 时 AUC 掉 0.0027,说明目标侧上下文的价值确实随候选数增长;反过来说,生产上限 300 也并非无损——论文只说 160–300 之间相差 ≤0.0004,但没有给出"不分片全集建模"的 AUC 上界,读者无法知道 300 这个上限还留了多少空间在桌上。
- 只有单一场景验证:全部离线与线上结果都来自美团搜索广告一个场景,没有第二个业务线或任何公开数据集的复现点。论文在摘要里主张该限制"在电商货架与瀑布流这类上下文丰富的场景尤为突出",但只验证了搜索广告一种。
- 无公开基准可比性:所有指标基于美团私有数据,绝对值(AUC 0.85+)无法与任何外部工作横向比较,本篇也不进任何公开 benchmark 榜。
- related work 的同公司缺口:37 条参考文献中没有任何一篇美团自家工作,尤其是与本文技术轴高度重合的 SIF(SIF,同为美团、早 4.5 个月)与统一排序框架 MTGR(MTGR)。
9.3 方法论可扩展性¶
按归档 rubric 的关键问题——"参数量 scaling 时,表征能力与序列建模能力能否一起增长"——本文的答案是能,这是它相对同轴工作的结构性优势:
- 没有离线固化的码本或离散 token 空间(对比 SIF 的 HGAQ 必须离线量化);
- 没有显式的多阶段解耦,压缩是块间可微的 Gumbel-TopK,与主干联合优化;
- 加深 UniConBlock 同时增加了"如何表征单个上下文"(intra 层)与"如何建模上下文序列"(inter 层)两条路径的容量,Fig. 3 的 0.05B→0.33B 曲线在两条路径上是同步扩张的。
唯一的结构性天花板在上下文压缩比:$r$ 降到 0.3–0.4 时最后几块只剩近乎单个历史单元,Dynamics 建模被破坏(AUC 0.8692 / 0.8695)。也就是说"更深"与"更省"在这个架构里是有内在张力的——深度增长会让压缩的累积效应吃掉历史上下文,$O(N^2/(1-r^2))$ 的常数上界是以"深层看不到多少历史"为代价换来的。这个张力在 12 层(Large)时尚可控,若继续往 24 层以上堆,需要重新设计逐层保留比例调度。
十、结论¶
UniCon 把工业 CTR 统一建模的"统一单位"从 token 换成了 context unit:一次曝光内共同展示的 item 连同其意图、环境与用户信号构成一个结构同构的单元,历史侧填 logged click、目标侧填可学习 placeholder,由堆叠的 intra / inter 两级注意力分别捕捉 Locality 与 Dynamics,块间用 target-aware Top-K 压缩控制开销。变长注意力、融合的压缩算子、并行 dense MMoE 与 AOTInductor 编译式 C++ 服务共同把 801.29 GFLOPs 压到 197.14 GFLOPs 并守住 SLA;美团搜索广告 7 天 20% 流量 A/B 拿到 RPM +3.09%、CTR +2.07%、营收 +2.95%($p \le 0.01$)。
工程与部署这一半是扎实且可复用的。但"Unified Context-Centric Modeling Paradigm"这个命名主张的净贡献没有被现有证据确立:直接检验它的两项消融合计只有 +0.0017,小于一个正交辅助监督的 +0.0034,而相对最强研究基线的全部空间只有 +0.0036——并且论文的公平性声明只覆盖了数据、原始特征字段与训练资源,没有说明基线是否同样开启曝光 / 位置辅助损失与 position-conditioned click head。全文对该范式最干净的正面证据反而是被塞进附录 B 的候选分片剂量—反应曲线(16→300 候选,AUC 单调 0.8670→0.8697,+0.0027)——它证明的是"候选集上下文有真实信号"这个较窄的命题,而不是标题所主张的那个更宽的范式。