Not Only NTP: Extending Training Signal Coverage for Generative Recommendation
美团(Meituan)· arXiv:2607.12277v1 · 2026-07-14 · 生成式推荐 / 训练信号设计
研究动机与背景
生成式推荐(Generative Recommendation, GR)近年已成为工业级序列推荐的主导范式。受自回归语言建模成功的启发,GR 把 item 表示为离散语义 token(Semantic ID)序列,训练一个 Transformer 通过 Next-Token Prediction(NTP) 预测下一个 token。TIGER(Rajput et al., 2023)用 RQ-VAE 语义 ID 开创了这一路线;HSTU(Zhai et al., 2024)把它扩展到工业排序并展现出强 scaling-law 特性;OneRec(Deng et al., 2025)进一步在生成框架内统一了召回与排序。
然而本文提出一个关键质疑:为语义连续的 token 序列设计的 NTP,能否把它的全部效力迁移到推荐序列上?作者论证「不能」。 语言序列相邻 token 之间存在自然的语义连续性;而推荐序列会自由混合来自根本不同语义空间的 item(外卖、团购、酒店、丽人……)。对 NTP 的不满近来已成为跨领域的共同主题:在语言生成中,Nagarajan et al.(2025)证明了 NTP 的「近视(myopia)」使其无法完成需要隐式规划的任务;在表征层面,Cola DLM(Guo et al., 2026)和 ELF(Hu et al., 2026)干脆完全抛弃离散 token,改在连续潜空间中操作。本文选择在「训练信号」这一层加入讨论:保留离散语义 ID 框架,通过辅助目标扩展 NTP 的信号覆盖。
作者把 NTP 的结构性训练信号缺陷拆成两个正交维度:时间局部性(Temporal Locality) 与 空间局部性(Spatial Locality)。
时间局部性(Temporal Locality)
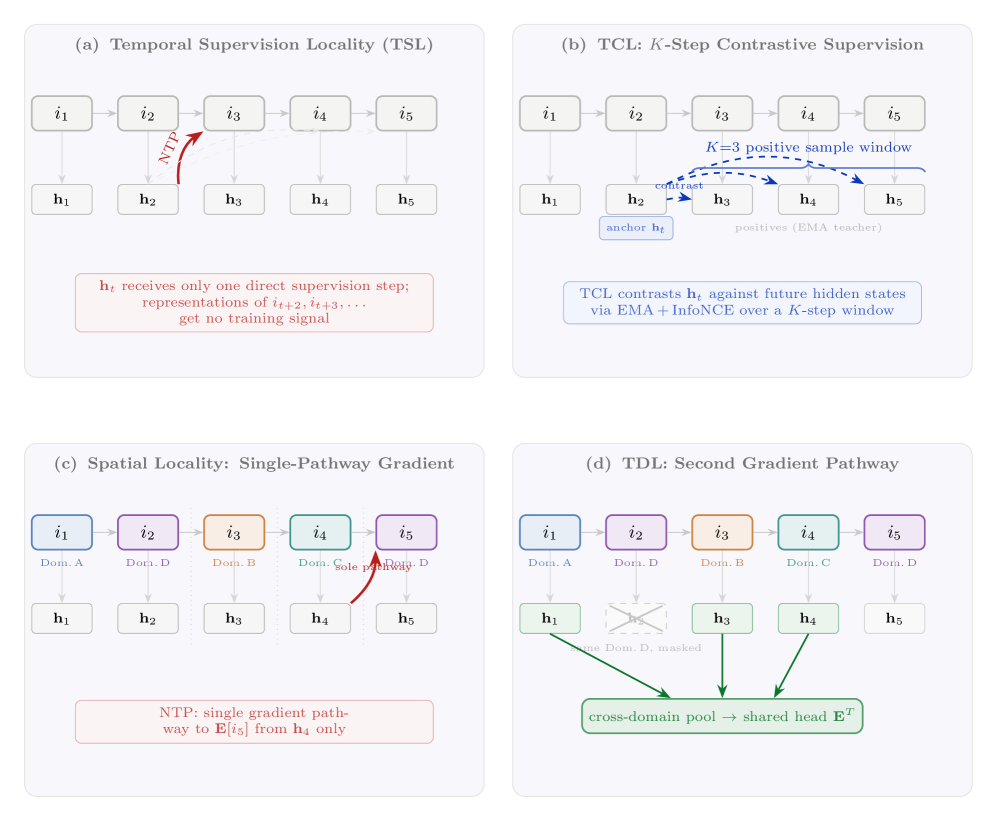
NTP 训练隐状态 $\mathbf{h}_t$ 只去预测紧邻的下一个 item $i_{t+1}$。模型从未被赋予一个直接的监督理由去把关于 $i_{t+2}, i_{t+3}, \dots, i_{t+K}$ 的信息编码进 $\mathbf{h}_t$。虽然注意力机制在理论上允许长程信息流动,但损失函数对模型捕捉跨步行为结构施加零压力。作者称之为时间局部性:每个位置的训练信号被局限在单一未来步,即使用户真实的偏好轨迹跨越更宽的时域。
例子。 考虑一个用户一周的交互序列:"外卖 → 外卖 → 外卖 → 丽人",之后是"丽人 → 团购 → 酒店"。这个轨迹清楚地指示了一次从即时消费向线下生活服务的结构性兴趣迁移。但在 NTP 下,第二个"丽人"位置(转折点)的隐状态只被训练去预测紧邻的"团购",完全错过了两步之后向"酒店"的更长程迁移。只有当监督覆盖 $K=3$ 的窗口时,模型才能感知到"丽人 → 团购 → 酒店"这一系统性兴趣迁移。
时间局部性带来两个实际问题:(1)近视偏差(myopic bias):模型记住的是高频局部转移,而非捕捉长程兴趣演化;(2)噪声敏感(noise sensitivity):单个 next-item 标签极其嘈杂(冲动购买、送礼、误点),使模型容易过拟合零星行为。
更糟的是,GR 中的 RQ-VAE 语义 ID 进一步加剧了时间局部性。在语言建模里,相邻 token 共享连续语义空间,梯度信号可以隐式携带跨位置的语义关联;但在 GR 中,即便语义相似的 item,其离散语义 ID token 也可能完全不同——相邻位置之间没有语义桥梁。这意味着 NTP 的近视偏差在 GR 中比在语言中更严重:不仅监督窗口太短,相邻位置还提供不了任何隐式的语义连续性来补偿。
空间局部性(Spatial Locality)
NTP 相对于共享预测头 $\mathbf{E}$ 是一个单通路(single-pathway)监督器:每个目标 item 的 embedding $\mathbf{E}[i_{j+1}]$ 只从紧邻的前一个隐状态 $\mathbf{h}_j$ 接收梯度更新。尽管 $\mathbf{h}_j$ 通过自注意力聚合了所有先前位置的信息,但到 $\mathbf{E}$ 的梯度通路在结构上被限制到单一输入源。这个约束对所有目标一视同仁,但其后果在不同域间是非对称的。
为何稀疏域受害更重。 考虑 $\mathbf{E}$ 中一个稀疏域 item $i_s$。在 NTP 下,$\mathbf{E}[i_s]$ 每次作为 next-item 目标出现时只收到一次梯度更新——而稀疏域 item 按定义就出现得少。更关键的是,当 $i_s$ 确实作为目标出现时,唯一的梯度通路来自 $\mathbf{h}_j$,而 $\mathbf{h}_j$ 的表征主要由稠密域模式塑造(因为稠密域 item 主导训练序列)。于是稀疏 item embedding 是在一份稀缺、且被稠密域偏置的梯度信号上被训练的。
作者称这个结构性限制为空间局部性:NTP 把每个目标的梯度通路局限在单一源位置,没有任何显式机制让跨域上下文参与优化共享预测头。
与 MBGR 的关系(动机层面):MBGR(Li et al., 2026,同为美团团队)此前通过 Label Dynamic Routing(LDR) 部分解决了相关问题——LDR 在标签空间用同域替代品替换跨域标签,提高稀疏域 item 作为预测目标出现的频率。LDR 是有效的工程方案,但它作用在标签层(选择"预测什么"),并未改变 $\mathbf{E}$ 上的单通路约束。这促使本文走表征空间的路线:与其增加目标频率,不如给共享头开辟额外的梯度通路。
NONTP 框架总览
本文提出 NONTP(Not Only NTP),通过两个与主损失联合训练的辅助目标扩展 NTP 的训练信号覆盖:
- TCL(Temporal Contrastive Learning,时间对比学习):用 BYOL 式的 EMA teacher + InfoNCE,在表征空间中把当前隐状态与 $K$ 步未来轨迹对齐。之所以在隐状态空间(而非 token 输出空间)操作是刻意的:作者论证语义 ID 是相邻 item token 间无语义连续性的离散码,故表征空间对齐比 token 序列预测是一个更鲁棒的、扩展时间监督的目标。
- TDL(Trans-Domain Learning,跨域学习):对每个目标属于域 $d$ 的位置,TDL 均值池化非目标域位置的隐状态,并通过 NTP 所用的同一共享预测头去预测目标 item,从而为每个目标 item embedding 开辟第二条梯度通路。TDL 不引入任何额外头参数,均值池化均匀混合跨域来源——在平滑域特定极值的同时保留共享模式。
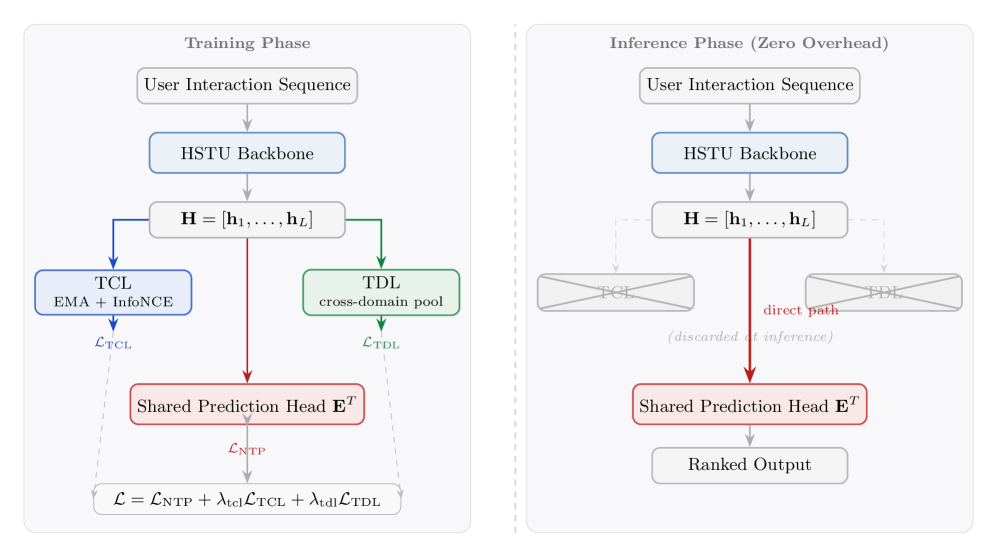
TCL 沿时间轴扩展监督,TDL 沿域轴扩展,二者共同提供双维度信号覆盖。两者在推理时全部丢弃:零开销。
本文贡献:
- 识别出时间局部性是 NTP 在推荐中的一个根本性限制,并把它与语言建模中独立观察到的 NTP 近视现象连接起来,进一步刻画了多域序列中的空间局部性。
- 提出 TCL——一个带 EMA teacher 与 InfoNCE 的时间对比目标,把监督扩展到表征空间中的 $K$ 步未来轨迹。
- 提出 TDL——一个跨域学习机制,均值池化跨域上下文并经共享头预测,代表了从标签空间方法到表征空间方法的演进。
- 在工业级四域数据集与公开 Amazon Movie-Book-CDs 基准上验证 NONTP,配以完整的消融研究与线上 A/B 结果。
核心方法 / 模型架构
预备形式化
一个生成式推荐模型把用户交互序列 $\mathcal{S}_u = [(i_1, d_1, t_1), \dots, (i_L, d_L, t_L)]$ 经 HSTU 骨干(Zhai et al., 2024)编码,产出隐状态 $\mathbf{H} = [\mathbf{h}_1, \dots, \mathbf{h}_L] \in \mathbb{R}^{L \times D}$,并通过共享预测头 $\mathbf{E} \in \mathbb{R}^{|\mathcal{I}| \times D}$ 预测下一个 item:
$$P(i_{j+1} \mid i_1, \dots, i_j) = \mathrm{softmax}(\mathbf{h}_j \cdot \mathbf{E}^T) \tag{1}$$
标准 NTP 目标最大化观测到的 next-item 的对数似然:
$$\mathcal{L}_{\text{NTP}} = -\frac{1}{L-1} \sum_{j=1}^{L-1} \log P(i_{j+1} \mid i_1, \dots, i_j) \tag{2}$$
在多域推荐中,item 划分为 $M$ 个域 $\mathcal{D} = \{\mathcal{I}_1, \dots, \mathcal{I}_M\}$。用户序列自由混合来自不同域的 item,使跨域转移成为用户行为的自然表达,而非数据噪声。
架构总览
NONTP 建立在 HSTU 骨干上。训练通过简单加权求和联合优化三个损失:
$$\mathcal{L} = \mathcal{L}_{\text{NTP}} + \lambda_{\text{tcl}} \mathcal{L}_{\text{TCL}} + \lambda_{\text{tdl}} \mathcal{L}_{\text{TDL}}, \quad \lambda_{\text{tcl}} = \lambda_{\text{tdl}} = 0.1 \tag{3}$$
推理时,所有辅助组件(EMA teacher、TCL predictors、TDL pooling)全部丢弃。 部署的模型就是一个带共享预测头的标准 HSTU 骨干——在结构、参数、推理成本上与 NTP baseline 完全相同(零推理开销)。
TCL:时间对比学习
TCL 的核心洞察:不要去预测未来的 item 是什么,而要让 $\mathbf{h}_t$ 感知未来状态的分布。 遵循 CPC(van den Oord et al., 2018)与 BYOL(Grill et al., 2020),TCL 用一个 EMA teacher 产出稳定的目标表征,并用 InfoNCE 把预测与之对齐。
EMA Teacher。 骨干的一个指数滑动平均副本充当 teacher:
$$\theta_{\text{ema}} \leftarrow m \cdot \theta_{\text{ema}} + (1-m) \cdot \theta_{\text{online}}, \quad m = 0.999 \tag{4}$$
产出稳定的目标状态 $\mathbf{h}_1^{\text{ema}}, \dots, \mathbf{h}_L^{\text{ema}}$。
未来步预测器。 对每个偏移 $k \in \{1, \dots, K\}$,一个线性预测器 $g_k: \mathbb{R}^D \to \mathbb{R}^D$ 把 $\mathbf{h}_j$ 映射为一个前向预测 $\mathbf{z}_j^{(k)} = g_k(\mathbf{h}_j)$。
InfoNCE 损失。 对每个 $k$ 与每个有效位置 $j$($j + k \le L$):
$$\mathcal{L}_{\text{TCL}} = -\frac{1}{K} \sum_{k=1}^{K} \frac{1}{|\mathcal{P}_k|} \sum_{j \in \mathcal{P}_k} \log \frac{\exp(\mathrm{sim}(\mathbf{z}_j^{(k)}, \mathbf{h}_{j+k}^{\text{ema}}) / \tau)}{\sum_{(s', j') \in \mathcal{B}_k} \exp(\mathrm{sim}(\mathbf{z}_j^{(k)}, \mathbf{h}_{j'+k}^{\text{ema}, (s')}) / \tau)} \tag{5}$$
其中 $\mathcal{P}_k = \{j : j + k \le L\}$;$\mathcal{B}_k$ 是 batch 中所有有效 (序列 $s'$, 位置 $j'$) 对(满足 $j' + k \le L_{s'}$)的集合;$\mathbf{h}_{j'+k}^{\text{ema},(s')}$ 表示序列 $s'$ 中位置 $j'+k$ 处的 EMA 隐状态;$\mathrm{sim}$ 是带温度 $\tau$ 的余弦相似度。正样本对为每个偏移 $k$ 独立构造。负样本只从 batch 中的其他序列采样;同序列位置被排除,以避免序列内时间相关性引起的假负样本。
推理。 EMA teacher 与所有 predictors 全部丢弃,零开销。
设计要点解释:TCL 之所以在隐状态空间对齐而非在 token 输出空间预测,是因为语义 ID 是离散码、相邻 token 无语义连续性——用一个「对齐到未来 K 步隐状态分布」的对比目标,比硬去预测确定的未来 token 序列更鲁棒,也天然抵抗 next-item 标签的噪声。EMA teacher 提供稳定的目标(BYOL 思想避免了显式对表征的坍缩),InfoNCE 提供跨多个未来步的时间对齐(CPC 思想)。
TDL:跨域学习
TDL 通过给 $\mathbf{E}$ 中每个目标 item embedding 开辟第二条梯度通路来解决空间局部性。每个 item $i$ 属于一个由数据集元数据决定的域 $d(i)$(例如 Amazon 的 Movie/Book/CDs 类目;美团的业务线标签);对目标 item 记 $d_{j+1} \equiv d(i_{j+1})$。对位置 $j$,定义跨域上下文集:
$$\mathcal{C}_j = \{l < j : d_l \neq d_{j+1}\} \tag{6}$$
当 $\mathcal{C}_j$ 非空时,通过均值池化计算一个跨域表征:
$$\mathbf{z}_j^{\text{tdl}} = \frac{1}{|\mathcal{C}_j|} \sum_{l \in \mathcal{C}_j} \mathbf{h}_l \tag{7}$$
这个表征通过 NTP 所用的同一共享预测头预测目标 item:
$$\hat{P}(i_{j+1} \mid \mathcal{C}_j) = \mathrm{softmax}(\mathbf{z}_j^{\text{tdl}} \cdot \mathbf{E}^T) \tag{8}$$
TDL 损失为:
$$\mathcal{L}_{\text{TDL}} = -\frac{1}{|\mathcal{J}_{\text{tdl}}|} \sum_{j \in \mathcal{J}_{\text{tdl}}} \log \hat{P}(i_{j+1} \mid \mathcal{C}_j) \tag{9}$$
其中 $\mathcal{J}_{\text{tdl}} = \{j : |\mathcal{C}_j| > 0\}$。由于 $d_{j+1}$ 是静态元数据,$\mathbf{z}_j^{\text{tdl}}$ 完全由位置 $l < j$ 的隐状态计算得到;没有关于 $i_{j+1}$ 的内容信息被引入(不构成信息泄露)。
TDL 为每个目标 item embedding 开辟第二条梯度通路:NTP 每次目标出现提供一次梯度更新(来自 $\mathbf{h}_j$),而 TDL 从跨域池化表征 $\mathbf{z}_j^{\text{tdl}}$ 额外提供一次更新。对于稀疏域 item——它们作为目标出现得少——这把每次出现的梯度更新数翻倍,而且第二条通路的输入主要来自稠密域位置。均值池化均匀混合来自不同域的贡献:单域极值被平滑,跨域共享信号被保留。TDL 可被看作 LDR 的表征空间演进:标签空间硬路由 → 表征空间软聚合,且与 NTP 共享预测头。
TCL 与 TDL 的共同设计原则
TCL 与 TDL 共享一个共同设计原则:(1)都在隐状态表征空间操作;(2)都避免引入自定义标签定义;(3)都与主 NTP 目标正交;(4)都在推理时丢弃。TCL 扩展时间覆盖,TDL 扩展跨域覆盖,默认权重 $\lambda_{\text{tcl}} = \lambda_{\text{tdl}} = 0.1$。
先验工作的统一视角
作者用一张表把已有方法沿两个局部性轴定位(Table 1)。
| Method | Addresses | Level | Limitation |
|---|---|---|---|
| NTP | — | — | 单步监督 + 单通路梯度 |
| Future Data (Yuan et al., 2020) | Temporal (early) | Label | Session 级,非面向 GR |
| PinnerFormer (Pancha et al., 2022) | Temporal (industrial) | Label | Day 级跳步标签,非 position 级 |
| SessionRec (Huang et al., 2025) | Temporal (partial) | Label | 依赖 session |
| LDR (MBGR) (Li et al., 2026) | Spatial (partial) | Label | 硬路由;需要域标签 |
| TCL (ours) | Temporal | Hidden state | EMA teacher 增加训练开销;短序列上收益有限 |
| TDL (ours) | Spatial | Hidden state | 需要域标签;无跨域上下文时收益有限 |
结论:这张表清晰地把 NONTP 的定位表达出来——已有的时间/空间补救方案都作用在标签层,而 TCL/TDL 是首次同时在隐状态表征层分别对时间与空间两个维度补救的方法。
实验设置
数据集
Meituan 工业数据集:覆盖美团平台一年、横跨四个业务域(A/B/C/D)的用户交互序列。训练集含 38.3M 用户、54.9M item。域密度差异显著:域 A(主导)、B(中密度)、C 与 D(稀疏)。平均序列长度 280。评估采用全量排序(full ranking)(在完整 item 语料上排序),报告每域及整体 HR@10(All 为跨域按样本加权平均)。
注:该四域数据集与 MBGR(2604.02684)使用的是同一份美团数据(用户/商户规模、四域划分、SASRec/TIGER/NTP/MBGR 的 baseline 数值均一致),NONTP 的工业实验实质是在 MBGR 的 benchmark 上继续叠加改进。
Amazon Movie-Book-CDs:从 Amazon 评论语料(McAuley et al., 2015)构造,含 Movie、Book、CDs 三个域。用户序列通过合并每用户跨类目的交互历史构建,严格按时间戳排序,使跨域转移反映用户真实时序行为。测试集 1,241,628 样本(Movie: 480K;Book: 720K;CDs: 42K),共 3.2M item。平均序列长度仅 12。评估采用固定负采样(999 candidates,seed=42),报告 HR@1/5/10 与 NDCG@5/10。
Baselines
SASRec(Kang and McAuley, 2018)、TIGER(Rajput et al., 2023)、NTP(HSTU)、MBGR(Li et al., 2026)。NONTP 消融变体:+TCL(NTP + TCL)、+TDL(NTP + TDL)、NONTP(full)。
实现细节
Adam 优化器,学习率在 $\{1\text{e-}4, 3\text{e-}4, 5\text{e-}4\}$ 中网格搜索,最大序列长度 1500,在验证 NDCG@10 上早停(patience=5),结果对 3 个随机种子取平均(工业 All HR@10 标准差 $\sigma \approx 0.0006$)。TCL 超参:$K = 3$,EMA $m = 0.999$,$\tau = 0.07$。$\lambda_{\text{tcl}} = \lambda_{\text{tdl}} = 0.1$。
训练成本:NONTP 增加了一个 EMA teacher(全骨干副本)、$K$ 个线性预测头、InfoNCE 成对计算,以及 TDL 跨域池化。相比 NTP,训练时间增加约 20–25%,GPU 显存增加约 40%;推理零开销。
主要实验结果
工业结果(Table 2:Meituan 全量排序 HR@10)
NONTP 在所有域上一致优于所有 baseline(All HR@10 0.0485,较 NTP +34.3%,较 MBGR +18.3%)。
| Method | All | A | B | C | D |
|---|---|---|---|---|---|
| SASRec | 0.0192 | 0.0218 | 0.0101 | 0.0178 | 0.0269 |
| TIGER | 0.0202 | 0.0221 | 0.0128 | 0.0180 | 0.0278 |
| NTP | 0.0361 | 0.0222 | 0.0488 | 0.0351 | 0.0371 |
| MBGR | 0.0410 | 0.0252 | 0.0554 | 0.0398 | 0.0421 |
| +TCL | 0.0445 | 0.0268 | 0.0595 | 0.0438 | 0.0460 |
| +TDL | 0.0458 | 0.0273 | 0.0612 | 0.0448 | 0.0472 |
| NONTP | 0.0485 | 0.0280 | 0.0630 | 0.0465 | 0.0490 |
结论分析:稀疏域(C: +0.0114、D: +0.0119 绝对值)比稠密域(A: +0.0058)显示出更大的绝对增益,这与双通路机制一致——$\mathbf{E}$ 中稀疏域 item embedding 每单位训练收到的 NTP 梯度更新最少,因此从 TDL 的第二条梯度通路(主要来自稠密域位置)中受益最多。作者也谨慎指出:域 A 较低的 NTP baseline(0.0222)可能反映其更大的 item 目录使全量排序本身更难,跨域绝对增益的比较应考虑目录规模差异。+TCL、+TDL 单独均能超过 MBGR,二者组合的 NONTP 最优,验证两个目标的独立且互补的贡献。
公开数据集结果(Table 3:Amazon Movie-Book-CDs,999 candidates,seed=42)
NONTP 整体 HR@10 +2.8%、NDCG@10 +3.7%。
| Method | HR@1 | HR@5 | HR@10 | ΔHR@10 |
|---|---|---|---|---|
| NTP | 0.1458 | 0.2796 | 0.3455 | — |
| +TCL | 0.1480 | 0.2836 | 0.3498 | +1.2% |
| +TDL | 0.1505 | 0.2864 | 0.3532 | +2.2% |
| NONTP | 0.1534 | 0.2895 | 0.3553 | +2.8% |
| Method | NDCG@5 | NDCG@10 | ΔNDCG@10 |
|---|---|---|---|
| NTP | 0.2158 | 0.2371 | — |
| +TCL | 0.2189 | 0.2405 | +1.4% |
| +TDL | 0.2217 | 0.2432 | +2.6% |
| NONTP | 0.2246 | 0.2459 | +3.7% |
结论分析:NONTP > TDL > TCL > NTP 的一致 rank ordering 在两个数据集上都成立,确认增益来自方法本身而非数据集特定因素。工业-公开的增益差距(+34.3% vs. +2.8%)反映多重结构差异:full ranking vs. 999-candidate 负采样、四域 vs. 三域、以及最突出的序列长度(280 vs. 12 步)。更长的序列同时放大了时间局部性(近视随更多步累积)与跨域转移,使工业数据集成为双局部性的压力测试,而公开数据集验证泛化性。
每域结果(Table 4:Amazon per-domain HR@10 / NDCG@10)
| Method | Movie | Book | CDs |
|---|---|---|---|
| HR@10 | |||
| NTP | 0.4118 | 0.3058 | 0.2657 |
| NONTP | 0.4282 | 0.3118 | 0.2684 |
| NDCG@10 | |||
| NTP | 0.2809 | 0.2123 | 0.1598 |
| NONTP | 0.2947 | 0.2182 | 0.1625 |
结论分析:三个域上增益一致(Movie: +0.0164、Book: +0.0060、CDs: +0.0027 绝对 HR@10)。CDs 域(42K 样本,占测试集 3.4%)改善最小,这与工业模式(稀疏域受益最多)相反。作者归因于 Amazon 序列极短(平均 12 步):转移总数少时单通路约束的影响有限,第二条梯度通路的收益也相应变小。这是一个诚实的负向结果解释——TDL 的收益依赖于足够多的跨域转移。
消融研究(Table 5:工业 All HR@10,base NONTP = 0.0485)
对 TDL,no-pool 变体对每个跨域位置做一次独立预测并对损失求平均(无聚合);其余行比较池化策略。
| Variant | HR@10 | Δ |
|---|---|---|
| TCL 消融(TDL 固定为 full) | ||
| NONTP (full) | 0.0485 | — |
| − EMA teacher | 0.0470 | −3.1% |
| $K = 1$ | 0.0475 | −2.1% |
| $K = 5$ | 0.0480 | −1.0% |
| − predictor MLPs | 0.0477 | −1.6% |
| TDL 池化策略(TCL 固定为 full) | ||
| NONTP (full) | 0.0485 | — |
| no-pool (per-pos. h) | 0.0478 | −1.4% |
| max-pool | 0.0483 | −0.4% |
| attention-pool | 0.0485 | ≈ 0% |
结论分析:
- EMA teacher 是 TCL 中最关键组件(移除 −3.1%),印证 BYOL 式稳定目标对表征对齐的必要性;
- $K$ 的选择:$K=1$(退化为只看单一未来步)掉 2.1%,$K=5$ 也略掉 1.0%,$K=3$ 为默认最优——说明扩展时间窗有益但过长会引入噪声/难度;
- predictor MLPs 移除掉 1.6%,说明前向预测器有价值;
- TDL 池化策略:mean-pool(默认)最优;
no-pool掉 1.4%(聚合本身有价值);max-pool几乎无损(−0.4%);attention-pool与 mean-pool 持平(≈0%),说明简单均值池化已足够,无需引入更复杂的注意力聚合——这是一个支持"简单即好"的工程判断。
超参数敏感性
温度 $\tau$ 在 $[0.05, 0.10]$ 内稳定;过小($\tau = 0.01$)导致不稳定,过大($\tau = 0.20$)削弱对比信号。损失权重 $\lambda_{\text{tcl}}, \lambda_{\text{tdl}}$ 在 $[0.05, 0.20]$ 内稳定,主结果变化不到 1%。$m = 0.999$ 最优,$m = 0.99$ 差 1.8%。
梯度冲突分析
直接把三个损失相加存在梯度干扰风险:不同目标可能把共享骨干参数拉向冲突方向。所有报告结果使用 $\lambda_{\text{tcl}} = \lambda_{\text{tdl}} = 0.1$ 的简单加权求和;作者经验证实这一设置处于协作区(cooperative regime),而把任一权重增到 $\approx 0.3$ 以上会降低 HR@10,说明在更大尺度上梯度冲突开始主导。作者还做了一个初步实验,应用 PCGrad 式梯度手术(Yu et al., 2020)——把与 NTP 梯度冲突的 TCL/TDL 梯度分量投影到正交方向后再求和——观察到适度的额外改善。但投影只解决方向冲突,不解决幅度失配(辅助损失在训练早期可能主导),更好的多目标梯度协调仍是开放方向(作者明确列为 future work)。
线上 A/B 测试
NONTP 部署在美团 DSP 平台的召回阶段,做 A/B 测试(各 5% 流量,14 天)。NONTP 取得 CTR +1.8% 与 GMV +2.1%(均 $p < 0.01$),确认了离线到线上的一致性。
核心贡献总结
- 诊断框架:把 NTP 在生成式推荐中的训练信号不足系统地拆成时间局部性(单步监督)与空间局部性(单通路梯度)两个正交维度,并把时间局部性与语言建模中独立观察到的 NTP 近视连接——提供了一个诊断 GR 训练信号不足的"principled lens"。
- TCL:BYOL 式 EMA teacher + InfoNCE,在隐状态表征空间把 $\mathbf{h}_t$ 对齐到 $K$ 步未来轨迹,扩展时间监督且抗 next-item 标签噪声。
- TDL:跨域均值池化 + 共享预测头,为每个目标 item embedding 开辟第二条无参数梯度通路,是 LDR(标签空间硬路由)向表征空间软聚合的演进。
- 零推理开销 + 工业验证:两个辅助目标推理时全丢弃,部署模型与 NTP baseline 完全一致;工业四域 HR@10 +34.3%(vs. NTP)、+18.3%(vs. MBGR),线上 CTR +1.8% / GMV +2.1%。
与已归档相关工作的对比
MBGR MBGR: Multi-Business Prediction for Generative Recommendation at Meituan (Meituan, 2026-04-03)
关系:系统迭代 + 显式引用(同为美团团队;NONTP 复用 MBGR 的 BID/MBP 基础设施,并把 MBGR 的 LDR 定位为 TDL 的标签空间前身)· 已加载对方精读
- 共同关注的问题:两篇都在解决同一个 root cause——在多业务/多域混合的生成式推荐序列中,NTP 框架对稀疏业务的训练信号严重不足。MBGR 把它表述为"跷跷板效应 + 表征混淆",NONTP 把它精炼为"空间局部性"(稀疏域 item embedding 的单通路、稠密域偏置梯度)。两篇甚至使用同一份美团四域数据集——用户 38.3M、商户/item 54.9M、A/B/C/D 四域划分、以及 SASRec/TIGER 的 baseline 数值完全一致,NONTP 的工业实验实质是在 MBGR 建立的 benchmark 上继续叠加。
- 相近的技术骨架:两篇都建立在 HSTU 骨干 + 共享语义 ID 预测头 + InfoNCE 对比损失之上(MBGR 的主损失就是跨业务 InfoNCE + 重建损失;NONTP 的 TCL 也用 InfoNCE)。两篇都强调"稀疏业务受益最大"这一实验规律。
- 本文的差异与推进:MBGR 的 LDR(Label Dynamic Routing) 作用在标签空间——用同业务最近交互替换跨域标签(式 13),把稀疏多业务标签稠密化,选择"预测什么"。NONTP 明确指出 LDR 是有效的工程方案但并未改变共享头 $\mathbf{E}$ 上的单通路梯度约束,于是 TDL 走表征空间路线:不改标签,而是均值池化跨域隐状态、经同一共享头开辟第二条梯度通路("标签空间硬路由 → 表征空间软聚合")。此外 NONTP 还额外攻击了 MBGR 未触及的时间维度(TCL),并在 Table 2 中直接把 MBGR 作为最强 baseline,报告 NONTP 较 MBGR All HR@10 +18.3%(0.0410 → 0.0485)。
- 可比的方法/实验差异:MBGR 引入 BID 双路径自编码器 + MBP MoE 专家(有额外结构与参数,部署时保留);NONTP 的两个辅助目标零额外头参数、推理时全丢弃,部署成本与 NTP 完全相同——这是相比 MBGR 在工程落地上的一个明显轻量化取舍。MBGR 报告下游 CTCVR GAUC +3.8% 与线上 CTCVR +3.98%;NONTP 报告线上 CTR +1.8% / GMV +2.1%(召回阶段,指标口径不同,不直接可比)。
讨论与局限性
核心贡献与借鉴价值:本文最值得借鉴的不是某个具体模块,而是它提供的诊断视角——把"NTP 训练信号不够"这个模糊直觉,锋利地拆成时间(监督窗口只有一步)与空间(梯度通路只有一条)两个可操作维度,并对每个维度给出一个零推理开销、与主损失正交、推理即丢弃的辅助目标。这种"训练期加信号、推理期零成本"的设计范式在工业界极具吸引力:它把改进完全压进训练阶段,部署侧不承担任何额外延迟或参数——相比 MBGR 保留 BID/MBP 结构的做法更易落地。TCL 把 BYOL+CPC 的自监督设计模式适配到 GR 隐状态空间("不预测未来 item 是什么,而是感知未来状态分布"),TDL 把 LDR 从标签空间提升到表征空间,两者都是干净、可复用的思路。
与已有工作的差异:与在表征层彻底抛弃离散 token 的 Cola DLM / ELF 不同,NONTP 保留离散语义 ID 框架,只在训练信号层做加法,因此与表征层方法是互补而非竞争关系。与 Future Data / PinnerFormer / SessionRec 等在标签层引入未来监督的方法不同,TCL 在隐状态表征层用对比学习扩展时间监督。与 Cross-Domain Recommendation(CDR)的显式 source/target 跨数据集迁移不同,NONTP 操作在单一数据集内自然混合多域的序列上,没有跨数据集迁移目标。
局限与争议:作者自陈三点局限——(1)TDL 需要域标签:在无显式标注的场景需通过聚类推断域;(2)TCL 的 EMA momentum 调度敏感:自适应调度是开放问题;(3)TDL 至少需要两个跨域位置,在极短序列(<10 步)上有效性受限(Amazon CDs 域的小增益就是佐证)。此外,三损失简单相加带来的梯度冲突是作者显式承认的未解决问题——PCGrad 只解决方向冲突不解决幅度失配,更好的多目标梯度协调被列为 future work。另一个值得注意的点:工业增益(+34.3%)与公开增益(+2.8%)差距巨大,作者归因于序列长度(280 vs. 12)等结构差异,这一解释合理但也意味着方法的收益高度依赖长序列 + 多域的工业场景,在短序列公开基准上的绝对收益相对有限。
工业落地价值:NONTP 已在美团 DSP 平台召回阶段完成 14 天线上 A/B(各 5% 流量),取得 CTR +1.8% / GMV +2.1%($p < 0.01$),且部署模型与 NTP baseline 零差异(无额外推理开销),落地摩擦极小。训练侧代价为时间 +20–25%、显存 +40%,对工业训练资源而言可接受。