HubMixer: Progressive Latent Hub Mixing for Parameter-Efficient Feature Interaction in Recommendation¶
快手科技(9 位作者中 8 位)+ 清华大学,2026-08-28,arXiv 2608.27991。本文面向工业推荐排序的特征交互骨干,提出用一小组可学习的 latent hub 替代原始 token 空间上的全连接 mixing,形成 induction → interaction → readout 三段式 block,在快手短视频招聘业务(约 4000 万 DAU)的十亿级样本上四个多任务目标 AUC 全面领先,且总参数量低于 RankMixer / TokenMixer,线上 A/B 简历投递转化率 +5.48% 并已全量部署。
一、研究动机与背景¶
1.1 token-mixing 路线的现状¶
工业排序模型的输入通常被组织成一组 token:用户画像、用户行为历史、物品特征、上下文特征、实时反馈信号等,各自经 embedding 后拼成 $T$ 个语义 token。近年一条主线是把类 Transformer 架构搬进排序:自注意力提供 content-adaptive 的 token-token 交互,但 $O(T^2)$ 的代价在 token 集变大时变得昂贵。于是 token-mixing 架构用轻量 mixing 算子或矩阵友好的变换替换注意力——RankMixer 采用 MLP-Mixer 式结构并做硬件协同设计,TokenMixer-Large 进一步引入 mixing/reverting 与层间残差以支持深度扩展。这条路线对工业部署很有吸引力:降低计算开销、提高硬件利用率、随模型规模放大表现良好。
1.2 本文指认的结构性问题:异构 token 上的"扁平混合"是参数低效的¶
论文的出发点是一个与 NLP 的对照:自然语言 token 来自共享语义空间、按有意义的顺序排列;而推荐的特征 token 本质异构——user-age token、historical-click 序列 token、item-category token、context token、statistical token 语义不同、稀疏模式不同、参与的交互类型也不同。更关键的是,有用的交互通常是稀疏且样本相关的:原文举的例子是"用户行为 token 往往只有在与 item-category 或 job-intent token 匹配时才有信息量,而 context token 主要调制时间敏感或场景特定的特征"。
在这种结构下直接对所有 token 做扁平混合,模型必须隐式地自己发现哪些特征组该交互、这些交互该如何路由,因此可能是参数低效的——容量被摊薄在大量弱相关的 token 对上。
由此引出本文的核心问题:能否先把异构 token 组织成少量语义 hub,在 hub 空间做高阶交互,再把交互后的语义注入回 token 表示?作者认为这既提供了更契合异构特征交互的归纳偏置,也能通过避免穷举式 token-token 混合、把容量集中到少量高价值交互子空间上,从而改善参数效率。
1.3 与 latent query 谱系的关系¶
论文把自己放在 Perceiver / Q-Former 的谱系里:Perceiver 用一小组 latent 变量总结大输入集合;Q-Former 用少量可学习 query 通过 cross-attention 桥接冻结的图像编码器与语言模型,是一个轻量信息瓶颈;OneRec 受 Q-Former 启发,在 lifecycle 路径上用可学习 query 归纳用户终生偏好为定长表示。
作者强调的差异是:Q-Former 与 OneRec 主要用可学习 query 去压缩模态特征或长行为序列,而 HubMixer 把 latent hub 用作通用推荐特征 token 之间的中间交互中枢——目标不只是表示压缩,还包括结构化的跨特征交互,以及交互后的 token-conditioned 信息写回。
1.4 贡献自述¶
- 从 token mixing 视角重新审视推荐中的特征交互,指出直接混合语义多样的特征 token 可能参数低效,因为有用交互往往稀疏、样本特定且具组结构;
- 提出 HubMixer,每个 block 遵循 induction–interaction–readout;
- 在快手短视频招聘业务上做离线实验、消融与线上 A/B,离线以更少参数超过强 token-mixing 基线,线上简历投递转化率 +5.48% 且已全量部署。
二、核心方法 / 模型架构¶
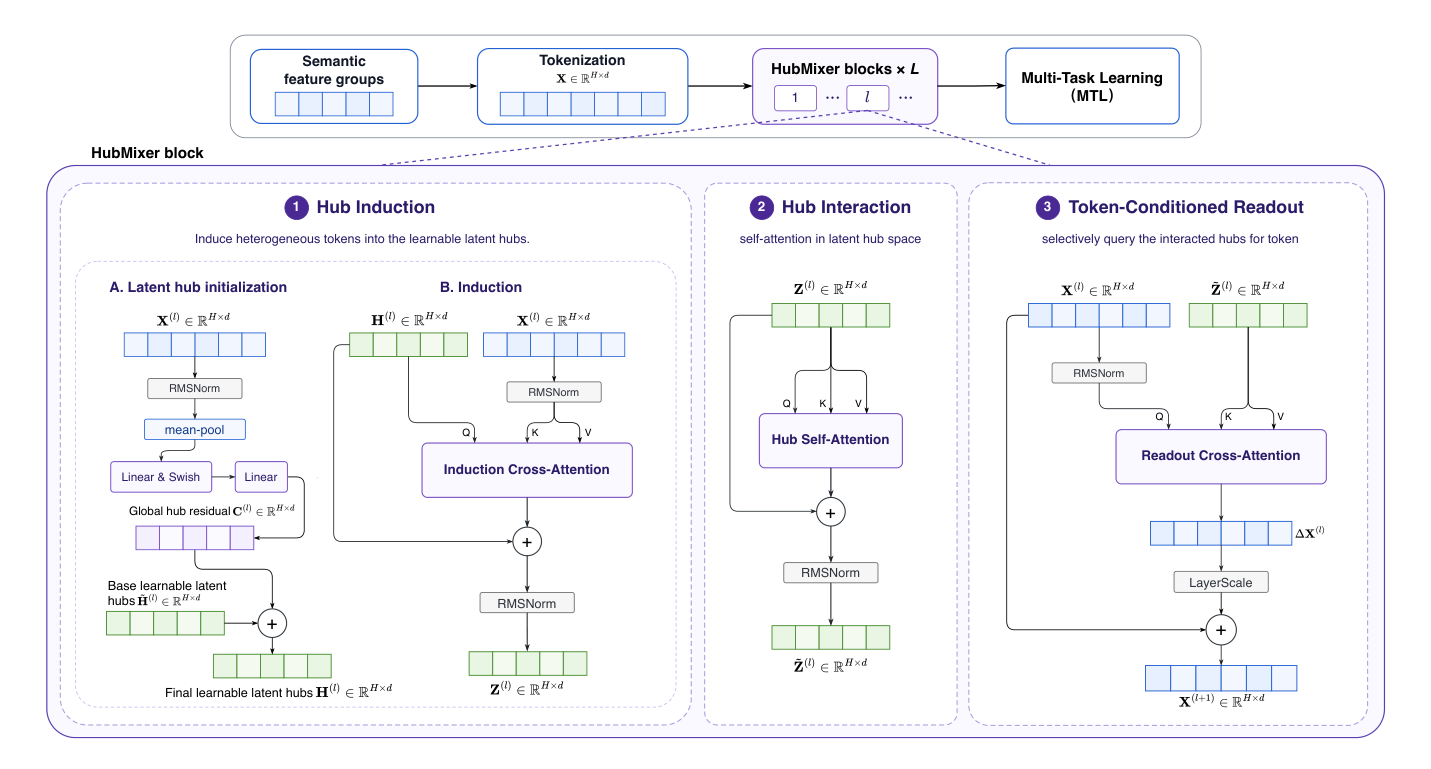
整体是四段流水线:tokenization → hub induction → hub interaction → token-conditioned readout,其中后三段构成一个 HubMixer block,堆叠 $L$ 层。
2.1 Tokenization¶
不把所有特征 embedding 拍平成无结构向量,而是按语义组组织并转成一组特征 token:
$$\mathbf{X} = [\mathbf{x}_1, \mathbf{x}_2, \dots, \mathbf{x}_T] \in \mathbb{R}^{T\times d} \tag{1}$$
其中 $T$ 是特征 token 数、$d$ 是 token 维度。每个 token 对应一个特定语义特征组或 field 级表示。这个 tokenized 表示保留了特征语义,为后续交互建模提供结构化输入空间。HubMixer 的目标就是把 $\mathbf{X}$ 变换为更精炼的 token 表示:每个 block 接收 $\mathbf{X}^{(l)}$、输出 $\mathbf{X}^{(l+1)}$。
2.2 Latent hub 的初始化:静态原型 + 输入条件残差¶
令 $\tilde{\mathbf{H}}^{(l)} \in \mathbb{R}^{H\times d}$ 为第 $l$ 层的 $H$ 个基础可学习 latent hub,$H \ll T$。这些基础 hub 跨实例共享、端到端优化,充当把异构特征 token 组织进紧凑交互中心的语义路由器。
但纯静态原型缺乏样本级上下文,因此用一个两层 MLP 生成输入条件残差。先对 token 做全局均值汇总:
$$\mathbf{p}^{(l)} = \frac{1}{T}\sum_{t=1}^{T}\mathbf{x}^{(l)}_t \tag{2}$$
再生成 hub 残差:
$$\mathbf{C}^{(l)} = \phi\!\left(\mathbf{W}^{(l)}_2\,\sigma\!\left(\mathbf{W}^{(l)}_1\mathbf{p}^{(l)} + \mathbf{b}^{(l)}_1\right) + \mathbf{b}^{(l)}_2\right) \tag{3}$$
其中 $\mathbf{C}^{(l)}\in\mathbb{R}^{H\times d}$,$\sigma(\cdot)$ 是 Swish 激活,$\phi(\cdot)$ 把向量 reshape 成 $\mathbb{R}^{H\times d}$。最终 hub 为:
$$\mathbf{H}^{(l)} = \tilde{\mathbf{H}}^{(l)} + \mathbf{C}^{(l)} \tag{4}$$
这一步的物理含义:hub 既是跨样本共享的语义原型(保证稳定的路由结构),又被当前请求的全局特征摘要平移了一下(保证样本级自适应)。注意 $\mathbf{W}^{(l)}_2$ 的输出维度是 $H\cdot d$,因此这个 MLP 的参数量与 hub 数 $H$ 成正比——后文的参数分析会回到这一点。
2.3 Hub Induction:hub 作为 query 读取 token¶
第一阶段把原始异构 token 归纳进 latent hub。给定归一化的 token 表示 $\tilde{\mathbf{X}}^{(l)} = \mathrm{RMSNorm}(\mathbf{X}^{(l)})$,以 hub 为 query 做 cross-attention:
$$\mathbf{Z}^{(l)} = \mathrm{RMSNorm}\!\left(\mathbf{H}^{(l)} + \mathrm{CrossAttn}\!\left(Q=\mathbf{H}^{(l)},\,K=\tilde{\mathbf{X}}^{(l)},\,V=\tilde{\mathbf{X}}^{(l)}\right)\right) \tag{5}$$
$\mathbf{Z}^{(l)}\in\mathbb{R}^{H\times d}$ 是归纳后的 hub 表示。直觉是每个 hub 学会关注某种特征 token 的混合,不同 hub 可以特化到不同语义面向(用户兴趣、物品语义、上下文信号、用户-物品交互)。由于注意力权重依赖输入内容,Hub Induction 提供了从异构特征 token 到 latent 交互中心的样本特定路由。
2.4 Hub Interaction:在紧凑 hub 空间做高阶交互¶
对归纳后的 hub 施加自注意力:
$$\tilde{\mathbf{Z}}^{(l)} = \mathrm{RMSNorm}\!\left(\mathbf{Z}^{(l)} + \mathrm{SelfAttn}\!\left(Q=\mathbf{Z}^{(l)},K=\mathbf{Z}^{(l)},V=\mathbf{Z}^{(l)}\right)\right) \tag{6}$$
因为 hub 数很小,hub 级交互计算上很便宜。作者认为这一步是关键:原始特征 token 来自不同语义组,对给定请求而言很多 token 对是弱相关的,直接建模全部 token-token 依赖会把容量花在大量低价值交互上;而 Hub Interaction 作用在每个已经汇总了一个内容相关子集的 hub 上,对捕捉紧凑高价值的跨特征交互提供了结构化归纳偏置。
2.5 Token-Conditioned Readout:选择性信息写回¶
hub 空间交互后,可以简单地把 hub 池化成一个全局向量喂给预测模块——但作者指出这会坍缩 field 特定的 token 身份,而在多任务排序里不同特征 token 对不同目标的作用不同。因此 HubMixer 把交互后的 hub 语义投影回 token 空间:每个 token 用自己的归一化表示 $\hat{\mathbf{X}}^{(l)}$ 作 query 选择性读取交互后的 hub:
$$\Delta\mathbf{X}^{(l)} = \mathrm{CrossAttn}\!\left(Q=\hat{\mathbf{X}}^{(l)},\,K=\bar{\mathbf{Z}}^{(l)},\,V=\bar{\mathbf{Z}}^{(l)}\right) \tag{7}$$
$\Delta\mathbf{X}^{(l)}\in\mathbb{R}^{T\times d}$ 是 token 特定的 readout 信号。与全局池化或广播不同,这个操作让每个 token 按自身表示检索一份定制化的 hub 语义混合。
readout 信号通过 LayerScale 式残差注入原 token 流:
$$\mathbf{X}^{(l+1)} = \mathbf{X}^{(l)} + \boldsymbol{\gamma}^{(l)}\odot\Delta\mathbf{X}^{(l)} \tag{8}$$
$\boldsymbol{\gamma}^{(l)}\in\mathbb{R}^{d}$ 是可学习 LayerScale 参数,$\odot$ 是在 token 维广播的逐元素乘。这个残差形式保留原始 field 特定表示,同时自适应注入交互感知的 hub 信息;LayerScale 给出一个稳定控制 readout 更新幅度的机制,在堆叠多个 block 时尤为有用。
因此第 $l$ 个 block 的输出不是池化后的 hub 表示,而是精炼后的 token 集合 $\mathbf{X}^{(l+1)}$。这保证 token 级 field 身份对下游多任务预测始终可用,同时逐层从 latent hub 空间注入全局跨特征交互信号。
2.6 多任务预测与优化¶
最后一个 block 输出的 token 被聚合成实例级表示后喂进 MTL 模块:
$$\mathbf{r} = \mathrm{Concat}\!\left(\mathbf{X}^{(L)}\right) \tag{9}$$
即所有 token 表示的拼接(不是池化)。每个任务头产出自己的预测:
$$\hat{y}_k = \mathrm{Sigmoid}_k\!\left(\mathrm{MTL}_k(\mathbf{r})\right) \tag{10}$$
任务 $k$ 的二分类交叉熵损失:
$$\ell_k(y_k,\hat{y}_k) = -y_k\log\hat{y}_k - (1-y_k)\log(1-\hat{y}_k) \tag{11}$$
总目标是各任务的加权和:
$$\mathcal{L} = \sum_{k=1}^{K}\lambda_k\cdot\ell_k(y_k,\hat{y}_k) \tag{12}$$
$\lambda_k$ 控制各任务的相对重要性。作者强调这里的职责划分:HubMixer 负责跨特征交互,MTL 模块负责任务特定信号抽取。
三、实验设置¶
数据与业务:快手短视频招聘业务的大规模工业数据集。该业务是建在快手内容分发场景之上的、创收的蓝领招聘服务,把招聘相关短视频与招聘线索分发给潜在感兴趣用户,覆盖约 4000 万日活用户。排序模型面向线索生成优化,目标是提升用户投递简历的数量与下游招聘转化。
数据收集与目标:从快手大规模日志中收集潜在感兴趣用户一个月的行为数据,构建了超过 10 亿样本的数据集,包含用户画像、用户行为序列特征、职位特征、短视频特征、上下文特征与统计特征。按生产设定形式化为四目标多任务排序:plc_click、effective_view、interact、resume_submit,对应招聘链路从初始点击、有效消费、互动到最终简历投递的不同阶段。
基线:DCN、DCNv2、AutoInt、Wukong、RankMixer、TokenMixer。覆盖显式特征交叉模型、基于注意力的特征交互模型、面向交互的工业排序模块,以及近期的 token-mixing 排序骨干。所有模型在相同特征集、相同多任务设定下训练。
指标:离线用 AUC,且按任务分别报告而不是压成单一分数。线上主指标是简历投递转化率;由于用户投递意愿受点击、有效消费、互动影响,线上把四个任务预测融合成一个综合排序分。
实现细节:所有模型使用相同的特征预处理流水线、embedding 维度、优化器、batch size、训练调度与多任务损失权重。所有 Mixer 类模型 token 数 $T=32$、mixer block 层数 $L=2$;HubMixer 默认 hub 数 $H=16$。(注:具体的 $d$、学习率、batch size、训练步数等数值论文未披露。)
四、主要实验结果¶
4.1 主表:四目标 AUC 与参数量¶
Table 1:快手短视频招聘数据集上的性能对比
| Model | plc_click | effective_view | interact | resume_submit | Avg. AUC | #Params |
|---|---|---|---|---|---|---|
| DCN | 0.8196 | 0.8453 | 0.8358 | 0.7818 | 0.8206 | 155.3M |
| DCNv2 | 0.8194 | 0.8468 | 0.8361 | 0.7825 | 0.8212 | 157.5M |
| AutoInt | 0.8194 | 0.8459 | 0.8363 | 0.7823 | 0.8210 | 162.6M |
| Wukong | 0.8183 | 0.8461 | 0.8365 | 0.7822 | 0.8208 | 154.6M |
| RankMixer | 0.8221 | 0.8495 | 0.8389 | 0.7845 | 0.8238 | 155.1M |
| TokenMixer | 0.8227 | 0.8491 | 0.8394 | 0.7852 | 0.8241 | 156.9M |
| HubMixer (ours) | 0.8253 | 0.8507 | 0.8401 | 0.7864 | 0.8256 | 142.4M |
作者的三点结论:
- 传统特征交叉模型(DCN / DCNv2 / AutoInt / Wukong)整体弱于近期 token-mixing 模型(RankMixer / TokenMixer)。这说明在特征 token 语义多样、有用交互稀疏且样本相关的现代工业排序场景下,单纯提高交叉的阶数或形式是不够的。
- HubMixer 在四个目标上全部取得最佳 AUC,且提升在早期参与类目标与深层转化类目标上都成立,说明学到的交互模式对整个招聘链路有用,而不是只对单一目标有用。
- HubMixer 用比 RankMixer / TokenMixer 更少的参数取得更好 AUC,凸显 induction–interaction–readout 范式的参数效率:把特征交互路由过紧凑 latent hub,比在扁平 token 空间直接混合所有特征 token 更有效地使用容量。
对幅度的独立核算(详见 §八):相对最强基线 TokenMixer,四项增量分别为 plc_click +0.0026、effective_view +0.0016(对 RankMixer 是 +0.0012)、interact +0.0007、resume_submit +0.0012,平均 +0.0015。工业 CTR 场景通常把 +0.001 AUC 视作有意义,因此"全胜"成立,但强度极不均匀:plc_click 一项明显超出经验噪声带,interact 一项(+0.0007)落在噪声带内,而论文未报告任何多次运行的方差或显著性检验。
4.2 线上 A/B¶
在快手内容型招聘短视频分发系统部署,A/B 持续 7 天、覆盖 7.2% 生产流量。主指标是简历投递转化率,直接反映招聘业务的下游线索生成目标。
结果:简历投递转化率相对 base model 提升 5.48%,统计显著。A/B 之后 HubMixer 已在快手短视频招聘业务全量部署。
五、消融与分析¶
5.1 模块消融¶
作者对比完整模型与两个变体:(1) 去掉 hub interaction,归纳后的 hub 不经 hub 空间自注意力直接用于 readout;(2) 把 token-conditioned readout 换成 pooled hub injection,交互后的 hub 池化成一个全局向量加到所有 token 上——第二个变体检验"token 特定的选择性读取"是否必要,还是一个共享全局摘要就够了。
Table 2:模块消融
| Variant | plc_click | effective_view | interact | resume_submit | Avg. AUC |
|---|---|---|---|---|---|
| Full HubMixer | 0.8253 | 0.8507 | 0.8401 | 0.7864 | 0.8256 |
| w/o Hub Interaction | 0.8221 | 0.8480 | 0.8383 | 0.7844 | 0.8232 |
| Pooling-to-Token Readout | 0.8242 | 0.8499 | 0.8390 | 0.7857 | 0.8247 |
分析:完整模型在四个任务上一致最优。去掉 hub interaction 在每个目标上都明显下降,平均 AUC 从 0.8256 掉到 0.8232——说明只把 token 归纳成 latent hub 是不够的,必须在 hub 之间做高阶交互,才能把归纳出的摘要转化成有用的跨特征交互信号。把 token-conditioned readout 换成池化注入也伤性能(0.8256 → 0.8247),但降幅小于去掉 hub interaction;这说明全局 hub 信息有用,但把池化后的 hub 表示均匀加到所有 token 上,不如让每个 token 从交互后的 hub 里选择性检索——token-conditioned readout 在注入交互上下文的同时保留了 token 特定语义,这对"不同特征 token 对 click / effective view / interaction / resume submission 贡献不同"的多任务招聘排序很重要。
一个论文没有点破的关键读数:w/o Hub Interaction 的平均 AUC 0.8232 低于 RankMixer 的 0.8238,也低于 TokenMixer 的 0.8241。也就是说,只保留"latent hub 归纳 + token 条件读出"这套 hub 组织机制、去掉 hub 空间自注意力之后,HubMixer 比它要取代的扁平 token mixing 更差。归因含义见 §八。
5.2 Hub 数的影响¶
hub 数控制 latent 交互空间的容量:太少形成过强信息瓶颈,太多则增加参数与计算而收益递减。
Table 3:latent hub 数的影响(默认 $H=16$)
| $H$ | plc_click | effective_view | interact | resume_submit | Avg. AUC | Params |
|---|---|---|---|---|---|---|
| 4 | 0.8231 | 0.8486 | 0.8382 | 0.7852 | 0.8238 | 135.1M |
| 8 | 0.8244 | 0.8498 | 0.8394 | 0.7857 | 0.8248 | 138.2M |
| 16 (default) | 0.8253 | 0.8507 | 0.8401 | 0.7864 | 0.8256 | 142.4M |
| 32 | 0.8255 | 0.8511 | 0.8402 | 0.7865 | 0.8258 | 150.8M |
$H$ 从 4 增到 16,四个任务 AUC 一致提升,说明更大的 latent hub 空间为组织跨特征交互提供了更强容量。但从 16 增到 32 只有边际收益:平均 AUC 从 0.8256 到 0.8258,参数从 142.4M 增到 150.8M。作者据此认为信息增益在 16 个 hub 之后开始饱和,选 $H=16$ 作为精度-参数权衡的默认值。
原文内部不一致:§4.3 正文写"the parameter count increases from 142.4M to 165.1M",而 Table 3 的 $H=32$ 一行写的是 150.8M。两处数字冲突,论文未作解释。
5.3 Token 表示增强分析¶
为解释为什么 HubMixer 超过最强基线 TokenMixer,作者从两个互补角度分析 token 表示:token 级表示更新幅度,以及线性探测性能。
(a) token 级方向性更新。对第 $l$ 个 block,令 $\mathbf{x}^{(l)}_{n,i}$、$\mathbf{x}^{(l+1)}_{n,i}$ 为实例 $n$ 第 $i$ 个 token 的输入输出表示,用余弦距离度量方向性更新:
$$D^{(l)}_i = \mathbb{E}_n\!\left[1-\cos\!\left(\mathbf{x}^{(l)}_{n,i},\,\mathbf{x}^{(l+1)}_{n,i}\right)\right] \tag{13}$$
$D^{(l)}_i$ 越大表示 block 交互后输出 token 与输入越不相似,即注入了越多新交互信息。
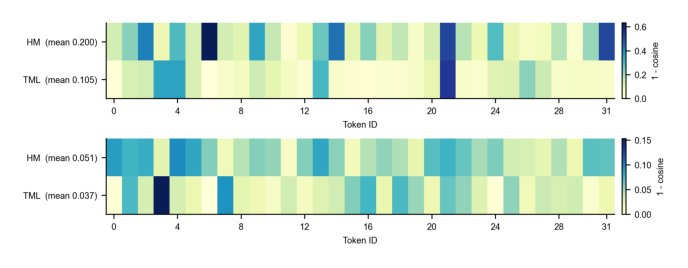
结果:HubMixer 的输入输出不相似度一致大于 TokenMixer。第一层 HubMixer 平均余弦距离 0.200,接近 TokenMixer(0.105)的两倍;第二层 HubMixer 仍然更大(0.051 vs 0.037)。作者解释:TokenMixer 直接在原始 token 空间混合,token 更新相对温和;HubMixer 先归纳出紧凑 latent hub、在 hub 空间做高阶交互、再通过 token-conditioned readout 写回每个 token,因此注入了更丰富的交互信息。热力图还显示更新在 token 之间不均匀分布,说明注入的信息是 token 相关的,而非简单的全局扰动。
(b) 线性探测。作者也承认更大的表示更新本身不必然意味着更好的表示质量——也可能来自不必要的扰动。因此进一步做线性探测:训练完骨干后冻结全部骨干参数,在每个 token 表示之上训练轻量线性分类器;同时在拼接表示 $\mathrm{Concat}(\mathbf{X}^{(L)})$ 上做实例级探测衡量整体表示质量。
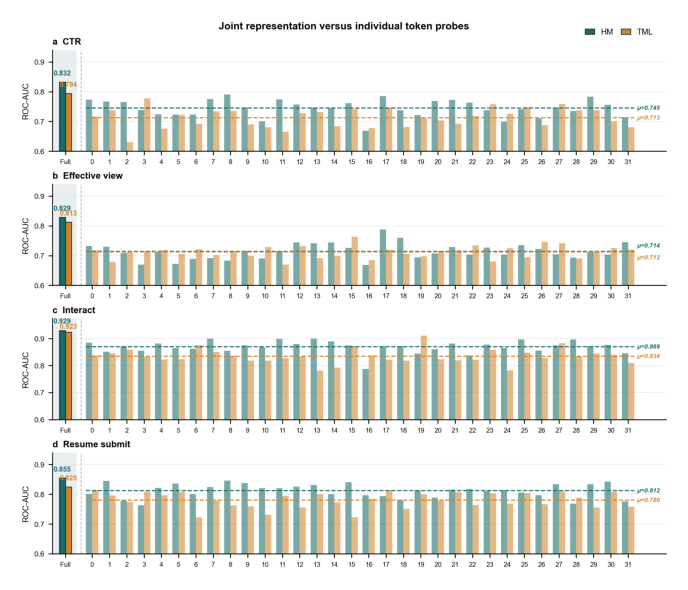
图中给出四组任务的实例级(Full)与逐 token 探测 ROC-AUC:CTR 上 HM 0.832 vs TML 0.794(token 均值 0.745 vs 0.713);Effective view 上 0.829 vs 0.813(均值 0.714 vs 0.712);Interact 上 0.929 vs 0.923(均值 0.869 vs 0.834);Resume submit 上 0.855 vs 0.825(均值 0.812 vs 0.780)。由于探测器是线性的、骨干是冻结的,这个提升说明 HubMixer 让任务相关信号更容易被线性读取。两项分析互补:HubMixer 不只是更强地改动 token 表示,而且产出对多任务招聘排序更有预测力的表示。
六、讨论(原文 §5)¶
Latent hub 作为归纳偏置:hub 可以看作在显式交互之前组织推荐特征的架构归纳偏置。把异构 token 当作扁平序列意味着让模型完全从数据中发现交互结构;HubMixer 引入少量可学习交互中心,鼓励模型先把相关信号汇总成紧凑 latent 语义、再在这些语义之间做交互。这个设计不假设固定的特征层次,而是让 hub 在端到端训练中学到软的、内容相关的组织模式。
Readout 作为选择性信息写入:token-conditioned readout 更应理解为"选择性信息写入"而非全局特征广播。交互后的 hub 存储紧凑的跨特征语义,原始 token 保留下游预测所需的 field 特定信息,readout 连接两个空间:每个 token 按自己的 query 决定吸收哪些 hub 信息。这对多任务排序尤其合适,因为不同目标可能依赖同一特征集的不同侧面——参与型目标与转化型目标可能受益于用户意图、物品语义与上下文信号的不同组合。
部署考量:hub 数控制 latent 交互空间大小,可按参数与延迟预算调整;block 数控制渐进交互精炼的深度。hub induction 与 token-conditioned readout 都是特征 token 与少量 hub 之间的 cross-attention,代价按 $TH$ 而非 $T^2$ 增长,便于批量化 cross-attention、kernel fusion、小矩阵计算优化等工程手段。
未来方向:(1) 由请求级上下文/用户意图/场景信号动态生成完整 hub 集合,而非当前的共享 hub + 轻量输入条件残差;(2) 用多样性正则或正交约束显式鼓励 hub 特化,尤其在堆叠更多 block 时;(3) 与更高级的多任务设计结合,如 task-aware readout、task-conditioned hub、目标特定路由;(4) 把 hub interaction 算子换成更轻量的形式(MLP-based hub mixing 或稀疏专家式 hub mixing);(5) 系统级优化。
七、核心贡献总结¶
HubMixer 的核心主张是:推荐特征交互不该在原始异构 token 空间里做扁平的全对全混合,而应当先把 token 归纳进一小组可学习 latent hub、在干净的 hub 空间做高阶交互、再让每个 token 按自身 query 从交互后的 hub 里读出定制信号并以 LayerScale 残差写回。这样既把容量集中到少量高价值交互子空间(参数效率),又通过写回 token 流而非池化成全局向量保住了 field 特定的 token 身份(多任务友好)。在快手招聘业务十亿级样本上四目标 AUC 全面领先,线上简历投递转化率 +5.48% 并已全量部署,是一份可信的工业落地记录。
八、对"AUC 全胜 + 参数更少"两个卖点的独立核查¶
这一节是精读时的独立复核,不属于原文内容。
8.1 AUC 提升的幅度:全胜成立,但强度极不均匀且缺少方差¶
以最强基线为参照逐项算差值:
| 目标 | 最强基线 | HubMixer | 增量 |
|---|---|---|---|
| plc_click | 0.8227 (TokenMixer) | 0.8253 | +0.0026 |
| effective_view | 0.8495 (RankMixer) | 0.8507 | +0.0012 |
| interact | 0.8394 (TokenMixer) | 0.8401 | +0.0007 |
| resume_submit | 0.7852 (TokenMixer) | 0.7864 | +0.0012 |
| Avg. | 0.8241 (TokenMixer) | 0.8256 | +0.0015 |
判断:工业 CTR 里 +0.001 AUC 通常被认为有意义(可作为量纲锚点的是归档中腾讯 RankElastor 把"Criteo/Avazu 上至多 +0.001 AUC"当作主结果之一)。按这个标尺,plc_click 的 +0.0026 是扎实的,effective_view / resume_submit 的 +0.0012 是及格线上的,而 interact 的 +0.0007 落在经验噪声带内。更关键的是:论文没有报告任何多次运行的均值/方差或显著性检验(只有线上 A/B 被称为 statistically significant),因此第四位小数上的差异无法与随机种子噪声区分。结论:"四个 AUC 全胜"字面成立,但只有一项明显超出噪声,把它读成"全面碾压"是过度解读。
8.2 参数更少:是配置的副产物,不是受控的参数匹配对照¶
Table 1 里所有模型都在"$T=32$、$L=2$"的同一组旋钮下配置,各自的参数量是各架构在这组旋钮下自然长出来的结果,而不是被匹配到同一预算。论文没有做参数匹配对照:既没有把 RankMixer / TokenMixer 缩到 142M 再比,也没有把 HubMixer 放大到 155M 再比。因此"更少参数拿更好效果"只能说明"在这一组特定超参下恰好如此",不能支撑"架构本身更参数高效"的一般结论。
再看参数量的构成。Table 3 显示 $H$ 从 4 到 32,总参数从 135.1M 涨到 150.8M——15.7M 的增量完全由 hub 数线性驱动。但可学习 hub 本身只有 $L\cdot H\cdot d$ 个参数($L=2$、$H=16$ 时即使 $d=1024$ 也只有约 3.3 万),所以这 15.7M 几乎全部来自式 (3) 里生成 $\mathbf{C}^{(l)}\in\mathbb{R}^{H\times d}$ 的第二层线性 $\mathbf{W}^{(l)}_2$(形状为 $d_{\text{hidden}}\times H d$,与 $H$ 严格成正比)。换句话说:HubMixer 参数量上真正的旋钮不是"hub 机制",而是那个输入条件残差 MLP;把 $H$ 调小即可换来参数下降,而 $H=4$ 时平均 AUC 已跌到 0.8238,与 RankMixer 持平。这意味着"142.4M vs 155.1M"这条对比里,参数差主要是一个可自由调节的超参选择,而不是架构层面的效率证据。
另一个量级问题:$H=4$ 已经要 135.1M 参数,说明约 130M+ 的参数(embedding 表、tokenizer、MTL 头)是所有模型共享的固定成本。真正被比较的交互骨干只占十几 M,所以"参数少 8%"这个总量口径实际掩盖了交互模块之间的相对差距,两个方向上都不精确。
8.3 复杂度论证在论文自己的默认配置下不成立¶
§5.3 与 §5.4 反复强调 hub induction 与 readout 的代价按 $TH$ 而非 $T^2$ 增长。但代入论文自己的默认值 $T=32$、$H=16$:
- HubMixer 每个 block 的注意力 pair 数 = 归纳 $TH$ + hub 自注意力 $H^2$ + 读出 $TH$ = $2\times 32\times 16 + 16^2 = 1280$;
- 在同样 32 个 token 上做一次普通自注意力 = $T^2 = 1024$。
1280 > 1024:在默认配置下 HubMixer 的注意力开销高于直接对 32 个 token 做全自注意力。$O(TH)$ 相对 $O(T^2)$ 的优势只有在 $H \le T/4 = 8$ 时才真正兑现($H=8$ 时 $2TH+H^2 = 576 < 1024$),而 Table 3 显示 $H=8$ 时平均 AUC 降到 0.8248,相对 TokenMixer 只剩 +0.0007、interact 一项完全打平(0.8394 = 0.8394)——即:复杂度论证成立的配置区间,恰好是性能优势退化到噪声的区间。另外论文全文没有报告任何延迟、QPS、MFU 或吞吐数字,而 RankMixer / TokenMixer 这条线的立身之本正是硬件效率,因此"参数更少"是否translate 成更便宜的服务,论文没有给出任何证据。
8.4 收益归因:来自"重新引入自注意力",而不是 latent hub 组织本身¶
这是最关键的一点。按"引入新信号 ≠ 收益来源"的判据核对消融:
w/o Hub Interaction(保留 hub 归纳 + token 条件读出,只去掉 hub 空间自注意力)平均 AUC = 0.8232;- RankMixer = 0.8238,TokenMixer = 0.8241。
去掉 hub 自注意力后,HubMixer 比它要取代的两个扁平 token-mixing 基线都更差。 也就是说,本文主打的新信号——"用少量 latent hub 组织异构特征、避免穷举 token-token 混合"——单独拿出来是负收益的;全部 +0.0015 的平均增量(以及更多)都来自式 (6) 那一步 hub 空间的 softmax 自注意力。
而 hub 空间自注意力恰恰是 RankMixer / TokenMixer 为了硬件效率主动砍掉的东西。因此更准确的机制叙事是:HubMixer 的收益来自"把 content-adaptive 的完整自注意力重新请回排序骨干",latent hub 的作用是把这件事的成本压到可接受范围(在 16 个 hub 而非 32 个 token 上做自注意力)——hub 是让 attention 变便宜的载体,不是收益本身。论文把功劳归给 induction–interaction–readout 这个"组织范式",与它自己的消融表并不一致。
一个直接的对照实验缺失也印证了这点:论文在 §2.2 引用了 HyFormer 和 OneTrans 作为"把注意力引入推荐"的代表,却没有把它们纳入 Table 1;唯一的注意力基线 AutoInt(0.8210)是 2019 年的老设计(无 FFN、无 RMSNorm / LayerScale、无现代残差)。在 $T=32$ 这个规模上,直接对 token 做全自注意力完全可承受,这个最该做的对照被略过了。
8.5 消融的覆盖不完整,且与摘要的措辞不符¶
摘要与结论都写"Ablation studies validate the effectiveness of hub induction, hub interaction, and token-conditioned readout",但 Table 2 只有两个变体,hub induction 从未被消融(诚然它很难单独移除,但那就不该在摘要里声称验证过)。此外两处关键消融缺失:
- 式 (2)-(4) 的输入条件残差 $\mathbf{C}^{(l)}$ 从未被消融——而它正是参数量的主要来源(§8.2)。去掉它能省下大部分 hub 相关参数,效果损失多少完全未知;
- LayerScale $\boldsymbol{\gamma}$ 从未被消融,论文却在 §2.5 强调它对堆叠稳定性的作用。
8.6 线性探测分析被高估¶
Figure 3 的探测差距远大于端到端差距:CTR 上实例级探测 0.832 vs 0.794(+0.038),resume_submit 上 0.855 vs 0.825(+0.030),而同样任务的端到端 AUC 差距只有 +0.0026 与 +0.0012,相差一个数量级。合理解释是:非线性的 MTL 头本就能从 TokenMixer 的表示里提取出线性探测器提不出的信息,因此"线性可读性"上的巨大优势在端到端指标上被大幅抹平。这说明该分析衡量的是表示的线性可访问性,把它当作 HubMixer 机制优越性的证据是放大了效应。(另注:Figure 3 把第一个任务标为 "CTR",Table 1 里叫 plc_click,命名不一致。)
8.7 其他可信度扣分项¶
- 线上 A/B 的 base model 未指明。+5.48% 的简历投递 CVR 对一次排序模型替换而言相当大;如果 base 是线上遗留的旧生产模型而非离线最强的 TokenMixer,这个数字就无法与 Table 1 的离线差距互相印证。论文没有说明。
- 完全没有公开数据集实验。Criteo / Avazu / MovieLens 一个都没跑,因此论文的任何结论都无法被外部复现或交叉验证。
- 超参未披露:只给了 $T=32$、$L=2$、$H=16$,embedding 维度、学习率、batch size、训练步数、$\lambda_k$ 全部缺失。
- 深度只到 $L=2$。Figure 2 显示第二层的平均余弦距离已从 0.200 掉到 0.051(约 4 倍衰减),意味着第二个 block 的实际更新已经很弱;论文却把"stacked blocks progressively refine"当作核心叙事,却没有 $L=1/2/4/6$ 的深度实验。对一篇以"参数效率与堆叠精炼"为主张的论文,这是方法论可扩展性上的实质缺口。
- 未引用最直接的先行工作 Set Transformer。式 (5) + 式 (7) 的组合(inducing points 先 attend 输入、再让输入 attend inducing points)就是 Set Transformer 的 ISAB(Induced Set Attention Block),HubMixer 在中间多加了一步 hub 自注意力、并加了输入条件残差与 LayerScale。论文只引了 Perceiver 与 Q-Former,没有提 ISAB,对"新颖性"的自我定位偏高。
九、与已归档相关工作的对比¶
SlimPer SlimPer: Make Personalization Model Slim and Smart (Meta, 2026-07-14)¶
关系:独立并发(本文未引用 SlimPer,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都认为,判别式排序把类 Transformer 架构照搬进来是一种结构性错配。SlimPer 的表述是:LLM 需要逐位置自回归监督、因而必须全程维护完整 token 级表示,而排序对每个
<user, item>只产出一组分数、没有这个需求,于是被迫在"层间大力压缩(信息损失)"与"保留大型中间张量(显存/算力开销)"之间二选一;HubMixer 的表述是:推荐 token 本质异构、有用交互稀疏且样本相关,在原始 token 空间做扁平混合是参数低效的。两者指向同一个 root cause——把容量花在 token 之间的全对全交互上,对判别式排序而言是浪费。 - 相近的技术骨架:两者的方法流程图几乎可以叠合。SlimPer 维护一个定长知识库 $\mathcal{X}^k\in\mathbb{R}^{K\times d}$(实验 $K=64$),每层用 KB 派生的 query 去 cross-attend 全部原始用户侧 token(Select),再更新 KB(Refine),堆叠 5-10 层;HubMixer 维护 $H=16$ 个 latent hub,每层用 hub 作 query cross-attend 全部特征 token(Induction),堆叠 $L=2$ 层。两者都主张"每层直接读原始 token、而不是读上一层的压缩隐状态"(SlimPer 用信息瓶颈的语言称之为"迭代压缩打破了数据处理不等式的 Markov 链",HubMixer 称之为"progressive refinement"),也都用一小组共享 latent 槽位把 $T\times T$(或 $N\times N$)交互折成 $T\times H$。
- 本文的差异与推进:分歧点在"读出",而且方向恰好相反。SlimPer 让 KB 承载全部下游预测(式 11 从 KB 直接出 task logits),token 表示从头到尾不被重建;HubMixer 则明确论证"把 hub 池化成一个全局向量会坍缩 field 特定的 token 身份",因此必须通过 token-conditioned readout 把交互语义写回 token 流、最终以 $\mathrm{Concat}(\mathbf{X}^{(L)})$ 而非 hub 送进 MTL。有意思的是,HubMixer 自己的消融给这一分歧提供了一个数据点:
Pooling-to-Token Readout变体(更接近"全局摘要"的一侧)平均 AUC 0.8247,比完整版低 0.0009——差距真实但不大,远小于去掉 hub 自注意力的 0.0024。另一个差异是 HubMixer 多了一步 hub 空间自注意力(式 6),而 SlimPer 的 KB 槽位之间没有显式交互,只通过 $\mathrm{MLP}_\mu$ 混合;按 §8.4 的归因,这一步恰是 HubMixer 全部增益的来源。 - 可比的方法/实验差异:SlimPer 的 KB 是 $K=64$、深度 5-10 层、面向 $N=O(10^3)\text{–}O(10^4)$ 的超长用户侧 token;HubMixer 是 $H=16$、深度 2 层、$T=32$。这个量级差解释了为什么 SlimPer 能拿到实打实的复杂度收益($O(L\cdot K)$ 显存与序列长度解耦),而 HubMixer 在 $T=32$ 上 $2TH+H^2>T^2$、复杂度论证反而不成立(§8.3)。SlimPer 还给出了 ROO 感知的工程收益与信息论容量论证($O(L\cdot N\cdot K)$ 交互容量),HubMixer 则完全没有理论或效率侧证据。SlimPer 的"定长 KB 迭代精炼"提供了 HubMixer 缺的那一半论证:latent 瓶颈的价值主要在长 token 集上,而 HubMixer 把它用在只有 32 个 token 的场景,动机基础相对薄弱。
FAT FAT: From Scaling to Structured Expressivity — Rethinking Transformers for CTR Prediction (Alibaba, 2025-11-15)¶
关系:独立并发(本文未引用 FAT,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇的问题陈述高度重合。FAT 把 CTR Transformer 的收益衰减归因于结构性错配:自然语言的语义是序列的、组合的,而 CTR 的预测力是"组合的、域相关的",输入是异构特征集合、顺序任意,真正重要的是语义域之间的交互拓扑;标准自注意力用全局共享投影矩阵一视同仁地处理所有 embedding,在极端稀疏下放大噪声。HubMixer 的诊断(异构 token、稀疏且样本相关的交互、模型被迫隐式发现该和谁交互)是同一个论断的另一种措辞。
- 相近的技术骨架:两者都把"稠密异构交互"因子分解到一组少量共享的隐性结构上以换参数效率。FAT 把 $O(F^2d^2)$ 的域对专属投影拆成"每域投影($O(Fd^2)$)× 域对标量调制($O(F^2)$)",再用 Basis-Composed Hypernetwork($M=64$ 个共享基矩阵、Top-$K=3$ 稀疏混合、训练后离线物化并缓存)把参数增长与域基数解耦,复杂度降到 $O(Md^2+Fk)$,典型设置下从 150B 压到 0.5B;HubMixer 把 $T\times T$ 交互折成经过 $H=16$ 个共享 hub 的两跳路由。两者的"少量共享基/中枢 + 内容相关的稀疏选择"骨架可以抽象重合。
- 本文的差异与推进:压缩的对象不同。FAT 压缩的是参数(交互仍在原 token/field 空间逐对进行,只是投影矩阵由共享基合成),因此保住了 field 对级的细粒度可解释路由(学到的 $w_{f_i,f_j}$ 非对称,暴露方向性交互模式);HubMixer 压缩的是交互空间本身(token 不再两两交互,一律经 hub 中转),代价是失去了 token 对级的可解释性——论文只能用余弦距离与线性探测间接论证 hub 有效。反过来,HubMixer 的写回机制(token-conditioned readout + LayerScale 残差)是 FAT 没有的:FAT 最后是 sum-pooling 出全局向量(式 9),恰恰是 HubMixer 明确反对的那种"坍缩 field 身份"的做法。
- 可比的方法/实验差异:证据强度差距明显。FAT 给出了 Rademacher 复杂度泛化界(误差依赖语义域数 $F$ 而非词表大小 $n$)、跨三个数量级(50M→1.5B)的 $\Delta\text{AUC}=1.16\times10^{-4}N^{0.405}$ 无饱和 scaling 曲线、公开数据集结果(Taobao 78.20 / MovieLens-20M 84.50,在 0.5B 匹配容量下胜过 Wukong/HSTU/HiFormer/RankMixer)、以及带 P99 延迟(45ms→48ms)与 MFU(5%→34%)的线上 A/B。HubMixer 只有单一私有数据集、无 scaling 曲线、无理论、无延迟数据、无参数匹配对照。在"异构特征交互的参数效率"这条共同主线上,FAT 把论证做完整了,HubMixer 停在了工程验证层面。
TokenMixer-Large TokenMixer-Large: Scaling Up Large Ranking Models in Industrial Recommenders (ByteDance AML, 2026-02-06)¶
关系:显式引用(即 Table 1 中的 "TokenMixer" 基线,对应参考文献 [4]),原文有主表与 §4.5 表示分析,但完全未讨论对方自己诊断的架构病理 · 已加载对方精读
- 共同关注的问题:TokenMixer-Large 的整篇论文是在回答"RankMixer(TokenMixer) 为什么堆不深"。它列出的关键局限包括:次优残差设计(mixing 要求新 token 数 $T'$ 与原 token 数 $T$ 匹配,add & norm 直接把 mixing 前后的 token 相加导致语义错位)、深层模型梯度更新不足(TokenMixer 通常只配 2 层,缺乏面向深层的设计)。它的解法是对称的"mixing-reverting"两层结构保证输入输出维度一致、建立从输入到深层的连续信号通路,外加每 2-3 层一次的 inter-residual 与 auxiliary loss。
- 本文的对比数据点与机制差异:HubMixer 报告 TokenMixer 平均 AUC 0.8241(142.4M vs 156.9M 参数),HubMixer 0.8256。HubMixer 的路线与 TokenMixer-Large 是互补而非互斥:TokenMixer-Large 在扁平 token 空间内部修残差通路与 MoE 稀疏化以支持深度扩展(推到 15B),HubMixer 换掉交互空间本身、但深度只到 $L=2$。两者对"堆不深"这件事的诊断也不冲突——一个说是残差语义错位/梯度衰减,一个说是异构 token 上的扁平混合本身低效。
- 本文未展开、但精读中可以补上的一条线索:HubMixer 的 Figure 2 恰好在 TokenMixer-Large 关心的同一坐标上留下了证据——HubMixer 自己第一层的平均余弦距离 0.200,第二层骤降到 0.051,约 4 倍衰减;TokenMixer 的对应数字是 0.105 → 0.037(约 2.8 倍衰减)。也就是说,HubMixer 的逐层更新衰减比 TokenMixer 更陡,第二个 block 的实际贡献已经很弱。这与 TokenMixer-Large 诊断的"深层梯度更新不足"是同一个症状家族,而 HubMixer 既没有引入 inter-residual 之类的深度补救(只有 LayerScale),也没有做 $L>2$ 的深度实验,却把"stacked blocks progressively refine cross-feature semantics"写进摘要。换言之,把两篇放在一起读会发现:HubMixer 展示的"更强 token 更新"其实只在第一层成立,它对深度扩展的主张缺乏证据,而这正是 TokenMixer-Large 花整篇论文解决的问题。
被剔除的近似候选与理由:
- UniMixer UniMixer(快手,2026-04-01)——同为快手、同属 token-mixing 参数/扩展效率主线,且本文同样没有引用自家这篇。但解法路径是把 TokenMixer 的置换矩阵参数化(Kronecker 全局×局部分块 + Sinkhorn-Knopp 约束 + 低秩/基组合的 UniMixing-Lite),始终停留在扁平 token 空间内部改造 mixing 算子,不引入任何中间隐变量集合;与 HubMixer"插入 $H$ 个 latent hub 作为交互中枢"的流程图无法抽象重合,故剔除。
- TMallGS TMallGS(淘天,2026-07-15)——问题同构("The Heterogeneity Gap"),但解法是 Per-Field QKV 放弃参数共享 + Decoupled FiLM 后融合,方向与"用少量共享 hub 做瓶颈"相反且骨架不重合;且其 per-field 路线已由 FAT 一条覆盖,保留 FAT 即可,剔除。
- TransRetrieval TransRetrieval(淘天,2026-08-26)——问题是 field 基数差异导致的 token norm 发散破坏 Transformer 的同质 token 假设,解法是把 weighted-sum 换成 weighted-average 的聚合标定(坚持参数无条件共享),属聚合层面的归一化而非交互结构的因子分解;且发表日仅早于本文两天,时序上既谈不上先行工作也难认定为可交叉验证的并发工作,剔除。
- RankElastor RankElastor(腾讯,2026-05-22)——问题同属"RankMixer 系为什么扩不动",但根因诊断落在 effective rank 的阻尼振荡(token mixing 扩、P-FFN 缩),解法是"parameterized full mixing + GLU 改进的 P-FFN",仍在扁平 token 空间调 mixing/FFN 的伸缩配比,解法路径不重合,剔除。(其"Criteo/Avazu 上至多 +0.001 AUC"被本篇 §8.1 借作幅度量纲的锚点。)
- SpecFormer SpecFormer(阿里,2026-07-27)——问题同为"特征异构导致深度 scaling 失败",但根因定位在谱坍缩(低秩 attention 充当低通滤波器 + 主导谱方向外的梯度饥饿),解法是可学习谱滤波,属频域路径,与 latent hub 的空间因子分解不同构,剔除。
十、讨论与局限性¶
值得借鉴的设计:
- 写回 token 流而不是池化成全局向量。这是本文相对 Perceiver / Set Transformer / SlimPer 一类"latent 瓶颈"设计最有价值的一处取舍,理由(多任务排序里不同 token 对不同目标贡献不同,池化会坍缩 field 身份)站得住,消融也给了 -0.0009 的支持。对任何要在判别式排序里引入 latent 瓶颈的工作,这是一个应当默认采纳的默认项。
- LayerScale 控制 readout 幅度。在把一个外来信号残差注入既有 token 流时,用可学习的逐维缩放控制注入强度,是廉价且稳妥的做法。
- 静态共享原型 + 输入条件残差的 hub 初始化,兼顾了跨样本的稳定路由结构与样本级自适应,是一个可复用的小设计(但见下方局限)。
核心局限(详细论证见 §八):
- 收益归因与论文叙事不符。消融显示,去掉 hub 空间自注意力后模型(0.8232)反而低于 RankMixer(0.8238)与 TokenMixer(0.8241);本文主打的"latent hub 组织异构 token"这一新信号单独看是负收益,全部增益来自重新引入 content-adaptive 自注意力。按"引入新信号 ≠ 收益来源"的判据,正确的定位应当是"latent hub 让自注意力在排序骨干里变得可负担",而不是"hub 组织范式本身更优"。
- 参数效率不是受控结论。没有参数匹配对照;参数差主要由输入条件残差 MLP 的 $H$ 依赖驱动(一个可自由调节的超参),而不是架构固有效率;且该 MLP 从未被消融。
- 复杂度论证在默认配置下自相矛盾。$T=32,H=16$ 时 $2TH+H^2=1280>T^2=1024$;论证成立的 $H\le 8$ 区间恰好是性能优势退化到噪声的区间。全文无任何延迟/吞吐/MFU 数据。
- 实验面过窄。单一私有数据集、零公开数据集、无多次运行方差、无 $L$ 深度实验、超参未披露、未与自己引用的 HyFormer / OneTrans 对比、唯一的注意力基线是 2019 年的 AutoInt。
- 新颖性自我定位偏高。式 (5)+(7) 的组合即 Set Transformer 的 ISAB,论文未引用;摘要声称消融验证了 hub induction,但 Table 2 里并没有这一项;Table 3 与正文的参数数字(150.8M vs 165.1M)自相矛盾。
- 方法论可扩展性存疑。$L$ 只到 2,且 Figure 2 显示第二层更新已衰减 4 倍;$H$ 从 16 到 32 收益饱和(+0.0002)。参数量继续放大时,表征能力靠什么继续增长,论文没有给出路径——把"progressive refinement"当卖点却没有深度扩展的证据,是这条路线最实在的天花板。
工业落地价值:这一维度是本文最扎实的部分。业务场景清晰(快手短视频招聘,蓝领招聘线索生成,约 4000 万 DAU,创收业务),数据规模真实(一个月日志、超 10 亿样本、六类特征),四个生产目标与招聘漏斗各阶段一一对应,A/B 参数完整(7 天、7.2% 流量),主指标是直接的业务指标(简历投递转化率 +5.48%,统计显著),并且已全量部署。唯一的遗憾是 base model 未指明,使得线上收益无法与离线表格互相印证。对同类业务(内容分发场景上叠加的垂类转化业务)而言,这套 hub 化的交互骨干是一个可直接借鉴的工程方案——只是应当带着 §8.4 的归因去借鉴:真正该抄的是"在压缩后的小集合上重新用完整自注意力",而不是"hub 这个概念"。