HA-MoE:工业级异构 feed 排序的端到端案例研究(Google Discover)
Heterogeneous Ranking in Industrial-Scale Recommender Systems: A Case Study Di Bai, Jintao Liu, Zhenwei Tang, Peifan Wu, Nada Al-Thawr, Luoshu Wang(Google LLC) RecSys '26 · arXiv:2607.27577v1 · 2026-07-30
研究动机与背景
同质封闭生态 vs. 开放网络异构 feed
绝大多数推荐系统构建在自包含平台上——专门的短视频应用或音乐流媒体服务。在这些相对同质的封闭生态里,item 的模态与互动模式高度相似,上游信号在整个平台范围内已被标准化。即便某些 feed 确实混合了异构内容(如 organic 内容与 ad cards),它们通常也依赖分离的排序模型,只在 late-stage re-ranking 阶段才把结果合并起来。
Google Discover 走的是另一条路:用单一排序模型从高度异构的开放网络构建统一的、个性化的 feed。
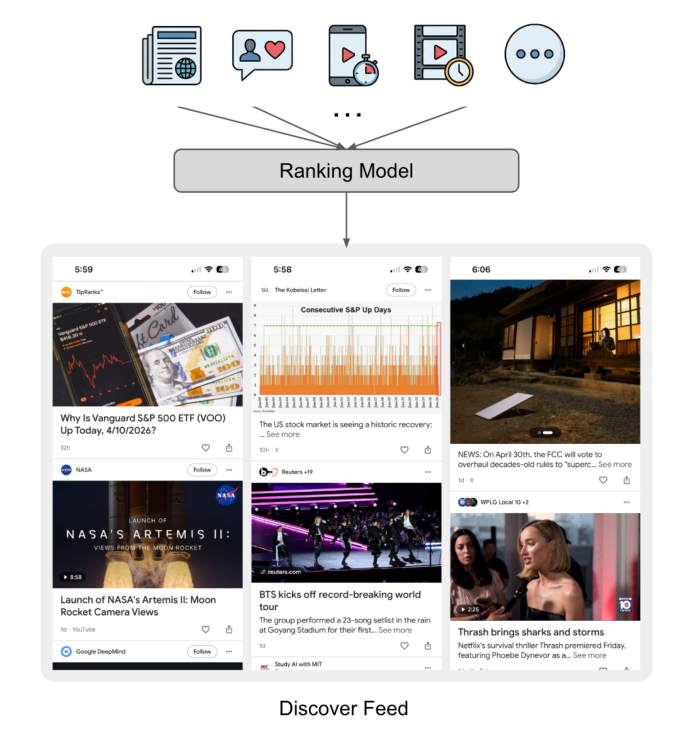
系统必须联合评估的内容谱系极宽:web articles、长视频与短视频、user-generated content(UGC)posts,以及 sports match cards、生成式 AI 摘要这类专门格式。论文把这种内容异构性拆成两个维度:
- Data Heterogeneity(数据异构):来自开放网络的内容缺乏统一特征,导致特征密度与元数据结构存在固有差异,以及信号可得性的不对称。
- Interaction Heterogeneity(互动异构):互动模式与用户意图各不相同。例如 like 与 dismissal 广泛适用于所有内容,但文章主要驱动 click,而 UGC posts 和 sports match cards 驱动长 dwell time。
三个具体的工程挑战
这种内在的内容异构性给统一排序带来三个实际问题:
- 分布不匹配(distribution mismatch):互动分布跨内容类型剧烈差异。一个主要按全局 CTR 优化的模型,可能会不成比例地偏好低质量文章(如 click-bait)而牺牲高价值的视频与 UGC,导致次优的用户体验。
- seesaw 现象(跷跷板):多任务排序系统联合优化冲突目标(如最大化 click 同时最小化 dismissal)时,常因负迁移(negative transfer)导致一个目标的改进反而损害其他目标。
- minority-type collapse(少数类坍塌):共享表征架构天生带有偏向"特征更丰富、流量更高"的主导内容类型的风险,少数类型的表征被压塌。
生产 baseline 与数据现状
当前 Discover 的生产 baseline 是一个共享 MLP 骨干 + 11 个任务专属预测头的架构。这 11 个头预测正负用户互动的混合,既涵盖通用互动(predicted click-through rate、dismissal rate),也涵盖格式专属动作。这个架构虽然运营高效,但强制单一 latent 表征去服务所有内容类型。
论文明确指出:公开数据集(REASONER、Yahoo! Music/KDD-Cup '11、KuaiRec)缺乏研究此类动态所需的内容异构性,因此作者完全依赖内部的大规模工业数据集。这也是本文无法复现的根源。
三项贡献
论文自称是一个覆盖模型全生命周期的生产案例研究,贡献分三层:
- 模型层:HA-MoE(Heterogeneity-Adaptive multi-gated Mixture-of-Experts),一个把显式异构上下文同时注入门控网络与专家表征的架构,在不突破严格运营约束的前提下实现有效特化。
- 可观测性层:LENS(Latent Expert Network Specialization),一个"拆盒(unboxes)"模型内部分工、并定量追踪功能性任务特化随时间演化的观测框架。
- 评估层:DL-AUC(Dual-Level AUC),一个同时捕捉 cross-type 排序正确性与整体排序性能的异构感知评估指标。
相关工作定位
多任务与多域推荐
早期推荐系统的多任务学习主要依赖 shared-bottom MLP 来联合优化多样的用户互动信号。为缓解共享表征中固有的负迁移,MMoE 与 PLE 引入了任务专属门控与解耦表征这两块基础架构;近期工作进一步通过动态平衡冲突任务的参数更新来精炼这些框架。
但论文强调:在单一模型内处理高度异构的内容仍是一个独立的挑战。因此许多工业 feed 干脆完全绕过统一建模,改用 late-stage 启发式、保留 slot 或竞价机制来合并 domain 专属的 ranker。为弥合这一 gap,多域推荐(MDR)架构如 STAR、PEPNet、M³oE 通过引入条件参数调制(conditional parameter modulation)推进了统一 serving。这些方法(包括 FiLM 及其在结构化数据上的适配)都利用外部信号来自适应地调整内部激活或权重,从而在不过度扩参的前提下对齐差异分布。此外,近期的 weight-ensembling MoE 被用于缓解 MoE 层内的参数干扰;Zhao et al. 则通过识别 domain-sensitive 特征 + 可检索记忆机制来显式捕捉 domain 专属区分度。
作者的结论是:在工业级、生产就绪的排序系统约束下有效处理这种异构性,仍是一个关键的开放挑战。
异构排序系统的两类形态
- Intra-platform Content Heterogeneity(平台内内容异构):TikTok 这类 feed 混合了短视频、长视频、图文 posts。主要挑战在于信息密度与用户互动模式的差异——视频消费用 watch time 衡量,而 posts 依赖 comments 这类互动。近期进展探索用统一表征学习桥接差异特征空间、部署异构 GNN 做 ad-keyword matching、以及用 RL 跨多样 item channel 优化推荐,以防止"majority bias"(主导格式盖过高质量小众内容)。
- Cross-business Objective Heterogeneity(跨业务目标异构):feed 中必须联合排序 organic 内容与广告。虽然它们外观相似,但优化目标常常不同甚至冲突——"seesaw phenomenon"是商业收益回退用户留存的常见瓶颈。通常这类系统采用两阶段机制而非完全统一的模型:第一阶段各类型内部单独排序,第二阶段合并有序列表最终曝光。
与受益于标准化统一信号处理的封闭生态不同,Discover 这类平台面临开放网络去中心化聚合带来的独特结构性挑战:这个多样生态排除了严格的上游特征标准化,系统必须处理内在非均匀的特征空间,导致数据密度差异与信号不对称。此外,用户互动模式会自然跨内容模态漂移,需要在排序模型内部直接对齐多个优化目标。
核心方法:HA-MoE
问题形式化
主要目标是为用户集 $\mathcal{U}$ 从异构 item 语料 $\mathcal{I}$ 构建统一的个性化 feed。每次 user-item 互动基于两类输入评估:
- $x \in \mathbb{R}^{d}$:输入的稠密特征表征;
- $h \in \mathbb{R}^{d_h}$:编码后的显式异构信号。
$h$ 是本文的核心抓手,它直接编码内容的结构性上下文,跨越两类信息:
- 类别属性,如
content_type(web articles vs. UGC posts); - 一大批上下文元数据,如 followed-creator status、shoppable content、AI-enhanced cards。
为捕捉多样用户意图,系统必须联合预测 $K = 11$ 个不同的用户互动任务,记为集合 $\mathcal{T} = \{1, 2, \ldots, K\}$。这些任务涵盖通用互动(predicted click-through rate、dismissal rate)与格式专属动作,并被归入两个宏类:
- pInterest:正向互动;
- pDisinterest:负向互动。
对用户 $u \in \mathcal{U}$ 与 item $i \in \mathcal{I}$,令 $y_t \in \{0, 1\}$ 表示任务 $t \in \mathcal{T}$ 的 ground truth 二值互动标签。统一排序模型学习一个映射函数来预测概率向量 $\mathbf{p} \in [0,1]^{K}$。
三条硬性工业约束
在工业规模部署统一排序架构受三条严格运营约束支配,它们直接塑造了设计选择:
- 模型内存容量有界——任意增大参数量会违反推理服务器的硬件内存约束;
- 训练速度必须保持——任何显著增加训练时间的架构改动都会拖慢生产流水线、降低整体工程速度;
- serving latency 必须有界——推理延迟的增加会直接降级用户体验。
生产 baseline 的共享 MLP 骨干虽然运营高效,但强制单一 latent 表征满足差异内容分布,使模型高度易受冲突目标间的负迁移与少数类坍塌影响。为在固定运营预算内打破这个瓶颈,HA-MoE 的策略是:不大幅扩模型、不重新设计复杂的特征 ingestion 流水线,而是聚焦提升模型骨干内已有显式异构信号的利用效率。
模型设计总览
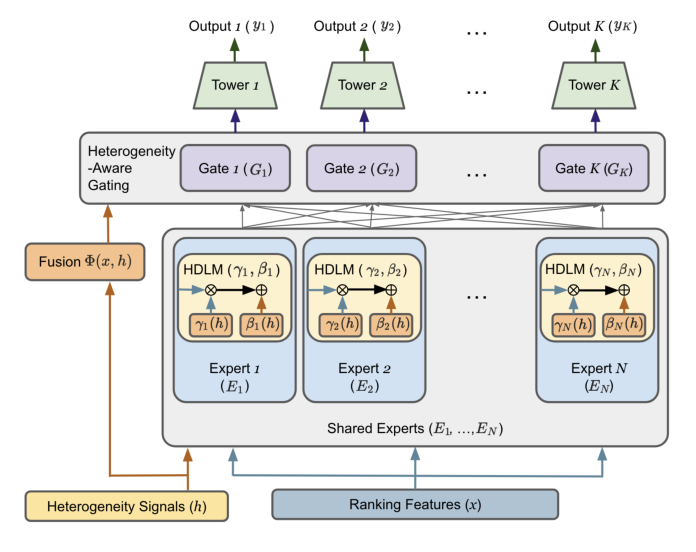
HA-MoE 采用稠密(dense)的 expert-based 多任务学习框架预测 $K$ 个不同互动任务。每个 expert 是一个前馈网络(FFN)。通过采用稠密 multi-gate MoE 骨干,模型把 monolithic 的共享表征分解为专门化的 experts,同时维持鲁棒收敛与高训练速度。在此基础上,HA-MoE 在门控网络与专家层内部同时引入异构感知的自适应机制。
对一个包含 $N$ 个共享 experts $\{E_n\}_{n=1}^{N}$ 的模型,任务 $t \in \mathcal{T}$ 的最终预测概率 $p_t$ 由「调制后专家输出的门控加权和」经任务专属 tower $T_t$ 得到:
$$p_t = T_t\left(\sum_{n=1}^{N} g_t(x,h)_n \cdot \tilde{E}_n(x, h)\right) \tag{1}$$
其中 $g_t(x,h)_n$ 是分配给任务 $t$ 的第 $n$ 个 expert 的标量门控概率,$\tilde{E}_n(x,h)$ 是第 $n$ 个 expert 的异构自适应输出。这个式子依赖两个各自利用异构性的关键组件。
组件一:Heterogeneity-Aware Gating(HA-Gating)
第一个组件把 $h$ 显式加进门控输入,以引导每个任务 $t$ 的专家利用:
$$g_t(x,h) = \text{Softmax}\big(W_t \Phi(x, h) + b_t\big) \tag{2}$$
其中 $W_t \in \mathbb{R}^{N \times d_\Phi}$ 是门控权重矩阵,$b_t \in \mathbb{R}^{N}$ 是对应的偏置向量,$\Phi(x,h) \in \mathbb{R}^{d_\Phi}$ 表示一个轻量的 fusion function,把稠密特征 $x \in \mathbb{R}^{d}$ 与显式异构信号 $h \in \mathbb{R}^{d_h}$ 整合为一个 $d_\Phi$ 维的联合表征。
设计动机:通过在这个表征中结构性地强调 $h$ 的影响,门控机制主动跨多样内容分段 steer 专家利用。这鼓励了「专门化 experts」与「异构互动模式」之间的鲁棒对齐——而这个动态正是保护少数分段不被主导内容类型盖过的关键。
组件二:Heterogeneity-Driven Linear Modulation(HDLM)
第二个组件的目标是把专家容量与分布特有偏置解耦。受条件仿射变换(FiLM)启发,HDLM 基于显式异构信号计算一个缩放向量 $\gamma_n(h)$ 与平移向量 $\beta_n(h)$,用来动态自适应专家表征:
$$\gamma_n(h) = W_{\gamma,n} h + b_{\gamma,n}, \qquad \beta_n(h) = W_{\beta,n} h + b_{\beta,n} \tag{3}$$
其中 $W_{\gamma,n}, W_{\beta,n} \in \mathbb{R}^{d_e \times d_h}$ 是调制权重矩阵,$b_{\gamma,n}, b_{\beta,n} \in \mathbb{R}^{d_e}$ 是 expert $n$ 各自的偏置向量。虽然这种上下文感知调制原则上可以施加在不同 stage,但作者只把它应用到最终的 expert layer,以在保留表征表达力的同时维持生产环境所需的训练速度与稳定性。自适应后的表征 $\tilde{E}_n(x,h) \in \mathbb{R}^{d_e}$ 通过一次 late-stage 仿射变换算出:
$$\tilde{E}_n(x, h) = \gamma_n(h) \odot E_n(x) + \beta_n(h) \tag{4}$$
其中 $\odot$ 表示逐元素乘。
物理含义(论文给出的三个具象例子,很值得记住):通过上下文性地重校准这些表征,网络可以隐式地基于输入性质"切换上下文(switch contexts)":
- 处理视频时,调制层可以把焦点导向视觉消费模式;
- 对来自已关注创作者的内容,它可以把预测重心从严重影响无标注 organic 排序的全局流行度先验移开,转向 user-creator 亲和度;
- 对生成式 AI 摘要卡这类新格式,网络可以从稀疏的历史互动信号 pivot 到卡内丰富的语义。
模型优化:pointwise 校准 + pairwise 保序
作者使用组合训练目标,在校准绝对概率的同时显式保持相对顺序:
$$\mathcal{L} = \alpha \mathcal{L}_p + (1-\alpha)\mathcal{L}_r \tag{5}$$
其中 $\alpha \in [0,1]$ 是平衡 pointwise 与 pairwise 损失的超参。给定训练 batch $\mathcal{B}$,pointwise 的 Binary Cross-Entropy(BCE)损失校准 $K$ 个预测头:
$$\mathcal{L}_p = \sum_{i \in \mathcal{B}} \sum_{t \in \mathcal{T}} w_t \mathcal{L}_{\text{BCE}}(y_{t,i}, p_{t,i}) \tag{6}$$
其中 $w_t$ 是任务权重,$y_{t,i}$ 是 ground-truth 标签,$p_{t,i}$ 是 item $i$ 上任务 $t$ 的预测概率。为显式鼓励模型把已互动 item 排在未互动 item 之上,引入 RankNet 式的 pairwise 损失:
$$\mathcal{L}_r = \frac{1}{|\mathcal{B}^{+}| \times |\mathcal{B}^{-}|} \sum_{i \in \mathcal{B}^{+}} \sum_{j \in \mathcal{B}^{-}} \log\left(1 + e^{-(s_i - s_j)}\right) \tag{7}$$
其中 $\mathcal{B}^{+}$ 与 $\mathcal{B}^{-}$ 分别是 batch 内收到正/负反馈的互斥 item 集合,$s_i$ 表示 item $i$ 的模型 logit。
生产环境的工程适配(这段细节很实用):论文列出了四条把这个损失落地的做法——
- pairs 按任务分别构造,且只取来自同一 session 的 co-impressed items;
- 只保留 positive-negative pairs,并施加额外过滤以剔除噪声组合;
- 为进一步稳定梯度,logit margins 被适当缩放;
- 最终损失基于每个 batch 内有效 pair 的数量动态归一化。
关键技术细节:LENS 持续生产监控
Discover 部署统一多任务架构的一个长期痛点是它的"黑盒"本质:单一共享表征掩盖了模型如何同时平衡异构内容分布与冲突任务目标。采用 HA-MoE 框架恰好解锁了一个"拆盒"内部动态、获得更深可解释性的独特机制。作者据此提出 LENS(Latent Expert Network Specialization)框架,它承担两项分析功能:提供 content-level 特化的可解释视觉诊断,以及跨不同模型状态定量分析任务特化策略。
Activation Slicing:可视化特化
为检查 HA-MoE 如何解耦异构内容,作者抽取每个预测任务的门控激活,并把它们切片成分离的 content-by-expert 矩阵。关键之处在于:这些激活概率按 content type 逐行归一化,从而量化每个 expert 的比例贡献,与绝对流量无关。这产出了模型内部分工的可视化,既捕捉通用行为的共享基础表征,也捕捉特定内容类型(Web Articles、UGC、Videos)的专家利用模式。
论文观察到三种主要模式:
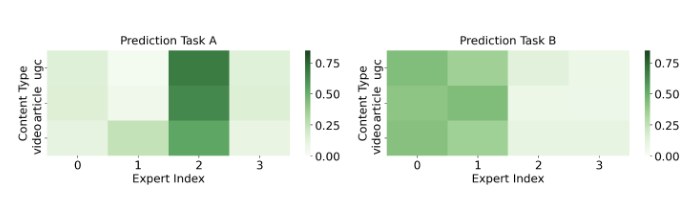
- Universal Prediction Tasks(通用任务):对于广泛适用、format-agnostic 的用户动作——例如通过 feed 主界面上每个 item 都具备的 heart button 表达 "like"(Task A)——模型一般展现强共同学习。如 Figure 3 所示,单个 expert(index 2)主导处理这个预测任务,且跨所有内容类型都如此。
- Universal but Sparse Tasks(通用但稀疏的任务):对于适用所有内容但正标签更稀疏的任务,如显式的 survey 正反馈(Task B),模型分配了两个共享 experts(index 0 与 1)。这表明虽然任务跨越所有内容类型,模型仍会调用略微更特化的容量来捕捉稀疏反馈内部的不同子模式。
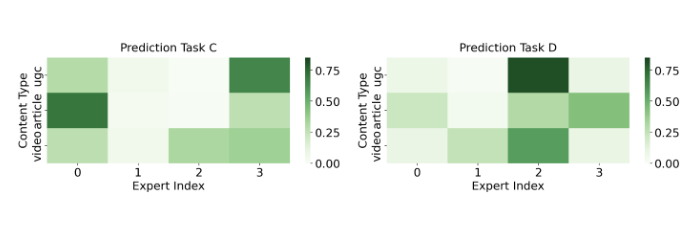
- Specialized/Format-Dependent Tasks(格式依赖的特化任务):对于内在绑定特定内容类型的行为——如 click 进详情视图(Task C)或展开文本块(Task D)——heatmaps 呈现高度特化的激活模式。如 Figure 4 所示,不同 experts 倾向为不同内容类型主要激活(Task C 中 article 行强激活 expert 0、ugc 行强激活 expert 3;Task D 中 ugc 行强激活 expert 2)。
PIEM:置换不变的专家匹配
视觉诊断单个模型状态提供了直观洞察,但管理持续训练流水线极度受益于自动化观测。随着部署越来越看重模型可预测性与内部表征稳定性,把这类分析扩展到比较多个模型 snapshot 具有关键诊断价值。
这里有一个技术障碍:expert networks 是置换不变(permutation-invariant)的,且对初始化高度敏感,因此直接跨模型比较参数矩阵是不可行的。虽然先验工作用 Multi-Level Optimal Transport 之类框架做跨运行的表征对齐,MoE 架构提出了独特挑战。
为自动化任务特化的比较,作者引入 PIEM(Permutation-Invariant Expert Matching)。每个 expert $n$ 由一个行为 profile 向量 $\mathbf{v}_n$ 刻画,表示它跨 $K$ 个预测任务分布的相对贡献。把这些向量归一化为有效概率分布后,用 Jensen-Shannon Divergence(JSD)量化功能差异。为对齐 baseline snapshot $A$ 与后续 snapshot $B$ 之间的 $N$ 个 experts,使用匈牙利算法求解 1-to-1 二分匹配问题,得到最小化总 JSD 的最优 permutation $\sigma^{*}$:
$$\sigma^{*} = \arg\min_{\sigma} \sum_{n=1}^{N} \text{JSD}\big(\mathbf{v}_{A,n} \,\|\, \mathbf{v}_{B,\sigma(n)}\big) \tag{8}$$
最终 PIEM 分数是这些最优匹配专家对上的平均相似度:
$$\text{PIEM}(A, B) = \frac{1}{N}\sum_{n=1}^{N}\left(1 - \sqrt{\text{JSD}\big(\mathbf{v}_{A,n} \,\|\, \mathbf{v}_{B,\sigma^{*}(n)}\big)}\right) \tag{9}$$
PIEM 的正确用法与作者的自我限定(这段很重要,作者反复强调):
- PIEM 是监控功能异构性的自动化诊断信号,而非模型性能的直接代理。
- 鉴于 MoE 架构高度非凸的优化 landscape,存在多个等价的局部最优。比较独立 retrain 时,模型可能收敛到不同的参数化与专家分配策略,同时取得可比的下游评估指标。因此,独立运行之间的低 PIEM 分数不必然意味着退化的模型;它只是量化了模型发现了不同的策略。
- 但在功能坍塌(functional collapse)的情况下——模型未能展现预期异构性、缺乏明确任务特化——PIEM 成功捕捉到这种功能分化的缺失,相对健康 baseline 呈现明显偏低的分数。
- 在持续 warm-start 训练流水线中,PIEM 提供了追踪专家利用随时间漂移的额外诊断价值。在时间滑动窗口上评估时,PIEM 量化专家特化如何适应渐进的数据漂移。在这个设定下,最优 permutation $\sigma$ 理论上被期望保持为恒等映射($\sigma(n) = n$)。显著偏离可以 flag 潜在有问题的内部模型行为,尽管把它们归因到模型问题很少见,实质性数据漂移仍是一个已知局限。
- PIEM 完全无标注(label-free)地运作在轻量行为 profile 向量上,给工程师在完整离线评估完成之前的早期定量信号。
实验设置
评估指标:DL-AUC
离线评估历史上依赖 ROC AUC 与 NDCG。但分布信息化评估与提供方公平性的重要性上升,推动了 Cross-AUC(xAUC)这类指标的采用。通过量化跨不同群组的 bipartite ranking 差异,xAUC 为在高度异构 feed 中显式评估跨类型排序正确性提供了关键基础。(论文中 "cross-segment" 与 "cross-type" 互换使用,segments 由 content type 定义。)
核心问题:在工业系统里,标准全局指标常常掩盖严重的结构性失败。例如,一个模型可能通过统一地 inflate 数据丰富的多数分段(web articles)的分数来 trivially 提升整体 AUC,同时把高质量内容(videos)埋掉。
理想上,这样的目标应该计算精确的 Group AUC(GAUC)以保证严格的个性化 per-user 排序,加上 traffic-weighted 的 xAUC 之和以保持跨类型 margins。然而精确 GAUC 跨海量 user-item 子群的计算对快迭代的工业流水线而言代价过高。因此作者采用了一个高度可扩展的生产近似:
$$\text{DL-AUC} = \lambda \cdot \text{Micro-AUC} + (1-\lambda) \cdot \text{Macro-xAUC} \tag{10}$$
其中 $\lambda$ 是控制「整体效用」与「生态健康」权衡的业务策略权重。令 $\mathcal{D}^{+}$ 与 $\mathcal{D}^{-}$ 表示评估数据中正/负互动的全局集合,$p_i, p_j$ 为 item $i, j$ 的预测概率,$\mathbb{I}(\cdot)$ 为指示函数。两个分量定义如下:
- Micro-AUC:反映在经验流量分布下的全局排序质量,衡量跨整个 feed 准确排序已互动 item 的能力:
$$\text{Micro-AUC} = \frac{1}{|\mathcal{D}^{+}||\mathcal{D}^{-}|}\sum_{i \in \mathcal{D}^{+}}\sum_{j \in \mathcal{D}^{-}} \mathbb{I}(p_i > p_j) \tag{11}$$
- Macro-xAUC:跨所有 segment pairs 的无加权(unweighted)平均 xAUC。作者特别评估所有关键内容类型的 pairs。令 $\mathcal{C}$ 为这些不同内容类型的集合。对任意两类 $A, B \in \mathcal{C}$($A \neq B$),$\text{xAUC}(A, B)$ 评估「来自 $A$ 的正样本排在来自 $B$ 的负样本之上」的概率:
$$\text{xAUC}(A, B) = \frac{1}{|\mathcal{D}_A^{+}||\mathcal{D}_B^{-}|}\sum_{i \in \mathcal{D}_A^{+}}\sum_{j \in \mathcal{D}_B^{-}} \mathbb{I}(p_i > p_j) \tag{12}$$
$$\text{Macro-xAUC} = \frac{1}{|\mathcal{C}|(|\mathcal{C}|-1)} \sum_{A, B \in \mathcal{C},\, A \neq B} \text{xAUC}(A, B) \tag{13}$$
为什么这个形式对自动化上线决策至关重要——论文用 web articles(Web)与 videos(Vid)作直观运行示例,说明 DL-AUC 如何正确处理三种常见工业情景:
- Dominant Score Inflation(主导类分数膨胀):如果一个模型人为 inflate 多数类型的分数以提升全局 AUC,无加权的 Macro-xAUC 会显著下降。因为 AUC 上界是 1.0,被 inflate 类型(Web⁺ vs. Vid⁻)的边际 cross-type 收益在数学上无法抵消被压制类型(Vid⁺ vs. Web⁻)的严重退化。DL-AUC 自动惩罚这种不对称,阻止损害生态健康的模型上线。
- Clean Global Improvement(干净的全局改进):如果模型改进了两种内容类型的底层表征,则 intra-type 排序与 cross-type margins 都上升,DL-AUC 显著上升,清晰量化真实的模型收益。
- Within-Type Gain(类内收益):如果某个内容类型的排序在内部改善但没有改变 cross-type margins,Macro-xAUC 保持稳定而 Micro-AUC 上升。DL-AUC 正确地把这奖励为一个安全的效用收益。
实现细节
- 稠密而非稀疏 MoE:作者采用 dense MMoE 而非 sparse MoE,以平衡模型性能与计算开销。
- 专家结构:每个 expert 是带 ReLU 激活的多层前馈网络(FFN)。
- 专家数量:最优专家数 $N = 4$,从 $\{2, 4, 8, 16\}$ 中选出;其他架构超参通过 grid search 确定,以在固定预算内最大化表征能力。
- fusion function 的实现:在初始生产部署中,门控网络内的 $\Phi(x,h)$ 被实现为直接拼接 $[x \,\|\, h]$。这个轻量设计缓解优化不稳定并支持稳定高效的收敛。作者明确表示正在积极探索更有表达力的门控机制,但这个低复杂度 baseline 的定位是优化「模型性能 vs. 训练稳定性」的 trade-off,且它有效驱动了论文报告的实质经验收益。
- 正交初始化:为鼓励多样的专家利用、缓解表征坍塌,对 expert networks 施加 orthogonal initialization。
- 训练数据与优化器:在 Discover 用户互动的海量专有数据集上训练,用 Adam 家族优化器端到端优化。训练语料跨越一个扩展的时间窗口,有效捕捉短期趋势与中长期 user-item 互动模式。此外,训练日志经过 positive upsampling 与 negative downsampling 以缓解固有的类不平衡。
- 超参公平性:为保证公平对比,所有优化超参默认继承预先建立的生产配置,且跨所有模型保持一致。这包括多任务损失平衡系数 $\alpha$ 以及 11 个任务权重 $w_t$ 的初值(它们在训练中通过梯度范数动态调整)。
- 策略参数:DL-AUC 计算中的 $\lambda = 0.8$,即赋予整体排序效用 4 倍于跨类型排序正确性的权重。这反映了「优先整体排序效用、把跨类型正确性作为安全底线」的运营策略;其他上下文可以不同地调 $\lambda$。
部署开销
相对 Shared MLP 生产 baseline,HA-MoE:
| 维度 | 变化 |
|---|---|
| 模型大小 | 增加 < 5% |
| 训练速度 | 在测量噪声内可比 |
| 端到端 serving latency | p50 与 p95 均增加 < 0.5% |
由于端到端延迟反映的是完整 serving 流水线,这些结果确认 HA-MoE 舒适地落在固定生产预算之内。
主要实验结果
离线评估
评估使用采样的 7 天 holdout 数据集,约 1000 万条打标样本。11 个不同预测任务的模型输出被归入两个宏类:pInterest(正向互动预测,如 clicks 与 likes)与 pDisinterest(负向互动预测,如 dismissals 与 blocks)。
Table 1: Offline performance comparison, measured by Aggregated DL-AUC.
| Model | pDisinterest | |
|---|---|---|
| Shared MLP | 0.679 | 0.939 |
| Standard MMoE | 0.686 | 0.934 |
| HA-MoE w/o HA-Gating | 0.689 | 0.949 |
| HA-MoE w/o HDLM | 0.690 | 0.945 |
| HA-MoE | 0.691 | 0.949 |
结果分析(why,不只是 what):
- Table 1 的结果凸显了 baseline 架构固有的一个基础性多任务优化冲突:Standard MMoE 相对 Shared MLP 改进了正向互动预测(0.679 → 0.686),但在负向预测上回退了(0.939 → 0.934)。这正是 seesaw 现象在数据上的直接体现——单纯引入任务专属门控并不能解决内容异构带来的负迁移。
- HA-MoE 有效打破了这个 trade-off:pInterest 0.691(相对 Shared MLP +1.2pt、相对 MMoE +0.5pt),同时 pDisinterest 达 0.949(相对 Shared MLP +1.0pt、相对 MMoE +1.5pt)。
- 消融分析:HA-Gating 与 HDLM 都对收益有贡献,完整模型在两个子类上都取得最佳聚合表现。通过经由两个组件显式注入异构上下文,所提架构在保住正向互动收益的同时逆转了负向预测的回退。
- 但需要客观指出:
HA-MoE w/o HA-Gating的 pDisinterest 已达 0.949,与完整模型持平;HA-MoE w/o HDLM的 pInterest 为 0.690,与完整模型 0.691 仅差 0.1pt。消融并没有干净地证明两个组件在每个宏类上都必要——更准确的读法是:HDLM(异构调制专家表征)是 pDisinterest 增益的主要来源,HA-Gating 对 pInterest 的边际贡献更明显。
跨类型 xAUC:验证 majority bias 被纠正
作者进一步检验了一个具体的历史难题:视频相对 web articles 被系统性地 under-rank。以 pDisinterest 为例,论文展示全局 AUC 如何掩盖严重的跨类型偏置——因为它被高流量的 intra-type 比较严重主导。
Table 2: Cross-type xAUC on pDisinterest tasks: Web Articles (Web) vs. Videos (Vid).
| Model | Web⁺ vs. Vid⁻ | Vid⁺ vs. Web⁻ | $\Delta$ Gap (↓) |
|---|---|---|---|
| Shared MLP | 0.971 | 0.830 | 0.141 |
| HA-MoE | 0.960 | 0.900 | 0.060 |
结果分析:
- 在 Shared MLP baseline 中,低质 web articles 频繁 outrank 高质视频,导致对立跨类型 pairs 之间高达 0.141 的显著 gap。
- HA-MoE 纠正了这一不平衡:把 Vid⁺ vs. Web⁻ 从 0.830 提升到 0.900,把 gap 收窄到 0.060(相对降低约 57%)。
- 值得注意的是 Web⁺ vs. Vid⁻ 从 0.971 略降到 0.960。这是一次有意的再平衡——牺牲约 1.1pt 的多数类优势,换取少数类 7.0pt 的改善。正是这种不对称的 trade-off 被 unweighted Macro-xAUC 设计所奖励(而会被 traffic-weighted 指标或全局 AUC 抹平)。
- 这确认 HA-MoE 防止坏的 web articles 不公平地压制好的视频,从而驱动了那些被标准全局 AUC 完全遗漏的聚合 DL-AUC 提升。
论文对此给出的定量洞察是:在专家与门控网络中同时显式建模异构性,提供了在多样内容类型之间解耦竞争排序模式所需的表征容量。
可解释性与系统可观测性
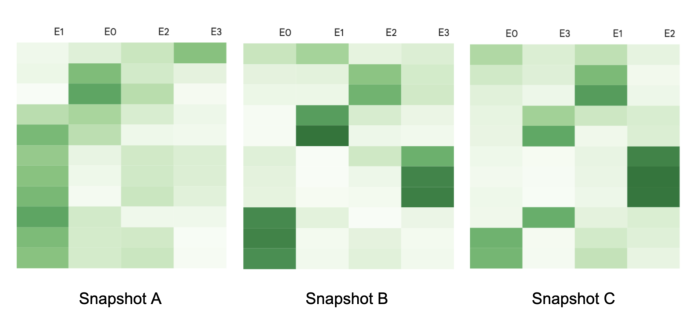
Figure 5 展示三个模型 snapshot(A、B、C)的任务级专家利用 profile,行表示预测任务、列表示 experts(E0–E3):
- 比较 snapshot B 与 C 时,两者都展现出明确的任务特化,产出高 PIEM(B, C) 分数。这表明稳定的结构性行为与特化专家角色的维持。
- 相反,snapshot A 与 B 的比较产出低 PIEM(A, B) 分数。检查 snapshot A 的 profile 揭示了预期功能异构性的明显缺失——网络未能发展出分化的专家角色。这种功能分化的缺失(任务保持大体统一、常常默认到单一主导 expert)阻碍了有效功能对与最优 permutation $\sigma^{*}$ 的对齐,从而降低了分数。
- 这个结构性观察与经验结果一致:snapshot A 那个初始的、未优化的配置,产出的离线评估指标确实低于 B 和 C。
论文的结论是:这个诊断指标提供了一个可解释的信号,帮助工程师识别专家特化中的意外漂移,并在需要时调查潜在不稳定。囊括 Activation Slicing 与 PIEM 两者,LENS 框架弥合了原始模型权重与系统可观测性之间的 gap,支撑一个高度可解释、运营透明的架构。
线上 A/B 测试
在满足离线评估准则、确立生产就绪性之后,HA-MoE 架构被部署到线上 A/B 测试以评估其真实影响。作者在 Discover 1% 的实时流量上进行了多次 7 天实验——该推荐平台全球服务数亿 DAU、数十亿 MAU。这些测试把所提架构与现有生产 baseline(一个基于共享 MLP 的多任务预测模型)对比,所有实验都在标准生产护栏下被监控。
Table 3: Online A/B test results, reported as lift over production ± 95% CI half-width.
| Feed Activity Metrics | Lift (± CI) |
|---|---|
| DAU | +0.22% ± 0.11% |
| Viewed Impressions | +0.48% ± 0.34% |
| Feed Exploration Metrics | Lift (± CI) |
|---|---|
| Scroll Depth | +0.34% ± 0.25% |
| Diverse Feed Rate | +0.36% ± 0.03% |
| Diverse Engagement Rate | +0.54% ± 0.07% |
生产影响分析:
- 线上结果显示 feed activity 指标的 lifts 与离线 DL-AUC 提升紧密对齐。通过对不同内容类型的正负用户互动都做出更准确的预测,模型驱动了更高的用户参与——反映在 DAU 与 Viewed Impressions 的正向 lift 上。
- 这些改进在多次 live 实验中保持一致,且在其他核心运营指标上未观测到回退。
- 超越基础参与度,作者在 feed exploration 指标上观测到显著收益:Scroll Depth、Diverse Feed Rate、Diverse Engagement Rate。这些指标共同表明用户在 feed 中导航更深、被服务了更多样的内容集合、并与更广泛种类的内容互动。
- 此外,作者观测到某些历史上 under-ranked 流量的压制被有效缓解——这正是 Table 2 的跨类型 xAUC 改善在线上的对应体现。
- 这些收益验证了「改进的异构排序转化为内容发现与整体生态健康的实质收益」,确认了该方法在工业级异构排序上的实践价值,支撑它从实验原型演进为生产就绪架构。
需要客观指出:DAU 的 +0.22% ± 0.11% 与 Scroll Depth 的 +0.34% ± 0.25% 置信区间相对增益偏宽,尤其 Scroll Depth 接近不显著;置信区间最紧的是 Diverse Feed Rate(±0.03%)与 Diverse Engagement Rate(±0.07%),这两个「多样性」指标恰恰也是本文方法最直接针对的目标,因此可信度最高。
核心贡献总结
- 问题层面的清晰刻画:把「开放网络异构 feed 的统一排序」拆解为 Data Heterogeneity + Interaction Heterogeneity 两个维度,并对应到三个可操作的失败模式(分布不匹配、seesaw、minority-type collapse)。
- HA-MoE:在固定运营预算(模型体积 < +5%、latency < +0.5%、训练速度噪声内)下,把显式异构信号 $h$ 同时注入门控输入(HA-Gating)与专家输出的仿射调制(HDLM),用「更好地利用已有信号」替代「扩参」。
- LENS:Activation Slicing(按 content type 行归一化的 content-by-expert 门控激活矩阵)+ PIEM(JSD + 匈牙利算法的置换不变专家匹配),构成一个 label-free、可在完整离线评估前给出早期信号的可观测性框架,专门用于检测功能坍塌而非充当性能代理。
- DL-AUC:$\lambda \cdot$ Micro-AUC $+ (1-\lambda) \cdot$ Macro-xAUC 的可扩展近似,替代计算上不可行的精确 GAUC + traffic-weighted xAUC;关键设计是 Macro-xAUC 不做流量加权,使得「膨胀多数类分数」这一作弊路径在数学上无法通过(AUC 上界 1.0 使边际收益无法抵消少数类的严重退化),从而可直接充当自动化上线闸门。
- 完整的端到端工业闭环:模型设计 → 异构感知评估 → 部署护栏 → 1% 流量 A/B,且开销数据齐备。
与已归档相关工作的对比
MESH MESH: Scaling Up Retrieval with Heterogeneous Content Unification(Pinterest, 2026-07-14)
关系:独立并发(本文未引用 MESH,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文指向完全同一个 root cause——工业统一模型中,共享的全局优化目标会让主导(高频/多数)内容的统计特性淹没稀疏(少数/新鲜)内容的学习信号。本文称之为 "majority bias / minority-type collapse",MESH 称之为 "The Scaling Bias of Heterogeneity",并把它形式化为梯度范数不等式 $\mathbb{E}_{\mathcal{X}_{\text{fresh}}}[\|\nabla \mathcal{L}\|] \ll \mathbb{E}_{\mathcal{X}_{\text{evergreen}}}[\|\nabla \mathcal{L}\|]$。两者都明确拒绝「靠 late-stage 启发式 / 维护一堆 domain 专属模型」这条工业惯用捷径,主张在单一统一骨干内部用结构性归纳偏置解决。
- 相近的技术骨架:两者的方法流程图可以抽象重合为「把异构信号按语义分组隔离 → 分组内独立富化表征 → 用一个由上下文生成的门控在融合阶段调制」。MESH 把特征空间划成 user/item/context 三个域子塔($K=3$),本文把共享表征分解为 $N=4$ 个 experts;MESH 用 context 超级 token 生成 $\mathbf{g} = \sigma(\text{MLP}_{\text{gate}}(T_c))$ 去调制干净的语义核 $\mathbf{X}_{ui}$(RGBC),本文用异构信号 $h$ 生成 $\gamma_n(h), \beta_n(h)$ 去调制专家输出 $E_n(x)$(HDLM)——两者都是「用一个专门承载异构/上下文的旁路信号,对主语义通路做逐元素门控/仿射调制」,甚至连「让旁路吸收环境方差、让主通路专注内容效用」的叙事都一致。
- 本文的差异与推进:(1)异构性的定义维度不同:MESH 的异构是内容层级(evergreen / fresh / tail,即流行度与新鲜度),本文的异构是内容形态(web article / video / UGC / AI card),后者带来的是特征密度与元数据结构的结构性差异,因此本文可以拿到一个显式的、可枚举的 $h$(
content_type+ followed-creator + shoppable + AI-enhanced 等元数据),而 MESH 的层级是隐式的统计属性、无法直接编码成条件向量。(2)隔离强度不同:MESH 是硬结构隔离(独立子塔、独立参数、组内 LayerNorm 阻断方差污染),本文是软条件化(experts 全共享、只靠 $h$ 条件化 gate 与仿射系数)——本文因此模型体积只涨 < 5%,而 MESH 需要付出多塔参数并靠 TorchScript 算子间并行才把延迟压回来。(3)阶段不同:MESH 在检索(双塔),本文在多任务精排(11 个头),因此本文必须额外处理 seesaw(pointwise BCE + RankNet pairwise 组合目标、梯度范数动态调任务权重),MESH 无此负担。(4)本文多出评估与可观测性两层:MESH 用分段指标 + scaling 指数说明公平性改善,本文则把它固化为一个可自动化决策的单标量 DL-AUC 与一个 label-free 的 PIEM 诊断,这是本文更强的工程闭环。 - 可比的方法 / 实验差异:两者的实验都完全落在专有工业数据上、都不可复现,但验证少数类改善的方式互补:MESH 报告新鲜物品的 power-law scaling 指数提升 14×、fresh-item repins +5.5%、serving throughput 2.87×;本文报告 Vid⁺ vs. Web⁻ 的 xAUC 0.830 → 0.900、跨类型 gap 0.141 → 0.060,以及 Diverse Feed Rate +0.36% / Diverse Engagement Rate +0.54%。MESH 证明的是「扩容时少数类也能等比受益」(容量维度),本文证明的是「固定容量下少数类不再被压制」(分配维度)——恰好是同一 root cause 的两个正交切面。
TMallGS TMallGS: Scaling Unified Feature and Sequence Modeling for Generative E-commerce Search(Alibaba Tmall, 2026-07-15)
关系:独立并发(本文未引用 TMallGS,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两者都在攻击统一(unified / all-in-one)工业排序骨干里的「异构性鸿沟」——把差异极大的输入模态强行压进单一共享表征/单一注意力空间,会触发梯度冲突并让某一类信号被系统性稀释。TMallGS 明确把 "The Heterogeneity Gap" 列为三大缺陷之首,并诊断其后果是 gradient conflicts;本文把同一现象命名为负迁移与 minority-type collapse。两者也都拒绝「为每种 domain/格式各养一个模型」的碎片化方案,坚持单模型统一 serving。
- 相近的技术骨架:两者的解法骨架高度重合于「为异构信号提供域专属参数化 + 在最终融合阶段用 FiLM 式仿射调制恢复/注入被稀释的信号」,而且两者都显式追溯到同一篇 FiLM 工作:
- 本文 HDLM:$\tilde{E}_n(x,h) = \gamma_n(h) \odot E_n(x) + \beta_n(h)$,其中 $\gamma_n, \beta_n$ 由异构信号 $h$ 线性生成,逐 expert 各一套 $W_{\gamma,n}, W_{\beta,n}$;
-
TMallGS Decoupled FiLM Late Fusion:$\mathbf{v}_{final} = (1 + \boldsymbol{\gamma}_c) \odot \mathbf{u}_c + \boldsymbol{\beta}_c$,其中 $\boldsymbol{\gamma}_c, \boldsymbol{\beta}_c$ 由综合候选特征 $\mathbf{e}_c^{all}$(含 heavy cross 特征)经 MLP 生成。 两者还都强调必须放在最后一层(late-stage / late fusion):本文的理由是保留表征表达力并维持训练速度与稳定性,TMallGS 的理由是深层 self-attention 是低通滤波器、必须在其后才能恢复高频硬信号。此外,TMallGS 的 Per-Field 异构 QKV 投影(每个域独立 $W_Q, W_K, W_V$ 以允许各自的语义旋转、缓解梯度冲突)与本文的逐 expert 独立调制矩阵在动机上同源:都是给异构模态各自的参数自由度,而不是强行共享。
-
本文的差异与推进:(1)条件变量的语义不同,这是最本质的分歧:TMallGS 的 FiLM 条件是信号强度维度的(用显式交叉特征去锐化被平滑掉的高频匹配分),目的是恢复保真度;本文的 FiLM 条件是结构上下文维度的(用
content_type等元数据去切换预测语义),目的是触发专家特化。因此本文的 $h$ 是可枚举的结构性元数据,而 TMallGS 的条件是连续的统计特征。(2)任务结构不同:本文是 11 任务多任务排序,必须正面处理任务间 seesaw,故有 $\mathcal{L} = \alpha\mathcal{L}_p + (1-\alpha)\mathcal{L}_r$ 与梯度范数动态调 $w_t$;TMallGS 是单任务 CTR,其复杂度花在 Error-Aware Progressive Training 的逐层难样本挖掘与 Context-Aware Bias Net 的偏置正交解耦上。(3)骨干范式不同:TMallGS 是重算力 Transformer(追 MFU 与 scaling law,序列化 tokenization),本文是刻意保守的 dense MMoE(明确选 dense 而非 sparse、$N$ 仅为 4、$\Phi$ 仅为拼接),因为 Discover 的约束是「训练速度与延迟不许动」而非「把算力吃满」。(4)本文额外贡献了评估与可观测性层(DL-AUC / LENS / PIEM),TMallGS 无对应物;反过来 TMallGS 的正交偏置解耦(加性 logit 在 pairwise loss 中自然抵消)是本文缺失的一块——本文的 pairwise loss 只做了 logit margin 缩放与有效 pair 数归一化,没有处理 position/page bias。 - 可比的方法 / 实验差异:两者都以工业 A/B 为最终证据但量级差异显著:TMallGS 报告 +1.52% GMV、+1.34% CTR 类电商指标,且同时在 Criteo/Avazu 等公开数据集上报告结果;本文完全没有公开数据集实验(作者论证公开集缺乏内容异构性),线上收益是生态型指标(DAU +0.22%、Diverse Engagement Rate +0.54%)。这一差异本身反映了两个场景的价值函数不同:电商搜索有直接可归因的 GMV,而 Discover 这类开放 feed 只能用多样性与探索深度作为生态健康代理——这也正是本文必须自己发明 DL-AUC 作为离线闸门的原因。
讨论与局限性
值得借鉴的设计
- 「异构信号该注入哪里」是本文最可迁移的工程结论:不是加宽模型、不是增加 expert 数量($N$ 只有 4),而是把同一个 $h$ 同时接到门控输入与专家输出的仿射系数上。前者决定「哪些 expert 被这个内容类型调用」,后者决定「被调用的 expert 如何为这个内容类型重校准输出」——两个注入点的分工非常清晰,且都是 $O(d_h)$ 级的极低成本。
- DL-AUC 的「不加权」是深思熟虑的机制设计而非疏忽:Macro-xAUC 刻意不做流量加权,使得「膨胀多数类分数」这条作弊路径在数学上走不通(AUC 上界 1.0 → 边际收益无法抵消少数类的严重退化)。把「指标本身抗 gaming」作为自动化上线闸门的前提条件,这个思路比具体公式更有价值。
- PIEM 的定位极其克制,值得学习:作者反复声明它不是性能代理,只用来检测功能坍塌这一种失败模式,并且明确了「warm-start 连续训练下 $\sigma^{*}$ 应为恒等映射」这个可检验的期望。这种「一个诊断信号只负责一种失败模式、并写清它不能做什么」的表述,比宣称一个万能健康分要可靠得多。
- 可直接抄的工程细节:pairwise pair 只在同 session co-impressed 内构造、logit margin 缩放、按 batch 有效 pair 数动态归一化、expert 的正交初始化、positive upsampling + negative downsampling、任务权重靠梯度范数动态调整、$\Phi$ 先用最简拼接以换取收敛稳定性。
局限与争议
- 完全不可复现:全部实验在内部专有数据上,无任何公开数据集结果。作者的辩护(公开集缺乏内容异构性)是成立的,但代价是外部无法验证任何数字。
- 匿名化过重,削弱了案例研究的信息量:11 个任务只以 pInterest / pDisinterest 两个宏类聚合报告,具体任务是什么、每个任务的单独指标全部未披露;LENS 分析里的 Task A/B/C/D 也是匿名的(只描述为 heart button / survey / click-into-detail / expand-text)。更关键的是,"Aggregated DL-AUC" 的聚合方式从未定义——是宏类内任务的简单平均还是加权?这直接影响 Table 1 的可解读性。
- 消融不够干净:
w/o HA-Gating的 pDisinterest(0.949)与完整模型完全持平,w/o HDLM的 pInterest(0.690)与完整模型仅差 0.1pt。严格说,Table 1 只能支持「两个组件各主导一个宏类的增益」,不能支持「两者都必要」。而且绝对增益幅度很小(相对 MMoE 的 pInterest 仅 +0.5pt)。 - 架构新意中等:HA-Gating 本质是把 domain/context 信号拼进 gate 输入,与 PEPNet / STAR / M³oE 的条件参数化同源;HDLM 就是 FiLM 用在 expert 输出上。论文自己在 Related Work 里诚实地列出了这些前置工作。真正的增量在于在严格生产约束下的注入位置选择 + 配套的评估与可观测性,而非新机制。
- 容量与表达力受限,作者自己承认:$N = 4$(从 $\{2,4,8,16\}$ 中选出 4,说明更多 expert 在固定预算下反而无益或超预算),$\Phi$ 只是拼接。作者明确表示正在探索更有表达力的门控与可扩展 sparse routing——即当前版本是保守的第一版落地。
- DL-AUC 的策略参数缺原理支撑:$\lambda = 0.8$ 是运营选择而非推导结果。且 unweighted Macro-xAUC 的副作用是极小流量的 content type 与主流类型拥有同等话语权,对噪声敏感;论文未讨论 segment 划分粒度与最小流量阈值。
- PIEM 缺可操作阈值:什么算「显著偏离」、告警线怎么定,全无量化标准,实践中仍需人工判断。作者也明确承认无法区分数据漂移与模型问题是已知局限。
- 在线实验统计功效偏弱:仅 1% 流量。DAU +0.22% ± 0.11%、Viewed Impressions +0.48% ± 0.34%、Scroll Depth +0.34% ± 0.25%,其中 Scroll Depth 已接近不显著。可信度最高的是两个多样性指标(CI 分别 ±0.03% / ±0.07%)。
- 一个值得注意的元信息:Acknowledgments 中作者声明使用 Google Gemini 3 精炼手稿文本,所有 AI 辅助修订经人工审阅并由作者承担全责。这是工业论文中逐渐常见的披露实践。
工业落地价值
本文的落地属性极强,且开销数据披露得比绝大多数工业论文完整:模型体积 < +5%、p50/p95 延迟 < +0.5%、训练速度在噪声内,配合「dense 而非 sparse MoE」「$\Phi$ 用最简拼接」「只在最后一层做调制」这三个明确以稳定性/速度为优先的取舍,构成了一份「在不许动延迟预算的成熟生产系统里,如何以最小侵入换取异构感知能力」的完整配方。
更具迁移价值的是评估与护栏这一层:把「异构公平性」从一个定性诉求压缩成单标量 DL-AUC,使其可以直接作为自动化发布决策信号(automated decision signal / deployment guardrail),并用 label-free 的 PIEM 在完整离线评估之前给出早期结构性告警。对任何维护多内容类型统一排序模型的团队,这套「抗 gaming 的离线闸门 + 功能坍塌探测器」比 HA-MoE 的具体架构更值得优先照搬。