PTDG:用实例级低秩任务依赖图对抗多任务转化漏斗里的「信号侵蚀」¶
Huawei Technologies Co., Ltd.(Fuyuan Liu、Tiandeng Wu 共同一作,Tiandeng Wu 通讯;另有 Yaqun Fang、Wei Zhou、Zehao Zhou、Wenping Chen、Qishun Mei、Jiaxin Zhou、Heng Chang、Yi Cao、Jiandong Ding,分布在上海/东莞/南京/北京),CIKM '26 短文(5 页),2026-09-04 挂 arXiv(2609.04862v1,cs.IR),DOI 10.1145/3799682.3839876。
核心主张:MMoE/PLE/AITM 这类多任务架构对整条转化漏斗施加全局统一的依赖强度,而依赖强度其实随 item 属性剧烈变化(重度游戏走 $Click\to Download\to Pay$ 的强因果链,轻量工具类则常常跳过中间步直接 $Click\to Pay$)。沿固定链做逐级消息传递会造成累积信号衰减(signal erosion),深层稀疏转化目标因此学不好。PTDG 把任务依赖当成可学的动态拓扑:用低秩分解为每个 item 生成任务-任务邻接矩阵、用用户/场景特征做个性化调制、用硬因果掩码剪掉逆因果边、再跑一层 GCN 做消息传递建立「自适应捷径」;另加 APM(Adaptive Progressive Masking)按任务标签密度渐进解耦共享参数以缓解梯度冲突。工业数据集平均 AUC 0.8878、KuaiRand1K 0.9081 均为表中最优;在某日活超 1 亿的主流应用分发平台做两周 10%/10% 分桶 A/B,CVR +1.2%、eCPM +1.9%,端到端延迟只增 8 ms。
一、研究动机与背景¶
现代工业推荐的优化目标已从单一交互指标转向整体 eCPM(effective Cost Per Mille),这要求同时预测从浅层交互(Click)到深层转化(Payment)的多种异质用户行为。MTL 通过跨任务共享知识提升效果并降低算力成本,MMoE、AITM 是表征学习的标准做法,但它们依赖一个刚性的归纳偏置:假设转化漏斗内部的依赖强度对全部流量都一样。
论文指出这个假设忽略了工业应用之间固有的结构异质性——物理因果次序(点击必先于付费)是必要的,但节点之间的相关强度差异巨大:
- 重度游戏遵循强因果路径 $Click \to Download \to Pay$;
- 轻量工具类应用依赖弱,用户常跳过中间步骤,实际是 $Click \to Pay$。
把单一拓扑强加到如此发散的实例上会限制模型表达力。PMTRec 一类工作虽然试图个性化优化权重,但没有处理任务节点之间的显式结构变化。更进一步,沿固定链的层级消息传递会在深依赖路径上造成累积信号衰减,显著劣化稀疏下游任务。
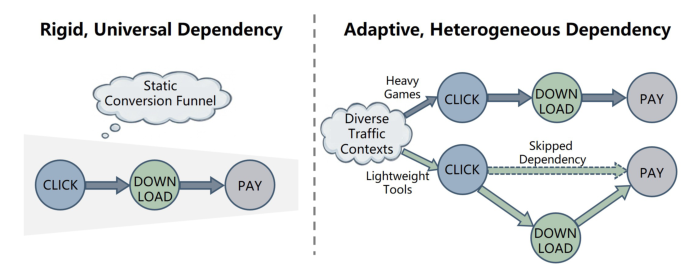
三条贡献:
- Dynamic Topology Learning:低秩图生成机制自适应构造实例特定的依赖强度,在因果约束内建模异质相关性;
- Controllable Propagation:带硬因果掩码的 GCN 消息传递,按相关性建立自适应捷径以缓解信号侵蚀;
- Adaptive Optimization:APM 不做数值层面的梯度手术,而是按标签密度解耦参数,从结构上化解梯度冲突并降低计算复杂度。
相关工作被归为两类。其一是缓解负迁移:MMoE、PLE、AITM 用门控网络解耦共享与专属表征;PaDiRec 用扩散过程的 adapter 按动态任务偏好权重生成模型参数;GradNorm、PMTRec、MoCoGrad 分别用重加权与动量校准处理梯度冲突——但这些方法都在优化数值 loss 地形,把任务当并行目标或使用全局共享的依赖模式。其二是建模任务依赖:ESMM、ESCM² 用全空间建模处理样本选择偏置;AITM 沿固定转化链引入信息迁移模块;HTLNet 研究层级级联路径但强制固定的层级分配;CSRL 试图学习因果结构但迭代搜索代价高达 $O(T^2)$ 以上,无法满足工业延迟约束;MIT 探索跨任务相关但依赖全局共享的任务关系。PTDG 的定位是:用高效 GCN 学实例特定的低秩依赖图,在结构灵活性与工业延迟约束之间取平衡。
二、核心方法:PTDG¶
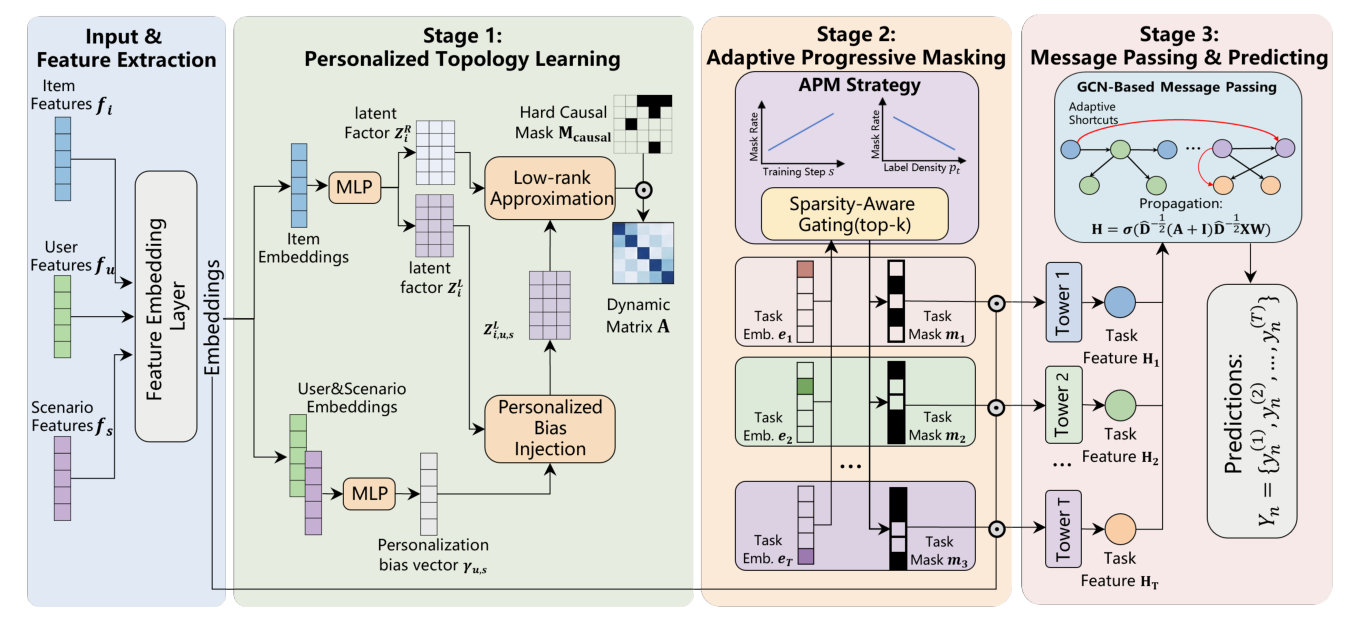
架构分三个组件:(1) Personalized Topology Learning,用低秩分解构造任务-任务依赖图;(2) Adaptive Progressive Masking (APM),结构化解耦参数共享以缓解梯度冲突;(3) Causally Optimized Message Passing,在硬因果掩码后的依赖图上跑 GCN 并带捷径连接,防止语义回流(如 $Pay \to Click$)与信号侵蚀。
2.1 问题形式化¶
把多目标转化预估形式化为监督学习。训练集 $\mathcal{D}=\{(d_1,Y_1),\dots,(d_N,Y_N)\}$,每个样本 $d_n$ 是三元组 $(f_i, f_u, f_s)$,分别为 item、user、scenario 特征。目标是学映射 $\Phi:\mathcal{X}\to\mathcal{Y}$,估计 $T$ 个转化目标的概率 $Y_n=\{y^{(1)}_n,y^{(2)}_n,\dots,y^{(T)}_n\}$。
2.2 个性化任务依赖图¶
Item-Specific Dependency Graph. 为防止在噪声密集的工业交互上过拟合并降低参数复杂度,采用低秩近似。item 特定的邻接矩阵定义为
$$\mathbf{A}_{item} = \mathbf{Z}^{L}_{i}\,(\mathbf{Z}^{R}_{i})^{\top} \tag{1}$$
其中 $\mathbf{Z}^{L}_i,\mathbf{Z}^{R}_i \in \mathbb{R}^{T\times q}$($q<\tfrac{T}{2}$)是从第 $i$ 个 item 的 embedding 派生的隐因子,由两个骨干模型(如 DeepFM 或 MLP)抽取。
Personalized Bias Injection. 为捕捉上下文特定的依赖,用 MLP 从用户 $u$ 与场景 $s$ 的特征生成个性化偏置向量 $\gamma_{u,s}\in\mathbb{R}^q$,再广播到全部 $T$ 个任务上调制 item 特定隐因子:
$$\mathbf{A}_{dyn} = \mathbf{Z}^{L}_{i,u,s}(\mathbf{Z}^{R}_{i})^{\top},\qquad \mathbf{Z}^{L}_{i,u,s} = \mathbf{Z}^{L}_{i}\odot(\mathbf{1}_{T}\otimes\gamma^{\top}_{u,s}) \tag{2}$$
$\mathbf{A}_{dyn}$ 即个性化动态依赖矩阵,$\mathbf{1}_T$ 是全一列向量,$\otimes$ 是外积。论文称这是「捕捉实例级多样性同时缓解过拟合的轻量方式」。
注意这个式子的实际表达力:$\mathbf{1}_T\otimes\gamma^{\top}_{u,s}$ 是把同一个 $q$ 维向量复制 $T$ 行,因此 $\mathbf{A}_{dyn}=\mathbf{Z}^{L}_{i}\,\mathrm{diag}(\gamma_{u,s})\,(\mathbf{Z}^{R}_{i})^{\top}$——个性化只是对 $q$ 个隐因子做对角缩放。论文取 $q=2$,也就是说「个性化」在整张 $T\times T$ 依赖图上只有 2 个自由度,无法改变任务对之间的相对模式,只能整体拉伸两个秩-1 分量的权重。
Causal Pruning & Message Passing. 施加硬因果掩码 $\mathbf{M}_{causal}$ 强制行为次序约束、避免语义回流,随后在原始任务特征矩阵 $\mathbf{X}$ 上做 GCN 传播:
$$\mathbf{A} = \mathbf{A}_{dyn}\odot\mathbf{M}_{causal} \tag{3}$$
$$\mathbf{H} = \sigma\!\left(\hat{\mathbf{D}}^{-\frac{1}{2}}(\mathbf{A}+\mathbf{I})\hat{\mathbf{D}}^{-\frac{1}{2}}\mathbf{X}\mathbf{W}\right) \tag{4}$$
$\mathbf{H}$ 是抽取出的任务节点特征矩阵,$\mathbf{I}\in\mathbb{R}^{T\times T}$ 为单位阵,$\hat{\mathbf{D}}$ 是 $(\mathbf{A}+\mathbf{I})$ 的度矩阵,$\mathbf{W}$ 可学。论文的关键论述是:与静态序列链不同,个性化依赖图会在没有因果关系的任务之间建立自适应捷径,从而避免固定层级里冗余中间步骤带来的信号侵蚀。
最终用任务节点特征预测目标 $t$ 的转化概率:
$$\hat{y}_t = \mathrm{Sigmoid}\big(\mathrm{MLP}(h_t)\big) \tag{5}$$
$h_t$ 是 $\mathbf{H}$ 中任务 $t$ 对应节点的特征。
2.3 优化目标¶
总目标是各任务 BCE 的加权和:
$$\mathcal{L}=\sum_{t=1}^{T}\beta_{t,s}\cdot\mathcal{L}_{t,s},\qquad \mathcal{L}_{t,s}=\mathrm{BCE}(y_t,\hat{y}_{t,s}) \tag{6}$$
$$\hat{\mathcal{L}}_{t,s}=\alpha\mathcal{L}_{t,s}+(1-\alpha)\hat{\mathcal{L}}_{t,s-1},\qquad \beta_{t,s}=\frac{1}{\hat{\mathcal{L}}_{t,s}} \tag{7}$$
$\beta_{t,s}$ 是任务 $t$ 在训练步 $s$ 的权重:把每个任务 loss 除以它自己的指数滑动平均(EMA),使所有任务 loss 落到统一尺度上以稳定训练。这是 GradNorm 式 loss 尺度平衡的一个极简变体。
2.4 APM:自适应渐进掩码¶
多任务之间的信息传递可能加剧多任务模型固有的梯度冲突。APM 是一个结构性掩码策略:为每个任务学一个掩码 $\mathbf{m}_t$ 来选择共享参数,掩码由为每个任务新增的任务 embedding $e_t$ 算出。
Sparsity-Aware Mask. 二值掩码只保留一个可学门控的 top-$k_t$ 元素:
$$m^{(j)}_{t}=\mathbb{I}\!\left(\mathrm{rank}(w^{(j)}_{t})\le k_t\right),\qquad \mathbf{w}_t=\mathrm{Gate}_t(\mathbf{e}_t) \tag{8}$$
掩码通过 Hadamard 积作用到任务间共享的参数上,得到任务 $t$ 可见的参数子集。
Adaptive Progressive Masking. 参数掩码率 $r^{(t)}_{target}$ 由任务 $t$ 的正样本率 $p_t$ 决定,以平衡易(稠密)任务与难(稀疏)任务:
$$r^{(t)}_{target}=r_{min}+(r_{max}-r_{min})\cdot\left(1-\frac{p_t-p_{min}}{p_{max}-p_{min}}\right) \tag{9}$$
$p_{min}/p_{max}$ 是最小/最大标签正样本率,$r_{max}/r_{min}$ 为超参。再加线性 warm-up,按训练步 $s$ 与共享参数量 $d$ 逐渐提高学习难度:
$$k_{t,s}=d-d\cdot\min\!\left(r^{(t)}_{target},\ \frac{s}{S_{warm}}\cdot r^{(t)}_{target}\right) \tag{10}$$
即训练初期 $k_{t,s}\approx d$(几乎不掩码,所有共享参数可见),随训练推进逐步收缩到 $d\,(1-r^{(t)}_{target})$。正样本率越低的任务掩码率越高,也就是稀疏任务被分到更少但更专属的共享参数,稠密任务保留更多共享通路。
2.5 复杂度分析¶
PTDG 用低秩分解($O(T\times q)$)作为结构正则,而非直接学完整邻接矩阵,避免在稀疏工业数据上拟合伪相关。低秩形式让邻接计算与 GCN 消息传递都对 $T$ 保持线性。生产环境中 PTDG 相对 MMoE 基线只增加 8 ms 端到端延迟,在 serving SLA 之内。与 PCGrad 这类需要 $O(T^2)$ 投影的梯度去冲突方法不同,APM 训练开销可忽略、且因为掩码在训练后固定而没有推理开销。
三、实验设置¶
数据集。 两个:
| Dataset | Samples | Tasks | Positive Ratio (range) |
|---|---|---|---|
| KuaiRand1K | 8.4M | 6 | 0.02% ~ 37.9% |
| Industrial | 13.2M | 7 | (Confidential) |
KuaiRand1K 的 6 个任务为 Click / Like / Follow / Comment / Forward / Hate;工业数据集 7 个任务全部匿名为 Task 1–7(正样本率保密),正文只透露 Task 4 是 click、Task 3 与 Task 6 是稀疏深转化任务。
Baselines. (1) MMoE:广泛采用的 multi-gate MoE;(2) PLE:工业界参数共享标准;(3) STEM:先进的 embedding 优化型 MTL 框架;(4) MoCoGrad:用动量校准处理梯度冲突;(5) PMTRec:用梯度重加权的个性化多任务方法;(6) MIT:近期专注跨任务异质相关建模的多塔信息迁移框架。
实现细节。 Adam,学习率 1e-3,dropout 0.1,batch size 2048;每个设置用 20 个不同随机种子重复 20 次;item 隐因子秩 $q=2$;EMA 的 $\alpha=0.1$;APM 的 $r_{max}=0.7$、$r_{min}=0.2$;warm-up 过程「$p_{min}=500$、$p_{max}=2000$」;所有 baseline 参数与原论文保持一致;全部实验在单张 NVIDIA Tesla V100 上完成。
这里有一处明显的记号错误:Eq. 9 中 $p_{min}/p_{max}$ 被定义为标签正样本率(取值在 $[0,1]$),而 §4.1 给出的却是 500 / 2000——显然是 warm-up 步数 $S_{warm}$ 相关的量而非正样本率。论文没有给出真正的 $S_{warm}$ 取值。
四、主要实验结果¶
| Dataset | Task | MMoE | PLE | STEM | MoCoGrad | PMTRec | MIT | PTDG |
|---|---|---|---|---|---|---|---|---|
| KuaiRand1K | Click | 0.8706 | 0.8637 | 0.8732 | 0.8743 | 0.8772 | 0.8766 | 0.8801 |
| Like | 0.8879 | 0.8903 | 0.8998 | 0.9009 | 0.9017 | 0.9028 | 0.9085 | |
| Follow | 0.9033 | 0.9024 | 0.9073 | 0.9130 | 0.9124 | 0.9129 | 0.9193 | |
| Comment | 0.9051 | 0.8986 | 0.9081 | 0.9072 | 0.9085 | 0.9101 | 0.9172 | |
| Forward | 0.8984 | 0.8933 | 0.9028 | 0.9011 | 0.9042 | 0.9038 | 0.9097 | |
| Hate | 0.9041 | 0.8960 | 0.9055 | 0.9066 | 0.9072 | 0.9085 | 0.9139 | |
| Avg. | 0.8949 | 0.8907 | 0.8995 | 0.9005 | 0.9019 | 0.9025 | 0.9081 | |
| Industrial | Task 1 | 0.8410 | 0.8424 | 0.8494 | 0.8501 | 0.8481 | 0.8471 | 0.8527 |
| Task 2 | 0.8395 | 0.8433 | 0.8457 | 0.8462 | 0.8500 | 0.8468 | 0.8511 | |
| Task 3 | 0.8601 | 0.8379 | 0.8482 | 0.8550 | 0.8745 | 0.8541 | 0.8872 | |
| Task 4 | 0.9417 | 0.9471 | 0.9457 | 0.9468 | 0.9462 | 0.9452 | 0.9464 | |
| Task 5 | 0.8699 | 0.8678 | 0.8613 | 0.8630 | 0.8729 | 0.8732 | 0.8751 | |
| Task 6 | 0.8837 | 0.8796 | 0.8557 | 0.8610 | 0.8843 | 0.8899 | 0.8993 | |
| Task 7 | 0.8912 | 0.8974 | 0.8915 | 0.8952 | 0.8967 | 0.8979 | 0.9028 | |
| Avg | 0.8753 | 0.8736 | 0.8710 | 0.8739 | 0.8818 | 0.8791 | 0.8878 |
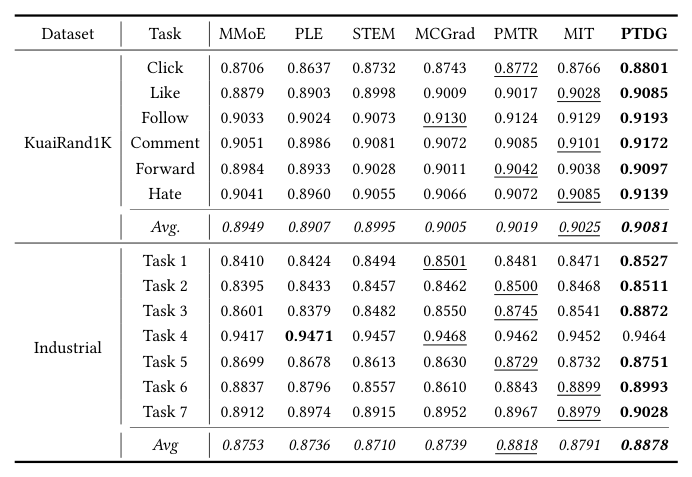
论文自述的结论。 PTDG 在两个数据集上都取得最高平均 AUC。在关键深转化任务 Task 6 上超过 MIT 1.05%(0.8899→0.8993)——因为不像 MIT 的刚性全局相关,PTDG 按实例自适应任务关系、让 GCN 消息传递在更深任务上保住信号强度;平均超过 MoCoGrad 1.59%(工业集 0.8739→0.8878),因为 APM 在参数层面直接解决梯度冲突,而非 MoCoGrad 的事后动量调优。在深层稀疏目标上,工业 Task 3 相对 PMTRec +1.45%(0.8745→0.8872),KuaiRand1K 的 follow 相对线上基线 MMoE +1.77%(0.9033→0.9193);而在稠密浅层任务(Task 4,click)上只是「comparable but not significantly better」,论文解释这是预期之中,因为信号侵蚀主要影响稀疏深漏斗目标。
独立复核:论文所有百分比都是相对提升,且数值自洽。 我按表格重算了两个数据集的 Avg 行(PTDG 工业 6.2146/7=0.88780、PMTRec 6.1727/7=0.881814,KuaiRand PTDG 5.4487/6=0.908117 等),与表中数值逐项吻合,说明 PDF 抽取无误。论文所有 "+X%" 均为相对提升(如 Task 6 vs MIT:0.0094/0.8899=1.056%),换算无误。
但这张表读出来的三件事,论文没有说:
- PTDG 相对最强已发表基线的真实优势只有 +0.68%(相对)/ +0.0060(绝对)。 工业集上最强基线是 PMTRec 0.8818,PTDG 0.8878。论文正文反复引用的 1.05% / 1.45% / 1.59% / 1.77% 都是挑选特定任务 × 特定较弱基线得到的:1.59% 是对 MoCoGrad(工业集第 4 名),1.77% 是对 MMoE(2018 年架构、也是它自己的线上基线)。在 KuaiRand1K 上相对最强基线 MIT 的优势更小,只有 +0.62%。
- 增益高度集中在 7 个任务里的 2 个。 逐任务算 PTDG 与 PMTRec 的差:T1 +0.0046、T2 +0.0011、T3 +0.0127、T4 +0.0002、T5 +0.0022、T6 +0.0150、T7 +0.0061,合计 0.0419(÷7 = 0.0060 ✓)。Task 6(+35.8%)与 Task 3(+30.3%)两项就贡献了平均增益的 66.1%,Task 2 与 Task 4 几乎持平(+0.0011 / +0.0002)。论文只强调 Task 3 的 +1.45%,其实 Task 6 相对 PMTRec 的 +1.70% 才是最大贡献项。
- 在稠密任务 Task 4 上 PTDG 不是「comparable」,而是排第三。 PLE 0.9471(加粗最优)> MoCoGrad 0.9468(下划线次优)> PTDG 0.9464 > PMTRec 0.9462。这是全表唯一一个 PTDG 没有拿到最优的任务,而且连次优都不是。论文用「maintaining comparable performance on dense objectives」一笔带过,没有说明在自家平台上 click 任务退化的业务代价。
此外,Table 2 只报了 20 个种子的均值,没有任何标准差、置信区间或显著性检验。摘要与 §4.2 里的 "significantly improves" / "significantly outperforms" 是口语意义上的「显著」,没有统计检验支撑。0.0060 这个量级的差距在 20 seed 上是否稳定,读者完全无从判断。
五、消融与敏感性分析¶
5.1 消融实验(仅工业数据集)¶
| Exp. | Variant Model | Avg AUC | 相对完整模型 | 相对 PMTRec (0.8818) |
|---|---|---|---|---|
| 1 | PTDG (Full) | 0.8878 | — | +0.68% |
| 2 | w/o Personalization ($\gamma_{u,s}$) | 0.8771 | −1.21% | −0.53%(低于 PMTRec) |
| 3 | w/o GCN (use Concat) | 0.8796 | −0.93% | −0.25%(低于 PMTRec) |
| 4 | w/o Causal Mask | 0.8814 | −0.72% | −0.05%(低于 PMTRec) |
| 5 | w/o APM (Adaptive Masking) | 0.8826 | −0.59% | +0.09% |
| 6 | w/o Progressive Warmup | 0.8841 | −0.42% | +0.26% |
论文的分析是:去掉实例级依赖图使 Avg AUC 降 1.21%,证明个性化任务依赖对捕捉异质多任务关系有效;把 GCN 换成简单拼接降 0.93%,说明 GCN 消息传递相对静态转化漏斗更能保住跨任务信号强度;关掉自适应掩码降 0.59%,凸显其缓解梯度冲突的作用。
独立复核结论:这些百分比数值属实(我按 (0.8878−x)/0.8878 逐项验算,1.205%→1.21%、0.924%→0.93%、0.586%→0.59% 全部吻合),但它们不能被当作架构价值读。
- 消融幅度超出了模型相对已发表 SOTA 的全部优势预算。 完整模型比最强基线 PMTRec 只多 0.0060 AUC,而三个单组件的移除分别损失 0.0107 / 0.0082 / 0.0064——每一项都单独超过 0.0060。也就是说,只要拿掉个性化、GCN、因果掩码中的任意一个,PTDG 就跌回 PMTRec 之下(0.8771 / 0.8796 / 0.8814 全部 < 0.8818)。「w/o Personalization」甚至同时低于 MIT(0.8791)。一个"组件贡献 1.21%"的说法,在"整机相对同表最强方法只领先 0.68%"的语境下是没有意义的——它测的不是该组件的价值,而是去掉它之后架构塌到什么程度。
- 退化变体没有任何重新调参的证据。 §4.1 只承诺"所有 baseline 的参数与原论文一致",对消融变体一字未提。而关键超参 $q=2$、$r_{max}=0.7$、$r_{min}=0.2$、$\alpha=0.1$ 全都是在完整模型上做敏感性分析选出来的。以 Exp.3「w/o GCN (use Concat)」为例:低秩 $q$ 与因果掩码是与 GCN 传播共同设计的,去掉传播后那张学出来的 $\mathbf{A}$ 基本变成惰性结构,$q=2$ 这个为传播调好的秩对拼接方案未必合适——这个变体更像是在测「一个没调过的退化架构」,而不是「GCN 的边际价值」。论文没有给出任何相反的解释。
- Exp.2 的排序本身就反常。 前面推导过,$\gamma_{u,s}$ 的实际作用只是 $\mathrm{diag}(\gamma)$ 对 $q=2$ 个隐因子做缩放,即整张依赖图上 2 个自由度。移除这 2 个标量造成的损失(1.21%)竟然大于移除整个 GCN 消息传递(0.93%)和整个因果掩码(0.72%)。若属实,说明模型的收益主要来自一个极窄的调制通道而非论文主打的图传播机制;若不属实,则说明消融本身噪声很大。两种解释都对论文的因果叙事不利,而缺少方差报告使得无法在两者间裁决。
- 消融只在保密的工业数据集上做,公开的 KuaiRand1K 上一次都没做。 而且 Table 3 的 caption 没有像 Table 2 那样声明"means over 20 random seeds",无从判断是否单次运行。这意味着外部任何人都无法复现或检验这套组件归因。
5.2 敏感性分析¶
低秩维度 $q$ 从 1 扫到 7,$q=2$ 时性能峰值、更大 $q$ 反而退化,论文据此确认低秩近似在用更少参数的同时有效控制过拟合,并给出经验规律 $q\approx T/3$;正式的 scaling 分析留作未来工作。掩码率实验把 APM 的最大/最小掩码率在 0–0.9 间扫描,结论是高正样本率任务取 $r_{min}=0.2$、低正样本率任务取 $r_{max}=0.7$ 最好。
Eq. 1 明确要求 $q<\tfrac{T}{2}$;工业集 $T=7$ 时 $q$ 最大只能取 3,KuaiRand1K $T=6$ 时最大 2。把 $q$ 扫到 7 已经越过了论文自己设的低秩约束($q=T$ 时 $\mathbf{Z}^L(\mathbf{Z}^R)^\top$ 就是满秩,"低秩正则"完全失效),所以"更大 $q$ 退化"这个观察一部分只是在重述定义。另外全文没有给出 $q$ 扫描的具体数值表,只有文字描述。
六、线上 A/B 实验¶
PTDG 作为某主流应用分发平台的排序模型部署,服务超过 1 亿日活用户,做两周线上 A/B。基线是当前线上部署的 MMoE,论文明确说明这就是 Table 2 里那个 MMoE 架构。流量切分为两个桶:base 桶 10%、实验桶 10%,剩余 80% 继续走原生产模型以保障服务稳定性。为确保统计显著性,对每个桶计算日级聚合指标并做双样本 t 检验,显著性阈值 $p<0.05$。结果:核心业务指标统计显著提升,CVR +1.2%、eCPM +1.9%。
独立复核:线上与离线在方向上自洽,但口径没有给全,而且比较对象被换掉了。
- 方向自洽。 线上基线是 MMoE,而 PTDG 相对 MMoE 的离线优势是工业集平均 +1.43% 相对 / +0.0125 绝对,深转化任务上更大(Task 3 +3.15%、Task 6 +1.77%、Task 7 +1.30%)。以此为参照,CVR +1.2% 是一个方向一致、量级上偏保守的结果——按工业界"0.1pp 绝对 AUC ≈ 1% 转化"的粗略经验,+1.25pp 的离线 AUC 增益本应换来远大于 1.2% 的线上 CVR。这个落差本身不矛盾,但提示离线设置(13.2M 样本、单张 V100)与生产模型不是同一个量级:一个日活过亿的平台,13.2M 样本约等于每个 DAU 0.1 条,显然是抽样后的研究集,因此消融结论也未必描述真正上线的那套系统。
- 真正被换掉的是比较对象。 离线表里 PMTRec(0.8818)和 MIT(0.8791)都已经明显强于 MMoE(0.8753),线上却拿一个 2018 年的架构当对照。这意味着 CVR +1.2% 中有多大比例只是"从 MMoE 换到任何一个 2024 年后的 MTL 方法"就能拿到,论文没有回答;PTDG 相对最强可选方案的增量从未被 A/B 验证过。
- eCPM 与 CVR 的差值未被解释。 eCPM +1.9% 高于 CVR +1.2%,多出的约 0.7pp 只能来自 CTR 变化或流量向更高出价 item 的迁移。论文既没有报 CTR,也没有做 eCPM 拆解,更没有讨论 pCVR 的校准——AUC 只衡量排序,而 eCPM 计价直接依赖预估值的绝对水平,一个 AUC 更好但校准更差的模型完全可能推高 eCPM 而损害广告主 ROI。
- 统计口径缺失。 只给了 $p<0.05$ 这一个数字:没有置信区间、没有效应量与标准差、没有逐日数据、没有 A/A 校验、没有说明是用户级还是请求级随机化、没有说明"CVR"对应 7 个任务里的哪一个。以两周日级聚合做双样本 t 检验意味着每桶只有 n=14 个样本点,且把天当作 i.i.d. 处理,忽略了星期效应带来的自相关。
- 护栏指标只有延迟。 全文唯一的护栏是端到端 +8 ms「within serving SLA」(SLA 具体数值未给)。没有留存、卸载率、下载完成率、广告负反馈、人均收入等任何用户体验或生态侧指标——而这恰恰是最需要护栏的场景:模型在稠密 click 任务上离线是低于 PLE 和 MoCoGrad 的。
七、核心贡献总结¶
- 把任务依赖从「固定超参」变成「实例级可学拓扑」,并且用低秩分解 + 硬因果掩码把这件事压到 $O(T\times q)$ 的代价内,是全文最有价值的工程判断:CSRL 那种 $O(T^2)$ 的因果结构搜索在工业延迟下不可用,而 PTDG 用一个 rank-2 分解就在 8 ms 内落地。
- APM 提供了一条「结构性」而非「数值性」的梯度去冲突路线:按标签正样本率决定共享参数的掩码率、用线性 warm-up 渐进收紧,训练开销可忽略、推理零开销(掩码训练后固定)。相比 PCGrad 的 $O(T^2)$ 投影,这是一个真正可上线的替代品。
- 真实的大规模部署:日活过亿的应用分发平台、两周 A/B、CVR +1.2% / eCPM +1.9%、延迟 +8 ms,工业可信度高于纯离线论文。
八、与已归档相关工作的对比¶
IntHQ IntHQ: Task-Interactive Hierarchical Query on Dual-Stream Representations for Generative Recommendation(DreamX, Alibaba Group / 高德,2026-08-10)¶
关系:独立并发(PTDG 未引用 IntHQ,参考文献止于 2025 年;两者殊途同归)· 已加载对方精读
- 共同关注的问题:root cause 逐字对应。PTDG 说"现有 MTL 在静态转化漏斗上强制统一的依赖强度……沿固定链的层级消息传递导致累积信号衰减";IntHQ 把同一件事命名为关系坍缩(Relational collapse)——"任务依赖要么被骨干隐式吸收,要么被预定义漏斗(ESMM、AITM)静态写死",并用信息论定理把它量化成非负超额风险项 $\Delta_{\text{rel}}=\mathrm{TC}(y\mid\mathcal{A})$,证明"无论编码器多大都从下方卡住任何因子化读出"。两篇都把 ESMM/AITM 的固定漏斗列为直接靶子。
- 相近的技术骨架:都在任务节点之间引入因果掩码的自适应消息传递来替代固定链。PTDG 的做法是 $\mathbf{A}=\mathbf{A}_{dyn}\odot\mathbf{M}_{causal}$ 再跑一层 GCN(Eq. 3–4);IntHQ 的 TIM 是在任务 token 之间做因果自注意力 $\hat H^{(\ell)}_q=\mathrm{Attn}_q(H^{(\ell)}_q,H^{(\ell)}_q)$,掩码规则是"下游 facet 能看到已实现的上游、反向被屏蔽"。注意力权重本身就是一张学出来的加权邻接矩阵,与 PTDG 的 $\mathbf{A}_{dyn}$ 是同一个对象的两种实现。两篇都额外做了共享参数解耦:PTDG 用 APM 按标签密度掩掉共享参数,IntHQ 用 DSD 把任务流与上下文流放到完全不相交的注意力参数上(并用命题 2 证明共享块的代价 $\tfrac12\Delta^\top H_c(H_c+H_q)^{-1}H_q\Delta$ 只取决于两种角色的最优点距离、与参数量无关)。IntHQ 命题 4 几乎是 PTDG 做法的理论化:"ESMM/AITM 也条件于前驱,但把顺序与耦合强度事先固定,跨任务注意力则为每个实例学出这个强度"。
- 本文的差异与推进:(i) 粒度——PTDG 的"个性化"实际只有 $q=2$ 个自由度的对角缩放(Eq. 2),IntHQ 的强度是逐 token、逐层、input-adaptive 学出来的,表达力高一个量级;(ii) 代价取向相反——PTDG 为工业延迟把结构压到 rank-2 GCN、只加 8 ms,IntHQ 则把编码器整个改成双流并加深度注意力(不过其 FLOPs 297.9M 反而低于 IntTravel/OneTrans/HGenPush 的 432–562M);(iii) 因果序的来源——PTDG 的 $\mathbf{M}_{causal}$ 是外部给定的物理漏斗序(Click→Pay 写死),IntHQ 的因果索引 $c(\cdot)$ 由 session 内决策实际实现的顺序给出,因而能处理"耦合随场景漂移、没有固定顺序成立"的非漏斗任务;(iv) 诊断深度——IntHQ 用逐层线性探针实证建立了层级坍缩,PTDG 对自己的"signal erosion"没有任何直接测量。
- 可比的方法 / 实验差异:PTDG 在应用分发(Click→Download→Pay 漏斗型 7 任务)拿 CVR +1.2% / eCPM +1.9%;IntHQ 在高德出行(when/where/how/via 四个非漏斗决策)拿 UVCTR +1.60%。两者数据集与任务定义完全不同,AUC 不可直接比较。一个值得注意的互补点:IntHQ 精读里自评的局限之一是"TIM 的因果序设计在漏斗型 click/cart/purchase 任务上会退化成接近 ESMM 的固定级联",而 PTDG 恰好证明了在纯漏斗场景下只保留因果掩码 + 一层低秩 GCN 也能拿到线上收益——两篇合起来把"学习式任务拓扑"在漏斗型与非漏斗型两类场景都做了验证。
OneRank OneRank: Unified Transformer-Native Ranking Architecture for Multi-Task Recommendation(人大高瓴 + Shopee + NTU,2026-06-15)¶
关系:独立并发(PTDG 未引用 OneRank)· 已加载对方精读
- 共同关注的问题:两篇都把矛头指向"共享底座 + 固定任务关系"这一组合。OneRank 诊断为任务无关信息瓶颈与跷跷板现象——"共享参数上的梯度冲突会改善一个任务却恶化另一个";PTDG 的 APM 动机与之逐字对应:"多任务之间的信息传递可能加剧多任务模型固有的梯度冲突"。两者也都不满意 ESMM/MMoE 这一代把任务依赖写死或完全并行的做法。
- 相近的技术骨架:OneRank 的可配置跨任务关系注意力用二值 mask $\mathbf{A}\in\{0,1\}^{K\times K}$ 控制任务间可见性,其中 Cascade Masking $A_{kj}=\mathbb{I}[j\le k]$ 沿"稠密→稀疏"依赖级联单向流动、让稀疏下游任务利用上游信号——这与 PTDG 的 $\mathbf{M}_{causal}$(强制 Click→Pay 单向、阻断语义回流)是同一招。解耦侧也同构:OneRank 用策略性梯度解耦(反传时只保留对角线、清零 off-diagonal,把跨任务注意力变成"只读记忆"),PTDG 用 APM 在参数空间掩掉任务不可见的共享参数,两者都是"前向共享、后向隔离"的实现变体。
- 本文的差异与推进:(i) mask 是否可学——OneRank 的 Parallel/Null/Cascade/Hybrid 四态 mask 是手工配置的二值矩阵,PTDG 在二值因果掩码之上再乘一层连续、实例特定的强度矩阵 $\mathbf{A}_{dyn}$,把"是否连边"(先验)与"连多强"(学习)分离,这正是 PTDG 相对 OneRank 的核心增量;(ii) 解耦力度——OneRank 的 off-diagonal 梯度全部清零(IntHQ 批评这"会丢掉有用的跨任务信号"),PTDG 的 APM 是软性的、按标签密度分配共享参数比例,稠密任务保留更多共享通路;(iii) 代价——OneRank 需要把整条排序流水线改造成 Transformer-native(任务 token + 候选感知上下文化 + 动态匹配打分),PTDG 是一个可以挂在现有 DeepFM/MLP 骨干之上的轻量模块(Eq. 1 明说隐因子由"两个骨干模型如 DeepFM 或 MLP"抽取),迁移成本低得多。
- 可比的方法 / 实验差异:OneRank 在 Shopee 电商漏斗(click/cart/purchase)7 天 A/B 拿 GMV/UU +1.01%、Paid GMV/UU +1.17%;PTDG 在应用分发漏斗两周 A/B 拿 CVR +1.2%、eCPM +1.9%。两者线上增益量级接近,但 OneRank 有系统的六变体消融(V1–V6,含"去梯度解耦"的 V4)且报到了任务级 AUC,PTDG 的消融只有 6 行均值、无方差。两篇未互跑实验,离线数值不可比。
Step 2.5 剔除的近似候选(问题或解法不构成双同构): - FSM-MMoE-VST(2608.04455, Twitch)——问题同构(稀疏/延迟的深层目标在统一 MTL 里被稠密目标挤压),但解法路径是"按信号性质拆成两个独立模型 + 14 天延迟窗口把稀疏标签稠密化 + 推理时分层加权",属于数据与标签工程,没有任何学习式任务拓扑,方法流程图无法与 PTDG 抽象重合。其实证结论已移入下节讨论。 - CMSL(2606.28533, Meta MRS)——措辞相近(context pollution vs signal erosion)但 root cause 不同:CMSL 处理的是单条用户历史序列内部上下文不连贯,解法是构造 K 条潜在子序列;PTDG 处理的是任务节点之间的依赖拓扑,两者作用的对象根本不是一个维度。 - DUET(2606.10243, Meta)——问题部分同构(稀疏站外转化信号被稠密点击淹没),但解法是在上游用户嵌入预训练阶段把两条流分开、冻结后异步喂给下游 ranker,与 PTDG 在 MTL 头部改依赖拓扑是相反方向(强化分离 vs 强化受控传递)。 - HA-MoE(2607.27577, Google)——解法侧确有相近处(用异构信号调制 MoE 门控 + FiLM 仿射,类似 PTDG 的 $\gamma_{u,s}$ 调制),但问题侧是跨内容类型(Vid/Web)的负迁移与少数类坍缩,不是转化漏斗上的任务依赖与信号衰减,root cause 不同。 - HubMixer(2608.27991, 快手)/ UniCon(2609.03290, 美团)——与本文共享的是"退化消融变体跑不过外部公开基线"这一方法论层面的现象,而非问题同构;两者分别处理特征 token 混合与上下文单元统一,与任务依赖建模无关。
九、讨论与局限性¶
值得借鉴的设计。 三点:(1) 把先验与学习分离——用二值 $\mathbf{M}_{causal}$ 编码不可违背的物理因果(Click 必先于 Pay),用连续 $\mathbf{A}_{dyn}$ 学可变的强度,比 ESMM 全写死、MMoE 全不管都更合理,也比 CSRL 那种从头搜因果结构便宜几个数量级;(2) 低秩当结构正则而非只当省参——论文明确说 $q<T/2$ 是为了"防止在稀疏工业数据上拟合伪相关",敏感性分析里 $q$ 增大反而退化也支持这个解释;(3) APM 把"梯度冲突"从优化问题改写成参数分配问题——按标签正样本率决定掩码率、训练后掩码固定因而推理零开销,这是 PCGrad/GradNorm 一系无法给出的工业性质。
核心问题一:消融不能作为架构价值的证据。 这是本篇最严重的方法论缺陷,也是本项目本周总结的"退化消融变体跑不过外部公开基线"这条核法的典型命中。完整 PTDG 相对同表最强的已发表方法 PMTRec 只领先 0.0060 AUC(+0.68%),而三个单组件移除分别损失 0.0107(w/o Personalization)、0.0082(w/o GCN)、0.0064(w/o Causal Mask)——每一项都大于这个总优势,对应的三个变体(0.8771 / 0.8796 / 0.8814)也都掉到 PMTRec(0.8818)之下,其中 w/o Personalization 连 MIT(0.8791)都不如。这意味着 −1.21% / −0.93% 这些幅度描述的不是"该组件带来多少价值",而是"拿掉它之后这套架构比外部 SOTA 差多少"。要让消融具备归因意义,至少需要:把 PMTRec 的水平线画进 Table 3、对每个变体重新做超参搜索、报告 20 seed 的方差。三件事论文一件都没做,也没有给出任何为什么不必做的解释。
核心问题二:「信号侵蚀」这个 root cause 从未被直接测量。 "signal erosion / signal attenuation" 在全文出现 12 次(标题、摘要、引言、贡献列表、§3.2、§4.2、结论),但每一次都是断言或标签,没有一次是测量。论文没有沿漏斗深度画任何信号强度/梯度范数/激活幅值的衰减曲线,没有对比固定链与 PTDG 图在深层任务节点上的信号量,没有可视化任何一张学出来的 $\mathbf{A}_{dyn}$,甚至连引言那个最有说服力的动机——"重度游戏走 $C\to D\to P$、轻量工具跳到 $C\to P$"——都没有用学出来的图去验证一次(全文只有 3 张图:Fig.1 概念示意、Fig.2 架构图、Table 2)。整条因果链完全是从最终 AUC 反推的:稀疏任务涨了 ⇒ 一定是信号侵蚀被缓解了。但同一批 AUC 差异同样可以由"多了一层带残差的 GCN 增加了容量"、"任务 embedding $e_t$ 增加了参数"、或 Eq. 7 的 EMA loss 重加权(一个与图结构完全无关的组件,且从未被消融)来解释。Eq. 6–7 的 EMA loss 平衡没有出现在 Table 3 的任何一行,而它恰恰是最容易单独解释稀疏任务增益的组件。
核心问题三:线上与离线自洽但口径不全,且换了对照物。 详见 §6。方向一致(相对 MMoE 离线 +1.43% 平均 AUC、深转化任务 +1.77%~+3.15%,线上 CVR +1.2%),但:线上基线是 2018 年的 MMoE 而非离线表里更强的 PMTRec/MIT,因此 PTDG 相对最优可选方案的增量从未上线验证;eCPM +1.9% 与 CVR +1.2% 之间约 0.7pp 的差额未被拆解,也没有任何 pCVR 校准分析(eCPM 计价依赖预估绝对值,AUC 管不到);统计口径只给了 $p<0.05$,无置信区间、无效应量、无 A/A、无随机化粒度说明,且日级聚合的双样本 t 检验每桶仅 n=14 并把天当作 i.i.d.;护栏只有延迟 +8 ms,没有任何用户体验或生态指标——而模型在稠密 click 任务上离线是低于 PLE 和 MoCoGrad 的。
一个来自归档的反证。 Twitch 的 FSM-MMoE-VST 在同类问题(稀疏深层目标 vs 稠密浅层目标)上给出了一个直接冲击本文叙事的实证:一旦把稀疏/延迟信号从稠密信号里分离出来,MMoE、Shared-Bottom、CGC 三种骨干的表现几乎完全相同(LMP NDCG@6 0.2462–0.2463),而任一"统一 MTL 模型"都会把 LMP 打垮 4.2%–4.6%——结论是"新鲜/延迟信号分离而非 MTL 骨干选型才是主导增益来源"。PTDG 的全部增益都记在骨干侧(依赖图 + 参数掩码),却完全没有对照"简单地把稀疏任务拆出去单独建模"这一 baseline。考虑到 PTDG 的增益 66% 集中在 7 个任务中的 2 个稀疏任务上,这个未做的对照相当关键。
其他局限。
- 个性化通道过窄:$\gamma_{u,s}$ 经 $\mathbf{1}_T\otimes\gamma^\top$ 广播后等价于 $\mathrm{diag}(\gamma_{u,s})$,$q=2$ 时"个性化"只有 2 个自由度,无法为不同用户改变任务对之间的相对模式——这与"Personalized Task Dependency Graphs"这个标题所暗示的表达力有明显落差。
- 记号与实验描述的瑕疵:Eq. 9 定义 $p_{min}/p_{max}$ 为标签正样本率($[0,1]$),§4.1 却给出 500/2000,显然是 warm-up 步数;真正的 $S_{warm}$ 全文未给。敏感性分析把 $q$ 扫到 7,越过了 Eq. 1 自设的 $q<T/2$ 约束($T=7$ 时上限为 3)。
- 可复现性:工业数据集正样本率标注 Confidential、7 个任务全部匿名、无代码;唯一公开的 KuaiRand1K 上没有做消融。全部组件归因都建立在外部无法检验的数据上。
- 只有一层 GCN:Eq. 4 是单层传播,而"信号沿深链累积衰减"本身是一个多跳现象。用一层 GCN 建立跨任务捷径确实能绕开中间步骤,但论文没有讨论 $T$ 增大(未来工作提到"scaling to larger task sets")时单层是否够用,也没有做层数消融。
- 方法论可扩展性:PTDG 是挂在既有 DeepFM/MLP 骨干之上的一个 $T\times T$ 轻量模块,参数量随任务数而非数据规模增长。它对"表征能力"和"序列建模能力"两条 scaling 路径都不提供增长空间——扩参时只能扩骨干,PTDG 本身的 $O(T\times q)$ 结构基本封顶。这是一个典型的"低成本工程增量"而非"可长期扩展的路线"。
总评。 一个真实上线、代价可控、想法干净的工业短文:把任务依赖强度从超参变成实例级可学的低秩拓扑,用硬因果掩码守住物理约束,用 APM 把梯度冲突改写成参数分配问题,8 ms 换 CVR +1.2%。但作为论文,它的证据链是断的——三个主打组件的消融幅度全部超出模型相对最强已发表方法的总优势,退化变体跌破 PMTRec 且无重新调参、无方差;主打的因果机制"signal erosion"从头到尾没有被测量过一次;线上对照换成了 2018 年的架构且没有护栏指标。读者能从中拿走的是工程配方(低秩 + 因果掩码 + 稀疏度驱动的参数掩码,以及 8 ms 的延迟预算),而不是该配方为什么有效的因果解释。