Multi-Objective Ranking for Live-Streaming:用「新鲜信号 / 延迟信号」分离与分层观众定向做直播多目标排序(Twitch)
Xiaoyi Gu, Julia Tavares, Eder Santana, Carlos Mendoza-Cardenas, Nikita Mishra, Saad Ali(Twitch Interactive;Nikita Mishra 现于 Amazon Prime Video,工作在 Twitch 期间完成) RecSys '26 · arXiv:2608.04455v1 · 2026-08-05 · DOI 10.1145/3773078.3831867
研究动机与背景
直播是一个必须同时喂饱多方的双边市场
Twitch 这类直播服务是一个双边市场(two-sided marketplace):观众与主播通过观看内容、聊天室发言、关注频道、商业活动(订阅、送礼)等多种机制互动。要让生意可持续,服务必须同时满足生态里所有利益相关方——观众既想发现新内容也想和已有社区建立羁绊,主播想扩大受众并变现。因此推荐系统必须在即时参与度与长期留存、营收目标之间取得平衡。
多目标优化(MOO)已借由多任务学习架构取得长足进展:MMoE 引入任务专属门控实现灵活知识共享,后续 SNR、PLE、MSSM、HoME 沿这条线演化并在 YouTube 这类系统中验证;平衡冲突目标的路线还包括梯度方法与 Pareto 优化。但作者的判断是:这些方法在电商与点播(VOD)场景奏效,却没有正面回应直播场景被放大的三个结构性挑战——直播观众是在多个并发行为(看、聊、关注、消费)上同时表达偏好,而非沿一条线性漏斗前进。
三个被直播场景放大的挑战
第一,目标稀疏(target sparsity)。 关注、订阅、购买这类高价值动作的发生率比点击、短观看低若干数量级。作者对100 万观众 7 天内数百万次曝光的分析给出一条清晰的密度递减链:
| 行为 | 相对 CTR 的密度 |
|---|---|
| Click-through rate | 1x(基准) |
| Short watch rate | 约 1/2.5 |
| Longer watch rate | 约 1/3.4 |
| Chat rate | 约 1/20 |
| Follow rate | 接近 1/90 |
| 货币化交易(订阅/送礼) | 比 follow 还要更低 |
第二,延迟反馈(delayed feedback),与稀疏性互相叠加。用户动作可能在曝光后数小时甚至数天才发生,带来一个根本张力:过早把「无响应」标成负样本会注入噪声,等太久又会让训练数据变陈旧(stale)。直播里尤其典型——观众可能在几周内反复观看一个被推荐频道才最终决定关注,也可能要在建立更强羁绊之后才订阅。
第三,观众分层偏置(user segment bias)。 高活观众主导训练数据,把模型从新观众和低活观众身上带偏,而后者恰恰代表关键增长潜力。更麻烦的是不同生命周期阶段的优化需求本身就不同:低活用户更需要以即时参与为导向的推荐来促成回访,高活用户则更适合被引导向更深的参与与变现动作。
三项贡献
作者以 Twitch 推荐系统为案例,把原本单一「以参与度为目标」的排序算法(Chen et al. 2022)扩展为联合优化参与、留存、营收的多目标框架:
- 论证了分离新鲜信号与延迟信号是直播推荐提升的主要驱动力,工程化为多模型架构:Fresh Signal Model(FSM)负责即时参与,Delayed Signal Model(DSM)在 14 天延迟窗口上聚合稀疏动作;再引入 Viewer Segment Targeting(VST) 在推理时对不同生命周期阶段施加不同权重。
- 论证了把深层参与与延迟动作放进 MMoE 联合建模、同时把浅层参与保留为独立 FSM,既提升效果又把参数减少 41.9%。
- 在数百万日活的 Twitch 系统上做分阶段线上 A/B:多模型 + 延迟窗口把 DAV 提升 +0.09%、高活观众 capped ARPU +0.56%;VST 进一步把低活观众 DAV +0.15%;MMoE 增强再加 +0.08% 总体 DAV 与 +0.27% 新增关注。全程 p99 延迟 <110ms。
相关工作定位
多目标优化。 早期 shared-bottom 让所有任务共享同一表征;MMoE 用任务专属门控覆盖共享专家网络推进范式;后续 SNR 模块化共享隐层、PLE 显式分离任务共有与专属参数、MSSM 做选择性特征学习、HoME 引入层次化 meta expert。针对序列化行为,ESMM 建模电商转化漏斗的目标依赖,AITM 自适应学习广告多步转化的序列依赖。此外还有梯度方法、Pareto 优化、策略学习、目标集成与对齐等路线。作者定位:这些方法没有充分处理直播下多个并发的延迟反馈与观众分层偏置。
延迟反馈与目标稀疏。 直播推荐中未观测到的交互不必然是负样本。展示广告领域的手段包括概率延迟模型(Chapelle 2014)、非参数方法、损失函数修正、多窗口方法、辅助校正模型。但现有方法主要面向「单一目标动作跟随一次初始交互」的序列转化场景(点击→购买),而直播中多个动作在内容消费之后独立发生、需要联合优化;订阅与购买在短窗口内根本凑不出足够正标签。
观众分层偏置。 偏置研究已很充分,但多数聚焦 item 级或算法级偏置而非分层不均衡。Fu et al. 识别了对低活用户的不公平并提出重排方法。本文则在多目标框架内部用预校准的、按生命周期阶段区分的权重做分层感知定向。
预备知识
两阶段推荐系统
Twitch 遵循两阶段深度神经网络架构:第一阶段用双塔模型从百万级创作者目录召回数十个频道;实时排序阶段用深度神经网络预测给定观众 $v_i$ 与召回频道 $C_k, k=1,\dots,n$ 的观看分钟数概率,按概率排序呈现。本文只关注排序阶段。
五种观众行为与业务目标
论文严格区分三个词:objective 指业务目标,target 指用于训练的观众动作,task 指对应的预测问题。Twitch 观众通过五种关键动作参与:
- Short-form Minutes Play(SMP):播放某频道 $\tau_s$ 分钟。代表点进频道后的即时兴趣。
- Long-form Minutes Play(LMP):播放某频道 $\tau_l$ 分钟($\tau_l \gg \tau_s$,具体阈值为专有信息),代表超越初始好奇心的更深内容参与。
- Chatting:在频道社区中发言。
- Following:关注频道以便访问和接收通知。
- Spending:订阅与送礼。
SMP、LMP、chat、follow 主要驱动新观众参与与留存;持续参与可间接通过购买与订阅带来变现;直接的 spend 动作既增加营收也标志更深的观众-频道羁绊。这条自然的动作递进链为「同时优化参与、留存、营收」提供了合适的训练目标。
观众分层:Early 与 Dedicated
- Early (E):新用户(账号年龄 $\le M$ 天)或低频用户(最近 $M$ 天内聊天或访问天数 $\le N$ 天)。
- Dedicated (D):高频参与者与铁粉(账号年龄 $> M$ 天,且最近 $M$ 天访问天数 $> N$)。
$M$ 与 $N$ 是服务特定阈值,具体值为专有信息。关键数据点是:D 观众贡献的训练样本量大约是 E 观众的 4 倍。
核心方法
问题形式化
给定观众集合 $\mathcal{V}$ 与频道集合 $\mathcal{C}$,令 $\mathbf{x}_{v_i,c_j}$ 表示融合观众与频道信号的特征向量。为同时优化多个业务目标,构造一个把所有观众动作 $a \in \mathcal{A} = \{SMP, LMP, chat, follow, spend\}$ 的预测组合起来的排序函数:
$$F_{Ranking}(\mathbf{x}_{v_i,c_j}) = \sum_{a \in \mathcal{A}} w_a \cdot p_a(\mathbf{x}_{v_i,c_j}) \tag{1}$$
其中 $p_a(\mathbf{x}_{v_i,c_j})$ 是动作 $a$ 的预测概率,$w_a$ 是平衡不同业务目标的权重。式 (1) 本身很朴素——一个线性标量化(scalarization)——但落地面临前述三个挑战:稀疏与延迟的反馈信号、分层特定优化的需求,以及日均数百万用户所要求的实时推理效率。
延迟窗口框架
为同时对付目标稀疏与延迟反馈,作者扩大正信号的观测窗口:跨多天聚合可以让稀疏目标变稠密,同时把延迟反馈捕捉进来。对 chat、follow、spend 这三个稀疏动作,形式化如下。对时刻 $t$ 的一次推荐会话(观众 $v_i$ 被曝光频道 $c_j$),定义延迟窗口 $DW$:
$$DW_{v_i,c_j}(t, \Delta t) = \{(a, t') : a \in \mathcal{A},\ t \le t' \le t + \Delta t,\ \text{观众 } v_i \text{ 在时刻 } t' \text{ 对频道 } c_j \text{ 执行动作 } a\} \tag{2}$$
其中 $t'$ 表示延迟窗口区间内的任意时间戳。对每个动作,这把稀疏的即时观测转换为聚合后更稠密的延迟参与信号:
$$y^{delayed}_{v_i,c_j} = \mathbb{I}\big[\,|DW_{v_i,c_j}(t, \Delta t)| > 0\,\big] \tag{3}$$
$\mathbb{I}[\cdot]$ 是指示函数,若对应目标动作在延迟窗口内发生则为 1,否则为 0。
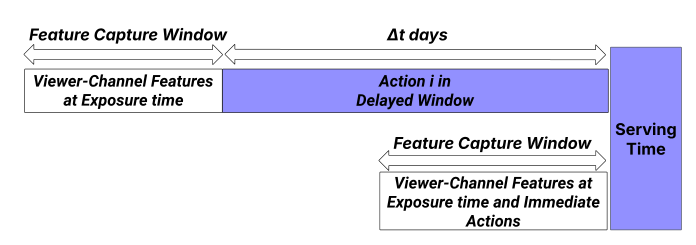
Figure 1 把权衡画得很清楚:上半条时间线是 DSM 的训练数据——特征捕获窗口停在曝光时刻,目标动作在其后 $\Delta t$ 天内收集;下半条是 FSM 的训练数据——特征捕获窗口紧贴服务时刻,用曝光时特征与即时动作。两条线右端指向同一个 Serving Time,一眼可见问题:只用延迟目标的话,到服务时刻特征已陈旧了 $\Delta t$ 天。
多模型(Multi-Model)架构
$\Delta t$ 延迟窗口确实缓解了动作稀疏,但只依赖延迟信号存在明显 trade-off:延迟反馈提供了全面的动作信息,却可能错过被即时信号捕捉的观众偏好近期变化。为在「全面历史反馈」与「新鲜观众偏好」之间取平衡,作者提出多模型(MM)架构:
- 对 SMP 这类不那么稀疏的动作,不使用延迟窗口,直接用新鲜信号训练 Fresh Signal Model(FSM) 捕捉即时参与;
- 延迟窗口方法只施加于稀疏动作 $a \in \{chat, follow, spend\}$,由 Delayed Signal Model(DSM) 在延迟目标上训练。
所有模型并行训练。推理时两类模型各自输出对应动作的 $p_a(\mathbf{x}_{v_i,c_j})$。这个架构是后续 VST 与效率增强的基础。
Viewer Segment Targeting(VST)
有了 DSM 与 FSM 提供的动作级预测,作者用对模型输出做分层感知加权处理观众分层偏置。理由有两条:其一,D 观众贡献的训练样本约为 E 观众的 4 倍,模型预测本身就偏向 D 的行为模式,对所有分层用同一套集成权重会把这份偏置原封不动传播到最终排序;其二,业务目标在生命周期阶段之间本就不同——E 观众要参与与留存,D 观众可往变现优化。
作者选择推理时的轻量级分层条件标量化(segment-conditioned objective scalarization),而非训练多个分层专属排序模型。对每个观众 $v_i$,按账号年龄与参与度确定分层 $s \in \mathcal{S} = \{E, D\}$,再把分层条件权重施加到最终排序分:
$$F_{VST}(\mathbf{x}_{v_i,c_j}) = \sum_{a \in \mathcal{A}} w_{a,s} \cdot p_a(\mathbf{x}_{v_i,c_j}) \tag{4}$$
其中 $w_{a,s}$ 是动作 $a \in \mathcal{A}$ 与观众分层 $s \in \mathcal{S}$ 对应的权重。模型在全体观众上训练,只在推理时差异化服务预测。 这种后训练加权保留了部署简洁性与线上迭代稳定性,同时实现了分层特定优化。
MMoE 增强
并行多模型虽能捕捉各目标的差异化信号,但为每个动作维护单独模型会增加系统复杂度与训练成本。作者因此把多个独立 DSM 合并进一个多任务学习模型,同时保留分层感知定向的收益。候选 MTL 骨干包括 MMoE、Shared-Bottom 和 CGC(PLE 的核心 extraction 模块),以下用 MMoE 作代表。
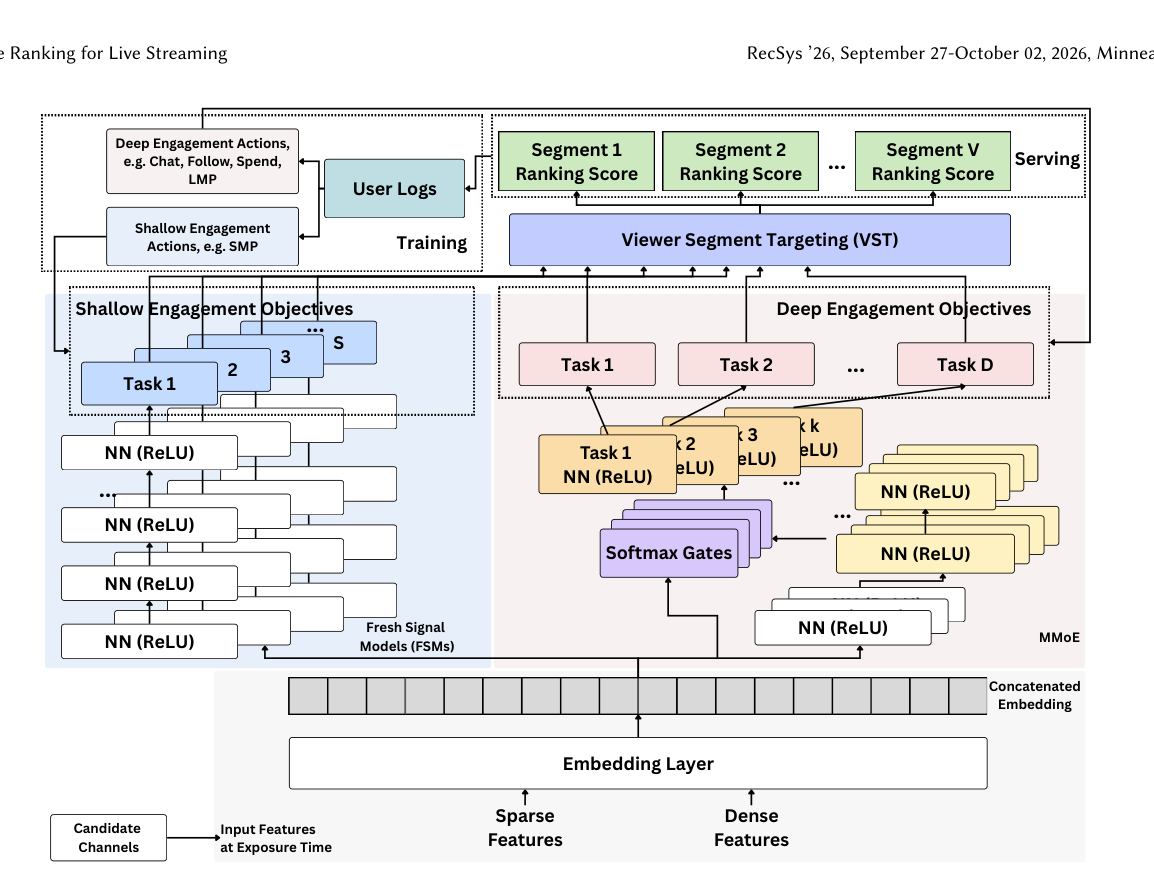
Figure 2 展示了最终的 FSM-MMoE-VST 架构:底部共享 Embedding Layer 把稀疏特征与稠密特征(曝光时输入特征 + 候选频道)编码为 Concatenated Embedding;左侧蓝色区块是负责浅层参与目标的 Fresh Signal Models(每个浅层任务一个四层 NN(ReLU) 塔);右侧粉色区块是负责深层参与目标的 MMoE(共享底层 → 多个专家网络 → Softmax Gates → 任务专属塔 → Task 1..D);顶部把两侧输出汇入 Viewer Segment Targeting (VST),输出 Segment 1..V 各自的 Ranking Score。训练侧从 User Logs 分出「Shallow Engagement Actions, e.g. SMP」与「Deep Engagement Actions, e.g. Chat, Follow, Spend, LMP」两路监督。
任务分组的动机来自三类动作的不同特性:
- SMP(浅层参与):关键的早期指示器,需要即时预测,保持为独立 FSM;
- LMP(深层参与):代表超越初始探索的持续兴趣。虽然 LMP 用的是即时标签而非延迟窗口,但它作为更深参与信号的角色与延迟动作目标天然对齐,因此适合联合建模;
- 延迟动作(chat、follow、spend):代表社区参与、留存与变现目标,用 14 天延迟窗口处理稀疏性。
最终架构 = 一个负责 SMP 的独立 FSM + 一个联合处理 $\{LMP, chat, follow, spend\}$ 的 MMoE($K = 4$ 个专家网络,由 HPO 选出)。MMoE 的任务专属门控让不同目标选择性利用共享专家表征、同时保持特化,分层感知定向则通过推理时加权保留。最终排序函数为:
$$F_{FSM-MMoE-VST}(\mathbf{x}_{v_i,c_j}, s) = w_{smp,s} \cdot p^{FSM}_{smp}(\mathbf{x}_{v_i,c_j}) + \sum_{a} w_{a,s} \cdot p^{MMoE}_{a}(\mathbf{x}_{v_i,c_j}) \tag{5}$$
其中 $a \in \{LMP, chat, follow, spend\}$,$s \in \mathcal{S} = \{E, D\}$,$w_{smp,s}$ 与 $w_{a,s}$ 分别是 FSM 与 MMoE 输出的分层专属权重。
实验设置
延迟窗口分析
为确定稀疏目标的最优延迟窗口大小,作者用600 万观众的历史曝光分析 $\{7, 14, 21, 28, 35\}$ 天窗口下的正样本比例。按周为间隔是因为 Twitch 用户在工作日与周末行为不同,按周对齐可平衡「捕捉到的信号」与「数据聚合效率」。密度改善很显著:仅 7 天窗口就让 chat 正标签增加约 9 倍,14 天增加 12 倍。但无限延长会带来收益递减并引发聚合计算量与信号陈旧性问题。最终实现里延迟窗口只施加于 chat、follow、spend,SMP 与 LMP 用即时标签。
模型架构与训练
- 训练数据:600 万观众的 7 天历史曝光。FSM 的 SMP 在全部曝光上用即时目标训练;MMoE 中 LMP 用即时标签,延迟目标用 14 天窗口。
- 评估数据:100 万观众的 1 天历史数据,配 35 天前向窗口取 ground truth,确保延迟动作被充分覆盖(订阅可能按月发生)。
- 多模型架构规模:FSM 四层全连接(size=1000),DSM 四层(size=300),全部 ReLU。
- MMoE 增强架构:保持相同 FSM,把独立 DSM 换成一个 MMoE——三层 shared bottom(size=1000)、四个专家网络(两层:512, 256)、任务专属门控(四层:各 128)、单层任务塔(size=64)。
- 其他 MTL 骨干:Shared-Bottom 与 CGC 各跑「单一统一模型(全部五目标)」与「FSM 配套」两种配置。
- 明确排除的基线:ESMM 与 AITM 这类序列转化模型被排除,因为它们假设序列动作漏斗(click → purchase),而直播观众的重要动作是无固定顺序、独立发生的。
- 超参数:全部模型用二元交叉熵损失、相同特征集(观众人口属性、频道特征、观众-频道交互);Adam,学习率 $[0.001, 0.005, 0.01]$、batch size $[1024, 2048]$ 由超参优化选出;用验证集 NDCG 做模型选择。
观众分层定向策略
假设是 E 与 D 观众有不同的优化需求:E 观众更新、对主播及其社区更不熟悉,最受益于聚焦即时参与(SMP)的推荐;D 观众可以往更深参与(chat、follow、LMP)与变现(spend)优化。
一个值得记录的负面结论:作者曾考虑在训练中对 E 观众样本施加更高损失权重来对抗数据偏置,但没有改善效果,反而引入了额外训练复杂度。因此改为推理时差异化加权:E 观众优先 SMP、其他动作权重极小;D 观众平衡多个目标。候选权重在离线测试里选出,生产配置通过业务指标与护栏指标上的迭代 A/B 定稿(具体值为专有信息)。收益是分层感知行为纯粹通过推理时加权实现,避免了维护分层专属模型的复杂度。
主要实验结果
离线:延迟窗口大小选择
用 2025 年 6-7 月数据集,分析不同延迟窗口大小对多模型效果的影响。Figure 3 是三张散点图(横轴 LMP NDCG@6,纵轴 Spend NDCG@6,每个点标注窗口天数,14d 用橙色高亮),分别对应 E / D / All 观众。之所以看 NDCG@6,是因为 Twitch 左侧导航栏默认展示 6 个推荐频道。
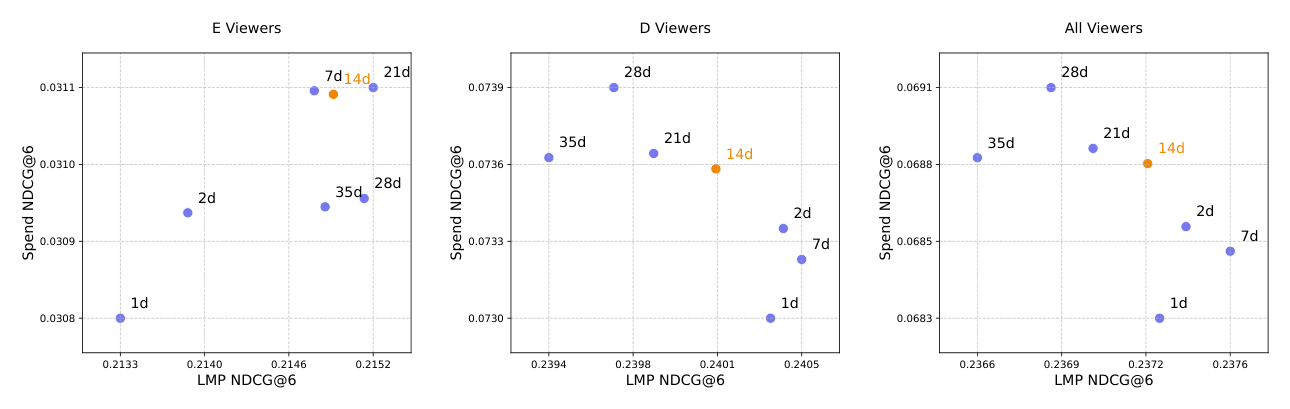
- E 观众:1 天窗口(LMP 0.2133 / Spend 0.0308)在两个指标上都最差,位于左下角;延长到 7-14-21 天后 LMP 与 Spend 双双显著改善,三者聚集在右上角(Spend 约 0.0311,LMP 0.2147-0.2152)。说明聚合延迟反馈有助于理解新观众的行为模式。
- D 观众:明显 trade-off——短窗口(1-7 天)LMP 占优(0.2404-0.2405)但 Spend 落后(0.0730-0.0733);长窗口(21-35 天)反过来(Spend 0.0736-0.0739,LMP 降到 0.2394-0.2399)。说明更长聚合周期有助捕捉稀疏延迟的消费动作,但过长窗口会把动作错误归因到已不相关的曝光上,引入噪声、降低参与信号质量。
- All 观众:14d 落在 LMP 0.2372 / Spend 0.0688,处于长短窗口之间的折中位置。
结论是选 14 天:取得显著 Spend 改善同时保持强参与表现。21 天效果类似(Spend 略好、LMP 略差),但考虑数据聚合计算量与陈旧性仍选 14 天。
离线:架构对比(Table 1)
基线是一个在 Twitch 数据集上训练、单目标 point-wise、建模 SMP 的深度神经网络(YouTube DNN 风格)。所有模型使用一致的特征集,在适用处使用 14 天延迟窗口。
| Model | LMP-E | LMP-D | LMP-All | Spend-E | Spend-D | Spend-All |
|---|---|---|---|---|---|---|
| YouTube DNN | 0.2090 | 0.2504 | 0.2459 | 0.0282 | 0.0780 | 0.0726 |
| MM + Delayed | 0.2071 | 0.2495 | 0.2448 | 0.0283 | 0.0797 | 0.0741 |
| MM + Delayed + VST | 0.2090 | 0.2498 | 0.2453 | 0.0283 | 0.0795 | 0.0740 |
| Single Shared Bottom | 0.1967 | 0.2402 | 0.2355 | 0.0275 | 0.0794 | 0.0738 |
| Single MMoE | 0.1961 | 0.2395 | 0.2347 | 0.0276 | 0.0797 | 0.0741 |
| Single CGC | 0.1964 | 0.2403 | 0.2355 | 0.0277 | 0.0795 | 0.0739 |
| FSM + Shared Bottom + VST | 0.2090 | 0.2509 | 0.2463 | 0.0283 | 0.0796 | 0.0740 |
| FSM + MMoE + VST | 0.2095 | 0.2507 | 0.2462 | 0.0284 | 0.0794 | 0.0739 |
| FSM + CGC + VST | 0.2095 | 0.2507 | 0.2462 | 0.0282 | 0.0794 | 0.0738 |
逐段分析:
(a)延迟窗口先换来 Spend、牺牲一点 LMP。 MM + Delayed 把整体 Spend NDCG@6 提升 2.07%(0.0726 → 0.0741),主要由 D 观众驱动(0.0780 → 0.0797),同时 LMP 轻微下降(整体 -0.45%,0.2459 → 0.2448)。这正对应 Figure 1 揭示的张力:延迟目标换来全面的稀疏动作信息,代价是特征相对陈旧。
(b)VST 把丢掉的 LMP 找回来且不损失 Spend。 MM + Delayed + VST 让 E 观众 LMP 从 0.2071 恢复到 0.2090(回到基线),整体 LMP 从 0.2448 回到 0.2453,Spend 只从 0.0741 微降到 0.0740,验证了「为高增长潜力的 E 优先参与、为已建立的 D 保住变现」的策略。
(c)单一统一 MTL 模型是灾难,且与骨干无关。 第 4-6 行三个 Single 模型相对 DNN 基线一致把 LMP 打垮 -4.2% 到 -4.6%(0.2459 → 0.2347~0.2355)。解读是:SMP 与深层参与、延迟目标塞进同一模型时会冲突。
(d)三个 FSM-MTL 骨干效果几乎一样——这才是核心发现。 第 7-9 行的 FSM + {Shared Bottom / MMoE / CGC} + VST 高度接近(LMP-All 0.2462-0.2463,Spend-All 0.0738-0.0740),说明提升主要来自「新鲜/延迟信号分离」本身而非具体多任务架构。其中 FSM + MMoE + VST 相对基线 LMP +0.12%(0.2459 → 0.2462)、Spend +1.79%(0.0726 → 0.0739),两分层均有增益(E LMP +0.24%、D LMP +0.12%)。Shared-Bottom 与 MMoE 都进了线上 A/B,MMoE 胜出;CGC 离线相当,作为未来线上评测候选保留。
线上 A/B 实验(Table 2)
三个各 14 天的 A/B 实验,逐阶段推进。所有指标经 CUPED 方差缩减处理。标注 $*$ 表示 $p < 0.05$,$**$ 表示 $p < 0.01$。
| Exp. | Segment | ARPU | DAV | LMP | Follow |
|---|---|---|---|---|---|
| 1 | E | −0.72% | +0.10%** | +0.11% | – |
| 1 | D | +0.56%* | +0.08%** | +0.17%** | – |
| 1 | All | +0.34% | +0.09%** | +0.16%** | – |
| 2 | E | −0.66% | +0.15%* | +0.25%** | – |
| 2 | D | +0.33% | −0.01% | −0.09% | – |
| 2 | All | +0.23% | +0.03% | +0.07% | – |
| 3 | E | +1.45% | +0.09% | +0.12% | +0.16% |
| 3 | D | −0.35% | +0.06% | +0.05% | +0.44%** |
| 3 | All | −0.01% | +0.08%* | +0.10%* | +0.27%** |
(Exp. 1-2 出于简洁省略 Follow 指标。)
实验 1:多模型 + 延迟目标。 基线是单目标 SMP 深度神经网络,外加变现启发式特征 Monetization Attach Ratio(MAR)——MAR 是此前营收优化 A/B 的胜出方案。实验组是 FSM(即时 SMP)+ 独立 DSM(chat/follow/spend,14 天窗口)。实验覆盖数百万访客,ARPU 按固定日阈值截尾以降低高消费用户带来的方差。
结果:整体 DAV +0.09%($p<0.01$)、LMP +0.16%($p<0.01$),折算成每年数百万个活跃观众日。D 观众同时拿到变现(+0.56% capped ARPU,$p<0.05$)与参与增益;E 观众参与提升(+0.10% DAV,$p<0.01$)但变现方向性下降(-0.72% ARPU,不显著)。作者特别强调:D 观众贡献绝大部分商业营收,故 +0.56% capped ARPU 有实质业务影响;且这个提升是在已带着此前 A/B 胜出的 MAR 启发式的基线之上取得的,因此收益可归因于多模型架构本身,而非「去掉了一个弱启发式」。
实验 2:观众分层定向。 以实验 1 胜出方案为基线,测试 E/D 分层条件权重(式 4)。结果:E 观众参与显著改善(+0.15% DAV $p<0.05$、+0.25% LMP $p<0.01$),D 观众基本持平(DAV -0.01%、LMP -0.09%,均不显著)。整体增益温和(+0.03% DAV、+0.07% LMP)正是被 D 的轻微变化稀释,但作者认为改善的 E 参与代表有价值的长期增长潜力。
实验 3:MMoE 增强。 以分层定向变体为基线,把多个独立模型换成 FSM + MMoE + VST。结果:整体关注数 +0.27%($p<0.01$)、整体 DAV +0.08%($p<0.05$)、整体 LMP +0.10%($p<0.05$);D 观众关注数提升尤为显著(+0.44%,$p<0.01$)。D DAV(+0.06%,$p = 0.11$)未达显著阈值但呈正向趋势。同一实验也评测了 FSM + Shared-Bottom + VST,结果明显更弱:capped ARPU +0.19%、DAV +0.06%($p = 0.10$)、LMP +0.06%、follows +0.15%,全部未达统计显著——确认 MMoE 是线上更强的 MTL 骨干(与离线三骨干近乎持平形成有趣对照)。
参数效率与泛化性。 MMoE 整合把延迟目标建模组件从 2670 万参数(多个独立 DSM)降到约 1550 万参数(单个 MMoE),即 41.9% 缩减,显著降低训练成本且维持服务延迟。作者还把多模型架构用在 Twitch 移动端 live feed 上,14 天 A/B 取得 +1.12% 的正向用户-频道交互(点击、关注、点赞之和),$p < 0.001$。全系统维持 p99 排序延迟低于 110ms。
消融与分析:MMoE 任务分组策略(Table 3)
Table 1 比较的是架构族之间的差异,Table 3 则聚焦「在 FSM + MMoE 设计下,目标应该怎么分组」。所有延迟目标使用 14 天窗口;Single MMoE 没有 VST,其余变体都带 VST。
| Architecture | LMP-E | LMP-D | LMP-All | Spend-E | Spend-D | Spend-All |
|---|---|---|---|---|---|---|
| Single MMoE (All targets) | 0.1961 | 0.2395 | 0.2347 | 0.0276 | 0.0797 | 0.0741 |
| FSM(SMP) + MMoE(Delayed only) | 0.2091 | 0.2501 | 0.2456 | 0.0280 | 0.0791 | 0.0736 |
| MMoE(SMP+LMP) + MMoE(Delayed) | 0.2094 | 0.2505 | 0.2460 | 0.0282 | 0.0794 | 0.0739 |
| FSM(SMP) + MMoE(LMP+Delayed) | 0.2095 | 0.2507 | 0.2462 | 0.0284 | 0.0794 | 0.0739 |
逐行分析:
- 第 1 行 Single MMoE(全部五目标):极端 trade-off——拿到全场最高的整体 Spend NDCG@6(0.0741),却把 LMP 打垮 -4.7%(0.2462 → 0.2347)。坐实了作者的假设:把 SMP 纳入联合建模会因其主导性信号压过更稀疏的目标而损害参与指标。
- 第 2 行 FSM(SMP) + MMoE(仅延迟目标):把 LMP 排除在外,效果中等(LMP-All 0.2456,Spend-All 0.0736),两个指标都不是最好。
- 第 3 行 双 MMoE(SMP+LMP 一组、延迟目标一组):LMP 略有改善(0.2460)但仍不及第 4 行,且系统复杂度显著增加而收益极小。
- 第 4 行 最终架构 FSM(SMP) + MMoE(LMP + 延迟目标):最佳 LMP(0.2462)且保持有竞争力的 Spend(0.0739)。支撑了作者的假设:LMP 尽管比 chat/follow/spend 频繁得多,却与延迟动作共享底层参与模式,因而受益于联合建模。
值得注意的是 Spend-All 最优值始终落在 Single MMoE(0.0741),即最终架构在 Spend 上让出了 0.0002(约 -0.27%)来换 LMP 上 +4.9% 的巨大改善。作者没有掩饰这个取舍。
讨论
信号分离 vs. 架构选择
贯穿全部实验的发现是:新鲜信号与延迟信号的架构级分离,比 MTL 骨干的选择重要得多。三个 MTL 架构配上独立 FSM 后离线表现相当,而所有单一统一模型无论骨干多复杂都严重降级参与指标。归因是:SMP 与深层参与、变现目标在参与深度与目标密度两个维度上都有根本差异(SMP 比 follow、spend 稠密若干数量级),联合建模时稠密的浅层信号主导梯度更新、淹没稀疏目标。可迁移建议:当各目标在密度与参与深度上差异显著时,优先做信号级的架构分离,而不是纠结 MTL 骨干选型。
实践设计教训
- 训练时干预 vs. 推理时干预:作者最初在损失函数中上调 E 样本权重——没有改善效果;反而是零额外参数的推理时分层加权对 E 参与有效且不降级 D。该框架可扩展到更细粒度分层,但通过在线学习自动化权重配置仍是开放挑战。
- 延迟窗口的边界:延长窗口在一定范围内改善目标密度,但更长窗口增加聚合成本、有捕捉陈旧模式的风险——14 天之后收益递减,D 参与指标反而下降;还有一个常被忽略的代价:训练数据必须等到曝光后 $\Delta t$ 天才能定稿。
核心贡献总结
- 延迟窗口聚合(式 2-3):把稀疏目标的即时观测转为 $\Delta t$ 天窗口内的聚合指示标签,chat 正标签 7 天增约 9 倍、14 天增 12 倍。
- Fresh / Delayed 信号分离的多模型架构:稠密目标走 FSM 保新鲜、稀疏目标走 DSM 保覆盖,被论文实证为主导性的提升来源。
- 零参数的推理时分层定向 VST(式 4):替代分层专属模型或损失加权,恢复延迟窗口牺牲掉的 E 参与、同时保住 D 变现。
- MMoE 整合:LMP 与延迟目标合入一个 MMoE、SMP 保持独立 FSM,是任务分组消融的最优解,参数 -41.9%。
- 分阶段线上验证:三次 14 天 A/B,DAV +0.09% / D capped ARPU +0.56% / E DAV +0.15% / 关注 +0.27%,p99 <110ms,移动 live feed 泛化 +1.12%。
与已归档相关工作的对比
HA-MoE HA-MoE: Heterogeneous Ranking in Industrial-Scale Recommender Systems(Google, 2026-07-30)
关系:独立并发(本文未引用 HA-MoE,两者殊途同归)· 已加载对方精读
- 共同关注的问题:同一个 root cause——统一多任务排序模型里,样本量或信号密度占优的一侧主导共享表征与梯度更新,压塌少数侧。HA-MoE 称之为 minority-type collapse(Web 文章盖过视频/UGC)与 seesaw 现象;本文的两个具体表现是 SMP(比 follow 稠密约 90 倍)联合建模时淹没稀疏目标(Table 1 三个 Single MTL 一致 LMP -4.2%~-4.6%),以及 D 观众约 4 倍样本量导致预测偏向 D。两篇都是 RecSys '26 工业案例研究,都完全依赖内部数据集。
- 相近的技术骨架:都能画成同一张图——MMoE 家族骨干 + 用一个显式的分段/异构上下文信号对模型行为做条件化。HA-MoE 把异构信号 $h$ 注入门控输入(HA-Gating)并对专家输出做 FiLM 式仿射调制(HDLM);本文把观众分层 $s$ 作为条件变量,在 MMoE 输出之上施加 $w_{a,s}$(式 4-5)。两者也都被同一组硬工业约束(内存 / 训练速度 / serving latency)塑形。
- 本文的差异与推进:条件化的位置与参数量不同。HA-MoE 做进训练时的模型内部,代价是模型体积 +5%、延迟 +0.5%;本文做在推理时的模型外部,零额外参数,且明确记录了「训练时上调 E 样本损失权重没有改善」这条负面结论。此外本文多了一个 HA-MoE 没有的维度——时间维度上的信号分离(fresh vs. delayed):HA-MoE 处理的是 item 侧模态/格式异构,本文处理的是目标侧的密度与延迟异构。
- 可比的方法 / 实验差异:HA-MoE 用 DL-AUC 作抗 gaming 的上线闸门,把 Vid⁺/Web⁻ xAUC gap 从 0.141 收窄到 0.060,线上 DAU +0.22%;本文用分 E/D/All 的 NDCG@6,线上 DAV +0.09%、D capped ARPU +0.56%。两者都显式报告分段级指标而非只看整体——本文的 E/D 分列正好暴露了「整体 +0.03% DAV 掩盖 E +0.15%」的稀释效应。互补之处:本文缺一个 HA-MoE 式的、能抗「拿 D 收益换 E 损失」的单一闸门指标。
UAME UAME: Uncertainty as Remedy for Multi-Objective Ensemble Ranking(Kuaishou, 2026-07-19)
关系:独立并发(本文未引用 UAME;反过来说,本文的式 1/4 正是 UAME 所批判的那一类范式)· 已加载对方精读
- 共同关注的问题:两篇处理同一个系统层——把多个任务预测融合成一个排序分的 objective ensemble 层。UAME 把工业主流方案总结为 Stage 1(point-wise MTL 产 pxtr)+ Stage 2(人工融合公式加权求和),而本文的式 (1)(4) 正是这个 Stage 2 的教科书形态。两者都认定这些代理信号彼此冲突且带系统性偏差:UAME 称之为 satisfaction label bias,本文则观察到 LMP 与 Spend 在延迟窗口长度上的取舍方向相反(Figure 3 中 D 观众短窗口 LMP 高 / Spend 低,长窗口反之)。
- 相近的技术骨架:都在「融合权重不该对所有样本一视同仁」上做文章。UAME 用不确定性 $U_{ij} = \sigma_i^2 + \sigma_j^2$ 做样本级自适应加权,本文用观众分层 $s$ 做群体级条件加权。
- 本文的差异与推进:条件变量的粒度与获取方式差异巨大。UAME 是端到端学出来的连续、样本级条件量——双分支输出层建模 $\hat{y}_i = \mu_i + \sigma_i \epsilon_i$,用高斯 CDF $\Phi\big((\mu_i-\mu_j)/\sqrt{\sigma_i^2+\sigma_j^2}\big)$ 构造概率化 pairwise 损失,再用不确定性给高冲突 pair 加权;本文是人工定义的离散二值群体条件量,权重靠离线选候选 + 线上 A/B 定稿。本文用工程简洁性换掉了 UAME 的建模复杂度,代价是权重无法个性化——论文自己承认「自动化权重配置仍是开放挑战」,而 UAME 正是这个方向的一个具体答案。
- 可比的方法 / 实验差异:UAME 在数亿 DAU 短视频系统上一致改进 EMER 与 EASQ 两个端到端集成骨干;本文没有和任何端到端集成方法对比,基线是单目标 DNN + MAR 启发式。场景差异解释了取舍:短视频 pxtr 大多即时可观测,冲突来自维度不一致;直播的 chat/follow/spend 延迟数天才可观测,本文必须先把标签造出来才谈得上融合——这也是 UAME「基于当前 pxtr 冲突估不确定性」的机制不能直接套用的原因。
DADF DADF: A Distribution-Aware Debiasing Framework for Watch-Time Regression(Kuaishou, 2026-05-18)
关系:独立并发(本文未引用 DADF,两者在「后处理分组校正」上骨架同构)· 已加载对方精读
- 共同关注的问题:都是「训练分布被某类样本主导,导致模型在分组层面存在系统性偏差」。DADF 命名的 pseudo-balance(伪标定) 指:模型在全局聚合层面看起来标定良好(observed/predicted ≈ 1.0),却系统性高估短观看、低估长观看,两类相反误差在聚合统计里互相抵消。本文的分层偏置是它在用户侧的对偶——整体 DAV +0.03% 掩盖了 E +0.15% / D -0.01% 的分裂(Table 2 Exp. 2),只看整体指标 VST 几乎会被判为「没用」。
- 相近的技术骨架:两者流程图几乎重叠——冻结已训练好的一阶预测器,在其输出之上挂一个「按组条件化」的后处理修正层,推理时按组查表施加修正。DADF 按 video duration 分 $K$ 组、每组一个专家网络做乘性残差校正 $\hat{y} = \hat{y}_0 \cdot \hat{b}$;本文按生命周期分两组、每组一套权重做线性标量化。两者也都论证了「为什么不改一阶模型」:DADF 是替换已部署预测器的工程与验证成本,本文是部署简洁性与迭代稳定性。
- 本文的差异与推进:DADF 的组条件化是学出来的(可学的 group-specific Box–Cox 参数 $\lambda_g$ + 每组专家网络 + 复用一阶 engagement 头 logits),本文是手工标定的固定权重。分组维度也正交:DADF 分 item 侧 duration 组做单目标 watch-time 标定,本文分 user 侧生命周期组做多目标融合权重。因此两者可叠加——VST 完全可以把 $w_{a,s}$ 升级成以 segment 为硬路由的轻量校正网络,正好落在本文自己点名的开放问题上。
- 可比的方法 / 实验差异:DADF 在 7 个 backbone 上一致改进 MAE/XAUC,Kwai 线上 +0.347% 人均使用时长;本文 Twitch 线上 DAV +0.09%、D capped ARPU +0.56%。绝对幅度不可直接比较,但共同证据是:在冻结的主模型之上做分组后处理,是工业系统里成本/收益比极高的一类干预。
局限性
(1)完全无法复现。 全部实验都在 Twitch 内部数据上进行,没有任何公开数据集结果。关键参数——观看阈值 $\tau_s, \tau_l$,分层阈值 $M, N$,以及 VST 的核心产出 $w_{a,s}$——全部标注为专有信息。VST 是三大贡献之一,读者却拿不到任何具体权重,只有「E 优先 SMP、其他权重极小;D 平衡多目标」这个定性策略。
(2)离线与线上结论的不一致没有被解释。 Table 1 中 FSM + Shared Bottom + VST 的 LMP-All(0.2463)与 D LMP(0.2509)略优于 FSM + MMoE + VST(0.2462 / 0.2507),但线上 MMoE 明显更强(+0.08% DAV $p<0.05$ vs. +0.06% $p=0.10$)。作者没有给出机制层面的解释,这也削弱了「用离线 NDCG 做模型选择」这一设置本身的说服力。
(3)收益幅度小、统计边界模糊。 DAV +0.09% 在 Twitch 规模上确有商业意义,但很多关键单元格未达显著:Exp. 1 的 E ARPU -0.72%、Exp. 3 的 D ARPU -0.35% 与 E ARPU +1.45% 都没标星,而 Exp. 3 整体 ARPU 是 -0.01%——MMoE 增强在营收上实际持平,摘要里只强调 DAV 与 follows。三个实验各只跑 14 天,对「长期留存」这类反复强调的目标而言观测窗口偏短。
(4)新颖性有限。 延迟窗口聚合、fresh/delayed 双模型、MMoE、推理时加权标量化逐项都是成熟做法;价值主要在组合方式的实证结论(信号分离 > 骨干选型)与工业细节披露,作者自己也把论文定位为 case study。
(5)分层粒度过粗、权重不个性化。 E/D 只有两档且权重全局固定;与 UAME 的样本级自适应加权相比是明显的能力差距。
(6)延迟窗口的流水线耦合被低估。 「训练数据必须等到曝光后 $\Delta t$ 天才能定稿」意味着 DSM 分支的迭代节奏被硬性锁死,对需要跟上直播内容快速变化的系统是实质成本,但文中只有一句话带过、没有量化。
工业落地价值
最大价值在于给出了一条低风险、可分阶段推进的多目标改造路径,每步都有独立 A/B 背书:先用延迟窗口把稀疏标签造出来(换 Spend),再用推理时分层加权把牺牲掉的参与找回来(换 E DAV),最后用 MMoE 做参数整合(换成本 + 关注)。三步互不阻塞、可独立回滚。
三条最值得借鉴的结论:
- 当多个目标的标签密度差若干数量级时,先做信号级架构拆分,再谈 MTL 骨干选型。 Table 1 里三个 Single MTL 一致 LMP -4.2%~-4.6%、而 FSM + 任意骨干 + VST 都能回正,这个对照的说服力比任何单点 SOTA 都强。
- 分层偏置的干预放在推理侧比训练侧划算。 训练时上调低活样本损失权重「没有改善且引入复杂度」,零参数的推理时加权直接拿到 E DAV +0.15%。
- 延迟窗口有明确甜点区,位置由「参与 vs. 变现」的取舍决定而非单调递增。 21 天效果与 14 天相当却因聚合成本与陈旧性被否决——这个「效果打平时用工程成本决胜」的决策记录很有参考价值。