Uncertainty as Remedy: Mitigating Satisfaction Label Bias in Short Video Multi-Objective Ensemble Ranking(UAME)¶
Kuaishou Technology(Zonghe Shao, Tiantian He, Xiaoxiao Xu, Jiaqi Yu, Minzhi Xie, Jinfang Gu, Yongqi Liu, Kaiqiao Zhan, Kun Gai),arXiv:2607.17092,2026-07-19。
研究动机与背景¶
短视频推荐的终极目标:建模不可观测的"真实满意度"¶
短视频推荐平台服务数亿日活(DAU),推荐系统的核心目标是准确估计用户对被推荐视频不可观测的真实综合满意度(true comprehensive satisfaction) $s$。但 $s$ 是一个潜变量,无法直接监督。工业界的主导做法是两阶段架构:
- Stage 1(Point-wise MTL):大规模多任务模型在多个维度上估计用户满意度,产出一组 pxtr(predicted xtr)分数——如 click(pctr)、watch-time(pvtr)、long-view(plvtr)、complete-view(pcpr)、like(pltr)、follow(pwtr)、comment(pcmtr)、share(pftr)等,统称 pxtr scores。
- Stage 2(Formula-based Ensemble):把这些 pxtr 分数用人工设计的启发式融合公式(加权和 / 乘积等)合成一个统一的排序分。
后续工作用深度学习学习融合权重来改进 Stage 2,方法包括交叉熵、网格搜索、强化学习等,但始终缺乏端到端的个性化排序。为此,端到端多目标集成排序(end-to-end multi-objective ensemble ranking) 兴起:用深度模型替代人工融合公式,把多个 pxtr 信号作为满意度代理(satisfaction proxies)直接优化端到端排序。代表工作有 EMER [7]、Pantheon [1]、HarmonRank [36],均在大规模工业短视频场景验证了有效性,相对启发式公式取得显著收益。
两大被忽视的核心缺陷¶
尽管端到端范式消除了人工融合约束,作者指出它们仍暴露两个影响与用户真实综合满意度对齐的关键局限:
局限一:无法解决"多维满意度代理 ↔ 真实满意度"之间的固有偏差(satisfaction label bias)。 现有方法隐式地把 pxtr 信号当作足够可靠的满意度代理,并采用等权损失(equal-weight loss)优化。但现实中异质的 pxtr 信号只捕捉了短视频用户行为的碎片化维度,它们携带的排序约束彼此矛盾,且系统性偏离用户真实偏好——这就是固有的满意度标签偏差(inherent satisfaction label bias)。等权损失会进一步放大这一偏差:它使 pxtr 排序一致的样本(consistent items)主导模型更新,而对满意度建模最关键的高冲突样本(high-conflict items)严重欠优化。
局限二:确定性建模范式无法调和相互冲突的优化目标。 现有模型输出一个确定性标量分数(deterministic score),等价于假设所有预测的置信度相同、一个固定分数能同时满足所有冲突的 pxtr。这两个假设在真实世界常被违反 [3],迫使模型收敛到一个折中的局部最优(compromised local optimum) [17],且没有任何不确定性量化 [32]。
局限三(对现有不确定性方法的批评): 已有的 uncertainty-aware 推荐工作要么聚焦 point-wise 预测任务(CTR 预测的偶然点击等),要么仅把不确定性当作后处理排序调整(post-hoc ranking adjustment)的辅助信号 [21,38],很少尝试把它嵌入到核心端到端优化管线中来缓解满意度标签偏差;它们也很少澄清与满意度标签偏差紧密耦合的不确定性来源。
核心洞察与贡献¶
作者的核心洞察是:在多目标排序标签下,由多目标冲突驱动的预测不确定性,经验上与"多维满意度代理 ↔ 真实满意度"之间的样本级满意度标签偏差正相关——即高冲突样本既有大的标签偏差、也应有大的预测不确定性。基于此,作者构建一个仅由预测不确定性驱动的自适应加权机制,把它嵌入核心优化管线以缓解标签偏差、对齐真实满意度。
本文提出 UAME(Uncertainty-Aware end-to-end Multi-objective Ensemble ranking framework)。核心贡献:
- 不确定性感知的打分建模(uncertainty-aware scoring formulation):为多目标集成排序引入不确定性感知打分,其中均值估计满意度分数、方差捕捉多目标冲突驱动的不确定性。
- 概率化 pairwise 排序目标 + 不确定性感知样本加权:学到的不确定性用来强调高冲突 item pair、在训练中缓解满意度标签偏差。
- 大规模工业部署与验证:在数亿 DAU 的工业短视频推荐系统上部署并广泛验证。UAME 一致地改进了 EMER 与 EASQ 两个 SOTA 范式,并更好地对齐问卷式(questionnaire-based)用户满意度,线上取得稳定、统计显著的收益。
相关工作¶
端到端多目标集成排序¶
端到端多目标集成排序已成为工业短视频推荐的主流研究方向,用深度模型的联合优化替代传统两阶段的人工融合公式。EMER [7]、Pantheon [1]、HarmonRank [36] 等代表工作虽然消除了人工融合约束,但都共享一个核心局限:重度依赖行为派生的 pxtr 信号作为排序标签,从而引入了"多维满意度代理 ↔ 用户真实综合满意度"之间的固有偏差。已有工作尝试用额外监督缓解,例如 EASQ [16] 引入显式的用户问卷满意度反馈作为高质量排序监督。与这条路线不同,本文分析上述偏差与模型预测不确定性的联系,提出针对 item pair 的不确定性感知自适应加权,在核心端到端训练管线中缓解标签偏差,不依赖任何超出既有 pxtr 行为标签的额外监督信号。
RecSys 中的不确定性估计¶
经典机器学习把不确定性分为认知不确定性(epistemic)与偶然不确定性(aleatoric) [10],本文主要讨论偶然不确定性。早期工作在 point-wise 预测任务(如 CTR 预测)上探索不确定性 [19],通常归因于标签噪声(偶然点击 [9,20])和分布漂移 [13,25]。但端到端多目标集成排序 [7] 依赖多个异质 pxtr 标签作监督,引入了建模中的新的不确定性来源:其主导来源是同一 user-item pair 下多个行为 pxtr 标签之间的内在冲突(intrinsic conflicts)。一条密切相关的研究是不确定性感知多任务学习(MTL) [18,33,34],但这些方法聚焦 point-wise 预测任务的任务级(task-level)全局冲突损失平衡;相比之下,本文针对排序中由不一致多目标行为标签导致的样本级(sample-level)满意度标签偏差,用不确定性缓解偏差,与 MTL 的任务中心设计本质不同,且在多目标集成排序中此前未被探索。
排序中的不确定性¶
已有工作曾用不确定性处理排序中的标签噪声、行为偏差 [39] 和分布漂移 [8],或用不确定性感知经验贝叶斯缓解 learning-to-rank 中的利用偏差 [38],或在 top-K 排序问题中基于分数分布建模不确定性 [27]。但现有排序不确定性研究有一个共同的范式局限:多数把不确定性当作辅助信号来校正预测排序分数、做后处理调整(post-hoc) [12,15],这种后处理用法不能直接缓解核心优化过程中的标签偏差。与之不同,UAME 把不确定性嵌入核心训练管线,在优化中直接缓解标签偏差,同时满足工业应用的低延迟要求(线上服务仅用均值分支,见部署细节)。
核心方法 / 模型架构¶
UAME 的核心框架包含三部分:满意度-不确定性建模(Satisfaction-Uncertainty Modeling)、概率化 pairwise 排序损失(Probabilistic Pairwise Loss)、不确定性感知自适应加权(Uncertainty-aware Adaptive Weighting),最后给出理论分析。
3.1 问题定义¶
形式化定义端到端多目标集成排序任务:令 $U$ 为用户集、$V$ 为短视频 item 集、$c$ 为上下文特征。对上下文 $c$ 下的用户 $u \in U$,模型输入候选集 $I_{cand}(u,c)$,目标是生成一个排序列表,最大化用户对每个候选 item $v_i$ 的不可观测真实满意度 $s_i$。关键挑战是 $s_i$ 是潜变量、无法直接监督。因此现有方法依赖 point-wise MTL 模型预训练得到的、面向核心交互目标(click、watch time、like、follow 等)的行为派生 pxtr 信号作为满意度代理。
对 item $v_i$,其 $K$ 维 pxtr 分数记为 $\{e_i^{(k)}\}_{k=1}^K$。对任意 item pair $(v_i, v_j)$,理想的 pairwise 排序标签是 $y_{ij}^* = \mathbb{1}\{s_i > s_j\}$($\mathbb{1}\{\cdot\}$ 为指示函数),而从第 $k$ 个 pxtr 信号派生的 pairwise 排序标签是:
$$y_{ij}^{(k)} = \mathbb{1}\{e_i^{(k)} > e_j^{(k)}\} \tag{$*$}$$
值得注意的是,pxtr 信号本身就是对真实满意度有偏的代理,且样本级冲突(sample-level conflicts)跨异质 pxtr 信号出现——这正是端到端多目标集成排序中预测不确定性的主导来源。
3.2 满意度-不确定性建模¶
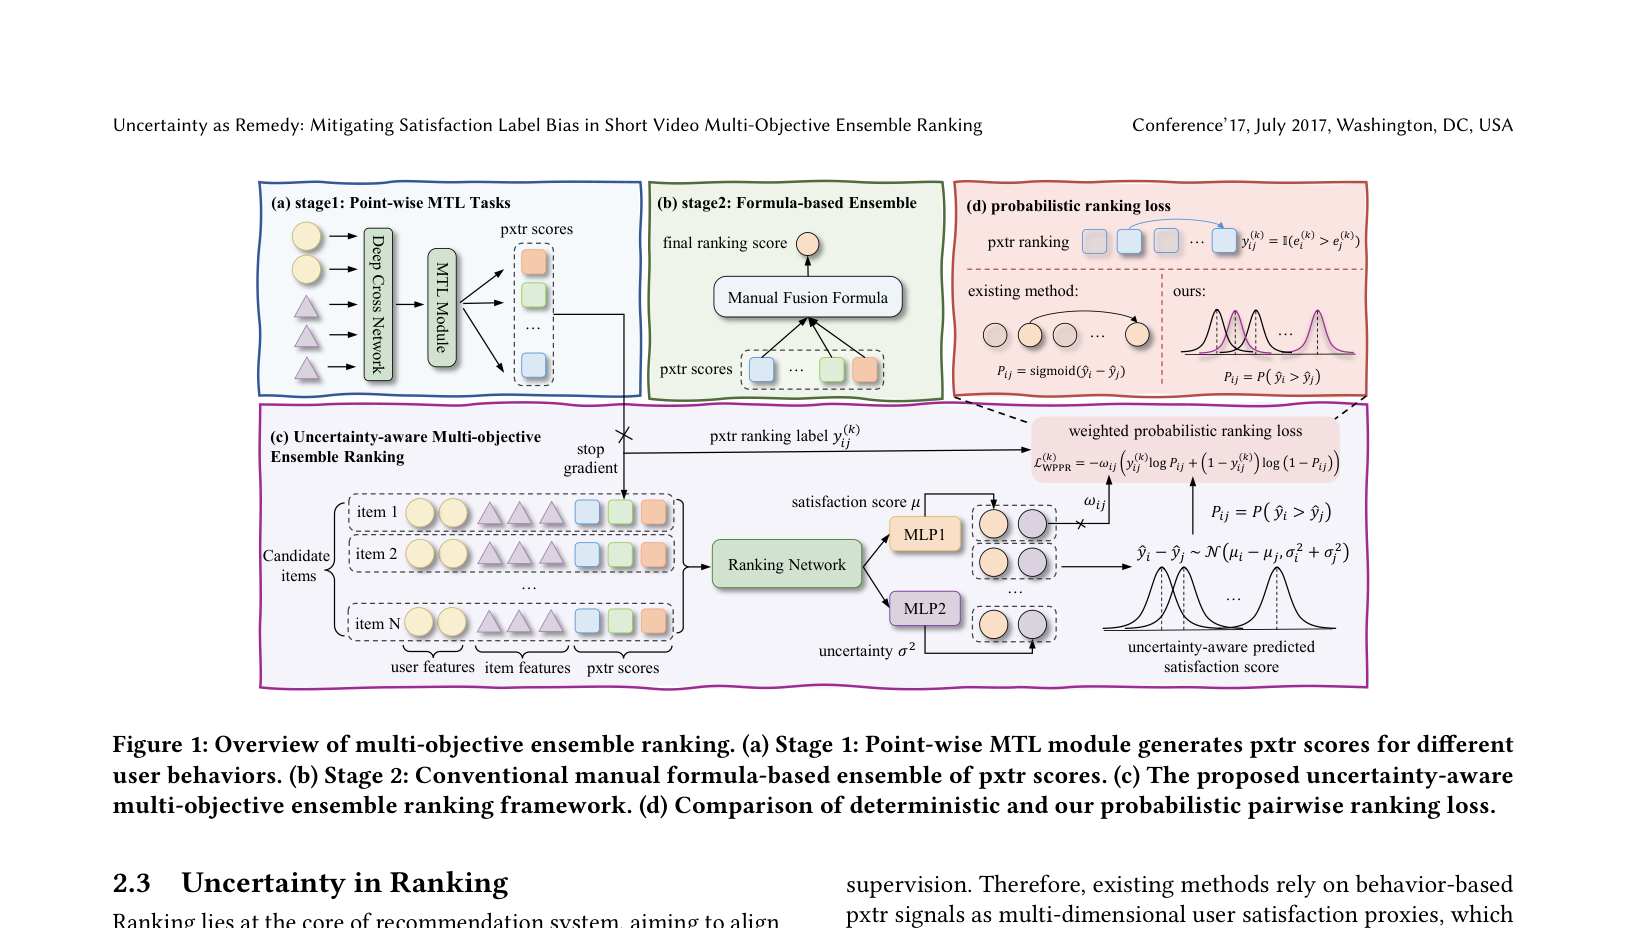
传统端到端多目标集成排序方法对每个候选 item 只输出单个标量排序分,不量化预测不确定性。为突破这一限制,UAME 设计了一个权重共享的双分支输出层(two-branch output layer) 的不确定性感知排序架构(见 Figure 1c)。
如 Figure 1c 所示,模型输入用户特征、item 特征和 pxtr 分数,送入骨干排序网络(backbone ranking network)。两个输出分支完全共享来自骨干网络的精炼特征表示,然后各自通过一个独立的轻量两层 MLP 产出各自输出:
- 打分分支(score branch):输出模型预测的满意度分数 $\mu_i$;
- 不确定性分支(uncertainty branch):输出预测不确定性 $\sigma_i^2$。
基于这两个输出,把第 $i$ 个候选 item $v_i$ 的不确定性感知打分变量(uncertainty-aware scoring variable) $\hat{y}_i$ 建模为高斯:
$$\hat{y}_i = \mu_i + \sigma_i \epsilon_i, \quad \epsilon_i \sim \mathcal{N}(0,1) \tag{1}$$
其中 $\mu_i$ 是预测满意度分数,$\sigma_i^2$ 控制与该分数关联的预测不确定性。这一步把原本确定性的标量分数升格为一个高斯随机变量,用方差显式承载"这个预测有多可信"的信息。
3.3 概率化 Pairwise Loss¶
3.3.1 概率化排序(Probabilistic Ranking)¶
对候选 item pair $(v_i, v_j)$,排序任务的核心是建模 $v_i$ 应排在 $v_j$ 之前的概率。定义 pairwise 排序概率 $P_{i,j}$:
$$P_{i,j} = P(\hat{y}_i > \hat{y}_j) \tag{2}$$
其中 $\hat{y}_i, \hat{y}_j$ 分别是 $v_i, v_j$ 的不确定性感知打分变量。为可解性,假设 $\hat{y}_i$ 与 $\hat{y}_j$ 条件独立。基于式 (1),pairwise 分数差 $z = \hat{y}_i - \hat{y}_j$ 服从高斯 $z \sim \mathcal{N}(\mu_i - \mu_j, \sigma_i^2 + \sigma_j^2)$。于是 $v_i$ 应排在 $v_j$ 之前的解析概率就是标准高斯的累积分布函数(CDF):
$$P(\hat{y}_i > \hat{y}_j) = P(z > 0) = \Phi\left(\frac{\mu_i - \mu_j}{\sqrt{\sigma_i^2 + \sigma_j^2}}\right) \tag{3}$$
其中 $\Phi(\cdot)$ 是标准高斯的 CDF。这个式子的物理含义:排序置信度不仅取决于两 item 的均值差 $\mu_i - \mu_j$,还被两者的不确定性之和 $\sigma_i^2 + \sigma_j^2$ 归一化——当不确定性大时,即使均值差不小,排序概率也会被拉回 0.5 附近(更不确定)。这对比了确定性方法(图 1d 中 $P_{i,j} = \text{sigmoid}(\hat{y}_i - \hat{y}_j)$)与本文的概率化方法(用高斯 CDF)。
3.3.2 概率化 Pairwise 排序损失(PPR Loss)¶
基于式 (3) 的排序关系,对所有有效 item pair 集合 $\mathcal{D}$,构造第 $k$ 个 pxtr 信号的概率化 pairwise 排序(PPR)损失:
$$\mathcal{L}_{\text{PPR}}^{(k)} = -\sum_{(i,j)\in\mathcal{D}} \left[ y_{ij}^{(k)}\cdot\log\big(P(\hat{y}_i > \hat{y}_j)\big) + (1 - y_{ij}^{(k)})\cdot\log\big(1 - P(\hat{y}_i > \hat{y}_j)\big) \right] \tag{4}$$
其中 $y_{ij}^{(k)} \in \{0,1\}$ 是第 $k$ 个 pxtr 的 pairwise 排序标签($v_i$ 排在 $v_j$ 前为 1,否则 0)。
优化动态解读:当模型正确预测某 item pair 的排序(即 $\mu_i > \mu_j$ 且 $y_{ij}^{(k)}=1$)时,模型倾向于增大均值间隔 $\mu_i - \mu_j$、减小 $\sigma_i^2$ 与 $\sigma_j^2$,从而拉大 $\frac{\mu_i - \mu_j}{\sqrt{\sigma_i^2+\sigma_j^2}}$、使 $P(\hat{y}_i > \hat{y}_j)$ 趋近 1、降低损失、增强正确排序决策的置信度。反之,当模型需要把均值调向正确顺序时,会增大 $\sigma_i^2$ 与 $\sigma_j^2$ 来减小该比值的绝对值,使预测更"不确定"——即模型对没把握的 pair 主动表达高不确定。
退化风险与正则:上述机制引入一个潜在风险——模型可能走捷径,把所有 item 的 $\sigma_i^2$ 无限增大以规避学习 $\mu_i$ 的正确排序,导致退化。为防止,引入不确定性正则项 [11],惩罚过大的不确定性、引导模型维持合理且有判别力的不确定性分布:
$$\mathcal{L}_{\text{reg}} = \sum_{(i,j)\in\mathcal{D}} \log(1 + \sigma_i^2 + \sigma_j^2) \tag{5}$$
3.3.3 辅助约束损失(Auxiliary Constraint Loss)¶
虽然 PPR 损失能联合优化满意度分数与不确定性,但学到的不确定性只被隐式监督,可能无法显式反映 pxtr 冲突。为让学到的不确定性更显式地刻画跨 pxtr 信号的冲突水平,引入辅助约束损失,强制模型的不确定性输出与 item 冲突水平对齐。
具体地,对每个候选 item,用它在多个 pxtr 信号上排序位置的标准差量化其冲突水平。基于此,构造一个 pairwise 训练集 $\mathcal{B}_{aux}^+$,仅由"item $v_i$ 的冲突显著高于 item $v_j$"的 item pair $(i,j)$ 组成。采用 pairwise logistic 损失构造辅助约束损失:
$$\mathcal{L}_{aux} = -\sum_{(i,j)\in\mathcal{B}_{aux}^+} \log\big(P(\sigma_i^2 \rhd \sigma_j^2)\big) = -\sum_{(i,j)\in\mathcal{B}_{aux}^+} \log\big(\text{sigmoid}(\sigma_i^2 - \sigma_j^2)\big) \tag{6}$$
其中 $P(\sigma_i^2 \rhd \sigma_j^2)$ 表示 item $v_i$ 的不确定性高于 $v_j$ 的概率。物理含义:冲突高的 item 应当被赋予更高的不确定性,辅助损失把这一先验显式注入训练。
3.4 不确定性感知自适应加权¶
3.4.1 Pairwise 综合不确定性¶
在端到端多目标集成排序中,item pair 的信息量并不均等。在所有 pxtr 信号上排序一致的 pair 相对容易优化(相对顺序基本无歧义);而排序矛盾的 pair 更具信息量,因为它们的相对顺序直接影响最终排序质量。然而常规 pairwise 排序不捕捉这种异质性——它对所有 pair 赋等权,可能过度强调容易 pair、欠强调对多目标排序更重要的 pair。
如原文 Figure 2 所示(该图为矢量插图,未被图表抽取覆盖):Figure 2a 展示不同候选 item 在异质 pxtr 上的排序不一致;Figure 2b 可视化对应的优化梯度与预测满意度分布。排序一致的 item(如 $I_A$、$I_C$)呈现对齐、锐利的分布(低不确定);排序严重冲突的 item(如 $I_B$)受矛盾梯度作用,呈现高不确定、宽的分布。利用这一性质,作者用预测不确定性直接量化每个 item 的 pxtr 冲突水平。对 item pair $(v_i, v_j)$,进一步定义 pairwise 综合不确定性(pairwise comprehensive uncertainty) 为两者预测不确定性之和:
$$U_{ij} = \sigma_i^2 + \sigma_j^2 \tag{7}$$
3.4.2 自适应加权(Adaptive Weighting)¶
为避免权重分布导致的训练不稳定,先对当前候选集中所有 item pair 的综合不确定性做 max-min 归一化,把 pairwise 不确定性映射到 $[0,1]$;再用缩放因子 $\gamma$ 缩放归一化权重,确保高不确定 pair 获得适当增强的权重,同时维持多目标联合训练的稳定收敛。item pair $(v_i, v_j)$ 的自适应权重 $\omega_{ij}$:
$$\omega_{ij} = \gamma \times \frac{U_{ij} - \min(U)}{\max(U) - \min(U)} \tag{8}$$
其中 $\gamma$ 是缩放因子,$\min(U)$、$\max(U)$ 分别是当前训练 batch 内所有 item pair 综合不确定性的最小、最大值。
把样本级权重 $\omega_{ij}$ 整合进 PPR 损失,并进一步结合辅助约束损失与不确定性正则项,构成最终损失:
$$\mathcal{L}_{\text{final}} = \sum_{k=1}^K \mathcal{L}_{\text{WPPR}}^{(k)} + \alpha\cdot\mathcal{L}_{\text{reg}} + \beta\cdot\mathcal{L}_{aux} \tag{9}$$
其中 $\mathcal{L}_{\text{WPPR}}^{(k)}$ 是第 $k$ 个 pxtr 信号的加权概率化 pairwise 排序损失(Weighted PPR, WPPR):
$$\mathcal{L}_{\text{WPPR}}^{(k)} = -\sum_{(i,j)\in\mathcal{D}} \omega_{ij}\cdot\left[ y_{ij}^{(k)}\cdot\log\big(P(\hat{y}_i > \hat{y}_j)\big) + (1 - y_{ij}^{(k)})\cdot\log\big(1 - P(\hat{y}_i > \hat{y}_j)\big) \right] \tag{10}$$
其中 $K$ 是 pxtr 信号数,$\alpha > 0$ 是调节不确定性正则强度的超参,$\beta > 0$ 平衡加权排序损失与辅助约束损失的优化权衡。
3.5 理论分析¶
作者从排序风险与代理偏差(ranking risk and proxy bias) 的角度刻画满意度标签偏差,进而建立"样本级标签偏差 ↔ pxtr 冲突 ↔ 不确定性"三者的联系,论证"用不确定性作自适应样本权重"是把加权代理风险更好对齐到真实排序风险的合理做法。
3.5.1 排序风险分解¶
多目标集成排序模型的终极目标是最小化真实 item pair 分布 $\mathcal{P}$ 上、关于真实满意度 $s$ 的真实总体风险(true population risk):
$$R(f) = \mathbb{E}_{(i,j)\sim\mathcal{P}}\left[\ell\big(P_{ij}, y_{ij}^*\big)\right] \tag{11}$$
其中 $\ell(\cdot)$ 是 pairwise 排序损失。现有端到端方法只优化代理风险(proxy risk) $R_{proxy}(f)$,即 $K$ 个 pxtr 标签上的平均损失:
$$R_{proxy}(f) = \mathbb{E}_{(i,j)\sim\mathcal{P}}\left[\hat{\ell}_{ij}\right], \quad \hat{\ell}_{ij} = \frac{1}{K}\sum_{k=1}^K \ell\big(P_{ij}, y_{ij}^{(k)}\big) \tag{12}$$
由期望的线性性,真实总体风险可分解为:
$$R(f) = R_{proxy}(f) + \Delta_{proxy} \tag{13}$$
其中 $\Delta_{proxy} = \mathbb{E}_{(i,j)\sim\mathcal{P}}\left[\ell\big(P_{ij}, y_{ij}^*\big) - \hat{\ell}_{ij}\right]$ 是整体固有的用户满意度标签偏差(proxy bias)。式 (13) 揭示现有方法的核心局限:它们最小化 $R_{proxy}(f)$,却忽略了样本级 proxy bias 的异质性 $\Delta_{ij} = \ell(P_{ij}, y_{ij}^*) - \hat{\ell}_{ij}$。高偏差 item(含冲突 pxtr 排序标签)会不成比例地影响优化结果,却被赋予与低偏差 item 相同的权重,导致与真实满意度失配。
3.5.2 从代理偏差到预测不确定性¶
为建立样本级代理偏差与预测不确定性的联系,先分析代理偏差如何源自异质 pxtr 信号间的冲突。
假设 1:当 $p \in [\varepsilon, 1-\varepsilon]$($\varepsilon$ 为小常数)时,损失 $\ell(p,y)$ 关于软标签 $y$ 是 $L$-Lipschitz 连续的。
引理 3.1:样本级代理偏差满足
$$|\Delta_{ij}| = \left|\log\frac{1 - P_{ij}}{P_{ij}}\right|\cdot\left|y_{ij}^* - \frac{1}{K}\sum_{k=1}^K y_{ij}^{(k)}\right| \le L\cdot\left|y_{ij}^* - \frac{1}{K}\sum_{k=1}^K y_{ij}^{(k)}\right| \tag{14}$$
其中 $L = \left|\log\frac{1-\varepsilon}{\varepsilon}\right|$。引理 3.1 表明样本级代理偏差与"真实满意度标签 $y_{ij}^*$ 和平均 pxtr 标签 $\frac{1}{K}\sum_k y_{ij}^{(k)}$ 的失配程度"直接成正比。
假设 2:在式 (4) 的 PPR 损失优化下,item pair $(v_i,v_j)$ 的综合不确定性 $U_{ij}$ 在期望意义下与其 pxtr 冲突水平正相关。该假设与 PPR 的优化行为一致:低冲突 pair 得到一致监督,能以稳定的均值差、小方差拟合;高冲突 pair 施加矛盾的排序约束,因而倾向诱导更大的不确定性。故用综合不确定性 $U_{ij}$ 表征 pxtr 冲突。
命题 3.2:在假设 1–2 下,样本级代理偏差 $|\Delta_{ij}|$ 与 pairwise 综合不确定性 $U_{ij}$ 通过它们对 pxtr 冲突的共同依赖,在期望意义下正相关。
3.5.3 不确定性感知加权的合理性¶
从加权经验风险最小化(Weighted ERM, WERM)视角,定义加权代理风险:
$$R_w(f) = \frac{1}{|\mathcal{D}|}\sum_{(i,j)\in\mathcal{D}} \omega_{ij}\cdot\hat{\ell}_{ij}(f) \tag{15}$$
命题 3.2 表明不确定性 $U_{ij}$ 与代理偏差幅度 $|\Delta_{ij}|$ 期望正相关。因此,用不确定性作样本权重会驱使 WERM 把更多优化重点放到更可能承载大偏差的 item pair 上 [24,28]。从这个意义上,不确定性感知加权把优化聚焦到高偏差 pair,相比均匀加权可能取得与真实排序风险更好的对齐。附录 A 给出 §3.5.1–3.5.3 的完整证明(风险分解、引理 3.1、命题 3.2 的证明草图,通过定义冲突水平 $C_{ij}$、并论证 $g_\Delta(c)$ 与 $g_U(c)$ 都是同一冲突变量 $C_{ij}$ 的非减函数,从而建立二者的期望级关联)。
训练与服务流程(Algorithm 1)¶
离线训练阶段:对每个训练 batch,(1) 用骨干排序网络编码 user/context/item 特征与 pxtr 分数;(2) 对每个候选 item 预测满意度 $\mu_i$ 和 log 方差 $\log\sigma_i^2$,由 $\log\sigma_i^2$ 得 $\sigma_i^2$;(3) 对每个有效 item pair 计算 $P_{ij} = \Phi\big((\mu_i - \mu_j)/\sqrt{\sigma_i^2+\sigma_j^2}\big)$、综合不确定性 $U_{ij} = \sigma_i^2 + \sigma_j^2$;(4) 归一化 $\{U_{ij}\}$ 得权重 $\omega_{ij} = \gamma\cdot\frac{U_{ij}-\min(U)}{\max(U)-\min(U)+\epsilon}$;(5) 依次计算 $\mathcal{L}_{\text{WPPR}}$(式 4/10)、$\mathcal{L}_{\text{reg}}$(式 5)、$\mathcal{L}_{aux}$(式 6),优化 $\mathcal{L}_{\text{final}} = \sum_k \mathcal{L}_{\text{WPPR}}^{(k)} + \alpha\mathcal{L}_{\text{reg}} + \beta\mathcal{L}_{aux}$。
在线服务阶段:对每个线上请求,用骨干网络编码候选 item,仅预测满意度分数 $\mu_i$、按 $\mu_i$ 排序返回最终列表。不确定性 $\sigma_i^2$ 不参与线上排序打分。因此 UAME 相比对应骨干模型不引入额外的线上推理延迟,线上服务路径与原始端到端集成排序骨干一致,只是用训练好的 $\mu_i$ 分支做最终打分——这使 UAME 兼容既有工业服务系统、无需改动线上排序管线。为数值稳定,不确定性分支输出 log 方差 $\log\sigma_i^2$(再指数化保证非负),并在不确定性归一化和概率相关计算的分母加小常数 $\epsilon$,避免除零/溢出/未定义对数。
实验设置¶
在数亿 DAU 的大规模工业短视频推荐平台上做离线 + 在线实验,回答 4 个研究问题:
- RQ1:UAME 能否在不同骨干和 pxtr 目标上一致改进多目标排序?
- RQ2:UAME 能否泛化到线上真实的用户满意度相关指标?
- RQ3:不确定性相关组件与超参如何影响 UAME 的有效性?
- RQ4:学到的不确定性是否反映满意度标签偏差、改善与用户满意度的对齐?
数据集:全部实验在真实工业短视频平台采集的数据集上进行。
评估指标:主指标采用 GAUC(user Group AUC),比全局 AUC 更贴合个性化排序目标,能更准确衡量模型拟合每个用户个性化偏好的能力:
$$\text{GAUC} = \frac{\sum_i^{\#user} \#\text{impression}_{u_i}\cdot\text{AUC}_{u_i}}{\sum_i \#\text{impression}_{u_i}} \tag{16}$$
即以曝光数为权重对各用户 AUC 加权平均。评估覆盖 8 个核心工业 pxtr:pctr(click)、pvtr(watch-time)、plvtr(long-view)、pcpr(complete-view)、pltr(like)、pwtr(follow)、pcmtr(comment)、pftr(share)。
两个骨干(backbone)范式:
- EMER [7]:广泛部署的工业端到端集成排序方法;
- EASQ [16]:引入显式用户问卷满意度反馈作为高质量排序监督的满意度对齐排序方法。
四个 baseline(在两个骨干上分别对比):
- Base Model:EMER / EASQ 骨干,不含本文的不确定性感知组件;
- RankDist [27]:通过预测方差建模不确定性,但只在推理阶段用它调整排序分(post-hoc);
- EBRank [38]:用经验贝叶斯建模预测不确定性,并用置信上界(UCB)做探索;
- ANSL [6]:按样本排序损失的幅度自动给样本分配优化权重(纯 loss-magnitude 加权,不用不确定性)。
这些 baseline 对应不同设置:仅在推理时用不确定性(RankDist、EBRank)、或不用不确定性只做样本加权(ANSL)——用以凸显"在训练中用不确定性作样本级权重"的价值。
实现细节:所有方法在相同数据划分、特征设置、评估协议下评估;每个 baseline 在验证集上独立调其关键超参以取得强配置。本文方法中,user/item embedding 尺寸固定为 32,pxtr embedding 维度固定为 8;训练用 Adagrad 优化器在打乱样本上进行,学习率 0.001;式 (9) 中损失权重 $\alpha = 0.02$、$\beta = 0.1$,权重缩放因子 $\gamma = 2$。更多实现与部署细节见附录 B。
主要实验结果¶
整体性能(RQ1)¶
Table 1 给出 UAME 与 baseline 在 EMER、EASQ 两个骨干上、8 个工业 pxtr 上的离线 GAUC 对比(加粗为最优、下划线为次优)。
Table 1: 两个骨干上的性能对比(GAUC)
| Backbone | Method | pctr | pvtr | plvtr | pcpr | pltr | pwtr | pcmtr | pftr |
|---|---|---|---|---|---|---|---|---|---|
| EMER [7] | Base Model | 0.706 | 0.667 | 0.731 | 0.640 | 0.688 | 0.684 | 0.686 | 0.706 |
| RankDist [27] | 0.700 | 0.663 | 0.729 | 0.649 | 0.690 | 0.677 | 0.678 | 0.689 | |
| EBRank [38] | 0.686 | 0.687 | 0.714 | 0.623 | 0.696 | 0.707 | 0.697 | 0.701 | |
| ANSL [6] | 0.666 | 0.715 | 0.670 | 0.642 | 0.669 | 0.709 | 0.599 | 0.692 | |
| UAME | 0.715 | 0.699 | 0.735 | 0.657 | 0.712 | 0.724 | 0.711 | 0.719 | |
| EASQ [16] | Base Model | 0.672 | 0.598 | 0.668 | 0.631 | 0.682 | 0.661 | 0.703 | 0.666 |
| RankDist [27] | 0.707 | 0.578 | 0.700 | 0.673 | 0.673 | 0.656 | 0.685 | 0.650 | |
| EBRank [38] | 0.693 | 0.634 | 0.689 | 0.679 | 0.675 | 0.650 | 0.669 | 0.655 | |
| ANSL [6] | 0.670 | 0.636 | 0.677 | 0.632 | 0.712 | 0.666 | 0.683 | 0.656 | |
| UAME | 0.734 | 0.669 | 0.763 | 0.686 | 0.684 | 0.675 | 0.695 | 0.678 |
核心结论:
-
两骨干上一致改进:UAME 在 EMER 与 EASQ 上都实现整体提升,在大多数 pxtr 指标上取得一致收益。跨两个结构不同骨干的一致增益,证明本框架的强泛化性——可轻松嵌入主流工业多目标集成排序模型、无需改动核心骨干结构。
-
一致超越原始骨干:对 EMER,UAME 在核心业务指标上带来最高 5.8% 的相对提升(如 pwtr 从 0.684 → 0.724,+5.85%);对 EASQ 提升更显著,plvtr 最高 14.2% 相对增益(0.668 → 0.763,+14.2%),pcptr(pcpr) 提升 9.2%(0.631 → 0.686,+8.7%)。
-
与 baseline 对比验证核心设计:RankDist 与 EBRank 只在推理阶段用不确定性调分,只在少数指标上取得部分改进——说明后处理没有充分挖掘不确定性的价值;ANSL 纯按 loss 幅度加权,在若干关键指标上反而掉点(如 EMER 上 pcmtr 0.686 → 0.599)——说明泛化的样本"难度"不足以刻画多目标集成排序中的标签偏差。相比之下,UAME 通过不确定性刻画的标签偏差优先高不确定 pair,在不牺牲主要目标的前提下取得更稳定的整体性能。
线上 A/B 测试(RQ2)¶
在工业短视频平台做 7 天线上 A/B,两组并行测试验证 UAME 跨两个 SOTA 骨干(EMER、EASQ)的泛化。每组独立分配 5% 主 feed 流量以获得统计功效。第一组以全量部署的线上 EMER 为对照、实验组用 EMER + UAME;第二组以用户满意度对齐的 EASQ 为对照、实验组用 EASQ + UAME。评估覆盖长期留存(LT7)、隐式消费行为(App 停留时长、观看时长、视频观看数)、显式正向交互(Like、follow、forward、comment)。
Table 2: 线上 A/B 性能对比(vs Base Method,p 值均 < 0.005)
| Metrics | vs EMER | vs EASQ |
|---|---|---|
| LT7 | +0.009% | +0.015% |
| AppStayTime | +0.050% | +0.074% |
| WatchTime | +0.030% | +0.221% |
| VideoView | +0.536% | +0.373% |
| LongView | +1.614% | +1.126% |
| Like | +0.939% | +1.349% |
| Follow | +0.641% | +1.299% |
| Forward | +1.325% | +1.598% |
| Comment | +0.679% | +0.642% |
UAME 在两组、所有指标上都取得统计显著提升,其中长视频观看(LongView)与主动交互行为(Like/Follow/Forward/Comment)增益最突出。尽管部分绝对增益数值较小,这在成熟的大规模推荐系统中常见——收益通常是跨多个关键指标的、增量但一致的。这些一致增益表明 UAME 有效缓解了满意度标签偏差、把模型优化对齐到真实用户满意度。
超参与消融分析(RQ3)¶
在 EMER 骨干上分析三个关键组件:正则系数 $\alpha$、辅助损失系数 $\beta$、不确定性归一化缩放因子 $\gamma$。
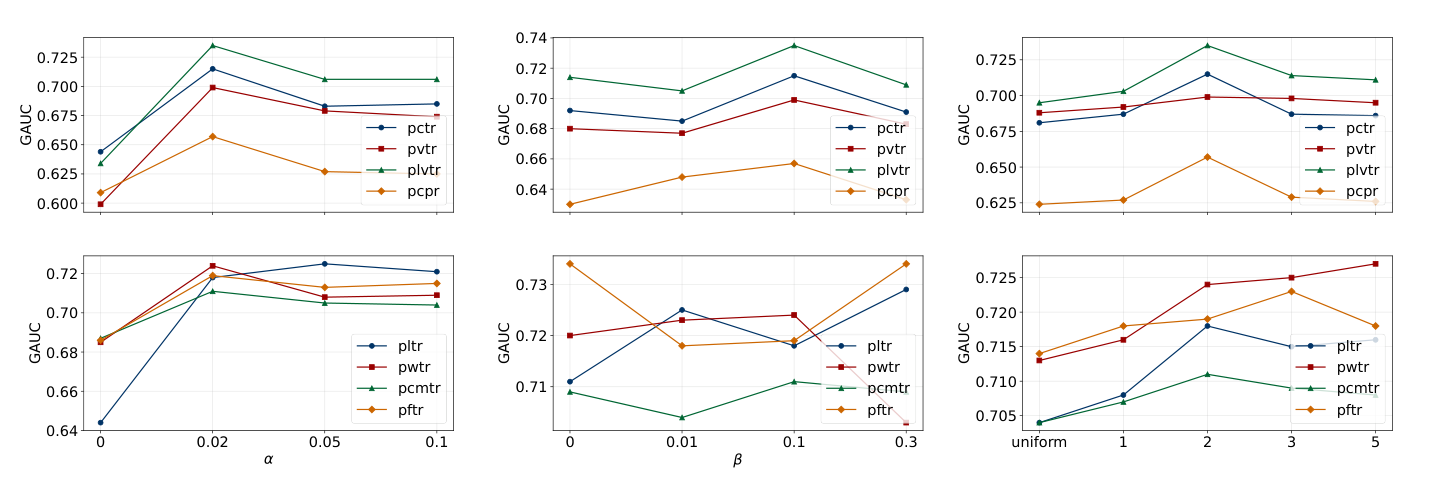
- 正则系数 $\alpha$(测 $\{0, 0.02, 0.05, 0.1\}$):性能随 $\alpha$ 增大先升后降,$\alpha = 0.02$ 最优。过小的 $\alpha$ 无法正确正则化不确定性;过大的 $\alpha$ 过度压制不确定性的判别力、削弱自适应加权机制。
- 辅助损失系数 $\beta$(测 $\{0, 0.01, 0.1, 0.3\}$):$\beta = 0.1$ 最优。$\beta$ 过小导致不确定性与真实多目标 pxtr 冲突水平的对齐不足;$\beta$ 过大使辅助损失主导训练、损害主排序任务。
- 不确定性缩放因子 $\gamma$:$\gamma = 2$ 最优。$\gamma$ 过小限制高不确定 pair 的增强;过大导致极端权重分布、优化不稳定。
消融研究:$\alpha = 0$(Figure 3a)消融不确定性正则、$\beta = 0$(Figure 3b)消融辅助约束损失、uniform 设置(Figure 3c,$\omega_{ij} = 1$)消融不确定性感知加权。整体上,移除任一组件都导致性能下降,证明这些组件都对 UAME 的有效性有贡献。
进一步分析(RQ4)¶
用 EASQ 上的问卷式用户满意度信号进一步分析,研究两个互补问题:(i) UAME 是否改善与用户满意度的对齐;(ii) 学到的不确定性是否捕捉满意度标签偏差。
(1) 真实用户满意度建模性能:用 EASQ 中的问卷信号作近似 ground-truth,严格按实验设置、用 NDCG、Hit Ratio(HR)、MRR 衡量排序质量。
Table 3: EASQ 骨干上的用户满意度建模性能
| Metrics | EASQ | UAME | Improvement ↑ |
|---|---|---|---|
| NDCG@5 | 0.3753 | 0.4080 | +8.71% |
| NDCG@10 | 0.3872 | 0.4160 | +7.44% |
| HR@1 | 0.4846 | 0.5312 | +9.62% |
| HR@5 | 0.8192 | 0.9063 | +10.63% |
| HR@10 | 0.8979 | 0.9421 | +4.92% |
| MRR | 0.6145 | 0.6675 | +8.62% |
UAME 在所有指标上一致超越 EASQ,最高相对提升为 NDCG@5 的 8.71%、HR@5 的 10.63%(top-ranking 质量的核心指标)。这表明 UAME 改善了排序质量与用户满意度的对齐——超越了仅在满意度代理上优化的范畴。
(2) 不确定性与满意度标签偏差的关系:由于工业系统中真实满意度不可观测,直接评估标签偏差困难;EASQ 的问卷反馈提供了对用户满意度的可靠近似,可构造标签偏差度量,量化"平均 pxtr 排序"与"问卷近似 ground-truth 排序"的不一致。作者在 300 万样本上研究学到的不确定性与构造的标签偏差的关系:观察到正相关,Pearson 相关系数 0.65、Spearman 相关系数 0.67。这与命题 3.2 的直觉一致,为假设 2 提供了经验支持。
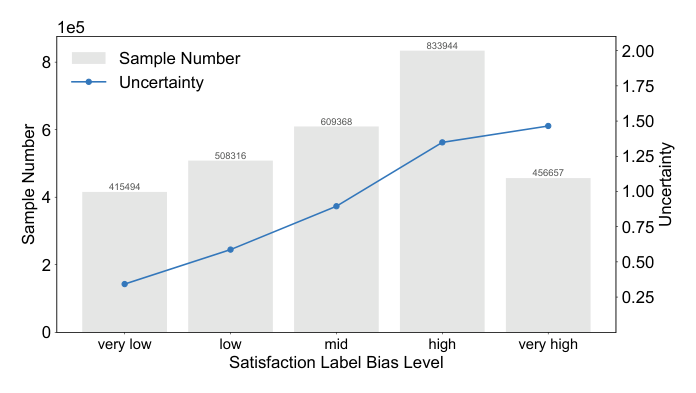
桶级可视化(附录 C, Figure 4):按 pairwise 标签偏差 $B_{ij} = \big|y_{ij}^{q*} - \frac{1}{K}\sum_k y_{ij}^{(k)}\big|$($y_{ij}^{q*}$ 为问卷式 pairwise 满意度标签)把 item pair 分成 very low → very high 五个桶。灰色柱为各桶样本数、蓝色曲线为桶内平均 pairwise 不确定性。不确定性随满意度标签偏差单调递增——直观印证了标签偏差与不确定性的正向关系,与 §4.5.2 报告的相关系数一致。
核心贡献总结¶
- 首次把不确定性作为"纠偏工具"嵌入端到端多目标集成排序的核心优化管线,而非像已有工作那样仅用于推理阶段的后处理排序调整——把预测建模为高斯打分变量(均值=满意度,方差=不确定性),用概率化 pairwise 排序损失(高斯 CDF 替代 sigmoid)承载不确定性。
- 不确定性感知的样本级自适应加权:用 pairwise 综合不确定性 $U_{ij} = \sigma_i^2 + \sigma_j^2$ 量化 pxtr 冲突,归一化后作样本权重上调高冲突 pair,配合辅助约束损失(显式监督不确定性对齐冲突)和不确定性正则(防退化)。
- 理论支撑:通过排序风险分解 $R = R_{proxy} + \Delta_{proxy}$、引理 3.1、命题 3.2,论证样本级代理偏差 $|\Delta_{ij}|$ 与综合不确定性 $U_{ij}$ 通过对 pxtr 冲突的共同依赖而期望正相关,从而"用不确定性作样本权重"是把加权代理风险对齐真实排序风险的合理做法。
- 工业价值:在两个 SOTA 骨干(EMER/EASQ)上一致改进,离线 GAUC 最高 +14.2%、问卷满意度 NDCG@5 +8.71%,线上 A/B 全指标统计显著提升;线上仅用均值分支打分、零额外推理延迟,已在数亿 DAU 短视频系统全量部署并持续带来稳定显著收益。
与已归档相关工作的对比¶
HeteGenCTR HeteGenCTR: Self-Balancing Gradient Allocation for Heterogeneity-Aware Feature Generation in CTR(Alibaba Group, 2026-05-24)¶
关系:独立并发(本文未引用 HeteGenCTR,两者殊途同归、且恰好落在本文明确划清界限的对比轴上)· 已加载对方精读
- 共同关注的问题:两篇论文的 root cause 都指向"异质监督信号的不均衡/冲突会让等权损失把训练梯度偏向易学部分,欠优化真正关键的部分"。UAME 面对的是样本级满意度标签偏差——多个行为 pxtr(click/watch/like/...)作为满意度代理彼此矛盾、等权损失让排序一致的样本主导更新、高冲突样本欠优化;HeteGenCTR 面对的是特征域级生成难度不均衡——离散扩散生成式 CTR 里易重建的低基数特征域早收敛却持续贡献大梯度、高信号的 ID/序列域长期欠拟合。
- 相近的技术骨架:两者都调用同一套 Kendall 不确定性加权数学([10,11]):把不确定性建模为高斯方差、用 $1/\sigma^2$(等价 $\exp(-s)$,$s = \log\sigma^2$)作损失权重、用对数方差重参数化保证数值稳定和权重正定,并配一个正则项(HeteGenCTR 是 $s^i/2$ 项、UAME 是 $\log(1+\sigma^2)$ 项)防止 $\sigma \to \infty$ 平凡退化。两者都能从一个可学的不确定性信号自动再分配梯度预算。
- 本文的差异与推进:加权粒度是决定性差异,也正是 UAME 在 §2.2 明确用来与 MTL 不确定性加权划清界限的那一条轴——UAME 用的是样本级/pair 级的偶然(aleatoric)、输入依赖的异方差不确定性 $\sigma_i^2$(每个 item 一个、由 MLP 从输入预测、随 pair 变化),驱动权重的是"高冲突则高不确定则高权重";HeteGenCTR 用的是任务级/特征域级的同方差(homoscedastic)、输入无关的不确定性 $\sigma_i$(每个特征域一个标量、与具体样本无关),驱动权重的是"难重建域降权、易域也降权直到均衡"。方向甚至相反:HeteGenCTR 的 $1/\sigma^2$ 让高不确定域降权以做梯度均衡;UAME 归一化后的 $U_{ij}$ 让高不确定 pair 升权以聚焦高偏差样本。UAME 还额外做了两件 HeteGenCTR 没做的事——把不确定性接进概率化 pairwise 排序(高斯 CDF 排序概率),并给出"不确定性↔代理偏差"的排序风险分解式理论。
- 可比的方法/实验差异:任务场景不同(UAME=短视频端到端多目标集成排序 / HeteGenCTR=离散扩散生成式 CTR 预训练),指标不可直接对齐(UAME 报 GAUC/NDCG/HR、HeteGenCTR 报 AUC/LogLoss)。两篇都是 2026 年工业界论文、都做了 7 天线上 A/B(UAME +LongView 1.6%、+Like 0.94%;HeteGenCTR +CTR 4.7%、冷启 +9.2%),都强调"不引入超出 baseline 的额外服务成本/超参"(UAME 线上仅均值分支零延迟、HeteGenCTR 仅加 $N$ 个标量参数)。二者共同印证:Kendall 式不确定性加权在推荐工业界正被独立地迁移到不同粒度(样本级排序 vs 特征域级生成)以对抗"等权聚合放大异质信号偏差"这一共性顽疾。
讨论与局限性¶
核心贡献与借鉴价值。UAME 最有价值的贡献是一个范式转变:把不确定性从推荐排序里长期扮演的"后处理调分辅助信号"角色,改造为"内嵌进核心优化管线、直接纠正标签偏差的驱动力"。这一改造建立在一个可验证的经验规律上——多目标冲突越强的样本,其预测不确定性越大、代理标签偏差也越大(本文实测 Pearson 0.65 / Spearman 0.67,并给出理论分解支撑)。工程上尤其值得借鉴的是训练-服务解耦设计:不确定性分支只在训练期用来算样本权重,线上排序只用均值分支,因此 UAME 对既有工业排序管线是"零侵入、零额外延迟"的挂件式增强,可以直接嫁接到 EMER/EASQ 这类不同骨干上——这是它能在数亿 DAU 系统全量落地的关键。概率化 pairwise 排序(用高斯 CDF 替代 sigmoid、把方差纳入排序置信度归一化)也是一个干净、可复用的构件。
局限与争议:
- 加权机制的启发式成分:$U_{ij}$ 的 max-min 归一化 + 线性缩放因子 $\gamma$ 是 batch 内的启发式,$\gamma$ 需要调(论文取 2),且归一化对 batch 组成敏感——极端 batch 里可能放大噪声。理论部分证明的是"不确定性与偏差期望正相关",而没有证明"按 $U_{ij}$ 线性加权"就是最优权重函数,加权形式本身仍是设计选择。
- 理论假设偏强:命题 3.2 依赖假设 2(PPR 优化下不确定性与 pxtr 冲突期望正相关),这是"empirically motivated"的假设而非从模型推导出的结论;引理 3.1 的 Lipschitz 假设也要求概率被 clip 在 $[\varepsilon, 1-\varepsilon]$。
- 不确定性的语义:本文把不确定性等同于"pxtr 冲突/满意度偏差",但预测方差实际上还会吸收标签噪声、数据稀疏、分布漂移等其他来源,$\sigma^2$ 未必纯粹反映满意度冲突——辅助约束损失(式 6)正是为缓解这一点而设,但它只是把"冲突高→不确定高"作为 pairwise 软约束注入,并不能完全隔离其他噪声来源。
- 收益量级:线上部分绝对指标增益偏小(LT7 仅 +0.009%/+0.015%、WatchTime +0.03%/+0.221%),交互类指标(Like/Forward)增益较大但绝对基数小;这是成熟大盘系统的常态,但"缓解满意度偏差"带来的收益主要体现在长视频/交互而非核心时长指标,其对"真实综合满意度"的实际改善程度仍主要靠问卷代理间接佐证。
- 评估依赖内部数据:全部实验在内部工业短视频数据集上进行、无公开学术数据集复现,EMER/EASQ 骨干也是工业方法,外部可复现性受限。