From Language to Behavior:给行为序列 Transformer 一套"推荐原生"的 scaling 配方(ReST,字节跳动)¶
arXiv: 2609.01240v1 · cs.IR / cs.AI / cs.LG · 2026-09-01 作者: Jie Chen, Xiangqian Yu, Yanchao Lian, Tan Lu, Run Yang, Zhengchun Shang, Xing Wang, Cheng Chen, Ke Hu, Qiang Li*, Tianjiu Yin, Xiaobing Liu(* 通讯作者) 机构: ByteDance(全部作者邮箱均为
@bytedance.com) 落地: TikTok Shop Ads 广告排序,一周线上 A/B → 已全量部署
一句话总结¶
把 LLM 的 Transformer scaling 配方直接搬到工业排序的行为序列上会很快饱和,本文把原因拆成两条——信号质量(行为 token 有噪声、时间不规则、监督稀疏且会被稠密 DLRM 分支短路)与算力不对称(一次请求里一份用户历史要对 N 个候选打分,序列侧算力可摊销、候选侧不可摊销)——并给出 ReST(Recommendation-native Scalable Transformer):编码器侧用 Dual-Gated Attention + RoPE/RoTE + Stabilized Residual Normalization 做"推荐原生"改造,架构上把排序拆成"重编码器 $T$ 算一次 + 轻量 cross decoder $C$ 每候选算一次",再用两个只在训练期存在的辅助目标缓解"序列饿死",最后配 user-level shared-prefix 训练与 request-level shared-prefix 服务把结构不对称兑现成真实算力复用。结果是在序列长度(→16k)、深度、宽度三条轴上都比 LLaMA-style / HSTU 更晚饱和,线上 A/B AUC +1.31%、Advertiser Value +11.93%($p<0.01$),50ms P99 预算内已全量上线。
一、研究动机与背景¶
1.1 推荐里的 Transformer scaling 为什么不像语言模型那样"给算力就涨"¶
Transformer 已经是语言建模的统治性 scaling 配方:加容量、加数据、加训练算力,收益稳定且持续 [13, 17, 29]。推荐排序看上去有同样的机会——用户行为序列携带的演化意图远比静态用户特征丰富,从 target-aware attention [41] 到长序列检索 [3, 23] 再到大推荐模型 [37] 都建立在这个前提上。但论文的判断是:直接把 Transformer 序列模型 scaling 到生产判别式排序上仍然很难,因为推荐与语言建模在两个根本维度上不同。
1.2 障碍一:信号质量(Signal Quality)¶
与自然语言不同,用户行为序列有三个使"朴素 scaling 统计上低效"的特性:
-
行为可靠性(Behavior reliability)。行为 token 是隐式反馈:点击和曝光可能反映稳定偏好,也可能只是误触、探索性浏览或有偏反馈 [15, 32]。标准 self-attention 用一个共享 softmax 聚合它们,没有任何显式机制去区分可靠与不可靠的行为证据。
-
时序结构(Temporal structure)。用户行为发生在不规则的物理时间上——相邻两个动作可能间隔几秒也可能间隔几天,因此相同的序号距离对应完全不同的 recency;纯序号编码不足以刻画多尺度的时间邻近性 [19]。
-
监督密度(Supervision density)。decoder-only 语言模型享有稠密的 next-token 监督,而工业排序只有稀疏、延迟的用户级/候选级标签 [4, 18]。更糟的是,在混合排序器里,主判别式损失可以被强大的非序列 DLRM 分支抄近路(shortcut)掉:即使历史里确实携带有用意图,序列模块仍然只收到很弱的监督——论文把这个现象命名为 sequence starvation(序列饿死),并指出它随序列模块规模增大而恶化。这直接解释了为什么朴素堆叠 vanilla Transformer 会迅速进入收益递减 [11]。
1.3 障碍二:目标条件排序中的算力不对称(Computation Asymmetry)¶
与语言建模不同,一次排序请求把一份用户历史与 $N$ 个候选广告配对 [7, 37]。两侧从 scaling 中获益的方式完全不同:
- 序列侧算力跨候选共享——在这里多投入算力可以被 $N$ 个候选摊销;
- 目标条件交互依赖每个候选,每请求要实例化 $N$ 次——每候选算力才是延迟瓶颈,但它同时又必须有足够容量去区分细粒度候选。
LLM 式的 decoder-only Transformer 把这两个角色塞进同一个栈,并把计算与参数耦合在一起,因而无法分别服务这两种发散的需求。要在生产延迟预算下 scaling 序列模型,就必须先打破这种对称性。
1.4 三条贡献¶
- 面向序列 scaling 的 Rec-native Transformer:识别并实证诊断混合生产排序器里的 sequence-starvation 效应;提出结合 Dual-Gated Attention(应对噪声行为)、RoPE + RoTE(应对不规则时序)、SRN(稳定深度 scaling)的推荐原生编码器,外加两个训练期辅助目标。
- 非对称架构 + 系统协同设计:利用"一份历史对多个候选"的结构,把计算分解为可复用的重序列编码器与轻量候选感知 cross decoder;projection-free KV 注意力与 token-specific 参数化在低激活 FLOPs 下保留候选侧容量,user-level shared-prefix 训练与 shared-prefix 服务把架构不对称翻译成实际算力复用。
- 大规模实证与线上部署:在大规模工业广告数据集与公开 benchmark 上取得更好的精度-效率折中,并在 LLM 式 block 饱和的地方继续沿长度/深度/宽度 scaling;一周线上 A/B 在 50ms P99 预算内 AUC +1.31%、核心营收类指标 +11.93%,随后全量部署。
二、问题形式化¶
论文聚焦大规模广告排序中的 CVR(转化率)预估,工业排序器把按时间排序的行为序列与非序列的用户/上下文特征结合 [22, 41]。
设 $\mathcal{U}$、$\mathcal{A}$ 分别为用户集与广告集。对用户 $u \in \mathcal{U}$,观察到行为序列
$$S_u = [(\mathbf{s}_1, t_1), \ldots, (\mathbf{s}_L, t_L)]$$
其中 $\mathbf{s}_i$ 是第 $i$ 次交互的特征向量,$t_i$ 是其物理时间戳;另有非序列特征 $\mathbf{u}_d$。
生产排序中,这些共享的用户侧输入与 $N$ 个候选广告 $\{a_1, \ldots, a_N\} \subseteq \mathcal{A}$ 配对。对每个候选 $a$,排序器预测
$$\hat{y} = f_\theta(S_u, \mathbf{u}_d, a) \approx P(y = 1 \mid S_u, \mathbf{u}_d, a) \tag{1}$$
其中 $y \in \{0, 1\}$ 是二元转化标签。模型以 CVR 损失训练:
$$\mathcal{L}_{ce} = \mathbb{E}_{\mathcal{D}}\big[\ell_{\text{BCE}}(\hat{y}, y)\big] \tag{2}$$
$\ell_{\text{BCE}}$ 是训练集 $\mathcal{D}$ 上的标准二元交叉熵。本文只 scaling 序列建模组件,非序列排序栈与候选打分协议保持不变——这是全文所有对比的基准约定,也是把归因锁在序列侧的关键实验设计。
三、核心方法:ReST 架构¶
3.1 总览¶
ReST 采用非对称的 encoder–decoder 架构:
- 重算力的 rec-native 序列 Transformer 编码器 $T$:对每个用户历史只跑一次,产出稳健、可复用的 memory(§3.2);
- 轻量 cross decoder $C$:从这份 memory 出发做候选特定的解码(§3.3)。
再加上两个训练期辅助目标缓解 sequence starvation(§3.4),以及 user-level shared-prefix 训练与 shared-prefix 服务(§3.5),最终实现在生产延迟预算下的 compute-once, decode-many-times 排序。
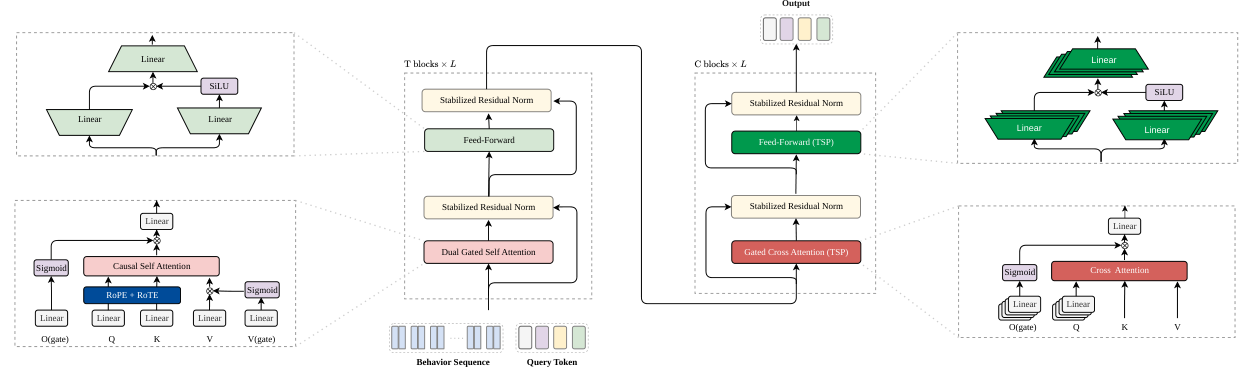
图 1 左半是编码器块:Causal Self Attention 之上加了 V(gate) 与 O(gate) 两路 Sigmoid 门,Q/K 上挂 RoPE + RoTE,注意力与 FFN 两个子层各自被 Stabilized Residual Norm 包裹;右半是 cross decoder:Query Token 只出 Q(K/V 直接取编码器输出,无投影),Gated Cross Attention 与 Feed-Forward 都带 TSP(token-specific parameterization)。
3.2 Rec-Native 序列编码器 $T$¶
起点是 LLaMA-style [29] 的 Transformer block(causal self-attention + SwiGLU [27] FFN),但针对推荐行为序列的三个特性做了三处改造。
3.2.1 Dual-Gated Attention(DGA):把去噪显式化在注意力算子两侧¶
推荐中的隐式反馈天然带噪 [32, 41]:误点、弱意图、探索性动作未必忠实反映稳定偏好。论文把这种噪声的影响拆成两个阶段:聚合前,单个行为 token 本身可能就是不可靠证据;聚合后,得到的行为上下文可能对更新表征仍然只有弱作用。因此 DGA 在注意力算子的两侧各放一个门——value gate 做聚合前过滤,output gate 做聚合后上下文调制。
给定输入序列 $\mathbf{X} \in \mathbb{R}^{L \times d}$:
$$\mathbf{H} = \text{Attention}\Big(\mathbf{X}\mathbf{W}_Q,\ \mathbf{X}\mathbf{W}_K,\ \sigma(\mathbf{X}\mathbf{W}_{gv}) \odot (\mathbf{X}\mathbf{W}_V)\Big) \tag{3}$$
$$\text{DualGatedAttn}(\mathbf{X}) = \Big(\mathbf{H} \odot \sigma(\mathbf{X}\mathbf{W}_{go})\Big)\mathbf{W}_o \tag{4}$$
其中 $\text{Attention}(\mathbf{Q}, \mathbf{K}, \mathbf{V}) = \text{softmax}\big(\mathbf{Q}\mathbf{K}^\top / \sqrt{d} + \mathbf{M}_{\text{causal}}\big)\mathbf{V}$,$\sigma$ 为 sigmoid,$\odot$ 为逐元素乘。
设计动机:$\mathbf{W}_{gv}$ 在不可靠的交互特征进入任何上下文之前先衰减它;$\mathbf{W}_{go}$ 控制聚合后的行为上下文对每个 token 表征的更新幅度。把"token 级可靠性过滤"与"上下文级调制"解耦,使模型对噪声历史更稳健,且不修改 attention softmax 本身,因而与 FlashAttention 这类高效 kernel 完全兼容。
与已有门控注意力的差别:以往门控设计(如 [14, 25, 37])主要调制聚合后的注意力输出;DGA 额外门控 value 流,在噪声行为特征进入聚合上下文之前就压制它们。另一处关键差异是门函数:HSTU 用的是无界的 SiLU 输出门 [37],本文观察到这类门在规模变大时会出现 attention-output 发散,因此改用有界的 sigmoid 门以稳定 scaling。
3.2.2 Rotary Positional and Temporal Embedding(RoPE + RoTE)¶
语言 token 在序号序列上等距分布,现代 LLM 普遍用 RoPE [28] 通过旋转编码相对序号位置,且该形式与 FlashAttention 式 kernel [8] 兼容。但用户行为活在不规则的物理时间里:相隔几秒的两次点击与相隔几天的两次点击,即便占据相邻序列位置也应被区别对待。以往时间感知推荐器用相对区间嵌入、时间偏置或分桶特征 [6, 19, 37] 编码时间,这些形式与长度外推和 rotary-friendly 高效注意力都不够对齐。
于是论文提出 RoTE:按 head 特定的时间粒度 $\tau_h$ 对离散化后的物理时间戳旋转 query 与 key,并把注意力头分成两组联合建模序号顺序与物理时间——$\mathcal{H}_{\text{pos}}$ 中的头用标准 RoPE 编码相对序号,$\mathcal{H}_{\text{time}}$ 中的头用 RoTE 编码相对时间间隔。小的 $\tau_h$(秒/分钟尺度)捕获细粒度时间邻近性,大的 $\tau_h$(天/周尺度)捕获粗粒度 recency。
对每条序列先按其起始时间平移时间戳 $\tilde{t}_i = t_i - t_1$,再定义桶索引 $b_i = \lfloor \tilde{t}_i / \tau_h \rfloor$(这一平移避免了不必要的巨大绝对桶索引,而不改变任何成对时间间隔)。对第 $h$ 个头,位置 $n$ 的 query $\mathbf{q}_h$ 与位置 $m$ 的 key $\mathbf{k}_h$ 之间的注意力分数为
$$\text{Score}_h(\mathbf{q}_h, \mathbf{k}_h) = \begin{cases} \big(\mathbf{R}_\Theta(n)\mathbf{q}_h\big)^\top \big(\mathbf{R}_\Theta(m)\mathbf{k}_h\big), & h \in \mathcal{H}_{\text{pos}} \\[4pt] \big(\mathbf{R}_\Theta(b_n)\mathbf{q}_h\big)^\top \big(\mathbf{R}_\Theta(b_m)\mathbf{k}_h\big), & h \in \mathcal{H}_{\text{time}} \end{cases} \tag{5}$$
其中 $\mathbf{R}_\Theta$ 是块对角旋转矩阵。因为位置与时间走的是同一套旋转机制,RoTE 在单个注意力算子内统一了多粒度的序号邻近性与时间邻近性,且天然兼容 FlashAttention。
工业实现细节(附录 A.2):保留一个头给 RoPE,其余头分配给 head-specific 的时间粒度 $\tau_h \in \{\text{second}, \text{minute}, \text{hour}, \text{day}, \text{week}, \text{quarter}, \text{year}\}$,让不同时间头在互补分辨率上捕获 recency——从秒/分钟级的细粒度模式到季/年级的长周期趋势。
3.2.3 Stabilized Residual Normalization(SRN):让深度真正起作用¶
纯注意力堆栈在理论上随深度偏向 token 均匀化 / 秩坍缩,尽管 skip connection 与 MLP 会缓解这种退化 [9];相关分析也把 decoder-only LLM 的 over-mixing 与表征坍缩联系到深度 [2];更一般地,训练目标本身会强烈影响 over-smoothing 与更深层的效用 [34]。而在判别式推荐排序里,序列编码器是从稀疏标签训练的,主损失甚至可以被强非序列 DLRM 特征抄近路。结果是:即便用 LLM 式的 Pre-LN 配置,直接加深 Transformer 在推荐 scaling 中往往收益有限 [11]。
SRN 用两处极小的修改解决这个深度瓶颈:其一,以 Mix-LN 式的深度相关方式调整 LN 放置 [20],调控跨层的反向梯度流;其二,给每条残差分支加一个初始化为很小值的可学习标量 [1],控制每层对前向表征的更新幅度。对第 $l$ 层($\text{SubLayer} \in \{\text{Attn}, \text{FFN}\}$):
$$\mathbf{x}_{l+1} = \begin{cases} \text{LN}\big(\mathbf{x}_l + \alpha_l \cdot \text{SubLayer}(\mathbf{x}_l)\big), & l \le L_{\text{switch}} \\[4pt] \mathbf{x}_l + \alpha_l \cdot \text{SubLayer}\big(\text{LN}(\mathbf{x}_l)\big), & l > L_{\text{switch}} \end{cases} \tag{6}$$
其中 $L_{\text{switch}}$ 约为总深度的 25%,$\alpha_l$ 初始化为 0.01。这个极小初始化让深编码器从接近恒等映射出发,残差更新只在收到足够训练信号后才逐步引入。配合深度相关的 LN 放置,这套前向/反向双重控制在"稀疏、易被抄近路"的监督下提供了更稳定的残差通路,深度 scaling 的收益因此更一致。
3.3 轻量 Cross Decoder $C$¶
$C$ 用一小组语义 query token $\{\texttt{[CLS]}, \texttt{context}, \texttt{user}, \texttt{ad}\}$ 去 attend 来自 $T$ 的可复用序列 memory。由于 $C$ 对每个候选都要跑一遍,必须在保留候选侧容量的同时把激活计算压到最小,为此有两个设计。
3.3.1 Projection-Free Key/Value(PF-KV)¶
因为 $T$ 已经产出了上下文化的 memory,$C$ 直接把 $\mathbf{H} = T(S_u)$ 同时当作 key 与 value,从而把 $\mathbf{W}_K$、$\mathbf{W}_V$ 以及 value gate $\mathbf{W}_{gv}$ 全部从"重复的候选侧计算"里移除。给定候选 query token $\mathbf{Z}$:
$$\text{CrossAttn}(\mathbf{Z}, \mathbf{H}) = \left(\text{softmax}\left(\frac{(\mathbf{Z}\mathbf{W}_Q)\mathbf{H}^\top}{\sqrt{d_h}}\right)\mathbf{H} \odot \sigma(\mathbf{Z}\mathbf{W}_{go})\right)\mathbf{W}_o \tag{7}$$
其中 $\mathbf{W}_{go}$ 是输出门投影。
3.3.2 Token-Specific Parameterization(TSP)¶
$C$ 里的各个 query token 承担不同语义角色,因此为每种 token 类型分配自己的一套参数,用于候选侧变换(cross attention 中的 $\mathbf{W}_Q$、$\mathbf{W}_{go}$,以及 FFN 子层)。对一个变换 $\mathcal{F}$,TSP 施加
$$\mathcal{F}_i(\mathbf{x}_i) = \mathcal{F}(\mathbf{x}_i; \mathbf{W}_i), \quad i = 1, \ldots, K \tag{8}$$
每个 token 只激活自己那套参数,因此解码器容量上升而激活 FLOPs 几乎不变——这正是消融表里 "+ C" 带来 +473.2% 参数却只有 +0.2% FLOPs 的来源。
3.4 面向序列 scaling 的辅助监督¶
与 LLM 不同,工业推荐排序器是混合系统:在最终预测头把非序列 DLRM 特征 [22] 与用户行为序列 [41] 融合。这造成论文命名的训练失衡 sequence starvation——稠密的、偏记忆的非序列分支把主 CVR 目标"抄近路"解决掉,序列分支只受到很弱的监督,从而阻碍序列编码器的有效 scaling。论文用两个只在训练期存在的辅助目标来对症。
3.4.1 辅助序列 CVR 监督¶
设 $\mathbf{H}_{\text{seq}} \in \mathbb{R}^{K \times d}$ 为所有 $K$ 个序列条件 query token 的最终状态。为给序列侧一个直接的监督信号,在 $\mathbf{H}_{\text{seq}}$ 与候选广告特征上挂一个轻量的辅助序列 CVR 头。与主预测头不同,这个辅助头拿不到非序列的用户/上下文 DLRM 特征,因此它把同样的 BCE 监督施加到一个纯序列条件的 CVR 预测上:
$$\hat{y}_{\text{seq}} = \sigma\big(g_{\text{seq}}(\mathbf{H}_{\text{seq}}, a)\big) \tag{9}$$
$$\mathcal{L}_{\text{seq}} = \mathbb{E}_{\mathcal{D}}\big[\ell_{\text{BCE}}(\hat{y}_{\text{seq}}, y)\big] \tag{10}$$
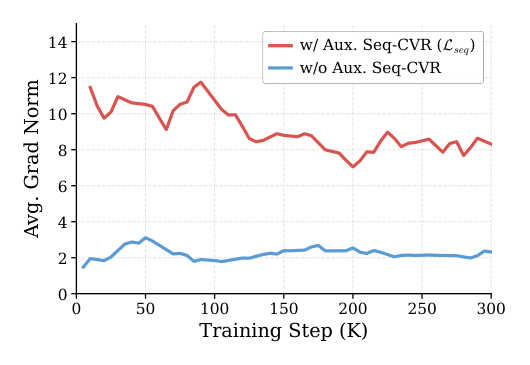
图 2 是本文最直接的机制证据:即使辅助权重只有 $\lambda_{\text{seq}} = 0.1$,$\mathcal{L}_{\text{seq}}$ 也让序列编码器参数的平均梯度范数提升 3 倍以上(2.35 → 8.50)。附录 A.3 说明该曲线报告的是所有序列编码器注意力层中 $Q, K, V$ 投影矩阵梯度范数的跨层平均,并指出 FFN 参数上观察到类似趋势——说明辅助目标改善的是整个编码器的梯度流,而非只作用于注意力投影。
3.4.2 序列 / 非序列表征对齐¶
除了直接的标签监督,论文还正则化序列与非序列用户表征之间的关系。灵感来自视觉-语言表征对齐 [26, 38]:把行为序列与非序列特征视为描述同一用户的互补模态,用 sigmoid 对比目标对齐两者——该目标比 softmax 式对比损失对 batch size 不敏感,更适合 scaling 推荐模型。
具体地,对用户 $i$,令 $\mathbf{H}_{\text{seq},i}$ 为序列编码器输出,$\mathbf{h}_{\text{seq},i} = \mathbf{H}_{\text{seq},i}[\texttt{CLS}]$ 为其 \texttt{[CLS]} 状态(作为序列级表征)。把 $\mathbf{h}_{\text{seq},i}$ 与非序列表征分别送入两个两层 MLP 投影头再做 $\ell_2$ 归一化,得到 $\mathbf{z}_{\text{seq},i}$ 与 $\mathbf{z}_{\text{ns},i}$(这两个投影头只在训练期使用,推理时移除)。对齐损失为
$$\mathcal{L}_{\text{align}} = -\frac{1}{B^2}\sum_{i=1}^{B}\sum_{j=1}^{B} \log \sigma\Big(y_{ij} \cdot \big(\mathbf{z}_{\text{seq},i}^\top \mathbf{z}_{\text{ns},j} / \tau - b\big)\Big) \tag{11}$$
其中序列与非序列表征来自同一用户时 $y_{ij} = +1$,否则 $-1$;$\tau$ 是可学习的正温度,$b$ 是可学习偏置。总训练目标:
$$\mathcal{L}_{\text{total}} = \mathcal{L}_{ce} + \lambda_{\text{seq}}\mathcal{L}_{\text{seq}} + \lambda_{\text{align}}\mathcal{L}_{\text{align}} \tag{12}$$
3.5 面向算力复用的系统协同设计¶
架构上的分离只有落到系统上才变成真实收益,论文围绕共享编码器输出给出两套 shared-prefix 机制。
User-Level Shared-Prefix Training(ULT)。标准的 instance-level 训练中,同一用户的样本往往共享很长的重叠行为前缀,导致序列编码器 $T$ 反复处理几乎相同的历史。ULT 把同一用户在一个时间窗内的样本分组:对有 $M_u$ 个样本的用户,在并集行为序列上只跑一次 $T$,并施加 prefix-valid causal mask,使每个样本只能 attend 到自己的合法历史。这在完整保留原有时序训练语义的前提下,把编码器计算从 $M_u \cdot \text{FLOPs}(T)$ 降到 $\text{FLOPs}(T)$。
Shared-Prefix Serving。服务时,一次排序请求要用同一份用户历史给 $N$ 个候选打分。借鉴 M-FALCON 式的复用原则 [37],每请求只计算一次编码器 memory $\mathbf{H} = T(S_u)$ 并作为共享前缀状态复用;候选侧 query token 批量化后对同一份 memory 由 $C$ 解码。每请求计算从
$$N \cdot \text{FLOPs}(T) + N \cdot \text{FLOPs}(C) \quad \longrightarrow \quad \text{FLOPs}(T) + N \cdot \text{FLOPs}(C)$$
因为 $C$ 被设计得远轻于 $T$,共享前缀复用把序列侧 scaling 与重复的每候选延迟解耦,使更大的序列编码器在生产约束下变得可行。
四、实验设置¶
论文围绕五个研究问题组织实验:RQ1 生产 FLOPs 预算下 ReST 是否优于其他序列模型?RQ2 在长度/深度/宽度上是否比 LLM 式基线 scaling 得更好?RQ3 各组件各贡献多少?RQ4 ULT 与 shared-prefix serving 是否改善训练与服务效率?RQ5 在 P99 延迟预算下是否改善线上业务指标?
数据集:主实验用来自 TikTok Shop Ads 的大规模工业数据集(数据在使用前严格匿名与去标识,不含 PII)。所有模型保持排序栈、行为序列、query token 不变,只替换序列建模组件。受保密约束,工业评测报告的是相对一个高度优化的生产 DLRM 基线的相对 AUC 提升(AUC Δ)。另在三个公开 benchmark 上评测:MovieLens-1M、MovieLens-20M [12]、Amazon-Books [21];为与工业 CVR 任务对齐,把它们标准的序列推荐协议按时间切分改造成 pointwise 预测任务,报告绝对 AUC 与 log loss。
基线分三族: 1. Target-aware attention 族:DIN [41]、Stacked Target-to-History Cross Attention(STCA)[10]; 2. 因果序列模型族:LLaMA-style Transformer [29]、HSTU [37]; 3. Trans.:一个强 encoder–decoder 基线,采用 ModernBERT [33] 式的现代化双向编码器(Pre-LN、GeGLU、RoPE),并装上 TSP、参数量配置为与 ReST 大致相当。
为公平比较,所有模型用同一套序列预处理流水线、接收同样的预处理行为序列;报告的 FLOPs 与参数量只覆盖序列建模组件。除非另有说明,所有序列建模基线在训练时都开启辅助序列 CVR 损失以缓解序列饿死。
公开 benchmark 实现细节(附录 A.4):RecBole [40] 实现,Adam 优化;学习率与 weight decay 在 $\{10^{-4}, 5\times10^{-4}, 10^{-3}\}$ 上调;batch size 4096;最多训练 20 epoch,以验证 AUC 早停。数据做 5-core 过滤。评分 ≥4 视为正样本,更低评分视为负样本,不做额外负采样;每个用户的交互按时间排序后按 80%/10%/10% 切分为 train/valid/test。模型配置:最大行为序列长度 200,item embedding 维度 32;Transformer 类模型用 2 个序列建模层(encoder–decoder 架构另加 2 个 decoder 层),2 个注意力头,FFN 内维 128;预测头为三层 MLP,隐层 [256, 128, 64];embedding 层、隐层与注意力权重上 dropout 0.25。
Table 6:公开数据集统计
| 统计量 | ML-1M | ML-20M | Books |
|---|---|---|---|
| Users | 6K | 138K | 604K |
| Items | 4K | 18K | 368K |
| Interactions | 1M | 20M | 9M |
五、主要实验结果¶
5.1 工业数据集整体对比(RQ1)¶
Table 1:与生产 DLRM 基线在大规模工业数据集上的对比
| Setting | Metric | DLRM | DIN | STCA | LLaMA | HSTU | Trans. | ReST |
|---|---|---|---|---|---|---|---|---|
| Base | AUC Δ | — | +0.23% | +0.38% | +0.53% | +0.51% | +0.57% | +0.67% |
| Base | FLOPs (G) | — | 0.07 | 1.66 | 1.37 | 1.70 | 1.52 | 1.52 |
| Base | Params (M) | — | 0.12 | 2.97 | 0.86 | 0.66 | 5.36 | 5.69 |
| Large | AUC Δ | — | +0.27% | +0.46% | +0.70% | +0.61% | +0.72% | +0.92% |
| Large | FLOPs (G) | — | 1.18 | 31.98 | 30.21 | 32.88 | 32.38 | 32.40 |
| Large | Params (M) | — | 0.46 | 15.05 | 3.43 | 1.98 | 21.33 | 22.64 |
结论分析:
- 量纲基准:论文明确给出,在这个生产排序场景里 0.05% 的离线 AUC Δ 就被视为实践上有意义、能转化为可测量的线上收益。这是读所有后续消融数字的标尺。
- ReST 在可比 FLOPs 下全面优于所有基线族,Base/Large 两档都拿到最好的 AUC 提升,Large 档 +0.92%。
- LLaMA 与 HSTU 都优于 DIN 和 STCA,说明更丰富的序列侧自注意力确有价值;但HSTU 弱于 LLaMA——这是一条值得单独记住的判断:生成式推荐的 scaling 配方未必能直接迁移到判别式排序。
- 现代化的 encoder–decoder 基线 Trans. 进一步超过 LLaMA,且参数量与完整 ReST 大致对齐,但在 Large 档仍落后 0.20% AUC(0.92% − 0.72%)。这条对比很关键:它把"ReST 赢在参数多"这个解释排除掉了。
- Table 3 提供了第二个参数受控对比:参数最多的 cross decoder $C$ 只贡献 +0.05% AUC;而参数量与 LLaMA 接近的 encoder-only ReST 仍保留约 +0.87% 的 AUC 提升,比 LLaMA 高 0.17%。两条参数受控证据合起来支持"收益来自推荐原生的序列建模与非对称架构,而非单纯堆参数"。
5.2 公开 benchmark(RQ1)¶
Table 2:ML-1M / ML-20M / Amazon-Books 公开 benchmark
| Dataset | Metric | DIN | STCA | LLaMA | HSTU | Trans. | ReST |
|---|---|---|---|---|---|---|---|
| ML-1M | AUC | 0.8064 | 0.8074 | 0.8087 | 0.8079 | 0.8090 | 0.8099 |
| ML-1M | Log loss | 0.5346 | 0.5372 | 0.5334 | 0.5343 | 0.5329 | 0.5317 |
| ML-20M | AUC | 0.8070 | 0.8079 | 0.8088 | 0.8082 | 0.8103 | 0.8135 |
| ML-20M | Log loss | 0.5329 | 0.5333 | 0.5317 | 0.5322 | 0.5302 | 0.5292 |
| Books | AUC | 0.7521 | 0.7527 | 0.7541 | 0.7566 | 0.7556 | 0.7571 |
| Books | Log loss | 0.4345 | 0.4357 | 0.4305 | 0.4242 | 0.4244 | 0.4221 |
| — | FLOPs (M) | 1.90 | 24.10 | 21.13 | 29.77 | 23.32 | 23.41 |
| — | Params (M) | 0.01 | 0.11 | 0.03 | 0.02 | 0.17 | 0.18 |
结论分析:与工业结论一致,ReST 在三个数据集上同时取得最好的 AUC 与 log loss,且 FLOPs 相当。这说明 ReST 的收益不只是大规模工业数据的产物,也能迁移到标准公开 benchmark。但要诚实地看量级:ML-1M 上 ReST 对 LLaMA 只有 +0.0012 AUC,Books 上对 HSTU 只有 +0.0005 AUC,且没有报告多次运行的方差或显著性检验——公开 benchmark 在这里更像"没有反例"的健全性检查,而非有力的独立证据。另一个值得注意的细节是 Books 上 HSTU 反超了 LLaMA 和 Trans.(AUC 0.7566、log loss 0.4242),与工业数据集上 HSTU < LLaMA 的排序相反,说明基线之间的相对强弱本身相当依赖数据分布。
5.3 Scaling 分析(RQ2)¶
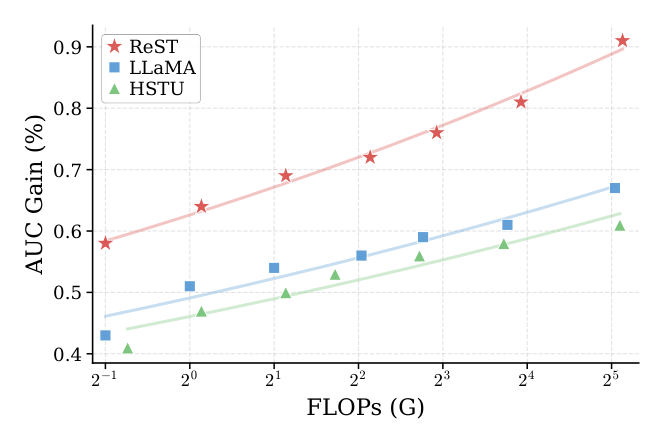
整体 scaling。图 3 展示层深、隐维、序列长度同时 scaling 时的联合行为。分析只聚焦可 scaling 的自注意力式序列模型,因为它们的序列侧计算可被缓存,是生产排序约束下长上下文 scaling 最相关的模型族。作为对测试算力区间的描述性总结,论文拟合
$$\Delta\text{AUC}(F) = a \cdot F^{b} \tag{13}$$
其中 $F$ 为 FLOPs,得到:
| 模型 | $a$ | $b$ | log-space $R^2$ |
|---|---|---|---|
| ReST | 0.626 | 0.101 | 0.991 |
| LLaMA | 0.491 | 0.090 | 0.935 |
| HSTU | 0.461 | 0.088 | 0.924 |
ReST 在整个测试算力区间上都取得更高的 AUC 增益,且拟合优度显著更高(0.991 vs 0.935 / 0.924)——这本身就是一个信息:ReST 的算力-精度关系比两个基线更接近一条干净的幂律,而基线的偏离恰恰来自它们在某些轴上提前饱和。
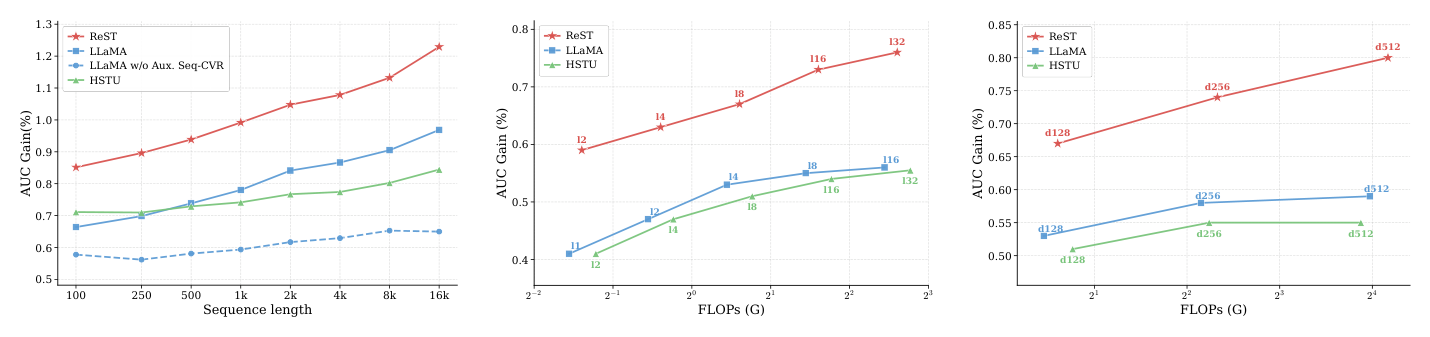
序列长度轴(图 4a)。在固定深度与隐维的前提下,把可用行为上下文从 100 变到 16k token;每个上下文长度设置在有足够历史覆盖的近期数据上评测,报告各模型在同一批样本上相对生产基线的 AUC 提升。关键观察:
- 不加辅助序列 CVR 监督时,LLaMA 表现出 §3.4 讨论的 sequence-starvation 效应——延长可用上下文几乎带不来任何额外提升(图中 "LLaMA w/o Aux. Seq-CVR" 是一条近乎水平的线)。
- 加上辅助序列 CVR 监督后,所有序列模型在更大上下文预算下都表现出更强的收益,排序为 ReST > LLaMA > HSTU。
- ReST 一路改进到 16k token,在整个评测上下文范围内取得约 +0.4% 的额外 AUC 提升,是所有对比模型中观察到的最大增幅。
深度轴(图 4b)。固定序列长度与隐维改变层数(ReST 的 $T$ 与 $C$ 深度按 1:1 一起 scaling)。ReST 随深度稳定改进,AUC 增益从 +0.59% 升到 +0.76%;相比之下 LLaMA 与 HSTU 分别在 8 层与 16 层之后出现收益递减。这说明单纯堆更深的通用序列 block 对推荐排序是不够的:在稀疏监督与噪声行为数据下,额外深度可能在被有效优化之前就饱和了。消融进一步确认 SRN 对更深模型尤其重要。
宽度轴(图 4c)。在深度与序列长度固定下 scaling 隐维 $d \in \{128, 256, 512\}$。两个基线都很早饱和:HSTU 与 LLaMA 在 $d = 256$ 附近走平,加到 $d = 512$ 几乎不涨 AUC,却付出大量 FLOPs。ReST 则从 +0.67% 继续升到 +0.80%,是唯一在最大宽度下仍保持单调增益的模型。论文归因为门控注意力、时间编码与稳定化残差学习的组合让 ReST 能真正利用更大的隐维,而不是只增加算术开销。
5.4 消融研究(RQ3)¶
Table 3:架构与 rec-native block 设计消融
| Group | Variant | AUC Δ | Param Δ | FLOPs Δ |
|---|---|---|---|---|
| Architecture | $T$ | base | — | — |
| + MoE in $T$ | +0.00% | +500% | +0.2% | |
| + $C$ (w/o TSP) | +0.03% | +100.3% | +0.2% | |
| + $C$ (w/o PF-KV) | +0.05% | +473.2% | +6.7% | |
| + $C$ | +0.05% | +473.2% | +0.2% | |
| Gated Attn | w/o gate | base | — | — |
| + O gate | +0.03% | +7.6% | +3.7% | |
| + O & QKV gate | +0.06% | +11.4% | +14.9% | |
| + O & V gate | +0.06% | +8.9% | +7.5% | |
| Norm | Pre-LN | base | — | — |
| Post-LN | +0.00% | ≈0 | ≈0 | |
| Mix-LN | +0.02% | ≈0 | ≈0 | |
| SRN | +0.08% | ≈0 | ≈0 | |
| Pos./Temporal | w/o pos | base | — | — |
| RoPE | +0.04% | ≈0 | ≈0 | |
| RoPE + RoTE (sec) | +0.08% | ≈0 | ≈0 | |
| RoPE + RoTE | +0.12% | ≈0 | ≈0 |
架构与算力分配。这一组回答"额外容量应该加在哪里":
- 给编码器 $T$ 加 MoE [30] 带来 +500% 参数,AUC 增益却是精确的 +0.00%——这是全表最有价值的一行,也是本文最值得称赞的一处诚实。它说明编码器容量本身不是瓶颈,"加参数就能涨"在这个场景里直接被证伪。
- 相反,加一个轻量 cross decoder $C$ 只用 +0.2% 额外 FLOPs 就带来 +0.03% AUC,展示了候选条件读出(candidate-conditioned readout)的价值。
- TSP 把增益进一步抬到 +0.05%;而 PF-KV 把 FLOPs 开销从 +6.7% 压回 +0.2%,在完全不损失 AUC 的前提下(两行 AUC Δ 都是 +0.05%)——这是一处非常干净的"纯赚"设计。
结论:ReST 的正确做法是把容量分配给异质的、候选条件的解码器,同时让重复的每候选算术几乎不变。
门控注意力。只加输出门已有 +0.03%;给 Q/K/V 全部加门把 AUC 抬到 +0.06%,但带来 +14.9% 的大额 FLOPs 开销;而输出门 + value 门在大约一半的额外算力(+7.5% FLOPs)下达到同样的 +0.06%。附录 A.1 进一步显示这个组合在噪声行为扰动下表现更好。因此 ReST 采用 Output + Value 门作为 DGA 设计,取的是精度-效率折中。
归一化与残差连接。在固定 16 层的设定下:Pre-LN 为局部基线;换成 Post-LN 无增益;Mix-LN 带来 +0.02%;在此之上加缩放残差学习的 SRN 拿到最大的 +0.08%,在同深度下明显优于其他变体。这说明在稀疏推荐数据上训练更深的序列模型,同时需要合适的归一化放置与受控的残差更新——两者缺一不可(Mix-LN 单独只有 0.02%)。
位置与时间编码。从"无位置"基线出发:加 RoPE 提升 +0.04%,确认序号位置信息有价值;在 RoPE 之上加单粒度(1 秒桶)RoTE 提到 +0.08%,说明物理时间提供了超出序号位置的互补信号;默认的多粒度 RoTE(不同时间注意力头分配不同时间粒度)进一步提到 +0.12%,是全表单项最大增益。
一个容易被忽略但很关键的控制:论文明确指出,所有变体都已经把 delta-time 特征作为 token 级 side information 输入,因此这些增益反映的是"把物理时间直接注入注意力机制"的额外价值,而不是"让模型第一次看到时间特征"。这个控制让 RoTE 的归因相当扎实。
Table 4:辅助目标消融
| Backbone | $\mathcal{L}_{\text{seq}}$ (Base) | $\mathcal{L}_{\text{seq}}$ (Large) | $\mathcal{L}_{\text{align}}$ |
|---|---|---|---|
| DIN | +0.02% | +0.02% | — |
| STCA | +0.13% | +0.20% | — |
| LLaMA | +0.16% | +0.22% | +0.05% |
| HSTU | +0.10% | +0.15% | +0.05% |
| ReST | +0.07% | +0.12% | +0.06% |
结论分析:
- 辅助序列 CVR 监督改善所有序列感知骨干,且在 Large 设定下增益更大:STCA 从 +0.13% → +0.20%,LLaMA 从 +0.16% → +0.22%,HSTU 从 +0.10% → +0.15%,ReST 从 +0.07% → +0.12%。这支持论文的动机:更大的序列模块需要更强的直接序列侧监督,否则会被稠密非序列分支抄近路。
- DIN 几乎不受益(+0.02%,Base/Large 相同),这条对照很有说服力:DIN 的序列建模能力本就极小(Params 0.12M/0.46M),没有"饿死"的空间可救,这从反面印证了 sequence starvation 是一个随序列模块容量增大才显现的问题。
- 论文自己的解读是:"ReST 上更小的边际增益说明其 rec-native 编码器对辅助目标依赖更小,尽管辅助监督仍然有益。"
- 在辅助序列 CVR 之上,对齐目标进一步给 LLaMA / HSTU / ReST 各带来 +0.05% / +0.05% / +0.06%,说明序列/非序列对齐是一个跨可 scaling 序列模型稳定通用的额外正则信号。
- 因为这两个目标是架构无关且不引入任何服务期开销的,论文在主对比中为所有序列 scaling 基线都开启了辅助序列 CVR 监督。
5.5 系统效率与线上 A/B(RQ4 & RQ5)¶
训练侧。基线本身已经是一条高度优化的流水线:融合的 attention/GEMM kernel、混合精度训练、变长序列的 padding removal。在这个强基线之上,ULT 通过消除同一用户样本间的冗余前缀计算,把端到端训练吞吐进一步提升 5.8×——论文特意强调这说明收益来自计算复用,而非底层 kernel 优化。
服务侧。request-level shared-prefix serving 是线上序列 scaling 的关键使能器:$T$ 每请求只执行一次并跨所有候选复用,把序列建模组件的每请求推理成本降低至多 20×。这一复用对在严格生产延迟预算下部署 ReST 至关重要,实质性地缩小了大序列模型与工业排序系统之间的部署鸿沟。
Table 5:线上 A/B 结果
| AUC Δ | Advv Lift | $p$-value |
|---|---|---|
| +1.31% | +11.93% | < 0.01 |
实验协议(原文明确给出的全部信息):
- 平台:TikTok Shop Ads,"最大的广告平台之一";
- 分流:用户随机分配到对照组与实验组,实验组承接 20% 的生产流量;
- 对照:一个强生产 DLRM 排序器;实验组只把它的序列建模组件换成 ReST;
- 配置:ReST scaling 到一个满足 50ms P99 延迟预算的可部署配置;
- 主指标:一个与营收相关的业务指标 Advertiser Value(Advv);同时报告在线预测质量的 streaming AUC,并监控端到端 P99 延迟与其他生产护栏;
- 结果:AUC +1.31%,Advv 统计显著地 +11.93%($p < 0.01$),其余所有被监控的生产护栏均满足;
- 结局:ReST 已在生产中全量部署。
5.6 附录中的两项补充分析¶
A.1 DGA 的去噪验证。做了一个受控噪声注入研究:在不同噪声水平下向行为 token 注入高斯噪声,在同一套训练与评测协议下比较标准注意力、输出门注意力与 DGA。
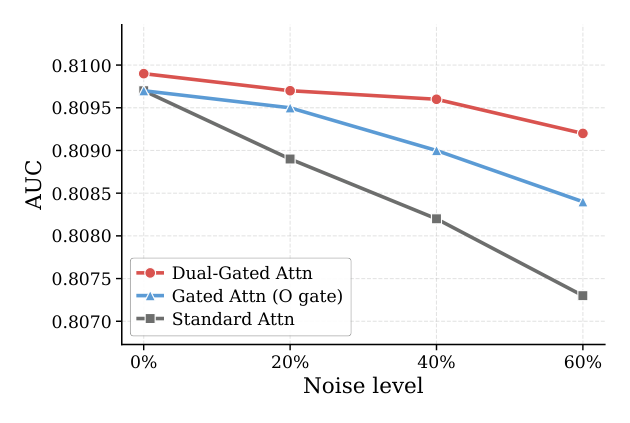
图 5 显示随 token 噪声上升 DGA 一致地更稳健:标准注意力退化最快,因为噪声行为特征直接进入 value 流并被聚合进上下文表征;输出门注意力更稳定,但仍无法阻止被污染的 token 特征在聚合过程中被混入;DGA 同时门控聚合前的 value 流与聚合后的输出流,让模型在不可靠证据污染序列上下文之前就压制它。这是全文唯一一处直接验证"去噪"机制假设(而非只看端到端 AUC)的实验,设计得很到位。
A.2 RoTE 的相对时间性质推导。RoTE 遵循与 RoPE 同样的原理:query 与 key 按各自时间戳桶旋转,点积会消掉共享坐标系而只依赖相对旋转。设 $\tilde{t}_i = t_i - t_1$、$b_i = \lfloor \tilde{t}_i / \tau_h \rfloor$,则
$$\begin{aligned} \text{Score}_{\text{RoTE}}(\mathbf{q}, \mathbf{k}) &= (\mathbf{R}_\Theta(b_n)\mathbf{q})^\top(\mathbf{R}_\Theta(b_m)\mathbf{k}) \\ &= \mathbf{q}^\top \mathbf{R}_\Theta(b_n)^\top \mathbf{R}_\Theta(b_m)\mathbf{k} \\ &= \mathbf{q}^\top \mathbf{R}_\Theta(-b_n)\mathbf{R}_\Theta(b_m)\mathbf{k} \\ &= \mathbf{q}^\top \mathbf{R}_\Theta(b_m - b_n)\mathbf{k} \end{aligned} \tag{14}$$
用到旋转矩阵的两条基本性质 $\mathbf{R}_\Theta(x)^\top = \mathbf{R}_\Theta(-x)$ 与 $\mathbf{R}_\Theta(x)\mathbf{R}_\Theta(y) = \mathbf{R}_\Theta(x+y)$。因此时间头只依赖相对桶差 $b_m - b_n$;由于按序列起始时间平移在成对差中被抵消,它不改变两 token 之间表示的时间间隔。
论文在这里有一段值得赞赏的自我克制:该推导只建立了相对时间依赖,并不意味着"经过时间→注意力分数"是单调或一一映射——rotary 特征是周期性的,分数还依赖 query/key 内容;同一桶内的事件在该粒度下被有意设计为不可区分。给不同头分配不同 $\tau_h$ 正是为了在互补分辨率上暴露相对时间间隔,同时保留与高效注意力 kernel 的兼容性。
六、核心贡献总结¶
- 诊断出并命名了 sequence starvation:混合排序器里主 CVR 损失可以被稠密非序列 DLRM 分支短路,使序列分支在 scaling 时越来越"吃不饱"。用梯度范数(2.35 → 8.50)而非只用端到端指标给出机制级证据,是本文最扎实的一块。
- 一套推荐原生的 block 改造:DGA(有界 sigmoid 双门,兼顾聚合前过滤与聚合后调制)、RoPE + 多粒度 RoTE(把物理时间纳入同一套 rotary 机制,兼容 FlashAttention)、SRN(Mix-LN 式深度相关放置 + ReZero 式小初始化残差标量),三者各自都有干净的消融数字。
- 把算力不对称提升为一等公民的架构原则:重编码器一次 / 轻解码器 N 次的分解,配合 PF-KV(去掉重复的 K/V/value-gate 投影)与 TSP(容量上升而激活 FLOPs 几乎不变),再由 ULT(训练 5.8×)与 shared-prefix serving(服务至多 20×)在系统层兑现。
- 诚实的负结果:明确报告"给编码器加 MoE,参数 +500%、AUC +0.00%",主动否定了"堆参数就有收益"的路径。
- 完整的工业闭环:三轴 scaling 曲线 + 幂律拟合 + 一周 20% 流量 A/B + 50ms P99 + 全量部署。
七、与已归档相关工作的对比¶
rDCN rDCN: Context Features Are Cheap — Rank-Aware Decomposition(Taboola, 2026-05-24)¶
关系:独立并发(本文未引用 rDCN,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇指向完全同一个 root cause——工业排序中一次请求的 $N$ 个候选共享同一套用户/上下文信号,而标准实现把"上下文-only 的计算"在每个候选上重复跑 $N$ 次。ReST 把它称作 computation asymmetry 并强调"序列侧算力可摊销、候选侧不可摊销";rDCN 把它形式化为 tensor rank 不对称(上下文是 rank-2
[B,D]、目标是 rank-3[B,N,D]),并算出仅上下文-上下文 FM 交互一项每请求就浪费 $(N-1)\binom{K}{2}D$ FLOPs。rDCN 提出的 Cost Asymmetry 设计权衡(加上下文特征比加目标特征便宜得多)与 ReST 的"往编码器投算力可被 $N$ 摊销、往解码器投算力必须省"是同一句话的两种说法。 - 相近的技术骨架:两者的方法流程图可以完全重叠——推迟广播(defer the broadcast):在 rank-2 上算完所有与候选无关的部分,只在"必须混入候选"的那一步才展开到 rank-3。rDCN 用代数分块分解实现($\mathbf{W}\mathbf{x} = \mathbf{W}_c\mathbf{x}_c + \mathbf{W}_t\mathbf{x}_t$,双线性情形拆成四项、其中 $\mathbf{x}_c^\top\mathbf{W}_{cc}\mathbf{y}_c$ 只算一次);ReST 用架构分解实现($T$ 只吃用户历史、$C$ 才引入候选)。
- 本文的差异与推进:rDCN 精读里有一句话几乎是为 ReST 写的——rank-aware 分解在 DIN / TWIN / ETA 这类 target attention 上根本不成立,因为用户表示按设计就依赖目标,压根不存在上下文-only 的路径。ReST 正是对这个限制的架构层回应:它主动放弃在编码器里做 target-aware 建模,把用户历史编码成与候选无关的 memory,再用一个极轻的 cross decoder 补回候选条件性。换言之,rDCN 说明"在既有架构上能省多少",ReST 说明"如果一开始就按可复用性设计架构,能把省下来的算力再投回序列侧 scaling"。另一处互补:rDCN 的分解是精确、identity-equivalent、预测逐位相同的(不改精度只提吞吐),ReST 的分解会改变模型(编码器看不到目标),因此必须用 Table 1 里 ReST > DIN/STCA 的结果来证明这个牺牲是划算的。
- 可比的方法/实验差异:两者的收益口径不同且不可直接比较——rDCN 报告单 pod 吞吐 +87.5%、峰值 pod 数 −47%、p99 −33%,且精度完全不变;ReST 报告服务侧序列组件每请求推理成本至多 −20×、训练吞吐 5.8×,并把节省转化成 +0.92% 离线 AUC 与线上 Advv +11.93%。rDCN 还给出了 ReST 缺失的一项定量分析:把上下文字段数 $K$ 增大 3× 只让 RPS 降 39%,而把目标字段数 $M$ 增大 3× 让 RPS 降 64%——这正是 ReST 只做了定性论证的"两侧 scaling 代价不对称"的量化版本。
SpecFormer SpecFormer: Mitigating Embedding and Attention Collapse via Spectral-Aware Transformer(Alibaba + 浙江大学, 2026-07-27)¶
关系:独立并发(本文未引用 SpecFormer,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在追问同一个症状——为什么 Transformer 在推荐里堆深度不像在 LLM 里那样有效,甚至很早就崩。SpecFormer 用 fractional effective rank 把它量化了:Qwen3-0.6B 的注意力 ferank 长期维持在 0.2–0.3 平台,而推荐 Transformer(OneTrans)全程在 0.06 以下且随层数继续走低——低了整整一个数量级。ReST 在 §3.2.3 引用的正是同一条文献线(Dong et al. 的"pure attention loses rank doubly exponentially with depth" [9]、Barbero et al. 关于 decoder-only LLM 中 over-mixing 与表征坍缩的分析 [2]、Xue et al. 关于训练目标影响 over-smoothing 的研究 [34]),并直接观察到"即便用 LLM 式 Pre-LN,加深 Transformer 在推荐 scaling 中往往收益有限"。
- 相近的技术骨架:两者都选择了在 block 内部做最小侵入式干预来恢复深度收益,而不是换架构或加参数——SpecFormer 三件套(可学习谱软化、谱软化注意力、谱残差位置编码)全部塞在注意力层内;ReST 的 SRN 只动了 LN 放置与一个初始化为 0.01 的残差标量,参数与 FLOPs 开销都标注为 ≈0。两者也都用"深度-指标单调性"作为核心验证:SpecFormer 展示注意力有效秩随深度单调上升,ReST 展示 AUC 增益随深度从 +0.59% 单调升到 +0.76%(而 LLaMA/HSTU 分别在 8 层、16 层后递减)。
- 本文的差异与推进:两篇对同一症状给出了不同的 root-cause 诊断,这是本组对比最有价值的地方。 SpecFormer 归因于数据侧:推荐特征的异质性与长尾频率导致嵌入矩阵谱坍缩,进而在前向(低秩注意力当低通滤波器)与反向(梯度被投影到主谱方向、次要方向饥饿)之间形成闭环恶性循环。ReST 归因于监督侧:序列编码器只从稀疏标签训练,主损失还会被强非序列 DLRM 特征抄近路,深度在被有效优化之前就饱和了。两个诊断并不互斥,但导向完全不同的处方——SpecFormer 去修谱,ReST 去修梯度流与残差幅度(SRN)以及监督本身(辅助序列 CVR 损失)。值得注意的是 ReST 的 Table 3 恰好为 SpecFormer 的诊断提供了一个侧面证据:单纯换归一化放置(Mix-LN)只值 +0.02%,必须叠加"让深层从近恒等出发"的残差缩放才到 +0.08%——这与"深层的问题不在归一化位置而在表征本身如何被更新"的判断相容。
- 可比的方法/实验差异:作用对象不同——SpecFormer 的 token 是特征字段(feature interaction Transformer),ReST 的 token 是行为事件(behavior sequence Transformer);因此两者的"深度诅咒"发生在不同的 token 语义空间上,SpecFormer 的谱坍缩解释(异质字段无法建立平滑语义对齐)对 ReST 的行为 token 未必同样成立。线上收益口径也不同:SpecFormer 在阿里电商广告报 CTR +1.34% / CVR +15.97% / Order +16.72%,仅 +5ms 延迟;ReST 在 TikTok Shop Ads 报 AUC +1.31% / Advv +11.93%,50ms P99 内。两者没有公开数据集交集(SpecFormer 跑的是 Criteo/Avazu,ReST 跑的是 ML-1M/ML-20M/Amazon-Books)。
AMBER AMBER: An Event is Worth One Token(AI at Meta, 2026-08-26)¶
关系:独立并发(本文未引用 AMBER,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在回答"把 LLM 的 scaling 配方搬到工业推荐的行为序列上,真正的结构性障碍是什么",且都拒绝"模型不够大"这个答案。AMBER 的答案是 serving 侧特征物化成本——存储、反序列化、网络传输的开销可以与 GPU 算力相当甚至更高,逼得架构必须在"序列长度"与"snapshot resolution(每个事件编码多少信号)"之间二选一,而且由于每个位置都是下一个位置的上下文,这种退化会沿序列逐级复合放大。ReST 的答案是 signal quality + computation asymmetry。两者共享一个更深的共识:限制行为序列 scaling 的是服务端的算力/成本结构,不是模型容量;因此两篇的核心工程主张也一致——刻意用离线/可摊销的算力去换在线的每请求算力。
- 相近的技术骨架:流程图可以抽象重合为"把重计算搬到一个可复用、可缓存的阶段,让在线路径上只留下轻量的、与候选/查询相关的部分"。AMBER:Event Tokenizer 逐事件、与历史无关地把几百个异构信号压成 1 个连续 Event Token,事件发生时异步触发并永久缓存,下游 1B Llama User LLM 只消费缓存 token。ReST:编码器 $T$ 对用户历史每请求算一次产出 memory,$C$ 对 $N$ 个候选复用它;ULT 更把复用扩展到"同一用户的多条训练样本"这个跨样本维度。两者也都在总算力账本下论证"训练最优不等于系统最优":AMBER 在 $m_u = 30\text{--}100\times$ 的训练+服务 FLOPs 折算下得出"事件侧 scaling 优于 User LLM scaling";ReST 用 $\Delta\text{AUC}(F) = a F^b$ 的幂律拟合论证在同样 FLOPs 下 rec-native block 的算力效率更高。
- 本文的差异与推进:两篇对同一问题下了方向完全相反的赌注,这组对照本身比任何一篇单独看都更有信息量。 AMBER 保留 LLM(用预训练 1B Llama 作 User LLM),改的是输入表征——认为模型 scaling 无法恢复输入表征中缺失的信息,所以要提高每个事件的分辨率。ReST 保留输入(明确声明所有模型共用同一套序列预处理流水线、接收同样的预处理行为序列),改的是 block 本身——并用 Table 1 与图 4 直接展示 LLaMA-style block 在长度/深度/宽度三轴上都比 rec-native block 更早饱和。一个具体到可以逐行对照的技术分歧是时间编码:AMBER 的 RoPE 用的是"相对于一个固定参考日期的事件时间戳"(绝对时间语义);ReST 的 RoTE 先按序列起始时间平移再分桶,并在附录 A.2 证明分数只依赖相对桶差 $b_m - b_n$,同时把多个头分配给 $\{$秒, 分, 时, 天, 周, 季, 年$\}$ 的互补粒度。ReST 的消融给出了这条路线的价格标签:单粒度秒桶 RoTE 值 +0.08%,多粒度值 +0.12%。
- 可比的方法/实验差异:复用的粒度与生命周期不同——AMBER 的缓存是跨请求、准永久的(代价是必须处理"周期重训导致的表征漂移",用 DANN 梯度反转 $\lambda \approx 5\times10^{-3}$ 加 EMA 参考编码器把 20 天 checkpoint 的 k-NN 可分性压到 0.856),ReST 的复用是请求内、瞬时的(因此完全不存在漂移问题,但也拿不到 AMBER 那种跨请求摊销)。ReST 的 ULT 是两者之间的中间态:跨同一用户的多条训练样本复用,但只在训练期。指标口径完全不同(AMBER 报 NE −0.40% vs FLOP-matched Incumbent、Soft Recall +0.31%~+0.51%;ReST 报相对生产 DLRM 的 AUC Δ),无法直接比较。
Step 2.5 剔除的近似候选(记录以防门槛放水):
- TransRetrieval TransRetrieval(阿里妈妈, 2026-08-26)——机制上高度接近(把候选侧全部字段压成 1 个 token 使每候选 FLOPs −85%,用户侧 KV cache 在一次请求内广播给所有候选,再把省下的预算投回深度/宽度)。剔除理由:阶段不同(召回而非精排,候选池量级差几个数量级),且诊断的 root cause 是"基数驱动的 token 范数发散破坏 Transformer 的同质 token 假设",与 ReST 的两条障碍都不重合;此外它与已入选的 rDCN 在"跨候选复用"这一点上高度重叠,保留 rDCN(同为精排阶段、且给出精确不变性)信息量更大。
- IAT IAT(字节, 2026-04-10)与 SIF SIF(美团, 2026-04-17)——都是"把每条历史样本/交互压成一个 token"。剔除理由:解法路径实质相反。IAT/SIF 的骨架是"先离线压缩、再在线建模",ReST 明确不做任何压缩("keep the sequence preprocessing pipeline fixed across models"),走的是"不压缩、靠架构复用换得起算力"。问题陈述也不同:IAT/SIF 攻的是手工序列特征的信息瓶颈(token 里装什么),ReST 攻的是 block 与算力分配(有了 token 之后怎么 scaling)。
- TM20K TM20K(字节, 2026-08-07)——同公司、同为广告 CVR、同为序列长度 scaling、且未被引用,是最接近入选线的一篇。剔除理由:解法骨架相反——TM20K 靠"一次性教师保留全量 token + 学生规则化 token merge + 蒸馏"来压缩序列,ReST 靠共享前缀复用而不压缩。不过它对本文的价值极高,已移到"讨论与局限性"里作为 Advv 量级与 ULT 新颖性的对照。
- HyFormer HyFormer(字节 AML/Search, 2026-01-23)——同公司、未被引用,且 Global Token + Query Decoding 的形态与 ReST 的语义 query token 跨注意力颇为相似。剔除理由:问题陈述方向相反——HyFormer 追求把序列建模与特征交互紧耦合进一个统一 Transformer,ReST 的整篇论证恰恰建立在"必须把两者拆开才能分别 scaling"之上。
- MixFormer MixFormer / OneTrans OneTrans / RankMixer RankMixer——统一单栈 scaling 路线。剔除理由:ReST 自己在 related work 里把这条线定位为"强化联合特征交互栈、与本文聚焦行为序列本身互补",属于引用/对照关系而非双同构,交给 DAG 处理。
八、讨论与局限性¶
8.1 值得借鉴的设计¶
"把不对称当成一等公民"是本文可迁移性最高的思想。 具体到工程上有三条:(1) PF-KV 是一个纯赚设计——编码器已经产出上下文化表征,解码器就没必要再投影一次 K/V,Table 3 里它把 FLOPs 开销从 +6.7% 压到 +0.2% 而 AUC 一分不掉;(2) TSP 用"每个 token 只激活自己那套参数"换来 +473% 参数、+0.2% FLOPs,是稀疏容量在小 token 集合上的一种非常廉价的实现;(3) 辅助目标全部设计成训练期存在、推理期移除(辅助 CVR 头、两个 MLP 投影头),这让它们可以无成本地开给所有基线,也是主对比归因公允的前提。
方法论可扩展性上 ReST 是干净的。 与 SIF / IAT 那种"先离线压缩再在线建模"的范式相比,ReST 没有任何被固化的中间表征:编码器沿长度/深度/宽度端到端 scaling,解码器容量沿 TSP 扩张,两条路径可以随参数量一起增长,不存在"压缩器与下游模型无法联合优化"的结构天花板。这是它相对同类工业方案的一个长期优势。
8.2 独立复核一:辅助 CVR 目标是不是收益的主要来源?¶
这是本文最需要独立判断的一点。Table 4 显示 $\mathcal{L}_{\text{seq}}$ 对 LLaMA 的 Large 档增益(+0.22%)反而大于对 ReST 的(+0.12%),而这个辅助目标是架构无关、只在训练期存在的正交技巧。直觉上这似乎在稀释"scaling 序列 Transformer"的净贡献。但把 Table 1 与 Table 4 一起算,结论是相反的:
| Large 档 | 主表 AUC Δ(辅助目标已开启) | $\mathcal{L}_{\text{seq}}$ 贡献 | 反推「关掉辅助目标」 |
|---|---|---|---|
| LLaMA | +0.70% | +0.22% | ≈ +0.48% |
| ReST | +0.92% | +0.12% | ≈ +0.80% |
| ReST − LLaMA 差距 | +0.22% | — | ≈ +0.32% |
也就是说,辅助目标是一道"托高所有人"的水位线,而且它托 LLaMA 比托 ReST 更多。主对比里对所有序列基线一视同仁地开启它,不但没有让 ReST 占便宜,反而压缩了 ReST 的相对优势——如果全部关掉,ReST 对 LLaMA 的领先会从 0.22% 扩大到约 0.32%。因此评分 agent"归因公允、不扣分"的判断方向正确,但理由可以更强:这个设置对 ReST 是保守的。论文自己的解读("ReST 的 rec-native 编码器对辅助目标依赖更小")与这个算术一致。
但真正的漏洞在另一处,而且论文没有堵上:图 4(a) 的序列长度 scaling 曲线只画了 "LLaMA w/o Aux. Seq-CVR",从来没有画 "ReST w/o Aux. Seq-CVR"。全文最有说服力的那条主张——"rec-native 设计让模型能更有效地利用更长的用户历史"(ReST 一路涨到 16k、额外 +0.4% AUC)——因此没有在"关掉辅助目标"的条件下被验证过。论文自己在同一段里承认,没有辅助监督时 LLaMA "延长上下文几乎带不来任何额外提升";那么读者完全有理由追问:长度 scaling 到底是 rec-native block 解锁的,还是辅助序列 CVR 监督解锁的、block 只是决定了斜率? 从 Table 4 的反推看,答案更可能是"两者都需要、且 block 贡献更大",但这需要一条缺失的曲线来坐实。
一个附带的、论文没有澄清的细节:Table 1 的脚注只说"所有序列建模基线在训练时都使用辅助序列 CVR 损失",没有说 $\mathcal{L}_{\text{align}}$ 是否也对所有基线开启。若对齐损失只开给 ReST,那么 Table 1 里 ReST 的数字含有约 +0.06% 的额外优势(Table 4 最右列)——相对 0.22% 的差距是不可忽略的比例。这属于应当写清而未写清的实验细节。
净判断:本文关于"序列 Transformer 可以继续 scaling"的主张成立且归因基本可靠;辅助目标不是收益的主要来源,反而是抬高基线的因素。但"长度轴收益归属"这一条在实验上仍是开放的,且它恰好是标题(From Language to Behavior)与摘要("behavior-sequence scaling remains an under-exploited axis")最依赖的那条轴。
8.3 独立复核二:MoE 的零收益(已核实)¶
Table 3 Architecture 组第二行确认无误:+ MoE in T:AUC Δ +0.00%、Param Δ +500%、FLOPs Δ +0.2%。这是一个真正的加分项——在一篇主张"该 scaling 序列模型"的论文里主动报告"最流行的加参数手段在这里一分不涨",需要克制。正文的解读也到位:编码器容量本身不是限制因素,因此应该把容量投到异质的、候选条件的解码器上。
需要给这个负结果加一层边界:论文只给了一行数字,没有说明专家数、top-k、路由粒度、是否只替换 FFN、以及是否为 MoE 单独调过学习率或负载均衡(只引用了 [30] 的 auxiliary-loss-free 负载均衡策略)。因此它是"在本文这个配置下 MoE 无效"的一个数据点,而非"MoE 对推荐序列编码器无效"的一般性结论——归档里 AIR-MoE、LoopCTR、MTmixAtt 等工作在别的位置用 MoE 拿到过正收益。恰当的读法是:它有力地支持了"容量不是瓶颈"这个局部诊断,但不足以支持更强的普遍主张。
8.4 独立复核三:+11.93% 这个营收量级站得住吗?¶
先纠正口径。 论文正文写的是"We use a revenue-related business metric, Advertiser Value (Advv), as the primary online metric"——它是广告主价值(广告带来的转化价值),不是平台广告营收。摘要里的措辞是 "lifts a core revenue metric by 11.93%",属于把 Advv 概括为"核心营收类指标",读者很容易顺势理解成平台营收,但论文本身并没有这么声称。这个区别很实质:本文改的是 CVR 预估模型,在 oCPM/目标转化出价的拍卖系统里,转化预估变准会直接改变分配与配速,广告主侧的转化价值可以被放大得远比平台营收剧烈。
口径逐条核对(论文给了什么、没给什么):
| 维度 | 论文给出的 | 缺失的 |
|---|---|---|
| 指标定义 | Advertiser Value(Advv),营收相关业务指标 | 是否人均/归一化、是否含税费返点、归因窗口 |
| 范围 | TikTok Shop Ads——一个广告产品,非 TikTok 广告全量、更非字节全量 | 是否进一步限定在某类广告主/品类 |
| 分流 | 用户随机分配,实验组 20% 生产流量 | 对照组流量占比、分桶数、AA 检验 |
| 对照 | 强生产 DLRM 排序器,只替换序列建模组件 | 对照组序列模块的具体配置 |
| 窗口 | 一周 | 无逐日曲线;CVR 有延迟反馈(论文自己引 [4, 18]),一周窗口内转化成熟度存疑 |
| 统计 | $p < 0.01$,"统计显著" | 无置信区间、无绝对基线值、无方差、无效应量 |
| 护栏 | "满足所有其他被监控的生产护栏" | 护栏具体是什么、成本/覆盖/广告主结构是否有位移 |
| 后续 | 已全量部署 | 无上线后 holdback 或长期回归数字 |
量级的横向与纵向校准(数据均来自本归档已精读论文):
- 纵向(同公司、同指标、最可比):TM20K TM20K(字节, 2026-08-07)在字节电商广告 CVR 场景做 5K→20K 序列长度 scaling,报告 ADVV(Advertiser Value)+0.780%、ADSS +1.036%,延迟 +5.6%。同一家公司、同一个指标名、同一类任务、同一条"序列 scaling"技术路线,收益差了约 15 倍。 这是对 +11.93% 最有力的一个反向压力测试。
- 横向(不同公司、同类改动):SpecFormer SpecFormer 在阿里电商广告报 CVR +15.97% / Order +16.72%,而 CTR 只有 +1.34%——说明当改动作用在转化侧模型上时,转化/订单类业务指标出现双位数提升在广告拍卖系统里确实会发生,机制上并不离奇。
- 对照的保守样本:TransRetrieval TransRetrieval 报 +2.53% 平台营收,但那是一个月窗口、5% 流量、$p<0.0001$,且指标是平台营收;CCFormer CCFormer 报 +1.71% 广告收入;归档里工业 A/B 的平台营收类提升确实多在 +2%~+6% 区间。
结论:这个数字不能按"核心营收 +11.93%"来引用。准确的表述是"在 TikTok Shop Ads 这一个广告产品上,一周 20% 流量的 A/B 中广告主价值(Advertiser Value)提升 11.93%($p<0.01$)"。它的性质(CVR 模型改进经拍卖放大到转化价值指标)是可信的、有同类先例的;它的量级相对本公司最可比的公开数字(TM20K ADVV +0.780%)高出一个数量级,而论文没有提供置信区间、绝对基线、逐日曲线或延迟反馈处理来支撑这个量级。已全量部署是最强的旁证,但论文没有给出上线后的 holdback 数字。建议在引用时降级为"量级待考、方向可信",并优先引用同文的 AUC +1.31% 与 Table 1 的 +0.92% AUC Δ——这两个数字的可核查性高得多。
8.5 其他局限与争议¶
-
工业数字全部是相对量,无法外部核验。因保密约束,工业侧只报 AUC Δ 而不报绝对 AUC、数据规模、序列平均长度、$N$ 的典型值、模型总参数量。"0.05% AUC Δ 有实践意义"这个标尺也只是作者给的断言。所有工业结论都必须信任作者。
-
组件几乎都是既有技巧的移植与重组。有界门控注意力来自 [14, 25] 与 HSTU [37] 的改良,RoPE 来自 [28],Mix-LN 来自 [20],残差小标量来自 ReZero [1],sigmoid 对比损失来自 SigLIP [38],shared-prefix serving 明确借鉴 M-FALCON [37]。真正原创的是 RoTE(多粒度旋转时间编码 + 相对时间性质证明)、sequence starvation 的诊断与对策、以及 $T$/$C$ 非对称分解这三件。这不减损工程价值,但"rec-native"这个标签下的多数零件其实是"LLM-native 零件的推荐化调参"。
-
未引用三篇同公司的高度相关工作:IAT(2604.08933,字节,2026-04)、TM20K(2608.07055,字节,2026-08,只比本文早三周半)、HyFormer(2601.12681,字节 AML,2026-01)。尤其 TM20K 与本文同为字节广告 CVR 的序列长度 scaling,且给出了同名的 ADVV 指标,本应是最自然的对照。同时 ULT(user-level shared-prefix training)在字节内部并不新:TM20K 精读记录其线上基线已经在用 "User-Level Training",而本文把 ULT 作为贡献并报告 5.8× 训练吞吐、其基线描述里只列了融合 kernel / 混合精度 / padding removal。两个团队的基线不同是可能的,但读者有理由要求作者说明 ULT 与已有内部实践的关系。
-
公开 benchmark 的证据强度有限。ML-1M 上 ReST 对 LLaMA 只领先 0.0012 AUC,Books 上对 HSTU 只领先 0.0005;无重复实验、无方差、无显著性检验;且把序列推荐协议改造成 pointwise 任务的做法使结果无法与该数据集上的其他文献直接比较。此外 Books 上 HSTU 反超 LLaMA,与工业数据集上的排序相反,说明基线强弱本身随分布变化。
-
消融的可加性未被验证。Table 3 的四个组各有各的局部 base,Table 4 是各骨干上的独立 delta;论文从未展示"逐个组件累加能复现 Table 1 的 +0.92%"。所有基于 delta 的反推(包括 §8.2 里我做的那个)都只是指示性的。
-
成本侧留白。$T$ 每请求只算一次固然便宜,但 16k 上下文的编码器在训练侧的绝对开销、shared-prefix serving 所需的显存/KV 存储、以及 ULT 的分组时间窗如何选,论文都未讨论。部署配置具体是多深多宽、序列长度取多少也没有披露——线上跑的到底是不是那个 16k / $d$=512 的最佳点,读者无从知晓。
-
单目标、单场景。全文只做 CVR 一个任务、只在电商广告一个场景验证。ReST 的非对称分解依赖"用户历史编码可以与候选无关"这一前提,在需要强 target-aware 早期交互的场景(论文自己引的 DIN/SIM/SDIM 谱系)下这个前提是否成立、代价多大,没有讨论。