ChronicleRec: Pre-training Temporally Anchored Tokens for Lifelong User Modeling¶
Tencent Inc. (China) × University of New South Wales (Australia),arXiv:2609.12375v1,cs.IR,2026-09-11。 作者:Chengkai Huang*, Yubin Sheng*(通讯), Liang Guo*, Haoxi Liu*, Junwei Pan, Shangyu Zhang, Zhixiang Feng, Chao Zhou, Chengguo Yin, Lina Yao, Haijie Gu, Jie Jiang(* 表示同等贡献)。
一句话总结¶
ChronicleRec 把终身行为序列建模从「按候选检索证据」重构成「预训练目标无关的用户表征」:用 recency-aware 多粒度合并把超长历史压成近细远粗的有序序列,再把可学习 query token 交织进这条序列并用因果编码器读出,使每个 token 成为一个有明确时间感受野的「Chronicle Token」;多分支 mask 掉不同长度的近期历史以覆盖多个时间视野;最后用 mask-and-predict 的 Chronicle Alignment 预训练把「压缩的过去」对齐到「近在眼前的意图」。因为 token 与候选无关,可按用户缓存并异步回写,把超长序列编码彻底移出在线打分路径;KuaiRand 与腾讯 AdLive 上逼近 full-attention,微信朋友圈广告 pCVR 七天 A/B GMV +1.61%。
一、研究动机与背景¶
1.1 终身行为序列的「表达力 vs 效率」张力¶
现代推荐与广告平台上,用户与平台交互数月到数年后,行为历史会增长到数千甚至数万条 action。论文给出的经验判断是:把建模历史从几十条扩到几千条,CTR / CVR 会持续获益——这段终身历史编码了短窗口看不到的稳定长期偏好。但在工业规模上利用它,受制于一个根本张力:
- 一端:把完整历史喂进 self-attention ranker,表达力最强,但复杂度随序列长度二次增长。单次请求要在严格延迟预算内给数百个候选打分时不可承受。
- 另一端:截断到最近 $L$ 条行为,便宜,但静悄悄地丢掉了往往对转化起决定作用的长程兴趣信号。
1.2 主流折中:target-attention 检索,及其两个结构性缺陷¶
工业界的主流折中是 target-attention retrieval:为每个候选从长历史中检索出一小撮 target-relevant 行为,只对这些行为打分(SIM、ETA、SDIM、TWIN 一脉)。论文指出该范式有两个结构性缺陷:
- 表征是 target-dependent 的:必须为每个候选重算,于是长序列建模的成本被候选数乘一遍;
- 按类目或 embedding 相似度硬检索会过度聚焦「表层相似于 target」的行为,无法代表用户宽而多尺度的兴趣结构。
1.3 另一条路:target-independent 压缩,及 VISTA 留在桌上的价值¶
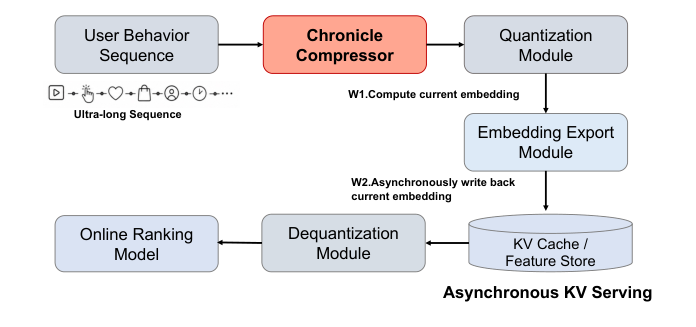
近期出现的替代方案绕开了 per-candidate 检索:把历史一次性压缩成一个与候选无关的 summary,从而可缓存、可跨候选复用(Figure 1)。代表工作 VISTA 把一组可学习 query token 追加在历史末尾,让它们双向注意整段历史,产出一袋 summary token。
论文承认 VISTA 是「迈向 target-independent 建模的真正一步」,但认为它在两处留下了价值:
- 把所有 query token 放在尾部、再作为无序的「bag」读出,坍塌了历史的时序结构——这个 summary 本质上是「sequence-in, tokens-out」;
- 双向注意让每个 query 都能窥视整条时间线,于是没有任何一个 query 被绑定到某个具体时刻,产出的 token 倾向于冗余而非互补。
论文后续的 token 级分析(§4.7、§4.8)正是为了实证这两点。
1.4 ChronicleRec 的立场与四个挑战¶
作者的立场转换是:不要把终身历史当成「服务时按候选检索的证据」,而要当成「预训练 target-independent 用户表征的语料」。ChronicleRec 从每个用户的终身历史预训练一组小而定长的时间锚定 token(Chronicle Tokens):不追加在末尾,而是交织进历史内部并因果地各自总结,于是 token 沿时间轴排布,每个 token 只总结自己锚点之前的历史。在这个意义上 ChronicleRec 遵循 sequence-in, sequence-out 原则——预训练出的用户表征本身就是一条短的、按时序排列的 token 序列,而不是一袋与顺序无关的 latent summary。
论文把实现这一视角归纳为四个挑战(前三个关于怎么压,最后一个关于压缩后的过去如何影响现在):
- (C1) 压什么、以什么粒度压。用户兴趣在时间上不均匀:近期行为细粒度且高度可预测,久远行为主要以粗粒度聚合偏好的形式起作用。统一的压缩率要么浪费容量在久远过去,要么模糊掉信息量最大的近期历史。
- (C2) 如何在不泄漏未来的前提下压缩。token 应当以因果、保序的方式总结历史,使每个 token 有良定义的时间感受野,而不是把序列坍塌成与顺序无关的池化向量。
- (C3) 如何覆盖多个时间视野。单趟压缩容易被最近的行为主导,久远但决定性的兴趣会被冲淡。
- (C4) 如何让过去真正影响现在。压缩表征总结的是过去,而排序关心的是当下;过去行为对当前决策的影响是间接且非平稳的,原始历史摘要不能直接喂给 ranker,必须先对齐到它要服务的「近在眼前的兴趣」。
四个挑战对应四个组件:recency-aware 多粒度合并(C1)、因果 query-token 交织(C2)、多分支多视野压缩(C3)、Chronicle Alignment 预训练(C4)。
1.5 贡献自述¶
- 把终身用户建模形式化为 target-independent 表征预训练,引入保留时序结构、且把历史编码与候选打分解耦的 Chronicle Tokens;
- 提出 ChronicleRec 这一 pre-train-and-transfer 框架,组合 recency-aware 多粒度合并、因果 query-token 交织、多视野压缩与对齐导向的预训练;
- 公开与工业数据集上的离线 + 在线实验表明:预训练的 Chronicle Tokens 改善下游排序、以低得多的服务成本恢复 full-attention 的大部分性能,并在生产中带来显著业务收益。
二、相关工作¶
2.1 终身用户兴趣建模¶
从 MIMN(维护定长、在线更新的用户 memory)的记忆网络路线,演进到主导当下工业实践的两阶段检索式方法。SIM 引入 GSU(General Search Unit)从终身历史检索 target-relevant 行为,再由 ESU(Exact Search Unit)在检索出的子集上做精确注意力;后续工作用 LSH、hashing-based sampling、两阶段一致性等手段降低检索与注意力成本或提升检索保真度(ETA、SDIM、TWIN 系)。打分阶段的骨干是 DIN / DIEN 这类以 target 激活历史的注意力兴趣抽取器。这条线的共同点是长序列表征是 target-dependent 的,服务成本随候选数增长。ChronicleRec 的差异在于产出每用户算一次、跨候选共享的 target-independent 摘要。
2.2 超长序列的压缩式范式¶
另一条互补路线是把长输入压缩成少量 latent token 而非从中检索。视觉-语言领域 BLIP-2 的 Q-Former 用一组定长可学习 query token 把变长特征图蒸馏成紧凑 query 集合;Perceiver 式架构同样用 cross-attention 把长输入映射到一个小的 latent 数组。线性注意力等高效注意力技术则从另一侧降低二次成本。推荐领域最接近的是 VISTA:把用户历史总结成几百个可缓存 token,再让候选注意这些 token,使训练与服务成本在历史增长到终身尺度时保持恒定。ChronicleRec 与之共享「target-independent、缓存复用」的哲学,差异在于摘要是怎么构成的:VISTA 是单趟摘要,ChronicleRec 引入 recency-aware 多粒度合并与因果 query-token 交织,使压缩 token 尊重用户兴趣沿时间的非均匀结构,并用多分支设计显式覆盖多个时间视野。
三、核心方法:Chronicle Compressor¶
3.1 问题形式化与总览¶
设用户的超长行为历史按由旧到新排列为 $\mathcal{H} = (b_1, \dots, b_L)$,每条行为 $b_i$ 由一组类别字段描述(本文设定下为 item/video ID、author/advertiser ID、content tag 三元组)。Embedding 层把每条行为映射为 $d$ 维向量,得到序列嵌入 $E \in \mathbb{R}^{L \times d}$ 以及标记 padding 位置的有效性 mask $\mathbf{m} \in \{0,1\}^L$(历史做左填充,因此下标越大越新)。给定候选 item 嵌入 $\mathbf{t} \in \mathbb{R}^d$,ranker 预测交互概率 $\hat{y} = f(\mathcal{H}, \mathbf{t})$,用二元交叉熵对观测标签 $y$(如 effective play 或 conversion)训练。
ChronicleRec 的核心是一个 target-independent 压缩器
$$g: (E, \mathbf{m}) \mapsto C \in \mathbb{R}^{P \times d},$$
把长度为 $L$ 的历史变成一小组 $P \ll L$ 的 Chronicle Tokens,再由一个共享的排序头消费。因为 $g$ 不依赖 $\mathbf{t}$,$C$ 每用户只需算一次并在所有候选间复用——这是整个工作的支点。
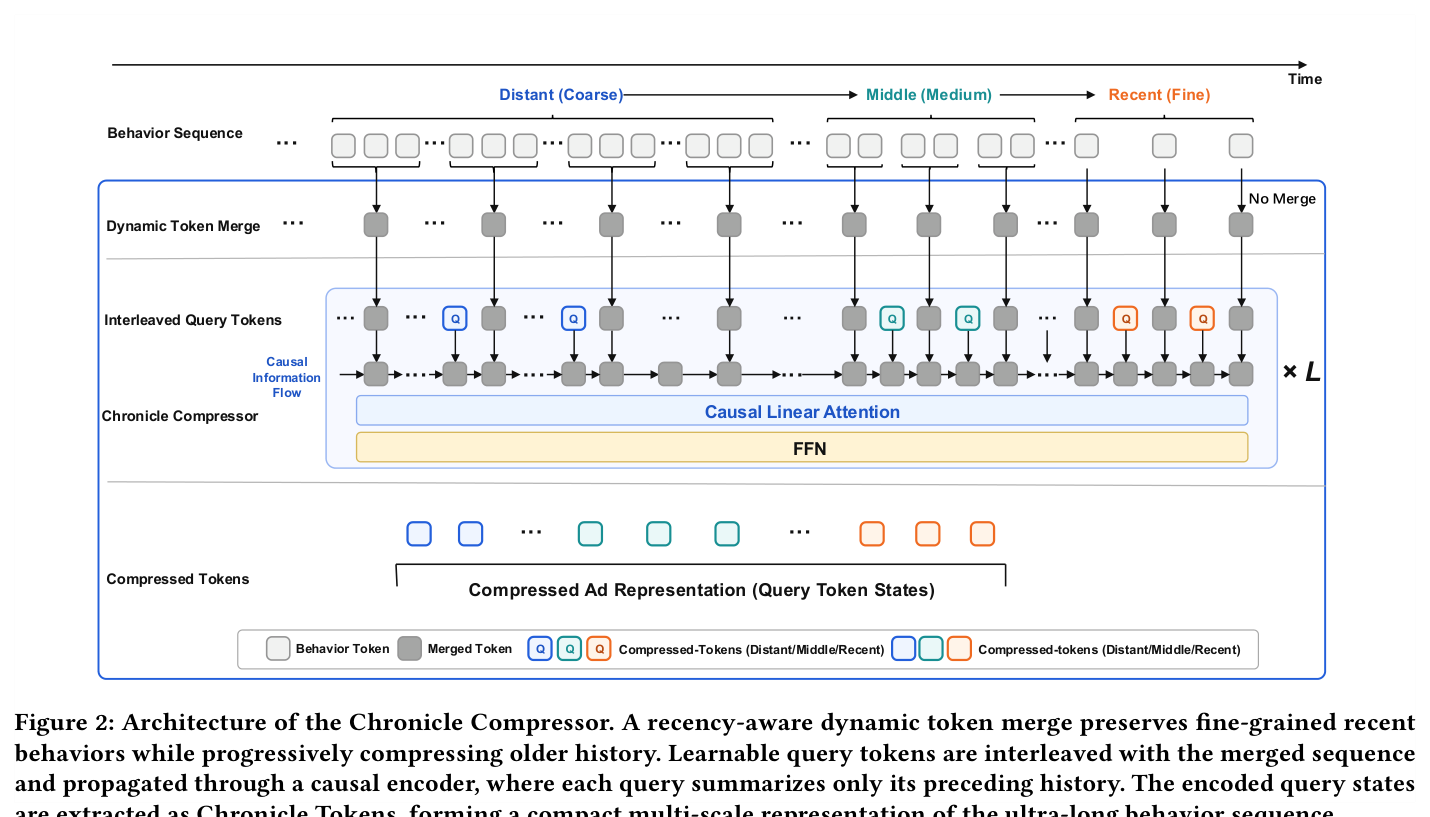
Figure 2 给出完整链路:行为序列 → Dynamic Token Merge(Distant 粗 / Middle 中 / Recent 不合并)→ 交织 Query Token → Causal Linear Attention + FFN 堆叠 $L$ 层 → 读出 query 位置的状态作为 Compressed Tokens(按 Distant / Middle / Recent 分色)。
3.2 Recency-Aware 多粒度合并(C1)¶
由于近期行为比久远行为更可预测,压缩必须是非均匀的。论文把有效历史按由旧到新切成三段:far(久远过去)、mid(中段)、near(最近行为)。给定保留的近期行为预算 $n$ 与目标 mid 长度,段边界为
$$\text{near} = \text{最近 } n \text{ 条行为}, \qquad \text{mid},\ \text{far} = \text{其余更老的历史}. \tag{1}$$
每段用带 mask 的滑窗平均池化总结,每段有各自的 kernel 与 stride:near 段保持全分辨率(stride 1,即不合并);mid 段用中等 kernel/stride;far 段用大 kernel/stride 做激进聚合。对覆盖源位置集合 $\mathcal{S}_w$ 的窗口 $w$,合并 token 为
$$\mathbf{u}_w = \frac{\sum_{i \in \mathcal{S}_w} m_i E_i}{\max\left(\sum_{i \in \mathcal{S}_w} m_i,\ 1\right)}, \qquad \tilde{m}_w = \mathbb{1}\!\left[\sum_{i \in \mathcal{S}_w} m_i > 0\right], \tag{2}$$
其中 mask $m_i$ 保证 padding 位置绝不会泄漏进合并 token;分母的 $\max(\cdot, 1)$ 避免全 padding 窗口除零。把三段的窗口沿时序拼接,得到按时序排列的合并序列 $U \in \mathbb{R}^{M \times d}$ 与 mask $\tilde{\mathbf{m}}$,其中 $M \ll L$,分辨率近处密、远处疏。
两个工程细节值得注意:
- 对短历史用户,far 段的窗口落在左填充上并被 mask 掉,因此该合并等价于「只压缩真实存在的行为」,无需额外分支逻辑;
- 给定最大长度后,窗口到源位置的分配是静态的,因此整个合并实现为一次向量化的 gather-and-pool,开销可忽略。
3.3 因果 Query-Token 交织(C2)¶
为得到定长、保序的摘要,引入 $P$ 个可学习 query token $Q \in \mathbb{R}^{P \times d}$,按一组锚点位置交织进合并 token $U$。锚点按「距合并序列最新端的偏移」放置,近处密、越往过去越疏,使近期历史以更细的时间分辨率被总结。交织后得到一条混合序列,其中每个 query token 锚定在一个具体的时间位置上。
混合序列由一个轻量 Transformer 编码器处理,使用因果注意力 mask:每个位置只能注意到自己及之前的位置,padding 的合并 token 额外作为 key 被屏蔽。于是每个 query token 恰好总结到自己锚点为止的历史,拥有良定义的时间感受野。为避免出现「整行全被 mask」的退化情况(短历史用户的久远 query 会遇到,会让 attention softmax 数值不稳定),自身位置始终保持可见。编码后读出 query 位置的编码器状态作为压缩输出:
$$C = \text{Encoder}_{\text{causal}}\big([U; Q]_{\text{interleaved}}\big)\Big|_{\text{query positions}} \in \mathbb{R}^{P \times d}. \tag{3}$$
这就是 Chronicle Tokens。
论文还考虑了一个 Q-Former 风格变体作为压缩器的另一种实例化:先用带步长的卷积子序列编码器下采样历史,再让一组 query token 通过双向线性注意力编码器去注意它;实验中与之对比(对应 §4.3 的 interleaved/end × causal/bidirectional 四宫格)。
3.4 多分支多视野压缩(C3)与 Chronicle Alignment(C4)¶
多分支设计。 单趟压缩会被最近行为主导,久远但决定性的兴趣容易被冲淡。因此使用 $B$ 条并行压缩分支,分支 $j$ 在压缩前 mask 掉最近的 $\delta_j$ 条行为,其中 $0 = \delta_1 < \delta_2 < \cdots < \delta_B$,于是 $\delta_j$ 越大的分支被迫关注越久远的视野。每条分支有自己的 query token 与编码器,产出前缀 $C^{(j)} \in \mathbb{R}^{P \times d}$。各分支前缀按分支权重 $w_j$ 缩放后拼接成最终 Chronicle token 集合:
$$C = \big[w_1 C^{(1)};\ w_2 C^{(2)};\ \dots;\ w_B C^{(B)}\big] \in \mathbb{R}^{(B \cdot P) \times d}. \tag{4}$$
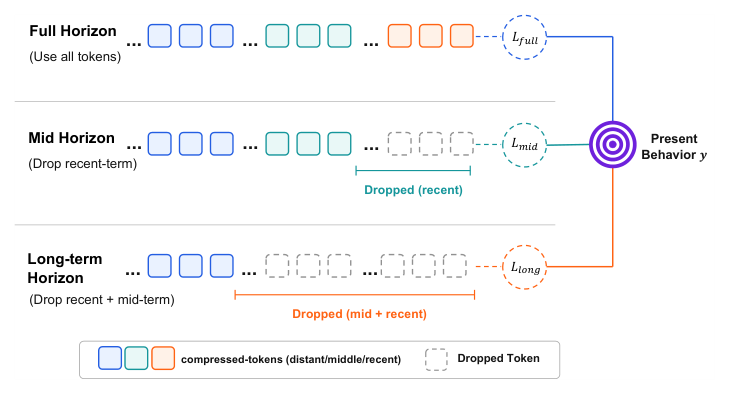
Figure 3 直观展示:Full Horizon 用全部 token;Mid Horizon 丢掉 recent-term;Long-term Horizon 丢掉 recent + mid-term;每条分支都被独立监督去预测「当下的行为 $y$」。
Chronicle Alignment。 尽管 Chronicle Tokens 总结了历史行为序列,下游 ranker 最终需要的是对近在眼前的用户意图有预测力的表征。因此引入 Chronicle Alignment 目标把压缩的过去与当下的决策信号对齐:对每条视野分支 $j$,在压缩前 mask 掉一个近期行为窗口,把该分支前缀 $C^{(j)}$ 送进一个轻量 target-attention 头去预测被留出的目标标签 $\hat{y}_j$。各分支以加权对齐损失联合优化:
$$\mathcal{L}_{\text{align}} = \sum_{j=1}^{B} \bar{w}_j\, \text{BCE}(\hat{y}_j, y), \qquad \bar{w}_j = \frac{w_j}{\sum_{k=1}^{B} w_k}. \tag{5}$$
这个目标迫使每条分支把自己压缩的历史上下文投影到近在眼前的兴趣信号上,同时鼓励不同视野保留互补的预测性信息。推理时辅助头被移除,拼接后的前缀 $C$ 作为紧凑的 Chronicle memory 传给共享 ranker。
这是论文对 (C4) 的直接回答,也是「mask-and-predict 预训练」的具体形态:用被留出的近期行为的真实标签做监督,重建「过去 → 现在」的映射。注意它并非自监督重建被 mask 的 item,而是用观测到的交互标签 $y$ 做 BCE 监督,因此更接近「用未来标签蒸馏历史表征」。
3.5 下游排序与两阶段训练¶
Chronicle Tokens 由一个共享排序头消费:堆叠若干层 Pre-LN self-attention,再接一个 target-attention read-out——候选嵌入 $\mathbf{t}$ 作为 query 在 token 上查询得到兴趣向量,与 $\mathbf{t}$ 拼接后由 MLP 打分。
ChronicleRec 支持两种使用模式:
- compress-only:排序头只消费 Chronicle Tokens(替代原始长历史);
- hybrid:Chronicle Tokens 作为前缀拼在一小段细粒度近期行为窗口之前,再进排序头。
关键的实验纪律是:所有变体共享同一个排序头,因此任何精度差异都归因于压缩步骤而非头的容量。
训练分两阶段:Stage 1 用 Chronicle Alignment 目标预训练压缩器;Stage 2 把压缩器载入 ranker 做端到端训练,压缩器或冻结或微调。
四、实验设置¶
4.1 数据集¶
| Statistic | KuaiRand-27K | Tencent AdLive |
|---|---|---|
| #Users | 27,285 | 199,914 |
| #Items | ~32M | 10,181,793 |
| #Tags/Industries | 59 | 317 |
| #Interactions | ~322M | 213,859,057 |
| Avg. hist. len. | 11,811.6 | 1,069.8 |
- KuaiRand(KuaiRand-27K split):公开短视频推荐 benchmark,行为历史极长——平均每用户接近 12K 个事件,最活跃用户达 228K——且视频空间极稀疏,是超长序列建模的理想试验场。使用
is_click作为正样本信号。 - Tencent AdLive:从生产系统采样的工业在线广告(直播)数据集,从超过 12.7M 用户池中采样近 200K 用户,平均历史长度接近 1,070,点击为正样本。
由于原始历史远超 ranker 能消费的长度,两者都做左填充并截断到最大长度 $L_{\max}$:KuaiRand 为 2,048,AdLive 为 4,000。每条行为由 item/creative、author/advertiser、tag/industry 三个 ID 表示。
4.2 Baseline 与变体¶
为隔离压缩的效果,所有方法共享同一个排序头,只在「如何把超长历史变成 token」上有差异:
- Full-Attn:对整段历史做完整 self-attention——昂贵但表达力强的上界参照;
- Short-Attn:只对最近 100 条行为做 self-attention——便宜的近期窗口基线;
- VISTA:两阶段压缩式长序列编码器,把用户历史总结成几百个可缓存 token 供候选注意;作为代表性的单趟压缩基线;
- ChronicleRec:本文的 recency-aware 三段式压缩器(§3.2–3.3),只消费 Chronicle Tokens;
- Hybrid-ChronicleRec:Chronicle Tokens 作为前缀拼在近期窗口 token 之前(§3.5);
- Multi-ChronicleRec:完整的多分支多视野设计 + 深度监督(§3.4)。
4.3 指标与超参¶
指标:主精度指标为 GAUC(按用户分组的 AUC)。所有模型共享 embedding 层、头架构与训练调度。
架构:模型维度 $d_{\text{model}} = 64$(video / author / tag embedding 分别为 64 / 16 / 16)。Chronicle 压缩器采用 recency-aware 多尺度合并:最近 near_keep = 100 个事件按 1:1 保留;长度 400 的 mid 段用 kernel/stride = 8/4 合并;far 段用 kernel/stride = 10/10。因果 Transformer 编码器为 4 层、4 头、dropout 0.1,默认 $P = 11$ 个 query token 产出 Chronicle Tokens。多分支变体使用 drop offsets $\{\delta_j\} = \{0, 100, 300, 600, 1000\}$,分支权重 $\{w_j\} = \{1.0, 0.5, 0.4, 0.3, 0.2\}$。预测头是 2 层 target-aware attention 模块(4 头,dropout 0.1)。
按超参推算的压缩率(论文未直接给出):以 KuaiRand 的 $L_{\max} = 2048$ 计,far 段约 $2048 - 100 - 400 = 1548$ 条 → 约 155 个合并 token;mid 段 400 条、stride 4 → 约 100 个;near 段 100 条不合并 → 100 个。合并序列 $M \approx 355$。多分支 $B = 5$、每支 $P = 11$,最终 $C \in \mathbb{R}^{55 \times 64}$,即把 2048 条行为压成 55 个 token(约 37×),这也是「可按用户缓存」在存储上成立的前提。
训练:BCE 损失,Adam(lr $= 10^{-3}$,weight decay $= 10^{-6}$),linear warmup 后接可选的 cosine decay。batch size 为 256(KuaiRand)/ 512(AdLive),训练 3 epoch,early stopping。
五、主要实验结果¶
5.1 主表(Table 2)¶
Table 2: Main results (GAUC) on KuaiRand and Tencent AdLive. 所有方法共享同一排序头,唯一变量是超长历史如何被 token 化。
| Method | Mechanism | KuaiRand | AdLive |
|---|---|---|---|
| Full-Attn | Full self-attention | 0.5601 | 0.8071 |
| Short-Attn | Recent-window attention | 0.5307 | 0.7950 |
| VISTA | Single-pass compression | 0.5518 | 0.7995 |
| ChronicleRec | Three-segment compression | 0.5536 | 0.8010 |
| Hybrid-ChronicleRec | Recent + far compression | 0.5541 | 0.8030 |
| Multi-ChronicleRec | Multi-horizon compression | 0.5580 | 0.8034 |
结论分析:
- 扩长历史确实有用。Full-Attn 在 KuaiRand 达 0.5601、AdLive 达 0.8071,显著高于 Short-Attn 的 0.5307 / 0.7950(分别 +0.0294 / +0.0121)。这确认了久远历史携带决定性的兴趣信号,短窗口会把它丢掉。这一对照本身就是全文的立论前提。
- 一小组 Chronicle Token 能以极低成本收回大部分差距。Multi-ChronicleRec 在 KuaiRand 达 0.5580,距 Full-Attn 只差 0.0021(即收回了 Full-Attn 相对 Short-Attn 增益的 $0.0273/0.0294 \approx 92.9\%$),而只给排序头喂了一个紧凑前缀而非完整序列。
- 对单趟压缩基线 VISTA 全面占优。KuaiRand 上 VISTA 0.5518;三段式 ChronicleRec 已提到 0.5536(+0.0018),hybrid 到 0.5541,多分支到 0.5580(相对 VISTA +0.0062)。这说明按时序的非均匀压缩和多视野设计在通用 latent 压缩之外都有独立贡献。
- 工业数据集上顺序一致。AdLive 上 VISTA 0.7995 < ChronicleRec 0.8010 < Hybrid 0.8030 < Multi 0.8034,全部显著高于 Short-Attn 0.7950,并接近 Full-Attn 0.8071(Multi 距上界 0.0037,收回 $0.0084/0.0121 \approx 69.4\%$)。
值得注意的是:AdLive 上 Hybrid(0.8030)与 Multi(0.8034)几乎打平(仅差 0.0004),而 KuaiRand 上 Multi 明显领先 Hybrid(+0.0039)。这与两个数据集的平均历史长度差异(11.8K vs 1.07K)吻合——历史越长,多视野分支的边际价值越大,因为短历史本来就没有几个「久远视野」可分。论文未点明这一点,但它是对多分支设计动机的一个自洽旁证。
5.2 Query 放置与注意力方向(Table 3)¶
ChronicleRec 的核心设计选择是 query token 相对合并历史放在哪里以及信息怎么传播。论文做了两因素交叉:query placement(interleaved 分布式 vs end 全部追加在末尾)× attention direction(causal vs bidirectional)。
Table 3: Query-token placement and attention direction on Tencent AdLive (best GAUC).
| Placement | Direction | GAUC |
|---|---|---|
| Interleaved | Causal | 0.8034 |
| End | Causal | 0.7890 |
| Interleaved | Bidirectional | 0.7930 |
| End | Bidirectional | 0.7951 |
结论分析:
- interleaved-causal 配置最佳(0.8034)。
- 在因果编码下,把 query 沿序列分布比全部放在末尾提升 GAUC 0.0144——这是全文最大的单项设计增益。
- 对交织的 query,因果编码比双向编码提升 0.0104。
- 这两个因素是互补的,但也有交互:注意 end 放置下双向(0.7951)反而优于因果(0.7890)。论文没有专门讨论,但这个反转其实很有解释力——query 全在末尾时,因果 mask 并不能给它们制造不同的时间感受野(所有 query 都能看到几乎整条历史),反而白白截断了末尾 query 之间的相互可见性,于是因果成了纯损失。只有当 query 被分布到不同锚点上时,因果 mask 才把「位置」翻译成「良定义的时间感受野」。论文的表述是:交织把 query 分配到用户时间线的不同位置,因果编码通过限制每个 query 只看其之前的历史,把这些位置变成明确的时间锚点;两者结合产生的是一组按时序结构化的摘要,而非多个反复总结同一条全局序列的 query。
5.3 消融实验(Table 4)¶
Table 4: Ablation study on Tencent AdLive (GAUC). $\Delta$ 相对完整模型。
| Variant | GAUC | $\Delta$ |
|---|---|---|
| multi-ChronicleRec (full) | 0.8034 | – |
| w/o recency-aware merge(改为均匀 stride 合并) | 0.7958 | −0.0076 |
| w/o causal mask(即双向交织) | 0.7960 | −0.0074 |
| w/o multi-branch(单分支) | 0.7962 | −0.0072 |
| w/o deep supervision | 0.7995 | −0.0039 |
| w/o Chronicle Alignment(用未对齐压缩器训 ranker) | 0.7948 | −0.0086 |
逐项分析:
- 所有组件都是正贡献,没有一个是可有可无的装饰。
- 去掉 Chronicle Alignment 掉得最多(−0.0086),直接印证了 (C4) 这个挑战本身的重要性:把压缩的历史表征对齐到近在眼前的用户兴趣,比任何单项压缩结构的设计都更关键。换句话说,「怎么压」重要,但「压完了怎么让它对当下有用」更重要。
- 去掉 recency-aware merge(−0.0076)确认了非均匀、尊重时序的压缩的必要性;
- 去掉因果 mask(−0.0074)与去掉多分支(−0.0072)几乎等量,分别验证了时序有序的信息流与显式多视野建模;
- 去掉深度监督(−0.0039)——注意这一项与 w/o multi-branch 不同:多分支还在,只是不再对每条分支单独施加对齐监督。掉 0.0039 说明光有多条分支不够,必须逼着每条分支都对「当下」负责,否则分支容易退化成冗余副本。
三个消融(causal / multi-branch / deep supervision)与 §4.7–4.8 的 token 级分析在结论上闭环:它们共同解释「为什么交织 + 因果 + 多视野会产出互补而非冗余的 token」。
5.4 长程信号分析(Table 5)¶
为探明久远历史里究竟有多少预测信号,作者 mask 掉每个用户最近的 $N$ 条行为,让 ChronicleRec 只依赖剩下的更老的历史。
Table 5: Long-range signal analysis on KuaiRand (GAUC).
| Masked recent $N$ | GAUC | $\Delta$ |
|---|---|---|
| 0 (full) | 0.5580 | – |
| 100 | 0.5532 | −0.0048 |
| 300 | 0.5529 | −0.0051 |
| 500 | 0.5527 | −0.0053 |
| 1,000 | 0.5499 | −0.0081 |
结论分析:
- 性能随着更多近期行为被隐藏单调下降,从 0.5580 降到 0.5499,确认近期行为确实最具预测力;
- 但衰减是渐进而非灾难性的。即使把最近 1,000 个事件整块抹掉(占 $L_{\max}=2048$ 的近一半),模型仍有 0.5499 GAUC,远高于只看这些近期行为的 Short-Attn 基线(0.5307)。
- 论文由此得出一个很强的论断:久远历史本身就携带一个强的、自洽的兴趣信号,ChronicleRec 有能力把它压缩并利用。这直接支撑了 sequence-in / sequence-out 范式的动机——建模用户历史的长尾带来的增量信息远超近期窗口。
- 中间三档(100/300/500)之间差异很小(0.5532 / 0.5529 / 0.5527,跨度仅 0.0005),到 1000 才明显掉一档。这提示信号密度在最近 100 条内最高,100–500 之间相当平坦,与 §3.2 把
near_keep定在 100 的超参选择自洽。
5.5 复杂度与效率(Table 6)¶
Table 6: Complexity and efficiency. 同 batch size、同硬件下测量。
| Method | Params (M) | Mem (GB) | Train (min) |
|---|---|---|---|
| Full-Attn | 1229.9 | 49.1 | 2997.0 |
| Short-Attn | 661.2 | 16.2 | 1368.8 |
| VISTA | 1230.1 | 24.8 | 610.9 |
| ChronicleRec | 1230.0 | 28.0 | 620.3 |
| Hybrid-ChronicleRec | 1230.1 | 24.8 | 614.3 |
| Multi-ChronicleRec | 1230.4 | 34.8 | 855.1 |
结论分析:
- Full-Attn 显著更贵:49.1 GB 显存、近 3000 分钟训练,源于对整段历史做 self-attention;
- ChronicleRec 把显存降到 28.0 GB、训练时间降到 620.3 分钟,约 4.8× 训练加速,同时保住大部分预测性能;
- Hybrid-ChronicleRec 进一步把显存降到 24.8 GB、训练 614.3 分钟——比 compress-only 的 ChronicleRec 更省且更准(AdLive 0.8030 > 0.8010),是性价比最高的配置;
- Multi-ChronicleRec 付出额外成本(34.8 GB、855.1 分钟)换取多视野带来的精度增益,仍比 Full-Attn 便宜 3.5×。
- 参数量在各长历史方法间基本相当(≈1.23B),说明性能差异主要来自序列建模策略而非模型容量——这是该论文最重要的实验纪律。
论文特别强调:这些额外的压缩成本不必在服务时为每个候选支付。因为 Chronicle Tokens 是 target-independent 的,可每用户算一次并存进 feature cache,跨候选打分复用,从而把超长序列编码从在线排序路径上解耦下来(Figure 1 的异步 KV serving:W1 计算当前 embedding,W2 异步回写 KV cache,在线 ranking 只做 dequantization + 读取)。
5.6 Token 相似度分析(Figure 4)¶
为检验压缩 token 究竟编码了互补的时间信息还是坍塌成冗余摘要,作者可视化压缩 token 位置之间的成对余弦相似度,token 按从最久远锚点到最近锚点排序,并分组为 far / middle / recent 三个时间区域。
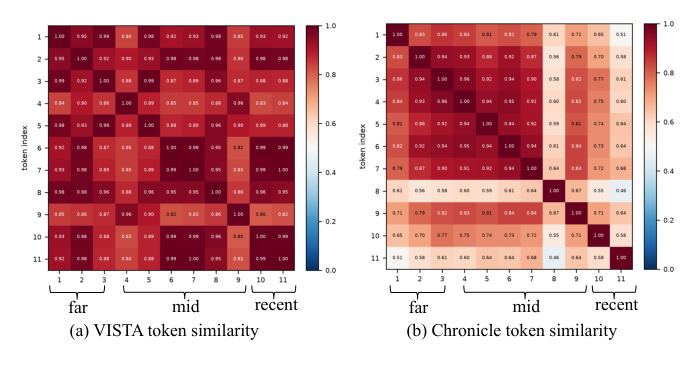
- VISTA 在很大一部分 token 对上呈现一致的高相似度,包括来自非相邻时间区域的 token 对。这说明「末尾追加 + 双向」的 query token 倾向于从完整历史中抽取相互重叠的全局摘要,导致表征冗余。
- ChronicleRec 呈现更结构化的相似度模式:学到的 Chronicle Tokens 形成可区分的时间块——同区域或邻近区域内的 token 高度相关,而相距较远区域的 token 相似度明显更低。
- 这个组织方式与「交织式因果 query 压缩」一致:每个 query token 插在特定时间锚点、只能聚合其历史上下文,因此不同 Chronicle Tokens 被鼓励去总结用户行为轨迹的不同阶段。
结论:ChronicleRec 改善的不只是被压缩信息的量,还有它在 token 位置上的组织方式。相比 VISTA,Chronicle Tokens 呈现更清晰的时间专门化与更低的跨区域冗余。
5.7 下游 target-attention 是否真的用上了多视野(Figure 5)¶
接着追问:Chronicle Tokens 编码的时间多样性是否真的被下游 ranker 用上了。作者为一个代表性用户可视化 target-attention 在 Chronicle Token 位置上的权重,token 索引从最久远锚点到最近锚点,虚线为均匀注意力 $1/P$。
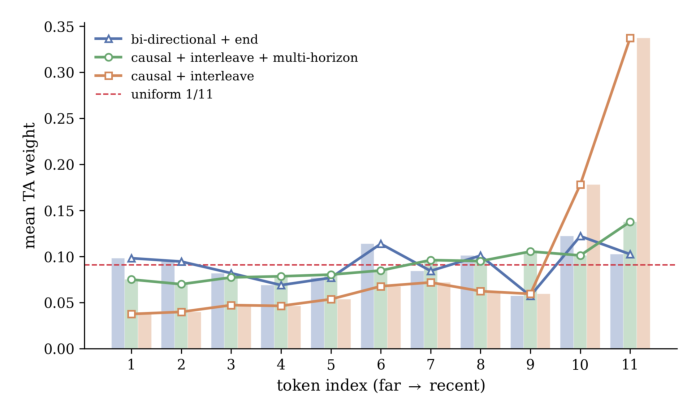
- 有多视野建模时,注意力分布在很宽的时间位置范围上。虽然近期 token 权重略大,但若干中期与长期 token 仍接近或高于均匀基线,说明候选打分确实在从多个时间视野取信息。
- 去掉多视野建模后,分布明显更集中:在这个例子里最近的那个 token 独占了约三分之一的总注意力质量,久远与中期 token 权重显著更小。
- 这个定性对照说明:多视野学习防止了压缩表征被近期行为主导,使更长程的信号对下游 ranker 保持可达。
论文随后总结说,effective-rank、token-similarity 与 target-attention 三项分析互补地证明 ChronicleRec 在压缩后同时保留了表征多样性与时间组织。需要指出的是,正文并未给出 effective-rank 的任何图表或数值——这是一处悬空引用(见 §八 局限)。
5.8 累积信息增益(Figure 6)¶
为在表征层分析之外再补一个信息论视角,作者检验「加入新的压缩 token 是否带来了前缀尚未捕获的 target-relevant 信息」。对交织变体,设 $\mathbf{c}_p$ 为第 $p$ 个时间锚点对应的压缩 token(从最久远到最近排序),前 $p$ 个 token 与预测目标的累积互信息(MI)估计为
$$\tilde{I}_p = \tilde{I}\big(y;\ \mathbf{c}_{1:p}\big), \tag{6}$$
其中 $y$ 为预测目标,$\tilde{I}(\cdot)$ 是去偏 MI 估计。对精确互信息,加入第 $p$ 个 token 的增量增益满足链式分解:
$$I(y; \mathbf{c}_{1:p}) - I(y; \mathbf{c}_{1:p-1}) = I(y; \mathbf{c}_p \mid \mathbf{c}_{1:p-1}). \tag{7}$$
因此累积 MI 的持续上升反映的是:前缀尚未捕获的、额外的 target-relevant 信息。由于 $\tilde{I}$ 是有限样本估计,作者只看曲线的整体趋势,不要求严格单调。
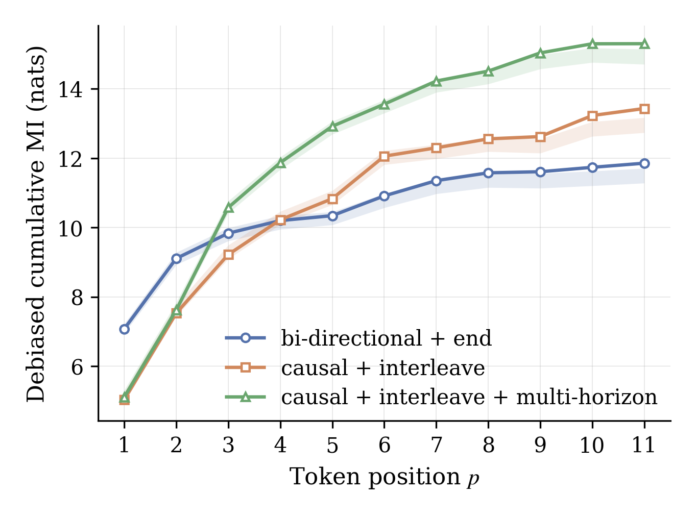
三种 token 构造策略的对比:
- bidirectional + end(把所有 query token 追加在行为序列之后、每个 query 都能注意整段历史):累积 MI 在前几个 query slot 上迅速上升,之后增长乏力,说明不同的末尾追加 query 捕获的 target-relevant 信息有大量重叠。这正是 Figure 4 中 VISTA 高冗余现象的信息论对应物。
- causal + interleave:把 query 分配到行为时间线上的不同位置、并限制每个 query 只看其之前的上下文,累积 MI 增长更平稳,并最终超过末尾追加变体——与因果交织诱导出的不同时间感受野一致。
- causal + interleave + multi-horizon:在大部分 token 区间内取得最高的累积 MI,说明多视野学习进一步鼓励压缩表征保留来自不同时间上下文的目标相关信号,而不是让所有 query token 都被历史的同一部分主导。
5.9 线上 A/B(§4.9)¶
ChronicleRec 部署在微信朋友圈广告(Weixin Moments Ads)的 pCVR 预估场景——大规模工业推荐设定,需要在海量在线流量与严格延迟约束下实时估计用户对候选广告的转化概率。
生产模型采用 MixFormer 架构联合建模大规模异构非序列特征与用户行为序列,其中 NS-Token 用于非序列特征交互、S-Token 用于序列行为建模。在本次部署中,压缩后的 Chronicle Tokens 被同时接入 NS-Token 与 S-Token 两条通路,使长期用户行为信息能被有效整合进既有排序模型,而无需改动其主干架构。
结果:七天在线 A/B,GMV +1.61%,95% 置信区间 [0.678%, 2.547%],不含 0,即统计显著。作者强调,以该平台的量级,这一幅度的 GMV 提升意味着可观的增量收入,证明离线增益在生产延迟约束下确实转化为了真实业务价值。
六、核心贡献总结¶
- 范式重构:把终身用户建模从「服务时按候选检索证据」重构为「target-independent 用户表征的预训练问题」,并给出 sequence-in / sequence-out 的具体形态——预训练产物本身是一条短的、按时序排列的 token 序列。
- 四个可分离的机制,各自对应一个明确挑战,且消融上各自有正贡献:recency-aware 多粒度合并(时间非均匀性)、因果 query-token 交织(时间锚定 + 良定义感受野)、多分支多视野(防近期主导)、Chronicle Alignment(过去 → 现在的对齐,贡献最大)。
- 「交织 × 因果」的交互发现:Table 3 显示两者只有组合才有效——因果 mask 在 end 放置下甚至是负收益(0.7890 < 0.7951)。这是本文最有迁移价值的机制级洞察:位置只有在因果约束下才成为「时间锚点」。
- 表征组织的三重实证:token 余弦相似度(时间块结构 vs VISTA 的全局冗余)、下游 target-attention 分布(多视野防止注意力坍塌到最近 token)、去偏累积互信息(因果交织带来持续的信息增量)。这套分析把「为什么有效」讲到了机制层,而非只报指标。
- 可缓存的工程形态:Chronicle Tokens 与候选无关 → 每用户算一次 → 异步写回 KV cache / feature store → 在线打分路径上完全不碰超长序列;且以「前缀」形式接入既有 MixFormer 生产模型的 NS-Token / S-Token 通路,不改主干即可上线,迁移成本极低。
七、与已归档相关工作的对比¶
本文的参考文献只有 13 条(SIM / ETA / SDIM / TWIN / MIMN / DIN / DIEN / VISTA / KuaiRand / BLIP-2 / 线性注意力 / 两篇综述),文档库中与之问题 + 解法双同构的工作没有一篇被引用,全部构成独立并发。以下三篇是筛选后保留的孪生工作。
SequenceO1 SequenceO1: End-to-End Ultra-Long (100K) Sequence Modeling in Recommendation with Low-Rank Caching (ByteDance/Douyin, 2026-09-08)¶
关系:独立并发(本文未引用,两篇 arXiv 时间相隔三天,殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文对 root cause 的判断几乎逐字一致——target-conditioned 的长序列计算是 query-dependent 的,跨候选没有可复用计算,于是长序列建模成本被候选数乘一遍;而 TWIN/SIM 谱系的两阶段检索把「压缩」与「排序目标」割裂开,无法端到端优化。两者给出的答案也同构:把超长历史压成一个只依赖用户侧信号的定长表示,算一次、缓存、跨候选与跨请求复用,让昂贵的 target-conditioned 模块永远不必直接跑在原始超长历史上。SequenceO1 甚至把这条路径命名为「cache-hit 路径相对原始长度是 $O(1)$ 的」,与本文 Figure 1 的异步 KV serving 是同一张图。
- 相近的技术骨架:都是「一组可学习的全局共享 slot(本文 $P=11$ 的 query token / SequenceO1 的 $k \approx 512$–1024 个 prototype)+ 一次前向把 $n$ 条历史聚合成 $k \times d$ 的定长、target-agnostic、可微、可缓存表征 + 下游对这个紧凑表征做 target-conditioned 推理」。两者都明确强调 slot 必须全局共享才能保证输出只依赖用户历史。两者也都采用「定长压缩表征 + 未压缩近期后缀」的双路组合——本文的 Hybrid-ChronicleRec(Chronicle Tokens 前缀 + 最近 100 条细粒度行为)与 SequenceO1 的「cached sketch 分支 + 未缓存 recent-10K 后缀」在结构上是同一设计。
- 本文的差异与推进:分歧点在用什么轴来组织压缩后的 token。SequenceO1 选择原型维 softmax(每个 history token 把单位质量分配到各原型上),刻意避免过早的 token 选择,让原型去覆盖整段历史——这是一种无序的、按内容聚类的组织;本文选择时间轴:交织锚点 + 因果 mask 让第 $p$ 个 token 严格对应「到第 $p$ 个锚点为止的历史」,是一种有序的、按时间分段的组织。两者对「冗余」的诊断相同(SequenceO1 用原型维归一化避免原型抢同一批 token,本文用因果交织避免 query 重复总结同一条全局序列),但处方不同。此外本文额外有两件 SequenceO1 没有的东西:多视野分支(显式对抗近期主导)与 mask-and-predict 对齐预训练(把压缩的过去投影到近present 意图)——而消融显示后者恰是贡献最大的组件(−0.0086)。反过来,SequenceO1 有本文完全缺失的系统侧完整闭环(训练侧 local KVCache、MRLB 多请求批处理、pipeline lift、FlashSA 融合算子)。
- 可比的方法 / 实验差异:规模差一个量级以上——SequenceO1 处理 100K 原始历史、平均 85K,本文 $L_{\max}$ 只有 2,048(KuaiRand)/ 4,000(AdLive)。SequenceO1 报告了 GEMM-only 解析 FLOPs 的 49.94×/63.89× 降幅与一个月抖音全流量 A/B(Finish +2.33%/+3.49%),但没有任何延迟/吞吐/显存实测;本文相反,给出了实测显存与训练时长(Table 6:49.1 GB → 28.0 GB,2997 → 620 min),却没有任何在线延迟或 QPS 数据。两篇在「可缓存带来的在线收益」这一最关键的主张上,各自留了一半的坑。
UxSID UxSID: Semantic-Aware User Interests Modeling for Ultra-Long Sequence (Kuaishou, 2026-05-09)¶
关系:独立并发(本文未引用)· 已加载对方精读
- 共同关注的问题:UxSID 把超长序列建模(ULSM)归纳为两条路径,与本文 §1.2–1.3 的归纳完全对应:路径一 Item-Specific Top-K 检索(SIM/TWIN/TWINv2 的 GSU+ESU,受预定义 key 空间限制、每候选重算);路径二 Item-Agnostic 预训练用户兴趣压缩(MIMN/HPMN/PinnerFormer/C-Former/DV365,离线蒸馏成紧凑静态 memory)。ChronicleRec 正是路径二的成员——而 UxSID 对路径二给出的批评,恰恰是本文必须回答的那一条:「memory 完全 target-agnostic,相当于一个低通滤波器,保留粗粒度全局趋势但抹平了 target 相关的高频兴趣峰」。
- 相近的技术骨架:UxSID 的 Item-Agnostic Interest Compression (IAIC) 与本文的压缩器几乎是同一个模块:一组可学习的 interest anchors $\mathbf{Q}_{anc} \in \mathbb{R}^{K \times d}$ 通过 cross-attention 把长度 $L$ 的行为序列聚合成 $K \ll L$ 个 anchor,再经 Per-token FFN(每个 anchor 一套独立 FFN)细化——本文是 $P$ 个 query token 通过因果注意力读出。两者都离线算好、按用户缓存、在线只做轻量查表 + attention 融合:UxSID 用 $\text{Hash}(UID \oplus SID)$ 的 $O(1)$ 点查,本文用 KV cache / feature store 异步回写。两者甚至都显式处理「anchor/token 之间会退化成冗余副本」这一失败模式。
- 本文的差异与推进:处理冗余的手段截然不同,而且这个差异正好落在两篇论文的核心分歧上。UxSID 用显式正则——归一化正交损失 $\mathcal{L}_{ortho} = \|\mathbf{P}\mathbf{P}^\top / \|\mathbf{P}\|_2^2 - \mathbf{I}\|_F$ 强行把 anchor 推开;本文用结构约束——因果 mask 让每个 token 的输入集合天然不同,冗余在构造上就被抑制,无需额外损失项(Figure 4 的相似度热图是这一主张的直接证据)。更根本的是对 UxSID 那条「低通滤波器」批评的回应路线:UxSID 的答案是引入部分 target 信息(用 target 的第一层 SID 作语义探针,做 semantic-group 共享的 memory,牺牲严格的 target-independence 换回高频兴趣峰,存储代价约 100 SID/user × 4 亿用户 ≈ 2.56 TB);本文的答案是坚持完全 target-independent,转而增加表征的时间分辨率与视野多样性(多锚点 + 多分支 + 对齐预训练),存储代价只有每用户 55 个 token。这是同一批评下的两条正交解法。
- 可比的方法 / 实验差异:UxSID 的 baseline 覆盖面更广(DIN、SIM、ETA、SDIM、MIRRN、TWIN、C-Former 全打过),并报告了 1k→10k 的 scaling 曲线与延迟增量(+0.16 ms)、快手广告一周 A/B(Revenue +0.337%);本文只对一个压缩基线 VISTA 做了对比,没有与任何检索式方法(SIM/TWIN/ETA)同台,这是本文实验覆盖上最明显的短板——毕竟检索式才是它在 §1.2 重点批判的对象。反过来,本文的 GMV +1.61%(CI [0.678%, 2.547%])在业务幅度与统计严谨度上都高于 UxSID 的 +0.337%。
SITA SITA: Semantic Interest Tokens for Target-Aware Compression in Long-Sequence Recommendation (USTC × Kuaishou, 2026-08-04)¶
关系:独立并发(本文未引用)· 已加载对方精读
- 共同关注的问题:SITA 把已有工作同样归纳为「检索式(SIM/TWIN)」与「压缩式(C-Former、VISTA)」两条路径——它点名的压缩式代表就是本文的唯一对比基线 VISTA,两篇论文在批判同一个对象。SITA 对压缩式的诊断是:「同一用户的所有 target item 共享同一份可复用兴趣表征,学到的用户兴趣天然是 target-agnostic 的」,形式化为 $\mathbf{h}_u = f(\mathcal{S}_u, \mathbf{x}_u, \mathbf{x}_c)$ 无法按 target 自适应地强调不同兴趣侧面。这与 UxSID 的「低通滤波器」批评是同一件事的两种说法。
- 相近的技术骨架:SITA 的 Structured Interest Compression (SIC) 与本文的压缩器高度同构:初始化一组可学习 interest token $\mathbf{Z}_u^{(0)} \in \mathbb{R}^{NK \times d}$,堆叠压缩块用 cross-attention 把完整行为序列注入这些 token,离线算好后以 UID 为 key 写进 Embedding Server,在线只做选择 + target attention。两者都是「把完整长序列压成一组被结构化组织的 token 并离线缓存」,都拒绝检索式的「丢弃大部分历史」。
- 本文的差异与推进:分歧点是「用什么给 token 编索引」。SITA 用语义轴:Balanced Parallel Quantization 把 item 空间压成 $N$ 个并行 codebook × $K$ 个码字,压缩 token 按 $(N, K)$ 与 codebook 严格对齐,在线时 target item 的 SID 逐组硬索引出 $N$ 个 token,从而在共享的 token 集合里「选」出一份 target-specific 的全局兴趣,存储 $O(|\mathcal{U}|NK)$。本文用时间轴:token 按时间锚点排序,在线不做任何选择,全部 $B \cdot P$ 个 token 都交给 target attention 自己去加权(Figure 5 正是在检验这个加权是否真的跨视野分布)。一句话概括:SITA 让 target 去「挑」token,ChronicleRec 让 target attention 去「读」一条有序的 token 序列。SITA 因此保住了 target-awareness 但需要维护一套 SID 体系与 $NK$ 份 per-user 存储;本文保持严格 target-independent、存储更省(55 token/user),但把区分不同候选的责任完全推给了下游 target-attention 头。此外本文独有的 Chronicle Alignment 预训练在 SITA 中没有对应物——SITA 的压缩 token 直接由排序损失端到端训练,不存在「先对齐到近present 意图再迁移」的阶段。
- 可比的方法 / 实验差异:SITA 的 baseline 覆盖 DIN/SIM/TWIN/MUSE/C-Former/UxSID/STCA/LONGER,在 Taobao-MM 与 XLong 上评测,工业场景 Effective-View AUC/GAUC +0.049%~+0.078%,但没有在线 A/B 也没有延迟实测;本文 baseline 只有 3 个(Full-Attn / Short-Attn / VISTA),但有七天在线 A/B 与置信区间。两篇的「结构化 token + 离线缓存」骨架相同,可组合性也很明显——语义分组与时间锚定是正交的两个轴,理论上可以叠成 $N \times P$ 的二维 token 网格,这是两篇论文都没有做、但顺理成章的下一步。
Step 2.5 筛选过程中被剔除的近似候选(记录于此以防门槛放水): - TM20K TM20K (ByteDance):其 Position-wise Adaptive Token Merge 按段落设置压缩因子 $K=[1,2,3,4]$、理由是「最近 10% 的 token 携带一半注意力质量」,与本文的 recency-aware 多粒度合并在这一个模块上高度同构;但 TM20K 的整体问题是「有效性-效率冲突 + 教师-学生蒸馏」,学生仍需在线实时计算、不可缓存,不是 target-independent 表征预训练。解法骨架实质偏离,剔除。 - IAT IAT (ByteDance) / SIF SIF (Meituan):都把历史「样本/实例」离线压成 token 喂进序列,缓存哲学相近;但两者的核心动机是打破手工特征的信息瓶颈、提升序列 token 的信息密度,而非解耦 target-dependent 计算,且压缩单位是「样本」不是「时间段」。问题陈述不同构,剔除。 - CCFormer CCFormer (Tencent PCG):用 Conv1D 做层级序列压缩(感受野 3→7→15→31),压缩比与本文相当;但压缩发生在 ranker 内部、每次请求实时计算、不可跨候选缓存,目标是降低排序算力而非产出可迁移的用户表征。剔除。 - Mosaic Mosaic / DUET DUET (Meta):预训练冻结用户 embedding 供多个下游 ranker 复用、异步服务,「pre-train-and-transfer + cacheable」的问题陈述最接近;但产物是单向量/多专家 embedding,不是有序 token 序列,不存在时间锚定与序列结构。解法骨架偏离,剔除。 - TransX TransX (LinkedIn):缓存长期行为编码 + candidate-specific 稀疏 cross-attention,降在线算力约 80%,问题同构度中等;但缓存的是常规 Transformer 编码结果,没有非均匀粒度、时间锚定或多视野设计,机制层无可对比的细节。剔除。 - KSA KSA (Kuaishou):learnable summary token 做 $O(n/k)$ KV cache 压缩,机制上最接近「用少量 summary token 压长序列」,但领域是 LLM 长上下文(RULER-128K),不涉及推荐的 target-independent / 候选打分问题。领域不同构,剔除。
八、讨论与局限性¶
8.1 值得借鉴的设计¶
- 「位置 + 因果」的组合才制造时间锚点。Table 3 的四宫格是本文最有方法论价值的结果:交织单独用(interleaved+bidirectional 0.7930)不如 end+bidirectional(0.7951),因果单独用(end+causal 0.7890)是四者最差,只有两者组合才到 0.8034。这提醒任何做「learnable query token 压缩」的工作:光把 query 撒开没用,必须同时用因果 mask 把「撒开」翻译成「各自不同的输入集合」。
- 对齐比压缩更重要。w/o Chronicle Alignment 掉 0.0086,是所有消融里最大的一项,超过任何单项压缩结构。这对「预训练用户表征」这条路线是一个强信号:上游表征的训练目标必须与下游决策时刻对齐,否则再精巧的压缩结构也会打折。mask-and-predict(用留出的近期行为标签监督)是一个极其廉价的对齐手段。
- 深度监督对抗分支退化。多分支在没有逐分支监督时只掉 0.0039 但确实掉——说明并行分支天然有坍塌成冗余副本的倾向,需要逐支施加「对当下负责」的压力。
- 不改主干的落地形态。Chronicle Tokens 以前缀形式接进既有 MixFormer 的 NS-Token / S-Token 两条通路,生产模型主干不动。这是工业落地成本最低的接入方式,对已有大型排序系统的迁移极有参考价值。
8.2 局限与争议¶
- 「ultra-long」的实验尺度与叙事不匹配。论文反复强调 KuaiRand 平均历史 11,811.6、最长 228K,但训练实际截断到 $L_{\max} = 2048$(AdLive 4,000)。也就是说,主张的「终身历史」在实验里只有约 2K 条被真正看到,平均历史的 83% 被截断丢弃。Table 5 的长程分析最多 mask 掉 1,000 条,也是在这 2,048 的框内做的。相比 SequenceO1 的 100K、TM20K 的 20K,本文的「ultra-long」更接近「long」。这一点论文没有讨论,但它削弱了「久远历史携带自洽信号」这一结论的外推强度。
- Baseline 面过窄。压缩式只比了 VISTA 一家,检索式(SIM / TWIN / ETA / SDIM)一个都没进主表——而这恰恰是 §1.2 重点批判、也是工业主流的对照组。没有这组对比,「target-independent 压缩优于 target-dependent 检索」这一核心主张在本文中没有被直接验证过,只能靠 Full-Attn 上界间接论证。同期的 UxSID、SITA 都做了这组对比。
- 单一指标、单一公开数据集。只报 GAUC,没有 AUC / LogLoss / NE;公开数据只有 KuaiRand 一个 split。Table 2 上 ChronicleRec 相对 VISTA 的增益是 +0.0018(KuaiRand)/ +0.0015(AdLive),在单次运行、无方差报告的情况下,这个幅度很难与噪声区分。全文没有任何 seed 重复、标准差或显著性检验(唯一的置信区间来自在线 A/B)。
- effective-rank 分析悬空。§4.7 结尾写「effective-rank、token-similarity 与 target-attention 三项分析互补地证明……」,但正文从头到尾没有任何 effective-rank 的图、表或数值。这是一处明显的编辑遗漏,也意味着三项分析实际只有两项。
- Table 6 的参数量口径自相矛盾。论文明确说「所有模型共享 embedding 层」,但 Short-Attn 报 661.2M 而其余长历史方法都是 ≈1230M,差了 569M。若真共享 embedding,参数量不应有此差异;合理猜测是 Short-Attn 只为最近 100 条行为涉及的 item 建表,但这样它与其他方法就不再是严格可比的同一容量设定了。
- 没有任何在线服务侧的实测。全文最核心的卖点是「target-independent → 可缓存 → 把超长序列编码移出在线路径」,但既没有在线延迟、QPS、缓存命中率,也没有 Figure 1 里 Quantization / Dequantization 模块的精度损失分析、KV cache 的存储量与 TTL、异步回写的新鲜度滞后(用户刚发生的行为多久才进入缓存表征)的量化。而新鲜度恰恰是所有「离线预计算用户表征」路线的共同软肋——SequenceO1 给了 cache TTL(训练 3h / 服务 1h)与命中率(≈0.5 / 0.6),本文一个都没有。
- 两阶段解耦的长期上限。压缩器先用 Chronicle Alignment 预训练、再载入 ranker(冻结或微调)——这是典型的「先离线压缩再在线建模」范式。虽然 Stage 2 允许微调缓解了部分问题,但只要服务时读的是缓存的、按上一版压缩器算出的 token,压缩器与下游 ranker 就无法真正端到端联合优化;参数量 scaling 时,「如何表征历史」(压缩器)与「如何建模序列」(排序头)两条路径也难以同步扩充——扩大排序头不会让缓存里的 55 个 token 携带更多信息,而扩大压缩器又需要全量刷新缓存。这是该路线共同的天花板。
- 多分支的成本被低估。Multi-ChronicleRec 用 $B=5$ 条分支各自独立的 query token 与编码器,训练时长从 620.3 涨到 855.1 分钟(+38%),显存从 28.0 涨到 34.8 GB(+24%)。虽然服务时可缓存,但缓存本身的离线刷新作业成本也随 $B$ 线性增长,而 AdLive 上多分支相对 hybrid 只换回 +0.0004 GAUC——在中等长度历史的场景里这笔账未必划算。
8.3 工业落地价值¶
论文的落地路径是清晰且低摩擦的:离线预训练压缩器 → 每用户算一次 Chronicle Tokens → 量化后写入 KV cache / feature store → 在线 ranking 取出反量化,作为前缀接入既有 MixFormer 的 NS-Token 与 S-Token 通路,主干架构零改动。异步回写(Figure 1 的 W1/W2)保证当前用户表征的更新不阻塞在线打分。七天 A/B 在微信朋友圈广告 pCVR 上取得 GMV +1.61%(95% CI [0.678%, 2.547%]),是本文最硬的证据。对已有大型排序系统而言,这是一条「不动主模型、只加一路可缓存前缀特征」的增量接入方案,实施风险显著低于换骨干。
九、精读结论¶
ChronicleRec 的真正贡献不在「用 learnable query token 压缩长序列」(VISTA、C-Former、UxSID、SITA、SequenceO1 都在做),而在指出了压缩后表征的「组织轴」是一个独立的设计维度,并论证时间轴是一个比「无序 bag」更好的选择——Table 3 的交织×因果交互、Figure 4 的时间块相似度结构、Figure 6 的累积互信息曲线,三者从设计、表征、信息论三个层面闭环地支持了这一点。加上 Chronicle Alignment 揭示的「对齐 > 压缩结构」这一反直觉排序,本文在机制解释上做得比同类工作扎实。
扣分项集中在实验覆盖(无检索式 baseline、单指标单公开数据集、增益幅度小且无方差)、叙事与尺度不匹配($L_{\max}=2048$ 撑不起 ultra-long 的说法)、以及全文最核心的「可缓存」卖点缺少任何服务侧实测。叠加「先压缩再建模」这一范式固有的端到端优化与 scaling 天花板,综合给 7 分:扎实、有明确机制洞察、有真实线上收益的工作,但离「一条研究路线的代表作」还差实验的完备性与规模。