Mosaic:Meta 的「用户嵌入专家舰队」——把用户表征层组织成一支架构异构的模型舰队¶
来自 Meta(John Zhiyuan Zheng、Xian Sun、Xiangyang Mou、Yujunrong Ma、Christina You、Michael Jiayuan He、Hrishikesh Paranjape、Aakarsha Agarwal、Hong Li,全部 Menlo Park),2026-07-27 挂 arXiv(2607.24015v1,cs.IR),收录于 RecSys '26(2026-09-27 至 10-02,Minneapolis)。
核心主张:工业推荐系统的用户表征层,既不该做成一个单一的通才大用户模型,也不该做成「共享骨干 + 任务适配头」,而应组织成一支架构异构、各自独立训练的专家舰队(fleet of specialists)——每个专家用一种与其目标信号族的统计结构相匹配的归纳偏置,独立产出可复用的用户嵌入,供多个下游 ranker 作为普通嵌入特征消费。Mosaic 由四个专家家族构成:memorization-driven(稀疏 ID / 大 hash table)、dense-heavy(聚合计数器)、sequential(行为历史序列)、CoTrain(下游端到端梯度)。围绕这一范式,论文补上三块配套设施:MRM(Multi-task Relation Mining)+ CRL(Cosine Redundancy Loss) 用于最大化每个新专家的边际信息增量,CoEval + User Tower Zero-Out 用于绕开特征打点流水线做免打点评估(迭代速度提升 3–5×),以及混合 CPU/GPU、在线 + 离线的服务栈。Mosaic 在 6 个下游 surface 上取得一致且统计显著的离线 NE 下降,并在多个 surface 上取得线上 A/B 的 topline 正向。
研究动机与背景¶
用户表征(user representation)是现代推荐系统里杠杆率最高的建模问题之一:用户编码方式上的一次改进,会同时传导到召回、排序、完整性(integrity)等多个下游任务上。用户级信号本身高度异质——稀疏 ID、类别特征、参与行为序列、以及学到的嵌入——各自刻画用户偏好的不同侧面,但它们在不同人群上的覆盖是不均衡的。这一点在冷启动用户上尤其明显:有限的历史往往直接导致更差的模型表现。因此,把这些异质信号融合成一个整体性的用户表征,能同时惠及下游的检索、预估与完整性任务。
一个常见做法是训练一个专用的用户嵌入模型(dedicated user embedding model),把异质的用户特征压缩成紧凑向量供下游 ranker 使用。相比在每个 ranker 内部直接学习用户表征,这种解耦设计有几个优势:
- 免费的模型扩容:下游的计算与内存开销不膨胀;
- 可利用下游拿不到的数据与监督信号;
- 产出的嵌入可被多个下游消费者复用。
工业界已有大量工作沿这个方向推进:早期系统通过深度检索模型从交互历史学用户表征 [Covington et al. 2016; Yi et al. 2019];Pinterest 加入了基于聚类的多向量表征 [PinnerSage] 与批量刷新的序列嵌入 [PinnerFormer, TransAct];多兴趣方法通过路由、兴趣抽取或条件特定模块,为每个用户产出多个向量 [MIND, ComiRec, Pinterest 多嵌入检索];更近的基础模型级设计进一步 scale 用户侧建模——大规模预训练序列模型、生成式范式、按应用微调,或共享骨干 + 轻量专家 [PinFM; Foundation-Expert 范式; Large User Model 三步范式]。
论文要挑战的共性假设:尽管上述方法差异不小,它们几乎都把用户表征围绕「单一用户侧架构」或「单一共享骨干」来组织,哪怕最终产出多个向量也是如此。Mosaic 选择了一条不同的设计路线——一个异构的专家嵌入模型库(heterogeneous library of specialist embedding models),并在 §3.2 中系统讨论了它与「单骨干范式」的权衡。
Mosaic 用四个专家家族来实例化这一设计,每个家族对准一种用户行为侧面:
- Memorization-driven:用大 hash table 捕捉细粒度的逐用户偏好;
- Dense-heavy:在聚合计数器上学非线性交互,架构候选包括 MHTA [Talking-Heads Attention]、SEDot [Squeeze-and-Excitation] 与 Wukong;
- Sequential:基于 HSTU 骨干 + MoE 路由,捕捉用户行为的时序动态;
- CoTrain:直接接收来自下游 ranker 的端到端梯度,学习任务对齐的表征。
为在规模上服务这支舰队,作者开发了混合 CPU/GPU 服务栈,最大化闲置算力资源的利用率;特别地,优化了 GPU 推理以在满足延迟目标的同时压缩在线服务容量。同时提供在线与离线两条嵌入推理路径,在特征新鲜度与效率之间提供灵活取舍——这把 Mosaic 的适用范围扩展到了算力受限的用例。
五点核心贡献¶
- 专家舰队设计(§3.3):给出构建「架构异构、各自匹配一种归纳偏置」的用户嵌入模型舰队的设计理据与实证验证——这是此前工作未系统探索过的范式。
- 跨 surface 数据构建整体用户表征(§3.3):利用来自多个 surface 的数据,同时用于监督信号与输入特征,让每个专家学到单 surface 模型学不到的跨 surface 用户行为。
- 最大化独特用户知识蒸馏(§4.1):提出 MRM(Multi-task Relation Mining) 与 CRL(Cosine Redundancy Loss),最大化每个新专家的边际信息贡献,直击多嵌入系统的一个根本挑战。
- 资源高效部署的混合服务(§3.4):结合在线与离线、CPU 与 GPU 路径的混合服务栈,按每个专家单独平衡新鲜度、延迟与算力。
- 免打点嵌入评估(§4.2):提出 CoEval 与 User Tower Zero-Out 两种评估方法,直接从训练好的 checkpoint 度量嵌入的下游对齐贡献,绕过标准特征打点流水线,把迭代速度提升 3–5×,同时保持精度。
相关工作定位¶
专用用户嵌入模型。工业系统长期使用专用的用户侧模型,其输出被下游检索或排序系统复用。早期工作依赖双塔架构学检索用的用户表征 [Covington 2016; Yi 2019];后续系统扩展了这个方向——行为聚类 [PinnerSage]、批量刷新的序列编码器 [PinnerFormer]、多向量兴趣表征 [ComiRec, 多嵌入检索, MIND],以及基础模型规模的用户侧模型 [Wide&Deep 系, PinFM]。更近的「基础模型 + 专家」设计把一个跨 surface 的共享骨干与 surface 特定的专家组合起来 [Foundation-Expert 范式]。这些系统确立了用户侧表征的价值,但它们通常围绕一种特定的模型家族或一个共享骨干来组织,因而无法完整蒸馏跨 surface 的用户行为。Mosaic 走了一条不同的路:把用户表征当作一支专家嵌入模型的舰队来管理——每个专家聚焦用户行为的一个不同侧面,拥有自己独立的架构、训练数据、刷新节奏与服务机制。
模型内用户表征(In-Model User Representations)。用户表征也可以在检索、排序或端到端推荐模型内部学习,包括经典的隐因子模型 [MF]、带门控特征交互的深度 ranker [Wide&Deep, DCN, DIN, DIEN]、目标注意力与长历史模型 [TWIN, TWIN V2, SIM, MIMN, Douyin 10k 序列]、以及用 next-item / masked-item / 自监督 / 对比目标训练的序列推荐器 [SASRec, BERT4Rec, CL4SRec, S3-Rec]。多任务与多域模型进一步用门控专家、共享/任务特定模块或个性化路由做特化 [PLE, MMoE, HoME, STAR, PEPNet]。近期生成式推荐器把表征学习与检索/排序耦合进序列转导、统一生成或 SID 解码 [HSTU, TIGER, OneRec, OneRec-V2];混合系统则把 in-ranker 的序列模块与批量生成的用户嵌入结合 [TransAct, TransAct V2]。在这些方案里,用户表征通常与某个特定目标、特征空间和服务图绑定,限制了用户侧 scaling、跨 surface 信号迁移与跨下游消费者的复用。 Mosaic 通过一支「独立训练、独立服务,再作为可复用特征暴露给多个下游消费者」的专用专家嵌入模型舰队来规避这些约束。
服务与评估基础设施。大规模用户嵌入还带来严苛的基础设施要求,横跨存储、新鲜度、服务成本与评估。已有工作通过实时嵌入表与规模化的稀疏–稠密混合嵌入解决了其中一部分 [Persia, Monolith]。Mosaic 建立在这些原语之上,但面对一个不同的运维问题:服务一支在新鲜度、延迟、成本、推理硬件需求上各不相同的异构模型舰队。其服务栈通过 CPU 在线推理、GPU 在线推理、GPU 离线推理支持不同的资源画像。免打点评估框架 CoEval 在本地模拟线上服务环境,允许在整支嵌入舰队上做快速迭代。
Mosaic 系统总览¶
Mosaic 分三个阶段运作:上游模型训练 → 嵌入推理 → 下游消费。
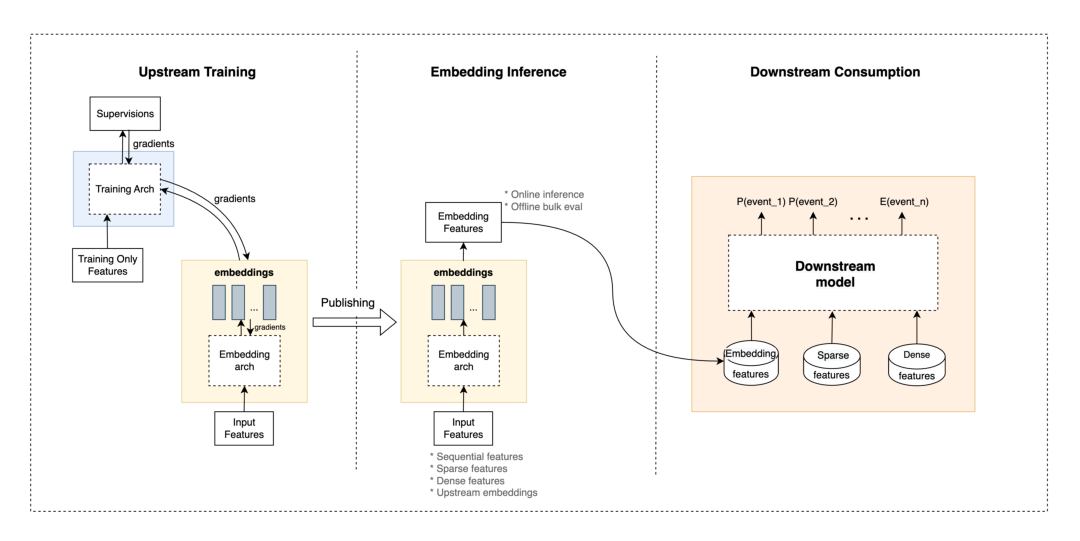
上游训练。每个专家模型用一张完整的训练图训练,该图由两部分组成:
- training-only 架构:摄入非用户特征,并被参与度任务(engagement tasks)监督;
- user tower(用户塔):摄入异质用户特征——稀疏 ID、稠密计数器、预训练嵌入。
training-only 架构把多任务梯度回传给 user tower,user tower 学会把这些信号压缩成一个或多个用户嵌入向量。
推理阶段。只有 user tower 被部署。给定用户侧输入特征,它为新鲜度敏感的用例做在线推理,或为新鲜度要求低的嵌入做离线批量推理。因为 training-only 架构在训练结束后不再需要,服务足迹显著小于完整训练图。新专家通过模型配置、二进制加载、分级流量爬坡(staged traffic ramping)进入推理路径,之后下游消费者才收到新嵌入。
下游消费。下游 ranker 把 Mosaic 的输出当作标准嵌入特征消费,与已有的用户、物品、上下文特征并列。这一设计让 ranker 能受益于一个更大的上游用户建模系统,而不必扩大自己的架构或服务图。training-only 架构与 user tower 都对下游 ranker 的架构不可知——SNN [DLRM]、Transformer、稠密特征交互网络都被 Mosaic 框架支持。取决于每个专家在舰队中的角色,它拥有各自不同的 user tower 与 training-only 设计,差异体现在主架构、监督任务、和/或特征集上。这套可配置的设定,正是 §3.3 中各专家设计的底座。
评估口径。Mosaic 的嵌入用下游排序指标评估,包括 NE(Normalized Entropy,基于 log-loss 的质量指标,越低越好)、FI(Feature Importance,Mosaic 特征在下游全部输入特征中的相对排名) 与线上 A/B 指标。由于上游 NE 可能与下游影响背离,作者把下游 ranker 的 NE 作为嵌入质量的主要离线度量。但标准评估路径很慢——需要先部署、打点、再重训下游;这正是 §4.2 中免打点 CoEval 框架的动机。
设计原则¶
专用用户嵌入模型 vs. 扩容下游用户特征¶
作者强调:一个专用的上游用户模型,在性质上不同于「简单地把更多用户侧特征暴露给每个下游 ranker」。它带来三项下游特征扩容给不了的能力:
- 摊薄用户侧建模容量:下游 ranker 收到的是紧凑的学到的嵌入,而更重的训练图留在其服务路径之外;
- 可用跨 surface 特征、辅助标签与监督任务——这些很难直接加到每一个下游 ranker 上;
- 同一份学到的嵌入可被多个消费者复用,避免重复的特征工程与模型容量增长。
实证上,作者还观察到:即使专用 user tower 的输入特征与下游模型已有的特征存在重叠,它依然能带来额外的信号价值——这表明上游模型学到的是互补的用户表征,而不是简单地重复下游的计算。
专家舰队 vs. 单一通才¶
有了专用的上游用户建模层之后,下一个设计选择是:建一个通用的大用户模型,还是多个专家? 作者选择专家舰队,理由是:在他们的设定里,主导性的用户信号族具有不同的统计结构与服务需求——
- 稀疏与类别特征偏好 memorization 重的模型;
- 稠密行为计数器受益于非线性特征交互;
- 序列动作需要时序建模;
- 下游特定目标受益于任务对齐的训练。
Table 1: Mosaic 舰队——模型类别由用户信号类型与最优归纳偏置共同决定
| 模型类别 | 特征类型 | 归纳偏置 | 用户信号示例 |
|---|---|---|---|
| Memorization-driven | Sparse list | 逐用户查表;记忆偏好 | Liked sports, shared food post |
| Dense-heavy | Dense counters | 非线性计数器组合 | 30d avg 12 likes/day, 80% mobile |
| Sequential | History seq. | 对时序依赖做注意力 | MMA → Wrestling → Jiu-Jitsu |
| CoTrain | Cross-surface | 来自下游任务的端到端梯度 | Feed emb. learned from Notif pClick |
一个单一通才模型能表示所有这些信号,但它必须在异质目标之间共享容量与优化。相比之下,小专家组成的舰队让每个专家在一个信号维度上做独立优化。作者报告:在一次数据与算力匹配的原型对比中,专家舰队产出了比一个大通才模型更强的嵌入质量。
Table 2: 通用大用户模型与专家舰队的定性权衡
| 设计维度 | 单一通才 | 专家舰队 |
|---|---|---|
| 信号聚焦 | 共享容量必须同时覆盖稀疏、稠密、序列信号 | 每个专家聚焦更窄的信号族与归纳偏置 |
| 开发速度 | 改动通过同一个模型发布周期耦合在一起 | 专家可被独立开发与独立验证 |
| 故障隔离 | 质量或服务回归会广泛影响共享模型 | 回归可被隔离到受影响的那个专家 |
这张表其实是全文最「工程」也最诚实的部分:舰队范式的胜出理由里,开发速度与故障隔离这两条组织层面的收益,权重不低于纯建模质量。
专家架构¶
舰队由四个专家家族构成,每个对准一个明确目标:memorization-driven(稀疏特征)、dense-heavy(聚合计数器)、sequential(动作历史)、CoTrain(下游参与度)。
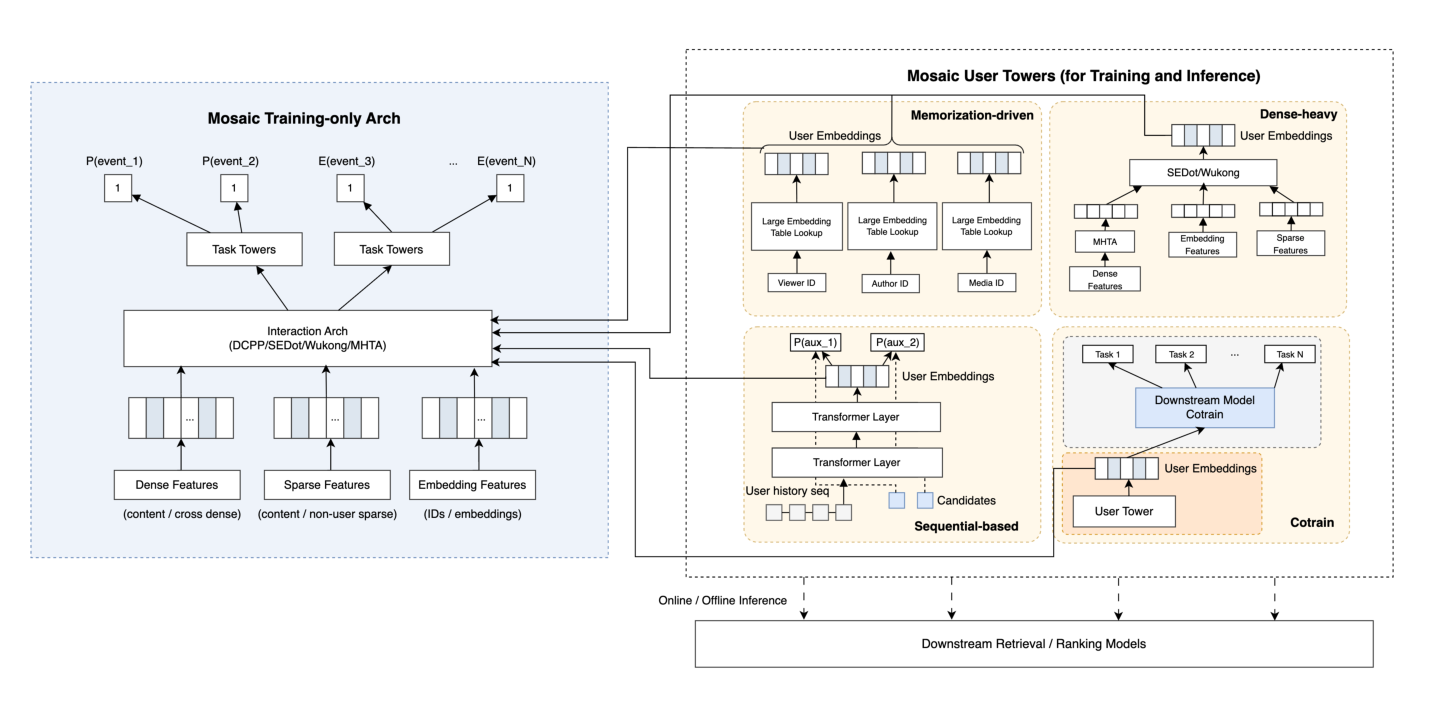
Memorization-Driven Specialist¶
记忆型专家依赖大规模嵌入表(hash table)捕捉行为模式。把大表分解进一个上游专家,等于在信号到达下游模型之前就把记忆化信号压缩成一个紧凑嵌入,从而让这张表的算力成本在多个消费者之间被摊薄。
但在不冲击生产 QPS 的前提下支撑这种规模(即数百 GB 的状态量),需要训练与服务端的协同优化。作者用三项技术支持超大嵌入表:
- Table-Batched Embedding(TBE):把大量 lookup 操作融合进一个 kernel,按访问频率把行分层放置于 GPU HBM / CPU DRAM / SSD,并把每张表量化到低至 INT4;
- TorchRec row-wise sharding(训练):把每张表跨 GPU HBM 按行切分,使每次 lookup 都命中一个 shard;
- distributed inference(服务):用一个异构方案——热表留在 GPU HBM,冷表跨多机分片到 CPU DRAM。
因为大部分逐用户信号已经被 hash table 本身捕捉,作者刻意把该专家的交互网络保持简单,只消费少量 top FI 的稠密特征与这些 hash 表嵌入。
Dense-Heavy Specialist¶
稠密型专家摄入跨多个时间窗(1d / 7d / 28d)、多种参与类型(点赞、评论、分享)、多个 surface、多种动作粒度的丰富聚合计数器特征,覆盖 user-level、user–content cross、content-level 三类信号。由于稠密计数器从非线性特征交互中获益多于从记忆化获益,该专家被设计成学习丰富的特征交叉并为下游产出多个嵌入。作者评估了多种模型架构:
- MHTA(Multi-Head Talking Attention):在 per-head DeepCrossNet 之上施加 multi-head 与 talking-head 门控;
- SEDot(Squeeze-and-Excitation Dot Networks):把稀疏特征点积交互与作用在稠密特征上的 SE 式重加权结合;
- Wukong:堆叠可学习的 Factorization-Machine 层,具备干净的 NE scaling law。
除架构之外,作者发现把上游的监督头(supervision heads)与下游 ranker 的 top tasks 对齐对嵌入质量至关重要。
Sequential Specialist¶
序列专家从跨平台的长参与历史建模用户行为动态,这些历史被合并成单一时间序。它建立在 HSTU 之上,做了三处修改:
- 前置上下文 token(contextual tokens):把来自跨 surface 信号的稠密嵌入投影到序列维度,作为前缀 token 加入;
- 交错 UIH(User Interaction History)token:每个用户动作贡献内容嵌入与元数据嵌入(动作类型、观看时长、时间位置)。由于内容与元数据被分别聚合并占据不同 token 位置,这一版注意力把「消费了什么物品」与「如何消费的」两类信号解耦——模型可以同时对二者施加注意力。相比标准 HSTU 的序列长度 $N$,上下文 token 与 UIH 交错使有效序列长度变为 $C + 2N$($C$ 为上下文前缀长度,$N$ 为历史长度)。
- 分层注意力(hierarchical attention):一个 L1 自注意力栈处理完整的交错序列,另有一个独立的 L2 交叉注意力层用目标物品对 L1 输出打分。
两个实质影响嵌入质量的工程问题:
- 训练与服务的序列长度机制不同:训练用长历史,服务为满足延迟预算而用更短序列。作者用 stochastic-length training(随机长度训练) 解决——把每个训练输入随机截断到一个从服务时长度分布中采样的长度,使模型暴露在生产中真实会遇到的长度上,而不只是最大训练长度。
- 时间戳不一致导致动作乱序:打点流水线偶尔把用户动作放错顺序。由于因果掩码与位置注意力都假设时序正确,作者在特征预处理阶段强制严格排序。
作者还研究了在 HSTU 骨干上做 MoE scaling:一个学到的 router 把每个 token 分配给 $E$ 个专家中的 top-$k$,通过稀疏激活增加参数容量而不按比例增加推理成本。NE 与 QPS 随序列长度、专家数、嵌入维度等因素的权衡见 §5.2 的 Table 6。
CoTrain Specialist¶
前三个专家只通过独立的上游训练架构训练,不绑定任何特定下游消费者。这让产出的嵌入可跨多个 ranker 复用,但也可能让它们与某个特定 surface 失配——尤其当该 surface 有不同的数据分布或监督目标时。
CoTrain 专家通过在上游训练期引入第二套训练架构来解决这个问题:一份目标下游 ranker 的副本,用它自己的数据训练,与标准的 Mosaic training-only 架构并列。两套架构共享同一个 user tower,因此产出的嵌入同时被 Mosaic 的监督目标和目标 surface 的目标共同塑形。
CoTrain 专家因此把下游监督带进了上游训练:来自下游 ranker 副本的梯度端到端流入 user tower,在部署前就把嵌入与其目标消费者对齐。服务仍然是解耦的——推理时下游 ranker 消费这个嵌入的方式与其它专家完全一致。
该框架支持两种模式:
- trainable 模式:CoTrain 用两套训练架构的梯度共同更新 user tower,并上线由此共同对齐得到的嵌入;
- frozen 模式:CoEval 把 Mosaic 的 training-only 架构与 user tower 冻结,只训练下游副本——这被用作评估加速器(§4.2)。
实践中,与目标 surface 共训一致地提升该 surface 上的嵌入质量,即便上游特征与监督保持不变。
混合服务¶
舰队通过一个组合三条路径的混合策略服务:CPU 在线推理、GPU 在线推理、GPU 离线推理。三条路径产出同格式的嵌入,因此下游 ranker 消费方式一致,与嵌入如何生成无关。这一混合设计让作者能在新鲜度、GPU 服务资源、延迟预算之间做平衡——三条路径可用,就能为每个专家的衰减画像(decay profile)与算力预算挑选最合适的配置。
在线推理优化¶
GPU 在线推理是最耗资源的路径,也可能成为实验速度的瓶颈,因此作者用一套编译、运行时与缓存层最小化其算力占用:
- AOTInductor(AOTI)编译:通过激进的算子融合绕过 Python 运行时;
- Predictor tuning:调整 batch coalescing、线程池大小、intra/inter-op 并行度;
- Model splitting:把 Mosaic 异构的稀疏嵌入路径与稠密 Transformer 路径分别路由到专用的执行单元;
- Look-aside memcache 层:带 2 小时 TTL,直接从缓存服务重复 lookup,利用用户嵌入缓慢的时间漂移特性。
Table 3: GPU 服务优化同时改善算力成本与服务延迟
| 优化方法 | GPU 服务用量 | 延迟 |
|---|---|---|
| Baseline | — | — |
| AOTI + model split | −56% | — |
| AOTI + model split + Memcache | −79% | −0.14% |
结论:AOTI + model split 累计减少 56% GPU 服务用量;再叠加 memcache,累计降到 −79%,且首屏(first-story)延迟还改善了 0.14%——缓存带来的是双赢而非成本换延迟。
离线推理¶
大型专家(尤其是 CoTrain 变体)通过离线推理流水线部署:从训练好的模型中抽出 user tower,用周期性批量推理应用到全量用户,结果嵌入写入持久化存储,通过 embedding-indexing 服务对外提供。
技术挑战与解法¶
论文讨论了两个最核心的挑战:随舰队增长最大化每个新专家的独特用户知识(§4.1),以及在不走特征打点流水线的前提下优化嵌入评估(§4.2)。
4.1 最大化独特用户知识¶
随着专家一个个上线,作者观察到边际收益递减(diminishing marginal gains):每个新嵌入在既有舰队之上带来的下游指标提升在缩小,即便该嵌入在孤立评估时表现很强。根因是信息冗余(information redundancy)——在重叠的输入特征与相似的监督信号上训练的后继专家,会收敛到相似的表征子空间,限制每个新模型能贡献的新信息。作者开发了多种互补技术缓解这一点。
4.1.1 MRM(Multi-Task Relation Mining)¶
下游排序模型在多个参与度预测任务上优化,且每个任务被独立建模。挖掘并利用任务间关系(inter-task relations),能产出「任何单一任务本身都无法很好表示」的监督信号。
直觉是:复合的跨任务标签能区分那些被单个任务模糊掉的细粒度用户意图——一个既分享又点赞某帖子的用户,可能表达了比只点赞的用户不同程度的兴趣,而把这两种情况当作同样的正标签会丢掉这种区分。虽然上游模型是多任务的,但每个 per-task 头只监督它自己的边际(marginal)标签分布;任务标签的联合分布得不到任何直接的监督信号。复合标签把这个联合结构变成一个显式的监督目标,逼迫嵌入去编码那些边际损失漏掉的细粒度意图。
任务间相关性分析。作者用 Spearman 秩相关刻画任务关系。设 $\mathbf{y}_i \in \mathbb{R}^N$ 为任务 $i$ 在 $N$ 个样本上的标签向量,$\mathrm{rg}(\mathbf{y}_i) \in \mathbb{R}^N$ 为其秩变换版本(第 $n$ 个元素是 $y_{i,n}$ 在 $\mathbf{y}_i$ 全部元素中的秩)。任务 $i$ 与 $j$ 之间的 Spearman 秩相关为:
$$\rho_{ij} = \frac{\mathrm{cov}\big(\mathrm{rg}(\mathbf{y}_i),\, \mathrm{rg}(\mathbf{y}_j)\big)}{\sigma_{\mathrm{rg}(\mathbf{y}_i)} \cdot \sigma_{\mathrm{rg}(\mathbf{y}_j)}}, \tag{1}$$
其中 $\mathrm{cov}(\cdot,\cdot)$ 是协方差、$\sigma_{(\cdot)}$ 是标准差,$\rho_{ij} \in [-1, 1]$ 度量两个任务标签之间单调关系的强度。作者计算跨全部 $T$ 个任务的完整成对相关矩阵 $\mathbf{R} \in [-1,1]^{T \times T}$,并施加阈值 $\tau$ 来识别高相关任务簇 $C_g = \{t_{g_1}, \ldots, t_{g_m}\}$,其中簇内每一对 $(a, b)$ 都满足 $\rho_{t_{g_a}, t_{g_b}} \geq \tau$。
MRM 标签构造。对每个识别出的、规模为 $m$ 的任务组 $C_g$,通过各二元标签的笛卡尔积构造复合多类标签:
$$\ell_n^{(C_g)} = \big(y_{t_{g_1}, n},\, \ldots,\, y_{t_{g_m}, n}\big) \in \{0,1\}^m, \tag{2}$$
由此诱导出一个最多 $2^m$ 类的多类问题。例如,交叉 like 与 comment 产生四类 $(0,0), (1,0), (0,1), (1,1)$,其中 $(1,1)$ 捕捉了比任一单独标签更强的兴趣表达。对于连续值任务(如 time-spent),先把数值标签分桶(bucketize)——桶的划分经过校准以平衡各桶的分布——再把每个桶当作一个类别类,之后再施加同样的笛卡尔积构造。
作者挖掘规模 $m \in \{2, 3\}$ 的任务组,在全二元情况下产出多类复合任务。这些复合任务被用作 Mosaic 专家的监督信号,作者发现 MRM 是他们最有效的独特知识蒸馏技术之一:用 MRM 标签训练的专家,一致地浮现出超越单任务监督所能提供的实质性额外用户信号。
4.1.2 CRL(Cosine Redundancy Loss)¶
为直接鼓励表征多样性,作者在训练期引入一个辅助的余弦冗余损失。设 $\mathbf{e}^{(\mathrm{new})} \in \mathbb{R}^d$ 为新嵌入,$\mathbf{e}_k^{(\mathrm{old})} \in \mathbb{R}^d$ 为第 $k$ 个已有嵌入,冗余损失为:
$$\mathcal{L}_{\mathrm{red}} = \frac{1}{K}\sum_{k=1}^{K} \frac{\mathbf{e}^{(\mathrm{new})} \cdot \mathbf{e}_k^{(\mathrm{old})}}{\big\|\mathbf{e}^{(\mathrm{new})}\big\| \cdot \big\|\mathbf{e}_k^{(\mathrm{old})}\big\|}, \tag{3}$$
总训练目标为:
$$\mathcal{L} = \mathcal{L}_{\mathrm{main}} + \lambda\,\mathcal{L}_{\mathrm{red}}, \tag{4}$$
其中 $\lambda$ 控制下游任务特定精度与嵌入正交性之间的取舍。通过最小化 $\mathcal{L}_{\mathrm{red}}$,模型被鼓励让 $\mathbf{e}^{(\mathrm{new})}$ 落在与已有嵌入正交的子空间中,从而最大化它对下游模型的增量信息贡献。
实践中 $\lambda$ 需要仔细调参:作者施加一个 warm-up schedule 把 $\lambda$ 从零逐渐 ramp 上去,使主损失先收敛,之后再施加冗余惩罚——这样能保住正交性而不伤害下游 NE。作者指出,这一形式是自监督表征学习中冗余削减目标(VICReg、Barlow Twins)的一个更简单的类比,只不过被适配到了「已有嵌入是已经部署好的」这一设定。
值得注意的差异:VICReg / Barlow Twins 是在同一个模型的两个视图之间做去冗余;CRL 是在新模型与一组已冻结、已上线的旧嵌入之间做去冗余——被约束的是单向的,这也是它能被简化为一个平均余弦项的原因。
4.1.3 补充策略¶
另有两个被验证有效的做法:
- 特征–任务对齐(feature task alignment):根据与特定监督任务对齐的特征重要性(FI)分数来挑选新模型的输入特征,降低特征层面的冗余;
- 先验嵌入条件化(prior embedding conditioning):把已有的 Mosaic 嵌入作为输入特征喂进一个 training-only 架构分支,使新模型能显式地基于先前表征做条件化并与之区分。
4.2 优化嵌入评估¶
可靠地评估一个 Mosaic 嵌入,需要通过下游 train/eval NE 度量它对下游 ranker 的贡献。但这么做很慢:新嵌入模型必须先部署并爬坡到全流量,然后打点进特征流水线以积累训练数据;再加上下游重训与评估,端到端迭代周期可长达数天。
上游模型自身的 train/eval NE 早得多就能拿到,但它不能一致地追踪下游影响——只有 user tower 会到达下游消费者,因此对上游训练图其余部分的改进会体现为上游 NE 的提升,却不转化为下游收益。这就使团队在日常开发中缺少一个快速而准确的离线信号,也直接催生了下面两种评估方法。
4.2.1 CoEval 框架¶
CoEval 是一个统一架构,它通过与下游 ranker 的直接、在训练中的集成来度量嵌入的下游影响,而不是用一个「从日志特征代理」的方式。CoEval 复用了 CoTrain 专家的联合训练架构(§3.3.4),但把 user tower $f_\theta$ 冻结而非可训:对每个下游训练样本 $(x_u, x_c, y)$,CoEval 计算嵌入 $\mathbf{e}_u = f_\theta(x_u)$,并把它与其它特征一起内联(inline)喂进下游模型。由此得到的 NE delta 直接量化了该嵌入的贡献:
$$\Delta \mathrm{NE}_{\mathrm{CoEval}} = \mathrm{NE}_{\mathrm{with}\ \mathbf{e}_u} - \mathrm{NE}_{\mathrm{baseline}}. \tag{5}$$
该设计有两个关键性质:
- 免部署、免打点:CoEval 直接从一个训练好的专家 checkpoint 产出下游对齐的评估信号,既不需要部署该专家(配置发布、模型加载、流量爬坡),也不需要把它的嵌入打点并积累进下游特征流水线。一个刚训完的 user tower 可以立刻被评估——甚至在它被接进服务栈之前。
- 模块化:CoEval 把 user tower 当作一个冻结模块,与任意下游 ranker 的一份副本配对,因此任何专家都能被这样评估,而不仅限于 CoTrain 专家。
实践后果是:端到端评估周期压缩到不足原来的一半。针对完整特征打点流水线的验证实验表明,CoEval 产出的评估与下游 NE 准确对齐。
4.2.2 User Tower Zero-Out 评估¶
作者还开发了 User Tower Zero-Out,作为一种不走特征打点步骤也能准确评估用户嵌入质量的替代方法。该技术度量把 Mosaic 模型中的 user-tower 输出置零所产生的 $\Delta \mathrm{NE}$,从而给出该嵌入信号在上游语境内的增量价值的一个量规。
两者分工清晰:CoEval 测「对下游有多大用」(下游对齐、更贵),Zero-Out 测「在上游内部承载了多少信息」(更便宜、可即时算,但只是上游代理)。
实验设置¶
数据集与任务。作者在多个 surface 上的多个下游 ranker 上评估 Mosaic(见 Table 4)。每个下游 ranker 优化自己的一组任务与标签,作者报告在 ranker 使用的同一 train/eval split 上度量的 task-level $\Delta$NE,其中 Task A 代表最高优先级任务,Task B / C 为其它参与度事件。
离线指标:
- NE(Normalized Entropy):下游 ranker 使用的基于 log-loss 的质量指标,越低越好;
- FI(Feature Importance):Mosaic 特征在下游 ranker 全部输入特征中的相对排名。
线上测试:作者还做了线上 A/B 实验,度量 Mosaic 嵌入在不同 surface 上对用户参与度与 topline 指标的贡献。
注意:论文出于保密对 surface 与任务做了匿名化,未披露具体业务、数据规模、模型参数量等绝对数字。
主要实验结果¶
离线评估¶
Table 4: Mosaic 嵌入在下游 surface 上的 $\Delta$NE(越负越好)
| Surface | Multi-Task Head | Train $\Delta$NE | Eval $\Delta$NE |
|---|---|---|---|
| Surface 1 | Task A | −0.37% | −0.21% |
| Surface 1 | Task B | −0.38% | −0.30% |
| Surface 1 | Task C | −0.30% | −0.16% |
| Surface 2 | Task A | −0.03% | −0.03% |
| Surface 2 | Task B | −0.04% | −0.05% |
| Surface 2 | Task C | −0.07% | −0.02% |
| Surface 3 | Task A | −0.10% | −0.05% |
| Surface 3 | Task B | −0.05% | −0.21% |
| Surface 4 | Task A | −0.27% | −0.13% |
| Surface 4 | Task B | −0.31% | −0.21% |
| Surface 4 | Task C | −0.31% | −0.16% |
| Surface 5 | Task A | −0.09% | −0.11% |
| Surface 5 | Task B | −0.03% | −0.08% |
| Surface 6 | Task A | −0.05% | −0.09% |
| Surface 6 | Task B | −0.21% | −0.33% |
分析。跨 6 个 surface、共 15 个 task-level 观测,Eval $\Delta$NE 全部为负,作者称其为「一致且统计显著」。但收益幅度高度不均衡:Surface 1 与 Surface 4 的收益最大(Eval $\Delta$NE 达 −0.21% 至 −0.30%),Surface 2 几乎不动(−0.02% 至 −0.05%)。这说明 Mosaic 的价值强依赖于目标 surface 的用户信号丰富程度与下游 ranker 现有特征的覆盖度——在下游已经把用户信号吃得比较透的 surface 上,上游嵌入的增量空间自然收窄。另一个值得注意的现象是 Train $\Delta$NE 普遍大于 Eval $\Delta$NE(Surface 1 Task A: −0.37% vs −0.21%),暗示存在一定程度的过拟合到训练分布;而 Surface 3 Task B 与 Surface 6 出现反向(Eval 收益大于 Train),说明嵌入在这些 surface 上带来的是泛化性收益而非记忆化收益。
专家家族消融¶
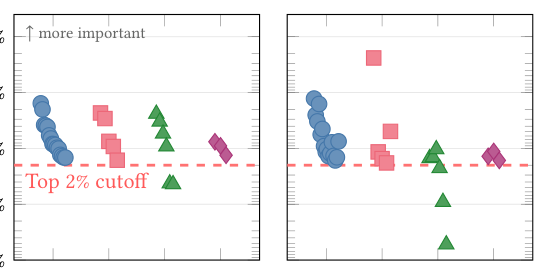
Table 5: Mosaic 各专家家族的 NE 贡献拆解(Surface 1)
| 专家家族 | 新增嵌入数 | 聚合 Eval $\Delta$NE |
|---|---|---|
| Memorization-driven | 8 | −0.09% |
| Dense-heavy | 20 | −0.22% |
| Sequential-based | 6 | −0.12% |
| CoTrain | 3 | −0.15% |
分析。在 Surface 1 上,dense-heavy 专家以约 20 个部署嵌入贡献了最大份额(−0.22% NE),其后是 CoTrain(−0.15%) 与 HSTU-CInt 序列模型(−0.12%)。
这张表最有信息量的其实是「每个嵌入的平均效率」这一隐含维度:
- CoTrain:3 个嵌入换 −0.15%,单位嵌入效率最高(约 −0.050%/嵌入)——这直接印证了「下游监督对齐」的价值密度;
- Sequential:6 个嵌入换 −0.12%(约 −0.020%/嵌入);
- Dense-heavy:20 个嵌入换 −0.22%(约 −0.011%/嵌入)——总量最大但边际效率最低,符合 §4.1 中「随舰队增长边际收益递减」的观察;
- Memorization-driven:8 个嵌入换 −0.09%(约 −0.011%/嵌入)。
换言之,dense-heavy 是靠「量」堆出来的主力,CoTrain 才是「质」最高的那一类——这也解释了为什么作者要专门为 CoTrain 设计一套 co-training 架构,尽管它是四类里部署最重、最需要离线推理的一类。
特征重要性¶
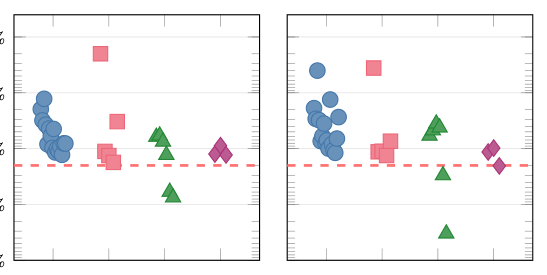
作者还通过 FI 评估了 Mosaic 各个嵌入在下游排序模型中的地位。Figure 3 展示了一个生产 surface 上各类 Mosaic 嵌入的排名,含三个最重要任务(Task A / B / C)的 FI 分布以及一个考虑下游 ranker 全部 10+ 个排序任务的 aggregated 排名。
关键结论:在 20k+ 个输入特征中,Mosaic 嵌入一致地排进前 2%。其中:
- 少数 memorization-driven 嵌入排到极顶(约 0.01% 分位)——即整个特征集里最重要的十几个特征之一;
- dense-heavy 专家平均给出非常高且非常稳定的 FI 表现——分布最紧凑,跨任务一致性最好。
对照 Table 5 看,这两条结论是互补的:memorization-driven 家族的聚合 NE 贡献并不高(−0.09%),但它能产出单点 FI 极高的特征;dense-heavy 则是广谱稳定。序列类(绿色三角)在 Task B 上出现了明显下沉到 10% 分位以下的点,说明序列嵌入的价值高度任务依赖。
序列模型 scaling 消融¶
作者在序列专家(§3.3.3)上报告了三条 scaling 轴的 NE 与 QPS delta。以 512 序列长度为基线,实验了变化的序列长度、稀疏 MoE 路由与嵌入维度。
Table 6: 序列模型 scaling——Surface 1 与 2 上各任务的 NE 提升
| 类别 | 配置 | Eval $\Delta$NE | QPS |
|---|---|---|---|
| Seq length | HSTU, 1024 seq len | −0.21% | −18% |
| Seq length | HSTU, 2048 seq len | −0.45% | −33% |
| MoE | top-2 of 8 experts, expert_dim=128 | −0.07% | −8% |
| MoE | top-2 of 8 experts, expert_dim=256 | −0.12% | −12% |
| MoE | top-2 of 8 experts, expert_dim=512 | −0.14% | −21% |
| MoE | top-4 of 8 experts, expert_dim=512 | −0.15% | −23% |
| Emb dim scale-up | emb_size=256 | −0.23% | −15% |
| Emb dim scale-up | emb_size=256 + warmup | −0.25% | −18% |
分析。这张表是全文对「性能–容量权衡」最直接的量化:
- 序列长度是最强的 scaling 轴。512→1024 换来 −0.21% NE、代价 −18% QPS;512→2048 换来 −0.45% NE、代价 −33% QPS。长度翻倍带来的 NE 收益近似线性叠加(−0.21% → −0.45%),而 QPS 成本亚线性(−18% → −33%,未翻倍)——说明在这个区间内加长序列的性价比仍在提升,尚未触及饱和点。这也是四条轴里唯一一条 NE 收益超过 0.4% 的。
- MoE 的收益明显更弱且很快饱和。expert_dim 从 128 → 256 → 512(即参数量 4×),NE 只从 −0.07% 走到 −0.14%,而 QPS 成本从 −8% 恶化到 −21%。进一步把 top-2 提到 top-4(激活参数翻倍),NE 只从 −0.14% 微增至 −0.15%,QPS 再降 2 个百分点——几乎完全饱和。这说明在这个序列专家上,MoE 的稀疏容量扩张并不是有效的 scaling 方向,瓶颈不在参数容量而在上下文长度。
- 嵌入维度扩容性价比不错。emb_size=256 给出 −0.23% NE / −15% QPS,是单位 QPS 成本上性价比最高的一档(约 0.0153% NE per 1% QPS,优于 2048 序列长度的 0.0136%)。再加 warmup 把 NE 推到 −0.25%,代价是 QPS 从 −15% 到 −18%——warmup 这个「零参数成本」的训练技巧换来 0.02% 的额外 NE,但 QPS 反而恶化 3 个百分点,作者未解释这一反常(推测与 warmup 后收敛到的模型在服务时的数值/缓存行为有关)。
线上 A/B 结果¶
Table 7: Mosaic 嵌入在下游 surface 上的 topline 线上 A/B 提升
| 产品 surface | Topline 收益 $\Delta$ |
|---|---|
| Surface 1 | +0.10% |
| Surface 2 | +0.15% |
| Surface 3 | +0.28% |
分析。Mosaic 在每一个测试的 surface 上都取得了一致且统计显著的提升。有意思的是线上收益与离线 NE 收益并不同序:Surface 2 的离线 $\Delta$NE 是三者中最弱的(−0.02% 至 −0.05%),线上却拿到 +0.15%;Surface 3 离线 NE 中等(−0.05% / −0.21%),线上却是最高的 +0.28%。这再次印证了 §4.2 的出发点——上游 NE、下游 NE、线上 topline 三者之间的传导并不单调,也侧面说明了为什么作者要花大力气建 CoEval 这样的下游对齐评估工具,而不是依赖上游指标。
核心贡献总结¶
- 范式层面:明确提出并论证「专家舰队 vs 单一通才 / 共享骨干」这一在用户表征层此前未被系统探索的设计轴,并给出了完整的权衡表(信号聚焦 / 开发速度 / 故障隔离)与一次数据算力匹配的原型对比结论。
- 方法层面:MRM 把任务间 Spearman 相关聚类 + 笛卡尔积复合标签变成一种可复制的「监督信号增广」手段,直接针对多任务上游模型「只监督边际、不监督联合分布」的盲区;CRL 把自监督领域的冗余削减目标适配到「旧嵌入已冻结上线」的工业设定,配合 $\lambda$ warm-up 保住正交性而不伤 NE。
- 评估层面:CoEval 把「冻结 user tower + 下游 ranker 副本内联训练」变成一个免部署、免打点、模块化的下游对齐评估器,把端到端评估周期压到不足一半(整体迭代速度 3–5×);User Tower Zero-Out 提供了一个更便宜的上游侧代理。
- 系统层面:三路径混合服务栈(CPU 在线 / GPU 在线 / GPU 离线)+ AOTI 编译 + model splitting + 2 小时 TTL look-aside memcache,累计削减 79% GPU 服务用量且延迟还改善 0.14%;TBE + TorchRec row-wise sharding + 异构分布式推理支撑数百 GB 的记忆化嵌入表。
- 实证层面:6 个 surface、15 个 task-level 观测的一致离线 NE 下降,3 个 surface 的线上 topline 正向,以及一张信息量很大的序列 scaling 权衡表(序列长度 >> 嵌入维度 > MoE)。
与已归档相关工作的对比¶
DUET DUET: Dual User Embedding Transformers(Meta,2026-06-08)¶
关系:独立并发(本文未引用 DUET,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文指向同一个 root cause——「单一上游用户嵌入编码器在统计结构异质的信号上共享容量,必然被某一类信号主导,欠拟合其余信号」。DUET 的表述是「signal dominance under regime mismatch」与「architectural uniformity」:把稠密短窗的点击流与稀疏长窗的站外转化流塞进同一个编码器,模型被稠密点击主导,欠拟合最相关的转化模式。Mosaic 的表述是 Table 2 的「Shared capacity must cover sparse, dense, and sequential signals」。二者甚至连解决方向的第一步都一样:先把「统计同质」的部分切出来,再为每一块配一个与其统计特性匹配的架构。
- 相近的技术骨架:两者的方法流程图可以高度重合——(1) 把上游训练资源沿某个轴切分;(2) 为每一块实例化一个架构与之匹配的专用上游编码器;(3) 各自独立训练,产出多个互补的用户嵌入;(4) 下游 ranker 把这些嵌入当作冻结的普通输入特征并列消费,不改下游架构;(5) 上游与下游按各自独立的节奏重训,通过异步 serving 把上游模型复杂度与在线延迟预算解耦。DUET 是这个骨架在 $N=2$ 时的实例,Mosaic 是同一骨架在 $N=4$ 家族、数十个嵌入时的实例。
- 本文的差异与推进:切分轴不同,且 Mosaic 多走了两步关键的。(a) 切分轴:DUET 沿标签语义与归因时长切(点击/站内转化流 vs 站外转化流),架构差异体现在注意力配置上(ClickAUN 堆叠自注意力 vs ConvAUN 交错交叉/自注意力),但两个编码器从同一个共享骨干实例化,共享相同的输入表征与 DLRM 结构。Mosaic 沿用户信号的特征类型切(稀疏 ID / 稠密计数器 / 行为序列 / 下游梯度),四个家族是真正架构异构的——大 hash table、Wukong/SEDot/MHTA、HSTU+MoE、下游 ranker 副本共训,彼此之间没有共享骨干。(b) 冗余治理:DUET 只在设计时假定两条流互补,未提供任何机制来度量或强制这种互补;Mosaic 因为舰队规模大得多,直接撞上了「边际收益递减」这堵墙,于是被迫发明 MRM + CRL + 特征–任务对齐 + 先验嵌入条件化 四件套去显式最大化每个新专家的边际信息。这是舰队范式规模化之后必然产生、而 $N=2$ 时看不见的问题。(c) 评估:DUET 走的仍是常规下游 train/eval NE 验证;Mosaic 因为专家产出节奏快,把评估本身当作瓶颈来攻,做出了 CoEval / Zero-Out。
- 可比的方法/实验差异:两者都用 NE 作为下游金标准指标,且量级可比——DUET 相对最强 baseline 至多 −0.38% NE(6 个下游 OCVR 模型),Mosaic 的 Train $\Delta$NE 最大 −0.38%、Eval $\Delta$NE 最大 −0.33%(6 个 surface)。线上收益 DUET 报 CVR +0.66% / +0.15%,Mosaic 报 topline +0.10% / +0.15% / +0.28%——DUET 的单点线上收益更高,但它优化的是单一垂直目标(站外转化);Mosaic 报的是topline,横跨多 surface 的通用参与度。此外 DUET 用事件触发推理(ETI)+ 嵌入量化做异步 serving,Mosaic 用三路径混合栈 + AOTI + memcache;两者在「上游复杂度不得侵占在线延迟预算」这一约束下独立收敛到了几乎相同的工程答案。
WHALE WHALE: Wukong-HSTU 统一可扩展推荐模型(Meta Platforms,2026-07-19)¶
关系:独立并发(本文未引用 WHALE,同为 Meta,相隔 8 天)· 已加载对方精读
- 共同关注的问题:两篇论文共享同一个前提性诊断——「非序列高阶特征交互」与「长行为序列建模」是两种统计结构与归纳偏置根本不同的建模目标,没有任何单一架构能同时覆盖」。WHALE 的表述是「以序列为中心的模型不显式 scale 静态与上下文交叉,特征交互模型缺乏对长历史时序演化的显式机制」;Mosaic 的 Table 1 则把这个诊断制度化成一张「信号类型 ↔ 最优归纳偏置」的映射表。更巧的是,两者选中的具体架构是同一对:Mosaic 的 dense-heavy 专家候选之一就是 Wukong,sequential 专家骨干就是 HSTU——WHALE 要在单模型内融合的,正是 Mosaic 刻意分开养的那两个。
- 相近的技术骨架:两者都从「异构架构各自匹配一类信号」出发,都把 Wukong 与 HSTU 当作已在 Meta 大规模验证过的可扩展骨干原语来复用,都在结果上要产出「同时携带静态交叉证据与时序证据」的表征供排序消费,也都用 NE + 线上 A/B 作为主指标并同步报告 QPS/延迟代价。
- 本文的差异与推进:同一个 root cause,两个方向相反的结构性答案。WHALE 把两个骨干塞进同一个模型的每一层,用基于注意力的融合模块让 Wukong 的高阶交互表示去 query HSTU 的 $L$-step 序列表示,实现逐层加深的跨分支交换;它明确把「先用序列模型把历史压成少量 summary embedding、再喂进特征交互模型」的做法批评为 shallow-hybrid 浅接口——一旦历史被压成固定摘要,高阶交互就无法再在细粒度行为事件层面选择性抽取证据。而 Mosaic 恰恰就是那个被批评的形态的极致工程化版本:它的 sequential 专家产出的正是压缩后的 summary embedding,下游 ranker 消费的正是这个浅接口。Mosaic 对此有它自己的回应逻辑——浅接口不是缺陷而是设计目标:它换来的是嵌入跨 10+ 下游 ranker 的复用、上下游独立重训节奏、故障隔离、以及上游复杂度完全不侵占下游服务图,这些是 WHALE 的单体架构结构上无法提供的。反过来,WHALE 的收益也是 Mosaic 结构上拿不到的:候选/上下文相关的特征交叉能逐层反复检索最相关的行为证据。
- 可比的方法/实验差异:WHALE 在 Meta 线上 A/B 把主指标推高 +0.113%,Mosaic 在三个 surface 上分别 +0.10% / +0.15% / +0.28%——量级同档,但 Mosaic 是一整支舰队跨多 surface 的累计效果,WHALE 是单模型在单场景的效果。两者的 scaling 结论也可互相印证:WHALE 报告随序列长度、深度、宽度都有良好 scaling;Mosaic 的 Table 6 则给出了更细的性价比排序——序列长度(2048 换 −0.45% NE / −33% QPS)远强于嵌入维度(−0.23%/−15%),而 MoE 稀疏容量扩张很快饱和(top-2→top-4 只换来 0.01% NE)。这条「MoE 在序列专家上不是有效 scaling 方向」的负面结论,恰好为 WHALE「把容量花在跨分支交换而非稀疏专家上」的路线提供了一个侧面支持。
讨论与局限性¶
值得借鉴的设计¶
1. 把「组织约束」提升为一等建模考量。 Table 2 里,专家舰队胜出的三条理由中有两条(开发速度、故障隔离)是组织与运维层面的。这在推荐系统论文里罕见地诚实:在一个有几十个下游 ranker、上百个建模者的组织里,「一个改动是否需要走同一个模型发布周期」往往比「这个架构 NE 好 0.05%」更决定长期迭代速率。这一视角对任何要在大组织内建平台型模型层的团队都有直接借鉴价值。
2. MRM 是一个便宜且可迁移的监督增广技巧。 「多任务模型只监督各任务的边际分布,联合分布拿不到任何直接监督」这一观察本身很锐利,而解法(Spearman 秩相关聚类 → 阈值筛高相关簇 → 笛卡尔积复合多类标签 → 连续标签先分布校准分桶)不依赖任何架构假设,几乎可以插进任何多任务推荐模型。$m \in \{2,3\}$ 的限制也很务实——再大类别数就爆炸且样本稀疏。
3. CRL 的「工业变体」定位准确。 把 VICReg / Barlow Twins 的去冗余目标改造成「新嵌入 vs 一组已冻结上线的旧嵌入」的单向余弦惩罚,加上 $\lambda$ warm-up,是一个恰好匹配工业增量上线约束的简化。它承认了一个现实:你不可能为了让第 38 个嵌入更正交而去重训前 37 个。
4. CoEval 攻击的是「评估延迟」而非「模型质量」。 大多数论文优化模型,Mosaic 花了整整一节优化评估这件事本身有多快。把 CoTrain 架构 frozen 一下就变成评估器,是一个成本极低、复用度极高的设计。3–5× 的迭代速度提升,在实际组织里的复利价值可能高于任何单个建模改进。
局限与争议¶
1. 没有任何单点新架构。 四个专家家族用的全是既有架构(hash table + TBE、MHTA / SEDot / Wukong、HSTU + MoE、下游 ranker 副本)。论文的贡献是编排(orchestration)而非发明。这本身不是缺点,但它意味着这篇论文的可迁移价值高度依赖读者是否处在类似的规模与组织形态下——在一个只有 2-3 个下游 ranker 的中型系统里,舰队范式的三条理由中至少两条(开发速度、故障隔离)会大幅贬值。
2. 关键方法缺少量化消融。 MRM 与 CRL 被称为「最有效的独特知识蒸馏技术之一」,但论文没有给出任何一张表来量化「加 MRM 前后 NE 差多少」「$\lambda$ 取不同值时正交性与 NE 的 trade-off 曲线」。同样,CoEval 声称「针对完整特征打点流水线的验证实验表明其评估与下游 NE 准确对齐」,但没有给出相关系数、散点图或任何数值。这是全文最大的实证缺口——方法论贡献的说服力主要建立在作者的断言而非数据上。
3. 匿名化到影响可解释性。 Surface 1-6、Task A/B/C 全部匿名,读者无法判断为什么 Surface 2 的收益比 Surface 1 小一个数量级,也无法判断 Table 7 的三个 surface 与 Table 4 的六个 surface 如何对应。「+0.28% topline」在没有 surface 语义与基线绝对量的情况下,难以横向比较。
4. 「舰队 vs 通才」的核心对比证据薄弱。 全文最重要的设计主张——「在数据与算力匹配的原型对比中,小专家舰队产出了比大通才模型更强的嵌入质量」——只有一句话,没有实验表、没有配置说明、没有 NE 数字。考虑到这是整篇论文的立论根基,且业界主流(PinFM、Foundation-Expert、Large User Model)正在往相反方向走,这个证据强度与主张强度明显不匹配。
5. 边际收益递减是范式的结构性上限,而非可以修补的 bug。 §4.1 承认「每个新嵌入的边际提升在缩小」,Table 5 的隐含数据也印证了这点(dense-heavy 用 20 个嵌入才换 −0.22%,单位效率约为 CoTrain 的 1/5)。MRM / CRL / 特征–任务对齐 / 先验条件化四件套是在缓解症状,但它们改变不了一个事实:当舰队规模继续增长,用户信息的总量是有限的,正交子空间会耗尽。论文没有讨论这条曲线会在哪里触底,也没有给出「什么时候应该停止加专家、转而重构」的判据。
6. 方法论可扩展性的隐忧:显式两阶段解耦。 从 scaling 视角看,Mosaic 是一个典型的「先离线压缩用户,再在线建模」范式:user tower 训练完就冻结,下游 ranker 消费的是固定维度的压缩产物。这带来两个结构性瓶颈——(a) 压缩器与下游模型无法端到端联合优化(CoTrain 专家是对此的部分补丁,但代价是牺牲跨 surface 复用,且只覆盖 3 个嵌入);(b) 参数量 scaling 时,「如何表征历史」(user tower 容量)与「如何建模序列」(下游 ranker 对这些嵌入的使用方式)两条路径无法同步增长——下游拿到的永远是那几十个固定向量。这正是 WHALE 批评 shallow-hybrid 时指出的同一个问题。Table 6 的 MoE 快速饱和(top-2→top-4 只换 0.01% NE)也可以从这个角度理解:瓶颈不在上游容量,而在上游→下游那个固定宽度的接口。
工业落地价值¶
抛开上述保留,这篇论文的工程披露密度是同类平台论文里偏高的:TBE 三级存储 + INT4 量化、TorchRec row-wise sharding、热冷表异构分布式推理、AOTI 编译、model splitting、2 小时 TTL look-aside memcache、stochastic-length 训练、时间戳强制排序、$\lambda$ warm-up ——这些都是只有真正跑过生产才会写出来的细节,对同类平台的建设者有直接参考价值。79% GPU 服务用量削减 + 延迟同时改善 0.14% 这一条,本身就值得单独抄作业。
论文最后给出的定位是恰当的:Mosaic 的设计原则与运作机制,为「希望把用户表征跨多个下游消费者 scale 起来」的工业推荐系统提供了一份实用蓝图(practical blueprint)——它卖的是范式与运维方法论,不是某个 SOTA 架构。