SequenceO1: End-to-End Ultra-Long (100K) Sequence Modeling in Recommendation with Low-Rank Caching¶
ByteDance(抖音),RecSys '26,arXiv:2609.08443v1,2026-09-08,20 页。
一句话总结¶
SequenceO1 把 100K 超长行为序列的瓶颈重新定义为「原始序列在训练与在线服务中被反复存储、传输、重复计算」,而不是注意力的复杂度;它用可学习原型 + 原型维 softmax 的 Sketch Attention 把 100K 历史压成定长、目标无关(user-only)的 sketch,因而这份表示可以被缓存并跨候选、跨请求复用,再用 STCA 分别在「近期 10K 后缀」和「定长 sketch」上做目标条件推理;配合训练侧 local KVCache、MRLB、pipeline lift 与融合算子 FlashSA,在抖音全流量上线并跑了一个月 A/B。
一、研究动机与背景¶
1.1 100K 的瓶颈是系统性的,不只是「注意力太贵」¶
抖音上单个用户一年的消费行为量级可以轻松达到 $10^5$ 次交互。这些超长历史里含有稳定偏好、周期性意图和复现的兴趣模式,短窗口看不到。但精排阶段(fine-ranking)受严格的延迟与训练吞吐约束,很难直接端到端用上这些历史。
论文反复强调的核心判断是:在 100K 尺度上,这不只是「每层算力」的问题——
- embedding 与序列特征会把训练样本和 cache footprint 撑大;
- 搬运这些特征会压垮 host–device 与分布式通信;
- 处理这些特征同时抬高训练与服务的计算。
即:存储(storage)、通信(communication)、计算(computation)三者同时爆炸。因此只优化「每层复杂度」是不够的,必须避免「反复存储、搬运、处理原始超长历史」这件事本身。
1.2 三条既有路线,各自差在哪¶
论文在 Figure 2(a) 里把既有路线摆成一张对照图。
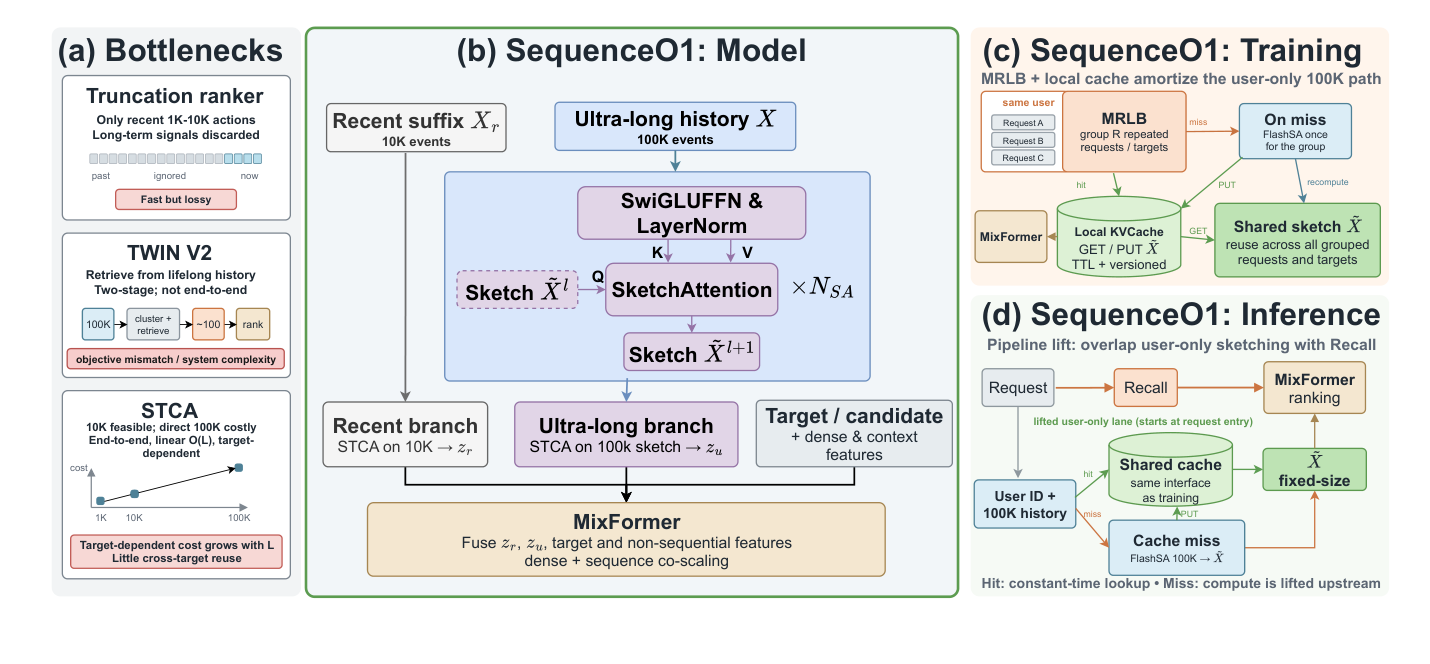
(a)截断(Truncation)。只保留最近 1K–10K 行为。快,但长期信号被直接丢掉。
(b)多阶段检索 / 生命周期压缩(TWIN V2 谱系)。抖音线上原有的基线正是 TWIN V2 [37] 风格:离线层次聚类把 lifelong 行为压成聚类,线上用 GSU(General Search Unit)从中检索出与 target 相关的一小撮行为,再交给下游做细粒度兴趣建模。在他们的实现里,聚类后的历史约 10K 条,GSU 再从中检索一个小子集。问题在于:压缩和检索这两步与最终排序目标是分离的,无法对原始超长历史做端到端优化,而且系统复杂度高。
(c)端到端长序列排序 + 长度外推。训练用短序列、服务用长序列。Meta 的 HSTU 用随机长度采样降低训练成本;抖音自家的 STCA [13] 用「train-sparsely / infer-densely」。但论文指出,外推倍率始终和训练长度绑死:ULTRA-HSTU 报告平均训练长度约 4,400 用于 16,384 的推理;STCA 研究的平均训练长度约 2–2.5K 用于 10K 服务——两者都只有约 4–5 倍。要靠外推达到 100K,训练上下文仍然要很长,特征-样本存储、通信、训练算力的成本一个都省不掉。
而且外推也解决不了服务端瓶颈:vanilla HSTU 的 self-attention 是 $O(L^2)$;STCA 把每层复杂度降到 $O(L)$,但推理成本仍随原始历史长度线性增长。更关键的是——STCA 的 target-conditioned cross attention 是 query-dependent 的,跨候选几乎没有可复用的计算。
(d)第四条路:解耦上游用户建模。LLaTTE [46]、SOLARIS [25] 这类多阶段系统把用户表征异步算好再迁移给在线排序器,降低在线计算,但引入表征瓶颈、目标错配、以及上游用户模型与最终排序目标之间的新鲜度约束。
1.3 关键观察:超长部分既应当可压缩,也应当可复用¶
论文的关键观察分两半:
- 可压缩:高效注意力的研究表明长序列沿长度维通常允许紧凑表示(Linformer [40]),定长 latent summary 也已被证明能在下游推理前压缩大输入(Perceiver [18]、Set Transformer [20])。
- 可复用:100K 序列应当被总结成一个只依赖用户侧信号的紧凑表示。如果这个定长用户表示能算一次、缓存、并在重复的训练实例、多个候选、连续请求之间复用,那么昂贵的 target-conditioned 模块就再也不需要直接在原始 100K 历史上跑。
「SequenceO1」这个名字指的正是 cache-hit 路径:一旦定长 sketch 可用,该样本就不需要物化、传输、处理原始 100K 特征序列,因此这条路径相对于原始超长序列长度是 $O(1)$ 的。
1.4 三条贡献¶
- 端到端 100K 排序(SA + STCA):用 Sketch Attention 压缩超长历史,再对 sketch 与近期 10K 后缀分别做 target-conditioned STCA。
- 可缓存的低秩 sketch:SA 是一个目标无关的压缩模块,产出定长的 user-only sketch;它可微、长度无关、可跨候选与请求复用。
- Cache-first 的 100K 训练与服务:训练侧 local KVCache + 服务侧 sketch 复用,辅以 MRLB、pipeline lift、FlashSA,在 cache hit 时彻底消除 $n$-依赖的特征存储、通信与计算。
二、背景与记号¶
2.1 问题设定¶
研究对象是抖音大规模短视频推荐的精排(fine-ranking)阶段。给定用户 $u$ 的一次请求,排序器在严格延迟与成本约束下给候选视频 $t$ 打分,用到用户/请求特征、item 特征,以及带监督信号(finish、click、skip 等)的交互历史 $\mathcal{H}$。
按工业惯例,训练与服务都把每个用户历史截断到最大长度 $n_{\max} = 100\text{K}$。
2.2 记号¶
用户交互历史记为
$$\mathcal{H} = \{(v_i, a_i)\}_{i=1}^{n} \tag{1}$$
其中 $v_i$ 是第 $i$ 个历史 item,$a_i$ 是关联的动作类型。每个事件被嵌入为 $\mathbf{x}_i \in \mathbb{R}^d$,目标 item $t$ 表示为 $\mathbf{x}_t \in \mathbb{R}^d$。
历史嵌入矩阵为
$$X = [\mathbf{x}_1, \dots, \mathbf{x}_n]^\top \in \mathbb{R}^{n \times d} \tag{2}$$
论文考虑两个时间尺度:长度 $n$(最多 100K)的超长历史,和长度 $L_r = 10\text{K}$ 的近期后缀。当 $n \ge L_r$ 时,近期后缀为
$$X_r = X_{n - L_r + 1 : n} \in \mathbb{R}^{L_r \times d} \tag{3}$$
超长历史被压缩成长度 $k$ 的定长 sketch(典型 $k \approx 512$–$1024$),$k$ 相对 $n$ 视为常数。
符号约定:$n$ 为原始超长历史长度,$L_r$ 为近期后缀长度,$k$ 为 sketch 长度;对通用 STCA 模块用 $L$ 表示其输入长度(近期分支 $L = L_r$,sketch 分支 $L = k$)。$d$ 为行为嵌入与 SA 的宽度,$d_h$ 为 STCA 每头宽度,$D$ 为经 sketch adapter 后的 STCA 模型宽度。
2.3 STCA 回顾¶
标准 self-attention 在长度 $L$ 上是 $O(L^2)$,工业规模下不可承受。Stacked Target-to-History Cross Attention (STCA) 的做法是:去掉 history–history 注意力,改成从 target 到 history 的堆叠单 query 交叉注意力。给定 target query $\mathbf{q} \in \mathbb{R}^{w}$ 与历史嵌入 $X \in \mathbb{R}^{L \times w}$,一层 STCA 计算
$$\mathrm{Attn}(\mathbf{q}, X) = \mathrm{softmax}\!\left(\frac{(\mathbf{q}W_Q)(XW_K)^\top}{\sqrt{d_h}}\right) \cdot (X W_V) \tag{4}$$
其中 $W_Q, W_K, W_V \in \mathbb{R}^{w \times d_h}$。
只有一个 query,因此每层成本随 $L$ 线性增长,这使得生产环境里的端到端排序能做到 10K 量级。但在 $n = 100\text{K}$ 时直接套 STCA 服务仍然太贵:它的主导项 target-to-history cross attention 仍然是 query-dependent 的,且随原始历史长度线性增长;跨候选几乎没有可复用计算。这正是「把超长用户侧压缩与目标条件推理解耦」的动机。
2.4 长度维压缩的动机¶
Linformer 从低秩注意力近似出发,论证了长度 $k \ll n$ 的短表示是合理的;Set Transformer 与 Perceiver 用 inducing points / 定长 latent 数组在做表达性推理之前总结大输入 [18, 20, 40]。这些工作共同说明:一小组学出来的 summary token 可以把序列长度换成可控的计算量。
但论文指出既有方案与自己场景的三点差异:
- Perceiver 与 poly-encoder 通常用 latent query + token-wise softmax 去「选择」输入 [17, 18];SA 改用 prototype-wise softmax,让每个 token 被分配到各原型上,鼓励目标无关的历史覆盖。
- Slot Attention [27] 在归一化精神上最接近,但它面向迭代式的 object-centric 学习,SA 面向严格延迟约束下的超长排序。
- 到 $n = 100\text{K}$ 的可变长度历史使显式的长度相关投影变得不灵活;而且通用压缩本身不天然提供一个定长、端到端兼容、可跨候选与请求复用的 user-only 状态。
三、核心方法:Sketch Attention¶
3.1 原型与原型维归一化¶
Sketch Attention 得名于 sketch 这个概念:在固定内存预算下保留一个大得多的对象的显著信息。这里对象是超长用户历史,sketch 是一组定长的用户侧表示 token。论文明确类比 Count Sketch [4] 这类流式 sketch,但强调 SA 是端到端学出来的,为下游排序而非恢复手工统计量优化。
给定超长历史嵌入 $X \in \mathbb{R}^{n \times d}$,学习 $k$ 个可训练原型(数量从几百到几千灵活可选):
$$P^{(0)} = [\mathbf{p}_1, \dots, \mathbf{p}_k]^\top \in \mathbb{R}^{k \times d} \tag{5}$$
它们充当一组紧凑的 summary slot。为了支持跨候选与跨请求复用,原型是全局共享的,因此产出的表示只依赖用户历史。
原型–token 亲和度为
$$S = \frac{(P^{(0)} W_Q)(X W_K)^\top}{\sqrt{d}} \in \mathbb{R}^{k \times n} \tag{6}$$
其中 $W_Q, W_K \in \mathbb{R}^{d \times d}$。
原型维归一化(Prototype-wise normalization)。 不像标准注意力那样在 token 维归一化,SA 在原型维归一化:
$$A = \mathrm{softmax}_{\mathrm{proto}}(S) \in \mathbb{R}^{k \times n}, \qquad \sum_{j=1}^{k} A_{j,i} = 1 \tag{7}$$
等价地,
$$A_{j,i} = \frac{\exp(S_{j,i})}{\sum_{j'=1}^{k} \exp(S_{j',i})} \tag{8}$$
因此 $A_{j,i}$ 定义了一个 token 到原型的分配 $p(j \mid i)$。相比 token 维归一化,这种分配避免了过早的 token 选择,鼓励在目标条件化之前覆盖整个历史——当压缩表示必须以可复用的方式支持多样候选时,这一点很关键。
Sketch 构造。 聚合历史嵌入得到紧凑 sketch:
$$\widetilde{X} = A X \in \mathbb{R}^{k \times d} \tag{9}$$
这是对历史 token 的加权聚合而非 token 级选择。结果 sketch 是定长、目标无关、完全可微的,因而适合缓存与端到端训练。
3.2 SA 作为隐式的长度维投影¶
式 (9) 可以看作一个数据相关的长度维投影:动态构造的 $A \in \mathbb{R}^{k \times n}$ 在目标条件推理之前把历史从 $n$ 个 token 压到 $k \ll n$ 个 sketch token。与绑死最大序列长度的固定投影 [40] 不同,$A$ 由输入历史与可学习原型生成,因而 SA 在参数化上是长度无关的,并与排序目标联合优化。
因为该投影只用用户侧信号,其定长、目标无关的输出 $\widetilde{X} \in \mathbb{R}^{k \times d}$ 可以物化一次、跨候选与请求复用。这就是「低秩缓存(low-rank caching)」的操作性含义:昂贵的目标条件推理跑在缓存的紧凑长度维表示上,而不是原始超长历史上。
附录 A 进一步澄清了与 Linformer 的关系。Linformer 的做法是把 keys/values 显式投影到低维子空间:
$$K' = E^\top K, \quad V' = F^\top V, \quad E, F \in \mathbb{R}^{n \times k},\ k \ll n \tag{10}$$
$$\mathrm{SelfAttn}(Q,K,V) \approx \mathrm{softmax}\!\left(\frac{Q K'^\top}{\sqrt{d_h}}\right) V' \tag{11}$$
论文列出显式长度维投影在工业推荐里的四条障碍:(i)参数随最大长度 scaling($E,F \in \mathbb{R}^{n\times k}$,$n$ 到 100K 时参数巨大且不灵活);(ii)变长序列需要 padding/截断,带来低效与伪影;(iii)缺乏目标无关的复用——投影表示嵌在注意力流水线里,不天然产出可缓存的 user-only 状态;(iv)与系统目标错配——压缩在这里不只是建模手段,更是系统原语,必须定长、目标无关、复用便宜。
论文自己也很克制:「低秩」是概念透镜而非严格论断,SA 不主张继承 Linformer 对 self-attention 的任何近似保证;SA 不是「推荐版 Linformer」,而是一个扮演类似降维角色但服务于不同系统目的的可缓存长度维压缩机制。
3.3 堆叠精化(Stacked Refinement)¶
单个 SA block 产出 $k \times d$ 的 sketch。为提升容量,论文加了少量带残差的精化步骤。从 $\widetilde{X}^{(0)} = P^{(0)}$ 开始迭代:
$$S^{(\ell)} = \frac{(\widetilde{X}^{(\ell)} W_Q^{(\ell)})(X W_K^{(\ell)})^\top}{\sqrt{d}} \tag{12}$$
$$A^{(\ell)} = \mathrm{softmax}_{\mathrm{proto}}\big(S^{(\ell)}\big), \qquad \sum_{j=1}^{k} A^{(\ell)}_{j,i} = 1 \tag{13}$$
$$\widehat{X}^{(\ell+1)} = A^{(\ell)} X \tag{14}$$
$$\overline{X}^{(\ell+1)} = \mathrm{LN}\big(\widetilde{X}^{(\ell)} + \widehat{X}^{(\ell+1)}\big) \tag{15}$$
$$\widetilde{X}^{(\ell+1)} = \mathrm{LN}\big(\overline{X}^{(\ell+1)} + \mathrm{FFN}(\overline{X}^{(\ell+1)})\big) \tag{16}$$
残差结构稳定优化并保留前一轮的有用信息,FFN 把表达能力推到线性聚合之上。实践中 $N_{\mathrm{sa}} = 2$ 次迭代已足够。
附录 E 的迭代精化视角给了一个有用的类比(论文明确声明只是类比,不主张 SA 精确实现了某个优化算法):一步 SA 可以看成 EM 式的分配–聚合交替——软分配 $A_{j,i} = p(j\mid i)$ 类似 responsibility 更新,聚合 $\widetilde{X} = AX$ 类似原型重估计。这解释了为什么堆叠 SA 能改善 sketch 质量(后层用已编码历史信息的原型去重算分配),也解释了为什么少量迭代就够——用户行为序列高度冗余,SA 的目的不是恢复细粒度 token 级结构,而是构造保留最显著长程信号的紧凑用户级摘要。
3.4 两时间尺度的 STCA 推理¶
近期历史。 用 STCA 直接建模最近 $L_r = 10\text{K}$ 个事件,$X_r \in \mathbb{R}^{L_r \times d}$:
$$\mathbf{z}_r = \mathrm{STCA}_{10k}(\mathbf{x}_t, X_r) \tag{17}$$
超长历史。 在 sketch 侧 STCA 之前,用一个宽度适配器 $W_A$(与分配矩阵 $A$ 不同)把 SA sketch 映射到 STCA 宽度,同时 $\phi_t$ 映射目标表示:
$$\widehat{X} = \widetilde{X} W_A \in \mathbb{R}^{k \times D}, \qquad \widehat{\mathbf{x}}_t = \phi_t(\mathbf{x}_t) \in \mathbb{R}^{D} \tag{18}$$
然后在适配后的 sketch 上做 STCA:
$$\mathbf{z}_u = \mathrm{STCA}_{\mathrm{sketch}}(\widehat{\mathbf{x}}_t, \widehat{X}) \tag{19}$$
因为 $\widehat{X}$ 长度固定为 $k$,一旦 sketch 可用,这条分支的成本与原始序列长度无关。
融合。 近期与超长表示交给下游排序骨干,可以用轻量 MLP、门控融合模块或骨干自带的融合机制与目标及非序列特征结合。Figure 2 展示的部署实例是 MixFormer [16],但 SequenceO1 不依赖特定融合骨干。
3.5 为什么是原型维归一化(附录 C)¶
这是全文最值得记的机制性论证。压缩模块必须是目标无关的:它在看到候选 item 之前就算好、作为 user-only 表示被缓存、然后被许多下游 target 和请求复用。在这个设定下,归一化的选择决定了压缩表示是倾向覆盖整个历史还是只选出一小撮 token。
token 维归一化的问题:它产出 $p(i \mid j)$,每个原型对一个 token 子集做注意力,实际上扮演序列上的选择器。这鼓励 token 之间为每个原型竞争,但不施加任何对全历史的覆盖约束。结果是多个原型可能塌缩到相似的高显著度区域,反复选中同一小撮 token 而忽略其他部分。在目标无关的压缩设定下,这会导致覆盖差:超长历史的大片区域可能在模型有机会判断哪部分对特定 target 重要之前就被欠表示甚至丢弃。
原型维归一化产出 $p(j\mid i)$ 并施加逐 token 的守恒约束 $\sum_{j=1}^{k} A_{j,i} = 1$:每个 token 把自己的质量分配到各原型上,而不是每个原型独立地选择 token。因此每个 token 都对压缩表示贡献质量,原型集体地聚合来自整个历史的信息。
一句话定位:token 维归一化天然适合 target-aware 的选择;原型维归一化天然适合 target-agnostic 的摘要。SA 不是最终推理模块,而是一个可复用的压缩层,其输出后续会被 target-conditioned STCA 消费——先保留覆盖、把选择性匹配推迟到推理阶段。
3.6 Action-side SwiGLU 融合(附录 D)¶
每条历史行为同时含 item 侧与 action 侧信息。Table 2 里的 action-side SwiGLU 融合指的是 sketch 构造前的一个轻量门控融合。给定 item 嵌入 $\mathbf{e}_i$ 与 action 类型嵌入 $\mathbf{a}_i$,融合后的行为嵌入抽象地写作
$$\mathbf{x}_i = \mathbf{e}_i + \mathrm{FFN}_{\mathrm{SwiGLU}}([\mathbf{e}_i; \mathbf{a}_i]) \tag{20}$$
其中 SwiGLU FFN 把拼接后的特征映回 $\mathbf{e}_i$ 的维度使残差加法良定义;生产实现可能还有额外的特征变换。这个融合让同一个历史 item 在 finish / skip / like / follow 等不同反馈下贡献不同。
3.7 误差分解(附录 F)¶
论文给了一个概念性的误差分解,说明 compress-then-reason 的近似误差可拆成两块。设 $F_{\mathrm{full}}(x_t, X)$ 是直接在完整历史上操作的理想目标条件预测器,$F^{\star}_{\mathrm{comp}}(x_t, C(X))$ 是只能访问压缩表示 $C(X)$ 的假设类内最优预测器,本文方法为 $\widehat{F}(x_t, X) = G(x_t, C(X))$。加减 $F^{\star}_{\mathrm{comp}}$ 并用三角不等式:
$$\|F_{\mathrm{full}}(x_t,X) - \widehat{F}(x_t,X)\| \le \underbrace{\|F_{\mathrm{full}}(x_t,X) - F^{\star}_{\mathrm{comp}}(x_t,C(X))\|}_{\text{压缩误差}} + \underbrace{\|F^{\star}_{\mathrm{comp}}(x_t,C(X)) - \widehat{F}(x_t,X)\|}_{\text{推理误差}} \tag{21}$$
第一项由 sketch 质量控制:如果超长历史沿长度维足够可压缩,且 sketch 保留了下游排序需要的显著用户信号,即使 $C(X)$ 定长,这一项也能保持小。第二项由下游容量控制:SequenceO1 用 STCA 同时覆盖近期 10K 后缀与超长 sketch,再做轻量融合来压这一项。整体有效性取决于两项的平衡——sketch 要足够紧凑以支持效率与复用,又要足够信息丰富以让 sketch 上的下游推理仍然高度可预测。
四、系统设计:让 100K 在抖音全流量跑起来¶
指导原则是摊销(amortization):昂贵的超长压缩是 user-only 的,应当算一次、跨候选复用、并尽可能跨邻近请求复用。
4.1 训练侧 local KVCache 与服务侧复用¶
训练时为超长 SA sketch $\widetilde{X}_u \in \mathbb{R}^{k\times d}$ 维护一个本地 key–value cache(local KVCache),因为它目标无关、只依赖用户侧信号。请求特定特征(近期后缀 $X_{u,r}$、候选侧特征)不缓存。论文提到可以顺带缓存在固定模型版本下仍属 user-only 的 sketch 侧线性投影,但复杂度分析中采用保守设定:adapter 输出不缓存。
缓存键 = (user id, model version, history timestamp, sketch configuration);采用 TTL 失效 + 容量淘汰来同时约束内存与陈旧度。
- 训练:MRLB 组内 3 小时 TTL,有效命中率 $p^{\mathrm{train}}_{\mathrm{hit}} \approx 0.5$;
- 服务:同一 cache 接口,1 小时 TTL,经验命中率 $p^{\mathrm{infer}}_{\mathrm{hit}} \approx 0.6$。
共享的 get/put 接口降低了 train/serve skew,同时大幅减少重复的 100K 特征存储、通信与 sketch 计算。报告的 FLOP 缩减就是用这两个观测到的命中率作为工作点。 cache miss 时额外的原始历史计算只有 user-only 的 SA sketching 一步,它仍可被 MRLB 摊销或提前到上游执行。
4.2 多请求用户级批(MRLB)¶
即使有 SA,在 100K token 上构造 $\widetilde{X}_u = \mathrm{SA}(X_u)$ 仍然贵。生产中一个用户往往在短时间窗内发起多次连续请求,而长期历史变化缓慢。MRLB 把同一用户的这些请求分组,超长 sketch 只算一次并复用于组内所有 target:
$$\widetilde{X}_u = \mathrm{SA}(X_u) \in \mathbb{R}^{k \times d} \tag{22}$$
请求特定的组件(近期后缀、候选特征)仍逐请求计算。实践中限制聚合度以保持内存稳定,并在近期历史分支上施加 request-aware masking 防止跨请求泄漏。
4.3 Pipeline Lift¶
精排通常只分到端到端延迟预算的一小部分——召回、粗排、过滤、特征拉取已经吃掉大量时间。常规流水线里,排序侧的序列建模必须等候选集就绪。
由于 $\widetilde{X}_u = \mathrm{SA}(X_u)$ 只依赖用户侧信息,这步计算可以被「提升」到请求入口或其他上游阶段,把 sketch 当作用户特征往下传(Figure 2(d))。cache hit 时,一次常数时间查表就在原始 100K 特征序列被物化与传输之前提供了定长 sketch;cache miss 时,user-only 计算仍可与上游召回并行跑。因此命中把原始长度的特征存储、通信、计算从样本路径上彻底移除,pipeline lift 进一步降低 miss 时的延迟影响。
4.4 FlashSA:SA 的算子融合¶
朴素 SA 实现会物化 $S \in \mathbb{R}^{k\times n}$ 与 $A \in \mathbb{R}^{k\times n}$,在 $n=100\text{K}$ 时带来 $O(kn)$ 的中间存储与沉重访存,再加上 ragged batching 下多次 kernel launch 的低效率。
FlashSA 是一个受 IO-aware 注意力算子 [10, 11] 启发的融合 kernel,把计算流式化:分块计算亲和度、原型维 softmax 统计量(max 与 log-sum-exp)、以及最终聚合到 $\widetilde{X}$,全程不在 HBM 里存完整的 $k\times n$ 分数矩阵。这降低峰值显存、通过更少的 launch 与更好的局部性提升吞吐,并通过数值稳健的 softmax 与累加稳定混合精度执行。
五、算力账:复杂度推导与数值(附录 G)¶
这一节是论文 20 页里最实的部分之一,也是本文「$O(1)$」主张的量化依据。注意:全部是 GEMM 主导的解析 FLOP 计数,不是实测墙钟时间。
计数约定:对 $U \in \mathbb{R}^{m\times r}$、$V \in \mathbb{R}^{r\times p}$,$\mathrm{FLOPs}(UV) \triangleq 2mrp$;忽略 softmax 指数、LayerNorm、bias、masking、激活等低阶逐元素运算。SwiGLU FFN 在 $T$ 个 token、宽度 $w$、中间宽度 $w_f$ 下:
$$\mathrm{FLOPs}_{\mathrm{SwiGLU}}(T; w, w_f) = 6 T w w_f, \qquad w_f = 2w \Rightarrow 12 T w^2 \tag{23}$$
5.1 STCA 的单 query 重排序¶
STCA 每层只有一个 query。标准形式会把所有 $L$ 个 token 投影两次并物化长度为 $L$ 的 $XW_K$、$XW_V$。论文做了重排序:
$$\mathbf{u} = (\mathbf{q}W_Q)W_K^\top \in \mathbb{R}^{1\times D}, \quad \boldsymbol{\alpha} = \mathrm{softmax}\!\left(\frac{\mathbf{u}X^\top}{\sqrt{d_h}}\right) \in \mathbb{R}^{1\times L}, \quad \mathbf{o} = (\boldsymbol{\alpha}X)W_V \tag{24}$$
跨 $h$ 头的每层注意力 FLOPs 为
$$\mathrm{FLOPs}_{\mathrm{attn\text{-}reorder}}(L; D, h) = \underbrace{4LDh}_{\text{长度相关}} + \underbrace{6D^2}_{\text{头投影}} \tag{25}$$
相比朴素路径(长度相关成本约 $4LD^2$),重排序把 $O(LD^2)$ 投影换成 $O(LDh)$ 加权归约,长度相关 FLOPs 降低约 $d_h = D/h$ 倍。
一个重要副作用:重排序避免物化 $L\times d_h$ 的 $(XW_K, XW_V)$,因此不存在可跨请求缓存/共享的目标无关每层 KV 投影——剩下的 $L$-相关项($\mathbf{u}X^\top$ 与 $\boldsymbol{\alpha}X$)都依赖 query,天然是 per-target 的。
加上输出投影 $W_O$($2D^2$)与单 token query 侧 SwiGLU FFN($12D^2$),每层每 target:
$$\mathrm{FLOPs}_{\mathrm{STCA\text{-}layer}}(L; D, h) = 4LDh + 20D^2 \tag{26}$$
每层还含一个作用在全部 $L$ 个历史 token 上的历史侧预处理 SwiGLU FFN(目标无关的历史变换,中间宽度 $2D$):
$$\mathrm{FLOPs}_{\mathrm{hist\text{-}FFN}}(L; D) = 12 L D^2 \tag{27}$$
总的每 target STCA FLOPs:
$$\mathrm{FLOPs}_{\mathrm{STCA}}(L; N_{\mathrm{stca}}, D, h) = N_{\mathrm{stca}}\big(12LD^2 + 4LDh + 20D^2\big) \tag{28}$$
5.2 SA 的 FLOPs¶
单头 SA,宽度 $d$,原型数(sketch 长度)$L_s$:
$$\mathrm{FLOPs}_{\mathrm{SA\text{-}layer}}(L, L_s; d) = \underbrace{2Ld^2}_{K=XW_K} + \underbrace{2L_sd^2}_{Q=PW_Q} + \underbrace{2L_sLd}_{S=QK^\top} + \underbrace{2L_sLd}_{\widetilde X = AX} + \underbrace{12L_sd^2}_{\text{sketch FFN}} = 2Ld^2 + 14L_sd^2 + 4L_sLd \tag{29}$$
$$\mathrm{FLOPs}_{\mathrm{SA}}(L; N_{\mathrm{sa}}, L_s, d) = N_{\mathrm{sa}} \cdot \mathrm{FLOPs}_{\mathrm{SA\text{-}layer}}(L, L_s; d) \tag{30}$$
两者都是 $O(L)$,但行为完全不同:SA 的主导项是 $4L_sLd$,斜率由定长 sketch 长度 $L_s$ 与更小的 SA 宽度 $d$ 控制;STCA 的主导项是 $12LD^2$ 与 $4LDh$,大宽度 $D$ 同时出现在历史侧变换与 query 侧变换里。这就是 compress-then-reason 的设计意图:把长历史处理压进一个轻量、高度可复用的阶段(SA),把重容量集中在需要精细匹配的目标条件交互(STCA)。
5.3 命中/未命中与 MRLB 摊销¶
adapter:$\mathrm{FLOPs}_{\mathrm{adapt}}(L_s; d, D) = 2L_s d D$。
$$\mathrm{FLOPs}_{\mathrm{hit}} = \mathrm{FLOPs}_{\mathrm{adapt}} + \mathrm{FLOPs}_{\mathrm{STCA}}(L_s), \qquad \mathrm{FLOPs}_{\mathrm{miss}}(L) = \mathrm{FLOPs}_{\mathrm{SA}}(L) + \mathrm{FLOPs}_{\mathrm{hit}} \tag{31}$$
$$\mathbb{E}[\mathrm{FLOPs}](L; p_{\mathrm{hit}}) = \mathrm{FLOPs}_{\mathrm{hit}} + (1 - p_{\mathrm{hit}}) \cdot \mathrm{FLOPs}_{\mathrm{SA}}(L; N_{\mathrm{sa}}, L_s, d) \tag{32}$$
MRLB 下($R$ 为组内共享同一份用户侧计算的 target 实例数),STCA 只有每层历史侧 pre-FFN 可摊销:
$$\mathrm{FLOPs}^{\mathrm{MRLB}}_{\mathrm{STCA}}(L; R) = \frac{12 N_{\mathrm{stca}} L D^2}{R} + N_{\mathrm{stca}}\big(4LDh + 20D^2\big) \tag{33}$$
而 SequenceO1 可以把整个 SA 阶段与 adapter 都摊销掉:
$$\mathbb{E}\big[\mathrm{FLOPs}^{\mathrm{MRLB}}_{\mathrm{SeqO1}}\big](L; R, p_{\mathrm{hit}}) = N_{\mathrm{stca}}(4L_sDh + 20D^2) + \frac{\mathrm{FLOPs}_{\mathrm{adapt}} + 12N_{\mathrm{stca}}L_sD^2 + (1-p_{\mathrm{hit}})\mathrm{FLOPs}_{\mathrm{SA}}(L)}{R} \tag{34}$$
cache-hit 敏感性:MRLB 下 miss 惩罚被 $R$ 进一步摊薄,
$$\mathrm{FLOPs}^{\mathrm{MRLB}}_{\mathrm{miss}}(L;R) - \mathrm{FLOPs}^{\mathrm{MRLB}}_{\mathrm{hit}}(R) = \frac{\mathrm{FLOPs}_{\mathrm{SA}}(L; N_{\mathrm{sa}}, L_s, d)}{R} \tag{35}$$
$$\Delta\mathrm{FLOPs}^{\mathrm{MRLB}} = (p_1 - p_2)\frac{\mathrm{FLOPs}_{\mathrm{SA}}(L)}{R} \tag{36}$$
论文的结论是:命中率下降只会平滑地削弱摊销收益,不会把 SequenceO1 退化回「在原始 100K 历史上做目标条件推理」——因为无论命中与否,重量级的 STCA 分支永远跑在定长 $L_s$ 上。
5.4 数值实例化与三个 FLOP 比值¶
超参:SA 宽度 $d = 128$、单头、$N_{\mathrm{sa}} = 2$、$L_s = 1024$;STCA $h = 16$、$d_h = 64$、$D = 1024$、$N_{\mathrm{stca}} = 4$;$p^{\mathrm{train}}_{\mathrm{hit}} = 0.5$、$p^{\mathrm{infer}}_{\mathrm{hit}} = 0.6$;$R_{\mathrm{train}} = 40$、$R_{\mathrm{infer}} = 300$。
| 设定 | 直接 STCA | SequenceO1 | 比值 |
|---|---|---|---|
| 无 MRLB($L=100\text{K}$,$p_{\mathrm{hit}}=0.5$) | 5059.46 GFLOPs/target | 108.10 GFLOPs/target | 46.80× |
| 训练 + MRLB($R=40$,$p=0.5$) | 152.13 GFLOPs/target | 3.046 GFLOPs/target | 49.94× |
| 推理 + 跨请求复用($R=300$,$p=0.6$) | 43.076 GFLOPs/target | 0.67419 GFLOPs/target | 63.89× |
(我按论文式 (28)(30)(33)(34) 独立复算过这四组数:5059.4 / 108.09 / 152.13 / 3.046 / 43.08 / 0.674,与论文完全吻合;其中 3.046 只有在 adapter 也被 MRLB 摊销时才成立,这与正文「组内 adapted sketch 物化一次并复用」的表述一致。)
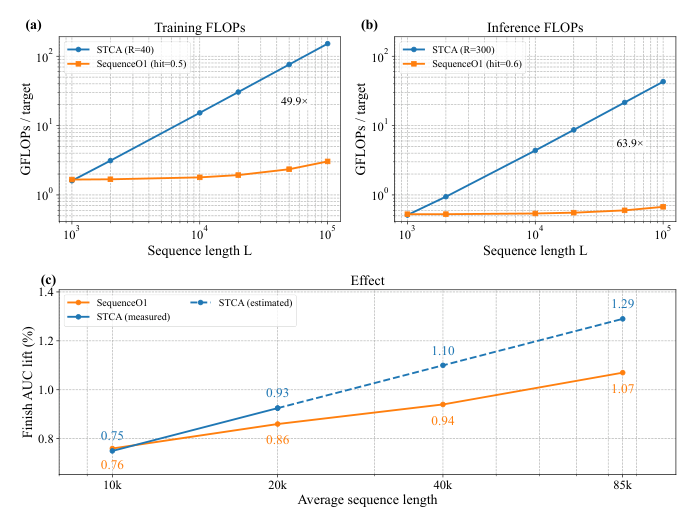
重要边界条件:这套 FLOP 分析只涵盖超长分支。近期 10K STCA 分支、dense ranker 计算、输入 embedding 与 action 特征预处理、最终两分支融合——在两个方案里都被略去。同时论文声明该分析对系统收益是保守的:它没有计入 cache 命中时同样被绕过的原始长度特征物化、存储与通信。
六、实验设置¶
论文报告两套离线评估设定:
- 轻量消融设定:简化 dense 组件以便高效实验,基线是 STCA(512),主看 Finish AUC。SA-vs-vanilla 诊断额外报告多任务 UAUC。
- 生产离线评估与线上 A/B:用完整生产排序器,基线是 STCA 10K + lifelong TWIN V2;SequenceO1 移除 TWIN V2,换成端到端 100K sketch 分支。
第 2 套是很严格的对比:SequenceO1 必须在吸收掉被移除模块的长期信号的同时改善排序。
七、主要实验结果¶
7.1 SA vs Vanilla Attention(Table 1)¶
保持同样的 STCA(512) 排序设置,只替换超长压缩分支里的归一化机制。
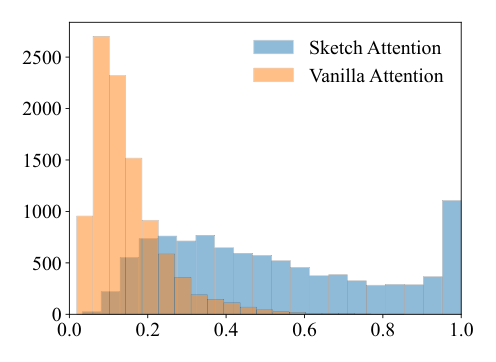
Table 1:100K 设定下 SA 相对 vanilla attention 的 UAUC 提升
| Task | like | follow | clicmmt | comment | share | finish |
|---|---|---|---|---|---|---|
| ΔUAUC | +0.10% | +0.20% | +0.09% | +0.19% | +0.14% | +0.01% |
论文对 Figure 3 的解读非常克制,值得照抄这份克制:因为原型维与 token 维归一化作用在不同的轴上,这些最大值不是标定过的置信度分数,不应被当作原型专门化的直接证据;Figure 3 只是在各自守恒约束下报告原始分布的描述性诊断,直方图之间的偏移同时反映了诱导的分配行为与不同的归一化域大小。附录 C.1 进一步声明:在原型维归一化内部,更大的最大值对应更集中的 token-to-prototype 分配,但这本身不保证多样覆盖或更少的原型重叠。
任务层的证据来自 Table 1:原型维归一化在多个互动目标上改进 UAUC。这些分配模式可能为未来的 sketch-to-behavior 检索或对某子集原型关联的行为组做局部精化提供接口,但这些扩展在本工作中都未被评估。
我的批注:Table 1 里 finish 的 ΔUAUC 只有 +0.01%,是六个任务中最低的,基本等同噪声——而全文的消融主指标恰恰是 Finish AUC,线上 A/B 的头条指标也是 Finish。这构成一个不可忽视的张力:论文核心机制(原型维归一化)在 Finish 这个最重要的目标上的直接证据是最弱的。详见第十节复核一。
7.2 SA 架构消融(Table 2)¶
Table 2:100K 消融设定下的 SA 架构消融。最终 SA 设置相对 STCA(512) 达到 +1.07% Finish AUC;所有数字都是相对最终 SA 设置的变化。
| Variant | Change vs. final SA | 换算绝对增益(vs STCA(512)) |
|---|---|---|
| Final SA($k$=1K, $N_{\mathrm{sa}}$=2, $d$=128) | 0.00% | +1.07% |
| $k$: 1K→512 | -0.04% | +1.03% |
| $k$: 1K→2K | +0.03% | +1.10% |
| $N_{\mathrm{sa}}$: 2→3 | +0.02% | +1.09% |
| $d$: 128→64 | -0.10% | +0.97% |
| w/o action-side SwiGLU fusion | -0.20% | +0.87% |
| w/o per-layer Add&Norm + SwiGLU FFN | -0.10% | +0.97% |
结论分析:把原型数增到 2K 或层数增到 3 只带来 +0.03% / +0.02%,论文明确表示把这些当作成本-质量指引而非独立的显著性证据,因此保留更小的生产配置。降低宽度或去掉精化都会退化;其中 -0.20% 来自去掉 action-side 融合,凸显 action-aware sketching 的价值——这与附录 D 的动机一致:同一个 item 在 finish / skip / like / follow 下应当贡献不同。
7.3 100K 压缩方法对比(Table 3)——全文最有说服力的一张表¶
Table 3:同一 1K × 128 预算下把 100K 历史压成紧凑表示的各种方法,报告相对 STCA(512) 基座的 Finish AUC 提升。
| Compression method | Gain vs. STCA(512) |
|---|---|
| Base (STCA(512)) | 0.00% |
| SA (final) | +1.07% |
| TWIN V2 KMeans Clustering [37] | +0.30% |
| Chunk mean pooling | +0.46% |
| Position-bucket queries(每桶约 100 个行为) | +0.72% |
| Recent-behavior query init.(LONGER [2]) | +0.78% |
| Lightning-Attention comp.(MiniMax-01 [28]) | +0.83% |
| SA 的最弱退化变体(w/o action fusion,Table 2 换算) | +0.87% |
结论分析:这张表是回答「收益是不是仅仅来自加了一条新分支/更多参数」的关键——所有方法都在同一个 1K×128 的表示预算下,因此 SA 的胜出说明收益来自压缩质量而非表示容量。论文还给了一条有意思的解读:SA 对 position bucket 的优势暗示推荐历史比语言更缺乏局部结构,因为相关行为可能相隔很远——这也解释了为什么 chunk mean pooling(+0.46%)和 position bucket(+0.72%)这类依赖局部性/位置先验的压缩明显吃亏。
同样值得注意的是:TWIN V2 式的 KMeans 聚类在这个预算下只有 +0.30%,是所有方法里最弱的,这为「用端到端 sketch 替换线上 TWIN V2」提供了机制层的理由。
7.4 生产离线:抖音全量数据集(Table 4)¶
Table 4:抖音数据集上完整生产设定的离线提升。基线是生产 STCA 10K + lifelong TWIN V2;SequenceO1 移除 TWIN V2、改用端到端 100K sketch 分支。
| Metric | Finish | Skip | Head | Like | Follow | Comment | Clicmmt | Share | Favourite | Dislike |
|---|---|---|---|---|---|---|---|---|---|---|
| ΔAUC | +0.29% | +0.23% | +0.18% | +0.09% | +0.05% | +0.04% | +0.16% | +0.18% | +0.30% | +1.29% |
| ΔUAUC | +0.40% | +0.43% | +0.46% | +0.72% | +0.58% | +0.43% | +0.61% | +0.94% | +1.47% | +3.63% |
结论分析:SequenceO1 在移除 TWIN V2 的前提下改善了每一个评估目标,说明 100K 分支成功地替代了两阶段 lifelong 模块并在完整排序器里进一步提升所有指标。UAUC 增益在偏好敏感目标(Like、Share、Favourite、Dislike)上最强,核心消费目标(Finish、Skip)也提升,表明比原先基于聚类的流水线做到了更有效的长期个性化。
Dislike 的 +1.29% AUC / +3.63% UAUC 是明显的离群值(其他 AUC 都在 +0.04%~+0.30%)。合理解释是 Dislike 是极稀疏标签、方差大;但它与线上 Dislike 下降 6~7% 方向一致,交叉印证还算可信。
7.5 线上 A/B:抖音 + 抖音极速版,一个月(Table 5)¶
SequenceO1 在抖音与抖音极速版上部署了一个月,把生产 STCA 10K 基线里的 lifelong TWIN V2 模块替换为端到端 100K sketch 分支。
Table 5:相对生产 STCA 10K + TWIN V2 基线的线上 A/B 结果(论文声明全部统计显著)。
| 抖音 30-Day Act.↑ | Duration↑ | Finish↑ | Comment↑ | Like↑ | Dislike↓ | 极速版 30-Day Act.↑ | Duration↑ | Finish↑ | Comment↑ | Like↑ | Dislike↓ | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Overall | +0.1968% | +1.4999% | +2.3256% | +3.5910% | +2.3617% | -6.9829% | +0.2335% | +1.6655% | +3.4872% | +8.6132% | +2.9399% | -5.9972% |
| Low-active | +0.5484% | +2.1476% | +3.2040% | +2.9099% | +3.5739% | -8.3061% | +0.6614% | +1.9989% | +3.9845% | +13.4620% | +6.1890% | -2.4977% |
| Middle-active | +0.5235% | +2.2408% | +3.1550% | +5.1155% | +3.0477% | -12.1796% | +0.4306% | +1.8468% | +3.0968% | +8.7780% | +0.0254% | -3.6990% |
| High-active | +0.1789% | +1.6334% | +2.4733% | +3.5232% | +2.1611% | -5.7208% | +0.3090% | +1.8161% | +3.4367% | +8.3048% | +3.2317% | -3.1752% |
| Full-active | +0.0622% | +1.2705% | +2.0744% | +3.1494% | +2.1376% | -7.8567% | +0.0853% | +1.5254% | +3.2774% | +7.5138% | +2.7786% | -6.5438% |
结论分析:Activeness、Duration、Finish、Comment、Like 全部显著提升,Dislike 在两个 App 上都下降。Finish 在抖音 +2.33%、极速版 +3.49%,指向更好的持续消费。收益在各活跃度分段上都稳定:低活用户在活跃度与时长上提升最大,暗示存在再激活(re-engagement)效应;高活用户则在 Finish 与 Like 上提升。论文的总结是:模型用稳定的长期偏好补充了短期信号,且这一结论跨平台、跨人群成立。
7.6 与两阶段迁移的关系,以及 100K 的边际收益(§5.5 + Figure 1(c))¶
论文把自己与两阶段表征迁移路线做了定位对比:LLaTTE [46] 报告上游用户建模到下游排序的收益迁移比 50%–53%;SOLARIS [25] 在 Instagram 与 Facebook 产品上报告约 42% 与 44%。论文诚实地声明:这些结果来自不同系统,只能用来给迁移效率提供语境,不构成 apples-to-apples 对比;自己的同系统证据来自「用端到端 100K sketch 分支替换生产 TWIN V2」。
Figure 1(c) 给出消融设定下 Finish AUC 相对 STCA(512) 的提升 vs 平均序列长度:
| 平均序列长度 | 10k | 20k | 40k | 85k |
|---|---|---|---|---|
| SequenceO1(全部实测) | 0.76 | 0.86 | 0.94 | 1.07 |
| 直接 scaling 的 STCA | 0.75(实测) | 0.93(实测) | 1.10(估计) | 1.29(估计) |
于是「在 100K 截断(平均 85K)下 SequenceO1 保留了直接 scaling STCA 收益的 83%(+1.07% vs +1.29%)」。论文由此主张:它把序列长度 scaling 翻译成了排序收益,同时保留了可缓存路径;与两阶段迁移不同,它更简单的 sketch 仍与最终排序器联合优化,而不是变成一个固定的外部特征。
关键读图注记(重要):Figure 1(c) 的图例明确区分 STCA (measured) 与 STCA (estimated)——STCA 只在 10k 与 20k 两点实测,40k 与 85k 是虚线外推。也就是说,「保留 83%」这个头条数字是「实测的 SequenceO1」对「外推的 STCA」,直接 STCA 在 100K 上从未被真正跑出来过。这在工程上完全可以理解(跑不动正是本文的出发点),但它意味着这个比值不是测量值。详见第十节复核四。
八、核心贡献总结¶
- 把 100K 问题重新定义为系统问题。论文最有价值的判断不是某个算子,而是「在 100K 尺度上瓶颈是存储 + 通信 + 计算三者,而不只是注意力复杂度」,以及由此推出的设计约束:压缩必须是定长、目标无关、可缓存的系统原语,而不只是建模技巧。
- 原型维 softmax 这一个改动。把归一化轴从 token 换到 prototype,就把「注意力选择器」变成「token 到原型的质量分配」,从而天然获得目标无关的历史覆盖。这是一个改动极小、动机极清晰的机制设计。
- Cache-first 的训练/服务对称设计。训练侧 local KVCache 与服务侧用同一套 get/put 接口,直接降低 train/serve skew——这在工业系统里是很实的一条。
- 完整的解析算力账。附录 G 把每个 GEMM 都数清楚,并给出 46.80× / 49.94× / 63.89× 三个可复现的比值;重排序导致「STCA 无可跨请求共享的 KV」这一观察也很有价值。
- 严格的替换式验证:不是「加一条新分支」,而是移除线上 TWIN V2 再打赢,这比常见的加法式消融强得多。
九、与已归档相关工作的对比¶
ReST ReST: From Language to Behavior — Scaling Sequence Transformers(ByteDance,2026-09-01)¶
关系:独立并发(本文未引用 ReST,两者殊途同归;且同为字节,仅早 7 天)· 已加载对方精读
- 共同关注的问题:两篇论文识别出同一个 root cause——ReST 称之为「算力不对称(Computation Asymmetry)」:一次排序请求把一份用户历史与 $N$ 个候选配对;序列侧算力可以跨候选摊销,而目标条件交互必须逐候选实例化。SequenceO1 用几乎相同的措辞描述 STCA 的困境:「target-conditioned cross attention 是 query-dependent 的,跨候选几乎没有可复用计算」。两者都得出「必须先打破这种对称性,才能在生产延迟预算下 scaling 序列」。
- 相近的技术骨架:ReST 把计算分解为跑一次的重编码器 $T$ + 逐候选的轻量 cross decoder $C$,每请求计算从 $N\cdot\mathrm{FLOPs}(T) + N\cdot\mathrm{FLOPs}(C)$ 降到 $\mathrm{FLOPs}(T) + N\cdot\mathrm{FLOPs}(C)$;SequenceO1 把计算分解为跑一次的 user-only SA sketch + 逐候选的 STCA,并靠 MRLB 把 SA 摊到 $R$ 个 target 上。两张方法流程图可以抽象重合。系统侧更是几乎同构:ReST 的 User-Level Shared-Prefix Training(同一用户样本在并集序列上只跑一次编码器,配 prefix-valid causal mask,5.8× 训练吞吐) 与 SequenceO1 的 MRLB(同一用户的连续请求分组,sketch 只算一次,配 request-aware masking 防跨请求泄漏,$R_{\mathrm{train}}=40$) 是同一件事的两种实现;ReST 的 Shared-Prefix Serving(每请求算一次 memory,最高 20× 单请求序列推理成本下降) 对应 SequenceO1 的服务侧 sketch 复用($R_{\mathrm{infer}}=300$)。
- 本文的差异与推进:(i)共享状态的形态不同。ReST 共享的是长度为 $|S_u|$ 的编码器 memory $\mathbf{H}$,其大小仍随历史长度增长,因此只能在「一个请求内 / 一个训练组内」共享,无法跨请求持久化;SequenceO1 共享的是定长 $k\times d$ 的 sketch,大小与 $n$ 无关,因此能进持久化 cache、跨请求跨小时复用。这正是 SequenceO1 能上 100K 而 ReST 停在常规长度的根本原因。(ii)ReST 把重容量放在编码器侧并靠辅助监督喂饱它(sequence starvation、CVR 辅助头把编码器梯度范数从 2.35 拉到 8.50、SigLIP 式对齐损失);SequenceO1 反过来,刻意把 SA 做轻(单头、$d$=128),把重容量留给 STCA($D$=1024、16 头),并且完全没有讨论序列侧监督不足的问题。(iii)ReST 有 rec-native 的架构改造(Dual-Gated Attention、RoPE+RoTE、SRN),SequenceO1 在行为噪声与不规则时间上没有任何机制——100K 历史里这两个问题只会更严重。
- 可比的方法/实验差异:ReST 一周 A/B、AUC +1.31%、核心营收 +11.93%、50ms P99 预算内;SequenceO1 一个月 A/B、Finish +2.33%/+3.49%、但全文没有任何延迟或吞吐的实测数字。两篇都是字节、都在 2026 年 9 月首周投出、都攻击算力不对称,互不引用,是本次归档中最典型的「同公司独立并发」。
ROCS ROCS: Request-Oriented Compute Sharing(Meta AI,2026-07-30)¶
关系:独立并发(本文未引用 ROCS)· 已加载对方精读
- 共同关注的问题:ROCS 把同一件事抽象到了更高的层次——它把「request 侧输出不得依赖 candidate」写成一条算子级、可组合的依赖契约(Generalized Layer Masking),并把 request 级算力冗余识别为「推荐模型架构」与「request-to-candidate 执行模式」之间的结构性错配。SequenceO1 的 SA 恰恰是这条契约在超长序列分支上的一个具体实例:「压缩只依赖用户侧信号」= GLM 的 request-only 通路。
- 相近的技术骨架:ROCS 的 Deep Cross Attention (DCA) 与 SequenceO1 的两分支设计几乎是同一张图——DCA 用共享序列编码($S_i = \mathrm{Enc}_i(S_{i-1})$,因为序列流排除 candidate 输入,每个 $S_i$ 及其 K/V 投影只需每请求算一次)+ 逐层 candidate-conditioned cross-attention 检索;SequenceO1 用 user-only SA sketch(每用户算一次)+ target-conditioned STCA 检索。连算子级优化都对应:ROCS 的 In-Kernel Broadcast Optimization(在 GEMM epilogue 与专用 FlashAttention kernel 里解析 request→candidate 索引映射,从不物化 broadcast,LCB kernel 延迟 -75.2%,attention 0.55ms→0.23ms)对应 SequenceO1 的 FlashSA(分块流式化,不在 HBM 里物化 $k\times n$ 分数矩阵)。
- 本文的差异与推进:(i)共享单元不同。ROCS 的复用粒度是 request 级(一次请求内跨 $N$ 个候选),SequenceO1 更进一步做到 user 级跨请求跨小时(TTL 1h/3h 的持久 cache)——因为 sketch 是定长且不依赖请求上下文的。反过来 ROCS 的契约覆盖整个网络的所有算子(MLP、特征压缩层、显式特征交互),而 SequenceO1 只把超长分支做成 user-only,近期 10K 分支与 dense 侧仍逐请求算。(ii)ROCS 显式处理了 SequenceO1 回避的一个问题:ROCSify 在固定容量下不必然保持表达力(常规层可以把全部容量给 candidate-dependent 表示),因此需要 Request-Oriented Resource Reallocation 把省下的算力再投资回 request 侧。SequenceO1 面临完全同构的取舍——把 100K 压成 1K×128 的目标无关 sketch 必然损失 target-aware 的选择能力(Figure 1(c) 里那 17% 的差距就是代价)——但论文没有提出对应的再投资机制,只是把 $k$ 从 1K 加到 2K(收益 +0.03%,等于告诉我们这条路已经饱和)。
- 可比的方法/实验差异:ROCS 在 KuaiVideo X1/KKBox/KuaiRand X1 公开集上以等摊销预算打赢 DCNv2/FinalMLP/Wukong,并在 Meta 数十个生产模型上把 replay QPS 提升 47–196%、容量节省 29–38%——全部是实测吞吐。SequenceO1 的 46.8×/49.9×/63.9× 全部是解析 FLOPs,没有任何 QPS/延迟测量。这是两篇工程质量上最大的差距。
AMBER AMBER: An Event is Worth One Token(AI at Meta,2026-08-26)¶
关系:独立并发(本文未引用 AMBER)· 已加载对方精读
- 共同关注的问题:AMBER 的核心论断是——限制工业推荐的不是模型容量,而是服务侧的特征物化成本,正是它逼着历史退化成 Semantic ID 或手挑特征子集。SequenceO1 的开篇判断(「在 100K 尺度上瓶颈是特征存储、通信、计算,而不是注意力复杂度」)与之高度同构。两者也都用「把用户侧表示预先算好并缓存,把它与实时服务算力解耦」作为答案。
- 相近的技术骨架:都是「压缩 → 缓存 → 下游消费」。AMBER 用一个共享的双向 Transformer Event Tokenizer 把每个事件的数百个异构特征压成 1 个 Event Token(排序 2 个、检索 1 个);SequenceO1 用 SA 把整段 100K 历史压成 $k$=1024 个 sketch token。
- 缓存语义上的根本差异(本次最值得记的一条):
- 粒度与失效:AMBER 的 token 是逐事件、history-independent 的——曝光发生时触发、算一次、append 到 feature store 里该用户的序列。新行为到来只是追加一个新 token,已缓存的所有 token 全部保持有效。SequenceO1 的 sketch 是整段历史的函数,缓存键含
history timestamp,因此任何一条新行为原则上都让整份 sketch 失效;论文的实际做法是用 TTL(服务 1h / 训练 3h)容忍陈旧,并把新鲜度需求整个甩给不缓存的近期 10K STCA 分支。换句话说:AMBER 的缓存是增量可组合的,SequenceO1 的缓存是整体性的、只能靠 TTL 与「近期分支兜底」这两条来管理陈旧度,论文全篇没有任何增量 sketch 更新机制(层次化/多分辨率 sketch 只在结论里作为未来方向提了一句)。 - 模型版本更新:SequenceO1 把
model version放进缓存键——意味着每次模型推版,全量 cache 冷启,$p_{\mathrm{hit}}$ 会掉到 0,论文对这个代价只字未提。AMBER 正面处理了同一问题:它把这称为表征漂移,用梯度反转层 + 判别器的对抗正则($\lambda \approx 5\times10^{-3}$,更大的 $\lambda$ 会产生「骗过判别器却没真正减少漂移」的退化表征)、EMA 编码器作为稳定参照系、以及分片周期重训(用户随机分 $N$ 片,每天只重训一片)来让旧缓存 token 跨重训仍然兼容。用 checkpoint 可分性(k-NN 准确率,0.5 = 完全不可区分)来度量漂移这个做法尤其值得借鉴。 -
存储压缩:AMBER 用 Matryoshka Dropout(单次前传内的结构化后缀 dropout)+ QAT(训练暴露 INT8 噪声、服务下发 INT4,8× 存储缩减保留约 80% 效果)来压缓存体积;SequenceO1 对 sketch 的存储量级、精度、cache 容量与淘汰策略完全没有量化说明(只说「TTL + 容量淘汰」)。$k\times d = 1024\times128$ 若按 fp16 即约 256 KB/用户,在十亿用户量级上是个不小的数字,论文没有讨论。
-
本文的差异与推进:SequenceO1 的 sketch 与最终排序器端到端联合优化(这是它相对 AMBER 的真实优势——AMBER 的 Event Token 是冻结后作为即插即用序列特征喂给下游的),也不需要 LLM。反过来 AMBER 的表征是跨模型、跨任务通用的(排序与检索共用),SequenceO1 的 sketch 与具体排序器强耦合,换骨干就要重训重刷缓存。
说明:本节按 skill 规则最终只保留 3 篇。同公司未引用的情况在库里还有两例值得一并点名:TM20K TM20K(ByteDance,2026-08-07,20K 序列,teacher 保全 token 并缓存 logits、student 用零参数规则化 token merge 压到 1.8K)与 IAT IAT(ByteDance,2026-04-10,把历史训练实例压成 embedding 当 token 的两阶段框架)——两者都是字节自家的超长序列压缩工作、都早于本文、都未被引用。它们没有进正式对比章节是因为解法路径实质偏离:TM20K 靠蒸馏 + 规则化 token merge(缓存的是 teacher logits,一次性离线产物,不是可跨请求复用的用户状态),IAT 靠两阶段离线压缩且 root cause 是「手工特征的信息瓶颈」而非「系统复用」,都落进 skill 里「问题相似但解法差异大」的反例。
十、讨论与局限性¶
10.1 值得借鉴的设计¶
- 「归一化轴」本身可以是一个设计变量。原型维 vs token 维只是 softmax 的一个 axis 参数,却直接决定了压缩表示是「覆盖式摘要」还是「选择式检索」,进而决定它能否目标无关地被复用。这个 insight 迁移性很强。
- 让训练与服务共用同一套 cache get/put 接口来降低 train/serve skew。
- Pipeline lift:只要一个计算是 user-only 的,它就可以被提到请求入口、与召回并行,从而把 miss 的延迟藏起来。这是「目标无关」这一性质的第二重红利(第一重是可缓存)。
- 附录 G 式的解析算力账:把每个 GEMM 数清楚、给出闭式、再代入生产观测到的 $p_{\mathrm{hit}}$ 与 $R$,是一种可复现、可审计的成本论证方式。
10.2 复核一:「退化变体仍高于最强外部基线」是否属实¶
结论:算术上属实,但这个 4 个基点的差距不足以承重;真正站得住的是另一个数字。
- 逐条核算:Table 2 的所有退化变体换算成绝对增益分别是 +1.03 / +1.10 / +1.09 / +0.97 / +0.87 / +0.97,最弱的是「w/o action-side SwiGLU fusion」的 +0.87%;Table 3 里最强的外部/替代压缩法是 Lightning-Attention 的 +0.83%。两表同为 100K 轻量消融设定、同为 STCA(512) 基座、同为 Finish AUC,因此可比。0.87 > 0.83 成立。
- 但这个论证不稳:差距只有 0.04 个百分点,而论文自己在 Table 2 的正文里明确说 +0.03% / +0.02% 这个量级「应被当作成本-质量指引而非独立的显著性证据」。0.04 落在同一个量级里,用论文自己的标准就不该被当作显著差异。
- 更严重的一点:Table 2 里唯一被剥掉的是 action-side 融合——那是一个输入侧的特征处理技巧,不是本文的核心机制。真正的「退化变体」应当是「SA 但换回 token 维归一化」,而这一行在 Table 3 里根本不存在。核心机制的直接证据只有 Table 1 的 ΔUAUC,其中 Finish 仅 +0.01%——恰恰是消融主指标与线上头条指标所在的目标。另外论文也没有报告任何组合式消融(同时去掉 action 融合与 Add&Norm+FFN),无法排除「多个组件同时退化后跌破 +0.83」。
- 不过评分 agent 的整体判断仍然成立,只是应该换一个支点:本文没有落进「引入新信号 ≠ 收益来源」这个陷阱,决定性证据是 Table 3 本身——五种外部/替代压缩法在完全相同的 1K×128 表示预算下与 SA 对打,SA 以 +1.07% vs 最强的 +0.83%(0.24 个百分点,是退化变体那个 0.04 的六倍)胜出。这足以证明收益来自压缩质量而非「多了一条分支 / 多了参数」。这与近期 PTDG / UniCon / MORE 三篇「退化变体跑不过外部基线」的情形确实相反——但准确的表述应当是「SA 完整版明显优于同预算外部基线」,而不是「即便砍掉一个组件也仍高于」。
10.3 复核二:10 万序列的算力账、缓存失效、与 AMBER 的缓存语义差异¶
(a)降到什么量级、是实测还是推算?
- 全部是推算,且是解析 FLOP 计数(GEMM-only,忽略 softmax/LN/bias/激活),不是墙钟时间、不是吞吐、不是延迟。我按论文公式独立复算过全部六个数值(5059.4 / 108.09 → 46.80×;152.13 / 3.046 → 49.94×;43.08 / 0.674 → 63.89×),与论文完全一致,推导本身没有算术错误。
- 输入是实测的:$p^{\mathrm{train}}_{\mathrm{hit}}\approx 0.5$、$p^{\mathrm{infer}}_{\mathrm{hit}}\approx 0.6$、$R_{\mathrm{train}}=40$、$R_{\mathrm{infer}}=300$ 都被描述为生产观测到的工作点。所以准确的说法是:在实测的缓存命中率与复用率工作点上,做出的解析算力推算。
- 绝对量级:服务侧超长分支从 43.08 降到 0.674 GFLOPs/target。
- 一条重要的自证边界:这个比值只覆盖超长分支,近期 10K STCA 分支、dense ranker、embedding 预处理、两分支融合都被从两边同时剔除。我用论文自己的式 (33) 代入 $L=10\text{K}$、$R=300$ 估算:近期 10K 分支约 4.38 GFLOPs/target——约为优化后超长分支(0.674)的 6.5 倍。也就是说,SequenceO1 成功之后,序列侧的成本瓶颈已经转移到那条不可缓存的近期 10K 分支上了,而论文对此完全没有讨论,也没有给出端到端的服务成本或延迟数字。对一篇以「让 100K 在生产可行」为唯一卖点的系统论文来说,零延迟测量、零吞吐测量、零 GPU 数量是最大的实证缺口。
(b)失效/更新策略:用户新行为来了怎么办?
- 缓存键 = (user id, model version, history timestamp, sketch configuration),策略是 TTL 失效 + 容量淘汰:训练 3h TTL、服务 1h TTL。
- 没有任何增量更新机制。sketch 是整段历史的函数($\widetilde X = AX$ 对全部 $n$ 个 token 做加权聚合),新行为到来时要么等 TTL 过期后全量重算 SA,要么被
history timestamp变化直接判失效。论文把「层次化 / 多分辨率 sketch」与「跨用户自适应容量」列为未来方向,但没有把「增量更新」列为方向。 - 新鲜度实际上由架构而非缓存来保证:近期 10K 后缀分支是逐请求计算、从不缓存的。所以设计意图很清楚——长期偏好允许陈旧 1 小时,短期兴趣由未缓存的 10K 分支实时覆盖。这是一个合理但未被显式论证的假设:论文没有做过「TTL 从 1h 拉到 6h/24h 会掉多少 AUC」的敏感性实验,只给了 FLOPs 对 $p_{\mathrm{hit}}$ 的线性敏感性(式 35–36),质量对陈旧度的敏感性完全空白。
- 模型版本进缓存键意味着每次模型推版全量 cache 冷启($p_{\mathrm{hit}}\to 0$),在日更/小时更的工业排序器上这不是小事,论文只字未提。
(c)与 AMBER 的缓存语义差异:见第九节 AMBER 子节,核心三点是——增量可组合 vs 整体失效(AMBER 追加一个 token,SequenceO1 整份 sketch 作废)、跨模型版本兼容 vs 版本进 key 冷启(AMBER 用对抗正则 + EMA + 分片重训主动维护旧 token 兼容性,SequenceO1 靠冷启)、量化后的存储账 vs 无存储账(AMBER INT4 + Matryoshka Dropout 有明确 8× 压缩数字,SequenceO1 对 ~256 KB/用户 的 sketch 存储无任何讨论)。
10.4 复核三:线上 A/B 的口径¶
对照组:明确且很强——生产 STCA 10K + lifelong TWIN V2,而实验组是移除 TWIN V2 后换成 100K sketch 分支。这是替换式而非加法式对比,比常见 A/B 严格。
置信区间:完全缺失。Table 5 只有一句 caption「all statistically significant」,没有 p 值、没有置信区间、没有流量分桶比例、没有样本量、没有实验单元(用户级 vs 请求级)说明。这是本文实证部分的一个明确短板。
内部一致性问题:极速版 middle-active 的 Like 是 +0.0254%,比同表其他数字小两个数量级,几乎不可能在任何合理样本量下与「统计显著」相容。这条至少说明 caption 的「全部显著」是一个笼统表述而非逐格结论。
护栏指标:部分覆盖。负反馈护栏有(Dislike 在两个 App、五个分段上一致下降 3%–12%,这是很强的信号);留存类护栏有(30-Day Activeness,但增益很小,+0.06%~+0.66%,且随活跃度上升单调衰减);分人群稳定性有(低/中/高/全活四段,方向全部一致)。缺失的护栏:延迟 / P99、服务成本 / QPS、广告或营收指标、内容多样性、创作者侧指标——对一个「全流量精排改造」而言,没有任何延迟护栏数字是显著遗漏(对比 ReST 明确写了 50ms P99 预算内,FAT 写了 P99 45ms→48ms)。
收益随时间衰减:无法判断。论文只给了一个月的聚合值,没有按周/按天的时间序列,没有 long-term holdback,也没有做重训后基线追平的分析。长序列类改动的一个典型风险是:基线模型在持续重训中逐步吸收实验组带来的分布变化,收益随时间收敛;本文对此没有提供任何证据。「部署一个月」是很强的工程事实,但它本身不等于「收益持续一个月」——只能说明这一个月的聚合平均是正的。
10.5 复核四:序列长度的边际收益曲线,以及「100K 是否必要」¶
(a)曲线形状:Figure 1(c) 的四个点(平均长度 10k / 20k / 40k / 85k)上,SequenceO1 的 Finish AUC 增益为 0.76 → 0.86 → 0.94 → 1.07。逐段增量为 +0.10(一倍)、+0.08(一倍)、+0.13(2.1 倍)——折算成每翻一倍约 +0.10~+0.12 个基点,近似恒定。在对数长度轴上这是一条近似直线,也就是说:到 85K 平均长度为止,收益尚未出现饱和迹象。
(b)「100K 是否必要」——论文没有给出正面证据,而且证据链有两个洞:
- 未饱和 ≠ 必要。曲线平滑意味着 100K 不是一个阈值或拐点,而是一个预算选择。论文自己说 $n_{\max}=100\text{K}$ 是「following industrial practice」的截断,并把百万级列为未来方向。从这条曲线看,10K→85K 一共只换来 +0.31 个基点的 Finish AUC(0.76→1.07),而这 0.31 个基点是整套 SA + KVCache + MRLB + pipeline lift + FlashSA 的全部理由。是否值得,论文没有做成本-收益的正面论证。
- 对照曲线一半是外推的。
STCA (measured)只有 10k、20k 两点(0.75、0.93),40k(1.10)与 85k(1.29)是虚线外推(在对数长度轴上按前两点斜率线性延长)。因此「保留 83% 的收益」是实测 SequenceO1 ÷ 外推 STCA。这个外推还内含一个未经检验的假设:直接 scaling 的 STCA 到 85K 也不饱和。如果 STCA 在 40K 之后其实饱和了(完全可能——它是 target-conditioned 的选择式注意力,长尾行为的边际信息本就递减),那么真实的 retention 会高于 83%;反之如果 STCA 在长序列上收益加速,retention 会更低。两个方向都无法排除,因为那两个点从未被测量。 - 还有一个更根本的缺口:论文没有做「$k$ vs $n$」的联合扫描。Table 2 只在 $n$=100K 固定下把 $k$ 从 1K 变到 512(-0.04%)和 2K(+0.03%),说明在 100K 上 sketch 容量已经饱和;但没有回答「如果只用 40K 历史配 $k$=1K,是不是和 85K 历史配 $k$=1K 一样好」。定长 sketch 的信息容量是固定的,$n$ 增大时每个 token 分到的容量在下降,理论上必然存在一个 $n$ 使得继续加长不再有收益——这个点在哪里,是本文最该回答而没回答的问题。
(c)一条不宜硬拉、但值得留档的理论旁注。昨天精读的 On the Recall Scaling Laws in Mamba: A Theoretical and Mechanistic Study via Hashing(Mamba 召回标度律,Tel Aviv University,2026-09-07)给出了固定尺寸状态下的信息论下界 $bS = \Omega(N_f \log V)$($b$ 为每状态元素比特数,$S$ 为状态大小,$N_f$ 为需精确召回的事实数,$V$ 为词表)。这条界不能直接套到 SequenceO1 上,理由有三:(i)它是精确键匹配的联想召回下界,而推荐排序需要的是近似打分,不需要从 sketch 里恢复出具体的历史 item;(ii)它假设有限状态的递推(流式读入,状态不能回看全序列),而 SA 是一次性看到全部 100K token 的非因果注意力,前提不成立;(iii)读出目标是每个 (user, target) 的一个标量,不是 $N_f$ 个键值对。
但有一个场景会让它直接相关:论文在 §5.1 与附录 C.1 两次提到 sketch 的分配模式「可能为未来的 sketch-to-behavior 检索 提供接口」。一旦真的要从 sketch 里检索出具体历史行为,那就是精确键匹配,这条界就适用了。粗略估一下量级(以下是我的推算,非论文内容):sketch 状态为 $k\times d = 1024\times 128 = 131{,}072$ 个数,若 fp16 则 $bS \approx 2.1$ Mbit;抖音 item 词表按 $V\sim10^9$ 计,$\log_2 V \approx 30$ bit,则可精确召回的事件数上界约 $N_f \lesssim 7\times10^4$——与 85K 的平均历史长度恰好同一量级、且略低于它。这说明:当前 sketch 的信息容量正好卡在「能否无损表征整段历史」的边界上,与 Figure 1(c) 观测到的 17% 收益缺口(+1.07 vs +1.29)方向一致,也预示论文设想的 sketch-to-behavior 检索扩展会立刻撞上容量墙。再次强调这只是一个数量级的直觉校验,不是严格推论。
10.6 其他局限与争议¶
- 零实测系统数字。这是最大的问题:一篇完全以系统效率为卖点的论文,没有延迟、没有吞吐、没有 P99、没有 GPU 数、没有 cache 内存占用、没有训练时间。全部效率主张都建立在解析 FLOP 上,而 GEMM-only 计数恰恰会系统性低估访存受限算子(FlashSA 要处理的 $k\times n$ 中间量正是访存瓶颈)——换言之,FLOP 比值大概率高估了真实加速比。
- 没有公开数据集实验。全部实验都在抖音私有数据上,SA 这个机制本身(一个通用的长度维压缩算子)完全可以在公开长序列基准上验证,论文没有做,外部可复现性为零。
- 压缩必然损失 target-aware 选择能力,论文用 Figure 1(c) 的 17% 缺口坦承了这一点,但没有提出补偿机制(对照 ROCS 的 RRR 再投资)。把 $k$ 加倍只换来 +0.03%,说明单纯加容量这条路已经堵死。
- 对行为噪声与不规则时间毫无处理。100K 历史里必然混杂误触、探索性浏览、有偏曝光,且时间跨度可达一年——ReST 用 Dual-Gated Attention 与 RoTE 正面处理这两点,SequenceO1 的 SA 是一个无时间感知、无可靠性加权的均匀分配算子,$\sum_j A_{j,i}=1$ 的守恒约束甚至强制每个 token(包括噪声 token)都必须往 sketch 里塞满一份质量——覆盖性是优点,也可能是噪声放大器。这是原型维归一化最值得追问的副作用,论文完全没有讨论。
- 方法论可扩展性上是加分项:与 SIF / IAT 的「先离线压缩再在线建模」不同,SA 与排序器端到端联合优化、$k$ 与 $d$ 都可 scaling、参数量与 $n$ 无关,不存在两阶段解耦或码本固化的结构性瓶颈。这是它相对同类压缩工作的实质优势。
- 写作上的克制值得肯定:论文在 Figure 3 的解读、Table 2 的小幅差异、§5.5 与 LLaTTE/SOLARIS 的对比、附录 A 与 Linformer 的关系、附录 E 的 EM 类比、附录 F 的误差分解上,每一处都主动声明了自己主张的边界(「不是标定分数」「不是独立显著性证据」「不构成 apples-to-apples」「不主张继承近似保证」「只是概念类比」「不是紧界」)。在工业论文里这种自我设限的密度相当罕见,也提高了其余结论的可信度。