On the Recall Scaling Laws in Mamba: A Theoretical and Mechanistic Study via Hashing¶
作者与机构:Yuval Koren、Assaf Ben-Kish、Raja Giryes、Lior Wolf、Itamar Zimerman,均来自特拉维夫大学 Blavatnik School of Computer Science and AI。arXiv:2609.07681v1(2026-09-07),代码开源于 github.com/yuvalko1/mamba-recall-scaling-laws。
这是一篇纯理论 + 机制可解释性的论文,没有任何工业背景,也不提出新的模型架构。它回答一个非常具体的问题:Mamba 到底用什么内部算法完成联想召回(Associative Recall, AR),以及这个算法的容量上限由哪些量决定? 结论是:Mamba 学到的召回电路本质上是一个隐式线性哈希表,因此可以用 Johnson–Lindenstrauss(JL)引理为它写出闭式的 Recall Scaling Laws——给定词表大小 $V$ 和上下文中的事实数 $N_f$,可以预测所需的嵌入维度 $D$ 与状态维度 $N$,也可以反过来预测给定维度下的召回成功概率。
一、研究动机与背景¶
1.1 固定状态是一把双刃剑¶
Transformer 在解码时的 KV cache 随序列长度线性增长,这是它处理长序列的核心低效。Mamba [1]、RWKV [2]、Griffin 等线性 RNN 通过固定大小的循环状态把内存复杂度压到常数。但论文一开篇就点明:这个固定状态是双刃剑——从信息论角度,把整个上下文压进一个向量必然带来信息损失。因此"如何提升循环架构的记忆利用率"成了活跃方向。
为了在可控环境下诊断模型的召回能力,社区提出了合成基准 Associative Recall(AR)[8] 和 Multi-Query Associative Recall(MQAR)[9],后者被 Arora et al. 证明与语言建模能力强相关。已有大量工作用 AR 指导架构选择、改进初始化、分析优化动力学。
1.2 与三条最相近工作的差异¶
论文明确划清了与三条前置工作的界线:
- Bick et al. [13](gather-and-aggregate 机制):同样用机制可解释性分析上下文检索,但不研究 AR,也没有理论分析;
- Jelassi et al. [26](Repeat after me):给出 Transformer 与 SSM 复制能力的理论,但不直接研究 AR,也不做机制可解释性;
- Huang et al. [27](Understanding Input Selectivity in Mamba,arXiv:2506.11891):这是最像的一篇——同样用 JL 引理推 Mamba 的召回界。论文用整个附录 J 做逐条对比(详见本文第七节)。核心差异是:Huang 的界是 $D=O(V_k + \log V_v)$、$N = V_k$,即状态维必须与键词表同阶,实践中不可行;本文把 JL 用两次(值压一次、键/查询再压一次),得到 $ND = O(N_f \log V)$,是可实践的紧界,并且这个紧界才使得可预测的标度律成为可能。
1.3 四级保证的"阶梯"¶
论文在 roadmap 里给了一个非常清晰的结论阶梯(给定 $N_f$ 个事实、词表大小 $V$):
- 非压缩模型(不现实):$N = D = V$ 可对任意上下文做到精确召回(worst-case,Thm 3.1);
- 压缩哈希模型:$\sqrt{ND} = O(N_f \log V)$ 即可精确召回(worst-case,Lem 4.1);
- 高概率召回:$ND = O(N_f \log V)$ 即可(mean-case,Thm 3.2 定性 / Thm 4.2、Rem 4.3 定量);
- 匹配的下界:高概率召回必须满足 $ND = \Omega(N_f \log V)$(Rem 4.4 是 Mamba 专属,Lem 4.5 是对任意固定状态循环模型都成立的信息论下界)。
一句话总结:所需的状态记忆,对事实数是线性的,对词表大小是对数的。
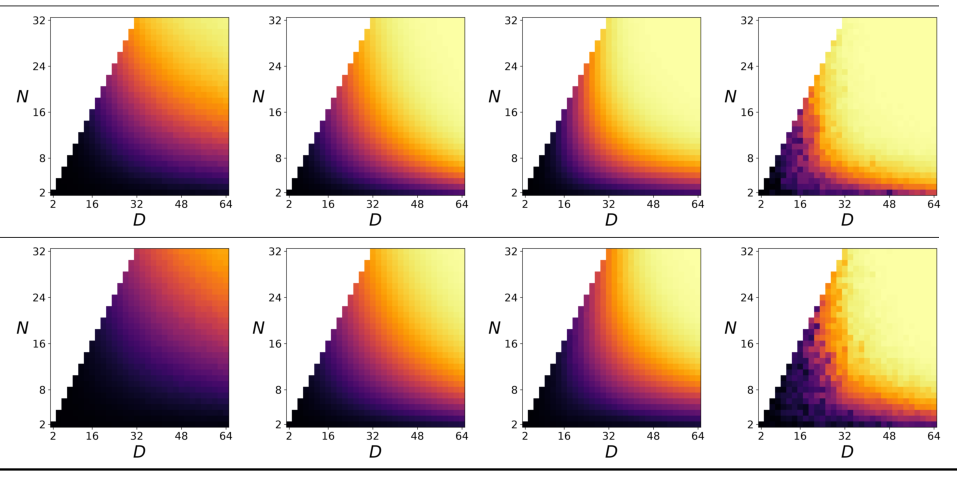
上图是全文的核心结果:横轴嵌入维 $D$、纵轴状态维 $N$,像素颜色是召回准确率。四列从左到右分别是 (a) 按 Thm F.2 手工设计权重的简化线性模型、(b) Thm 4.2 的理论标度律、(c) 训练出来的线性模型、(d) 训练出来的完整非线性 Mamba。等高线呈双曲线形(即 $ND \approx$ 常数),四列高度一致——理论预测与实测吻合,且简化模型与完整模型的相变边界几乎重合。
二、预备:MQAR 任务与 Mamba 记号¶
2.1 MQAR 任务定义¶
MQAR [9] 把一段"事实上下文"和一段"多查询"拼成一个 prompt。词表 $\mathcal{V}$ 被划分为不相交的键词表 $\mathcal{V}_k$ 与值词表 $\mathcal{V}_v$,且 $V_k = V_v = V/2$。序列总长 $L$,上下文含 $N_f$ 个不重复键的键值对 $(k_i, v_i)$(占 $2N_f$ 个 token),其余 $L - 2N_f$ 个 token 构成查询段:$N_f$ 个查询 token $q_i$(每个复制上下文里的某个键),其余 $L - 3N_f$ 个是从全词表随机采样的 padding。实现上遵循 Arora et al. 的约定 $L \ge 4N_f$。
论文给的例子(* 表示不计入 loss 的忽略位):
x   A 6 B 3 C 7  B 2 5 0 9 C 4 A 8 1
y   * * * * * *  3 * * * * 7 * 6 * *
另外,本文用 AR 特指单查询情形,即 $L = 2N_f + 1$。
2.2 Mamba / S6 的记号¶
Mamba 模型由 $\Lambda$ 个 block 堆叠,嵌入维 $D$、状态维 $N$,扩张维 $D_{in} = \text{expand}\cdot D$,卷积核长 $D_{conv}$。给定嵌入序列 $x^e$,block 的操作为:
$$\hat{x} = \mathrm{SiLU}(\mathrm{Conv1D}(\mathrm{Linear}(x^e))),\quad \hat{z} = \mathrm{SiLU}(\mathrm{Linear}(x^e)),\quad \hat{y} = \mathrm{SSM}(\hat{x})\odot\hat{z},\quad y^e = \mathrm{Linear}(\hat{y}) \tag{1}$$
每个时间步的 SSM 向量与离散化矩阵为:
$$B_t = S_B\hat{x}_t,\quad C_t = S_C\hat{x}_t,\quad \Delta_t = \mathrm{SoftPlus}(S_\Delta\hat{x}_t),\quad \bar{A}_t = \exp(\Delta_t A),\quad \bar{B}_t = \Delta_t B_t \tag{2}$$
每个通道 $d$ 上的循环更新:
$$h^d_t = \bar{A}^d_t\odot h^d_{t-1} + \hat{x}^d_t\bar{B}^d_t,\qquad \hat{y}^d_t = h^d_t\cdot C_t \tag{3}$$
所有通道拼成隐状态矩阵 $h_t\in\mathbb{R}^{D_{in}\times N}$。
简化线性模型(Alg. 1):论文移除 gating、离散化、非线性、bias、normalization 和残差,并令 $A = I$,于是 (3) 退化为极简形式:
$$h_t = h_{t-1} + \hat{x}_t B_t^\top,\qquad \hat{y}_t = h_t C_t \tag{4}$$
这就是"外积写入 + 内积读出"的经典快速权重(fast-weight)形式——后面所有理论都建立在这个式子上。
三、逆向工程:Mamba 的召回电路¶
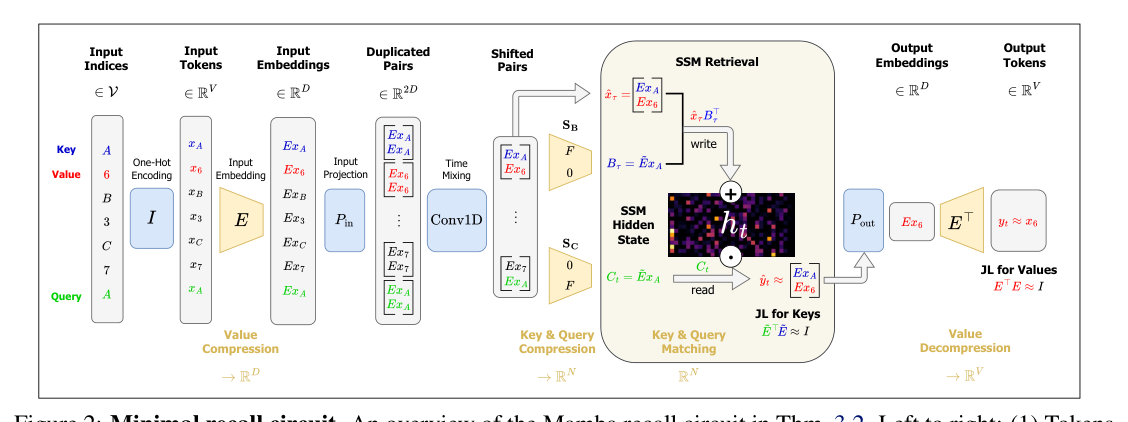
3.1 理想的非压缩电路(Theorem 3.1)¶
Theorem 3.1(完美非压缩召回电路):给定词表大小 $V$,一个单层简化 Mamba,若 $D = N = V$、$\text{expand}=2$、$D_{conv}=2$,可以完美(召回概率 = 1)解决 MQAR。
构造非常直观:
$$P_{in} = \begin{pmatrix}I_V\\ I_V\end{pmatrix},\ P_{out} = (0\,|\,I_V),\ W_{conv} = \begin{pmatrix}\mathbf{1}_V & \mathbf{0}_V\\ \mathbf{0}_V & \mathbf{1}_V\end{pmatrix},\ E = I_V,\ S_B = (I_V\,|\,0),\ S_C = (0\,|\,I_V) \tag{5}$$
四步流水线:$P_{in}$ 把输入复制成两份;Conv1D 做复制与移位,使 SSM 的输入变成相邻 token 对 $\hat{x}_t = (x_{t-1}, x_t)^\top$;$S_B$ 取出前一 token 当键、$S_C$ 取出当前 token 当查询;外积写入后读出:
$$y_t = E^\top P_{out}\hat{y}_t = \sum_{\tau=0}^{t} x_\tau\langle x_{\tau-1}, q_t\rangle \tag{6}$$
因为 one-hot 向量正交且键唯一,$\langle x_{\tau-1}, q_t\rangle = \delta_{x_{\tau-1},q_t}$,求和塌缩为 $y_t = v^*$。这就是一个显式的 $V\times V$ 键值表,代价是维度随 $V$ 线性增长,完全不现实。
3.2 压缩哈希电路(Theorem 3.2)——全文的核心¶
Theorem 3.2(高效压缩召回电路):给定 $V$、$N_f$、$L = 4N_f$ 的 MQAR,一个单层简化 Mamba 只要 $ND = O(N_f\log V)$($\text{expand}=2$、$D_{conv}=2$)就能以高概率解决任务。
构造改为:
$$P_{in} = \begin{pmatrix}I_D\\ I_D\end{pmatrix},\ P_{out} = (0\,|\,I_D),\ W_{conv} = \begin{pmatrix}\mathbf{1}_D & \mathbf{0}_D\\ \mathbf{0}_D & \mathbf{1}_D\end{pmatrix},\ S_B = (F\,|\,0),\ S_C = (0\,|\,F) \tag{7}$$
于是 SSM 输入被压缩为 $\hat{x}_t = (Ex_{t-1}, Ex_t)^\top$,键与查询被二次压缩为 $B_t = \tilde{E}x_{t-1}$、$C_t = \tilde{E}x_t$,其中 $\tilde{E}\equiv FE\in\mathbb{R}^{N\times V}$。模型输出变为:
$$y_t = E^\top P_{out}\hat{y}_t = \sum_{\tau=0}^{t}E^\top(Ex_\tau)\,(\tilde{E}x_{\tau-1})^\top(\tilde{E}x_t) \tag{8}$$
两次应用 JL 引理($D = O(\log V/\varepsilon_v^2)$、$N = O(\log V/\varepsilon_k^2)$),可构造近似正交的 JL 矩阵 $E$、$\tilde{E}=FE$(Lem. C.3 证明两次连续 JL 变换可同时满足两个失真参数),使得:
$$(\tilde{E}x_{\tau-1})^\top(\tilde{E}x_t)\approx\delta_{x_{\tau-1},x_t}+O(\varepsilon_k),\qquad E^\top(Ex_\tau)\approx x_\tau+O(\varepsilon_v)$$
匹配项贡献 $v^* + O(\varepsilon_v+\varepsilon_k)$,其余 $N_f-1$ 个不匹配项各留下 $O(\varepsilon_v\varepsilon_k)$ 的残差。大 $N_f$ 下这些 $O(\varepsilon_v\varepsilon_k)$ 项主导:worst case 下线性累加成 $O(N_f\varepsilon_v\varepsilon_k)$,mean case 下互相抵消到 $O(\sqrt{N_f}\varepsilon_v\varepsilon_k)$。于是 worst case 需要 $\sqrt{ND} = O(N_f\log V)$,而 mean case 只需 $ND = O(N_f\log V)$。
这个"抵消"正是 worst-case 界与 mean-case 界之间 $\sqrt{\cdot}$ 差距的全部来源,也是后面概率标度律的物理基础。
论文用的 JL 引理是内积形式:
Lemma C.1(JL 引理,内积形式):设 $x_1,\dots,x_n\in\mathbb{R}^m$ 非零、$0<\varepsilon<1$。若 $d\ge c\log n/\varepsilon^2$,则存在线性映射 $E\in\mathbb{R}^{d\times m}$ 使得对所有 $i,j$:
$$\big|\langle Ex_i, Ex_j\rangle - \langle x_i, x_j\rangle\big|\le\varepsilon\|x_i\|\|x_j\| \tag{9}$$
证明用概率方法:取 i.i.d. $\mathcal{N}(0,1/d)$ 的 $E$,靠 $\chi^2_d$ 的 Chernoff 界做范数集中,再用极化恒等式 $\langle Eu_i,Eu_j\rangle=\frac14(\|E(u_i+u_j)\|^2-\|E(u_i-u_j)\|^2)$ 转成内积,最后对 $2n^2$ 个事件做 union bound。论文特别注明:本文只把引理用在 one-hot 向量集上,此时直接界 $E$ 的 Gram 元可把常数收紧到 $c=4$。
四、机制可解释性验证:模型真的学到了这个电路吗?¶
理论只说明模型能学这个电路,不代表它真的学了。第 3.2 节用三组实验做验证。
4.1 不变算子(invariant operators)¶
难点在于解空间存在冗余:对任意正交阵 $Q$,$(P_{in}Q, Q^\top E)$ 与 $(P_{in}, E)$ 等价。因此必须找在正交变换下不变的证据。论文定义净算子($W_{conv}=(W^0_{conv}\,|\,W^1_{conv})$):
$$\hat{E}_{in} = \begin{pmatrix}\mathrm{diag}(W^0_{conv})P_{in}E\\ \mathrm{diag}(W^1_{conv})P_{in}E\end{pmatrix},\ \Pi_{v,in}=\hat{E}_{in},\ \Pi_{v,out}=E^\top P_{out},\ \Pi_{k,in}=S_B\hat{E}_{in},\ \Pi_{q,in}=S_C\hat{E}_{in} \tag{10}$$
$$G_{vv}=\Pi_{v,out}\Pi_{v,in},\qquad G_{kq}=\Pi_{k,in}^\top\Pi_{q,in},\qquad y_t=\sum_{\tau=0}^{t}G_{vv}\xi_\tau\,\xi_\tau^\top G_{kq}\,\xi_t \tag{11}$$
其中 $\xi_t\equiv(x_{t-1},x_t)^\top$ 是 token 对。若模型学的确实是 Thm 3.2 的电路,则应有:
$$G_{vv}\approx\begin{pmatrix}0\\ I_V\end{pmatrix},\qquad G_{kq}\approx\begin{pmatrix}0 & 0\\ I_V & 0\end{pmatrix} \tag{12}$$
实测(Fig. 16,三种 $D,N$ 配置)几乎精确满足这个结构:$G_{kq}$ 只关注查询 $x_t$ 与存储键 $x_{\tau-1}$,$G_{vv}$ 只关注存储值 $x_\tau$,其余分块全 $\approx 0$。非零块内部比 $I_V$ 更复杂——附录 F.3 说明这些花纹负责键值选择性。
4.2 隐状态就是一张哈希表¶
理想电路的隐状态是一张显式键值表:
$$H_t\equiv P_{out}h_t=\sum_{n=1}^{N_f}v_nk_n^\top,\qquad y_t=H_tq_t \tag{13}$$
压缩电路的隐状态则是压缩版($v'_n = Ev_n$、$k'_n=\tilde{E}k_n$、$q'_t=\tilde{E}q_t$):
$$H'_t=\sum_{n=1}^{N_f}v'_nk_n'^\top,\qquad y_t=E^\top\sum_{n=1}^{N_f}v'_nk_n'^\top q'_t \tag{14}$$
论文把 $H'_t$ 明确称作哈希表,理由有三:(i) 模型用的 JL 线性投影按定义就是保相似度的哈希函数;(ii) 内部表示不可直接解释,而最终输出可解释;(iii) 效率来自近似,误差以高概率有界。整个"哈希—存储—匹配—检索"接口与经典哈希表一一对应。
为了验证,论文做双向解压:定义 $v''_n = E^\top Ev_n\approx v_n$、$k''_n=\tilde{E}^\top\tilde{E}k_n\approx k_n$,得
$$H''_t=\sum_{n=1}^{N_f}v''_nk_n''^\top = E^\top H'_t\tilde{E}\approx H_t \tag{15}$$
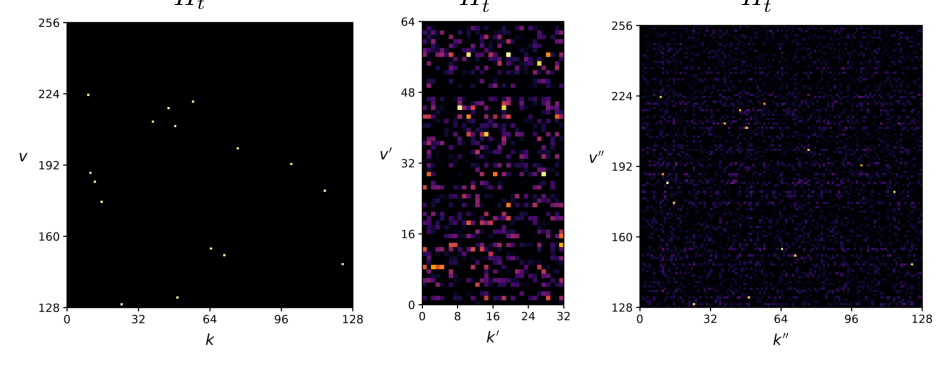
实测结果非常干净:真实隐状态 $H'_t$(中)看起来像随机噪声,但投影回词表空间后(右)恢复出与理想表 $H_t$(左)几乎相同的稀疏图案。这是"学到了压缩—解压方案"的直接证据。
这一点还有一个关键的判别意义:Huang et al. [27] 的构造暗示每个值 $Ev_\tau$ 存在隐状态的单个键坐标上($N = V_k$ 个坐标里的一个)。若真如此,只需单向解压 $H''_t = E^\top H'_t$ 就能看到干净图案。而实测必须做双向解压 $H''_t = E^\top H'_t\tilde{E}$ 才行,说明值是分布式地摊在全部 $N\ll V_k$ 个键坐标上的——支持本文的构造而非 Huang 的构造。
4.3 Conv1D 做的是"复制与移位"¶
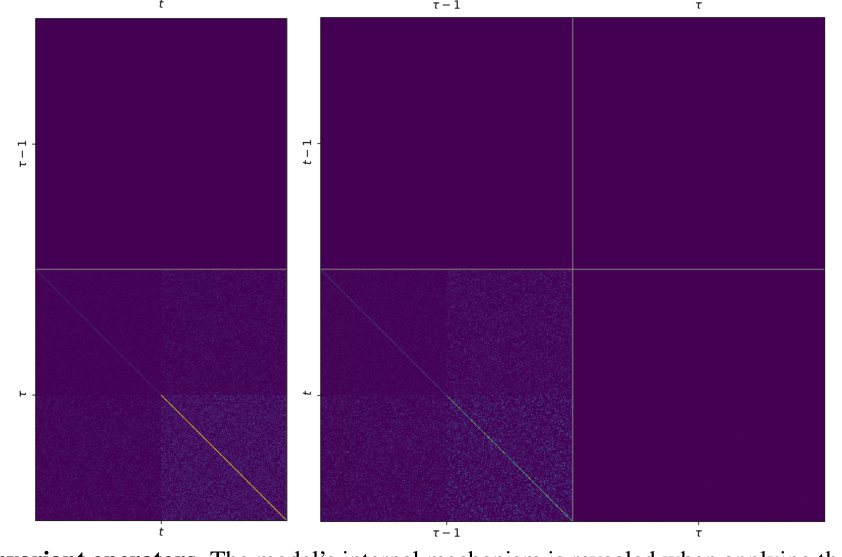
若 Conv1D 确实做复制与移位,则应有 $G_{vv}\xi_\tau\approx x_\tau$、$G_{kq}^\top\xi_\tau\approx\xi_{\tau-1}$。
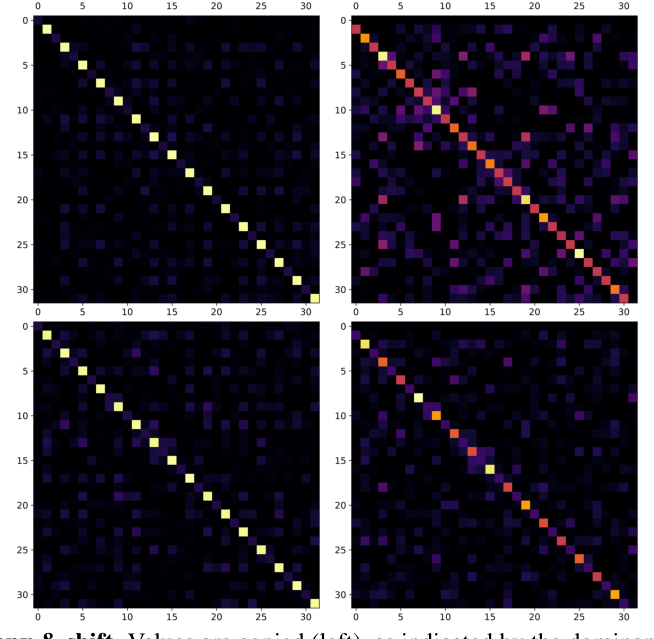
实测中 $x_tG_{vv}\xi_\tau\approx\delta_{t,\tau}$(主对角线)、$\xi_tG_{kq}^\top\xi_\tau\approx\delta_{t,\tau-1}$(次对角线),完全符合预期。
4.4 电路最小性消融(Table 8)¶
逐层剥离 Mamba block 的组件,看哪个是召回的关键($V=128$、$L=64$、$N_f=16$、$D=64$、$N=16$,5 个种子取均值):
| Model ID | 描述 | MQAR Accuracy |
|---|---|---|
| Base | 单层 Mamba,去掉 LayerNorm | 1.00 ± 0.00 |
| A | Base + $\bar{A}_t = I$ | 1.00 ± 0.00 |
| B | A 去掉 gate | 1.00 ± 0.00 |
| C | B 去掉激活函数(Conv1D 后) | 1.00 ± 0.00 |
| D | C 且 $d_{conv} = 2$ | 1.00 ± 0.00 |
| E | C 且 $d_{conv} = 1$(等效于没有 Conv1D) | 0.06 ± 0.00 |
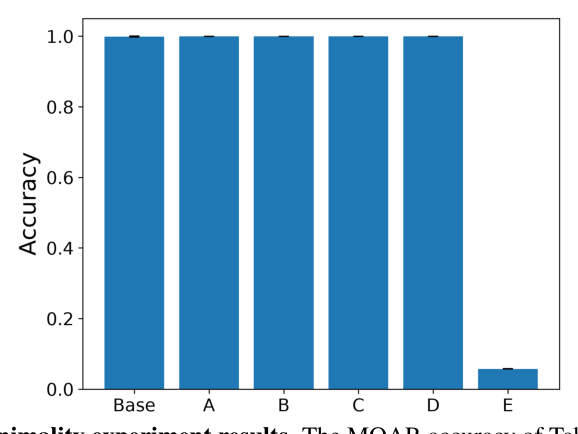
结论分析:除 SSM 本身外,卷积是最关键的组件。注意 0.06 这个数不是零——论文解释得很到位:去掉 conv 后模型无法把键绑定到值,但状态里仍保留了上下文中值的"袋子"(bag of values),在 $N_f=16$ 个值里瞎猜恰好得 $1/N_f\approx 0.06$。而 gate(模型 B)去掉后仍是满分 1.00,说明门控虽参与召回过程,但经验上不是召回能力的瓶颈——瓶颈是维度 $D$、$N$ 带来的线性压缩极限。
五、Mamba Recall Scaling Laws¶
5.1 JL 型标度律(Lemma 4.1,worst case)¶
Lemma 4.1:给定词表 $V$,单层简化 Mamba 取 $D = 4\log V/\varepsilon_v^2$、$N = 4\log V/\varepsilon_k^2$、$\text{expand}=2$、$D_{conv}=2$。若 $0<\varepsilon_v<1$、$0<\varepsilon_k<1$ 且 $$\varepsilon_v+\varepsilon_k+2N_f\varepsilon_v\varepsilon_k<\tfrac12 \tag{16}$$ 则可完美解决 AR;若进一步满足 $\varepsilon_v+\varepsilon_k+L\varepsilon_v\varepsilon_k<\frac12$,则可完美解决 MQAR。
这是把所有噪声项取绝对值直接相加的保守界。论文自己指出:这种简单求和过于严格,实践中噪声项符号相反、会互相抵消——于是进入概率版本。
5.2 概率标度律(Theorem 4.2)¶
推导骨架(附录 F.2/F.4)值得完整摘录,因为它决定了整个律的适用边界:
- 信号/噪声分解。把 Gram 矩阵 $G_E = E^\top E$、$G_{\tilde{E}} = \tilde{E}^\top\tilde{E}$ 的对角与非对角元分别记为随机变量 $S_{ii},Z_{ij}$ 与 $\tilde{S}_{ii},\tilde{Z}_{ij}$。输出的正确项、错误项、空项分别为: $$y^i_t = S_{ii}\tilde{S}_{mm}+\sum_p^{2N_f-1}Z_p\tilde{Z}_p,\quad y^j_t = S_{jj}\tilde{Z}_{nm}+Z_{ji}\tilde{S}_{mm}+\sum_p^{2N_f-2}Z_p\tilde{Z}_p,\quad y^l_t = Z_{li}\tilde{S}_{mm}+\sum_p^{2N_f-1}Z_p\tilde{Z}_p \tag{17}$$
- 方差代入。用 $\sigma_Z^2 = 1/D$、$\tilde{\sigma}_Z^2 = 1/N$、$\tilde{\sigma}_S^2 = 1/N - 1/D$ 得到三类坐标的均值方差: $$\mu_c = 1,\ \sigma^2_c = \tilde{\sigma}^2_S+(2N_f-1)\sigma^2_Z\tilde{\sigma}^2_Z;\qquad \mu_w=\mu_e=0,\ \sigma^2_w,\sigma^2_e\ \text{同阶} \tag{18}$$
- 中心极限定理(CLT)。大 $N_f$ 时每个坐标是大量独立随机变量之和,故近似为高斯:$y^i_t\sim\mathcal{N}(1,\sigma^2_c)$、$y^j_t\sim\mathcal{N}(0,\sigma^2_w)$、$y^l_t\sim\mathcal{N}(0,\sigma^2_e)$。
- 大 $N_f$ 近似。当 $N_f\gg N,D$ 时三个方差都被噪声项 $2N_f\sigma^2_Z\tilde{\sigma}^2_Z = 2N_f/(ND)$ 主导,因而近似相等,记为 $\sigma^2$。
- argmax 成功概率。条件在正确坐标取值 $x$ 上,其余坐标独立,故 $$p_{\text{success}} = \int_{-\infty}^{\infty}\frac1\sigma\phi\Big(\frac{x-1}{\sigma}\Big)\Big[\Phi\Big(\frac{x}{\sigma}\Big)\Big]^{V-1}dx \tag{19}$$
- 大 $V$ 近似(高斯极值)。$V-1$ 个标准高斯的最大值集中在典型值 $$m_V = \sqrt{2\log V}\Big(1-\frac{\log\log V+\log 4\pi}{4\log V}+O\big((\tfrac{\log\log V}{\log V})^2\big)\Big)\approx\sqrt{2\log V} \tag{20}$$ 把 $M_{V-1}$ 替换为 $m_V$,得 $p_{\text{success}}\approx\Phi(1/\sigma - m_V)$。
最终结果:
Theorem 4.2(训练模型的召回标度律):在 $N_f\gg N,D$ 且 $V\gg1$ 的极限下, $$p_{AR}\approx\Phi\left(\sqrt{\frac{ND}{N_f}}-\sqrt{2\log V}\right),\qquad p_{MQAR}\approx\frac{1}{L-2N_f}\sum_{t=2N_f}^{L}\Phi\left(\sqrt{\frac{ND}{\frac12 N_f+\frac14 t}}-\sqrt{2\log V}\right) \tag{21}$$
为什么"训练模型"比"设计模型"好一倍? 附录 F.3 的 Rem. F.3 给出机制解释:若学到的嵌入满足 $E_k\perp E_v$ 且 $\tilde{E}_k\perp\tilde{E}_v$(键子空间与值子空间正交),则值—键对根本不会被写进隐状态、键—键对写进去也不会污染输出——只有键值对贡献噪声。这把有效噪声对数从 $2N_f$ 砍到 $N_f$。Fig. 16 的实测正说明模型确实学到了这种正交嵌入。
5.3 统一标度律(Remark 4.3)¶
放宽 $N_f\gg N,D$ 并对 $\Phi$ 取线性近似后,AR 与 MQAR 可以合并成一条式子:
$$p_{\text{recall}}\approx\Phi\left(\sqrt{\frac{ND}{aN_f+N}}-\sqrt{2\log V}\right) \tag{22}$$
其中系数 $a$ 只依赖任务与模型类型:
| $a$ | AR | MQAR |
|---|---|---|
| Designed(手工权重) | 2 | 3 |
| Trained(训练得到) | 1 | 5/4 |
MQAR 的 $a$ 更大是因为查询更多、方差更大。附录 F.4 还给出更精细的分母 $\frac54 N_f+N+\frac14\sqrt{(3N_f+2N)(N_f+N)}$,说明 $\frac54N_f+N$ 只是它的粗近似。
5.4 匹配的下界(Remark 4.4 与 Lemma 4.5)¶
反解 (22):要以 $\ge 1-\delta$ 的概率解决 AR,需 $\sqrt{ND/N_f}\gtrsim\sqrt{2\log V}+n_\sigma$($n_\sigma=\Phi^{-1}(1-\delta)$),对 $\delta\ll1$ 有 $n_\sigma^2\approx2\log(1/\delta)$,故
$$ND = \Omega\!\left(N_f\log\frac{V}{\delta}\right) \tag{23}$$
更重要的是,这是一个更普遍的信息论约束的特例:
Lemma 4.5(状态大小的信息论下界):考虑任意固定状态循环模型,上下文被总结进 $S$ 个标量、每个 $b$ bit 精度的隐状态。若它以 $>1-\delta$ 的概率解决词表 $V$、$N_f$ 个事实的 AR(或 $L=4N_f$ 的 MQAR),则 $$bS = \Omega(N_f\log V) \tag{24}$$
证明用 Fano 不等式:事实值 $v_{1:N_f}$ 携带 $N_f\log_2 V_v$ bit 信息;事实段末尾的状态 $h_T$($T=2N_f$)是上下文的确定性函数,之后的答案只通过 $h_T$ 依赖于值;状态最多取 $2^{bS}$ 种构型,故 $I(v_{1:N_f};h_T)\le bS$。另一方面,用任意上下文键逐一查询 $h_T$ 就构成 $v_{1:N_f}$ 的解码器,由 Fano 得 $H(v_{1:N_f}\mid h_T)\le 1+\delta N_f\log_2V_v$,故 $I\ge(1-\delta)N_f\log_2V_v-1$。两式相夹即得。
Rem. F.8 特别强调:这个引理对递归形式不做任何假设,只要求上下文被总结进固定大小状态,因此同时适用于简化线性模型和完整非线性 Mamba。单层 Mamba 的状态是 $h_t\in\mathbb{R}^{D_{in}\times N}$,即 $S=2ND$,故 $ND=\Omega(N_f\log V)$;$\Lambda$ 层则是 $\Lambda ND = \Omega(N_f\log V)$。这是全文最强、最不依赖具体构造的结论。
六、多层与多头扩展¶
6.1 多层(Theorem 4.6)¶
多层简化 Mamba(Alg. 3)保留残差连接——这是多层召回的关键。直觉是:残差让第 $l$ 层的输入是原始序列 $Ex$ 与前 $l-1$ 层累计召回结果 $\sum_{k}^{l-1}y^k_{AR}$ 的线性组合;每层加上自己独立的召回结果 $y^l_{AR}=Ex\,\alpha^l_{AR}$,最终输出 $y=\sum_k^\Lambda y^k_{AR}$。
Theorem 4.6:$\Lambda$ 层简化 Mamba 的召回概率等同于有效状态维 $N_{\text{eff}}=\Lambda N$ 的单层模型: $$p_{\text{recall}}\approx\Phi\left(\sqrt{\frac{\Lambda ND}{aN_f+\Lambda N}}-\sqrt{2\log V}\right) \tag{25}$$
即层数与状态维在召回上是可互换的,只有乘积 $\Lambda N$ 起作用。
6.2 多头(Theorem 4.7)¶
Mamba-2 [43] 引入了多头 SSM,并类比 Transformer 的头共享模式给出四种($P = D/M$ 为头维):
| MHA(Multi-Head) | MQA(Multi-Query) | MKA(Multi-Key) | MVA(Multi-Value) | |
|---|---|---|---|---|
| $\hat{x}$ | $(L,M,P)$ | $(L,1,P)$ | $(L,1,P)$ | $(L,M,P)$ |
| $B$ | $(L,M,N)$ | $(L,1,N)$ | $(L,M,N)$ | $(L,1,N)$ |
| $C$ | $(L,M,N)$ | $(L,M,N)$ | $(L,1,N)$ | $(L,1,N)$ |
MVA 共享 $B,C$,MKA 共享 $C$,MQA 共享 $B$,MHA 不共享。Mamba-2 实际采用的是 MVA。
Theorem 4.7:固定 $D,N$,$M>1$ 头的单层简化 Mamba-2 满足 $$p_{MQA}=p_{MKA}\le p_{\text{single}}=p_{MVA}\le p_{MHA} \tag{26}$$
即多头只有在同时扩大键与查询维度时才提升召回(只有 MHA 做到),代价是可训练参数变多;MQA/MKA 因为跨头共享值压缩而变差;MVA 与单头等价。
七、实验设置¶
- 数据:直接用 Arora et al. [9] 的原版 MQAR 实现(Zoology),每个训练步在线重采样新 batch,以避免过拟合与泛化误差干扰容量测量。
- 模型:完整 Mamba 用官方
mamba-ssm(未改动);简化线性 Mamba 基于mamba-tiny本地改造。PyTorch 2.10.0 + CUDA 12.8。 - 硬件与规模:4×/8× Nvidia B200 节点;每张准确率网格图约 500–1000 个格点、每格点 3–5 个种子;线性模型网格 $8.0\pm5.5$ 小时/网格,完整 Mamba 网格 $2.3\pm1.0$ 天/网格;全文总计约 10 GPU-days。
- 超参数(Table 9):
| Linear MQAR | Linear AR | Full MQAR | Multi-layer MQAR | Multi-layer AR | Multi-head MQAR | |
|---|---|---|---|---|---|---|
| Batch size | 128 | 128 | 128 | 128 | 750 | 128 |
| Optimizer | AdamW ($\beta_1=0.9$, $\beta_2=0.95$),六组通用 | 同左 | 同左 | 同左 | 同左 | 同左 |
| Base LR | 0.01 | 0.01 | 0.01 | 0.01 | 0.01 | 0.01 |
| Weight decay | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| Label smoothing | 0.1 | 0.1 | 0.1 | 0.1 | 0.1 | 0.1 |
| Total steps | 2000 | 2000 | 20000 | 4000 | 10000 | 4000 |
| Warmup / Flat / Decay | 100/400/1500 | 100/400/1500 | 100/5900/14000 | 100/1400/2500 | 250/2250/7500 | 100/1400/2500 |
| Early stop acc | 1.0 | 1.0 | 0.999 | 1.0 | 1.0 | 1.0 |
| Grad clip | 1.5 | 1.5 | 0.75 | 2.5 | 2.5 | 5 |
| Seeds / grid point | 3 | 3 | 5 | 3 | 3 | 3 |
| GPU time / grid | 4.6 h | 11.4 h | 54.9 h | 2.3 h | 8.7 h | 1.6 h |
- 种子聚合(K.5):报告的是 best-of-seeds 准确率。理由是本文测的是容量(召回解是否存在),而非"优化能否找到它"的概率。附录 Fig. 19/20 给出逐种子网格与收敛率分析,说明相变边界在各种子间一致,种子差异主要是孤立的优化失败。
八、主要实验结果¶
8.1 单层:准确率网格(§5.1)¶
Fig. 1 / Fig. 7 展示三种 MQAR 参数 regime:(i) $V=1024, L=64, N_f=16$;(ii) $V=512, L=128, N_f=32$;(iii) $V=512, L=64, N_f=16$。四列(设计 / 理论 / 训练线性 / 训练完整)在每个 regime 下高度一致:
- 理论列 (b) 与训练线性列 (c) 紧密对齐,验证 Thm 4.2;
- 完整非线性 Mamba 列 (d) 与线性列 (c) 走势相同,说明简化没有破坏核心召回行为;
- 四列都呈现预测的 $D$–$N$ 反比权衡(等高线是 $ND=$ 常数的双曲线),与 Rem 4.4 一致。
值得单独指出的是 regime (iii):$V_k = V/2 = 512$ 时,单层 Mamba 用 $N=32\ll V_k$、$D=64\ll V_k$ 就完美解出 MQAR——这直接反驳了 Huang et al. 的 $N = V_k$ 界在实践中的必要性。
8.2 单层:标度曲线(§5.2)¶
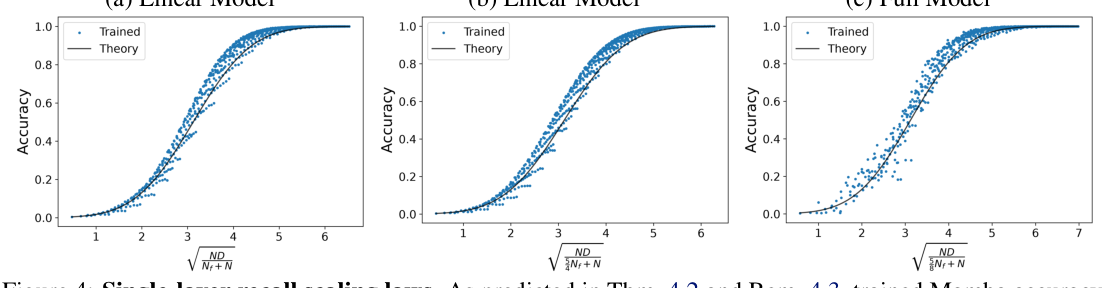
把二维 $D$–$N$ 网格用单一标度变量 $x = 1/\sigma = \sqrt{ND/(aN_f+N)}$ 重参数化后,所有格点塌缩到一条一维曲线 $p_{\text{recall}}(x)\approx\Phi(x-b)$,$b\approx\sqrt{2\log V}$:
- (a) 线性模型 + AR:$a = 1$;
- (b) 线性模型 + MQAR:$a\approx5/4$(查询更多 → 方差更大 → 同样 $D,N$ 下更难);
- (c) 完整非线性 Mamba 同样吻合 Rem 4.3,但 $a_{\text{full}}\approx\frac12 a_{\text{linear}}$($a\approx5/8$,启发式确定)——即完整模型性能更好,但标度行为形状相同。
Fig. 9 进一步显示这三个 $a$ 值在三个 regime 间保持一致。论文由此推断:简化模型与完整模型共享同一个哈希式键值压缩瓶颈,$N,D$ 是首要容量约束;但明确写明"我们把这个假设的详细验证留给未来工作"。
8.3 大词表与长上下文(附录 A.2)¶
这是唯一走出玩具规模的实验:固定 $D=150$、$N=75$ 的训练线性模型,$V$ 从 1000 扫到 50000(对数间隔),$L$ 从 1000 扫到 4000,$N_f = L/4$。
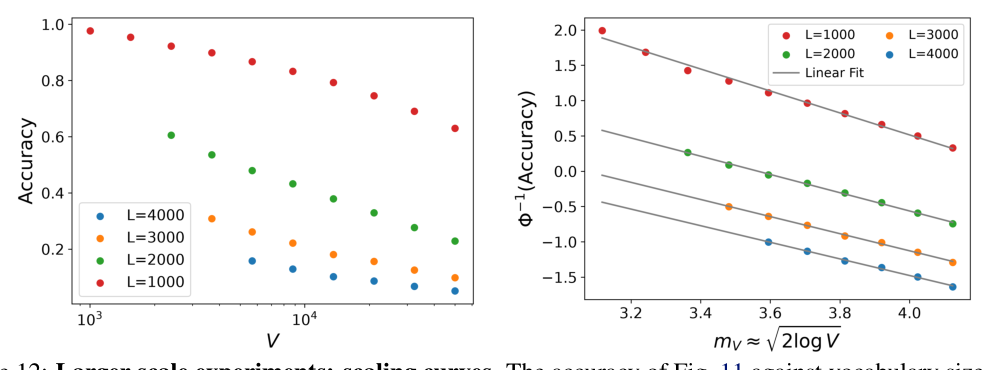
结论分析:左图显示准确率随 $V$ 单调下降,$L=1000$ 时从 0.98 降到 0.63,而 $L=4000$ 时整体只有 0.05–0.16。右图把 $\Phi^{-1}(\text{accuracy})$ 对 $m_V\approx\sqrt{2\log V}$ 作图,四条 $L$ 曲线都近似为直线,验证了 $\sqrt{2\log V}$ 这一函数形式。但逐 $L$ 线性拟合的斜率是 1.18–1.56,理论斜率是 1——论文自己坦承:"这说得通,因为理论标度是一个近似关系"。
8.4 多层(§5.3)¶
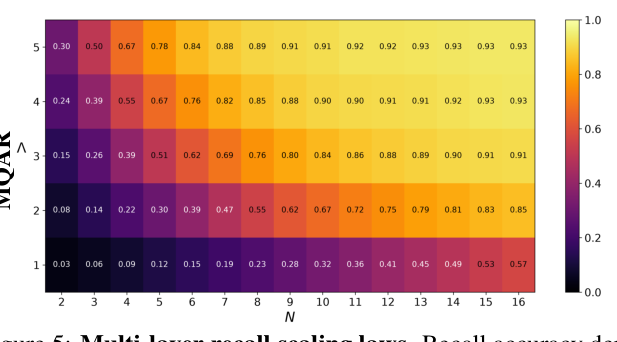
$N$–$\Lambda$ 网格清楚呈现反比关系:附录 A.1 明确给出 $p_{MQAR}\approx0.38$ 同时出现在格点 $(N,\Lambda) = (12,1), (6,2), (4,3), (3,4)$——即准确率只由 $N_{\text{eff}}=\Lambda N$ 决定。右图的标度曲线在换用 $x=\sqrt{\Lambda ND/(aN_f+\Lambda N)}$ 后同样塌缩到 $\Phi(x-b)$,与 Thm 4.6 精确吻合。
8.5 多头(§5.4)¶
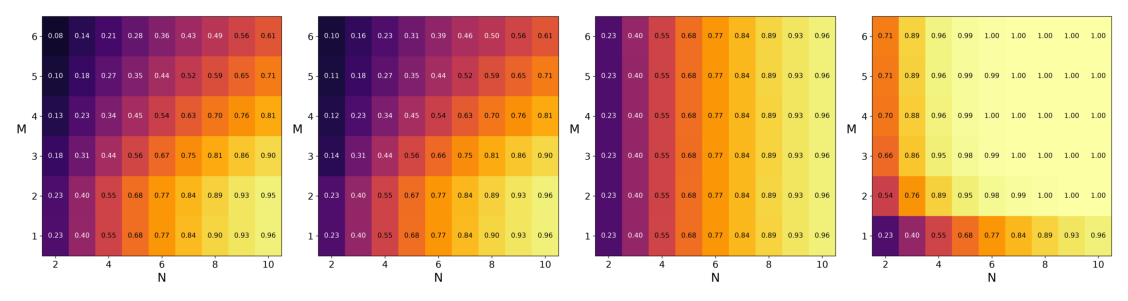
固定 $D$,扫 per-head 状态维 $N\in[2,10]$ 与头数 $M\in[1,6]$,MQAR 准确率(读自 Fig. 6):
| 模式 | $M=1$($N=2\to10$) | $M=6$($N=2\to10$) | 与单头相比 |
|---|---|---|---|
| (a) MQA | 0.23 → 0.96 | 0.08 → 0.61 | 显著变差 |
| (b) MKA | 0.23 → 0.96 | 0.10 → 0.61 | 显著变差 |
| (c) MVA | 0.23 → 0.96 | 0.23 → 0.96 | 完全等价 |
| (d) MHA | 0.23 → 0.96 | 0.71 → 1.00 | 显著变好 |
完全符合 Thm 4.7 的排序 $p_{MQA}=p_{MKA}\le p_{\text{single}}=p_{MVA}\le p_{MHA}$。
与语言建模的连接:论文指出这个趋势与 Mamba-2 论文 [43, Sec. 9.4, Table 5] 的困惑度消融吻合——MQA 与 MKA 的困惑度都劣于 MVA,正对应"共享值压缩会损害召回"。在参数量对齐的条件下 MVA 是更强的设计,因此被实际采用。这是全文唯一一处把合成任务结论与真实 NLP 指标对上的证据。
九、消融与生成化实验¶
9.1 重复键的 MQAR(附录 I.2)¶
论文构造一个 MQAR 变体:每个键出现 $N_k$ 次、每次配不同的值,模型必须返回最后一次出现的值($V=512$、$L=128$、$N_f=10$、$D=100$,并固定 $N_{\text{eff}}=\Lambda N=60$ 以保持总状态大小不变)。
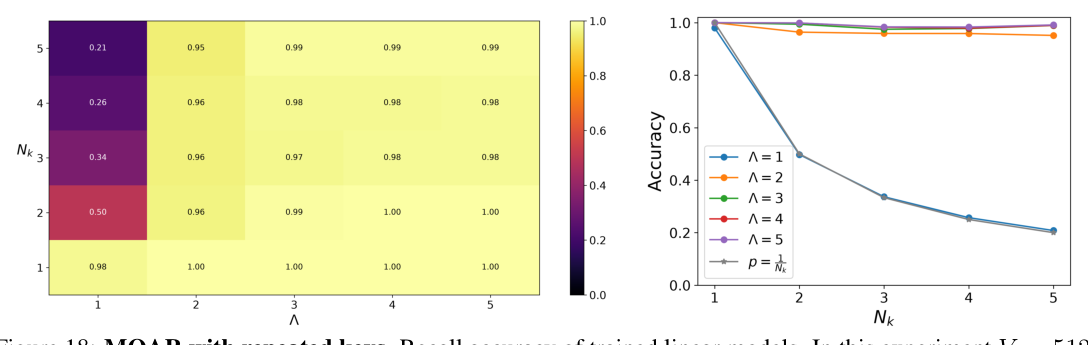
结论分析:单层模型的准确率约等于 $1/N_k$,即在 $N_k$ 个存储值里瞎猜。机制解释很清楚:每次出现都把值写进同一个隐状态槽位,最终槽里是 $N_k$ 个值的大致等权混合,而不是最后那个。深度解决了这个问题——两层时,第一层可以读回当前存储的值,第二层写入新值与旧值之差,从而覆盖而非混合陈旧条目。
这是一个重要的补充:Thm 4.6 说"$\Lambda$ 与 $N$ 在容量上可互换",但本实验说明层数还提供了容量之外的、状态更新语义上的能力(覆写 vs 累加),二者不完全等价。
9.2 按「引入新信号 ≠ 收益来源」判据核验¶
按本库判据检查:本文的消融是否把收益错误归因给某个新引入的组件?
- 电路最小性消融(Table 8)是反向消融——逐个移除组件而非添加,因此不存在"新信号带来收益"的归因风险。它的结论(gate 可去、非线性可去、离散化可去、Conv1D 不可去)是否定性的,且给出了 0.06 = $1/N_f$ 的定量机制解释,属于自洽的强证据。
- 真正需要警惕的是 $a_{\text{full}}\approx\frac12 a_{\text{linear}}$ 这一步:完整 Mamba 比简化线性模型好一倍,论文把这个系数启发式确定("determined heuristically"),并未从机制上归因到 gate / 非线性 / 离散化中的哪一个。也就是说,完整模型多出来的那一倍收益,本文并没有找到来源——论文自己在 §5.2 与 Limitations 里都承认了这点("the theoretical role of the gating branch in recall remains unclear")。这是本文最主要的归因缺口:理论解释的是简化模型,实测的"多出来的一半"仍是黑箱。
- 多头实验(Fig. 6)控制得当:固定总通道维 $D$、只变 $N$ 与 $M$,且 MVA 与单头严格重合这一条零效应基线恰好构成了实验有效性的内部对照。唯一的口径瑕疵是 MHA 的提升伴随可训练参数增加(论文明示"at the cost of more trainable parameters"),因此 MHA > single 这一条不是等参数量比较。
十、核心贡献总结¶
- 机制层面:通过逐步移除 Mamba 组件,隔离出负责召回的电路级机制,并用正交变换下不变的算子 $G_{vv},G_{kq}$ 在训练模型权重上验证了它。
- 解释层面:把学到的权重解释为隐式的保相似度线性哈希函数,把整个电路解释为哈希表的"哈希—存储—匹配—检索"接口。
- 理论层面:提出 Recall Scaling Laws 框架,给出近乎完美召回所需 $N,D,L$ 的上界,以及给定维度的召回概率预测;并配一个匹配的信息论下界 $bS = \Omega(N_f\log V)$。
- 扩展层面:把框架推广到多层(有效状态 $N_{\text{eff}}=\Lambda N$)和多头($p_{MQA}=p_{MKA}\le p_{\text{single}}=p_{MVA}\le p_{MHA}$)。
- 实证层面:约 10 GPU-days 的网格实验,验证理论在设计模型、训练线性模型与完整非线性 Mamba 上都成立。
与已归档相关工作的对比¶
LIMIT LIMIT: On the Theoretical Limitations of Embedding-Based Retrieval (Google DeepMind / JHU, 2025-08-28)¶
关系:独立并发(本文未引用 LIMIT,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文问的是同一个 root cause——「一个固定大小的表征,能承载多少种检索/召回结果?」LIMIT 问的是"$d$ 维单向量能否表示所有 top-$k$ 文档组合",本文问的是"$D\times N$ 的循环状态能否存下 $N_f$ 个来自 $V$ 词表的事实"。两者都拒绝"数据更好、模型更大就能解决"的默认假设,转而证明容量天花板由任务组合复杂度决定。
- 相近的技术骨架:两篇的方法流程图可以抽象重合成同一张——(1) 把"表征能力"形式化为一个几何/信息论量;(2) 用经典工具推出维度的必要下界;(3) 构造一个极简合成诊断任务,让下界在实验上真的咬住;(4) 拟合出临界曲线并外推。LIMIT 用球堆积($\binom{n}{k}\le(1+1/\gamma)^d$,即 $d=\Omega(k\log(en/k)/\log(1+1/\gamma))$)与 sign-rank 两条路径;本文用 JL 引理正向构造 + Fano 不等式反向下界($bS=\Omega(N_f\log V)$)。两者的形式惊人地平行:LIMIT 的 $d\gtrsim k\log n$ 与本文的 $ND\gtrsim N_f\log V$ 是同一个"事实数 × 对数词表"的骨架。LIMIT 的诊断集是 46/50k 文档的 LIMIT 数据集,本文是 AR/MQAR 网格;LIMIT 拟合 critical-$n$ 与 $d$ 的三次多项式($r^2=0.999$),本文拟合 $p_{\text{recall}}=\Phi(x-\sqrt{2\log V})$ 的一维塌缩曲线。
- 本文的差异与推进:LIMIT 的对象是无状态的编码器输出向量,容量瓶颈是纯几何的(单位球面上能塞多少个相互分离的 query 点);本文的对象是有状态的循环模型,瓶颈是"随时间累加的外积写入 + 有噪读出",因此本文额外给出了噪声的完整统计模型(式 17–19:CLT + $V-1$ 个高斯的极值),能预测的不只是"能/不能",而是连续的成功概率曲线。另一方面 LIMIT 的下界更强:它是对所有 $k$-子集都要求 margin 的 worst-case 组合界,而本文的核心律是 mean-case(worst case 只给到 $\sqrt{ND}=O(N_f\log V)$)。
- 可比的方法 / 实验差异:两篇都发现"真实模型显著劣于理论下界"——LIMIT 测到自由 embedding 在 $n=100$ 时需要 $d>18$ 而理论下界只要 $d\ge4$(约 4.5 倍乘子),本文测到完整 Mamba 的 $a_{\text{full}}\approx\frac12 a_{\text{linear}}$ 且大规模拟合斜率 1.18–1.56 而非理论的 1。两篇也都指向同一条工程出路:LIMIT 的结论是单向量不够、要靠 multi-vector 或 cross-encoder(即"不压缩"的路径);本文的结论是固定状态不够、要靠增大 $\Lambda N D$ 或换 MHA 头模式。这两条出路在结构上是同一件事:当容量律咬住时,唯一的解法是提高有效表征维度,而不是改训练配方。 LIMIT 用 fine-tune 实验排除了 domain shift 假设(在训练集上训练 recall@10 最多只到 2.8),本文用 best-of-seeds 排除了优化失败假设,两者都在把"容量问题"与"优化/数据问题"切开。
Qwen3.8-Flash-Next Qwen3.8-Flash-Next: 架构设计、评测、效率与训练稳定性(Qwen Team, Alibaba,2026-08-31)¶
关系:问题同构、解法互补(本文是理论/机制推导,对方是架构工程配方,解法路径并不同构)· 两篇互不引用(本文全文 0 次出现 "Qwen" / "GDN" / "hybrid";对方早于本文 7 天发布,也不可能引用本文)· 已加载对方精读
-
共同关注的问题:两篇指向同一个 root cause——把整个前缀压进固定尺寸循环状态,就存在一条绕不过去的精确检索容量上限。Qwen3.8-Flash-Next 的原话是「GDN 把前缀压进一个固定大小的循环状态并按当前内容更新它;穿插的全局注意力层保留任何有限状态记忆都无法精确复现的 token 级直接检索」。本文的 Lem. 4.5 恰好把这句定性判断变成了不等式 $bS=\Omega(N_f\log V)$。
-
本文补上了对方缺失的那个"为什么":Qwen3.8-Flash-Next 把混合比定为「每 4 层里 3 层 GDN + 1 层全注意力」,但其精读明确记录了该混合比没有做扫描消融(没有 1:2 / 1:8 的对照),论文只说"这个排布在效率与质量之间取得了有利的平衡,同时周期性全注意力对长上下文性能尤为重要",属工程判断而非机制解释。本文给出的机制解释是:线性/SSM 层的精确召回容量被状态比特总数硬性封顶,且这个上界与训练量无关——本文全部实验刻意用 best-of-seeds 报告,正是为了剥离优化难度、只测容量。所以无论训练多久,只要总状态预算不够,精确检索就做不到,必须要么加状态预算,要么放不压缩的全注意力兜底。
-
一处需要修正的常见误读:本文的 Thm. 4.6 说明层数并非无效——有效状态是 $N_{\text{eff}}=\Lambda N$,深度与状态维在总预算意义上线性可互换。准确表述是「受总状态比特数封顶,加层只能线性放大预算、不产生新机制」,而不是"与层数无关"。这对 3:1 混合的解读很关键:靠堆 GDN 层理论上也能线性扩容量,但代价是每层的全部参数与 FLOPs,远不如插一层全注意力划算(后者容量随上下文长度增长而非固定)——这正是混合架构在成本上占优的根本原因。
-
可比的方法 / 实验差异:本文证据全部来自合成 MQAR、玩具尺寸($D\le150$、$N\le75$、$\Lambda\le5$);Qwen3.8-Flash-Next 的证据是 28 层 25B-A3B MoE 在 400B+80B token 上的真实 benchmark(GDN hybrid 平均 53.81 vs 全注意力 49.87 vs SWA hybrid 51.15)。两者没有任何共同数据集或指标,只能做机制层面的相互印证,不能做数值对照。另一处呼应:Qwen 那篇也承认其 Table 1「本身并不能隔离出是哪个架构组件造成了各项提升」,而本文的 Table 8 恰恰把"隔离组件"做到了极致——代价是任务退化成合成 MQAR。
同构度标注:按 Step 2.5 的"问题 + 解法双同构"严格口径,本条只满足问题同构,解法路径(理论推导 vs 架构配方)并不重合,属于理论↔工程互补而非"殊途同归"。保留它的理由是本文正好为对方那条未经消融的工程判断提供了缺失的机制依据,属高价值对照;同构度弱于上面的 LIMIT 条目。
十一、讨论与局限性¶
11.1 理论主张的适用边界:假设有多强?¶
这是本文最需要如实标注的部分。逐条列出理论所依赖的假设:
- 键唯一、值 i.i.d. 均匀。MQAR 的定义就写死了"$N_f$ 个不重复键",Lem. 4.5 的证明更是显式假设"值从 $\mathcal{V}_v$ 中 i.i.d. 均匀抽取、查询在上下文键中均匀抽取"。这是全文最强的假设:$N_f\log_2 V_v$ 这个信息量正是均匀分布下的熵。若键值分布是重尾的(真实推荐里的 item 分布无一例外是重尾),实际熵 $H(v_{1:N_f})$ 会远小于 $N_f\log_2 V_v$,于是 Fano 下界立即松掉,$ND=\Omega(N_f\log V)$ 不再是必要条件——一个懂得分配更多状态给头部、共享尾部的模型可以用更小的状态达到同样的期望召回率。反过来看,这也意味着本文的律在重尾场景下是保守的:它给的是最坏(最高熵)情形的需求量。
- JL 构造依赖近似正交的随机投影。Thm 3.2 的构造要求 $E$、$\tilde{E}=FE$ 是 JL 矩阵,其误差分析($\sigma_Z^2=1/D$、$\tilde\sigma_Z^2=1/N$)本质上假设不同 token 的嵌入是各向同性、互不相关的。真实语料/物品的嵌入高度各向异性且强相关(同品类、同作者的 item 嵌入几乎共线),此时 $\langle Ex_i,Ex_j\rangle$ 的方差不再是 $1/D$,噪声项也不再独立。
- CLT 与独立性假设。式 (18)(19) 明确要求"每个坐标是大量独立随机变量之和",且条件在正确坐标上时"其余坐标独立"。键之间一旦相关,这两条同时失效。
- 大 $V$ 极限与高斯极值近似。式 (20) 用 $m_V\approx\sqrt{2\log V}$ 替代 $V-1$ 个高斯最大值的分布,忽略了 $O(\log\log V/\log V)$ 修正——这正是实测斜率 1.18–1.56 而非 1 的一个可能来源。
- 模型侧的简化。理论对象是去掉 gating、离散化、非线性、归一化、$A=I$ 的线性模型;完整 Mamba 只是经验上被发现服从同一形状,系数靠启发式凑。论文在 Limitations 里主动承认:"we do not fully characterize how each component of the full Mamba architecture contributes... the theoretical role of the gating branch in recall remains unclear."
- 任务侧的简化。$L=4N_f$、padding 从全词表随机采样、键值词表严格二分且各占一半——这些都是 Zoology 的实现约定,不是通用设定。
综合判断:这条律的函数形式($ND$ 而非 $N$ 或 $D$ 单独起作用;对 $N_f$ 线性、对 $V$ 对数;$\Phi(\cdot-\sqrt{2\log V})$ 的相变形状)在假设范围内被验证得相当扎实;但它的常数与斜率是脆的($a_{\text{full}}$ 靠启发式、大规模斜率偏离 18%–56%)。最稳健的是 Lem 4.5 的信息论下界——它对递归形式零假设,只要求固定状态,因此对 Mamba-2、RWKV、GLA、DeltaNet 乃至任何 linear attention 都成立;但它同样吃"值 i.i.d. 均匀"这个假设。
11.2 理论与实验是否互相支撑?¶
支撑得比多数理论论文好,但验证仍全在合成域内。 具体口径:
- 有真实模型验证吗? 有一半:Fig. 1 列 (d) 用的是未改动的官方
mamba-ssm完整非线性 Mamba,不是玩具复现。但它跑的仍然是合成 MQAR,不是语言建模,也没有任何下游任务。 - 唯一的"真实指标"连接是 §5.4 那一段:多头模式的排序 MQA/MKA < MVA 与 Mamba-2 原论文已发表的困惑度消融方向一致。这是二手证据(引用他人表格),不是本文自己跑的 LM 实验。
- 拟合跨几个数量级? 坦率地说不多:$V$ 跨 $10^3\to5\times10^4$(约 1.7 个数量级),$L$ 跨 $10^3\to4\times10^3$(0.6 个数量级),主网格的 $D\in[2,64]$、$N\in[2,32]$(约 1.5 个数量级),$N_f\in[16,1000]$(约 1.8 个数量级)。没有任何一条轴跨到 3 个数量级以上,与 Chinchilla 类工作动辄跨 4–5 个数量级的拟合完全不是一个量级。而且大规模那组只用了单一模型配置($D=150,N=75$),无法在大 $V$ 下重新验证 $D$–$N$ 反比关系。
- best-of-seeds 的口径需要标注:论文报告的是 3–5 个种子里的最好值,理由(测容量而非可优化性)站得住,但这意味着曲线是能力上界而非期望表现。Fig. 20 显示相变边界附近的收敛率明显低于 1,即实际训练常常找不到那个解。
结论:理论 → 实验方向的预测力是真的(一维塌缩、$D$–$N$ 双曲线、$N_{\text{eff}}=\Lambda N$、多头四模式排序,四条独立预测全部命中);实验 → 理论方向的外推力有限(规模窄、只有合成任务、常数需要启发式修正)。
11.3 对推荐的可迁移性:如实判断¶
本库跟踪这篇是因为"通用性强、可迁移到推荐的 LLM 技术"。如实说,可迁移性是有限且需要大幅打折的,理由如下:
能迁移的部分(结论层):
- $ND$ 是一个乘积约束这一点大概率是稳健的,且直接可用于 SSM/线性注意力推荐骨干的容量设计:单独加大 $N$ 或 $D$ 的收益是互相替代的,等准确率线是双曲线。这与推荐里"加宽 embedding vs 加大状态"的取舍直接对应。
- $\Lambda N$ 的可互换性给了一条便宜的工程结论:在固定单层状态维的硬件约束下,堆层数与加状态在召回容量上等价。
- 多头模式的排序(MVA=单头、MHA 更强、MQA/MKA 更弱)对任何要在推荐里上 Mamba-2 / GLA 类骨干的团队是可直接照抄的设计指引。
- Lem 4.5 的信息论下界作为一条"不可能性"论证是完全可迁移的:任何把用户历史压进固定状态的架构,其状态比特数必须随"需要被精确回忆的事件数 × 事件的对数熵"线性增长。这解释了为什么纯 SSM 骨干在超长行为序列上会有硬上限。
不能直接类比的部分(这是必须如实剔除的):
- AR/MQAR 的"事实"与推荐的"行为"根本不是一回事。 MQAR 要求精确恢复某个特定键对应的值(0/1 正确性),而序列推荐要求的是对下一个 item 的分布预测——绝大多数历史行为不需要被逐条精确回忆,只需要被聚合成一个偏好表示。把 $N_f$ 直接代成"10 万级用户行为序列长度"是错误的代入:推荐里真正需要精确召回的"事实"数量(比如"用户上周买过这双鞋所以别再推了"这类去重/复购约束)通常是几十到几百量级,不是 $10^5$。
- 重尾分布破坏下界的前提(见 11.1 第 1 条)。真实 item 分布的熵远低于 $\log V$,因此 $N_f\log V$ 是一个严重高估的需求量。用它去论证"10 万序列需要多大状态"会得出荒谬的结论。
- 推荐的容量瓶颈通常不在"上下文内召回",而在"参数化记忆"。MQAR 测的是 in-context 记忆;推荐系统的用户/物品记忆大部分存在 embedding table 与稀疏参数里,与循环状态容量是两套预算。本文对后者一字未提。
- 本文的 $V$ 是 $10^3$–$10^4$ 量级,推荐的 item 词表是 $10^7$–$10^9$。虽然依赖是 $\log V$(增长很慢),但 JL 常数、各向异性、以及"键唯一"假设在这个量级下都未被检验。
一个真正有价值但需谨慎表述的连接:本文的 $ND=\Omega(N_f\log V)$ 从容量侧给出了「为什么纯线性/SSM 骨干在需要精确检索时会不够、而混合全注意力层能补上」的一个理论解释——全注意力的 KV cache 大小随 $L$ 线性增长,天然满足这个下界,而固定状态不满足。这与 Qwen3.8-Flash-Next Qwen3.8-Flash-Next 采用 GDN 与全注意力 3:1 混合的工程选择方向一致。但必须说清楚:本文既没有分析混合架构,也没有测过任何检索型下游任务,这个连接是读者的外推而非论文的主张,本库不应把它记成本文的结论。
(说明:这条连接已在上文「与已归档相关工作的对比」中作为 Qwen3.8-Flash-Next 子节单独展开,并在那里显式标注为只满足问题同构、解法路径不同构——本文是理论/机制推导,对方是架构工程配方。按 Step 2.5 的严格口径它弱于 LIMIT 那条"殊途同归",保留的理由是本文正好为对方那条未经消融的 1:4 混合比判断补上了缺失的机制依据。)
11.4 其他局限与争议点¶
- 重复键场景下单层完全失效(准确率 $\approx1/N_k$),而"同一个键在不同时间对应不同值"恰恰是推荐里的常态(同一个 item 在不同时间的不同交互类型)。这个附录实验其实是全文对推荐最不利的一条发现,但论文只用了一页篇幅。
- best-of-seeds 与相变边界附近的低收敛率之间的张力没有被充分讨论:论文测的"容量"与工程上关心的"能否训出来"之间有实质差距。
- 值得借鉴的设计:用正交变换不变的净算子(式 10–12)来验证机制,这是一个可直接搬到其他架构分析上的通用方法论——它解决了"权重存在冗余等价类,因此不能直接比对权重"的核心困难。同样值得借鉴的是用一维标度变量把二维网格塌缩成一条曲线这一验证手法:它把"理论对不对"变成了一个可证伪的强预测,而不是事后拟合。
- 无工业落地价值:纯理论工作,无部署、无 A/B、无业务指标,这是它在本库评分体系下的天然上限。