On the Theoretical Limitations of Embedding-Based Retrieval¶
作者与机构:Orion Weller (Google DeepMind / Johns Hopkins University)、Michael Boratko、Iftekhar Naim、Jinhyuk Lee (Google DeepMind)。发表于 ICLR 2026(arXiv:2508.21038)。数据与代码开源于 https://github.com/google-deepmind/limit。
这是一篇偏理论的信息检索(IR)论文。它不提出新的检索模型,而是回答一个更根本的问题:单向量(single-vector)embedding 检索模型的表征能力到底有没有天花板? 作者用高维几何 / 学习理论的经典结果证明,对于固定的 embedding 维度 $d$,一定存在某些 top-$k$ 文档组合是任何 query 都无法从该模型中检索出来的——这与"只要数据更好、模型更大就能解决"的普遍假设相反。为了让这个抽象结论落地,他们构造了一个极其简单却让 SOTA embedding 模型集体失败的自然语言数据集 LIMIT。
一、研究动机与背景¶
1.1 检索范式的演进与"任何 query、任何 relevance"¶
过去二十年,信息检索从以稀疏方法(如 BM25,Robertson et al. 1995)为主,转向使用神经语言模型(LM)作为骨干的稠密检索(dense retrieval)。这些神经模型绝大多数以单向量形式工作:把整段输入压缩成一个 embedding 向量,query 和 document 各出一个向量,用内积(dot product)打分。这类模型被寄望于泛化到任意新的检索任务。
近年来这一趋势被 instruction-following 检索进一步推向极端:模型被要求为任意 query 表达任意 relevance 定义。例如:
- QUEST(Malaviya et al. 2023)用逻辑算子组合不同概念(如"Moths or Insects or Arthropods of Guadeloupe");
- BRIGHT(Su et al. 2024)用需要 reasoning 的方式定义 relevance(例如给定一个 Leetcode 题,找出共享同一子任务如"动态规划"的其他题目)。
作者指出:一旦 relevance 可以由任意逻辑算子(如 X and Y)连接任意两篇原本无关的文档,那么需要被 top-$k$ 集合表示的组合数量会爆炸式增长。这就引出核心疑问——embedding 的几何结构能承载这种无限增长的组合吗?
1.2 与已有工作的关系¶
- 实证层面的 embedding 局限:Reimers & Gurevych (2020) 发现小维度 embedding 在大规模语料上假阳性更多;Yin & Shen (2018) 研究了 embedding 维度与 bias-variance 权衡的关系。本文的区别是给出理论连接:把 embedding 维度和它能检索的 top-$k$ 集合数量直接挂钩。
- 几何空间中的向量极限:最近邻与语义空间的研究可追溯到 Voronoi 图(1908),其 order-$k$ 版本(把空间按最近的 $k$ 个点划分)与检索天然对应。但 order-$k$ Voronoi 图的区域数量难以紧界(Bohler et al. 2015)。作者换了一个角度:不问"某配置能实现多少个 $k$-子集",而问"要实现所有 $k$-子集且带一定 margin,必须多大维度"。
- 与 Johnson–Lindenstrauss 引理的对偶性:JL 引理给出保持 $n$ 个点两两距离所充分的维度;本文相反,给出实现所有带 margin 检索集所必需的维度。
- 与统计学习理论平行:margin 控制可实现配置复杂度这一点,与 fat-shattering 维度(Kearns & Schapire 1994)、基于 margin 的线性分类器泛化界(Bartlett 2002;Vapnik 1998)一脉相承——更大的 margin 同样约束假设类的容量。
论文明确声明:虽然只在文本表征上做实验(为简化),但结论适用于任意模态、任意领域的单向量 embedding。
二、核心理论:向量 embedding 的表征容量¶
这是全文的骨架。作者从两条独立路径给出维度下界:(A)带 margin 的球堆积(sphere-packing)论证(正文 Theorem 1),以及 (B)无 margin 的 sign-rank 论证(附录 D)。两者互补——前者更贴合实际(模型有噪声、需要 score 间隔),后者给出更弱假设(无 margin)下的下界。
2.1 设置(Setup)¶
设 $v_1, \dots, v_n \in \mathbb{R}^d$ 是单位文档向量,query 也是单位向量 $u \in \mathbb{R}^d$(几乎所有 SOTA 检索模型都用归一化向量)。固定 margin $\gamma > 0$。
定义(带 margin 实现 $k$-子集):一个 $k$-子集 $S \subseteq [n]$ 被 query $u_S$ 以 margin $\gamma$ 实现,当且仅当存在单位 query 向量 $u_S$ 使得:
$$\min_{i \in S} \langle u_S, v_i \rangle \;\geq\; \max_{j \notin S} \langle u_S, v_j \rangle \;+\; 2\gamma \tag{1}$$
直观含义:$S$ 中所有相关文档的最低分,也要比 $S$ 外所有无关文档的最高分至少高出 $2\gamma$。这样才能用一个阈值干净地把相关/无关分开。
由于单位向量的内积落在 $[-1, 1]$,任意 score gap 最多为 2,因此式(1)只在 $0 < \gamma \le 1$ 时可行。全文 $\log$ 取自然对数。
2.2 Theorem 1(维度下界,球堆积证明)¶
Theorem 1:假设 $1 \le k < n$,且每一个 $k$-子集 $S \subseteq [n]$ 都能以 margin $\gamma$ 按式(1)实现。则:
$$\binom{n}{k} \;\le\; \left(1 + \frac{1}{\gamma}\right)^d, \qquad \text{因此} \qquad d \;\geq\; \frac{\log \binom{n}{k}}{\log(1 + 1/\gamma)}. \tag{2}$$
证明骨架(sphere packing / 体积论证)——这是全文最关键的一步,逻辑链条如下:
-
两两分离:取两个不同的 $k$-子集 $S \ne T$,选 $i \in S \setminus T$ 和 $j \in T \setminus S$。把式(1)分别用到 $S$(对 $i,j$)和 $T$(对 $j,i$): $$\langle u_S, v_i - v_j \rangle \ge 2\gamma, \qquad \langle u_T, v_j - v_i \rangle \ge 2\gamma.$$ 两式相加得 $\langle u_S - u_T,\; v_i - v_j \rangle \ge 4\gamma$。
-
query 之间被拉开:由 Cauchy–Schwarz 及单位向量性质 $\|v_i - v_j\| \le \|v_i\| + \|v_j\| = 2$,得 $$\|u_S - u_T\| \ge 2\gamma.$$ 也就是说,$M = \binom{n}{k}$ 个 query 单位向量 $\{u_S\}$ 两两之间的距离都 $\ge 2\gamma$。
-
小球互不相交:以每个 $u_S$ 为球心、$\gamma$ 为半径的开球 $B_d(u_S, \gamma)$ 两两不相交(因为球心间距 $\ge 2\gamma$)。又因 $\|u_S\| = 1$,每个小球都被包含在半径 $1+\gamma$ 的大球 $B(0, 1+\gamma)$ 内。
-
体积不等式:所有小球的体积之和不超过大球体积: $$M \cdot \mathrm{vol}\big(B_d(\gamma)\big) \;\le\; \mathrm{vol}\big(B_d(1+\gamma)\big).$$ $d$ 维球体积 $\mathrm{vol}(B_d(r)) = C_d\, r^d$(常数 $C_d$ 只依赖 $d$,会被约掉),于是 $$M \gamma^d \le (1+\gamma)^d \;\Longrightarrow\; \binom{n}{k} = M \le \left(\frac{1+\gamma}{\gamma}\right)^d = \left(1 + \frac{1}{\gamma}\right)^d.$$ 两边取对数、整理即得式(2)。$\blacksquare$
物理含义:要在 $d$ 维单位球面上塞下 $\binom{n}{k}$ 个两两相距 $\ge 2\gamma$ 的 query 点,$d$ 必须足够大。而"能实现所有 $k$-子集"恰好要求存在这么多两两分离的 query,于是维度存在一个由组合数 $\binom{n}{k}$ 决定的硬下界。margin $\gamma$ 越大(要求分离越干净),$\log(1+1/\gamma)$ 越小,需要的维度越高(可行性要求 $\gamma \le 1$,故分母至少是 $\log 2$)。
2.3 数值代入与渐近形式¶
取 $\gamma = 0.1$(score gap $2\gamma = 0.2$,符合实际经验),式(2)变为 $d \ge \lceil \log \binom{n}{k} / \log 11 \rceil$。当 $n \gg k$ 时,$\log \binom{n}{k} \approx k \log(en/k)$,于是得到渐近下界:
$$d \;=\; \Omega\!\left(\frac{k \log(en/k)}{\log(1 + 1/\gamma)}\right). \tag{3}$$
下面是 $\gamma = 0.1$ 时的维度下界表(Table 1)。这已经是极度乐观的下界(假设向量可自由优化、无 LM 约束):
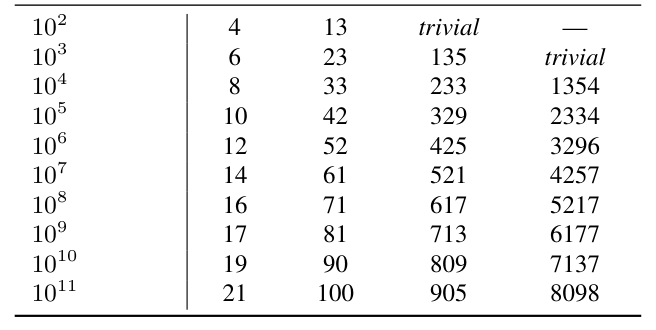
| 语料规模 $n$ | $k=2$ | $k=10$ | $k=100$ | $k=1000$ |
|---|---|---|---|---|
| $10^2$ | 4 | 13 | trivial | — |
| $10^3$ | 6 | 23 | 135 | trivial |
| $10^4$ | 8 | 33 | 233 | 1354 |
| $10^5$ | 10 | 42 | 329 | 2334 |
| $10^6$ | 12 | 52 | 425 | 3296 |
| $10^7$ | 14 | 61 | 521 | 4257 |
| $10^8$ | 16 | 71 | 617 | 5217 |
| $10^9$ | 17 | 81 | 713 | 6177 |
| $10^{10}$ | 19 | 90 | 809 | 7137 |
| $10^{11}$ | 21 | 100 | 905 | 8098 |
($n=k=1000$ 时结果 trivial,因为 $\binom{1000}{1000}=1$,只有一个 $k$-子集、没有"无关"文档需要分开。)
结论分析:对于 web-scale 检索($n$ 上亿、$k$ 上百甚至上千),所需维度已经超过当前实践中使用的维度(最大也就 4096,Zhang et al. 2025;很多因量化或 Matryoshka/MRL 截断而不足 1k,Kusupati et al. 2022)。而这还是最理想情况——一旦叠加梯度学习、需要泛化、自然语言 tokenization 等真实约束,实际所需维度会被一个乘子放大,从而彻底超出可行范围。
三、经验连接(一):最优情况下的自由 embedding 优化¶
理论下界是"必要条件",但真实模型可能达不到它。为验证这个限制在最强优化条件下也成立,作者设计了 free embedding(自由 embedding)优化实验。
核心思想:让向量本身可被梯度直接优化,不受任何自然语言约束——如果连自由 embedding 都解不出来,真实检索模型更不可能解出来。这可以视作"每个 query/doc 都是一个独立可查表的 embedding"的模型。
实验设置:
- 构造随机文档矩阵($n$ 个)和随机 query 矩阵,query 覆盖所有 top-$k$ 子集,即 $m = \binom{n}{k}$ 个 query,全部为单位向量。
-
用 Adam 优化器(Kingma & Ba 2014)直接优化,让 embedding 满足所有约束。每步梯度用全数据 batch(所有正确三元组),损失为 InfoNCE(Oord et al. 2018),把所有其他文档作为 in-batch 负例。因几乎所有 embedding 模型用归一化向量,这里也用投影梯度下降保持单位范数。损失形式: $$\mathcal{L}_{\text{total}} = -\frac{1}{M}\sum_{i=1}^{M} \log \frac{\sum_{d_r \in R_i} \exp(\mathrm{sim}(q_i, d_r)/\tau)}{\sum_{d_k \in D}\exp(\mathrm{sim}(q_i, d_k)/\tau)} \tag{4}$$ 其中 $D$ 是全部文档,$R_i$ 是 query $q_i$ 的相关文档集,$d_k$ 是非相关文档。(预实验中 InfoNCE 优于 MSE 和 Margin loss,因为它倾向拉出最宽的 margin。)
-
训练 1000 步,无提升则 early stopping。逐步增加文档数 $n$(进而增加组合 query 数),直到优化再也无法达到 100% 准确率——这个临界点称为 critical-$n$。
- 因组合爆炸(如 50k 文档、top-100 有 $7.7\times10^{311}$ 组合),实验聚焦相对小的 $n, k, d$,取 $k=2$,对每个 $d$ 逐一增大 $n$ 直到失败。
结果(Figure 2 / Table 6):critical-$n$ 与 $d$ 的关系可用三次多项式极好地拟合($r^2 = 0.999$): $$y = -10.5322 + 4.0309\,d + 0.0520\,d^2 + 0.0037\,d^3.$$
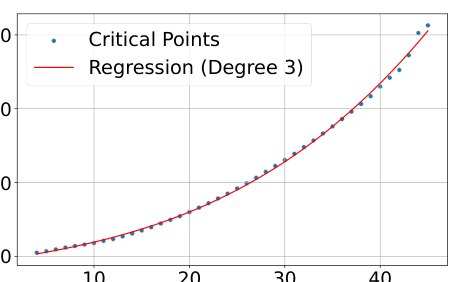
外推这条曲线得到各 embedding 尺寸的 critical-$n$(即使 top-$k$ 只有 2):
| embedding 维度 $d$ | critical-$n$(top-2 无法全部表示的临界语料规模) |
|---|---|
| 512 | 500k |
| 768 | 1.7m |
| 1024 | 4m |
| 3072 | 107m |
| 4096 | 250m |
关键分析:这已是最理想情况——真实模型无法直接对 test qrel 矩阵优化,还受"建模自然语言"等约束。对照 Table 1,$n=100$ 时理论下界只要 $d \ge 4$,但自由 embedding 实测需要 $d > 18$(约 4.5 倍乘子,且这还是无泛化、无自然语言的场景)。这印证了正文对"下界会被小乘子放大到不可行"的判断:即便最大的 embedding 维度,配上理想的 test-set 优化,也不足以建模 web-scale 检索的所有组合。
四、经验连接(二):真实世界数据集 LIMIT¶
自由 embedding 证明了理论在抽象层面成立。但对真实 embedding 模型意味着什么?作者据此构造 LIMIT 数据集。
4.1 与现有数据集的联系¶
现有检索数据集用静态、query 数量有限的评测集(relevance 标注昂贵),只能采样极小一部分潜在 query。例如 QUEST 有 325k 文档、每 query 20 个相关文档、共 3357 条 query;而所有可能的 top-20 文档集数量是 $\binom{325k}{20} \approx 7.1\times10^{91}$(比可观测宇宙原子数估计 $10^{82}$ 还大)。因此 3k 条 query 只覆盖了组合空间中无穷小的一部分。
现有数据集之所以只实例化部分组合,主要出于成本(评测昂贵)而非"这些组合不存在"。随着 search agent 兴起(如 BrowseComp,Wei et al. 2025,每 query 5+ 条件含 range 算子),用户完全可以用足够表达力的算子选出任意 top-$k$ 相关集。
4.2 LIMIT 数据集构造¶
作者不用 QUEST/BrowseComp 那种"因 query 算子难而难"的路径,而是故意用极简 query 和文档来凸显"表示所有 top-$k$ 集本身"的难度。
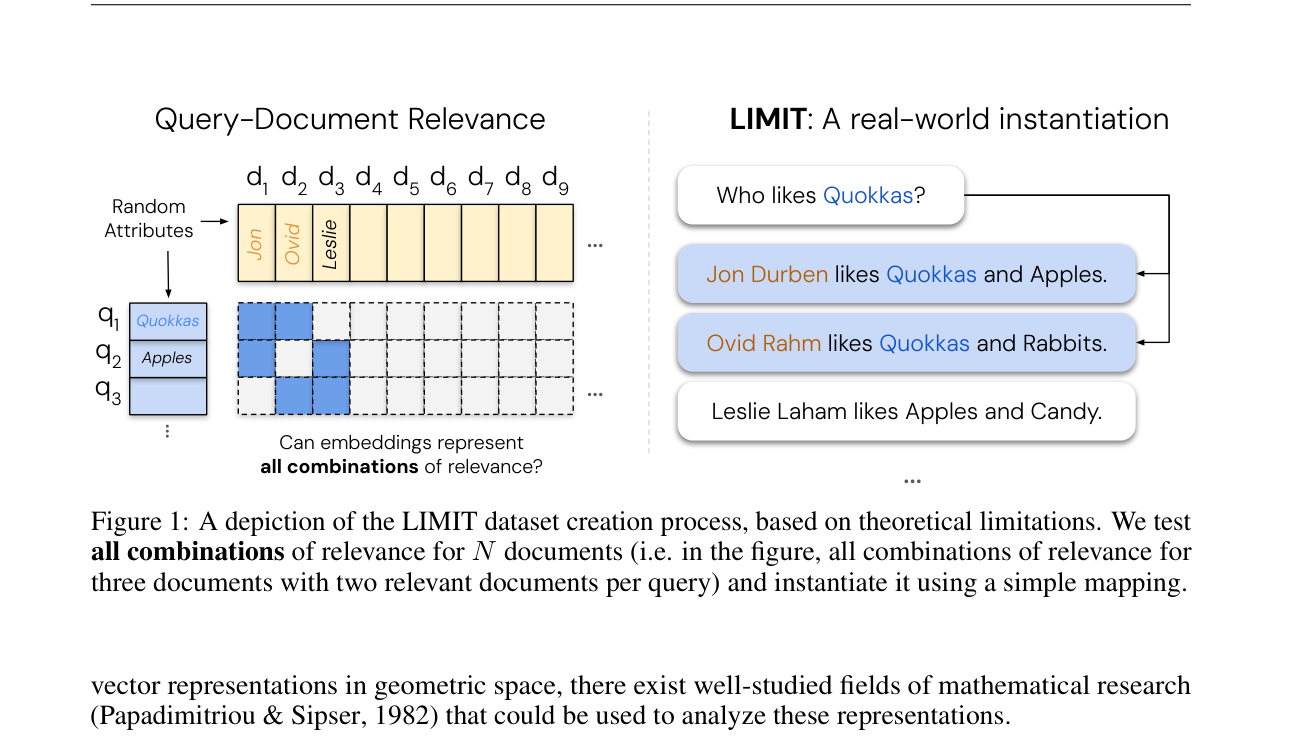
构造流程:
- latent 结构:先造一个 query/document 带 latent 变量的合成版本,再用自然语言实例化。映射选用"某人喜欢的属性"(如 Jon 喜欢 Hawaiian pizza、sports cars 等),因为这类属性无穷多且相互不冲突(一个人可以喜欢很多东西,各偏好都合法)。
- realism 约束:(1) 每人属性不能太多(每 user < 50 个),保持文档简短;(2) 每 query 只问一个物品以保持简单("who likes X")。
- 用 Gemini 2.5 Pro 收集属性列表,迭代清洗到最终 1850 个 items(去重/去上位词,并用 BM25 检查确保无重叠)。
- 选 qrel 矩阵:直觉上(虽无法严格证明是最难 qrel)qrel 越稠密(文档间越互联、越接近覆盖所有组合),模型越难表示。因此选用"top-$k=2$ 时所有组合恰好略超过 1000 个 query"的 qrel——46 个文档(因为 $\binom{46}{2} = 1035 > 1000$,是超过 1k 的最小值)。
- 给每个 query 分配随机自然语言属性并加到对应相关文档上(如图中 Jon Durben likes Quokkas and Apples);给每个文档随机的姓名(open-source 名单);随机采样新属性使所有文档属性数相同。
- 用 50k 文档 + 1000 query(保持统计显著又便于评测)。每 query 用 2 个相关文档($k=2$),既简化实例化又对齐 NQ/HotpotQA 等前作。
两个版本:
- LIMIT(full):50k 文档,其中 46 个是相关文档、49.95k 个是任意 query 都不相关的干扰文档。
- LIMIT small($N=46$):只留那 46 个相关文档,是最难的核心。这 46 个文档在自由 embedding 实验中只需 12 维即可完全嵌入,但真实模型即便 64 维也解不了。
4.3 评测的模型与设置¶
- 单向量 embedding 模型:GritLM 7B(Muennighoff et al. 2024)、Qwen 3 Embeddings(Zhang et al. 2025)、Promptriever Llama3 8B(Weller et al. 2024b)、Gemini Embeddings(Lee et al. 2025)、Snowflake Arctic Embed Large v2.0(Yu et al. 2024)、E5-Mistral 7B Instruct(Wang et al. 2022, 2023)。维度范围 1024–4096,训练风格各异(instruction-based、hard negative 等)。
- 非单向量模型(作对照):BM25(稀疏词法,Robertson et al. 1995)、gte-ModernColBERT(多向量,Chaffin 2025a)、以及一个 token-wise TF-IDF 模型。后者把每个 unique item 变成一个 token 再做 TF-IDF,能 100% 解出所有任务(因为它逆向工程了数据集构造),仅用于证明"高维度可解",不纳入正式图表。
- MRL 截断:对训练时用了 Matryoshka(MRL,Kusupati et al. 2022)的模型,也评测截断后的维度(图中带星标)。因无 LLM 的 embedding 维度小于 384,对所有模型都加入小维度(32)以展示维度的影响。
- 推理:用 MTEB 框架默认长度设置;因文档短(约 100 token),不受影响。
4.4 主要实验结果¶
LIMIT full(Figure 3 / Table 5):即便任务极简,SOTA 模型也严重失败——full 版本上模型连 recall@100 都难到 20%。
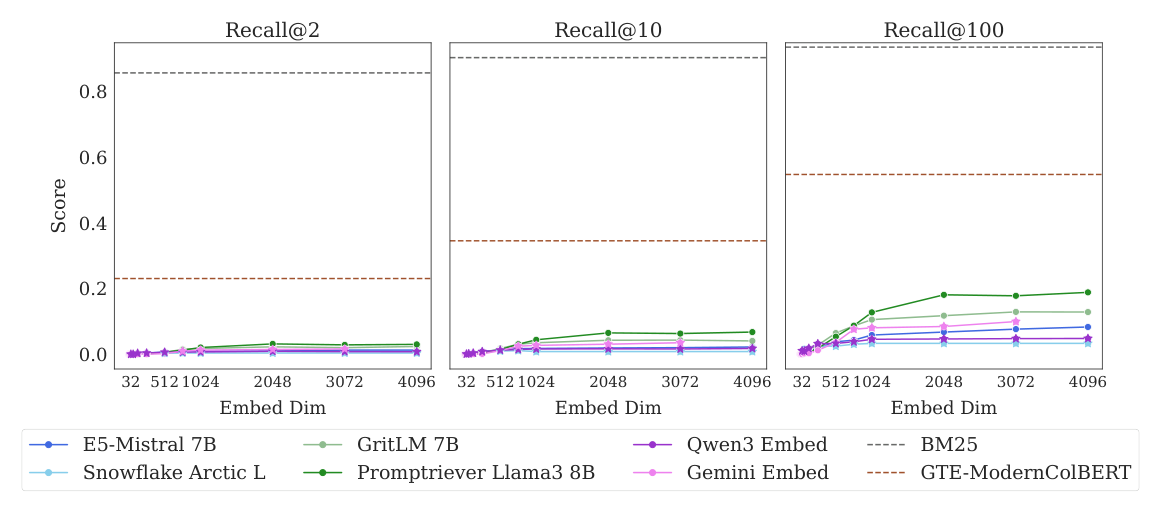
LIMIT full 关键数值(Recall,小数制见下节 benchmark;此处用原文百分数):
| Model | Dim | Recall@2 | Recall@10 | Recall@100 |
|---|---|---|---|---|
| BM25 | default | 85.7 | 90.4 | 93.6 |
| GTE-ModernColBERT(多向量) | default | 23.1 | 34.6 | 54.8 |
| GritLM 7B | 4096 | 2.4 | 4.1 | 12.9 |
| Promptriever Llama3 8B | 4096 | 3.0 | 6.8 | 18.9 |
| E5-Mistral 7B | 4096 | 1.3 | 2.2 | 8.3 |
| Qwen3 Embed | 4096 | 0.8 | 1.8 | 4.8 |
| Gemini Embed | 3072 | 1.6 | 3.5 | 10.0 |
| Snowflake Arctic L | 4096 | 0.4 | 0.8 | 3.3 |
分析:BM25(词法、高有效维度)几乎横扫单向量神经模型;多向量的 GTE-ModernColBERT 明显优于单向量模型(但仍远未解决);单向量模型即使 4096 维、recall@100 也多在个位数到十几。
LIMIT small($N=46$,Figure 4 / Table 4):仅 46 个文档,模型连 recall@20 都无法解出。
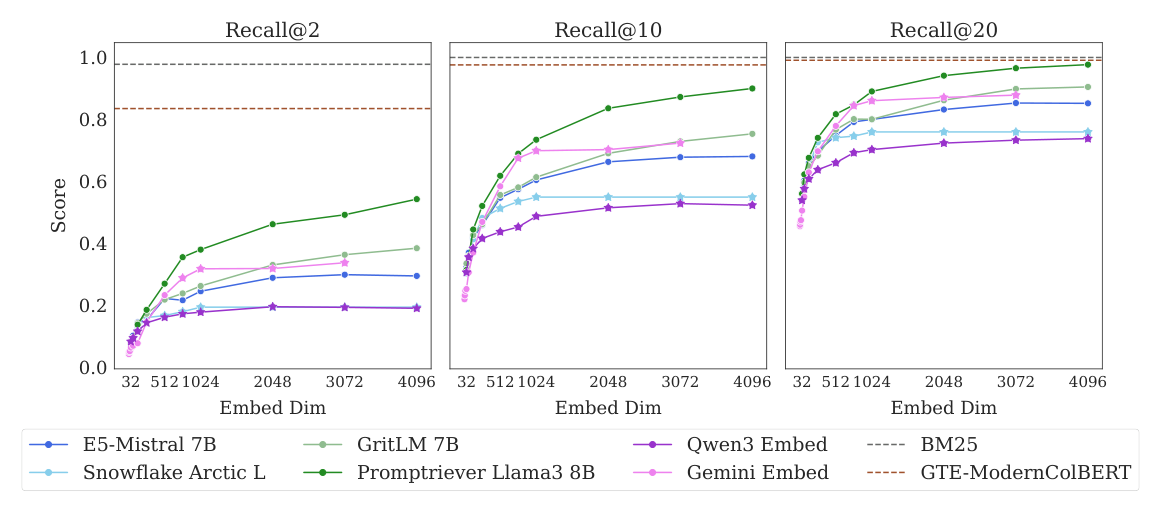
LIMIT small 部分数值(各模型全维度):
| Model | Dim | Recall@2 | Recall@10 | Recall@20 |
|---|---|---|---|---|
| BM25 | default | 97.8 | 100.0 | 100.0 |
| GTE-ModernColBERT | default | 83.5 | 97.6 | 99.1 |
| Promptriever Llama3 8B | 4096 | 54.3 | 90.0 | 97.7 |
| GritLM 7B | 4096 | 38.4 | 75.4 | 90.5 |
| E5-Mistral 7B | 4096 | 29.5 | 68.1 | 85.2 |
| Gemini Embed | 3072 | 33.7 | 72.4 | 87.9 |
| Qwen3 Embed | 4096 | 19.0 | 52.3 | 73.8 |
| Snowflake Arctic L | 4096 | 19.4 | 54.9 | 76.0 |
分析:性能随 embedding 维度增大而提升,印证"维度是瓶颈"。训练更多样 instruction 的模型(如 Promptriever)表现更好——作者推测它们的训练允许使用更多 embedding 空间,而 MRL 训练、任务范围窄的模型可能把表征压进了更小的子流形。
4.5 这是 domain shift 吗?——不是(Figure 5 / Table 3)¶
作者担心低分是否源于 domain shift。他们拿一个现成 embedding 模型(lightonai/modernbert-embed-large),分别在 LIMIT 的训练集(用非 test 属性合成)和官方 test 集上 fine-tune(SentenceTransformers,MultipleNegativesRankingLoss,全数据 batch + no-duplicates sampler,学习率 5e-5,5 epochs,训练集裁到 test 大小 2k),并用 projection 展示不同维度。
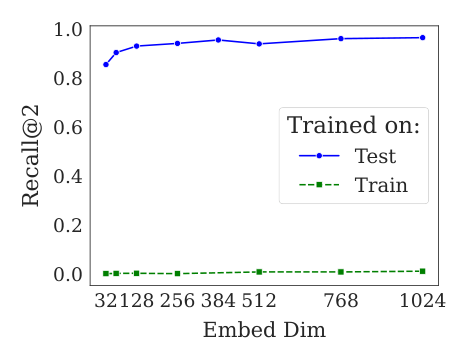
Fine-tuning 结果(Table 3,百分数):
| Split | Dim | Recall@2 | Recall@10 | Recall@100 |
|---|---|---|---|---|
| Test | 32 | 85.5 | 98.4 | 100.0 |
| Test | 64 | 90.4 | 98.7 | 100.0 |
| Test | 1024 | 96.5 | 99.8 | 100.0 |
| Train | 32 | 0.0 | 0.0 | 0.0 |
| Train | 64 | 0.1 | 0.3 | 2.2 |
| Train | 1024 | 1.0 | 2.8 | 11.2 |
分析:在训练集上训练几乎没帮助(recall@10 从近 0 到最多 2.8),说明问题不是 domain shift。但在 test 集上训练能学会(因为过拟合到 test query 的 token,类似自由 embedding),这与自由 embedding 结论一致:$N=46$ 只需 12 维即可过拟合。值得注意的是,即使 64 维的真实模型也无法完全解出,说明真实模型显著劣于 §2 的理论下界。
4.6 词法模型不是万能药(Figure 6)¶
BM25 在 LIMIT 上大幅领先,是否说明"回退到词法就够了"?作者构造 LIMIT small(synonym) 版本:用 Gemini 2.5 Pro 把语料中所有 item 替换为不与现有属性/原词重叠的同义词或上位词(如 glasses→spectacles),降低词法重叠。
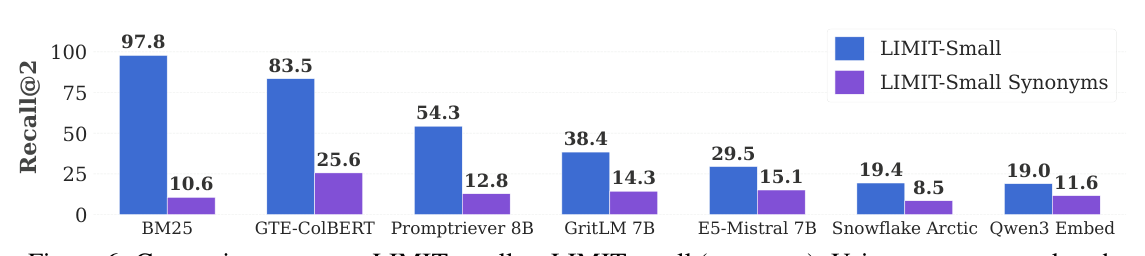
Recall@2 对比(LIMIT-Small → Synonym 版):
| Model | LIMIT-Small | Synonym | 下降 |
|---|---|---|---|
| BM25 | 97.8 | 10.6 | ≈ −89% |
| GTE-ColBERT | 83.5 | 25.6 | −69% |
| Promptriever 8B | 54.3 | 12.8 | −76% |
| GritLM 7B | 38.4 | 14.3 | −63% |
| E5-Mistral 7B | 29.5 | 15.1 | −49% |
| Snowflake Arctic | 19.4 | 8.5 | −56% |
| Qwen3 Embed | 19.0 | 11.6 | −38.9% |
分析:加同义词后所有模型都变差,但 BM25 骤降近 90%,甚至跌到大多数单向量模型之下。因此词法模型有自己的弱点(缺乏 paraphrase/instruction-following 能力),并非灵丹妙药——它的高维度优势只在有词法重叠时才成立。
五、替代架构分析(§5.3)¶
理论与实证都表明:单向量模型受 embedding 维度根本性限制,无法表示所有 top-$k$ 组合。作者逐一分析替代路线:
- Cross-Encoders(重排器):虽不适合大规模一阶段检索(通常用于二阶段重排),但不受 embedding 维度限制。作者用长上下文 reranker Gemini-2.5-Pro(Comanici et al. 2025),一次前向给它 46 个文档 + 1000 条 query,让它一次生成输出每 query 的相关文档——100% 解出全部 1000 条 query(对比最好的单向量模型 recall@2 < 60%)。说明 LIMIT 对 SOTA reranker 是简单任务。
- Multi-vector 模型:通过每序列多个向量 + MaxSim 算子(ColBERT,Khattab & Zaharia 2020)更具表达力,在 LIMIT 上明显优于单向量模型(即使骨干更小,ModernBERT)。但多向量通常不用于 instruction-following / reasoning 任务(Reason-ModernColBERT 是少数例外),能否迁移仍是开放问题。
- Sparse 模型(词法或神经,如 BM25):可看作高维度的单向量,高维帮它避开神经 embedding 的组合问题。但难以应用到没有词法/paraphrase 重叠的 instruction-following / reasoning 任务。
作者强调这些替代方案各有权衡,没有一条清晰的解决路径,把"从根本上解决单向量模型此问题"(如 hypercoders,Killingback et al. 2025,或尚待开发的新单向量架构)留给未来工作。
六、附录理论补充:Sign-Rank 证明(Appendix D)¶
正文 Theorem 1 是带 margin 的球堆积论证。附录 D 给出一条独立、无 margin的路径,把检索表征能力与经典的 sign-rank 概念挂钩——这是理论骨架的第二根支柱,也是作者在初版论文里最先用的证明。
6.1 形式化(D.1)¶
考虑 $m$ 个 query、$n$ 个文档,ground-truth relevance 矩阵 $A \in \{0,1\}^{m\times n}$(qrel 矩阵),$A_{ij}=1$ 当且仅当文档 $j$ 与 query $i$ 相关。embedding 模型把 query 映射到 $u_i \in \mathbb{R}^d$、文档到 $v_j \in \mathbb{R}^d$,用点积 $u_i^T v_j$ 建模 relevance,目标是相关文档得分高于无关文档。把 query 向量拼成 $U \in \mathbb{R}^{d\times m}$、文档向量拼成 $V \in \mathbb{R}^{d\times n}$,则 score 矩阵 $B = U^T V$。能实现给定 score 矩阵的最小维度 $d$,正是 $B$ 的秩(rank)。于是问题变成:找到能按 $A$ 正确排序文档的 score 矩阵 $B$ 的最小秩。
6.2 三种"秩"的定义(D.1)¶
- Row-wise order-preserving rank(按行保序秩)$\mathrm{rank}_{\text{rop}} A$:存在秩为 $d$ 的 $B$,在每一行内保持 $A$ 各元素的相对大小(对所有 $i,j,k$,$A_{ij}>A_{ik} \Rightarrow B_{ij}>B_{ik}$)的最小 $d$。这正是"任意向量 embedding 模型对所有 query 把相关文档排在无关之前"所需的最小维度。
- Row-wise thresholdable rank(按行可阈值秩)$\mathrm{rank}_{\text{rt}} A$:存在每行各自的阈值 $\tau_i$ 把 1 和 0 干净分开的最小秩。
- Globally thresholdable rank(全局可阈值秩)$\mathrm{rank}_{\text{gt}} A$:存在单一全局阈值 $\tau$ 分开 1 和 0 的最小秩。
6.3 关键命题与 sign-rank 链(D.2)¶
- Proposition 1:对二元矩阵 $A$,$\mathrm{rank}_{\text{rop}} A = \mathrm{rank}_{\text{rt}} A$(按行保序 = 按行可阈值,二者等价)。证明分 $\le$ 和 $\ge$ 两向:可阈值 $\Rightarrow$ 保序显然;反向对每行取 $\tau_i = (\max L_i + \min U_i)/2$($U_i$ 为相关得分集、$L_i$ 为无关得分集)构造阈值。
- Sign Rank(定义 3):矩阵 $M \in \{-1,1\}^{m\times n}$ 的 sign-rank $\mathrm{rank}_\pm M$ 是最小的 $d$,使得存在秩 $d$ 的 $B$ 与 $M$ 逐元素同号。
- Proposition 2:对二元 $A$,有 $2A - \mathbf{1}_{m\times n} \in \{-1,1\}^{m\times n}$,且成立不等式链 $$\mathrm{rank}_\pm(2A - \mathbf{1}_{m\times n}) - 1 \;\le\; \mathrm{rank}_{\text{rop}} A = \mathrm{rank}_{\text{rt}} A \;\le\; \mathrm{rank}_{\text{gt}} A \;\le\; \mathrm{rank}_\pm(2A - \mathbf{1}_{m\times n}).$$ 证明分三段:(1) $\mathrm{rank}_{\text{rt}} A \le \mathrm{rank}_{\text{gt}} A$(全局阈值是按行阈值的特例);(2) $\mathrm{rank}_{\text{gt}} A \le \mathrm{rank}_\pm(2A-\mathbf{1})$(同号矩阵取阈值 0 即满足全局阈值);(3) $\mathrm{rank}_\pm(2A-\mathbf{1}) - 1 \le \mathrm{rank}_{\text{rt}} A$(把按行阈值秩为 $r$ 的 $B$ 减去 $\tau \mathbf{1}_n^T$,其符号与 $2A-\mathbf{1}$ 一致,秩最多增加 1)。
意义(D.3):这把"精确捕捉某个检索 qrel 所需的向量维度"夹在 sign-rank 的上下界之间——至少 $\mathrm{rank}_\pm(2A-\mathbf{1})-1$ 维,至多 $\mathrm{rank}_\pm(2A-\mathbf{1})$ 维。Alon et al. (1985) 的 cyclotomic polynomial 构造表明:任意 qrel 矩阵的 sign-rank 最多为 $2k$($k$ 为单 query 最大相关文档数)。但该构造得到非归一化向量,且需要无限精度,与 Theorem 1 一致——实践中不可行。
6.4 与 Order-$k$ Voronoi 的关系(Appendix A)¶
order-$k$ Voronoi 区域数量对应"能返回的 top-$k$ 组合数",与检索天然对应;但对 $d > 3$ 计算不可行且难以紧界(Clarkson 1988;Bohler et al. 2015)。作者因此改用 sphere-packing 这条更可操作的路径。
6.5 qrel 稠密度指标(Appendix F)¶
作者用两个图论指标佐证"qrel 越稠密越难":
- Graph Density(文档-文档图,两文档若共享至少一个 query 则连边):$\rho = 2|E| / (|V|(|V|-1))$;
- Average Query Strength(query-query 图,边权为相关文档的 Jaccard 相似度):$\bar{s} = \frac{1}{|V_Q|}\sum_i s_i$,$s_i = \sum_{j\in N(i)} w_{ij}$。
Table 2 显示 LIMIT 的这两个指标远高于标准 IR 数据集,最接近的是 instruction-following 数据集 FollowIR Core17:
| Dataset | Graph Density | Avg Query Strength |
|---|---|---|
| NQ | 0 | 0 |
| HotPotQA | 0.000037 | 0.1104 |
| SciFact | 0.001449 | 0.4222 |
| FollowIR Core17 | 0.025641 | 0.5912 |
| LIMIT | 0.085481 | 28.4653 |
这暗示(虽不能严格证明)qrel 稠密度高的数据集对检索模型更难——而 instruction-following 数据集正朝这个方向走。
6.6 BEIR 与 LIMIT 无相关性(Appendix D.4,Figure 7)¶
BEIR(MTEB v1 常被指为 embedding 模型过拟合对象)分数与 LIMIT 分数无明显相关:小模型(如 Arctic Embed)在两者上都差(受维度和预训练知识限制),但整体不相关(如 Qwen3/Gemini 的 BEIR 高但 LIMIT R@100 反而不高)。说明 LIMIT 测的是正交于 BEIR 的能力维度。
| Model | BEIR | LIMIT R@100 |
|---|---|---|
| Snowflake Arctic | 55.22 | 3.3 |
| Promptriever | 56.40 | 18.9 |
| E5-Mistral | 57.07 | 8.3 |
| GritLM | 57.40 | 12.9 |
| Gemini Embed | 62.65 | 10.0 |
| Qwen3 Embed | 62.76 | 4.8 |
七、核心贡献总结¶
- 理论基础:首次给出 embedding 维度 $d$ 与其能检索的 top-$k$ 组合数量之间的严格连接。用球堆积(Theorem 1,带 margin)和 sign-rank(Appendix D,无 margin)两条独立路径证明——对任意检索模型、任意训练数据,都存在无法被返回的 top-$k$ 组合。
- 最优情况实证:free embedding 优化(直接对 test qrel 梯度优化,无自然语言约束)表明理论限制在最强优化条件下也成立,且 critical-$n$ 与 $d$ 可用三次多项式建模($r^2=0.999$)。
- 真实数据集 LIMIT:一个 query/文档都极简、却让所有 SOTA 单向量 embedding 模型失败的自然语言数据集。证明这不是 domain shift、不能靠词法模型兜底、与 BEIR 正交,且对 cross-encoder / 多向量模型可解——把问题精确定位到"单向量 embedding 维度"这一根因。
八、讨论与局限性¶
值得借鉴的设计:
- "最优情况实证"方法论——用 free embedding(可对 test 直接优化)作为"上界探针",把抽象的理论下界转成可观测的 critical-$n$ 曲线。这种"如果连作弊都解不了,真实模型必然解不了"的论证方式非常干净,值得在做能力上界分析时借鉴。
- 从理论反推数据集构造——LIMIT 不是先有数据再解释,而是先有 sphere-packing/sign-rank 理论,再据"qrel 越稠密越难"直觉选出 $\binom{46}{2}$ 略超 1000 的最难小配置。极简 query("who likes X")反而暴露了组合表示的根本困难。
- margin 的作用——把 margin $\gamma$ 引入下界($\log(1+1/\gamma)$ 项)连接了 IR 检索与 margin-based 学习理论(fat-shattering、SVM 泛化界),是漂亮的跨领域桥接。
核心局限(作者自陈 + 精读判断):
- 仅覆盖单向量模型:理论只对 single-vector 严格成立。多向量(MaxSim)、cross-encoder、sparse 模型的理论界作者未给出,留作未来工作(初步实证显示这些架构能解 LIMIT)。
- "允许部分错误"未建模:理论要求实现所有 $k$-子集且带 margin。如果只要求捕捉大多数组合(允许少量错误),下界会松弛多少,作者未给界(提到可参考 Ben-David et al. 2002)。这是实践中很关键的松弛——真实系统未必需要 100% 覆盖所有组合。
- 无法预判失败的组合类型:证明了"某些组合无法表示",但无法先验判断是哪类组合。因此某些 instruction-following/reasoning 任务或许恰好能完美解出;只是一定存在某些任务永远解不出。
- sign-rank 构造的 caveat:Alon et al. 的 $2k$ sign-rank 上界给的是非归一化、无限精度向量,实践不可行;这也解释了为何真实模型远达不到理论下界(真实模型受 $d$、梯度学习、自然语言 tokenization 三重约束)。
对社区的启示:一方面,学术 benchmark 只测了极小一部分潜在 query(且常被过拟合),掩盖了这些限制;另一方面,随着任务要求返回越来越多的 top-$k$ 组合(如用逻辑算子连接原本无关的文档),必然触及组合表示上限。社区应在设计 eval 时意识到这一点,并在需要处理"任意 query、任意 relevance"时转向 cross-encoder / 多向量 / 更具表达力的相似度函数,或研究能突破此根本限制的新单向量架构。