Qwen3.8-Next 架构设计:评测、效率与训练稳定性¶
Qwen Team(阿里巴巴)· arXiv:2608.30320 · 2026-08-31 · 28 页架构设计报告 Qwen3.8-Flash-Next:125B 总参数 / 6B 激活的稀疏 MoE,外加 51B 不放在加速器上的 n-gram 嵌入表参数
研究动机与背景¶
这不是一篇"提出一个新模块并证明它涨点"的论文,而是一篇设计方法论报告:Qwen 团队把 Qwen3.8-Flash-Next 的每一个候选架构改动,都放在三根轴上同时评估,并且刻意报告"三根轴互相打架"的那些位置。
三根轴是:
- loss 与下游 benchmark(能力);
- 训练、prefill、decode 三个阶段各自的成本(效率);
- 该改动对最优超参数与训练稳定性的影响(可训练性)。
论文的核心论断写在摘要末尾:"Loss, benchmarks, efficiency and stability form one design problem. Solved jointly, they yield a recipe that is simultaneously more efficient, more capable and more stable."(loss、benchmark、效率与稳定性是同一个设计问题;联合求解才能得到同时更高效、更强、更稳的配方。)
设计目标:用远小于前代的算力,保住上一代 397B-A17B 旗舰(Qwen3.7-Plus)的质量。最终结果是:在 14 个预训练 benchmark 上,Flash-Next-Base 在 8 个上领先 Qwen3.7-Plus-Base,在其余 6 个上最多落后 2.6 分,而它只用了约 1/3 的激活参数、1/3 的训练 token,合计约 1/9 的训练 FLOPs。
论文指出,一次架构改动同时触碰三件事:模型在下游任务上能做什么、训练与服务要花多少钱、以及大规模训练还能不能保持最优且稳定。所以他们对每个候选改动分别在三根轴上报告,并在正文中反复标注"三根轴意见不一致"的地方——这些不一致恰恰是最有价值的设计信息:
- 放大 n-gram 词表会让 loss 单调下降,但下游准确率饱和(Tab. 9);在固定参数预算下,loss 最优点与准确率最优点甚至分离(Tab. 8)。
- 反过来,把残差的读/写权重改成由残差状态预测(data-dependent),loss 只降 0.002,benchmark 却涨 1.98 分(Tab. 5)。
- 有些分歧很晚才浮现:把每个 block 限制为只读取门控值最高的两条残差分支,在预训练 loss 上几乎免费,但后训练之后质量明显退化;把全注意力层的位置编码去掉(NoPE),预训练期间与 RoPE 无法区分,但后训练后无限生成(endless generation)的比例显著更高。
四个架构组件各自针对一个瓶颈:
| 组件 | 针对的瓶颈 | 一句话方案 |
|---|---|---|
| GDN / 全注意力逐层混合 | 全注意力 $O(n^2)$ 计算 + KV cache 线性增长 | 3 层 Gated DeltaNet + 1 层全注意力为一个 block,循环堆叠 |
| Qwen Sparse Attention (QSA) | 稀疏注意力的 indexer 本身是 $O(n^2)$,长序列下开销不可忽略 | 用压缩轻量 indexer 在微块(micro-block)粒度打分,indexer 降到 $O(n^2/r)$ |
| Gated Residual (GR) | pre-norm 单一残差流被后写入的内容"冲淡",且高学习率下靠激活 outlier 自我 rescale 导致 loss spike | 残差流拓宽为 4 条分支,读取端用逐元素 sigmoid 门 |
| N-gram 嵌入层 | 参数容量只能靠 MoE 专家堆在加速器显存里 | 单层 n-gram 嵌入表放主存、异步预取,几乎零 per-token FLOPs |
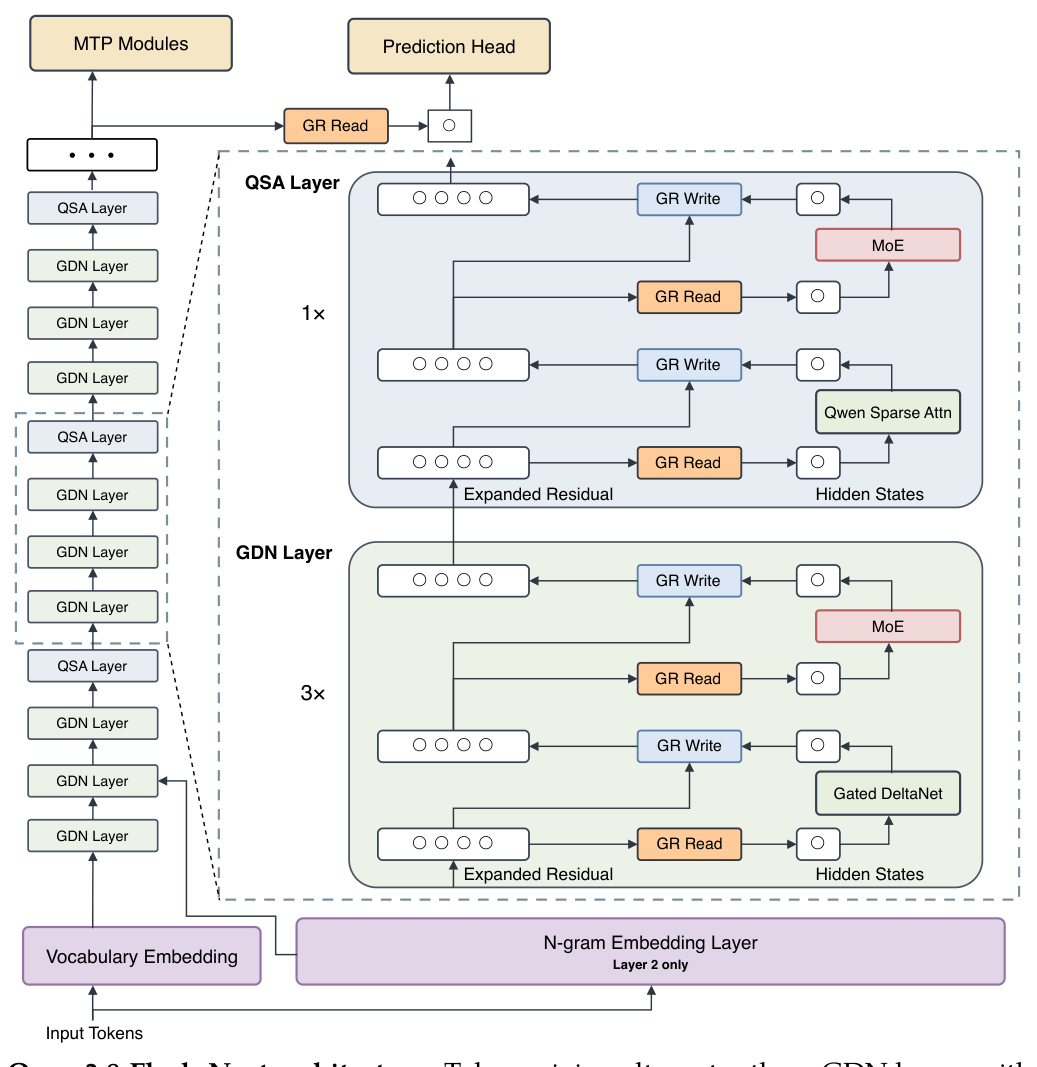
从 Figure 1 可以读出完整数据流:输入 token → Vocabulary Embedding → 第 2 层挂 N-gram Embedding Layer → 主干重复「GDN, GDN, GDN, QSA」四层为一组 → 每个子层(token mixer 与 MoE)都通过 GR Read(4 分支读入)和 GR Write(写回 4 分支)与残差流交互 → 末端 3 个 MTP 模块做多 token 预测,且 MTP 跨投机解码步复用 QSA 的 top-k 索引。
核心方法一:GDN 混合架构(§2.1.1)¶
动机¶
全自注意力提供对每个前序 token 的直接内容寻址,但 token mixing 成本随序列长度二次增长,KV cache 在自回归生成中线性增长。滑动窗口注意力(SWA)把全局访问换成有界的局部感受野,同时省下计算与 cache,但窗口外的信息只能靠深度间接传播。论文把这称为"高效局部处理与持久的内容相关记忆之间的张力"。
解法是 Gated DeltaNet (GDN) 与全局注意力的逐层混合:GDN 把前缀压进一个固定大小的循环状态并按当前内容更新它;穿插的全局注意力层保留任何有限状态记忆都无法精确复现的 token 级直接检索。
Gated Delta 递归¶
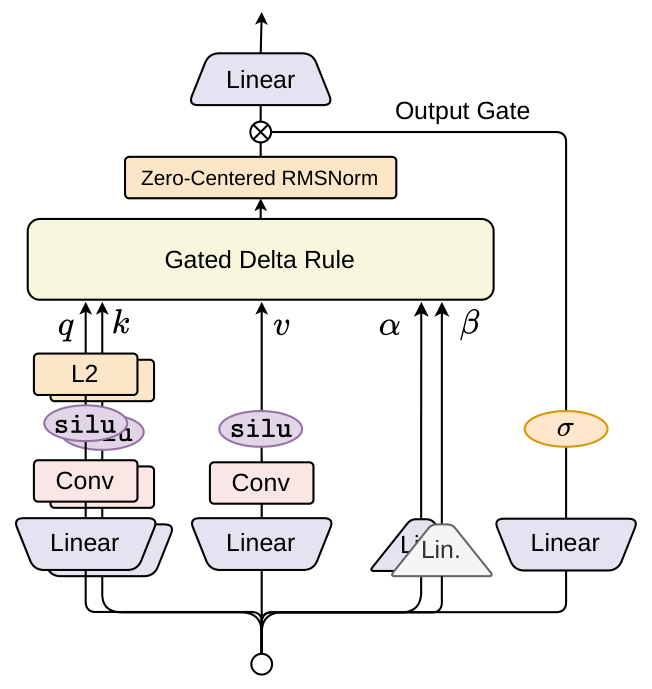
线性注意力可以理解为把 key–value 关联存进矩阵状态的 fast-weight memory。对每个 head,令 $q_t, k_t \in \mathbb{R}^{d_k}$,$v_t \in \mathbb{R}^{d_v}$。GDN 维护状态 $S_t \in \mathbb{R}^{d_k \times d_v}$(注意这是原始表述中状态约定的转置),应用 gated delta 规则:
$$\tilde S_{t-1} = \alpha_t S_{t-1} \tag{1}$$
$$e_t = v_t - \tilde S_{t-1}^{\top} k_t \tag{2}$$
$$S_t = \tilde S_{t-1} + \beta_t k_t e_t^{\top} \tag{3}$$
$$y_t = S_t^{\top} q_t \tag{4}$$
其中 $\alpha_t \in (0,1)$ 是数据相关的衰减,$\beta_t \in (0,1)$ 控制 delta 更新强度。等价地可以写成闭式:
$$S_t = \alpha_t \left( I - \beta_t k_t k_t^{\top} \right) S_{t-1} + \beta_t k_t v_t^{\top} \tag{5}$$
两个门的分工是互补的:衰减 $\alpha_t$ 全局控制既有状态的寿命;delta 项先估计已经和 $k_t$ 关联的值($\tilde S_{t-1}^{\top} k_t$),只写入残差误差 $e_t$。这样重复或相似的 key 会更新已有关联,而不是无止境地累加外积。这个"定向擦除—写入"操作正是 GDN 区别于纯加性线性注意力的地方。
GDN 参数化¶
给定归一化后的残差流输入 $x_t \in \mathbb{R}^d$:
$$q_t = \mathrm{L2Norm}\left( \mathrm{SiLU}\left( \mathrm{ShortConv}(W_q x_t) \right) \right) \tag{6}$$
$$k_t = \mathrm{L2Norm}\left( \mathrm{SiLU}\left( \mathrm{ShortConv}(W_k x_t) \right) \right) \tag{7}$$
$$v_t = \mathrm{SiLU}\left( \mathrm{ShortConv}(W_v x_t) \right) \tag{8}$$
短卷积在信息被压进循环状态之前提供显式的局部归纳偏置;$\mathrm{L2}$ 归一化界住 $q/k$ 的幅度,稳定 rank-1 的 delta 转移。写入强度与衰减参数化为:
$$\beta_t = \sigma(W_\beta x_t) \tag{9}$$
$$\alpha_t = \exp\left[ -\exp(A)\,\mathrm{softplus}(W_\alpha x_t + b_\alpha) \right] \tag{10}$$
跨 head 独立执行递归后,head 输出被归一化并由输入相关的输出门调制:
$$o_t = W_o \left[ \sigma(W_z x_t) \odot \mathrm{RMSNorm}(y_t) \right] \tag{11}$$
与原始 GDN 的两处差异:(a) 原始 GDN 用 SiLU 输出门,本文改用有界的 sigmoid 门(式 11),并观察到跨实验的一致提升;(b) 沿用 Qwen3-Next 的 zero-centered RMSNorm 约束 RMSNorm 权重的增长,并把同一形式一致地用到模型中所有 RMSNorm 层。
位置编码与混合比¶
混合架构在全注意力层保留 RoPE。RoPE 与 NoPE(无位置编码)变体在预训练期间差别很小,但 NoPE 变体在后训练之后无限生成的比例显著更高,更容易无法终止——这是论文列举的第二个"预训练指标看不出、后训练才暴露"的例子。混合比定为每四层放一层全注意力,其余三层用 GDN,论文表述为"这个排布在效率与质量之间取得了有利的平衡,同时周期性全注意力对长上下文性能尤为重要"。
复核提示:混合比 1:4 本身没有做扫描消融(没有 1:2 / 1:8 的对照),是论文直接给出的设定;RoPE-vs-NoPE 的结论也只有定性叙述("substantially higher rate of endless generation"),没有给出可复现的数值。
架构消融(Table 1)¶
三个 checkpoint 用同一评测流水线对比:全注意力 Transformer、SWA 混合、GDN 混合。两个混合变体都是每四层一层全注意力,其余分别用 SWA(窗口 128)或 GDN。每个 checkpoint 都是基于 Qwen3.5 架构的 28 层 25B-A3B MoE,先在 4K 上下文上预训练 400B token,再在 32K 上下文上训练 80B token。
| Architecture | MMLU | MMLU-Pro | SuperGPQA | MATH | GSM8K | BBH | MMMLU | EvalPlus | MultiPL-E | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|
| Full attention | 62.65 | 37.59 | 21.76 | 49.40 | 75.13 | 63.78 | 47.74 | 51.01 | 39.73 | 49.87 |
| SWA hybrid | 66.30 | 40.67 | 22.45 | 45.48 | 74.22 | 65.88 | 51.33 | 52.12 | 41.93 | 51.15 |
| GDN hybrid | 66.26 | 42.82 | 23.45 | 53.98 | 77.07 | 68.72 | 54.83 | 49.71 | 47.48 | 53.81 |
结论分析:GDN 混合在 9 个中的 8 个上优于 Transformer,在 7 个上优于 SWA 混合,取得 7 项最佳与最高总均值(53.81,比全注意力高 3.94 分);SWA 混合仅在 MMLU 上微弱领先、在 EvalPlus 上明显更强。差距最大的是 MultiPL-E(+7.75 over full attention)与 MATH(+4.58)。但论文自己承认:"These results motivate a hybrid design, but they do not by themselves isolate which architectural component causes each improvement."(这些结果支持混合设计,但它们本身并不能隔离出是哪个架构组件造成了各项提升。)这是全文最诚实的一句自我限定,也是复核时最需要抓住的一点。
Kernel 效率¶
GDN kernel 用 FlashQLA 优化——一个基于 TileLang 的融合线性注意力 kernel 库。在 NVIDIA GPU 的多种设定下,FlashQLA 相对 FLA Triton kernel 取得 2–3× 前向加速与约 2× 反向加速。实现与 benchmark 开源在 QwenLM/FlashQLA。
复核提示:这是实测加速比,但只有一句话、没有表格,也没有指明 GPU 型号与具体设定("across multiple settings on NVIDIA GPUs")。
核心方法二:Qwen Sparse Attention(§2.1.2)¶
动机¶
稀疏注意力通过选择性关注重要上下文缓解长上下文下 softmax 注意力的二次瓶颈。DSA(DeepSeek,Liu et al. 2025a)用轻量 indexer 生成 token 级稀疏 mask,取得可观的推理加速;但随着序列变长,其 $O(n^2)$ indexer 的开销本身就不可忽略了。
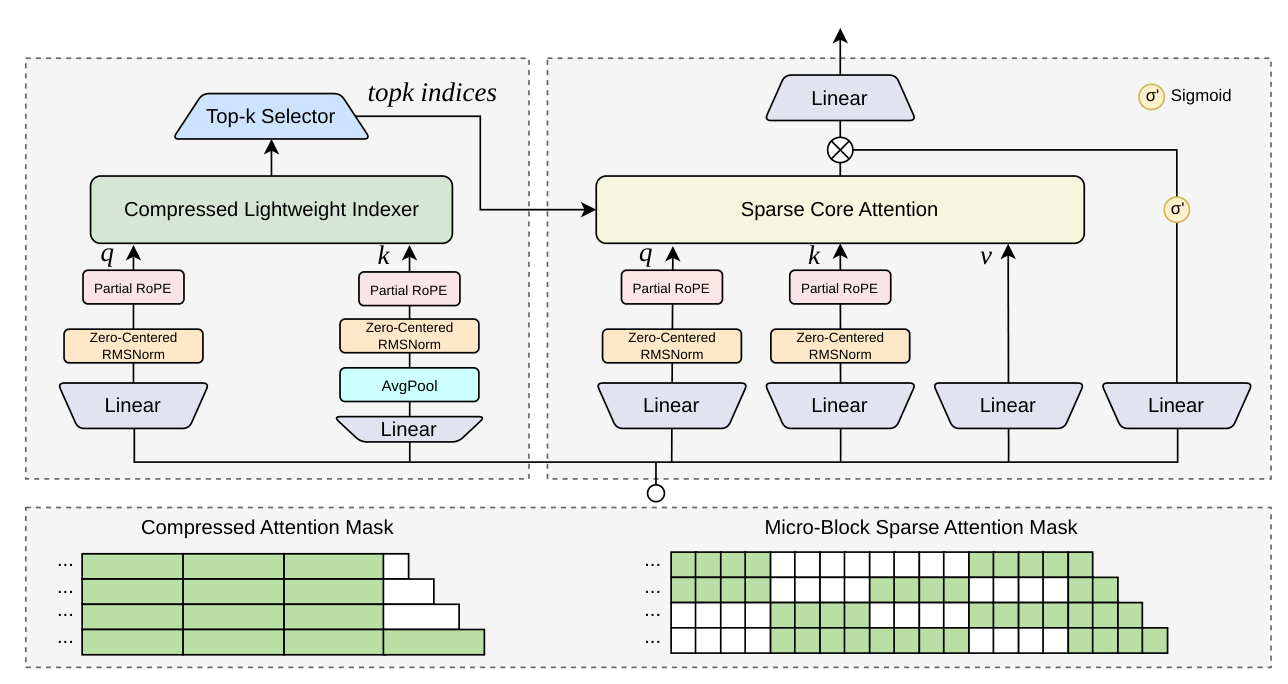
QSA 的做法:indexer 先把序列压缩成微块表示,估计微块重要性,再选出最相关的上下文送进核心注意力。这样 indexer 开销在长输入上显著下降。论文特别指出:相比跨层共享索引的方法,QSA 的层内序列压缩对跨层相似性的依赖更小,因而天然适配混合架构(混合架构里相邻全注意力层之间隔着三层 GDN,层间相似性低)。
压缩轻量 indexer¶
给定隐状态 $x_i$,indexer 采用 MQA 结构:$H$ 个 query head,1 个共享 key head,先做独立的轻量投影:
$$\hat q_i^{\,h} = \mathrm{RMSNorm}\left( W_Q^h x_i \right), \qquad k_i = W_K x_i \tag{12}$$
为缩短序列长度,key 被切成不重叠的 $r$ token 一块并做平均池化。记块 $b$ 的起始位置 $p_b = b \cdot r$,压缩 key 为:
$$\hat k_b = \mathrm{RMSNorm}\left( \mathrm{AvgPool}\left( k_{p_b : p_b + r - 1} \right) \right), \qquad 0 \le b < \left\lfloor \frac{n}{r} \right\rfloor \tag{13}$$
位置编码用 partial RoPE:每个 indexer head 的 128 维中对 64 维施加 RoPE,与核心注意力模块的旋转维度一致。关键顺序:如式 (13) 所示,key 压缩发生在位置编码之前——每个块先被概括成一个内容表示,再被赋予一个块级位置。这个顺序避免了把旋转相位不同的 token 表示平均到一起。每个 query 保留自己的 token 位置 $i$,每个压缩 key 被赋予其块的起始位置 $p_b$:
$$q_i^h = \mathrm{PRoPE}(\hat q_i^{\,h},\, i), \qquad \bar k_b = \mathrm{PRoPE}(\hat k_b,\, p_b) \tag{14}$$
块级重要性分数通过块因果打分得到——对 query token $i$ 与压缩块 $b$,把 ReLU 激活后的 query–key 相似度在所有 indexer head 上求和:
$$I_{ib} = \begin{cases} \sum_{h=1}^{H} \mathrm{ReLU}\left( \left\langle q_i^h,\ \bar k_b \right\rangle \right), & p_b + r - 1 \le i \\[4pt] -\infty, & \text{otherwise} \end{cases} \tag{15}$$
块因果条件保证每个 query 只给已被完整观测的块打分。给定 token 预算 $K$,每个 query 选出得分最高的压缩块;由于每块含 $r$ 个 token,块预算为 $K_B = \lceil K/r \rceil$:
$$B_i = \mathrm{TopK}_{K_B}\left( \{ I_{ib} \}_b \right), \qquad K_B = \left\lceil \frac{K}{r} \right\rceil \tag{16}$$
被选中的块随后展开回原始 token 索引并截断到预算 $K$,再与最后一个不完整块内的 token(永远被包含)合并,构成核心注意力的最终 token 集合。
训练细节:两阶段¶
QSA 在 continued pretraining(CPT) 阶段引入,序列长度 256K。训练分两阶段:
Stage 1:Dense Distillation(稠密蒸馏)。 先把主干的全序列注意力分布蒸馏进 indexer。token 级教师分布由所有教师 head 的 softmax 注意力分布求和后做 $L_1$ 归一化得到,记 query $i$ 到 token $j$ 的概率为 $a_{ij}$,则 $a_i \in \mathbb{R}^n$。为把这个分布对齐到块级 indexer 分数,采用 max pooling(而非平均),以保留可能在聚合中被稀释的显著 token 信号:
$$\bar a_{ib} = \mathrm{MaxPool}\left( a_i,\ p_b : p_b + r - 1 \right), \qquad \hat a_i = \frac{\bar a_i}{\lVert \bar a_i \rVert_1} \tag{17}$$
令 $B = \lfloor n/r \rfloor$,池化后的教师分布 $\hat a_i \in \mathbb{R}^B$ 与 indexer 分数 $I_i \in \mathbb{R}^B$ 共享同一块维度,通过 KL 散度蒸馏:
$$\mathcal{L}_{\mathrm{KL}} = \frac{1}{N} \sum_i D_{\mathrm{KL}}\left( \hat a_{i,:} \,\middle\|\, \mathrm{Softmax}(I_{i,:}) \right) \tag{18}$$
其中 $N$ 是 query token 数,每个 query 只有完整的 key 块进入 KL 损失。warm-up 阶段只训 indexer 1000 步,学习率 $1 \times 10^{-3}$,每步 8 条 256K 序列,合计约 2B token。
Stage 2:Sparse Training(稀疏训练)。 indexer 初始化后,整个主干在 indexer 引导下训练以适应稀疏注意力模式。按式 (16) 先选出 top-$K_B$ 块,展开为 token 索引并与末尾不完整块的 tail token 合并:
$$S_i = \mathrm{Expand}(B_i) \cup \left\{ r \left\lfloor \frac{i+1}{r} \right\rfloor, \ldots, i \right\} \tag{19}$$
本阶段 indexer 的 KL 损失只在 $B_i$ 中的 top-$K_B$ 块上计算,且在算 KL 之前先把 $B_i$ 内的教师概率重归一化到和为 1:
$$\mathcal{L}_{\mathrm{KL}} = \frac{1}{N} \sum_i D_{\mathrm{KL}}\left( \hat a_{i, B_i} \,\middle\|\, \mathrm{Softmax}(I_{i, B_i}) \right) \tag{20}$$
CPT 最后阶段开启 QSA,主干与 indexer 联合训练 8000 步,学习率 $2.5 \times 10^{-5}$,每步 96 条 256K 序列,合计约 200B token。
实现细节¶
主干与 MTP 模块的所有全注意力层都被换成 QSA。压缩轻量 indexer 用 MQA 结构:4 个 query head + 1 个共享 key head,配 partial-RoPE。token 预算 $K = 2048$,压缩比 $r = 4$,因此 QSA 为每个 query 选出至多 512 个完整块,外加末尾不完整块的 tail token。
为高效训练,实现了融合 QSA kernel,联合计算稀疏注意力输出与 KL 损失而不物化中间结果,大幅降低显存。压缩 indexer 在压缩后打分,同时降低 indexer 计算与 top-k 选择开销。此外多步 MTP 跨预测步复用 top-k 索引,进一步降低草稿模型推理成本。
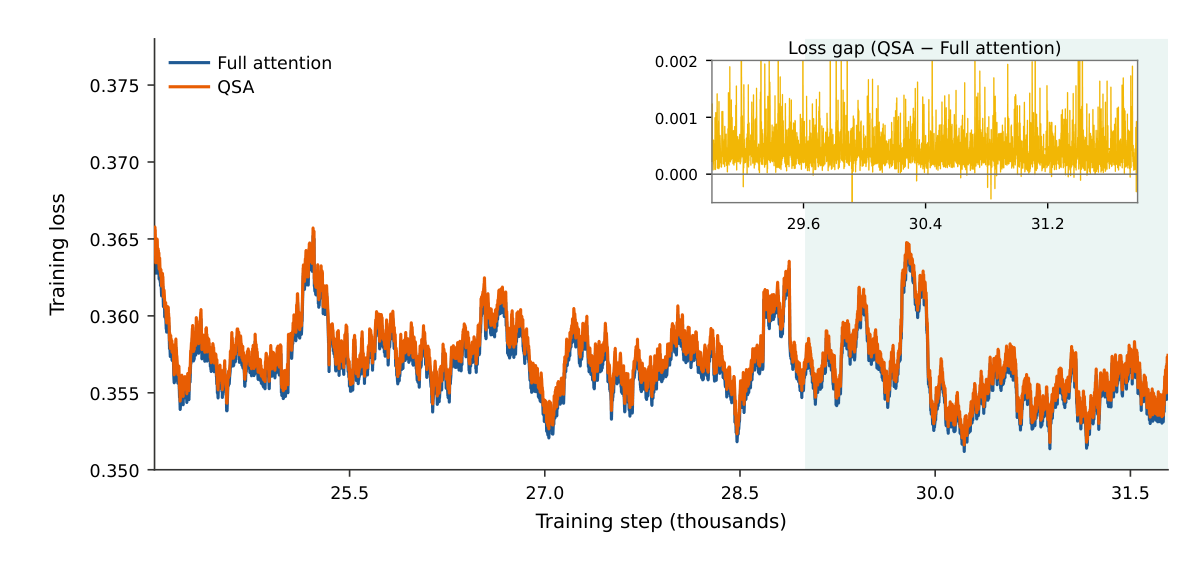
Figure 4 显示两条 loss 曲线高度一致,整体 loss 差在 $10^{-4}$ 量级——indexer 的重要性估计足够准确,使模型在 Stage 2 稀疏训练中能紧贴全注意力的 LM loss 轨迹。
QSA 评测¶
Table 2:短上下文通用能力(Qwen3.8-Flash-Next 全注意力 vs QSA)
| Method | MMLU-Pro | SuperGPQA | MATH | GSM8K | BBH | MMMLU | EvalPlus | MultiPL-E | Avg. |
|---|---|---|---|---|---|---|---|---|---|
| Full Attn | 72.9 | 51.7 | 69.8 | 91.0 | 90.4 | 81.8 | 70.8 | 78.4 | 75.9 |
| w/ QSA | 73.7 | 52.1 | 71.6 | 92.2 | 91.6 | 81.1 | 72.3 | 79.8 | 76.8 |
结论分析:QSA 在 8 项中的 7 项上匹配或超过全注意力,均值从 75.9 提升到 76.8。唯一下降的是 MMMLU(−0.7)。论文的措辞是"剩余差异很小,没有在任何任务类别上显示系统性退化"。
复核提示:一个稀疏注意力在短上下文知识/推理任务上平均高出稠密基线 0.9 分,物理上并不自然。Figure 4 显示两条曲线来自同一时段的并行 run,token 预算应当匹配,但正文没有明确说明 Table 2 的 full-attention 基线是否同样吃满了 Stage 2 的 200B token。更合理的解读是:+0.9 落在评测噪声范围内,QSA 的正确读法是"不掉点",而不是"涨点"。
Table 3:长上下文检索(RULER 按序列长度分档平均;8-needle MRCR)
| Method | RULER ≤128K | 128–256K | 256–512K | 512K–1M | MRCR 128K | 256K | 512K | 1M | Avg. |
|---|---|---|---|---|---|---|---|---|---|
| Full Attn | 99.84 | 99.81 | 97.65 | 90.08 | 97.14 | 94.20 | 30.66 | 20.71 | 78.76 |
| w/ QSA | 99.89 | 99.62 | 98.95 | 93.00 | 95.98 | 93.00 | 40.53 | 26.44 | 80.93 |
结论分析:这张表比 Table 2 更有说服力,因为它呈现出清晰的长度趋势——短长度上 QSA 与全注意力持平甚至略逊(MRCR 128K −1.16、256K −1.20),随着上下文变长优势逐步放大:RULER 512K–1M 从 90.08 → 93.00(+2.92),MRCR 512K 从 30.66 → 40.53(+9.87)、1M 从 20.71 → 26.44(+5.73)。这个单调趋势本身是"稀疏化确实在长程上帮忙"的强证据,比 Table 2 那个疑似噪声的 +0.9 可靠得多。机制上可以理解为:在极长上下文里,稠密注意力的概率质量被大量无关 token 稀释,top-k 选择起到了去噪作用。
Table 4:MTP 平均接受长度(四步投机解码)
| Method | MT-Bench | GSM8K | MATH | HumanEval | MBPP | Avg. |
|---|---|---|---|---|---|---|
| Full Attn | 3.44 | 4.19 | 4.29 | 4.24 | 4.12 | 4.06 |
| w/ QSA | 3.47 | 4.20 | 4.30 | 4.26 | 4.13 | 4.07 |
结论分析:把 MTP 的注意力层也换成 QSA、并跨投机解码步复用 top-k 索引(做法沿用 GLM-5)之后,平均接受长度几乎不变(4.06 → 4.07)。这条证据的意义在于:索引复用是一个纯粹的省钱操作,而它没有付出草稿质量的代价。
架构消融(Figure 5)¶
在 35B-A3B 规模上做 QSA 的架构消融,聚焦压缩比与 indexer head 数,评测指标是长度到 1M 的 RULER 分数,全部在 Stage 2 稀疏训练后的 CPT 模型上评测。
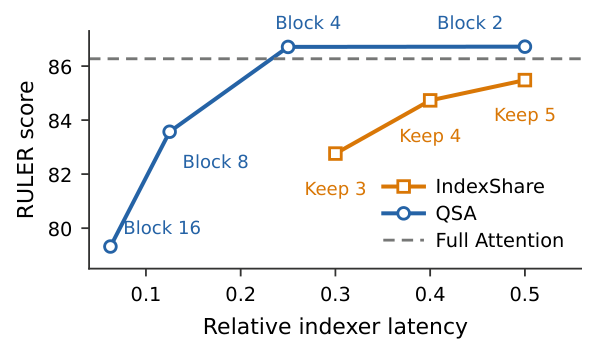
- (a) 压缩比 / 微块大小:对比 Block 2/4/8/16,并额外引入 training-aware IndexShare 作为基线——它通过在混合模型中相邻全注意力层间均匀共享 top-K 索引来降低索引开销。横轴是各自的估计 indexer 延迟下降幅度。结果:QSA 在相对 indexer 延迟 0.25 处即可追平全注意力基线,而 IndexShare 在 0.5 处仍低于基线(IndexShare 的 0.5 表示在隔着三层 GDN 的两个全注意力层之间共享一份索引)。这直接印证了论文的核心主张:在混合架构里,层内压缩优于跨层索引共享,因为层间相似性低。
- (b) indexer query head 数:对比 1 / 2 / 4 / 16 个 head,分 Stage 1(稠密蒸馏后)与 Stage 2(稀疏训练后)两条曲线。稠密初始化后直接拿 indexer 做稀疏注意力会明显掉点;只要一小段联合训练,主干就能适应稀疏模式并恢复到全注意力水平。结论是 QSA 只需远少于核心注意力的 query head 数就能维持性能,最终选 4 个 query head。
复核提示:Figure 5(a) 的横轴是"estimated reductions in indexer latency"(论文原文用词),即估算而非实测。这是全文效率论证中唯一一处明确的估算轴,恰好也是与 IndexShare 对比的那张图。
效率分析(Figure 6)¶
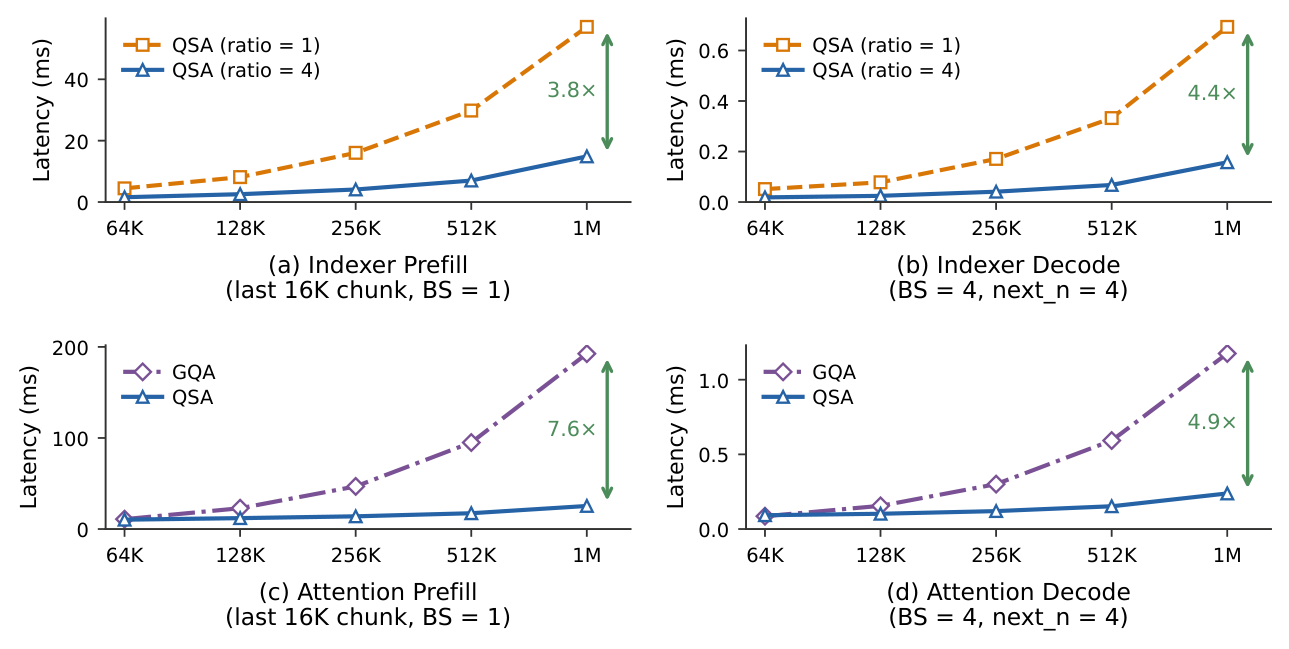
用压缩比 $r$ 压缩 key 序列,把 indexer 复杂度从 $O(n^2)$ 降到 $O(n^2/r)$。对 indexer 而言,序列压缩直接降低 MQA logits 计算与 top-k 选择开销,加速比与压缩比同量级。
稠密基线用 FlashInfer 提供的 paged GQA 实现。prefill 在 chunked-prefill 设定下评测(16K token chunk,batch size 1),decode 含三个额外 MTP 步(batch size 4,next_n = 4)。在 1M 上下文下的 kernel 级加速:
| 场景 | 对比 | 1M 上下文加速比 |
|---|---|---|
| Indexer Prefill | QSA (ratio=4) vs QSA (ratio=1) | 3.8× |
| Indexer Decode | QSA (ratio=4) vs QSA (ratio=1) | 4.4× |
| Attention Prefill | QSA vs 稠密 GQA | 7.6× |
| Attention Decode | QSA vs 稠密 GQA | 4.9× |
QSA 从 64K 上下文开始就提供加速,且随序列增长收益持续放大。
复核提示:这些是实测的 kernel 级延迟(单位 ms,跨 64K/128K/256K/512K/1M 五个点),不是 FLOPs 推算——这一点比 Figure 5(a) 扎实得多。但要注意它是注意力模块级微基准,不是端到端服务吞吐 / TTFT / TPOT;全文没有任何端到端 serving 数字。
核心方法三:Gated Residual(§2.2)¶
这是全文消融做得最细、机制分析最深的一节。
动机¶
残差连接给每个 block 一条通往网络输出的直接路径,pre-normalization 让大规模训练保持稳定,但它衰减了每一层接收到的信号:每个 block 读的是同一条流,因此一个早期写入的特征必须和之后写入的一切内容竞争。
修改残差路径的工作分成两族:第一族让每层的读与写更有表达力(highway networks 谱系);第二族把流本身拓宽——AltUp 与 Hyper-Connections (HC) 用若干条并行分支替换单一残差向量。论文强调这两者是互补的:拓宽增加容量,更丰富的读/写机制决定这些容量怎么花。
第一步:只拓宽,值多少?¶
先用一个适配 pre-norm 网络的 AltUp 简化变体单独测量"宽度本身"的收益。block $\ell$ 之前的残差状态是 $n_r$ 条分支 $R^{(\ell)} \in \mathbb{R}^{n_r \times d}$。每个 block 持有 $n_r$ 个可学习标量 $h \in \mathbb{R}^{n_r}$,把输入读作分支的加权和:
$$x^{(\ell)} = \sum_{i=1}^{n_r} h_i\, R_i^{(\ell)} \tag{21}$$
block 输出 $y^{(\ell)}$ 按深度 round-robin 写回单一分支:
$$R_i^{(\ell+1)} = R_i^{(\ell)} + \mathbb{1}\left[ i = \ell \bmod n_r \right] y^{(\ell)} \tag{22}$$
这只增加每 block $n_r$ 个参数、零矩阵乘,计算成本可忽略;额外成本只是携带 $n_r$ 条分支而非一条的显存流量。即便如此,它把一个在 400B token 上训练的 25B-A3B MoE 的训练 loss 降低了约 0.01。
第二步:Hyper-Connections 的三个算子¶
HC 把式 (21)(22) 推广成三个可学习算子:读算子 $H_{\mathrm{mix}}$ 构造 block 输入,写算子 $H_{\mathrm{combine}}$ 把 block 输出分配到各分支,混合算子 $H_{\mathrm{res}}$ 在分支间交换信息:
$$x^{(\ell)} = H_{\mathrm{mix}}^{\top} R^{(\ell)} \tag{23}$$
$$y^{(\ell)} = F^{(\ell)}\left( \mathrm{Norm}\left( x^{(\ell)} \right) \right) \tag{24}$$
$$R^{(\ell+1)} = H_{\mathrm{res}} R^{(\ell)} + H_{\mathrm{combine}}\, y^{(\ell)\top} \tag{25}$$
其中 $H_{\mathrm{mix}}, H_{\mathrm{combine}} \in \mathbb{R}^{n_r}$,$H_{\mathrm{res}} \in \mathbb{R}^{n_r \times n_r}$(HC 原文记为 $A_m$、$B$、$A_r$)。三个算子都由残差状态预测。令 $\mathcal{R} = \mathrm{norm}(R^{(\ell)})$ 为分支的归一化视图,每个算子是静态项与数据相关项之和:
$$H_{\mathrm{mix}} = H_{\mathrm{mix}}^{s} + \lambda_m \odot \phi\left( \mathcal{R} W_m \right) \tag{26}$$
$$H_{\mathrm{combine}} = H_{\mathrm{combine}}^{s} + \lambda_c \odot \phi\left( \mathcal{R} W_c \right) \tag{27}$$
$$H_{\mathrm{res}} = H_{\mathrm{res}}^{s} + \lambda_r \odot \phi\left( \mathcal{R} W_r \right) \tag{28}$$
其中 $H_\star^s$ 是可学习静态项,$W_\star$ 投影归一化残差,$\phi$ 是激活函数,$\lambda_\star$ 是可学习尺度。HC 用 $\phi = \tanh$ 且 $\lambda_\star$ 初始化为 0.01;mHC 用 sigmoid 并额外把 $H_{\mathrm{res}}$ 约束到双随机矩阵流形上。本文把静态项设为 $H_{\mathrm{mix}}^s = e_{\ell \bmod n_r}$、$H_{\mathrm{combine}}^s = \mathbf{1}$、$H_{\mathrm{res}}^s = I$:当 $W_\star = 0$ 时这个初始化让拓宽网络精确地从 pre-norm 基线出发;当 $\lambda_\star \equiv 0$ 时算子保持静态、拓宽流不增加任何计算,正好退化为上面的 AltUp 简化变体。
设计消融(Table 5)与五条观察¶
从静态算子出发,只保留那些自己赚回成本的表达力。Table 5 报告这条演进路径的端点,评测套件与流水线同 §2.1.1。模型是 25B-A3B MoE,训练 560B token,所有拓宽变体用 $n_r = 4$。
| Residual | Loss | MMLU | MMLU-Pro | SuperGPQA | MATH | GSM8K | BBH | MMMLU | EvalPlus | MultiPL-E | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Pre-norm | 1.617 | 64.29 | 38.40 | 21.78 | 53.92 | 77.41 | 64.73 | 51.26 | 49.25 | 37.15 | 50.91 |
| mHC (static) | 1.596 | 64.62 | 43.69 | 22.20 | 55.08 | 78.05 | 65.42 | 52.78 | 49.59 | 40.94 | 52.49 |
| mHC (dynamic) | 1.594 | 66.11 | 45.84 | 24.20 | 59.54 | 78.51 | 66.01 | 56.61 | 52.16 | 41.30 | 54.47 |
| GR | 1.590 | 66.69 | 46.02 | 23.80 | 61.18 | 78.20 | 66.54 | 56.19 | 51.36 | 42.00 | 54.66 |
五条塑造最终设计的观察:
- 有界正门优于 tanh。sigmoid 门在 loss 与训练稳定性上都优于 tanh,与 mHC 一致,也与 GDN、注意力组件中"sigmoid 门优于 SiLU 或 tanh"的观察一致。
- 数据依赖性。把 $H_{\mathrm{mix}}$ 与 $H_{\mathrm{combine}}$ 改成数据相关,相对静态变体只降低 loss 0.002;而静态变体相对 pre-norm 基线降低了 0.021。但 benchmark 的比例完全反转:静态→动态涨 1.98 分,基线→静态涨 1.58 分。这是全文最有力的"loss 与下游不同步"实证——只看 loss 会严重低估这个改动的价值。
- 读的粒度比写的粒度更重要。把式 (23) 的 $H_{\mathrm{mix}}$ 从"每分支一个标量"细化到"每分支每通道一个权重"有帮助;对式 (25) 的 $H_{\mathrm{combine}}$ 做同样细化几乎没有收益,所以写保持为 per-branch 标量。
- 读取所有分支。从所有分支预测算子,优于只用最后一条分支或先池化;对每条分支分别归一化(即在拓宽流上做 group RMSNorm)还能再涨一点。
- $H_{\mathrm{res}}$ 贡献很小。一旦读与写足够有表达力,再加那个 $n_r \times n_r$ 的混合算子没有显著改善。
复核提示:这五条观察里,只有第 2 条能从 Table 5 的四行里读出数字。第 1、3、4、5 条都只有定性叙述,没有对应的数值行——论文明确说 Table 5 报告的是"the endpoints of that progression"(这条演进路径的端点)。所以"sigmoid 优于 tanh"、"读粒度比写粒度重要"、"$H_{\mathrm{res}}$ 无用"这三条关键设计决策,在本文中是无法被读者复核的。
Gated Residual 的具体形式¶
在另一篇工作(Qiu et al., 2026)中,作者发现在 RMSNorm 之后加一个轻量的逐元素自门(称为 GatedNorm)能显著改善训练稳定性:
$$\mathrm{GatedNorm}(u) = \mathrm{RMSNorm}(u) \odot \sigma\left( W_2\, \mathrm{SiLU}\left( W_1\, \mathrm{RMSNorm}(u) \right) \right) \tag{29}$$
其中 $W_1$、$W_2$ 构成低秩瓶颈。而上面消融得到的"读"——逐元素、数据相关、sigmoid 门——恰好就是式 (29) 施加在拓宽流上的形式。于是把两者合并成一个算子,称为 Gated Residual (GR)。
GR 先对每条分支独立归一化,各自带自己的 gain $\gamma_i \in \mathbb{R}^d$:
$$\hat R_i = \mathrm{RMSNorm}\left( R_i;\ \gamma_i \right), \qquad i = 1, \ldots, n_r \tag{30}$$
再从所有分支预测每分支每通道的逐元素门控分数,把门控后的分支平均成 block 输入:
$$G = \mathrm{unvec}\ \sigma\left( W_u\, \mathrm{SiLU}\left( \frac{1}{n_r} W_d\, \mathrm{vec}(\hat R) \right) \right) \in \mathbb{R}^{n_r \times d} \tag{31}$$
$$x = \frac{1}{n_r} \sum_{i=1}^{n_r} G_i \odot \hat R_i \tag{32}$$
其中 $\mathrm{vec}$ 把各分支堆成长度 $n_r d$ 的向量、$\mathrm{unvec}$ 是其逆,$W_d \in \mathbb{R}^{r \times n_r d}$、$W_u \in \mathbb{R}^{n_r d \times r}$,瓶颈秩 $r = d/8$。block 输出 $y = F(x)$ 通过每分支一个数据相关标量写回每条分支:
$$s = 2\,\sigma\left( \frac{1}{n_r} W_w\, \mathrm{vec}(\hat R) \right) \in \mathbb{R}^{n_r} \tag{33}$$
$$R_i' = R_i + s_i\, y \tag{34}$$
其中 $W_w \in \mathbb{R}^{n_r \times n_r d}$。式 (31)(33) 就是式 (26)(27) 在 $\phi = \sigma$、$H_{\mathrm{mix}}$ 逐元素、$H_{\mathrm{combine}}$ 为 per-branch 标量、$\mathcal{R}$ 为所有分支的 group-RMSNorm 时的实例化。GR 中静态项 $H_\star^s$ 不带来任何改善,因此当前配置下不需要特殊初始化,主干使用的标准随机初始化即可。取 $n_r = 4$,每层的注意力 block 与 MLP block 各配一个独立的 GR 模块。
GR 相对 mHC (dynamic) 的差异在于逐元素的 $H_{\mathrm{mix}}$ 与移除 $H_{\mathrm{res}}$;Table 5 显示在该规模上两者表现相当(1.594/54.47 vs 1.590/54.66)。GR 的价值主张不在精度而在另外两处:
- 效率优势:移除 $H_{\mathrm{res}}$ 消掉了每个 block 对残差状态的一整次读取,降低显存流量——而这正是拓宽残差流的主要推理成本。
- 稳定性优势是双重的:GatedNorm 本身改善训练稳定性(§3.3 分析);且丢掉需要单独约束(mHC 要求双随机)的 $H_{\mathrm{res}}$,也移除了一个潜在的不稳定来源。
论文把 GR 定位在 HC / mHC / VWN 同一族里,差别在于额外表达力花在哪:HC 与 mHC 把读与写都保持为 per-branch 标量、把容量投进 $H_{\mathrm{res}}$(mHC 还进一步约束它是双随机的);VWN 同样保留那些标量,转而拓宽 token embedding、把它切成许多窄段以追求更细粒度的读写。GR 把表达力全花在"读"上:门是逐元素的,$H_{\mathrm{res}}$ 被彻底丢掉——消融显示这不付出任何代价,却移除了每 block 对整个残差状态的一次读取。
两个额外的结构后果:(a) 因为式 (32) 的读已经包含归一化与门控,GR 取代了 block 的 pre-normalization 而非坐在它前面——式 (24) 失去了 $\mathrm{Norm}$,拓宽也不增加任何归一化层;(b) 没有混合算子意味着各分支彼此独立(一条分支只被 block 写入、只通过式 (32) 被读取),这让信息流易于追踪,正是 §2.2 后半段机制分析的基础。
与 Attention Residual 的对比(Table 6)¶
Attention Residual (AttnRes) 用对前序各层输出的 softmax 注意力决定每个子层的读。Full AttnRes 对每个前序子层的输出做注意力;Block AttnRes 把 $L$ 个子层分成大小 $S$ 的块,把每块求和成一个表示再对这些块做注意力。在 28 层模型($L = 56$ 个子层)上,两个变体各自在开/关 GatedNorm (GN) 下与 GR 对比:
| Residual design | Loss | Loss + GN |
|---|---|---|
| Pre-norm residual | 1.789 | 1.787 (−0.002) |
| Block AttnRes, $S = 4$ | 1.773 | 1.768 (−0.005) |
| Block AttnRes, $S = 2$ | 1.770 | 1.766 (−0.004) |
| Full AttnRes | 1.762 | 1.758 (−0.004) |
| GR ($n_r = 4$) | — | 1.762 |
结论分析:Full AttnRes 是该族最强设定,与 GR 打平(同为 1.762);把块概括起来在 $S = 2$ 时要付 0.008、$S = 4$ 时付 0.011。更深时排序一致:48 层下 Block AttnRes ($S=4$) 达到 1.711,GR 是 1.707。GN 在每个设定上都降低 loss——在 AttnRes 上降 0.004–0.005,在朴素 pre-norm 基线上只降 0.002。论文的解读是:子层读入的输入越复杂,门带来的帮助越大——而这正是 GR 在它的"读"里自带的同一个门。
拓宽的宽度到底被用来做什么(Figure 7)¶
消融显示 GR 同时改善 loss 与 benchmark,但是什么机制产生了收益?由于 GR 没有分支混合,每条分支都是过去输出的纯累加器,因此可以精确分解每个 block 读到了什么。
统计量。 block $v$ 之前的分支 $c$ 持有:
$$R_c^{(v)} = R_c^{(0)} + \sum_{u < v} s_c^{(u)}\, y^{(u)} \tag{35}$$
其中 $R_c^{(0)}$ 是分支 $c$ 的初值(token embedding),$y^{(u)}$ 是 block $u$ 的输出,$s_c^{(u)}$ 是式 (33) 的标量写门。block $v$ 通过式 (32) 的门控读取该分支:归一化、按 per-channel gain $\gamma_c$ 缩放、用数据相关门 $G_c^{(v)}$ 逐元素门控、再跨分支平均。由于归一化除以 $\mathrm{rms}(R_c^{(v)})$,block $u$ 对 block $v$ 输入的贡献为:
$$a_{u \to v} = \frac{1}{n_r} \sum_{c=1}^{n_r} G_c^{(v)} \odot \gamma_c \odot \frac{s_c^{(u)}\, y^{(u)}}{\mathrm{rms}\left( R_c^{(v)} \right)} \tag{36}$$
在前向传播实际取到的门值上求值。每个因子都有直接的解读:$s_c^{(u)} y^{(u)}$ 是 block $u$ 存进分支 $c$ 的东西;除以 $\mathrm{rms}(R_c^{(v)})$ 对应读取时的归一化;$\gamma_c$ 逐通道重缩放;$G_c^{(v)}$ 决定 block $v$ 实际用了这条分支多少。报告的是归一化后的贡献幅度:
$$\pi_{uv} = \frac{\lVert a_{u \to v} \rVert}{\sum_{u' < v} \lVert a_{u' \to v} \rVert} \tag{37}$$
即 block $v$ 的输入中来自 block $u$ 的比例。这个分解是精确的:每个读者的份额加起来等于 1,误差在 $3 \times 10^{-8}$ 以内。 用一个 20 层 MoE(带 GR)对比一个除 GR 外完全相同的参照模型(相同配方、数据、优化器、训练步,在相同 token 上探测),报告差值 $\Delta_{uv} = \pi_{uv}^{\mathrm{GR}} - \pi_{uv}^{\mathrm{ref}}$——减掉参照可以去掉所有残差网络共有的模式(近处写者占主导)。
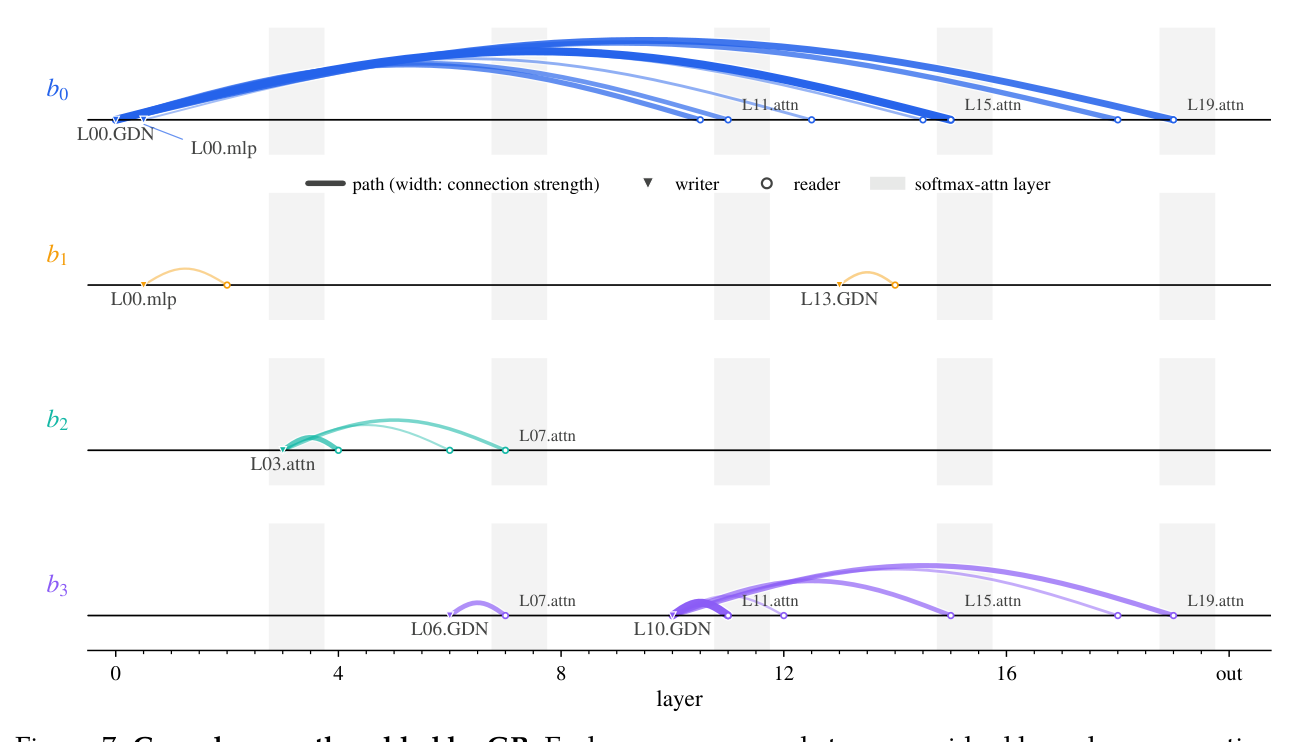
Figure 7 展示 $\Delta_{uv} \ge 0.05$ 且跨越至少一层的 21 条路径(总共 780 个有序对)。校准:在第 15 层有 30 个写者,均分则每个约 0.03,所以 0.13 的份额是均分的四倍。
核心发现:一条分支承载长程路径,其余三条保持局部。 具体是哪一条无所谓(分支在初始化时可交换),但模式是一致的:跨 5 个 GR checkpoint,每个都恰好有一条这样的分支,典型跳跃 10.9 层,其余三条是 3.4–3.9 层。三个例子:
- 第 0 层 GDN → 第 15 层 attention:份额从参照模型的 0.020 升到 GR 的 0.138。这个份额在第 10 到 19 层的每一个读者上都维持在 0.072–0.138,且没有下降趋势。这印证了第一层在跨深度保存信息上的超常作用。
- 第 10 层 GDN → 第 11 层 attention:$\Delta_{uv} = 0.117$。增益和上面那条长程路径一样大,但只跨一层——GR 同时也强化短程连接。
- 第 0 层 MLP,同时走两条分支:到第 15 层走长程分支,份额从 0.008 升到 0.058;到第 2 层走一条局部分支,份额从 0.139 升到 0.192。同一个输出以不同强度到达一个近处读者和一个远处读者——这是单一残差流无法表达的,因为它对每个写者只有一个衰减率。
分支 0 的典型长程路径可以从式 (35) 直接解释:这条分支在第 0 层被最重地写入,之后几乎不再更新,因此第 0 层的信息对所有后续层都保持可访问。此外,最重地从 GR 分支读取的子层压倒性地是 softmax 注意力层——表明全局注意力充当了整合显式长程历史上下文的关键枢纽,而这些上下文正是 GDN 层压缩掉的。
整体模式:把全部 780 条路径按跳跃层数分组并在组内求和 $\Delta_{uv}$,得到——相邻层路径(跳 1)合计涨 0.96 份额;长程路径(跳 > 12)合计涨 0.91;中程路径(跳 2–12)合计跌 3.21。加权平均跳跃几乎不变(3.97 vs 3.91),说明跨层信息总量相似,变化的是它的分布:GR 挑选出少数路径并放大它们,代价是中程路径。
这是全文最漂亮的一段分析:它不是"消融显示涨点",而是给出了一个精确到 $3\times10^{-8}$ 的守恒分解,并用它回答"多出来的宽度被花在哪"。这类机制证据在架构论文里非常罕见。
推理效率:两次尝试¶
GR 的推理成本由拓宽残差状态的显存流量主导,因此作者找了两条"少搬字节"的路。
第一次尝试:稀疏化读取。 观察到训练好的模型里,每个 GR 层的写入通常由两条分支主导。于是尝试稀疏写入——无论从头训还是训练中途切换,让每个 block 只读门控值最高的两条分支而非全部 $n_r$ 条。预训练 loss 与 benchmark 几乎不受影响,但后训练之后质量明显退化,因此不采用。更复杂的变体(如跨层变化稀疏度)也没能解决。论文原话:"We note this as a case where pre-training metrics alone would have led to the wrong decision."(我们把这记为一个只看预训练指标就会做出错误决策的案例。)近期工作 xHC 探索用更大的 $n_r$ 让稀疏分支更新更容易,但考虑到更大 $n_r$ 的显存开销,本文没有继续这个方向。
第二次尝试:残差状态存 FP8。 GR、gated attention 与 GDN 的门都界住了写进流里的东西的幅度,因此残差值停留在一个窄区间内,与低精度格式很匹配。把分支存成 FP8 相对 BF16 把残差状态搬运的字节数减半,质量几乎无损。最后,式 (30)–(32) 的读与式 (33)–(34) 的写各自融合成单个 kernel,group RMSNorm 折进读里,使拓宽流在每个 block 的每个方向上只被遍历一次。
复核提示:FP8 的"almost no loss in quality"没有给出任何数字;拓宽残差流的绝对显存流量开销也没有给出数字。
核心方法四:N-gram 嵌入层(§2.3)¶
动机¶
基于嵌入的记忆为扩展模型容量提供了一条互补维度。N-gram 嵌入进一步把 unigram 查表推广为以局部上下文而非仅 token 身份为条件的记忆检索:以每个 token 结尾的短 n-gram 作为 key 索引嵌入表,检索到的向量增强对应的 token 表示。
它的两个关键性质是:(a) N-gram 记忆以几乎为零的额外 per-token FLOPs 扩展容量;(b) 确定性寻址使得主存卸载与异步预取成为可能。实现上用 multi-head hashing 做嵌入查表,嵌入通过上下文门控机制注入残差流。全部实验用 300 tokens per active parameter (TPP)。
放在第几层(Table 7)¶
在固定参数预算下消融嵌入层的放置位置与数量。单层变体覆盖浅层(第 1–4 层)、中层(第 10、15 层)与深层(第 25 层);多层配置把浅层(第 2 层)与中层(第 15 层)或深层(第 25 层)组合。
| Layer Index | Loss | MMLU | MMLU-Pro | SuperGPQA | MATH | GSM8K | BBH | MMMLU | EvalPlus | MultiPL-E | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|---|
| w/o N-gram emb. | 1.585 | 62.78 | 33.43 | 20.97 | 32.52 | 59.21 | 53.40 | 54.06 | 52.13 | 45.42 | 45.44 |
| 1st | 1.541 | 64.19 | 35.25 | 21.30 | 36.20 | 65.73 | 56.00 | 56.16 | 50.95 | 47.45 | 47.30 |
| 2nd | 1.541 | 64.71 | 35.80 | 21.49 | 37.32 | 64.00 | 57.56 | 56.64 | 53.09 | 45.56 | 47.94 |
| 3rd | 1.543 | 63.20 | 34.93 | 20.67 | 35.74 | 63.15 | 56.71 | 55.02 | 50.15 | 44.90 | 46.76 |
| 4th | 1.544 | 63.36 | 34.81 | 22.33 | 36.20 | 61.26 | 55.32 | 55.79 | 51.05 | 45.60 | 46.89 |
| 10th | 1.544 | 64.22 | 34.99 | 20.81 | 33.80 | 62.17 | 55.54 | 54.81 | 52.69 | 43.61 | 46.62 |
| 15th | 1.543 | 65.07 | 34.95 | 21.35 | 36.12 | 63.50 | 57.15 | 55.98 | 52.21 | 44.42 | 47.37 |
| 25th | 1.541 | 64.70 | 35.15 | 22.13 | 36.26 | 63.31 | 55.73 | 55.99 | 52.66 | 44.33 | 47.40 |
| 2nd + 15th | 1.541 | 63.82 | 35.63 | 21.25 | 37.48 | 63.23 | 56.52 | 55.68 | 50.44 | 43.85 | 47.01 |
| 2nd + 25th | 1.540 | 64.94 | 35.40 | 21.80 | 37.40 | 64.33 | 57.79 | 56.45 | 51.69 | 44.73 | 47.75 |
结论分析:
- 没有哪个深度区间一致占优。前两层表现很强,中层与深层也保持竞争力。
- 把同样的参数预算分散到多层没有一致收益。第 2 层 + 第 25 层组合虽然拿到最低 loss(1.540),但这个边际 loss 下降没有转化为下游性能提升(Avg 47.75 < 单独第 2 层的 47.94)——又一处 loss 与下游分歧。
- 一层就够了。而且不同放置位置的相对性能在全注意力与 GDN 下相似,说明放置选择对注意力机制基本不敏感。
- 最终放在第 2 层,理由是工程性的:让主存预取能与第 1 层的计算重叠。
相对无 n-gram 基线,第 2 层配置把 loss 从 1.585 降到 1.541(−0.044),Avg 从 45.44 升到 47.94(+2.50 分),其中 MATH +4.80、GSM8K +4.79 增幅最大。
词表规模:两种预算口径¶
(a) 固定总参数预算(Table 8):按照既有工作的做法,扩大 n-gram 嵌入槽位的同时减少专家数以维持总参数不变。词表规模相对基础 tokenizer 词表(250K)计。
| Vocab. Scale (Param. Ratio) | Loss | Uncheatable PPL | MMLU | MMLU-Pro | SuperGPQA | MATH | GSM8K | BBH | C-Eval | CMMLU | MMMLU |
|---|---|---|---|---|---|---|---|---|---|---|---|
| None (0%) | 1.202 | 5.55 | 68.25 | 44.38 | 25.22 | 46.02 | 74.79 | 65.71 | 70.78 | 73.01 | 58.32 |
| 5× (10%) | 1.200 | 5.54 | 68.15 | 44.49 | 24.25 | 45.64 | 72.86 | 65.39 | 70.93 | 73.44 | 57.49 |
| 10× (25%) | 1.197 | 5.55 | 67.71 | 44.66 | 25.64 | 46.56 | 73.65 | 65.54 | 70.71 | 73.31 | 56.22 |
| 30× (50%) | 1.201 | 5.59 | 67.75 | 42.61 | 24.18 | 44.62 | 74.45 | 65.55 | 72.49 | 73.28 | 56.66 |
结论分析:loss 随词表规模非单调变化,在 10×(25% 参数占比)处最低,与既有工作报告的分配甜点一致。但这个最优点在其他评测上不成立:域外 uncheatable PPL 在各预算下几乎不变,下游 benchmark 相对纯 MoE 基线没有明显改善(MMLU 甚至从 68.25 跌到 67.71–68.15,MMMLU 从 58.32 跌到 56.22–57.49)。论文的解读是:n-gram 嵌入与 MoE 专家在扩展容量上扮演不同角色。因此他们转而在保持 MoE 参数预算不变的前提下研究 n-gram 词表扩展。
(b) 追加参数(Table 9):因为嵌入表被稀疏访问且确定性寻址,它们可以以几乎为零的额外 per-token 计算被扩展并存放在加速器外的存储上。于是把 n-gram 词表从 $20V$ 扩到 $200V$($V$ 为 Qwen3.5 基础 tokenizer 词表)。
| Vocab. Scale | Loss | MMLU | MMLU-Pro | SuperGPQA | MATH | GSM8K | BBH | C-Eval | CMMLU | MMMLU |
|---|---|---|---|---|---|---|---|---|---|---|
| None | 1.585 | 62.78 | 33.43 | 20.97 | 32.52 | 59.21 | 53.40 | 66.91 | 68.10 | 54.06 |
| 20× | 1.553 | 64.14 | 34.46 | 21.83 | 37.38 | 65.09 | 57.13 | 71.75 | 72.29 | 55.94 |
| 50× | 1.541 | 64.71 | 35.80 | 21.49 | 37.32 | 64.00 | 57.56 | 72.12 | 72.48 | 56.64 |
| 100× | 1.534 | 64.70 | 35.87 | 21.93 | 36.98 | 63.08 | 56.03 | 73.75 | 72.73 | 56.65 |
| 200× | 1.526 | 64.85 | 35.21 | 21.11 | 35.34 | 62.96 | 56.23 | 74.94 | 73.24 | 55.82 |
结论分析:这张表是整篇论文"三轴打架"论点的核心证据——loss 随 n-gram 词表增大单调下降(1.585 → 1.526,跨越 20×→200× 仍在降),而下游表现不跟随同一趋势:词表扩展相对基线带来广泛收益,但部分 benchmark 随词表增大饱和或波动(GSM8K 在 20× 达到峰值 65.09 后一路跌到 62.96;MATH 同样在 20× 峰值 37.38 后跌到 35.34;MMLU-Pro 在 100× 峰值后回落)。唯一一致随词表规模改善的是中文 benchmark(C-Eval 66.91 → 74.94,CMMLU 68.10 → 73.24,均单调)。这个中文 vs 数学/推理的分化很有信息量:n-gram 记忆本质上在做局部上下文条件的查表记忆,它对知识/词汇密集任务的帮助是单调的,对需要多步组合的推理任务则很快饱和甚至有害。
除词表扩展外,作者还探索了一系列提升 n-gram 嵌入参数效率的策略,包括但不限于 token 归一化做词表压缩、跨 n-gram 阶数的非均匀分配、以及基于频率的嵌入槽位划分。在他们的训练配方下都没有观察到一致的性能收益——这是一段有价值的负面结果记录。
复核提示:这一节把"n-gram 嵌入有用"论证得很扎实(三张表、10 个放置位置、两种预算口径),但"卸载到主存 + 异步预取"这个核心工程主张本身没有任何测量。全文没有一个数字说明预取带宽占用、预取是否真的与第 1 层计算完全重叠、开/关 n-gram 层的 decode 延迟差、或主存到加速器的传输是否成为瓶颈。"negligible additional per-token FLOPs and latency" 是断言,不是测量。
优化(§3)¶
优化器:Muon(§3.1)¶
Muon 通过 Newton–Schulz (NS) 迭代对动量做正交化来计算矩阵参数的更新方向。本文用 Muon 作主优化器,并给出若干影响其实际效率与稳定性的设计选择。
正交化。 NS 迭代作用在 $\mu = 0.95$ 的 Nesterov 加速动量上,正交化结果按 $\gamma(A,B) = 0.2\sqrt{\max(A,B)}$ 缩放(参数形状为 $A \times B$),使更新的 RMS 与矩阵形状无关。NS 迭代采用 Polar Express 的逐步系数调度(对给定步数预算是 minimax 最优的),迭代步数设为 8——比更少的步数提供更准确的正交化,并在压力测试中同时降低梯度范数尖峰的幅度与频率。NS 迭代前 Frobenius 归一化的数值稳定常数设为 $10^{-14}$。
哪些参数用 Muon。 用在那些真正充当线性映射的二维权重上:注意力 q/k/v 与输出投影、GDN 的输入与输出投影、routed 与 shared 专家的 fc1/fc2、以及 n-gram 嵌入层的 key/value 投影。留在 AdamW 上的:
- 输入嵌入与输出头;
- MoE router——Muon 会加剧早期训练波动并使 router 失稳;虽然在中后期对 router 用 Muon 不引发不稳定,但也没有显著性能收益。一个可能的解释是:router 的每个输出维对应一个专家的分数,各维大体独立,没有可供正交化利用的共享线性结构;
- GR 的两个低秩投影——归因于其极度细长的形状;
- n-gram 嵌入表跑 Adam 且关闭 weight decay。
拆分融合参数。 在 Megatron-LM 中,注意力 qkv 投影、SwiGLU 的 fc1、GDN 输入投影各自被存成一个融合矩阵,但语义上它们是沿输出维拼接的独立线性算子。对融合矩阵做正交化因此在两个方面是错的:迭代会在不相关的子块之间混合奇异方向;且 $\gamma(A,B)$ 是按拼接后的形状而非真实算子形状计算的。所以在正交化前拆分融合梯度,对每个子矩阵独立跑 NS,再收集回原布局施加更新。qkv 与 GDN 输入投影按 per-head 粒度拆分,同时改善 loss 与下游 benchmark;fc1 拆成 gate 与 up 两半,loss 基本不变而 benchmark 略有改善。拆分还提供了把个别子矩阵排除出 Muon 的自然粒度:GDN 的 decay 与 beta 投影每 head 产出一个标量、因而是向量,正交化对它们没有意义;对输出门(注意力输出门与 GDN 的 $z$ 投影),消融发现 AdamW 与 Muon 持平或略优。
实现的两个挑战。 (a) NS 迭代要求对每个完整参数矩阵做整体更新($K$ 步迭代约需 $4K \max(A,B)\min(A,B)^2$ FLOPs),这与 Megatron 的分片有两处冲突:TP 下没有任何 rank 拥有完整权重矩阵;DP 下成本对较短维是三次方的,所以 Megatron 的等元素划分会留下严重的掉队者(straggler)。为此开发了 Canzona,把逻辑上的优化器分配与物理参数布局解耦:一个 $\alpha$-balanced 静态划分器按整个参数(不在张量内部切)重新分配,以均衡各 DP rank 上的估计 NS FLOPs;一个异步的 Micro-Group 流水线通过跨 TP rank 的融合 All-to-All 重构每个 Muon 拥有的矩阵。每个 owner 随后执行一个在数学上等价于单设备 Muon 的步骤,ZeRO-1 的 bucket 几何被保留,Megatron 的 Reduce-Scatter / backward 重叠得以保留。(b) 拆分后一层贡献上百个子矩阵,优化器步骤退化成一长串很小的 kernel,瓶颈变成 launch 开销而非算术——因此把整个步骤捕获进 CUDA graph 来消除这个开销。
超参数 scaling(§3.2)¶
动机:最优学习率与 batch size 取决于模型架构与优化器,所以在两者都改变之后,上一代最优的配方可能变得次优。在 Qwen3.5 的超参数配方下,新架构与新优化器训练得明显更稳(§3.3),暗示还有空间采用更激进的超参数设定。因此重新拟合超参数 scaling law,其预测把近最优超参数同时推向更大的 batch size 与更大的学习率,且学习率随模型规模的衰减更慢。
验证策略很讲究:在最能放大各自效应的机制里分别验证——batch size 预测在"小模型 + 长 token 预算"上验证(过大的 batch size 在此更容易导致次优);学习率预测在"大模型 + 有限 token 预算"上验证(此时训练不稳定是主要风险)。
Batch Size(Figure 8):在 20 层 10.8B-A0.89B MoE、4T token 预算上评测。对比旧配方($B = 12.6\mathrm{M}$)、新 scaling law 预测的最优($B = 25.2\mathrm{M}$)、以及 1.5× 更大($B = 37.7\mathrm{M}$),每个配置用 scaling law 为各自 batch size 规定的学习率,所有 run 消耗相同 token 预算(等算力对比)。
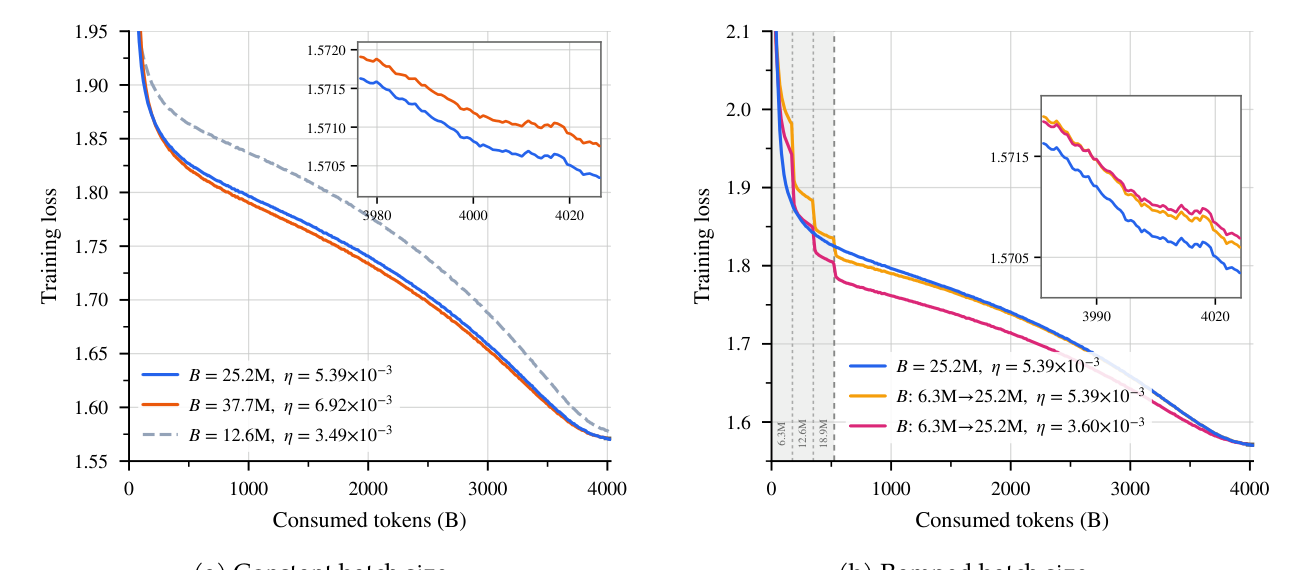
最后 20B token 上平均的 loss:$B=25.2\mathrm{M}$ 为 1.5702,$B=37.7\mathrm{M}$ 为 1.5707,旧配方为 1.5774。即新拟合相对旧配方改善 $7.2 \times 10^{-3}$,而进一步 1.5× 增大 batch 只带来 $4.3 \times 10^{-4}$ 的惩罚(不显著)。loss 在预测 batch size 以下急剧上升、以上则趋平,说明预测接近最优且足够大到能实现性能收益而不至于过头。
Batch-size warmup 不再必要:大规模训练通常在早期 ramp batch size,理由是临界 batch size 早期小、随训练增长。但作者此前的超参数扫描显示 Muon 下行为不同——把 batch size 降到预测最优以下的惩罚,比升到以上更严重;且 Muon 在 AdamW 会退化的更大 batch 处仍能保持数据效率;对稀疏 MoE,更大的 batch 还确保每个专家每步收到充分且多样的 token 信号。据此假设 warmup 可能不必要,并重测:batch size 从 6.3M 起以 6.3M 为增量上升,在 524B token 处达到 25.2M 目标。两个变体——第一个保持恒定 batch 最优的峰值学习率(ramp 是唯一差异),第二个降低峰值学习率以适配早期更小的 batch。
两个变体都没有改善:都在 run-to-run 方差内收敛但仍略差于恒定 batch 基线,分别落后 $2.5\times10^{-4}$ 与 $3.5\times10^{-4}$。此外 warmup 在同样 token 预算下需要多 18.8% 的优化器步数,带来更大的墙钟开销。训练稳定性也不受影响:这批扫描中没有任何一个 run 出现 loss 超过其局部中位数 0.1 以上的步,p99.9 的 pre-clip 梯度范数在 0.088–0.190,远低于 0.5 的裁剪阈值。
机制解释也给得很清楚:warmup 阶段较小的 batch 在同样学习率下引入更高的梯度噪声,导致 loss 高于恒定 batch 基线;batch 达到目标后不久,warmup 变体可能因早期累积了更多优化步而短暂领先;但随着学习率衰减、模型接近收敛,这个步数优势被抵消,最终恒定 batch 基线反超。因此生产 run 不使用 batch-size warmup。
Learning Rate(Figure 9 与 Table 10):在大得多的 48 层 156B-A7B MoE、419B token 预算上测试(每个 run 预算相同)。评测预测最优、学习率乘除 $\sqrt{2}$、25% 更大 batch 配匹配学习率、以及旧配方。
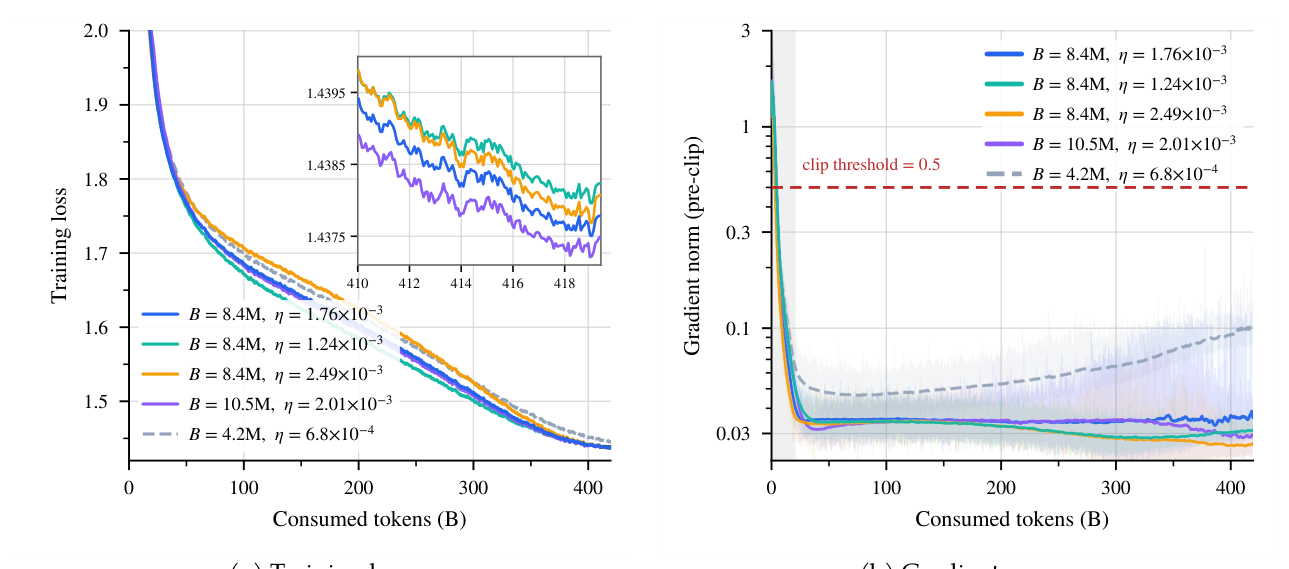
旧配方比预测最优高 $7.8\times10^{-3}$,而预测最优附近的四个设定彼此终值相差在 $7\times10^{-4}$ 以内(接近噪声水平)。因此最优点位于一个在学习率上至少覆盖 $\sqrt{2}$ 倍两个方向、在 batch size 上覆盖 +25% 的平坦盆地底部;更大的 batch 名义上是四者中最好的,领先 $3\times10^{-4}$。
Table 10:五个 run 的下游准确率(同为 419B token 预算,48 层 156B-A7B MoE)
| Setting | $B$ | $\eta$ | MMLU | MMLU-Pro | SuperGPQA | MATH | GSM8K | BBH | MMMLU | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|
| New fit, predicted optimum | 8.4M | $1.76\times10^{-3}$ | 73.84 | 48.35 | 29.31 | 49.98 | 80.89 | 73.25 | 68.23 | 60.55 |
| New fit, $\eta \div \sqrt{2}$ | 8.4M | $1.24\times10^{-3}$ | 73.59 | 47.00 | 28.10 | 48.92 | 77.48 | 72.00 | 66.88 | 59.14 |
| New fit, $\eta \times \sqrt{2}$ | 8.4M | $2.49\times10^{-3}$ | 73.84 | 46.92 | 28.04 | 49.58 | 80.06 | 73.82 | 68.46 | 60.10 |
| New fit, $B \times 1.25$ | 10.5M | $2.01\times10^{-3}$ | 73.73 | 48.51 | 28.52 | 49.32 | 80.06 | 72.58 | 67.72 | 60.06 |
| Qwen3.5 recipe | 4.2M | $6.8\times10^{-4}$ | 71.23 | 45.35 | 25.67 | 45.54 | 74.32 | 69.54 | 63.19 | 56.41 |
结论分析:预测最优取得最高平均准确率(60.55),旧配方明显落后(56.41,差 4.14 分)。关键在于:超出预测最优地增大 batch size 或学习率只带来边际的、统计上不显著的下降——说明这是一个高度稳定的优化景观。论文自己加了一句难得的自我克制:"We treat these specific rankings as observational; given the single evaluation per run and the narrow margins among the top settings, these minor variations likely fall within standard evaluation noise."(我们把这些具体排名视为观察性的;每个 run 只评测一次且顶部设定之间边际很窄,这些微小差异很可能落在标准评测噪声内。)
训练动力学:五个 run 中梯度裁剪在 warmup 后从未触发。预测最优处的最大 pre-clip 梯度范数只达到裁剪阈值的 28%,而旧配方达到 51%(其更小的 batch 带来更嘈杂的梯度)。loss 曲线极其平滑,没有任何一个 run 出现 loss 超过局部中位数 0.1 以上的步。在这个规模上进一步提高预测学习率仍然完全稳定,确认新 scaling law 没有危险地外推过头。
稳定性压力测试(§3.3)¶
动机:模型扩到万亿参数、训练几十万亿 token 时,会进入一个在小规模实验中完全不存在的稳定性区间——长 run 会在峰值学习率上花掉多得多的优化步,增加不稳定出现的机会,通常表现为需要 checkpoint 重启的 loss spike 或发散。为了在中等规模上高效迭代同时仍能暴露生产规模才会出现的不稳定,设计了一组在更小预算内放大相关压力的压力测试。
压力测试设计:沿用 Wortsman et al. (2023) 的观察——大规模不稳定可以通过提高学习率在小模型上复现——把学习率恒定保持在其最优值的某个倍数,绕过标准衰减调度以模拟生产 run 的长时间峰值学习率。施加于 28 层 MoE,倍数为 2× 与 4×。
评价准则:"the new recipe must be at least as stable as the generation it replaces under equal stress"(新配方在同等压力下必须至少与它取代的那一代一样稳定),即对照组是已经被成功扩展过的 Qwen3.5 结构 + AdamW。所有 run 共享同一 batch size 与 0.5 的梯度范数裁剪阈值。测量三个量:
- loss spike:超过 201 步滚动中位数 0.1 以上的步;
- pre-clip 梯度范数的 p99.9 与穿越阈值的次数;
- 每 block 的最大激活。
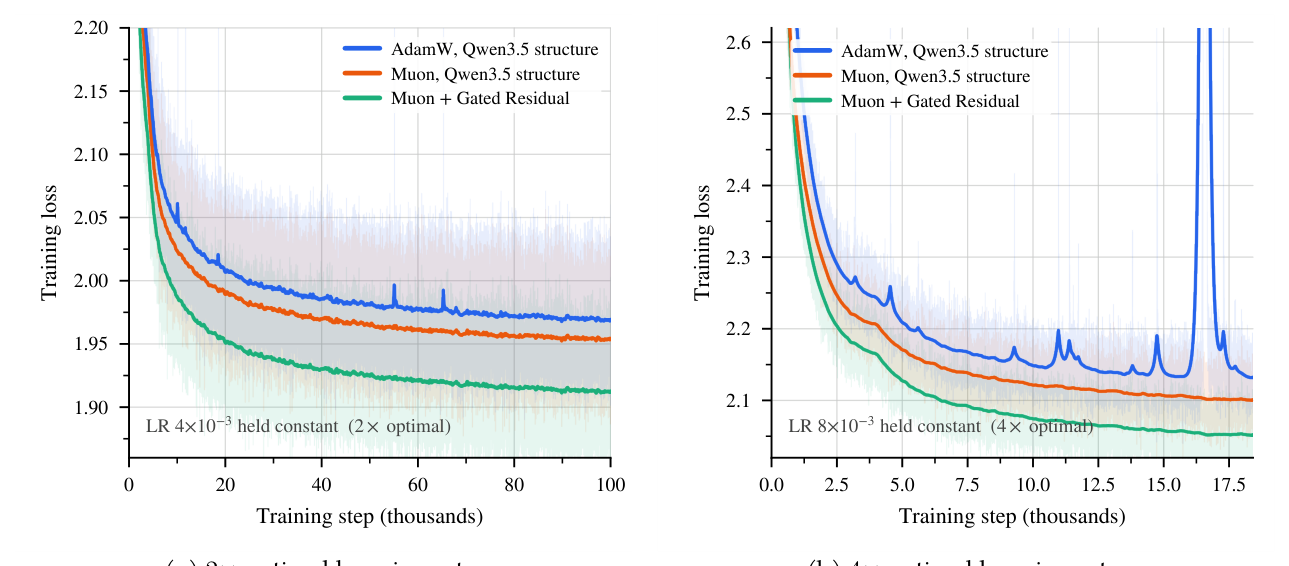
压力测试结果——这一节给出了全文量化程度最高的证据:
| 压力 | 配置 | loss spike 率 | 穿越 0.5 阈值 |
|---|---|---|---|
| 2× 最优 LR | AdamW + Qwen3.5 结构 | 4.3 / 10k 步 | — |
| Muon + Qwen3.5 结构 | 0.2 / 10k 步 | — | |
| Muon + GR | 0.2 / 10k 步 | — | |
| 4× 最优 LR | AdamW + Qwen3.5 结构 | 183 / 10k 步 | 213 / 19,932 步(持续触发裁剪) |
| Muon + Qwen3.5 结构 | — | 从不穿越 | |
| Muon + GR | 0(零 loss spike) | 从不穿越 |
在 4× 学习率下差异变成定性的(categorical):AdamW run 持续触发裁剪器,而两个 Muon run 从未穿越阈值,且带 GR 的配置记录到零 loss spike。
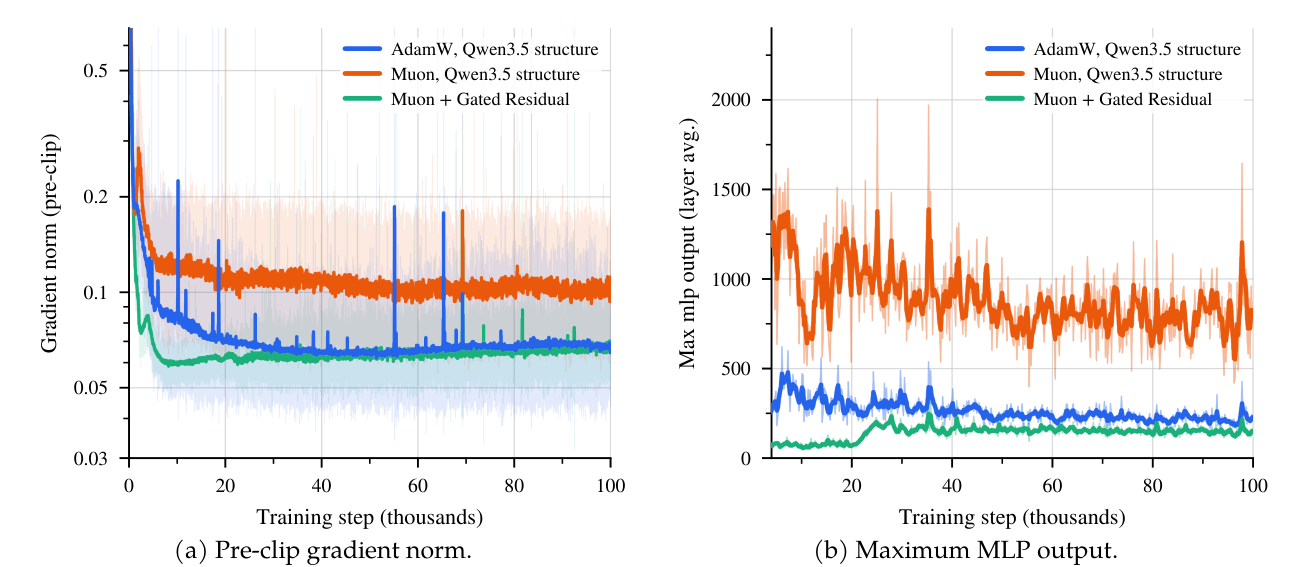
机制:门的作用。 分析梯度范数与激活给出了这个稳定性余量的来源。在 2× 最优学习率下,Muon run 的中位梯度范数与最大激活都比 AdamW 更高,却产生远少的 loss spike——这是一个反直觉但重要的观察:spike 与梯度范数的绝对大小不是一回事。加上 GR 之后,梯度范数尖峰的频率与幅度、以及激活 outlier 的幅度都被降低。
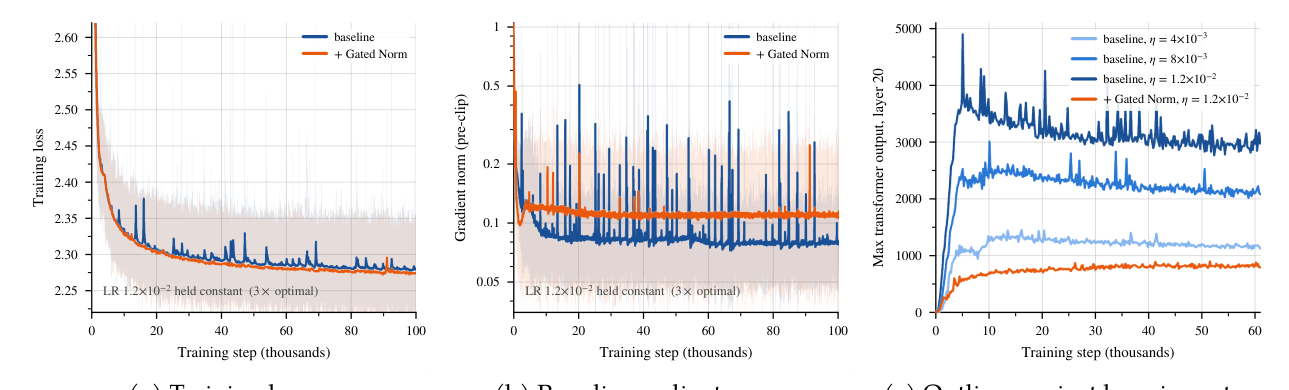
为隔离门本身的效应,在 28 层模型上做了一个单变量对照:保持 AdamW 优化器、结构与数据顺序不变,只开关 GatedNorm,学习率固定在 3× 最优。结果:
- spike 率从 32.0 降到 3.2 每 10k 步(10× 改善);
- 穿越阈值次数从 256 降到 20。
对无门基线做的学习率阶梯(Figure 12c)显示:激活 outlier 几乎与学习率成正比增长,而 spike 率增长得快得多。而门开启后在最高学习率下,outlier 水平反而低于无门基线在最低学习率下的水平。
论文由此给出一个明确的机制假说:"training at high learning rates requires a rescaling mechanism: without an explicit gate, the network achieves this by growing activation outliers, leaving it fragile; the multiplicative gate supplies the necessary rescaling directly, keeping the training stable."(高学习率训练需要一个 rescaling 机制:没有显式的门,网络就靠增长激活 outlier 来实现它,从而变得脆弱;乘性门直接提供所需的 rescaling,从而保持训练稳定。)
生产 run 上的验证(Figure 13):压力测试通过偏离出厂配置来放大不稳定,作者也验证了稳定性收益在真实生产训练配置下依然存在。对比三个共享相同数据顺序、学习率调度与优化器的 run 的前 276B token:Qwen3.5 结构 + Muon、同结构 + GR、以及完整的 Qwen3.8-Flash-Next 配方(含进一步精炼的 GR 与 n-gram 嵌入层)。
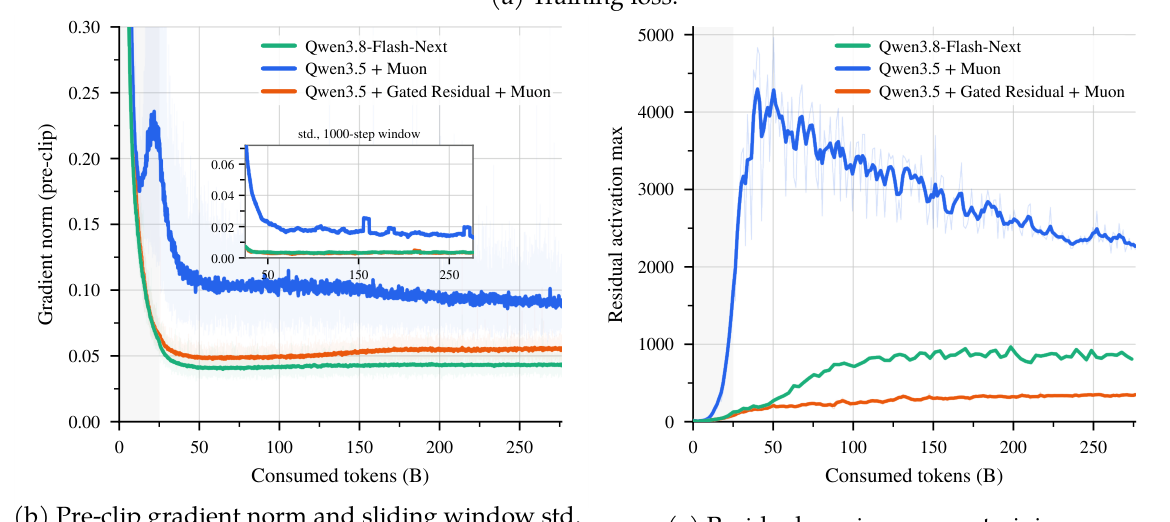
| 指标 | Qwen3.5 + Muon | + Gated Residual | Qwen3.8-Flash-Next |
|---|---|---|---|
| 276B token 处的 loss | 基准 | −0.026 | −0.058(再降 0.032) |
| 中位 pre-clip 梯度范数 | 0.097 | 0.053 | 0.043 |
| p99.9 pre-clip 梯度范数 | 0.298 | 0.071 | 0.066 |
| 是否穿越裁剪阈值 | 是(唯一) | 否 | 否 |
| 1000 步窗口内梯度范数标准差 | 基准 | 低 4.3–4.7× | 低 4.3–4.7× |
结论分析:Muon 单独使用的中位梯度范数约为任一带门 run 的两倍、p99.9 是 4.2 倍,且是唯一穿越裁剪阈值的 run。带门 run 也更平稳,1000 步滚动窗口内的标准差低 4.3–4.7×——在 8 倍于压力测试的模型规模上、在生产学习率下复现了压力测试的发现。把残差读与 LM head 前的最终归一化融合成一次门控读操作进一步降低了梯度范数,很可能是 Flash-Next 与 Muon+GR 配置之间差距的主要来源。在激活上(Figure 13c),加 GR 在每一个被探测的深度上都一致地显著降低残差最大值。这使得无需 qk-clip 或 SwiGLU-clip 这类显式激活控制也能稳定训练。
论文在引言中还给出了终局论断:"As a direct result of these stability enhancements, the full-scale training of Qwen3.8-Flash-Next proceeded smoothly without a single loss spike or anomalous fluctuation in gradient norms."(全尺寸训练顺利进行,没有一次 loss spike,梯度范数也没有异常波动。)
复核提示:这句关于全尺寸 125B 生产 run 的论断是纯叙述——没有全程 loss 曲线、没有 spike 计数、Figure 13 只覆盖前 276B token。而 Flash-Next 的全量训练 token 数远大于此(论文只说是 Qwen3.7-Plus 的 1/3)。
最终评测(§4)¶
评测覆盖 14 个 benchmark:
- 通用:MMLU (5-shot)、MMLU-Pro (5-shot, CoT)、MMLU-Redux (5-shot)、BBH (3-shot, CoT)、SuperGPQA (5-shot, CoT)
- 数学与 STEM:GPQA (5-shot, CoT)、GSM8K (4-shot, CoT)、MATH (4-shot, CoT)
- 代码:EvalPlus (0-shot;HumanEval / MBPP / HumanEval+ / MBPP+ 的平均)、MultiPL-E (0-shot;Python/C++/Java/PHP/TypeScript/C#/Bash/JavaScript)、SWEBench-Pretrain(SWE-bench 的预训练变体:喂给基座模型问题描述与相关代码文件,要求产出 diff patch,用黄金 patch 与模型生成 patch 的序列相似度作为分数)
- 多语:MGSM (8-shot, CoT)、MMMLU (5-shot)、INCLUDE (5-shot)
Table 11:与两个强基座的对比
| Qwen3.8-Flash-Next-Base | Qwen3.8-27B-Base | Qwen3.7-Plus-Base | |
|---|---|---|---|
| # Params | 125B | 27B | 397B |
| # Activated Params | 6B | 27B | 17B |
| # N-gram Embedding Params | 51B | – | – |
| General | |||
| MMLU | 90.36 | 87.51 | 90.43 |
| MMLU-Redux | 90.68 | 87.26 | 91.47 |
| MMLU-Pro | 73.23 | 68.60 | 70.90 |
| SuperGPQA | 51.36 | 44.86 | 48.42 |
| BBH | 90.87 | 89.56 | 89.41 |
| Math & STEM | |||
| GPQA | 51.42 | 45.01 | 51.52 |
| GSM8K | 93.29 | 93.18 | 92.95 |
| MATH | 72.78 | 60.54 | 74.38 |
| Coding | |||
| EvalPlus | 78.76 | 76.05 | 78.06 |
| MultiPL-E | 79.09 | 74.50 | 81.68 |
| SWEBench-Pretrain | 50.99 | 41.66 | 49.24 |
| Multilingual | |||
| MGSM | 89.33 | 86.37 | 85.42 |
| MMMLU | 84.86 | 79.74 | 84.53 |
| INCLUDE | 78.40 | 74.37 | 78.90 |
结论分析:Flash-Next-Base 在全部 14 个 benchmark 上一致优于 Qwen3.8-27B-Base。相对大得多的 Qwen3.7-Plus-Base,它在 8/14 上领先(MMLU-Pro +2.33、SuperGPQA +2.94、BBH +1.46、GSM8K +0.34、EvalPlus +0.70、SWEBench-Pretrain +1.75、MGSM +3.91、MMMLU +0.33),在其余 6 项上落后,最大落差是 MultiPL-E 的 2.59 分(其次 MATH −1.60、MMLU-Redux −0.79)。
值得注意的分布规律:Flash-Next 赢的是推理密度高、需要长/多步组合的项(MMLU-Pro、SuperGPQA、BBH、SWEBench-Pretrain)与多语项(MGSM、MMMLU);输的是知识记忆密集(MMLU、MMLU-Redux、GPQA)与代码多语言生成(MultiPL-E、MATH)。这与 §2.3 中"n-gram 词表扩展在中文知识 benchmark 上单调涨、在数学上早早饱和"的观察方向一致——外挂的稀疏查表记忆补的是词汇/知识,而非组合推理。
这些结果是在约 1/3 的激活参数、1/3 的训练 token、约 1/9 的训练 FLOPs 下达成的。除了训练效率,架构改进加上大幅减少的激活参数数量也带来显著更低的推理成本。
核心贡献总结¶
- 一套可迁移的三轴设计协议:每个候选架构改动同时按「loss + 下游 benchmark」「训练/prefill/decode 三阶段成本」「最优超参与训练稳定性」评估,并显式记录三轴分歧。这是本文最有普适价值的部分,与具体模型无关。
- Qwen Sparse Attention:把稀疏注意力的 indexer 本身也稀疏化——先在微块粒度做 AvgPool 压缩(且压缩在位置编码之前)再打分,把 indexer 从 $O(n^2)$ 降到 $O(n^2/r)$;两阶段(稠密蒸馏 → 稀疏联合训练)训练配方;对混合架构比跨层索引共享更适配。
- Gated Residual:把"拓宽残差流"(AltUp/HC/mHC 谱系)与"逐元素自门"(GatedNorm)合并成一个算子,表达力全部押在读上、丢掉分支混合算子 $H_{\mathrm{res}}$,同时拿到质量、显存流量与稳定性三重收益。配套的 $\pi_{uv}$ 精确分解(式 35–37)给出了"多余的宽度被花在少数几条被放大的长程与相邻路径上、代价是中程路径"的机制证据。
- n-gram 嵌入表卸载:把参数容量的一部分移出加速器,用确定性寻址 + 主存预取,几乎不增加 per-token FLOPs;并给出"哪一层放、放几层、词表多大"的完整消融与一段负面结果记录。
- 稳定性的可量化定义与压力测试协议:loss spike = 超过 201 步滚动中位数 0.1 的步;配合 p99.9 pre-clip 梯度范数、阈值穿越计数、每 block 最大激活三个指标;用"恒定学习率 = $k\times$ 最优"复现生产规模的不稳定;并对门做单变量隔离。
- Muon 的工程化:拆分融合参数后再正交化(qkv 按 per-head、fc1 按 gate/up)、按估计 NS FLOPs 做 DP 负载均衡(Canzona)、把碎片化的优化器步捕获进 CUDA graph;并明确列出哪些参数不该用 Muon(router、GR 低秩投影、嵌入与输出头)及其理由。
与已归档相关工作的对比¶
Kimi K3 Kimi K3: Open Frontier Intelligence(Moonshot AI,2026-07-27)¶
关系:独立并发(本文未引用 Kimi K3,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都把"把 MoE 底座推到更大规模、把上下文推到 1M"分解成三个正交的结构性瓶颈,且分解方式几乎逐条对应。Kimi K3 的三维是「序列维(KV cache 随长度线性增长)/深度维(标准残差把所有前序信息压进单一状态 $h_l$,被明确形容为"类似 RNN 沿时间的瓶颈")/宽度维(极端稀疏 MoE 的激活爆炸与负载失衡)」;本文的四个组件里,前三个正好落在同样的序列维与深度维上。两者对深度维的病因诊断是同一句话:单一残差流对每个写者只有一个衰减率,早写入的内容必须与之后写入的一切竞争。
- 相近的技术骨架:(a) 序列维——Kimi K3 每个 block 是 3 层 Kimi Delta Attention (KDA) + 1 层 Gated MLA(3:1);本文是 3 层 GDN + 1 层全注意力/QSA(同样 3:1)。两者的线性层参数化也高度重合:q/k/v 都过 ShortConv 再过 Swish/SiLU、q/k 都做 $\mathrm{L2Norm}$、都用 sigmoid 写门 $\beta_t$、都在输出处加 data-dependent sigmoid 门 + RMSNorm。(b) 深度维——Kimi K3 用 Attention Residuals(每层用可学习 pseudo-query 对前序层做 softmax 注意力,Block 变体分 8 块);本文用 GR(拓宽成 4 条分支 + 逐元素门控读)。两者是解决同一问题的两个不同答案,而本文的 Table 6 恰好把它们放在同一张表上直接比过:Full AttnRes 与 GR 在 28 层上打平(同为 1.762),48 层上 GR 略优(1.707 vs Block AttnRes $S{=}4$ 的 1.711)。(c) 稳定性——两者都把"无界乘性因子产生激活 outlier"认定为不稳定的根因,都用有界门来治:Kimi K3 用 scaled sigmoid 给 KDA 的 log-decay 加下界($g_{\min} = -5$)并用 SiTU-GLU 的 $\mathrm{softcap}$ 给 SwiGLU 的两个乘性因子加软上界;本文用 GatedNorm/GR 的 sigmoid 门直接供给 rescaling,从而让网络不必靠长 outlier 来实现它。
- 本文的差异与推进:(a) 本文在混合架构里进一步把全注意力层换成稀疏注意力(QSA),Kimi K3 的 Gated MLA 层仍是稠密全局注意力(走的是 KV 低秩压缩而非稀疏化);(b) 本文的 $\pi_{uv}$ 分解(式 35–37)给出了跨层信息流的精确守恒分解,回答了"多出来的宽度被花在哪",Kimi K3 对 AttnRes 只给了动机与设计,没有同等深度的机制探针;(c) 本文额外有一整条 n-gram 嵌入卸载轴,Kimi K3 没有;(d) 本文有系统的超参数 scaling law 重拟合 + 压力测试方法论章节,Kimi K3 侧重 scaling law 与基础设施。反过来,Kimi K3 在 KDA 的 kernel 层级做得更深(lower-bounded decay 使对角 tile 也能用 Tensor Core 稠密矩阵乘,彻底消掉 position-pair 路径),本文的 FlashQLA 只给了一句 2–3× 的加速比。
- 可比的方法/实验差异:两者规模差一个量级(Kimi K3 2.8T-A104B / 93 层 vs Flash-Next 125B-A6B),评测套件也不同(Kimi K3 面向 agentic/coding 前沿对比,本文面向预训练 base 模型对比),因此没有可以直接对齐的数值。但两者对同一组设计选择的独立收敛本身就是最强的信号:3:1 的线性/全注意力混合比、跨层残差机制、有界 sigmoid 门抑制 outlier——三家团队(Qwen、Moonshot,以及下面的 Ant Group)在同一季度独立走到同一处。
DeRes DeRes: Decoupling Residual Stability and Adaptivity(2026-06-08)¶
关系:独立并发(本文未引用 DeRes,DeRes 也发表在先但方向是 CTR;两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇把同一个 root cause 写成了几乎相同的句子。DeRes 列出标准残差在 pre-norm 下的三个副作用:「Pre-Norm 信号稀释(层输出被加到已归一化的残差流上,早期层特征被逐层冲淡)」「无法遗忘(恒等跳连以权重 1.0 保留一切)」「单层视野(每层只能看到直接前驱)」。本文 §2.2 开篇是:「pre-normalization 衰减了每一层接收到的信号:每个 block 读的是同一条流,因此一个早期写入的特征必须和之后写入的一切内容竞争」。这是同一个诊断。更巧的是两者的参照系完全相同:DeRes 明确把 DenseFormer、AttnRes、Hyper-Connections / mHC、MUDDFormer 列为前序工作并逐一实现为 CTR baseline;本文 Table 5/Table 6 的对照组正是 mHC(static/dynamic)与 AttnRes(Full/Block)。
- 相近的技术骨架:两者的最终形态在门控读取这一点上高度同构。DeRes 用两条并行路径(Path 1 固定恒等残差保稳定 + Path 2 块注意力残差保适应性),再用一个向量级 sigmoid 门 $\gamma_l = \sigma(W_g[r_l; d_l] + b_g)$ 逐维融合,理由是"让每个隐藏维度独立选择信息来源"。本文的 GR 用 4 条分支各自 RMSNorm 后,用一个从所有分支预测的逐元素 sigmoid 门 $G \in \mathbb{R}^{n_r \times d}$ 加权平均(式 31–32),理由同样是"读的粒度比写的粒度更重要"。两者都得出写端保持粗粒度的结论:DeRes 的 Path 2 写入是 block 求和;本文的 $H_{\mathrm{combine}}$ 保持 per-branch 标量(式 33),且明确说把写也细化到 per-channel"几乎没有收益"。
- 两处独立收敛的结论:(a) 可学习残差矩阵不如固定恒等。DeRes 的 Proposition 2 从理论上论证最小奇异值小于 1 的可学习残差矩阵会随深度累积指数衰减,并在讨论里直接引用"Qwen3 的实验报告 $H^{\mathrm{res}} = I$ 最终胜过可学习替代";本文则用实验独立得到同一结论——"$H_{\mathrm{res}}$ 贡献很小,一旦读和写足够有表达力,加上那个 $n_r \times n_r$ 混合算子没有显著改善",并进一步把它彻底删掉以省下每 block 一次残差状态读取。(b) 本文归档中另一条 DAG 边记录了 DeRes 对 mHC 的诊断("mHC 的双随机可学习残差矩阵随深度谱衰减,$\rho \approx 0.49$"),与本文"丢掉需要单独约束的 $H_{\mathrm{res}}$ 也移除了一个潜在不稳定来源"的表述互为印证。
- 本文的差异与推进:(a) 拓宽 vs 不拓宽——DeRes 保持单条残差流(只是切成 $d/2 + d/2$ 两路通道),本文真正把流拓宽成 4 条独立分支,因此才有式 (35)–(37) 那种"每条分支独立、贡献可精确分解"的分析能力,这是 DeRes 结构上做不到的。(b) Softmax vs 门——DeRes 的核心 CTR 特化是把跨层 Softmax 换成 Pointwise SiLU(论据:用户同时持有多个兴趣,跨层零和竞争是错误的归纳偏置,且 SiLU 的负分支提供"软遗忘");本文走的是完全不同的路线——不做跨层注意力,而是靠 4 条分支的写门 $s_c^{(u)}$ 天然实现"同一个输出以不同强度到达不同距离的读者"(Figure 7 的第三个例子),论文明确说"这是单一残差流无法表达的,因为它对每个写者只有一个衰减率"。两者在功能上等价地解决了"多重并行通路"的需求,但一个靠去掉 Softmax 归一化、一个靠增加物理分支数。 (c) 稳定性论证的强度——DeRes 靠三个命题做理论论证,本文靠压力测试给出可复现的量化证据(spike 率 32.0 → 3.2 / 10k 步)。
- 可比的方法/实验差异:规模与领域相差极大(DeRes 是 8 层 $d{=}128$ 的 CTR Transformer、评测 Criteo/Avazu/工业数据集的 AUC;本文是 25B–125B 的 LLM、评测 loss 与 MMLU 族),没有任何可直接对齐的数值。但 DeRes 自己写了一节"为什么 CTR 比 LLM 受益更多",理由是 CTR 只有 4–12 层而 LLM 有 32–128 层、每层承担的预测比例更大——这恰好可以用本文 Table 6 的深度趋势来检验:从 28 层到 48 层,GR 相对 Block AttnRes 的优势从"打平"(1.762 vs 1.762)扩到 0.004(1.707 vs 1.711),即更深反而让残差机制的差异更明显,与 DeRes 的直觉方向相反。这是一个值得后续验证的分歧点。
PowLU PowLU: An Activation Function for Stable Pre-training of LLMs(Ling Team, Ant Group,2026-05-25)¶
关系:独立并发(本文未引用 PowLU;但 Kimi K3 引用了它,三篇构成一个环)· 已加载对方精读
- 共同关注的问题:两篇对训练不稳定给出的因果链完全一致:无界的乘性因子 → 前向/反向激活 outlier → loss spike / 梯度 spike → 需要裁剪甚至崩溃,且在低精度下更严重。PowLU 把矛头指向 SwiGLU:$\mathrm{SwiGLU}(x) = x^2 \cdot \mathrm{sigmoid}(x)$,当 $x$ 变大时 $\mathrm{sigmoid}(x) \to 1$,输出趋近二次函数,对大输入有强烈放大效应,随层数增加累积恶化,FP8/FP4 下部分激活会超出可表示范围。本文 §3.3 的结论句是同一个机制的另一半:"训练在高学习率下需要一个 rescaling 机制;没有显式的门,网络就靠增长激活 outlier 来实现它,从而变得脆弱。" 一个说"无界的乘性形式制造 outlier",一个说"缺少显式门时网络被迫制造 outlier"——这是同一枚硬币的两面。
- 相近的技术骨架:两者的解法都是给乘性通路加界,且都刻意避开硬截断。PowLU 用有理幂 $x^{1 + m/(\sqrt{x}+1)} \cdot \mathrm{sigmoid}(x)$ 把正区间增长从二次压到"亚二次、近线性",并证明其连续性、可微性、单调性与有界增长四条性质,明确批评 SwiGLU-Clip 的硬截断会丢弃有用信息、且梯度在截断点不连续。本文的 GR/GatedNorm 用 sigmoid(有界于 $(0,1)$)而非 tanh 或 SiLU 作为门函数,并把这条选择贯穿到 GDN 输出门(明确从原始 GDN 的 SiLU 门改成 sigmoid)与 gated attention;论文还直接点名说这套配方使得无需 qk-clip 或 SwiGLU-clip 这类显式激活控制——PowLU 极力反对的那个 baseline,正是本文声称自己不再需要的那个东西。
- 本文的差异与推进:干预点不同。PowLU 改的是 FFN 内部的激活函数(每个 expert 的 fc1→fc2 之间),本文改的是残差流的读取算子(每个子层的入口)。两者是可以叠加而非互斥的。证据强度上也各有侧重:PowLU 的证据是 7.9B/124B MoE 上的 loss 曲线(SwiGLU FP8 出现明显 spike,SwiGLU-Clip FP8 延后但仍在约 77,000 步 spike,PowLU FP8 全程平滑维持在约 1.32)、P1–P99 张量分布图与 outlier channel 可视化——都是分布层面的证据;本文的证据是计数层面的(spike 率 4.3 / 0.2 / 183 / 0 每 10k 步、阈值穿越 213/19,932、单变量隔离 32.0 → 3.2、p99.9 梯度范数 0.298 vs 0.071/0.066)。本文的量化更严格(有 loss spike 的操作定义 + 单变量对照),PowLU 的机制可视化更直观。
- 一个值得注意的三角关系:Kimi K3 的 SiTU-GLU 一节明确引用了 PowLU,称其为"其他近期工作也探索过这一 trade-off 的替代参数化",并给出与 PowLU 高度相似的诊断("SwiGLU 的两个乘性因子都是无界的,同时出现的大坐标会产生激活 outlier"),最终选择用 $\mathrm{softcap}(x,\beta) = \beta\tanh(x/\beta)$ 平滑封顶。于是本库中三篇 2026 年的前沿 LLM 架构工作——Qwen3.8-Flash-Next、Kimi K3、PowLU——对同一个不稳定根因给出了三个不同位置的有界化方案(残差读门 / GLU 软 cap / 激活函数幂次),而 Qwen 这一篇是唯一一篇既不引用另外两篇、又给出最强量化证据的。
被剔除的近似候选与理由(防止门槛放水):
- KSA KSA(Kuaishou):问题高度同构(长上下文 KV cache 与注意力成本,且它直接把 hybrid-KSA 与 hybrid-GDN 对比,RULER-128K 上高 5.48 分)。但解法路径在关键一步分岔:KSA 是压缩后全部读取(可学习 summary token 做序列级压缩 + sliding chunk attention,从不做选择),QSA 是压缩后 top-k 选择(AvgPool 微块 → 打分 → 选块 → 展开)。前者的长程信息经"压缩中继"路由,后者是显式稀疏 mask。方法流程图无法抽象重合,剔除。
- GBLA GBLA(Yandex):结构上极像 GDN 块(核化线性注意力 + Conv1D + key 门控 + gated RMSNorm,且用
[SA, LA, LA]的层级混合),但它是双向编码器用于生成式检索,问题陈述是检索侧的序列建模效率,不是自回归 LLM 的 KV cache + 训练稳定性联合问题。问题不同构,剔除。 - TokenMixer-Large TokenMixer-Large(ByteDance AML):用户点名要求判断。它确实诊断"深度 scaling 瓶颈"并引入层间残差,与 GR 表面同轴。但其 root cause 是 mixing-reverting——TokenMixer 在异构特征 token 上的混合操作会自我反转,这是 CTR 特征 token 特有的病理,与 pre-norm 单流残差的信号稀释不是同一个 root cause;其层间残差是解决 mixing-reverting 的副产品而非主线。不同构,如实剔除。
- RankElastor RankElastor(Tencent):用户点名要求判断。它诊断 RankMixer 的 effective rank 呈阻尼振荡(token mixing 扩张、P-FFN 收缩),解法是"参数化全混合 + GLU 改进的 P-FFN"——动的是混合算子与 FFN 的谱性质,完全没有触碰层间/残差通路。问题层面只是同属"深度收益递减"这个宽泛主题,解法层面无重合。不同构,如实剔除。
- LoopCTR LoopCTR:确实用了 Hyper-Connected Residuals(与 GR 同族的 HC 谱系)。但它的核心问题是"参数量受限下如何靠循环共享块加深"(loop scaling 作为第四条轴),HC 残差只是稳定循环的辅助组件,不是主张。问题不同构,剔除。
- Compute-Optimal Is Not Cluster-Optimal: Systems-Aware Scaling for Sparse Mixture-of-Experts MOSAIC(Amazon AGI):问题层面很接近本文的方法论主张(把系统成本折进 scaling law,而非先定架构再谈效率)。但解法是拟合一个四维联合 scaling law $L(N_{\mathrm{tot}}, S, D, G)$ 求联合最优,本文是对每个候选改动做三轴并行报告——一个是数值优化,一个是评审协议,不是同一张方法流程图。剔除。
- Let's Scale Step by Step: Compute-Efficient Hyperparameter Transfer for Large-Scale Mixture-of-Experts Kakao muP 超参迁移:与本文 §3.2 的问题几乎相同(Muon + MoE 下最优 LR/BS 漂移,需要避免 2D 全扫描)。但 §3.2 只是本文的支撑章节而非核心解法,且 Kakao 走 muP 零样本迁移、本文走经验幂律重拟合。作为局部同构不足以入选。剔除。
讨论与局限性¶
值得借鉴的设计¶
- "三轴联合"作为评审协议而非口号。论文真正的可迁移资产不是 GR 或 QSA,而是那条纪律:任何一根轴单独看都会做出错误决策。文中给出了三个具体的反例——稀疏残差写入(预训练免费、后训练退化)、NoPE(预训练无差别、后训练无限生成)、batch-size warmup(直觉上应该有用、实测多花 18.8% 步数还更差)。这套协议对推荐系统的大模型排序/生成架构同样成立:离线 AUC 与线上 A/B、训练成本与推理成本、以及"这个改动会不会让训练变得难调",本来就是三件事。
- 把表达力花在"读"而不是"混合"上。GR 的关键取舍是:读做到逐元素、写保持标量、混合算子直接删掉。删 $H_{\mathrm{res}}$ 省下的是每 block 一次对整个残差状态的读取——在推理阶段这是拓宽残差流的主要成本。这是一个典型的"质量打平但成本减半"的决策,而这类决策只有在成本轴被显式建模时才会被做出来。
- 精确守恒的机制探针。式 (35)–(37) 的 $\pi_{uv}$ 分解只在"分支之间不混合"时才成立(这也是删掉 $H_{\mathrm{res}}$ 的意外红利)。为了可解释性而做减法,然后用得到的可解释性反过来证明设计是对的——这个循环在架构论文里很少见。
- 稳定性的可操作定义。"loss spike = 超过 201 步滚动中位数 0.1 的步"是一个可以直接抄进任何训练监控系统的定义;配合 p99.9 pre-clip 梯度范数与阈值穿越计数,把"训练稳不稳"从叙述变成了三个可比较的数字。
- 压力测试的构造:恒定学习率在 $k\times$ 最优上跑,用小模型放大生产规模才出现的不稳定;以及"新配方必须在同等压力下至少与已被成功扩展过的上一代一样稳"这条可证伪的验收标准。
独立复核:三点结论¶
(一)三轴消融是否真的支撑每个组件的必要性?—— 4 个组件里 3 个有各自的净贡献测量,但都不在最终 125B 配置上,且关键子决策不可复核。
| 组件 | 是否有独立的净贡献测量 | 证据 | 缺口 |
|---|---|---|---|
| GDN / 全注意力混合 | 部分 | Tab. 1 三方对照(Full / SWA hybrid / GDN hybrid,Avg 49.87 / 51.15 / 53.81) | 混合比 1:4 没有扫描;RoPE-vs-NoPE 只有定性叙述、无数值;论文自陈这张表"不能隔离出是哪个组件造成了各项提升" |
| QSA | 是(最扎实) | Tab. 2/3/4 + Fig. 4 loss 重合 + Fig. 5(a) 微块大小扫描(含 IndexShare 竞品基线)+ Fig. 5(b) head 数扫描(1/2/4/16,分 Stage 1/2) | Fig. 5(a) 横轴是估计延迟;Tab. 2 的 +0.9 分很可能是噪声,正确读法是"不掉点" |
| Gated Residual | 是(但增量在噪声内) | Tab. 5 四点阶梯把收益拆成"拓宽 +1.58 分 / 数据依赖 +1.98 分 / GR 自身 +0.19 分";Tab. 6 对 AttnRes 族;Fig. 7 机制分解;Fig. 13a 生产规模 −0.026 | GR 相对 mHC(dynamic) 的质量增量(loss 1.594→1.590、Avg 54.47→54.66)在噪声内,它的正当性实际来自效率与稳定性而非精度;五条设计观察里有四条(sigmoid vs tanh、读粒度 vs 写粒度、读所有分支、$H_{\mathrm{res}}$ 无用)只有叙述、没有数值行,读者无法复核 |
| n-gram 嵌入卸载 | 质量轴是,效率轴否 | Tab. 7(10 个放置配置)、Tab. 8(固定预算)、Tab. 9(追加参数,loss 1.585→1.526) | "卸载 + 主存预取"这个核心工程主张零测量:没有预取带宽、没有重叠率、没有开/关 n-gram 层的 decode 延迟对比。"negligible latency"是断言 |
结论:这不是"只报最终配置组合收益"的论文——四个组件里有三个能读到自己的净贡献数字,QSA 甚至有超参扫描与竞品基线,GR 有四点阶梯把收益拆成三段。评 9 分是站得住的。但两个真实的缺口必须记住:(a) 全文没有任何一张表在最终的 125B-A6B 配置上逐个移除组件(唯一接近的是 Fig. 13a 的两级阶梯 Qwen3.5+Muon → +GR → 完整 Flash-Next,而最后一级把"精炼后的 GR + n-gram 层"打包在一起,无法拆开);所有消融都在 10.8B/25B/35B/156B 的代理规模上,组件之间的交互效应未被测量。(b) GR 一节的五条设计观察里,只有"数据依赖性"那条能从 Table 5 读出数字,其余四条是纯叙述——而它们恰恰是最有迁移价值的部分。论文自己用"Tab. 5 reports the endpoints of that progression"这句话承认了这一点。
(二)"训练稳定性"有没有量化证据?—— 有,而且是全文证据最硬的一节;但生产规模的终局论断仍是叙述。
量化到位的部分:
- 可操作的 spike 定义(201 步滚动中位数 + 0.1 阈值),三个指标(spike 率 / p99.9 pre-clip 梯度范数与穿越计数 / 每 block 最大激活)。
- 可复现的失败案例:4× 最优 LR 下 AdamW + Qwen3.5 结构的 run 是一个明确的失败样本——183 spike / 10k 步、19,932 步中 213 步穿越裁剪阈值、裁剪器持续触发;压力测试协议(恒定 LR = $k\times$ 最优,沿用 Wortsman et al. 2023)写得足以复现。
- 单变量隔离:Fig. 12 只开关 GatedNorm、固定 AdamW / 结构 / 数据顺序,spike 率 32.0 → 3.2 每 10k 步、穿越 256 → 20。这是全文最干净的一个因果实验。
- 机制假说 + 支持证据:Fig. 12(c) 的学习率阶梯显示激活 outlier 近似随 LR 线性增长、而 spike 率增长快得多;开门后最高 LR 下的 outlier 水平低于无门基线在最低 LR 下的水平。这支持"网络在没有显式门时靠长 outlier 来完成 rescaling"这一假说。
- 生产配置下的复现:Fig. 13 在 8× 于压力测试的模型规模、生产学习率、相同数据顺序下复现了同样的排序(中位梯度范数 0.097 vs 0.053/0.043、p99.9 0.298 vs 0.071/0.066、1000 步窗口标准差低 4.3–4.7×、只有无 GR 的 run 穿越阈值)。
仍属叙述的部分:
- "全尺寸训练没有一次 loss spike"这句话没有配图或计数。Fig. 13 只覆盖前 276B token,而 Flash-Next 的总训练量远大于此。
- 所有压力测试都在 28 层 25B-A3B 上做,Fig. 13 也只到 276B token;最终 125B 生产 run 的反事实(不用 GR 会怎样)在物理上不可能存在,这是这类论断的固有上限,不是本文的疏漏。
结论:稳定性这一条不是叙述性卖点,而是全文量化最扎实的部分——有定义、有三指标、有可复现失败案例、有单变量隔离、有跨规模复现。这也是本篇最值得直接迁移的资产。
(三)效率数字是实测还是估算?—— 混在一起,必须逐项分清。
| 效率主张 | 性质 | 依据 |
|---|---|---|
| QSA 在 1M 上下文的 7.6× prefill / 4.9× decode | 实测(kernel 级微基准) | Fig. 6(c,d),跨 64K–1M 五个点的 ms 延迟,对 FlashInfer paged GQA;prefill 为 chunked(16K chunk, BS=1),decode BS=4、next_n=4 |
| Indexer 的 3.8× / 4.4× | 实测(kernel 级) | Fig. 6(a,b),ratio=4 vs ratio=1 |
| FlashQLA 的 2–3× 前向 / ~2× 反向 | 实测,但无表格、无 GPU 型号、无设定说明 | 正文一句话 |
| Indexer 复杂度 $O(n^2) \to O(n^2/r)$ | 解析推导 | §2.1.2 |
| Fig. 5(a) 的横轴 | 明确的估算 | 论文原文 "their estimated reductions in indexer latency" |
| 1/9 训练 FLOPs | 算术推导,非墙钟测量 | 由"1/3 激活参数 × 1/3 训练 token ≈ 1/9 FLOPs"得到($6/17 \times 1/3 \approx 0.118$)。全文没有任何 GPU-hours 或墙钟对比 |
| batch-size warmup 多花 18.8% 优化器步 | 计数推导(步数),被表述为墙钟开销 | §3.2 |
| GR 残差状态存 FP8 "几乎无质量损失" | 无数字 | §2.2,"almost no loss in quality",无对照表 |
| 拓宽残差流的显存流量开销 | 无数字 | 只有定性说明"额外成本是携带 $n_r$ 条分支的显存流量" |
| n-gram 主存预取的延迟/带宽 | 无数字 | "negligible additional per-token FLOPs and latency" 为断言 |
| 端到端服务吞吐 / TTFT / TPOT | 完全缺失 | 全文无任何端到端 serving 数字 |
结论:本文的效率论证比库里 AMBER 那种"算力横轴是估算"的情况要好——最关键的 QSA 加速比是 kernel 级实测的 ms 数据,有五个上下文长度点。但三处必须打折:(a) 头条的 "1/9 训练 FLOPs" 是纯算术(激活参数比 × token 比),不是墙钟或 GPU-hours,且这个口径把 51B n-gram 嵌入参数排除在外(理由是稀疏查表,可接受)、也完全不计主存到加速器的预取带宽成本;(b) 与 IndexShare 竞品对比的那张图(Fig. 5a)横轴是估算延迟,恰好是最需要实测的地方;(c) 所有"效率"都停在 kernel 级或参数级,没有一个端到端服务数字——因此"显著更低的推理成本"这一句在证据上是外推,不是测量。对推荐系统的读者而言,这意味着 QSA 的 7.6× 不能直接理解成线上 QPS 的 7.6×。
其他局限¶
- 所有 CPT 与消融都在代理规模上(10.8B-A0.89B / 25B-A3B / 35B-A3B / 48 层 156B-A7B),最终 125B-A6B 只有一张终局表(Tab. 11)与前 276B token 的训练动力学(Fig. 13)。规模外推的风险没有被讨论。
- Table 11 的两个基线都是自家模型(Qwen3.8-27B、Qwen3.7-Plus),没有任何外部模型对照(如同期的 Kimi K3、GLM-5.2、DeepSeek-V3.2)。这让"1/9 FLOPs 达到同等质量"这个论断只在 Qwen 自己的训练配方内部成立。
- 后训练几乎没有覆盖。论文多次把"后训练之后才暴露的退化"作为关键论据(稀疏残差写入、NoPE),但从未展示这些后训练评测的具体数字——它们是决策的依据,却不在证据里。
- 评测吞吐被论文自己列为最紧的瓶颈:结论一节写道"最紧的瓶颈是评测吞吐:一个能可靠预测后训练排序的、更便宜的中等规模探针,会让设计空间可搜索得多"。这既是坦诚的自我批评,也精确指出了这套三轴协议的成本所在——三轴里最贵的那一轴(后训练评测)恰恰是它最依赖的。
- N-gram 嵌入的收益结构值得警惕:Table 8 显示在固定总参数预算下,n-gram 嵌入相对多加专家基本是打平甚至略负;它真正的价值完全建立在"这些参数不占加速器显存所以是免费的"这一前提上。一旦主存带宽或预取成本被计入(而论文没有计),这条轴的收益率需要重估。
对推荐系统方向的迁移价值¶
本文虽是纯 LLM 架构报告,但四个组件里有三个可以直接迁移到推荐系统的大模型排序/生成骨干:
- 线性/全注意力混合 + 微块稀疏注意力:工业推荐的超长行为序列(10K–20K)面临完全相同的 $O(n^2)$ 与 KV cache 问题。QSA 的"压缩后打分、块因果、压缩在位置编码之前"三条设计都与领域无关;库中 KSA(Kuaishou)与 GBLA(Yandex)已经在做同一件事的不同版本。
- Gated Residual:库中的 DeRes 已经独立走到几乎同一个终点(向量门融合双路径残差),本文进一步提供了"拓宽到 $n_r$ 条分支 + 精确分解验证"的更完整版本,以及"把表达力花在读上、删掉分支混合"这条明确的成本-质量取舍。工业排序模型层数浅(4–12 层),DeRes 认为收益更大——但本文 Table 6 的 28 层 vs 48 层趋势暗示相反方向,值得实测。
- 三轴评审协议 + 稳定性的可操作定义:这两条与模型类型完全无关,可以直接搬进任何架构迭代流程。
- n-gram 嵌入卸载:推荐系统本来就有巨大的稀疏嵌入表和成熟的参数服务器/主存卸载体系,反而是这条轴上更成熟的一方;本文的贡献主要是"确定性寻址使异步预取成为可能"这个论证角度,以及"loss 单调降但下游饱和"这个警告。