ROCS: Request-Oriented Compute Sharing for Efficient Large-Scale Recommendation¶
Yuxin Chen*, Liang Luo*, Buyun Zhang*, Jian Jiao*, Boda Li*, Haoyu Wang* 等 40+ 作者(* 表示同等贡献)· Meta AI, Menlo Park, California, USA · arXiv:2607.27744v1 · 2026-07-30
一句话总结¶
推荐推理有一个被长期浪费的结构性性质:一次请求要对 N 个候选打分,而 request 侧特征在这 N 个候选上完全相同;但主流排序架构在很早就把 request 与 candidate 特征 early-fuse,导致 request-only 的计算被重复执行 N 次。ROCS 把「哪些计算可以跨候选复用」提升为一条算子级依赖契约:用 Generalized Layer Masking (GLM) 给每个算子施加块下三角掩码 $M_{ij}=\mathbb{1}\{j\le i\}$,使 request 组的输出函数式地不依赖 candidate 输入,且该性质在复合下封闭;用 Deep Cross Attention (DCA) 把这套契约延伸到序列模块(共享的 request-only 序列编码器 + 逐层 candidate-conditioned cross-attention);用 Request-Oriented Resource Reallocation (RRR) 把省下的算力回投到 request 侧容量;再用 In-Kernel Broadcast Optimization (IKBO) 在 GPU kernel 内部解析 request→candidate 的关联,完全不物化 broadcast。公开数据集上在 DCNv2 / FinalMLP / Wukong / RankMixer 四种骨干上一致改善质量-效率前沿;Meta 生产环境把 replay QPS 提升 47%–196%,覆盖广告与自然流量、召回与排序、跨越两个数量级的推理复杂度。
1. 研究动机与背景¶
1.1 推荐 scaling 撞上成本天花板¶
推荐 scaling law 表明预测质量随模型算力可预测地提升,但生产环境的容量与延迟约束给「每请求算力预算」划了一条硬线。现实系统因此必须在预测精度与服务成本之间小心权衡。这个张力在两类模块上同时加剧:
- 特征交互架构(DCNv2、FinalMLP、Wukong、DHEN、RankMixer)随算力提升质量,展现出类似语言模型的 scaling 行为;
- 序列架构(HSTU、Longer 等)同样受益于更大规模。
更新的一批架构(Kunlun、MixFormer、HyFormer、InterFormer、OneTrans)在整个网络中联合建模序列与非序列特征。这加强了 candidate-conditioned 交互、提升了质量,但也直接抬高了给每个候选打分所需的算力。
1.2 已有路线:系统层缓解 vs 建模层直击¶
先前工作大多走系统层路线来缓解成本约束:
- 模型统一(model unification):把多个专用模型合并成一个,降低总体计算;
- 知识迁移与蒸馏:把重计算卸载到离线/异步流水线,把知识蒸馏进轻量服务模型;
- 低精度执行(LoKA 等):提升硬件效率。
这些方法有效,但受限于跨任务干扰、蒸馏本身的不完美、以及新鲜度(freshness)要求——DECK 这类工作已经报告过增量 checkpoint 的现实困难。
本文选择直接从建模侧攻击这个问题。核心洞察源自推荐推理的一个内禀性质:
一次用户请求要对许多候选物品打分。对给定请求,request 侧特征在所有候选上完全相同,只有 candidate 侧特征在变。
因此,如果 request–candidate 交互能被延迟,那么 request 侧计算就可以只算一次、在所有关联候选间复用。因为交互点之前的计算被摊到所有候选上、而交互点之后的计算要逐候选付账,尽可能延迟交互就直接等价于最大化可复用计算量。
1.3 传统架构为何做不到¶
不幸的是,常规排序架构强制 early fusion:request 与 candidate 在很早就被交叉成 cross-feature。这在现代序列建模里被进一步放大——当长用户序列在早期就与 candidate 信号融合时,二次成本的序列算子及其全部下游计算都必须为每个候选重跑一遍,让实时服务几乎不可行。
光谱的另一端是 two-tower 架构:把 request–candidate 交互一路推迟到最终打分函数(点积),复用最大化,但牺牲了中间层交互与模型表达力,因此很少作为算力密集的排序阶段的唯一架构。
最近的 transformer 类与架构特定方案(ULTRA-HSTU、Request-Only Optimization、HyFormer)在中间地带探索,通过 masked representation 保留可复用的 request 侧表示。但这些设计绑定在特定模型结构上,且——这是本文最关键的批评——注意力掩码只管注意力,不管实际推荐模型里大量存在的非注意力组件(MLP、特征压缩层、显式特征交互算子)。一旦这些组件把 request 与 candidate 输入混在一起,其结果就变成 candidate-dependent,无法再跨候选精确复用。
本文把 request 级算力冗余 识别为「推荐模型架构」与「request-to-candidate 执行模式」之间的结构性错配(structural mismatch),而不仅仅是一个实现层的瑕疵。
1.4 ROCS 的四个组件¶
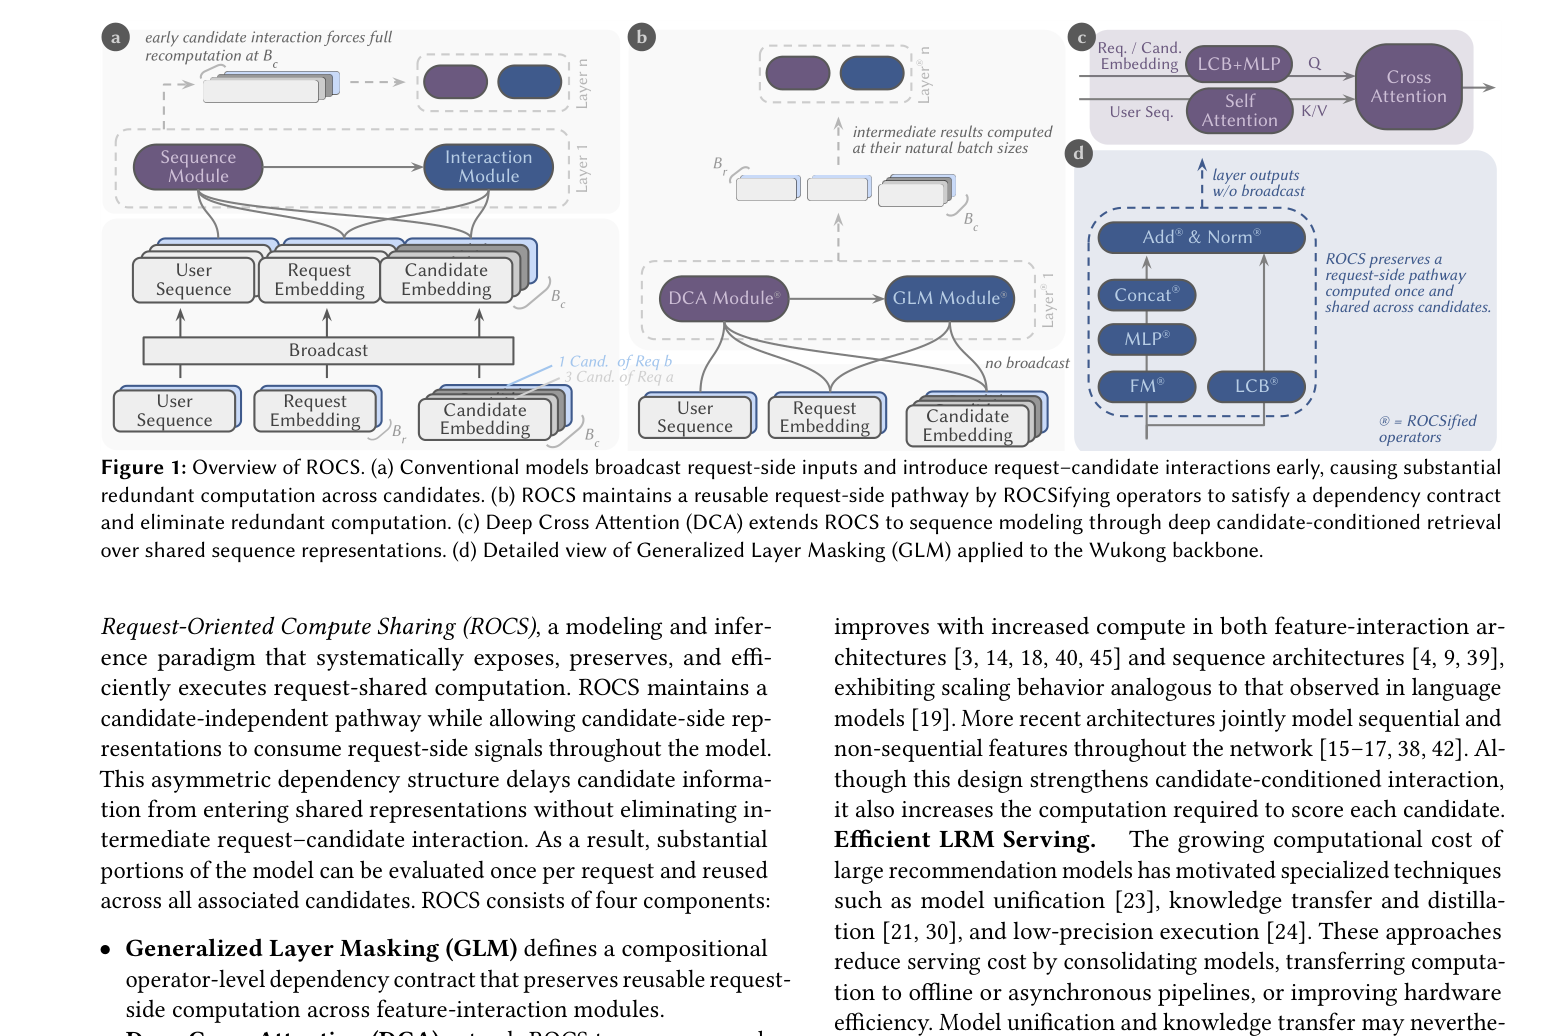
Request-Oriented Compute Sharing (ROCS) 是一个系统性地暴露、保留并高效执行 request-shared 计算的建模与推理范式。它维持一条 candidate-independent 的通路,同时允许 candidate 侧表示在整个模型中持续消费 request 侧信号。这种非对称依赖结构推迟 candidate 信息进入共享表示,却并不消除中间层的 request–candidate 交互。四个组件:
- Generalized Layer Masking (GLM):定义一条组合式的、算子级的依赖契约,在异构特征交互模块中保留可复用的 request 侧计算。
- Deep Cross Attention (DCA):通过共享序列编码 + 深度 candidate-conditioned 检索,把 ROCS 延伸到序列模型。
- Request-Oriented Resource Reallocation (RRR):把节省下来的算力再投资回去,改善质量-效率前沿。
- In-Kernel Broadcast Optimization (IKBO):高效执行 ROCS 模型,不物化 broadcast。
2. 相关工作定位¶
大型推荐模型。 现代推荐模型从异构输入预测用户行为:request 级上下文(时间、地点)、用户行为序列、candidate 级物品特征。稀疏与稠密特征先被 embedding 或变换,再送入特征交互与序列模块。近期工作显示预测质量随算力在两类架构上都提升,展现出与语言模型类似的 scaling 行为。更新的架构在全网络联合建模序列与非序列特征——强化了 candidate-conditioned 交互,也抬高了每候选打分成本。
高效 LRM 服务。 模型统一、知识迁移/蒸馏、低精度执行三条路线通过「合并模型 / 卸载到离线或异步流水线 / 提升硬件效率」降低服务成本。ROCS 与它们正交且互补——ROCS 是重构模型本身来消除冗余的逐候选计算,可以与上述方法组合使用。
Request-oriented 推荐模型。 这类设计把 request 侧与 candidate 侧子图分开、跨候选复用 request 子图。Two-tower 独立编码 request 与 item、把交互推迟到最终相似度函数,对召回高效但限制了中间层交互,因此很少单独用于算力密集的排序阶段。
Transformer 通过注意力掩码保留分离的 request/candidate token 表示(ULTRA-HSTU、Request-Only Optimization、HyFormer)。但——
注意力掩码并不治理实际推荐模型中大量非注意力组件(MLP、特征压缩层、显式特征交互算子)引入的依赖。一旦这些组件混合了 request 与 candidate 输入,其结果就变成 candidate-dependent,无法跨候选精确复用。
此外,把 candidate 信息注入共享序列的架构(Kunlun、InterFormer)会让后续序列表示 candidate-dependent,从根本上阻止其跨候选精确复用。
UGSEP(Compute Only Once: UG-Separation)引入了一种 RankMixer 特定的 masked token-mixing 设计,保留可复用的 user 侧 token,但以损失交互容量为代价。对比之下,ROCS 把 request-shared 计算表述为一个在复合下封闭、且跨异构特征交互与序列算子适用的算子级不变量。ROCS 进一步与 IKBO 协同设计模型结构:IKBO 让 request 侧与 candidate 侧张量保持在各自的自然 batch size,在消费它们的 GPU kernel 内部解析 request–candidate 关联,不物化 request-to-candidate 广播。
3. ROCS 的设计¶
ROCS 由三条设计目标引导:(1) 应广泛适用于既有推荐架构;(2) 应尽可能延迟 request–candidate 交互以最大化可复用的 request 侧计算;(3) 即使交互被延迟,也应保持或改善预测质量。为此,ROCS 把既有模型变换为带一条显式可复用 request 侧子图的架构。
3.1 Generalized Layer Masking (GLM)¶
对一个要打 N 个候选的请求,一个中间的 request 侧结果只有在「改变 candidate 不会改变该结果」时才可复用。GLM 把这个要求变成对特征交互栈里每一个被变换的算子的显式契约。该契约受因果注意力掩码启发,但实现必须逐算子定制。
关键点:GLM 不能靠掩码算子的输出来强制执行。 一旦算子内部已经混合了 request 与 candidate 输入,被保留的 request 侧输出值仍可能依赖 candidate——依赖限制必须在算子内部强制执行。
3.1.1 GLM 不变量¶
设输入 $x$ 被划分为 $K$ 个有序组 $x^{(0)},\dots,x^{(K-1)}$。设 $f^{(i)}(x)$ 表示输出组 $i$(使用同一组顺序)。对固定模型参数与确定性前向,称 $f$ 是 GLM-compliant(或 ROCSified),当且仅当对每个组 $i$ 与每对输入 $x, x'$:
$$x^{(0:i)} = x'^{(0:i)} \implies f^{(i)}(x) = f^{(i)}(x') \tag{1}$$
其中 $x^{(0:i)} = (x^{(0)},\dots,x^{(i)})$。等价地,存在函数 $\tilde f_i$ 使得 $f^{(i)}(x) = \tilde f_i(x^{(0)},\dots,x^{(i)})$。
物理含义:信息只能从较早的组流向较晚的组,反方向不行。这是一条函数依赖约束,不是「特征组在统计上独立」的假设——这个区分很重要,ROCS 并不要求 request 与 candidate 特征统计无关。
ROCS 通常用两组:request 侧为组 0(记 $x^R$),candidate 侧为组 1(记 $x^C$)。Eq.(1) 于是要求
$$f(x^R, x^C) = \big(f^R(x^R),\ f^C(x^R, x^C)\big) \tag{2}$$
request 侧输出对 candidate 不变;candidate 侧输出仍可同时吃两侧输入并建模其交互。 这正是「延迟但不消除交互」的形式化表达。
组级依赖模式就是块下三角掩码:
$$M_{ij} = \mathbb{1}\{j \le i\} \tag{3}$$
$M$ 记录哪些「输入组 → 输出组」对被允许;每个算子按其自身结构强制这一模式。对矩阵 $X \in \mathbb{R}^{n\times d}$,行块 $i$ 形如 $X^{(i)} \in \mathbb{R}^{n_i \times d}$,$n = \sum_i n_i$;对向量 $x \in \mathbb{R}^m$,坐标块 $i$ 形如 $x^{(i)} \in \mathbb{R}^{m_i}$,$m = \sum_i m_i$。输入输出组遵循同一组顺序,尽管对应组的大小可以不同。
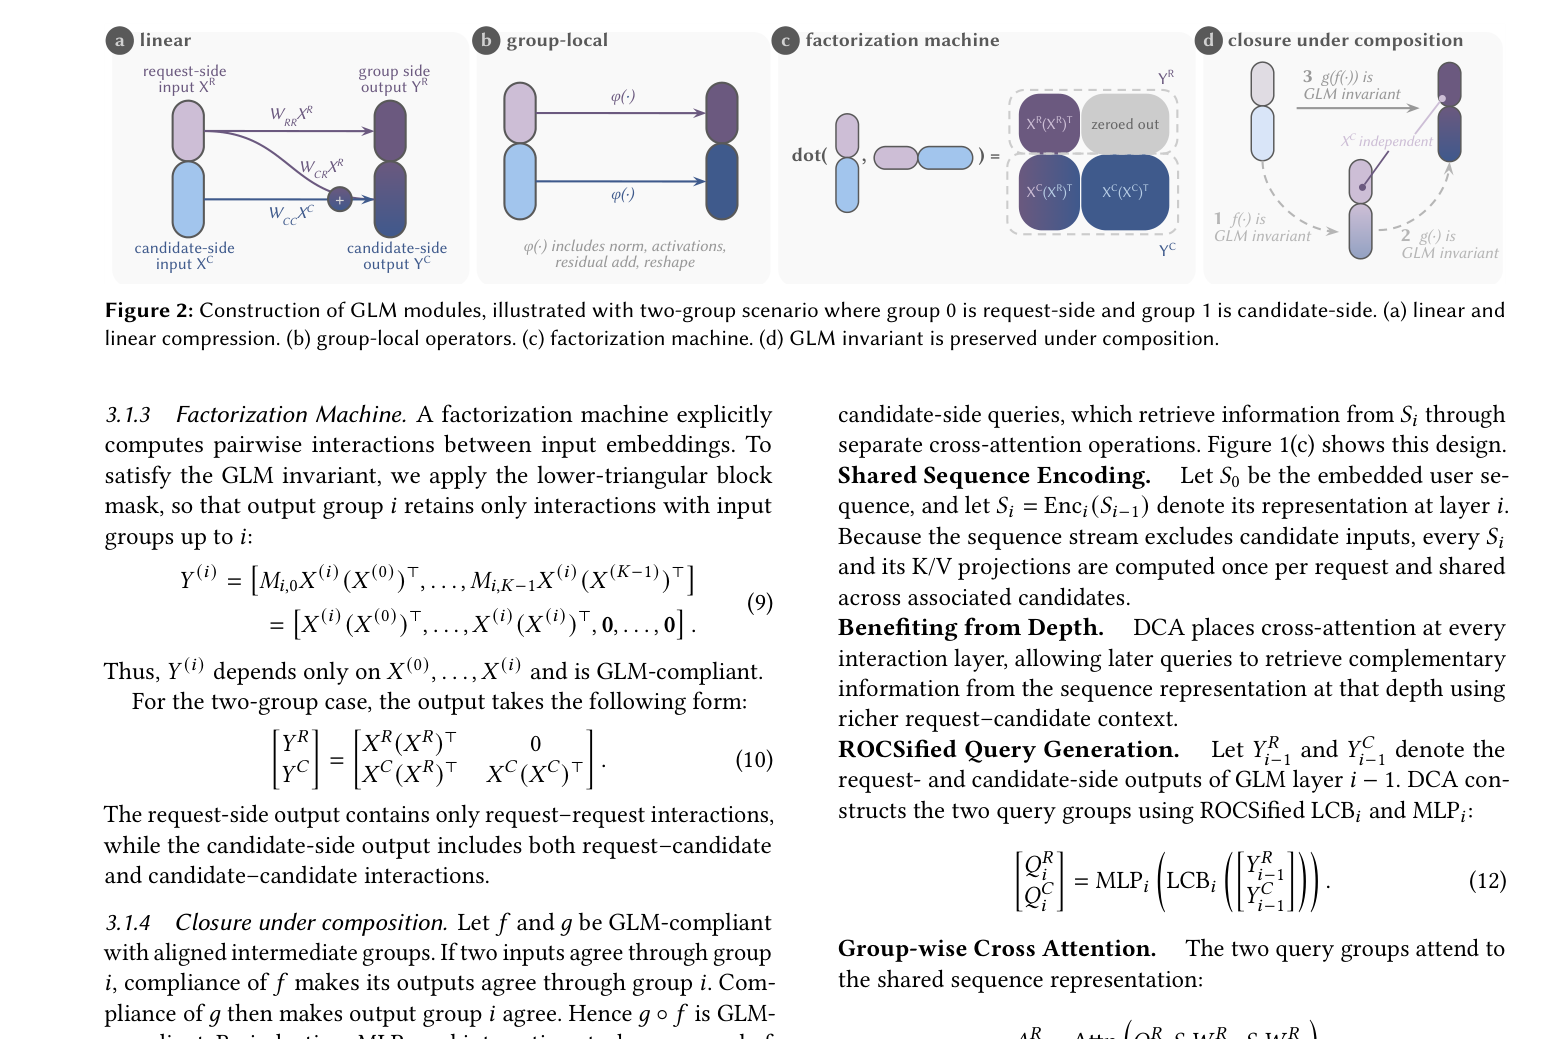
3.1.2 线性层与线性压缩层(LCB)¶
考虑一个分组输入的仿射层,输入 $x = [x^{(0)};\dots;x^{(K-1)}]$、输出 $y = [y^{(0)};\dots;y^{(K-1)}]$。$x^{(j)} \in \mathbb{R}^{m_j^{in}}$ 是输入组 $j$ 的向量,$y^{(i)} \in \mathbb{R}^{m_i^{out}}$ 是输出组 $i$ 的向量。权重块 $W_{ij} \in \mathbb{R}^{m_i^{out}\times m_j^{in}}$ 把输入组 $j$ 映到输出组 $i$,$b^{(i)} \in \mathbb{R}^{m_i^{out}}$ 是偏置。GLM 按块掩码权重:
$$\widetilde W_{ij} = M_{ij}W_{ij},\qquad y^{(i)} = \sum_{j=0}^{K-1}\widetilde W_{ij}x^{(j)} + b^{(i)} = \sum_{j=0}^{i} W_{ij}x^{(j)} + b^{(i)} \tag{4}$$
LCB(Linear Compression Block,Wukong 的核心算子之一)把同样的模式作用在 embedding 矩阵的行轴上。设 $X^{(j)} \in \mathbb{R}^{n_j^{in}\times d}$、$Y^{(i)} \in \mathbb{R}^{n_i^{out}\times d}$,$W_{ij}\in\mathbb{R}^{n_i^{out}\times n_j^{in}}$,ROCSified LCB 为
$$Y^{(i)} = \sum_{j=0}^{i} W_{ij}X^{(j)} \tag{5}$$
两组情形下权重有显式形式:
$$\begin{bmatrix} Y^R \\ Y^C \end{bmatrix} = \begin{bmatrix} W_{RR} & 0 \\ W_{CR} & W_{CC}\end{bmatrix}\begin{bmatrix} X^R \\ X^C \end{bmatrix} \tag{6}$$
右上块被强制置零——这是「candidate 不能影响 request」的直接体现。而 $W_{CR}X^R$ 这一项是 request-derived contribution:它是 request 侧对 candidate 侧输出的贡献,IKBO 会在不显式物化 broadcast 的前提下把它供给 candidate 侧(§4)。
3.1.3 组局部算子(Group-Local Operations)¶
任何跨坐标聚合的算子(如 normalization)必须在不使用组 $i$ 之后任何组的值的前提下计算输出组 $i$。本文采用更严格也更简单的组局部(group-local)形式:
$$y^{(i)} = \mathrm{Norm}_i(x^{(i)}) \tag{7}$$
这覆盖 per-group LayerNorm / RMSNorm 以及固定统计量的推理期 normalization。从拼接后的组计算统计量会依赖更晚的组,从而违反 Eq.(1)。
对逐点激活:多输入时对对齐的、可广播的输入分别施加逐元素算子 $\phi$:
$$y^{(i)} = \phi\big(x_1^{(i)},\dots,x_q^{(i)}\big) \tag{8}$$
这覆盖激活函数、残差加法以及其他逐点合并。拼接与 reshape 在保持组标签时也是 compliant 的。
3.1.4 因子分解机(Factorization Machine, FM)¶
FM 显式计算输入 embedding 之间的两两交互。为满足 GLM 不变量,对其施加下三角块掩码,使输出组 $i$ 只保留与组 $0..i$ 的交互:
$$Y^{(i)} = \big[M_{i,0}X^{(i)}(X^{(0)})^\top,\ \dots,\ M_{i,K-1}X^{(i)}(X^{(K-1)})^\top\big] = \big[X^{(i)}(X^{(0)})^\top,\dots,X^{(i)}(X^{(i)})^\top, 0,\dots,0\big] \tag{9}$$
于是 $Y^{(i)}$ 只依赖 $X^{(0)},\dots,X^{(i)}$,满足 GLM。两组情形:
$$\begin{bmatrix} Y^R \\ Y^C \end{bmatrix} = \begin{bmatrix} X^R(X^R)^\top & 0 \\ X^C(X^R)^\top & X^C(X^C)^\top \end{bmatrix} \tag{10}$$
request 侧输出只含 request–request 交互;candidate 侧输出同时含 request–candidate 与 candidate–candidate 交互。 这再次印证「交互被延迟到 candidate 流、而非被删除」。
3.1.5 复合下的封闭性(Closure under Composition)¶
设 $f$ 与 $g$ 都 GLM-compliant 且中间组对齐。若两个输入在组 $i$ 之前(含)一致,则 $f$ 的 compliance 保证其输出在组 $i$ 上一致;$g$ 的 compliance 再保证输出组 $i$ 一致。因此 $g\circ f$ 也是 GLM-compliant。由归纳,MLP 以及由上述构造组成的整个交互栈都保持该不变量。
于是,对同一请求 $R$ 关联的候选 $C_1,\dots,C_N$,每个 ROCSified 模块满足
$$\big[F(X^R, X^{C_1})\big]^R = \dots = \big[F(X^R, X^{C_N})\big]^R = F^R(X^R) \tag{11}$$
其 request 侧通路因此可以只求值一次、在全部 $N$ 个候选间复用,同时保持该 ROCSified 模块在 broadcast 执行下的确定性输出。这确立了 compute sharing 的语义合法性。
这条「封闭性」是 ROCS 与前人工作最本质的差异:它不是在某一层做一次分解,而是让整个网络深度上的 request 侧通路都保持纯净。
3.2 Deep Cross Attention (DCA)¶
Candidate-aware 序列检索在推荐中被广泛使用:当前 candidate 为「从用户行为序列中挑出相关事件」提供上下文(DIN/TWIN/ETA 谱系)。更早引入 candidate 上下文能提升预测质量,但会让序列变成 candidate-dependent,其昂贵算子与下游计算必须为每个候选重复。
DCA 把 candidate-conditioned 序列建模拆成「共享序列编码」与「candidate-conditioned 检索」两部分。
共享序列编码(Shared Sequence Encoding)。 设 $S_0$ 为 embedding 后的用户序列,$S_i = \mathrm{Enc}_i(S_{i-1})$ 为第 $i$ 层的表示。因为序列流排除了 candidate 输入,每个 $S_i$ 及其 K/V 投影都只需每请求算一次,并在关联候选间共享。
从深度中获益(Benefiting from Depth)。 DCA 在每一个交互层都放置 cross-attention,让更靠后的 query 能用更丰富的 request–candidate 上下文,从该深度上的序列表示中检索互补信息。这是 DCA 相对「单点 target-attention」的关键改进。
ROCSified 查询生成。 设 $Y_{i-1}^R$、$Y_{i-1}^C$ 为 GLM 第 $i-1$ 层的 request/candidate 侧输出。DCA 用 ROCSified 的 $\mathrm{LCB}_i$ 与 $\mathrm{MLP}_i$ 构造两组 query:
$$\begin{bmatrix} Q_i^R \\ Q_i^C \end{bmatrix} = \mathrm{MLP}_i\left(\mathrm{LCB}_i\left(\begin{bmatrix} Y_{i-1}^R \\ Y_{i-1}^C \end{bmatrix}\right)\right) \tag{12}$$
组级 cross-attention。 两组 query 分别 attend 到共享的序列表示:
$$A_i^R = \mathrm{Attn}\big(Q_i^R,\ S_iW_{K,i}^R,\ S_iW_{V,i}^R\big),\qquad A_i^C = \mathrm{Attn}\big(Q_i^C,\ S_iW_{K,i}^C,\ S_iW_{V,i}^C\big) \tag{13}$$
注意力输出与对应的 GLM 表示拼接后进入下一个交互层。
GLM 不变量的保持。 共享序列与 request 侧 query 只依赖 request 侧输入,而 candidate 侧 query 可以同时依赖 request 与 candidate 输入。因此 request 侧 attention 每请求算一次,candidate 侧 attention 保持 candidate-specific。DCA 由此共享了序列编码与 K/V 投影,同时保留了 candidate-conditioned 检索,并可与 §3.1 的 GLM 模块自由组合。
3.3 Request-Oriented Resource Reallocation (RRR)¶
GLM 与 DCA 通过约束「candidate-specific 信息何时进入模型」来最大化计算共享。但 ROCSification 在固定模型容量下不必然保持表达力:常规层可以把全部容量用于 candidate-dependent 表示,而其 ROCSified 对应版本要留出一部分容量给可复用的 request 侧表示。因此直接对模型做 ROCSify 可能降低预测质量。
RRR 通过把节省的计算再投资到 scale request 侧通路来解决这个权衡,遵循现代推荐骨干的 scaling 行为。因为每个请求要对多个候选打分,request 侧计算被摊到它们身上,使 request 侧 scaling 比等价的 candidate 侧 scaling 便宜得多。这种非对称成本结构提供了一个有利的杠杆——在保留 compute sharing 效率收益的同时恢复甚至改进模型质量。
分配量由 request 侧 scaling ratio $r$ 控制,它决定每个 ROCS 模块中分给 request 侧表示的相对容量。$r$ 越大,可复用 request 侧通路的容量越大。 除非特别说明,所有 ROCS 模块使用同一个 $r$。
4. 用 In-Kernel Broadcast Optimization 高效执行 ROCS¶
ROCS 重构模型以暴露可复用的 request 子图。但直接的 dense 实现仍会把 request 侧张量扩张到 candidate batch size,为每个关联候选复制一遍每个张量——本文称之为 request-to-candidate broadcast。这种复制增加显存占用、引入不必要的计算、并带来额外访存流量。
IKBO 是一个专门针对 ROCS 暴露出的结构化计算的 GPU 执行策略。 IKBO 把 request 侧与 candidate 侧张量保存在各自的自然 batch size $B_r$ 与 $B_c$,并用一个索引映射 $\mathbf{m}$ 把每个候选关联到它对应的请求。IKBO 不物化 request-to-candidate broadcast,而是在 candidate 侧 GPU kernel 内部按需加载对应的 request 侧结果。 该策略被应用到 ROCS 中的两类主导算子:GLM 里的线性算子、DCA 里的 cross-attention。
4.1 ROCSified 算子的分解¶
为高效执行,一个 ROCSified 算子可以分成 request-batched 与 candidate-batched 两个部分。request-batched 部分每请求求值一次,产出 request 侧输出以及 candidate 侧所需的 request-derived contribution。
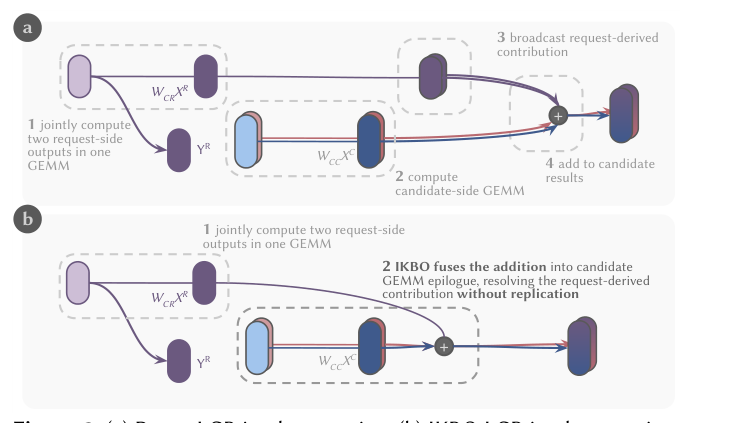
以 Eq.(6) 的两组 LCB 为例,request/candidate 侧输入存放在各自的自然 batch size:$\mathbf{X}^R \in \mathbb{R}^{B_r\times n_r\times d}$、$\mathbf{X}^C\in\mathbb{R}^{B_c\times n_c\times d}$。索引映射把候选 $i$ 关联到请求 $m_i$:$\mathbf{m}\in\{0,\dots,B_r-1\}^{B_c}$。
IKBO 不先把 $\mathbf{X}^R$ 复制到 candidate batch,而是在一个 GEMM(batch size $B_r$)里同时算出两个 request-dependent 项:
$$\begin{bmatrix} \mathbf{Y}^R \\ \mathbf{Z}^{R\to C}\end{bmatrix} = \begin{bmatrix} W_{RR} \\ W_{CR}\end{bmatrix}\mathbf{X}^R$$
其中 $\mathbf{Z}^{R\to C} = W_{CR}\mathbf{X}^R$ 正是 Eq.(6) 中的 request-derived contribution。candidate 侧输出于是为
$$\mathbf{Y}_i^C = \mathbf{Z}_{m_i}^{R\to C} + W_{CC}\mathbf{X}_i^C \tag{14}$$
DCA 有一个类似的分解。 设 $\mathbf{S}^R$ 为 batch size $B_r$ 下存储的 request 侧序列表示。线性 K/V 投影可以在逻辑上的 request-to-candidate broadcast 之前施加——对 $W \in \{W_K, W_V\}$:
$$\big(\mathbf{S}_{m_i}^R\big)W = \big(\mathbf{S}^RW\big)_{m_i}$$
投影后的 K/V 张量因此每请求只算一次。但候选 $i$ 有自己的 attention query,必须 attend 到其关联请求 $m_i$ 的 K/V 张量。dense attention 算子会因此要求 candidate-batched 的 K/V 张量。
两个分解都在 batch size $B_r$ 上算一次 request 侧贡献,并通过 $\mathbf{m}$ 与 candidate 侧计算关联。常规 dense 实现仍会把这些结果物化到 batch size $B_c$;IKBO 则在消费它们的 GEMM 与 attention kernel 内部解析 $\mathbf{m}$,消除剩余的 broadcast 及其访存流量。
4.2 GLM 的 In-Kernel Broadcast Optimization¶
分解消除了冗余算术,但高效实现还必须消除拆分执行引入的数据移动与调度开销。IKBO 渐进式地处理这些开销。
4.2.1 把 broadcast-and-add 融进 GEMM epilogue¶
分解 ROCSified 算子之后,瓶颈转移到 Eq.(14) 中访存受限的 broadcast-and-add。朴素实现里,candidate 侧 GEMM 输出先写到 HBM,再读回来与对应的预计算 request 侧贡献合并,最终 candidate 侧输出再写回 HBM——这条执行路径物化了一个不必要的中间张量,并产生额外 HBM 流量。
IKBO 把 broadcast 与加法融进 candidate 侧 GEMM 的 epilogue:累加完每个输出 tile 之后,epilogue 用与每个候选关联的 request 索引去加载对应的预计算 request 侧贡献,在寄存器中完成加法,只把最终输出写到 HBM。于是 candidate 侧 GEMM 结果与被广播的 request 侧贡献都不再被物化为中间张量。
因为同一请求的候选通常连续存储,相邻的 candidate tile 常访问同一份 request-derived 结果,改善了 cache 局部性、降低 HBM 流量。该融合实现为一个 Triton batched-GEMM kernel + 自定义 post-accumulation epilogue。
4.2.2 用 warp specialization 重叠 mainloop 与 epilogue¶
常规 Triton GEMM 里,软件流水把 operand load 与 WGMMA 在一个输出 tile 的 K 块上重叠;包括 epilogue 在内的延迟通常能被同一 SM 上的其他 CTA 隐藏。但这个机制对本 kernel 不奏效——它的 tile 大、流水深,限制了 CTA 驻留数。暴露出的延迟对 IKBO 尤其昂贵,因为它的 epilogue 要做一次索引查找、加载对应的 request 侧结果、并把它加到累加的 tile 上,而不只是简单地存储输出。
因此本文改用 TLX 实现的 persistent、warp-specialized kernel。每个 persistent CTA 反复处理输出 tile,并被划分为三个特化 warp group:
- 1 个 producer:持续为未来 tile 发起 TMA load;
- 2 个 consumer:以 ping-pong 方式工作——一个执行已完成 tile 的 fused epilogue,另一个在另一个 tile 上做 WGMMA 计算。
该设计显式地重叠数据加载、tensor-core 计算与 fused epilogue,而不依赖同一 SM 上的其他 CTA。
4.2.3 合并 request 与 candidate kernel¶
request 与 candidate 计算仍作为独立 kernel 执行,在 request batch 小时低效:request 侧 kernel 会暴露 wave quantization 与 kernel-launch 开销,因为它没有足够的 tile 来充分利用 GPU。本文因此把两部分计算合并进单个 mega-kernel,让 request 侧与 candidate 侧 tile 共享一个 persistent 执行调度,也创造了「把 candidate 侧 epilogue 与 request 侧输入加载重叠」的机会。
candidate 侧 tile 可以与 request 侧 tile 并发调度,即使其 request 侧依赖尚未就绪——因为 request 侧结果只在 candidate 侧 epilogue 阶段才被消费。由于对应的 request tile 与 candidate tile 可能在不同 CTA 上执行,candidate epilogue 在消费 request 侧结果前,会在一个 per-tile 完成标志上以 release-acquire 语义等待。这避免了设备级 barrier,允许 candidate tile 在其自身依赖就绪时立刻推进。
为改善负载均衡,采用 bidirectional tile scheduling:request 侧 tile 按升序分配,candidate 侧 tile 按降序分配。这在 tile 总数不能被 SM 数整除时减少 per-SM 工作量失衡。
4.2.4 内存对齐¶
除 kernel 融合与调度外,分解还改变了结果张量的形状,可能降低内存传输效率。特别地,张量连续维度的字节大小可能不再满足内存传输与 cache 事务的对齐要求。对 row-major 张量,该尺寸决定相邻行之间的字节 stride;未对齐的 stride 会强制窄 load、阻止 TMA 路径、并让行访问跨越额外 cache line。
本文用一个自动变换识别受影响的维度并做 zero-pad,同时相应调整权重维度(按元素类型与后端要求)。这在数学上不改变计算,却让宽传输 / TMA 传输成为可能,避免不必要的 cache-line 事务,从而降低 L1/TEX 压力与访存流量。
4.3 DCA 的 In-Kernel Broadcast Optimization¶
FlashAttention 是注意力工作负载上被广泛使用的优化,但其效率取决于把每次 K/V tile 加载摊到一个足够大的 query tile 上。这种摊销在 DCA 里效果较差:candidate 侧 query 很短(例如 32 个 token),而 request 侧用户历史可能包含数百到数千个 token。每个 K/V tile 因此只被相对少的 query token 复用,导致算术强度低、执行访存受限。
直接的 DCA 实现会先把投影后的 K/V 张量物化到 candidate batch size,再调用 FlashAttention。尽管同一请求关联的候选拥有完全相同的 K/V 值,被物化的副本占据不同的内存地址;FlashAttention 因而把它们当作独立 batch 元素,无法跨候选复用同一份物理 K/V 数据。
4.3.1 跨候选摊销 K/V 访存¶
本文开发了一个特化的 FlashAttention kernel,直接消费 batch size $B_r$ 的 request 侧张量 $\mathbf{K}$、$\mathbf{V}$,外加 request–candidate 映射 $\mathbf{m}$。在为候选 $i$ 加载 K/V tile 之前,kernel 解析 $m_i$ 并从对应的 request 侧 K/V 张量加载,从而在 kernel 内部实现逻辑上的 broadcast。关联同一请求的候选因此访问同一份物理 K/V 数据,让用户历史读取被摊到候选之间,无需物化 candidate-batched 副本。
对 multi-head attention,进一步改变 thread-block grid 的顺序:
$$(\texttt{Q\_block},\ \texttt{head},\ \texttt{candidate})\ \rightarrow\ (\texttt{Q\_block},\ \texttt{candidate},\ \texttt{head})$$
因为关联同一请求的候选连续存储,这个顺序把「访问给定 head 的同一份 request 侧 K/V」的 block 调度得更靠近,改善时间局部性与 L2 cache 命中率。
4.3.2 Persistent warp-specialized 执行¶
FlashAttention-3 在一个 CTA 内重叠加载与 tensor-core 计算,但流水会为每个 query tile 排空并重新初始化。这个开销对 DCA 里短的 candidate 侧 query 尤其明显。本文改用 persistent TLX kernel:每个 CTA 处理多个 query tile;一个 producer warp group 持续发起异步 TMA load,两个 consumer warp group 处理连续的 query tile,各自执行 WGMMA 计算、softmax 与输出处理。这在摊销 buffer 与 barrier 初始化的同时,重叠了访存加载、tensor-core 计算与输出存储。
本文的 WGMMA 实现每个 consumer warp group 使用 query-tile size 64。因此共同处理关联同一请求的候选以充分利用 CTA:有两个 consumer warp group 时,query 长度为 64 时每个 CTA 处理 2 个候选,query 长度为 32 时处理 4 个候选。
5. 实验¶
评估分三部分:(1) 在三个公开数据集与多种交互骨干上评估 ROCS 的通用性与质量-效率前沿;(2) 用 Wukong 作代表骨干,在多个生产规模内部数据集上做深入实验,端到端评估 ROCS 并分离其各组件贡献;(3) 报告召回与排序系统的在线部署结果。
5.1 公开 Benchmark¶
5.1.1 实验设置¶
数据集。 选择同时提供不同 request 侧与 candidate 侧特征、且任一侧都不是由单个 ID 独占表示的公开推荐 benchmark。这个设定更好地反映生产推荐工作负载,并确保 ROCS 有非平凡的 request 侧计算可以暴露与复用。使用 KuaiRand、KuaiVideo、KKBox,采用 RecZoo / BARS 提供的预处理与数据格式。
表 6:公开数据集元数据
| Dataset | #Users | #Items | #Interactions | #User Feat. | #Item Feat. | Feedback |
|---|---|---|---|---|---|---|
| KuaiRand | 1,000 | 4,369,953 | 11,713,045 | 30 | 62 | IsClick, IsLike, IsFollow |
| KuaiVideo | 10,000 | 3,239,534 | 13,661,383 | 5 | 2 | IsClick, IsLike, IsFollow |
| KKBox | – | – | 7,377,418 | 7 | 12 | IsReplay |
指标。 每个模型用预测质量与摊销推理复杂度两个维度评估。质量上报告每种反馈类型的 AUC 与跨反馈类型的宏平均 AUC。效率上用 FLOPs 量化 ROCS 带来的硬件无关的算法性节省:设 $C_R$ 为每请求求值一次的 request 侧 FLOPs,$C_C$ 为每候选求值一次的 candidate 侧 FLOPs。对关联 $N$ 个候选的请求,每候选摊销 FLOPs 为
$$c_{\mathrm{amort}}(N) = C_C + \frac{C_R}{N}$$
报告 $N \in \{1, 100\}$ 的结果,覆盖从「单候选打分」到「对大候选集服务」的范围。
骨干。 在三个代表性交互骨干上评估 ROCS:DCNv2、FinalMLP、Wukong。这些模型使用不同的特征交互模块,可以检验 ROCS 是否能泛化到特定架构之外。另外把 RankMixer + UGSEP 作为 request-sharing 专用基线纳入对比。
实现细节(附录 A.1.2)。 所有模型用 PyTorch 实现,在单张 NVIDIA H100(96 GB)上训练。每个 vanilla 骨干的超参数通过 grid search 确定,vanilla 骨干的算力预算限制在每实例约 10 MFLOPs 的前向成本量级。具体地,对每个 (model, dataset) 对,从表 7 汇总的搜索空间抽 20 组配置,保留满足预算的组合,取验证 AUC 最高者。所有模型在同一训练机制下训练:Adam,学习率 $10^{-3}$,batch size 65,536,最多 100 epoch,early stopping(patience 5)。ROCS-Base 配置沿用其对应 vanilla 骨干的超参数选择;ROCS-Scaled 配置渐进式扩大容量(例如 DCNv2 / FinalMLP 的 DNN 宽度),使 $N=100$ 时的摊销每实例成本不超过 vanilla 预算。
表 7 搜索空间要点:DCNv2(embedding dim {16,32,64};cross 层数 {1,2,3,4};deep-network units {[256,128],[400,400],[512,256],[1024,512,256]};dropout {0,0.1,0.3,0.5});Wukong(embedding dim {64};Wukong 层数 $l$ {2,4,8};压缩维度 $k$ {8,16,32,64};FMB MLP hidden {64,128,256,512};projection dim {64,128,256};prediction-head MLP {[64],[256],[512]});FinalMLP(embedding dim {16,32,64};MLP₁ units {[400,400],[400,400,400],[400,400,400,400]};MLP₂ units {[400],[1000],[2000]};FS-gate hidden {[800]};fusion heads {200};dropout {0.1,0.2,0.3});RankMixer(embedding dim {64};token 数 $T$ {4,8,16};token dim $D$ {64,128};层数 {2,3,4};expansion ratio {2,4};dropout {0.1,0.2,0.3})。
5.1.2 评估场景¶
对每个 ROCS 骨干评估三种配置:
- Vanilla:原始骨干,在 request 与 candidate 侧特征之间做早期交互。其中间的 request 侧表示因此变成 candidate-dependent,每个候选都要求值完整模型。
- ROCS-Base:配置 ROCS 使其在 $N=1$ 时近似匹配对应 Vanilla 模型的推理 FLOPs。这个「效率优先」的配置不把候选数增大时释放出的节省再投资回去,从而可以隔离出「直接对一个 early-fusion 模型做 ROCSify」的质量影响。因为模型维度是离散的,精确 FLOP 匹配不可能时,选择目标预算内最接近的设置。
- ROCS-Scaled:缩放 ROCS 使其在 $N=100$ 时的摊销推理 FLOPs 近似匹配对应的 Vanilla 模型。这个设置评估 RRR——把通过 request 侧共享节省的计算,用额外的 request 侧共享容量再投资。
对 RankMixer,报告 UGSEP@1 与 UGSEP@100 配置,使用相同的摊销成本定义。
5.1.3 结果¶
表 1:三个公开数据集上的结果。 每个骨干内每个任务的最佳 AUC 加粗;FLOPs@100 最低者下划线。FLOPs@1 列中 a/b 表示 $C_R/C_C$。
KuaiVideo X1
| Model | AUC All (Click/Like/Follow) | FLOPs@1 ($C_R/C_C$) | FLOPs@100 (Reduced%) |
|---|---|---|---|
| RankMixer | 0.7933 (0.7199/0.7843/0.8757) | 9.52 | 9.52 |
| UGSEP-Base | 0.7919 (0.7209/0.7792/0.8756) | 5.37/4.74 | 4.79 (49.5%) |
| UGSEP-Scaled | 0.7939 (0.7186/0.7829/0.8802) | 10.74/9.50 | 9.61 |
| DCNv2 | 0.7909 (0.7200/0.7728/0.8622) | 1.49 | 1.49 |
| ROCS-Base | 0.7850 (0.7156/0.7927/0.8643) | 1.06/0.13 | 0.14 (90.6%) |
| ROCS-Scaled | 0.7935 (0.7138/0.7947/0.8719) | 11.58/1.34 | 1.46 |
| FinalMLP | 0.7848 (0.7158/0.7734/0.8654) | 4.39 | 4.39 |
| ROCS-Base | 0.7843 (0.7163/0.7724/0.8642) | 2.24/1.83 | 1.87 (57.5%) |
| ROCS-Scaled | 0.7890 (0.7164/0.7819/0.8687) | 5.37/4.17 | 4.23 |
| Wukong | 0.7972 (0.7247/0.7918/0.8750) | 1.10 | 1.10 |
| ROCS-Base | 0.7929 (0.7166/0.7803/0.8819) | 0.83/0.26 | 0.27 (75.4%) |
| ROCS-Scaled | 0.7980 (0.7211/0.7928/0.8801) | 3.96/1.05 | 1.10 |
KKBox
| Model | AUC Replay | FLOPs@1 ($C_R/C_C$) | FLOPs@100 (Reduced%) |
|---|---|---|---|
| RankMixer | 0.8167 | 5.49 | 5.49 |
| UGSEP-Base | 0.8135 | 3.05/2.77 | 2.79 (49.1%) |
| UGSEP-Scaled | 0.8182 | 6.32/5.69 | 5.76 |
| DCNv2 | 0.8287 | 7.21 | 7.21 |
| ROCS-Base | 0.8250 | 2.66/2.88 | 2.91 (50.7%) |
| ROCS-Scaled | 0.8330 | 5.29/5.74 | 5.79 |
| FinalMLP | 0.8232 | 10.21 | 10.21 |
| ROCS-Base | 0.8192 | 2.75/5.61 | 5.64 (44.7%) |
| ROCS-Scaled | 0.8239 | 4.54/11.21 | 11.26 |
| Wukong | 0.8342 | 6.93 | 6.93 |
| ROCS-Base | 0.8326 | 3.07/3.27 | 3.30 (53.8%) |
| ROCS-Scaled | 0.8357 | 7.36/6.78 | 6.86 |
KuaiRand X1
| Model | AUC All (Click/Like/Follow) | FLOPs@1 ($C_R/C_C$) | FLOPs@100 (Reduced%) |
|---|---|---|---|
| RankMixer | 0.8635 (0.7765/0.8810/0.9328) | 10.59 | 10.59 |
| UGSEP-Base | 0.8628 (0.7757/0.8789/0.9338) | 5.68/5.49 | 5.51 (47.9%) |
| UGSEP-Scaled | 0.8641 (0.7763/0.8842/0.9318) | 11.19/10.56 | 10.67 |
| DCNv2 | 0.8692 (0.7755/0.9013/0.9316) | 10.58 | 10.58 |
| ROCS-Base | 0.8672 (0.7749/0.8971/0.9289) | 3.49/4.76 | 4.79 (54.7%) |
| ROCS-Scaled | 0.8695 (0.7770/0.9017/0.9296) | 7.56/10.31 | 10.38 |
| FinalMLP | 0.8661 (0.7750/0.8805/0.9310) | 9.96 | 9.96 |
| ROCS-Base | 0.8659 (0.7746/0.8926/0.9305) | 2.30/5.23 | 5.26 (30.1%) |
| ROCS-Scaled | 0.8700 (0.7762/0.9019/0.9319) | 5.66/6.47 | 6.53 |
| Wukong | 0.8673 (0.7820/0.8838/0.9363) | 9.92 | 9.92 |
| ROCS-Base | 0.8624 (0.7832/0.8669/0.9370) | 3.05/5.44 | 5.47 (45.1%) |
| ROCS-Scaled | 0.8715 (0.7847/0.8908/0.9390) | 7.24/9.87 | 9.92 |
结论分析:
-
直接 ROCSify 偏向效率。 在 base 配置下,ROCS 在所有被评估骨干上都把 $N=100$ 的摊销 FLOPs 大幅降低——降幅从 FinalMLP/KuaiRand 的 30.1% 到 DCNv2/KuaiVideo 的 90.6%。如预期,不做 scaling 而直接 ROCSify 一个模型,可能因 candidate-dependent 通路的容量被削减而带来适度的质量损失(如 Wukong/KuaiRand 0.8673 → 0.8624)。这正是 §3.3 指出的「固定容量下 ROCSification 不必然保表达力」的经验印证。
-
RRR 改善质量-效率前沿。 ROCS-Scaled 把节省的计算再投资为额外的 request 侧容量,在可比的 $N=100$ 摊销预算下超越对应的 Vanilla 骨干。最典型的是 Wukong/KuaiRand:ROCS-Scaled 在 FLOPs@100 完全相同(9.92 vs 9.92) 的条件下把 AUC 从 0.8673 提到 0.8715(三个子任务全面提升);Wukong/KuaiVideo 同样在 1.10 vs 1.10 的相同预算下从 0.7972 提到 0.7980。这说明 ROCS 可以按目标在「更低服务成本」与「更高模型容量」之间自由兑换。
-
与专用 request-sharing 方案的对比。 RankMixer + UGSEP 是密切相关的、架构特定的基线。在被评估的数据集上,ROCS 让 DCNv2、FinalMLP 与 Wukong 都达到有竞争力的质量-效率前沿,同时支持差异显著的特征交互模块——这正是 GLM 相对 UGSEP 的通用性优势所在。
5.2 生产规模评估¶
公开 benchmark 确立了 ROCS 跨多骨干的适用性。接下来把骨干固定为 Wukong(代表性的大规模推荐骨干),在覆盖召回与排序阶段、跨越大范围模型复杂度的工作负载上做受控研究。
5.2.1 实验设置¶
工作负载。 评估三个生产工作负载:广告召回、短视频排序、广告排序。每个数据集包含超过 1000 亿条训练样本,对应模型跨越约两个数量级的推理复杂度。
基线。 每个工作负载下,与对应的 Vanilla Wukong 模型在相同数据、特征集、训练流程与服务环境下比较。
指标。 报告相对 log-loss(RLL)改进、以 MFLOPs 计的每候选摊销推理复杂度、以及在 H100 服务器上用重放生产流量测得的相对 QPS。RLL 越低、QPS 越高越好。 对广告工作负载,0.02% 的 RLL 改进被认为具有实际意义;对自然流量(organic)工作负载则是 0.1%。FLOPs 量化 ROCS 带来的模型层效率收益,QPS 捕捉包含 IKBO 在内的 ROCS 实现所实现的端到端服务效率。
5.2.2 端到端结果¶
表 2:ROCS 在各部署阶段与场景的表现
| Stage | Surface | Relative LogLoss | Complexity (MFLOPs) | Candidate Multiplicity | Relative QPS |
|---|---|---|---|---|---|
| Retrieval | Ads | On par | $O(100)$ | $O(10{,}000)$ | +196% |
| Ranking | Organic | −0.5% | $O(1{,}000)$ | $O(100)$ | +47% |
| Ranking | Ads | On par | $O(10{,}000)$ | $O(100)$ | +62% |
结论分析: ROCS 在匹配或改进模型质量的同时,把 replay QPS 提升 47%–196%,覆盖跨越约两个数量级推理复杂度的召回与排序模型。
- 最大增益出现在广告召回(+196%),它也具有最高的候选倍数 $O(10{,}000)$ ——这与「request 侧计算的摊销程度越高,收益越大」完全一致,也直接对应 $c_{\mathrm{amort}}(N) = C_C + C_R/N$ 中 $N$ 越大、$C_R$ 被摊得越薄的数学结构。
- 短视频排序上,恢复出的服务预算有一部分被再投资到模型容量,因此在保留可观 QPS 增益(+47%)的同时还拿到 −0.5% 的 RLL 改进(自然流量场景 0.1% 即算显著,这是 5 倍于显著阈值的收益)。
5.2.3 Request 侧 scaling¶
固定 candidate 侧容量,渐进式扩大 request 侧计算。
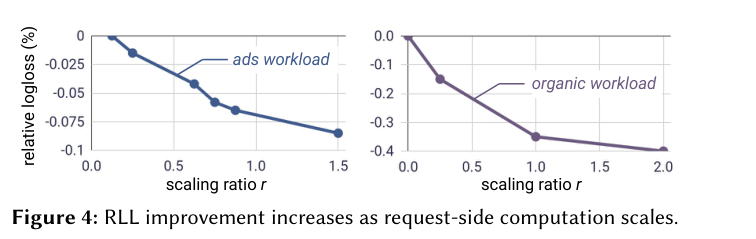
结论分析: 图 4 显示,随着 request-to-candidate FLOPs 比值(scaling ratio $r$) 增大,两个模型的模型质量都一致改善——广告工作负载的相对 logloss 从 0 单调降到约 −0.1%($r$ 从 0 到 1.5),自然流量工作负载从 0 降到约 −0.4%($r$ 从 0 到 2.0)。这直接验证了 RRR 的有效性:request 侧容量是一个便宜且真实有效的质量杠杆。值得注意的是自然流量曲线在 $r\approx1.0$ 后趋于平缓,暗示存在收益递减点。
5.2.4 DCA 的有效性¶
表 3:DCA 关键设计选择的消融
| Model | Relative LogLoss | Relative QPS |
|---|---|---|
| DCA | (baseline) | (baseline) |
| Interformer | On par | −36% |
| Single-Depth Cross-Attention | +0.05% | +5% |
| DCA w/o Request-side Cross Attention | +0.05% | On par |
结论分析:
- 替换 DCA 为 InterFormer(它把 candidate 依赖引入序列处理栈)虽然质量相当,但 QPS 降低 36%。这精确说明了 DCA 的价值主张:同等质量下,把 candidate 依赖挡在序列栈之外能省下超过三分之一的服务吞吐。
- 把 cross-attention 限制到单个交互深度会让 RLL 退化 0.05%(换来 +5% QPS),证明了逐层序列检索的质量收益——即 §3.2「Benefiting from Depth」的经验支撑。
- 移除 request 侧 cross-attention 造成 0.05% 的 RLL 回退且 QPS 无改善,说明 request 侧检索本身也对质量有贡献——它不是一个纯粹的效率装置,而是承重的建模组件。
5.2.5 IKBO 的有效性¶
表 4:增量优化的 IKBO-LCB kernel 延迟分解
| Optimization | Latency (ms) | Changes |
|---|---|---|
| Original | 1.944 | (baseline) |
| Decomposition | 1.389 | −28.5% |
| Memory alignment | 0.798 | −58.9% |
| Broadcast fusion | 0.580 | −70.2% |
| Pipelining GEMM with broadcast + fusing request/candidate compute | 0.482 | −75.2% |
结论分析: 把 request 侧 broadcast 融进 candidate 侧 GEMM、再叠加后续的调度与对齐优化,渐进式地把 kernel 延迟压到原来的四分之一。值得注意的是内存对齐(§4.2.4)单独就贡献了从 −28.5% 到 −58.9% 的巨大一跳——这提醒:分解本身改变了张量形状,如果不修复由此产生的对齐问题,代数上的节省会被访存效率的退化大幅抵消。
表 5:IKBO-DCA 与 FlashAttention 基线的性能对比。 总延迟包含显式的 K/V broadcast 与 attention。
| Method | Throughput (TFLOPs/s) | IO (GB/s) | Total / Attention Latency (ms) |
|---|---|---|---|
| TLX FA3 | 245 | 2,152 | 1.473 / 0.561 |
| CuTeDSL FA4 Hopper | 250 | 2,193 | 1.462 / 0.550 |
| IKBO DCA | 594 | 681 | 0.230 / 0.230 |
结论分析: IKBO 通过消除物化的 K/V broadcast、并改善跨候选的复用,把 attention 延迟从 0.55 ms 降到 0.23 ms(约 2.4×)。从算子层面看,IKBO 降低了访存带宽(2,193 → 681 GB/s)同时提升了吞吐(250 → 594 TFLOPs/s),把 kernel 从访存受限推向计算受限——这是本表最有信息量的一点:两个 FlashAttention 基线的 IO 高达 2 TB/s 却只跑出 250 TFLOPs/s,说明它们的瓶颈完全在重复搬运同一份 K/V。另外注意 FA3/FA4 的 total latency(1.47 ms)远大于 attention latency(0.55 ms),差额即显式 K/V broadcast 的代价;IKBO 的 total 与 attention 延迟完全相等(0.230 / 0.230),即 broadcast 开销被彻底消除。
5.3 在线部署¶
ROCS 已在 Meta 数十个生产推荐模型中部署,覆盖广告与自然流量场景、召回与排序两个阶段。代表性结果:
- 短视频排序模型上 0.04% topline 指标增益 + 32% 容量节省(在该规模上具有实际显著意义);
- 广告排序模型上 topline 持平 + 38% 容量节省;
- 广告召回模型上 0.2% topline 指标增益 + 29% 容量节省。
跨部署来看,ROCS 一致地交付质量收益、成本下降,或两者兼得;释放出的容量可以被再投资到进一步的模型 scaling。
核心贡献总结¶
-
把 request 级算力冗余识别为结构性错配,而非实现瑕疵。 论文明确指出:这是「推荐模型架构」与「request-to-candidate 执行模式」之间的 co-design 机会。这个 framing 本身是贡献。
-
GLM:一条在复合下封闭的算子级依赖契约。 相比「注意力掩码」只治理注意力,GLM 用块下三角掩码 $M_{ij}=\mathbb{1}\{j\le i\}$ 覆盖线性层/LCB、group-local normalization、逐点算子、FM 交互,并证明其在复合下封闭(Eq.11),从而保证整条 request 侧通路在任意深度都可精确复用。这是从「一层的代数分解」到「全网络的不变量」的跃迁。
-
DCA:把 request-oriented 共享延伸到序列建模。 共享 request-only 序列编码器 + 逐层双组 cross-attention,同时保留了 candidate-conditioned 检索与深度收益,且被证明保持 GLM 不变量、可与 GLM 模块自由组合。消融显示逐层检索与 request 侧检索都是承重的。
-
RRR:把「节省」变成「杠杆」。 因为 request 侧算力被摊到 N 个候选上,request 侧 scaling 比 candidate 侧便宜得多。这个非对称成本结构让 ROCS 能按需在成本与质量之间兑换,图 4 与 ROCS-Scaled 行给出了经验曲线。
-
IKBO:让代数节省真正落到硬件上。 四层递进的 GPU 协同设计——GEMM epilogue 融合 broadcast-and-add、warp specialization 重叠 mainloop 与 epilogue、request/candidate mega-kernel + bidirectional tile scheduling、以及内存对齐自动变换;DCA 侧则特化 FlashAttention-3 以跨候选摊销 K/V 访存并重排 grid 顺序。结果:LCB kernel −75.2% 延迟,DCA attention 2.4× 加速且 broadcast 开销归零。
-
大规模生产验证。 数十个模型、广告 + 自然流量、召回 + 排序、两个数量级推理复杂度,replay QPS +47%~196%,在线 topline 增益 + 29%~38% 容量节省。
与已归档相关工作的对比¶
rDCN rDCN / Rank-Aware Decomposition:Context Features Are Cheap(Taboola, 2026-05-24)¶
关系:独立并发(本文未引用该工作,两者殊途同归)· 已加载对方精读
-
共同关注的问题(同一 root cause):两篇指向完全相同的结构性浪费——一次请求里的 N 个候选共享同一套 request/context 特征,但标准实现在交互计算前就把它们 broadcast/tile 到候选 batch 维度,导致 context-only 计算被重复 N 次。rDCN 原文的诊断("标准做法在任何交互计算前就把上下文 embedding 广播到 rank 3……本文做法:推迟广播")与 ROCS 的 "ROCS defers request–candidate interactions as late as possible" 是同一句话的两种写法。两者甚至选择了同一组被优化的算子:线性/FC 层、FM 配对交互、cross 层、attention。
-
相近的技术骨架:两者的方法流程图在正确抽象层上高度重合——「按 request/candidate(rank-2/rank-3)划分输入 → 对每个线性/双线性算子做分块分解、把 candidate→request 的权重块置零 → request 块每请求算一次 → 只在进入 candidate 流时才广播混合」。rDCN 的非对称加载原理("架构应当只把 context×target 交互加载到 target 流上,context 流只通过 context×context 演化")与 ROCS 的 GLM 块下三角掩码 Eq.(6)(右上块 $W_{RC}$ 强制置零、保留 $W_{CR}$)在数学上是同一个约束。rDCN 的双流 rDCN 层(Eq.19/20)与 ROCS 的 GLM 双组通路是同一结构。
-
本文的差异与推进:
- 从「逐层分解」到「复合封闭的不变量」。rDCN 明确承认其精确分解只在第 0 层成立,因为后续层会「混 rank」,并把 rDCN 作为"放弃 identity-equivalence、换全深度节省"的架构变体提出。ROCS 则直接把封闭性作为设计起点(§3.1.5,Eq.11),用一条统一契约覆盖线性/LCB/group-local norm/逐点算子/FM,并证明整个 MLP 与交互栈都保持不变量。ROCS 还额外指出 rDCN 未处理的一个坑:normalization 等聚合算子必须 group-local,否则统计量会引入反向依赖。
- 序列侧从「草拟」到「生产」。rDCN 的 rank-aware attention 只有 §4.3 的文字草稿("生产实现与经验评估留作未来工作");ROCS 的 DCA 是完整实现 + 消融(表 3)+ 上线,并解决了 rDCN 未触及的深度问题(逐层 cross-attention)与 softmax 归一化实现。
- 补上了「再投资」这一环。rDCN 只把节省当作成本下降兑现;ROCS 用 RRR 明确提出「request 侧 scaling 比 candidate 侧便宜」的非对称杠杆,并用 ROCS-Scaled 与图 4 证明可以把节省换成质量。
-
kernel 层协同设计。rDCN 停在代数与框架层(TensorFlow Serving + oneDNN);ROCS 的 IKBO 把 broadcast 消解进 GPU kernel,表 4/表 5 显示这一层贡献了 75.2% 的 LCB 延迟下降与 2.4× 的 attention 加速——没有这一层,代数节省会因张量对齐退化与显式 broadcast 而被大幅侵蚀。
-
可比的方法/实验差异:rDCN 在 CPU(Intel Xeon Silver 4510 + TF Serving)、判别式 DLRM/DCN、单作者单平台(Taboola),核心卖点是 identity-equivalent(预测逐位相同、零训练、零 A/B 风险),生产收益 +87.5% 单 pod 吞吐;ROCS 在 GPU(H100)、Wukong 骨干、Meta 数十个模型,放弃了逐位等价(ROCSify 会改变模型函数、需要重训),换来全深度节省 + 序列侧覆盖 + RRR 质量增益,replay QPS +47%~196%。此外 rDCN 提供了 ROCS 缺失的一个分析视角:节省二次于 context 字段数 K、对 target 字段数 M 不敏感("加上下文几乎免费,加目标才真贵"),而 ROCS 只给出 $c_{\mathrm{amort}}(N)=C_C+C_R/N$ 这个关于候选数的摊销式,未刻画与特征规模的标度关系。一句话:rDCN 把这件事证成了一条零风险的代数恒等式,ROCS 把它做成了一个覆盖全深度、含序列模块与 GPU kernel 的完整范式。
WHALE WHALE: Wukong + HSTU 统一模型(Meta Platforms, 2026-07-19)¶
关系:独立并发(同一公司、相隔 11 天,本文未引用 WHALE)· 已加载对方精读
-
共同关注的问题:两篇都把「同一请求内许多候选共享同一段用户历史,把历史表示算一次并跨候选复用」作为让长序列建模在大规模工业排序中计算上可行的关键结构性质。WHALE 的精读原文在评述 Kunlun 时明确写道:Kunlun 不采用 HSTU 式序列骨干,"因此不针对『按请求复用用户历史计算』这一点"——这正是 ROCS §3.2 DCA 的出发点。ROCS 则把这一点从「某个架构的附带性质」提升为必须被算子级契约保证的不变量。
-
相近的技术骨架:WHALE 的融合模块与 ROCS 的 DCA 几乎是同一张流程图:特征交互侧(Wukong)表示充当 query,序列侧(HSTU)表示提供 key/value,跨分支 cross-attention 在每一层重复,让候选/上下文相关的交互表示从共享的用户历史中选择性检索行为证据。ROCS 的 Figure 1(c) 结构(Req./Cand. Embedding → LCB+MLP → Q;User Seq. → Self Attention → K/V;→ Cross Attention)与 WHALE 的 Wukong-query/HSTU-KV 融合层一一对应;ROCS 的 Figure 1(d) 更是直接把 GLM 画在 Wukong 骨干上(FM/LCB/MLP/Concat/Add&Norm 全部标注为 ROCSified)。两者连逐层重复交换这一设计动机(WHALE 的"渐进式跨分支交换"vs ROCS 的"Benefiting from Depth")都一致。甚至在 kernel 层也撞车:WHALE 的共享 key-value(令 $K=V$)以减半 KV 侧显存流量,与 IKBO-DCA 跨候选摊销 K/V 访存(IO 2,193 → 681 GB/s)动机相同——都识别出跨分支/跨候选 attention kernel 是 memory-bound。
-
本文的差异与推进:
- 目标函数不同。WHALE 的首要目标是质量 scaling(让两个已验证的可扩展骨干同时活跃、逐层互相条件化),跨候选复用是其得以部署的前提条件;ROCS 的首要目标就是把这个前提条件本身形式化并最大化。因此 WHALE 的 Wukong 分支仍然混合 user/item/contextual 特征(即 candidate-dependent),而 ROCS 用 GLM 在 Wukong 内部再切一刀,让 FM/LCB/MLP 的 request 组输出保持 candidate-independent。
- 序列侧的严格性。WHALE 的 HSTU 分支天然 candidate-independent,但这依赖架构选择;ROCS 的 DCA 用「序列流排除 candidate 输入」+「GLM-compliant query generator」把它变成可验证的契约,并证明 DCA 与 GLM 组合后不变量仍然成立。
- RRR 与 IKBO。WHALE 的系统协同设计(共享 KV、非对称反向、shared-gate SwiGLU)带来训练吞吐 +30%、推理吞吐 +22%;ROCS 的 IKBO 在同类问题上更激进(消除物化 broadcast、mega-kernel、内存对齐自动变换),并额外提供 RRR 这个把效率换质量的显式旋钮。
- 在线收益对照:WHALE 主指标 +0.113%(Meta 社交媒体 surface,0.03% 即显著);ROCS 短视频排序 +0.04% topline + 32% 容量节省、广告召回 +0.2% topline + 29% 容量节省。两者是互补而非替代——WHALE 提供「Wukong × HSTU 该怎么融合」的架构答案,ROCS 提供「这个融合如何在候选维度上不浪费算力」的执行答案,且 ROCS 的实验骨干正是 Wukong。
OneTrans OneTrans:统一因果 Transformer + Cross-Request KV Caching(ByteDance, 2025-10-30)¶
关系:显式引用但原文未展开对比(仅作为 [42] 列在"jointly model sequential and non-sequential features"一组中,无方法或指标层对比)· 已加载对方精读
-
共同关注的问题:OneTrans §2.5.1 的诊断与 ROCS 完全一致——"同一请求的多个候选物品共享相同的 S-tokens(用户行为历史),仅 NS-tokens 因候选物品不同而变化",据此把推理分为 Stage I(S 侧,每请求一次,缓存 KV) 与 Stage II(NS 侧,每候选一次,与缓存 KV 做 cross-attention),把 S 侧时间复杂度从 $O(C)$ 降到 $O(1)$($C$ 为候选数)。这与 ROCS 的 DCA「共享序列编码 + K/V 每请求算一次」是同一机制。
-
相近的技术骨架:OneTrans 用因果注意力掩码 + 混合参数化实现 S/NS 分离——S-token 只 attend 之前的 S-token,NS-token 可 attend 完整 S 历史。这在注意力算子内部等价于 ROCS 的块下三角掩码 Eq.(3)。ROCS 的两阶段执行(request-batched / candidate-batched)与 OneTrans 的 Stage I / Stage II 一一对应。
-
本文的差异与推进:这恰恰是 ROCS §2 相关工作里那句关键批评的靶心——"注意力掩码并不治理实际推荐模型中大量非注意力组件(MLP、特征压缩层、显式特征交互算子)引入的依赖"。OneTrans 的因果掩码保证了 attention 内部的 S/NS 分离,但它的 Mixed FFN($\mathbf{W}_i^1,\mathbf{W}_i^2$ 对 $i\le L_S$ 共享、对 $i>L_S$ token-specific)虽然按 token 分参数,其分离依然是架构特定的、按 token 位置手工排布的,而非一条可组合、可验证、跨异构算子成立的契约。ROCS 的 GLM 把它推广到 FM、LCB、group-local norm、逐点算子,并给出复合封闭性证明——从「某个 Transformer 恰好满足」变成「任何交互栈都能被 ROCSify」。此外 OneTrans 的金字塔裁剪是一种沿深度丢弃 token 的近似压缩(信息漏斗到序列尾部),与 ROCS 的 RRR「把省下的算力再投资回 request 侧容量」方向相反:OneTrans 用节省换更长的序列(固定 FLOPs 下支持 1.75× 长序列),ROCS 用节省换更大的 request 侧容量或更低成本。
-
一个 OneTrans 独有、ROCS 未覆盖的维度:因为用户行为序列是追加式的,OneTrans 的 KV 缓存还能跨请求复用(复杂度 $O(L)\to O(\Delta L)$)。ROCS 的共享严格发生在单次请求内部的候选维度上,跨请求复用不在其范围。两者在这一点上完全互补。详细精读见 OneTrans。
讨论与局限性¶
核心贡献与值得借鉴的设计¶
1. 「依赖契约」是比「掩码」更正确的抽象层次。 本文最锋利的一击,是指出注意力掩码只是一个算子局部的机制,而跨候选复用需要的是一个全网络的函数依赖性质。把它写成 Eq.(1) 这样的形式化不变量之后,「哪些算子可以 ROCSify、怎么 ROCSify」就变成一个可以逐算子机械检查的问题,而不需要对每个新架构重新做一遍分析。Eq.(1) 后面那句「这是函数依赖约束,不是统计独立假设」尤其值得记住——它澄清了一个常见误解:ROCS 并不要求 request 与 candidate 特征无关,它只要求信息不倒流。
2. 「复合封闭性」是把一次性优化变成系统性优化的关键。 rDCN 那篇已经证明了单层分解,但明确承认「第 0 层之后节省衰减到零」。ROCS 的 §3.1.5 用两行归纳论证补上了这个缺口,代价是接受 group-local normalization 这类更严格的算子形式。这个取舍非常划算:牺牲一点算子灵活性,换来任意深度的可复用性。
3. 非对称成本结构是一个真正的设计杠杆。 RRR 的洞察——「因为 request 侧被摊到 N 个候选上,往 request 侧加容量比往 candidate 侧加便宜 N 倍」——把「省下来的算力怎么办」从一个事后问题变成了架构设计的一等公民。图 4 与 ROCS-Scaled 那些「FLOPs 完全相同、AUC 更高」的行(Wukong/KuaiRand 9.92 vs 9.92,0.8673 → 0.8715)是全文最有说服力的证据。
4. 代数节省必须靠 kernel 兑现。 表 4 里「内存对齐」单独贡献了一大跳(−28.5% → −58.9%),提醒一个容易被忽视的事实:分解会改变张量形状,如果不管对齐,FLOPs 上的胜利会在访存上被吐回去。表 5 里 FA3/FA4 用 2.2 TB/s 的 IO 只换来 250 TFLOPs/s,更是把「重复搬运同一份 K/V」的代价量化得极其清楚。做这类工作的人应该把这两张表当作 checklist。
局限与争议¶
1. 放弃了 identity-equivalence,因此有真实的建模风险。 与 rDCN 的「预测逐位相同、零重训、零 A/B 风险」不同,ROCSify 改变了模型函数——表 1 的 ROCS-Base 行清楚显示了这一点(Wukong/KuaiRand 0.8673 → 0.8624,DCNv2/KuaiVideo 0.7909 → 0.7850)。质量必须靠 RRR「买回来」,这意味着每次应用 ROCS 都需要重训 + 容量重新调优,而不是一个可以灰度上线的纯工程优化。论文对「哪些场景下 RRR 买不回来」没有给出边界条件。
2. 收益强依赖候选倍数,论文自己也承认。 §6 明确写道:"ROCS 在每请求对多个候选打分、且大部分模型计算保持 candidate-independent 时最有效。当候选倍数低时其收益减弱,包括低候选数的训练设定。" 表 2 也印证:候选倍数 $O(10{,}000)$ 的广告召回拿到 +196%,$O(100)$ 的排序只有 +47%~62%。这限制了 ROCS 在精排后段、重排、或候选数很小的场景的价值。 此外「训练时候选倍数低」这一点意味着 ROCS 的训练侧收益远小于推理侧,训练成本可能不降反升(request 侧容量被 RRR 扩大了)。
3. IKBO 绑定 NVIDIA 生态。 §6 承认 "IKBO 是一个通用策略,但我们的实现依赖现代 NVIDIA GPU 上可用的原语"——TLX、WGMMA、TMA、Triton、FlashAttention-3/4 全是 Hopper/Blackwell 特有。在 CPU 服务(如 rDCN 所处的场景)或非 NVIDIA 加速器上,本文的效率收益能剩下多少是未知数,而表 4/表 5 显示这部分收益占比很大。
4. 生产实验的可验证性偏弱。 生产部分的所有数字都是相对值("On par"、"−0.5%"、"+196%"、"$O(100)$ MFLOPs"),没有绝对指标、没有模型规模、没有数据集描述,外部无法评估。表 2 只有 3 行、表 3 只有 3 个消融点,消融偏薄:GLM 的各个算子级构造(FM 掩码 vs LCB 掩码 vs group-local norm)没有单独消融,RRR 的 scaling ratio $r$ 也只有图 4 两条曲线而无表格。GLM 本身没有独立的消融——表 3 只测了 DCA。
5. 与最接近的两条基线对比不充分。 UGSEP 是 §2 点名的、最直接的 request-sharing 竞品,但表 1 中 UGSEP 只跑在 RankMixer 上、ROCS 只跑在 DCNv2/FinalMLP/Wukong 上,两者从未在同一骨干上正面比较。论文的结论只是"ROCS 在支持差异显著的交互模块的同时达到有竞争力的前沿"——这是一个关于通用性的论证,不是关于同条件下谁更强的论证。同理,InterFormer 只在生产消融里出现一行(表 3)。
6. 公开实验规模有限。 三个数据集、单张 H100、每实例约 10 MFLOPs 的预算,与生产侧 $O(10{,}000)$ MFLOPs、1000 亿样本的规模相差三个数量级以上。表 1 的部分结果也并不干净:ROCS-Scaled 在 FinalMLP/KKBox 上 AUC 0.8239 只比 vanilla 0.8232 高 0.0007,而 FLOPs@100 却从 10.21 涨到 11.26(更贵却几乎没更好);UGSEP-Scaled 在 KuaiVideo 上同样是 9.52 → 9.61 换来 0.7933 → 0.7939。这类「摊销预算并未严格匹配」的行削弱了「同预算下更优」的叙事强度。
与已有工作的差异(一句话定位)¶
ROCS 是把「一个请求 × N 个候选」这个推荐推理独有的结构,第一次同时在三个层次上做到位的工作:在代数层用复合封闭的算子级契约(GLM)取代逐层分解与注意力掩码;在架构层用 DCA 把契约延伸到序列模块并保留深度收益,用 RRR 把节省变成可兑换的质量杠杆;在执行层用 IKBO 让 broadcast 彻底不落地。相对 rDCN 它牺牲了 identity-equivalence 换来全深度与序列覆盖,相对 OneTrans/WHALE 它把「架构恰好满足的性质」变成了「任何架构都能被施加的契约」。其局限也同样清晰:收益随候选倍数衰减、依赖重训、绑定 NVIDIA 原语,且公开实验规模与生产叙事之间存在难以桥接的鸿沟。