TransX:通过行为流与服务流交叉扩展 Transformer 推荐系统
研究动机与背景
工业推荐系统每天处理数十亿事件,并在数十万 QPS 下受百毫秒级 p99 延迟约束。传统 DLRM 依赖人工构造的稀疏/稠密特征及浅层特征交叉,难以直接吸收 180 天级别的超长、异质行为历史;近年的 Transformer 与生成式推荐则常照搬 LLM,把历史行为、系统曝光以及用户反馈全部压成一条 monolithic token stream。这种统一序列看似简洁,却隐含了两个结构性问题。
第一是语义与因果角色混淆。用户行为流由用户主动产生,反映跨场景、跨时间的潜在意图;服务事件流由系统产生,包含当前曝光的候选及上下文;反馈是用户对这次曝光的响应。三者时间未必对齐,生成机制也不同。把它们当成同质 token,会掩盖“长期意图作为条件、候选曝光作为直接原因、action 作为结果”的非对称关系。
第二是计算重复。如果每次曝光、每个候选都重新编码完整行为前缀,训练复杂度会被服务事件数 $T$ 乘上,在线成本也随历史长度 $L$ 增长。论文的核心判断是:长期行为表示天然可以按用户近线增量计算,而实时请求只应承担候选特定的轻量 crossing 与 action decoding。
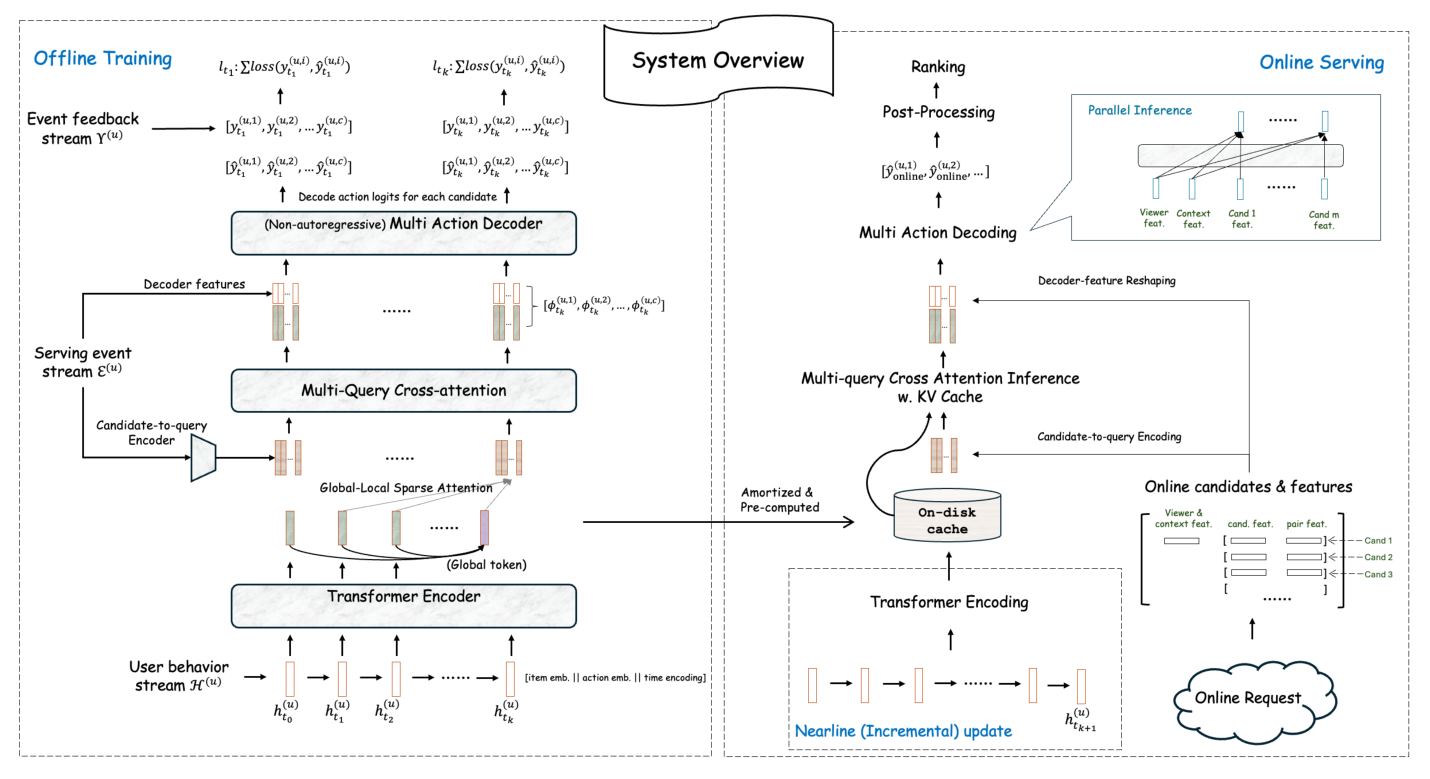
TransX 因而把推荐重写为 Action Transduction via Stream Crossing:行为流交给独立的 causal Transformer encoder;当前 serving slate 生成 candidate-specific query;二者通过 grouped multi-query sparse cross-attention 交叉;最后以非自回归方式并行预测每个候选的离散 action token。模型与基础设施共同设计,使昂贵的历史编码移出在线关键路径。
问题形式化与记号
| 符号 | 含义 |
|---|---|
| $u$ | 用户索引 |
| $j$ | 一次服务事件内的候选索引 |
| $L,d$ | 行为序列长度与隐藏维度 |
| $\mathcal A=\{a^{[1]},\ldots,a^{[k]}\}$ | action token 词表,如 view、click、like |
| $y_t^{(u,j)}\in\mathcal A$ | 用户对事件 $t$ 中第 $j$ 个候选采取的动作 |
| $c_t^{(u,j)}\in\mathcal I$ | 第 $j$ 个候选的 item identity |
| $x_t^{(u,j)}$ | user、item、user-item pair 与 event context 特征 |
| $h_{\tilde t}^{(u)}\in\mathbb R^d$ | 时间 $\tilde t$ 的行为 token;$\tilde t$ 不必与服务事件时间 $t$ 对齐 |
| $\mathcal E^{(u)},\mathcal Y^{(u)},\mathcal H^{(u)}$ | 服务事件流、反馈流、行为流 |
一次服务事件向用户呈现 $m_t$ 个候选:
$$ \mathcal E_t^{(u)}:=\left\{\left(c_t^{(u,j)},x_t^{(u,j)}\right)\right\}_{j=1}^{m_t}. \tag{1} $$
对应反馈集合为:
$$ \mathcal Y_t^{(u)}:=\left\{y_t^{(u,j)}\right\}_{j=1}^{m_t},\qquad y_t^{(u,j)}\in\mathcal A. \tag{2} $$
用户在平台上的一般行为形成不强制与曝光对齐的序列:
$$ \mathcal H^{(u)}:=\left\{h_{\tilde t}^{(u)}\right\}. \tag{3} $$
于是推荐不再是对扁平序列做 next-token prediction,而是在行为前缀与当前服务事件的 crossing 上转导整组动作:
$$ y_t^{(u,1)},\ldots,y_t^{(u,m_t)}\sim p\!\left(\mathcal Y_t^{(u)}\mid \{x_t^{(u,1)},\ldots,x_t^{(u,m_t)}\},\mathcal H_{<t}^{(u)}\right). \tag{4} $$
核心方法与模型架构
1. 行为流编码器
$\Phi_{\mathrm{behavior}}(\mathcal H_{<t}^{(u)})$ 由标准 causal Transformer block 构成,每个行为 token 拼接三类信息:行为对象 embedding(如被点击的 item)、行为类型 embedding(search、profile view 等)以及相对位置编码。causal mask 保证每个表示只依赖过去,使整条行为流可一次左到右编码,并在任意服务时间点切出 prefix-consistent 表示。
行为编码器只学习用户意图演化,不接收当前候选,因此输出可异步、近线计算;但它也不能单独预测特定候选的反馈。候选相关性由下一阶段的 stream crossing 注入。
2. 候选编码与 grouped multi-query cross-attention
候选到 query 的编码器把一次事件的 $m$ 个候选表示为矩阵:
$$ \Phi_{\mathrm{candidate}}(\mathcal E_t^{(u)}) := \left[\Phi_{\mathrm{candidate}}(x_t^{(u,1)}),\ldots,\Phi_{\mathrm{candidate}}(x_t^{(u,m)})\right]^\top\in\mathbb R^{m\times d}. \tag{5} $$
每个候选保留独立 query,同一用户请求中的所有候选共享由行为流导出的 key/value:
$$ \mathbf Q=\Phi_{\mathrm{candidate}}(\mathcal E_t^{(u)})\mathbf W^Q,\qquad \mathbf K=\Phi_{\mathrm{behavior}}(\mathcal H_{<t}^{(u)})\mathbf W^K,\qquad \mathbf V=\Phi_{\mathrm{behavior}}(\mathcal H_{<t}^{(u)})\mathbf W^V. \tag{6} $$
这既保留 candidate specificity,又避免为每个候选重复生成行为侧 K/V。为了不让在线 attention 扫描全部 $L$ 个历史 token,TransX 采用 local-global 稀疏模式:$\mathcal I_t=\mathcal I_{t,\mathrm{local}}\cup\mathcal I_{t,\mathrm{global}}$,前者包含最近 $L_{\mathrm{local}}$ 个行为,后者包含对截至 $t$ 的历史做 attention pooling 得到的全局 anchor。每个 head 计算:
$$ \operatorname{Attn}_{\mathcal I}(\mathbf Q,\mathbf K,\mathbf V)=\operatorname{softmax}\!\left(\frac{\mathbf Q\mathbf K_{\mathcal I}^{\top}}{\sqrt{d_h}}\right)\mathbf V_{\mathcal I}. \tag{7} $$
记 $\Phi_{c,t}=\Phi_{\mathrm{candidate}}(\mathcal E_t^{(u)})$、$\Phi_{b,t}=\Phi_{\mathrm{behavior}}(\mathcal H_{<t}^{(u)})$,完整 crossing block 为:
$$ \widetilde\Phi_{c,t}=\operatorname{LN}\!\left(\Phi_{c,t}+\operatorname{MHA}_{\mathrm{LG}}(\Phi_{c,t},\Phi_{b,t})\right),\qquad \operatorname{crossAttend}(\mathcal E_t^{(u)},\mathcal H_{<t}^{(u)})=\operatorname{LN}\!\left(\Phi_{c,t}+\operatorname{FFN}(\widetilde\Phi_{c,t})\right). \tag{8} $$
在线 crossing 成本从 dense attention 的 $O(mL)$ 降为 $O(mL_{\mathrm{local}})$,且行为表示和 K/V 都可缓存。
3. 并行 Action Transduction Decoder
TransX 对同一事件里的候选做条件独立、并行的非自回归解码:
$$ p\!\left(\mathcal Y_t^{(u)}\mid\{x_t^{(u,1)},\ldots,x_t^{(u,m_t)}\},\mathcal H_{<t}^{(u)}\right)=\prod_{i=1}^{m_t}p\!\left(y_t^{(u,i)}\mid x_t^{(u,i)},\mathcal H_{<t}^{(u)}\right). \tag{9} $$
令 $\mathbf Z_t^{(u)}=\operatorname{crossAttend}(\mathcal E_t^{(u)},\mathcal H_{<t}^{(u)})\in\mathbb R^{m\times d}$。decoder 维护共享 action-token query embedding:
$$ \mathbf Q_{\mathrm{dec}}=\left[\mathbf q_{\mathrm{dec}}^{(a_1)},\ldots,\mathbf q_{\mathrm{dec}}^{(a_k)}\right]\in\mathbb R^{k\times d}. \tag{10} $$
每个候选的 crossing 表示与事件特征经非线性 prediction head 生成 decoder key:
$$ \mathbf k_{\mathrm{dec}}^{(u,c)}=f_{\mathrm{dec}}\!\left(\mathbf z_t^{(u,c)},x_t^{(u,c)}\right). \tag{11} $$
最终 action 分布为:
$$ p\!\left(y_t^{(u,c)}\mid\mathcal E_t^{(u)},\mathcal H_{<t}^{(u)}\right)=\operatorname{softmax}\!\left(\mathbf Q_{\mathrm{dec}}\mathbf k_{\mathrm{dec}}^{(u,c)}\right). \tag{12} $$
这种 query-key softmax 把 action 词表与上游 candidate/behavior 表征解耦,使所有候选共享同一 action 归一化空间,减少 uncontrolled logit scaling 与多任务干扰,有利于工业排序所需的概率校准。$f_{\mathrm{dec}}$ 可用 Deep & Wide:
$$ f_{\mathrm{dec}}(\mathbf z_t^{(u,c)},x_t^{(u,c)})=\operatorname{concat}\!\left([\operatorname{linear}(x_t^{(u,c)}),\operatorname{FFN}(\mathbf z_t^{(u,c)},\operatorname{deep}(x_t^{(u,c)}))]\right). \tag{13} $$
也可用 Transformer prediction head,把 context、user 与各 candidate token 组成:
$$ \mathcal S_t^{(E)}=[x_t^{\mathrm{context}};x_t^{\mathrm{user}};[x_t^{c_1},\mathbf z_t^{(u,c_1)}];\ldots;[x_t^{c_m},\mathbf z_t^{(u,c_m)}]]. \tag{14} $$
定制 mask 令候选只能看 context/user,候选之间互不可见,因此仍能完全并行。
单次流式 Seq-to-Seq 训练
传统 per-event 训练会为每个标签重复编码用户历史。TransX 对一个用户的全部 serving event 做一次 grouped non-autoregressive 映射:
$$ \left(\mathcal H^{(u)},\{\mathcal E_t^{(u)}\}_{t=1}^{T_u}\right)\xrightarrow{\mathrm{TransX}}\{\mathcal Y_t^{(u)}\}_{t=1}^{T_u}. \tag{15} $$
所有事件和候选的损失在一次 forward-backward 中累积:
$$ \mathcal L^{(u)}=\sum_{t=1}^{T_u}\sum_{c=1}^{m_t}\ell\!\left(y_t^{(u,c)},\widehat y_t^{(u,c)}\right). \tag{16} $$
训练时先用 causal encoder 一次编码行为流,再按每个事件时间切片对应前缀;event-level crossing 与 decoder 只在服务事件处触发。论文在 CTR 公平比较中统一使用 click/no-click binary cross-entropy。该设计实测把每 epoch 训练时间相对 per-event 范式缩短约 50%。
在线服务与复杂度
近线管道在新行为到达时增量更新用户编码,并持久化到 per-viewer on-disk cache;缓存用 bf16 代替 float32,作者报告性能影响可忽略。请求到达后只读取最近 $L_{\mathrm{local}}$ 个表示和一个全局 token,生成共享 K/V,再为候选并行执行 crossing 与 decoder。
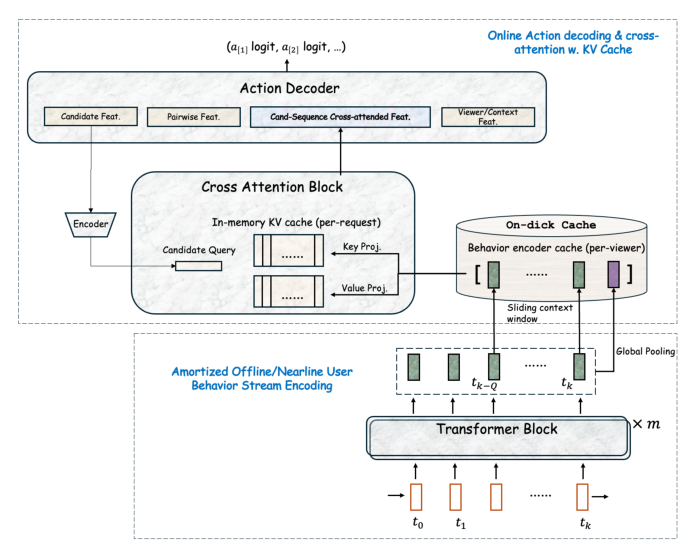
训练时,TransX 的每用户总复杂度是:
$$ O(L^2d+Ld^2)+O(TmL_{\mathrm{local}}d+Tmkd). \tag{17} $$
重复编码前缀的基线则约为:
$$ \sum_{t=1}^{T}O(\bar L^2d+\bar Ld^2)=O\!\left(T(\bar L^2d+\bar Ld^2)+Tmkd\right). \tag{18} $$
在线每事件计算为:
$$ O(md^2+mL_{\mathrm{local}}d+mkd), \tag{19} $$
与完整历史长度 $L$ 无关;请求内存只需:
$$ O(L_{\mathrm{local}}d). \tag{20} $$
部署还覆盖了现实故障路径:约 2% 无行为缓存的 cold-start 流量回退到不含 behavior encoder/cross-attention 的轻量模型;短历史用户直接用完整 TransX;cache 以 model ID 与 feature-schema version 联合版本化,并配置 TTL/LRU;高活跃用户用 Kafka event trigger 增量更新,其他用户用 HDFS time trigger 批量刷新。cache 损坏、驱逐尖峰或临时存储故障时同样自动回退。因 causal Transformer 与相对位置 bias 不改变历史 token 表示,新行为到来时仅编码追加 token,无需重算全序列。
实验设置
- 数据:LinkedIn 最大社交推荐应用的内部生产数据,覆盖数亿日交互;行为回看窗口为 180 天,按时间切分 train/validation/test。
- 任务与指标:为公平比较,预测 click/no-click;报告 AUC、AUPR 和按用户等权平均的 gAUC。
- 采样:正样本率约 3%;训练时下采样 no-action,使正负候选数相等;验证与测试保持真实分布。
- 模型:TransX behavior encoder 为 2 层 causal Transformer,使用 relative position encoding;$L_{\mathrm{local}}=10$;全局 token 由 attention pooling 产生。
- 优化:Adam,初始学习率 0.001,linear warmup 后 cosine decay;按 validation AUC early stopping;所有模型统一 batch size、tokenization、特征与预处理。
- 容量控制:所有 Transformer 基线均为 2 blocks,通过调整 projection/FFN hidden dimension 匹配 MFLOPs;容量匹配后以 dropout 为主要调参项。
- 环境:TensorFlow 2.11,在同一套 on-premise NVIDIA H100 集群训练;离线结果为 5 次独立运行均值。
- 基线:生产 LiDLRM、SASRec、TransAct 的 concat/append 两个变体,以及模拟 Meta GRM 的 monolithic generative baseline。
主要实验结果
离线比较与架构消融
| 模型 | AUC | AUPR | gAUC | MFLOPs(offline/online) |
|---|---|---|---|---|
| LiDLRM-prod | 0.846 | 0.257 | 0.636 | $0.8/0.8\times10^2$ |
| LiDLRM-large | 0.852 | 0.264 | 0.641 | $3.9/3.9\times10^2$ |
| SASRec | 0.851 | 0.260 | 0.641 | $3.5/3.5\times10^2$ |
| TransAct-concat | 0.853 | 0.262 | 0.629 | $3.6/3.6\times10^2$ |
| TransAct-append | 0.860 | 0.271 | 0.644 | $4.0/4.0\times10^2$ |
| GRM | 0.858 | 0.269 | 0.645 | $4.1/4.1\times10^2$ |
| TransX | 0.862 | 0.273 | 0.648 | $3.8/0.6\times10^2$ |
| TransX-crossAttn(相对变化) | -13.4% | -10.6% | -7.3% | $3.6/0.4\times10^2$ |
| TransX-encoder(相对变化) | -28.3% | -22.5% | -15.8% | $0.7/0.7\times10^2$ |
| TransX-sparseAttn(相对变化) | +4.5% | +3.6% | +2.1% | $5.1/2.2\times10^2$ |
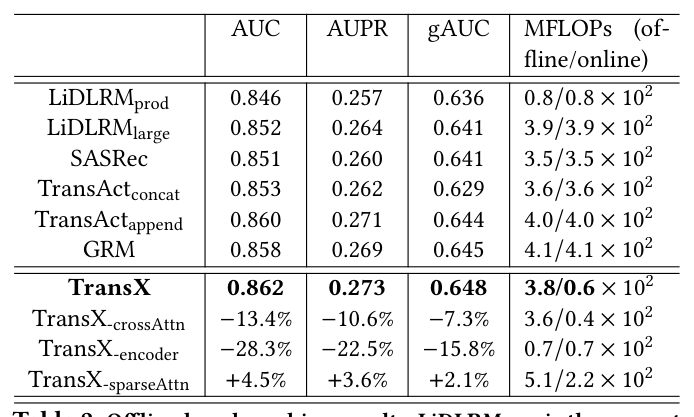
TransX 在约相同离线预算下取得最佳三项指标,而在线仅需 $0.6\times10^2$ MFLOPs,约为 TransAct/GRM 的 15%–17%。去掉 cross-attention 后三项指标显著下降,说明显式 behavior-serving 交互不可由简单拼接替代;直接去掉 encoder 的损失最大,证明原始行为 token 上的即时 target attention 不足以捕获长期依赖;把稀疏 attention 换成 full global attention 虽提升 AUC 4.5%,却将在线 MFLOPs 从 0.6 增至 2.2,显示 local-global 稀疏模式位于更优的质量-成本点。需要注意,消融行报告的是相对变化,不是绝对指标。
Encoder 配置消融
| Position bias | Causal h=1 | Causal h=2 | Causal h=3 | Bidirectional h=1 | Bidirectional h=2 | Bidirectional h=3 |
|---|---|---|---|---|---|---|
| No pos bias | 0.850 | 0.856 | 0.859 | 0.852 | 0.859 | 0.861 |
| Absolute pos bias | 0.851 | 0.858 | 0.860 | 0.853 | 0.861 | 0.863 |
| Relative pos bias | 0.852 | 0.862 | 0.863 | 0.853 | 0.863 | 0.864 |
双向 attention 略高,但 causal + relative bias 在 2 层已达 0.862,且后者是单次 prefix reuse 和增量近线更新成立的必要条件。论文选择的是服务友好的 Pareto 点,而非离线 AUC 的绝对极值。
Sparse cross-attention 消融
| 全局聚合方式 | $L_{\mathrm{local}}=5$ | 10 | 15 | 20 |
|---|---|---|---|---|
| 无 global token | 0.853 | 0.856 | 0.858 | 0.859 |
| Mean/Max pool(取更优) | 0.856 | 0.860 | 0.861 | 0.862 |
| Attention pool | 0.857 | 0.862 | 0.864 | 0.865 |
global token 在所有局部窗口下均有收益,attention pooling 又稳定优于固定 mean/max;扩大局部窗口继续提高 AUC,但边际收益下降且增加 cache I/O 与 attention 成本,因此生产配置取 $L_{\mathrm{local}}=10$。
线上 A/B、部署收益与稳定性
服务优化的 p99 延迟降幅
| 优化 | 300 candidates | 400 candidates | 500 candidates |
|---|---|---|---|
| Amortized sequence encoding + caching | -58% | -64% | -73% |
| 再加 request-level KV caching | -63% | -71% | -83% |
该测试基于平均 80K requests/s 的真实流量。候选越多,共享行为编码与 K/V 的摊销收益越明显;约 500 candidates/request 时 p99 最多下降 83%,支持论文“在线计算约降 80%”的主张。
主实验:50%–50% 流量 A/B
| 指标 | 相对提升 | 显著性 |
|---|---|---|
| Task CTR | +6.0% | $p<10^{-4}$ |
| Task conversion rate | +4.4% | $p<10^{-4}$ |
| Daily active users | +0.26% | $p<10^{-4}$ |
| Home feed views | +0.08% | $p<10^{-2}$ |
CTR 与 conversion 是该 LinkedIn 应用近年来最大的提升,同时 DAU 与 feed views 的平台级指标也显著为正。离线总算力可扩到生产 DLRM 的 5–6 倍,但通过近线摊销后在线成本仍相近,说明收益并非单纯以同比例硬件投入换取。
按活跃度分桶
| 活跃度 | High | Medium | Low | Cold-start |
|---|---|---|---|---|
| Traffic | 32% | 48% | 16% | 4% |
| CTR lift | +6.6% | +5.5% | +1.8% | +0.01(不显著) |
| CVR lift | +4.7% | +4.3% | +3.6% | -0.01(不显著) |
高活跃用户受益更大,符合更丰富历史可被 encoder 利用的预期;无历史用户通过 backup model 保持中性,没有明显回归。
按 180 天历史长度分桶
| 历史长度 | Long | Medium | Short | No history |
|---|---|---|---|---|
| p50 长度 | 163 | 67 | 13 | 0 |
| CTR lift | +6.2% | +6.0% | +5.5% | 0.0 |
| CVR lift | +4.8% | +4.3% | +4.1% | 0.0 |
非空历史的所有桶都显著为正,且历史越长收益越大;短历史也有 +5.5% CTR,说明 local window 并未让模型只对重度用户有效。
长尾候选规模下的绝对 p99 延迟
| Candidate size | 100–300 | 300–500 | 500–1,000 | 1,000+ |
|---|---|---|---|---|
| Traffic | 22% | 26% | 35% | 17% |
| Raw p99 | 201 ms | 255 ms | 289 ms | 330 ms |
| + amortized encoding/cache | 60 ms | 71 ms | 86 ms | 113 ms |
| + KV cache | 43 ms | 49 ms | 58 ms | 74 ms |
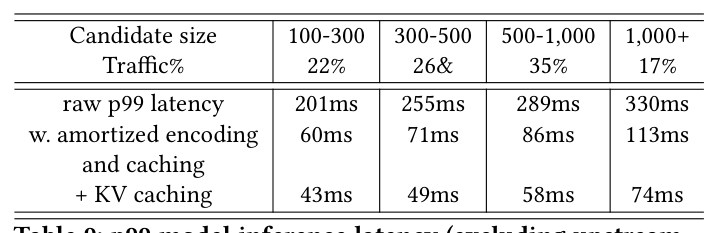
即使候选超过 1,000,模型 p99 也从 330 ms 降至 74 ms;优化后延迟随候选数近线性增长,且不再受完整行为序列长度控制。5 周线上评估中收益稳定,说明结果不是短期流量偶然性。
核心贡献总结
- 问题抽象:将推荐明确拆成用户驱动的 behavior stream、系统驱动的 serving-event stream 与条件生成的 feedback stream,用 seq-to-seq action transduction 代替异质 token 的 monolithic modeling。
- 结构设计:行为 causal encoder、candidate query、共享 K/V 的 grouped multi-query local-global cross-attention 与并行 action decoder 共同表达非对称因果关系。
- 训练摊销:一个用户的整条行为流只编码一次,所有服务事件在一次 forward-backward 中累积监督,避免 per-event prefix 重算。
- 模型-基础设施协同:近线增量编码、版本化磁盘缓存、bf16 表示、请求级 KV cache、冷启动 fallback 与并行解码共同把大部分算力移出在线路径。
- 生产证据:完整离线基线/消融、80K QPS 延迟测试、50/50 A/B、用户分桶和五周稳定性分析形成了少见的端到端工业证据链。
与已归档相关工作的对比
AttnMVP AttnMVP: Beyond Interleaving: Causal Attention Reformulations for Generative Recommender Systems(LinkedIn,2026-03-11)
关系:独立并发(本文未引用 AttnMVP,两者殊途同归)· 已加载对方精读
- 共同关注的问题:二者都认为把语义异质 token 交错进统一序列,会掩盖 item/曝光到 action 的非对称因果关系并引入冗余注意力计算。
- 相近的技术骨架:两者都保持独立信息流,再让 candidate/item 侧 query 从历史侧表示中选择性聚合证据,最后预测 action;都避免候选间的自回归依赖。
- 本文的差异与推进:AttnMVP 面向生成推荐中的 item-action interleaving,用 item-only Q/K 与混合 item+action Value 做逐层 causal pooling;TransX 则把平台级行为流与实时服务 slate 拆成 encoder-decoder,通过 candidate-specific query 和共享行为 K/V 做 crossing,覆盖未与目标曝光对齐的 organic actions。
- 可比的方法 / 实验差异:AttnMVP 的重点是因果归纳偏置与交错噪声;TransX 更进一步给出近线增量编码、磁盘/KV cache、冷启动回退和大流量 A/B,证明这种解耦能在严格 SLA 下落地。
ROCS ROCS: Request-Oriented Compute Sharing for Efficient Large-Scale Recommendation(Meta,2026-07-30)
关系:独立并发(本文未引用 ROCS,两篇仅相隔一天提交)· 已加载对方精读
- 共同关注的问题:二者都把工业排序的关键浪费归因于 request/behavior 侧信息在候选间不变,却被 early fusion 后为每个 candidate 重算。
- 相近的技术骨架:TransX 的行为 encoder 与 K/V 对候选无关、candidate query 只在 cross-attention 处注入;ROCS 的 DCA 同样拆成共享 request-only sequence encoder/KV 与 candidate-conditioned cross-attention,从结构上延迟交互并复用计算。
- 本文的差异与推进:TransX 从多流 action transduction 出发,强调单次 seq-to-seq 训练、近线增量行为缓存和离散 action decoder;ROCS 从算子依赖契约出发,用 GLM 把 candidate 不可反向污染 request 表示推广到 linear、normalization、FM 等整个交互栈,并用 IKBO 在 GPU kernel 内消除广播。
- 可比的方法 / 实验差异:TransX 报告 LinkedIn CTR +6.0%、conversion +4.4% 与最高 83% p99 降幅;ROCS 覆盖 Meta 多种 retrieval/ranking 骨干,报告 47%–196% replay QPS 增益和 29%–38% capacity savings。两者共同支持“非对称数据流 + 延迟 crossing”是一条可复现的工业 scaling 路线。
讨论与局限性
TransX 最值得借鉴的不是某个 attention 变体,而是先识别数据流的因果角色,再让模型图与部署图保持同构。causal encoder 带来 prefix reuse,候选独立 query 带来 K/V sharing,非自回归 action decoder 带来 slate parallelism;这些不是事后系统优化,而是由架构直接导出的服务性质。它也展示了 scaling 不必等价于在线硬件成本按 1:1 增长:只要重计算被迁到用户级近线路径,模型训练和表示容量仍可扩展。
但证据仍有边界。所有准确率与 A/B 数据来自 LinkedIn 单一内部应用,数据、特征和代码不可公开复现;离线只把 click 简化为二分类,并未展示完整 multi-action vocabulary 下的任务冲突、校准误差或 action 相关性。条件独立 decoder 假设同一 slate 中候选动作给定历史后可分解,不能显式建模候选之间的竞争、位置与整页组合效应。local-global 稀疏模式仅用一个 pooled global token,可能压平长期兴趣的多峰结构;full attention 消融的准确率明显更高,说明当前 Pareto 点仍牺牲了一部分质量。缓存方案也引入 freshness、容量、版本迁移和 fallback 运维成本,论文虽给出机制,却没有量化缓存命中率、存储规模、近线更新成本及端到端总拥有成本。
此外,行为 encoder 仍采用 2 层标准 causal Transformer,论文没有展示参数量、序列长度与数据规模的系统 scaling law;“可扩展”主要由计算分解和生产部署证明,而非从多档模型规模中证明。未来可沿论文提出的统一 retrieval-ranking 方向加入 behavior/candidate 的 InfoNCE 目标,也可引入多兴趣 global tokens、slate-aware decoder,或借鉴 ROCS 把候选无关不变量推广到整个非 attention 特征交互栈。