SID-Coord:在短视频搜索排序里协调 Semantic ID 的泛化与 Hashed ID 的记忆¶
快手科技(Kuaishou Technology, Beijing)+ 一位 unaffiliated 作者,arXiv:2604.10471(2026-04-12),SIGIR '26 短文(5 页)。提出 SID-Coord,把离散、可训练的 Semantic ID(SID)直接嵌进以 hashed item ID(HID)为核心的判别式排序模型,用「多分辨率 SID 建模 + target-aware HID–SID 门控 + SID 兴趣对齐」三件套显式协调「记忆 vs 泛化」。不改动主干排序模型即可接入生产系统,快手短视频搜索线上 A/B:搜索长播率 +0.664%(+0.226pp)、播放时长 +0.369%、播放次数 +0.472%,平均搜索延迟变化 +0.005%(不显著)。
研究动机与背景¶
工业级短视频搜索排序系统的主流解法,至今仍然是基于稀疏 ID 的判别式模型:把海量 user–item 交互喂给一个以 hashed item identifier(HID,即把 item ID 哈希进固定大小 embedding table 的做法)为核心特征的排序网络。这条路线的优点是明确的——在严苛的延迟约束下,它对高频交互的记忆既高效又有效。
但论文指出它有两个结构性短板:
- 对内容语义完全不可知。HID 只是一个哈希桶编号,本身不携带任何视频内容信息,模型因此无法利用视频里丰富的多模态信息。
- 长尾泛化差。曝光稀疏的长尾物品,其 HID embedding 只能收到极少的梯度更新,表示学不充分。
一个自然的方向是引入多模态语义 embedding 来丰富物品表示。论文点名了 SimTier、MOON、MUSE、DMF 这一系工作,承认稠密语义特征确实能部分补偿稀疏交互信号,但同时指出这条路的三个问题:任务自适应性有限(预训练 embedding 冻结后不随排序目标调整)、serving 开销不小(稠密向量的存储与查表成本),以及语义特征通常只是「附加输入」,并未与 ID 类排序架构紧密耦合。
Semantic ID(SID)路线正是为解决前两点而来:把语义表示离散化成紧凑编码。论文强调 SID 相对稠密 embedding 在大规模排序里有两个特别可取的性质:
- 保留层次语义结构。结构化量化(如残差量化)天然产生由粗到细的抽象层级,可以直接落进 ID 类架构;
- 可作为可训练标识符被判别式排序目标直接优化,让语义表示适配下游监督。
然而论文认为,现有把 SID 增量式塞进排序模型的做法仍然停在「把 SID 当静态 item 侧特征」:既没有显式利用 SID 的层次结构去建模由粗到细的语义抽象,更缺少按物品热度(head vs long-tail)自适应平衡「语义泛化」与「ID 记忆」的机制。结果是 SID 对排序、尤其是长尾内容的系统性收益,仍然没被挖掘出来。
由此论文提炼出自己的核心主张:
关键挑战不在于「要不要引入语义表示」,而在于如何利用 SID 的多层语义粒度,并在严苛工业约束下把语义泛化与稀疏 ID 记忆系统性地协调起来。
SID-Coord 把「协调(coordination)」沿三个维度落地:
- 粒度协调(granularity coordination):对层次 SID 做自适应融合,应对头尾异质性;
- 信号协调(signal coordination):target-aware 的 HID–SID 门控,平衡记忆与泛化;
- 兴趣协调(interest coordination):候选与历史之间的分布级语义对齐。
相关工作定位¶
论文把相关工作分成两块。
Semantic ID 的构造:TIGER 用 RQ-VAE 对多模态内容 embedding 做层次量化,证明离散编码下语义结构可以被保留;后续工作探索变长 SID 策略自适应调整码深以提升表征容量(引文 [9],即 Breaking the Hourglass Phenomenon of Residual Quantization);OneSearch 把残差量化与 optimized product quantization 结合成 RQ-OPQ,把可学习旋转引入量化过程;VQ-VAE 则用 commitment 目标学离散码本,支持离散隐表示的端到端训练。
SID 与 ID 类排序器的集成:SPM 用 SentencePiece Model 对层次 SID 做组合式编码,在固定码本规模下实现高效表征,并实证了 semantic ID 优于随机哈希 ID;Prefix-based 方法用前缀 n-gram 表示 SID 并扩展到用户行为序列建模,在大规模工业系统上提升了预测精度与稳定性。论文对这两类的批评是一致的:它们把 SID 当成静态特征或松耦合的辅助信号,既不利用层次粒度,也不自适应地协调语义泛化与 ID 记忆。
论文自我定位的一句话很明确:把 SID 集成当作「语义抽象与稀疏 ID 记忆之间的协调问题」,而不是一个特征工程问题。
核心方法 / 模型架构¶
SID-Coord 由三个组件构成:(1) Multi-resolution SID modeling,自适应融合层次 SID 以捕捉由粗到细的语义;(2) Target-aware HID–SID gating,平衡记忆与语义泛化;(3) SID-based interest alignment,建模目标物品与用户行为历史之间的语义一致性。前两者作用在 target side,第三者作用在 user side,三路输出连同其余标准特征(Dense / Sparse / Wide & Context)一起送入排序主干。
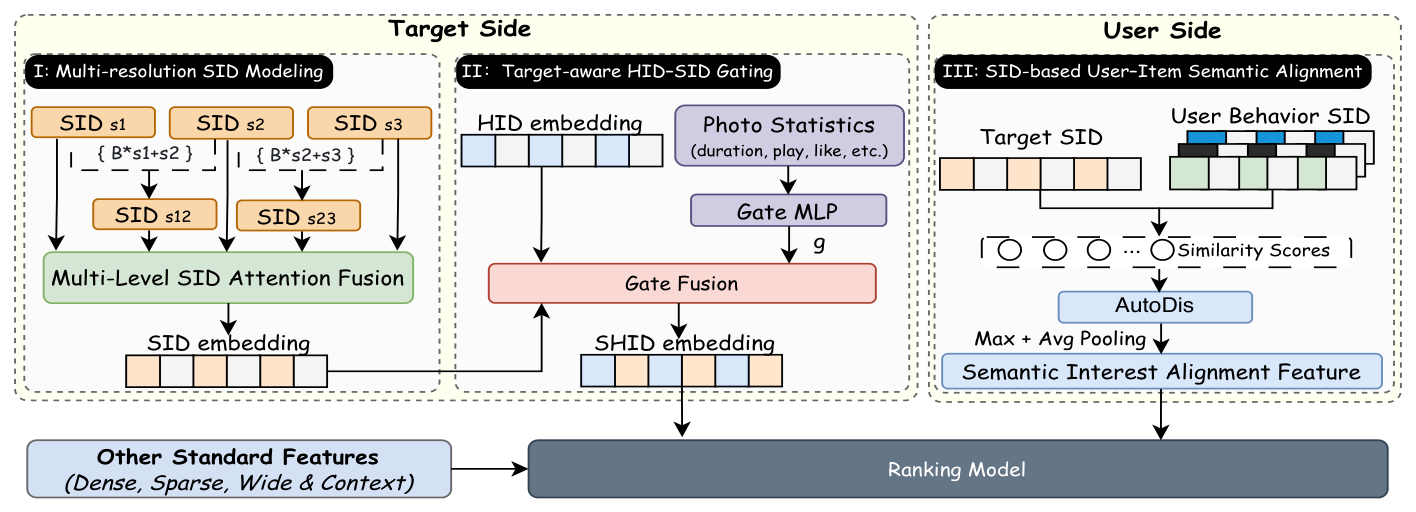
3.1 多分辨率 SID 建模(Multi-resolution SID Modeling)¶
这一模块分两步:层次 SID 复合(显式编码语义精化关系)与基于注意力的分辨率融合(自适应挑选对排序最有效的语义分辨率)。
层次 SID 复合(Hierarchical SID composition)¶
对每个物品 $v$,内容侧量化器按 QARM 的残差量化(RQ)框架产出三个语义特异性递增的 Semantic ID $\{s^{(1)}_v, s^{(2)}_v, s^{(3)}_v\}$,每个 $s^{(i)}_v$ 是取自一个 8192 大小码本的离散整数索引。
为了在保持层次局部性的前提下显式编码「精化关系」,论文在相邻层级之间构造复合 Semantic ID:
$$s^{(1,2)}_v = B \cdot s^{(1)}_v + s^{(2)}_v, \qquad s^{(2,3)}_v = B \cdot s^{(2)}_v + s^{(3)}_v \tag{1}$$
其中 $B$(实现中取 10000)是一个大于码本规模的进制基数,用来保证「有序对 → 单个整数」的映射唯一。论文给了一个具体例子:$s^{(1)}_v = 17$、$s^{(2)}_v = 5301$ 时,$s^{(1,2)}_v = 175301$。
这个 radix-$B$ 构造的设计动机,论文讲得比较细,值得原样保留:
- 与把 SID 当成扁平序列的标准 N-gram 方法不同(后者常受参数量指数爆炸之苦),radix-$B$ 构造显式利用了残差量化层级中固有的树状依赖;
- 好处一:在每个粗粒度父区域内部精化语义空间,从而在不破坏结构局部性的前提下获得更细的判别力;
- 好处二:严格阻止跨尺度的无差别混合。例如非相邻的 $s^{(1,3)}_v$ 会绕过中间的语义精化层,导致过度碎片化、过于稀疏的表示,因此被排除;
- 论文还有意省略了全深度组合 $s^{(1,2,3)}$,理由是它会剧烈膨胀参数空间、加剧数据稀疏,而收益只是边际的。
注:$s^{(1,3)}$ 与 $s^{(1,2,3)}$ 的排除属于设计论证,论文没有给出对应的消融实验数据来支撑「收益只是边际」这一判断。
基于注意力的分辨率融合(Attention-based resolution fusion)¶
复合之后,每个物品由五个 Semantic ID 表示:$\{s^{(1)}, s^{(2)}, s^{(3)}, s^{(1,2)}, s^{(2,3)}\}$,它们通过一张共享 embedding table 映射为稠密向量 $\{e^{(1)}_v, e^{(2)}_v, e^{(3)}_v, e^{(1,2)}_v, e^{(2,3)}_v\}$。
由于不同物品受益于不同的语义分辨率(直觉上:曝光充足的头部物品能撑起细粒度码,长尾物品则更依赖粗粒度码做统计共享),论文引入一个基于注意力的分辨率选择器:在所有分辨率上学一组权重,把最终语义表示计算为加权融合。结构上是一个 Self-Attention + Add & Norm 的轻量块(见 Figure 2),输出即为 SID embedding $e^{sid}_v$。
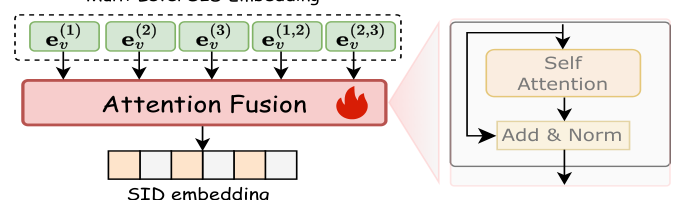
论文没有写出注意力融合的显式公式(只有 Figure 2 的结构图与文字描述「learns weights over all resolutions and computes the final semantic representation as a weighted fusion」),也没有给出注意力头数、隐维度等超参。这是短文篇幅所限,但也构成一个可复现性缺口。
3.2 Target-aware HID–SID 门控¶
HID 与 SID 的性质是互补的:HID 从大规模稀疏共现信号中获得记忆能力,SID 提供语义层面的泛化能力。为在异质的物品热度分布下显式协调二者,论文引入一个 target-aware 的门控机制。
记 $e^{hid}_v$ 为目标物品的 HID embedding,$e^{sid}_v$ 为其 SID 表示(即 §3.1 的融合输出)。论文用目标物品的历史统计特征——曝光数、点击数、点赞数、分享数、评论数等——通过一个轻量门控网络预测门控权重 $g \in [0,1]$;该门控网络实现为两层 MLP + sigmoid 激活。融合表示为:
$$e^{shid}_v = g \cdot e^{hid}_v + (1 - g) \cdot e^{sid}_v \tag{2}$$
设计动机说得很直白:这些统计信号是物品热度的直接代理,让门控网络能显式区分「数据稀疏的长尾物品」与「曝光充足的头部物品」,从而学会自适应地平衡 SID 泛化与 HID 记忆。融合后的 $e^{shid}_v$ 随后作为排序模型中的目标物品表示使用。
论文用 Figure 3 验证门控确实学到了预期的「热度感知协调」:把物品按 7 天曝光量分成十分位(deciles) 建桶,绘制每桶内 item 级 $g$ 的均值与置信区间。结果是 $g$ 随热度单调递增——从最低分位(尾部)约 0.30 一路升到最高分位(头部)约 0.73。即:对头部物品模型更依赖 HID 记忆,对尾部物品更依赖 SID 语义泛化。
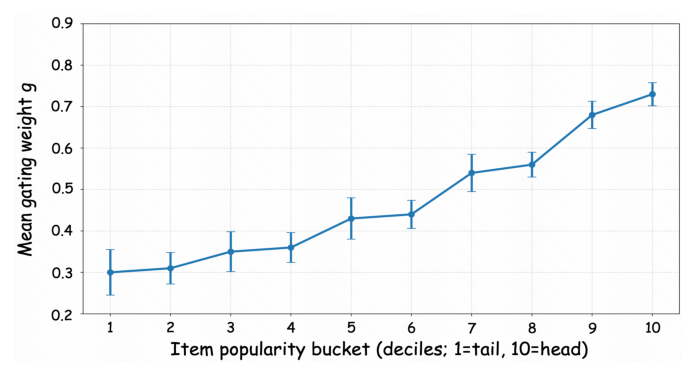
值得注意的是,即便在最头部的分位,$g$ 也只有 ~0.73 而非趋近 1,说明 SID 语义信号在头部物品上依然贡献了约四分之一的表示权重;而在最尾部分位 $g \approx 0.30$,HID 也没有被完全关掉。门控学出来的是一条平滑的连续过渡曲线,而非硬切换。
3.3 用户–物品语义对齐(User–Item Semantic Alignment)¶
除了 target 侧的协调,论文进一步在用户侧做协调:显式刻画候选物品与用户行为序列之间的语义对齐。
论文的论证是:用户行为建模在排序系统里至关重要,但传统做法只依赖特定标识符(如 photo ID 或 author ID),对内在的内容关联在语义上是盲的。因此引入 SID 来增强内容理解,显式强化「历史消费」与「当前候选」之间的语义匹配。
给定用户 $u$ 及其行为历史 $H_u = \{v_1, \ldots, v_T\}$,每个历史物品 $v_t$ 用 §3.1 得到的语义 embedding $e^{sid}_{v_t}$ 表示。对候选物品 $v$,计算其语义 embedding 与全部历史 embedding 的余弦相似度:
$$S = \big[\, \mathrm{sim}(e^{sid}_v, e^{sid}_{v_1}),\ \ldots,\ \mathrm{sim}(e^{sid}_v, e^{sid}_{v_T}) \,\big] \tag{3}$$
其中 $\mathrm{sim}(\cdot)$ 为余弦相似度。
关键设计在于不直接使用原始的 pairwise 相似度:论文用 AutoDis(KDD'21 的数值特征 embedding 学习框架)把相似度分数转换为分布感知(distribution-aware)表示,以捕捉更高阶的语义兴趣模式。随后对这些表示做 max pooling 与 average pooling,分别抽取「最强语义匹配」与「整体一致性」两个视角。最终这些对齐特征与其他标准特征一起被整合进主干排序模型以改进预测。
这一模块与 §3.2 的门控是解耦的:门控作用于 target 侧的物品表示,而对齐特征是一路独立的、target-conditioned 的用户侧特征。二者共享同一套 $e^{sid}$。
实验设置¶
所有实验都在快手短视频搜索排序系统中进行:
| 项目 | 设置 |
|---|---|
| SID 生成 | 遵循 OneRec / QARM 方法论,用 RQ-KMeans 生成基础 SID |
| 码本 | 3 个残差码本,每个 8192(即 3×8192 个码字) |
| 复合基数 $B$ | 10000 |
| 训练数据 | 真实用户交互日志采样,约 4.5B 条样本 |
| 评估集 | 按时间切分(chronologically held-out)的次日数据,约 130M 条样本 |
| 公平性控制 | 所有方法用相同数据切分、相同特征集、相同主干架构、相同优化设置,差异仅来自 SID 如何构造与集成 |
| 指标 | AUC / UAUC,分别在 ALL 与 Long-tail 两个切片上报告 |
| 门控网络 | 两层 MLP + sigmoid |
| 数值特征处理 | AutoDis |
需要指出:论文全程只使用快手内部工业数据,没有任何公开学术数据集实验(Amazon / MovieLens 等一概没有),因此结果无法与文献中的公开榜单交叉验证。论文也没有给出长尾切片的划分阈值(只在 Figure 3 中说明热度桶按 7 天曝光十分位定义)。
Baseline¶
所有 baseline 与 SID-Coord 共享同一排序主干,差异只在 SID 如何组合与并入模型:
- base:生产基线(不含 SID);
- Prefix-Ngram:用前缀式组合表示层次 Semantic ID(对应引文 [19],Zheng et al., RecSys'25);
- Ngram:把前缀组合扩展到相邻 n-gram 组合(对应引文 [14],Singh et al., RecSys'24);
- SPM-SID:在 SID 序列上用固定词表做 subword 切分(同样来自引文 [14]);
- DAS:引入目标物品与用户历史之间的显式 SID 匹配统计(引文 [17],Ye et al., CIKM'25,快手 Dual-Aligned Semantic IDs)。
主要实验结果¶
Table 1: Overall Performance Comparison¶
| Model | ALL AUC | ALL UAUC | Long-tail AUC | Long-tail UAUC |
|---|---|---|---|---|
| base | 0.7683 | 0.6091 | 0.7691 | 0.5951 |
| Prefix-Ngram | 0.7688 | 0.6096 | 0.7698 | 0.5962 |
| Ngram | 0.7695 | 0.6100 | 0.7706 | 0.5961 |
| SPM-SID | 0.7700 | 0.6101 | 0.7711 | 0.5974 |
| DAS | 0.7693 | 0.6111 | 0.7705 | 0.5983 |
| SID-Coord | 0.7708 | 0.6158 | 0.7723 | 0.6045 |
结论分析(why,不只是 what):
- 所有 SID 方法都超过生产基线,证实把语义信号引入 ID 类排序确有效——这一点是四条不同 SID 集成路线的共同结论,不是某一种编码方式的偶然收益。
- SID-Coord 在全部四个指标上都最优。论文报告:整体 AUC 相对基线 +0.33%,长尾 AUC +0.42%,长尾 UAUC 提升被表述为 +0.93%。
- 复核:整体 AUC $(0.7708-0.7683)/0.7683 = +0.33\%$(相对)✓;长尾 AUC $(0.7723-0.7691)/0.7691 = +0.42\%$(相对)✓。
- 但长尾 UAUC:绝对差 $0.6045-0.5951 = 0.0094$,相对提升是 +1.58%,绝对提升是 +0.94pp。论文写的「+0.93% relative to baseline」与两种口径都对不上(最接近绝对 pp 值)。这处表述与前两个数字的口径不一致,属于论文的一处笔误/口径混用,读者引用时需注意。
- 两类 baseline 的分工很清楚:SPM-SID 在 AUC 上是最强 baseline(0.7700 / 0.7711),而 DAS 在 UAUC 上是最强 baseline(0.6111 / 0.5983)。这不是巧合——SPM-SID 属于「更好的 item 侧 SID 编码」,直接改善的是全局排序判别力(AUC);DAS 引入的是「target–history 的 SID 匹配统计」,改善的是用户内的排序(UAUC)。SID-Coord 同时包含了这两类机制(§3.1 对应前者、§3.3 对应后者),所以能同时拿下两条线。
- UAUC 上的领先幅度明显大于 AUC。SID-Coord 的 ALL UAUC 比最强 baseline DAS 高 0.0047,而 ALL AUC 只比 SPM-SID 高 0.0008。这说明本文的增量主要来自用户内的个性化区分度,而非全局分数校准。
- 论文特别强调:在其大规模系统里,即使是小数点后几位的 AUC 提升也具有实际意义,并会转化为可测量的线上收益(由 §4.3 的 A/B 佐证)。
- 论文的总结句是:端到端的 SID-Coord 框架显著提升长尾表现而不牺牲头部物品精度。从数据看,长尾 AUC 增幅(+0.42%)确实大于整体(+0.33%),支持这一说法。
消融与分析¶
Table 2: Ablation study of different components¶
| Model | ALL AUC | ALL UAUC | Long-tail AUC | Long-tail UAUC |
|---|---|---|---|---|
| FULL | 0.7708 | 0.6158 | 0.7723 | 0.6045 |
| FULL w/o I(多分辨率 SID 建模) | 0.7691 (-0.22%) | 0.6117 | 0.7703 (-0.26%) | 0.6005 |
| FULL w/o II(HID–SID 门控) | 0.7698 (-0.13%) | 0.6121 | 0.7712 (-0.14%) | 0.6010 |
| FULL w/o III(SID 兴趣对齐) | 0.7696 (-0.16%) | 0.6120 | 0.7708 (-0.19%) | 0.6016 |
(括号内百分比为相对 FULL 的相对下降,已复核:$(0.7691-0.7708)/0.7708 = -0.22\%$ ✓)
逐项分析:
- Effect of Multi-resolution SID Modeling(w/o I):三个组件中掉点最多(AUC 整体 -0.22%、长尾 -0.26%)。论文解释:自适应语义粒度对稀疏长尾物品至关重要——它让模型在信号不足时做粗粒度的统计共享,在信号充分时又保留细粒度判别力。这与 §3.1 的设计动机自洽。值得注意的是,去掉模块 I 后 ALL AUC 降到 0.7691,已经低于 SPM-SID baseline 的 0.7700,说明模块 I 正是 SID-Coord 在 AUC 维度胜过强 baseline 的主要来源。
- Effect of Target-aware HID–SID Gating(w/o II):一致回退(AUC 整体 -0.13%、长尾 -0.14%),且长尾 UAUC 掉得更明显(0.6045 → 0.6010)。论文的解读是:简单地把 HID 与 SID 信号拼在一起是不够的,在异质交互密度下必须有热度感知的门控来平衡记忆与泛化。
- Effect of SID-based Interest Alignment(w/o III):同样掉点(AUC 整体 -0.16%、长尾 -0.19%)。论文强调这个下降在整体与长尾切片上都是一致的,说明「建模目标物品与用户历史之间的分布级语义相似度」提供了超出 item 侧语义之外的互补的 user–item 匹配信号。
一个值得注意的观察(论文未展开):三个组件在 UAUC 上的掉点幅度非常接近(ALL UAUC 分别掉到 0.6117 / 0.6121 / 0.6120,长尾 UAUC 0.6005 / 0.6010 / 0.6016),但在 AUC 上差异更大。也就是说,三个模块对「用户内排序」的贡献相当且大体可加,而对「全局判别力」的贡献则以模块 I 为主。另外,消融只做了 leave-one-out,没有做累加式(+I、+I+II、+I+II+III)消融,也没有任何超参敏感性分析($B$ 的取值、码本层数、AutoDis 桶数、注意力融合的容量等一概没有扫描)。
线上 A/B 测试与部署开销¶
论文在生产系统做了线上 A/B,实验设计在短文里算相当规范:
- 先跑 7 天 A/A 测试验证流量随机化与指标稳定性;
- 再跑 7 天 A/B 实验,10% 总流量在对照与实验组之间均分;
- 显著性用差分-in-差分(DiD)估计量在日聚合指标上评估,用以控制两组之间的共同时间波动;
- 所有关键指标报告 95% 置信区间。
Table 3: Online A/B Testing Results¶
| Model | watch time | play count | long-play rate |
|---|---|---|---|
| base | - | - | - |
| SID-Coord | +0.369% | +0.472% | +0.664% (+0.226 pp) |
带置信区间的完整结果:
| 指标 | 相对提升 | 95% CI |
|---|---|---|
| 搜索 watch time(播放时长) | +0.369% | [0.05%, 0.69%] |
| play count(播放次数) | +0.472% | [0.17%, 0.77%] |
| long-play rate(长播率) | +0.664%(+0.226 pp) | [0.49%, 0.84%] |
| 平均搜索延迟 | +0.005% | [-0.08%, 0.09%] |
分析:
- 三个业务指标的置信区间下界均为正,统计显著,且论文称在整个实验窗口内保持稳定。
- long-play rate 的提升(+0.664%)明显大于 watch time(+0.369%)。这与方法的定位是自洽的:长播率反映的是「推上来的视频是否真的对上了用户口味」,正是语义泛化最该改善的维度;而 watch time 还受视频时长分布等因素稀释。
- 延迟几乎零开销:平均搜索延迟变化 +0.005%,置信区间跨零,无统计显著的延迟增加。这是本方法「轻量」主张的关键实证——SID-Coord 只在 target 侧多了几张 embedding 查表 + 一个两层 MLP + 一个小注意力块,在 user 侧多了 $T$ 次余弦相似度与 AutoDis 变换,相对完整排序主干的成本可忽略。
- 不需要改动主干模型:论文反复强调 SID-Coord 可以在不修改 backbone 的前提下集成进现有生产排序系统,这对工业落地的迁移成本是决定性的。
核心贡献总结¶
- 问题重构:把「SID 如何进排序模型」从特征工程问题重新表述为语义抽象与稀疏 ID 记忆之间的协调问题,并沿粒度 / 信号 / 兴趣三个维度给出可操作的分解。
- radix-$B$ 相邻层级复合 SID:用 $s^{(i,i+1)} = B\cdot s^{(i)} + s^{(i+1)}$ 显式编码残差量化的树状精化关系,规避扁平 N-gram 的参数爆炸,同时禁止跨尺度(非相邻)混合与全深度组合。
- 热度感知的 HID–SID 门控:用目标物品的曝光/点击/点赞/分享/评论统计作为热度代理驱动一个标量门 $g$,凸组合 HID 与 SID 表示,并用 Figure 3 实证了 $g$ 随热度从 ~0.30 单调升到 ~0.73。
- 分布感知的 SID 兴趣对齐:不用原始 pairwise 相似度,而是把 target–history 余弦相似度序列经 AutoDis 转成分布感知表示,再做 max + avg 池化。
- 可部署性验证:4.5B 训练样本 + 130M 时间外推评估集 + A/A 前置校验 + DiD + 95% CI + 延迟测量的完整工业验证链路。
与已归档相关工作的对比¶
本文投稿于 2026-04-12。归档库中与之「问题 + 解法双同构」的论文绝大多数发表时间晚于本文,因此本文不可能引用它们——这不构成「作者遗漏引用」,只是时序使然;下文对每篇明确标注双方日期与先后。经检索本文 content.txt,以下三篇的 arXiv ID 与 model name 均未在本文正文/参考文献中出现。
Semantic IDs for Recommender Systems at Snapchat: Use Cases, Technical Challenges, and Design Choices Semantic IDs at Snapchat(Snap Inc., 2026-04-05,早于本文 7 天)¶
关系:独立并发(本文未引用,且对方早本文 7 天,属真正的同期工作)· 已加载对方精读
- 共同关注的问题:两篇都直面「原子/哈希 ID 在长尾 entity 上因稀疏监督而欠训练」这一 root cause,并且都把 SID 作为工业排序系统里的解药、都在真实生产环境做了线上验证。Snap 的动机三件套(参数爆炸、冷启动、长尾泛化)与本文的「memorization–generalization trade-off」指向同一处结构性瓶颈。
- 相近的技术骨架:都基于残差量化产生层次 SID,都把 SID 接进已有排序模型而非替换主干,都强调 serving 可行性。
- 本文的差异与推进:Snap 明确把 SID 用作「辅助分类特征(auxiliary categorical feature)」直接融入标准排序架构——这正是本文在 Introduction 里点名批评的范式(「treat them as static item-side features」)。Snap 的技术贡献集中在 tokenizer 侧(STE 优化缓解 codebook collapse、多模态 embedding 融合提升 uniqueness)与 SID-to-item resolution(启发式 intra-bucket 消歧、depth-over-breadth);本文则把 tokenizer 视为给定(沿用 QARM/RQ-KMeans),全部火力放在集成侧——层次复合、注意力分辨率融合、热度门控。两者恰好是同一问题的上下游互补切分。
- 可比的方法 / 实验差异:Snap 报告广告排序 AUC 提升 +0.028%~+0.035%、动态商品广告 Add-to-cart +0.67%(跨 head 平均 +0.24%);本文报告搜索排序整体 AUC +0.33%、长尾 AUC +0.42%。数量级上本文更高,但两者场景(广告 vs 短视频搜索)与基线不同,不能直接比较。一个有意思的交叉验证:Snap 发现 SID 在冷启动压力最大的 DPA 场景收益最大(+0.67% vs 广告的 +0.03%),与本文「长尾切片收益大于整体」的结论方向一致——都在说 SID 的边际价值随 ID 信号稀疏度上升。另外 Snap 用 Table 5 证明 uniqueness 超过约 70% 后 GR 性能就饱和,这对本文「有意省略 $s^{(1,2,3)}$ 全深度组合以避免过度碎片化」的设计选择是一个独立的旁证。
AKT-Rec AKT-Rec: From Head to Tail: Asymmetric Knowledge Transfer in Long-tail Recommendation with Generative Semantic IDs(Alibaba/天猫 + 北大, 2026-05-22,晚于本文 40 天)¶
关系:独立并发但时序在后(本文 2026-04-12 早于 AKT-Rec 2026-05-22,本文不可能引用它;两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇给出的 root cause 几乎逐字重合——头部物品交互充足所以表示学得准,尾部物品信号稀疏所以表示学不好;而且都额外强调「补尾部不能伤头部」。AKT-Rec 把这一点提炼为「非对称性」并作为核心主张;本文则表述为「显著提升长尾表现而不牺牲头部物品精度」。两者的场景(天猫电商 CTR vs 快手短视频搜索排序)不同,但结构性瓶颈同一。
- 相近的技术骨架:两者都把物品表示拆成「语义共享分量」+「ID 个性化分量」,并按热度/活跃度自适应地调整二者的权重。本文是 $e^{shid}_v = g\cdot e^{hid}_v + (1-g)\cdot e^{sid}_v$,$g$ 由目标物品统计特征经两层 MLP 产出;AKT-Rec 是 cluster embedding $\mathbf{c}_i$ + individual embedding $\mathbf{d}_i$,用「活跃度感知的自适应嵌入机制(CGAE)」动态调整两者平衡。这是一个相当罕见的骨架级重合——两支团队在一个多月内独立收敛到同一种「双分量 + 热度门控」的解法。
- 本文的差异与推进:(a) SID 的用法相反。AKT-Rec 刻意配置高碰撞率(3 个码本、大小仅 128/256),把碰撞当成「形成语义簇」的特性;本文用 3×8192 的大码本并额外构造相邻层级复合 ID 来提升判别粒度,方向是降碰撞、增分辨率。(b) 迁移机制不同。AKT-Rec 用活跃度感知的非对称 InfoNCE(stop-gradient 保证梯度只从头流向尾)显式做知识迁移;本文没有任何显式的头→尾迁移损失,纯靠门控在表示层做凸组合,让尾部物品自动更多地落在共享语义空间里。本文的方案更轻(无额外损失项、无对比学习采样),AKT-Rec 的方案对「污染方向」的控制更严格。(c) 粒度维度。本文额外有一条 AKT-Rec 没有的轴——多分辨率 SID 的注意力融合;而 AKT-Rec 有本文没有的用户侧语义 ID(用户也被 RQ-VAE 量化成簇)。
- 可比的方法 / 实验差异:AKT-Rec 报告天猫离线 +0.35% AUC / +1.53% GAUC、线上 +2.76% CTR / +3.47% GMV;本文报告 +0.33% AUC(整体)、线上长播率 +0.664%。离线 AUC 增幅几乎相同(+0.35% vs +0.33%),线上增幅 AKT-Rec 高一个数量级——但电商 CTR/GMV 与短视频长播率的口径与弹性完全不同,此处不可作为方法优劣的证据。两篇的消融也呼应:AKT-Rec 的消融显示「非对称约束」是关键,本文的消融显示模块 I(多分辨率)掉点最多、门控次之。
SIREN SIREN: 多粒度语义交互,把多模态信号「早融合」进终身兴趣建模(Tencent + 厦门大学, 2026-05-25,晚于本文 43 天)¶
关系:独立并发但时序在后(本文早 43 天,本文不可能引用它)· 已加载对方精读
- 共同关注的问题:两者都认为「把多模态语义当作松耦合的辅助旁支塞进 ID 主导的排序模型」是当前范式的结构性缺陷。本文说「semantic features are typically introduced as auxiliary inputs rather than being tightly integrated into ID-based ranking architectures」;SIREN 说分离建模 + 晚融合让多模态「只充当注意力调制或序列级增强,而非直接参与表征学习」。措辞不同,指的是同一件事。两者都主张把离散语义标识符与协同 ID 特征放进同一个建模框架里做细粒度交互。
- 相近的技术骨架:三处几乎一一对应。(a) 层次 SID 的组合编码:本文用 radix-$B$ 相邻复合 $s^{(1,2)}, s^{(2,3)}$ + 注意力融合;SIREN 用 prefix encoding 构造前缀 token 集合 $\{c^{(1)}, (c^{(1)},c^{(2)}), \ldots\}$ 经共享查找表映射后拼接。两者都在做「把层次码变成可查表的组合标识符」,只是本文选相邻二元组 + 注意力加权,SIREN 选累积前缀 + 拼接。(b) target–history 语义相似度作为显式特征:本文计算候选与历史的余弦相似度序列 $S$ 后过 AutoDis 做分布感知变换;SIREN 计算同样的余弦相似度 $s_{i,t}$ 后做桶化并映射到可学习 embedding。两者本质上都是「把连续相似度离散/分布化后作为可学习特征」——AutoDis 正是「可微软分桶」的代表方法,SIREN 用的是硬分桶。(c) 两者都把语义信号与 ID 协同特征在同一注意力/融合结构内交互,而非事后拼接。
- 本文的差异与推进:(a) 本文有 SIREN 完全没有的热度感知门控——SIREN 的早融合是无条件的,不按物品热度调节语义 vs 协同的配比;这恰恰是本文的核心主张。(b) SIREN 的战场在终身超长行为序列的 GSU–ESU 两阶段范式,还额外研究了「SemID 硬检索 vs 相似度软检索」的 GSU 权衡(硬检索可省 90%+ serving 成本);本文的用户侧处理要简单得多(对全部 $T$ 条历史算相似度后 max/avg 池化),没有涉及超长序列检索问题。(c) SIREN 用 Figure 2 给出了一个本文没有的关键洞察:同一相似度桶内不同 SemID 组的 CTR 差异显著,说明多模态邻近度只是粗粒度视角、不保留支配用户反馈的协同结构——这实际上是对本文 §3.3「仅用余弦相似度 + AutoDis」的一个潜在批评,暗示本文的对齐特征可能同样存在「高相似 ≠ 同质响应」的桶内异质性问题。
- 可比的方法 / 实验差异:SIREN 已于 2025 年 7 月起在微信广告全量上线,报告 +1.61%~+3.87% GMV;本文报告搜索长播率 +0.664%。两者场景(微信广告 vs 快手短视频搜索)与指标口径不同,不可直接比较。方法覆盖面上 SIREN 更完整(含 GSU 检索策略、条件熵分析、表征分析),本文作为 5 页短文则更聚焦。
被剔除的近似候选及理由(均检索到但未通过深度终判):
- DSIRM DSIRM(Alibaba/Tmall, 2026-06-03,晚于本文 52 天):同样是「把 SID 从生成式检索目标改造成排序侧的离散特征」,场景也同为搜索。但其核心是用 query 桥接的对比式 RQ-VAE 学「相关性感知」的 item SID + 用微调 Qwen 生成 query SID,再用层次前缀匹配分数增广排序 DNN——解决的是 query–item 相关性匹配,而非 HID 记忆与 SID 泛化的协调;本文完全没有 query 侧的 SID 生成。问题的 root cause 不同(相关性 vs 长尾稀疏),剔除。
- FLUID FLUID(TikTok, 2026-05-20,晚于本文 38 天):同样把层次语义码用 prefix n-gram late-fuse 进生产排序器,同样是短视频/直播工业场景。但 FLUID 的目标是彻底退役候选侧的 item ID(三阶段 warmup 逐步 phase-out item ID),与本文「保留 HID 记忆并与 SID 协调」是方向相反的设计选择;且其问题起点是直播间的 ephemeral ID(房间生命周期短、ID 不稳定),而非曝光稀疏导致的长尾欠训练。剔除。
- DIG DIG(Meituan, 2026-05-14,晚于本文 32 天):把 RQ tokenizer 直接嵌进 DIN+DCNv2+MoE 判别式排序器,让排序 BCE loss 直接驱动 SID 码本构造——「SID 作为可训练标识符被判别式目标优化」这一句与本文 Introduction 高度重合。但 DIG 的落点是用同一模型同时服务排序与 beam-search 检索(统一 ranking 与 retrieval),且训练的是码本本身;本文把 SID 视为给定(RQ-KMeans 产出后固定),只训练其 embedding,也不涉及检索。解法骨架实质偏离,剔除。
- IDProxy IDProxy(Xiaohongshu, 2026-03-02,早于本文 41 天):问题同构度高——用多模态 LLM 为冷启/长尾物品生成 proxy ID embedding,无缝接入现有 CTR 排序模型,同样不改主干。但其解法是稠密 proxy embedding,恰恰属于本文在 Introduction 里点名的「dense semantic features as auxiliary inputs」那一族(SimTier/MOON/MUSE/DMF 的同路),没有离散标识符、没有层次粒度、没有热度门控。解法路径实质偏离,剔除(但作为「本文所反对范式」的早期代表,值得作为对照记住)。
- PrefixMem PrefixMem(Pinterest, 2026-05-29)/ RQ-FSQ RQ-FSQ(LinkedIn, 2026-05-31):两者都用 prefix n-gram 编码 SID,与本文 §3.1 表面相近。但 PrefixMem 解决的是 LLM 生成 SID token 时的编码器缺失问题(提升最深层 SID 预测准确率),RQ-FSQ 解决的是跨域「用户」SID 的量化与存储压缩。两者都不处理 item 侧的记忆–泛化协调,剔除。
- QuaSID QuaSID(UESTC, 2026-02-28,早于本文)/ AdaSID AdaSID(UESTC, 2026-04-26,晚于本文 14 天):均属 SID 构造质量(碰撞是否有害、如何自适应处理碰撞)的研究,服务生成式检索场景,不涉及判别式排序器内的 HID/SID 协调。剔除。
- SIF SIF(Meituan, 2026-04-17,晚于本文 5 天):同为工业排序 + 量化,但量化对象是整条历史训练样本(sample-level tokenization),解决的是序列 token 粒度问题,与 item 语义/长尾无关。剔除。
讨论与局限性¶
核心贡献与值得借鉴的设计:
本文最有价值的地方不是任何单个模块,而是把「SID 集成」这件事显式地问题化为一个协调问题,并给出了可验证的证据。Figure 3 那条随热度单调上升的门控曲线(0.30 → 0.73)是全文最有说服力的一张图:它把「模型应该对头部靠记忆、对尾部靠泛化」这个人人都会说的直觉,变成了一个可观测、可验证的模型内部量。这种「设计一个可解释的标量,然后画出它随业务变量的变化来证明机制生效」的做法,比单纯堆指标更值得借鉴。
其次是 radix-$B$ 相邻层级复合 ID。它以一行极简的算术($B\cdot s^{(i)} + s^{(i+1)}$)实现了「在父区域内精化子空间」,同时通过只取相邻层级、拒绝跨尺度与全深度组合,把参数量控制在 $2\times$ 而非 $8192^3$ 量级。这是一个工程上非常干净、可以直接复用的技巧。
第三是部署摩擦极低:不改主干、延迟零增长(+0.005%,CI 跨零)。对已有庞大排序系统的团队来说,这决定了方法能不能真的上线。
局限与争议:
- 完全没有公开数据集实验。全部结果来自快手内部数据,无法与文献交叉验证,也无法被外部复现。对于一篇主张「方法论层面的协调框架」的论文,这是明显短板。
- 收益幅度小且高度依赖规模。整体 AUC +0.33%、线上长播率 +0.664%,其中 watch time 的 95% CI 下界仅 0.05%——非常贴近零。论文自己也承认要靠「大规模系统里小数点后几位也有意义」来辩护。换到中小规模系统,这个收益能否复现存疑。
- 数字口径不一致。长尾 UAUC 的 "+0.93%" 与相对(+1.58%)和绝对(+0.94pp)两种口径都对不上,与同段落 AUC 用相对口径的写法冲突。
- 关键设计缺少实证支撑。「排除非相邻 $s^{(1,3)}$」「省略全深度 $s^{(1,2,3)}$ 只有边际收益」这两个论断都只有论证没有数据;$B=10000$、码本 3×8192 等超参也没有敏感性分析。
- 注意力融合模块的公式与超参缺失,只有结构图与文字描述,可复现性不足。
- 消融只做 leave-one-out,没有累加式消融,无法判断组件之间是互补还是冗余;三个模块在 UAUC 上掉点几乎相同这一现象也未被解释。
- 方法论可扩展性存在瓶颈(评分的主要减分项)。SID 由外部 tokenizer(RQ-KMeans,3×8192)离线一次性产出后即固化,本文只训练其 embedding。这意味着:(a) 语义空间的上限被 tokenizer 锁死,排序目标无法反向塑造码本——这恰恰是同期 DIG 那条路线要解决的问题;(b) 参数量 scaling 时,能扩的只有 embedding table 与融合模块的宽度,「如何表征物品语义」这条路径无法同步生长;(c) 用户侧的 $T$ 条历史相似度是 $O(T)$ 的朴素全扫描,没有为超长序列做任何设计(对比 SIREN 的 GSU 硬检索)。这是典型的「离线压缩 + 在线建模」两阶段解耦形态,工程优势明显但长期上限存疑。
- 门控输入的隐忧:$g$ 由曝光/点击/点赞等后验统计特征驱动。这些统计本身受当前推荐系统的曝光策略影响,存在反馈回路——新上线的优质长尾视频统计量天然偏低,会被门控推向 SID 侧(这符合预期),但同时也意味着门控在放大系统既有的头尾划分,本文没有讨论这一潜在的马太效应。
工业落地价值:本文的部署细节相当具体且可直接照搬:SID 生成沿用 OneRec/QARM 的 RQ-KMeans(3 个 8192 码本);门控网络就是两层 MLP + sigmoid;数值特征用 AutoDis;训练 4.5B 样本、次日 130M 样本做时间外推评估;线上先 7 天 A/A 校验流量随机化,再 7 天 10% 流量 A/B,用 DiD 控制共同时间波动并报 95% CI;最后单独测了延迟。对任何已经有 SID tokenizer、想把语义接进现有 ID 排序器的团队,这是一条摩擦最小、验证最完整的落地路径。