One Hierarchy, Two Systems:一套 SID 层次同时服务发现面排序与搜索页查询改写
DoorDash Inc.(San Francisco, CA),arXiv:2608.20640v1(2026-08-21),USRW '26(First Workshop on Unified Search and Recommendation,2026-10-02,Minneapolis)workshop 论文,正文 6 页 + 附录,共 8 页。Steven Xu、Sanjyot Thete、Saathvik Dirisala、Raghav Saboo 四人并列一作,另有 Nimesh Sinha、Leo Shao、Elyse Winer、Sudeep Das、Martin Wang、Kyle MacDonald,全员 DoorDash 署名。
一句话:把从商品内容里一次性学出来的三层 Semantic ID(SID)层次,当成"介于精确 listing ID 与专家分类法之间"的共享概念单元,分别喂给两个互不共享参数、互不共享训练目标、互不共享 serving 架构的生产系统——个性化商品排序与搜索页查询改写——并用受控消融 + 线上 A/B 证明这套共享层次在两边都有效。
研究动机与背景
多商家电商目录的表示困境
DoorDash 这类电商 marketplace 把生鲜(grocery)、便利店(convenience)、通用零售(general retail)多个商家的目录放进同一个发现体验里。这带来一个结构性问题:等价或高度相关的商品会在不同商家下以不同的 listing ID 反复出现。因此,用来组织商品的表示,实际上同时决定了两件事:
- 行为证据能在多细的粒度上被聚合;
- 这份证据能在哪些商品之间被共享。
论文把这一点分别在两个应用上展开。
个性化排序侧。 merchant-scoped 的 listing ID 精确保留了"身份",但一个消费者在商家 A 购买某商品,并不会增强商家 B 上等价商品的偏好信号。于是会出现一种很典型的失效模式:一个消费者跨多个商家反复购买同一个"商品概念",却在任何单个 listing 上都没有积累出足以学到可靠偏好的证据量。反过来,人工定义的 taxonomy 确实能跨更大的商品组共享证据,但它的设计目标是可解释性与目录组织,对细粒度个性化而言往往太粗。
查询改写侧。 传统做法是从搜索 session 里直接挖 query 字符串之间的转移(query-to-query transition)。字符串层面的转移会因为拼写错误、缩写、同义表达而把行为证据碎片化;同时它容易被宽泛的高频 query 主导,并且当同一个 query 串在不同业务垂类(business vertical, BV)下含义不同时会把不同意图混为一谈。论文的观察是:通过下游行为与某个 query 关联起来的商品,天然是给这个 query 的语义"接地(grounding)"的信号——这样转移就可以建模在"商品概念"之间而不是原始字符串之间。但这要求一种表示:细到能保留有用的区分度,又层次化到能同时支持横向 pivot(milk → cereal)与纵向细化(milk → whole milk)。
把两侧的痛点合起来,root cause 是同一个:缺少一个粒度介于"精确标识符"与"粗粒度专家分类法"之间、可跨实体汇聚行为证据、且自带多级粒度的商品表示单元。
为什么是 Semantic ID
Semantic ID 由 TIGER [8] 在生成式检索中引入:对商品内容 embedding 做残差量化,把商品编码成一串短的离散码。论文强调 SID 一个被反复观察到的性质:学出来的 SID 往往呈现层次结构——共享前缀的商品倾向于语义相关,共享的前缀越长,对应的商品组越细。 这恰好提供了"多个级别上分组相关商品、同时保留细粒度区分"的能力。
本文的主张因此是:把学到的 SID 层次当作跨个性化排序与查询改写的共享商品表示。层次只从目录内容里构造一次,每个应用各自围绕这些概念组织自己的交互数据。 两个系统按各自目标使用不同的层级深度,不共享模型参数、不共享训练目标、不共享 serving 架构。
三条贡献:(1) 一份生产规模的研究,考察"学出来的 SID 层次"作为可复用商品表示跨推荐与搜索;(2) 在两个独立开发的应用上给出任务特定的用法——排序侧把消费者交互在多级 SID 前缀上聚合,改写侧用 SID 层次把 query 转移接地到商品概念并支持层次化细化;(3) 实证证明在两个应用上 SID 都比专家 taxonomy 更有效。
相关工作定位
Semantic ID。 TIGER [8] 之后的大量工作仍在生成式推荐、搜索及二者的统一模型里研究 SID [5, 7]。在工业排序方向,Singh et al. [9](RecSys'24, Better Generalization with Semantic IDs)用 SentencePiece 学 SID 的 subpiece,并用其 embedding 表示 item 与用户历史,发现优于人工定义的 n-gram;Zheng et al. [11](arXiv:2504.02137)发展了 prefix n-gram 参数化,把 SID 稀疏特征与序列特征部署到广告排序。本文同样用 SentencePiece 切分的 SID 来表示商品与消费者历史,但差异在于:以往排序工作主要把 SID 衍生 token 用于参数化学习表示,本文额外把 SID 前缀当作跨两个应用的共享概念单元——排序在这些概念上聚合消费者交互,查询改写在同一套层次上聚合 query 接地与转移证据。
查询建议与改写。 Query-Flow Graph [1] 用 session 转移建图并跑随机游走;context-aware 方法 [3] 引入点击证据缓解稀疏与歧义;工业电商系统 [10] 把高频 query 的行为证据迁移到语义相关的长尾 query。本文保留了转移图的可解释性与批式 serving 优势,但把 query 接地到商品概念、在 SID 层次的概念之间建模转移,从而能跨词面变体汇聚证据、同时支持横向改写与向下细化,并按商家在售品类过滤候选。
共享的学习型商品层次
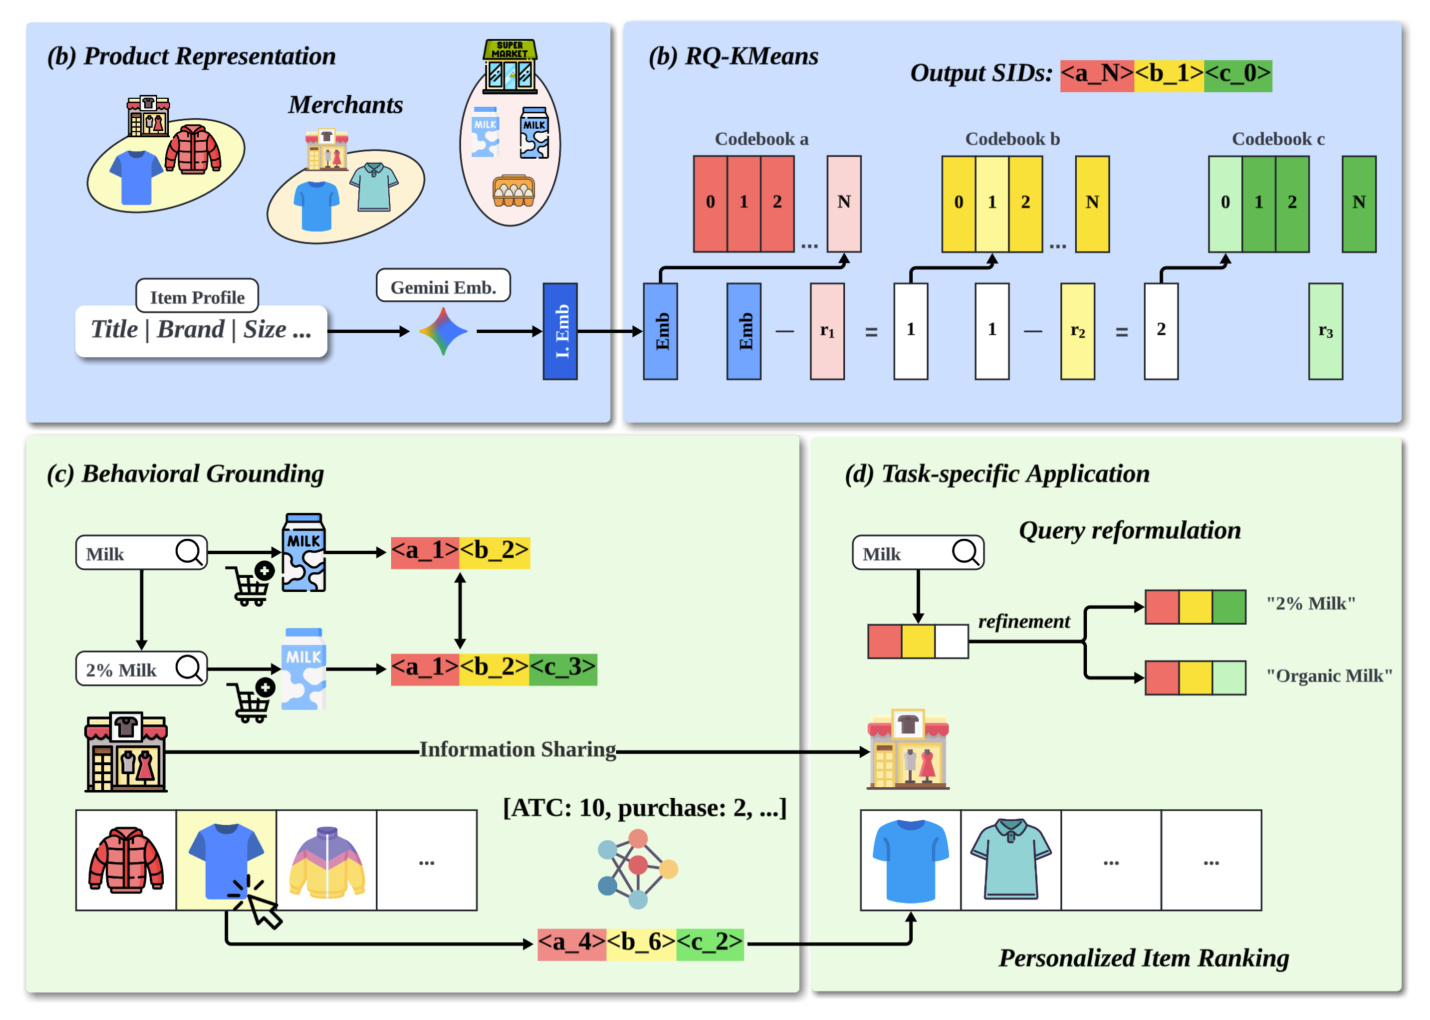
SID 构造
对商品 $i$,把选定的目录字段(商品名、品牌、规格等)拼成文本 profile $t_i$,用预训练文本编码器编码。实际使用 gemini-embedding-001 [4],产出 3,072 维 embedding $\mathbf{x}_i$。
用 residual-quantization $K$-means(RQ-$K$-means) 构造 SID,$L = 3$ 级、每级 $K = 512$ 个 centroid。每级都在 $L_2$ 归一化后的输入上操作。令 $\mathbf{r}_{i,0} = \mathbf{x}_i$,第 $\ell \in \{0,\dots,L-1\}$ 级把当前残差分配给码本 $\mathcal{C}_\ell$ 中最近的 centroid,并减去被选中的 centroid:
$$c_{i,\ell} = \arg\min_{k \in \{0,\dots,K-1\}} \left\| \mathbf{r}_{i,\ell} - \boldsymbol{\mu}_{\ell,k} \right\|_2^2 \tag{1}$$
$$\mathbf{r}_{i,\ell+1} = \mathbf{r}_{i,\ell} - \boldsymbol{\mu}_{\ell, c_{i,\ell}} \tag{2}$$
最终 SID 为 $\mathbf{s}_i = [c_{i,0}, c_{i,1}, c_{i,2}]$。记 $\mathbf{s}^{(\ell)}_i = [c_{i,0},\dots,c_{i,\ell-1}]$ 为深度 $\ell$ 的前缀,深度 1/2/3 分别称为 L1 / L2 / L3。
值得注意的是这里用的是 RQ-KMeans 而非 RQ-VAE:没有编码器/解码器、没有重建损失与 commitment 损失,纯粹是逐级 k-means。这是工业实践里对"码本坍塌 + 在线重训稳定性"的一种常见取舍(本文没有展开论证这一选择,只是直接采用)。
学到的层次
前缀 $n$-gram 构成商品目录的嵌套划分(nested partitions)。论文观察到:在学出来的码空间里,共享更长前缀的商品倾向于更语义相似,即层次刻画了逐级更具体的商品概念。这些概念提供了一个介于精确 listing ID 与专家 taxonomy 节点之间的中间粒度。同一套层次在两个应用里复用:排序在多个深度的前缀上聚合消费者交互,查询改写在由此得到的商品概念上做接地与转移建模。
层次的内在特性
论文用三个指标考察前缀长度增加时商品组的变化(Table 1):
| Prefix level | Gini | DBI | Held-out cosine |
|---|---|---|---|
| L1 (coarse) | 0.472 | 3.934 | 0.957 |
| L2 (intermediate) | 0.508 | 2.065 | 0.965 |
| L3 (fine) | 0.467 | 0.976 | 0.981 |
- Gini:前缀使用的不均衡度,越低表示商品在各组上分布越均匀;
- DBI(Davies–Bouldin index):组内离散度与组间分离度之比,越低表示组越紧致、分离越好;
- Held-out cosine:一个未见过的商品与训练集中被分到同一前缀组的商品之间的平均余弦相似度,越高表示语义一致性越强。
结论分析:随共享前缀变长,DBI 从 3.934 单调降到 0.976(近 4 倍改善),held-out cosine 从 0.957 升到 0.981,说明更长前缀确实识别出更紧致、语义更连贯的商品组;而 Gini 在三级之间基本相当(0.467–0.508),说明码使用的不均衡度没有随深度恶化——这一点很关键,否则深层前缀会退化成"少数超大桶 + 大量空桶",无法作为可靠的聚合键。三者合起来支持"学到的 SID 层次刻画了逐级更细的商品概念"这一前提。
应用一:基于 Semantic ID 的个性化商品排序
场景与排序模型
发现面(discovery surface)上,消费者通过按品类和主题组织的 carousel 浏览某个商家的在售商品。一个 carousel 可能代表一次生鲜任务(如 Produce、Summer Grilling),也可能是零售概念(如 Beauty、Apparel、Household Supplies)。召回阶段为每个 carousel 选出候选商品,个性化排序器决定每个消费者看到的顺序。
排序器是一个多任务多标签神经网络,带 CTR / ATCR / CVR 三个 head,分别对应点击、加购、下单。它已有的商品身份特征包括 merchant-scoped listing ID 与专家 taxonomy 前缀。前者在商家内部精确保留身份,但无法把消费者历史迁移到另一商家的等价/相关商品;后者支持更广的共享,但可能把过于异质的商品归到一起,无法表达具体的生鲜或零售偏好。结果是:已建立的细粒度偏好可能无法反映到 carousel 顶部,尤其在消费者此前没有下过单的商家上。
特征设计
构造两族互补的 SID 衍生特征(Table 2 给出代表性例子):
| Feature family | Feature Scope | Description |
|---|---|---|
| Dense aggregates | Consumer | 消费者历史中每个 SID 前缀的下单频次、购买 recency、小计(subtotal)统计 |
| Dense aggregates | Submarket | 某 submarket 内每个 SID 前缀的曝光、点击、ATC 行为、下单数及相应比率 |
| Sequence | Item | 候选商品的 SID 得到的 SPM token 序列 |
| Sequence | Consumer | 从历史下单商品聚合、按下单次数排序的 SPM token |
设计动机说得很清楚:Dense 特征把行为统计显式地在 SID 前缀定义的商品概念上聚合,提供了强归纳偏置,避免让排序器纯靠可训练 embedding 去学每一个高基数概念;Sequence 特征保留 SID 码序列本身的信息,支持候选商品与消费者历史之间的学习式交互。沿用 [9, 11] 的做法:前缀 $n$-gram 作为 dense 特征的聚合键,SentencePiece subword 作为 item 侧与 consumer 侧序列特征的单位。
特征标识符
每个前缀 $n$-gram 被映射为一个确定性整数标识符:
$$p^{(n)}_i = \sum_{j=0}^{n-1}\Big( (c_{i,j} + 1) K^{j} - 1 \Big), \qquad n \in \{1,2,3\},\quad K = 512 \tag{3}$$
L1 / L2 / L3 的标识符存在各自独立的字段里,因此在每个前缀级别内部映射是无碰撞的(论文只保证 level 内无碰撞,不追求跨 level 唯一)。
SentencePiece 输入的构造
为构造 SentencePiece 输入,把每个 (position, code) 对映射到一个来自 $3K = 1{,}536$ 个符号的字母表中的唯一符号,从而把每个三码 SID 转成一个三符号字符串。在这些字符串的按曝光加权(impression-weighted)语料上训练 SentencePiece 模型 [6]。得到的 piece 可以跨越 1、2 或 3 个相邻 SID 符号,因此不必与层次前缀重合——这正是它相对 dense 前缀特征的信息增量所在。
Dense 聚合特征
SID 前缀让行为证据能在多个语义分辨率上共享:消费者级聚合刻画个体对每个前缀所代表概念的 affinity;全局与区域级聚合提供整体与本地条件下的表现先验。这些信号在三个前缀级别上都计算,并在适用处覆盖多个回看窗口(lookback windows)。因此排序器可以把浅前缀更广的覆盖度与深前缀更强的特异性结合起来。
序列特征
论文评估了 SentencePiece 的 Unigram LM 与 BPE 两个变体,并给出了一个很有价值的负结果:Unigram LM 学出来的词表主要由 SID 前缀 $n$-gram 构成,因而与前缀键控的 dense 特征所携带的信息高度重叠。于是改用 BPE 以获得更互补的子序列集合,把得到的单位称为 SPM token。
- Item 侧:候选商品由其 SID 得到的 SPM token 表示。
- Consumer 侧:收集过去 180 天内下单的商品,展开它们的 SPM token 列表,按 token 聚合下单频次。不同 token 按下单次数排序、以 recency 作为 tie-breaker,保留排名最高的若干 token,作为"反复出现的语义偏好"的紧凑表示。
Item 侧与 consumer 侧的 token 共享一张 embedding table,使排序器可以直接把候选商品的 subword 与消费者历史偏好关联起来。记 $\mathcal{T}$ 为任一侧的 SPM token 列表,词表规模 $N = 2 \times 10^5$ 个学到的 token,另加一个 null token 条目,共享可训练 embedding table $\mathbf{E} \in \mathbb{R}^{(N+1)\times 64}$。每一侧的表示由均值池化得到:
$$h(\mathcal{T}) = \frac{1}{|\mathcal{T}|}\sum_{t \in \mathcal{T}} \mathbf{E}_t \tag{4}$$
另有一个独立的 mask 指示该侧输入是否为空。池化表示与 embedding 参数与排序目标联合学习。
离线评估
排序模型在 $M$ 天的日志交互上训练,在第 $M+1$ 天的数据上评估($M$ 的具体值未披露)。关键的实验设计考量:完整候选(full candidate, FC)在引入 SID 衍生特征的同时还包含了并发的非 SID 特征更新,因此只跟生产 baseline 比无法隔离 SID 的贡献。为此构造了一个消融候选(ablated candidate, FC-A):移除全部 SID 衍生特征,同时保持完整的非 SID 特征配置不变。
在 CVR head 上用 MRR@$K$ 与 NDCG@$K$($K \in \{3,5,10\}$)评估。论文报告 $K=5$,因为在被评估的发现面上不滚动即可看到 5 个商品。两个指标都只在至少含一次转化的 session 上计算。
Table 3:SID 衍生排序特征的离线消融(所有值为相对生产 baseline 的相对增益)
| Model | MRR@5 | NDCG@5 |
|---|---|---|
| FC-A(去掉全部 SID 特征) | +2.10% | +2.92% |
| FC(完整候选) | +6.98% | +6.76% |
结论分析:FC 在两个指标上都大幅超过 FC-A(MRR@5 从 +2.10% 到 +6.98%,NDCG@5 从 +2.92% 到 +6.76%),$K=3$ 与 $K=10$ 上模式相同。由于两个候选只在 SID 衍生特征上不同,这个消融表明 SID 特征贡献了完整候选离线增益的大部分(按 MRR 口径约 $4.88/6.98 \approx 70\%$,按 NDCG 口径约 $3.84/6.76 \approx 57\%$)。这是本文最干净的一处因果论证。
线上实验
线上实验评估的是一个生产特征包(feature bundle),把 SID 衍生特征与并发的非 SID 更新绑在一起。消费者被大致均匀地随机分到三个 arm:现有排序器、特征包处理组、以及"处理组 + 额外的 serving 优化"。论文报告的是现有排序器 vs 特征包处理组的 21 天对比。
Table 4:完整排序处理组的线上结果
| Outcome | Relative gain |
|---|---|
| Subtotal | +0.31% |
| Average carousel ATC rate | +5.5% |
| Item ATC rate, position 1 | +8% |
| Item ATC rate, position 2 | +16% |
| Item ATC rate, position 3 | +6% |
结论分析:处理组在整个 carousel 以及前三个位置上都提升了加购参与度,并转化为 +0.31% 的小计(subtotal)相对提升。位置 2 的 +16% 明显高于位置 1 的 +8% 与位置 3 的 +6%,论文没有解释这个非单调模式(一个合理猜测是位置 1 本来就被强 prior 占据、提升空间较小,但这属于读者推测)。
曝光集中度的改善(这一段是本文相当有分量的一个结果):处理组降低了热度集中:第一个 carousel 位置上展示商品的历史平均热度下降 18.1%,第一位曝光中分给 blockbuster 商品的份额下降 2.1 个百分点。也就是说,处理组在提升参与度的同时,把更少的头部位置曝光分给了历史上占主导的商品——参与度与冷门商品曝光两个通常相互冲突的目标被同时改善。这与 SID 前缀跨商家汇聚证据的机制一致:偏好可以从"同一商品概念的其他 listing"迁移过来,不必依赖单个 listing 的历史热度。
论文自己也明确了这个实验的局限:生产包同时含 SID 与非 SID 更新,线上实验单独并不能隔离 SID 的贡献;但离线消融与实验后分析都指向 SID 衍生特征解释了大部分观测到的改善。
应用二:基于 Semantic ID 的查询改写
场景
研究对象是商家 Store Page 上、与搜索结果并排展示的建议 query pill(suggested-query pills)。一个有用的建议必须同时满足两点:推进消费者的购物任务,并且对应商家在售品类中真实存在的商品。购物 session 里既有横向的凑篮动作(milk → cereal),也有对商品类型、品牌、变体的细化。
方法
Query-to-concept grounding(查询到概念的接地)
对每个 (query, business vertical BV) 对,把关联的 ATC(add-to-cart)事件按 SID 前缀聚合。对至少有 5 个事件的 query–BV 对:
- 若某个 L2 前缀占据至少 30% 的证据,则把该 query–BV 对分配给这个 dominant L2 前缀;
- 否则在 L1 上应用同样的判据;
- 若两级都不满足,则走一条受保护的 fragmented-query 路径:保留原始 query 节点,而不是硬塞一个没有支撑的概念。
按 BV 条件化使同一个 query 串在不同零售语境下解析到不同的商品概念——这直接解决了字符串图里"同串异义"被混淆的问题。
Lateral navigation(横向导航)
给定 session 中的连续 query 对 $(q_t, q_{t+1})$,用它们各自接地后的 SID 前缀之间的转移替换掉原来的字符串对。转移计数与边缘分布在每个 BV 内部分别估计,候选边按 NPMI(normalized pointwise mutual information)[2] 排序。保留一条边需同时满足三个条件:
- 观测计数 $\geq 5$;
- 独立性假设下的期望计数 $\geq 1$;
- NPMI $\geq 0.1$。
这个构造把解析到同一概念的词面变体汇聚起来,同时保留了歧义 query 在不同 BV 下的解释。
Hierarchical refinement(层次化细化)
接地到同一个 SID 前缀的 query 共享一个图节点,于是细粒度意图之间的转移会坍缩成自环并被丢弃。这一点在 L2 上尤其吃亏:图捕捉到了跨概念的横向 pivot,却漏掉了同一父节点下的细化。因此论文加了一条并行路径:从一个 L2 前缀下降到它的 L3 子节点,在有 query 特定 ATC 证据时用该证据排序,否则退回父级热度排序。
这是本文查询改写侧最关键的设计——它承认"接地"本身会丢掉一层信息,然后用层次的下一级把它补回来。
Query rendering(查询渲染)
因为 SID 是内部标识符,需要一个语言模型 prompt把两条候选生成路径产出的目标概念、用每个概念的代表性商品渲染成简短的、面向消费者的 query 文本。第二遍会移除不可用的 source–target 对,剩余候选按 source query 与渲染后 query 之间的 embedding 相似度排序。论文特别强调:语言生成被严格限制在这个渲染步骤内;候选结构由观测行为与目录概念决定。
Assortment-aware filtering(在售品类感知过滤)
serving 时,候选按商家当前在售品类过滤:只有当在售品类中至少有一个 active item 被分配到该目标概念时,这个概念才是合格的——从而避免向消费者建议该商家无法满足的意图。
离线评估
离线评估围绕两个互补问题。
(1) SID 是否比商品 taxonomy 更好地保留细粒度意图区分? 度量方式是:表达不同意图的 query 有多大比例被映射到同一个概念——这类转移会坍缩成自环、无法产出改写候选。
| 表示 | 意图变化转移被坍缩的比例 |
|---|---|
| Taxonomy | 18.8% |
| SID | 10.9% |
SID 把坍缩率从 18.8% 降到 10.9%(相对减少约 42%),即更细的 SID 表示为候选生成保留了更多可用的行为信号。
(2) 在 SID 概念上建转移是否比在原始 query 字符串上更好? 用 LLM judge 对 usefulness、target-text quality、distinctiveness 三个维度打 bad / acceptable / good,分别映射为 0 / 0.5 / 1。在一个 200 条 query pair 的人工标注集上,judge 达到 78% 的精确一致率、usefulness 维度 80% 一致率(即先验证了裁判本身的可靠性,再用它做大规模评估——这是一个值得肯定的做法)。
| 系统 | Rank-one judged quality |
|---|---|
| Query-string transition graph | 0.522 |
| Catalog-grounded SID system | 0.734 |
在两个系统都能服务的 query 上,rank-one 判定质量从 0.522 提升到 0.734(+40.6% 相对)。
综合结论:SID 既比 taxonomy 提供了更有判别力的商品意图表示,也比原始 query 字符串提供了更强的行为转移挖掘基础。
线上实验
在消费者随机化实验中评估完整的 SID 改写模块,对照组不展示建议 query 改写。
Table 5:SID 查询改写对搜索效率的线上影响(相对对照组;ATC position 与 scroll depth 越低越好)
| Metric | Relative change | 95% CI |
|---|---|---|
| Purchase MRR | +0.558% | [+0.294, +0.823]% |
| ATC position | −1.571% | [−2.159, −0.982]% |
| Search scroll depth | −1.866% | [−2.262, −1.470]% |
结论分析:三个指标的 95% 置信区间均不跨零,方向一致:改写模块提升了 purchase MRR,同时降低了加购发生的位置与搜索滚动深度。合起来说明消费者更早、且花更少检索成本就触达到相关且可购买的商品。相比排序侧的 bundle 实验,这个实验的干净程度更高(对照组是"无改写建议",处理组是完整 SID 改写模块),但代价是它比较的是"有 vs 无",并没有和一个 query-string 转移图的线上基线对比——字符串图 vs SID 图的对比只在离线做了。
定性分析
附录 Table 6 用例子说明了 SID 表示对两个应用都有利的两个性质。
| SID property | Example | Observed effect |
|---|---|---|
| 排序 · 跨商家迁移 | 在另一个商家有蘑菇与鸡肉的历史购买 | 尽管 merchant-scoped 标识符不同,匹配商品在排序中上浮到顶部 |
| 排序 · 细粒度语义 affinity | 曾购买一支化妆刷 | 相关的化妆刷套装排到化妆海绵之上,且更多刷类商品进入头部结果 |
| 改写 · 层次化细化 | 源 query:clay mask | L3 下降引入更具体的意图,包括 sheet mask、hydrating mask |
| 改写 · 由粗到细的导航 | 源 query:car clean | L3 补充 interior wipes、interior cleaner、leather wipes;L2 同时保留一个有用的横向 pivot |
同时论文诚实地指出了语义压缩引入的 trade-off:把很多商品或 query 映射到一个前缀会增加统计支撑,但过宽或语义混杂的前缀会把不相关的行为连起来。在改写里,这类前缀可能成为高度数的图 hub,扩散出不相关的建议;基于商品的 query 接地也可能捕捉到最终被加购的概念,而非原始 query 表达的意图(一种典型的下游行为污染)。在排序里,处在量化边界附近的商品可能拿到不同的码,尽管它们互为有用的替代品;而共享前缀的商品仍可能在某个消费者在意的属性上不同。
论文给出的应对思路是在 SID 之外恢复信息:排序把多个深度的前缀与消费者特定、商品特定的信号结合;改写把接地与转移按 BV 条件化、在下降到 L3 时使用 query 特定证据、并按商家在售品类过滤。因此 SID 层次提供的是一个可迁移的语义先验,而不是任务意图的完整表示。
跨系统发现
附录 Table 7 总结了两个应用如何复用同一套 SID 层次:
| SID role | 个性化商品排序 | 查询改写 |
|---|---|---|
| 输入单元 | merchant-scoped 商品 listing | 原始 query 字符串 |
| 映射进 SID 空间的方式 | 消费者交互历史中的商品 | 通过关联商品接地的 query |
| 被汇聚的证据 | 语义相关商品之间的跨商家交互 | 同一概念的词面变体之间的转移 |
| 层次的使用 | L1–L3 前缀作为排序特征联合使用 | L2 转移做导航;L3 下降做细化 |
| 任务特定信号 | affinity、recency、商品表现、交互序列 | 转移强度、query 证据、概念热度 |
| 被恢复的上下文 | 消费者、候选商品、区域上下文 | BV、源 query、商家在售品类 |
| 主要表示风险 | 共享前缀可能掩盖影响偏好的属性 | 宽前缀可能坍缩意图或成为图 hub |
论文提炼出的共同模式是:用 SID 做语义层面的证据汇聚(semantic evidence pooling),然后在产出结果之前恢复任务特定上下文。 粗前缀提供支撑度与可迁移性,深前缀恢复特异性。合适的操作深度是应用相关的:排序可以同时消费多个深度,而改写则给 L2 导航与 L3 细化分派了截然不同的角色。
这一节还澄清了 SID 相对既有标识符的定位:精确商品 ID 对身份与 serving 仍然必要,taxonomy 对业务组织仍然有用;SID 是对二者的补充——提供一个细粒度、可迁移的层次,可以跨发现类任务复用而不要求这些应用共享同一个模型或同一套决策逻辑。
核心贡献总结
- 一份生产规模的实证:一套层次化 SID 词表可以同时支撑跨推荐与搜索的发现系统,且不需要联合训练的模型——两个系统不共享参数、目标与 serving 架构。
- 排序侧的具体配方:SID 前缀既作为行为聚合的键(消费者/submarket 级 dense 统计,三级前缀 × 多回看窗口),又通过 SentencePiece BPE 子词作为 item 与 consumer 共享 embedding table 的序列特征;并给出了"Unigram LM 与前缀 dense 特征信息冗余、BPE 更互补"这一可复用的负结果。
- 改写侧的具体配方:query→SID 概念接地(BV 条件化 + 30%/L2→L1 回退 + fragmented 保护路径)、概念级 NPMI 转移图(三重阈值)、L2→L3 层次下降补回被自环丢弃的细化、LLM 仅用于渲染、在售品类过滤。
- 受控消融隔离 SID 贡献:FC vs FC-A 的设计使得在"生产特征包不可避免地捆绑了其他更新"的现实约束下,仍然能对 SID 的离线贡献做因果性归因。
- 参与度与曝光多样性同向改善:首位商品历史平均热度 −18.1%、blockbuster 首位曝光份额 −2.1pp,同时 ATC 与 subtotal 上升。
与已归档相关工作的对比
本文参考文献仅 11 条(TIGER、SentencePiece、Query-Flow Graph、NPMI、Gemini Embedding、Singh et al. 2024、Zheng et al. 2504.02137、Ju et al. 2507.22224、Penha et al. 2508.10478、Zhang et al. 2402.11202),下述三篇均未被引用,属于独立并发工作。时序上三篇都早于本文(2026-08-21)。
Semantic IDs for Recommender Systems at Snapchat: Use Cases, Technical Challenges, and Design Choices Semantic IDs for Recommender Systems at Snapchat: Use Cases, Technical Challenges, and Design Choices(Snap Inc., 2026-04-05)
关系:独立并发(本文未引用,两者殊途同归)· 已加载对方精读 · 对方早于本文约 4.5 个月
- 共同关注的问题:两篇都是"一套 SID 词表、多个生产系统"的工业实践报告,且 root cause 一致——原子标识符(Snap 的 per-item atomic ID / DoorDash 的 merchant-scoped listing ID)无法在语义等价的物品之间汇聚行为证据,导致长尾与冷启动下表示欠训练。两篇也都把 SID 定位为"补充而非取代"精确 ID。
- 相近的技术骨架:残差量化内容 embedding → 得到层次化离散码 → 同一套码被多个下游生产系统各自消费。Snap 的两个 use case 是「排序模型的辅助特征」与「生成式检索的目标」;本文的两个是「排序特征」与「查询改写的概念空间」。
- 本文的差异与推进:Snap 的重心在 tokenizer 侧的工程难点——用 STE 让梯度回传到整个码本以缓解 codebook collapse、多模态 embedding 融合提高输入方差、以及生成式检索里的 SID→item 消歧(启发式 intra-code 排序、depth over breadth)。本文几乎不碰 tokenizer(直接用 RQ-KMeans + gemini-embedding-001,甚至没讨论 collapse),全部重心放在"消费侧":前缀 $n$-gram 作为行为聚合键、SPM token 作为序列特征、query 接地与概念转移图。可以说两篇正好覆盖了同一条流水线的上下游两半。
- 可比的方法/实验差异:Snap 用 RQ-VAE(带编码器/解码器与重建+commitment 损失),本文用 RQ-KMeans(无学习式编码器);Snap 的第二个 use case 是生成式检索(因此必须解决 SID→item 碰撞),本文的第二个 use case 是搜索侧的查询改写——这是归档中第一次看到 SID 层次被用作 query-to-query 转移图的节点空间。两篇都只报告相对增益、无公开数据集指标。
SID-Coord SID-Coord: Coordinating Semantic IDs for ID-based Ranking in Short-Video Search(Kuaishou Technology, 2026-04-12)
关系:独立并发(本文未引用)· 已加载对方精读 · 对方早于本文约 4 个月
- 共同关注的问题:如何把 SID 塞进一个已经以稀疏 ID 为核心的判别式生产排序器,让语义泛化能力补上稀疏 ID 在长尾上的记忆失效。SID-Coord 的对象是 hashed item ID(HID)在短命/长尾视频上的欠训练;本文的对象是 merchant-scoped listing ID 无法跨商家迁移偏好。两者都承认"精确 ID 仍然必要",争的是如何叠加语义层。
- 相近的技术骨架:都从残差量化得到多级 SID,都把多个前缀深度同时送进排序器(本文:L1/L2/L3 dense 聚合 + SPM token 序列;SID-Coord:$\{s^{(1)},s^{(2)},s^{(3)},s^{(1,2)},s^{(2,3)}\}$ 五路 + 自注意力分辨率融合),都在 target 侧与 user 侧分别使用 SID,且都不改动主干排序器。
- 本文的差异与推进:最值得注意的一点是,SID-Coord 的实验基线恰好就是本文的方法族——它把 Prefix-Ngram、Ngram、SPM-SID 作为对照组,批评这些做法"把 SID 当静态特征、不利用层次粒度、不按热度自适应平衡记忆与泛化",并在其内部数据上报告自己优于它们(ALL AUC 0.7683→0.7708)。本文则给出了这条被批评路线在真实生产系统上确实有效的另一侧证据:不做任何学习式协调,仅靠"前缀键控的显式行为统计聚合 + BPE 子词共享 embedding",离线 MRR@5/NDCG@5 相对 baseline 就有 +6.98%/+6.76%,且线上加购与曝光多样性同向改善。本文额外贡献了一个 SID-Coord 没有的观察:Unigram LM 学出来的词表几乎就是前缀 $n$-gram,与 dense 前缀特征冗余,因此必须用 BPE——这直接解释了为什么"SPM-SID"与"Prefix-Ngram"在某些实现下会表现接近。
- 可比的方法/实验差异:SID-Coord 有明确的机制创新(radix-$B$ 相邻层复合、热度驱动的 HID–SID 门控 $g$ 从尾部 ~0.30 单调升到头部 ~0.73、AutoDis 处理的兴趣对齐),并给了逐项消融;本文没有任何学习式协调模块,靠的是显式统计聚合的归纳偏置。指标口径也不同:SID-Coord 报告绝对 AUC/UAUC,本文只报告相对增益,因此两者无法直接放在同一张榜单上比。
FLUID FLUID: From Ephemeral IDs to Multimodal Semantic Codes for Industrial-Scale Livestreaming Recommendation(TikTok / ByteDance, 2026-05-20)
关系:独立并发(本文未引用)· 已加载对方精读 · 对方早于本文约 3 个月
- 共同关注的问题:两篇的 root cause 表述几乎可以互换——原子标识符的粒度使得任何单个单元都攒不够行为证据。FLUID 量化的是时间维度(直播间中位生命周期约 40 分钟,item ID embedding 的 $\ell_2$ 范数在 40 分钟时只有稳态的 72%);本文是空间/商家维度(同一商品概念被切成多个 merchant-scoped listing,任一 listing 都学不到可靠偏好)。两者都用"内容衍生的层次语义码"来替换或补充这个失效的单元。
- 相近的技术骨架:都用 RQ-KMeans(而非 RQ-VAE)对内容 embedding 做层次量化;都用 prefix $n$-gram 复合索引把层次码映射成排序器可消费的 embedding,且两者的复合索引公式本质相同——FLUID 是 $\bar{c}_l = \sum_{k=1}^{l} c_k N^{l-k}$,本文是 $p^{(n)}_i = \sum_{j=0}^{n-1}\big((c_{i,j}+1)K^{j}-1\big)$,动机都是"深层码只有在其父路径条件下才有意义,不能跨不相关子树共享 embedding 槽位";都采用后融合(late fusion)、把语义码作为独立特征/token 接进已有生产排序器。
- 本文的差异与推进:FLUID 的目标是彻底退役候选侧 item ID(分阶段 warmup:先加 LUCID → 再淘汰 item ID → 再加 room 级码),并为此配套训练了一个跨域多模态编码器(SigLIP2 ViT + Qwen3-Embedding-0.6B 单塔),还引入 slice/room 双粒度以区分瞬态与持久语义。本文完全不动 listing ID 与 taxonomy,只做叠加,并且编码器直接用现成的 gemini-embedding-001 商用 API(无自训编码器)。更重要的是,本文把同一套前缀不仅用于 embedding 参数化,还用作显式行为统计的聚合键(消费者 affinity、submarket 表现、多回看窗口),这是 FLUID 没有做的一层——FLUID 的前缀 $n$-gram 只是 embedding 查表方案。反过来,本文也没有 FLUID 那样的粒度分离设计。
- 可比的方法/实验差异:FLUID 的层次是 $L=4$、每级 $N=64$;本文是 $L=3$、每级 $K=512$(更宽更浅,符合"商品目录概念数远多于直播内容主题数"的直觉)。FLUID 有 item-ID 淘汰的分阶段消融与线上 +0.55% Quality Watch Duration / +2.05% Cold-Start Room Views;本文的线上排序结果是 bundle,不可隔离,但另有查询改写侧的干净 A/B(三指标 95% CI 均不跨零)。两篇都无公开数据集结果。
被剔除的近似候选(附理由)
- DSIRM DSIRM(Alibaba Tmall, 2026-06-03):同样把 query 接地进 SID 空间、同样用层次前缀匹配产出排序特征,是最接近的一次落选。但它的 root cause 是"无监督量化学不出 query-dependent 的相关性划分",解法是改造 tokenizer(query-bridged contrastive RQ-VAE + category-aware 首层码本 + LLM 生成 query SID)。本文的核心设计信条恰恰相反——层次只从内容学一次、保持任务无关,任务上下文在 SID 之外恢复。问题陈述与解法路径都是对立的设计赌注,不构成双同构。
- PrefixMem PrefixMem(Pinterest, 2026-05-29):共享"prefix $n$-gram 是 SID 的正确参数化单位"这一原语,但它的问题是LLM 骨干无法编码 SID 的层次 token 结构、导致深层 SID 生成准确率低,解法是给 LLM 加一个 prefix hash-memory 编码器。既不涉及行为证据汇聚,也不涉及跨系统复用,root cause 不同。
- Improving Item Discoverability in e-Commerce Search via Related Intent Generation Instacart Related Intent Generation(Instacart, 2026-07-29):行业几乎完全重合(多零售商生鲜 marketplace 的搜索发现),产出形式也接近(相关意图/建议 query)。但其 root cause 是"精确词面匹配限制了商品可发现性",解法是 LLM 标注 + 头部缓存 + 蒸馏 Qwen3-30B 学生模型;本文的候选结构完全由行为与目录概念决定,LLM 只负责最后的文本渲染。解法路径差异过大(一方靠 LLM 生成,一方靠概念转移图),属于 SKILL 明示的"问题相似但解法差异大"反例。
- UxSID UxSID(Kuaishou, 2026-05-09)与 SITA SITA(USTC + Kuaishou, 2026-08-04):都把 SID 当作用户兴趣记忆的分组键,形式上很像"按 SID 前缀聚合行为"。但两者的 root cause 是超长序列的 serving 成本(O(1) 哈希查表 / 压缩成 N×K 兴趣 token),追求的是把在线计算搬到离线,而非跨标识符汇聚证据;也没有跨系统复用。
- SIREN SIREN(Tencent, 2026-05-25):用 prefix-encoded SID 做排序特征,工业部署充分。但其问题是多模态晚融合 vs 早融合在终身兴趣建模中的取舍,解法是 target-conditioned attention 里的 item 级早融合,与"共享概念层次"无关。
- RQ-FSQ RQ-FSQ(LinkedIn, 2026-05-31):同样使用 prefix $n$-gram HDE 模块、同样讲跨域证据迁移,但量化对象是用户 embedding(为了存储压缩与跨域迁移),不是商品概念层次,也没有第二个消费系统。
- OneSug OneSug(Kuaishou, 2025-06-07)与 OneBar OneBar(浙大 + Kuaishou, 2026-06-13):都是电商 query 建议/推荐,问题层面相邻。但两者的技术赌注是用端到端生成式 encoder-decoder 取代多阶段级联,与本文"保留转移图的可解释性与批式 serving、只把节点从字符串换成概念"的路线正好相反。
讨论与局限性
值得借鉴的设计。
- "共享表示 + 任务特定上下文恢复"这一分工范式,比"统一模型"更容易在真实组织里落地。本文两个应用是独立开发的,只共享一张离线产出的 SID 表;这意味着接入成本近似于加一批特征,不需要跨团队对齐训练目标或 serving 架构。对绝大多数还做不了 OneRec 式端到端统一的公司,这是更现实的"统一搜推"路径。
- FC / FC-A 消融的实验设计值得单独拎出来:工业论文最常见的可信度硬伤就是"处理组捆绑了多项改动",本文没有回避,而是构造了一个"只删 SID、其余非 SID 更新全部保留"的对照,从而在离线口径上把贡献隔离出来,并在正文里明确承认线上实验做不到同样的隔离。
- 接地会丢信息、就用层次的下一级补回来:L2 接地导致细化转移坍缩成自环 → 加一条 L2→L3 下降路径。这个"发现坍缩 → 从层次上补"的思路可以迁移到任何用聚类/量化做节点归并的图挖掘系统。
- 把 LLM 严格限制在渲染步骤。候选结构由行为与目录决定,LLM 只把内部 SID 翻译成消费者可读的 query。这在成本、可控性、可审计性上都远优于让 LLM 直接生成候选,也天然避免了品牌幻觉(对照 Instacart 那篇需要靠"空结果 carousel 静默降级"来兜底幻觉)。
- Unigram LM vs BPE 的负结果:Unigram LM 学出来的 SID 词表几乎就是前缀 $n$-gram,与前缀键控的 dense 特征信息重叠,因此必须用 BPE 才能拿到互补的子序列。这是一个别人可以直接复用的踩坑记录。
局限与争议。
- 线上排序结果不可归因。 Table 4 的处理组是"SID 特征 + 并发非 SID 更新"的 bundle,+5.5% carousel ATC、+0.31% subtotal 中有多少来自 SID 无法确定。论文只说"离线消融与实验后分析都指向 SID 解释了大部分改善",但实验后分析(post-experiment analysis)本身没有给出任何数据。三 arm 设计里第三个 arm(处理组 + serving 优化)的结果也完全没有报告。
- 全部指标都是相对值,且全部来自内部数据。 没有任何公开学术数据集结果,也没有绝对指标(如 baseline 的绝对 NDCG@5、绝对 ATC rate)。这使得本文无法进入任何 benchmark 榜单,也难以判断 baseline 本身的强度。
- 方法本身的新颖性有限。 前缀 $n$-gram 聚合键来自 Zheng et al. [11],SentencePiece 子词来自 Singh et al. [9],RQ 来自 TIGER [8],NPMI 来自 [2],Query-Flow Graph 来自 [1]。本文的贡献主要在组合方式与跨系统复用的证据,而非任何单点机制。论文自己的定位("a production-scale study")也很诚实。
- 层次是任务无关的、且是固化的。 SID 一旦从 gemini-embedding-001 上离线量化出来就冻结了,不随排序或改写的目标更新。这带来两个已知代价,论文在定性分析里都承认了:量化边界附近的替代品会拿到不同码;共享前缀的商品仍可能在关键属性上不同。同时这也构成方法论可扩展性上的隐患——排序器扩容时,"如何表征商品概念"这条路径不会跟着增长,码本容量 $512^3$ 是一个固定的天花板。DSIRM、SID-Coord 那类"让下游目标反向影响 SID 构造/使用"的路线在这一点上更有上限。
- 关键超参数与规模未披露。 训练天数 $M$、lookback window 的具体取值、consumer 侧保留的 top-$k$ token 数、排序器规模、目录规模、SID 覆盖率、fragmented-query 路径的触发比例,全部缺失。作为 8 页 workshop 论文可以理解,但复现性接近于零。
- 查询改写的线上对照是"无建议"而非"字符串图"。 因此 Table 5 的收益里混杂了"展示建议 pill 本身的价值"与"用 SID 而非字符串建图的价值"。后者只有离线 LLM-judge 的 0.522→0.734 支撑,而这个 judge 只在 200 条人工标注 pair 上验证过一致性。
- query 接地依赖 ATC 事件,存在下游行为污染。 论文自己点破了:"基于商品的 query 接地可能捕捉到最终被加购的概念,而非原始 query 表达的意图"。在 grocery 场景这尤其危险——用户搜 milk 最后加购了 cereal,会把 cereal 概念错误地绑到 milk 上。30% dominant-prefix 阈值与 fragmented 保护路径是缓解手段,但没有量化这类误接地的发生率。