Improving Item Discoverability in e-Commerce Search via Related Intent Generation:头部缓存大模型 + 长尾蒸馏小模型的"发现增强搜索"¶
Instacart(Ji Xin、Xiao Xiao — 共同一作、Ishan Bhatt、Vinesh Gudla、Trace Levinson、Raochuan Fan、Shishir Kumar Prasad、Prakash Putta、Tejaswi Tenneti),TSMO '26 workshop(Two-sided Marketplace Optimization: Search, Discovery, Matching, Pricing & Growth,2026-08-10,Jeju,Korea;arXiv:2607.27172,7 页)。一句话:传统搜索以"严格匹配 query"为目标,把精确率放在召回率之前,导致目录里大量替代品 / 互补品 / 主题相关品长期拿不到曝光;论文提出 discovery-augmented search(发现增强搜索),让 LLM 为 query 生成隐式用户意图(carousel 标题 + 意图检索词)来做意图条件化的召回扩展,并用两级混合架构解决生成式检索的成本-质量权衡:头部约 1 万条高流量 query 用闭权重 LLM 离线标注并缓存,长尾用 LoRA 微调的 Qwen3-30B 学生模型经教师-学生蒸馏实时承接;发现能力的覆盖率从约 60% 提到 80% 的 query 流量,而推理成本只有教师模型的约 30%。
⚠️ 阅读提示:这是一篇7 页的 workshop 系统报告,不含损失函数推导、不含在线 A/B(论文把 A/B 明确列为 future work)、不含非 LLM 基线对比(同样列为 future work)。它的真正价值集中在三处:(a) 把"发现"形式化为 substitute / complement / thematic 三类意图,并刻意把生成与检索解耦——LLM 只产出意图词,商品仍由既有检索引擎 hydrate,从而让缓存、降级、灰度都可控;(b) 一套双轨评测方法论——会话共同购买派生的端到端购买预测 benchmark + 人工校准过的 LLM-as-a-judge;(c) 一节相当诚实的 Deployment Lessons and Limitations,把蒸馏上下文缺口、温度对 Coherence 的敏感性、品牌幻觉、离线评测的反事实偏差全部摊开。
研究动机与背景¶
exact-match 范式在生鲜电商里的结构性失效¶
论文开篇指出,搜索系统在历史上一直围绕 ad hoc retrieval 的原则设计:首要目标是返回与用户 query 最直接匹配的结果。query 改写(rewriting)与扩展(expansion)这类技术虽被广泛使用,但它们通常只用来处理词表不匹配(vocabulary mismatch)、提升对显式 query 的匹配准确度,而不是去拓宽(broadening)结果集的范围。
在生鲜(grocery)与更一般的电商市场里,这种"严格基于相关性"的范式是不够的。论文给出三个真实场景:
- 想给缺货商品找一个合理的替代品;
- 为某个菜谱凑齐配料;
- 为某个使用场景找互补品。
在这些场景下,三类关系才是用户目标的核心,但它们几乎不会被单一 keyword 表达出来:
- substitution(替代)——例如 tangerine 换 clementine;
- complementarity(互补)——例如 pasta 和 sauce;
- thematic association(主题关联)——例如 seafood platter、seasoning。
结果就是:传统检索把目录里能满足用户更宽泛隐式意图的大片商品长期低曝光(under-exposes),从而限制了营收潜力。论文特别强调,在双边市场(two-sided marketplace)语境下,这种低曝光还会不成比例地伤害长尾与新兴供给——于是"发现"不只是一个用户满意度问题,同时是一个市场平衡(marketplace-balancing)问题。
任务的形式化:discovery-augmented search¶
论文把这件事形式化成一个与标准检索不同的任务设定 discovery-augmented search:目标不只是检索出与 query 精确匹配的商品,而是同时检索出通过更宽泛语义关联而有用地相关的商品。它通过 implicit intent generation(隐式意图生成) 来建模——用 LLM 推断用户的潜在意图,再用这些生成的意图去扩展召回集。
评测上有一个核心难点:标准相关性指标(如基于 exact match 的 NDCG)天然惩罚面向发现的结果。为了解决这一点,论文同时做两条分析:一条基于从会话共同购买派生的、全新的端到端评测数据集,一条基于 LLM-as-a-judge 框架。这套双轨设计让作者能同时验证生成意图在语义上成立且在商业上保值(commercially utility-preserving)。
三条核心贡献¶
- Task Formulation(任务定义):定义 discovery-augmented search 并将其操作化,通过三类意图(substitute / complement / thematic)落地,明确区别于 query expansion(词法/语义层面)与 item-item recommendation(与 query 无关)。
- Production-Grade Hybrid Architecture(生产级混合架构):两级系统,头部 query 用缓存的闭权重 LLM 标注,长尾 query 用 LoRA 微调的 30B SLM,在 80%+ query 覆盖率下平衡质量与成本。
- Dual Evaluation Methodology(双轨评测方法论):会话派生的购买预测 benchmark + 人工校准过的 LLM-as-a-judge 框架,在"标准相关性指标会给发现打低分"的场景下同时提供外在效用(extrinsic utility)与内在语义(intrinsic semantic)信号。
与已有工作的定位¶
论文把相关工作分四块,并逐块说明差异:
Query Understanding and Rewriting(refs [5,11,18])。query 改写与扩展在 web 搜索里用于提升召回、缓解词法不匹配;电商域中已有工作用这类精炼模式改善 query 理解(ref [9])。但这些方法通常聚焦于同义改写、近义词、拼写变体,实质上是在用户显式意图的边界内做优化;它们一般用严格相关性指标(NDCG、MRR)评测,既不考虑潜在意图扩展,也不考虑生鲜发现所依赖的互补结构。
Complementarity and Co-Purchase Modeling(refs [3,13,14,21])。推荐系统里已有大量用共现统计、图方法、会话 embedding 做互补品预测的工作,它们在 item-to-item 推荐界面("You might also like")上很有效,但在query 条件化的检索场景里有两个局限:(a) 它们通常与搜索路径解耦、缺乏 query 条件逻辑;(b) 它们依赖历史共同交互信号,而这类信号对长尾 query、新兴供给,以及像 smoothie station 这种极少能从共购图里浮现出来的主题意图都很稀疏。论文强调自己的工作是互补而非竞争:语言模型能直接从 query 出发推断互补与主题关系,天然延伸到共购图稀疏的长尾 query,并且其输出可以与稠密参与度数据可得时的图信号结合。
LLMs for Query Understanding and Retrieval(refs [17,22,23])。LLM 在意图抽取、分类、属性抽取上已展现效力;也有工作用 RL 微调 LLM 以适配定制奖励(refs [2,12])。但论文指出:把专有(proprietary)模型部署到整条 query 分布上——尤其长尾——成本上不可承受。本文的应对就是把推理能力迁移到成本高效的模型上,在不承担巨型 LLM 运营开销的前提下实现可扩展的意图生成。
Discovery in Two-Sided Marketplaces(refs [1,6,8,7,19])。双边市场的搜索排序必须同时满足消费者相关性与供给侧曝光。Airbnb 系列工作(refs [1,6,8])显式地在房客偏好与房东/房源多样性之间做权衡;方法论工作(ref [7])把卖家侧评估形式化为一个与消费者侧 A/B 不同的反事实问题;多边设定如外卖(ref [19])进一步把目标推广到异构供给方。论文把这套结论类比到生鲜市场的两侧:消费者获得他们本来不知道该去搜的替代品与互补品,而零售商与品牌——特别是长尾与新兴的那些——获得超越精确匹配检索的、query 条件化的曝光机会。于是隐式意图生成因此是作为一种市场平衡机制在运作,而不纯粹是一个相关性杠杆。
核心方法 / 模型架构¶
3.1 问题形式化¶
任务定义。 给定用户 query $q$,系统输出一组 $C$ 个 carousel(轮播):
$$\{(t_i, \mathbf{e}_i)\}_{i=1}^{C}, \quad \mathbf{e}_i = (e_{i,1}, \dots, e_{i,K}) \tag{1}$$
其中 $t_i$ 是自然语言的 carousel 标题,$\mathbf{e}_i$ 是长度为 $K$ 的意图词(intent terms)列表。每个 $e_{i,j}$ 随后被发给标准检索引擎去 hydrate 出一个商品列表。生产环境中使用的具体取值是 $C = 9$、$K = 5$。
论文明确区分这个任务与两类既有任务:
- 与 query expansion 不同——后者产出的是单一改写后的 query;
- 与 item-item recommendation 不同——后者是 query-free 的。
给定用户 query,传统检索系统的目标是最大化相关性;本文要检索的是一个扩展召回集,既包含高相关商品,也包含用户隐式想要的商品。三类关注的潜在意图:
- Substitute(替代):例如 query "milk" 下的 "non-dairy milk"——用户可以换用的商品;
- Complementary(互补):例如 "coffee and tea"——与被查询商品共同消费的商品;
- Thematic(主题):例如 "smoothie station"——处于同一使用场景上下文(菜谱、场合、生活方式组合)里的商品。
系统只负责生成这些意图词,用来填充面向发现的 carousel——即"一个描述性标题 + 一组精选的相关商品"构成的界面元素;而 exact matches(定义为:经过停用词移除与词干化后,其分词标题包含全部 query token 的商品)仍由遗留检索栈(legacy retrieval stack)处理。
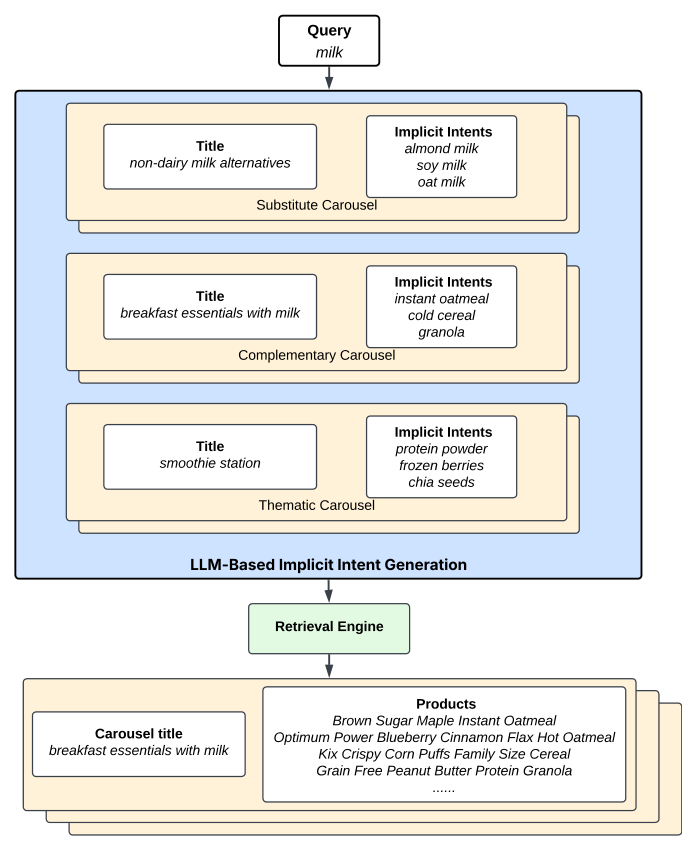
如 Figure 1 所示,以头部 query milk 为例:LLM 输出 carousel 标题 breakfast essentials with milk 以及意图词 instant oatmeal、cold cereal;每个意图词被分派给既有检索引擎,检索结果 hydrate 成用于展示的 carousel。
3.2 头部 query:闭权重 LLM + 离线缓存¶
当前在生产中的系统使用一个离线特征库(offline feature store),覆盖约 10k 条流量最高的 query。这些头部 query 约占搜索流量的 60%,其余 40% 为长尾 query。这批标注由闭权重 LLM GPT-3.5 Turbo(ref [15])生成。
论文采用 generate-then-retrieve(先生成再检索)范式。对每条用户 query,LLM 被要求生成一份包含两个组成部分的结构化输出:
- Carousel Title:为用户界面设计的自然语言字符串(如 breakfast essentials with milk);
- Intent Terms:一组具体的搜索 query(如 instant oatmeal、cold cereal),它们在语义上属于该 carousel。
生成的 intent terms 随后被在标准搜索引擎上执行以检索最终商品集,与 carousel 标题一起构成用于展示的 carousel。论文强调这种把生成与检索解耦的做法确保了:LLM 只聚焦于高层语义推理,而真正的商品检索仍然锚定在目录里。采样温度 $T = 1.0$。
Table 1: Examples from the End-to-End Evaluation Dataset.(端到端评测数据集示例)
| Query | Semi-relevant product categories |
|---|---|
| chicken broth | Cheese, Fresh Vegetables, Condiments, Pasta |
| tomato paste | Snacks, Cheese, Fresh Fruit, Pasta, Beef |
| tequila | Baking and Cooking, Fruit Juice, Snacks |
3.3 长尾 query:LoRA + 教师-学生蒸馏的 SLM¶
为把发现能力扩展到长尾(剩余 40% 流量)而不承担高昂的延迟或成本,论文引入一个经教师-学生蒸馏训练的微调 SLM。
蒸馏数据集构造:标注 20k 条采样 query,头尾各半(balanced 50/50),教师用更强的 GPT-5.1(ref [16])。为增强教师的推理能力,prompt 里注入来自离线特征库的 contextual metadata,包括:关联品牌、商品属性、概念标签、近期购买历史。同时用 few-shot prompting(ref [4])教模型在有上下文时利用上下文、在冷启动 query 上退回到内在知识。得到的数据集按 70% 训练 / 30% 验证切分。
学生模型与训练配置:基座选 Qwen3-30B-Instruct(ref [20]);用 LoRA adapters(ref [10])微调 1 个 epoch,rank = 8,batch size = 65536,learning rate = 1e-4;损失是在教师输出(JSON 格式)上的标准 next-token 交叉熵。
部署效果:微调后 SLM 实时(in real time)服务高频长尾 query,把系统总覆盖率从约 60% 提到 80% 的流量。剩余约 20% 的流量——语义内容极低的极端长尾 query(如单字符、代码混写、或错字严重)——回落到遗留的 retrieval-only 栈,不展示任何 carousel。
实验设置¶
反映系统的层级结构(Query → Title/Intent → Product),论文采用两级评测策略:
- 端到端评测:评测完整流水线,衡量下游效用;
- 内在评测:评测生成阶段,衡量语义质量。
用于评测的 query 全部来自 30% 验证集,与训练集无重叠。全节中 Prod. 指当前部署的系统:为 top ~10k 头部 query 缓存的闭权重 GPT-3.5-Turbo 标注(§3.2)。按设计,Prod. 不覆盖长尾 query,相应格子标为 "—"。
4.1 端到端评测数据集的构造¶
论文从历史搜索会话构造了一个 "Discovery Evaluation Dataset",构造过程含以下步骤:
- Session Aggregation(会话聚合):收集与搜索发生在同一会话内的 (query, product) 购买对。施加基于位置的衰减
$$w(n) = \frac{1}{\log_2(2+n)} \tag{2}$$
其中 $n$ 是该购买在会话中的序号(0-indexed),因此第一次购买权重为 1,第二次约 0.63,依此类推——从而优先看重更早的购买作为更强的意图信号。
-
Category Mapping(类目映射):每个商品映射到其高层商品类目(如 Mild Gouda Cheese → cheese,Maple Beef Jerky → snacks),以提升泛化性、降低稀疏性。
-
Signal Extraction(信号抽取):跨会话聚合被转化的商品。为降噪并归一化常见 query 与稀有 query 之间的信号,排除每条 query 下出现在 top-10 排名之外的商品。
-
Exclusion of Exact Matches(排除精确匹配):同样排除与 query 精确匹配的商品(§3.1),因为它们由传统检索栈处理。
由此得到的商品集,代表了用户隐式需要但通过精确匹配找不到的商品。同时移除精确匹配与 top 排名结果后,剩余商品就为潜在需求——替代、互补、主题补充——提供了 ground-truth 信号。示例见 Table 1。
评测协议:一个被检索商品被判为 relevant 的充要条件是,其高层类目属于该会话中被购买的类目集合(经上述基于位置的加权之后)。
4.2 生成质量评测的指标定义¶
论文用一个经人工偏好校准过的 LLM-as-a-judge 框架评测生成的 carousel 标题与意图的内在质量,指标分两级。
Title-level 指标。对 query $q$ 产出的每个 carousel 标题 $t_i$,judge 返回二值判定:
- Relevance:$t_i$ 是否在主题上与 $q$ 对齐;
- Quality:$t_i$ 是否是一个清晰、描述性的自然语言短语,能概括该 carousel;
- Safety:$t_i$ 是否避免了敏感、冒犯或违反政策的内容;
- Coherence:$t_i$ 是否与同一 query 下产出的其它标题 $\{t_j\}_{j \neq i}$ 主题一致(即整组 carousel 覆盖的是互补的轴而非彼此重复)。
Intent-level 指标。对 carousel $i$ 内的每个意图词 $e_{i,j}$:
- Relevance:$e_{i,j}$ 在语义上是否属于标题 $t_i$;
- Diversity:集合 $\{e_{i,1}, \dots, e_{i,K}\}$ 是否覆盖了不同的子意图;
- Novelty:$e_{i,j}$ 是否是对 $q$ 的非平凡扩展(而非改写或平凡复述)。
judge 模型:GPT-5(ref [16]),对所有指标给出二值 pass/fail 标记。
论文主动披露一个 same-provider caveat(同厂商警示):教师(GPT-5.1)与 judge(GPT-5)共享同一个模型族,这可能使 judge 偏向教师风格的输出;人工对齐分析(下节)在一定程度上缓解这一顾虑,论文把跨模型族的 judge 审计列为 future work。
为验证这套自动评测,论文请人工在关键指标上标注 50 个 (query, carousel-title, intent-term) 三元组:Title Relevance、Intent Relevance、Intent Novelty。
主要实验结果¶
端到端购买预测¶
Table 2: End-to-End purchase prediction results. Prod. 是缓存的 GPT-3.5-Turbo 头部 query 系统,按设计不覆盖长尾 query("—")。
| Model | Head P | Head R | Head F1 | Tail P | Tail R | Tail F1 |
|---|---|---|---|---|---|---|
| Prod. | 0.130 | 0.260 | 0.173 | – | – | – |
| GPT-5.1 | 0.124 | 0.426 | 0.192 | 0.108 | 0.379 | 0.168 |
| Qwen3 | 0.117 | 0.433 | 0.184 | 0.117 | 0.383 | 0.179 |
结论分析。论文的解读分三层:
- 头部 query 上,教师与学生都以略低的精确率换来了大幅的召回率增益,并转化为清晰的 F1 提升:GPT-5.1 达到 0.192、Qwen3 达到 0.184,而 Prod. 为 0.173。注意召回率的抬升幅度相当大——0.260 → 0.426 / 0.433(相对 +64% / +67%),而精确率仅从 0.130 掉到 0.124 / 0.117。这正是"发现"的预期形状:牺牲一点严格精确率,买到显著更宽的隐式需求覆盖。
- 关键在于长尾:在生产基线根本不覆盖的长尾 query 上,Qwen3 在三个指标上全部匹配或略微超过体量大得多的 GPT-5.1 教师(P 0.117 vs 0.108,R 0.383 vs 0.379,F1 0.179 vs 0.168)。论文据此判断,隐式意图生成路线有效扩展了类目级购买召回,同时保持了整体检索质量。
- 一个值得注意的细节是,学生在长尾上反超教师。论文没有把这解释为"学生更强",而是在 §5 的 Deployment Lessons 里给出线索:教师在标注时被喂了丰富的离线元数据,而学生在请求时拿不到这份 metadata payload;为此论文在蒸馏集里刻意混入一部分被剥离 metadata 的样本,使学生学会不依赖上下文载荷——这恰好让学生在"没有元数据可用"的长尾请求形态下更稳健。
LLM judge 与人工专家的一致性¶
Table 3: Alignment between LLM-Judge and Human Experts.
| Metrics | Title Relevance | Intent Relevance | Intent Novelty |
|---|---|---|---|
| Precision | 0.84 | 0.87 | 0.95 |
| Recall | 0.56 | 0.69 | 0.75 |
| F1 | 0.67 | 0.77 | 0.84 |
论文在 50 个三元组上计算 judge 与多数投票 ground truth之间的 precision / recall / F1。结论分析:一致性较强,尤其在精确率与 F1 上,确认 LLM judge 为模型对比提供了可靠信号。
但论文进一步做了一个重要的自我限定:LLM judge 使用的指标是主观的,且它倾向于比人类专家更严格。给出两个具体例子:
- query glass bowl:人类把标题 meal prep and portion control 评为相关,而 LLM 判为不相关;
- query kids lunch:意图词 grape tomatoes 被人类判为 novel,LLM 则没有。
因此论文明确指出:Table 4 中报告的分数很可能代表性能的一个保守下界(conservative lower bound)。这里 recall 显著低于 precision(0.56 / 0.69 / 0.75)也正与"judge 偏严"的判断一致——judge 漏判了不少人类认可的正例。
LLM judge 打分¶
Table 4: LLM Judge scores for all models.
| Query | Model | Title Relevance | Title Quality | Title Safety | Title Coherence | Intent Relevance | Intent Diversity | Intent Novelty |
|---|---|---|---|---|---|---|---|---|
| Head | Prod. | 0.941 | 0.983 | 0.995 | 0.964 | 0.911 | 0.917 | 0.853 |
| Head | GPT-5.1 | 0.967 | 0.995 | 0.996 | 0.977 | 0.966 | 0.968 | 0.898 |
| Head | Qwen3 | 0.938 | 0.985 | 0.995 | 0.918 | 0.930 | 0.894 | 0.911 |
| Tail | GPT-5.1 | 0.933 | 0.994 | 0.991 | 0.965 | 0.977 | 0.868 | — |
| Tail | Qwen3 | 0.889 | 0.988 | 0.990 | 0.903 | 0.930 | 0.887 | 0.888 |
说明:原表 Tail 行 GPT-5.1 的七个数值为 Title(0.933 / 0.994 / 0.991 / 0.933)、Intent(0.965 / 0.977 / 0.868);上表因排版对齐做了逐列还原,完整原始序列为 GPT-5.1 (Tail): 0.933, 0.994, 0.991, 0.933 | 0.965, 0.977, 0.868。
结论分析(论文原文):
- 教师模型 GPT-5.1 在头部 query 上全面稳定地优于生产基线,尤其是在 Intent Relevance、Diversity、Novelty 三项上。论文的解读是:标题的质量或许彼此接近(Prod. Title Quality 已达 0.983),但教师生成的意图检索到的是一个更多样、更新颖的商品集合——这正好解释了端到端评测里召回率的大幅抬升。
- 微调后的 Qwen3 成功保留了这些收益,在多数指标上与基线相当(comparably),而只用了 30% 的推理成本。
- 最显著的改进是 Intent Novelty:Qwen3 头部 0.911 超过 Prod. 的 0.853,甚至超过教师的 0.898。
- 需要注意学生的弱项是 Coherence(头部 0.918 vs 教师 0.977;长尾 0.903 vs 0.965)与 Intent Diversity(头部 0.894 vs 0.968)。这与 §5 中"Coherence 是对解码温度最敏感的指标"的观察互相印证:在同一 carousel 集合内保持主题不漂移,是蒸馏后学生最难守住的能力。
定性对比:Novelty 从哪来¶
Table 5: Qualitative comparison of carousels generated for the query cranberry juice.
| Title | Intents |
|---|---|
| Prod. | |
| Other fruit juices | orange juice, apple juice, grape juice, pineapple juice, mango juice |
| Healthy alternatives | pomegranate juice, watermelon juice, acai juice, ginger juice, blueberry juice |
| Qwen3 | |
| Other cranberry drinks | cranberry juice cocktail, 100 percent cranberry juice, cranberry apple juice, cranberry grape juice, cranberry flavored sparkling water |
| Light and fruity sippers | sparkling water, flavored seltzer, fruit punch, lemonade, sparkling iced tea |
| Office hydration station | mini juice boxes, single serve coffee pods, trail mix, desk water bottle, reusable snack containers |
结论分析。论文指出生产基线把自己限制在严格的分类学兄弟节点(strict taxonomic siblings)上——两个 carousel 都只是"其它果汁"。相比之下,微调 Qwen3 捕捉到了更宽的主题意图(如 Office hydration station),浮现出诸如零食容器(snack containers)与咖啡胶囊(coffee pods)这类非显而易见的互补品。论文明确把这条因果链串起来:这种改善的语义新颖性,直接对应到 §4.1 端到端评测里观察到的更高召回率。
这个例子也顺带暴露了发现的边界:Office hydration station 下的 reusable snack containers、desk water bottle 已经离原 query cranberry juice 相当远——这正是精确率从 0.130 掉到 0.117 的来源。论文没有掩盖这个 trade-off,而是用 F1 与会话级购买信号来论证净收益为正。
部署经验与局限性(Deployment Lessons and Limitations)¶
这是全文信息密度最高的一节,论文列出六条真实的失败模式与运营选择:
-
Distillation context gap(蒸馏上下文缺口)。教师是在丰富的离线元数据(品牌、属性、近期购买)条件下被调用的。而学生在请求时被查询、拿不到那份 metadata payload,结果长尾 query 上质量会静默退化(degraded silently)。缓解手段:在蒸馏集里有控制地混入一部分被剥离元数据的样本,使学生不依赖上下文载荷。
-
Coherence sensitivity to decoding(Coherence 对解码的敏感性)。Coherence(Table 4)是对解码温度最敏感的指标:高温让意图更多样,但导致标题在整个 carousel 集合上偏离主题(drift off-topic)。论文最终在留出切片上扫 Coherence 指标,选定 $T = 1.0$。
-
Long-tail policy(长尾策略)。对最深的约 20% 长尾,缓存 LLM 与 SLM 都无法产出可靠有用的意图;论文选择对这些 query 直接丢弃 carousel,而不是服务退化的结果——回落到 retrieval-only。
-
Maintenance(维护)。两项必要的周期性维护任务:(a) 随着 query 分布与目录漂移,周期性刷新头部与长尾标注;(b) 当教师被更新或其行为漂移时,重新蒸馏学生模型。
-
Hallucinated brand names(品牌名幻觉)。闭权重 LLM 偶尔会编造出听起来合理但并不存在的品牌(拼写错误或凭空发明的自有品牌)。论文的观察是:这类编造词在下游检索里通常返回稀疏或空结果,因此受影响的 carousel 对用户来说干脆就不可见——但论文同时承认,目前并没有在检索前对一份精选品牌词表做有效性校验。
-
Counterfactual bias in offline evaluation(离线评测的反事实偏差)。端到端指标源自日志会话数据,而这些数据本身就被当前的检索与排序系统所塑造。排除精确匹配与 top-10 排名结果能通过"隔离出那些用户尽管系统没有呈现却依然购买了的商品"来缓解这一偏差,但并不能消除它。
结论与未来工作¶
论文的结论提出两条元级教训(meta-lessons):
- 把生成与检索解耦,使 LLM 脱离用户可见的热路径(hot path),从而让缓存、降级(fallback)、灰度上线(rollout)都变得可处理;
- 双轨评测框架——会话派生的购买预测 + 人工校准的 LLM judge——为其它"标准相关性指标会给探索打低分"的发现型界面提供了一个模板。
论文同时主张:discoverability 应当被当作搜索系统的一等目标(first-class objective),尤其在互补结构强的领域;query 条件化的召回扩展提供了一个灵活机制,在纯检索与探索式推荐之间架桥,同时把结果锚定在用户的即时上下文里。
Future work 列出六项(这份清单同时也是本文局限的自陈):
- Non-LLM baselines:与 item-item 共购图(refs [3,13])及经典 query 改写做正面对比,以量化"LLM 生成意图"的边际价值,并设计在参与度数据稠密时回落到图信号的混合流水线;
- Online experimentation:大规模 A/B 量化对篮子大小、会话级营收、长尾供给曝光的影响,为会话派生的离线指标提供线上对照;
- Jointly optimizing 意图生成与商品排序,超越两阶段流水线;
- 用 RL 结合线上用户反馈(点击、加购)更新 SLM 权重;
- 进一步对齐离线评测数据集与 LLM-as-a-judge prompt,使其与线上业务指标相关;
- 通过引入用户历史与会话信息生成个性化意图。
核心贡献总结¶
- 把"发现"从模糊的产品诉求变成了可操作的任务定义:substitute / complement / thematic 三类意图 + $(t_i, \mathbf{e}_i)$ 的结构化输出契约($C=9$、$K=5$),与 query expansion(单一改写)和 item-item rec(query-free)划清界限。
- 生成-检索解耦是本文最可复用的架构决策:LLM 只输出自然语言意图词,商品由既有检索引擎 hydrate。这使得 LLM 不在用户可见热路径上,缓存 / 降级 / 灰度全部可控,也让"生成幻觉"退化为"检索空结果"这一自限性失效。
- 按 query 频次分层的成本架构:头部 10k query(60% 流量)离线缓存闭权重 LLM 标注;长尾 40% 用 LoRA(rank 8)微调的 Qwen3-30B 学生实时承接;最深 20% 主动放弃。净结果:覆盖 60% → 80%,成本约为教师的 30%。
- 一套可迁移的双轨评测方法论:(a) 从会话共同购买派生、主动剔除精确匹配与 top-10 结果的端到端购买预测数据集,配位置衰减 $w(n) = 1/\log_2(2+n)$;(b) 二值化、双层级(title / intent)的 LLM-as-a-judge,并用 50 个三元组做人工对齐审计,同时自陈 judge 偏严 → 分数是保守下界、judge 与教师同厂商 → 存在风格偏置。
- 罕见的诚实度:蒸馏上下文缺口、温度-Coherence 权衡、品牌幻觉无前置校验、离线评测反事实偏差、没有在线 A/B、没有非 LLM 基线——全部写进正文而非藏起来。
与已归档相关工作的对比¶
Hypothesis-Driven Shelf Generation for Personalised Recommendation Hypothesis-Driven Shelf Generation for Personalised Recommendations (Spotify, 2026-07-28)¶
关系:独立并发(本文未引用,两者相差一天挂到 arXiv,殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在攻同一个 root cause——面向发现的界面单元("carousel" / "shelf")长期由一套有限的、预定义的规则或严格匹配逻辑决定,无法覆盖「意图 × 场景 × 品类」组合的长尾。Instacart 的表述是"exact-match 范式 under-exposes 目录里的替代/互补/主题商品";Spotify 的表述是"每个人工货架模板都把『满足什么需求 / 什么内容算有效实现 / 用哪个系统去填充』这三个本可分离的决策耦合死了"。两者都进一步把这件事升格成曝光分配问题(Instacart 说长尾与新兴供给,Spotify 用均匀随机曝光实验测量内容池增益)。
- 相近的技术骨架:抽象后几乎是同一张流程图——LLM 生成一个自然语言的"行标题 / 假设"作为规划层的中间表示 → 用检索把这个自然语言概念接地(ground)到目录实体 → 把成品行作为候选注入既有排序去竞争 → 用 LLM-as-a-Judge 分阶段评测。连"生产环境用蒸馏后的小模型替代前沿 LLM 做生成、并用同一个 judge 做 parity check"这一步都撞上了:Spotify 报告蒸馏学生与前沿基线整体分 78.3% vs 78.2% 基本无损,Instacart 报告 Qwen3 学生在多数 judge 指标上与基线相当、Intent Novelty 甚至反超教师。
- 本文的差异与推进:(1) 触发条件不同——Instacart 是 query 条件化(用户已经打出了 cranberry juice),Spotify 是用户画像条件化(无 query,从行为证据推断)。这让 Instacart 的意图有一个天然的相关性锚点,而 Spotify 必须自己解决"假设是否对这个用户恰当"(其 User-to-Hypothesis Judge 正是为此隔离出来的)。(2) 接地方式不同——Instacart 刻意不碰检索,只把意图词丢给遗留检索引擎;Spotify 则专门训练了内容类型受约束的 Semantic-ID 生成式检索器,并证明它在全部七个 judge 维度上超过 BM25 / 稠密 / 混合基线(Overall 0.56 → 0.71)。(3) 成本轴的位置不同——Instacart 把成本问题放在架构正中央(按 query 频次分头/尾两级,60%→80% 覆盖 @ 30% 成本);Spotify 是全量离线预计算,成本靠"预算好再注入排序"消化。
- 可比的方法 / 实验差异:Spotify 还多做了一步 Instacart 没有的 Stage 3 对齐——用 LLM 从已检索候选里精选并重写标题/副标题,把 judge 整体分从 0.71 抬到 1.27(+78%),且明确指出对齐补不回检索阶段就没取到的标志性 item。这对 Instacart 是个直接可借的补丁:其学生模型最弱的两项恰是 Coherence(0.918/0.903)与 Intent Diversity(0.894),而这两项正是"事后对齐"最擅长修的。反向看,Spotify 披露了不利的线上数字(播客节目池 −41%、歌单 −14%),Instacart 则完全没有线上实验——两篇合起来才构成一个完整的风险图景:LLM 生成的发现行在某些内容/品类上是会亏的,而 Instacart 目前只有离线 F1 与 judge 分作为依据。
LLM-Based User Personas for Recommendations at Scale LLM-Based User Personas for Recommendations at Scale (Google / Google DeepMind, 2026-06-10)¶
关系:独立并发(本文未引用)· 已加载对方精读
- 共同关注的问题:两篇都指向"用 LLM 生成自然语言的用户意图表征"这件事在成本与延迟上无法覆盖全量流量这一 root cause。Google 的诊断是既有 LLM 用户理解工作"多为同步设计,代价与延迟无法部署到十亿用户规模,因此只在学术 benchmark 上评测";Instacart 的诊断是"把专有模型部署到整条 query 分布上——尤其长尾——成本上不可承受"。两者也都反对"绕开自然语言、直接输出结构化 ID"的主流做法,坚持自然语言中间表示(persona / carousel title)本身有不可替代的语义细腻度与可解释性。
- 相近的技术骨架:大教师 LLM 生成自然语言意图 → 知识蒸馏进小学生模型 → 用异步/离线 + 缓存的服务架构把学生塞进工业延迟预算 → 再把自然语言意图接地回 item 空间。Google 是 Gemini 1.5 Pro → Gemini Nano/Flash 加量化;Instacart 是 GPT-5.1 → Qwen3-30B 加 LoRA(rank 8)。两者的"接地"步骤也同构:Google 用 transformer 序列模型 + 受限最近邻检索(把检索限制在与文本兴趣语义相关的 item 子集内),Instacart 用意图词打进既有检索引擎——都是"把生成空间收束到自然语言意图之内,而不让 LLM 直接吐 item"。
- 本文的差异与推进:(1) 分层维度不同,这是最有意思的分歧。Google 是按用户全量铺开(所有人都算 persona,靠异步 + 量化压成本);Instacart 是按 query 频次分层——头部缓存、长尾走学生、最深 20% 直接放弃。后者承认了一个 Google 没有明说的事实:有一部分输入根本不值得投入 LLM。(2) 探索的来源不同:Google 把 exploration 做成 persona 的一个显式输出通道(Exploration Interests 与 Summarized Interests 在单次调用里一起产出),用 LLM 世界知识外推新主题来对抗反馈回路;Instacart 的"探索"是意图类型的结构化产物(thematic carousel),用 judge 的 Intent Novelty 指标度量。(3) 证据强度不同:Google 有 30+ 天十亿级 A/B(观看时长 +0.04%、活跃用户 +0.03%,增益集中在轻度用户)+ 用户调研(>80% 认为画像贴切);Instacart 只有离线双轨评测。
- 可比的方法 / 实验差异:Google 明确指出增益集中在 casual users——即系统对其历史信号最稀薄的那部分用户帮助最大。这与 Instacart 观察到的"学生在长尾 query 上反超教师"是同一现象的两个投影:自然语言意图生成的边际价值在信号最稀疏处最高。另一处可互相印证的细节是 Instacart 的 distillation context gap——教师有丰富离线元数据、学生在请求时没有,导致静默退化;Google 因为走的是纯异步离线生成,天然不存在这个"教师/学生输入分布不一致"的缺口,代价是放弃了对即时意图的响应(而 Instacart 的学生是实时服务长尾 query 的)。这构成一个清晰的设计权衡:要实时性,就得承担教师-学生输入不对称的蒸馏缺口。
AIR AIR: Atomic Intent Reasoning (HK PolyU + Kuaishou, 2026-06-09)¶
关系:独立并发(本文未引用)· 已加载对方精读
- 共同关注的问题:同一个 root cause 的另一种表述——在线 LLM 意图推理在毫秒级延迟约束下代价不可接受,而周期性离线画像又跟不上兴趣/分布漂移。AIR 把这两难写成明确的 First/Second 双难题;Instacart 则在 §5 的 Maintenance 里承认"必须周期性刷新头尾标注、必须在教师漂移时重新蒸馏"——正是 AIR 所说的漂移问题的另一面。两篇也都把电商 GMV / 购买作为最终裁判,而非纯相关性指标。
- 相近的技术骨架:把 LLM 的语义推理成本整体挪到离线,在线只做便宜的组装与检索。Instacart 的 tier-1 就是这个思路的最小实现:头部 10k query 的 LLM 标注全部离线算好灌进 offline feature store,在线零 LLM 调用。AIR 把同一思路推到极致——离线用 LLM 把用户事件拆成原子行为-意图对 $\mathcal{P}(e) = \{p_1,\dots,p_m\}$(层级意图路径),灌进意图知识库,在线只做检索 + 组装意图树,完全不调用在线 LLM,换来约 400× 吞吐增益与线上 +3.446% GMV。
- 本文的差异与推进:分歧点在于如何覆盖"缓存没命中"的部分,两篇给出了两条互斥的路线。AIR 走"原子化 + 组合泛化":把推理单元切到最小(单个行为事件),使任意长尾组合都能由已缓存的原子对拼出来——缓存天然全覆盖,代价是承认"整序列级语义推理"只能被原子意图的组合近似。Instacart 走"蒸馏一个学生实时补位":承认缓存注定只能覆盖头部,于是花 20k 条教师标注训一个 30B 学生实时兜住长尾,代价是引入了教师-学生质量差与上下文缺口。哪条更好取决于推理对象能否被原子化:AIR 的对象是用户行为序列(可切成事件),Instacart 的对象是query 的语义意图(切不动——cranberry juice 无法由更小的可复用单元组合出 Office hydration station" 这种主题联想)。这恰好解释了为什么两个团队在同一个成本困境下选了相反的解法。
- 可比的方法 / 实验差异:AIR 额外提供了 Instacart 缺的两块——公开 benchmark 上的 SOTA 对比与线上 A/B(+3.446% GMV);而 Instacart 提供了 AIR 没有的生成质量的内在评测(title/intent 双层级 judge + 人工对齐审计)。方法论上一个直接可借的点:AIR 的 target-aware intent retrieval(以目标 item 为条件在意图树上检索出紧凑高证据的意图链)本质是对生成的意图做后置筛选;Instacart 目前把 9 个 carousel 全量下发、只靠 Coherence 指标事后度量主题漂移,若引入类似的"以会话上下文为条件筛选 carousel"的一步,很可能同时改善其学生模型最弱的 Coherence(0.918/0.903)与精确率(0.117 vs Prod. 0.130)。
Step 2.5 剔除的近似候选与理由: - Efficient Clustering with Provable Guardrails for LLM Inference at Scale Efficient Clustering with Provable Guardrails for LLM Inference (Amazon) — 问题同构(LLM 推理成本在千万用户规模不可承受、靠代表点摊销),但解法是 Mini-batch K-Means + 集合覆盖式代表点选择让簇成员继承输出,与本文"按频次分层 + 蒸馏"骨架不同;且对象是 persona 而非 query 条件化的意图扩展。与 AIR 占同一生态位而距离更远,故不入选。 - RecGPT-Mobile RecGPT-Mobile (Alibaba) — 同样是"LoRA 压缩小 Qwen3 做意图生成",但 root cause 是端侧功耗与调用频次(靠 intent-drift trigger 把 LLM 调用降到 21%),任务是 next-query prediction(搜索框推荐)而非给定 query 后的召回扩展,问题层不同构。 - [[2606.06913]] OneSug / OneBar OneBar — 表面同为"电商场景生成 query",但两者都是用端到端生成式模型替换多级级联并直接优化 suggestion 界面本身;本文恰恰相反,刻意保留遗留检索栈、只在其上叠一层意图生成,且核心矛盾是成本分层,解法路径实质偏离。 - OneSearch-V2 OneSearch-V2 (Kuaishou) — 含"reasoning-internalized self-distillation"做 query 理解,蒸馏这一环相近,但发生在一个端到端生成式检索模型内部以消除推理开销,而非本文的头/尾两级成本架构;且优化目标是 CTR/订单量,不是发现型曝光。
讨论与局限性¶
值得借鉴的设计¶
第一,"生成-检索解耦"作为风险控制手段,而不只是架构偏好。 论文两次强调这一点(§3.2 与结论的 meta-lesson 1),而它的价值在 §5 的品牌幻觉那条里才完全显现:因为 LLM 只输出意图词而不是商品,一个被编造出来的品牌名在下游检索不到东西,于是那个 carousel对用户干脆不可见——幻觉自动退化为静默失效。这是一个非常干净的失效隔离设计:把 LLM 放在"提出候选语义"的位置,让目录充当事实校验器。任何要把 LLM 塞进生产搜索链路的团队都该抄这一点。
第二,按输入频次做成本分层,并且敢于对最难的一段直接放弃。 头部缓存 / 长尾蒸馏 / 最深 20% 不服务——这个三段式比"想办法覆盖 100%"务实得多。论文的理由也站得住:那 20% 是单字符、代码混写、错字严重的 query,教师与学生都产不出可靠意图,此时服务退化结果比不服务更糟。
第三,为"发现"专门造评测集,而不是硬套 NDCG。 端到端数据集构造里有三个刻意的动作值得注意:排除精确匹配(那是遗留栈的活)、排除 top-10 排名结果(否则测的是现有排序而非发现)、位置衰减加权(早期购买是更强的意图信号)。剩下的就是"用户尽管系统没呈现却依然买了的东西"——这是相当聪明的反事实近似。论文自己也诚实地说这缓解但不消除日志数据的反事实偏差。
局限与争议¶
创新层面偏工程组合。 剥开来看,方法骨架是"闭权重 LLM 生成结构化输出 + 缓存头部 + teacher-student 蒸馏 + LoRA 微调小模型接长尾"——每一块都是 2024 年以来相当成熟的手法,论文没有提出新的损失、新的架构或新的蒸馏目标(蒸馏损失就是在教师 JSON 输出上的标准 next-token 交叉熵)。真正原创的部分是任务定义与评测方法论,而非建模。
证据链有两个明显缺口,且都被论文自己承认。 (1) 没有在线 A/B——所有"发现有商业价值"的论证都建立在从日志派生的离线购买预测上,而论文同时承认该指标带反事实偏差。对一篇声称"discoverability 应当是一等目标"的论文,缺少线上营收/篮子大小证据是核心短板;并发的 Spotify 工作恰恰显示,同类生成式发现行在部分内容池上会亏(−41%)。(2) 没有非 LLM 基线——共购图(refs [3,13])与经典 query 改写都没有被正面对比,因此"LLM 生成意图"的边际价值并未被量化。论文自己把这两项列在 future work 首位。
评测框架的内部循环风险。 judge(GPT-5)与教师(GPT-5.1)同族,论文主动 flag 了这一偏置并承诺跨族审计;但更值得注意的是,Table 4 中被评为最优的头部模型正是教师自己(七项里六项第一),这个结论在同族 judge 下很难说是干净的。人工对齐只在 50 个三元组、3 个指标上做过,且 recall 只有 0.56–0.75,样本量对支撑七维度打分而言偏薄。
收益幅度需要放在正确的尺度上看。 头部 F1 从 0.173 → 0.192(教师)/ 0.184(学生),绝对量都在 0.18 上下——这是一个类目级、宽松定义下的指标(命中"会话内购买过的高层类目"即算 relevant),不宜与商品级检索指标类比。真正稳健的结论是召回率的相对抬升很大(+64%~+67%)而精确率仅小幅下滑,以及长尾从 0 覆盖变成有覆盖。
方法论可扩展性存疑处。 系统是显式两阶段解耦的:意图生成与商品排序无法端到端联合优化(论文把 "jointly optimizing" 列为 future work),且教师的能力上限就是学生的天花板——学生的提升路径依赖于换更强的教师并重新蒸馏(§5 Maintenance 明确把 re-distillation 列为周期性运维任务)。这意味着参数量 scaling 时,"如何表征意图"与"如何排序商品"两条路径不会同步增长。此外,carousel 结构被硬编码为 $C=9$、$K=5$,并未随场景自适应。
工业落地价值¶
即便缺少 A/B,这篇的落地信息量仍然可观,值得单独列出:
- 生产系统现状:offline feature store 覆盖 top ~10k query(60% 流量),标注由 GPT-3.5 Turbo 生成,即论文的 Prod. 基线;
- 升级路径:教师 GPT-5.1 标注 20k query(头尾 50/50),prompt 注入品牌/属性/概念标签/近期购买 + few-shot;70/30 切分;学生 Qwen3-30B-Instruct + LoRA(rank 8,bs 65536,lr 1e-4,1 epoch);
- 量化收益:覆盖率 60% → 80%,成本约为教师的 30%;
- 解码配置:$T = 1.0$,由在留出切片上扫 Coherence 指标确定——这个"用一致性而非多样性来定温度"的取法本身就是一条经验;
- 运维清单:周期性刷新头尾标注(应对 query 分布与目录漂移)+ 教师更新时重新蒸馏学生;
- 未做的护栏:检索前对精选品牌词表做有效性校验(目前依赖"检索空结果 → carousel 不可见"这一被动机制)。
对做电商/生鲜搜索的团队,这篇最实用的读法是把它当成一份成本分层 + 失效隔离的施工图:哪一段流量值得花 LLM、哪一段该蒸馏、哪一段该直接放弃、幻觉往哪里泄、离线指标怎么造才不至于自欺。方法创新有限,但这些工程判断在论文里很少见得这么完整。