Efficient Clustering with Provable Guardrails for LLM Inference at Scale¶
Amazon · HiLD 2026 (4th Workshop on High-dimensional Learning Dynamics) · arXiv:2607.19704v1 作者:Longshaokan Wang, Wai Tsang Keung, Punit Ghodasara, Roman Wang, Ali Dashti, Francesc Moreno-Noguer(均来自 Amazon)
研究动机与背景¶
把基于大语言模型(LLM)的应用扩展到数千万级用户时,真正的瓶颈不是模型质量,而是推理成本与延迟:现代基础模型对每一个输入都要跑一次昂贵的前向计算。一个自然的降本思路是——把输入聚类,只对每个簇的"代表"调用 LLM,簇内其他成员直接继承代表的输出。这本质上是一种"语义去重 + 输出复用",用一定的近似误差换取算力节省。
但这个思路对面向客户的业务(customer-facing)有一个致命约束:近似误差必须被显式控制。论文举了两个非常具体的风险例子——不相关的推荐会损害用户信任;最坏情况下甚至会引发安全隐患(例如把「有窒息风险的玩具」推给有幼儿的家庭)。因此,簇内成员与其代表之间必须"可度量地足够接近",否则复用输出就是不可接受的。
论文的落地场景是一条生产级个性化推荐流水线(Figure 1):客户的购物画像(shopping personas)经由一个 LLM 映射为个性化查询(Personalized Search Query Generation),随后检索商品并排序,最后再由一个基于 LLM 的「营销评审(Marketing Critic)」对结果做过滤。
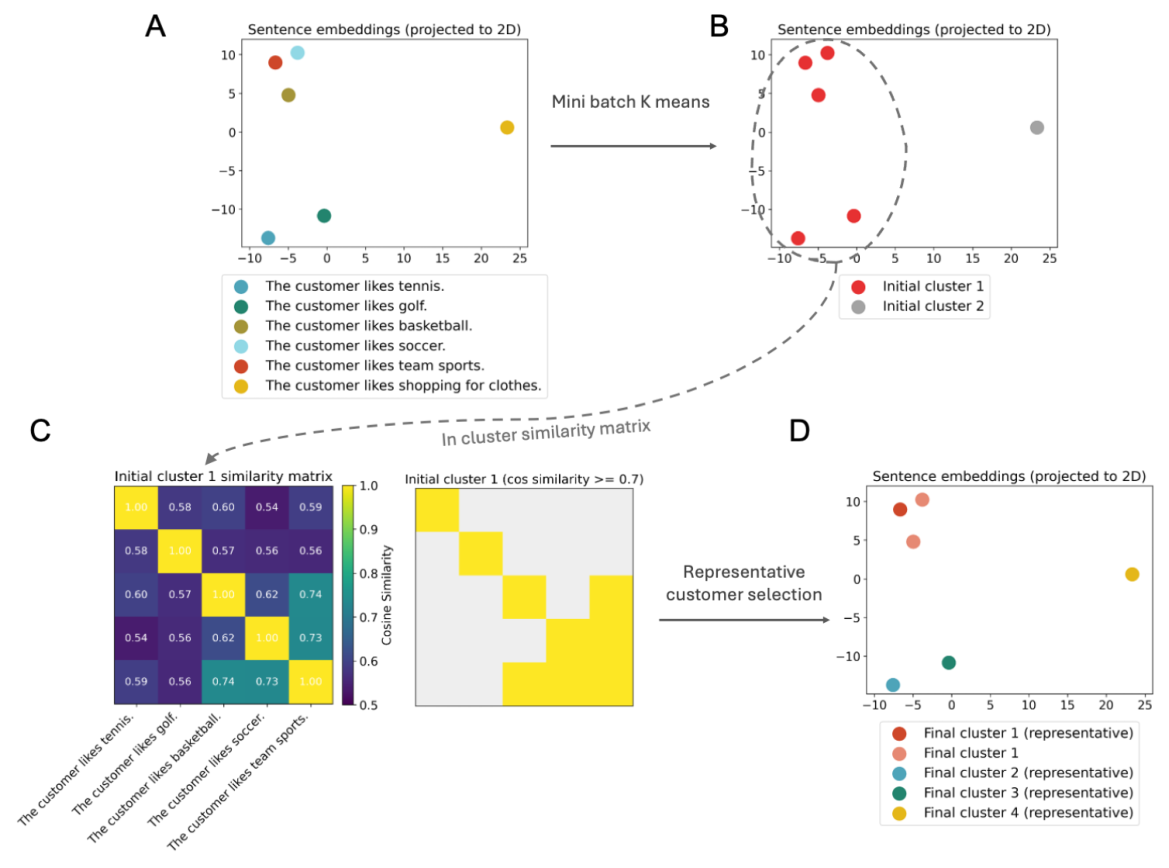
(注:Figure 1 在原文第 2 页,展示流水线:Shopping Personas / Household Attributes → Customer Clustering → Personalized Search Query Generation (LLM) → Query-to-Product Retrieval and Ranking → Marketing Critic (LLM) → Personalized Recommendations。上面引用的 fig_01.png 实为附录 Figure 2 的算法示意图,见后文"核心方法"一节。)
关键的成本数字:对 3800 万客户,仅这条流水线中的两个 LLM 阶段就要花费 $1.13M 成本、在分配到的吞吐下需要 508 天 wall-clock 时间。因此,在进入流水线之前对输入 personas 做聚类是必须的——但这个聚类必须同时满足四个要求(jointly):
- 相似度护栏:每个样本与其簇代表之间的语义相似度超过用户指定阈值 $\alpha$(逐样本的质量护栏);
- 属性护栏:同一簇内所有样本共享用户指定的类别属性(如家庭构成 household composition)完全一致;
- 数据压缩:簇数量显著小于初始样本量 $n$(目标 $\geq 10\times$ 缩减),以换取下游算力节省;
- 可扩展性:聚类本身的运行时、内存、成本能扩展到 $n \sim 10^7$,且相对下游 LLM 成本可忽略。
核心痛点:据作者所知,没有任何现有聚类方法能同时满足这四条。标准聚类方法(K-Means、GMM、BIRCH、Spectral)不接受"最小相似度"或"属性相等"约束;阈值型方法(Community Detection、Star Clustering、SimClus)虽然支持相似度阈值,但需要 $O(n^2)$ 的两两计算,无法扩展到 $n\sim 10^7$;词法近似去重(MinHash)处理不了改写(paraphrase)。与本文最接近的工作是 SemDedup(Abbas et al., ref [1],一种用于预训练数据高效学习的两阶段 embedding + 聚类方法),但本文在两点上与之不同:(i) 把属性相等约束与相似度约束联合强制执行;(ii) 用带重分配步骤的贪心 set-cover 代表选择,提升平均簇内相似度,并产生可用于"尾部裁剪"的重度右偏簇尺寸分布。
核心方法 / 模型架构¶
问题形式化(Problem Formulation)¶
设数据集 $\mathcal{D} = \{(P_i, \mathbf{A}_i)\}_{i=1}^{n}$,其中 $P_i$ 是文本内容、$\mathbf{A}_i$ 是类别属性。embedding 模型 $f_{\text{emb}}$ 把 $P_i$ 映射到 $\mathbf{E}_i \in \mathbb{R}^d$,$f_{\text{sim}}$ 表示余弦相似度。目标是找一个簇分配 $\hat{f}_{\text{cluster}} : \mathcal{D} \to \{1, \dots, n\}$(其像是代表索引的集合),使其满足护栏性质(guardrail property):
$$\hat{f}_{\text{cluster}}(P_i, \mathbf{A}_i) = j \implies f_{\text{sim}}(\mathbf{E}_i, \mathbf{E}_j) \geq \alpha \ \text{ and } \ \mathbf{A}_i = \mathbf{A}_j. \tag{1}$$
即:任何样本 $i$ 被分配到代表 $j$,则 $i$ 与 $j$ 的 embedding 相似度必须 $\geq \alpha$,且二者类别属性必须完全相同。
匹配关系(match relation):定义 $i \sim_\alpha j \iff f_{\text{sim}}(\mathbf{E}_i, \mathbf{E}_j) \geq \alpha \wedge \mathbf{A}_i = \mathbf{A}_j$,以及其 α-ball(可容许集) $\mathcal{B}_\alpha(i) = \{j : i \sim_\alpha j\}$。护栏要求:每个样本都必须被分配到一个"其 α-ball 覆盖它"的代表。关键洞察是:$\sim_\alpha$ 是自反、对称,但非传递(not transitive)的——正是"非传递"让这个聚类问题变得非平凡(相似不能传递,A 像 B、B 像 C 并不意味着 A 像 C,所以不能简单地用连通分量来聚类)。该形式化对任意特征向量与任意相似度/距离函数都成立。
两阶段算法(Algorithm 1)¶
Stage 1 — 初始聚类(Initial Clustering):对全部 embedding $\{\mathbf{E}_i\}$ 跑 Mini-batch K-Means,产生 $K$ 个初始簇 $\{C_k\}$。这一步不需要精确——后续的代表选择还会在每个初始簇内进一步细分。选 Mini-batch K-Means 是因为它比标准 K-Means 显著更快、更省内存,同时结果相近(Scully 2010)。
Stage 2 — 代表客户选择(Representative Customer Selection):在每个初始簇 $C_k$ 内独立执行:
- 计算簇内两两相似度矩阵 $S_{ij} = f_{\text{sim}}(\mathbf{E}_i, \mathbf{E}_j)$;
- 计算两两匹配矩阵 $M_{ij} = \mathbb{1}\{S_{ij} \geq \alpha \wedge \mathbf{A}_i = \mathbf{A}_j\}$;
- 迭代地选择"在剩余未匹配样本中,其 α-ball 覆盖最多样本"的点 $r^*$,将其设为代表,并把它匹配到的所有点分配给它;
- 移除已匹配样本,重复直到所有点都被覆盖。
伪代码(Algorithm 1):
Input : 数据集 D = {(P_i, A_i)}, embedding f_emb, similarity f_sim, 阈值 α, 初始簇数 K
Output: 簇分配 f_cluster, 满足 |f_cluster(D)| < |D|, 最小相似度 ≥ α, 属性匹配

/* Stage 1: Initial Clustering */
E_i ← f_emb(P_i)  for all i                    // personas → embeddings
C_init ← MiniBatchKMeans({E_i}, K)             // 生成初始簇

/* Stage 2: Representative Customer Selection */
for each initial cluster C_k in C_init:
    S_ij ← f_sim(E_i, E_j)   ∀ i,j ∈ C_k       // 簇内两两相似度
    M_ij ← 1{S_ij ≥ α ∧ A_i = A_j}  ∀ i,j∈C_k  // 簇内两两匹配
    U ← C_k                                     // 未匹配集合
    R ← ∅                                       // 代表集合
    while U ≠ ∅:
        M_i ← {j ∈ U : M_ij = 1}  ∀ i ∈ C_k    // 每点在未匹配集中的匹配
        r* ← argmax_{i∈C_k} |M_i|               // 匹配数最多的点
        R ← R ∪ {r*}                            // 加入代表集
        f_cluster(P_i, A_i) ← r*  ∀ i ∈ M_{r*}  // 把匹配点分给该代表
        U ← U \ M_{r*}                          // 移除已匹配点
return f_cluster
Set-Cover 视角与保证:在每个 $C_k$ 内,Stage 2 恰好是经典的 Johnson–Chvátal 贪心启发式 求解 Set Cover——覆盖集族为 $\mathcal{F}_k = \{\mathcal{B}_\alpha(i) \cap C_k : i \in C_k\}$,每次迭代挑选覆盖最多"仍未覆盖元素"的集合。由于 $\sim_\alpha$ 自反,每个元素至少被自己的 α-ball 覆盖,所以有效覆盖必然存在、贪心过程一定终止。贪心 set-cover 优先挑最大的未覆盖集,导致簇尺寸分布严重右偏(heavily right-skewed)——这是刻意设计的特性,使得可以对尾部小簇做激进裁剪(tail-trimming)以进一步压缩数据(详见 §4.2 与附录 F.1)。
可选的重分配步骤(Algorithm 2,Reassignment)¶
贪心选择是顺序相关的:某个点可能被早期选中的代表"抢先"覆盖,而这个代表未必是它最相似的。事后重分配(post-hoc reassignment) 把每个点重新分配给它"可行代表中最相似的那个",在保持代表集 $\mathcal{R}$ 和护栏 (1) 不变的前提下,严格提升平均簇内相似度。代价是:簇尺寸分布被抹平(flatter),略微降低尾部裁剪效率。
伪代码(Algorithm 2,在 Stage 2 内对每个初始簇可选应用):
Input : 初始簇 C_k, 代表集 R ⊆ C_k, 相似度矩阵 S, 匹配矩阵 M, 来自 Algorithm 1 的分配
Output: 更新后的分配 f_cluster,平均簇内相似度提升;最小相似度与属性匹配保证不变

for each customer i ∈ C_k:
    r* ← argmax_{r ∈ R : M_ir = 1} S_ir     // 找最相似的可行代表
    if r* exists:
        f_cluster(P_i, A_i) ← r*             // 重分配到最相似代表
return f_cluster
关键技术细节¶
形式化的护栏保证(附录 D)¶
Theorem 1(Algorithm 1 的护栏保证):对任意输入 $\mathcal{D}$、任意 embedding 函数 $f_{\text{emb}}$、任意对称相似度函数 $f_{\text{sim}}$(满足 $f_{\text{sim}}(x,x) \geq \alpha$)、任意阈值 $\alpha$、任意初始簇数 $K \geq 1$,Algorithm 1 返回的分配都精确满足护栏性质 (2)。即对每个 $i$,令 $r = \hat{f}_{\text{cluster}}(P_i, \mathbf{A}_i)$,有 $f_{\text{sim}}(f_{\text{emb}}(P_i), f_{\text{emb}}(P_r)) \geq \alpha$ 且 $\mathbf{A}_i = \mathbf{A}_r$。
证明要点:固定一个初始簇 $C_k$,考察 Stage 2。第 $t$ 次迭代时,$\mathcal{M}_i^{(t)} = \{j \in \mathcal{U}^{(t)} : M_{ij} = 1\} = \mathcal{B}_\alpha(i) \cap \mathcal{U}^{(t)}$。算法选 $r^{*(t)} = \arg\max_{i} |\mathcal{M}_i^{(t)}|$,把每个 $j \in \mathcal{M}_{r^{*(t)}}^{(t)}$ 分给它。由构造 $j \in \mathcal{M}_{r^{*(t)}}^{(t)} \implies j \in \mathcal{B}_\alpha(r^{*(t)})$,故 $f_{\text{sim}}(\mathbf{E}_j, \mathbf{E}_{r^{*(t)}}) \geq \alpha$ 且 $\mathbf{A}_j = \mathbf{A}_{r^{*(t)}}$。这些点随即从 $\mathcal{U}$ 中移除,Stage 2 内不会有点被二次分配,故每次迭代分配的点都满足 (2)。因 $\sim_\alpha$ 自反,$r^{*(t)} \in \mathcal{M}_{r^{*(t)}}^{(t)}$,每次至少移除一个点,故至多 $|C_k|$ 次迭代终止。Stage 1 把 $\{1,\dots,n\}$ 划分为 $\{C_k\}_{k=1}^K$、Stage 2 在每个 $C_k$ 内独立执行,保证扩展到全体 $\{1,\dots,n\}$。∎
Corollary 2(覆盖解释):Stage 2 在 $C_k$ 内选出的代表集 $\mathcal{R}_k$ 使 $\{\mathcal{B}_\alpha(r) \cap C_k\}_{r \in \mathcal{R}_k}$ 构成 $C_k$ 的一个有效覆盖,最终簇数恰为 $|\mathcal{R}| = \sum_{k=1}^K |\mathcal{R}_k|$。
Remark 3(初始聚类的角色):Theorem 1 对任意划分 $\{C_k\}$ 成立(包括平凡划分 $K=1$)。初始聚类的选择只影响最终簇数与运行时/内存,不影响护栏的正确性——这解释了 Table 3 中报告的经验鲁棒性。
Theorem 4(Algorithm 2 的护栏保证 + 单调性):重分配后的分配同样满足护栏 (2),且对每个样本 $i$,重分配后的相似度至少不低于原来的:$f_{\text{sim}}(\mathbf{E}_i, \mathbf{E}_{\hat{f}^{\text{new}}(P_i,\mathbf{A}_i)}) \geq f_{\text{sim}}(\mathbf{E}_i, \mathbf{E}_{\hat{f}^{\text{old}}(P_i,\mathbf{A}_i)})$。证明关键:原代表 $r^{\text{old}}$ 本身就是 $\mathcal{R}_k \cap \mathcal{B}_\alpha(i)$ 中的一个可行候选,故 argmax 的结果不会更差(单调性);且约束集非空,重分配总会执行。
Remark 5:Algorithm 2 不改动 $\mathcal{R}_k$,只在已有代表间重分配非代表样本,故簇数 $|\mathcal{R}|$ 对两个变体完全相同,而相似度只会弱增——这解释了 Table 1 中"Proposed w/ Reassign."在相同 $\alpha$、相同簇数下取得更高平均相似度。
Remark 6:重分配把质量从"最大簇"(最早被选中的)重分到小簇,抹平尺寸分布,因此尾部裁剪覆盖的客户数会略少(与 Figure 3/4 一致)。
Set-Cover 近似界(附录 D.5)¶
Stage 2 的贪心步是经典 Johnson–Chvátal 启发式。设 $\text{OPT}_k$ 是覆盖 $C_k$ 所需的最少 α-ball 数,则贪心给出:
$$|\mathcal{R}_k| \leq \text{OPT}_k \cdot (1 + \ln |C_k|),$$
故最终总簇数满足:
$$|\mathcal{R}| = \sum_{k=1}^K |\mathcal{R}_k| \leq (1 + \ln \max_k |C_k|) \sum_{k=1}^K \text{OPT}_k.$$
这给出了贪心代表选择相对于(NP-hard 的)最优覆盖在数据压缩效率上的形式化上界——注意这个界约束的是"数据压缩损失",不是正确性(护栏是精确成立的,非近似)。Remark 7 进一步区分了"分区约束最优" $\mathcal{R}^*_{\text{partition}}$ 与"全局最优" $\mathcal{R}^*_{\text{global}}$:因为被分到不同初始簇的两个相似客户无法共享代表,二者存在 gap,但该 gap 由初始聚类质量控制,实验证明 Mini-batch K-Means 已足够小(Table 3)。
复杂度分析(附录 E)¶
设 $n$ 为样本数、$d$ 为 embedding 维度、$K$ 为初始簇数、$a$ 为属性向量维度、$n_k = |C_k|$。
Stage 1(Mini-batch K-Means):$T_{\text{Stage 1}} = O(T_1 b K d)$ 时间、$M_{\text{Stage 1}} = O((n+K)d)$ 内存。因 batch size $b$ 与迭代数 $T_1$ 是与 $n$ 无关的常数,Stage 1 实际是 $O(nd)$ 内存、$O(Kd)$ 摊还时间/mini-batch。
Stage 2(每个初始簇内):
- (a) 两两相似度矩阵 $S_{ij}$:$O(n_k^2 d)$ 时间、$O(n_k^2)$ 内存;
- (b) 属性匹配矩阵 $M_{ij}$:$O(n_k^2 a)$ 时间;实践中可预计算属性组 ID($O(n_k a)$)把两两属性检查降到 $O(1)$,即 $O(n_k^2)$;
- (c) 迭代贪心代表选择:维护 $M$ 的行和向量,初始化 $O(n_k^2)$,每次迭代选 $r^*$ 为 $O(n_k)$,更新行和为 $O(|\mathcal{M}_{r^*}^{(t)}| \cdot n_k)$。因 $\mathcal{M}_{r^*}^{(t)}$ 划分 $C_k$,$\sum_t |\mathcal{M}_{r^*}^{(t)}| = n_k$,所有更新总成本 $O(n_k^2)$。故贪心循环 $O(n_k^2)$ 时间。
每簇 Stage 2:$T_{\text{Stage 2}}(C_k) = O(n_k^2 d + n_k^2) = O(n_k^2 d)$,$M = O(n_k^2)$。
聚合 Stage 2(逐簇处理,只在内存中保留一个两两矩阵):
$$T_{\text{Stage 2}} = O\!\left(d \sum_{k=1}^K n_k^2\right), \quad M_{\text{Stage 2}} = O\!\left(\max_k n_k^2\right).$$
若初始簇大致平衡 $n_k \approx n/K$:
$$T_{\text{Stage 2}} = O\!\left(\frac{n^2 d}{K}\right), \quad M_{\text{Stage 2}} = O\!\left(\frac{n^2}{K^2}\right).$$
总复杂度:
$$T_{\text{total}} = O\!\left(T_1 b K d + d\sum_{k=1}^K n_k^2\right), \quad M_{\text{total}} = O\!\left(nd + \max_k n_k^2\right).$$
平衡情形下:$T_{\text{total}} = O(nd + n^2 d/K)$,$M_{\text{total}} = O(nd + n^2/K^2)$。当 $K = \Theta(n)$(即 $n_k = O(1)$)时,Stage 2 退化为 $O(nd)$,整体算法对 $n$ 线性。这正是能扩展到 $n \sim 10^7$(乃至 3800 万)的根本原因:$K$ 随 $n$ 成比例增长时,$O(n^2)$ 的两两计算被限制在每个大小 $\approx n/K$ 的初始簇内,$O(\max_k n_k^2) \ll O(n^2)$。
$K$ 是一个可扩展性旋钮:更大的 $K$ 线性减少 Stage 2 时间、平方减少峰值内存,但引入分区噪声——把本可同簇的相似样本切到不同初始簇,轻微增大 $|\mathcal{R}|$(降低压缩效率)。实践建议:在延迟/内存预算允许下取尽可能小的 $K$。
与 baseline 复杂度对比(附录 E.5):K-Means $O(nKdT)$;Mini-batch K-Means $O(bKdT)$;Agglomerative(Ward) $O(n^2 d)$ 时间、$O(n^2)$ 内存;BIRCH $O(nd)$ 摊还但常数大;Spectral $O(n^3)$ 时间、$O(n^2)$ 内存;GMM(EM) $O(nKd^2 T)$。没有一个 baseline 支持用户指定的最小簇内相似度约束,且 Agglomerative/Spectral 的 $O(n^2)$ 内存在 $n = 38\text{M}$ 时高达 $\sim 90\text{TB}$($n=5\text{M}$ 时也不可行),彻底不可扩展。
实验设置¶
- 数据集:三个 100K 样本子集——(i) 内部客户购物 personas(工业数据);(ii) AG News(新闻分类);(iii) Cosmopedia(合成教科书语料)。选 100K 是因为几个 baseline(Agglomerative、Spectral)超过该规模就变得不可行(intractable)。
- Embedding 模型:
all-MiniLM-L6-v2(SentenceTransformer)。选型标准:输出 embedding 同时支持欧氏距离(Stage 1 Mini-batch K-Means 用)和余弦相似度(Stage 2 代表选择用);跨多数据集表现好且延迟合理。 - 硬件:单台
r7i.12xlarge,无并行化(即报告的时间是单机单进程的保守值)。 - 公平对比设定:由于 baseline 不接受 $\alpha$ 约束,改为固定簇数对比——先跑本文算法($\alpha$ 取 0.75/0.3/0.4 分别对应三数据集、目标 $\sim 50\times$ 数据缩减),再让每个 baseline 跑到匹配的簇数。
- baseline:Mini-batch K-Means、K-Means、Agglomerative(Ward)、BIRCH、Spectral、Gaussian Mixture。scikit-learn 1.7.2 默认超参(Spectral 略调)。关键超参:Mini-batch K-Means
max_iter=100, batch_size=10240, init_size=30720, random_state=123;K-Meansk-means++, n_init=auto, max_iter=300, lloyd;Agglomerativeeuclidean, ward;BIRCHthreshold=0.5, branching_factor=50;Spectralnearest_neighbors, n_neighbors=10, lobpcg;GMMfull, init=kmeans, max_iter=100。
主要实验结果¶
簇内相似度与运行时(Table 1)¶
在匹配簇数下,报告平均相似度(Avg. Sim.)、最小相似度(Min. Sim.,即最坏情况样本-代表相似度)、低于阈值样本比例(Perc. Below Thresh.)、运行时(秒):
| Method | | Shopping Avg | Min | Below% | Time(s) | | AG News Avg | Min | Below% | Time(s) | | Cosmopedia Avg | Min | Below% | Time(s) |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Proposed | 0.802 | 0.750 | 0.0% | 2.7 | 0.413 | 0.300 | 0.0% | 4.2 | 0.512 | 0.400 | 0.0% | 6.8 |
| Proposed w/ Reassign. | 0.825 | 0.750 | 0.0% | 2.7 | 0.490 | 0.300 | 0.0% | 4.2 | 0.588 | 0.400 | 0.0% | 6.8 |
| Mini-batch K-Means | 0.819 | 0.554 | 6.1% | 44 | 0.553 | 0.006 | 5.7% | 33 | 0.619 | -0.005 | 4.3% | 91 |
| K-Means | 0.828 | 0.600 | 2.9% | 154 | 0.561 | -0.038 | 4.9% | 136 | 0.630 | 0.133 | 2.9% | 296 |
| Agglomerative | 0.812 | 0.542 | 10.3% | 1778 | 0.543 | -0.108 | 9.6% | 2854 | 0.608 | 0.007 | 7.0% | 2851 |
| BIRCH | 0.799 | 0.558 | 14.0% | 28 | 0.536 | -0.068 | 9.2% | 878 | 0.603 | -0.001 | 7.0% | 1337 |
| Spectral | 0.807 | 0.445 | 11.3% | 6281 | 0.505 | -0.186 | 21.2% | 1221 | 0.592 | -0.077 | 13.9% | 1804 |
| Gaussian Mixture | 0.846 | 0.618 | 0.8% | 5548 | 0.562 | 0.006 | 4.8% | 1898 | 0.630 | 0.090 | 3.0% | 4254 |
两个核心结论: 1. 护栏精确性:每个 baseline 都在非平凡比例的样本上违反护栏(Min. Sim. 远低于 $\alpha$,Below% 达 3–21%),而本文方法按构造精确满足(Min. Sim. 恰等于 $\alpha$、Below% = 0.0%)。这是本文相对所有标准聚类方法的定性优势——不是"更好",而是"提供了别人根本不提供的逐样本质量保证"。 2. 速度:本文方法比 baseline 快 $10\times \sim 1000\times$(如 Shopping 上 2.7s vs Spectral 6281s ≈ 2300×,vs GMM 5548s ≈ 2000×)。原因是 $O(n^2)$ 相似度计算被限制在每个大小 $\approx n/K$ 的初始簇内,而非整个数据集。值得注意:即便单跑 Mini-batch K-Means($K = |\mathcal{R}|$,即直接聚成最终簇数)也比本文两阶段方法慢 $>10\times$,因为在如此多的簇上跑 K-Means 会被"跨大量簇的质心更新"主导。
(注:GMM/K-Means 的平均相似度偶尔略高于本文,但这是以违反护栏为代价换来的——它们没有 Min. Sim. 底线保证;且慢 2–3 个数量级。)
簇尺寸右偏与尾部裁剪(§4.2,附录 F.1)¶
set-cover 贪心优先选最大未覆盖集,产生重度右偏的簇尺寸分布(Figure 3/4)。实用意义:内部数据上前 4% 的最大簇就覆盖了 90% 的客户,裁掉尾部可再得 $25\times$ 数据缩减,代价只是丢弃一小部分用户(可在上游通过 oversampling 补偿)。baseline 追求平衡簇,在同样 4% 阈值下最多只覆盖 $\sim 30\%$。重分配变体会部分抹平该分布,用尾部裁剪效率换取更高平均相似度。
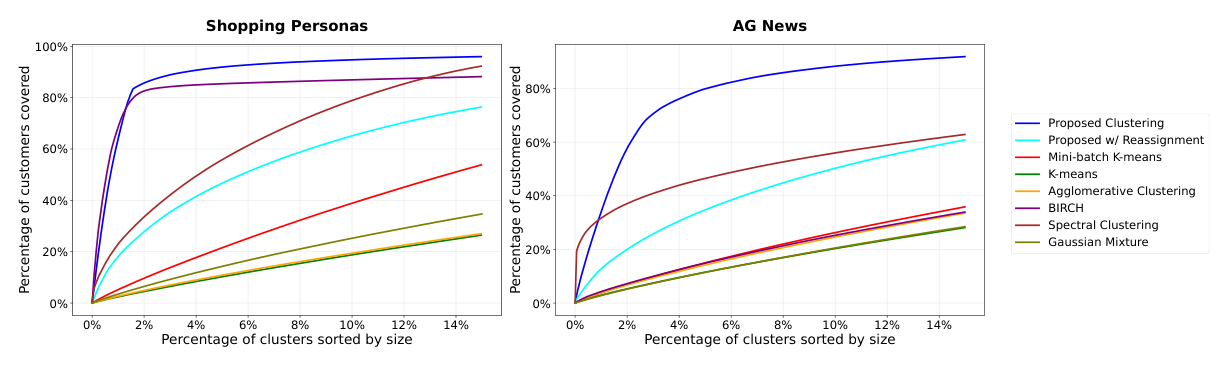
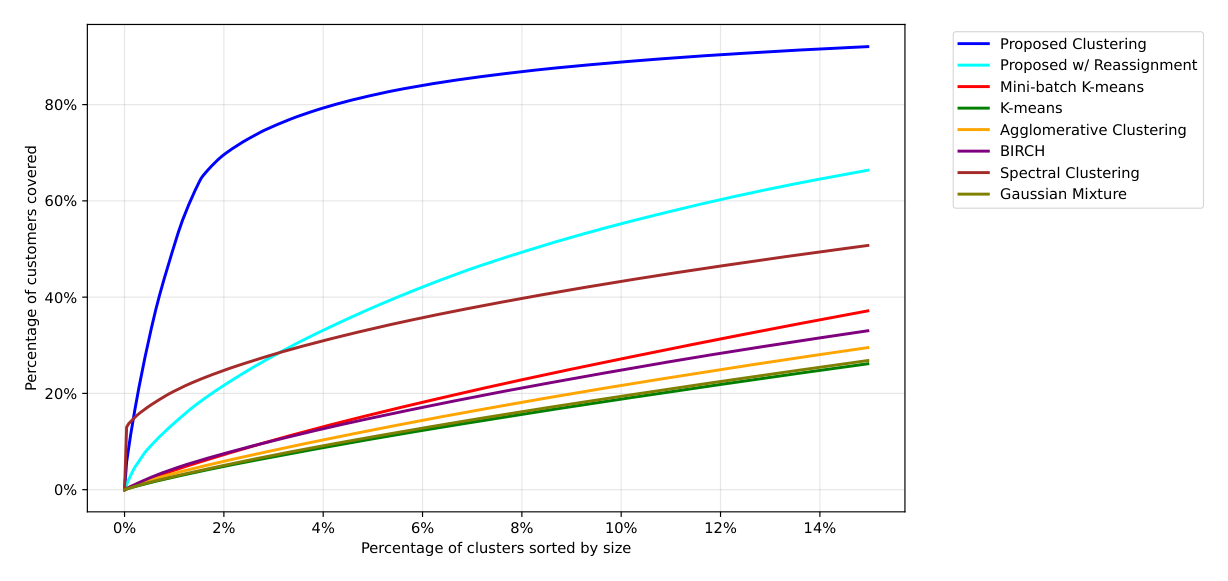
两图横轴为"按尺寸排序的簇的百分比",纵轴为"覆盖客户百分比"。Proposed Clustering(蓝)曲线在极小的簇比例处就陡升到 ~90%,远高于所有 baseline;Proposed w/ Reassignment(青)次之;Mini-batch K-Means(红)等 baseline 近乎线性缓慢上升。这直观印证了尾部裁剪的巨大压缩潜力。
相似度作为推荐相关性的代理(§4.3,附录 F.2)¶
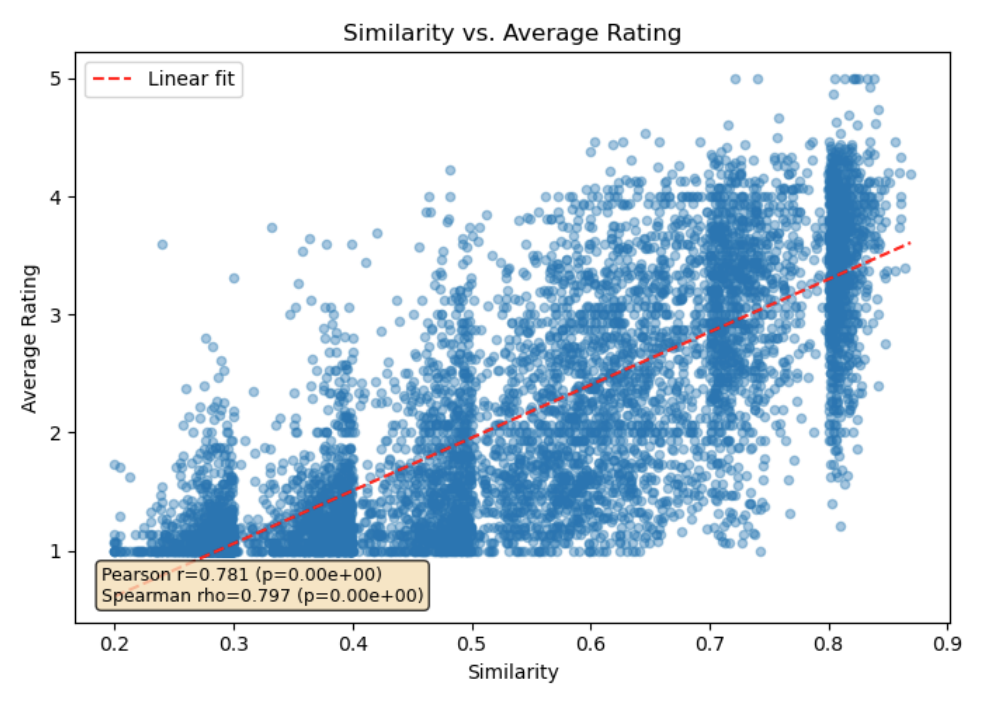
护栏 (1) 只有在"簇内相似度与下游推荐相关性正相关"时才有用。作者做了分层验证:在 7 个相似度桶(0.2–0.9)上分层采样 7,000 对 member–representative pair,每对生成 15 条推荐,由基于 LLM 的 Marketing Critic 对每个 (member, product) 对在 1–5 相关性尺度打分。结果:pair 相似度与平均相关性的 Pearson 相关 0.781 / Spearman 0.797($p < 0.001$),实证验证了 embedding 相似度可作为推荐相关性的代理。
超参鲁棒性(Table 3,附录 F.4)¶
在 100K Shopping Personas 上扫 Mini-batch K-Means 的 batch size / init size / 初始簇数 $K$(10/50/250):最小相似度始终精确锁定在 0.750(护栏不受任何超参影响,与 Remark 3 一致);平均相似度 0.823–0.826 几乎不变;最终簇数在 2029–3104 间浮动、数据缩减 32–49× 随 $K$ 增大而轻微下降;Stage 2 时间随 $K$ 增大显著下降($K=10$ 时约 13–15s,$K=250$ 时约 0.9–1.0s),Stage 1 时间随 $K$ 增大而增加(0.12→1.69s)——完美印证复杂度分析中 $K$ 的作用。
最小相似度与属性约束对压缩的影响(Table 2,附录 F.3)¶
在 5M 客户上扫 $\alpha$ 与是否要求属性匹配:
| 属性要求 | Min Sim | 簇数 | Avg Sim | 保留数据比例 | 压缩倍数 |
|---|---|---|---|---|---|
| None | 0.65 | 2,344 | 0.794 | 0.05% | 2133× |
| None | 0.70 | 5,012 | 0.812 | 0.1% | 998× |
| None | 0.75 | 26,868 | 0.824 | 0.5% | 186× |
| None | 0.80 | 230,262 | 0.840 | 4.6% | 22× |
| None | 0.85 | 1,694,033 | 0.904 | 33.9% | 3× |
| None | 0.90 | 4,695,169 | 0.994 | 93.9% | 1× |
| adult gender/count, child presence/gender/age | 0.65 | 44,285 | 0.792 | 0.9% | 113× |
| (同上属性) | 0.70 | 49,804 | 0.809 | 1.0% | 100× |
| (同上属性) | 0.75 | 97,298 | 0.824 | 1.9% | 51× |
| (同上属性) | 0.80 | 435,727 | 0.846 | 8.7% | 11× |
| (同上属性) | 0.85 | 2,146,887 | 0.916 | 42.9% | 2× |
| (同上属性) | 0.90 | 4,787,855 | 0.996 | 95.8% | 1× |
结论:$\alpha$ 越高、簇越多、压缩倍数越小(相似度与压缩是根本 trade-off);增加属性匹配约束会显著增加簇数(如 $\alpha=0.75$ 时从 26,868 增至 97,298,压缩从 186× 降至 51×)——因为属性硬约束进一步细分了簇。即便在较高的 0.75 阈值下仍能保持 51–186× 压缩。
生产部署(§5)¶
- 时间/规模:2025 年 6 月在 Figure 1 的推荐流水线上做了 A/B 测试,针对 3800 万客户。
- 护栏配置:$\alpha = 0.77$,属性精确匹配 adult gender / adult count / child presence / child gender / child age。$\alpha=0.77$ 经离线验证选定——在推荐相关性与"分配的 LLM 预算所施加的吞吐上限"之间平衡;属性约束反映 embedding 相似度无法捕捉的商品安全考量(如年龄适宜性)。
- 降本效果:聚类实现 $\sim 50\times$ 数据缩减——
- LLM 查询生成步:$114,000 / 22.8 天 → $2,100 / 0.4 天;
- Marketing Critic 步:$1,018,500 / 485 天 → $20,370 / 9.7 天;
-
合计下游 LLM 算力与 wall-clock 约 50 倍缩减。
-
质量验证:对 5,000 对 representative–member pair 应用 Marketing Critic,product-to-member 相关率仅比 product-to-representative 率低 0.7%——确认 α-护栏带来的端到端质量损失极小,相对 $\sim 50\times$ 的算力/延迟节省完全可接受。
- 业务收益:A/B 显示统计显著的业务指标正向提升,并解锁了原本被阻塞的生产上线,后续多个功能都建立在同一套聚类基础设施之上。
核心贡献总结¶
- 带精确护栏的简单两阶段聚类算法(相似度 + 属性双护栏),并给出 set-cover 近似界刻画数据压缩效率(附录 D);
- 复杂度分析:$O(nd + n^2 d/K)$ 时间、$O(nd + n^2/K^2)$ 内存,$K = \Theta(n)$ 时对 $n$ 线性(附录 E);
- 在内部 + 公开数据上对六种标准聚类方法的 benchmark,在匹配簇数下取得 $10\times$–$1000\times$ 加速、并唯一提供逐样本护栏(§4);
- 对 3800 万客户的生产部署,下游算力 50 倍缩减、解锁上线(§5)。
讨论与局限性¶
值得借鉴的设计:
- 把"LLM 推理降本"重新表述为"embedding 空间上 α-ball 的贪心 set-cover"——这个 reframe 非常干净,直接把一个模糊的工程问题("怎么少调点 LLM 又不出事")转成一个有经典算法与理论保证的组合优化问题。
- 护栏是"by construction 精确成立"而非"近似/期望成立"——对面向客户、涉及安全的业务,这种硬保证比"平均更好"重要得多。这是本文相对 SemDedup 等纯 embedding 聚类的关键差异。
- 把两阶段(初始 K-Means + 簇内 set-cover)解耦,用初始聚类把 $O(n^2)$ 限制在小簇内,是让方法扩展到千万级的工程核心。且 Theorem 1 证明初始聚类只影响效率不影响正确性,给了实现极大自由度。
- 簇尺寸右偏 + 尾部裁剪:把"缺点"(贪心导致的不平衡)转化为"特性"(可激进裁尾再压缩),思路巧妙。
局限与争议:
- 方法本身在算法上并不新颖:Stage 1 是现成的 Mini-batch K-Means,Stage 2 是 1970 年代的 Johnson–Chvátal set-cover 贪心。本文的贡献主要在问题建模 + 工程落地 + 理论包装,而非新算法。作为 HiLD workshop 论文,这个定位是合理的。
- 护栏质量完全依赖 embedding + 相似度阈值:$f_{\text{sim}}(\mathbf{E}_i, \mathbf{E}_j) \geq \alpha$ 只保证 embedding 相似,不直接保证"LLM 对二者的输出真的应该相同"。§4.3 用 0.781 的相关系数做了间接验证,但这只是相关而非因果——存在 embedding 相似但 LLM 输出应不同的失败模式(长尾 corner case)。作者在结论中也承认,未来方向是"更能预测 LLM 输出一致性的相似度度量"。
- 属性护栏是硬编码的人工约束:需要业务方手工指定哪些类别属性必须匹配(如儿童年龄),不是学出来的;漏掉某个关键安全属性会直接导致护栏失效。
- 相似度-压缩的根本 trade-off 无法回避:Table 2 显示要拿到高压缩就得容忍较低 $\alpha$,而 $\alpha$ 太低护栏就形同虚设。50× 压缩对应 $\alpha=0.77$ 是这条流水线在其 LLM 预算下的甜点,换个场景需重新标定。
- 可扩展性依赖初始簇平衡假设:复杂度的线性结论建立在 $n_k \approx n/K$ 上;若 Mini-batch K-Means 产出严重不平衡的初始簇(某个 $C_k$ 极大),Stage 2 的 $O(\max_k n_k^2)$ 内存会成为瓶颈。
工业落地价值:非常高且高度可迁移。这不是一个绑定推荐场景的技巧,而是一个通用的"LLM 推理降本 + 逐样本质量护栏"模式——任何"对大量语义相近输入批量调用 LLM"的场景(批量摘要、批量分类、批量改写、批量打标)都可套用。有真实的 3800 万客户部署、量化的 50× 成本/延迟下降($1.13M → $22K 量级)、明确的上线解锁与业务收益,且实现依赖的都是成熟组件(SentenceTransformer + scikit-learn),复现门槛低。这是它拿到 7 分精读评价的主要原因。