Knowledge–Geometry Decoupling: Refreshable Pretrained Transfer for Streaming Recommendation¶
KGD 来自厦门大学(Xiamen University)与 Shopee 的联合团队,作者为 Zixuan Wang、Yuhong Chen、Yuxuan Zhu、Guidong Lei、Zhiluohan Guo、Yu Zhao、Kun Wang、Bangyang Hong、Kangle Wu、Yabo Ni、Anxiang Zeng、Cong Fu、Hui Li(通讯)。论文于 2026 年 8 月 3 日提交 arXiv(2608.02738),核心实现已开源于 https://github.com/FuCongResearchSquad/KGD4REC。
这篇论文回答的问题非常具体:当工业推荐系统采用"生成式预训练 → 判别式迁移"的范式,而底层数据分布每天都在漂移时,预训练模型必须被持续刷新(refresh)——那么 (1) 到底该从行为序列里学什么知识,(2) 又该如何在刷新不断进行的同时把知识迁移给下游任务? 论文给出的答案是 Knowledge–Geometry Decoupling (KGD):用 BMTP 解决"学什么",用 参数所有权分离(read-only 交叉注意力 + Anchored Calibration Residual) 解决"怎么迁"。
研究动机与背景¶
推荐系统的 pretrain-then-transfer 与语言/视觉的关键差异¶
在语言和视觉里,"大规模预训练一次 + 迁移到下游任务"已是默认配方。工业推荐也在认真采用这一路线:在用户行为序列上用 next-token 目标预训练 Transformer,再用它初始化或增强 CTR 估计、排序等生产模型;近期工作(GPSD,Wang et al. 2025)表明这个配方能解锁纯判别式训练达不到的 scaling 行为。
但作者强调,推荐场景的"迁移"在结构上就不一样:语言/视觉里模型通常预训练一次、此后不断迁移;而推荐里行为分布持续漂移,预训练必须在系统的整个服务生命周期里被不断刷新。
论文把漂移拆成两种互相叠加的成分:
- 物料池换血:新内容、新 listing、新营销活动持续进入与老化退出;
- 更受众换血(更关键):用户到达不均匀、回访间隔不规则。因此一条用户行为序列不是一条连续的意图轨迹,而是若干独立兴趣 session 的拼接。
这个"拼接"直接腐蚀了预训练所依赖的监督信号:跨越 session 边界时,相邻不再意味着依赖,而把每一对相邻 item 都当训练信号的目标函数会把噪声写进表征。同时漂移让任何固定表征迅速过时,所以预训练必须刷新;但在任务优化同一批权重的同时刷新预训练参数,等于把两个冲突目标压到同一个参数集上。
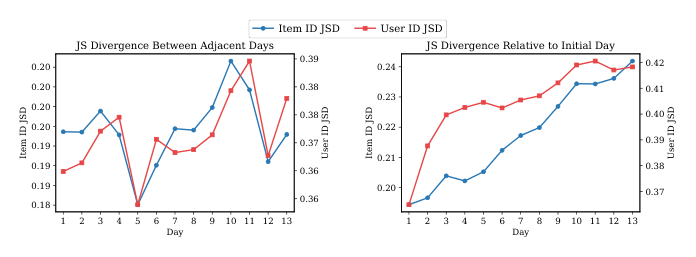
附录 B.1 给出了漂移的量化证据:在工业流上计算每日 item 交互分布与固定参考日之间的 Jensen–Shannon 散度(JSD),该散度持续上升而非饱和,说明物料池与受众都在持续换血,任何固定快照都无法长期代表行为分布。
Q1:学什么(What to learn)¶
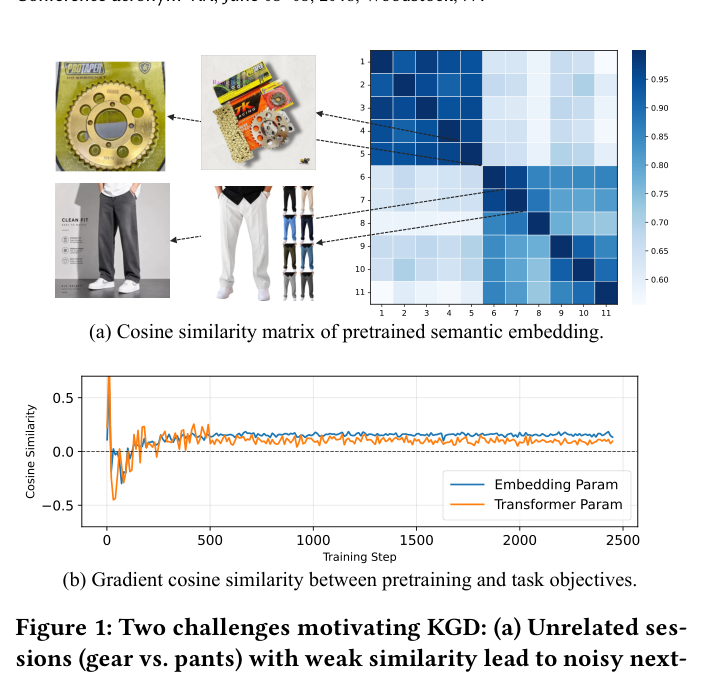
序列预训练几乎原封不动照搬了语言模型的自回归目标——从每个位置预测下一个(或接下来几个)item,从而把相邻当作依赖。但在推荐里相邻远不蕴含依赖:Fig. 1(a) 展示了 Shopee 上一条真实用户序列,由"自行车齿盘配件"和"裤子"两段连续子序列组成,对这类不相关 item 之间的依赖建模只会给下游任务留下噪声表征。图中热力图是这条序列各 item 语义 embedding 两两余弦相似度:session 内部相似度很高(深色对角块),跨 session 边界则直接坍塌。
作者指出既有的去噪补丁都只解决了一半问题:
- 基于注意力的去噪(Dual Sparse Attention, Yuan et al. 2021)在表征里降权不相关 item,但目标函数仍然在原始转移上做监督,模型仍被迫拟合虚假依赖;
- 基于 LLM 的重标注(LLM4DSR)直接改写噪声交互,但需要逐序列的 LLM 推理,在十亿级日志上每次刷新都重跑一遍完全不现实。
附录 B.2 还补充了一个更现实的观察:在真实业务里,一种兴趣可能跨天、跨多次登录持续(用户在连续几次访问里反复搜同一品类),机械按时间/session id 切分反而会切断真实依赖;而单个 session id 也可能拼接了不相关意图(用户在浏览零食时被推了一条裙子并去追它)。所以"机械分段"两个方向都会引入噪声,干净的 session 根本切不出来。BMTP 的做法是彻底放弃分段,改为在监督层面去噪:只要一对 item 在协同或语义任一轴上足够接近就保留,检验关系而不是位置,因此能跨越表面边界保留真实依赖。
Q2:怎么迁(How to transfer)¶
Fig. 1(b) 是论文在 Shopee 推荐系统上做的关键测量:在联合优化时计算预训练损失梯度 $\nabla_\theta\mathcal{L}_\mathrm{pre}$ 与任务损失梯度 $\nabla_\theta\mathcal{L}_\mathrm{task}$ 在同一参数组上的余弦相似度,结果长期在 0 附近徘徊、时而为负(embedding 参数与 Transformer 参数皆然)。这说明预训练知识与任务几何对同一批参数提出的是互相冲突的优化要求。附录 B.3 的 Fig. 5 把这个测量扩展到 8 个 Amazon 基准,结论一致。
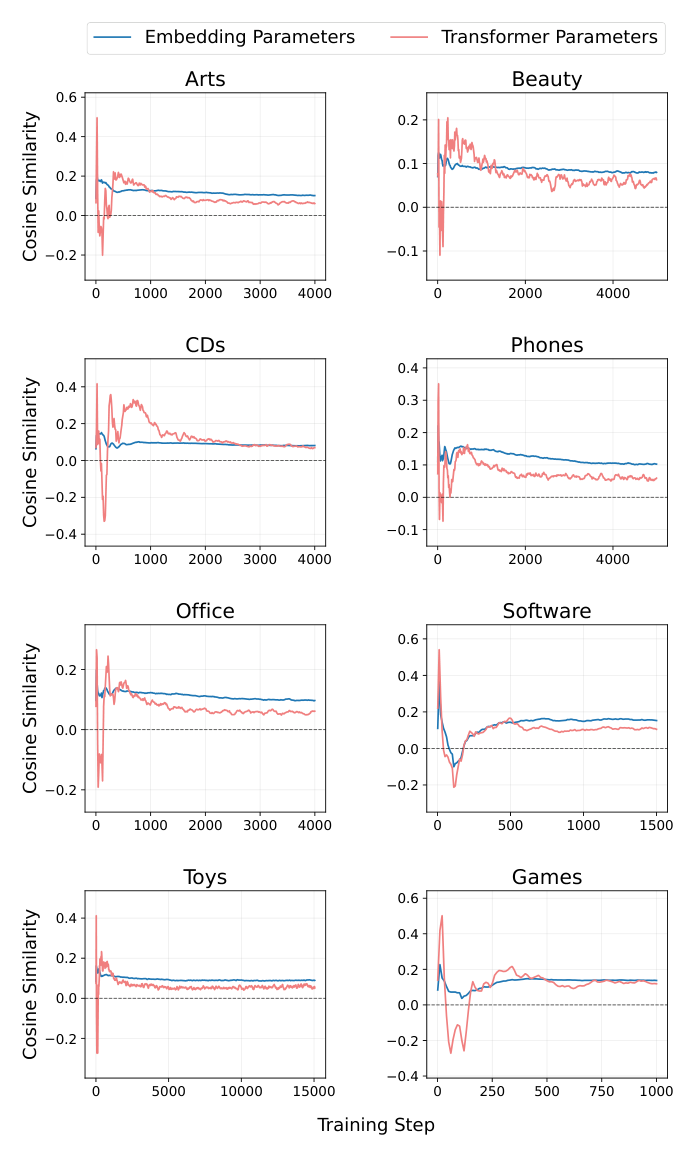
Fig. 6 进一步展示了双向干扰:虚线之前只回传预训练损失、任务损失仅被监控,可以看到预训练收敛时任务损失并不同步改善、在若干数据集上甚至上升;虚线之后放开任务梯度,任务损失下降,但预训练损失重新抬头。
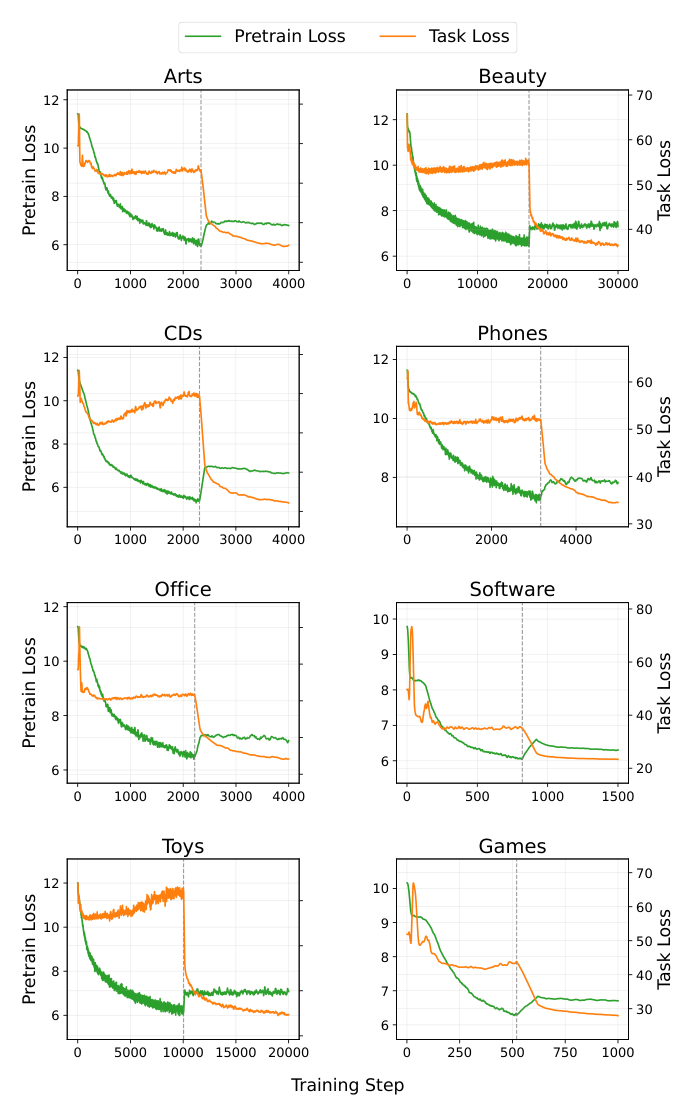
Fig. 7 用 t-SNE 从几何角度佐证:去噪预训练学到的 item embedding 形成更连贯的品类邻域(捕捉了跨全库的行为分布结构),而从零训练的任务 embedding 呈现明显不同的几何,品类邻域的全局组织性更弱、空间更多被任务特定优化塑形。两种几何天然不一致。
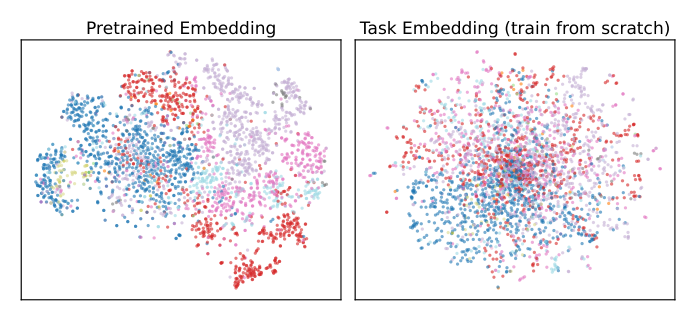
在这个诊断下,现有迁移范式各自只能满足一头:
- Full fine-tuning:任务对几何有完全控制权,但梯度会覆写预训练参数——刷新一次,预训练知识就被侵蚀一次;
- Frozen transfer(GPSD 的 transfer-and-freeze 配置):走另一个极端,禁止写入以保护知识,任务只能在下游模块里对固定 embedding 做再投影,永远无法调整表征几何、也无法在输入层注入任务所需知识;
- Adapter / 低秩微调(LoRA):继承同样的局限——冻结骨干 + 小的可训练残差,给的几何自由度太少,改不动源头编码的知识与几何。
论文的三点贡献¶
- 一个去噪的、refresh-native 的 pretrain-transfer 框架:KGD 用 BMTP 去噪预训练目标,并让预训练行为知识与任务几何作为两个正交层、在分离的读写所有权下共存,而不是争夺同一份表征。这使得"知识刷新"与"任务适配"成为互相独立的操作:encoder 可以每日以边际成本刷新,而不会让任务已学到的东西失效——这正是持续漂移下预训练迁移所缺的原语。
- 一项 90 天的"什么让流式迁移有效"的研究:在工业级流上、在对齐的预算下跑 90 天,八种迁移模式各自以不同方式失败:不预训练则缺乏结构化知识;冻结则知识陈旧;纠缠刷新被目标冲突抵消;部分参数分离缺乏几何自由度;数据回放过拟合陈旧噪声。KGD 逐条消除了这些原因。
- 充分验证与全量部署:8 个公开基准上超过最强 pretrain–transfer baseline 4–12%,在 Shopee Homepage Search 全量部署,线上 A/B 提升 GMV/user +1.75%、广告收入 +1.53%。
作者还专门声明了研究边界:模型层面只研究构成工业主线的经典深度学习推荐器,而不是 LLM-based 推荐器(后者的预训练知识蒸馏自文本、靠 prompting 或 PEFT 适配),本文关心的知识是直接从累积用户行为里学到的协同关系与序列转移模式;实验设定层面,流式评测形似增量学习,但研究的问题不同——不是找环境不变机制(invariant learning),也不是在增量数据上维持一个判别器,而是研究自回归序列预训练得到的知识能否跨越"预训练-任务目标鸿沟"迁移、并在动态漂移的数据下持续有效。
前置设定¶
问题设置¶
论文研究 GPSD 首次形式化的 generative-pretraining-to-discriminative-transfer 范式:Transformer 在用户行为序列上自回归预训练,再迁移到召回、排序等下游任务。GPSD 沿两条正交设计轴刻画迁移:迁移哪些参数(Transformer 的 dense 部分,还是只迁 embedding)以及是否冻结它们。
作者认为流式推荐系统提出了这两条轴覆盖不到的维度:(1) 如何在持续增长的工业行为流上把预训练做好——那里相邻不蕴含依赖;(2) 预训练与任务目标对共享表征所要求的几何互相冲突,而在持续更新下,知识获取与迁移都必须跨刷新周期保持稳定。
符号与自回归预训练¶
设 $\mathcal{U}$ 为用户集合、$\mathcal{I}$ 为物品目录。用户 $u\in\mathcal{U}$ 由按时间排序的行为序列 $S_u=(i_1,\dots,i_T)$ 表示,$i_t\in\mathcal{I}$。Transformer encoder $f_\theta$ 把前缀映射为上下文表征 $h_t=f_\theta(i_{1:t})\in\mathbb{R}^d$,每个 item $i$ 从表 $E=\{e_i\}_{i\in\mathcal{I}}$ 取 embedding $e_i\in\mathbb{R}^d$。
encoder 用 next-token prediction 预训练:用内积对全目录打分并归一化:
$$\mathcal{L}_{\mathrm{NTP}}=-\sum_{t=1}^{T-1}\log\frac{\exp\langle h_t,e_{i_{t+1}}\rangle}{\sum_{i'\in\mathcal{I}}\exp\langle h_t,e_{i'}\rangle} \tag{1}$$
这产出的 item embedding,其几何反映的就是行为共现结构,下游任务随后迁移并适配它。
下游迁移在精选监督上训练:例如 CTR 估计用"曝光未点击"作为负样本、对抗点击正样本,通常在 BCE 这类校准损失下学一个判别式几何。因为这份监督在负样本分布和目标函数两方面都与预训练不同,它要求的几何会偏离预训练几何——这正是 §3.2 要刻画的 gap。
流式刷新:部署中数据以非平稳流的形式到达。encoder 不是预训练一次,而是在更新步 $\ell=1,2,\dots$ 上对新增窗口刷新,产出 $\theta^{(1)},\theta^{(2)},\dots$(生产中为每日一次)。迁移必须在 encoder 从 $\theta^{(\ell)}$ 移动到 $\theta^{(\ell+1)}$ 时依然有效——这是本文方法针对的核心要求。
核心方法:KGD¶
KGD 的前提是:预训练知识与任务几何不必争夺同一份表征,它们可以作为两层、在分离的所有权下共存——一层是 encoder 不断刷新的行为几何,另一层是正交写在其上的任务几何。
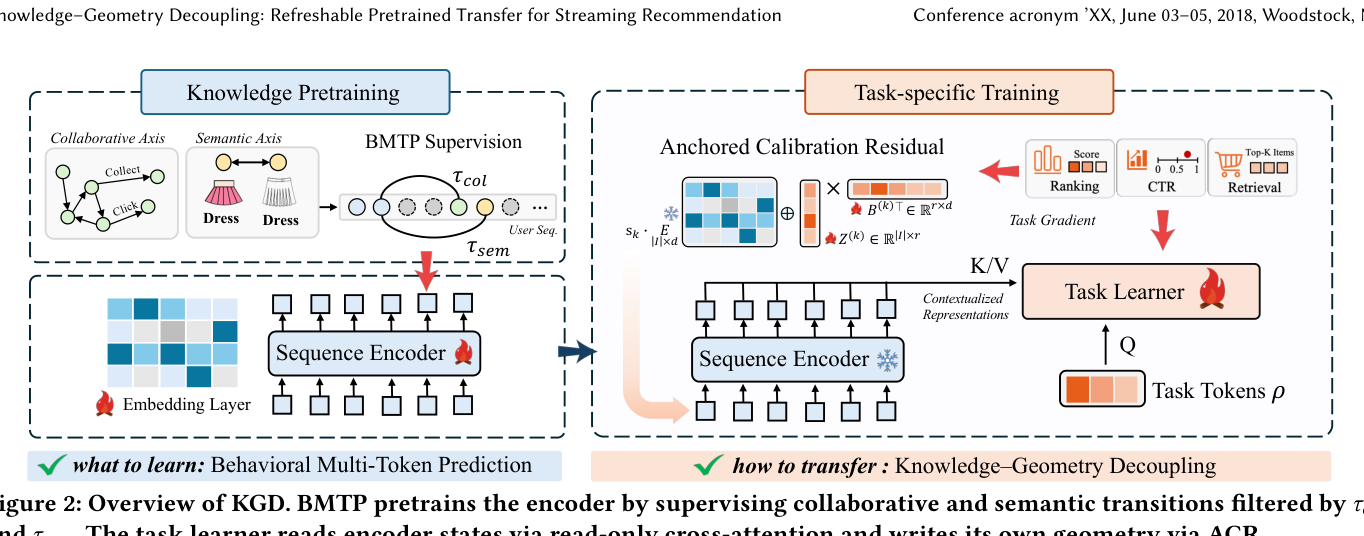
Behavioral Multi-Token Prediction (BMTP)¶
按 Levy & Goldberg (2014) 的经典结果,next-token 预训练驱动的 item embedding,其内积近似相邻 item 的对数共现:它学到的几何就是"什么倾向于跟在后面"的几何。作者由此把推荐特有的问题重述为:问题不是如何预测下一个 item,而是哪些共现值得被编码进这个几何。
两类转移携带值得保留的知识:
- 协同(collaborative):两个 item 经常被共同消费,哪怕它们并不相似(经典的"啤酒与尿布");
- 语义(semantic):两个 item 内容接近(用户从一条红裙看到另一条红裙)。
BMTP 只在这两类上做监督。具体地,对每个位置 $t$ 与每条轴,保留最近的、相似度超过阈值的后续 item:协同轴用预训练 item 共现图(LightGCN 图 embedding)上的邻近度,语义轴用预训练文本 embedding 模型(Qwen3-Embedding)算的余弦相似度。两种相似度都离线算好并缓存,预训练时不引入任何逐序列模型推理:
$$\mathcal{S}^a_t=\bigl\{\,i_j:j=\min\{\,j'>t,\ \mathrm{sim}_a(i_t,i_{j'})\ge\tau_a\,\}\,\bigr\},\quad a\in\{\mathrm{col},\mathrm{sem}\} \tag{2}$$
$$\mathcal{L}_{\mathrm{pre}}=-\sum_{t=1}^{T-1}\ \sum_{a\in\{\mathrm{col},\mathrm{sem}\}}\ \sum_{i^{+}\in\mathcal{S}^a_t}\log\frac{\exp\langle h_t,e_{i^{+}}\rangle}{\sum_{i'\in\mathcal{I}}\exp\langle h_t,e_{i'}\rangle} \tag{3}$$
其中 $\mathrm{sim}_\mathrm{col}$、$\mathrm{sim}_\mathrm{sem}$ 是协同与语义相似度,阈值分别为 $\tau_\mathrm{col},\tau_\mathrm{sem}$;$\mathcal{S}^a_t$ 只含轴 $a$ 上最近的合格 item,为空则该项跳过。
为什么每轴只监督一个正样本:全目录 softmax 使成本随正样本数线性增长,在生产规模上预测每一个合格的未来 item 会主导训练时间,而最近的几个已经携带了最强的依赖信号。
BMTP 产出的基础几何"干净"有一个具体含义:它的结构由持续存在的协同/语义关系决定,而不是由 session 边界的瞬时噪声决定。因此当流漂移时,刷新 encoder 只是在新数据上重新估计这个几何,而不会累积那类噪声——这是它可以被持续刷新的原因,也是 task learner 将要读取并在其上构建的那一层。
Decoupled Read–Write Ownership¶
干净的预训练几何只有在下游任务能够"把它适配成判别式结构而不摧毁它"时才有价值。但两个目标并不对齐(附录 B:共享 embedding 上的梯度从负相关到近正交),单一参数集无法同时服务两者:微调会覆写预训练几何,冻结则完全禁止任务重塑它。
KGD 的做法是把行为转移知识与任务几何指派给两个所有者——预训练 encoder 与 task learner,各自持有自己的参数,并通过两个不触碰 encoder 权重的接口耦合:
- embedding 层面:task learner 把自己的残差叠加到预训练 embedding 上(即 Anchored Calibration Residual);
- 表征层面:task learner 通过 read-only cross-attention 读取 encoder 的隐状态。
两个接口上任务梯度都到不了 encoder,因此预训练几何与任务几何占据分离、互不干扰的两层。
Anchored Calibration Residual (ACR)¶
task learner 不修改预训练 embedding,而是把一个任务自有的残差叠加到它的 detached 副本上。论文先刻画这个残差"必须是什么形状",再照着参数化。
观察 1:理想情形下残差退化为全局缩放。 考虑一个简单情形:任务目标只在温度 $\tau$ 上与预训练不同,且对同一批全目录负样本打分。其后验 $q_\tau(i\mid h)\propto\exp(\tau\langle h,e_i\rangle)$ 是预训练后验 $p(i\mid h)\propto\exp(\langle h,e_i\rangle)$ 的温度锐化,保序。令两个目标的稳态条件相等:
$$\nabla_{e_i}\mathcal{L}_{\mathrm{pre}}=0\iff\mathbb{E}_h\bigl[h\cdot(p(i\mid h)-\mathbf{1}[i=i^{+}])\bigr]=0 \tag{4}$$
$$\nabla_{e_i}\mathcal{L}_{\tau}=0\iff\mathbb{E}_h\bigl[\tau\cdot h\cdot(q_\tau(i\mid h)-\mathbf{1}[i=i^{+}])\bigr]=0 \tag{5}$$
可见二者都被一个全局缩放 $e_i^{\mathrm{task}}=\alpha\,e_i^{\mathrm{pre}}$($\alpha=1/\tau$)满足。这一情形下任务只向预训练要"更锐的对比",预训练几何在缩放意义下被完整保留。
观察 2:真实任务是在形变几何,而不是缩放它。 两条结构性事实打破了上述等价:其一,目标函数不同——下游任务优化校准或判别式损失(如 CTR 的 BCE),其稳态几何并非 softmax 排序目标的温度缩放;其二,负样本分布不同——它刻意不是预训练隐含的全目录分布:即使是与预训练最接近的召回任务也用 hard-negative 采样而非全局 softmax,CTR 与 CVR 则分别从"曝光未点击"和"点击未转化"里取负样本。每一种选择都把任务最优方向从预训练的行为方向上推开(位移量即 Fig. 1(b) 的梯度余弦轨迹),且对每个任务的推开方式还不一样。因此任务需要的是一个任务条件的、方向相关的形变,任何全局标量都表达不了。
观察 3:形变不能抵消预训练几何。 这份自由不能无约束:预训练 embedding 携带的结构本身对迁移有价值(GPSD 中 embedding-only 迁移的强表现,本文实验也复现了),而 KGD 中 task learner 恰恰是通过被 ACR 适配过的那份 embedding 把知识读回来。一个把 embedding 朝预训练方向反向旋转的形变会在读取时抵消该信号。因此任务需要的是非冲突的几何自由:只加判别结构,不反转或覆写预训练方向。
三条观察共同确定了修正项的形式:"超过标量的自由度(观察 2)"与"保留预训练方向(观察 3)"当且仅当新增分量与 $e_i^{\mathrm{pre}}$ 正交时同时成立——任务级标量 $s_k$ 保留并锐化预训练方向,低秩残差 $\Delta e_i^{(k)}\perp e_i^{\mathrm{pre}}$ 把任务条件的形变写进它的正交补:
$$\tilde{e}_i^{(k)}=s_k\cdot\operatorname{sg}\!\left(e_i^{\mathrm{pre}}\right)+\Delta e_i^{(k)} \tag{6}$$
$$s_k=1+\operatorname{ReLU}\!\left(\tilde{s}_k\right),\quad \Delta e_i^{(k)}=\left(Z^{(k)}{B^{(k)}}^{\top}\right)_i,\quad \Delta e_i^{(k)}\perp e_i^{\mathrm{pre}} \tag{7}$$
其中 $k$ 索引下游任务,$\operatorname{sg}(\cdot)$ 是 stop-gradient,$Z^{(k)}\in\mathbb{R}^{|\mathcal{I}|\times r}$、$B^{(k)}\in\mathbb{R}^{d\times r}$ 是任务自有的低秩因子($r<d$,实现中取 embedding 维度的 1/4)。正交性由正则项软性保证(见式 (12)(13))。正交约束正是两种几何得以共存的原因:$\Delta e_i^{(k)}$ 把判别方向引入预训练子空间的补空间,在输入层面就给了足够的几何自由度,而 $e_i^{\mathrm{pre}}$(detached,且被所有任务共享)保持完好且可刷新。
Read-only cross-attention¶
ACR 是在单个 item 粒度上修正几何,但下游任务需要的不止是更锐的 item 空间:它必须把用户上下文化的兴趣(行为序列蒸馏成的意图)投影到一个任务判别空间里,让正负样本最大分离、分数被校准。这个上下文信号只有预训练 Transformer 的中间层能产出,从 item embedding 无法复原。
但把该 Transformer 与任务共享并不是好选择:它的参数是为建模转移而特化的,为判别再优化会把冲突原样引回来。因此 KGD 解耦两个骨干(任务拥有一个独立 Transformer),用 read-only cross-attention 搭桥:任务 Transformer 选择性地抽取并再投影预训练模型的上下文化表征,而不改变它们。记 $\tilde{H}$ 为预训练 encoder 在 ACR 调整后的 embedding 上产生的隐状态,任务 Transformer 通过下式读取:
$$Q=W_Q\,\rho,\quad K=W_K\,\operatorname{sg}(\tilde{H}),\quad V=W_V\,\operatorname{sg}(\tilde{H}) \tag{8}$$
其中 $\rho$ 是任务侧的 reader token,$W_Q,W_K,W_V$ 由任务 Transformer 拥有;$\tilde{H}$ 取 encoder 最后一层隐状态。K/V 上的 stop-gradient 让这个接口严格单向:$\mathcal{L}_\mathrm{task}$ 只更新 task Transformer 与 ACR 参数。
为什么它能干净地刷新¶
两条性质让刷新与适配成为独立操作:
- 接口严格单向:read-only cross-attention 隔离梯度,刷新转移骨干不会扰动任务骨干,任务优化也永远不会污染预训练知识;
- 任务几何是锚定在预训练 embedding 上的相对残差,而非绝对坐标:一次刷新只是把底座移动到残差之下,而不是让残差失效。
再加上 BMTP 保证这个底座不含瞬时噪声,在新数据上重估它是在累积知识而不是累积漂移。于是 encoder 可以按流刷新(频率可到每日,代价只是一次 encoder 更新),而它承载的任务适配保持完好。
实例化、训练与部署¶
架构。encoder 是标准自注意力 Transformer,用 BMTP 训练,在其训练期把原始 item-embedding 序列 $E$ 映射为隐状态:
$$H=\mathrm{Trans}_{\mathrm{enc}}(E) \tag{9}$$
task learner 是一个同时含自注意力与 read-only 交叉注意力的 Transformer,分两步消费 encoder。第一步,ACR 重塑输入 embedding,encoder 重新编码它们,得到任务适配后的状态:
$$\tilde{H}=\mathrm{Trans}_{\mathrm{enc}}\!\bigl(\mathrm{ACR}(E)\bigr) \tag{10}$$
第二步,learner 注意这些状态:
$$H'=\mathrm{Trans}_{\mathrm{task}}(\rho,\tilde{H},\tilde{H}) \tag{11}$$
任务侧 reader token $\rho$ 作 query、$\tilde{H}$ 供 key/value。$H'$ 送入任务头、在任务损失下训练。learner 训练期间,encoder 拥有的参数被冻结、只做推理。
正交正则。为保证新刻的几何不覆写预训练知识,任务目标里加了一项正交正则:
$$\mathcal{L}=\mathcal{L}_{\mathrm{task}}+\mathcal{L}_{\mathrm{orth}} \tag{12}$$
$$\mathcal{L}_{\mathrm{orth}}=\frac{1}{|\mathcal{B}|}\sum_{i\in\mathcal{B}}\left(\cos\left(\Delta e_i^{(k)},e_i^{\mathrm{pre}}\right)\right)^{2} \tag{13}$$
$\mathcal{B}$ 是当前 mini-batch 涉及的 item 集合。
任务特定 query。reader token $\rho$ 的实例化随任务需求而定:召回时 $\rho$ 是用户侧向量(编码用户画像特征或一个学到的用户潜向量),产出单个用户 embedding 供最近邻检索;排序时 $\rho$ 是候选侧 token(聚合候选特征),于是每个候选从同一份共享的用户历史编码里读取任务相关信号并被独立打分。
公开基准(ManCAR 骨干)实例化:reader token 由 encoder 最终用户表征初始化——取最后一层最后位置的隐状态:
$$u=H^{(L)}_{T} \tag{14}$$
$$R^{(0)}=\phi_{\mathrm{read}}(u) \tag{15}$$
$\phi_\mathrm{read}$ 是 task-learner 拥有的 reader token 适配模块。公开设定的 task learner 采用 reasoning-reader 投影结构,先用自注意力精化 reader token,再交叉注意 encoder 最后一层状态,然后交叉注意 ManCAR 的上下文序列 $C$(含近期 item 的图邻居上下文),最后过 FFN:
$$\bar{R}=R^{(0)}+\mathrm{SA}(R^{(0)}) \tag{16}$$
$$R^{(1)}=\bar{R}+\mathrm{CA}\big(Q=\bar{R},\;K=H^{(L)},\;V=H^{(L)}\big) \tag{17}$$
$$R^{(2)}=R^{(1)}+\mathrm{CA}\big(Q=R^{(1)},\;K=C,\;V=C\big) \tag{18}$$
$$R^{\mathrm{out}}=R^{(2)}+\mathrm{FFN}(R^{(2)}) \tag{19}$$
工业(OneRank 骨干)实例化:reader token 就是生产排序骨干使用的任务侧非序列 token,包括候选 item token 与用户特征 token:
$$R^{(0)}=[E_{\mathrm{cand}};\;E_{\mathrm{user}};\;E_{\mathrm{task}}] \tag{20}$$
$E_\mathrm{cand}$ 为候选侧特征 embedding,$E_\mathrm{user}$ 为非序列用户特征 embedding,$E_\mathrm{task}$ 为可选的 click/order 任务 token。工业 task learner 把 read-only attention 实例化为 Perceiver 风格的 reader,每层依次做自注意力、交叉注意 encoder 末层状态、FFN:
$$\bar{R}^{(\ell)}=R^{(\ell-1)}+\mathrm{SA}(R^{(\ell-1)}) \tag{21}$$
$$\tilde{R}^{(\ell)}=\bar{R}^{(\ell)}+\mathrm{CA}\big(Q=\bar{R}^{(\ell)},\;K=H^{(L)},\;V=H^{(L)}\big) \tag{22}$$
$$R^{(\ell)}=\tilde{R}^{(\ell)}+\mathrm{FFN}(\tilde{R}^{(\ell)}) \tag{23}$$
两种实例化只在 reader token 的选择上不同,都遵循同一套参数解耦范式。
日流训练:数据每日到达。每天先在新数据上对 encoder 刷新一遍(one pass);随后冻结 encoder 拥有的参数,跑合并后的 encoder-learner 计算图,只更新 learner,encoder 只做推理。因此训练时间大致是"encoder-only 一遍"的两倍,在其部署环境下约 2 小时(A100),与 GPSD 的增量训练成本相当——这是目标冲突不可避免的代价。
部署:learner 拥有独立的注意力、FFN 参数和低维度的 item 目录 embedding,因此 KGD 大致把 dense 参数翻倍、稀疏 embedding 增加 20%,在其规模下仍可管理。延迟不增长:如果 query token 不走这个独立 learner,它在非预训练设定里仍要走共享 encoder,所以单请求延迟与单骨干 baseline 对齐。
实验设置¶
公开基准设定¶
使用 Amazon-2023 Reviews 的 8 个数据集(单任务建模),骨干采用一个 reasoning-enhanced 的 SOTA 序列推荐器 ManCAR(Yang et al. 2026)。在每个训练划分上先用 BMTP 在完整用户行为序列上自回归预训练 encoder,然后把数据重组为 reasoning-recommendation 任务来适配 task learner,同时它通过 read-only 接口读取 encoder。官方静态划分不是为测试"可刷新性"设计的,但它能在一个强共享骨干下干净地区分"预训练知识的质量(BMTP)"与"知识被迁移的方式(解耦所有权)",排除弱骨干的混淆。指标为 NDCG@50 与 Recall@50(附录另给 @20)。
数据统计(5-core、官方 leave-one-out 划分、仅用 item ID 作输入特征):
| Dataset | Users | Items | Interactions | Density |
|---|---|---|---|---|
| Software | 146,396 | 17,591 | 1,130,444 | 0.044% |
| Video Games (Games) | 94,762 | 25,612 | 719,824 | 0.030% |
| Office Products (Office) | 223,308 | 77,551 | 1,577,570 | 0.009% |
| CDs and Vinyl (CDs) | 123,876 | 89,370 | 142,888 | 0.001% |
| Arts Crafts and Sewing (Arts) | 197,286 | 89,958 | 1,589,151 | 0.009% |
| Cell Phones and Accessories (Phones) | 380,999 | 111,480 | 2,371,786 | 0.006% |
| Toys and Games (Toys) | 432,264 | 162,035 | 3,429,622 | 0.005% |
| Beauty and Personal Care (Beauty) | 729,576 | 207,649 | 5,894,865 | 0.004% |
作者还专门解释了为什么不用更接近工业设定的公开流式数据集:一些数据集靠对高活跃用户的追踪采集(KuaiRand),无法反映真实流量的大规模用户 ID 分布漂移;另一些缺少 KGD 需要的输入——特征被加密(JDsearch、Tenrec)导致无法做语义 BMTP、交互序列特征不足(Criteo)、或缺少可靠时间戳(KuaiSearch、MUSE)。因此公开实验的定位是先取得一个可复现的验证,再推进到工业评测与线上 A/B。
工业流式设定¶
工业数据来自 Shopee Homepage Search 场景(十亿级规模电商平台),多任务排序(click + order)、每日流量流,骨干是强 Transformer 工业排序器 OneRank(Tang et al. 2026)。指标为每个任务的 AUC 与 GAUC,两个时间跨度:
- 28 天流用于主对比:预训练目标 × 迁移方法的大范围组合,每个配置 5 次运行取平均,在 test-before-train 协议下评估(模型在被当日数据训练之前先在该日测试),报告各方法最后一天的测试指标;
- 90 天轨迹跟踪一个子集——28 天扫描中的最强者加上代表性 baseline(如 TA&FE,即 GPSD)——观察各方法随时间的保持能力。
数据统计:约 13B 样本(28 天,经极端降采样与负采样),click 正样本率约 7.5%、order 约 0.41%;用户词表千万级、item 词表接近十亿级(业务原因未完全披露)。长期衰减研究再额外续训 62 天,90 天合计约 42B 样本。
三种耦合"预训练与刷新"的调度:
- S1 — 不预训练:标准工业增量刷新配方,每天加载前一天 checkpoint 在新数据上继续训练(OneRank 的基础配方);
- S2 — 先预训练再冻结:前 14 天预训练后冻结 encoder 产出的参数,后续只训练任务模块,encoder 一次预训练后不再刷新;
- S3 — 预训练-适配交替:每天先对 encoder 在当日数据上刷新一遍,再依迁移方法做冻结/迁移/微调/KGD 的解耦训练。S2 vs S3 隔离"刷新"的价值,S3 内部各方法对比隔离"迁移机制"的价值。
Baseline¶
预训练目标:BMTP vs NTP(Yuan et al. 2020;SORT;PRECISE;GPSD)与 MTP(PinFM;Climber-Pilot;GReF)。
迁移方式(按失败模式分组):
- 不预训练(S1):Scratch(标准 OneRank baseline);IncCTR(把前一天 checkpoint 当 teacher 蒸馏分数给今天的 student);buffer replay(回放历史样本);
- 微调(S2):TE&FT(迁 Embedding 后全量微调)、TA&FT(迁全部模块后全量微调)——任务梯度覆写预训练知识;
- 冻结迁移(S2):TE&FE(只迁 embedding 并冻结,GPSD/SORT 路线)、TA&FE(迁全部、冻结 embedding,GPSD)、TA&FD(迁全部、冻结 dense/Transformer 参数)、TA&FA(迁全部、除任务头外全部冻结,PeterRec 路线);
- 纠缠刷新(S3):在 S3 调度下微调同一骨干——encoder 每天刷新,然后在同一批参数上微调任务;
- 部分分离(S3):LoRA/adapter refresh——S3 下每天先用 BMTP 训基座,再在注意力层的低秩 adapter 上用任务损失更新(基座冻结);
- 解耦所有权(S3):KGD。
超参数与算力¶
- 公开(ManCAR):2 层标准 Transformer encoder + causal mask,hidden size 与 item embedding 维度均为 256,2 个注意力头,最大序列长度 50;任务训练用 Adam、学习率 $1\times10^{-3}$、batch size 1024、early stopping patience 3。
- 工业(OneRank):2 层 Transformer 排序骨干,hidden size 256、4 个注意力头;稀疏特征 embedding 每特征 32 维,最大序列长度 200;线上 OneRank 用了 500+ 精心设计的特征。
- BMTP 超参:协同相似度来自 LightGCN 图 embedding,$\tau_\mathrm{col}=0.5$;语义 embedding 来自 Qwen3-Embedding,$\tau_\mathrm{sem}=0.8$,文本输入是拼接元数据的简单 prompt:"Item title: title text, Item category: category text, Item shop: shop title text"。ACR 的低秩维度 $r$ 取 embedding 维度的 1/4。
- 算力:公开实验在单张 NVIDIA A800(80GB)上完成;工业部署硬件因业务原因未披露。
主要实验结果¶
公开基准(Table 1,NDCG@50 / Recall@50)¶
前四个数据集:
| Strategy | Pretrain | Arts N@50 | Arts R@50 | Beauty N@50 | Beauty R@50 | CDs N@50 | CDs R@50 | Phones N@50 | Phones R@50 |
|---|---|---|---|---|---|---|---|---|---|
| Scratch | – | 0.0302 | 0.0807 | 0.0243 | 0.0595 | 0.0618 | 0.1552 | 0.0242 | 0.0635 |
| TE&FT | NTP | 0.0305 | 0.0834 | 0.0229 | 0.0632 | 0.0636 | 0.1555 | 0.0292 | 0.0808 |
| TE&FT | MTP | 0.0308 | 0.0878 | 0.0229 | 0.0604 | 0.0632 | 0.1527 | 0.0256 | 0.0682 |
| TE&FT | BMTP | 0.0304 | 0.0901 | 0.0229 | 0.0639 | 0.0618 | 0.1660 | 0.0268 | 0.0786 |
| BMTP vs. NTP | -0.30% | 8.00% | 0.00% | 1.10% | -2.80% | 6.80% | -8.20% | -2.70% | |
| TA&FT | NTP | 0.0299 | 0.0825 | 0.0220 | 0.0604 | 0.0625 | 0.1594 | 0.0267 | 0.0751 |
| TA&FT | MTP | 0.0314 | 0.0877 | 0.0221 | 0.0596 | 0.0645 | 0.1512 | 0.0245 | 0.0640 |
| TA&FT | BMTP | 0.0304 | 0.0805 | 0.0246 | 0.0625 | 0.0634 | 0.1715 | 0.0254 | 0.0667 |
| BMTP vs. NTP | 1.70% | -2.40% | 11.80% | 3.50% | 1.40% | 7.60% | -4.90% | -11.20% | |
| TE&FE | NTP | 0.0353 | 0.1011 | 0.0261 | 0.0725 | 0.0637 | 0.1734 | 0.0321 | 0.0879 |
| TE&FE | MTP | 0.0339 | 0.0956 | 0.0249 | 0.0678 | 0.0620 | 0.1674 | 0.0277 | 0.0741 |
| TE&FE | BMTP | 0.0376 | 0.1069 | 0.0270 | 0.0755 | 0.0690 | 0.1893 | 0.0330 | 0.0933 |
| BMTP vs. NTP | 6.50% | 5.70% | 3.40% | 4.10% | 8.30% | 9.20% | 2.80% | 6.10% | |
| TA&FE | NTP | 0.0340 | 0.0987 | 0.0256 | 0.0709 | 0.0649 | 0.1780 | 0.0308 | 0.0855 |
| TA&FE | MTP | 0.0327 | 0.0927 | 0.0237 | 0.0649 | 0.0619 | 0.1685 | 0.0247 | 0.0716 |
| TA&FE | BMTP | 0.0364 | 0.1045 | 0.0273 | 0.0763 | 0.0691 | 0.1901 | 0.0327 | 0.0947 |
| BMTP vs. NTP | 7.10% | 5.90% | 6.60% | 7.60% | 6.50% | 6.80% | 6.20% | 10.80% | |
| TA&FD | NTP | 0.0229 | 0.0724 | 0.0160 | 0.0494 | 0.0531 | 0.1562 | 0.0212 | 0.0653 |
| TA&FD | MTP | 0.0275 | 0.0857 | 0.0181 | 0.0549 | 0.0522 | 0.1530 | 0.0174 | 0.0534 |
| TA&FD | BMTP | 0.0268 | 0.0860 | 0.0178 | 0.0539 | 0.0531 | 0.1575 | 0.0229 | 0.0704 |
| BMTP vs. NTP | 17.00% | 18.80% | 11.30% | 9.10% | 0.00% | 0.80% | 8.00% | 7.80% | |
| TA&FA | NTP | 0.0266 | 0.0809 | 0.0192 | 0.0582 | 0.0412 | 0.1232 | 0.0257 | 0.0760 |
| TA&FA | MTP | 0.0236 | 0.0727 | 0.0171 | 0.0525 | 0.0388 | 0.1172 | 0.0186 | 0.0561 |
| TA&FA | BMTP | 0.0300 | 0.0894 | 0.0222 | 0.0655 | 0.0515 | 0.1477 | 0.0292 | 0.0842 |
| BMTP vs. NTP | 12.80% | 10.50% | 15.60% | 12.50% | 25.00% | 19.90% | 13.60% | 10.80% | |
| KGD | NTP | 0.0354 | 0.1024 | 0.0262 | 0.0734 | 0.0666 | 0.1844 | 0.0317 | 0.0865 |
| KGD | MTP | 0.0344 | 0.0979 | 0.0266 | 0.0731 | 0.0635 | 0.1751 | 0.0271 | 0.0725 |
| KGD | BMTP | 0.0380 | 0.1099 | 0.0292 | 0.0803 | 0.0701 | 0.1930 | 0.0337 | 0.0951 |
| gain vs. best published baseline | 7.60% | 8.70% | 11.90% | 10.80% | 8.00% | 8.40% | 5.00% | 8.20% | |
| gain vs. best baseline w/ BMTP | 1.06% | 2.81% | 6.96% | 5.24% | 1.45% | 1.53% | 2.12% | 0.42% |
后四个数据集:
| Strategy | Pretrain | Office N@50 | Office R@50 | Software N@50 | Software R@50 | Toys N@50 | Toys R@50 | Games N@50 | Games R@50 |
|---|---|---|---|---|---|---|---|---|---|
| Scratch | – | 0.0279 | 0.0640 | 0.1257 | 0.3374 | 0.0315 | 0.0755 | 0.0670 | 0.1800 |
| TE&FT | NTP | 0.0279 | 0.0658 | 0.1279 | 0.3426 | 0.0308 | 0.0764 | 0.0666 | 0.1903 |
| TE&FT | MTP | 0.0274 | 0.0657 | 0.1295 | 0.3463 | 0.0313 | 0.0766 | 0.0664 | 0.1865 |
| TE&FT | BMTP | 0.0271 | 0.0735 | 0.1293 | 0.3430 | 0.0314 | 0.0866 | 0.0669 | 0.1914 |
| BMTP vs. NTP | -2.90% | 11.70% | 1.10% | 0.10% | 1.90% | 13.40% | 0.50% | 0.60% | |
| TA&FT | NTP | 0.0277 | 0.0671 | 0.1275 | 0.3380 | 0.0323 | 0.0772 | 0.0675 | 0.1935 |
| TA&FT | MTP | 0.0274 | 0.0659 | 0.1276 | 0.3408 | 0.0304 | 0.0769 | 0.0670 | 0.1880 |
| TA&FT | BMTP | 0.0272 | 0.0658 | 0.1291 | 0.3438 | 0.0322 | 0.0761 | 0.0669 | 0.1927 |
| BMTP vs. NTP | -1.80% | -1.90% | 1.30% | 1.70% | -0.30% | -1.40% | -0.90% | -0.40% | |
| TE&FE | NTP | 0.0309 | 0.0826 | 0.1320 | 0.3696 | 0.0325 | 0.0888 | 0.0754 | 0.2127 |
| TE&FE | MTP | 0.0287 | 0.0744 | 0.1306 | 0.3660 | 0.0318 | 0.0844 | 0.0735 | 0.2068 |
| TE&FE | BMTP | 0.0334 | 0.0895 | 0.1349 | 0.3732 | 0.0354 | 0.0955 | 0.0782 | 0.2208 |
| BMTP vs. NTP | 8.10% | 8.40% | 2.20% | 1.00% | 8.90% | 7.50% | 3.70% | 3.80% | |
| TA&FE | NTP | 0.0306 | 0.0826 | 0.1325 | 0.3720 | 0.0326 | 0.0892 | 0.0754 | 0.2149 |
| TA&FE | MTP | 0.0287 | 0.0745 | 0.1304 | 0.3638 | 0.0314 | 0.0841 | 0.0728 | 0.2041 |
| TA&FE | BMTP | 0.0332 | 0.0894 | 0.1345 | 0.3694 | 0.0351 | 0.0951 | 0.0772 | 0.2187 |
| BMTP vs. NTP | 8.50% | 8.20% | 1.50% | -0.70% | 7.70% | 6.60% | 2.40% | 1.80% | |
| TA&FD | NTP | 0.0197 | 0.0605 | 0.0887 | 0.2796 | 0.0216 | 0.0644 | 0.0524 | 0.1632 |
| TA&FD | MTP | 0.0230 | 0.0658 | 0.0859 | 0.2735 | 0.0246 | 0.0715 | 0.0556 | 0.1705 |
| TA&FD | BMTP | 0.0238 | 0.0713 | 0.1005 | 0.3141 | 0.0246 | 0.0727 | 0.0605 | 0.1813 |
| BMTP vs. NTP | 20.80% | 17.90% | 13.30% | 12.30% | 13.90% | 12.90% | 15.50% | 11.10% | |
| TA&FA | NTP | 0.0253 | 0.0726 | 0.1196 | 0.3436 | 0.0199 | 0.0582 | 0.0535 | 0.1611 |
| TA&FA | MTP | 0.0226 | 0.0655 | 0.1179 | 0.3446 | 0.0179 | 0.0533 | 0.0506 | 0.1502 |
| TA&FA | BMTP | 0.0277 | 0.0754 | 0.1202 | 0.3438 | 0.0266 | 0.0752 | 0.0653 | 0.1895 |
| BMTP vs. NTP | 9.50% | 3.90% | 0.50% | 0.10% | 33.70% | 29.20% | 22.10% | 17.60% | |
| KGD | NTP | 0.0317 | 0.0857 | 0.1347 | 0.3662 | 0.0339 | 0.0910 | 0.0758 | 0.2189 |
| KGD | MTP | 0.0304 | 0.0784 | 0.1340 | 0.3618 | 0.0312 | 0.0843 | 0.0739 | 0.2071 |
| KGD | BMTP | 0.0352 | 0.0938 | 0.1381 | 0.3775 | 0.0365 | 0.0975 | 0.0788 | 0.2244 |
| gain vs. best published baseline | 13.90% | 13.60% | 4.20% | 1.50% | 12.00% | 9.30% | 4.50% | 4.40% | |
| gain vs. best baseline w/ BMTP | 5.39% | 4.8% | 2.37% | 1.15% | 3.11% | 2.09% | 0.77% | 1.63% |
结论分析(两条增益要分开看):
- BMTP 提供了更好的行为知识,但只有在它不被覆写时才兑现。 固定迁移策略、把 NTP 换成 BMTP,在不同架构和数据集上都有帮助——说明增益来自预训练目标本身而非 KGD 架构。但增益大小强烈依赖知识如何被迁移:在冻结迁移下,BMTP 相对 NTP 的增益大且一致(Arts 上 TE&FE/TA&FE 分别 +6.5%/+7.1%),并且冻结的部分越多增益越大,到 TA&FD 与 TA&FA 达到两位数(Toys 上 TA&FA 高达 +33.7% N@50);而在全量微调下,同样的优势缩小甚至反转(Phones 上 TE&FT −8.2%)。这个模式很说明问题:当任务梯度被允许重写预训练参数时,它们抹掉的恰恰是 BMTP 装进去的结构。这同时证明了两件事——BMTP 编码了真实可迁移的知识,且保住它需要一种不覆写它的迁移方式。
- 解耦所有权是最好的迁移方式。 控制预训练目标不变(都用 BMTP),KGD 在每个数据集上都超过最好的共享参数 baseline(0.4–7.0%,"gain vs. best baseline w/ BMTP"行)。作者归因于三条共享参数拿不到的性质:read-only cross-attention 让 task learner 用上 encoder 的上下文化中间表征而没有任何梯度回流,知识永不被覆写;ACR 把任务判别方向写成与预训练 embedding 正交的残差,在预训练子空间的补空间里增加区分度而不是逆向旋转,校准因此不会抵消迁移来的知识;解耦骨干让 task learner 端到端拥有自己的判别几何,而不是借用一个为转移特化的骨干。冻结迁移保知识但改不动几何;微调改得动几何但毁知识;只有解耦所有权两者兼得且无冲突。
工业数据 28 天流(Table 2)¶
| Strategy | Pretrain | click AUC | click GAUC | order AUC | order GAUC |
|---|---|---|---|---|---|
| Scratch (S1) | – | 0.7806 | 0.7759 | 0.8941 | 0.8410 |
| TE&FT (S2) | NTP | 0.7826 | 0.7786 | 0.8981 | 0.8434 |
| TE&FT (S2) | MTP | 0.7827 | 0.7785 | 0.8982 | 0.8440 |
| TE&FT (S2) | BMTP | 0.7839 | 0.7795 | 0.8985 | 0.8444 |
| TA&FT (S2) | NTP | 0.7824 | 0.7787 | 0.8982 | 0.8437 |
| TA&FT (S2) | MTP | 0.7830 | 0.7789 | 0.8980 | 0.8436 |
| TA&FT (S2) | BMTP | 0.7852 | 0.7801 | 0.8993 | 0.8447 |
| TE&FE (S2) | NTP | 0.7821 | 0.7779 | 0.8977 | 0.8421 |
| TE&FE (S2) | MTP | 0.7820 | 0.7778 | 0.8980 | 0.8427 |
| TE&FE (S2) | BMTP | 0.7834 | 0.7786 | 0.8985 | 0.8448 |
| TA&FE (S2) | NTP | 0.7813 | 0.7780 | 0.8975 | 0.8421 |
| TA&FE (S2) | MTP | 0.7825 | 0.7781 | 0.8980 | 0.8423 |
| TA&FE (S2) | BMTP | 0.7835 | 0.7789 | 0.8991 | 0.8434 |
| TA&FD (S2) | NTP | 0.7813 | 0.7765 | 0.8981 | 0.8428 |
| TA&FD (S2) | MTP | 0.7815 | 0.7768 | 0.8981 | 0.8429 |
| TA&FD (S2) | BMTP | 0.7831 | 0.7779 | 0.8997 | 0.8449 |
| TA&FA (S2) | NTP | 0.7816 | 0.7761 | 0.8970 | 0.8424 |
| TA&FA (S2) | MTP | 0.7812 | 0.7762 | 0.8971 | 0.8423 |
| TA&FA (S2) | BMTP | 0.7821 | 0.7772 | 0.8984 | 0.8431 |
| TA&FT (S3) | NTP | 0.7819 | 0.7781 | 0.8978 | 0.8432 |
| TA&FT (S3) | MTP | 0.7825 | 0.7781 | 0.8975 | 0.8429 |
| TA&FT (S3) | BMTP | 0.7837 | 0.7793 | 0.8979 | 0.8433 |
| TA&FE (S3) | NTP | 0.7822 | 0.7783 | 0.8979 | 0.8432 |
| TA&FE (S3) | MTP | 0.7825 | 0.7785 | 0.8978 | 0.8433 |
| TA&FE (S3) | BMTP | 0.7841 | 0.7792 | 0.8989 | 0.8446 |
| KGD (S3) | NTP | 0.7837 | 0.7804 | 0.9003 | 0.8460 |
| KGD (S3) | MTP | 0.7825 | 0.7785 | 0.8989 | 0.8459 |
| KGD (S3) | BMTP | 0.7867 | 0.7826 | 0.9015 | 0.8477 |
| KGD w/o ACR and RO | BMTP | 0.7785 | 0.7737 | 0.8919 | 0.8382 |
| IncCTR | – | 0.7810 | 0.7744 | 0.8936 | 0.8397 |
| LoRA | BMTP | 0.7818 | 0.7773 | 0.8967 | 0.8423 |
| Buffer replay | – | 0.7732 | 0.7664 | 0.8813 | 0.8289 |
结论分析:
- 决定性的是所有权,而不是调度。 比较 S2(预训练一次后冻结)与 S3(每日刷新)可以隔离"持续刷新"的收益。在共享参数上,刷新根本不起作用:TA&FT 甚至从 0.7852(S2)掉到 0.7837(S3),TA&FE 只从 0.7835 微动到 0.7841。刷新与适配在同一批参数上迭代地互相抵消。同样的 S3 调度下,KGD 通过解耦二者达到 0.7867;而把它的接口拿掉(无 ACR、无 read-only encoder),S3 就退化成纠缠刷新,跌到 0.7785——甚至低于 Scratch 的 0.7806。也就是说,刷新只有在解耦所有权下才有回报;在纠缠参数下,交替更新反复覆写几何,让它无法稳定,反而降低性能。
- 每种替代方案各自以不同方式失败。 不预训练时,持续学习方法收益甚微:IncCTR(0.7810)勉强超过 Scratch,蒸馏前一天的 checkpoint 并不带来结构化信号;buffer replay 更差(0.7732,低于 Scratch),因为回放历史等价于多轮训练,触发了稀疏 embedding 的"超过一个 epoch 就过拟合"问题(Zhang et al. 2022)。LoRA(0.7818)——注意力层上的低秩 adapter——留给几何重塑的自由度太少。
90 天轨迹(Figure 3)¶
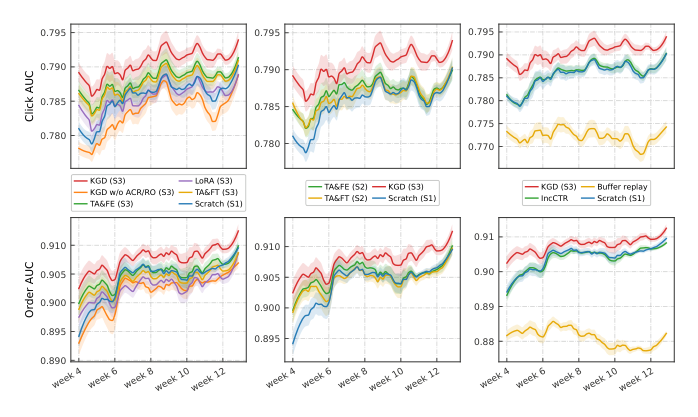
快照掩盖的东西被 90 天轨迹揭示出来:冻结迁移在短时间窗内看起来很有竞争力——这正是"可刷新性与稳定性无法从静态表格判断"的原因。在 90 天尺度上,冻结迁移(TA&FE,即 GPSD)随时间推移持续侵蚀,而 KGD 全程保持;buffer replay 单调退化——它记住的陈旧模式再也不会重现,与附录 B.1 中 item 分布 JSD 持续上升而非稳定的测量互相印证。KGD 在活的数据流上刷新,因而跟得上漂移。附录 E 的 Fig. 10 给出未平滑版本,趋势一致。
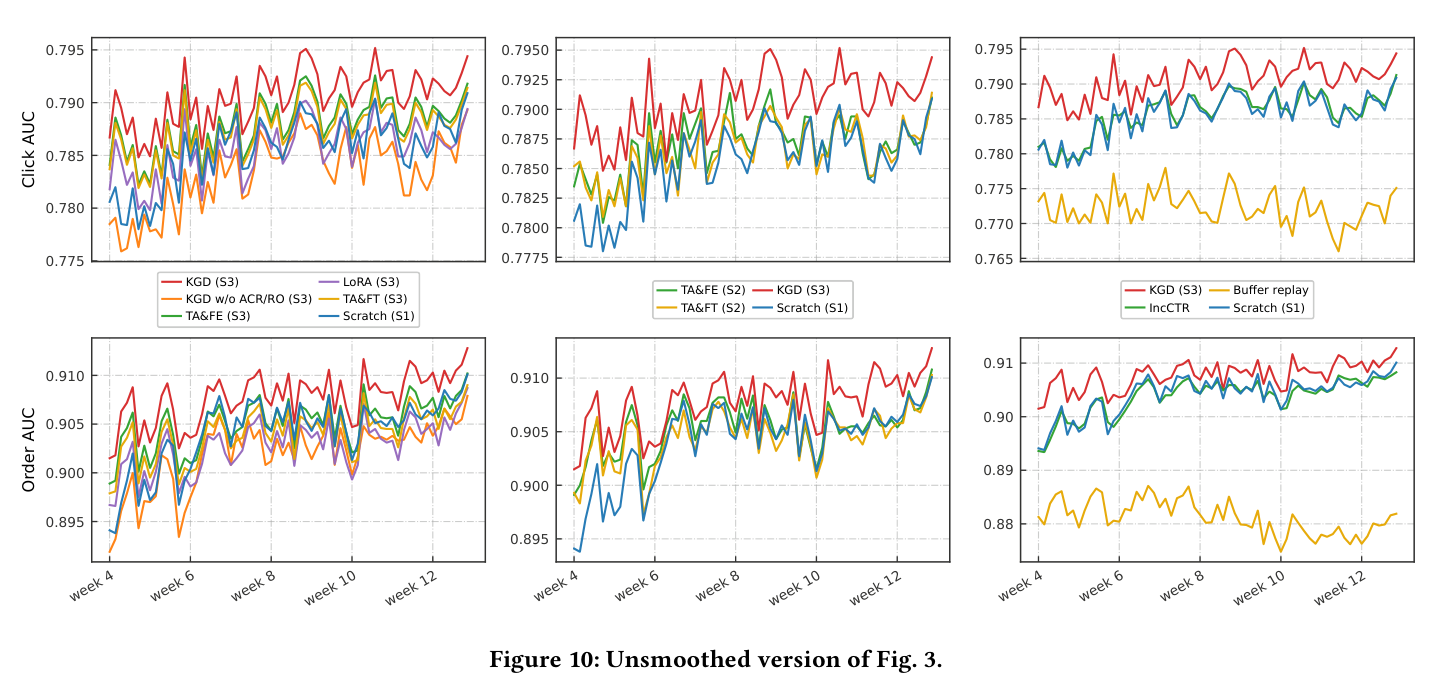
附录 E:@20 指标的补充结果(Table 9)¶
前四个数据集(NDCG@20 / Recall@20):
| Strategy | Pretrain | Arts N@20 | Arts R@20 | Beauty N@20 | Beauty R@20 | CDs N@20 | CDs R@20 | Phones N@20 | Phones R@20 |
|---|---|---|---|---|---|---|---|---|---|
| Scratch | – | 0.0251 | 0.0548 | 0.0208 | 0.0417 | 0.0544 | 0.1180 | 0.0204 | 0.0443 |
| TE&FT | NTP | 0.0251 | 0.0559 | 0.0190 | 0.0436 | 0.0560 | 0.1173 | 0.0239 | 0.0539 |
| TE&FT | MTP | 0.0247 | 0.0570 | 0.0193 | 0.0421 | 0.0559 | 0.1160 | 0.0213 | 0.0463 |
| TE&FT | BMTP | 0.0241 | 0.0585 | 0.0190 | 0.0441 | 0.0529 | 0.1210 | 0.0215 | 0.0519 |
| TA&FT | NTP | 0.0245 | 0.0555 | 0.0183 | 0.0418 | 0.0544 | 0.1185 | 0.0219 | 0.0505 |
| TA&FT | MTP | 0.0257 | 0.0586 | 0.0185 | 0.0415 | 0.0573 | 0.1153 | 0.0204 | 0.0429 |
| TA&FT | BMTP | 0.0254 | 0.0548 | 0.0209 | 0.0433 | 0.0542 | 0.1251 | 0.0214 | 0.0463 |
| TE&FE | NTP | 0.0281 | 0.0645 | 0.0212 | 0.0477 | 0.0538 | 0.1238 | 0.0260 | 0.0573 |
| TE&FE | MTP | 0.0271 | 0.0615 | 0.0203 | 0.0443 | 0.0524 | 0.1190 | 0.0225 | 0.0481 |
| TE&FE | BMTP | 0.0301 | 0.0692 | 0.0220 | 0.0499 | 0.0581 | 0.1342 | 0.0266 | 0.0609 |
| TA&FE | NTP | 0.0271 | 0.0636 | 0.0209 | 0.0469 | 0.0546 | 0.1260 | 0.0249 | 0.0557 |
| TA&FE | MTP | 0.0261 | 0.0591 | 0.0193 | 0.0427 | 0.0522 | 0.1194 | 0.0192 | 0.0434 |
| TA&FE | BMTP | 0.0290 | 0.0672 | 0.0221 | 0.0502 | 0.0580 | 0.1341 | 0.0261 | 0.0614 |
| TA&FD | NTP | 0.0166 | 0.0408 | 0.0119 | 0.0289 | 0.0432 | 0.1059 | 0.0160 | 0.0391 |
| TA&FD | MTP | 0.0207 | 0.0510 | 0.0137 | 0.0327 | 0.0424 | 0.1038 | 0.0129 | 0.0303 |
| TA&FD | BMTP | 0.0197 | 0.0497 | 0.0134 | 0.0319 | 0.0424 | 0.1036 | 0.0173 | 0.0423 |
| TA&FA | NTP | 0.0201 | 0.0481 | 0.0145 | 0.0345 | 0.0319 | 0.0760 | 0.0197 | 0.0455 |
| TA&FA | MTP | 0.0177 | 0.0428 | 0.0127 | 0.0303 | 0.0299 | 0.0724 | 0.0139 | 0.0321 |
| TA&FA | BMTP | 0.0232 | 0.0546 | 0.0171 | 0.0397 | 0.0414 | 0.0964 | 0.0228 | 0.0515 |
| KGD | NTP | 0.0278 | 0.0640 | 0.0212 | 0.0482 | 0.0558 | 0.1302 | 0.0257 | 0.0563 |
| KGD | MTP | 0.0274 | 0.0625 | 0.0215 | 0.0474 | 0.0530 | 0.1224 | 0.0222 | 0.0476 |
| KGD | BMTP | 0.0302 | 0.0701 | 0.0238 | 0.0528 | 0.0588 | 0.1359 | 0.0272 | 0.0618 |
| gain vs. best published baseline | 7.50% | 8.70% | 12.30% | 10.70% | 2.60% | 7.90% | 4.60% | 7.90% |
后四个数据集:
| Strategy | Pretrain | Office N@20 | Office R@20 | Software N@20 | Software R@20 | Toys N@20 | Toys R@20 | Games N@20 | Games R@20 |
|---|---|---|---|---|---|---|---|---|---|
| Scratch | – | 0.0245 | 0.0467 | 0.1034 | 0.2248 | 0.0278 | 0.0568 | 0.0556 | 0.1222 |
| TE&FT | NTP | 0.0243 | 0.0476 | 0.1056 | 0.2302 | 0.0270 | 0.0569 | 0.0537 | 0.1253 |
| TE&FT | MTP | 0.0238 | 0.0477 | 0.1068 | 0.2321 | 0.0274 | 0.0569 | 0.0539 | 0.1235 |
| TE&FT | BMTP | 0.0228 | 0.0517 | 0.1071 | 0.2309 | 0.0266 | 0.0620 | 0.0537 | 0.1252 |
| TA&FT | NTP | 0.0241 | 0.0488 | 0.1056 | 0.2275 | 0.0284 | 0.0576 | 0.0541 | 0.1258 |
| TA&FT | MTP | 0.0238 | 0.0477 | 0.1054 | 0.2285 | 0.0264 | 0.0569 | 0.0542 | 0.1232 |
| TA&FT | BMTP | 0.0236 | 0.0476 | 0.1070 | 0.2323 | 0.0285 | 0.0575 | 0.0537 | 0.1262 |
| TE&FE | NTP | 0.0257 | 0.0563 | 0.1070 | 0.2429 | 0.0274 | 0.0629 | 0.0604 | 0.1370 |
| TE&FE | MTP | 0.0240 | 0.0509 | 0.1058 | 0.2409 | 0.0268 | 0.0592 | 0.0589 | 0.1331 |
| TE&FE | BMTP | 0.0278 | 0.0602 | 0.1092 | 0.2436 | 0.0298 | 0.0673 | 0.0629 | 0.1434 |
| TA&FE | NTP | 0.0255 | 0.0566 | 0.1071 | 0.2435 | 0.0274 | 0.0631 | 0.0601 | 0.1377 |
| TA&FE | MTP | 0.0242 | 0.0515 | 0.1059 | 0.2399 | 0.0265 | 0.0590 | 0.0585 | 0.1318 |
| TA&FE | BMTP | 0.0275 | 0.0604 | 0.1094 | 0.2429 | 0.0295 | 0.0667 | 0.0618 | 0.1405 |
| TA&FD | NTP | 0.0149 | 0.0361 | 0.0654 | 0.1616 | 0.0169 | 0.0407 | 0.0396 | 0.0982 |
| TA&FD | MTP | 0.0184 | 0.0423 | 0.0642 | 0.1639 | 0.0199 | 0.0474 | 0.0425 | 0.1040 |
| TA&FD | BMTP | 0.0184 | 0.0440 | 0.0758 | 0.1894 | 0.0193 | 0.0460 | 0.0472 | 0.1139 |
| TA&FA | NTP | 0.0200 | 0.0456 | 0.0948 | 0.2180 | 0.0155 | 0.0359 | 0.0408 | 0.0968 |
| TA&FA | MTP | 0.0176 | 0.0403 | 0.0931 | 0.2195 | 0.0138 | 0.0322 | 0.0386 | 0.0895 |
| TA&FA | BMTP | 0.0226 | 0.0494 | 0.0954 | 0.2186 | 0.0212 | 0.0483 | 0.0509 | 0.1168 |
| KGD | NTP | 0.0262 | 0.0576 | 0.1099 | 0.2411 | 0.0285 | 0.0637 | 0.0601 | 0.1396 |
| KGD | MTP | 0.0255 | 0.0536 | 0.1097 | 0.2394 | 0.0261 | 0.0584 | 0.0595 | 0.1338 |
| KGD | BMTP | 0.0292 | 0.0631 | 0.1126 | 0.2484 | 0.0305 | 0.0675 | 0.0631 | 0.1452 |
| gain vs. best published baseline | 13.60% | 11.50% | 5.10% | 2.00% | 7.40% | 7.00% | 4.50% | 5.40% |
结论:@20 与 @50 的结论完全一致——解耦所有权的优势不依赖更大的截断位置,且把标准预训练目标换成 BMTP 会带来进一步收益。
消融与分析¶
组件消融(Table 3)¶
| Setting | Office N@50 | Office R@50 | Software N@50 | Software R@50 | click AUC | click GAUC | order AUC | order GAUC |
|---|---|---|---|---|---|---|---|---|
| w/o semantic BMTP | 0.0337 | 0.0886 | 0.1374 | 0.3748 | 0.7859 | 0.7818 | 0.9002 | 0.8469 |
| w/o collaborative BMTP | 0.0338 | 0.0908 | 0.1363 | 0.3731 | 0.7854 | 0.7810 | 0.8986 | 0.8459 |
| w/o ACR | 0.0350 | 0.0932 | 0.1369 | 0.3753 | 0.7829 | 0.7790 | 0.8950 | 0.8426 |
| ACR + share-param + freeze dense | 0.0279 | 0.0771 | 0.1259 | 0.3568 | 0.7833 | 0.7797 | 0.8972 | 0.8435 |
| ACR + share-param + finetune all | 0.0331 | 0.0884 | 0.1344 | 0.3659 | 0.7847 | 0.7811 | 0.9000 | 0.8451 |
| Align capacity with KGD | 0.0267 | 0.0608 | 0.1224 | 0.3240 | 0.7839 | 0.7802 | 0.8962 | 0.8439 |
| KGD full | 0.0352 | 0.0938 | 0.1381 | 0.3775 | 0.7867 | 0.7826 | 0.9015 | 0.8477 |
逐项分析:
- BMTP(学什么):两个过滤器角色互补,在工业规模上最明显——去掉协同(图)过滤器在头部用户请求(按活跃度前 30%)上损失 0.5% AUC,去掉语义过滤器在尾部用户(后 30%)上损失 1% AUC。头部用户的行为被共现图刻画得很好,而稀疏的尾部用户依赖语义一致性。Amazon 上看不到这种分离,因为其激进采样扭曲了真实用户分布。
- ACR(写几何):移除 ACR、直接读取预训练 embedding,全线下滑(工业 click AUC 0.7867→0.7829):任务无法只从一个只读 encoder 里获得判别几何。
- Read-only 解耦(骨干分离):保留 ACR 但把它放到一个共享骨干上,无论冻结(0.7833)还是全量微调(0.7847),都仍劣于完整 KGD——item 级校准本身不够。在共享参数上知识和几何持续竞争,且任务头拿不到一份为自身目标重新投影的上下文化表征,而这只有一个独立的、读取 encoder 的任务骨干才能提供。
- 容量不是原因:把共享骨干的参数量对齐到 KGD("Align capacity with KGD")仍落后于 KGD,在稀疏公开数据集上甚至倒退(Office N@50 0.0267 vs KGD 0.0352),因为放大的共享空间过拟合。收益来自容量如何被拥有——知识归 encoder、几何归 task learner——而不是容量有多少。
可扩展性分析(Table 8,工业设定)¶
| Setting | click AUC | click GAUC | order AUC | order GAUC |
|---|---|---|---|---|
| Scaling in task-specific parameters | ||||
| tasks share parameters | 0.7867 | 0.7826 | 0.9015 | 0.8477 |
| tasks independent parameters | 0.7883 | 0.7839 | 0.9033 | 0.8479 |
| Scaling in each side | ||||
| 2-layer encoder + 2-layer task learner | 0.7867 | 0.7826 | 0.9015 | 0.8477 |
| 4-layer encoder + 2-layer task learner | 0.7895 | 0.7853 | 0.9048 | 0.8518 |
| 2-layer encoder + 4-layer task learner | 0.7891 | 0.7848 | 0.9053 | 0.8525 |
| 4-layer encoder + 4-layer task learner | 0.7907 | 0.7859 | 0.9061 | 0.8529 |
分析:因为所有权解耦,容量可以被独立分配到两侧——扩大 encoder 精化被刷新的行为知识,扩大 task learner 表达更丰富的几何,per-task 独立的 learner 参数再带来一层增益。与共享骨干(新增容量被两个对抗目标瓜分)不同,解耦把 scaling 变成一次有目标的分配:encoder 容量买知识、task-learner 容量买几何,这与部署中成本被切分的方式一致。
预训练表征本身的质量(Table 6、Table 7)¶
直接下一 item 预测(不经下游适配,直接用预训练 encoder 做召回):
| Dataset | Method | N@5 | N@10 | N@20 | N@50 | R@5 | R@10 | R@20 | R@50 |
|---|---|---|---|---|---|---|---|---|---|
| Arts | NTP | 0.0131 | 0.0179 | 0.0229 | 0.0302 | 0.0247 | 0.0398 | 0.0596 | 0.0963 |
| Arts | MTP | 0.0112 | 0.0154 | 0.0202 | 0.0269 | 0.0193 | 0.0324 | 0.0514 | 0.0855 |
| Arts | BMTP | 0.0149 | 0.0203 | 0.0258 | 0.0334 | 0.0268 | 0.0438 | 0.0656 | 0.1041 |
| Beauty | NTP | 0.0108 | 0.0144 | 0.0181 | 0.0237 | 0.0195 | 0.0307 | 0.0454 | 0.0737 |
| Beauty | MTP | 0.0089 | 0.0119 | 0.0152 | 0.0203 | 0.0145 | 0.0239 | 0.0371 | 0.0631 |
| Beauty | BMTP | 0.0125 | 0.0163 | 0.0202 | 0.0259 | 0.0217 | 0.0337 | 0.0492 | 0.0776 |
| CDs | NTP | 0.0275 | 0.0365 | 0.0446 | 0.0549 | 0.0518 | 0.0796 | 0.1117 | 0.1638 |
| CDs | MTP | 0.0215 | 0.0296 | 0.0372 | 0.0474 | 0.0400 | 0.0650 | 0.0953 | 0.1469 |
| CDs | BMTP | 0.0326 | 0.0431 | 0.0524 | 0.0638 | 0.0592 | 0.0916 | 0.1286 | 0.1863 |
| Phones | NTP | 0.0139 | 0.0182 | 0.0226 | 0.0290 | 0.0240 | 0.0374 | 0.0547 | 0.0871 |
| Phones | MTP | 0.0111 | 0.0143 | 0.0179 | 0.0236 | 0.0170 | 0.0268 | 0.0411 | 0.0701 |
| Phones | BMTP | 0.0141 | 0.0190 | 0.0236 | 0.0302 | 0.0253 | 0.0404 | 0.0588 | 0.0920 |
| Office | NTP | 0.0139 | 0.0177 | 0.0215 | 0.0268 | 0.0248 | 0.0368 | 0.0518 | 0.0786 |
| Office | MTP | 0.0118 | 0.0151 | 0.0185 | 0.0234 | 0.0195 | 0.0298 | 0.0431 | 0.0681 |
| Office | BMTP | 0.0168 | 0.0212 | 0.0253 | 0.0311 | 0.0275 | 0.0411 | 0.0572 | 0.0867 |
| Software | NTP | 0.0625 | 0.0826 | 0.1035 | 0.1300 | 0.1061 | 0.1686 | 0.2512 | 0.3851 |
| Software | MTP | 0.0629 | 0.0820 | 0.1024 | 0.1284 | 0.1025 | 0.1618 | 0.2428 | 0.3742 |
| Software | BMTP | 0.0588 | 0.0762 | 0.0946 | 0.1201 | 0.0917 | 0.1456 | 0.2189 | 0.3480 |
| Toys | NTP | 0.0146 | 0.0188 | 0.0227 | 0.0279 | 0.0264 | 0.0395 | 0.0549 | 0.0810 |
| Toys | MTP | 0.0110 | 0.0147 | 0.0182 | 0.0232 | 0.0196 | 0.0311 | 0.0451 | 0.0705 |
| Toys | BMTP | 0.0174 | 0.0223 | 0.0267 | 0.0325 | 0.0301 | 0.0453 | 0.0627 | 0.0919 |
| Games | NTP | 0.0300 | 0.0412 | 0.0526 | 0.0683 | 0.0562 | 0.0910 | 0.1363 | 0.2160 |
| Games | MTP | 0.0275 | 0.0375 | 0.0480 | 0.0626 | 0.0477 | 0.0789 | 0.1206 | 0.1944 |
| Games | BMTP | 0.0333 | 0.0450 | 0.0566 | 0.0725 | 0.0605 | 0.0967 | 0.1431 | 0.2231 |
item embedding 的品类纯度(Table 7):
| Method | Arts | Beauty | CDs | Software | Games |
|---|---|---|---|---|---|
| From Scratch | 0.2194 | 0.2732 | 0.2040 | 0.1862 | 0.4720 |
| Pretrained | 0.5074 | 0.3192 | 0.4022 | 0.3941 | 0.7274 |
分析:在下游适配之前,encoder 就应当编码目录级的行为结构,而不只是充当任务模型的初始化。两个探针都支持这一点:直接下一 item 预测里 BMTP 在 8 个基准中的 7 个取得最好 NDCG 与 Recall;纯度指标上,预训练 embedding 在所有评测基准上都显著高于从零训练。
唯一的例外是 Software:BMTP 在下游适配前不如 NTP/MTP。作者的解释是 Software 目录小、交互密度高,相邻转移本身已经相对可靠,去噪反而会移除有用的局部信号。但这不影响 BMTP 在完整 KGD 流水线中的角色——经过任务适配后,KGD+BMTP 在 Software 上仍然取得最好的下游性能(N@50 0.1381)。这一对比恰好呼应论文的核心论点:encoder 负责改善目录级行为结构,而 read-only 的 task learner 决定这份结构如何被转换成任务特定的检索几何。
阈值敏感性(Figure 8、Figure 9)¶
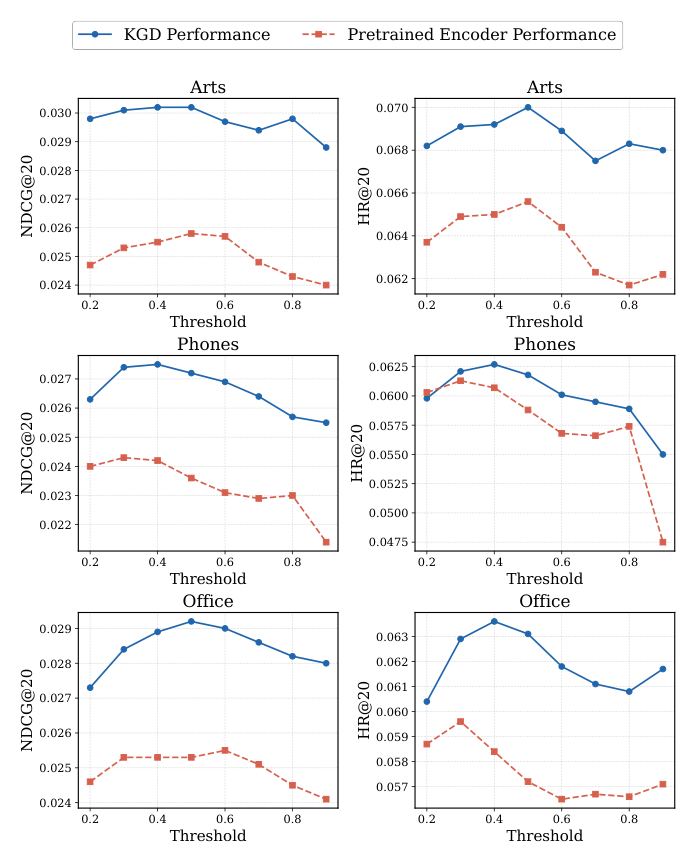
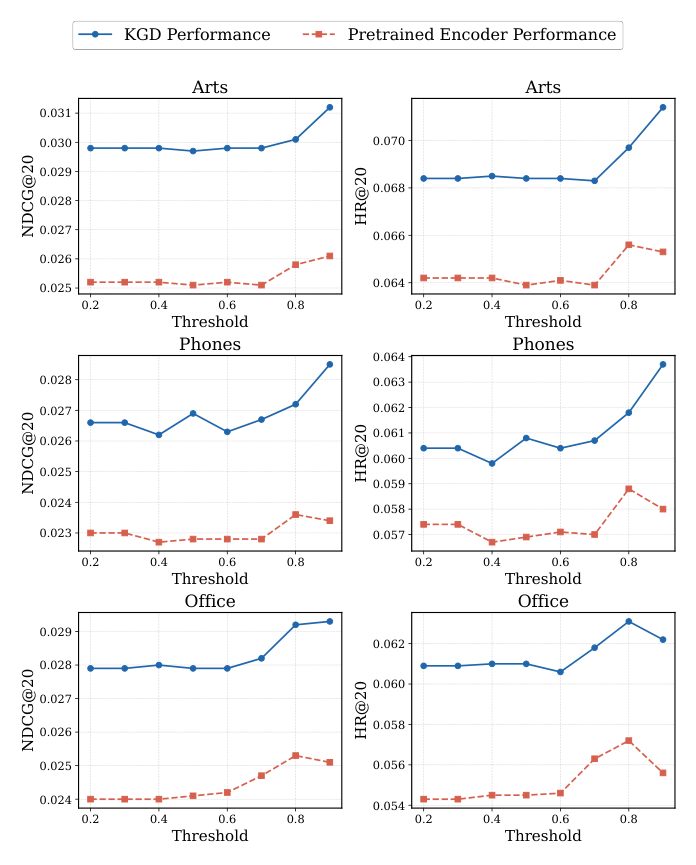
去噪目标对两个阈值都敏感,但在多数数据集上存在清晰稳定的最优区间:协同阈值 $\tau_\mathrm{col}$ 最优通常落在 [0.4, 0.6]——太小保留噪声转移,太大则移除有用的共现结构;语义阈值 $\tau_\mathrm{sem}$ 的最优区间更高,约 [0.8, 0.9],说明内容高度相似的 item 往往携带强行为相关性。
一个有工程价值的观察:预训练阶段曲线与任务训练阶段曲线趋势一致,这意味着预训练模块的直接性能可以作为下游性能的有效代理,因此最优阈值区间只需评估预训练模型本身即可确定,大幅简化了超参搜索。
线上 A/B 实验¶
KGD 部署在 Shopee Homepage Search 的排序阶段(服务十亿级用户的主搜索入口)。流量按 user-ID hash 划分为对照与实验桶各 10%(每桶超过千万用户),另设 A/A 桶做校验。对照组是从零训练、持续更新超过 6 个月的生产 OneRank 模型;实验组是 KGD,经过 1.5 个月离线交替训练后上线,并在同一份日流上更新。实验在 2026 年上半年运行两周。
结果:A/A 桶无显著差异;KGD 提升 GMV per user +1.75%、广告收入 per user +1.53%、CTR +0.95%、CVR +0.72%,其中 GMV 与收入的增益在用户级分布的双样本 t 检验下 $p<0.01$ 显著。
反转实验:上线后做了一周反转,GMV 下降 1.21%、收入下降 1.50%;作者认为正向/反转的不对称反映的是 GMV 本身的高方差,而非增益不稳定。
成本:日常离线训练从 1 小时升到 2 小时(A100 卡数不变),与 GPSD 相当;serving 延迟保持在 A30 GPU 上的 120 ms,内存因 read-only learner 翻倍。此外还通过人工评估跟踪了 per-query 的不相关 item 率,作为质量回退的安全阀。
核心贡献总结¶
- 问题重构:把"推荐里的 pretrain-then-transfer"从"一次预训练 + 迁移"重述为 refresh-native 问题——预训练必须随流刷新,于是"迁移机制必须在刷新之后依然有效"成为一等约束。这一 framing 本身是本文最有价值的部分。
- BMTP:用离线可缓存的协同/语义相似度过滤未来 item 作为监督,用"检验关系"取代"依赖位置",避免了 session 分段的两难,且不引入任何逐序列 LLM 推理,可在十亿级日志上每次刷新重跑。
- 参数所有权分离:read-only cross-attention(K/V stop-gradient)+ ACR(锚定在预训练 embedding 上的正交低秩残差 + 任务级正标量),使"刷新知识"与"写任务几何"成为互不失效的独立操作,并给出了三步观察(温度等价 → 真实任务是形变 → 形变必须正交)的推导,把残差形式论证出来而非拍出来。
- 90 天流式对照实验:在对齐预算下系统性地枚举 8 种迁移模式 × 3 种预训练目标 × 3 种调度,量化出"冻结会陈旧、纠缠刷新被抵消、回放过拟合、LoRA 自由度不足"四类失败模式,并证明刷新只有在解耦所有权下才有回报(KGD w/o ACR&RO 在 S3 下 0.7785 低于 Scratch 0.7806)。
- 全量部署与开源:Shopee Homepage Search 全量上线,GMV/user +1.75%,训练成本翻倍(1h→2h)、延迟不变,核心实现开源。
与已归档相关工作的对比¶
UniR2 UniR²: Unifying Generative Recall and Multi-Objective Ranking in a Single Decoder-Only Sequence (Kuaishou, 2026-07-27)¶
关系:独立并发(本文未引用 UniR²,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文指向同一个 root cause——一个自回归/生成式目标与一个判别式任务目标共享同一批参数时,梯度互相污染。KGD 用梯度余弦(Fig. 1(b)、Fig. 5,长期在 0 附近甚至为负)量化它;UniR² 用消融量化它(去掉 DQ-PCA 与 stop-gradient 后排序指标涨 AUC@CTR +3.97%,但生成侧 HR@1 崩塌 -44.39%)。两者都拒绝"共享一个 encoder 或一个 loss 就叫统一"的做法,转而在参数所有权层面切分。
- 相近的技术骨架:骨架几乎可以叠印——(a) 单向 stop-gradient 接口:KGD 在 read-only cross-attention 的 K/V 上加 sg,UniR² 在 ranking head 之前对共享表征加 sg;(b) 任务侧自有的低秩/独立参数通路补回适配自由度:KGD 用 ACR($Z^{(k)}B^{(k)\top}$,正交于 $e^{\mathrm{pre}}$)+ 独立 task Transformer,UniR² 用只在 ranking-view 注意力投影上生效的 LoRA;(c) 两者都明确论证"纯 stop-gradient 不够"——UniR² 说纯 sg 会冻结排序侧特征融合放大跷跷板,KGD 说纯冻结迁移改不动几何(TA&FA/TA&FD 全线最差)。
- 本文的差异与推进:(a) 冲突轴不同——UniR² 是"生成式召回 vs 多目标排序"两个同时在线的任务;KGD 是"预训练知识 vs 下游任务几何"两个时间上错开、且预训练要被反复刷新的角色,因此 KGD 多出一条 UniR² 没有的维度:刷新之后残差是否仍然有效。ACR 的"锚定"设计(相对预训练 embedding 的残差而非绝对坐标)正是为这一维度而生。(b) 对低秩路径的判断相反——UniR² 把 LoRA 当作救回排序适配能力的关键(去掉后 AUC@GTR -31.29%);KGD 则把"注意力层上的 LoRA/adapter 刷新"作为一条独立 baseline 明确否决(工业 click AUC 0.7818 vs KGD 0.7867),理由是低秩 adapter 挂在冻结骨干上时几何自由度不够。这个差异并不矛盾:UniR² 的 LoRA 作用在共享骨干的 ranking-view 投影上(改的是读法),KGD 的 ACR 作用在输入 embedding 的正交补上(改的是被读的东西),后者在输入层就重塑几何,自由度更高。(c) 验证尺度不同——UniR² 的 scaling 只测到 4 层/1024 维,且没有跨时间的稳定性实验;KGD 有 90 天轨迹与全量 A/B。
- 可比的方法/实验差异:两者都做了"移除隔离机制"的消融并给出相同方向的结论——UniR²:w/o DQ-PCA & sg 时生成侧崩溃;KGD:w/o ACR and RO 时 S3 退化为纠缠刷新、AUC 0.7785 低于不预训练的 Scratch 0.7806。两条数据从不同角度佐证了同一个判断:在结构化生成目标与判别目标之间,不做梯度隔离的共享参数会被判别侧吞掉。
PAMT PAMT: A Parametric Memory Head for Continual Generative Retrieval (University of Amsterdam, 2026-04-25)¶
关系:独立并发(本文未引用 PAMT,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两者都在处理"同一组权重上,持续到来的新更新与需要保住的既有知识互相干扰"。PAMT 把它形式化为 plasticity–stability trade-off(新 slice 学得越好、旧 slice 检索质量被侵蚀得越狠);KGD 的表述是"刷新预训练参数的同时任务在优化同一批权重,等于把两个冲突目标压在一个参数集上"。两者也都明确指出LoRA/Adapter 这条 PEFT 路线不够——PAMT 实测 LoRA 仍然引发灾难性遗忘,KGD 实测 LoRA 刷新(0.7818)几何自由度不足。
- 相近的技术骨架:都走"主干只负责知识、把需要独立演化的那部分写进一个旁挂的、写权限受限的参数集"。PAMT 冻结主干,只在 product-key memory head 的 value 行上做稀疏更新(AF×IHF 选行),把跨 slice 干扰限制在被选中的少数行内;KGD 冻结 encoder(对任务而言只读),把任务几何写进 ACR 的低秩正交残差与独立 task Transformer。两者都刻意避免回放历史监督(PAMT 不 rehearse legacy supervision,KGD 明确把 buffer replay 列为失败模式并实测最差:0.7732,低于 Scratch)。
- 本文的差异与推进:(a) 谁在动、谁被冻恰好相反——PAMT 冻主干、只让旁挂 memory 更新,本质是保住旧知识;KGD 让 encoder 每天刷新、冻的是"任务看到的那份 encoder",本质是主动追踪漂移。这个差别来自问题设定:PAMT 的文档语料是累积的(旧 slice 仍要被检索),而 KGD 的行为分布是换血的(JSD 持续上升,旧模式再也不重现),所以"保住旧知识"在 KGD 的场景里反而是错的目标。(b) 两阶段 vs 同时进行——PAMT 是 Stage 1 适配主干 / Stage 2 memory-only 校准的顺序流程;KGD 是每日"刷新 encoder 一遍 + 冻结后训 learner"的交替,但两个所有者的接口是恒定的,不存在"先压缩后建模"的阶段解耦瓶颈。(c) 正交性约束是 KGD 独有的:PAMT 的 memory 行更新没有"不得抵消主干方向"的显式约束,KGD 则用式 (13) 的余弦平方正则显式保证任务残差落在预训练方向的补空间——这是它敢让 task learner 回头读取被 ACR 改过的那份 embedding 的前提。
- 可比的方法/实验差异:PAMT 在 MS MARCO / NQ 的学术持续检索设定上把 BWT± 从 -55 提到 -15、-36 提到 -9;KGD 没有报告遗忘类指标,而是用 90 天生产流上的 AUC 轨迹衡量同一件事(冻结迁移随时间侵蚀、KGD 保持)。两者的评价工具不同,但测的都是"持续更新下知识是否被保住"。
被剔除的近似候选(供追溯):
- Multi-Decoder OneRec Multi-Decoder OneRec(Kuaishou):机制高度相似(共享底座 + 每目标独立 LoRA 专家 + 共享参数处 stop-gradient 梯度路由),但冲突轴是多个业务目标之间的跷跷板,既没有"预训练知识 vs 任务几何"的对立,也没有刷新/漂移维度 → 剔除。
- DACT DACT(Fudan):同样面向持续漂移下的 stability-plasticity,但解法走的是collaborative tokenizer 的码本漂移识别与层级重分配,与"参数所有权分离 + 正交残差"没有骨架重合 → 剔除。
- DUET DUET(Meta)/ Mosaic Mosaic(Meta):都是"上游预训练用户表征冻结后供多个下游 ranker 消费",正好落在 KGD 批评并实测的 frozen transfer(TE&FE / TA&FE)家族内;但它们的问题动机是表征复用与迭代效率,不是梯度冲突,且结构上没有让任务侧回写几何的通路 → 剔除。
- AKT-Rec AKT-Rec(Alibaba):用 stop-gradient 非对称 InfoNCE 做单向知识迁移以保护强侧,机制像,但问题是头部→长尾的知识迁移,与预训练-任务目标冲突无关 → 剔除。
- Embedding Items at Scale: Comparing GNN-Based and ID-Based Item Embeddings in the Yandex Ecosystem(Yandex):问题同域(预训练表征到底值不值得迁给生产 ranker,结论是大规模下不值),但它是实证研究、没有方法骨架 → 剔除。
讨论与局限性¶
值得借鉴的设计¶
- "锚定残差"这个抽象值得推广。 把任务几何写成相对于预训练 embedding 的残差而非绝对坐标,是本文最可复用的一招:底座移动时残差自动跟随,于是"上游模型刷新"与"下游适配存续"从互斥变成正交。任何"上游 foundation model 高频更新、下游任务模型低频重训"的工业系统都可以照抄这个模式。
- 三步观察把残差形式推导出来,而不是拍出来。 从"温度等价 → 全局缩放"到"真实任务改变目标函数与负样本分布 → 需要方向相关形变"再到"形变不能反向旋转 → 必须正交",这条链条把 $s_k\cdot\mathrm{sg}(e^{\mathrm{pre}})+\Delta e\perp e^{\mathrm{pre}}$ 的形式逼了出来。相比大量"我们加了个残差模块"的论文,这里的论证密度明显更高。
- "检验关系而不是位置"的去噪思路。 BMTP 拒绝在序列上切 session,改为在监督对上做相似度门控,既回避了"跨天持续兴趣被切断 / 同 session 拼接无关意图"的两难,又保持了 O(1) 的额外训练成本(相似度离线缓存)。这一点比 LLM 重标注路线在工业上可行得多。
- S1/S2/S3 三调度的实验设计。 把"刷新的价值"和"迁移机制的价值"用调度维度正交拆开,是这类流式研究里少见的干净设计,也直接产出了论文最反直觉的数据点:在共享参数上刷新是负收益。
局限与争议¶
- 公开实验完全没有验证"可刷新性"这一核心卖点。 8 个 Amazon 基准用的是官方静态 leave-one-out 划分,作者自己也承认它"不是为测试 refreshability 而设计"。因此论文最独特的贡献(refresh-native)只有工业内部数据一条证据链,外部无法复现。作者用一整段解释了为什么现有公开流式数据集都不合适(KuaiRand 用户过于活跃、JDsearch/Tenrec 特征加密、Criteo 序列不足、KuaiSearch/MUSE 缺时间戳),理由成立,但结果仍是核心主张不可复现。
- 成本翻倍且被轻描淡写。 每天要跑"encoder 刷新一遍 + 冻结后再跑一遍合并图",训练时长 1h→2h;serving 侧 dense 参数翻倍、稀疏 embedding +20%、内存翻倍。论文用"与 GPSD 相当"和"延迟不变"来化解,但这套账的前提是基线本来就要跑一次 encoder;对于当前没有预训练阶段的团队,这是从 1 倍到 2 倍的实打实成本。
- A/B 的反转实验没有对称复现增益。 正向 +1.75% GMV,反转只掉 1.21%;作者归因于 GMV 高方差。这个解释可能成立,但反转幅度小于正向幅度通常也是"存在新奇效应或桶间残差"的信号,论文没有给出反转期的显著性检验,这一点比正向结果弱。
- BMTP 的收益并非无条件。 Table 6 显示 Software 上 BMTP 在预训练阶段直接被 NTP/MTP 击败(R@50 0.3480 vs 0.3851,差距不小),Table 1 里 BMTP 在全量微调(TE&FT/TA&FT)下多个数据集上是负增益(Phones N@50 -8.2%、-4.9%)。也就是说 BMTP 与"不覆写"的迁移方式是绑定销售的:单独把 BMTP 拿去配全量微调,很可能得到负收益。论文对此是诚实的,但这也意味着方法的适用面比摘要里的"4–12%"要窄。
- 两个阈值是敏感超参。 $\tau_\mathrm{col}\in[0.4,0.6]$、$\tau_\mathrm{sem}\in[0.8,0.9]$ 的最优区间虽稳定,但论文自己说"对两个阈值都敏感"。好在作者给出了用预训练阶段指标作为下游代理的省事调法,这条工程经验有实用价值。另外协同相似度依赖 LightGCN 图 embedding、语义相似度依赖 Qwen3-Embedding,等于把两个外部离线组件引入了刷新链路——这两个组件自身的刷新周期与陈旧问题论文没有讨论。
- 方法论可扩展性方面的隐忧较轻但存在。 KGD 明确避开了"先离线压缩再在线建模"的两阶段瓶颈:encoder 与 task learner 都是活的 Transformer,Table 8 也证明两侧容量可以独立 scaling 且同时受益(4+4 层最佳)。这比"码本一旦固化就锁死下游表征空间"的路线健康得多。但仍有一处固化:task learner 只能读取 encoder 的最后一层隐状态($K,V=\mathrm{sg}(H^{(L)})$),当 encoder 被 scaling 到很深时,中间层的层级信息对任务是不可见的;论文在 C.4 里把"reading depth"列为设计维度之一却没有做这方面的实验。
- 与 baseline 的公平性存在一处不对称:KGD 相对共享参数 baseline 多出一整个 task Transformer 与一份低维 item embedding。作者用"Align capacity with KGD"这一行消融回应了容量质疑(对齐参数量后仍落后,稀疏数据上甚至倒退),这条消融很关键;但"对齐容量"的具体做法(加宽还是加深共享骨干)没有细说。
工业落地价值¶
这篇是部署证据非常完整的一类工业论文:Shopee Homepage Search 全量上线(对照组是持续训练 6 个月的生产 OneRank)、10% × 2 桶 + A/A 校验、两周实验期、GMV/收入的 $p<0.01$ 显著性、反转实验、人工评估的不相关率安全阀、明确的成本账(1h→2h 训练,120 ms 延迟不变,内存翻倍)。对于已经在跑"生成式预训练 + 判别式排序"路线(GPSD/SORT/PinFM 谱系)且面临"预训练模型多久刷新一次"这一实际问题的团队,本文的 S1/S2/S3 对照表本身就是一份可直接参考的决策依据:如果不打算改造参数所有权,那么把预训练模型接进日更流水线大概率是负收益。