Embedding Items at Scale:GNN 预训练 item embedding 与端到端 ID embedding 的工业对照(Yandex)¶
来自 Yandex(Sergei Makeev、Artem Matveev、Vladimir Baikalov、Kirill Khrylchenko,全部 Yandex Moscow),2026-07-29 挂 arXiv(2607.26365v1, cs.IR)。这是一篇case study(案例研究),不提出任何新方法,只回答一个工业界反复遇到的抉择:transformer 序列推荐里的 item 表示,到底该由一个独立的预训练阶段(图神经网络)产出,还是直接和 transformer 端到端一起学? 作者把两种表示插进同一套生产 two-tower ranker 的 item tower,在 Yandex Market(电商)、Yandex Music(音乐流媒体)两个成熟生产系统上跑大规模对照,再补一个从 Yandex Lavka(生鲜电商)日志采样出的低资源数据集(数据与代码已开源)。结论是一条明确的规模依赖(scale-dependent)结论:训练数据有限时,单独的 embedding 预训练阶段有用;数据充足的大规模模型上,它带来的收益不值那份额外成本。
研究动机与背景¶
序列推荐(sequential recommendation)的目标是:根据用户过去的交互,预测他下一个会交互的 item。基于 transformer 的模型已在大规模工业系统中被广泛采用——论文点名的部署清单包括 Pinterest、ByteDance、Taobao、Kuaishou、Zalando、Yandex 等。这类模型的输入是按时间排序的 user-item 交互序列,输出是个性化推荐。而一切都建立在「序列里的 item 怎么编码」这个前提之上——这正是本文的靶心。论文把现有做法归为两条路线。
路线一:ID embedding(端到端学)¶
最直接的做法是把 item ID 映射到与 transformer 联合学习的 embedding,不设独立的 embedding 训练阶段。但现代推荐系统的 item catalog 又大又高度动态,给每个 item ID 都分配一个专属 embedding 并不现实。于是引入 hashing trick:用哈希函数把 item ID 映射到一张固定大小 embedding 表的索引上。为降低碰撞,multihash 技术对同一个 item ID 施加多个哈希函数,取出若干表项后再用求和或拼接合并。论文特别指出,Coleman 等人报告过这类 multihash embedding 已在 Google 的多种 web 规模搜索、广告、推荐模型中部署。
路线二:预训练 item embedding(图表示学习)¶
另一条路是使用预训练 item embedding。用户交互天然可以表示成一张异质图(heterogeneous graph):节点是用户和 item,边是点击、购买、点赞等关系。图表示学习的目标是学出高质量的节点 embedding,之后拿来当 transformer 的 item embedding 用。Pinterest 报告过这类多阶段系统的部署(PinnerFormer、TransAct、TransAct V2)。
沿用 Hamilton 等人的观点,图表示学习可以看作一个 encoder-decoder 问题:encoder 把节点映射为 embedding,decoder 重建图结构。GNN 可分为两类:
(1) Transductive GNN(直推式)——直接训练节点 embedding,要求所有节点在训练时都在场;新节点出现就必须重训。TwHIN(El-Kishky 等,部署于 X / 原 Twitter)是这类里简单但高效的代表。它的 encoder 把节点集 $\mathcal{V}$ 与关系集 $\mathcal{R}$ 映射到被直接训练的 embedding:$\mathrm{ENC}(\cdot) = \theta_\cdot \in \mathbb{R}^d$,$d$ 为 embedding 维度;因此被训练的参数可以看作一个 embedding 矩阵 $\Theta \in \mathbb{R}^{(|\mathcal{V}|+|\mathcal{R}|)\times d}$。decoder 重建一条由两个节点 $s,t \in \mathcal{V}$ 与关系 $r \in \mathcal{R}$ 构成的边 $e=(s,r,t)$ 存在与否的 logit:
$$\mathrm{DEC}(e) = \mathrm{DEC}(\mathrm{ENC}(s), \mathrm{ENC}(r), \mathrm{ENC}(t)) = (\theta_s + \theta_r)^{T}\theta_t \tag{1}$$
模型被训练成最大化「真 / 假」二分类的对数似然——正样本是异质图 $\mathcal{G}$ 里观测到的边,负样本来自负采样 $\mathcal{N}(\cdot)$:
$$\arg\max_{\Theta} \sum_{e \in \mathcal{G}} \left[ \log \sigma(\mathrm{DEC}(e)) + \sum_{e' \in \mathcal{N}(e)} \log \sigma(-\mathrm{DEC}(e')) \right] \tag{2}$$
其中
$$\mathcal{N}(s,r,t) = \{(s,r,t') : t' \in \mathcal{V}\} \cup \{(s',r,t) : s' \in \mathcal{V}\} \tag{3}$$
即把正边的 source 或 target 替换掉得到的负边集合。注意 TwHIN 的 encoder 本质上就是一张可训练的查找表——它并不聚合邻居特征,所谓「图」只体现在训练目标(重建边)里。
(2) Inductive GNN(归纳式)——学的是一个可泛化的参数化函数,而不是特定节点的 embedding。该函数依据邻居的特征聚合其局部邻域信息;因此训练时不需要完整图,未见过的新节点也能自然处理。本文用的是 MultiBiSage(Gurukar 等),它扩展了 PinSage(PinSage 正是 Pinterest 生产模型里 item embedding 的来源),并适配到异质图。做法是把异质图 $\mathcal{G}$ 分解成多张二部图(bipartite graph) $\mathcal{G}_r$,每张只含一种关系 $r \in \mathcal{R}$。MultiBiSage 的 encoder 用一个 transformer 处理节点 $s \in \mathcal{V}$ 及其在每张二部图 $\mathcal{G}_r$ 中邻居的视觉与文本特征,得到中间表示;再用另一个 transformer 把所有二部图上的表示聚合成最终 embedding $e^{\theta}_s$($\theta$ 为 encoder 参数)。decoder 用 sampled softmax 学习「$t$ 与 $s$ 相似」的概率分布 $p(t\mid s)$:
$$\arg\max_{\theta} \sum_{(s,t)} \log \left( \frac{\exp\{\langle e^{\theta}_s, e^{\theta}_t\rangle - \log Q(t)\}}{\sum_{t' \in \mathcal{N}} \exp\{\langle e^{\theta}_s, e^{\theta}_{t'}\rangle - \log Q(t')\}} \right) \tag{4}$$
其中 $\mathcal{N}$ 是 in-batch 负样本与均匀采样负样本的并集,即 Mixed Negative Sampling;$\log Q(t)$ 是 logQ 校正项(采样偏差修正)。
本文要回答的问题¶
论文把预训练 TwHIN / MultiBiSage embedding 统称 GNN embeddings,把与 transformer 从零端到端训练的 multihash item ID embedding 统称 ID embeddings,在两个成熟生产系统 + 一个公开低资源数据集上做对照。关键是同时分析质量与成本,判断「多加一个预训练阶段」到底值不值。作者强调:据其所知,此前没有工作在大规模工业场景下同时从成本和质量两个角度比较过这两个选项。
核心方法:统一的生产 ranker 与两种 item 表示的插拔¶
序列推荐的任务定义:给定用户 $u$ 的交互历史 $x^u = \left(i^u_1, i^u_2, \dots, i^u_{l_u}\right)$($l_u$ 是用户 $u$ 的交互数),推荐最相关的 item。本文聚焦 ranking(排序)模型,沿用 Khrylchenko & Fritzler 的生产排序设置,把 transformer ranker 的训练拆成 pretraining(预训练) 与 fine-tuning(微调) 两个阶段;两个阶段里用户都由其交互历史 $x^u$ 表示。
模型架构(two-tower)¶
用的是生产环境的 two-tower 架构:user tower 是交互序列上的 transformer,item tower 是残差网络。
item tower 把 item 标题与 item embedding(GNN 或 ID)结合起来:
- 一个 embedding bag 层把 BPE 分词后的标题映射为 token embedding 并求和;BPE 词表规模 $O(10^5)$。
- item embedding 被加到标题表示上——这是全文最关键的「插拔点」:两种 item 表示走的是完全同一条通路,唯一变量就是这一项的来源。
- 一个线性层把结果投影到更高维空间,接三个残差 block;每个 block 由线性层、ReLU、dropout、Layer Normalization 组成。
- 最后一个线性层把 embedding 映射回原始维度,输出做 $L_2$ 归一化。
user tower 编码用户交互历史:先对序列中每个 item 施加 item tower;然后按元素加上可学习的 action embedding(可能的 action 集合随平台而定)与位置 embedding;再拼上一个 CLS token;过一个双向 transformer encoder,取 CLS 位置的 $L_2$ 归一化输出作为用户表示。
user 与 item embedding 的点积(因为两侧都已 $L_2$ 归一化,等价于余弦相似度)即相关性分数 $r_{ui}$。
预训练目标:next-item prediction¶
预训练被表述为下一个 item 预测:对每个 $k$,给定子序列 $\left(i^u_1, i^u_2, \dots, i^u_{k-1}\right)$,模型预测 $i^u_k$。用带 in-batch 负样本的 sampled softmax 损失,在整个 item catalog 上学一个概率分布:
$$\mathcal{L}_{pretrain}(u, i^u_k, \mathcal{N}) = -\log \frac{\exp\{r_{u i^u_k}/\tau\}}{\exp\{r_{u i^u_k}/\tau\} + \sum_{n \in \mathcal{N}} \exp\{r_{un}/\tau\}} \tag{5}$$
其中 $r_{ui}$ 是用户 $u$ 与 item $i$ 的相关性分数,$\mathcal{N}$ 是 in-batch 负样本集,$\tau$ 是温度参数。
微调目标:pointwise + pairwise 混合排序损失¶
微调训练模型对候选 item 排序。对每次用户请求,推荐系统返回展示给用户 $u$ 的 $s^u$ 个 item:$\mathcal{I}^u = \{i^u_1, \dots, i^u_{s^u}\}$;每个 item 对应的用户行为 $\mathcal{A}^u = \{a^u_1, \dots, a^u_{s^u}\}$ 被记录下来,用于计算 pointwise 与 pairwise 排序损失。
Pointwise 被表述为点击预测:
$$\mathcal{L}_{pt}(u,i) = -t_{ui}\log f^{pt}_{ui} - (1-t_{ui})\log(1 - f^{pt}_{ui}) \tag{6}$$
其中 $f^{pt}_{ui} = \sigma(\alpha \cdot r_{ui} + \beta)$,$\alpha,\beta$ 是可训练参数,$t_{ui} = \mathbb{1}\left\{a^u_i = \text{“click”}\right\}$。这里的 $\alpha,\beta$ 相当于一个可学习的校准(calibration)变换,把余弦相似度拉到概率标度上。
Pairwise 部分:在被视为正交互的 item $i^u_p$ 与用户未交互的 item $i^u_n$ 之间构造所有配对,沿用 Bai 等人的损失:
$$\mathcal{L}_{pr}(u, i^u_p, i^u_n) = -\log \frac{f^{pr}_{up}}{f^{pr}_{up} + f^{pr}_{un}} \tag{7}$$
其中 $f^{pr}_{ui} = \sigma(\delta \cdot r_{ui} + \gamma)$,$\delta,\gamma$ 是可训练参数(与 pointwise 的 $\alpha,\beta$ 分开,即两个目标各有自己的标度)。
微调总损失是两者的加权和,pairwise 项权重为 $1/10$:
$$\mathcal{L}_{finetune}(u, \mathcal{I}^u, \mathcal{A}^u) = \sum_{i \in \mathcal{I}^u} \mathcal{L}_{pt}(u,i) + \frac{1}{10}\sum_{(i^u_p, i^u_n)} \mathcal{L}_{pr}(u, i^u_p, i^u_n) \tag{8}$$
评测协议:CatBoost 增量 + 32 折 Wilcoxon 检验¶
对比方式是把每种 embedding 插进 item tower 后训 transformer。微调后的模型输出 ranking score,这些分数连同其他统计特征一起作为生产 CatBoost ranker 的输入。为衡量 transformer 模型的贡献,作者把 CatBoost ranker 训两遍——一遍带这些 ranking score、一遍不带——报告指标的相对差异。所有实验都用基于时间戳的 train/test 切分。
这一层设计很重要:报出来的所有百分数都不是「模型 A vs 模型 B」的直接差,而是「把 A 的分数塞进生产 CatBoost 后相对无 transformer 特征基线的增量」。因此表格里 TwHIN 的 +0.790% 与 ID 的 +1.238% 之间的差值,才是两种 embedding 的真实差距。
统计显著性检验:把 CatBoost 数据集切成 32 等份 fold;对每个 fold,在该 fold 上分别训「基线 CatBoost」和「带额外特征的 CatBoost」,在剩余数据上算指标;用 Wilcoxon 符号秩检验比较结果,只报 $p<0.01$ 显著的差异。
实验设置¶
三个 Yandex 平台:Yandex Market(电商)、Yandex Music(音乐流媒体)、Yandex Lavka(生鲜电商)。前两者用已发表的生产模型与大规模内部数据集,用于给出「大规模模型」的结论;Lavka 上训一个更小的模型跑低资源数据集,数据与代码开源(GitHub)。作者明确声明:比较 GNN 与 ID embedding 时,两者是在同一个 item 集合上获取的。
3.1 Yandex Market¶
研究问题:
- RQ1:在大规模场景下,预训练 GNN embedding 是否带来比 ID embedding 更好的排序质量?
- RQ2:把两种 embedding 结合起来,是否带来值得的提升?
数据:Yandex Market 上一年期的用户日志,服务数百万用户,含 $O(10^7)$ 个 item;用户行为包括点击、加购、点赞、购买。测试数据取训练期之后的两天。
GNN item embedding 用 TwHIN 与 MultiBiSage 训练。embedding 只对最热门 17% 的 item 计算(这部分覆盖了大多数用户交互),其余所有 item 共享一个 embedding。
- TwHIN:构造 user-item 异质图,边表示点击、下单、点赞、加购。
- MultiBiSage:构造两张二部图——item-cart 图(item 连到其被加入的购物车)与 item-order 图(item 连到已完成的订单)。为抑制流行度偏差(popularity bias),对图做剪枝:限制每个节点最多几千条边;并剔除归一化熵超过阈值的 cart / order 节点——熵在 item 类目上计算,归一化是相对于 cart 或 order 的大小而非类目数量(直觉:一个装了大量互不相关类目商品的购物车,对「什么和什么相似」几乎没有信息量)。每张二部图上用 4 层 transformer 处理视觉与文本表示,再用 2 层 transformer 聚合两张图的向量。沿用 Gurukar 等的做法,用随机游走为每个节点采样 50 个邻居定义局部邻域。正样本 item 对的构造是:source item 为用户浏览的 item,target item 为用户从「相似商品」推荐位点击的 item。
- ID embeddings:embedding 矩阵 $O(10^6)$ 条目、64 维;multihash 用 6 次查表,取出的 embedding 拼接后再投影回初始维度。
transformer 处理最长 256 个事件的序列。为回答 RQ2,把 TwHIN 与 ID embedding 同时放进 item tower 研究其联合效应。报告三个推荐位(surface)的离线相对 nDCG 差异:retargeting(无约束的个性化设置,类似 eBay 的 Recently Viewed Items 模块)、discovery(限制只推此前未见过的 item)、以及购物车页推荐(cart)。
3.2 Yandex Music¶
研究问题:
- RQ3:两种 embedding 方案的比较结论能否推广到另一个大规模领域?
- RQ4:微调预训练 GNN item embedding 能否改善表现?
数据:数千亿次交互,来自 $O(10^7)$ 用户与超过 $O(10^6)$ 首曲目;用户行为包括收听时长、点赞、跳过。
embedding 为同一批最热门的 $O(10^5)$ 首曲目训练,这些曲目占了超过 90% 的用户交互。由于曲目的文本与视觉内容比电商场景信息量更少,加上上一实验里 MultiBiSage 表现较弱,这里只训 TwHIN。
- TwHIN:图中节点是用户与曲目,边对应点赞与长播放(至少播放了曲目的 90%)。
- ID embeddings:由于只嵌入 $O(10^5)$ 个 item,给所有 item 训练独立 embedding,不用哈希。
训练的是生产 transformer ranker(即「Scaling recommender transformers to one billion parameters」那套),序列最长 2048 次交互。报告 pair accuracy 与 weighted pair accuracy 的相对差异,后者按每种行为类型的重要性对行为重新加权。为回答 RQ4,这里不是把两种策略组合,而是把预训练 TwHIN item embedding 与 transformer 一起端到端微调。
3.3 Yandex Lavka(低资源,开源)¶
研究问题:
- RQ5:在资源受限的设置下,训练 GNN item embedding 是否带来提升?
数据:来自 Yandex Lavka 生鲜电商服务、一年期采样。数据集含 1500 万 user-item 交互、3315 名用户、25833 个 item;可用行为为浏览、点击、加购、购买。为控制发布数据集体积,不包含 item 的文本与图像描述,因此本实验只研究 TwHIN。由于唯一 item 数量相对较少,TwHIN 与 ID embedding 都对全部 item 训练,不做基于流行度的裁剪。TwHIN 训在 user-item 图上,边对应点击、加购、购买。
排序 transformer 处理最长 256 个事件的序列。报告每次用户请求的 nDCG@5 / nDCG@10 / nDCG@20。与前两个实验不同的是,transformer 分数被直接用来排序 item,不再作为额外特征喂给 CatBoost——这消除了 CatBoost 这一层的稀释效应,也是 Lavka 上绝对数值可读的原因。
主要实验结果¶
Table 1:Yandex Market(相对 nDCG 差异,全部统计显著)¶
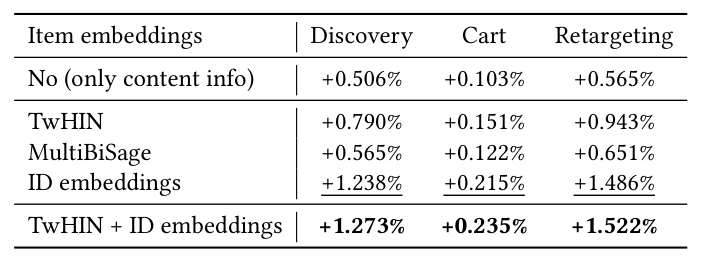
| Item embeddings | Discovery | Cart | Retargeting |
|---|---|---|---|
| No(仅内容信息) | +0.506% | +0.103% | +0.565% |
| TwHIN | +0.790% | +0.151% | +0.943% |
| MultiBiSage | +0.565% | +0.122% | +0.651% |
| ID embeddings | +1.238% | +0.215% | +1.486% |
| TwHIN + ID embeddings | +1.273% | +0.235% | +1.522% |
结论分析:
- ID embedding 在大规模场景全面胜出(RQ1 的答案是「否」)。在三个推荐位上,ID embedding 的增量都比最好的 GNN 方案高出约 1.5–1.6 倍(discovery:+1.238% vs +0.790%;retargeting:+1.486% vs +0.943%)。
- 「只有内容信息」的基线(不加任何 item embedding,只有标题)已经拿到 +0.506% / +0.565%——这是全表最容易被忽略却最有信息量的一行:它说明 MultiBiSage 相对纯内容基线的净增量只有 +0.059%(discovery)/ +0.086%(retargeting),几乎可以忽略。换言之,MultiBiSage 这类归纳式 GNN 在这里贡献的信息,与它自己输入的视觉/文本特征高度重叠——它没能从图结构里榨出多少标题之外的新东西。TwHIN 的净增量(+0.284% / +0.378%)明显更大,说明直推式地直接拟合交互图反而比「聚合内容特征」的归纳式路线更能带来协同过滤信号。这也解释了作者为何在 Music 实验里干脆放弃 MultiBiSage。
- 两者结合有额外增益,但增量极小(RQ2 的答案是「不值」)。TwHIN + ID 相对纯 ID 只多 +0.035%(discovery)/ +0.036%(retargeting)/ +0.020%(cart)。作者直接判定:这点增益配不上额外的 GNN 训练成本。这条也间接说明 TwHIN 里的信息几乎被 ID embedding 完全覆盖——如果二者信息互补,组合的增益应当远大于此。
- cart 位的所有数值都比另两个位小一个量级(+0.103%~+0.235%),但相对排序完全一致。这符合直觉:购物车页推荐更受当前购物车内容主导,用户长期序列表示的贡献空间本来就小。
3.1.1 计算时间与显存分析¶
全部实验在第三方算力平台租用的 8 张 NVIDIA A100 上完成。
ID embedding 的训练时间取决于 embedding 维度、查表次数、embedding 表大小:
| 配置维度 | 范围 | 训练时间 |
|---|---|---|
| 维度 / 查表次数 | 16 维、2 次查表 | 40 小时 |
| 维度 / 查表次数 | 256 维、6 次查表 | 70 小时 |
| embedding 表大小(固定 64 维、6 次查表) | $O(10^4)$ 条目 | 41 小时 |
| embedding 表大小(固定 64 维、6 次查表) | $O(10^6)$ 条目 | 52 小时 |
GNN 的训练时间:MultiBiSage 52 小时,TwHIN 5 小时。
存储布局:主模型训练期间,冻结的 GNN embedding 用 LMDB(Lightning Memory-Mapped Database)存在 SSD 上,而可学习的 ID embedding 常驻 GPU。由于额外的 RAM-GPU 通信开销,作者不报告使用 GNN embedding 带来的训练时间变化。
成本结论:这是全文「值不值」判断的算术依据。TwHIN 只要 5 小时,看起来很便宜——但它是纯增量:不管有没有 TwHIN,那 40–70 小时的主模型训练都得跑;而 TwHIN 换来的质量还低于直接把这些算力花在 ID embedding 上。MultiBiSage 的 52 小时更是几乎等于主模型自己的训练时长,即总训练成本翻倍换来负收益。更棘手的是那句「因 RAM-GPU 通信开销而不报告训练时间变化」——它承认使用冻结 GNN embedding 引入了未被量化的隐性成本,也意味着表 1 里 GNN 各行的真实性价比比数字看起来更差。此外还有整条 GNN 流水线的运维成本:图构建、剪枝规则、TwHIN 因是直推式而必须随新 item 出现重训。
Table 2:Yandex Music(相对准确率差异,全部统计显著)¶
| Item embeddings | embedding 是否微调 | Pair Accuracy | Weighted Pair Accuracy |
|---|---|---|---|
| TwHIN | – | +0.348% | +0.325% |
| TwHIN | ✓ | +0.524% | +0.448% |
| ID embeddings | ✓ | +0.699% | +0.603% |
结论分析:
- RQ3 的答案是「能推广」:ID embedding 在另一个完全不同的大规模领域(音乐流媒体,序列长达 2048,行为语义是收听/跳过而非点击/购买)依然显著优于 TwHIN,相对优势约 1.33–1.35 倍(+0.699% vs +0.524%)。
- RQ4 的答案是「微调有帮助,但仍追不上从零学」:微调把 TwHIN 从 +0.348% 抬到 +0.524%(pair accuracy 相对提升约 50%),说明冻结的预训练表示确实存在任务错配——GNN 的目标(重建边)与排序目标(预测点击/长播)不是同一件事,放开梯度就能修回一部分。但即便如此,它依然低于纯 ID embedding。作者用了「Interestingly」来形容这一点:预训练的初始化不仅没有优势,甚至可能是个更差的起点。这是全文对「预训练阵营」最不利的一条证据——它排除了「GNN 只是因为被冻结才吃亏」这一辩解。
- 这个实验的对照比 Market 那组更干净:Music 上 GNN 与 ID 都只覆盖同一批 $O(10^5)$ 热门曲目,且 ID embedding 不用哈希、每个 item 独占一个 embedding,因此结论不受哈希碰撞或长尾覆盖差异的干扰。
Table 3:Yandex Lavka(低资源,10 次运行平均)¶
| Item embeddings | embedding 是否微调 | nDCG@5 | nDCG@10 | nDCG@20 |
|---|---|---|---|---|
| TwHIN | – | 0.337 | 0.409 | 0.457 |
| TwHIN | ✓ | 0.342 | 0.415 | 0.464 |
| ID embeddings | ✓ | 0.333 | 0.406 | 0.456 |
结论分析:
- 与前两个实验相反:使用预训练 TwHIN embedding 的模型一致地优于只用 ID embedding 的模型。RQ5 的答案是「是」——训练数据有限时,额外的 GNN 训练阶段能改善模型表现。
- 但要看清幅度:微调 TwHIN 相对 ID embedding 的相对提升只有 +2.7%(nDCG@5)/ +2.2%(nDCG@10)/ +1.8%(nDCG@20);即使是冻结 TwHIN 也比 ID embedding 好(0.337 vs 0.333)。注意 Lavka 这组没有报告显著性检验,只说「10 次运行平均」,也没给方差/置信区间——0.337 vs 0.333 这种量级的差距,缺了离散度就难以完全排除噪声。这是全文实验严谨度上最明显的一处短板(前两组反而都做了 32 折 Wilcoxon)。
- 微调在低资源下同样有效(0.337→0.342),与 Music 上的观察方向一致:不论数据多少,让预训练 embedding 参与端到端优化总是比冻结更好。规模只改变「预训练值不值」,不改变「冻结不如微调」。
- 数据规模的对照很直白:Lavka 只有 3315 用户 / 25833 item,而 Market 是数百万用户 / $O(10^7)$ item、Music 是 $O(10^7)$ 用户 / 数千亿交互。结论的分界线因此落在「每个 item / 每个 embedding 参数能分到多少监督信号」上——低资源时端到端 ID embedding 学不出可用的协同信号,只能靠一个独立阶段从全图聚合的统计量来兜底;数据充足时,端到端信号本身就足够,而预训练带来的任务错配与信息冗余开始成为净负担。
与已归档相关工作的对比¶
RQ-FSQ RQ-FSQ / Quantizing Intent: Cross-Domain Semantic IDs(LinkedIn,2026-05-31)¶
关系:独立并发(本文未引用该工作,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在问同一个 root cause 问题——一个「在主排序模型之外预训练出来的表征」,在成熟工业排序器里到底还能不能挣回它的成本,以及在什么数据条件下能挣回。LinkedIn 的靶心是广告 CTR 的用户侧监督稀疏(绝大多数用户很少点广告),本文的靶心是物品侧的 embedding 供给方式,但两者的结论轴完全同构:外部预训练表征的边际价值由「本域监督信号的丰沛程度」决定。
- 相近的技术骨架:两篇的实验骨架都是「冻住生产排序器骨干,只换输入侧的表征来源,做单变量对照」。LinkedIn 明确写了「只在输入侧加跨域 viewer SID,Transformer 骨干、attention 栈、prediction head 完全不动」;本文则是「把每种 embedding 插进 item tower,其余通路一致」。两篇也都把存储/成本核算当成一等结论(LinkedIn 报 30–280× 存储压缩,本文报 5h/52h GNN 训练时长与 LMDB-on-SSD 布局)。
- 本文的差异与推进:本文给出的是否定结论并明确划出适用边界(大规模不值、低资源值),而 LinkedIn 给出的是肯定结论——但两者其实指向同一条规律的两端:LinkedIn 最大的 AUC 增益(+1.522%)恰恰落在最冷启动的用户段,也就是本文 Lavka 那一端;而在行为丰沛的用户段,其增益同样收窄。本文的推进在于把这条规律直接做成了跨三个数据规模的对照实验,而不是在单一系统内按人群分层观察。
- 可比的方法/实验差异:最有价值的差异是 LinkedIn 走了一条本文没有考察的第三条路——不把预训练 embedding 当 dense 特征直接冻着用,而是先量化成 K 级 SID,再用一个可端到端训练的 HDE(prefix n-gram 稀疏哈希表)模块去编码它。这条路把「预训练表征提供先验」与「端到端学习适配任务」合成了一件事,恰好绕开了本文 Table 2 暴露的痛点(冻结 GNN 因任务错配吃亏、微调后仍不如从零学)。而且 HDE 的 prefix n-gram 哈希与本文 ID embedding 的 multihash 是同一族技术,可比性很强:本文用 6 次哈希查表 + 拼接投影,LinkedIn 用逐级前缀哈希 + 加和。若把本文的 GNN embedding 按 LinkedIn 的方式离散化后交给可训练查找表,很可能会得到不同于 Table 1 的结论——这是本文留下的最大空白。
IDProxy IDProxy(Xiaohongshu,2026-03-02)¶
关系:独立并发(本文未引用,两者从相反方向验证同一条规律)· 已加载对方精读
- 共同关注的问题:IDProxy 的问题陈述几乎是本文 RQ5 的逐字对偶——「新物品缺乏足够交互历史,其 ID embedding 训练不充分,导致 CTR 预测效果差」。这正是本文在 Lavka 上观察到的机制,只不过本文把「监督不足」放在整个数据集规模这一层,IDProxy 放在单个 item 的交互次数这一层。两者共同的 root cause 是:端到端 ID embedding 的质量正比于它分到的监督信号量;信号不够时,必须由一个外部预训练的表征来供给先验。
- 相近的技术骨架:两篇都在做「用一个外部预训练表征去替代/补充生产排序器里那条 ID embedding 通路」,且都不改动排序器主体。IDProxy 用 MLLM(InternVL)中间层隐状态生成 proxy ID embedding 注入现有 CTR 排序模型;本文用 GNN(TwHIN/MultiBiSage)embedding 注入 item tower。
- 本文的差异与推进:方向相反且互补。IDProxy 假定「外部表征有用」,力气全花在怎么把它对齐到 ID embedding 空间;本文则先退一步质问「在数据充足处它到底还有没有用」,并给出否定答案。把两篇拼起来读,得到的是一条更完整的判据:外部预训练表征应该被定位为「监督稀疏处的补丁」,而不是「全catalog 的默认表征方案」——恰好也解释了为什么本文 Market 实验里 GNN 只覆盖热门 17% item 却依然输:它的算力全花在最不需要它的那部分 item 上了。
- 可比的方法/实验差异:IDProxy 提供了一条本文缺失的机制级解释。它指出工业场景的 ID embedding 分布「不规则、非聚类化」(与 MovieLens 这类公开数据集不同),浅层 MLP 难以桥接语义空间与协同空间——这正好可以解释本文 Table 2 里「微调 TwHIN 仍不如从零学」的现象:预训练 embedding 所在的几何空间与排序任务需要的协同空间失配,微调只能局部修正,无法重塑几何。本文完全没有做这类表征空间分析(无探针、无相似度结构对比),这是它作为 case study 的主要缺口。
On the Practice of Scaling Search Conversion Rate Prediction On the Practice of Scaling Search Conversion Rate Prediction(Coupang,2026-05-28)¶
关系:独立并发(本文未引用;同为工业经验研究,且在 item embedding 这一轴上给出可直接互补的数据点)· 已加载对方精读
- 共同关注的问题:两篇都是不提新方法的工业经验研究,都在回答「在一个成熟生产排序系统里,往 item embedding 这条通路上投入更多资源,能换回多少质量」。Coupang 把它拆成 backbone / embedding / data 三轴系统实测;本文只做 embedding 这一轴,但把它拆成「来源」维度(预训练 vs 端到端)而非「容量」维度。
- 相近的技术骨架:实验方法论骨架一致——在生产模型上做单变量受控对照 + 成本/延迟核算 + 输出投资优先级建议。两篇都用 hashing trick 控制 item ID 词表规模(Coupang 靠调 hashing modulus,本文靠 multihash 6 次查表),都报告相对指标而非绝对值。
- 本文的差异与推进:Coupang 的 Table 3 给了本文缺的那一半答案:在端到端学习的 item ID embedding 上,扩 embedding 维度比扩词表更有效(16→128 维带来 +0.12%,而词表扩 10× 只带来 +0.02%),原因是「用户互动高度集中在少量 top item 上,扩词表对长尾收益有限」。这与本文的两个设计选择互为印证:本文在 Market 上只给最热 17% item 算 embedding、在 Music 上只覆盖占 90% 交互的 $O(10^5)$ 首曲目——都是同一条「监督集中在头部」规律的产物。而本文的计算时间表(16 维 2 查表 40h → 256 维 6 查表 70h;$O(10^4)$ → $O(10^6)$ 表项 41h → 52h)恰好给 Coupang 的质量曲线补上了成本侧刻度:扩维度更贵但更值,扩词表更便宜但也更没用。
- 可比的方法/实验差异:Coupang 有完整的 scaling 曲线(数据轴拟合出 $y=0.39\ln x - 1.29$ 的对数线性律)与 +2.6% 的线上 A/B,本文两者皆无——只有三张小表和离线相对指标。反过来,本文覆盖了 Coupang 完全没碰的「表征来源」维度,并跨三个数据规模验证了结论的规模依赖性。两篇合起来才构成对「item embedding 该怎么投资」的较完整回答。
被剔除的近似候选(说明门槛):
- LLM-Native TT LLM-Native Two-Tower(Meta)——同样是「用经验证据反驳当下更时髦的范式在 web 规模上更好」,但其争论轴是生成式 vs 判别式检索,且它提出了新的蒸馏方法,解法骨架并非受控对照,问题 root cause 也不是表征供给方式。
- Shallow-RHS Shallow-RHS(Tubi)——确实在做「无 ID 的内容塔 vs ID 表征」,但严格限定在物品冷启动,且解法是一套新的归纳式图补全架构;没有跨数据规模的 pretrain-vs-e2e 对照。
- Language Models Without a Trainable Input Embedding Table: Learning from Fixed Minimal Binary Token Codes(Independent,LLM 输入 embedding 表的非必要性证明)——抽象层面同构(「那张可训练 embedding 表是否必需」),但域是 LLM 预训练,对照的是学得的表 vs 固定二进制码,与「预训练 vs 端到端」不是同一组对立;且无推荐排序栈。
- PrefixMem PrefixMem(Pinterest)——其 prefix n-gram 哈希记忆模块与 LinkedIn 的 HDE 高度相似,但它的问题是LLM 内部 SID token 的解码准确率,而非「预训练表征值不值」,问题层面偏离。
- GBLA GBLA / Gryphon Gryphon(同为 Yandex,同一批生产系统)——公司与生产栈重合(Gryphon 的「industrial music service」与本文 Yandex Music 是同一套),但一篇解决双向注意力的计算复杂度、一篇解决 SID beam 似然的校准,与 item embedding 供给方式无问题同构,属于生态背景而非孪生工作。
讨论与局限性¶
核心贡献¶
- 填了一个此前没人系统做过的空白:作者声称(可信)此前没有工作在大规模工业设置下同时从成本和质量两个角度比较「预训练 item embedding」与「端到端 ID embedding」。这类「负结果 + 明确适用边界」的工作在工业界的决策价值很高——它能直接劝退一条要投入 52 GPU·小时且需要长期维护图流水线的技术路线。
- 结论具备可操作的分界线:不是笼统地说「预训练没用」,而是给出规模依赖判据——低资源用预训练,大规模用端到端。配合 Table 2 的第二条结论(冻结不如微调,但微调仍不如从零学),实际给出的决策树相当清晰。
- 开源了一个低资源数据集与代码:Lavka 数据集(1500 万交互 / 3315 用户 / 25833 item)与代码公开,使 RQ5 这条结论可复现——这在工业 case study 里不常见。
值得借鉴的设计¶
- 「仅内容信息」基线行(Table 1 第一行)是全表的锚:没有它,MultiBiSage 的 +0.565% 看起来像个正收益;有了它,才看清其净增量只有 +0.059%。任何声称「加了 X 表征有提升」的实验都该配这样一条基线。
- 32 折 + Wilcoxon 符号秩检验的显著性方案:在相对提升只有零点几个百分点的工业场景里,这是把「提升」与「噪声」区分开的必要工序。
- 成本与质量同表汇报的习惯:TwHIN 只要 5 小时这个数字,如果不与「主模型本来就要跑 40–70 小时」并置,就无法支撑「不值」的判断。
局限与争议¶
- 完全没有线上 A/B。三张表全是离线指标,且 Market/Music 两组还是「塞进 CatBoost 后的相对增量」这种被两次稀释的口径。一个大规模生产系统的论文没有任何在线实验,对「值不值」这个成本判断来说是明显缺口。
- 没有机制级分析。论文观察到「ID 更好」「微调仍不如从零」「MultiBiSage 几乎无净增益」三个现象,但一个都没解释。没有表征空间探针、没有 embedding 相似度结构对比、没有按 item 流行度分层的结果。而按流行度分层恰恰是最该做的切片:既然 GNN 只覆盖热门 17%,那结论究竟是「GNN 在头部也输」还是「GNN 在头部小赢但被长尾拖垮」,会导向完全不同的工程决策。
- Market 组的 item 覆盖口径披露不清。§3 声明「比较时在同一 item 集合上获取 embedding」,但 §3.1 又说 ID embedding 用 $O(10^6)$ 条目 + 6 次哈希覆盖 $O(10^7)$ 个 item,而 GNN 只对最热 17% 算、其余共享单个 embedding。这两处叙述难以严格对齐:如果 ID 侧实际覆盖面更宽,则 Table 1 的差距部分来自覆盖度而非表征质量。这是全文最需要澄清的一处。
- Lavka 组缺显著性检验与方差。前两组做了 32 折 Wilcoxon,这一组只写「10 次运行平均」。0.333 vs 0.342 的差距在没有离散度信息时说服力有限,而这一组承载的正是「低资源时预训练有用」这条唯一的正向结论。
- GNN 侧的调参投入可能不对等。MultiBiSage 只在 Market 上试过一次就因「表现弱」被后续实验放弃;TwHIN 是两类 GNN 里最简单的一种(encoder 就是查找表,不聚合邻居特征)。论文没有报告 GNN 侧的超参搜索规模,也没有尝试更强的归纳式 GNN 或更贴近排序目标的预训练目标(例如直接用 next-item 目标预训练 item 塔)。「预训练无用」的结论强度因此受限于所选预训练方案的强度。
- 只覆盖了两条路线,漏掉了当下最活跃的第三条。2026 年的主流做法已经是把外部表征(多模态 / LLM / 图)量化成 Semantic ID,再交给一个可端到端训练的稀疏查找模块(见上文 LinkedIn RQ-FSQ + HDE、Pinterest PrefixMem)。这条路正面回应了本文暴露的「冻结吃亏、微调也追不上」困境,但本文完全没有讨论,甚至没有引用任何 SID 工作。这使论文的二元框架(预训练 vs 端到端)在 2026 年显得偏窄。
方法论可扩展性¶
本文本身不提方法,但它的结论对路线可扩展性有直接含义,且方向是正面的:它实质上是在为「表征与序列建模能力应当在同一个端到端图里一起 scaling」提供工业证据。预训练 item embedding 是典型的两阶段解耦——图 encoder 与下游 ranker 无法联合优化、TwHIN 因直推式还必须随新 item 重训;本文的 Table 2(微调有帮助但仍不如从零学)正好量化了这种解耦的代价。反过来,端到端 ID embedding 的容量可以随主模型一起扩(维度、查表次数、表大小三个旋钮,成本曲线本文也给了),不存在固化瓶颈。这条结论与 Coupang 的 embedding 缩放实验方向一致,也与「不要在主模型之外固化核心表征组件」这一更普适的判断相符。
工业落地价值¶
本文没有报告新的上线,但它的落地价值恰恰在反向:它给出的是一条削减建议——在数据充足的成熟系统里,可以砍掉整条 GNN item embedding 预训练流水线(Market 上 MultiBiSage 52 GPU·小时/次 + 图构建 + 剪枝规则维护 + 直推式模型的重训义务),把资源转投到主模型的 embedding 容量上,质量反而更好。对于正在评估「要不要上一套图表示学习中台」的团队,这是一篇成本很低、结论很直接的参考。而对小规模场景(catalog 万级、用户千级),结论翻转:预训练值得做,且一定要放开微调。