Scaling Transformers for Discriminative Recommendation via Generative Pretraining(GPSD)精读¶
- 作者:Chunqi Wang*, Bingchao Wu, Zheng Chen, Lei Shen, Bing Wang*, Xiaoyi Zeng(* 通讯作者)
- 单位:Alibaba International Digital Commercial Group(阿里国际数字商业集团),杭州
- 发表:KDD '25(Toronto);arXiv 2506.03699(v2,2025-08-11)
- 代码:https://github.com/chqiwang/gpsd-rec
- 模型名:GPSD(Generative Pretraining for Scalable Discriminative Recommendation)
研究动机与背景¶
排序模型想用 Transformer,却卡在过拟合上¶
工业推荐多为多阶段流水线,召回与排序最关键:召回从海量物品池中取回十万级候选,排序从候选中挑出几十个用户最可能感兴趣的物品。论文把两个阶段对应到两类模型:召回是生成式模型(自回归预测下一个 item),排序是判别式模型(在曝光样本上估计 CTR、CVR 等指标,再聚合得到最终列表)。本文只关注判别式模型的训练。
要得到更强的判别式模型,一个自然想法是用 Transformer 编码用户行为序列。Transformer 在语言与视觉上靠堆叠注意力和 FFN 层获得强大容量,并有 scaling law 支撑 LLM 的成功。但推荐排序里的既有尝试(BST、DMT、ZEUS)模型都很小,只用单层 Transformer,没有一个利用上 Transformer 的可扩展性。
作者观察训练过程中的指标(Figure 1a),发现训练 AUC 与验证 AUC 之间有很大的泛化差距(generalization gap),即明显的过拟合。过拟合有两种:
- One-epoch overfitting:在 epoch 切换时突然发生的过拟合。Zhang et al.(CIKM '22,文献 [40])最早研究它,并指出特征稀疏性是根本原因。
- Within-one-epoch overfitting(本文命名):更隐蔽,从第一个 epoch 的早期步数就开始,并贯穿整个训练——验证 AUC 很快停滞,而训练 AUC 继续快速上升。
过拟合严重阻碍了靠扩大规模提升性能。Figure 1b 显示模型规模与性能关系很弱,与语言模型的 scaling law 形成鲜明对比;文献 [1](Ardalani et al.,推荐模型参数 scaling「running out of steam」)与 [10](embedding collapse)也观察到了 scaling 效果有限。
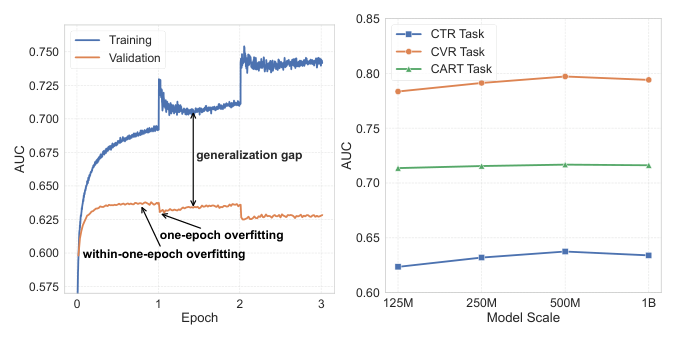
图注补充:右图横轴 125M/250M/500M/1B 是稀疏加稠密的总参数量,对应 Table 3 中从零训练(NT)的 L4H32A4→L4H256A4;CTR 曲线上的四个点与 Table 3 NT 行一致(0.6235/0.6320/0.6375/0.6340),在 L4H128A4 达到峰值后回落。
关键观察与假设¶
与判别式模型形成对照的是:用 sampled softmax loss 训练、以前序行为预测下一个 item 的自回归生成式模型,不存在这个问题。作者的假设原文是:
We hypothesize that generative training avoids the sparsity issue through extensive random negative sampling, thus leading to more stable and sufficient training of sparse parameters.
即生成式训练通过大量随机负采样绕开了稀疏性问题,使稀疏参数得到更稳定、更充分的训练。由此提出 GPSD:用生成式预训练负责稀疏参数,判别式训练只专注于稠密参数。
需要提前指出(详见「五个关键问题的核查」):这是一个假设,全文没有任何实验单独验证「随机负采样」这一机制。
贡献声明¶
- 重新审视推荐模型的过拟合现象,在工业规模数据上展示两类过拟合,并指出生成式与判别式模型在过拟合行为上的差异;
- 提出 GPSD:生成式预训练加冻结稀疏参数,有效缓解判别式模型的过拟合,在多个工业与公开数据集上显著提升,并取得线上收益;
- 把 Transformer 的稠密参数从 13K 扩到 0.3B(327M),观察到持续提升,建立了判别式推荐的 scaling law。
核心方法 / 模型架构¶
GPSD 由三部分组成:(1) 生成式预训练;(2) 判别式训练;(3) 二者之间的桥接(参数迁移与冻结策略)。
生成式预训练¶
任务定义。 类比 GPT,预训练阶段训练 Transformer 自回归地生成用户行为 item 序列。先只考虑 item ID(side feature 后述)。数据集 $D$ 中每个元素是按时间排序的用户行为序列 $X=\{x_1,x_2,\ldots,x_L\}$,长度为 $L$。目标是最小化 $D$ 的负对数似然,序列概率用链式法则分解:
$$\mathcal{L}=\sum_{X\in D}\sum_{l\in 1,\ldots,L}-\log\bigl(p(x_l\mid x_{<l})\bigr) \tag{1}$$
其中 $p(x_l\mid x_{<l})$ 是模型给出的、以前序 item 为条件的下一 item 概率。
模型架构。 沿用 LLaMA 的改进版 Transformer:(1) Pre-Normalization,提升训练稳定性;(2) RMSNorm;(3) RoPE 位置编码,可外推;(4) SwiGLU 激活(原文写作 SwiLU)。生成式训练中每个注意力都加 causal mask,使 Transformer 成为单向。作为替代,也可以采用类似 BERT 的去噪(denoising)方式训练双向 Transformer;默认用生成式,二者在 §3.5 用实验比较。
训练:从 softmax 到 sampled softmax。 自回归模型通常用 softmax 建模概率:
$$p(x_l\mid x_{<l})=\frac{\exp\bigl(f(x_l;x_{<l})\bigr)}{\sum_{v\in V}\exp\bigl(f(v;x_{<l})\bigr)} \tag{2}$$
但推荐场景的词表巨大(工业数据 4M item),全词表 softmax 不现实,于是换成 sampled softmax:
$$\hat{p}(x_l\mid x_{<l})=\frac{\exp\bigl(f(x_l;x_{<l})\bigr)}{\exp\bigl(f(x_l;x_{<l})\bigr)+\sum_{n\in N}\exp\bigl(f(n;x_{<l})\bigr)} \tag{3}$$
其中 $V$ 为全体 item,$N$ 为负采样得到的 item 集合,$f(\cdot)$ 为模型输出的 logit。实现细节:
- 均匀采样器抽负样本,因此省略修正项;负样本数 4K(Table 2,工业与公开数据相同);
- 为省显存,同一序列内所有位置共享同一组负样本;
- 输入 embedding 层与输出线性层权重绑定(tied);
- 使用 BFloat16 训练,作者称相比 Float32 只有轻微损失,同时显存减半、训练加速(未给测量数据);
- AdamW 优化器;线性 warmup 到峰值学习率,再 cosine 衰减到峰值的 10%。
关于「省略修正项」,按 sampled softmax 的标准形式(本式为推导,非原文):对采样分布 $Q$,修正后的 logit 为
$$\tilde{f}(v;x_{<l})=f(v;x_{<l})-\log Q(v),\qquad Q(v)=\frac{1}{|V|} \tag{4}$$
均匀采样时 $-\log Q(v)=\log|V|$ 对正样本和所有负样本是同一个常数,在式 (3) 的分子分母中相互抵消,所以省略是严格成立的,不是近似。
整合 side feature。 两处改动:(1) embedding 层:每个特征(如 category ID)独立映射为 embedding,所有 embedding 求和作为 Transformer 输入;(2) 损失:除预测下一个 item ID 外,还可以预测下一个 item 的各个特征,形成多个损失后聚合为总损失(原文未给聚合权重)。
术语核查:这里的「生成式」到底是什么¶
把式 (1)(3) 与上述实现细节放在一起看,GPSD 的「生成式」目标是:
- 不是全词表 softmax:式 (2) 只是作为动机出现,实际训练用的是式 (3);
- 也不是 in-batch 负采样:负样本来自全词表的均匀随机采样(4K 个,序列内共享),而非同 batch 其他序列的正样本;
- 在序列维度上是生成式的:causal mask 下每个位置都预测下一个 item,概率按链式法则分解;
- 在item 维度上是判别式/对比式的:每一步是「真实下一个 item」对「4K 个随机 item」的 (4K+1) 路分类,形式上等价于以均匀负样本为负例的 InfoNCE。模型从未显式生成一个覆盖全词表的分布,也从未被要求为全词表中的每个 item 分配合理概率。
因此,GPSD 所说的生成式训练与判别式 CTR 训练的真正差别不在「生成 vs 判别」,而在于三个具体因素:(i) 负样本来源:随机未曝光 item vs 曝光未点击 item;(ii) 每条序列的监督位置数:$L$ 个 vs 1 个候选;(iii) 每个监督位置的负样本数:4K vs 0 或 1。作者自己的假设(「extensive random negative sampling」)指向的恰恰是 (iii) 这个判别式成分。
判别式训练¶
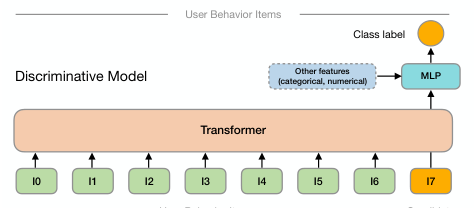
任务定义。 判别式推荐模型以多种特征为输入,输出若干类别上的概率。输入特征分三组:(1) 用户行为 item;(2) 候选 item;(3) 其他类别型与数值型特征。
模型架构。 采用与生成式模型相似的 Transformer,稍作修改:
- 把用户行为 item 序列与候选 item 拼接成输入序列送入 Transformer;
- 为让 Transformer 区分行为 item 与候选 item,在 item embedding 上额外加一个 segment embedding;
- 在最后一层 Transformer 之上接一个 MLP head,以便处理其他类别型与数值型特征;
- 同样可选单向或双向 Transformer。默认单向:因果性质可结合 KV cache 提升线上推理效率(未给测量数据)。
训练。 损失为 cross-entropy,其余设置与预训练相同。原文未给公式,标准形式为(按原文文字补写):
$$\mathcal{L}_{\text{disc}}=-\sum_{(\mathbf{x},y)}\sum_{c}\mathbb{1}[y=c]\,\log q_c(\mathbf{x}) \tag{5}$$
其中 $q_c(\mathbf{x})$ 为 MLP head 输出的第 $c$ 类概率,CTR/CVR/CART 均为二分类。
桥接:五种迁移策略¶
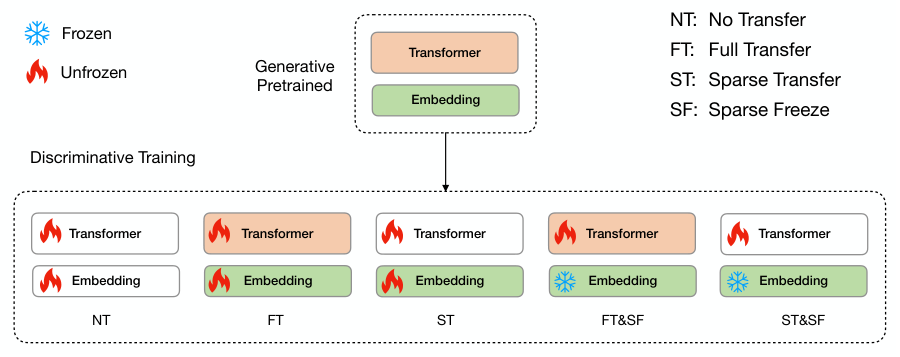
作者认为在语言领域「在大规模无标注语料上预训练,再把全部参数迁移到下游任务微调」是公认有效的做法,但在推荐领域未必成立,需要更精细的策略。原因在于稀疏参数(embedding table)在推荐模型里极其关键,也是推荐与语言领域差异的主要来源,所以把参数拆成稀疏与稠密两部分分别处理:
| 策略 | 稀疏参数(embedding)初始化 | 判别训练中稀疏参数 | 稠密参数(Transformer 层)初始化 |
|---|---|---|---|
| NT(No Transfer) | 随机 | 更新 | 随机 |
| FT(Full Transfer) | 预训练 | 更新 | 预训练 |
| ST(Sparse Transfer) | 预训练 | 更新 | 随机 |
| FT&SF(Full Transfer & Sparse Freeze) | 预训练 | 冻结 | 预训练 |
| ST&SF(Sparse Transfer & Sparse Freeze) | 预训练 | 冻结 | 随机 |
注:判别式模型新增的 segment embedding 与 MLP head 在生成式模型中不存在,无论哪种策略都只能随机初始化;原文未说明 segment embedding 是否被归入被冻结的稀疏参数。后续工作 KGD 将这两条轴记为「迁移哪些参数 × 是否冻结」:TE&FE 对应 ST&SF,TA&FE 对应 FT&SF,TE&FT 对应 ST,TA&FT 对应 FT。
ST&SF 的灵活性:稠密参数不迁移,所以预训练与判别训练的架构可以完全不同。这带来两个用途:跨架构迁移(§3.7,把 Transformer 学到的 embedding 迁给 HSTU 和 Wukong),以及与增量训练结合(§3.9 线上部署)。
关键技术细节¶
模型记号。 用 LuHvAw 表示深度为 u、宽度为 v、注意力头数为 w 的标准 Transformer,如 L4H64A4。
稀疏参数规模与宽度绑定。 由于 embedding 与输出层权重绑定、且 embedding 维度等于隐层宽度,稀疏参数量 ≈ 词表 × 宽度。Table 5 中 125M/250M/500M/1B/2B/3B/4B 的稀疏参数正好对应 4M 词表乘以宽度 32/64/128/256/512/768/1024。换言之,论文所说「稀疏参数从 125M 扩到 4B(32×)」就是 embedding 维度从 32 扩到 1024,与稠密参数同步扩大,这对解读 scaling law 很重要(见下文)。
大模型用浅层预训练。 对 L8H512A8 及以上的判别模型,预训练网络固定为 4 层、只匹配宽度(如 L24H1024A16 用 L4H1024A16 预训练)。作者称这「在保持相近下游性能的同时降低资源消耗」,但没有给出对照数据。这一做法只对 ST&SF 可行,因为 ST&SF 不迁移稠密参数。
跨架构迁移的实现。 HSTU 与 Transformer 一样是可变长序列模型,直接把所有 Transformer 层替换为 HSTU 层、其余组件不变;Wukong 是非序列模型,把输入序列 pad 到固定长度,每个位置当作一个独立特征输入。
incremental-GPSD(线上)。 基线排序模型每天在新数据上增量训练。为此把 ST&SF 改造为增量版:生成式模型与排序模型都按天增量训练;每一轮排序模型训练前,先把生成式模型的稀疏参数迁到排序模型并冻结,只更新稠密参数,稠密参数则从前一天的排序模型继承(Figure 7,见线上 A/B 一节)。
实验设置¶
数据集¶
Table 1:数据集统计($L_{min}$ / $L_{max}$ 为 item 序列的最小/最大长度)
| Source | Dataset | #Samples | #Tokens | Vocab | $L_{min}$ | $L_{max}$ |
|---|---|---|---|---|---|---|
| Industry | CLICK | 278M | 27B | 4M | 50 | 100 |
| Industry | CTR | 1.6B | – | 4M | 10 | 100 |
| Industry | CVR | 68M | – | 4M | 10 | 100 |
| Industry | CART | 126M | – | 4M | 10 | 100 |
| Industry | CTR-XL | 5B | – | 4M | 10 | 100 |
| Public | Taobao | 969k | 39M | 4.1M | 10 | 200 |
| Public | Electronics | 192k | 1.2M | 63k | 2 | 50 |
| Public | Foods | 127k | 890K | 41k | 2 | 50 |
工业数据集。 三个判别任务:点击率(CTR)、转化率(CVR)、加购(CART)预测。另收集 50 亿样本的 CTR-XL 用于探索大模型。每个判别数据集按时间划分:最近一天作为验证与测试集,之前的数据作为训练集。生成式预训练使用单独收集的 CLICK 数据集:把每个用户的点击 item 按时间排序,再切成长度在给定范围内的子序列。
原文未披露的信息(对「五个关键问题」中的第 2 条至关重要):CLICK 与各判别数据集的时间跨度、用户数、二者时间窗是否重叠、CLICK 是否覆盖判别任务的验证/测试日,均未说明。此外 CLICK 的 $L_{min}=50$,意味着只包含点击数不少于 50 的用户,偏向重度用户;判别数据的 $L_{min}=10$。
公开数据集。 (1) Taobao(天池 dataId=649,9 天用户行为):按 Pi et al. 的做法,按时间整理每个用户的点击 item。若用户点击了 $T$ 个 item,第 $T$ 个作为正样本,再随机采样一个 item 作为负样本;前 $T-1$ 个 item 作为用户行为序列,同时也用于构造预训练数据。(2) Amazon 的 Electronics 与 Foods 子集:把商品评论视为点击序列,构造方式与 Taobao 一致。
特征集。 所有数据集中每个 item(候选 item 与行为序列中的 item)都关联 item ID 与若干 side feature(如 category ID),此外不包含任何其他类别型或数值型特征。也就是说,离线实验中判别式模型的全部稀疏参数都是 item 侧 embedding,全部可以从预训练得到。
超参数¶
Table 2:实验超参数
| Hyperparameter | Industrial | Public |
|---|---|---|
| AdamW Beta | (0.9, 0.98) | (0.9, 0.98) |
| Weight Decay | 0.1 | 0.1 |
| Peak Learning Rate | 5e-4 / 1e-4 / 5e-5 | 5e-3 / 5e-4 / 1e-4 |
| Max Gradient Norm | 1.0 | 1.0 |
| Batch Size | 32K / 16K / 4K | 512 |
| #Warmup Steps | 5000 | 500 |
| #Training Epochs | 1 / 3 / 5 | 10 |
| #Negative Samples | 4K | 4K |
工业实验中:batch size 在 CTR/CTR-XL 训练时为 32K、预训练 16K、CVR/CART 4K;预训练与 CTR/CVR/CART 训练的学习率为 5e-4,CTR-XL 训练的学习率随模型规模变化(Table 5);训练 epoch 数为预训练 5、CTR/CVR/CART 3、CTR-XL 1。公开数据集上学习率网格搜索。原文未说明 weight decay 是否作用于 embedding,也未给稀疏参数单独的学习率,因此 FT/ST 中的稀疏参数与稠密参数用同一学习率更新。
硬件:单卡或多卡 A100。评估指标:AUC(ROC 曲线下面积,对分类阈值不敏感,越大越好)。全文所有表格都只报单次运行结果,没有方差或置信区间。
主要实验结果¶
重新审视过拟合现象(§3.3,Figure 3)¶
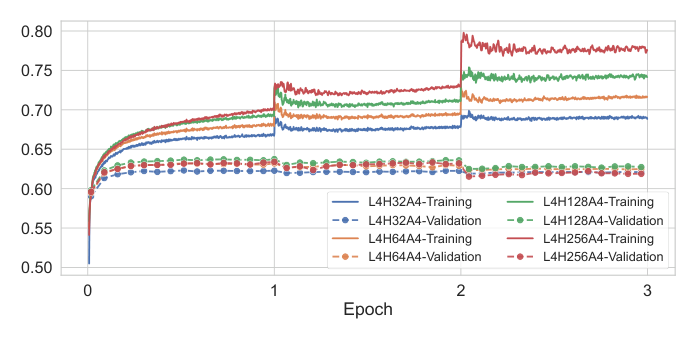
Figure 3a 是 CTR 任务上从零训练的判别式模型(L4H32A4 到 L4H256A4)的训练/验证 AUC 曲线:
- 无论规模大小,训练与验证之间都有显著差距,说明过拟合严重;
- 更大的 L4H256A4 训练 AUC 明显更高,验证 AUC 却低于更小的 L4H128A4;
- 四个规模都在 epoch 切换处出现性能骤降,即 one-epoch overfitting。作者强调其工业数据规模是 [40] 所用最大数据集的 16 倍,确认该现象在工业规模上同样存在;
- 另一类更隐蔽的过拟合:第一个 epoch 内某个步数之后,验证 AUC 几乎停滞,训练 AUC 仍快速增长,即 within-one-epoch overfitting。
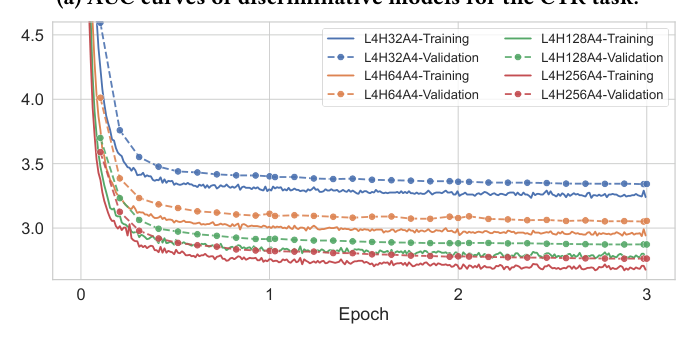
Figure 3b 是生成式模型的训练/验证 loss 曲线:二者在整个训练中保持一个小而恒定的差距,作者认为这是时间上的分布漂移造成的、可以接受;并且规模越大 loss 越低,表现出良好的 scalability。作者再次提出「大量随机负采样使稀疏参数训练更稳定充分」的假设。
这组对比本身并不对等:生成式模型在 CLICK(27B token)上训练、看的是 sampled softmax loss;判别式模型在 CTR(1.6B 样本)上训练、看的是 AUC。数据集、数据量、指标都不同,因此 Figure 3 能说明「这套生成式训练没有过拟合」,但不能把「没有过拟合」归因到「生成式目标」而非「数据量更大、每条序列监督信号更密」。
用生成式预训练增强判别式训练(§3.4,Table 3)¶
Table 3:工业数据集结果(Imp 为相对 NT 的相对提升;原表中下划线为同规模最优、粗体为跨规模最优)
| Model Scale | Strategy | CTR AUC | Imp | CVR AUC | Imp | CART AUC | Imp |
|---|---|---|---|---|---|---|---|
| L4H32A4 | NT | 0.6235 | – | 0.7835 | – | 0.7136 | – |
| FT | 0.6231 | -0.06% | 0.7887 | 0.66% | 0.7156 | 0.28% | |
| ST | 0.6238 | 0.05% | 0.7857 | 0.28% | 0.7152 | 0.22% | |
| FT&SF | 0.6487 | 4.04% | 0.8092 | 3.28% | 0.7151 | 0.21% | |
| ST&SF | 0.6524 | 4.63% | 0.8110 | 3.51% | 0.7146 | 0.14% | |
| L4H64A4 | NT | 0.6320 | – | 0.7913 | – | 0.7155 | – |
| FT | 0.6286 | -0.54% | 0.7932 | 0.24% | 0.7185 | 0.42% | |
| ST | 0.6357 | 0.59% | 0.7991 | 0.99% | 0.7187 | 0.45% | |
| FT&SF | 0.6654 | 5.28% | 0.8204 | 3.68% | 0.7274 | 1.66% | |
| ST&SF | 0.6716 | 6.27% | 0.8249 | 4.25% | 0.7281 | 1.76% | |
| L4H128A4 | NT | 0.6375 | – | 0.7972 | – | 0.7168 | – |
| FT | 0.6376 | 0.02% | 0.8016 | 0.55% | 0.7221 | 0.74% | |
| ST | 0.6395 | 0.31% | 0.7997 | 0.31% | 0.7212 | 0.61% | |
| FT&SF | 0.6838 | 7.26% | 0.8290 | 3.99% | 0.7370 | 2.82% | |
| ST&SF | 0.6834 | 7.20% | 0.8326 | 4.44% | 0.7362 | 2.71% | |
| L4H256A4 | NT | 0.6340 | – | 0.7941 | – | 0.7162 | – |
| FT | 0.6444 | 1.64% | 0.8050 | 1.37% | 0.7244 | 1.14% | |
| ST | 0.6413 | 1.15% | 0.8009 | 0.86% | 0.7205 | 0.60% | |
| FT&SF | 0.6940 | 9.46% | 0.8378 | 5.50% | 0.7437 | 3.84% | |
| ST&SF | 0.6916 | 9.09% | 0.8327 | 4.86% | 0.7381 | 3.06% |
作者的四条结论:
- FT 与 ST 只比 NT 略好,说明语言领域的「预训练 + 微调」范式对推荐任务不够;
- 冻结稀疏参数(FT&SF、ST&SF)在大多数情况下显著优于完整训练(FT、ST),说明判别式训练中的稀疏参数学习有问题;
- FT&SF 与 ST&SF 互有胜负:作者概括为「判别数据集较小或模型规模较大时 FT&SF 更好」;ST&SF 灵活性更高,支持跨架构迁移与增量训练;
- 在 FT&SF 与 ST&SF 下,从 L4H32A4 扩到 L4H256A4 一致变好。
逐项核对(本文计算)。 把「冻结 vs 不冻结」拆成 24 组成对比较(4 个规模 × 3 个任务 × {FT→FT&SF, ST→ST&SF}),AUC 绝对差(pt = 0.01)如下:
| 规模 | CTR FT→FT&SF | CTR ST→ST&SF | CVR FT→FT&SF | CVR ST→ST&SF | CART FT→FT&SF | CART ST→ST&SF |
|---|---|---|---|---|---|---|
| L4H32A4 | +2.56 | +2.86 | +2.05 | +2.53 | −0.05 | −0.06 |
| L4H64A4 | +3.68 | +3.59 | +2.72 | +2.58 | +0.89 | +0.94 |
| L4H128A4 | +4.62 | +4.39 | +2.74 | +3.29 | +1.49 | +1.50 |
| L4H256A4 | +4.96 | +5.03 | +3.28 | +3.18 | +1.93 | +1.76 |
- 22/24 组冻结更优,唯二的例外都是最小规模的 CART(−0.05/−0.06 pt,大概率在噪声范围内);冻结带来的增益随规模单调增大。「大多数情况下」的表述是准确的。
- 第 3 条结论只得到部分支持:「模型规模较大时 FT&SF 更好」在 L4H256A4 三个任务上都成立;但「判别数据集较小时 FT&SF 更好」不成立——最小的 CVR(68M)上,ST&SF 在 4 个规模中的 3 个胜出(L4H32A4/L4H64A4/L4H128A4)。
- NT 的规模趋势:CTR 与 CVR 都在 L4H128A4 见顶后回落,与 Figure 1b 一致;ST&SF 的规模趋势:CTR 0.6524→0.6716→0.6834→0.6916 单调上升,CVR 在最大两个规模几乎持平(0.8326/0.8327)。
- Table 3 报告的是哪个检查点? 原文没说。但 NT 行的数值与 Figure 3a 验证曲线的峰值吻合(例如 L4H256A4 的验证 AUC 峰值约 0.634,训练末尾已跌到约 0.62,表中是 0.6340),FT/ST 行与 Figure 4a/4b 的峰值也吻合,推测报告的是最佳检查点。这一点很关键:冻结的优势不是多 epoch 训练后 FT/ST 崩掉造成的假象。
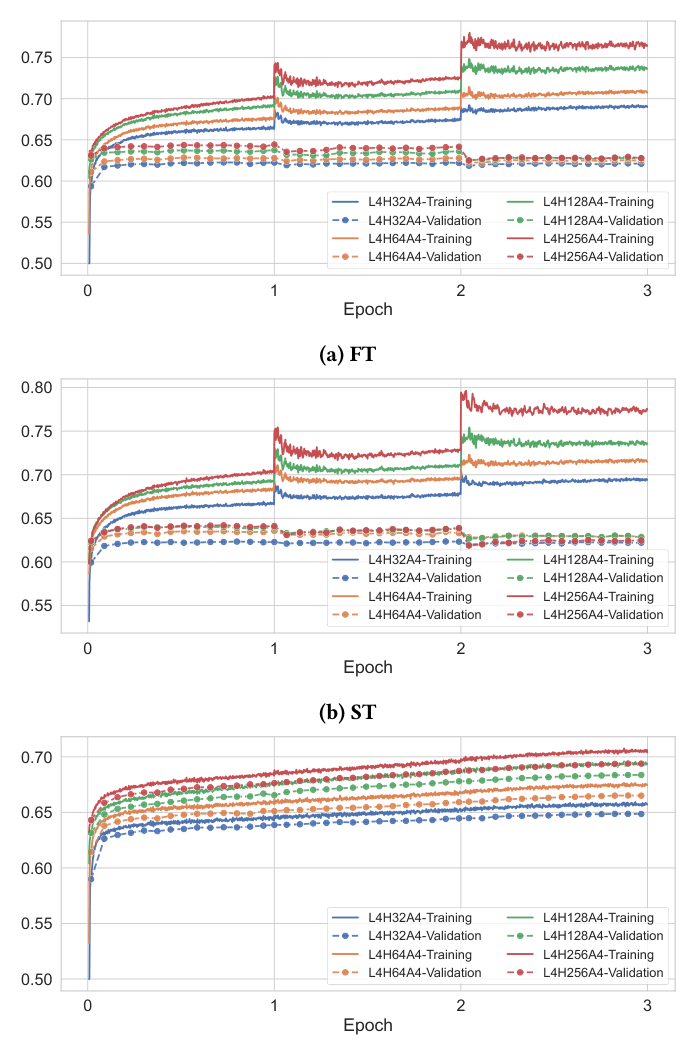
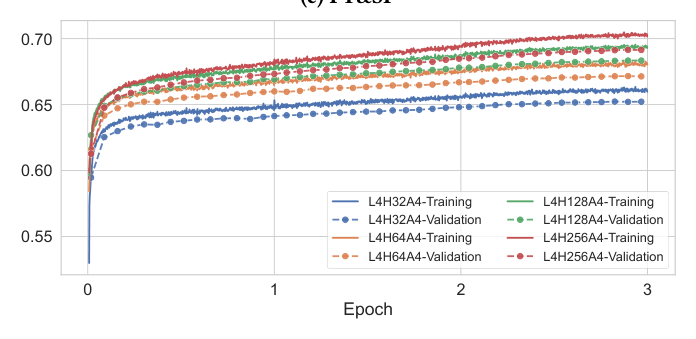
Figure 4 的解读。 (a)(b) 显示没有 SF 时预训练的收益有限,FT 与 ST 仍然出现与基线(Figure 3a)相同的过拟合:epoch 切换处验证 AUC 骤降,训练-验证差距巨大。(c)(d) 显示 SF 同时消除了 one-epoch overfitting 与 within-one-epoch overfitting:训练与验证曲线几乎贴合,且在 3 个 epoch 内持续上升,最终测试性能显著更好。
从图上读(图读数,非原文数值):第 1 个 epoch 结束时,FT&SF L4H256A4 的验证 AUC 已约 0.68,而 FT L4H256A4 整个训练中的验证峰值约 0.645。所以即使只训练 1 个 epoch,冻结在 GPSD 的设定下也领先约 3 pt,另外 3 个 epoch 的持续上升又带来一部分增益。这一点在下文与 LazFormer 的冲突中会用到。
单向 vs 双向 Transformer(§3.5,Table 4)¶
预训练除了生成式(单向)外,还可以用 BERT 式去噪(双向);判别训练也可以用双向 Transformer。基于 L4H64A4 在 CTR 上比较:
Table 4:L4H64A4 在 CTR 任务上的单向(→)与双向(⇄)变体
| No. | Pretraining | Discriminative Training | Strategy | AUC |
|---|---|---|---|---|
| (A) | → | → | FT&SF | 0.6654 |
| (B) | ⇄ | ⇄ | FT&SF | 0.6662 |
| (C) | → | → | ST&SF | 0.6716 |
| (D) | ⇄ | ⇄ | ST&SF | 0.6666 |
| (E) | → | ⇄ | ST&SF | 0.6707 |
| (F) | ⇄ | → | ST&SF | 0.6673 |
作者结论:(A) vs (B) 在 FT&SF 下双向预训练略好(差异很小);(C) vs (D)、(E) vs (F) 在 ST&SF 下单向预训练更好;(C) vs (E)、(D) vs (F) 说明判别阶段用单向还是双向只有很小差距。结合线上 KV cache 的效率优势,默认两阶段都用单向。
分析。 这是全文唯一一组比较不同预训练目标的实验,但它比较的是两种同属「自监督序列 item 预测」的目标:
- 干净的单因素对比只有两对:(C) vs (F),判别阶段都是单向,自回归预训练比去噪预训练高 0.43 pt(0.6716 vs 0.6673);(E) vs (D),判别阶段都是双向,高 0.41 pt(0.6707 vs 0.6666)。(A) vs (B) 同时改变了预训练与判别两个阶段的方向,无法归因。
- 去噪预训练的 mask 比例、是否同样用 sampled softmax 等细节原文均未给出;
- 只有一个规模(L4H64A4)、一个任务(CTR)、单次运行。
进一步扩大规模(§3.6,Table 5,Figure 5,Table 8)¶
用 50 亿样本的 CTR-XL,受资源限制每个模型只训 1 个 epoch,采用 ST&SF(因为它允许预训练与判别训练架构解耦)。
Table 5:scaling 实验的模型设置
| Architecture | Pretraining Architecture | #Layers | Hidden Dim | #Att Heads | #Sparse Params | #Dense Params | Peak LR |
|---|---|---|---|---|---|---|---|
| L1H32A4 | L4H32A4 | 1 | 32 | 4 | 125M | 13K | 5e-4 |
| L4H32A4 | L4H32A4 | 4 | 32 | 4 | 125M | 53K | 5e-4 |
| L4H64A4 | L4H64A4 | 4 | 64 | 4 | 250M | 213K | 5e-4 |
| L4H128A4 | L4H128A4 | 4 | 128 | 4 | 500M | 850K | 5e-4 |
| L4H256A4 | L4H256A4 | 4 | 256 | 4 | 1B | 3.4M | 5e-4 |
| L8H512A8 | L4H512A8 | 8 | 512 | 8 | 2B | 27M | 5e-4 |
| L12H768A12 | L4H768A12 | 12 | 768 | 12 | 3B | 92M | 1e-4 |
| L24H1024A16 | L4H1024A16 | 24 | 1024 | 16 | 4B | 327M | 5e-5 |
大模型用更小的峰值学习率以保证训练稳定。稀疏参数从 125M 扩到 4B(32×),稠密参数从 13K 扩到 327M(25K×)。
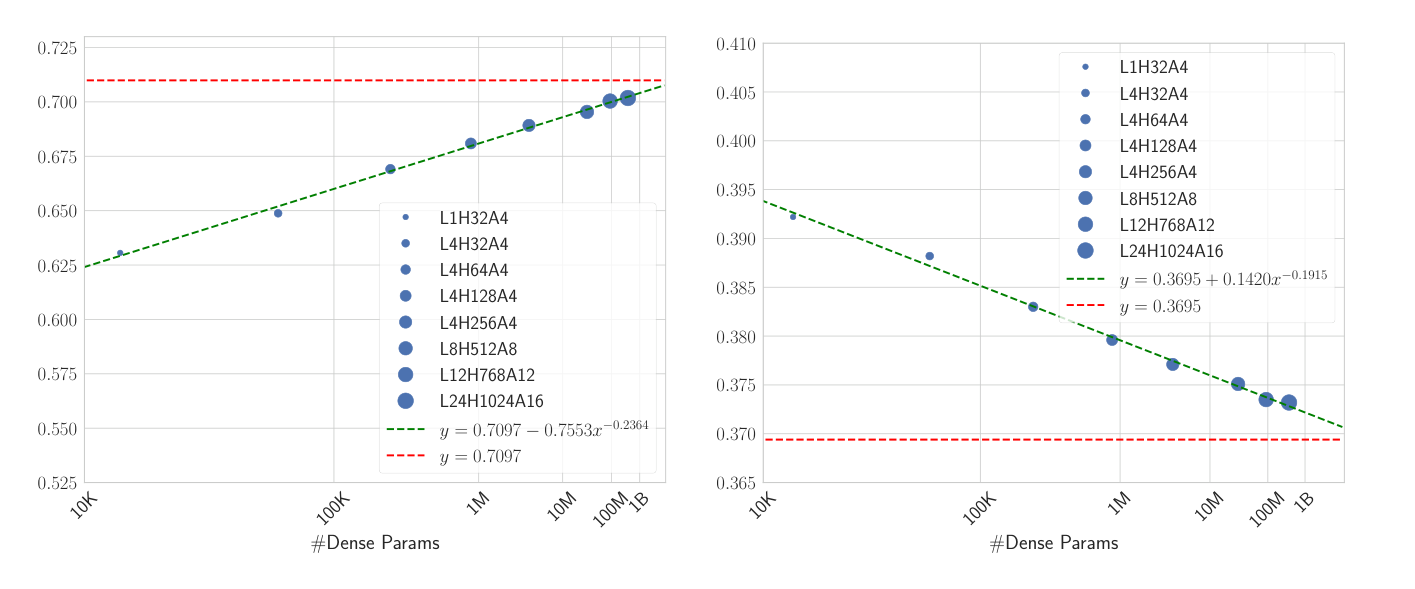
模型性能随规模持续提升,并能用幂律拟合($x$ 为稠密参数量):
$$\mathrm{AUC}(x)=0.7097-0.7553\,x^{-0.2364} \tag{6}$$
$$\mathrm{Loss}(x)=0.3695+0.1420\,x^{-0.1915} \tag{7}$$
据此推出 CTR-XL 上 AUC 的经验上界约 0.7097、loss 的经验下界约 0.3695。本文把 Table 8 的数值代入复核:式 (6) 在 13K 处给出 0.6292(实测 0.6306),在 327M 处给出 0.7024(实测 0.7018),拟合与数据一致。
Table 8:Figure 5 对应的指标与训练开销(右三列为本文按 GPU 数 × 小时计算)
| ID | AUC↑ | Loss↓ | #Training GPUs | #Training Hours | #Pretraining GPUs | #Pretraining Hours | 训练 GPU·h | 预训练 GPU·h | 预训练占比 |
|---|---|---|---|---|---|---|---|---|---|
| L1H32A4 | 0.6306 | 0.3922 | 4 | 3 | 2 | 14 | 12 | 28 | 70% |
| L4H32A4 | 0.6488 | 0.3882 | 4 | 7 | 2 | 14 | 28 | 28 | 50% |
| L4H64A4 | 0.6691 | 0.3830 | 4 | 10 | 4 | 17 | 40 | 68 | 63% |
| L4H128A4 | 0.6809 | 0.3796 | 4 | 16 | 4 | 22 | 64 | 88 | 58% |
| L4H256A4 | 0.6892 | 0.3771 | 4 | 29 | 4 | 39 | 116 | 156 | 57% |
| L8H512A8 | 0.6954 | 0.3751 | 16 | 50 | 8 | 55 | 800 | 440 | 35% |
| L12H768A12 | 0.7004 | 0.3735 | 16 | 101 | 8 | 82 | 1616 | 656 | 29% |
| L24H1024A16 | 0.7018 | 0.3732 | 32 | 184 | 16 | 91 | 5888 | 1456 | 20% |
分析。
- scaling 曲线里没有 NT 对照。 Figure 5 只画了 ST&SF。在 CTR-XL 上、只训 1 个 epoch(天然没有 one-epoch overfitting)的条件下,从零训练的模型能否同样 scale,论文没有回答。「GPSD 让原本不能 scale 的模型能 scale」这一主张,依赖的是 Table 3(CTR,4 个小规模)与 Figure 6(HSTU/Wukong)。
- 横轴只算稠密参数,但稀疏侧同步扩大了 32 倍。 如「关键技术细节」所述,embedding 维度与宽度绑定,从 32 扩到 1024,预训练模型宽度也同步扩大。所以这条曲线是「稠密参数 + embedding 维度 + 预训练模型宽度」的联合 scaling,不能单独归因于稠密参数。
- 不是算力对齐的 scaling law。 横轴是参数量而非 FLOPs 或 GPU·h,预训练开销没有计入曲线。按 Table 8 计算,预训练占总 GPU·h 的 20%–70%。边际收益明显递减:从 L12H768A12 到 L24H1024A16,总 GPU·h 增加 3.23 倍(2272→7344),AUC 只提升 0.14 pt(0.7004→0.7018)。
- 值得肯定的是,Table 8 如实报告了训练与预训练的开销,这在同类工业论文中并不常见。
跨架构迁移(§3.7,Figure 6,Table 9)¶
用 ST&SF 把 Transformer 预训练出的稀疏参数迁移给 HSTU 与 Wukong,各取 4 个规模。
Table 9:跨架构迁移的网络设置
| ID | HSTU #Layers | HSTU Hidden Dim | HSTU #Att Heads | Wukong #Layers | Wukong Emb Dim | #LCB Emb | #FMB Emb | FMB Rank |
|---|---|---|---|---|---|---|---|---|
| (A) | 8 | 64 | 4 | 2 | 32 | 8 | 8 | 24 |
| (B) | 8 | 128 | 4 | 4 | 64 | 32 | 32 | 24 |
| (C) | 8 | 256 | 4 | 8 | 128 | 32 | 32 | 24 |
| (D) | 8 | 512 | 8 | 8 | 256 | 48 | 48 | 48 |
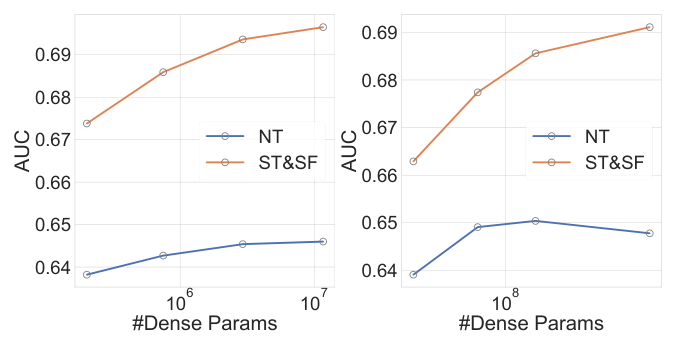
按图读数(约值,原文未给数值表):
| 架构 | 策略 | (A) | (B) | (C) | (D) |
|---|---|---|---|---|---|
| HSTU | NT | ≈0.638 | ≈0.643 | ≈0.645 | ≈0.646 |
| HSTU | ST&SF | ≈0.674 | ≈0.686 | ≈0.693 | ≈0.696 |
| Wukong | NT | ≈0.639 | ≈0.649 | ≈0.650 | ≈0.648 |
| Wukong | ST&SF | ≈0.663 | ≈0.677 | ≈0.686 | ≈0.691 |
结论:虽然参数来自不同架构(Transformer),ST&SF 仍大幅提升了 HSTU 与 Wukong 的效果与可扩展性。HSTU 从零训练时随规模只缓慢增长,Wukong 从零训练在 (C) 之后开始下降;加 ST&SF 后二者都单调上升,且增益达到 5 pt 左右。作者据此认为这些「声称能 scale」的新架构在一定规模后仍受限,生成式预训练能释放更多潜力。
说明:原文没有指明 Figure 6 用的是哪个数据集(从 AUC 量级看接近工业 CTR 任务),HSTU/Wukong 的训练 epoch 数也没有说明。
公开数据集结果(§3.8,Table 6)¶
Baseline:DeepFM、DIN、DIEN、DMIN、DMR,embedding 维度均为 64。
Table 6:公开数据集结果(Imp 为叠加 ST&SF 后的相对提升)
| Method | Taobao AUC | Imp | Electronics AUC | Imp | Foods AUC | Imp |
|---|---|---|---|---|---|---|
| DeepFM | 0.9044 | – | 0.7985 | – | 0.7425 | – |
| DeepFM + ST&SF | 0.9547 | 5.56% | 0.8665 | 8.52% | 0.7948 | 7.04% |
| DIN | 0.9341 | – | 0.8091 | – | 0.7711 | – |
| DIN + ST&SF | 0.9752 | 4.40% | 0.8800 | 8.76% | 0.8223 | 6.64% |
| DIEN | 0.9386 | – | 0.8055 | – | 0.7803 | – |
| DIEN + ST&SF | 0.9608 | 2.36% | 0.8788 | 9.09% | 0.8253 | 5.77% |
| DMIN | 0.9301 | – | 0.7969 | – | 0.7753 | – |
| DMIN + ST&SF | 0.9620 | 3.43% | 0.8790 | 10.03% | 0.8317 | 7.27% |
| DMR | 0.9344 | – | 0.8198 | – | 0.7792 | – |
| DMR + ST&SF | 0.9684 | 3.64% | 0.8779 | 7.08% | 0.8240 | 5.75% |
| L1H32A4 | 0.9310 | – | 0.7964 | – | 0.7412 | – |
| L1H32A4 + ST&SF | 0.9708 | 4.27% | 0.8674 | 8.91% | 0.8228 | 11.01% |
| L4H32A4 | 0.9306 | – | 0.7943 | – | 0.7508 | – |
| L4H32A4 + ST&SF | 0.9739 | 4.65% | 0.8715 | 9.72% | 0.8384 | 11.67% |
| L4H64A4 | 0.9357 | – | 0.7948 | – | 0.7495 | – |
| L4H64A4 + ST&SF | 0.9771 | 4.42% | 0.8810 | 10.84% | 0.8398 | 12.05% |
| L4H128A4 | 0.9257 | – | 0.7944 | – | 0.7398 | – |
| L4H128A4 + ST&SF | 0.9806 | 5.93% | 0.8799 | 10.76% | 0.8368 | 13.11% |
| L4H256A4 | 0.8651 | – | 0.7710 | – | 0.7135 | – |
| L4H256A4 + ST&SF | 0.9808 | 12.37% | 0.8847 | 14.47% | 0.8370 | 17.31% |
作者结论:
- 叠加 ST&SF 后所有 baseline 都显著提升,幅度 2.36%–10.03%,说明框架与各种推荐模型兼容;预训练稀疏参数通用,可即插即用地部署。
- 不加 ST&SF 时 Transformer 明显不如 baseline;加上后大幅提升并超过所有 baseline,验证了缓解过拟合的效果。
- 最大的 L4H256A4 并非在所有数据集上最优(可能因为数据规模有限),但仍有竞争力,且不再严重过拟合。
核对与分析:
- 原表有三处相对提升算错(本文按表中 AUC 重算):L4H256A4 在 Taobao 应为 13.37%(表记 12.37%),在 Electronics 应为 14.75%(表记 14.47%);DMIN 在 Electronics 应为 10.30%(表记 10.03%),因此 baseline 提升范围应为 2.36%–10.30%。都是数字录入错误,不影响结论方向。
- 「不加 ST&SF 的 Transformer 明显不如 baseline」只部分成立:Taobao 上 L4H64A4(0.9357)高于 DIN(0.9341),Foods 上 L4H32A4(0.7508)高于 DeepFM(0.7425)。真正明显落后的是 L4H256A4(Taobao 0.8651),这正体现了过拟合随规模加剧。
- 公开数据集的判别任务与预训练目标结构上几乎同构。 判别样本是「用户真实的第 $T$ 个点击 vs 一个均匀随机采样的 item」,而预训练目标恰好是「真实下一个 item vs 均匀随机采样的 item」(式 3)。预训练阶段用 4K 负样本、在前 $T-1$ 个位置上反复练习的,正是下游要做的事。因此 0.98 量级的 AUC 与最高 17% 的相对提升,不能外推到真实曝光日志上的 CTR 预估(真实场景的负样本是曝光未点击的 item)。这不是 GPSD 独有的问题,DIN/DIEN/MIMN 一系的公开数据构造都是如此,但对「生成式预训练」这种方法的放大尤其明显。
- 公开数据上 baseline 训练 10 个 epoch、学习率网格搜索;报告的是最终还是最佳检查点,原文未说明。若为最终检查点,NT 基线会受 one-epoch overfitting 额外拖累。论文也没有与 MEDA、调强正则、降低 embedding 学习率等其他抗过拟合手段做对照。
线上 A/B(§3.9,Figure 7,Table 7)¶
部署在 AliExpress 商品推荐系统的排序模型上。基线是特征丰富的多任务模型:数百个类别型与数值型特征、三个任务,用单层 target attention 编码用户行为,每天在新数据上增量训练。改造包括两件事:(1) 用 incremental-GPSD(ST&SF + 增量训练);(2) 把 target attention 模块替换为 Transformer。出于线上效率,只用了小规模的 L3H160A4。
Figure 7(incremental-GPSD)未被图片提取脚本抽出,按原图重绘:
flowchart LR
    G1((生成式模型<br/>第 1 天)) -->|Full Transfer| G2((生成式模型<br/>第 2 天)) -->|Full Transfer| G3((…)) -->|Full Transfer| GT((生成式模型<br/>第 T 天))
    R1((排序模型<br/>第 1 天)) -->|Dense Transfer| R2((排序模型<br/>第 2 天)) -->|Dense Transfer| R3((…)) -->|Dense Transfer| RT((排序模型<br/>第 T 天))
    G1 -->|Sparse Transfer + Sparse Freeze| R1
    G2 -->|Sparse Transfer + Sparse Freeze| R2
    GT -->|Sparse Transfer + Sparse Freeze| RT
原图图注:生成式模型与排序模型都增量训练;每轮排序模型训练时,先把生成式模型的稀疏参数迁移到排序模型并冻结,只更新稠密参数。
Table 7:30 天实验窗口的线上 A/B 结果
| Metric | GMV | Orders | Buyers | CTR |
|---|---|---|---|---|
| Gains | +7.03% | +2.11% | +1.86% | +3.78% |
分析:
- 线上收益混合了两个改动:GPSD 预训练迁移,以及 target attention → L3H160A4 Transformer 的架构替换。论文没有离线或线上消融把二者分开,所以 +7.03% GMV 不能全部归给 GPSD。
- 基线模型有数百个特征,但哪些稀疏参数来自生成式模型并被冻结、其余特征的 embedding 如何训练,原文没有说明;离线实验恰好没有其他特征,回避了这个问题。
- GMV(+7.03%)明显高于 Orders(+2.11%),隐含客单价上升约 4.8%,论文未讨论;也没有给流量比例、置信区间与线上延迟/资源开销。
消融与分析¶
本文的「消融」主要就是上述几组:
- 迁移策略消融(Table 3 + Figure 4):全文最系统、证据最强的部分。NT/FT/ST/FT&SF/ST&SF × 4 规模 × 3 任务,清楚地显示「冻结稀疏参数」才是收益主体,「迁移本身」(FT/ST 相对 NT)只贡献很小一部分。
- 预训练与判别方向消融(Table 4):单规模、单任务,只比较自回归与去噪两种自监督目标。
- 跨架构(Figure 6):从侧面说明预训练稀疏参数不依赖特定稠密架构。
- 公开数据插件实验(Table 6):说明 ST&SF 可以叠加在传统模型上。
缺失的关键消融:(a) 负样本数量(作者假设的核心变量,固定为 4K);(b) 判别式/CTR 目标预训练加冻结;(c) 降低稀疏参数学习率、只更新若干步后冻结、按 epoch 重置等介于「冻结」与「完整更新」之间的方案;(d) scaling 实验中的 NT 曲线与 embedding 维度固定的对照;(e) 线上架构替换与 GPSD 的拆分。
五个关键问题的核查¶
1. 为什么用生成式预训练,而不是判别式?¶
结论:未论证。 论文给出的是「观察 + 假设」,没有任何实验比较「生成式预训练」与「判别式/CTR 目标预训练」。
- 论文的全部理由:(i) Figure 3 中生成式模型不过拟合、判别式模型过拟合;(ii) 假设「大量随机负采样使稀疏参数训练更稳定充分」。这个假设没有被检验:负样本数固定为 4K,没有扫描;也没有「CTR 训练中加入随机负样本」之类的对照。
- (i) 本身不是受控比较:两类模型用的数据集(CLICK 27B token vs CTR 1.6B 样本)、数据量和指标(loss vs AUC)都不同。
- 全文唯一比较预训练目标的实验是 Table 4:自回归(单向)vs BERT 式去噪(双向)。二者都是自监督的 item 预测。干净的单因素对比中,自回归比去噪高 0.43 pt(C vs F:0.6716 vs 0.6673)和 0.41 pt(E vs D:0.6707 vs 0.6666);FT&SF 下的 (A) 0.6654 vs (B) 0.6662 同时改了两个阶段,无法归因。规模只有 L4H64A4、任务只有 CTR、单次运行,去噪的 mask 比例与损失形式未披露。
- 没有做的对照:在同一份 CLICK 数据上用判别式目标预训练 embedding 再冻结。这是区分「目标函数」与「冻结一份来自别处的 embedding」的必要实验。MEDA 的负面探索(见对比章节)表明冻结判别式训练出的 embedding 不能阻止过拟合,但那是另一篇论文、另一种设定,且只有文字描述,不能替 GPSD 补上这个论证。
2. 目标函数与数据量是否被区分开?¶
结论:工业实验中没有区分;公开数据集部分区分,但存在任务同构的混淆;没有给从零模型等量数据曝光的对照。
- 工业数据量对照:CLICK 278M 条子序列 / 27B token / 5 个 epoch,vs CTR 1.6B 样本 / 3 个 epoch(CVR 68M、CART 126M、CTR-XL 5B / 1 个 epoch)。时间跨度、用户数、CLICK 与判别数据的时间窗是否重叠、CLICK 是否覆盖判别任务的验证/测试日——全部未披露。最后一点还牵涉潜在的信息泄漏:若 CLICK 包含测试日的点击,冻结的 embedding 就编码了测试期的共点击信息。论文未说明,无法排除。CLICK 的 $L_{min}=50$ 只收录重度点击用户。
- 监督信号量级完全不同:CLICK 每个 token 都是一个监督目标,并配 4K 负样本;CTR 每个样本只有一个二值标签。
- 公开数据集是唯一的「同数据」证据:预训练用的就是判别样本的前 $T-1$ 个点击,没有引入任何额外原始交互,但 ST&SF 仍带来 2.36%–17.31% 的提升。这说明收益不完全来自「多看了原始数据」。但仍有两处混淆:(i) 同一份交互在预训练中被监督的位置数与负样本数远多于判别训练,即「目标」与「监督密度」没有分开;(ii) 公开判别任务(真实第 $T$ 个 item vs 均匀随机负样本)与预训练目标几乎同构。
- 等量数据曝光对照:没有。没有「从零训练的判别模型也接触 CLICK 数据」(如联合训练、或在 CLICK 构造的样本上做判别式预训练)的对照。
- 一个间接线索:ST(迁移预训练 embedding 但继续更新)在 CTR 上只比 NT 高 0.03–0.73 pt(FT 为 −0.34 到 +1.04 pt),远小于 ST&SF 的 +2.89 到 +5.76 pt。说明预训练 embedding 带进来的信息在判别式梯度下很快被冲掉,增益与「冻结」强绑定。但这只说明冻结必要,仍不能区分「生成式目标」与「更多数据」。
3. 术语核查:「生成式」目标的具体形式¶
结论:是 sampled softmax 的自回归 next-item 预测,负样本为全词表均匀随机采样(非 in-batch),在 item 维度上本质是判别式/对比式的。
- 式 (3):正样本 logit 对 4K 个均匀随机负样本做 softmax,同一序列内各位置共享负样本,输入/输出 embedding 绑定,均匀采样使 logQ 修正为常数而被省略(式 4);另可加预测下一 item side feature 的损失。
- 不是全词表 softmax(式 2 只作动机);不是 in-batch 负采样(这一点与后续 LazFormer 用 16,000 个 in-batch 负样本不同)。
- 每一步是「真实下一个 item vs 随机 item」的 (4K+1) 路分类,在 item 维度上是判别式的(形式上等价于均匀负样本的 InfoNCE);「生成式」只体现在序列维度的因果自回归分解。
- 与 CTR 判别训练的实质区别是:随机未曝光负样本 vs 曝光未点击负样本、每条序列 $L$ 个监督位置 vs 1 个、每个位置 4K 个负样本 vs 0 或 1 个。作者的假设本身指向的就是负采样这一判别式成分。
4. 冻结稀疏参数的依据,以及与 LazFormer 的冲突¶
GPSD 自己的证据:
- Table 3 共 24 组「冻结 vs 不冻结」的成对比较,22 组冻结更优,增益 +0.89 到 +5.03 pt,且随规模增大;两个例外为 L4H32A4 CART(−0.05/−0.06 pt)。
- Figure 4 给出机制层面的曲线证据:冻结后 one-epoch 与 within-one-epoch 两类过拟合都消失,训练-验证差距收窄,多 epoch 持续上升;按图读数,即使只训练 1 个 epoch,冻结仍领先约 3 pt。
- 证据的边界:单次运行无方差;稀疏参数与稠密参数用同一学习率(5e-4,AdamW,weight decay 0.1,是否作用于 embedding 未说明),没有任何中间方案(小学习率微调、先冻后解、按 epoch 重置);离线数据集除 item ID 与 side feature 外没有任何其他特征,所有稀疏参数都能由预训练覆盖,这是对冻结最有利的条件;公开数据集只比较 NT vs ST&SF,没有提供 ST vs ST&SF 的对照。
LazFormer(2609.14978)的反证: Table 4 中,Config-2(加载预训练稀疏参数并冻结,1 epoch)CTR AUC 0.7675 / GAUC 0.6775;Config-3(加载后继续更新,1 epoch)0.7699 / 0.6810。继续更新优于冻结 +0.24 pt AUC / +0.35 pt GAUC,超过该文自称的 0.1 pt 显著阈值。
两者结论的冲突与各自的证据强度:
| 维度 | GPSD(支持冻结) | LazFormer(支持继续更新) |
|---|---|---|
| 对照规模 | 24 组(4 规模 × 3 任务 × 2 迁移方式),22 组冻结胜 | 1 组(CTR,1 epoch,仅稀疏迁移) |
| 效应量 | +0.89 至 +5.03 pt(排除两个 ≈0 的例外) | +0.24 pt AUC / +0.35 pt GAUC |
| 训练轮数 | 3 epoch;按图读数 1 epoch 内冻结仍领先约 3 pt | 仅 1 epoch;缺少「冻结 × 3 epoch」这一臂 |
| 方差 | 未报告 | Table 4 未注明(该文 Table 2 注明 3 次平均) |
| 从零到冻结的增益 | CTR L4H256A4:0.6340→0.6916(+5.76 pt) | 0.7577→0.7675(+0.98 pt) |
| 预训练负样本 | 均匀随机 4K,序列内共享,点积(绑定 embedding) | in-batch 16,000,温度 0.07 的余弦相似度 |
| 数据规模 | CLICK 27B token vs CTR 1.6B 样本;时间跨度/用户数未披露 | 16M 用户/11B token/一年 vs 11M 用户/370M 曝光/25 天 |
| 稀疏特征覆盖 | 只有 item ID + side feature,全部来自预训练 | 共享特征来自预训练,排序专属特征走零初始化适配器 |
判断:
- 在各自设定内,两个结论都成立,都不能外推为普适规律。 GPSD 的证据更系统、效应量大一个量级,但来自一个过拟合极严重的设定:从零训练很快见顶,冻结带来 5 pt 以上的提升。LazFormer 的反例只有一个点,幅度小,但设定更接近生产:更长序列、更多特征、单 epoch 训练、预训练与排序数据时间窗明确。
- 可能的调和解释(本文推测,未被任何一篇论文验证):冻结本质上是一种强正则。当判别训练的过拟合风险很高时(GPSD:冻结比从零训练高 5.76 pt),正则收益远大于失去适配能力的代价;当过拟合较轻时(LazFormer:从零到冻结只差 0.98 pt),让 embedding 适配排序目标与近期分布的收益占上风。两篇预训练负样本形式不同(均匀随机 vs in-batch),也可能影响预训练 embedding 与 CTR 目标的对齐程度,因而影响「是否需要继续适配」。
- 双方各缺一个关键实验:GPSD 没有给稀疏参数小学习率、或只在第 1 个 epoch 更新之类的中间方案;LazFormer 没有「冻结 × 3 epoch」这一臂——而 GPSD 的 Figure 4c/4d 恰好显示冻结的一大优势是允许多 epoch 持续增益。LazFormer 的 Config-5(每 epoch 把稀疏参数重置为预训练值,3 epoch)达到 0.7731,是否优于「冻结 × 3 epoch」,目前是未知数。
- 第三方证据(KGD,见对比章节)呈现同样的分裂:在 next-item 公开基准上冻结大幅占优,在 Shopee 工业 CTR 流上微调略优(+0.05 到 +0.17 pt)。
5. 是否宣称并测量了「省算力 / 加速收敛」?¶
结论:GPSD 没有把「省算力」或「加速收敛」列为贡献;零星的效率表述都未被测量;开销表如实计入了预训练,但 scaling law 不是算力对齐的。
- 论文的核心主张是缓解过拟合、提升可扩展性,没有声称比从零训练更省算力或收敛更快。Figure 4c/4d 显示冻结后的曲线在 3 个 epoch 内仍在上升,说明它的作用是让模型「能训得更久」,而不是「收敛得更快」。论文没有给出达到目标 AUC 所需的步数或 wall-clock 对比。
- 未被测量的效率表述:(a) BF16「显存减半、加速训练」;(b) 大模型用 4 层预训练「降低资源消耗且下游性能相近」——无对照数据;(c) 单向 Transformer 配合 KV cache 的推理效率;(d) 线上「出于效率只用 L3H160A4」——无延迟或吞吐数据。
- Table 8 如实报告了训练与预训练的 GPU 数 × 小时,预训练开销没有被隐藏,按本文计算占总 GPU·h 的 20%–70%。但:(i) 没有 NT 的开销对照,无从评价「省」或「费」;(ii) Figure 5 横轴是稠密参数量,不是 FLOPs 或 GPU·h,预训练开销没有进入 scaling 曲线;(iii) 最后一档用 3.23 倍总 GPU·h 只换 +0.14 pt AUC,边际收益在拟合的 0.7097 上界附近已明显递减。
- 线上 incremental-GPSD 需要每天额外增量训练一个生成式模型,这部分开销没有报告。
核心贡献总结¶
- 把「判别式推荐 Transformer 不能 scale」诊断为过拟合问题,并区分出 one-epoch 与 within-one-epoch 两类过拟合;后者是本文命名的新现象,它说明单 epoch 训练本身也不足以避免稀疏参数过拟合。
- 给出了简单、可复现、有代码的解法:生成式预训练 embedding → 迁移 → 冻结稀疏参数、只训稠密参数。Table 3 的 5 策略 × 4 规模 × 3 任务消融清楚地表明:收益主体是「冻结」,而不是「迁移」本身。
- 首次在工业 CTR 数据上把 Transformer ranker 从 13K 扩到 327M 稠密参数并拟合出幂律,同时如实报告训练与预训练开销;但该曲线没有 NT 对照、横轴不是算力,且与 embedding 维度同步扩大。
- ST&SF 的架构无关性:预训练 embedding 可以即插即用地提升 DeepFM/DIN/DIEN/DMIN/DMR 与 HSTU/Wukong,并能与每日增量训练结合,在 AliExpress 上线(GMV +7.03%,但与架构替换混杂)。
- 开创了「生成式预训练 → 判别式排序迁移」这一研究脉络:后续的 LazFormer 与 KGD 都把它当作直接出发点与对标对象。
与已归档相关工作的对比¶
LazFormer LazFormer: Scaling Transformers for Industrial Recommendation via Transferable Generative Pre-training(Alibaba AIDC,2026-09-14)¶
关系:后续工作(LazFormer 显式建立在本文之上:沿用本文的预训练数据构造,把本文列为「冻结预训练参数」路线的代表并在 Table 4 中正面挑战;本文发表更早,无从引用它)· 已加载对方精读
- 共同关注的问题:同一个范式的同一组痛点——Transformer 排序模型的稀疏参数在判别式多 epoch 训练下过拟合,以及如何把自回归 next-item 预训练的参数迁到判别式 ranker。LazFormer 的「稀疏参数过拟合」直接对应本文 Figure 3/4 的诊断;两文作者单位均为阿里国际数字商业集团,末位作者相同(Xiaoyi Zeng)。
- 相近的技术骨架:都是「因果 Transformer 做 next-item 预训练(负采样 softmax)→ 把 embedding 迁到判别式 Transformer ranker」。差异在于 LazFormer 用 16,000 个 in-batch 负样本加温度余弦相似度,本文用 4K 个均匀随机负样本加点积。
- 对方对本文的推进:(a) 从 sparse-only 到 sparse + dense 迁移。本文 FT 迁移稠密参数时没有遇到「排序专属特征」问题,因为离线数据集里根本没有其他特征;LazFormer 在有加购/下单等排序专属特征的真实设定下发现直接融合会抵消稠密迁移收益,用零初始化残差适配器解决(Direct 0.7701 → LazFormer 0.7735)。(b) 用「每 epoch 重置稀疏参数到预训练值、稠密参数累积」替代本文的冻结(Config-5 0.7731,3 epoch)。(c) 请求级组织与混合稀疏注意力,把本文 10–100 的短序列推进到 2,048。(d) scaling 以 FLOPs 为横轴,但 FLOPs 同样只计排序阶段、未计预训练,这一点与本文 Table 8 至少报告了预训练 GPU·h 相比反而更少披露。
- 可比的方法 / 实验差异:核心冲突是冻结 vs 继续更新(Config-2 0.7675 vs Config-3 0.7699,+0.24 pt)。证据强度对照已在「五个关键问题」第 4 条展开:本文 24 组中 22 组支持冻结、效应量 +0.89 到 +5.03 pt,但设定过拟合极重、无方差、无中间方案;LazFormer 只有 1 组、1 epoch、效应量 +0.24 pt,但设定更接近生产。LazFormer 缺少「冻结 × 3 epoch」这一臂,而这恰是本文 Figure 4c/4d 显示冻结最有优势的区域。因此「继续更新优于冻结」目前只能读作「在 LazFormer 的 1-epoch 设定下成立」,不足以否定本文在自身设定下的结论,反之亦然。
KGD KGD: Knowledge–Geometry Decoupling: Refreshable Pretrained Transfer for Streaming Recommendation(Xiamen University × Shopee,2026-08-03)¶
关系:后续工作(KGD 把本文列为直接对标的冻结迁移前作,TE&FE / TA&FE 即本文的 ST&SF / FT&SF,TE&FT / TA&FT 即 ST / FT)· 已加载对方精读
- 共同关注的问题:KGD 明确以本文首次形式化的「生成式预训练 → 判别式迁移」范式为研究对象,并沿用本文的两条设计轴:迁移哪些参数 × 是否冻结。它把本文的冻结路线概括为「保住知识但改不动几何」,把微调概括为「改得动几何但毁掉知识」。
- 相近的技术骨架:都是在用户行为序列上自回归预训练 encoder,再迁到排序模型。KGD 的解法是第三条路:refreshable encoder 对任务只读(stop-gradient 的 read-only cross-attention),任务侧用与预训练 embedding 正交的低秩残差(ACR)重塑几何。
- KGD 提供了本文缺失的两类证据:(a) 预训练目标对照——NTP / MTP / BMTP 三种目标 × 8 种迁移方式,冻结迁移下 BMTP 相对 NTP 增益大且一致(如 Arts 上 TE&FE +6.5%、TA&FE +7.1%),说明「用什么目标预训练」确实重要。但三者都属序列预测族,KGD 精读中同样没有判别式目标的预训练对照。(b) 冻结 vs 微调在两种设定下的分裂——公开 next-item 基准上冻结大幅占优(如 Arts NTP:TE&FE 0.0353 vs TE&FT 0.0305;Games 0.0754 vs 0.0666),与本文方向一致;Shopee 28 天工业 CTR 流(5 次平均)上微调略优(TE&FT 0.7826 vs TE&FE 0.7821;TA&FT 0.7824 vs TA&FE 0.7813;BMTP 下 TA&FT 0.7852 vs TA&FE 0.7835),与 LazFormer 方向一致。
- 可比的方法 / 实验差异:KGD 的 90 天轨迹显示「冻结迁移(TA&FE,即 GPSD)随时间持续侵蚀」。从其「冻结则知识陈旧」的归因看,这应是一次预训练后不再刷新的 S2 调度(KGD 精读未对轨迹中的调度作明确标注)。而本文线上实际部署的 incremental-GPSD 每天刷新生成式模型并重新迁移冻结,更接近 KGD 的 S3 TA&FE。在 S3 下,冻结与微调几乎持平(NTP:TA&FE 0.7822 vs TA&FT 0.7819;BMTP:0.7841 vs 0.7837)。所以 KGD 的长期侵蚀证据针对的是「预训练一次 + 冻结」,并不直接否定本文的增量部署形态。KGD 实验覆盖 8 个公开集 + 90 天工业流 + 5 次平均,在「迁移方式」这一共同命题上的实验强度明显高于本文。
MEDA MEDA: Multi-Epoch Learning for Deep Click-Through Rate Prediction Models(Kuaishou,2023-05)¶
关系:显式引用但原文未展开对比(仅在 §4.2 related work 中一句带过,引用的是同一方法的 2407.01607 版本;无实验对比)· 已加载对方精读
- 共同关注的问题:同一个 root cause——CTR 模型极端稀疏的 embedding 在多 epoch 判别式训练中过拟合(one-epoch overfitting,二者都以 Zhang et al. CIKM '22 为现象出处),导致模型只敢训 1 个 epoch、稠密部分训练不充分。
- 相近的技术骨架:二者都是稀疏/稠密非对称处理:阻止 embedding 经历多 epoch 判别式更新,同时让稠密参数跨 epoch 持续训练。MEDA 在每个 epoch 开始时把 embedding 重置为随机初始化,MLP 参数累积;本文把 embedding 固定为生成式预训练的结果,稠密参数训练 3 个 epoch。
- 本文的差异与推进:(a) 本文的 embedding 从不接受判别式梯度,MEDA 的 embedding 每个 epoch 仍被判别式训练一遍;(b) 本文还声称解决了单 epoch 内的 within-one-epoch overfitting,MEDA 只针对 epoch 切换处的过拟合;(c) 本文要求额外的预训练阶段与数据,MEDA 零额外成本。两篇结合起来有一个值得注意的互补:MEDA 报告(仅文字、无数值)「第 2 个 epoch 起冻结已训练的 embedding 仍会过拟合」「从随机初始化起冻结 embedding 不收敛」。结合本文「冻结生成式预训练 embedding 显著有效」,可以推出一个两篇都没单独写明的推论:有害的是判别式训练出来的 embedding,冻结只有在 embedding 来自非判别式来源时才起作用。但本文没有做「冻结判别式预训练 embedding」的对照(见关键问题 1),这一推论仍需验证。
- 可比的方法 / 实验差异:本文没有把 MEDA 作为 baseline,无法直接比较「重置」与「冻结」。二者都报告了 Taobao 上 DIN/DIEN 的 AUC,但预处理不同、基线差异很大(DIN:MEDA 基线 0.8804、+MEDA 0.9265;本文基线 0.9341、+ST&SF 0.9752),数值不可比。后续 LazFormer 的 Config-5 实际上是把 MEDA 的「重置到随机」换成「重置到预训练值」,介于本文的冻结与 MEDA 的重置之间。
讨论与局限性¶
值得借鉴的设计¶
- 把「能不能 scale」先诊断为「是否过拟合」,并用训练/验证曲线而不仅是终点指标来论证。within-one-epoch overfitting 这一现象提醒:「只训 1 个 epoch」并不能消除稀疏参数的过拟合。
- 稀疏/稠密参数解耦处理。「迁移」与「冻结」拆成正交的两个选项,Table 3 用一张表清晰地证明了收益主要来自冻结,这种消融设计值得在任何预训练迁移工作中复用。
- ST&SF 的架构无关性让预训练 embedding 成为可复用的资产:同一份 embedding 可服务 Transformer、HSTU、Wukong 与传统 DIN 系模型,也能与每日增量训练结合。
- 诚实报告开销:Table 8 同时给出训练与预训练的 GPU 数与小时。
局限与争议¶
- 「为什么生成式」未被论证(关键问题 1)。全文没有判别式目标预训练的对照,作者的「随机负采样」假设也没被检验;Table 4 只比较了两种同族自监督目标。「生成式」这一命名本身也有误导性:目标在 item 维度上是均匀负采样的对比式分类(关键问题 3)。
- 预训练收益与数据量没有分开(关键问题 2)。工业侧 CLICK 与判别数据的时间跨度、用户数、时间窗重叠均未披露,也无法排除 CLICK 覆盖测试日带来的泄漏;公开侧的判别任务与预训练目标结构同构,放大了提升幅度。
- scaling law 的解释力被高估:没有 NT 曲线;横轴只计稠密参数,但 embedding 维度与预训练宽度同步放大了 32 倍;不是算力对齐的;拟合的 0.7097 上界附近边际收益已很小(3.23 倍算力换 0.14 pt)。
- 冻结依据有设定依赖(关键问题 4)。在过拟合极重、所有稀疏参数都能被预训练覆盖的离线设定中证据充分;后续 LazFormer(1 epoch、+0.24 pt)与 KGD 工业流(+0.05 到 +0.17 pt)都发现继续更新略优。没有中间方案(小学习率、先冻后解、重置)的对照。
- 全文无方差、无重复运行,Table 6 有三处相对提升计算错误(12.37%→13.37%、14.47%→14.75%、10.03%→10.30%)。
- 线上 A/B 混杂了架构替换(target attention → Transformer),且未说明数百个线上特征中哪些稀疏参数被冻结;无流量比例、置信区间与延迟数据。
- 方法论可扩展性上的隐患:这是典型的两阶段解耦,稀疏表征由预训练决定并在判别阶段固化,判别目标无法回头塑造 embedding。它在本文设定下是优点(正则),但当排序阶段有大量预训练覆盖不到的特征、或需要 embedding 追踪分布漂移时,就成了瓶颈。后续 LazFormer 的「继续更新 + 重置」、KGD 的「只读 encoder + 正交残差」都可以看作对这一瓶颈的修补。另外,Yandex 的案例研究(2607.26365,据其归档摘要)在大规模 two-tower ranker 中发现端到端 ID embedding 优于预训练的 GNN item embedding,预训练只在低资源数据集上稳定有效。虽然预训练形式不同,但它与本文结论的分歧同样指向「数据规模 / 过拟合强度」这一调节变量。
- 短序列:行为序列长度 10–100(Taobao 最长 200),作者自己也把「序列较短」列为局限。
工业落地价值¶
对于排序模型过拟合严重、特征以 item 侧 ID 为主、希望把单层 target attention 升级为深层 Transformer 的团队,GPSD 给出了一个实现成本很低的起点:开源代码,超参数完整(Table 2/5),增量部署形态(incremental-GPSD)清晰,并有 AliExpress 30 天 A/B 背书(GMV +7.03%、CTR +3.78%,但与架构替换混杂)。落地时建议:(1) 先在自己的数据上确认从零训练是否确实严重过拟合——若过拟合较轻(如 LazFormer 的设定),冻结可能不如继续更新;(2) 同时比较冻结、小学习率微调、按 epoch 重置三种方案;(3) 明确预训练数据与排序训练/评估数据的时间窗关系,避免泄漏;(4) 把预训练的每日增量开销计入 ROI。