LazFormer: Scaling Transformers for Industrial Recommendation via Transferable Generative Pre-training 精读¶
- 作者:Xiaodong Li, Alin Fan, Mingyang Li, Yan Xiao, Shichao Nie, Junfeng Zhang, Shaochuan Lin, Zhanming Ou, Tao Luo, Xiaoyi Zeng
- 单位:Alibaba International Digital Commerce Group(阿里国际数字商业集团,AIDC),北京
- arXiv: 2609.14978v1(2026-09-14),cs.IR
研究动机与背景¶
Transformer 在 LLM 上凭借「加参数、加数据、加算力就持续变好」的 scaling 行为取得成功,这一范式正在倒灌工业推荐。传统工业推荐模型(DeepFM、DCN、DIN 一系)走的是显式特征交互路线:高维稀疏 embedding 先经专用的序列建模模块与特征交互模块处理,再进打分头。近期 Wukong 与 RankMixer 尝试把特征交互网络本身做大,而 HSTU、MTGR 则把推荐重述为生成式序列转导问题,给出了经验 scaling law;OneTrans 更进一步,用统一的 Transformer 骨干在 per-token 粒度上同时完成用户序列建模与特征交互,MixFormer、HyFormer 沿这条线继续扩展异构特征交互与长序列建模。
但论文指出,这些工作有一个共同的结构性代价:它们都依赖单个排序模型从零同时优化稀疏参数与稠密参数。工业推荐的稀疏参数动辄数十亿(本文中嵌入参数约 5B),从随机初始化开始联合优化,算力消耗巨大、收敛缓慢。
预训练看起来是天然的解药——它能同时给稀疏与稠密参数一个好的初始化。但论文认为「预训练 + 排序」这一范式本身还有两个未解的限制,而这两点正是全文的立论:
- 稠密参数的负迁移(Negative transfer of dense parameters)。预训练阶段可用的特征与排序阶段所需的特征通常不一致——排序阶段会引入加购、下单等预训练时拿不到的行为特征。直接把这些排序专属特征拼接进输入,会扰动预训练稠密参数所期待的表示空间,造成负迁移。
- 稀疏参数的过拟合(Overfitting of sparse parameters)。排序阶段若训练多个 epoch,数十亿稀疏参数在同一批数据上反复更新会过拟合(即已被 Zhang et al./Liu et al. 反复观察到的 one-epoch overfitting 现象),破坏其可迁移表示;但反过来把稀疏参数冻住,又限制了它们向排序目标适配的能力。
于是核心挑战被表述为:如何在同时迁移稀疏与稠密参数的前提下,让模型容量与有效训练数据消耗能够共同 scaling(co-scaling)。LazFormer 的四个组件正是逐条对应:生成式预训练(提供初始化)、可迁移残差适配器(解稠密负迁移)、请求感知排序(让模型容量与序列长度在算力约束下可扩)、非对称多轮训练(解稀疏过拟合,让数据维度可扩)。
问题定义¶
工业推荐中需要同时预测多个概率,本文关注点击率(CTR)与点击后转化率(CVR)。记用户–物品交互数据 $\mathcal{D}=\{\mathcal{U},\mathcal{V},\mathcal{Y}\}$,其中 $\mathcal{Y}$ 含 $y^{ctr}\in\{0,1\}$ 与 $y^{cvr}\in\{0,1\}$。用户 $u_i$ 的历史交互序列记作 $\mathcal{H}_i=\{v_j\mid v_j\in\mathcal{V}\}_{j=1}^{|\mathcal{H}_i|}$,每个 $v_j$ 关联两类特征:
- ID-based 特征:历史序列中物品的 item ID,即 $\boldsymbol{e}^{id}_j$;
- Side Info-based 特征:物品属性与上下文特征。前者含 category、shop、brand、decay、stay time 等($\boldsymbol{e}^{cate}_j,\boldsymbol{e}^{shop}_j,\boldsymbol{e}^{brand}_j,\boldsymbol{e}^{decay}_j,\boldsymbol{e}^{stay}_j$),其中 $\boldsymbol{e}^{decay}_j$ 表示该交互物品与当前请求之间的时间间隔;后者主要刻画交互场景 $\boldsymbol{e}^{scene}_j$。
模型对目标(候选)物品集合 $\mathcal{T}_i=\{v_j\mid v_j\in\mathcal{V}\}_{j=1}^{|\mathcal{T}_i|}$ 预测:
$$\hat{y}^{ctr},\hat{y}^{cvr}=f\bigl(u_i,\mathcal{H}_i,\mathcal{T}_i;\Theta\bigr) \tag{1}$$
其中 $\Theta$ 为可训练参数,$f$ 是 Transformer-based 模型。优化标准的负对数似然:
$$\mathcal{L}_{XTRs}=-\sum_{xtr}^{ctr,cvr}\bigl[y^{xtr}\log(\hat{y}^{xtr})+(1-y^{xtr})\log(1-\hat{y}^{xtr})\bigr] \tag{2}$$
核心方法 / 模型架构¶
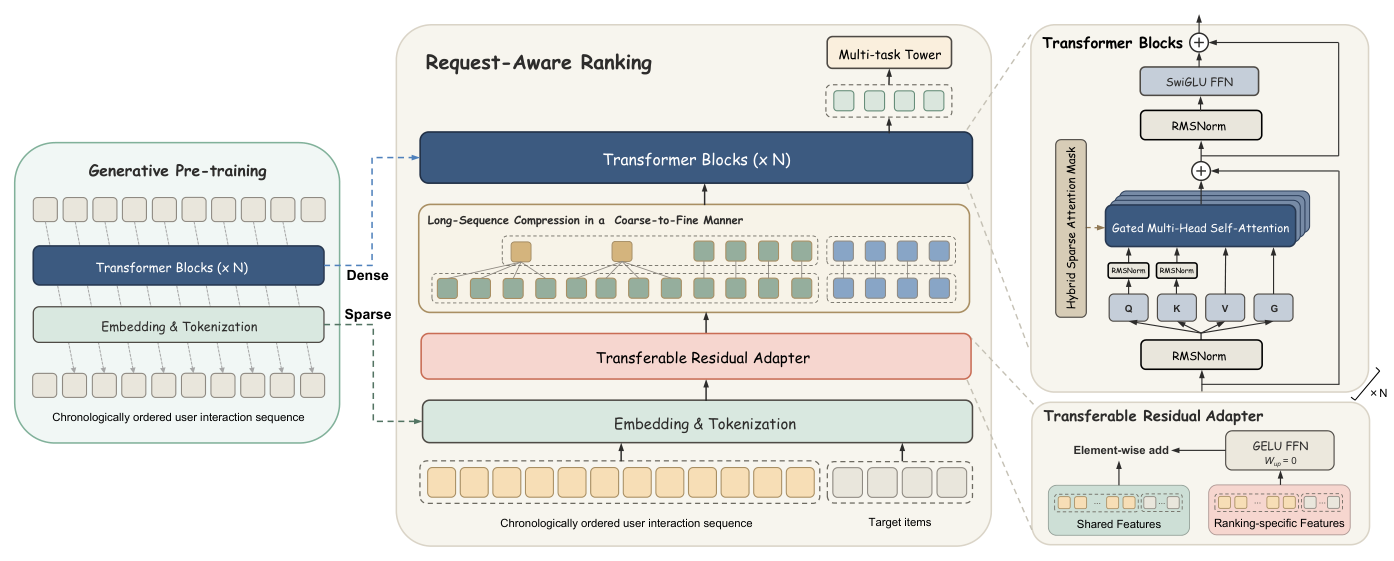
LazFormer 由三部分构成:(1) 生成式预训练,自回归生成序列特征,为后续排序提供稀疏与稠密参数的良好初始化;(2) 可迁移残差适配器,借鉴 LoRA 的思路,以残差方式把排序专属特征注入排序过程,解决稠密参数负迁移;(3) 请求感知排序,组合「由粗到细的长序列压缩 + 混合稀疏注意力 + 渐进式 token 剪枝 + 请求级范式」实现与预训练并行的模型 scaling。此外还有 (4) 非对称多轮训练策略,跨 epoch 持续累积稠密参数以实现数据 scaling,同时重置稀疏参数以缓解过拟合。
生成式预训练¶
与此前冻结预训练参数的方法(GPSD、SORT)不同,LazFormer 允许预训练参数在排序阶段继续被更新和优化。
Tokenization。 对用户 $u_i$ 的历史序列 $\mathcal{H}_i$ 中每个物品 $v_j$,先做 embedding 查表得到统一的 token 表示:
$$\boldsymbol{x}_j=[\boldsymbol{e}^{id}_j\|\boldsymbol{e}^{cate}_j\|\boldsymbol{e}^{shop}_j\|\boldsymbol{e}^{brand}_j\|\boldsymbol{e}^{decay}_j\|\boldsymbol{e}^{stay}_j] \tag{3}$$
其中 $\|$ 为拼接。由于不同特征组表示空间不同,再用线性投影与归一化映射到同一维度:
$$\boldsymbol{h}_j=\mathrm{RMSNorm}\bigl(\boldsymbol{W}_{attr}\boldsymbol{x}_j+\boldsymbol{W}_{cont}\boldsymbol{e}^{scene}_j\bigr) \tag{4}$$
$$\boldsymbol{H}_i=[\boldsymbol{h}_1,\boldsymbol{h}_2,\ldots,\boldsymbol{h}_{|\mathcal{H}_i|}] \tag{5}$$
关键工程约束:只要对应特征在排序阶段可用,稀疏 embedding 层与投影层就与后续排序共享——这是稀疏参数得以迁移的物理载体。
Next-Item Prediction。 用一叠 Transformer block 捕捉序列依赖,每块含因果自注意力、FFN、归一化与残差连接,并引入 pre-Norm、QKNorm 与 attention gate 稳定训练:
$$\boldsymbol{Q}^l_r,\boldsymbol{K}^l_r,\boldsymbol{V}^l_r=\mathrm{RMSNorm}\bigl(\boldsymbol{H}^{l-1}_i\boldsymbol{W}^Q_r,\ \boldsymbol{H}^{l-1}_i\boldsymbol{W}^K_r,\ \boldsymbol{H}^{l-1}_i\boldsymbol{W}^V_r\bigr) \tag{6}$$
$$\mathrm{Head}^l_r=\mathrm{Softmax}\left(\frac{\boldsymbol{Q}^l_r{\boldsymbol{K}^l_r}^{\top}}{\sqrt{d_k}}+\boldsymbol{M}\right)\boldsymbol{V}^l_r \tag{7}$$
$$\mathrm{MHA}^l=[\mathrm{Head}^l_1\|\mathrm{Head}^l_2\|\ldots\|\mathrm{Head}^l_n]\boldsymbol{W}^O \tag{8}$$
$$\tilde{\boldsymbol{H}}^l_i=\boldsymbol{H}^{l-1}_i+\mathrm{MHA}^l,\qquad \boldsymbol{H}^l_i=\tilde{\boldsymbol{H}}^l_i+\mathrm{FFN}^l\bigl(\mathrm{RMSNorm}(\tilde{\boldsymbol{H}}^l_i)\bigr) \tag{9}$$
其中 $\boldsymbol{M}$ 是因果掩码,防止未来交互泄漏。得到最终序列表示 $\boldsymbol{Z}_i=[\boldsymbol{z}_1,\ldots,\boldsymbol{z}_{|\mathcal{H}_i|}]$ 后,把隐表示投影回 item ID embedding 空间:
$$\boldsymbol{q}_j=\boldsymbol{W}_{auto}\boldsymbol{z}_j \tag{10}$$
以 $\boldsymbol{e}^{id}_{j+1}$ 为正样本,从同 mini-batch 其他序列中采一组负样本 $\mathcal{N}_{i,j}$,生成概率为:
$$p(v_{j+1}\mid\mathcal{H}_{i,\le j})=\frac{\exp\bigl(s(\boldsymbol{q}_j,\boldsymbol{e}^{id}_{j+1})\bigr)}{\sum_{v\in\{v_{j+1}\}\cup\mathcal{N}_{i,j}}\exp\bigl(s(\boldsymbol{q}_j,\boldsymbol{e}^{id}_v)\bigr)} \tag{11}$$
其中 $s(\boldsymbol{a},\boldsymbol{b})=\mathrm{sim}(\boldsymbol{a},\boldsymbol{b})/\tau$ 是温度缩放的余弦相似度,$\tau$ 可学习。预训练损失:
$$\mathcal{L}_{pre}=-\sum_{u_i\in\mathcal{U}}\sum_{j=1}^{|\mathcal{H}_i|-1}\log p(v_{j+1}\mid\mathcal{H}_{i,\le j}) \tag{12}$$
可迁移残差适配器(Transferable Residual Adapter)¶
排序阶段特有的特征包括加购(add to cart)、下单(order)以及对应的 gap(加购/下单距最近一次点击的时间间隔):
$$\boldsymbol{s}_j=[\boldsymbol{e}^{atc}_j\|\boldsymbol{e}^{order}_j\|\boldsymbol{e}^{atc-gap}_j\|\boldsymbol{e}^{order-gap}_j],\qquad \boldsymbol{a}_j=\boldsymbol{W}_{up}\,\mathrm{GELU}\bigl(\boldsymbol{W}_{down}\boldsymbol{s}_j\bigr) \tag{13}$$
论文强调这一设计的附加好处:它让多行为信号无需显式拉长交互序列即可注入,避免了更长自注意力输入带来的巨大开销。残差被逐元素加到从预训练载入的交互 token 上:
$$\boldsymbol{h}^{rank}_j=\mathrm{RMSNorm}\bigl(\boldsymbol{W}_{attr}\boldsymbol{x}_j+\boldsymbol{W}_{cont}\boldsymbol{e}^{scene}_j+\boldsymbol{a}_j\bigr) \tag{14}$$
关键在于 $\boldsymbol{W}_{up}=0$ 的零初始化,使适配器初始产出零残差:
$$\boldsymbol{a}_j=0\ \Rightarrow\ \boldsymbol{h}^{rank}_j=\mathrm{RMSNorm}\bigl(\boldsymbol{W}_{attr}\boldsymbol{x}_j+\boldsymbol{W}_{cont}\boldsymbol{e}^{scene}_j\bigr) \tag{15}$$
即排序从预训练学到的特征形态精确出发(函数保持式初始化),再在优化中逐步吸收排序专属特征。这与冻结预训练参数的方法形成对比:LazFormer 让稀疏与稠密参数都能继续适配排序目标,同时保证起点不被扰动。
与预训练 token 构造逐项对照。 把式 (14) 与预训练的式 (4) 并排看,两者只差一项 $+\boldsymbol{a}_j$:$\boldsymbol{x}_j$ 与 $\boldsymbol{e}^{scene}_j$ 在预训练阶段就已存在,$\boldsymbol{W}_{attr}$、$\boldsymbol{W}_{cont}$ 连同稀疏 embedding 层按上文约束与排序共享。因此 $\boldsymbol{W}_{up}=0$ 给出的不是「近似保持」而是恒等——第 0 步式 (14) 与式 (4) 是同一个函数。需要限定的是,「排序阶段只新增了 $\boldsymbol{a}_j$」仅对 token 构造这条路径成立;排序阶段整体上还新增了目标物品 token、长序列压缩、混合稀疏注意力、请求级组织与多任务 tower,只是它们作用在 token 的下游或结构层面,而非注入 token 本身。
注入位置:token 构造之后、压缩之前,只加一次。 Figure 1 给出了排序侧的完整数据流:Embedding & Tokenization → Transferable Residual Adapter → 由粗到细长序列压缩 → Transformer Blocks (×N) → Multi-task Tower。可见 $\boldsymbol{a}_j$ 只在进入压缩与 Transformer Blocks 之前加一次,而且先于长序列压缩——因此 $\boldsymbol{a}_j$ 携带的多行为信息会随压缩流入远期压缩 token $\boldsymbol{c}$,这与式 (18) 中 $\hat{\boldsymbol{H}}^{rank}_i$ 整体带 rank 上标的记号一致。虽然论文称其「draws inspiration from LoRA」,但 LoRA 改的是层内权重矩阵、逐层插入;这里借用的只是「瓶颈 + 零初始化」这两个构件。(图中右下角的 Transferable Residual Adapter 是同一模块的放大说明,并非第二个适配器实例。)
注入粒度:逐个历史 token,而非 global 或目标 token。 原文把排序专属特征定义为「item $v_j$ 的」加购、下单与 gap,下标与交互序列 $\mathcal{H}_i=\{v_j\}$ 的 $j$ 一致,因此历史序列的每个 token 都注入,既不是只加在 global token 上,也不是只加在目标 token 上。而式 (18) 中的目标物品 token $\boldsymbol{T}_i$,原文明确是「constructed using the shared feature embeddings and projection layers」,即走式 (4) 的路径。这在语义上也是必然的:加购、下单、gap 描述的是已发生的交互,而目标物品是尚待打分的候选,这四个特征对它不存在。
需要指出一处图文不一致:Figure 1 把适配器方框画得横跨整个输入宽度、覆盖了目标物品,单看图会以为目标 token 也经过适配器。本文采纳正文的表述,理由有二:其一,$\boldsymbol{T}_i$ 被限定为只用共享的 embedding 与投影层构造,而适配器的 $\boldsymbol{W}_{down}$、$\boldsymbol{W}_{up}$ 恰恰是排序独有、不在共享层之列的参数;其二,排序专属特征在语义上只属于已发生的交互。若真按图的画法让目标 token 也走适配器,其排序专属特征只能取「无加购/无下单」的缺省值,训练后产出的将是一个非零的常数残差而不是零——论文对此没有说明。
设计意图:用通道维度换序列维度的多行为建模。 预训练序列的 token 特征 $\boldsymbol{x}_j$(式 3)全是点击侧属性,序列本身是点击序列。适配器所做的,是在同一个被点击 item 的 token 上叠加「它后来是否被加购/下单、以及那次行为距最近点击隔了多久」。常规的多行为序列建模会把加购、下单作为独立 token 插入序列,使序列长度成倍增长、自注意力开销按平方上涨;LazFormer 保持序列长度不变,把其他行为叠加到已有 token 上。
一个论文未讨论的覆盖盲区(本文观察,非原文结论):这种叠加式设计只能表示已在点击序列中的 item 的多行为信号。一个商品若被加购或下单却从未被点击,或那次点击落在保留窗口之外,就没有 token 可以附着,等于完全不进入模型;真正插入行为 token 的做法没有这个盲区。论文没有量化这部分覆盖损失。它不影响 Table 3 的对比结论——各变体使用同一套特征,盲区在变体间一致——但会限制该设计在「从推荐位直接加购、无独立点击」较常见的场景下的上限。
请求感知排序(Request-Aware Ranking)¶
排序阶段的序列远长于预训练,且同一请求内有多个目标物品;若仍按单目标物品构样本,同一条长序列会被反复编码,存储与带宽成为瓶颈。
由粗到细的长序列压缩。 保留短期交互的细粒度,压缩长期交互。记 $L_i=|\mathcal{H}_i|$,$\ell_i=\min(L_i,L_s)$ 为保留的短期 token 数($L_s$ 为预设短期长度),其余交互按组大小 $g$ 分组做组内求和池化:
$$\boldsymbol{c}_k=\sum_{j=\ell_i+(k-1)g+1}^{\min(\ell_i+kg,\,L_i)}\boldsymbol{h}^{rank}_j \tag{16}$$
$$\hat{\boldsymbol{H}}^{rank}_i=[\boldsymbol{c}_1,\ldots,\boldsymbol{c}_{N_i},\boldsymbol{h}^{rank}_1,\ldots,\boldsymbol{h}^{rank}_{\ell_i}] \tag{17}$$
其中 $N_i=\lceil (L_i-\ell_i)/g\rceil$,序列长度由 $L_i$ 降到 $N_i+\ell_i$。
混合稀疏注意力。 把同一请求的全部目标物品 token 追加到压缩后的历史之后:
$$\boldsymbol{X}^0_i=[\hat{\boldsymbol{H}}^{rank}_i\|\boldsymbol{T}_i]=[\boldsymbol{c}_1,\ldots,\boldsymbol{c}_{N_i},\boldsymbol{h}^{rank}_1,\ldots,\boldsymbol{h}^{rank}_{\ell_i},\boldsymbol{t}_1,\ldots,\boldsymbol{t}_{|\mathcal{T}_i|}] \tag{18}$$
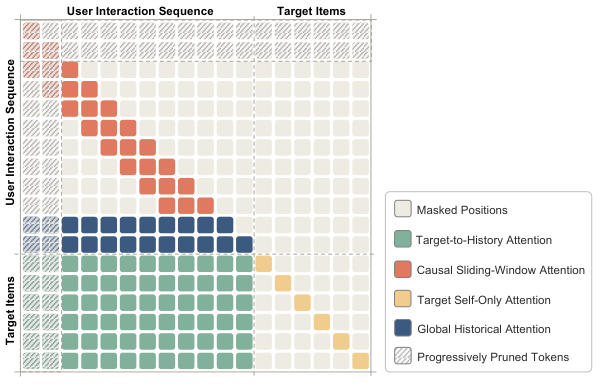
把最近的 $G_i$ 个历史 token 指定为全局 token(承载短期细粒度偏好并做长程信息传播),其余为局部历史 token,结合因果滑动窗口注意力构造稀疏模式。设 $p,q$ 为 query/key 位置,$\tilde{L}_i=N_i+\ell_i$ 为压缩后历史 token 数,$W$ 为滑窗大小:
$$\mathcal{A}_i(p,q)=\begin{cases}1,& p,q\le\tilde{L}_i,\ q\le p,\ (p-q<W\ \text{或}\ p>\tilde{L}_i-G_i),\\ 1,& p>\tilde{L}_i,\ q\le\tilde{L}_i,\\ 1,& p>\tilde{L}_i,\ q>\tilde{L}_i,\ p=q,\\ 0,&\text{otherwise},\end{cases} \tag{19}$$
$$\boldsymbol{M}_{p,q}=\begin{cases}0,&\mathcal{A}_i(p,q)=1,\\ -\infty,&\mathcal{A}_i(p,q)=0,\end{cases} \tag{20}$$
$$\mathrm{SparseAttn}(\boldsymbol{Q},\boldsymbol{K},\boldsymbol{V})=\mathrm{Softmax}\left(\frac{\boldsymbol{Q}\boldsymbol{K}^{\top}}{\sqrt{d_k}}+\boldsymbol{M}\right)\boldsymbol{V} \tag{21}$$
三条规则的物理含义:局部 token 只看自己前面的窗口;全局 token 提供跨越遥远历史的持久信息锚点;每个目标物品能看到全部有效历史(全局 + 局部),但在目标序列内部只能看到自己,从而杜绝候选之间的信息泄漏。稀疏模式用 flex attention 编译成融合 CUDA kernel 落地。
渐进式 token 剪枝。 跨层线性削减保留的历史 token 数,把 $\tilde{L}_i$ 降到预设最小长度 $N_{\min}$:
$$N^l_i=\min\left(\tilde{L}_i,\ \max\left(N_{\min},\ \mathrm{Round}\left[\tilde{L}_i-\frac{l-1}{L-1}(\tilde{L}_i-N_{\min})\right]\right)\right) \tag{22}$$
第 $l$ 层之后,只有最近的 $N^{l+1}_i$ 个历史表示与全部目标物品表示进入下一层。
请求感知范式。 传统排序对每个目标物品 $v_j$ 独立构样本 $(u_i,\mathcal{H}_i,v_j,y_{ij})$,同一条 $\mathcal{H}_i$ 被反复序列化、存储、CPU→GPU 传输并编码。LazFormer 改为请求级组织:
$$\mathcal{R}_i=(u_i,\mathcal{H}_i,\mathcal{T}_i,\mathcal{Y}_i) \tag{23}$$
历史只序列化与传输一次,请求内全部目标物品并行处理。论文明确点出两者分工:混合稀疏注意力降的是长序列建模的计算成本,请求级训练消除的是冗余存储、传输与重复历史编码——一个是算法侧、一个是系统侧的互补。
排序 Transformer 输出后取所有目标物品的上下文表示:
$$\boldsymbol{Z}^t_i=[\boldsymbol{z}^t_1,\boldsymbol{z}^t_2,\ldots,\boldsymbol{z}^t_{|\mathcal{T}_i|}] \tag{24}$$
$$\hat{y}^{xtr}=f_{xtr}(\boldsymbol{Z}^t_i) \tag{25}$$
$$\mathcal{L}_{rank}=\mathcal{L}_{XTRs} \tag{26}$$
由于目标物品被稀疏掩码相互隔离,请求级范式在共享历史的存储/传输/编码的同时保持了各目标预测的独立性。
非对称多轮训练策略¶
即便有好的初始化,单个 epoch 仍不足以让稠密骨干吸收大规模日志中的全部监督;但直接多轮训练会触发 one-epoch overfitting。论文的解法是按参数类型区别对待:每个 epoch 开始时把稀疏参数 $\Theta^s$ 重置回从生成式预训练迁移来的初始态 $\Theta^s_{init}$,而稠密参数 $\Theta^d$ 继承上一个 epoch 的优化结果:
$$\Theta^s_{e,0}=\Theta^s_{init},\qquad \Theta^d_{e,0}=\begin{cases}\Theta^d_{init},&e=1,\\ \Theta^d_{e-1,K_{e-1}},&e>1,\end{cases} \tag{27}$$
其中 $e$ 为 epoch 索引,$K_{e-1}$ 为上一 epoch 的训练步数。每个 epoch 内部两类参数都由 $\mathcal{L}_{rank}$ 联合优化。
实验设置¶
数据集。 全部为某真实电商推荐平台的工业数据,无任何公开学术数据集。预训练集按 GPSD 的做法,将每个用户一年的交互按时序排序并切成子序列;排序集用过去连续 25 天日志训练、次日测试。
| Dataset | # Users | # Tokens | # Impressions |
|---|---|---|---|
| Pre-training | 16M | 11B | – |
| Ranking | 11M | – | 370M |
Baselines。 覆盖四类:vanilla Transformer;可扩展排序 Transformer(HSTU、OneTrans);预训练–排序范式(SORT);高效长序列建模(STCA)。为公平起见,所有 baseline 都载入了与 LazFormer 相同的预训练稀疏参数(尽管原文中这些 ranking-only baseline 通常是从零训练的),只有 LazFormer 额外迁移了稠密参数。
评估指标。 AUC 与 GAUC;效率侧报告可训练参数量与 FLOPs。论文特别声明:在其工业数据集上,AUC/GAUC 0.1 pt(即 0.001)的提升已被视为显著。
实现细节。 PyTorch + NVIDIA H100 + AdamW。Transformer / HSTU / OneTrans / SORT / STCA / LazFormer* 共享同一骨干配置:3 层、hidden size 256、4 头、FFN 维度 1024、序列长度 1024;SORT 用 1 个共享专家 + 4 个路由专家(激活 2 个)。生成式预训练用 5 层 Transformer,item-ID embedding 维度 64,温度 $\tau=0.07$,16,000 个 in-batch 负样本。LazFormer 相对 LazFormer* 扩到 5 层、序列长度 2,048,其中 $\ell_i=1{,}024$、压缩窗口 $g=8$、$W=G_i=N_{\min}=128$。默认全部训练 1 epoch,LazFormer† 表示用非对称多轮策略训 3 epoch。
主要实验结果(RQ1)¶
Table 2:离线主结果(粗体为最优,下划线为最佳 baseline;缩进行派生自 LazFormer;结果为三次运行平均)
| Models | CTR AUC | CTR GAUC | CVR AUC | CVR GAUC | Params | FLOPs |
|---|---|---|---|---|---|---|
| Transformer | 0.7630 | 0.6704 | 0.8835 | 0.7001 | 6M | 20G |
| HSTU | 0.7636 | 0.6725 | 0.8826 | 0.6942 | 6M | 22G |
| STCA | 0.7636 | 0.6732 | 0.8830 | 0.6996 | 7M | 3G |
| OneTrans | 0.7661 | 0.6738 | 0.8840 | 0.7053 | 28M | 15G |
| SORT | 0.7652 | 0.6740 | 0.8850 | 0.7068 | 16M | 29G |
| LazFormer | 0.7735 | 0.6868 | 0.8905 | 0.7130 | 9M | 25G |
| Improve (pt) ↑ | +0.74 | +1.28 | +0.55 | +0.62 | – | – |
| LazFormer* | 0.7704 | 0.6808 | 0.8885 | 0.7094 | 7M | 14G |
| LazFormer† | 0.7761 | 0.6891 | 0.8933 | 0.7143 | 9M | 75G |
LazFormer*:降配到 baseline 配置(3 层、序列长度 1,024)。LazFormer†:启用非对称多轮训练(3 epoch)。Params 不含约 5B 的嵌入参数(所有模型相同)。FLOPs 为同一请求级样本上一次训练前反向的量、跨 epoch 累加,且只计未被掩码的注意力对。
结论分析:
- 增益不是单纯堆算力换来的。LazFormer* 在与 baseline 完全对齐的深度与序列长度下(3 层/1024)已经全面超过所有 baseline,且 FLOPs 只有 14G——低于 vanilla Transformer 的 20G、HSTU 的 22G、SORT 的 29G,与 OneTrans 的 15G 基本持平。这是全表最有说服力的一条:算力对齐(甚至算力更低)时优势依然成立。
- 优势也不是来自稀疏侧预训练初始化。所有 baseline 都载入了同一份预训练稀疏参数,因此差距只能归到「超越 sparse-only 迁移、走向可迁移的稠密适配」。
- 相比同属预训练范式的 SORT(同样只做 sparse-only 迁移),LazFormer 的稠密可迁移适配仍带来额外增益(CTR AUC 0.7652→0.7735)。
- 相比高效长序列 baseline STCA:STCA 通过激进压缩用户历史只需 3G FLOPs(全表最低),但牺牲了细粒度短期偏好,因此落后 LazFormer*;而 LazFormer 的由粗到细压缩兼顾了长短期。
消融与分析¶
可迁移残差适配器分析(RQ2)¶
四个变体:Sparse(只迁移稀疏参数,排序模型不变)、NoFeat(迁移稀疏+稠密,但移除排序专属特征,输入只含预训练共享特征)、Direct(迁移稀疏+稠密,在 tokenization 阶段直接融合排序专属特征)、PreProj(迁移稀疏+稠密,在被迁移的输入投影之前加一个预投影融合层)。
Table 3:可迁移残差适配器消融
| Variants | CTR AUC | CTR GAUC | CVR AUC | CVR GAUC |
|---|---|---|---|---|
| Sparse | 0.7699 | 0.6810 | 0.8898 | 0.7109 |
| NoFeat | 0.7694 | 0.6843 | 0.8809 | 0.7038 |
| Direct | 0.7701 | 0.6817 | 0.8897 | 0.7091 |
| PreProj | 0.7699 | 0.6810 | 0.8889 | 0.7050 |
| LazFormer | 0.7735 | 0.6868 | 0.8905 | 0.7130 |
这张表是全文信息量最大的一处消融,读法如下(第 4 点指出其中一处混淆):
- 相对 Sparse 的增益证明稠密迁移本身有价值(CTR AUC +0.36 pt,CTR GAUC +0.58 pt)。
- NoFeat 的分裂行为:它的 CTR GAUC 达到 0.6843(全表第二好,甚至超过 Direct 与 PreProj),说明「当排序只用与预训练对齐的共享特征时,稠密迁移依然有效」;但 CVR 大幅塌陷(AUC 0.8809、GAUC 0.7038,全表最差)。论文由此论证 order、order-gap 这类强购买意图信号对转化建模不可或缺,不能为了对齐预训练输入就把它们删掉。
- 真正的发现在 Direct/PreProj 与 LazFormer 的对比上:Direct(0.7701)与 PreProj(0.7699)几乎与完全不迁稠密的 Sparse(0.7699)不可区分——按论文自己的 0.1 pt 显著性门槛,这三者是同一水平。也就是说,只要融合方式错了,稠密迁移的收益就会被完全抵消掉。直接融合会扰动预训练学到的输入表示空间;额外的随机初始化预投影同样扰动喂给预训练稠密骨干的输入。只有零初始化残差分支在初始时刻精确保持预训练表示、再逐步纳入排序专属特征,才把 +0.36 pt 释放出来。「融合方式」比「是否迁移稠密参数」更关键——这一层结论站得住。
- 但这组对照同时改变了初始化与支路结构,「零初始化是起作用的机制」并未被隔离,详见下文。
三种融合方式的机制差异与混淆¶
原文对 Direct 与 PreProj 只有散文描述、未给公式。下面的式 (28)–(31) 是按其措辞还原或推导的,并非论文原式。比较的基准是预训练的式 (4)。
Direct(原文:「directly fuses ranking-specific features with shared features at the tokenization stage」)在式 (3) 那一步就把排序特征拼进来,$\boldsymbol{x}_j\to[\boldsymbol{x}_j\|\boldsymbol{s}_j]$:
$$\boldsymbol{h}_j=\mathrm{RMSNorm}\bigl(\boldsymbol{W}'_{attr}[\boldsymbol{x}_j\|\boldsymbol{s}_j]+\boldsymbol{W}_{cont}\boldsymbol{e}^{scene}_j\bigr) \tag{28}$$
$\boldsymbol{W}_{attr}$ 必须为新拼入的维度扩出一批列,于是 $\boldsymbol{W}_{attr}\boldsymbol{x}_j$ 这一项本身被改动,第 0 步输出不再等于预训练表示。原文的解释是「perturbs the input representation space learned during pre-training」。
PreProj(原文:「uses a pre-projection layer to fuse ranking-specific features with shared features before the transferred input projection」)先过一层随机初始化的融合层 $\boldsymbol{P}$,再喂给迁移来的投影:
$$\tilde{\boldsymbol{x}}_j=\boldsymbol{P}\bigl([\boldsymbol{x}_j\|\boldsymbol{s}_j]\bigr),\qquad \boldsymbol{h}_j=\mathrm{RMSNorm}\bigl(\boldsymbol{W}_{attr}\tilde{\boldsymbol{x}}_j+\boldsymbol{W}_{cont}\boldsymbol{e}^{scene}_j\bigr) \tag{29}$$
迁移来的 $\boldsymbol{W}_{attr}$ 本身得以保留,但喂给它的输入 $\tilde{\boldsymbol{x}}_j\neq\boldsymbol{x}_j$。原文:「still perturbs the input representations fed into the pre-trained dense backbone」。保住了权重,没保住输入。
LazFormer 让排序特征不汇入主路,走式 (13) 的并行瓶颈支路,在迁移投影之后相加(式 14)。$\boldsymbol{W}_{attr}\boldsymbol{x}_j$ 与 $\boldsymbol{x}_j$ 均不变动,加上 $\boldsymbol{W}_{up}=0$,第 0 步恒等于式 (4)。
| 变体 | 迁移的 $\boldsymbol{W}_{attr}$ 原样保留 | 输入 $\boldsymbol{x}_j$ 原样保留 | 第 0 步输出 | CTR AUC |
|---|---|---|---|---|
| Sparse(不迁稠密) | — | — | — | 0.7699 |
| Direct | ✗(扩列) | ✗ | 被扰动 | 0.7701 |
| PreProj | ✓ | ✗(过随机层) | 被扰动 | 0.7699 |
| LazFormer | ✓ | ✓ | 恒等于式 (4) | 0.7735 |
混淆所在。 Direct 与 LazFormer 之间,变动的不只是初始化,而是两件事:(i) 初始化,新增部分随机初始化 vs. 零初始化;(ii) 支路结构,一次线性映射 vs. GELU 瓶颈 MLP。论文把 0.7701→0.7735 的差距完全归因于 (i),但这个实验无法区分 (i) 与 (ii)。
关键在于,零输出起点并非 LazFormer 独有。把 Direct 扩出的矩阵拆开,$\boldsymbol{W}'_{attr}=[\boldsymbol{W}_{attr},\ \boldsymbol{W}_s]$:
$$\boldsymbol{W}'_{attr}[\boldsymbol{x}_j\|\boldsymbol{s}_j]=\boldsymbol{W}_{attr}\boldsymbol{x}_j+\boldsymbol{W}_s\boldsymbol{s}_j \tag{30}$$
只要令新增列 $\boldsymbol{W}_s=\boldsymbol{0}$,第 0 步即恒等于式 (4),与 LazFormer 的起点逐项相同;且 $\partial\mathcal{L}/\partial\boldsymbol{W}_s=\boldsymbol{\delta}\,\boldsymbol{s}_j^\top\neq\boldsymbol{0}$,第一步就开始学习,不存在死支路。但训练过程中两者属于不同的函数类:Direct 置零后的残差是 $\boldsymbol{W}_s\boldsymbol{s}_j$,线性、满秩;LazFormer 的残差是 $\boldsymbol{W}_{up}\mathrm{GELU}(\boldsymbol{W}_{down}\boldsymbol{s}_j)$,非线性、秩受瓶颈维度限制。二者互不包含。所以「起点相同」只保证了不被扰动,不保证学到同样的东西。
PreProj 要做到同样的起点则更苛刻。设 $\boldsymbol{P}$ 线性:
$$\boldsymbol{P}[\boldsymbol{x}_j\|\boldsymbol{s}_j]=\boldsymbol{P}_x\boldsymbol{x}_j+\boldsymbol{P}_s\boldsymbol{s}_j \tag{31}$$
只令 $\boldsymbol{P}_s=\boldsymbol{0}$ 并不够,随机的 $\boldsymbol{P}_x$ 仍会打乱 $\boldsymbol{x}_j$;还须 $\boldsymbol{P}_x=\boldsymbol{I}$,这要求 $\boldsymbol{P}$ 线性且输出维数等于 $\dim\boldsymbol{x}_j$,中间一旦含非线性就无法做到。即便满足,残差 $\boldsymbol{W}_{attr}\boldsymbol{P}_s\boldsymbol{s}_j$ 仍穿过可训练的 $\boldsymbol{W}_{attr}$:它的每次更新都会同时带动共享特征与排序特征两条路径。LazFormer 的支路则是独立的,不共用预训练投影。
缺失的对照臂正是「Direct + 新增列零初始化」,它能直接判决机制:
- 若其结果 ≈ 0.7735,论文的解释成立:零初始化才是关键,适配器的具体结构无关紧要,任何函数保持式初始化都行;
- 若其结果 ≈ 0.7701,则零初始化并不充分,收益来自非线性瓶颈支路,论文的机制解释不成立。
论文没有跑这一臂,也没有说明 Direct 新增列的初始化方式——「扰动表示空间」这一解释只是暗示它们非零。
结论分两层。 「融合方式比是否迁移稠密参数更关键」这一层,由 Direct/PreProj/Sparse 三者不可区分得到支持;「零初始化是起作用的机制」这一更具体的主张,并未被隔离。
非对称多轮训练策略分析(RQ3)¶
Table 4:参数载入与优化策略对比(freeze / continue / reset 分别表示稀疏冻结、稀疏持续更新、稀疏重置;本表仅报告 CTR)
| Config | Sparse | Dense | Epoch | CTR AUC | CTR GAUC |
|---|---|---|---|---|---|
| Config-1 | ✗ | ✗ | 1 | 0.7577 | 0.6587 |
| Config-2 | ✓, freeze | ✗ | 1 | 0.7675 | 0.6775 |
| Config-3 | ✓, continue | ✗ | 1 | 0.7699 | 0.6810 |
| Config-4 | ✓, continue | ✗ | 3 | 0.7387 | 0.6694 |
| Config-5 | ✓, reset | ✗ | 3 | 0.7731 | 0.6851 |
| Config-6 | ✓, reset | ✓ | 3 | 0.7761 | 0.6891 |
逐条分析:
- Config-1 → Config-2/3:载入预训练稀疏参数带来跳变式提升(+0.98/+1.22 pt AUC),确立了预训练的价值基线。
- Config-2 → Config-3:让稀疏参数继续适配排序目标优于冻结它们(+0.24 pt)——这正面反驳了 GPSD/SORT 那条「冻结稀疏参数」的路线。
- Config-3 → Config-4:naive 地连训 3 epoch 造成灾难性退化(0.7699→0.7387,-3.12 pt),把 one-epoch overfitting 现象在本文的设定下复现了出来。
- Config-4 → Config-5:每 epoch 把稀疏参数重置回预训练态,直接把 -3.12 pt 的坑填平并反超 1-epoch 基线(0.7731)。
- Config-5 → Config-6:再叠加稠密参数迁移达到最优(0.7761)。
跨表一致性很好:Config-3 与 Table 3 的 Sparse 完全相同(0.7699/0.6810),Config-6 与 Table 2 的 LazFormer† 完全相同(0.7761/0.6891)。这类交叉一致是诚实报告的正面信号。
Scaling Laws 分析(RQ4)¶
Table 5:LazFormer 的不同模型规模
| Scale | Depth | Width | Intermediate Size | Params |
|---|---|---|---|---|
| Small | 5 | 256 | 1024 | 9M |
| Medium | 8 | 384 | 1536 | 23M |
| Large | 12 | 512 | 2048 | 55M |
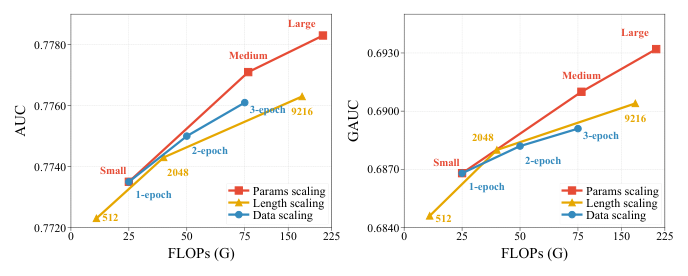
三条 scaling 轴:模型容量(Small/Medium/Large)、训练数据(1/2/3 epoch,用非对称多轮策略)、序列长度(512→9,216)。横轴是 FLOPs 而非参数量,这一点很重要——这是一张真正算力对齐的 scaling 图,而不是常见的「只对齐参数量」的伪对比。
论文自己的结论是三条轴上 AUC/GAUC 都随算力单调上升。但从图里还能读出两条论文没有写的事实(数值按图上刻度读取,横轴刻度为 0/25/50/75/150/225,非均匀):
- 三条轴的算力性价比并不相同。参数 scaling 曲线整体位于另外两条之上:约 50G 处 Medium 已达 AUC≈0.7770,而同算力的 2-epoch 只有≈0.7748;75G 处 3-epoch 为 0.7761,而参数曲线插值约 0.7775。换言之,论文的第二个「解法」(非对称多轮 = data scaling)在它自己的算力对齐图里恰好是三条轴中收益最低的一条——同样的算力用来把模型做大更划算。
- 饱和非常明显,且被横轴的非均匀刻度在视觉上拉直了。Small(25G)→Medium(50G) 用 2× 算力换 +0.35 pt;Medium(50G)→Large(≈215G) 用 ≈4.4× 算力只换 +0.13 pt,边际收益下降约一个量级。横轴在 75G 之后被压缩(75 与 150、225 等距),使高算力段看起来仍在陡升。
- 另有一处未解释的不一致:长度 scaling 曲线上的 2048 点为 AUC≈0.7745、约 40G,而默认 LazFormer 同样是序列长度 2048 却是 0.7735/25G(与 Small、1-epoch 两个锚点重合)。说明长度 scaling 这条 sweep 用了与默认配置不同的注意力稀疏设定(0.7745 恰好等于 Figure 5 中 Sparsity-1 的数值),论文未加说明。
请求感知排序的效率分析(RQ5)¶
Table 6:不同长序列压缩策略的配置
| Strategy | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|
| $\ell_i$ | 0 | 256 | 512 | 0 | 1024 | 1024 | 2048 |
| $g$ | 4 | 8 | 16 | 2 | 16 | 8 | – |
| $\ell_i+N_i$ | 512 | 480 | 608 | 1024 | 1088 | 1152 | 2048 |
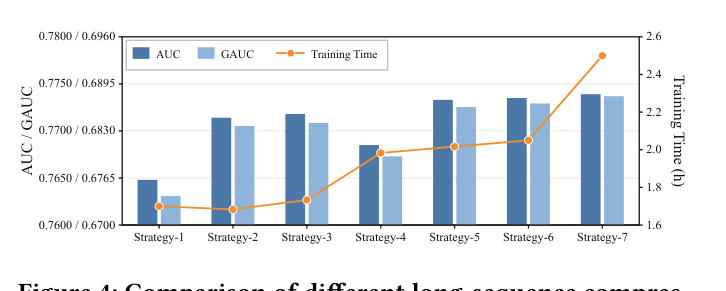
观察:(1) 全序列无差别压缩效果次优——Strategy-4 压缩后仍保留 1,024 token,却仍不如只留 480/608 token 的 Strategy-2/3,说明细粒度短期序列对刻画用户偏好是必需的;(2) 由粗到细的策略中保留更多短期交互普遍更好,Strategy-6(即 LazFormer 采用的 $\ell_i=1024$、$g=8$)在所有压缩策略中最优,相对未压缩的 Strategy-7 只有轻微性能损失却显著缩短训练时间(训练时长从约 2.5h 降到约 2.1h)。
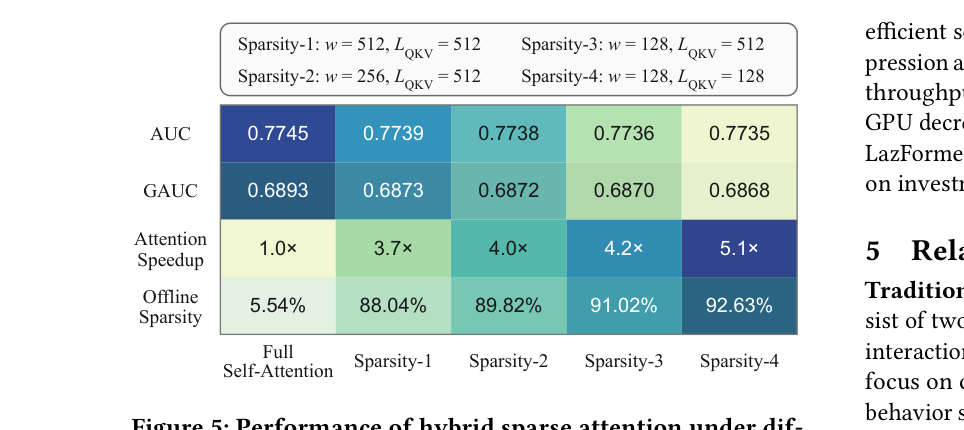
混合稀疏注意力的四档配置($w$ 为滑窗大小,$L_{QKV}$ 为剪枝后保留的历史长度):
| Config | AUC | GAUC | Attention Speedup | Offline Sparsity |
|---|---|---|---|---|
| Full Self-Attention | 0.7745 | 0.6893 | 1.0× | 5.54% |
| Sparsity-1 ($w{=}512,L_{QKV}{=}512$) | 0.7739 | 0.6873 | 3.7× | 88.04% |
| Sparsity-2 ($w{=}256,L_{QKV}{=}512$) | 0.7738 | 0.6872 | 4.0× | 89.82% |
| Sparsity-3 ($w{=}128,L_{QKV}{=}512$) | 0.7736 | 0.6870 | 4.2× | 91.02% |
| Sparsity-4 ($w{=}128,L_{QKV}{=}128$) | 0.7735 | 0.6868 | 5.1× | 92.63% |
结论:所有稀疏配置都在大幅加速的同时保持了有竞争力的 CTR 性能。Sparsity-1 以 88.04% 稀疏度换来 3.7× 加速,AUC/GAUC 只有极小退化;从 Sparsity-1 到 Sparsity-3 滑窗不断缩小、稀疏度与加速持续上升而性能仅轻微下降,说明只看有限的局部窗口已足以捕捉大部分有用的序列依赖。LazFormer 默认采用 Sparsity-4(5.1× 加速、92.63% 稀疏),论文给的理由很务实:把省下的算力重新分配到深度、序列长度与 epoch 上,收益大于 0.10 pt 的 AUC 代价——这正是 Figure 3 的算力对齐视角的直接应用。
线上 A/B 实验(RQ6)¶
部署在某大型工业电商平台首页推荐的排序阶段,线上生产基线是一个 3 层的 SORT-like 排序模型,两周 A/B:
Table 7:Online A/B testing results
| Metrics | IPV | Orders | Buyers | GMV |
|---|---|---|---|---|
| % Improve ↑ | +5.21% | +3.38% | +3.70% | +9.85% |
尽管 LazFormer 因骨干加深(3→5 层)与更长序列带来额外在线计算,但得益于长序列压缩与混合稀疏注意力,NVIDIA A10 单机吞吐(QPS)只下降 12.1%。论文据此主张 ROI 良好。
归因复核:两个「解法」各值多少¶
把 Table 2/3/4 的交叉一致数值串成一条阶梯(CTR,最佳 baseline 取 OneTrans 0.7661 / SORT 0.6740),可以把 LazFormer† 的总优势拆开:
| 阶段 | 配置 | CTR AUC | 增量 | CTR GAUC | 增量 |
|---|---|---|---|---|---|
| 最佳 baseline | OneTrans / SORT(3层/1024,载入稀疏) | 0.7661 | — | 0.6740 | — |
| ① 架构 + 规模 + 稀疏初始化 | Sparse / Config-3(5层/2048,仅稀疏迁移) | 0.7699 | +0.38 pt | 0.6810 | +0.70 pt |
| ② 可迁移残差适配器(稠密迁移) | LazFormer(1 epoch) | 0.7735 | +0.36 pt | 0.6868 | +0.58 pt |
| ③ 非对称多轮训练(3 epoch,3× FLOPs) | LazFormer† / Config-6 | 0.7761 | +0.26 pt | 0.6891 | +0.23 pt |
| 合计 | +1.00 pt | +1.51 pt |
据此可以回答「消融退化幅度是否与总优势成比例」:
- 没有任何单个组件的移除代价超过总优势(0.38/0.36/0.26 vs 1.00),归因在这个意义上是自洽的,没有出现「去掉某组件退化幅度大于总优势」的归因矛盾。
- 但三者的分量与论文的叙事重心并不匹配。论文把两个「解法」摆在标题与摘要的核心位置,实际上它们合计只解释了总优势的约 62%(AUC)/ 53%(GAUC);剩下的 38%/46% 来自架构与规模本身(5 层/2048 对 3 层/1024),而这一部分没有做算力对齐的 baseline 对照——baseline 全部被固定在 3 层/1024,从未被放大到与 LazFormer 同规模。因此「LazFormer 的 scaling 更好」这一暗示并未被证明,被证明的只是「LazFormer 能 scaling」。
- 第三个组件(非对称多轮)的性价比最低:+0.26 pt 要付 3× 的排序算力(25G→75G),而这恰是 Figure 3 中三条轴里最弱的一条。若把同样的 3× 算力投到参数轴上,按图读数应能拿到更多。论文对 Config-4→Config-5 的 +3.44 pt 反复强调,但那是相对一个故意破坏掉的配置(naive 3-epoch,比 1-epoch 还低 3.12 pt)的差值;与务实的替代方案「就训 1 个 epoch」相比,真实增量只有 +0.26 pt。这是一处叙事上的放大。
- 反过来,论文最该强调的结果被低估了:LazFormer* 在 14G FLOPs(约为 Sparse/Config-3 的一半算力)下就做到 0.7704/0.6808,与 5 层/2048 的 sparse-only 迁移(0.7699/0.6810)打平。这才是「可迁移残差适配器」价值的最强证据——它是一个几乎免费的算力乘数,而不是靠堆算力。需要注意,这里的「适配器价值」是零初始化与瓶颈结构的合体效果,二者各自贡献多少,Table 3 分不开(见 RQ2 第 4 点)。
核心贡献总结¶
- 把「生成式预训练 → 判别式排序」的参数迁移从 sparse-only 推进到 sparse + dense,并用 Config-2/3 的对照正面驳斥了冻结稀疏参数的既有做法。
- 零初始化的可迁移残差适配器:用函数保持式初始化($\boldsymbol{W}_{up}=0$)让排序从预训练表示精确出发,再渐进吸收排序专属特征;Direct/PreProj/Sparse 三者不可区分的对照证明了「融合方式比是否迁移更重要」。但该对照同时改变了初始化与支路结构,「零初始化是起作用的机制」并未被隔离——Direct 只要把新增列置零,同样能恒等起步(见 RQ2 第 4 点)。
- 请求感知排序:由粗到细长序列压缩 + 混合稀疏注意力(滑窗 + 全局 token + 目标自隔离)+ 渐进式跨层 token 剪枝 + 请求级样本组织,四件套把算法侧与系统侧的冗余同时削掉,做到 92.63% 稀疏 / 5.1× 注意力加速。
- 非对称多轮训练:稀疏重置 + 稠密累积,把 CTR 模型从「只敢训 1 epoch」解放出来。
- 完整的算力对齐 scaling 研究与全量部署:三轴 scaling 都以 FLOPs 为横轴;线上 GMV +9.85%,吞吐仅降 12.1%。
与已归档相关工作的对比¶
MEDA MEDA: Multi-Epoch Learning for Deep CTR Prediction Models(KuaiShou,2023-05)¶
关系:显式引用但原文未展开对比(仅作为「one-epoch overfitting 现象」的引文 [9,22])· 已加载对方精读
- 共同关注的问题:完全同一个 root cause——工业 CTR 模型的极端稀疏性使 embedding 层成为最易过拟合的组件,导致模型只敢训 1 个 epoch,样本利用率极低。MEDA 把这一诊断写成了全文主张("只要在多轮训练中阻止 embedding 过拟合、同时维持 MLP 的多轮收敛,就能突破单轮上限"),而 LazFormer §3.4 的开篇论证与之逐句同构。
- 相近的技术骨架:两者的算法可以直接叠印。MEDA 的 Algorithm 1 是「每个 epoch 开始重新初始化 embedding $E$,MLP 参数 $\theta$ 跨 epoch 持续累积」;LazFormer 的式 (27) 是「每个 epoch 开始把 $\Theta^s$ 重置,$\Theta^d$ 跨 epoch 继承」。两者的参数划分、重置粒度(epoch 边界、全局、彻底)、以及"稀疏重置/稠密累积"的非对称结构完全一致。MEDA 还额外报告了一组负面探索:只冻结 embedding、或从头冻结只训 MLP,都要么不收敛要么仍过拟合,只有完全重置才有效——这正好预演了 LazFormer 的 Config-2(freeze)弱于 Config-3/5 的结果。
- 本文的差异与推进:唯一实质差异是重置的目标态——MEDA 重置到随机初始化(并把这解释为一种数据增强:每个 epoch 给 MLP 一组全新的随机编码,迫使它依赖 id 的统计本质而非 embedding 几何),LazFormer 重置到生成式预训练得到的 $\Theta^s_{init}$(解释为"保留可迁移的稀疏知识")。这是一个合理且有意义的改进,因为 LazFormer 恰好有一个预训练态可回退。
- 可比的方法/实验差异:问题在于LazFormer 没有做 reset-to-random 这一组对照。Table 4 只有 continue(Config-4)与 reset-to-pretrained(Config-5)两档,缺了 MEDA 那一档。因此「重置能保留可迁移的稀疏知识」这一归因是未被验证的——Config-5 相对 Config-4 的 +3.44 pt 完全可以由「重置本身」解释,而 MEDA 早已证明随机重置就足以打破 one-epoch 屏障(Taobao 上 DNN AUC 0.8714→0.9034、DIN 0.8804→0.9265)。LazFormer 把 MEDA 的两篇论文([9] 2407.01607、[22] 2305.19531)都只当作"现象观察"引用,未在方法层面承认这一前置工作,是本文引用处理上最实质的不足。
KGD KGD: Knowledge–Geometry Decoupling(Xiamen University × Shopee,2026-08-03)¶
关系:独立并发(本文未引用 KGD,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文针对的是同一个范式的同一个痛点——KGD 明确研究 GPSD 首次形式化的 generative-pretraining-to-discriminative-transfer 范式(GPSD 正是 LazFormer 的参考文献 [26]、其预训练数据构造方式也照搬自它),并把失败归因于「预训练目标与下游判别目标对共享参数提出互相冲突的几何要求」,用 Shopee 生产系统上的梯度余弦测量给出实证(长期在 0 附近徘徊、时而为负)。LazFormer 的"稠密负迁移"是同一现象在特征空间一侧的表述。两者还都明确否决了现有的两个极端:全量微调会覆写预训练几何,冻结则任务改不动几何——KGD 把它写成三条失败模式的枚举,LazFormer 把它写成 Config-2(freeze)与 Direct/PreProj(覆写)两组消融。
- 相近的技术骨架:两者的核心补丁在形状上高度重合——都是在预训练表示上叠加一个任务自有的低秩残差,且都对这个残差的"不得扰动预训练方向"施加了某种约束。LazFormer:$\boldsymbol{a}_j=\boldsymbol{W}_{up}\mathrm{GELU}(\boldsymbol{W}_{down}\boldsymbol{s}_j)$ 加到 token 上,靠 $\boldsymbol{W}_{up}=0$ 让残差在初始时刻为零(时间维度上的约束:起点不扰动)。KGD:$\tilde{e}_i^{(k)}=s_k\cdot\mathrm{sg}(e_i^{\mathrm{pre}})+\Delta e_i^{(k)}$,靠 $\Delta e_i^{(k)}\perp e_i^{\mathrm{pre}}$ 的正交正则让残差只写进预训练方向的正交补(空间维度上的约束:方向不冲突)。KGD 还从三条观察(温度等价 → 真实任务是形变而非缩放 → 形变不能抵消预训练几何)把这个残差形式推导了出来,而 LazFormer 是把 LoRA 直接搬过来用。
- 本文的差异与推进:(a) 所有权立场相反。KGD 用 K/V 上的 stop-gradient 建立严格单向的 read-only 接口,任务梯度永远到不了 encoder;LazFormer 恰恰主张稀疏与稠密参数都要继续被排序目标更新(Config-3 > Config-2 就是它的论据)。两条路线在同一问题上给出了相反的答案,而且各自都有实证支撑——差别在于 KGD 的设定多了一条"encoder 必须每日刷新"的约束,一旦刷新,共享参数的交替更新会互相抵消(KGD 实测:共享参数下每日刷新 0.7837 反而低于预训练一次后冻结的 0.7852)。LazFormer 是离线 25 天窗口的一次性训练,没有这条约束,所以它可以选择"继续更新"。(b) LazFormer 多出的部分是稀疏侧的时间节律设计(非对称多轮)与请求级系统优化,KGD 完全没有涉及。(c) KGD 多出的部分是预训练目标本身的去噪(BMTP,只监督协同/语义相似度超阈的后续 item),而 LazFormer 的预训练仍是朴素的 next-item + in-batch 负采样,未处理"相邻不蕴含依赖"的噪声问题。
- 可比的方法/实验差异:KGD 在 8 个公开 Amazon-2023 基准 + 90 天 Shopee 生产流上做了系统枚举(8 种迁移模式 × 3 种预训练目标 × 3 种调度),并有全量 A/B(GMV/user +1.75%);LazFormer 只有单一工业数据集与两周 A/B,无任何公开基准。就"迁移范式"这一共同命题而言,KGD 的实验强度明显更高。反过来,LazFormer 的 Table 3 提供了一个 KGD 没有的对照:Direct/PreProj/Sparse 三者不可区分,说明"融合方式"而非"是否迁移"才是决定因素——这一点对 KGD 的正交约束论证是独立的佐证。
LP-FFT-RFT Progressive Alignment of Recommender Foundation Model(NAVER WEBTOON,2026-08-07)¶
关系:独立并发(本文未引用,两者对同一失败模式给出不同形态的解法)· 已加载对方精读
- 共同关注的问题:NAVER 的"缺口一"与 LazFormer 的"稠密负迁移"是同一句话的两种写法——把庞大的预训练 backbone 与随机初始化的下游模块放在一起一次性全参微调,随机模块产生的高方差梯度会在下游组件学到任何有意义的表征之前就破坏 backbone。LazFormer 的 PreProj 消融正是这一失败模式的直接实测:一个额外的随机初始化预投影层仍会扰动喂给预训练稠密骨干的输入,结果 0.7699,与完全不迁稠密的 Sparse 一模一样。
- 相近的技术骨架:两者的补丁在功能上等价——都是让"新引入的随机参数在初期不要影响预训练骨干"。NAVER 用调度实现:Phase 1 Linear Probing 冻结 backbone、只训下游头,让随机初始化的组件先在稳定的优化 landscape 里对齐到预训练表示空间;Phase 2 FFT 解冻并给 backbone 小一个数量级的判别式学习率。LazFormer 用架构实现:$\boldsymbol{W}_{up}=0$ 让新分支在第 0 步就是恒等映射,之后连续地、由梯度自行决定的速度"解冻"。LazFormer 的方案严格更优雅:它不需要划分阶段、不需要额外超参(LP 轮数、backbone 学习率倍率),且"解冻速度"是学出来的而非拍的。
- 本文的差异与推进:(a) NAVER 的整篇重心其实在第三阶段(RFT/GRPO 的业务对齐),LP→FFT 只是前置的知识适配;LazFormer 则把这一段做成了核心贡献。(b) NAVER 明确引用了 Kumar et al. (2022) 的 LP-then-FT 经验结论作为依据,而 LazFormer 完全没有接触这条"预训练表征在全参微调下被扭曲"的既有文献,导致它把一个跨领域已知的问题当作推荐场景的新发现来论述。(c) 规模差距悬殊:NAVER 的 FM 只有 ~7M 参数(其精读已指出"灾难性遗忘"叙事在此规模上是否主导存疑),LazFormer 的稠密骨干 9–55M、嵌入约 5B,所以 LazFormer 这一侧的证据更扎实。
- 可比的方法/实验差异:NAVER 的量化结果与 LazFormer 方向一致但幅度更小——1-phase FFT 0.429、1-phase LP 0.426,两阶段 LP→FFT 0.434,加判别式学习率 0.437(Rank NDCG);LazFormer 的对应量级是 Direct 0.7701 → 残差适配器 0.7735(+0.36 pt,在其 0.1 pt 显著阈下是 3.6 倍显著幅度)。两篇都缺同一组关键对照:没有把"调度式解冻"与"零初始化残差"这两种补丁放在同一实验里比过。
讨论与局限性¶
值得借鉴的设计。
- 零初始化残差 = 函数保持式初始化,是把任何新增输入/新增模块接到预训练骨干上的通用安全做法。Direct/PreProj 两组对照确实量化了「融合方式错了,会损失全部稠密迁移收益」,但没能把修复归因到零初始化本身:Direct 把新增列置零同样恒等起步,而它与 LazFormer 的差别还包括线性映射 vs. 非线性瓶颈(见 RQ2 第 4 点)。因此这份工程配方可以放心沿用,但「为什么有效」尚未确定;若打算把适配器精简为一次零初始化的线性列,应先补上「Direct + 零初始化」这一对照。
- 把"排序专属特征"当作残差而非序列扩展。加购、下单等多行为信号传统上要么拉长序列、要么另起一路子网络;这里用一个 bottleneck 残差注入,几乎零算力代价,同时避开了长序列自注意力的二次开销。代价是覆盖盲区:只有已在点击序列中的 item 才能携带这些信号(见局限第 9 点)。
- "省下的算力要再投出去"的显式论证。选 Sparsity-4 而非 Sparsity-1 的理由不是"稀疏度更高更好看",而是"把 5.1× 的注意力加速换成深度/长度/epoch 的收益大于 0.10 pt 的 AUC 代价",并且用 Figure 3 的算力对齐曲线来支撑这个判断。这种把局部效率决策放回全局算力预算里权衡的习惯,在工业论文里并不常见。
局限与争议。
- 第二个「解法」的前置工作未被承认。非对称多轮训练与 MEDA(2305.19531)的算法结构完全一致,而 MEDA 被本文引用了两次却只作为"现象观察"。更关键的是缺少 reset-to-random 对照,使得"重置到预训练态"相对"重置到随机"的增量完全未知,「保留可迁移稀疏知识」这一机制解释因此悬空。
- scaling 的比较只对齐了 LazFormer 自己。Figure 3 是算力对齐的(横轴 FLOPs),这一点值得肯定;但所有 baseline 都被钉死在 3 层/1024,从未沿任何一条轴放大过。因此论文能支持的结论是"LazFormer 可 scaling",不能支持"LazFormer 比 HSTU/OneTrans 更可 scaling"——而后者恰恰是标题里 "Scaling Transformers" 所暗示的。此外 Figure 3 的横轴刻度非均匀(0/25/50/75/150/225),Medium→Large 用 4.4× 算力只换 +0.13 pt 的强饱和在视觉上被拉直了。
- 动机中的"节省算力、加速收敛"从未被测量。全文 FLOPs 只统计排序阶段(脚注明确说明),预训练的 11B token 开销不在表内;而"收敛更快"这一主张没有任何收敛曲线、训练步数或 wall-clock 对比来支撑。唯一的从零训练对照 Config-1 只给了终点 AUC。
- 消融表缺少方差。Table 2 注明"三次运行平均",Table 3/4 未注明。而 Table 3 中 Sparse/Direct/PreProj 三者相差 0.02–0.07 pt,低于论文自己声明的 0.1 pt 显著门槛——这一点并不损害"三者不可区分"的核心论断(恰恰是它的证据),但对 NoFeat 的 CTR GAUC 0.6843 是否真的"相对较强"就无法判断了。
- 线上 GMV 与订单数的背离未被讨论。Orders +3.38%、Buyers +3.70%,而 GMV +9.85%,隐含客单价上升约 6.3%。对一个 CTR/CVR 排序模型改动而言这是异常大的价格结构位移,通常需要单独解释(候选价格分布变化、类目结构变化);论文一字未提。同时缺少流量比例、置信区间与显著性检验。
- 完全无公开数据集,无代码,平台匿名为"某大型工业电商平台"(从单位可推断为 AIDC 旗下电商)。外部不可复现,也无法进入任何公开 benchmark 对照。
- 同期替代路线的对照缺位。ReST(2609.01240,与本文同月)同样识别出"一份历史对 N 个候选"的算力不对称并给出编码器/cross-decoder 的非对称分解,但完全不靠预训练迁移;Coupang 的 scaling 实践研究(2605.29232)则实测 backbone/embedding/data 三轴收益"largely 独立可加",与本文 Figure 3 的三轴结论可互相印证但结论口径不同。这些同期工作都未被讨论。
- 适配器的起效机制未被隔离。Table 3 中 Direct 与 LazFormer 之间同时变动了初始化(随机 vs. 零)与支路结构(线性映射 vs. GELU 瓶颈 MLP),论文却把差距完全归因于前者。零输出起点并非 LazFormer 独有——Direct 把新增列置零即可恒等起步(式 30)。缺少「Direct + 零初始化」这一对照臂,「零初始化是关键」与「非线性瓶颈是关键」无法区分;论文也未说明 Direct 新增列的初始化方式。
- 多行为叠加的覆盖盲区未被讨论(本文观察)。排序专属特征只能叠加在已存在的点击 token 上,被加购或下单却无保留点击的 item 完全不进入模型。论文没有量化这部分覆盖损失;在「从推荐位直接加购」较常见的电商场景中,这会限制该设计的上限。另外 Figure 1 把适配器画得横跨目标物品,与正文「目标 token 只用共享层构造」的表述不一致,论文未作澄清。
工业落地价值。 部署细节完整:H100 训练 + A10 推理、25 天训练窗口、$L_s=1024$/$g=8$/$W=G_i=N_{\min}=128$/$\tau=0.07$/16,000 负样本等超参齐备,flex attention 落地块稀疏 kernel,吞吐代价(-12.1% QPS)与业务收益(GMV +9.85%)都给了。对同样在做"判别式排序 Transformer + 预训练初始化"的团队,第 2 节的残差适配器与第 3 节的请求级组织可以直接照抄(适配器原样照抄无妨;若想简化成零初始化的线性列,先补「Direct + 零初始化」对照);第 4 节的非对称多轮训练建议先补上 reset-to-random 对照再决定是否值得那 3× 算力。