Progressive Alignment of Recommender Foundation Model through Multi-Phase Post-Training 精读¶
NAVER WEBTOON(韩国)· RecSys '26 · arXiv 2608.06792 · 开源实现 https://github.com/webtoon/rec-fm-progressive-alignment
1 研究动机与背景¶
1.1 推荐基础模型「一次预训练、多面适配」范式下的两个缺口¶
推荐基础模型(Foundation Model, FM)通过大规模自回归预训练建模长周期用户行为,已经从「任务专用排序器」演化为「通用行为先验」。工业界的标准做法是:一个预训练 FM 通过 SFT 适配到多个差异很大的 serving surface(首页、发现页、推送等),每个 surface 各有自己的任务目标。论文开篇指出这条流水线上有两个被忽视的结构性缺口。
缺口一:单步 SFT 会摧毁预训练表征。 把庞大的 FM backbone 和随机初始化的下游任务模块放在一起一次性全参微调,随机初始化模块产生的高方差梯度会在下游组件学到任何有意义的表征之前就把 backbone 破坏掉,即灾难性遗忘(catastrophic forgetting)。所以需要一个结构化的适配过程,在注入任务知识的同时保住预训练的行为表征。
缺口二:任务目标 ≠ 业务指标。 SFT 优化的是点击、点赞这类任务级目标,但真正决定推荐质量的是长期留存、付费转化这类业务指标,两者并不重合。
1.2 为什么不能直接对业务指标做监督¶
一个直觉的做法是直接把业务指标(长期留存、付费转化)当作监督目标。论文明确反对,理由是监督密度与排序判别力之间的矛盾:
- 业务标签天然稀疏且延迟,在整个候选空间上泛化能力有限;直接拿它训 serving policy,学到的分数「捕捉到了效用的方向,却不具备大规模排序所需的判别力(discrimination)」。
- 稠密隐式反馈(点击、停留时长)在候选物品上提供了远为丰富的监督,因此训出的策略排序能力更强。
由此得到本文的核心设计决策,也是全文的中心论点——角色分离:用稠密隐式反馈训 serving policy,用业务指标监督训 reward model,后者只作为对齐信号(alignment signal),而不是直接作为线上打分策略。
这两个缺口分别对应两个阶段:知识适配阶段(LP → FFT)解决第一个,业务对齐阶段(RFT)解决第二个。
2 相关工作¶
推荐基础模型。 从早期自回归序列推荐器(GRU4Rec、SASRec、TIGER)确立 next-item prediction 范式,到 Zhang et al. 发现序列推荐模型具备 scaling-law 行为,大型序列推荐器开始从任务专用排序器转变为通用行为基础模型(PinFM、HSTU)。随后研究重心从架构转向下游适配:与其为每个 surface 训独立模型,不如迁移预训练序列表征。工业系统把它落成 foundation–expert 框架(Meta 的 Realizing Scaling Laws in Recommender Systems),共享 FM 提供通用用户表征,轻量任务模块各自特化;LFM4Ads 进一步支持用户/物品/交互表征的多粒度迁移(feature / module / model 三级)。
后训练与对齐。 下游适配要么只训任务头(Linear Probing, LP),要么全参微调(Full Fine-Tuning, FFT)。Kumar et al. (2022) 的经验研究表明先 LP 后 FT 的顺序优化更优——先初始化下游头,再引入新数据集,可以避免一上来就扭曲骨干。但即使有这类结构化策略,标准 SFT 仍高度易受灾难性遗忘影响。与之相对,Lai et al. (2025) 发现 RFT 天然缓解遗忘:RL 的梯度更新起到了数据依赖正则化器的作用,比标准 SFT 更好地保住先验知识与表征稳定性。这条观察是本文把第三阶段设成 RFT 而非继续 SFT 的直接依据。
RFT 的具体载体上,PPO 需要参数化 reward model 加一个独立 value network;GRPO 通过组内相对打分估计 baseline,去掉了 value model;DPO 绕开显式 reward 建模,直接在成对偏好上优化。三者都通常在 RLHF 框架下实例化,用 KL 散度惩罚严格约束表征漂移。
3 模型架构¶
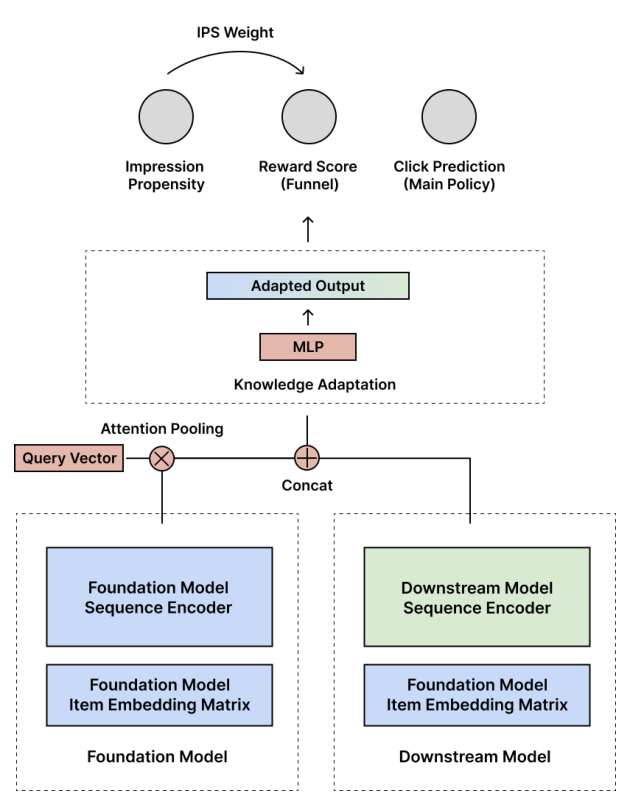
3.1 下游编码器:foundation–expert 融合¶
给定用户交互序列 $s$,预训练的 foundation 序列编码器产出一串 embedding:
$$E = \mathrm{SequenceEncoder}(s) \tag{1}$$
用一个可学习 query 向量 $q$ 做 cross-attention pooling,把变长序列压成定长表征:
$$\alpha = \mathrm{softmax}\!\left(\frac{qE^{\top}}{\sqrt{d}}\right),\qquad h_{\mathrm{fm}} = \alpha E \tag{2}$$
与此并行,下游模块从 surface 专属特征产出表征 $h_{\mathrm{ds}}$。两者拼接成最终用户表征:
$$h = [h_{\mathrm{fm}};\, h_{\mathrm{ds}}] \tag{3}$$
$h$ 再送入各任务头。这个设计的用意是给「按需接入下游专属信号」提供一个极简接口,同时保持 FM 表征作为模型的主骨干。Figure 1 显示:FM 侧与 downstream 侧各有一个 sequence encoder,但共享 FM 的 item embedding matrix;attention pooling 与 concat 之后进入一个称为 Knowledge Adaptation 的 MLP 适配层,再分出三个头——Impression Propensity、Reward Score (Funnel)、Click Prediction (Main Policy),其中 propensity 头以 IPS 权重的形式作用到 reward 头上。
3.2 奖励模型:序数回归 + 曝光倾向去偏¶
为了在没有显式人类反馈的情况下从日志里刻画业务目标,论文把 reward model 定义成「预测用户对某内容的参与深度」。Webtoon 平台上用户参与天然是一个多级漏斗,逐级代表更深的内容消费。生产环境中这个漏斗被实例化为六级:曝光 → 点击 → 首话观看 → 免费话读完 → 进入付费话 → 付费内容读完。reward 目标定义为「用户对该内容达到的最深漏斗层级」。
用序数回归(ordinal regression)建模。设 $f$ 为 user–item 对 $(u,v)$ 观测到的漏斗深度,定义 $C=5$ 个 cutpoint,构造序数目标:
$$t_{u,v,c} = \mathbb{I}(f > c),\qquad c = 1,\dots,C \tag{4}$$
reward 头对每个 cutpoint 预测 logit $\hat z_{u,v,c}$。
由于日志反馈是在历史曝光策略下观测到的,reward 学习会受曝光偏置污染。为此引入一个 impression propensity 头,估计物品对该用户的曝光概率:
$$\hat p_{u,v} = \sigma(\hat z_{\mathrm{imp},u,v}) \tag{5}$$
在此基础上先做截断逆倾向加权,再做自归一化(SNIPS)以稳定训练尺度:
$$\tilde w_{u,v} = \frac{s_{u,v}}{\sum_{(u',v')\in D_r} s_{u',v'}},\qquad \text{where}\quad s_{u,v} = \min\!\left(\frac{1}{\hat p_{u,v}},\ \tau_{\mathrm{IPS}}\right) \tag{6}$$
该权重施加到序数损失上:
$$L_{\mathrm{reward}} = \sum_{(u,v)\in D_r} \tilde w_{u,v} \sum_{c=1}^{C} \mathrm{BCE}(\hat z_{u,v,c},\, t_{u,v,c}) \tag{7}$$
推理时把序数输出聚合成一个连续 reward 分数:
$$R_{\phi}(u,v) = \sum_{c=1}^{C} \sigma(\hat z_{u,v,c}) \tag{8}$$
它作为下游对齐用的稠密效用估计。这里的设计动机很清楚:序数回归保证了 reward 的单调可比性(层级越深分数越高),截断 + 自归一化的 IPS 则在不引入方差爆炸的前提下部分抵消曝光偏置——而曝光偏置恰恰是「用生产日志训 reward model」最致命的隐患。
4 三阶段渐进后训练¶
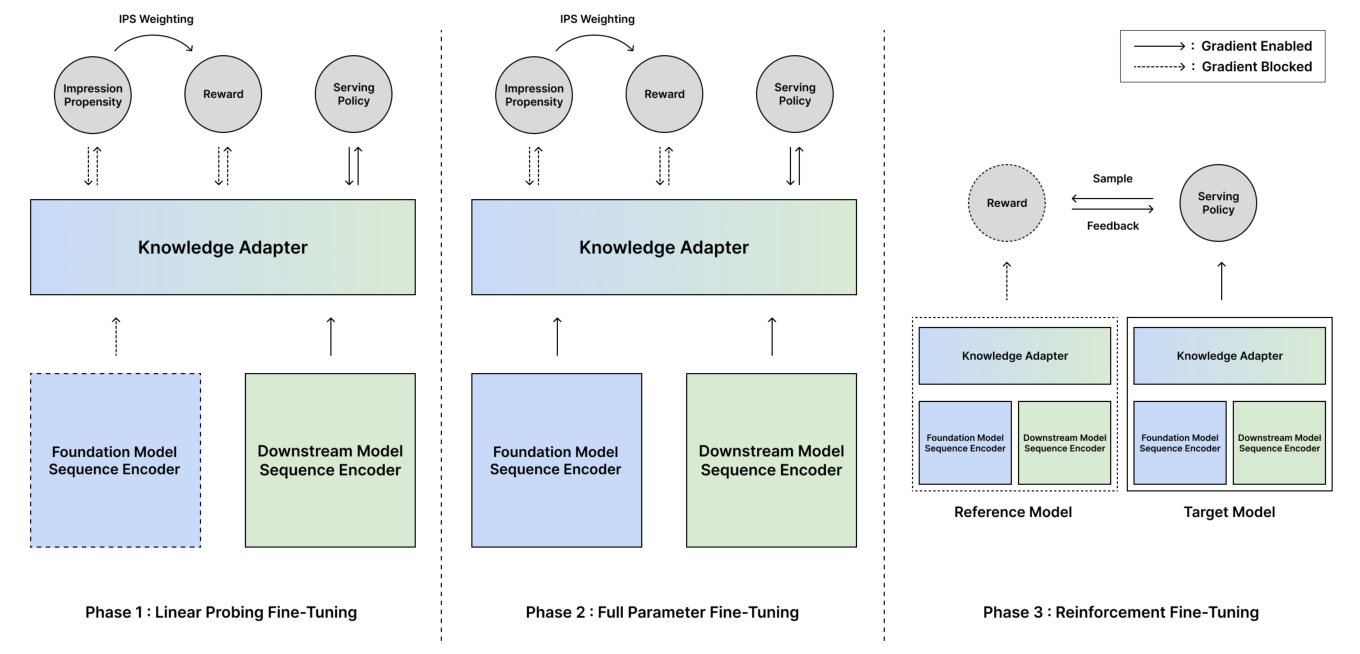
论文用 FM backbone 指预训练序列编码器,用 serving policy 指从融合用户表征产出最终排序分的策略头。
4.1 Phase 1:Linear Probing(LP)¶
FM backbone 冻结,只优化下游模块与各预测头。监督目标是三项之和:
$$L_{\mathrm{SFT}} = L_{\mathrm{policy}} + L_{\mathrm{reward}} + L_{\mathrm{propensity}} \tag{9}$$
其中 $L_{\mathrm{policy}}$ 是点击的交叉熵,$L_{\mathrm{propensity}}$ 是曝光的 BCE,$L_{\mathrm{reward}}$ 是式 (7)。这一阶段让随机初始化的下游组件在一个稳定的优化 landscape 中对齐到预训练 FM 的表征空间,从而降低高方差梯度腐蚀 backbone 的风险。注意 Figure 2 的 Phase 1 里,reward 与 propensity 头到 Knowledge Adapter 的箭头是虚线(梯度被阻断/detach),只有 serving policy 是实线双向——说明 reward/propensity 分支对共享表征不回传梯度,避免业务侧噪声污染主策略表征。
4.2 Phase 2:Full Fine-Tuning(FFT)+ 判别式学习率¶
解冻 FM backbone,让全部组件联合特化。因为下游组件已在 LP 阶段稳定下来,此时优化的条件数更好、更不容易灾难性遗忘。为进一步稳定联合训练,采用判别式学习率(discriminative learning rate):FM backbone 的学习率比下游模块小一个数量级。这允许任务专用组件快速适配,而预训练骨干更保守地协同适配。
4.3 Phase 3:Reinforcement Fine-Tuning(RFT)¶
任务预测器稳定、去偏 reward model 校准完毕后,进入策略优化。FFT 结束时的模型快照被保存为冻结的参考策略 $\pi_{\mathrm{ref}}$。这一阶段只更新 policy 头与 FM backbone,reward 与 propensity 模型保持冻结。
GRPO 形式。 对每个用户状态,从当前策略选出一组候选动作 $\{a_k\}_{k=1}^{K}$,由 reward model 给出稠密标量反馈 $R_\phi(a_k)$。由于 reward 已做曝光倾向纠正,即使对历史策略很少曝光的物品,reward 估计也保持一致性。组内归一化得到优势:
$$A_k = \frac{R_\phi(a_k) - \bar R}{\sigma_R},\quad \text{where}\ \ \bar R = \frac{1}{K}\sum_{k=1}^{K} R_\phi(a_k),\ \ \sigma_R = \mathrm{std}\,R_\phi(a_k) \tag{10}$$
相对冻结参考策略的策略比与 clip 后的代理目标为:
$$\rho_k(\theta) = \frac{\pi_\theta(a_k)}{\pi_{\mathrm{ref}}(a_k)} \tag{11}$$
$$L_k(\theta) = \min\Big(\rho_k(\theta)A_k,\ \mathrm{clip}\big(\rho_k(\theta),\,1-\epsilon,\,1+\epsilon\big)A_k\Big) \tag{12}$$
带 KL 正则的整体目标(原文 Eq. 1):
$$L(\theta) = -\mathbb{E}_k\big[L_k(\theta)\big] + \beta \cdot D_{\mathrm{KL}}\big(\pi_\theta(\cdot\mid s)\,\|\,\pi_{\mathrm{ref}}(\cdot\mid s)\big) \tag{13}$$
DPO 形式(备选)。 reward model 也可以用来构造偏好对,做无显式人工标注的直接偏好优化。对一个候选组,偏好集定义为
$$\mathcal{P} = \{(a_i,a_j)\ \mid\ R_\phi(a_i) > R_\phi(a_j)\} \tag{14}$$
每对的对数概率差为 $\Delta_k = \log\pi_\theta(a_k) - \log\pi_{\mathrm{ref}}(a_k)$,优化目标:
$$L_{\mathrm{DPO}}(\theta) = -\mathbb{E}_{(a_i,a_j)\in\mathcal{P}}\Big[\log\sigma\big(\beta(\Delta_i - \Delta_j)\big)\Big] \tag{15}$$
Figure 2 的 Phase 3 画得很清楚:Reference Model 整体虚线(梯度阻断)只做 Sample,Target Model 实线接收 Feedback;reward 分支同样虚线冻结。
4.4 算法伪代码(Algorithm 1)¶
输入: 预训练 FM E_FM, 下游数据集 D
输出: serving policy π_θ, reward model R_φ
 1  初始化下游模块 E_DS、策略头 π_θ、reward 头 R_φ、propensity 头 P_ψ
    // Phase 1: Linear Probing (LP)
 2  冻结 E_FM
 3  for each batch (u, v, y_click, y_funnel, y_imp) ∈ D:
 4      由 E_FM 与 E_DS 计算融合表征
 5      L_policy ← CE(π_θ(u,v), y_click)
 6      L_prop   ← BCE(P_ψ(u,v), y_imp)
 7      由 P_ψ(u,v) 计算 SNIPS 权重 w̃_{u,v}
 8      L_reward ← w̃_{u,v} · OrdinalBCE(R_φ(u,v), y_funnel)
 9      更新 E_DS, π_θ, R_φ, P_ψ,最小化 L_policy + L_reward + L_prop
    // Phase 2: Full Fine-Tuning (FFT)
11  解冻 E_FM
12  for each batch ... ∈ D:
14      计算 L_policy, L_reward, L_prop
15      更新全部参数,E_FM 使用更小的学习率
    // Phase 3: GRPO-based RFT
17  初始化参考策略 π_ref ← π_θ
18  冻结 R_φ 与 P_ψ
19  for each user state u:
20      用 π_θ(·|u) 贪心选出 top-K 候选集合 A_K
21      for each a_k ∈ A_K:  r_k ← R_φ(u, a_k)
24      计算归一化优势 A_k ← (r_k − r̄)/σ_r
25      计算策略比 ρ_k(θ) ← π_θ(a_k|u)/π_ref(a_k|u)
26      计算 GRPO 目标 L(θ)(式 13)
27      更新 π_θ 与 E_FM,E_FM 使用更小的学习率
值得注意的一个实现细节:第 20 行是贪心选 top-K,而不是从策略里随机采样 K 条 rollout——论文的理由是「与线上推荐设定相匹配」。
5 实验设置¶
5.1 数据与骨干¶
- 数据:韩国 Webtoon 生产平台的大规模交互日志,离线评测取最近三周窗口;随机抽 10% 用户构成测试集,从其交互中采样 session 评测。
- FM backbone:基于 HSTU encoder 的序列基础模型,约 7M 参数,作为下游适配与策略对齐的预训练序列表征骨干。
- 下游任务:内容发现(content discovery),定义为推荐用户此前未消费过的作品。为此接入 FM 输入之外的长周期特征——免费话消费、付费话消费、追更相关信号等行为统计量,由一个轻量编码器编码后与 FM 表征融合。
- 策略头:预测「曝光后是否发生点击」。
5.2 评估指标¶
论文用两个互补的排序指标。
Rank NDCG:衡量策略在全量作品目录上把「曝光后被点击的作品」排到前面的能力。对用户状态 $u$,模型在整个作品集合 $\mathcal{V}$ 上产出分数 $z_u \in \mathbb{R}^{|\mathcal{V}|}$,二值相关向量 $y \in \{0,1\}^{|\mathcal{V}|}$(session 内被点击则为 1):
$$\mathrm{RankNDCG} = \mathrm{NDCG}(z_u,\, y) \tag{16}$$
Funnel NDCG:衡量模型把已曝光作品按下游参与深度排序的能力。设 $\mathcal{S}\subset\mathcal{V}$ 为该 session 实际曝光的作品集合,对每个 $v\in\mathcal{S}$ 赋分级相关标签 $r_v\in\{0,\dots,L\}$(用户对该作品达到的最深漏斗层级):
$$\mathrm{FunnelNDCG} = \mathrm{NDCG}\big(z_u^{(\mathcal{S})},\, r\big) \tag{17}$$
两者合起来同时考察即时点击排序质量与与更深层参与的对齐程度。
5.3 训练超参¶
| 配置项 | 取值 |
|---|---|
| 1-phase baseline 训练轮数 | 100 epochs |
| 2-phase 训练轮数 | LP 50 + FFT 50(总监督预算可比) |
| 学习率(LP) | $10^{-3}$ |
| 学习率(FFT) | $10^{-4}$ |
| 学习率(FFT,带 LR control 的 FM backbone) | $10^{-5}$ |
| RFT 初始化 | 2-phase SFT checkpoint,额外训练 50 epochs |
| 学习率(RFT,policy 相关参数) | $10^{-5}$ |
| 学习率(RFT,FM backbone,带 LR control) | $10^{-6}$ |
| GRPO/DPO 候选数 | 贪心取 top-32(匹配线上推荐设定) |
| GRPO clip $\epsilon$ | 0.1 |
| GRPO KL 系数 $\beta$ | 0.001 |
| 漏斗 cutpoint 数 $C$ | 5(六级漏斗) |
6 主要实验结果¶
6.1 Table 1:离线消融全表¶
Table 1: Offline ablation study. Rank NDCG 对应全目录点击排序,Funnel NDCG 对应按多级参与深度排序已曝光作品。
| Model Configuration | Rank NDCG | Funnel NDCG |
|---|---|---|
| SFT for Stable Downstream Adaptation | ||
| 1-Phase SFT (Only FFT) | 0.429 | 0.620 |
| 1-Phase SFT (Only LP) | 0.426 | 0.620 |
| 2-Phase SFT (LP → FFT w/o LR Control) | 0.434 | 0.622 |
| 2-Phase SFT (LP → FFT w LR Control) | 0.437 | 0.625 |
| Direct Reward-Based Serving Policy | ||
| Reward Model-Based Policy | 0.394 | 0.637 |
| RFT for Alignment | ||
| Baseline (2-Phase SFT, LP → FFT w/ LR Control) | 0.437 | 0.625 |
| GRPO w/ RM | 0.463 | 0.637 |
| GRPO w/o RM (Observed Funnel Preferences) | 0.441 | 0.627 |
| DPO w/ RM | 0.423 | 0.630 |
| DPO w/o RM (Observed Funnel Preferences) | 0.453 | 0.637 |
6.2 Phase 1–2:LP → FFT 的增益从哪来¶
单阶段训练(无论纯 LP 还是纯 FFT)在两个指标上都表现受限:1-phase FFT 0.429 / 0.620,1-phase LP 0.426 / 0.620,都低于两阶段变体。这说明冻结骨干的适配和直接全参优化,单独任何一个都不足以支撑该下游设定。渐进式微调(LP → FFT)把 Rank NDCG 提到 0.434、Funnel NDCG 提到 0.622——先在冻结骨干下热身下游组件,为后续全模型适配提供了更稳定的起点。
判别式学习率控制(FM backbone 用 ×0.1 学习率)再带来温和但一致的增益:0.434 → 0.437、0.622 → 0.625。作者的解释是:控制预训练骨干的更新幅度,能在保留有用预训练表征的同时仍然完成下游特化。需要注意增益幅度——两阶段相对最好单阶段只有 +1.9%(0.429→0.437),LR control 只有 +0.7%,属于「一致但很小」的量级。
6.3 直接拿 reward model 当 serving policy 会怎样¶
这是全文最关键的一条消融,因为 reward model 才是最直接瞄准业务目标的组件——它被训练来预测每个 user–item 对的参与漏斗深度。如果「业务目标监督本身就够了」,那 reward model 理应是天然的 serving 候选。
结果是:直接用 reward model 排序拿到有竞争力的 Funnel NDCG(0.637,与最好的 RFT 变体持平),但 Rank NDCG 只有 0.394,比点击训练出的 serving policy(0.437)低了 9.8%,是全表最低。这精确验证了 §1.2 的论点:reward model 把「业务导向的参与深度」刻画得不错,但不具备全目录点击排序所需的判别力。这一条数据点是整篇论文「角色分离」设计的实证基石。
6.4 Phase 3:RFT 对齐¶
从 2-phase SFT checkpoint 出发做 RFT,联合更新 policy 头与 FM backbone(reward 与 propensity 冻结),并继续沿用判别式学习率。四个变体的结论:
- GRPO w/ RM 最优(0.463 / 0.637),Rank NDCG 相对 SFT baseline +5.9%,Funnel NDCG +1.9%。它在 Funnel NDCG 上追平了直接 reward-model 策略(0.637 vs 0.637),同时 Rank NDCG 高出 17.5%(0.463 vs 0.394)——这正是论文的中心论断:业务目标 reward 作为后训练的「对齐信号」比作为直接 serving 打分更有效,reward 携带的业务效用可以被迁移进 serving policy 而不牺牲排序判别力。
- GRPO w/o RM(直接用观测到的漏斗偏好)也超过监督 baseline(0.441 / 0.627),但增益明显更小,说明学习出的 reward 比原始漏斗监督提供了更有信息量的对齐信号(稠密、平滑、已做曝光去偏)。
- DPO w/o RM 表现意外地强(0.453 / 0.637),Rank NDCG 仅次于 GRPO w/ RM。作者据此承认:当有足够信息量的分级参与标签时,显式 reward 建模并非严格必要。
- DPO w/ RM 反而最差(0.423 / 0.630),是唯一 Rank NDCG 低于 SFT baseline 的 RFT 变体。作者的解释:学习出的 reward model 更适合在 GRPO 里当连续对齐信号,而不适合当合成偏好对的来源——把标量 reward 估计转成二值偏好对会丢弃有用的相对幅度信息,并放大 reward model 噪声。
7 线上 A/B 实验¶
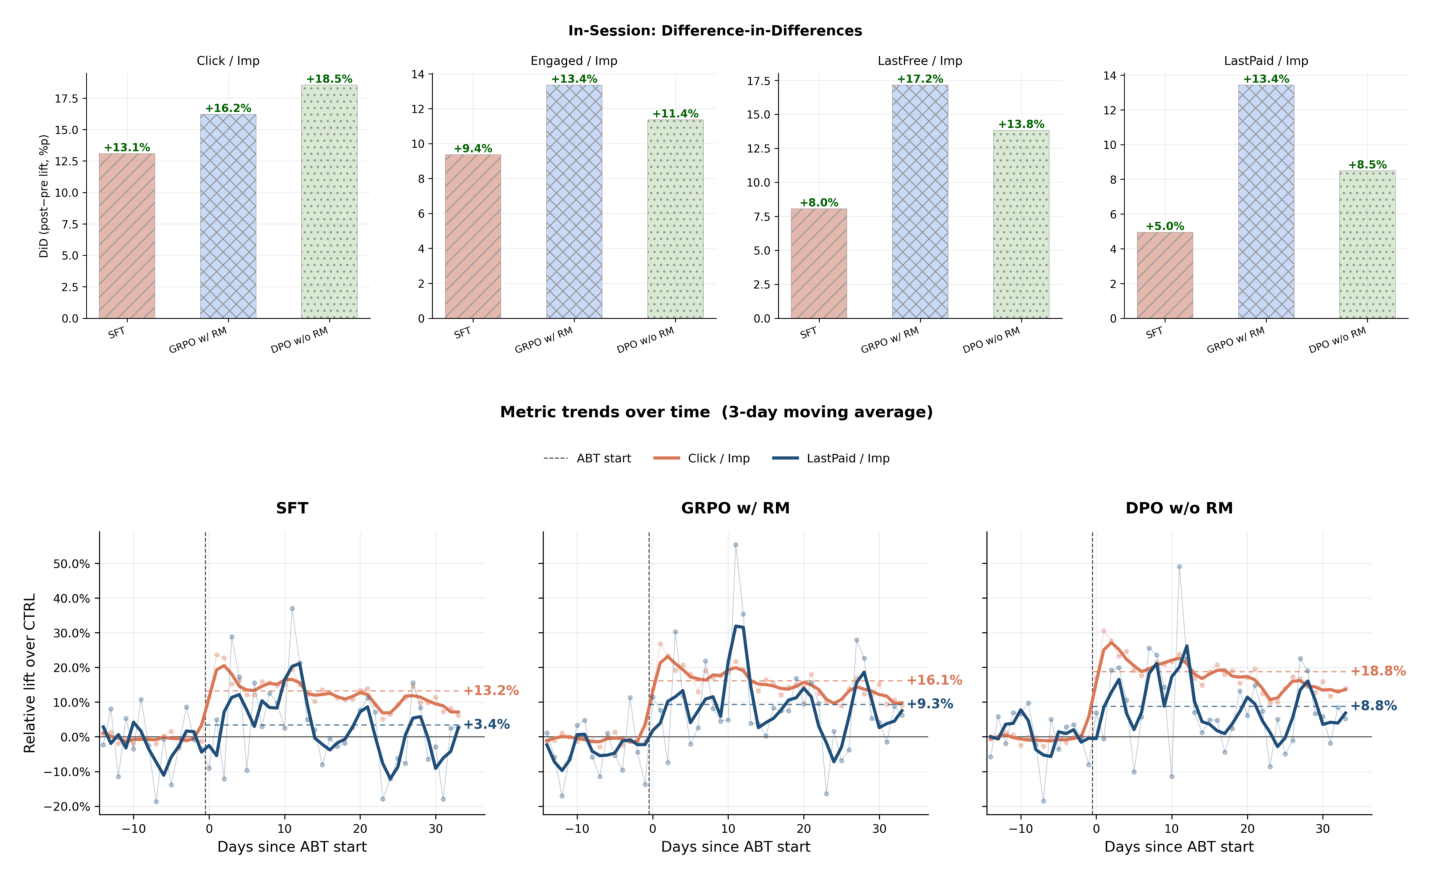
对照组设置。 四个分桶:
- CTRL:生产环境对照,不含 FM backbone,是常规多任务排序结构——分别估计 CTR 与 CVR,按二者乘积(CTCVR)排序,遵循 ESCM² 的 post-click conversion 建模标准工业形式。
- SFT:2-phase 监督 FM baseline(LP → FFT + LR control)。
- GRPO w/ RM:三阶段渐进模型 + 学习 reward model 的 GRPO 对齐。
- DPO w/o RM:三阶段渐进模型 + 观测漏斗偏好的 DPO 对齐。
指标为 in-session per-impression 指标:曝光后同 session 内的点击、engaged reading、读到最后一话免费内容、读到最后一话付费内容。
结果(difference-in-differences 估计,读自 Figure 3 上半部):
| 指标 | SFT | GRPO w/ RM | DPO w/o RM |
|---|---|---|---|
| Click / Imp | +13.1% | +16.2% | +18.5% |
| Engaged / Imp | +9.4% | +13.4% | +11.4% |
| LastFree / Imp | +8.0% | +17.2% | +13.8% |
| LastPaid / Imp | +5.0% | +13.4% | +8.5% |
一个月实验窗口内稳定后的相对提升(读自 Figure 3 下半部,3 日移动平均的收敛值):
| 变体 | Click / Imp | LastPaid / Imp |
|---|---|---|
| SFT | +13.2% | +3.4% |
| GRPO w/ RM | +16.1% | +9.3% |
| DPO w/o RM | +18.8% | +8.8% |
结论分析:
- 所有 FM 变体一致优于 CTRL,说明「预训练序列骨干 + 渐进下游适配」比现有 CTR/CVR 乘积排序框架是更强的推荐基础——光是把非 FM 生产模型换成渐进适配的 FM,在每个指标上就已有明显收益,还没用上 reward 对齐。
- 对齐变体在 SFT 之上再有增量。 GRPO w/ RM 在更深层参与指标(Engaged/Imp、LastFree/Imp)上提升更强,同时点击与付费消费也在改善——这与 reward 对齐的设计意图完全一致:把 serving policy 引向「关联更深下游消费」的作品,而不是只优化即时点击。LastPaid/Imp 上 SFT 只有 +5.0%,GRPO w/ RM 达到 +13.4%,是全表相对差距最大的一格。
- DPO w/o RM 在 Click/Imp 上拿到最大增益(+18.5%),深层漏斗指标上仍有竞争力。与 GRPO w/ RM 相比,它的提升相对更集中在即时交互,而 GRPO w/ RM 在中段漏斗推进上略强。
- 时间轨迹:所有 FM 变体在上线后立刻出现高提升,随后头几天逐步回落(在线推荐实验里的常见现象),之后稳定在更低但显著为正的水平($p<0.001$)。变体间的相对次序在整个实验窗口内保持稳定——在 LastPaid/Imp 上 GRPO w/ RM 始终最高,其次 DPO w/o RM,再次 SFT,说明reward 对齐在更深参与结果上带来的增益更持久。
作者对 GRPO w/ RM 与 DPO w/o RM 的机制差异给出解释:GRPO 直接对 reward model 的连续标量输出优化,通过基于优势的更新既利用候选的序、也利用其估计效用的相对幅度,因而更利于提升下游参与深度;DPO 作用在成对偏好上,当连续 reward 分数被转成二值偏好对时幅度信息丢失,且小而带噪的分差被迫转成硬比较,偏好信号可靠性下降。而当 DPO 直接从观测到的漏斗结果构造偏好对时,它不依赖学习出的 reward model——监督虽然更稀疏,却是来自真实用户行为的直接、相对无歧义的偏好信号,因此特别擅长锐化漏斗顶端(点击导向)的排序决策。
8 核心贡献总结¶
- 把 LLM 的「SFT → RLHF」后训练范式系统地移植到推荐基础模型,并明确拆成「知识适配」与「业务对齐」两个正交阶段,而不是混在一个 SFT 里。
- 知识适配再拆成 LP → FFT 两相,加判别式学习率控制,用一组消融证明单阶段(纯 LP 或纯 FFT)都不够。
- 角色分离的核心主张:稠密隐式反馈训 serving policy(保排序判别力),稀疏业务指标训 reward model(保业务方向),reward 只当对齐信号。用「reward model 直接当策略」这条消融(Funnel NDCG 0.637 但 Rank NDCG 只有 0.394)给出了直接证据。
- 一个可落地的去偏 reward model 配方:六级漏斗 + 序数回归 + 截断自归一化 IPS + 冻结 propensity 头。
- 大规模线上 A/B 验证(一个月窗口、DiD 估计、$p<0.001$)与开源参考实现。
9 与已归档相关工作的对比¶
Exp-RSFT Exp-RSFT: Exponential Reward Weighting for Fine-Tuning Generative Recommenders under Sparse and Noisy Feedback (Netflix Research, 2026-08-01)¶
关系:独立并发(本文未引用,两者同周出现在 arXiv 且结论直接对立)· 已加载对方精读
- 共同关注的问题:两篇都指出「用日志似然训出来的序列推荐策略(行为克隆 / 点击 SFT)并不等于用户真实效用」,都要在已 SFT 好的策略之上再做一次 reward 驱动的后训练;两篇的骨干甚至都是 HSTU;两篇也都明确点出「推荐日志的 reward 观测受未知曝光/日志策略选择偏置污染」。
- 相近的技术骨架:都是「预训练序列 FM → 监督策略 → 用一个标量 reward 做后训练对齐」的三段式;都用 KL / 参考策略约束表征漂移(本文式 13 的 $\beta D_{\mathrm{KL}}$,Exp-RSFT 的 KL 约束下闭式指数倾斜)。
- 本文的差异与推进:本文保留并信任学习出的 reward model,Exp-RSFT 彻底不用 reward model——它把 KL 约束优化解成闭式的指数倾斜 $\pi^\star \propto \pi_\beta \exp(R(\tau)/\lambda)$,直接对日志观测 reward 加权做 SFT,因此「没有可 hack 的对象」,也不需要 propensity。本文对曝光偏置的处理停在 reward 训练侧的截断 SNIPS 权重,Exp-RSFT 则论证 IPS 在生产日志策略不可得且方差极大时根本不可用。
- 可比的方法 / 实验差异(结论直接冲突):Exp-RSFT 报告在 ML-1M / ML-20M / Amazon-Books / StreamCo 上 PPO 与 DPO 因过优化学习出的 reward model 而崩塌(ML-1M NDCG@10:PPO 0.0303、DPO 0.0091 vs Exp-RSFT 0.1465),且其学习出的 RM 在 MSE/MAE 上打不过 Item-Mean 朴素基线;本文却报告 GRPO w/ RM 是全表最优(0.463 / 0.637),且线上 A/B 中 reward 对齐变体的增益最持久。两者不矛盾的可能解释在于 reward 的可观测密度:Exp-RSFT 的 reward 是评分/观看时长这类每条轨迹只有一个稀疏观测的量,而本文的 reward 是六级漏斗序数标签 + 序数回归,监督比单标量 rating 稠密得多、且强制单调结构,因而 RM 质量足以支撑 GRPO;此外本文的候选来自策略贪心 top-32(分布内、且被 KL 锚在 $\pi_{\mathrm{ref}}$ 附近),而不是自由采样,天然限制了策略跑到 RM 未校准区域的空间。本文缺失而 Exp-RSFT 具备的关键证据是「RM 质量基准」——本文从未报告 reward model 本身的预测精度,因此无法排除「GRPO 的增益部分来自 RM 与 Funnel NDCG 评测目标同源」这一自证嫌疑。
AdaGRPO AdaGRPO: Adaptive Loss Balancing for Noise-Robust GRPO in Generative Recommendation (JD.com, 2026-06-07)¶
关系:独立并发(本文未引用)· 已加载对方精读
- 共同关注的问题:两篇都在解「工业推荐里用一个在曝光偏置日志上训出来的 reward model 去 GRPO 微调一个 SFT 策略」这件事的可靠性问题,都明确把「曝光偏置 → RM 在长尾/未曝光物品上不可信」认定为 root cause,也都把「不能让 RL 破坏 SFT 已建立的判别力」当作硬约束。
- 相近的技术骨架:都是「SFT 策略 + 冻结 RM + group-relative 优势 + clip + KL/NLL 锚」的同一张流程图;本文式 (10)–(13) 与 AdaGRPO 的式 (3)(4) 逐项对应。
- 本文的差异与推进:两者在同一个 root cause 上选了正交的解法。本文在reward 训练侧动手——加一个 impression propensity 头,用截断自归一化 IPS 重加权序数损失,试图让 RM 本身在低曝光物品上就无偏;AdaGRPO 则承认 RM 无法被全局修好,转而在策略优化侧动手——用 policy 困难度 $f_1$ 与 RM 可判别性 $f_2$ 两个 rank 诊断做逐样本二值 clip,只在「策略不确定且 RM 局部可信」的样本上放行 GRPO 梯度,其余退化为纯 NLL。AdaGRPO 的分层实证(全样本上 RM 影响 $\Delta$ 近零甚至为负,HARD 子集上 $\Delta$ 达 +11.4/+30.8,再叠加可判别性条件翻倍到 +23.2/+59.9,但覆盖率只剩 12–13%)正好是本文没做的那层诊断。
- 可比的方法 / 实验差异:AdaGRPO 保留 NLL 作为静止锚($L_i = L_{\mathrm{NLL}} + \lambda\alpha_i L_{\mathrm{GRPO}}$),本文 Phase 3 则完全切换到 GRPO 目标、只靠 $\beta=0.001$ 的 KL 约束防漂移——考虑到本文 RFT 还额外更新 FM backbone(学习率 $10^{-6}$),这个锚显得比 AdaGRPO 弱。另一处工程差异:本文的候选是贪心 top-32,AdaGRPO 是采样 rollout group;贪心取候选会让组内 reward 方差偏小、式 (10) 的分母 $\sigma_R$ 偏小从而放大噪声——这正是 AdaGRPO 在 easy 样本上诊断出的「优势坍缩、残余 RM 噪声主导梯度」失败模式,而本文没有任何机制处理它。
(初筛中被剔除的近似候选:OxygenREC-v2 OxygenREC-v2 同样质疑「外部代理 reward model」,但解法是把行为信号内化进预训练 prefix + 可验证 reward 蒸馏,彻底取消 RM,且没有分阶段适配,技术骨架实质偏离;UniVA UniVA 同样做「业务价值对齐」,但价值是即时可观测的 eCPM 而非稀疏延迟漏斗,解法重心在 Commercial SID tokenizer 与 value-guided beam search;GrowthGR GrowthGR 同样把稀疏长期业务标签变成 GRPO reward,但 root cause 是新品冷启供给而非 FM 下游适配稳定性;KGD KGD 同样处理「预训练表征在下游适配中被破坏」,但 root cause 是流式日更导致的刷新失效,解法是架构层的所有权切分(stop-gradient 只读交叉注意力 + 正交残差),且完全没有对齐阶段。)
10 讨论与局限性¶
值得借鉴的设计。
- 「reward 当对齐信号而非 serving 打分」这条论断是可迁移的,而且论文给出了最干净的实证形式——同一个 reward model,直接排序 Rank NDCG 0.394,经 GRPO 蒸进策略后 0.463,而 Funnel NDCG 两者相同(0.637)。这基本上是在说:业务效用信息可以在几乎不损失的前提下迁移进一个判别力更强的策略。任何做「多目标融合 vs 端到端优化业务指标」权衡的团队都值得看这一条。
- 序数回归 + 六级漏斗作为工业 reward 的形式化,比常见的「加权多目标标量」更自然:它强制了单调结构,$R_\phi = \sum_c \sigma(\hat z_c)$ 天然是一个稠密、有界、可比的效用估计。
- 判别式学习率 + LP 热身是极低成本的工程动作(改两行学习率配置),却在两个指标上一致有效,值得作为 FM 下游适配的默认配方。
局限性与争议。
- FM 只有 ~7M 参数。这个规模比论文自己在 related work 里引用的 PinFM / LFM4Ads / HSTU 生产系统小三到四个数量级。「灾难性遗忘」「预训练表征被高方差梯度破坏」这套叙事是从大模型场景借来的,在 7M 规模上是否还是主导因素存疑;而 LP→FFT 相对最好单阶段仅 +1.9%、LR control 仅 +0.7% 的增益幅度,也与「防止灾难性遗忘」这种量级的问题描述不太匹配。
- GRPO 的实现偏离标准形式。式 (11) 的策略比分母是冻结参考策略 $\pi_{\mathrm{ref}}$ 而非 $\pi_{\theta_{\mathrm{old}}}$,加上式 (13) 又单独加了 KL 项,等于同时用两种方式约束到同一个参考点,clip 的 trust-region 语义已经不是 PPO/GRPO 原本那个含义。更关键的是候选来自贪心 top-32 而非采样,这意味着整个「RL」实际上是在一个固定的、由初始策略决定的候选集上做加权似然调整,探索几乎为零——它更接近一次 reward 加权的重排微调而非策略优化。
- 没有任何 reward model 质量的度量。全文没有报告 RM 的校准度、AUC、或对长尾物品的可靠性,而这恰恰是 Exp-RSFT 与 AdaGRPO 两篇独立工作都认定为决定成败的变量。IPS 的截断阈值 $\tau_{\mathrm{IPS}}$ 也没给具体值,propensity 头本身的估计质量同样未评估。
- 评测口径可能自证。Funnel NDCG 的分级相关标签就是 reward model 的训练目标(漏斗深度),因此「用 reward model 对齐后 Funnel NDCG 提升」有一部分是同源目标的必然结果。真正独立的证据只有 Rank NDCG 与线上 A/B。
- 离线实验单薄:只有一张表、单一数据集、无方差/显著性、无随机种子重复;「epochs」这个单位在工业级日志上的含义也没交代(三周日志跑 100 epoch 是很不寻常的设置)。没有公开学术数据集实验,因此结果不可复现比较(尽管代码开源)。
- 线上实验没有对齐离线的关键消融:线上缺少「reward model 直接当策略」这一桶,也缺少单阶段 SFT 桶,因此「渐进式适配」在线上的独立贡献未被隔离。DPO w/o RM 在 Click/Imp 上反超 GRPO w/ RM 这一现象,作者只给了推测性解释,没有进一步实验支撑。
- 方法论可扩展性:三阶段是串行解耦的——reward model 在 SFT 阶段与策略联合训练后即冻结,Phase 3 不再更新它。当目录与用户行为分布随时间漂移时,冻结的 RM 会持续给出过时的效用估计,而论文没有讨论 RM 的刷新策略。不过与「先离线压缩再在线建模」那类硬瓶颈相比,这里的解耦是训练流程层面的、可以通过周期性重跑整条流水线缓解,不构成表征能力上的天花板;参数量 scaling 时,FM 骨干与下游模块可以同步扩,路线本身没有架构级封顶。