Exponential Reward Weighting for Fine-Tuning Generative Recommenders under Sparse and Noisy Feedback 精读¶
Keertana Chidambaram(Stanford MS&E,实习于 Netflix Research)、Sanath Kumar Krishnamurthy(Meta)、Qiuling Xu、Ko-Jen Hsiao、Moumita Bhattacharya(Netflix Research)。arXiv:2608.00816v1,2026-08-01,cs.IR。后两位与第二位标注为同等贡献。
1 研究动机与背景¶
1.1 生成式推荐的后训练缺口¶
生成式推荐(generative recommender)把推荐重构成「在用户交互历史上做序列生成」,与 LLM 的 next-token prediction 同构。SASRec、HSTU、OneRec 这一谱系的模型都是用 behavior cloning(行为克隆) 训练的:直接最大化日志里下一个物品的似然。作者一开始就点出这条范式的结构性缺陷——行为克隆不加区分地模仿两类行为:
- 高价值参与(genuine enjoyment,用户真正喜欢);
- 低价值参与(accidental clicks、click-bait,误点与标题党)。
RLHF 在 LLM 上已经证明:拿真实用户反馈做后训练,能突破单纯行为克隆的上限。推荐场景看起来是 RLHF 的天然温床——评分、评论、观看时长、复访这些有机反馈(organic feedback) 规模巨大,而这恰恰就是区分高价值与低价值参与所需的信号。
1.2 把 RLHF 搬到推荐上的四个独特障碍¶
论文列了四条,每一条都直指标准 RLHF 流水线在推荐里失效的具体环节:
- 用户交互稀疏(Sparse user interactions)。大目录下用户只碰到极小一部分物品,而且物品表征纯粹从用户行为里学出来、没有语义接地(no semantic grounding)。在这么稀疏的数据上拟合的 reward model 必须在巨大物品空间上做外推,泛化极差。后训练时策略会去利用(exploit) 这些预测误差——即 reward hacking,系统性地挑选那些「reward model 不可靠」的物品,而不是用户真正偏好的物品。
- 奖励带噪(Noisy rewards)。即使被观测到的 reward 也只是偏好的不完美度量:同一物品在不同 session 的评分会变、点击受 position bias 影响、隐式信号会因与偏好无关的原因波动。任何直接在日志 reward 上优化的方法都必须防止过拟合到这些噪声。
- 无法在线探索(No online exploration)。工业数据集是预先收集的静态数据,策略无法在训练中途向用户索要新反馈。标准 RLHF 用「训一个 reward model 当模拟器」绕开这一点,但在推荐设定下这个模拟器继承了上面的泛化失败,等于把问题原样搬回来。
- 日志策略未知(Unknown logging policy)。reward 只在「线上策略曾经展示过的物品」上被观测到,天然带选择偏置。原则上 IPS(Inverse Propensity Scoring)可以按展示概率重加权来纠偏,但生产日志策略要么太复杂(Covington et al. 2016)要么不可访问(Liang & Vlassis 2022),无法估计倾向性;而且 IPS 权重方差极大,日志策略接近确定性时尤甚。
1.3 本文的选择:Exp-RSFT¶
为同时绕开这四条,作者采用 Exponential Reward-Weighted SFT(Exp-RSFT):把每条日志轨迹 $\tau$ 用 $\exp(R(\tau)/\lambda)$ 加权,其中 $R(\tau)$ 是该轨迹被观测到的累计 reward,$\lambda>0$ 是温度。这个设计有三条直接的性质:
- 永不查询学习出来的 reward model,因此不可能 reward hack;
- 不需要倾向性分数(propensity scores),因此不受未知日志策略之苦;
- 完全离线,不需要在线探索。
论文非常坦率地承认:算法本身早已为人所知(RWR,Peters & Schaal 2007;MARWIL,Wang et al. 2018;LPI,Liang & Vlassis 2022)。本文的贡献是给出「它在这个 regime 下何时、为何有效」的理论刻画,并用实验证实理论预测。三条贡献:
- 理论上的次优性分解:证明 Exp-RSFT 学到的策略能与任意想要模仿的对照策略(comparator policy)竞争(含最优策略),且相对最优策略的次优性裂成两个可解释的项——coverage cost(覆盖代价),只随「最优轨迹在日志策略下概率的倒数」对数增长;noise cost(噪声代价),只随目录规模对数增长。分析是轨迹级(trajectory-level) 的,不需要 reward model 也不需要 value function,并把 contextual bandit 作为 $T=1$ 的特例回收。
- 温度作为权衡参数:两项代价随 $\lambda$ 反向移动——覆盖偏好小温度,噪声鲁棒性偏好大温度。两者之和在一个闭式 $\lambda^\star$ 处最小,因此理论预测性能随 $\lambda$ 变化呈倒 U 形。
- 验证理论的实验:三个公开基准 + 一个大规模私有数据集上,温度扫描确实描出了预测的倒 U 曲线;Exp-RSFT 优于 behavior cloning、线性 reward 加权(RSFT)、PPO 与 DPO。相对 RSFT 的增益把「温度」隔离为起作用的关键成分。与理论所针对的 regime 一致:学到的 reward model 在本文设定下打不过 naive baseline,而 PPO 与 DPO 因过优化它而崩溃。
2 相关工作¶
生成式推荐的后训练。 标准方法是 RLHF、GRPO、DPO。RLHF 与 GRPO 都从当前策略采样输出、再用 reward model / verifier / 模拟器打分;但推荐里没有 ground-truth 正确性可验证,也没有活的用户响应模拟器,所以打分必须来自一个「从稀疏观测出发在巨大目录上外推」的学习型 reward model,这直接招来 §5 中记录的 reward hacking。DPO 绕开了 reward model 训练,但需要 (preferred, dispreferred) 对,而评分、观看时长这类标量反馈并不提供偏好对;用 reward model 给候选排序来构造偏好对,等于把同一个问题重新引入。
除了 reward 建模的问题,日志数据只包含日志策略选择展示过的物品的反馈。经典离线策略学习用 IPS 或保守 value function(CQL)来纠正,但生产日志策略下倾向性不可得,value function 又要在目录上泛化。行为克隆什么都不需要,但无法超越日志策略。于是「直接在日志 reward 上优化、同时保持贴近日志策略」的方法成为这个 regime 的自然候选。
指数 reward 加权。 本文分析的算法有一长串前身:RWR、MARWIL、IQL、CRR、LPI,都用回报或优势的单调(通常是指数)函数去加权对数似然。IQL、CRR、MARWIL 从学习出的 value function 构造 advantage;RWR 直接按回报加权,本文与之相同,彻底避开 value function 估计。相对 Mukherjee et al. (2025) 的线性 reward 加权,指数形式增加了温度 $\lambda$ 这个显式鲁棒性旋钮,并且避免了线性方案在基于似然的目标里的负权重病态(Steck 2010;Schnabel et al. 2016)。已有的该家族分析处理的是优化稳定性、收敛性、value function 估计中的分布漂移,没有任何一篇刻画 reward 噪声下的行为,或量化大动作空间下有限覆盖的代价。提供这一刻画正是 §4 的贡献。
LLM 后训练中的 reward 加权。 RLOO 每个 prompt 采多条输出、按 group-relative reward 加权;ALoL 需要倾向性分数与学习出的 value function。两者都无法迁移到本文设定——新反馈无法采样、倾向性未知。
3 背景与方法¶
3.1 问题设定¶
用户交互历史作为初始上下文 $s_1\sim d_0$。从 $s_1$ 出发,策略生成一条长度 $T$ 的推荐轨迹:第 $t$ 步在当前状态 $s_t$ 下选择物品 $a_t\in\mathcal{A}$,状态确定性地追加所选物品更新,$s_{t+1}=(s_t,a_t)$。策略 $\pi$ 因此在轨迹 $\tau=(s_1,a_1,\dots,s_T,a_T)$ 上诱导一个分布,乘积形式与求和形式等价:
$$\pi(\tau\mid s_1)=\prod_{t=1}^{T}\pi(a_t\mid s_t),\qquad \log\pi(\tau\mid s_1)=\sum_{t=1}^{T}\log\pi(a_t\mid s_t). \tag{1}$$
每条轨迹得到一个标量 reward $R(\tau)$,概括用户在这次推荐 session 里的反馈。作者刻意把 $R$ 当作轨迹的任意泛函:它可以由每步观测到的反馈算出,可以是轨迹中途收集的中间反馈,可以是终局的 session 级反馈,也可以是任何别的评估指标。分析唯一要求的是「反馈能被表示成与每条轨迹绑定的标量 reward」。假设有一个在未知日志(行为)策略 $\pi_\beta$ 下收集的离线数据集 $\mathcal{D}=\{\tau_i\}_{i=1}^n$,含观测 reward。策略从上下文 $s$ 出发的价值为
$$V^\pi(s)=\mathbb{E}_{\tau\sim\pi(\cdot\mid s)}[R(\tau)]. \tag{2}$$
Contextual bandit 是 $T=1$ 的特例:$\tau=(s,a)$,$R(\tau)=r(s,a)$。
3.2 从 KL 约束优化到指数加权 SFT¶
沿用 AWAC(Nair et al. 2020),寻找一个在保持贴近数据生成分布的前提下最大化期望 reward 的策略:
$$\max_{\pi}\ \mathbb{E}_{s\sim d_0,\ \tau\sim\pi(\cdot\mid s)}[R(\tau)]\quad \text{s.t.}\quad \mathbb{E}_{s\sim d_0}\big[D_{\mathrm{KL}}(\pi(\cdot\mid s)\,\|\,\pi_\beta(\cdot\mid s))\big]\le\varepsilon, \tag{3}$$
优化在轨迹上的分布这一层进行。用乘子 $\lambda$ 写拉格朗日量并令泛函导数为零,得到闭式解
$$\pi^*(\tau\mid s)=\frac{1}{Z(s)}\,\pi_\beta(\tau\mid s)\exp\!\Big(\frac{R(\tau)}{\lambda}\Big),\qquad Z(s)=\sum_{\tau'}\pi_\beta(\tau'\mid s)\exp\!\Big(\frac{R(\tau')}{\lambda}\Big), \tag{4}$$
其中求和遍历从初始状态 $s$ 出发的所有轨迹。式 (4) 可以读成把行为策略朝高 reward 轨迹做一次指数倾斜(exponential tilt)。
这里有一个对工程落地至关重要的观察:生成式推荐器本身就在轨迹上定义自回归分布,因此倾斜后的分布 $\pi^*$ 仍然落在同一个自回归策略类里——不需要换模型结构。为得到参数化策略 $\pi_\theta$,把 $\pi^*$ 投影到策略类上,即最小化 $D_{\mathrm{KL}}(\pi^*\|\pi_\theta)$。用密度比 $\pi^*/\pi_\beta$ 把期望改写到 $\pi_\beta$ 下,并像 AWAC 那样丢掉配分函数,得到加权极大似然目标:
$$\theta^*=\arg\max_{\theta}\ \mathbb{E}_{\tau\sim\mathcal{D}}\left[\exp\!\Big(\frac{R(\tau)}{\lambda}\Big)\sum_{t=1}^{T}\log\pi_\theta(a_t\mid s_t)\right], \tag{5}$$
内层求和就是式 (1) 的轨迹对数似然。这就是 Algorithm 1:一次标准的监督微调,只是每条日志轨迹被自己「取指数、按温度缩放后的 reward」加权。 它不需要 reward model、不需要倾向性分数、不需要知道 $\pi_\beta$;唯一的超参 $\lambda$ 控制正则强度。
Algorithm 1(Exp-RSFT)
输入: 离线数据集 D = {τ_i}_{i=1}^n 及其 reward R(τ_i); 初始策略 π_θ; 温度 λ > 0; 轮数 E
for e = 1, ..., E do
    for 每个 mini-batch B ⊂ D do
        L(θ) ← -(1/|B|) * Σ_{τ∈B} exp(R(τ)/λ) * Σ_{t=1}^{T} log π_θ(a_t | s_t)
        更新: θ ← θ - η ∇_θ L(θ)
    end for
end for
输出: 微调后的策略 π_θ
值得强调这个目标的极简性:相对普通 SFT 只多了一个逐样本标量权重,梯度形状不变,因此工业训练栈几乎零改造成本。
4 理论分析¶
作者从三个视角分析指数 reward 加权:相对行为策略的改进、对带噪用户反馈的鲁棒性、reward 优化与离线数据覆盖之间的权衡。全程固定一个上下文 $s$,记 $\mathcal{T}$ 为从 $s$ 可达的轨迹集合,$|\mathcal{T}|\le|\mathcal{A}|^T$。
4.1 热身:无噪时的单调改进¶
先看理想情形——数据集给出真实 reward $R^*$。沿用 MARWIL(Wang et al. 2018)的策略改进论证,reward 加权策略 $\pi^*_\lambda(\tau\mid s)\propto\pi_\beta(\tau\mid s)\exp(R^*(\tau)/\lambda)$ 满足 $V^{\pi^*_\lambda}(s)\ge V^{\pi_\beta}(s)$。也就是说,在没有 reward 噪声时,指数加权通过把概率质量搬向更高 reward 的轨迹,一定不劣于行为策略。
但现实中用户反馈是带噪的:点击受呈现效应影响、评分随用户语境变化、参与信号含有与偏好无关的随机变动。因此作者转入更现实的设定——观测 reward 是底层 reward 的带噪估计。
Assumption 4.1(Sub-Gaussian Reward Noise):观测 reward 满足 $\hat R(\tau)=R^*(\tau)+\xi(\tau)$,其中 $R^*$ 是期望 reward,$\xi(\tau)$ 对每条轨迹 $\tau$ 都是零均值 $\sigma$-sub-Gaussian 随机变量。
这条假设覆盖了推荐系统里常见的反馈信号:有界反馈(点击、评分)通过 Hoeffding 引理满足;近似高斯变动的连续反馈同样被覆盖。关键的是,假设只加在最终的轨迹级 reward 上——中间 reward 之间可以任意相关,只要它们的聚合产生一个 sub-Gaussian 的轨迹级误差即可。这一点让理论对「session 内多步反馈高度相关」的真实推荐场景保持适用。
记 $\pi_\lambda(\tau\mid s)\propto\pi_\beta(\tau\mid s)\exp(\hat R(\tau)/\lambda)$ 为从带噪 reward 得到的策略。作者不只把 $\pi_\lambda$ 与 $\pi_\beta$ 比,而是与任意对照策略 $\tilde\pi$ 比,这样学到的策略可以对任何目标策略(包括最优策略)做评估,同时显式计入「那个目标离线数据分布有多远」。
4.2 Theorem 4.2:带噪 reward 下的策略改进¶
Theorem 4.2:固定上下文 $s$。在 Assumption 4.1 下,以至少 $1-\delta$ 的概率,对每一个对照策略 $\tilde\pi$:
$$V^{\pi_\lambda}(s)\ \ge\ V^{\tilde\pi}(s)-\lambda\,D_{\mathrm{KL}}\big(\tilde\pi(\cdot\mid s)\,\|\,\pi_\beta(\cdot\mid s)\big)-2\epsilon,\qquad \epsilon:=\sigma\sqrt{2\log(2|\mathcal{T}|/\delta)}. \tag{6}$$
定理把性能差拆成两个可解释项:
- 第一项 $\lambda D_{\mathrm{KL}}(\tilde\pi\|\pi_\beta)$ 是 coverage cost(覆盖代价):离线学习无法可靠地模仿那些「把概率质量放在日志数据之外」的策略;
- 第二项 $2\epsilon$ 是随机用户反馈诱导的 noise cost(噪声代价)。由于 $\log|\mathcal{T}|\le T\log|\mathcal{A}|$,噪声惩罚的量级是 $O(\sigma\sqrt{T\log|\mathcal{A}|})$,只随目录规模对数增长——这是在百万级目录下仍然可用的关键。
证明骨架(附录 A.1)分四步:
- 噪声事件:每个 $\xi(\tau)$ 是 $\sigma$-sub-Gaussian,标准尾界配上对 $|\mathcal{T}|$ 条轨迹的 union bound 给出,以至少 $1-\delta$ 概率 $|\xi(\tau)|\le\epsilon,\ \forall\tau\in\mathcal{T}$。注意这里不需要轨迹间独立性——union bound 只用到每个 $\xi(\tau)$ 的边缘尾部。
- 变分恒等式:定义 $F(\pi)=\sum_\tau\pi(\tau\mid s)\hat R(\tau)-\lambda D_{\mathrm{KL}}(\pi\|\pi_\beta)$,则
$$F(\pi)=\lambda\log Z-\lambda D_{\mathrm{KL}}(\pi\,\|\,\pi_\lambda). \tag{14}$$
由于 KL 非负且当且仅当 $\pi=\pi_\lambda$ 时为零,倾斜策略 $\pi_\lambda$ 是 $F$ 的唯一最大值点,特别地 $F(\pi_\lambda)\ge F(\tilde\pi)$。
- 对照不等式:展开 $F(\pi_\lambda)\ge F(\tilde\pi)$ 并在左边丢掉非负项 $\lambda D_{\mathrm{KL}}(\pi_\lambda\|\pi_\beta)\ge0$,得 $\sum_\tau\pi_\lambda\hat R\ \ge\ \sum_\tau\tilde\pi\hat R-\lambda D_{\mathrm{KL}}(\tilde\pi\|\pi_\beta)$。
- 噪声换算:在事件 (A1) 上,$V^{\pi_\lambda}(s)\ge\sum_\tau\pi_\lambda\hat R-\epsilon$ 且 $\sum_\tau\tilde\pi\hat R\ge V^{\tilde\pi}(s)-\epsilon$,串起来即得。
若 $D_{\mathrm{KL}}(\tilde\pi\|\pi_\beta)=\infty$ 则界平凡成立,所以全程假定它有限——等价于 $\tilde\pi(\cdot|s)$ 的支撑落在 $\pi_\beta(\cdot|s)$ 的支撑内。§4.1 的无噪单调改进就是 $\sigma=0$(故 $\epsilon=0$)并取 $\tilde\pi=\pi_\beta$ 的特例。
4.3 Theorem 4.3:温度如何显式控制噪声–覆盖权衡¶
Theorem 4.2 里 $\lambda$ 只是个正则参数。当 reward 有界时,可以刻画 $\lambda$ 如何显式控制这个权衡。
Theorem 4.3:设 $R^*(\tau)\in[0,R_{\max}]$。在 Theorem 4.2 的条件下,以至少 $1-\delta$ 概率,对每个对照策略 $\tilde\pi$:
$$V^{\pi_\lambda}(s)\ \ge\ V^{\tilde\pi}(s)-\lambda\,D_{\mathrm{KL}}\big(\tilde\pi(\cdot\mid s)\,\|\,\pi_\beta(\cdot\mid s)\big)-R_{\max}\big(e^{2\epsilon/\lambda}-1\big). \tag{7}$$
当 $\lambda\ge2\epsilon$ 时,$R_{\max}(e^{2\epsilon/\lambda}-1)\le 4R_{\max}\epsilon/\lambda$。
含义:增大 $\lambda$ 让策略更保守,线性地抬高对照代价,同时以 $O(1/\lambda)$ 的速率降低对 reward 噪声的敏感度;反之,减小 $\lambda$ 允许更强地利用高 reward 轨迹,但会放大 reward 噪声。
证明骨架(附录 A.2)的核心是把「真实倾斜」与「带噪倾斜」之间的总变差界住。记真实 reward 下的倾斜为 $\pi^*_\lambda\propto\pi_\beta\exp(R^*/\lambda)$(配分 $Z^*$),带噪倾斜为 $\pi_\lambda\propto\pi_\beta\exp(\hat R/\lambda)$(配分 $Z$):
- 干净对照不等式:把变分恒等式 (14) 用在真实 reward 上,得 $V^{\pi^*_\lambda}(s)\ge V^{\tilde\pi}(s)-\lambda D_{\mathrm{KL}}(\tilde\pi\|\pi_\beta)$,确定性成立(两边只涉及真实 reward,不需要噪声事件)。
- 分解:$V^{\pi_\lambda}(s)=V^{\pi^*_\lambda}(s)-\big(V^{\pi^*_\lambda}(s)-V^{\pi_\lambda}(s)\big)$,于是只需界住噪声差。
- 界住噪声差:因 $R^*\in[0,R_{\max}]$,有 $|V^{\pi^*_\lambda}-V^{\pi_\lambda}|\le R_{\max}\sum_\tau|\pi^*_\lambda-\pi_\lambda|=2R_{\max}D_{\mathrm{TV}}(\pi^*_\lambda,\pi_\lambda)$。定义噪声权重 $w(\tau)=\exp(\xi(\tau)/\lambda)$,在事件 (A1) 上 $e^{-\epsilon/\lambda}\le w(\tau)\le e^{\epsilon/\lambda}$。带噪配分函数因式分解为 $Z=Z^*\sum_\tau\pi^*_\lambda(\tau|s)w(\tau)$,故 $\rho:=Z^*/Z$ 满足 $e^{-\epsilon/\lambda}\le\rho\le e^{\epsilon/\lambda}$;两式相除给出策略比 $\pi_\lambda/\pi^*_\lambda=w(\tau)\rho\in[e^{-2\epsilon/\lambda},e^{2\epsilon/\lambda}]$,于是 $|w\rho-1|\le\max(e^{2\epsilon/\lambda}-1,\,1-e^{-2\epsilon/\lambda})=e^{2\epsilon/\lambda}-1$(因为 $x\ge0$ 时 $e^x-1\ge1-e^{-x}$),从而 $D_{\mathrm{TV}}\le(e^{2\epsilon/\lambda}-1)/2$。
- 合并:代回即得 (7);$\lambda\ge2\epsilon$ 时用 $e^x-1\le2x\ (x\in[0,1])$ 得到 $4R_{\max}\epsilon/\lambda$ 的简化式。
这一步的技术要点在于:噪声不是加性地污染 value,而是乘性地扰动倾斜分布,因此界必须走 TV 距离而不是直接的 reward 误差累加,$e^{2\epsilon/\lambda}$ 的形式正是这个乘性结构的产物。
4.4 Theorem 4.4:覆盖依赖的次优性界与闭式最优温度¶
最后把对照策略 $\tilde\pi$ 取成上下文 $s$ 的最优策略,把「一般对照界」转化为「相对最高 reward 轨迹的次优性刻画」。令 $\tau^\star(s)\in\arg\max_\tau R^*(\tau)$ 为从 $s$ 出发的最优轨迹,定义它在行为策略下的覆盖 $p^\star(s)=\pi_\beta(\tau^\star(s)\mid s)$。
Theorem 4.4:在 Theorem 4.3 的条件下,以至少 $1-\delta$ 概率:
$$\max_\tau R^*(\tau)-V^{\pi_\lambda}(s)\ \le\ \lambda\log\frac{1}{p^\star(s)}+R_{\max}\big(e^{2\epsilon/\lambda}-1\big). \tag{8}$$
当 $\lambda\ge2\epsilon$ 时右端至多为 $\lambda\log(1/p^\star(s))+4R_{\max}\epsilon/\lambda$,该式在
$$\lambda^\star=2\sqrt{\frac{R_{\max}\,\epsilon}{\log(1/p^\star(s))}} \tag{9}$$
处取最小,最小值为 $4\sqrt{R_{\max}\,\epsilon\,\log(1/p^\star(s))}$。
这是全文的中心权衡。第一项度量「从离线数据中恢复最优轨迹的难度」:如果行为策略几乎不访问最优轨迹,任何保支撑(support-preserving)的方法都无法可靠地恢复它。第二项刻画对带噪反馈的敏感度。因此——最优温度随 reward 噪声上升、随数据覆盖上升而下降。
覆盖项的序列化解读。 用式 (1) 的自回归分解,
$$\log\frac{1}{p^\star(s)}=\sum_{t=1}^{T}\log\frac{1}{\pi_\beta(a^\star_t\mid s^\star_t)}, \tag{10}$$
其中 $(s^\star_t,a^\star_t)$ 是最优轨迹上的状态与动作。覆盖惩罚因此分解为逐步代价之和。这是一个非常漂亮的观察:虽然「在行为策略下观测到某条特定长度-$T$ 轨迹」的概率随 horizon 乘性衰减,但界里对应的惩罚是它的对数,跨步加性累积。因此恢复目标轨迹的代价随轨迹长度线性增长,而非指数增长——这为把方法推广到多步 session 级推荐提供了理论底气。
证明骨架(附录 A.3):若 $p^\star(s)=0$ 则右端无穷,界平凡。否则取 $\tilde\pi(\cdot|s)$ 为 $\tau^\star(s)$ 上的点质量,此时 $V^{\tilde\pi}(s)=\max_\tau R^*(\tau)$ 且 $D_{\mathrm{KL}}(\tilde\pi\|\pi_\beta)=\log\frac{1}{\pi_\beta(\tau^\star(s)|s)}=\log\frac{1}{p^\star(s)}$,代入 Theorem 4.3 即得 (8)。第二个论断把右端记为 $g(\lambda)=\lambda\log\frac{1}{p^\star}+\frac{4R_{\max}\epsilon}{\lambda}$,它是凸的,$g'(\lambda)=\log(1/p^\star)-4R_{\max}\epsilon/\lambda^2$ 在 (9) 处为零。
实践上的诚实说明:reward 无噪时噪声项消失,越小的温度越偏向最优轨迹,剩下的限制只由离线覆盖决定。带噪时 $\lambda$ 不能任意减小——激进重加权改善了对高 reward 轨迹的利用,但放大了对 reward 噪声的敏感度;大温度提高鲁棒性但代价是更贴近行为策略。这正是 §5 中观测到的倒 U 关系的解释。作者明确指出:虽然式 (9) 刻画了 $\lambda^\star$,但求值需要 reward 噪声水平和最优轨迹覆盖这些未知量,因此不能直接用于实践中的超参选择,$\lambda$ 仍需经验调优。
5 实验设置¶
实验的形式化实例化。 理论考虑的是自回归生成式推荐器的一般轨迹级设定;实验则实例化到 next-item 推荐,即单步情形 $T=1$。此时轨迹由「用户上下文 + 一个推荐物品」构成,$\tau=(s,a)$,轨迹 reward 退化为观测到的物品级反馈 $R(\tau)=r(s,a)$。这样既能直接评估指数 reward 加权,又保留与一般形式的联系。
数据集。 三个公开序列推荐基准 + 一个大规模工业数据集:MovieLens 1M(ML-1M)、MovieLens 20M(ML-20M)、Amazon Reviews(Books)、以及一个匿名化的私有流媒体数据集 StreamCo。基准覆盖了从「稠密的电影推荐」到「稀疏的大目录推荐」的谱系。
Table 1:数据集统计
| Dataset | Users | Items | Avg. Interactions/User | Test Cases ($r\ge4.5$) |
|---|---|---|---|---|
| ML-1M | 6,040 | 3,706 | 165.60 | 1,530 |
| ML-20M | 138,493 | 26,744 | 144.41 | 40,667 |
| Amazon Books | 811,227 | 695,762 | 14.47 | 424,271 |
| StreamCo | O(Millions) | O(Thousands) | O(Tens) | O(Thousands) |
Amazon Books 是目录规模与稀疏度的极端点(69.6 万物品、人均仅 14.47 次交互),恰好落在理论关心的「覆盖极差」regime;ML-1M 则是「覆盖好但测试样本只有 1,530 条」的另一端。
模型与训练设置。 底座生成式推荐器统一用 HSTU(Zhai et al. 2024)。预训练好的 HSTU 直接作为 behavior cloning(BC)baseline,做 next-item 预测。对需要 reward model 的方法,在推荐器表征之上训一个轻量 reward head 预测所选物品对应的反馈,其预测的物品级 reward 作为优化信号。
对比算法(5 个),横跨行为克隆、reward 加权 SFT、RL 对齐三类:
- BC(Behavior Cloning):预训练 HSTU,只用 next-item 预测训练,无 reward 优化。
- RSFT(Reward-weighted SFT):按观测 reward 线性加权训练样本(Mukherjee et al. 2025)。
- DPO:提升偏好物品相对非偏好物品的似然。由于推荐数据集不含显式偏好对,作者采样候选物品并用 reward model 打分来构造偏好,遵循 online DPO 风格训练(follow OneRec)。
- PPO:用学习出的 reward model 给出的 reward 更新推荐策略。
- Exp-RSFT(本文):即 Algorithm 1。在实验的 $T=1$ 设定下,它按 $\exp(r(s,a)/\lambda)$ 加权 next-item 似然,是 §3.2 轨迹级指数加权的单步实例化。
由于 StreamCo 的私有性质,报告相对 RSFT 的相对变化而非绝对值(因保密无法以 BC 为基准)。训练轮数:ML-1M 30 epochs、ML-20M 12 epochs、Amazon Books 10 epochs。
评估。 在 ML-1M / ML-20M / Amazon Books 的标准测试划分上评估,只保留评分 $\ge4.5$ 的 held-out 交互。这既把评估聚焦在高偏好推荐上,也与 reward 优化目标对齐。所有方法(含 BC)都在同一批过滤后的测试集上评估。设 $r_i$ 为 ground-truth 物品在全部候选中的排名,报告:
$$\mathrm{HR@}K=\frac1N\sum_{i=1}^{N}\mathbb{1}(r_i\le K), \tag{11}$$
$$\mathrm{NDCG@}K=\frac1N\sum_{i=1}^{N}\frac{\mathbb{1}(r_i\le K)}{\log_2(r_i+1)}, \tag{12}$$
$$\mathrm{MRR}=\frac1N\sum_{i=1}^{N}\frac{1}{r_i}. \tag{13}$$
HR 与 NDCG 的截断取 $K\in\{10,50\}$。此外还报告 Avg Reward(reward-model-as-judge,见 §6.2)。
训练细节(附录 B.1):全部实验在 4 张 NVIDIA A100 上完成。每个「算法–数据集」配置只跑一次训练(single run),作者以「Exp-RSFT 的提升在全部 5 个评估指标、全部 4 个数据集上一致」作为鲁棒性证据;温度 $\lambda$ 与训练轮数在 §5 给出,其余超参(含固定随机种子)随代码提供,可精确复现。
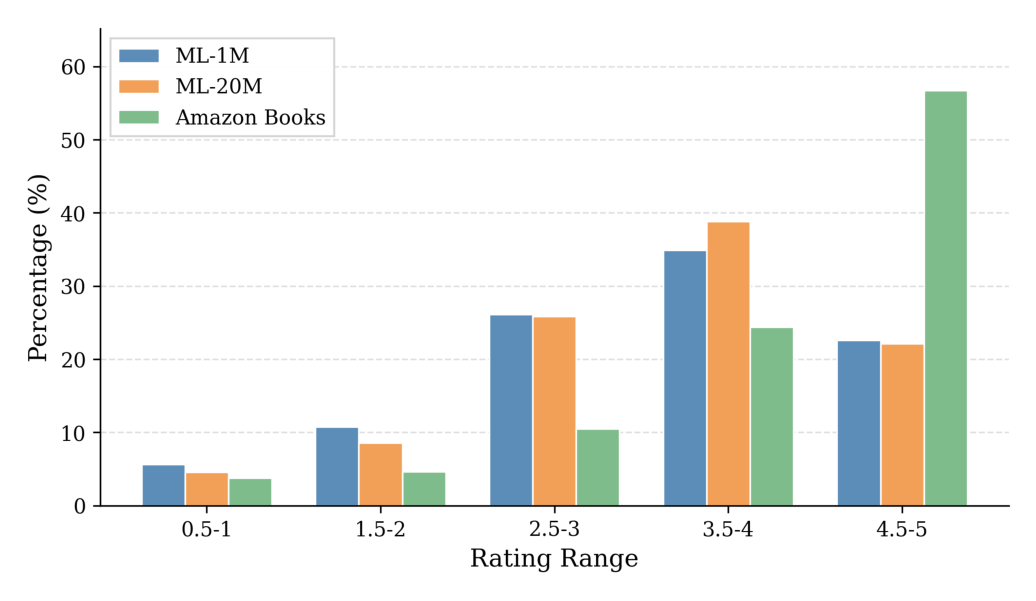
评分分布(附录 B.2)。Figure 2 显示三个公开数据集的评分集中在高分端,这正是评估采用 $r\ge4.5$ 过滤的动机。
6 主要实验结果¶
6.1 Reward model 质量基准:学习出的 RM 打不过朴素基线¶
这是全文最关键的一张「否定性」表。为评估学习出的 reward model 的可靠性,作者拿它的预测误差与三个极其朴素的基线比:User Mean、Item Mean、Global Mean 预测器。
Table 2:Reward model 预测性能 vs. 朴素基线(各行最优加粗;列依次为 User-Mean / Item-Mean / Global-Mean / 训练出的 reward model)
| Dataset | Metric | User | Item | Global | RM |
|---|---|---|---|---|---|
| ML-1M | MSE | 1.0784 | 0.9179 | 1.2394 | 1.2166 |
| ML-1M | MAE | 0.8232 | 0.7619 | 0.9268 | 0.8680 |
| ML-20M | MSE | 0.9550 | 0.8898 | 1.0939 | 0.8963 |
| ML-20M | MAE | 0.7588 | 0.7320 | 0.8423 | 0.7307 |
| Amazon Books | MSE | 1.1578 | 0.7290 | 1.1868 | 1.1067 |
| Amazon Books | MAE | 0.7411 | 0.5651 | 0.8636 | 0.8140 |
| StreamCo | MSE | 2.412 | 2.568 | 2.568 | 2.486 |
| StreamCo | MAE | 2.112 | 2.442 | 2.451 | 1.916 |
分析:在 8 行里 reward model 只赢下 2 行(ML-20M MAE、StreamCo MAE),在目录最大、最稀疏的 Amazon Books 上被 Item Mean 拉开巨大差距(MSE 1.1067 vs 0.7290,MAE 0.8140 vs 0.5651);在 ML-1M 上甚至连 Global Mean 的 MSE 都只是勉强打平(1.2166 vs 1.2394)。这直接印证了 §1.2 的第一条障碍:为未见过的物品准确预测用户反馈本身就极其困难。而 PPO/DPO 的全部优化信号都来自这样一个 reward model——它们优化的是一个连 Item Mean 都不如的代理。这就是后面 reward hacking 的机制根源。
6.2 主表:PPO/DPO 崩塌,Exp-RSFT 全线最优¶
Table 3:公开基准($r\ge4.5$)与私有 StreamCo(高 reward 轨迹)上的推荐性能(各数据集每列最优加粗;StreamCo 为相对 RSFT 的变化率,因数据保密用 RSFT 代替 BC 作基准)
| Dataset | Method | NDCG@10 | NDCG@50 | HR@10 | HR@50 | MRR | Avg Reward |
|---|---|---|---|---|---|---|---|
| ML-1M | BC | 0.1304 | 0.1866 | 0.2405 | 0.4967 | 0.1116 | 3.8672 |
| ML-1M | DPO | 0.0091 | 0.0231 | 0.0163 | 0.0824 | 0.0122 | 3.3737 |
| ML-1M | PPO | 0.0303 | 0.0617 | 0.0673 | 0.2124 | 0.0285 | 4.4775 |
| ML-1M | RSFT | 0.1437 | 0.2003 | 0.2608 | 0.5163 | 0.1230 | 3.6558 |
| ML-1M | Exp-RSFT | 0.1465 | 0.2029 | 0.2712 | 0.5261 | 0.1235 | 3.6933 |
| ML-20M | BC | 0.1753 | 0.2313 | 0.3035 | 0.5569 | 0.1510 | 3.7388 |
| ML-20M | DPO | 0.0196 | 0.0342 | 0.0372 | 0.1052 | 0.0195 | 4.4008 |
| ML-20M | PPO | 0.1164 | 0.1688 | 0.2141 | 0.4536 | 0.1008 | 3.7547 |
| ML-20M | RSFT | 0.1847 | 0.2403 | 0.3161 | 0.5677 | 0.1593 | 3.7904 |
| ML-20M | Exp-RSFT | 0.1912 | 0.2462 | 0.3238 | 0.5726 | 0.1651 | 3.8611 |
| Amazon Books | BC | 0.0328 | 0.0478 | 0.0589 | 0.1279 | 0.0296 | 4.2824 |
| Amazon Books | DPO | 0.0008 | 0.0020 | 0.0019 | 0.0075 | 0.0013 | 4.8615 |
| Amazon Books | PPO | 0.0094 | 0.0156 | 0.0184 | 0.0469 | 0.0088 | 4.4549 |
| Amazon Books | RSFT | 0.0349 | 0.0514 | 0.0630 | 0.1388 | 0.0314 | 4.3350 |
| Amazon Books | Exp-RSFT | 0.0356 | 0.0520 | 0.0641 | 0.1397 | 0.0319 | 4.3374 |
| StreamCo | RSFT | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% | 0.00% |
| StreamCo | DPO | −99.30% | −96.77% | −99.14% | −95.52% | −95.34% | +19.21% |
| StreamCo | PPO | −4.88% | −24.01% | −14.66% | −35.71% | −8.60% | +13.39% |
| StreamCo | Exp-RSFT | +106.20% | +69.71% | +98.07% | +49.58% | +86.31% | +17.27% |
逐条分析:
- Exp-RSFT 在四个数据集的五个排序指标上全部最优。相对 BC 的 NDCG@10 提升:ML-1M +12.3%(0.1304→0.1465)、ML-20M +9.1%(0.1753→0.1912)、Amazon Books +8.5%(0.0328→0.0356)。
- 相对 RSFT 的增量把「温度」隔离出来。RSFT 与 Exp-RSFT 的唯一区别就是权重从线性变成 $\exp(r/\lambda)$。NDCG@10 增量:ML-1M +1.9%、ML-20M +3.5%、Amazon Books +2.0%;StreamCo 上则是翻倍级的 +106.20%。这是全文最重要的对照实验设计——它排除了「加权本身」的功劳,把增益归因于温度这个显式鲁棒性旋钮。
- Avg Reward 与推荐质量完全反向。这是 reward hacking 最直白的证据:在每一个数据集上,取得最高 Avg Reward 的方法都伴随排序指标的严重退化——ML-1M 上是 PPO(Avg Reward 4.4775 最高,NDCG@10 却只有 0.0303,掉到 BC 的 1/4),ML-20M / Amazon Books / StreamCo 上都是 DPO(Amazon Books 上 Avg Reward 4.8615 最高,NDCG@10 却是 0.0008,几乎归零)。作者的 reward-model-as-judge 协议是:对 10,000 个评估上下文各采 10 条生成,取 reward model 预测 reward 的均值。
- DPO 崩得比 PPO 更彻底。Amazon Books 上 DPO 的 NDCG@10 是 BC 的 1/41,StreamCo 上相对 RSFT 掉 −99.30%。原因在 §2 已经交代:推荐数据没有天然偏好对,用 reward model 打分构造偏好对等于把 reward model 的误差直接编码进监督标签,比 PPO 只把它当作标量 reward 更致命。
- PPO 在 ML-20M 上退化最轻(NDCG@10 0.1164,仍是 BC 的 66%),恰好对应 Table 2 里 reward model 在 ML-20M 上表现最好(MAE 甚至赢过 Item Mean)。「RM 越可靠 → RL 崩得越轻」这条对应关系在跨数据集层面成立,是对论文因果叙事的有力旁证。
- StreamCo 上的巨大相对增益(+106.20% NDCG@10)说明:工业级稀疏噪声数据恰是 Exp-RSFT 相对线性加权优势最大的地方,与理论「噪声越大、温度旋钮越有价值」的预测方向一致。
训练曲线(附录 B.4)印证崩塌发生在训练早期。以 ML-1M 为例(Figure 5,epoch 0 即 BC baseline):DPO 在第 5 个 epoch 就把 NDCG@10 从 0.13 砸到 0.017 并再无恢复;PPO 起初尚能维持,从第 10 个 epoch 开始持续下滑到 0.03;而 RSFT 与 Exp-RSFT 全程单调上行并稳定在 BC 之上。
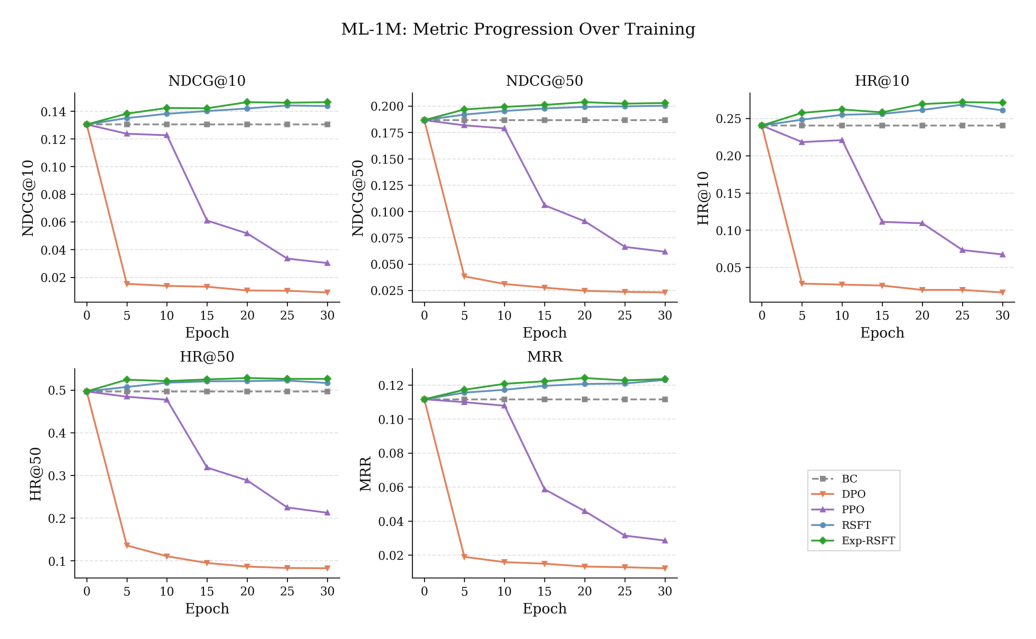
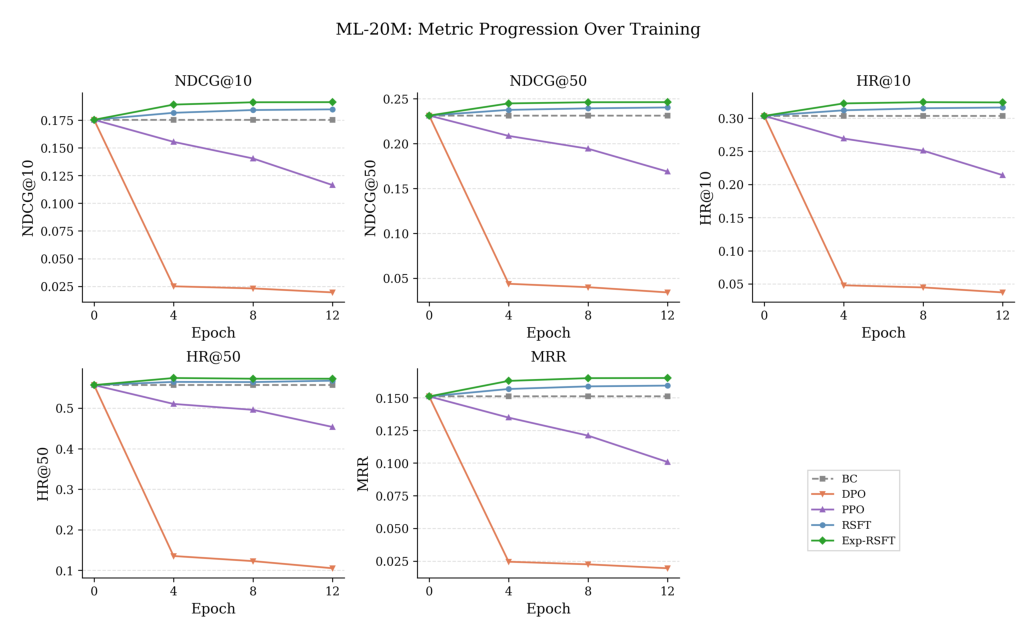
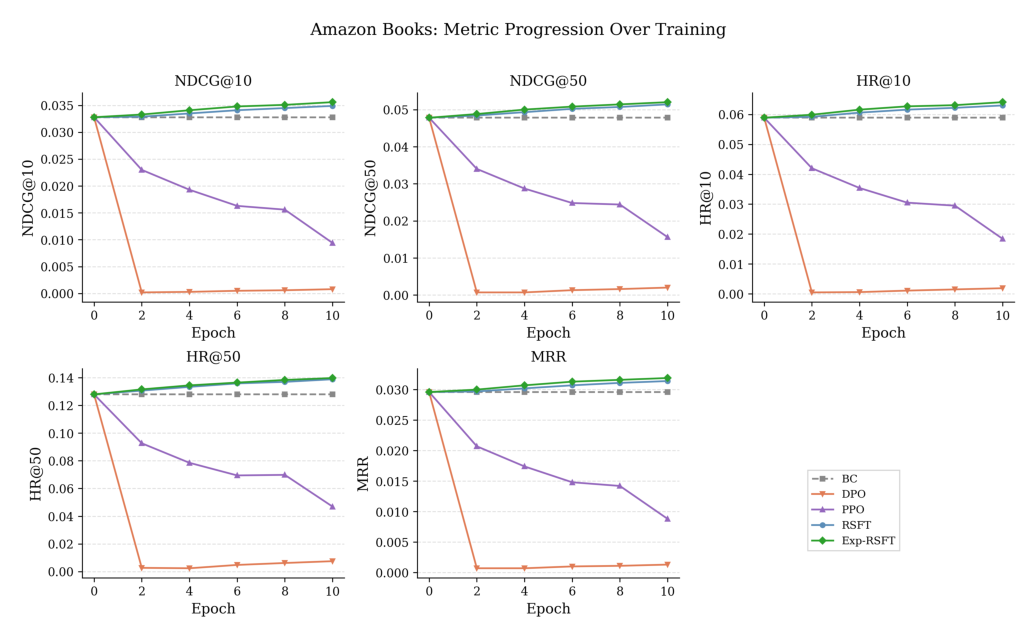
Figures 8–10 把镜头拉近到只看 RSFT 与 Exp-RSFT:Exp-RSFT 在每个数据集、几乎每个 epoch 上都优于 RSFT,而且两者都稳定高于 BC 虚线。ML-1M 上还能看到 RSFT 在第 25 个 epoch 后开始回落(HR@10 从 0.269 掉到 0.261),Exp-RSFT 则保持平稳——温度提供的正则效果同时改善了训练后期的稳定性。
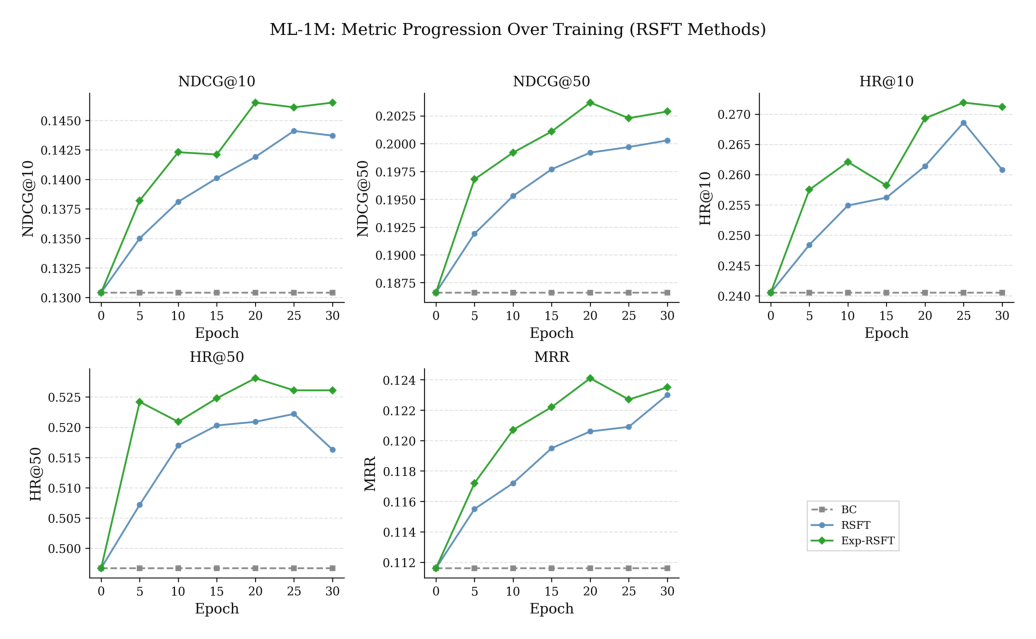
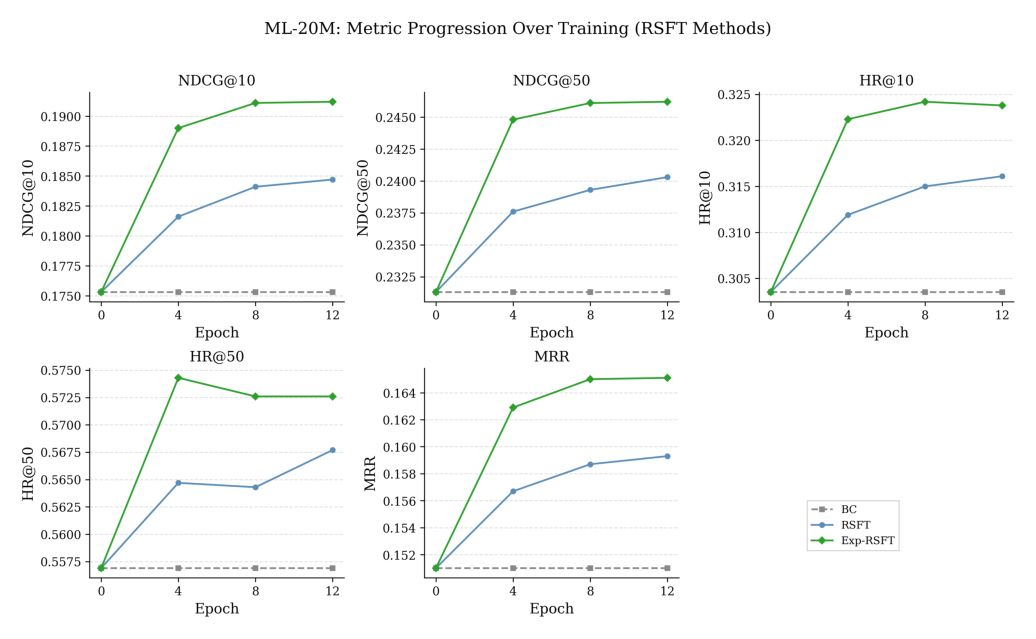
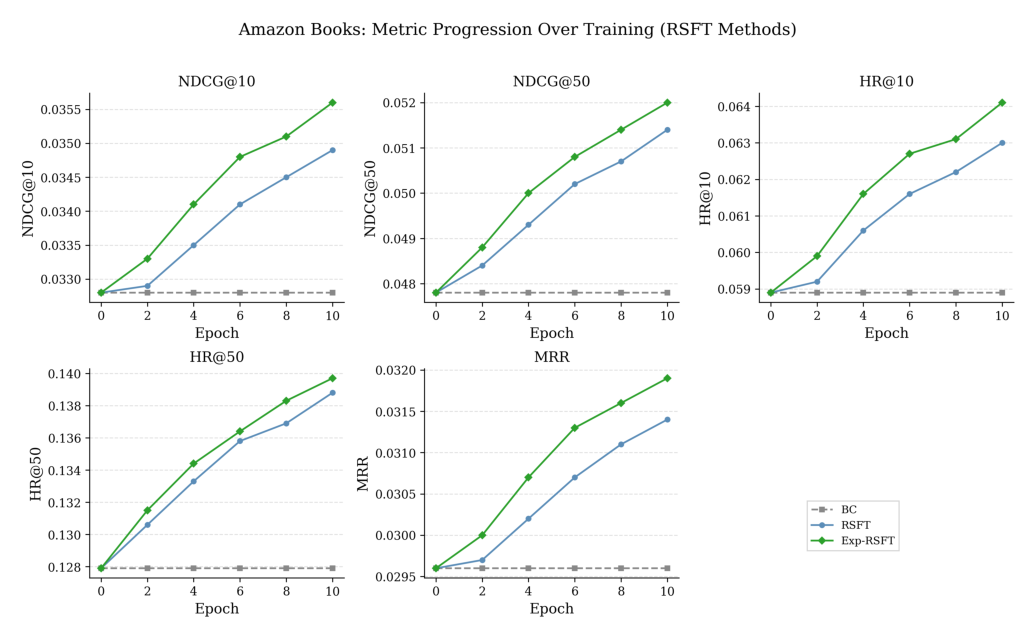
6.3 温度扫描:倒 U 形曲线验证理论预测¶
这是论文唯一的、也是最重要的「理论–实验对拍」实验。Theorem 4.3 与 4.4 预测由温度 $\lambda$ 控制的权衡:小值激进强调高 reward 动作但提高对 reward 噪声的敏感度,大值贴近行为策略、改进潜力受限。作者在所有数据集上扫描 $\lambda$。
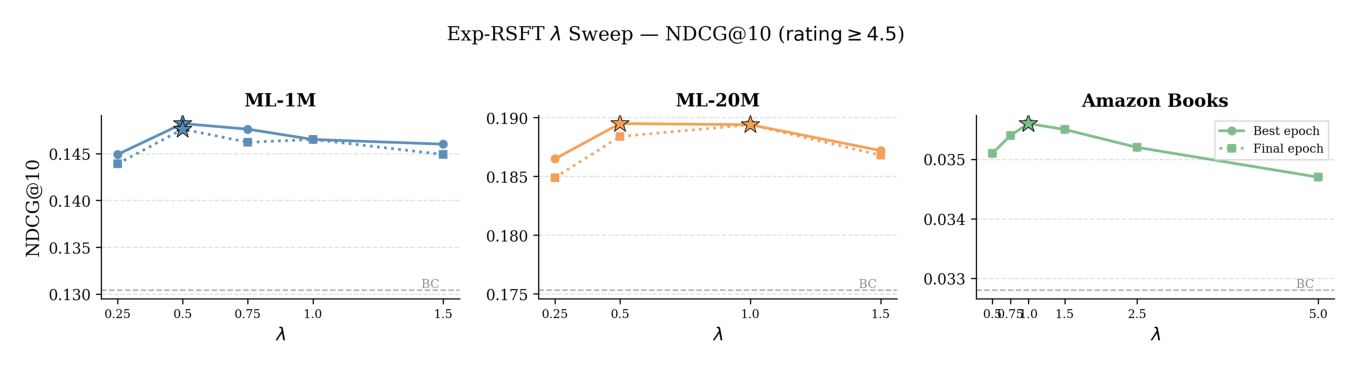
结果:所有数据集上性能都呈倒 U 形——$\lambda$ 从大值下降时性能改善,在中间温度($\lambda\approx0.5\text{–}1.0$)达到最大,$\lambda$ 过小时再度退化。ML-1M 与 ML-20M 的峰值在 $\lambda=0.5$,Amazon Books 的峰值在 $\lambda=1.0$(其扫描范围更宽,$\lambda\in\{0.5,0.75,1.0,1.5,2.5,5.0\}$,$\lambda=5.0$ 时 NDCG@10 掉到 0.0345,但仍高于 BC 的 0.0328)。三张子图里 BC 都是一条水平虚线,整条曲线在所有扫描到的 $\lambda$ 上都位于 BC 之上——这意味着 Exp-RSFT 对 $\lambda$ 的选择相当鲁棒,调错温度只是少赚,不会亏。
与理论的对应:大温度通过限制对行为策略的偏离而压制改进(式 (8) 第一项 $\lambda\log(1/p^\star)$ 随 $\lambda$ 线性增长);过小的温度放大噪声敏感度(第二项 $R_{\max}(e^{2\epsilon/\lambda}-1)$ 随 $\lambda\to0$ 爆炸)。这正是式 (9) 所刻画的内点最优。
7 消融与分析¶
7.1 倒 U 不是早停假象(附录 B.3)¶
一个自然的质疑是:倒 U 会不会只是「不同 $\lambda$ 下最佳 epoch 不同」造成的选择效应?作者用 Figures 3 与 4 分别报告最佳 epoch 与最后一个 epoch 下全部五个指标的完整温度扫描,两种选法下倒 U 形状都出现,从而排除了早停作为混淆因素。这是一个虽小但重要的严谨性检查——它把「倒 U」从「调参痕迹」升格为「优化目标本身的性质」。
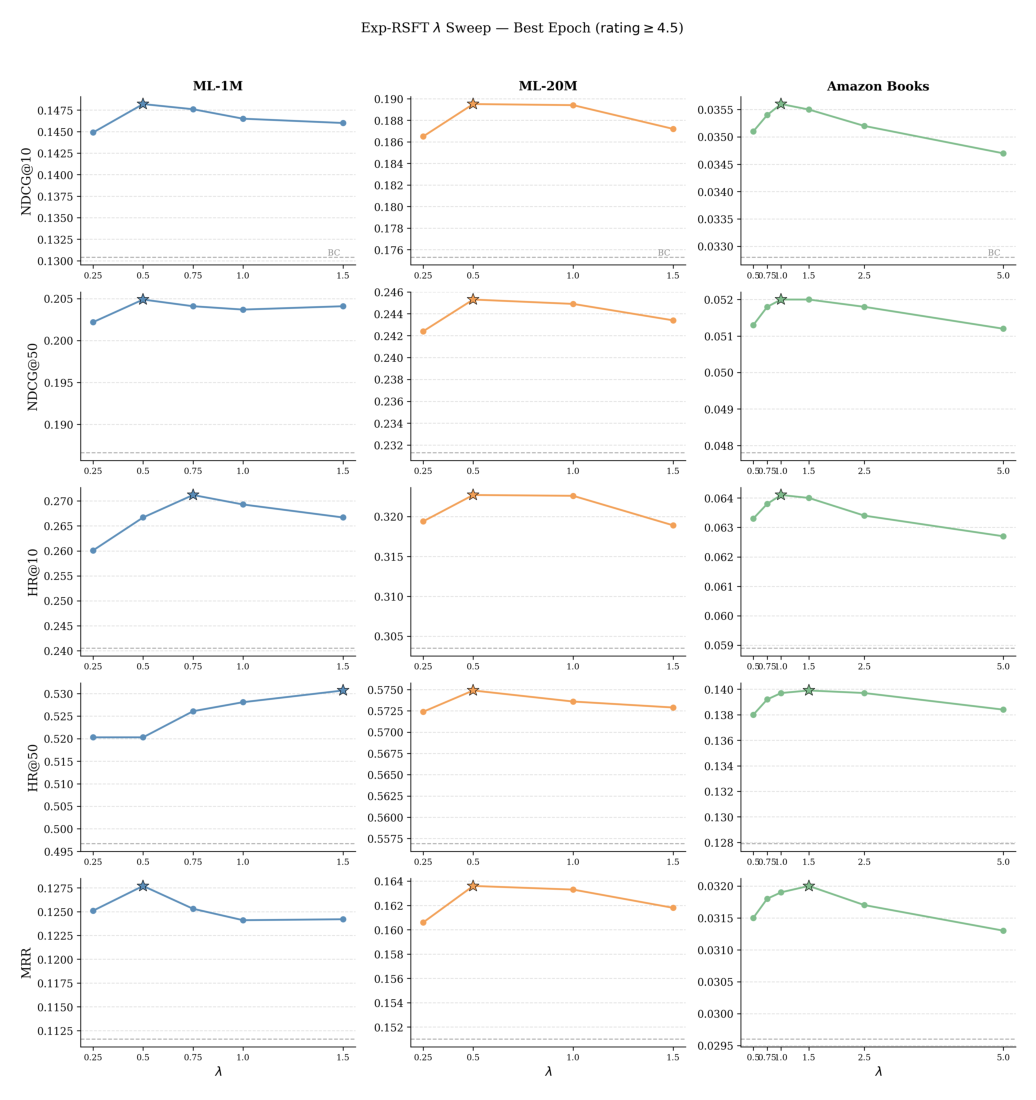
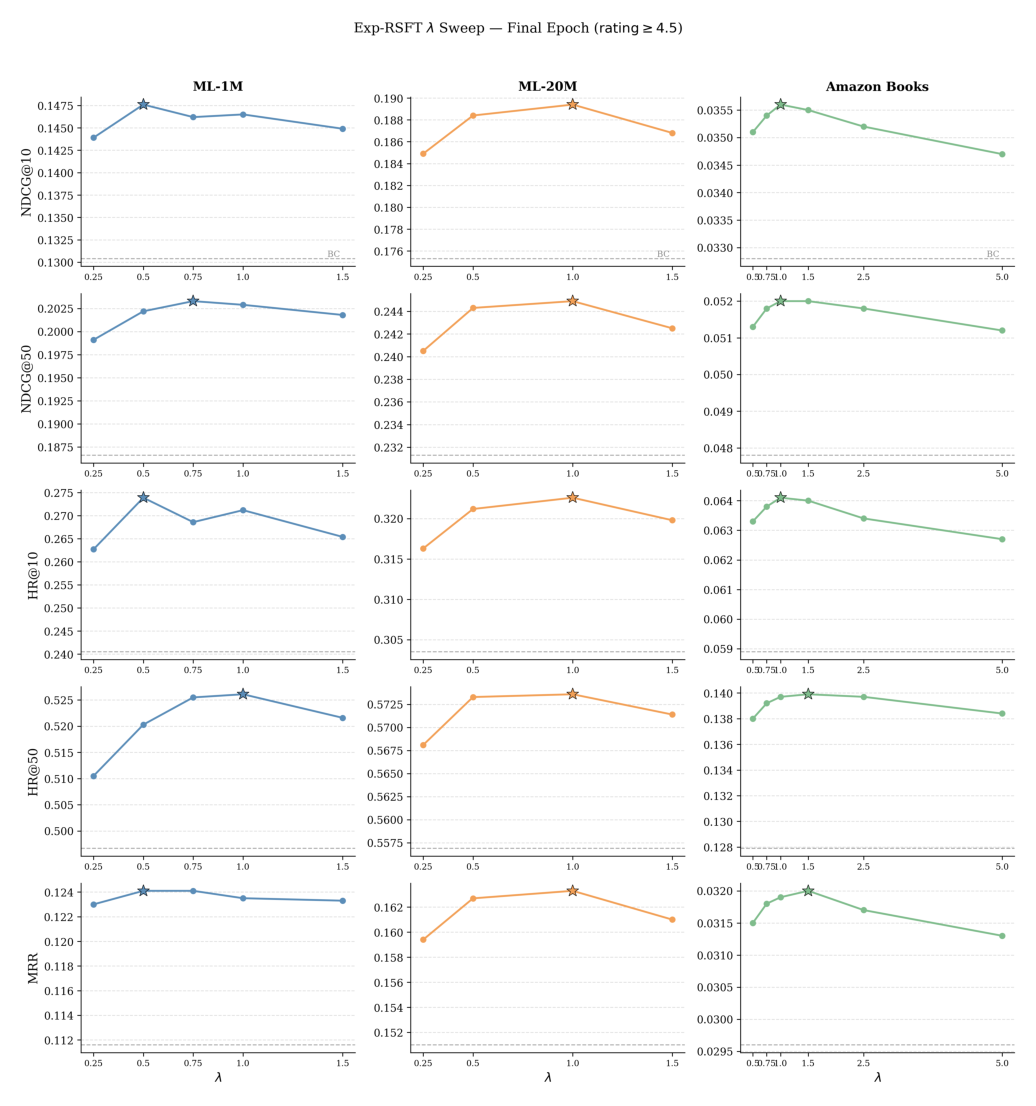
从 Figure 1 也能直接看出这一点:ML-1M 与 ML-20M 的 best-epoch(实线)与 final-epoch(虚线)两条曲线几乎平行,峰值位置一致。
7.2 组件贡献的隐式消融¶
论文没有设独立的消融章节,但整个 baseline 阵列本身就构成一组干净的逐层消融:
| 对比 | 隔离出的成分 | 结论 |
|---|---|---|
| BC → RSFT | 「用不用 reward 加权」 | reward 加权有效(ML-1M NDCG@10 0.1304→0.1437,+10.2%) |
| RSFT → Exp-RSFT | 「线性权重 vs. 指数权重 + 温度」 | 温度旋钮再带来 +1.9%~+3.5%(公开集)与 +106%(StreamCo) |
| Exp-RSFT vs. PPO/DPO | 「用不用学习型 reward model」 | 用 RM 的方法全线崩塌,不用 RM 的方法全线改进 |
| $\lambda$ 扫描 | 「温度取值」 | 内点最优,倒 U,$\lambda\approx0.5\text{–}1.0$ |
这组对照的说服力在于它们两两只差一个变量,把「加权」「温度」「reward model」三个因素彻底解耦。
8 核心贡献总结¶
- 把一个老算法放进正确的理论显微镜下。Exp-RSFT(= RWR / MARWIL / LPI 谱系)本身不新,但此前所有分析都关注优化稳定性、收敛性与 value function 估计的分布漂移,没有人刻画 reward 噪声下的行为,也没有人量化大动作空间下有限覆盖的代价。本文补上了这块空白。
- 次优性的双项分解 + 闭式最优温度。Theorem 4.4 把次优性拆成 $\lambda\log(1/p^\star)$(覆盖)与 $R_{\max}(e^{2\epsilon/\lambda}-1)$(噪声),二者随 $\lambda$ 反向移动,最优点 $\lambda^\star=2\sqrt{R_{\max}\epsilon/\log(1/p^\star)}$。分析是轨迹级的、无需 reward model 与 value function,并把 contextual bandit 作为 $T=1$ 特例回收。
- 覆盖代价随 horizon 线性而非指数增长。式 (10) 的自回归分解显示:轨迹概率乘性衰减,但界里的惩罚是其对数,因此跨步加性累积。这条结论对把方法推到多步 session 级推荐至关重要。
- 理论预测被实验精确复现。倒 U 形温度曲线在三个公开基准 + 一个工业数据集上一致出现,且经 best-epoch / final-epoch 双重检验。
- 对「推荐场景下 reward model 有多不可靠」的定量记录。Table 2 显示学习出的 RM 连 Item Mean 都打不过;Table 3 显示 Avg Reward 与真实排序质量系统性反向。这两张表本身就是可复用的负面结论。
9 与已归档相关工作的对比¶
AdaGRPO AdaGRPO: Adaptive Loss Balancing for Noise-Robust GRPO in Generative Recommendation (JD.com / 早稻田 / 电子科大, RecSys '25)¶
关系:独立并发(本文参考文献中未出现 AdaGRPO,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文的 root cause 陈述几乎逐字重合——生成式推荐的 RL 后训练依赖一个从稀疏、曝光偏置日志中学出的 reward model,而这个 RM 在它被查询的大部分区域并不可信,于是策略把它的预测误差当作可优化的信号(reward hacking),排序质量反而崩塌。更惊人的是两篇都用「先量化 RM 到底有多差」来奠定叙事:Exp-RSFT 的 Table 2 显示 RM 的 MSE/MAE 连 Item Mean 都打不过;AdaGRPO 的 Table 1 显示 RM 对 ground-truth 排名的聚合影响在 $K=50$ 时仅 +0.48、在 $K=128$ 时转为 −0.28。两者独立地得出「工业 RM 在聚合意义上近乎无用」这一结论。
- 相近的技术骨架:两者的解法都不是「造一个更强的 reward」,而是保留监督似然作为主干、用一个由 reward 派生的标量去调制它,并把「施加多少 reward 压力」暴露成一个显式旋钮。AdaGRPO 的逐实例目标是 $L_i=L_{\mathrm{NLL}}^{(i)}+\lambda\alpha_i L_{\mathrm{GRPO}}^{(i)}$,$\alpha_i\in\{0,1\}$;Exp-RSFT 的目标是 $\mathbb{E}[\exp(R/\lambda)\sum_t\log\pi_\theta]$。把 $\alpha_i$ 与 $\exp(R/\lambda)$ 并置来看,两者都是「reward 决定的、detached 的逐样本权重乘在对数似然上」——AdaGRPO 是二值门控,Exp-RSFT 是连续指数权重。
- 本文的差异与推进:(i) AdaGRPO 保留 RM 但只在它可信的样本子集上准入,Exp-RSFT 干脆彻底不要 RM,直接在日志 reward 上优化——从「有条件地信任」推到「不需要信任」。(ii) Exp-RSFT 给出了 AdaGRPO 完全没有的理论刻画:次优性双项分解、闭式 $\lambda^\star$、覆盖代价随 horizon 线性增长。AdaGRPO 的两个诊断 $f_1,f_2$ 是经验分层分析的产物,阈值 $\tau=1/3,\rho=0.9$ 靠跨任务经验稳健性辩护,没有对应的界。(iii) 反过来,AdaGRPO 的 clip 需要 on-policy rollout(要采 $K$ 条 rollout 才能算秩诊断),Exp-RSFT 则完全离线、零采样开销,训练栈改造成本更低。(iv) AdaGRPO 有线上 A/B(+0.43% effective IPV),Exp-RSFT 只有离线工业数据集。
- 可比的方法/实验差异:AdaGRPO 的旋钮是秩阈值(哪些样本可以说话),Exp-RSFT 的旋钮是温度(每个样本能说多响)。两者面对的是同一个 precision–coverage 权衡的两种参数化:AdaGRPO 用二值 clip 换来「构造即可解释」(每个被 clip 的样本都能说清为什么),Exp-RSFT 用连续权重换来「闭式最优点 + 倒 U 可预测」。AdaGRPO 在 §4 里发现 RM 的价值随候选集增大而增大(HARD 分区 $K=50$ 时 $\Delta=+11.41$、$K=128$ 时 $\Delta=+30.77$),这与 Exp-RSFT 的 $O(\sigma\sqrt{T\log|\mathcal{A}|})$ 噪声界方向一致:目录/候选规模只带来对数级的代价。
OxygenREC-v2 OxygenREC-v2: Internalizing Discrimination into Generative Recommendation (JD.com, 2026-07-27)¶
关系:独立并发(本文未引用,两者同一诊断、不同处方)· 已加载对方精读
- 共同关注的问题:OxygenREC-v2 把它的两个痛点归为同一个 root cause,第一条与本文完全一致——「离线排序模型对分布外输出打分不可靠,于是策略可以在不真正改善推荐质量的前提下把代理分数刷上去」。这与 Exp-RSFT 的 Table 3 现象(Avg Reward 最高的方法排序指标最差)是同一件事的两种表述。两篇的结论也一致:问题不在于把代理 reward 用得更好,而在于代理 reward 这个环节本身应该被移除。
- 相近的技术骨架:两者都主张「用日志里本就存在的信号直接监督生成器,而不是委派给一个外部打分器」。OxygenREC-v2 的原话是「让信号成为内部的而非外部的,就从源头上移除了代理奖励问题」;Exp-RSFT 则是把日志 reward 直接做成似然权重。两者的后训练目标也都落在「advantage/reward 加权的对数似然」这一族里——OxygenREC-v2 的 EA-TOSD 含一路 low-entropy advantage-weighted self-distillation,正是 RWR 谱系的同构项。
- 本文的差异与推进:(i) 抽象层次不同。Exp-RSFT 是一条与骨干无关、与物品标识无关的一般性目标(任何自回归生成式推荐器 + 任何标量 reward 都能套),并配一个理论;OxygenREC-v2 是一整套 SID 生成式推荐系统的工程设计(行为指令 $I_b$ 进 decoder prefix、特权 teacher、熵感知蒸馏)。(ii) 是否需要 rollout。OxygenREC-v2 的可验证 reward 要从 $G$ 条 on-policy rollout 里选最优,Exp-RSFT 纯离线加权,不采样。(iii) 对噪声的处理。OxygenREC-v2 用「熵感知」防止特权蒸馏偏置,本质是在 token 维度上分辨哪些位置的 teacher 自信是「作弊」来的;Exp-RSFT 用温度在轨迹维度上统一地压制噪声,并给出 $\sigma$-sub-Gaussian 假设下的显式界。前者更精细但无理论,后者更粗但可分析。(iv) OxygenREC-v2 有六个 JD 生产场景的线上 A/B(+1.6–4.4% UCTCVR、+2.8–6.8% GMV),Exp-RSFT 没有。
- 可比的方法/实验差异:OxygenREC-v2 显示「增益最大的是 order 行为——最稀疏、价值最高的那个」;Exp-RSFT 则显示相对增益最大的是 StreamCo(+106.20% NDCG@10)这个最稀疏、噪声最大的工业数据集。两者都指向「越稀疏噪声越大的场景,去掉代理 RM 的收益越大」这一共同经验规律。
GenRec GenRec: A Preference-Oriented Generative Framework (JD.com, 2026-04-16)¶
关系:独立并发(本文未引用;GenRec 的 §1.1(iii) 与本文的动机同构)· 已加载对方精读
- 共同关注的问题:GenRec 的第三个挑战原文是「SFT 阶段基于 offline log 的 next-token likelihood 训练,本质上只是在模仿历史行为,并不直接优化用户偏好;而 offline log 又相当稀疏、非平稳,naive 地用 RL 对齐容易出现 reward hacking」——这与本文 §1.1/§1.2 的诊断逐条对应(行为克隆的模仿本性、日志稀疏、RL 招致 reward hacking)。
- 相近的技术骨架:GenRec 的 GRPO-SR 在 GRPO 之外加了一项 NLL 正则,把策略强锚定到真实用户正向轨迹 $\mathcal{D}^+$ 上。GenRec 精读里那句「和标准 KL-divergence 正则不同,NLL 正则显式地把策略拉向『真实用户行为分布』而不是『参考模型分布』,因而对 reward over-optimization 有更硬的约束」——这恰好是 Exp-RSFT 式 (3) 那条 $D_{\mathrm{KL}}(\pi\|\pi_\beta)\le\varepsilon$ 约束的工程化表述。两篇独立地得出「anchor 应当落在行为日志而不是 reference policy 上」这一结论,只是 Exp-RSFT 把它写成了受约束优化并解出闭式解 (4),GenRec 则是把它作为一项 loss 加权相加。
- 本文的差异与推进:GenRec 仍然保留一个稠密代理 RM(基于 SIM 的 preference 模型),只是额外用 gating $\mathcal{G}$ 过滤 + NLL 锚定来压制 hacking;Exp-RSFT 则论证这条路本身就有上限,因为 RM 在稀疏大目录下连 Item Mean 都打不过。有意思的是 GenRec 的消融给出了同方向的证据:去掉 gate 后 HaR(幻觉率)看起来极低,但 HR@50 从 0.7438 掉到 0.7016——低 HaR 不等于高质量,与本文「Avg Reward 高不等于推荐好」是同一类观察。另一方面,GenRec 有月级全量线上 A/B(click +9.5%、transaction +8.7%),工业验证强度远超本文。
- 可比的方法/实验差异:GenRec 的 NLL 锚定是均匀权重的(对 $\mathcal{D}^+$ 里所有正样本一视同仁),Exp-RSFT 则按 $\exp(r/\lambda)$ 分级加权——在 GenRec 的框架里,这相当于把「点击」和「下单」以指数比例区别对待,而不是都算作 $\mathcal{D}^+$。这是一个可以直接把本文结论迁移到 GenRec 上的具体改进点,且 GenRec 缺的正是「$\lambda$ 该取多大」这个问题的答案。
Step 2.5 被剔除的近似候选(记录以防门槛放水): - OneSug OneSug(Kuaishou):其 RWR 同样不用学习型 RM、直接用分级日志行为,但权重进入的是 DPO margin($rw_\Delta$ 缩放偏好差),而非对数似然;且论文的核心问题是「多阶段级联 → 端到端生成式 query suggestion」,不是 RM 不可靠 / reward 噪声。解法路径实质偏离。 - AMRS AMRS(LUCID):问题同构(在线探索不可行,必须纯离线优化),但解法正好相反——它构建 world model 当模拟器,再用 world-model 打分做 DPO。这正是 Exp-RSFT 论证会失败的路线,属于对立而非同构。 - HRPO HRPO(CityU,同日 arXiv):同样是生成式推荐的 RL 后训练,但 root cause 是信用分配 / 终局 reward 稀疏(把 item 级终局反馈沿 SID trie 残差化成 token 级 credit-to-go),不是 reward 噪声或 RM 不可靠;解法是 PPO 式 RRPO + 位置级 group 归一化,与加权 MLE 骨架不同。 - BLADE BLADE(USTC):处理 BoN 对齐里静态参考分布的瓶颈,用 Beta-Binomial 共轭融合做自演化分位数 reward 再喂 GRPO。问题是 reward 的参考基准,不是 reward 的噪声;且仍重度依赖打分器。 - Mult-DPO Mult-DPO(UVA):把 DPO 从 pairwise 推广到 setwise 多正样本,root cause 是偏好结构的表达力,与日志 reward 的噪声/覆盖无关。
10 讨论与局限性¶
10.1 值得借鉴的设计¶
- 「不引入 reward model」本身就是一种正则。论文最有价值的立场是把 reward hacking 的解法从「更好的 RM / 更聪明的 RL」转向「根本不给策略一个可 hack 的对象」。Table 2 与 Table 3 的组合把这个立场量化得极为干净:RM 打不过 Item Mean(Table 2),而 Avg Reward 越高排序越差(Table 3)。任何要在推荐里上 RLHF 的团队都应该先跑一遍 Table 2 这个检查。
- 权重形式选指数而非线性有实质理由,不只是「效果更好」:线性 reward 加权在基于似然的目标里会出现负权重病态(Steck 2010;Schnabel et al. 2016),指数形式天然为正,且额外提供温度旋钮。
- 工程改造成本极低。式 (5) 相对普通 SFT 只多一个逐样本标量系数,梯度形状不变、不需要 value network、不需要 rollout、不需要倾向性。对已有 HSTU/OneRec 类训练栈几乎是即插即用。
- 覆盖代价的对数/加性结构(式 (10))是把方法从 $T=1$ 推到多步 session 级最重要的理论支撑。
10.2 局限性(作者自陈)¶
- regime 受限。分析聚焦于「用户只与大目录的一小部分交互、反馈以标量 reward 形式给出」的情形。在监督显著更丰富的场景(稠密偏好比较、广泛的用户反馈覆盖)下,其他后训练方法可能更有效。
- 没有消除偏好估计的根本困难。Exp-RSFT 只是绕开了 RM,并没有解决「稀疏交互下的偏好估计」。更精细的 reward 建模(不确定性感知 / 保守 reward model、纳入更多用户信号)可能缓解实验中观察到的部分局限;但当反馈只覆盖目录的一小部分时,把可靠偏好推广到未见物品仍然困难。
- 噪声模型假设。理论保证依赖 sub-Gaussian reward 噪声;真实反馈可能有更重的尾部或更复杂的依赖结构。把分析扩展到更广的噪声模型、以及研究「改进的 reward 建模」与「离线策略优化」之间的相互作用,是未来方向。
10.3 我认为更值得指出的问题¶
- 理论与实验之间存在一道未被跨越的鸿沟:全部实验都是 $T=1$。论文最漂亮的理论结论——覆盖代价随 horizon 线性而非指数增长(式 (10))、噪声代价 $O(\sigma\sqrt{T\log|\mathcal{A}|})$——恰恰是唯一没有被实验触及的部分。$T=1$ 时式 (10) 退化为单项,$\sqrt{T}$ 因子消失。换句话说,被验证的只有「温度呈倒 U」这一条,而这一条在 contextual bandit 里就已成立,不需要轨迹级分析。理论中最有新意的多步部分完全缺乏实证。
- $\lambda^\star$ 的闭式解不可用,理论的实践指导价值因此被削弱。作者自己承认式 (9) 需要未知的 $\sigma$ 与 $p^\star$,只能经验调 $\lambda$。但论文没有尝试任何代理估计——例如用 reward 的重复观测方差估 $\sigma$、用行为策略在日志上的对数似然估 $\log(1/p^\star)$。哪怕给出一个粗略的量级预测再和实测峰值 $\lambda\approx0.5$–$1.0$ 对照,理论的说服力都会强很多。目前理论对实践的贡献仅止于「存在内点最优、去扫一遍」。
- 每个配置只跑一次训练,没有随机种子方差。附录 B.1 明确说明「each reported result corresponds to a single training run」,作者用「跨 5 指标 4 数据集一致」代替方差报告。ML-1M 的测试集只有 1,530 条,而 Exp-RSFT 相对 RSFT 的 NDCG@10 差距只有 0.0028(0.1437→0.1465,约 1.9%)——这个量级在单次运行 + 1,530 样本下很难说显著。ML-20M 的 +3.5% 与 Amazon Books 的 +2.0% 同理。真正拉开差距的只有 StreamCo(+106%),而它恰恰是无法复现、只报相对值的私有数据集。
- StreamCo 的 +106.20% 缺乏机制解释。公开集上 Exp-RSFT vs RSFT 只有 2–3.5%,工业集上却是翻倍,跨度接近 50 倍。论文没有报告 StreamCo 上的 $\lambda$ 取值、reward 尺度、噪声水平,也没有解释为什么差距会放大到这个程度。按理论,差距应当与 $\epsilon=\sigma\sqrt{2\log(2|\mathcal{T}|/\delta)}$ 相关,但 Table 1 显示 StreamCo 的物品数只有 O(Thousands),比 Amazon Books 的 69.5 万小两个数量级——按 $\log|\mathcal{A}|$ 的依赖关系,StreamCo 的噪声代价反而应该更小。这个反差没有被讨论。
- 没有线上 A/B。Netflix Research 的作者、拿到了私有流媒体数据集,却只报离线相对指标。对一篇主张「工业落地价值」的论文,缺少线上验证是明显短板——尤其考虑到本文的对照组 PPO/DPO 在离线指标上崩得如此彻底,一个线上实验能极大增强「离线排序指标确实代表用户满意度」这一隐含前提的可信度。
- 对 DPO 的实现方式可能不够公平。论文用「reward model 打分构造偏好对」来实例化 DPO,然后论证它崩溃。但这本来就是论文自己在 §2 指出的「把同一个问题重新引入」的做法。如果用日志中天然存在的偏好信号(例如同一 session 内 rating 4.5 vs rating 2 的物品对)构造偏好对,DPO 就不再依赖 RM,结论可能不同。论文没有给这个更强的 DPO 变体。
Avg Reward作为 reward hacking 证据存在循环性。Avg Reward 由同一个 reward model 打出,因此「RM 分高但排序差」在逻辑上只能说明 RM 与排序指标不一致,无法单独证明是策略在 hack RM 而非 RM 本身就与排序指标正交。不过 Table 2(RM 连 Item Mean 都打不过)在很大程度上补上了这个缺口。
10.4 方法论可扩展性¶
Exp-RSFT 在这一维度上表现良好:它不引入任何会固化的组件(无码本、无 value network、无独立的 RM、无两阶段解耦),只是在现有自回归目标上乘一个标量。式 (4) 的关键性质——「倾斜后的分布仍在同一自回归策略类内」——意味着骨干模型参数量 scaling 时,表征能力与序列建模能力可以一起增长,方法本身不构成瓶颈。反过来说,它的天花板也由骨干决定:它只能在行为策略的支撑内重新分配概率质量(式 (8) 第一项在 $p^\star\to0$ 时发散),永远无法发现日志中从未出现过的好轨迹——这是所有保支撑离线方法的共同上限,作者在 Theorem 4.4 的解读中已经诚实指出。