SetMIR: Multi-Interest Retrieval as Set Prediction¶
Snap Inc. · arXiv 2608.30251 · 2026-08-31 · cs.IR · KDD '27 ADS Track (Under Review)
作者全部来自 Snap Inc.(Bellevue / Seattle / Palo Alto / Santa Monica),共 16 人,通讯邮箱均为 @snapchat.com。这是一篇工业界 ADS(Applied Data Science)轨的短文(正文 9 页),主线只有一件事:把工业召回里的「多兴趣建模」重写成计算机视觉里的「集合预测(set prediction)」问题,用 DETR 的匈牙利匹配 + presence(存在性)头一次性解决多兴趣召回长期存在的两个病灶——训练侧的兴趣坍缩(interest collapse)与服务侧的静态派发(static dispatch)。
一、研究动机与背景¶
1.1 召回阶段与单向量双塔的天花板¶
大规模推荐系统的召回(retrieval)阶段要从百万到十亿量级的物料库里,为每个请求挑出几千个候选,再交给下游更重的 ranker 打分。主流架构是双塔神经网络:user tower 产出一个 user embedding,item tower 把整个目录索引起来,再用近似最近邻(ANN)按内积或余弦相似度取 top-$N$。
论文开篇就点出这个架构的结构性缺陷:
"A single user embedding is often too coarse for this task. A user may interact with streetwear, baby clothes, and skincare in the same week, yet an averaged representation favors dominant categories and misses narrower, short-lived ones."
一个用户可能在同一周里同时逛街头潮牌、婴儿服装和护肤品,但平均化的单一表示会偏向占比最大的类目,把窄众的、短时的兴趣直接抹掉。这不是数据量或模型规模能解决的问题——它是表示形式本身的容量上界。
1.2 多兴趣召回的两个遗留病灶¶
多兴趣召回(multi-interest retrieval)的思路很直接:给每个用户产出 $K$ 个 embedding,每个各发一次 ANN 查询,结果再合并。MIND、ComiRec、PinnerSage、SINE、MVKE、DCM、KuaiFormer 都在这条线上,区别只在于「这 $K$ 个 embedding 是怎么构造出来的」(胶囊路由 / 多头自注意力 / 稀疏全局原型激活 / 虚拟核专家 / 可微聚类 / 可学习 query token)。
但论文指出,落到生产环境里,两个问题始终没被解决:
(一)兴趣坍缩(interest collapse)。标准训练信号(MIND、ComiRec)用 $\arg\max_k \langle e_k, t\rangle$ 把每个 target 独立分配给离它最近的那个兴趣向量。后果有三层:
- 多个 target 可能撞进同一个 query;
- 没被任何 target 选中的 query 收不到任何梯度;
- 模型最终收敛到只有少数几个真正有效的兴趣。
(二)静态派发(static dispatch)。服务时无条件从全部 $K$ 个 embedding 各发一次 ANN。每请求的召回预算 $N$ 被摊在冗余或低质量的 query 上;而且没有 per-query 的质量信号,所以 $K$ 次 ANN 调用可能返回不足 $K$ 个真正有区分度的候选集,却把预算全花光了。
论文明确说,近期工作(Re4、Rethinking Multi-Interest)加了辅助正则项,但它们没有学「对某个特定用户请求,$K$ 个 embedding 中哪些应该真正去检索候选」。
1.3 与最接近的两个生产系统的关系¶
论文点名了两个离它最近的已部署系统:
- KuaiFormer(快手):架构上最接近——同样是在行为序列上跑 transformer、附加可学习 query token,证明了这条设计在生产规模上可行。SetMIR 沿用同一族架构,但替换掉它的 argmax 分配与固定 ANN 预算。
- DCM(Pinterest):用单次分配的可微聚类缓解了兴趣坍缩,但仍然是静态派发。
SetMIR 声称同时解决这两个问题,办法是把多兴趣召回形式化成集合预测。
1.4 与集合预测 / 多向量检索 / 可微选择的关系¶
这一节是论文自我定位最清晰的地方,值得完整摘出来:
与 DETR 的关系。集合预测的范式是「从固定大小的可学习 query bank 里产出一个可变大小的输出集合」,由 DETR 在目标检测上带火,Set Transformer、Perceiver IO、Q-Former 把可学习 query 推广到别的领域。SetMIR 继承了 DETR 的三件东西:可学习 query bank、匈牙利分配、给未匹配 query 的显式 absence 目标,但作用对象不同:
| DETR | SetMIR | |
|---|---|---|
| 预测目标 | 有界连续空间中的 box | 冻结的 item embedding 空间中的向量 |
| 监督形式 | 穷举标注 | 对比学习(InfoNCE) |
| ground truth | 图像中的全部物体 | 用户在未来窗口内的互动 |
| 未匹配 query 的含义 | 该位置没有物体 | 该窗口内不再有更多兴趣出现 |
| presence 分数的作用点 | 每个 query 都解码,absence 类只过滤输出 | 决定发出几次 ANN 检索 |
与 ColBERT 式多向量检索的关系。ColBERT / ColBERTv2 把每篇文档表示成很多向量,在打分时做 late interaction。SetMIR 反过来:每个 item 仍然是单向量,多重性只放在 user 侧,因此现有的单向量 ANN 索引(ScaNN、Faiss)可以原样复用,不需要任何改造。这是一个很关键的工程取舍。
与可微 top-$M$ 选择的关系。相比 Gumbel-Softmax 式的可微 top-$M$ 采样,presence 头支持每请求可变数量的激活 query,并且不需要温度调度和直通估计器(straight-through estimator)。
二、核心方法¶
2.1 问题形式化¶
给定用户按时间排序的互动历史 $\mathcal{H}_u = [v_1, v_2, \ldots, v_L]$,其中每个 $v_i$ 是一个「被互动的商品 + 互动类型」对。最近的高意图商品(购买 purchase、加购 add-to-cart、上滑 swipe-up)构成目标集合
$$\mathcal{T}_u = \{t_1, \ldots, t_W\} \subset \mathcal{V}$$
$\mathcal{V}$ 是 item 全集。更早的互动商品作为模型输入。目标数量 $W$ 因用户而异,且在推理时未知——这正是「集合预测」这个形式化的立足点。
召回任务是在服务预算约束下返回 top-$N$ 候选列表 $\mathcal{C}_u \subseteq \mathcal{V}$,使其对 $\mathcal{T}_u$ 有高 recall;预算约束是每请求最多 $K$ 个兴趣 embedding 可以查询 item 索引。因此 SetMIR 预测的是一组兴趣表示
$$\mathcal{P}_u = \{(e_k, p_k)\}_{k=1}^{K}$$
其中 $e_k \in \mathbb{R}^d$ 是兴趣 embedding,$p_k \in [0,1]$ 是 presence 分数,表示「query $k$ 是否对应用户当前的一个真实兴趣」。
2.2 架构¶
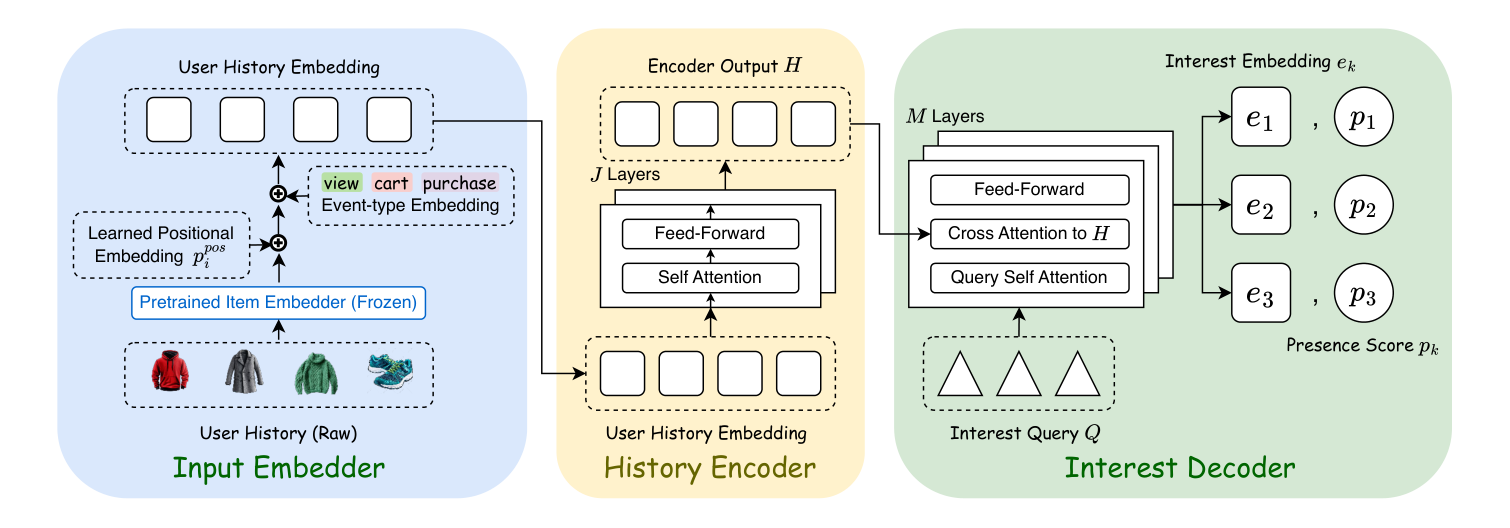
整个模型分三块:Input Embedder、History Encoder、Interest Decoder(带两个 per-query 输出头)。
Input embedder(输入嵌入器)。每个历史商品 $v_i$ 由一个冻结的预训练内容嵌入模型从其元数据(标题、品牌、类目、图片)编码成内容 embedding $\bar{x}_i \in \mathbb{R}^d$。再加上一个可学习的位置 embedding $p_i^{\text{pos}}$ 和一个 $\alpha$ 门控的事件类型 embedding:
$$x_i = \bar{x}_i + p_i^{\text{pos}} + \alpha\, c(\text{type}_i) \in \mathbb{R}^d \tag{1}$$
设计动机很讲究:事件类型 embedding $c(\cdot)$ 从零开始学,而标量 $\alpha$ 初始化为 0 并直接学习。这意味着模型从纯内容 embedding 空间起步,再逐渐把互动信号掺进来——避免随机初始化的事件 embedding 一上来就污染已经训好的内容表示空间。§4.2.4 的消融专门验证了这个设计。
History encoder(历史编码器)。一个标准的 $J$ 层 transformer encoder $\mathcal{E}_\theta$:
$$H = \mathcal{E}_\theta\big([x_1, \ldots, x_L]\big) \in \mathbb{R}^{L \times d} \tag{2}$$
带 $K$ 个可学习 query 的兴趣解码器。SetMIR 维护 $K$ 个跨用户共享的可学习兴趣 query $Q^{(0)} = [q_1, \ldots, q_K] \in \mathbb{R}^{K\times d}$,随机初始化并与模型其余部分联合训练。一个 $M$ 层 transformer decoder $\mathcal{D}_\phi$ 在「query 之间的自注意力」与「对编码后历史的交叉注意力」之间交替(略去残差连接和 LayerNorm):
$$\tilde{Q}^{(\ell)} = \text{SelfAttn}\big(Q^{(\ell-1)}\big) \tag{3}$$
$$\bar{Q}^{(\ell)} = \text{CrossAttn}\big(\tilde{Q}^{(\ell)}, H, H\big) \tag{4}$$
$$Q^{(\ell)} = \text{FFN}\big(\bar{Q}^{(\ell)}\big) \tag{5}$$
$\ell = 1, \ldots, M$。Query 自注意力的作用是让兴趣 query 在读历史之前先互通信息,从而鼓励不同 query 各自分化,而不是各自独立地去追同一个主导信号。这是架构层面的第一道防坍缩机制(第二道是训练损失里的匈牙利匹配,第三道是 margin diversity loss)。解码器输出 $Z = Q^{(M)} \in \mathbb{R}^{K\times d}$。
两个 per-query 输出头。对 $Z$ 的每一行 $z_k$:
$$e_k = \frac{W_e \,\text{LN}(z_k) + b_e}{\big\|W_e\, \text{LN}(z_k) + b_e\big\|_2} \in \mathbb{R}^d \tag{6}$$
$$p_k = \sigma\big(w_p^{\top}\,\text{LN}(z_k) + b_p\big) \in [0,1] \tag{7}$$
$\sigma(\cdot)$ 是 logistic sigmoid。$L_2$ 归一化让训练与线上服务保持一致(ANN 索引里的 item 向量也是 $L_2$ 归一化存储的,因此内积即余弦)。标量 presence 头估计「这个 query 对当前请求是否活跃」。
2.3 集合预测训练¶
目标集合的构造。target 商品先按 pid 去重;若同一 pid 出现多种事件类型,保留意图最强的那个(优先级 purchase > add-to-cart > swipe-up);再按意图强度截断到 $W_{\max} = 15$ 个。同一个冻结的预训练模型把每个 target 商品 $t_w$ 编码成 $\bar{t}_w \in \mathbb{R}^d$。注意 $W$ 可以超过 $K$。
匈牙利匹配。令 $\mathcal{A}_{K,W}$ 为所有一对一匹配 $A \subseteq [K]\times[W]$ 的集合,满足 $|A| = \min(K, W)$ 且不重复使用任何 query 或 target。求解
$$\hat{A} = \arg\min_{A \in \mathcal{A}_{K,W}} \sum_{(k,w)\in A} \Gamma_{k,w}, \qquad \Gamma_{k,w} = -\lambda_{\text{emb}}\, e_k^{\top}\bar{t}_w - \lambda_{\text{cls}} \log \sigma(\ell_k) \tag{8}$$
其中 $\ell_k$ 是 sigmoid 之前的 presence logit。embedding 项偏好几何上接近的 query-target 对;class 项把匹配器往「模型已经认为存在的 query」上偏。取 $\lambda_{\text{emb}}=1$、$\lambda_{\text{cls}}=0.5$,且 class 项在前 10% 训练步内线性 warm-up,使早期匹配主要由 embedding 几何驱动(否则一个还没训好的 presence 头会一开始就把匹配锁死)。$K=10$ 时每个用户是一个很小的 $K\times W$ 指派问题,求解开销可忽略。
记 $\mathcal{M}_u = \{k : (k,w)\in\hat{A}\}$ 为匹配上的 query 下标,$|\mathcal{M}_u| = \min(W, K)$;$\mathcal{U}_u = [K]\setminus \mathcal{M}_u$ 为未匹配("no-interest")query。
InfoNCE 检索损失。对每个匹配对 $(k,w)\in\hat{A}$,用 in-batch sampled-softmax(InfoNCE)损失。被指派的 target $\bar{t}_w$ 是正样本,数据并行 mini-batch 内跨 GPU 汇总的全部有效 target embedding 构成对比池 $\mathcal{N}$(因此包含 $\bar{t}_w$ 自身):
$$\mathcal{L}_{\text{InfoNCE}}(u) = -\frac{1}{|\hat{A}|}\sum_{(k,w)\in\hat{A}} \log \frac{\exp\big(e_k^{\top}\bar{t}_w / \tau_r\big)}{\sum_{\bar{t}'\in\mathcal{N}} \exp\big(e_k^{\top}\bar{t}' / \tau_r\big)} \tag{9}$$
$\tau_r$ 是 InfoNCE 温度,padding 的 target 项被 mask 掉。只有匹配上的 query 参与 $\mathcal{L}_{\text{InfoNCE}}$;未匹配的 query 不被拉向任何 target 方向。
Presence 损失。匹配器识别出哪些 query 在这条样本上被用到,presence 头就学着预测这个指派结果。给定 presence 分数 $p_k$ 与二值标签 $y_k = \mathbb{1}[k\in\mathcal{M}_u]$:
$$\mathcal{L}_{\text{Pres}}(u) = -\frac{1}{K}\sum_{k=1}^{K}\Big[y_k \log p_k + (1-y_k)\log(1-p_k)\Big] \tag{10}$$
论文对这两个损失的分工有一句很到位的总结:
"This absence signal is the mechanism missing from argmax-trained multi-interest models: when targets independently choose their closest query, unmatched queries receive no direct supervision and can collapse or drift."
匹配上的 query 被拉向指派给它的 target;未匹配的 query 只收到一个 $y_k = 0$ 的 presence 目标。这个「缺席信号」正是 argmax 训练的多兴趣模型所缺的机制——当 target 各自独立地挑最近的 query 时,未被挑中的 query 没有任何直接监督,于是坍缩或漂移。
Margin 多样性损失。再加一个轻量的成对排斥项,阻止活跃 query 变得几乎相同。令 $a_k = \mathbb{1}[p_k > 0.5]$ 为一个 detach 掉的硬活跃掩码(梯度不流过阈值):
$$\mathcal{L}_{\text{Div}}(u) = \frac{\sum_{i\neq j} a_i a_j \max\big(0,\; e_i^{\top}e_j - m\big)}{\max\big(1,\; \sum_{i\neq j} a_i a_j\big)} \tag{11}$$
margin $m = 0.3$。活跃 query 少于两个时该损失为 0;否则只惩罚余弦相似度超过 $m$ 的活跃对,已经分开的 query 保持不动。论文特意强调:与 ComiRec 的可控性项(在推理时施加)不同,这一项是在训练时塑造检索几何。
总损失。对一个 mini-batch 的用户 $\mathcal{B}$:
$$\mathcal{L} = \frac{1}{|\mathcal{B}|}\sum_{u\in\mathcal{B}}\Big[\lambda_R \mathcal{L}_{\text{InfoNCE}}(u) + \lambda_P \mathcal{L}_{\text{Pres}}(u) + \lambda_D \mathcal{L}_{\text{Div}}(u)\Big] \tag{12}$$
2.4 推理:从固定 $K$ 到动态 $\tilde{K}$¶
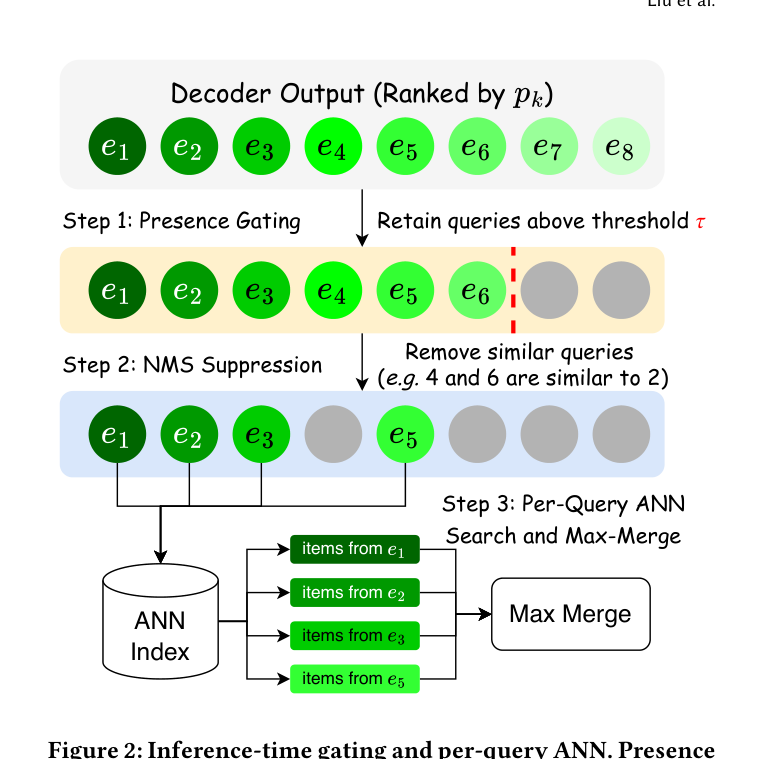
服务时一次前向编码历史、解码 $K$ 个兴趣 query,得到 $\{(e_k,p_k)\}_{k=1}^K$,然后经三个轻量步骤把固定 query bank 变成动态的 $\tilde{K}\le K$ 次 ANN 查询。
Step 1:Presence 门控。保留 presence 超过阈值 $\tau$ 的 query:
$$\mathcal{S}_1 = \{\,k \in [K] : p_k > \tau\,\} \tag{13}$$
如果没有任何 query 过阈,兜底保留 presence 最大的那一个(保证至少发一次检索)。
Step 2:Query 级非极大值抑制(NMS)。把 $\mathcal{S}_1$ 按 $p_k$ 降序排列,在 query-query 余弦相似度上做 NMS:若某 query 与任一更高 presence 的已保留 query 的余弦相似度超过 $\delta_{\text{NMS}}$(取 0.9),则移除它。存活集合 $\mathcal{S}_2 \subseteq \mathcal{S}_1$,$|\mathcal{S}_2| = \tilde{K}$。
Step 3:逐 query ANN 检索 + max-merge。每个存活 query $k\in\mathcal{S}_2$ 从 item 索引取 top-$M_q$ 个 item,取 $M_q = \lceil N/\tilde{K}\rceil$,使总检索深度随 $\tilde{K}$ 变化时保持近似恒定。被多个 query 返回的 item 按最大分数合并:
$$s(t\mid u) = \max_{k\in\mathcal{S}_2} e_k^{\top}\bar{t} \tag{14}$$
最终按 $s(t\mid u)$ 取 top-$N$ 构成候选列表。
值得注意的是,式 (14) 的打分函数 在形式上就是 ColBERT 的 MaxSim——只不过多重性放在 query 侧而非 document 侧。论文自己在 §2 里把 ColBERT 摆在「对立面」(document 侧多向量、需要改索引),但没有点破自己的 max-merge 其实同属一个算子族。这一点在下文的对比章节还会回来。
三、实验设置¶
数据集。Snap DPA(Dynamic Product Ads)的用户-商品互动日志。广告主目录含数亿商品,事件流包括 view、swipe-up、add-to-cart、purchase。对每个用户,目标集合 $\mathcal{T}_u$ 取最近 3 天窗口内的全部高意图事件,按 pid 去重并截断到 $W_{\max}=15$(论文称这在训练数据里对大多数用户都保留了全部高意图 target)。历史序列取窗口开始时刻严格之前的全部事件,截断到最近 $L=40$ 条。用户被划分为不相交的 train / validation / test 集合。Item embedding 由一个单独预训练的内容嵌入模型离线算好、冻结、以 $L_2$ 归一化向量存储,在 SetMIR 训练与评估全程不变。
评测池。所有离线结果在约 100 万用户的留出测试集上报告,对应约 530 万商品的 target 池。validation split 同样约 100 万用户,用于选择 presence 阈值 $\tau$、NMS 阈值 $\delta_{\text{NMS}}$ 与各方法的收敛 checkpoint,因此没有任何被报告的数字参与了这些选择。
指标。R@$N$($N\in\{1,5,10,100\}$)、HR@100、NDCG@100、MRR,以及服务侧的 $\tilde{K}$(门控 + NMS 后每请求平均 ANN 查询数)。「Per Snap's policy, we report only relative metric lifts.」——按 Snap 政策只报相对提升,全部绝对值缺失。
实现与超参。
| 组件 | 配置 |
|---|---|
| History encoder | 2 层 transformer,8 头,$d_{ff}=1024$,dropout 0.1 |
| Interest decoder | 6 层,同宽度 / 头数 / dropout |
| 隐藏维度 $d$ | 128 |
| 可学习参数量 | 约 3M |
| 优化器 | AdamW,peak lr $5\times10^{-4}$,4000 warm-up steps,weight decay 0.01,cosine decay |
| 硬件 / batch | 8×A100-40GB,每 GPU 1536 用户,bfloat16 混合精度 |
| InfoNCE 温度 $\tau_r$ | 0.05 |
| Diversity margin $m$ | 0.3 |
| 损失权重 | $\lambda_R=1.0$,$\lambda_P=0.5$,$\lambda_D=0.1$ |
| 匈牙利 class 项 $\lambda_{\text{cls}}$ | 0.5,前 10% 步线性 warm-up |
| 推理默认 | $\tau=0.3$,$\delta_{\text{NMS}}=0.9$,$K=10$ |
四、主要实验结果¶
4.1 与四个已学习多兴趣召回器的对比¶
Table 1(所有指标归一化到 SetMIR = 100%):
| Method | $\tilde{K}$ | R@1 | R@5 | R@10 | R@100 | HR@100 | NDCG@100 | MRR |
|---|---|---|---|---|---|---|---|---|
| MIND | 10.00 | 45.7% | 50.7% | 52.9% | 61.7% | 58.2% | 54.3% | 44.4% |
| ComiRec-SA | 10.00 | 67.4% | 83.5% | 89.8% | 99.9% | 99.6% | 89.8% | 80.0% |
| DCM | 10.00 | 26.0% | 34.5% | 37.4% | 49.3% | 48.8% | 39.3% | 29.1% |
| KuaiFormer | 10.00 | 43.0% | 47.6% | 52.0% | 62.8% | 64.1% | 52.3% | 42.2% |
| SetMIR (argmax) | 2.16 | 62.1% | 63.2% | 63.5% | 69.1% | 73.2% | 63.1% | 56.4% |
| SetMIR | 6.70 | 100% | 100% | 100% | 100% | 100% | 100% | 100% |
实验条件的公平性声明(很重要,直接影响结论强度):所有行共享同样的训练数据、同样的冻结 item embedding、$K=10$、同样的优化器与 batch size、同样的每请求召回预算;只在兴趣抽取架构与 target-to-query 分配方式上不同。baseline 没有 presence 概念,因此派发全部 $K$ 个 query($\tilde{K}=K$),这也正是它们在生产中的静态派发做法。每个方法训到各自收敛,而非统一步数:MIND / ComiRec-SA / DCM 在 60K 步内到顶,KuaiFormer 约 100K,SetMIR 160K。
论文自己也承认了一个关键的不对称:SetMIR 消费的是一个冻结的预训练 item 塔,而四个 baseline 原本都是把 item embedding 与 user 侧联合学习的,因此「这是对兴趣抽取机制的受控对比,而不是对已发表结果的端到端复现」。此外 MIND 的 ReLU 输出层被去掉(否则冻结 item 塔会把 query 限制在非负象限),DCM 与 KuaiFormer 没有公开代码、是照论文重新实现的。
结论分析:
- SetMIR 在每一个指标上都最强,且优势在排序顶部最宽——这恰是下游 ranker 真正消费的位置。最强 baseline ComiRec-SA 只有 SetMIR 的 67.4% R@1 和 80.0% MRR,但在深度上追平(99.9% 的 R@100、99.6% 的 HR@100)。论文的解读很克制:注意力路由能捞回一个相似的候选池,但把它排得更差。
- MIND 与 DCM 落后最多(R@10 只有 52.9% 与 37.4%)。两者都是几何式构造兴趣(胶囊路由 / 可微聚类),且都是为「item 塔与 user 侧联合学习」设计的;DCM 还额外承担了重新实现的风险。论文明确说这两行应读作「这些机制在冻结 item 空间下如何表现」的证据,而不是对已发表系统的判决。这个自我限定是诚实的。
- KuaiFormer 这一行值得单独看:它是架构上与 SetMIR 最接近的(历史上的 transformer + 可学习 query token),容量相当、数据与 item embedding 相同,却只有 SetMIR 的 52.0% R@10。差距因此指向「query 是怎么被监督的」——这正是下一节的 SetMIR (argmax) 行要直接隔离的变量。
- SetMIR 做到这些的同时,每请求只发 6.70 次 ANN,对 baseline 的 10 次少了 33%。
4.2 组件消融(Table 2)¶
每行只移除一个机制,架构、数据与其余损失保持不变,归一化到 SetMIR,$\tilde{K}$ 在 $\tau=0.3$ 下取绝对值:
| Variant | $\tilde{K}$ | R@1 | R@5 | R@10 | R@100 | HR@100 | NDCG@100 | MRR |
|---|---|---|---|---|---|---|---|---|
| SetMIR (full) | 6.70 | 100% | 100% | 100% | 100% | 100% | 100% | 100% |
| − presence loss | 8.23 | 97.1% | 90.4% | 91.4% | 91.3% | 88.4% | 92.9% | 97.4% |
| − diversity loss | 7.55 | 88.5% | 90.6% | 93.2% | 91.8% | 91.5% | 93.3% | 95.7% |
| argmax assignment | 2.16 | 62.1% | 63.2% | 63.5% | 69.1% | 73.2% | 63.1% | 56.4% |
这是全文最重要的一张表,因为它直接回答「收益到底来自哪里」。
- 把匈牙利匹配换成 per-target argmax,损失 36.5% 的 R@10 和 43.6% 的 MRR,并把平均活跃 query 数从 6.70 砸到 2.16(满分 10)。机制解释:target 争抢那个已经离它最近的 query,其余 query 永远收不到检索梯度,模型最终稳定在大约两个有效兴趣上——这就是兴趣坍缩的量化画像。
- Presence 损失(去掉后 R@10 降到 91.4%)的作用是「让门控变得可学」:不加监督时 $\sigma(\ell_k)$ 不携带任何关于「这个 query 是否有必要」的信息,于是 $\tau=0.3$ 的阈值放进来 8.23 个 query 而不是 6.70 个,却还丢了 recall——更多的调用换更少的回报。
- Diversity 损失(去掉后 R@10 降到 93.2%)作用于 query 冗余:去掉后 $K$ 个 query embedding 的平均成对余弦从 0.298 升到 0.321。
- 三者之中分配方式占绝对主导:36.5% vs 8.6%(presence)与 6.8%(diversity)。论文的定性总结是「一对一匹配承担了检索质量,另两个损失贡献更小、更独立的效果」。
4.3 $K$ 扫描(Table 3)¶
只变 $K$,其余配置固定,归一化到 $K=1$ = 100%:
| $K$ | $\tilde{K}$ | R@1 | R@5 | R@10 | R@100 | HR@100 | NDCG@100 | MRR |
|---|---|---|---|---|---|---|---|---|
| 1 | 1.00 | 100% | 100% | 100% | 100% | 100% | 100% | 100% |
| 3 | 3.00 | 108.4% | 133.5% | 137.5% | 137.2% | 110.8% | 130.7% | 112.4% |
| 5 | 4.72 | 113.2% | 145.8% | 151.1% | 148.6% | 113.3% | 141.6% | 117.2% |
| 7 | 5.75 | 112.3% | 147.6% | 154.7% | 151.9% | 114.2% | 144.2% | 117.8% |
| 10 | 6.70 | 113.0% | 148.3% | 155.0% | 152.8% | 114.1% | 145.8% | 118.9% |
| 15 | 7.59 | 112.8% | 148.6% | 155.1% | 152.6% | 114.1% | 145.9% | 118.4% |
三个模式:
- 增大 $K$ 带来大幅 recall 增益:$K=10$ 达到 $K=1$ 的 155% R@10 与 153% R@100;最大的一跳在 $K=1\to3$,说明少数几个额外兴趣 query 就吃掉了大部分可得收益。
- 增益在更深的检索深度上更大:$K=1\to10$ 在 R@10/R@100 上是 +55%/+53%,在 R@1/HR@100 上只有 +13%/+14%——与「多兴趣是在拓宽候选面而不仅仅是改善头名命中」的直觉一致。
- 增益逐渐饱和:$K=7$ 已达 $K=10$ 的 99.8% R@10,$K=15$ 在所有列上与 $K=10$ 相差 ±0.5% 以内。$\tilde{K}$ 列把这一点讲得更透:$\tilde{K}$ 随 $K$ 次线性增长($K=5$ 时 4.72,$K=10$ 时 6.70,$K=15$ 时只有 7.59),即使给 15 个 query,模型平均也只承诺不到 8 个。有效兴趣数由数据决定,而不是由 $K$ 决定——这条结论比数字本身更有价值。
4.4 事件类型 embedding(Table 4)¶
隔离 §2.2 的 $\alpha$ 门控事件类型 embedding,报告相对「无事件类型 embedding baseline」的百分比变化:
| Steps | ΔR@1 | ΔR@5 | ΔR@10 | ΔR@100 | ΔHR@100 | ΔNDCG@100 | ΔMRR |
|---|---|---|---|---|---|---|---|
| 30K | +5.1% | +2.6% | +3.0% | +1.7% | +0.5% | +2.9% | +3.0% |
| 60K | +7.6% | +5.6% | +4.0% | +1.8% | +0.5% | +4.3% | +5.3% |
| 120K | +8.2% | +6.9% | +5.0% | +3.2% | +1.6% | +5.2% | +5.6% |
结论:事件信号一致有帮助,且效果随训练时长增长。因为 $\alpha$ 初始化为 0,模型先与无事件 baseline 持平,再逐渐学「该掺多少事件类型信息」——R@10 增益从 +3.0% 升到 +5.0%。增益在排序顶部最强(ΔR@1 = +8.2% vs ΔR@100 = +3.2%),恰好与 $K$ 扫描互补(后者的多兴趣增益在深度上更明显)。这两个机制在不同位置起作用,是个不错的观察。
4.5 数据规模扫描(Table 5)¶
只变训练用户数,归一化到最小规模(100K 用户)= 100%:
| Train users | R@1 | R@5 | R@10 | R@100 | HR@100 | NDCG@100 | MRR |
|---|---|---|---|---|---|---|---|
| 100K | 100% | 100% | 100% | 100% | 100% | 100% | 100% |
| 1M | 179.1% | 181.2% | 179.2% | 166.9% | 145.1% | 175.1% | 171.0% |
| 10M | 247.5% | 262.5% | 258.4% | 218.5% | 169.7% | 243.3% | 231.2% |
性能随训练数据平滑扩展:1M 用户把 R@100 拉到 1.66×、HR@100 到 1.45×;10M 用户进一步到 2.18× 与 1.69×。注意这是数据 scaling,不是参数 scaling——模型只有约 3M 参数,论文没有做任何参数量扫描。
4.6 推理时门控与派发削减(Table 6)¶
同一个 $K=10$ checkpoint 在三种派发策略下服务,不重训,归一化到 static all-$K$ = 100%:
| Dispatch policy | ANN calls | R@1 | R@10 | MRR |
|---|---|---|---|---|
| static all-$K$($\tau=0$) | 10.00 | 100% | 100% | 100% |
| + presence gating($\tau=0.3$) | 7.73 | 101.9% | 99.4% | 100.7% |
| + query-level NMS($\delta=0.9$) | 6.70 | 101.8% | 99.2% | 100.7% |
结论分析:
- 门控贡献了绝大部分削减(10 → 7.73,占 10 → 6.70 全程的大头),并且略微改善了 R@1 和 MRR——因为抑制低置信 query 剔除了那些本会稀释合并列表的候选。这是一个「省算力顺便涨指标」的少见组合。
- 两个旋钮互补而非可替代:门控问的是「用户到底有没有这个兴趣」(presence 头被训来回答这个),NMS 施加的是纯几何测试、作用于门控的幸存者,各自剔掉对方留下的调用。
- 把门槛放到 $\tau=0.30$ 以下收益甚微(99.4% → 100% R@10 换 7.73 → 10 次调用),所以线上部署 $\tau=0.30$ 与 $\delta_{\text{NMS}}=0.90$。
4.7 线上 A/B 实验(Table 7)¶
SetMIR 作为一个新的召回源部署到 Snap DPA 生产栈,做线上 A/B,下游 ranker 保持不变。SetMIR 使用其默认推理策略,以及由同一个预训练内容嵌入模型构建的它自己的 ANN 索引。实验在「一个有代表性的线上流量切片」上跑了约一周;「exact traffic fractions, sample sizes, and significance thresholds are omitted per Snap's policy」——确切流量比例、样本量与显著性阈值按 Snap 政策省略。
| Metric | (a) Δ vs control | (b) Δ SetMIR vs I2I |
|---|---|---|
| CTR | +0.21% | +44% |
| CVR | +3.11% | +51% |
(正文另报:user impressions +0.10%。)
(a) 对生产栈的整体贡献。control 保留现有 Snap DPA 召回组合;treatment 在全局召回配额不变的前提下新增 SetMIR 这一路召回源。加入 SetMIR 带来 impressions +0.10%、CTR +0.21%、CVR +3.11%。
(b) 对 item-to-item 召回源的逐源对比。I2I 召回把用户最近互动过的高意图商品直接当作 ANN 种子派发出去,与 SetMIR 共享同样的输入信号、同样的冻结 item embedding、同样的 ANN 索引、同样的每源召回配额,两者只在「query 向量是怎么产生的」这一点上不同。由于 I2I 本身每请求也派发若干种子,这是两种「挑一小组 query 向量」方式之间的对比,且服务成本相当(都发几次单向量 ANN 查询)。在 treatment 臂内部把互动归因到各源,SetMIR 相对 I2I 拿到 CTR +44%、CVR +51%。
4.8 定性分析(Figure 3)¶
论文用一个用户可视化了兴趣坍缩:该用户历史横跨 shirts & tops、pants、dresses、shoes、skirts、handbags、accessories 七个类目,单 query($K=1$)baseline 只返回 pants。SetMIR 的五个活跃 query 各自专精一个类目:
| head | $\sigma(\text{presence})$ | NMS 结果 | 类目 |
|---|---|---|---|
| head 3 | 0.976 | kept | Shirts & Tops |
| head 1 | 0.959 | dropped(与 head 3 重复) | Shirts & Tops |
| head 9 | 0.947 | kept | Dresses, Skirts |
| head 5 | 0.708 | kept | Pants |
| head 0 | 0.683 | kept | Apparel & Accessories, Hats, Earrings |
| head 7 | 0.526 | kept | Shoes |
这张图同时展示了三件事:单向量的坍缩、presence 分数与「兴趣强度」的直觉一致性、以及 NMS 确实在剔除近重复 query(head 1 因与 head 3 重叠被抑制)。
五、核心贡献总结¶
- 把多兴趣召回形式化为集合预测:$K$ 个可学习 query 预测一个可变大小的兴趣集合,在训练目标层面消除兴趣坍缩,而不是像已有工作那样靠辅助正则项打补丁。
- 用自适应检索替代静态派发:presence 门控 + query 级 NMS,每请求激活 $\tilde{K}\le K$ 个 query,性能与全 $K$ 检索持平(99.2% R@10)而 ANN 调用少 33%,R@1 反而略升。
- 多重性只放 user 侧:item 保持单向量,现有单向量 ANN 索引原样复用,这是这套方案能低成本上线的关键工程判断。
- 完整的工业验证:对四个已学习多兴趣召回器的受控离线对比 + Snap DPA 生产栈的线上 A/B。
六、与已归档相关工作的对比¶
LIMIT On the Theoretical Limitations of Embedding-Based Retrieval (Google DeepMind, 2025-08-28)¶
关系:独立并发 / 理论–工程殊途同归(SetMIR 未引用该文,参考文献中无 Weller et al.)· 已加载对方精读
- 共同关注的问题:两篇论文指向同一个 root cause——固定维度的单向量表示存在可实现 top-$k$ 集合的容量上界。LIMIT 用球堆积论证给出严格形式:若 $n$ 个单位文档向量的每个 $k$-子集都要被某个 query 以 margin $\gamma$ 实现,则必须有 $\binom{n}{k}\le(1+1/\gamma)^d$,即 $d \ge \log\binom{n}{k}/\log(1+1/\gamma)$;并构造了 LIMIT 数据集,让所有 SOTA 单向量 embedder 集体失败(4096 维、recall@100 仍在个位数到十几)。SetMIR 从工业侧给出同一件事的经验画像:Figure 3 里一个横跨七个服饰类目的用户,单向量召回只返回 pants——这正是「可实现的 top-$k$ 集合被维度锁死」在推荐语境下的具体形态。
- 相近的技术骨架:LIMIT 的处方是「转向 cross-encoder / 多向量 / 更具表达力的相似度函数」,实测多向量的 GTE-ModernColBERT 明显优于所有单向量模型;SetMIR 的检索打分函数 $s(t\mid u)=\max_{k\in\mathcal{S}_2} e_k^{\top}\bar{t}$(式 14)在算子形式上正是 ColBERT 的 MaxSim。两者抽象重合为同一条路径:用「多向量 + max 聚合」把打分函数从单个内积升级成一族内积的上包络,从而绕开 LIMIT 定理约束的那个假设。
- 本文的差异与推进:LIMIT 的定理是关于「一个 query 向量对一组文档向量」的配置;SetMIR 把多重性放在 query(user)侧而非 document(item)侧,因此 item 索引保持单向量、ANN 基础设施零改造——这是 LIMIT 处方在工业召回栈上唯一低成本可落地的方向(把每个 item 变成多向量意味着重建整个索引)。此外 SetMIR 补上了 LIMIT 完全没有涉及的两件事:这 $K$ 个向量该怎么训才不塌(匈牙利一对一分配 + 缺席监督),以及该发几个向量去查(presence 门控 + NMS)。反过来,LIMIT 为 SetMIR 的动机提供了它自己没有给出的理论依据——SetMIR 的开篇论断「单个 user embedding 太粗」在原文里只是经验观察加一个例子。
- 可比的方法 / 实验差异:LIMIT 是理论 + 诊断数据集,不提出检索模型,实验在公开自然语言检索数据上做(LIMIT small 上 GTE-ModernColBERT recall@100 达 54.8/99.1,单向量模型个位数);SetMIR 是生产系统,全部数字是 Snap DPA 私有数据上的相对值。两者没有任何可直接并列的数字,可比的只有结论方向。需要如实指出的不对称是:LIMIT 严格证明的是单向量的界,而对多向量(MaxSim)、cross-encoder、sparse 模型的理论界作者明确留作 future work——所以 SetMIR 的 max-merge 究竟把容量提升了多少,两篇论文都没有回答,SetMIR 的 $K$ 扫描饱和($K=7$ 已达 $K=10$ 的 99.8%)恰恰暗示这个提升是有限且很快触顶的。
Step 2.5 剔除的近似候选(问题或解法不同源,如实剔除): TransRetrieval TransRetrieval(Alibaba,2026-08-26)——同在召回层、同样抱怨「一个内积不够用」,但 root cause 与处方相反:它归因于内积打分函数锁死了跨特征交互,处方是放弃双塔、改做允许任意跨特征交互的逐候选 model-based retrieval(并用 Kuaiformer 编码器放大只从 0.485 到 0.495 的近乎平坦的 scaling 曲线来论证);SetMIR 则完整保留双塔内积与 ANN 索引,只在 user 侧加多路。解法路径互斥而非重合,剔除。 EGR EGR(同为 Snap,2026-07-25)——同公司、同召回层、同 ANN 索引,但 root cause 是「item 表示空间与 query 空间没有端到端一起塑形(隔着离散 SID 或一次先冻结再训练)」,解法是共享 LLM backbone 联合优化;SetMIR 恰恰冻结 item 塔,正是 EGR 批评的那种做法。问题不同源,剔除(这一张力在下节局限性中另作讨论)。 Multi-Decoder OneRec Multi-Decoder OneRec(Kuaishou,2026-07-29)——表面同样是「把多路召回收进一个模型并做派发」,但它的「多路」是不同业务目标(曝光 / 点击 / 转化),靠 per-objective LoRA expert 隔离,且是生成式 SID 召回;SetMIR 的「多路」是同一目标下的多兴趣。问题不同源,剔除。 LLM-Native TT LLM-Native TT(Meta,2026-07-28)——同在召回层、同样反对一条主流路线,但它坚持单向量用户表示(EOS pooling + 单步 latent reasoning),核心是 cross-encoder 蒸馏;与 SetMIR 的多向量路线正相反,剔除。 Cluster GOOBS Cluster GOOBS(Meta)与 CS3 CS3(Kuaishou)——都是双塔召回的训练侧改进(难负样本采样 / 在线学习结构),不触及用户侧表示的多重性,剔除。
七、讨论与局限性¶
7.1 收益归因核验:来自 set prediction 范式,还是来自「更多兴趣向量」?¶
「把多兴趣检索建模成集合预测」是一个很有吸引力的框架叙事,因此必须分清收益是来自建模范式本身,还是来自「更多向量 / 更大容量」这种正交因素。这篇论文难得地把决定性消融跑了出来,结论对它有利,但归因的机制解释比论文声称的更窄。
(1)决定性证据存在,且方向明确。 SetMIR (argmax) 这一行就是「同架构、同 $K=10$、同容量、同数据、同 item embedding,只把集合分配换成朴素多向量的 per-target argmax 损失(MIND / ComiRec 的做法)」。它掉了 36.5% 的 R@10、43.6% 的 MRR。所以「把 set 损失换成朴素多向量损失后差距很小」这一怀疑在本文数据上不成立——差距非常大。同时 $K$ 扫描表明容量本身也贡献显著($K=1\to10$ 在集合目标固定下 +55% R@10)。两条轴都实打实有贡献,且论文都做了隔离,这不是「引入新信号 ≠ 收益来源」的典型案例。
(2)但「分配」的收益有一部分就是容量收益,需要把它剥出来。 argmax 变体的 $\tilde{K}$ 从 6.70 塌到 2.16,也就是说这个对比在效果上部分等价于「6.7 个有效兴趣向量 vs 2.16 个」——容量这条轴又混进来了。可以用两张表交叉验算把它剥开:Table 3 的 $K=10$ 行就是 SetMIR full,因此 Table 3 与 Table 2 共享同一个分母。$K=3$($\tilde{K}=3.00$)达到 SetMIR full 的 $137.5/155.0 = 88.7\%$ R@10,$K=1$ 达到 $100/155.0=64.5\%$。在 $\tilde{K}=1\to3$ 之间线性内插,$\tilde{K}=2.16$ 「应该」值约 78.5%。而 argmax 实际只有 63.5%,几乎等于单 query 模型的水平。结论:argmax 不只是让活跃 query 变少,它还让残存的那几个 query 变差——一对一分配确实带来了约 15 个百分点、无法用「活跃向量数量」解释的净收益。这是支持论文主张的最硬的一条推理,而且是论文自己没有做的交叉验算。
(3)机制归因比论文的叙事更窄:起作用的很可能是「单射性」而非「集合性」。 三点保留:
- 这里没有集合级损失。式 (9) 是匹配对上的 InfoNCE 逐对求和,不是任何置换不变的集合损失(无 Chamfer、无 Sinkhorn、无集合级打分)。从 DETR 借来的实际只有两件东西:一个二部匹配器和给未匹配 query 的 absence 目标。「as set prediction」这个标题承担的叙事分量,超过了它的机械内容。
- 匈牙利求解的「最优性」从未被消融。论文诊断的病因是「未匹配 query 收不到梯度」,那么真正起作用的很可能是单射性(每个 query 都拿到一个 target、都拿到梯度),而不是指派成本最优。缺一个关键对照组:随机的一对一分配(或贪心分配)。如果随机单射就能拿到大部分收益,那 $O(K^3)$ 的匈牙利求解在工程上完全可以省掉。这个消融的缺失,使「set prediction 范式」的功劳有一部分可能应记在更平凡的「负载均衡」头上。
- 被匹配的「集合」是 item 的袋子,不是兴趣的集合。target 是用户 3 天窗口内按 pid 去重、按意图强度截到 15 个的高意图商品。若一个用户买了 10 条裤子,匈牙利匹配会强迫 10 个不同的 query 各去追一条裤子——这在 item 层面是反多样性的压力。论文需要额外挂一个 margin diversity loss(式 11)来把 query 推开,本身就是「target ≠ interest」这个假设不干净的证据。$K$ 扫描里 $\tilde{K}$ 的次线性增长($K=15$ 时只有 7.59)说明模型确实学会了不滥用 query,但这更像是 presence 头 + diversity 项的功劳,而非一对一分配的。
小结:收益不是来自「更多兴趣向量」这一个正交因素——论文用同容量的 argmax 对照证明了这一点,且交叉验算显示分配带来约 15pp 的净增益。但收益也不是来自「集合预测」这个范式的全部内涵;可被现有证据支持的机制只有两条很具体的:(i)保证每个 query 都收到梯度的单射分配,(ii)一个被匹配结果监督的二值 presence 头。剩下的框架叙事目前是修辞,不是被验证的机制。
7.2 部署证据强度核验¶
部署是真的,实验设置的控制变量做得相当干净,但统计严谨性很薄,而且摘要与结论里领衔的两个数字恰恰是识别最弱的那两个。
证据强的部分:
- 明确「deployed as a new retrieval source in the Snap DPA production stack」,跑了真实线上 A/B,下游 ranker 全程固定,且 treatment 不改变全局召回配额(只新增一路源)——这是干净的因果设置:+3.11% CVR 可以归因给「多了这一路召回」。
- (b) 的逐源对比控制得很细:同输入信号、同冻结 item embedding、同 ANN 索引、同每源召回配额、可比的服务成本,两者只差「query 向量怎么产生」。
证据弱的部分:
- 没有流量比例、没有样本量、没有显著性阈值、没有置信区间——原文直接写明按 Snap 政策省略。时长只有约一周,且只有单次实验,没有复现或反转实验。
- 三个组级指标里只有 CVR 是大数:impressions +0.10%、CTR +0.21% 基本在噪声量级,唯一支撑全文业务主张的 +3.11% CVR 恰恰是事件最稀疏、方差最大的那个指标,却连一个误差棒都没有。DPA 这类商品广告的转化通常还有较长的归因窗口,一周的观测期对 CVR 尤其不宽裕。
- 摘要领衔的 +44% CTR / +51% CVR 不是随机化对比,而是 treatment 臂内部的互动归因。两个问题:(i) 合并候选池里同一个 item 可以被多路源同时召回,归因规则决定这个数字,而论文没有说明用的是哪种归因;(ii) 对照物 I2I 是把用户刚买过 / 加过购物车的商品直接当 ANN 种子的启发式,结构上必然大量召回「已购近重复品」,在 CVR 上是个偏弱的对照。SetMIR 的训练目标又直接就是 purchase / add-to-cart / swipe-up,与归因所用的转化信号高度同源。这两个数字应读作「学习式 query 生成优于最朴素的启发式种子派发」的量级示意,而不是 44%/51% 的业务增量。
- 33% 的 ANN 削减是离线测得的 $\tilde{K}$,不是线上实测的延迟 / QPS / 成本节省。论文没有给任何线上服务指标(P99、CPU、ANN 服务负载)。
- 没有说明 SetMIR 是否已全量放开、在线上稳定运行了多久。
综合判断:部署是实的,设置是讲究的,但证据强度停在「一次为期约一周、无统计口径披露的单实验」,且真正随机化的净收益是 CVR +3.11%。这足以支撑「这套方法在生产里有用」,不足以支撑「+51% CVR」这种量级的读法。
7.3 与同司 EGR 的路线张力(论文未提)¶
Snap 自己在 2026-07 发表的 EGR EGR 把召回问题的病根定为「item 表示空间与 user/query 表示空间之间隔着一次『先冻结再训练』的时间割裂,item embedding 从来没有为检索目标本身优化过」,处方是用一个共享 LLM backbone 把两侧联合训练。而 SetMIR 恰恰使用一个单独预训练、全程冻结的内容嵌入模型产出 item 向量,正是 EGR 点名批评的那种结构。两篇论文相隔一个月、来自同一家公司、面向同一个 ANN 召回栈,对「瓶颈在哪」给出了互不相容的诊断,而 SetMIR 完全没有引用或讨论 EGR。这不必然是缺陷(DPA 广告与内容召回是不同业务,冻结 item 塔也让 SetMIR 得以与 I2I 做同索引对照),但读者应当知道:SetMIR 的全部离线对比都建立在一个被同司工作认为次优的表示基础之上,四个 baseline 在这个约束下的表现(尤其 MIND / DCM)因此更难解读。
7.4 其他局限¶
- 完全没有公开数据集实验。所有离线数字都在 Snap DPA 私有数据上、并且是归一化后的相对百分比。这意味着:外部无法复现、无法与已发表的 MIND / ComiRec / KuaiFormer 数字对齐、也无法判断 SetMIR 在 Amazon / MovieLens 这类标准 benchmark 上处于什么位置。对一篇 ADS 轨论文这不算失格,但确实使这篇工作无法进入任何公共 benchmark 榜单。
- 训练预算不对等。SetMIR 训到 160K 步,baseline 在 60K–100K 步收敛。论文的辩护是「各训到各自收敛」,合理;但「更晚饱和」本身可能也部分来自集合目标带来的更困难、更慢的优化,而这与「更强」并不等价。
- 两个 baseline 是自行复现的(DCM、KuaiFormer 无公开代码),且四个 baseline 全部被搬进「冻结 item 塔」这个它们没有被设计的环境。论文自己对此作了限定,值得称道,但也意味着 Table 1 的绝对名次不宜外推。
- 方法论可扩展性存疑。模型只有约 3M 参数,唯一做过的 scaling 是数据 scaling(Table 5),没有任何参数量扫描。更根本的是:$K$ 扫描已经在 $K=7$ 饱和、$\tilde{K}$ 次线性且封顶在 7.59,说明「加更多兴趣向量」这条容量轴很快就到头了;而 item 侧是冻结的、user 侧编码器只有 2+6 层。这套路线在参数量扩大时,「如何表征历史」与「如何建模兴趣」两条路径都缺乏明确的同步扩张办法——尤其 item 表示被外部冻结模型固化,下游表征空间的上限不在本模型手里。这是一个典型的两阶段解耦瓶颈。
- 超参对 presence 阈值的敏感性未充分探索。$\tau$ 只报了 0.3 与 0(全 $K$)两点、$\delta_{\text{NMS}}$ 只报了 0.9 一点,没有扫描曲线;而这两个旋钮直接决定线上算力与召回质量的取舍点。
- $W_{\max}=15$ 与 3 天窗口的选择没有消融,而目标集合的构造方式直接定义了「集合预测」这个问题本身。