Real-Time Hard Negative Sampling via LLM-based Clustering for Large-Scale Two-Tower Retrieval¶
Meta · arXiv 2607.00448 · 2026-07-01 Ivan Ji, Liuyi Hu, Harrison (Zihao) Zhao, Lei Huang, Qunshu Zhang, Max (Xiangjun) Fan, Aameek Singh(前三位并列一作)
研究动机与背景¶
大规模推荐系统普遍采用「召回 + 排序」的多阶段级联架构:候选物料动辄百万、千万乃至上亿,用复杂排序模型直接对全库打分不现实,因此先由召回阶段从整个 corpus 里粗筛出一个小的候选子集,再交给下游若干排序阶段精排。双塔模型(Two-Tower Model) 因其独特的服务效率成为工业召回阶段的事实标准:用户塔与物品塔分别把用户侧信息、物品侧信息编码成 embedding,打分退化为两个向量的点积;由于物品塔 embedding 可以离线预计算并建索引,线上召回被转化为一个近邻搜索(NN search)问题,无需实时前向整个物品塔。
召回模型的训练通常被建模成一个极端多分类(extreme classification)问题——在整个物品集合上预测用户会与哪个物品交互——负样本的采样方式因此对训练效率至关重要。工业界的既有标准是 in-batch 负采样和/或 out-of-batch(OOB)负采样:
- in-batch:把同一 mini-batch 内其他用户的正样本当作当前样本的负样本,省时省内存,但负样本数量被 batch size 死死限制,暴露给模型的候选多样性不足,且带来推荐偏置;
- OOB:从当前 batch 之外的物品池采负样本,覆盖面更广、与线上「从全库召回」的场景更一致,但计算开销更大,而且随机 OOB 采出来的样本对模型太容易区分。
本文点出这套标准做法的根本病灶:它们采出来的多是「easy negatives」——模型很快就能学会区分,无法持续给模型足够的挑战,训练信号迅速衰减。与此同时,召回模型通常用「点击」这类用户参与行为当正样本,但用户能点什么本身是被多阶段系统决定的,这条强反馈闭环(feedback loop) 会不断放大流行度偏置(popularity bias):热门物品曝光越多→交互越多→更被推荐,长尾物品则始终学不好 embedding。
为同时解决「负样本太容易」和「流行度偏置」两个问题,本文提出一种自监督(self-supervised)的、基于物品簇(item cluster)的难负采样技术,并配套一个能在工业规模落地的实时服务框架 GOOBS:训练时实时地从「与正样本同簇」的物品中采负样本,这些同簇物品在语义上与正样本相似,天然构成难负样本。公开数据集实验显示该方法显著优于业界常用采样法,尤其在 Amazon Reviews 这类物品数量庞大的稀疏数据集上;工业落地带来 +53% CTR 的显著提升,并被证明能打破反馈闭环、明显缓解流行度偏置。
本文的核心贡献可总结为四点:
- 提出一种利用物品簇引入难负样本的、面向双塔模型的自监督难负采样技术;
- 提出一个高效的端到端训练/服务系统 GOOBS,能实时生成负样本,可扩展到工业规模(十亿级训练数据);
- 在公开与工业数据集上验证该采样技术显著超越广泛使用的 in-batch / OOB 负采样;
- 在工业应用中验证该技术能缓解流行度偏置。
相关工作¶
多阶段系统。 面对百万级候选与延迟约束,现代推荐系统普遍采用「召回 + 排序」两段式设计,召回负责从大库粗筛,后续多个排序阶段精排,学术界与工业界均广泛使用。
双塔模型。 自 Huang et al. (2013) 引入以来,双塔成为工业召回的主力。一塔建模用户交互,一塔建模物品特征,检索问题转化为 embedding 空间的近邻搜索;最大优势是物品塔 embedding 可全库预计算、建索引,线上无需实时推理。
负采样。 召回训练常被形式化为极端多分类,由此衍生出多种采样技术以提升训练效率:
- In-batch 负采样:把同 batch 内其他用户的正样本当负样本,时间与内存高效,但受 batch size 限制、带来推荐偏置、候选多样性不足;Wang et al. (2021) 的 cross-batch 负采样(CBNS) 复用近期 mini-batch 编码好的物品 embedding 来扩充负样本。
- LogQ correction:修正 sampled softmax 训练中「热门物品更容易被采为负样本」引入的偏置——通过从 logits 里减去负样本出现的对数概率,惩罚热门物品、提升模型召回低频物品的能力,已被 Google(Yi 2019, Yang 2020)、ByteDance(Yan 2024)、Kuaishou(Liu 2024)广泛采用。
- Out-of-batch(OOB)负采样:从当前 batch 外的物品池采负样本,覆盖更广、与线上服务更一致,但计算开销大;随机 OOB 太容易,而 DNS(Zhang 2013)、Adaptive Sampling(Chen 2022, Wang 2017)这类难负采样虽有研究,却因计算成本高而未在工业界大规模落地。
- Mixed 负采样:混合 in-batch 与 OOB,以缓解隐式反馈的选择偏置(Yang 2020, Hidasi 2018)。
流行度偏置。 推荐系统理想上应个性化地帮用户找到最相关物品,但现实中常倾向推荐热门物品、牺牲用户可能感兴趣的冷门物品。作者总结其三重危害:(1)用户只与有限物品交互,损害体验;(2)长尾物品学不到好 embedding;(3)形成难以打破的强反馈闭环——已热门的物品获得更多曝光、变得更热门。缓解手段包括:训练中直接纠偏(Abdollahpouri 2017, Steck 2011, Wei 2021)、后处理阶段用偏置因子调整预测(Abdollahpouri 2019, Zhu 2021)、以及按物品流行度的倒数在损失里加权(Steck 2011)。
核心方法¶
问题形式化¶
记有标注样本为 $\{x_i, y_i, r_i\}_{i=1}^n$,其中 $x_i$ 表示用户侧信息,$y_i$ 表示物品侧信息,$r_i$ 是第 $i$ 个样本对 $(x_i, y_i)$ 的标签。召回模型通常被建模成极端多分类器,目标是预测用户 $x_i$ 与物品 $y_i$ 发生交互的概率:
$$P(y_i \mid x_i; \theta) = \frac{e^{s(x_i, y_i \mid \theta)}}{\sum_{j \in \mathcal{I}} e^{s(x_i, y_j \mid \theta)}} \tag{1}$$
其中 $\mathcal{I}$ 是候选物品全集,$s(x_i, y_i \mid \theta)$ 是关于 $x_i$、$y_i$ 的打分函数,$\theta$ 为模型参数。在基础双塔设定下,$s(x_i, y_i) = v_i^{\top} u_i$,即物品塔输出 embedding $v_i$ 与用户塔输出 embedding $u_i$ 的点积。工业应用中 $\mathcal{I}$ 的基数至少百万起步——这正是式 (1) 分母无法直接精确计算、必须用采样近似的根源。
采用广泛使用的交叉熵损失,优化目标为:
$$\mathcal{L}\big(\{x_i, y_i, r_i\}_{i=1}^n\big) = -\frac{1}{n} \sum_{i=1}^{n} r_i \cdot \log\big(P(y_i \mid x_i; \theta)\big) \tag{2}$$
自监督的基于簇的难负采样¶
为提升训练效率,本文的核心方法依赖一种自监督的、基于簇的难负采样:先对物品池 $\mathcal{I}$ 做聚类,每个 $y_j$ 被分配一个簇 id;聚类维度可以多样,如物品类目、物品主题等。随后对每个有标注样本 $(x_i, y_i)$,从与 $y_i$ 同簇的物品里采出 $K$ 个负样本 $y_{i1}^{-n}, y_{i2}^{-n}, \dots, y_{iK}^{-n}$。这些 $\{y_{ik}^{-n}\}$ 之所以是 $(x_i, y_i)$ 的难负样本,是因为它们在某种意义上与 $y_i$ 相似。
于是对每个样本,只在「真实标签 + 采样出的负类」上最小化交叉熵:
$$\mathcal{L}\big(\{x_i, y_i, r_i\}, \{x_i, y_{ik}^{-n}, 0\}_{k=1}^{K}\big) = -\,r_i \cdot \log\!\left( \frac{e^{s(x_i, y_i \mid \theta)}}{\sum_{j \in \{y_i,\, \{y_{ik}^{-n}\}_{k=1}^{K}\}} e^{s(x_i, y_j \mid \theta)}} \right) \tag{3}$$
对比式 (1) 与式 (3) 可以看出:采样把分母从「全库 $\mathcal{I}$」缩小为「正样本 + $K$ 个同簇负样本」,这正是 sampled softmax 的思路,而本文的关键在于这 $K$ 个负样本不再随机采,而是限定在同簇内。
基于簇的难负样本的理论依据¶
本文从对比学习理论与梯度方差分析的视角论证了同簇负采样为何有效。在标准双塔模型 + InfoNCE / softmax 交叉熵下,一个负样本 $x_j^-$ 对用户锚点 $x_u$ 的梯度贡献正比于其指数化相似度 $\exp\!\big(s(x_u, x_j^-)\big)$。均匀采样的负样本通常落在 embedding 空间中远离锚点的区域,相似度极小,梯度也随之趋近于零,几乎不提供学习信号——这正是「easy negatives 训练信号弱」的数学解释。
反之,从与正样本同一语义簇中采负样本,可以保证 $x_j^-$ 与正样本共享潜在特征,在模型完全收敛之前维持一个更高的相似度 $s(x_u, x_j^-)$,从而把负样本推近模型当前的决策边界。这样梯度幅值显著更大,迫使模型去学习簇内物品之间的细粒度区分,而不是依赖平凡的簇间差异。这一结论与 ANCE(Xiong et al., 2021)的理论发现一致:从查询的局部邻域采负样本能产生更高的梯度范数,更好地逼近 oracle importance sampling 分布。
基于 LLM 的簇生成¶
在基于簇的负采样流程中,如何选簇至关重要。传统做法是用媒体流派/类目当作聚类选项(见 §5.1 公开数据集实验);但在本文描述的工业应用中,物品簇来自一个内部的多模态内容 embedding 模型,相比传统基于类目的聚类具有显著优势。
该内容 embedding 模型是构建在一个大语言模型(LLM)之上的一组 fine-tuned 编码器,旨在跨文本、图像、视频模态产出语义丰富的物品表征。其工作流(图 1)包括三步:
- 预训练(Pre-training):利用预训练 LLM 获得稳健的通用语言理解能力,这一基础确保模型能捕捉传统聚类方法(仅靠流派/类目等表层特征)会漏掉的复杂语义关系;
- 多模态编码器(Multimodal Encoder):用一个 transformer 架构处理文本、图像、视频等多样输入,编码成固定长度向量表征,超越传统单模态聚类的局限;
- 微调(Fine-tuning):再对模型做任务特定微调,使生成的簇高度相关且上下文相关,捕捉传统聚类可能忽略的用户兴趣细微差别。
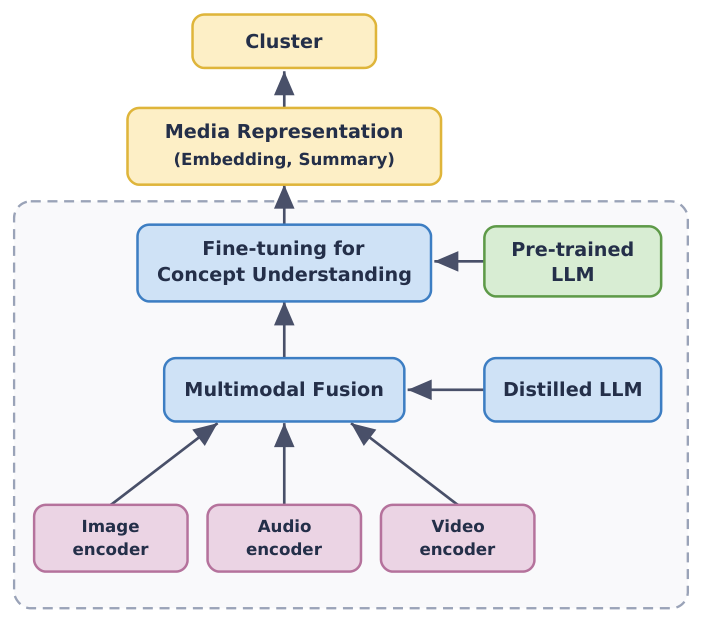
作者特别强调簇粒度对性能至关重要:为了有效负采样,应选择不过分细粒度的簇,以最小化把「其实相关的物品」误当负样本(false negative)的风险。
GOOBS:实时采样框架¶
GOOBS(Global Out-of-Batch Sampling) 是一个实时的、基于簇的负采样框架,专为「集成进生产模型、处理十亿级训练数据、且计算开销极小」而设计。如图 2 所示,GOOBS 维护一个存储 OOB 样本张量的物品池(item pool):物品的最大数量预先设定,每个物品被分配到一个「slot」——即一组存储该物品特征的张量。
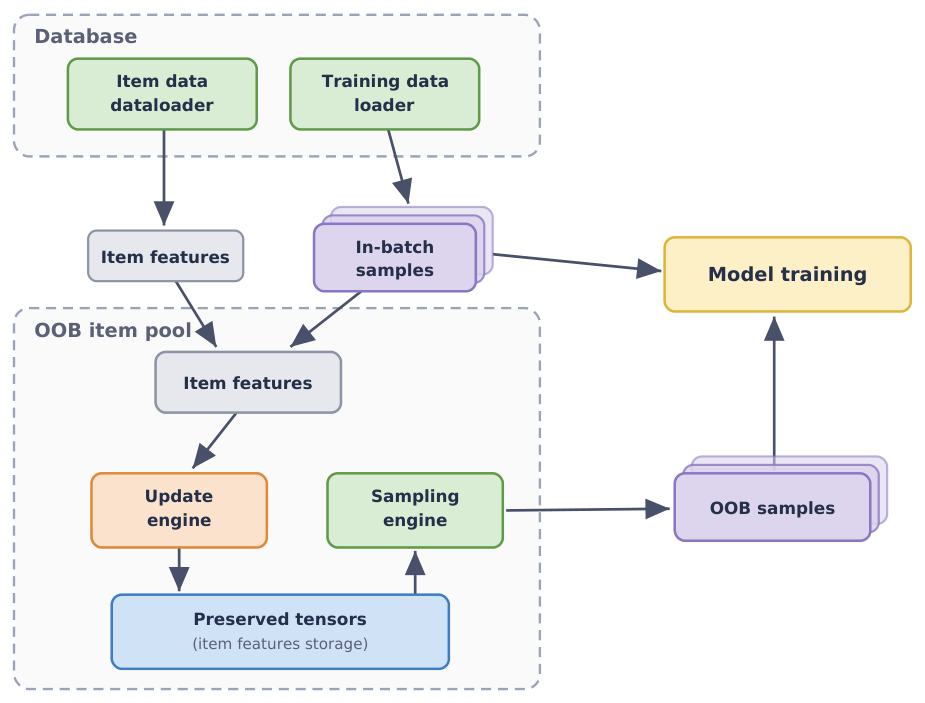
训练时,in-batch 样本一方面经过一个更新引擎(update engine),由定制哈希函数决定该物品应存到哪个 slot;另一方面,一个采样引擎(sampling engine) 以 in-batch 物品的簇 id 为输入,从物品池采出对应的 OOB 样本。这些 OOB 样本随后与 in-batch 样本一起进入模型训练。
为了在训练早期就有高采样命中率,物品池会用「来自历史训练数据的物品数据表」的物品特征做预加载(pre-loading);尽管这份数据可能相对最新训练数据略有延迟,但 in-batch 训练样本会持续捕捉最新物品并不断更新物品池以保持新鲜度。
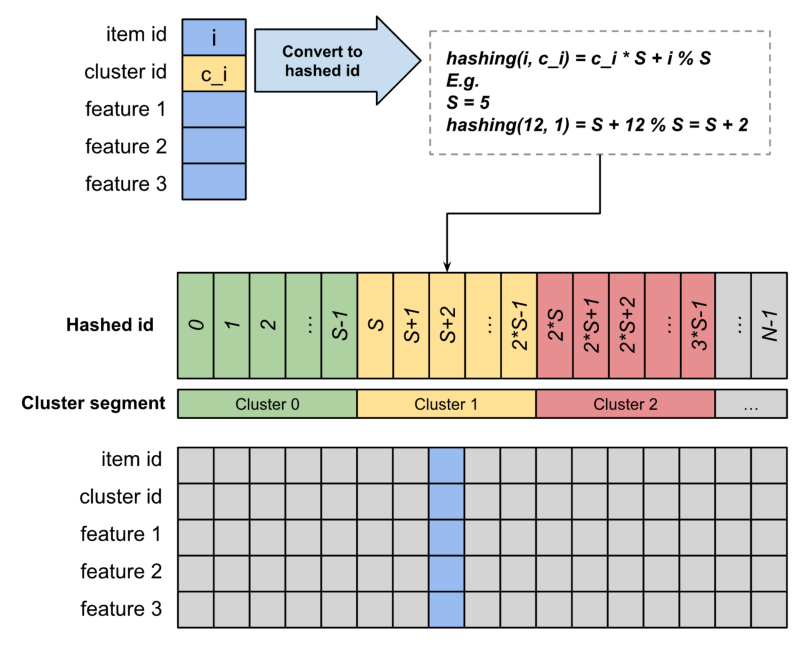
GOOBS 的核心功能落在更新引擎与采样引擎里。物品 id 与簇 id 经过哈希函数被映射到物品池中一个专属的簇段(cluster segment);每个簇段由多个 slot 组成,且各簇段的 slot 数量相等。
更新引擎(Algorithm 1)。 输入为第 $i$ 个训练 batch 的物品 id $x_i = [x_{i1}, x_{i2}, \dots, x_{iB}]$,batch 大小 $B$,簇大小(每簇 slot 数)$S$:
for j = 1 to B:
    1. 取 x_ij 的簇 id: c_ij
    2. 把 x_ij 哈希到物品池索引: c_ij · S + (x_ij mod S)
如图 3,哈希函数为
$$\text{hashing}(i, c_i) = c_i \cdot S + (i \bmod S) \tag{4}$$
举例:当 $S=5$、物品 id $i=12$、簇 id $c_i=1$ 时,$\text{hashing}(12, 1) = 1 \cdot 5 + (12 \bmod 5) = 5 + 2 = 7$,即落在「簇 1 段」内的第 3 个 slot。物品池整体被排成 hashed id $0, 1, \dots, N-1$,连续的 $S$ 个 slot 构成一个簇段(Cluster 0 占 $[0, S)$、Cluster 1 占 $[S, 2S)$……),每个 slot 存该物品的 id、簇 id 及各特征。
采样引擎(Algorithm 2)。 输入同上。如图 4,in-batch 样本的簇 id 被用来定位目标簇段,再在该段内随机取一个已有物品及其特征作为 OOB 负样本:
for j = 1 to B:
    1. 取 in-batch 样本的簇 id: c_ij
    2. 随机采样 r_ij ∈ rand(0, S)
    3. 从物品池索引 c_ij · S + r_ij 取物品 N_ij
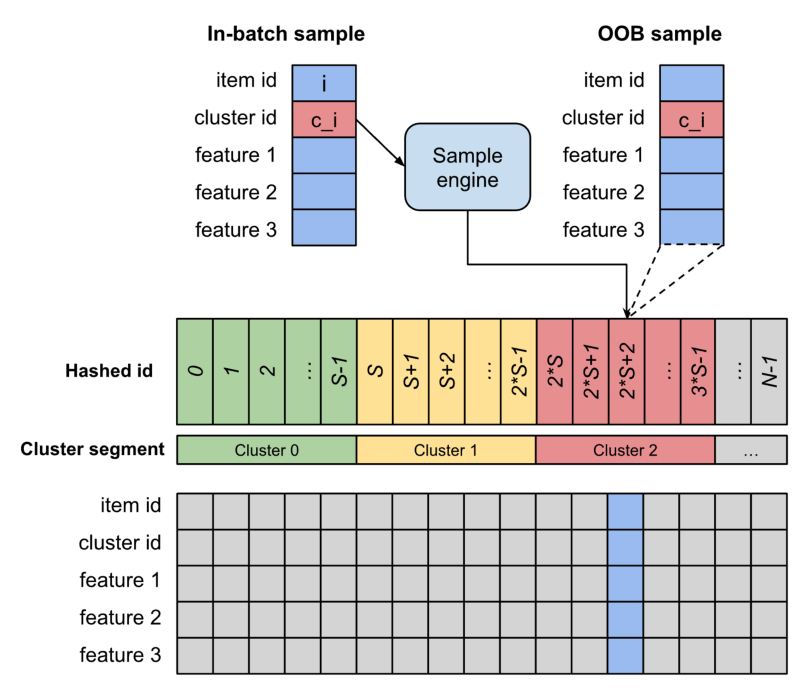
整套设计的精妙之处在于:用「簇 id × 簇大小 + 段内偏移」的哈希布局,把「同簇采样」这件事变成 O(1) 的定位与随机读取,既不需要维护/异步刷新全局 ANN 索引(对比 ANCE),又能在十亿级数据上实时供给同簇难负样本,训练 QPS 几乎无损。
实验设置¶
公开数据集¶
在 MovieLens-1M 和 Amazon Reviews(子集 Grocery、Electronics、Home)上评测,采用与 Zhai et al. (2023, 2024) 类似的 full-shuffle 设置。数据按时间戳排序,取前 80% 训练、后 20% 评估;评分 1–2 转为负标签,3–5 转为正标签。特征包括:用户 id、物品 id,以及数据集中直接可得的簇 id(如 genre id、category id);每个用户的历史交互序列作为用户特征。
评测协议上,本文刻意不做 k-core 过滤(即不删除交互少于 5 或 10 次的用户/物品),并且用整个全局 corpus 而非仅 100 个随机负样本来评估目标物品的排名。作者引用 Krichene & Rendle (2020) 指出:sampled 评测指标常与精确全局排名不一致、会人为抬高 Hit Rate 绝对值。保留数据集原始稀疏度、做精确全局排名,能更准确反映真实世界冷启动部署的难度——代价是这里报告的 HR@50 / HR@100 绝对值低于那些重度 k-core 过滤 + sampled 指标的研究,但采样策略之间的相对提升是稳健、无偏的。
对比方法(在同一标准双塔骨干上实现):
- Baseline(in-batch + LogQ correction):业界标准基线,用 in-batch 负样本 + LogQ 修正以降低对高频物品的过度惩罚,并加了 false-negative mask 来压制作为 in-batch 负样本出现的已知正样本的 logits。
- DNS(Zhang 2013):Dynamic Negative Sampling,从当前模型 checkpoint 里选预测相关性最高(即模型当前最相信、实则为负)的物品,是推荐文献里经典的难负基线。
- CBNS(Ding 2020):Cross-Batch Negative Sampling,缓存近期 mini-batch 的物品 embedding 复用为当前 batch 的负样本;与 GOOBS 一样利用 OOB 物品,但它按出现的近期性(recency) 而非语义簇成员来选负样本。
- ANCE(Xiong 2021):在整个物品 corpus 上建一个全局 ANN 索引并在训练中异步刷新,负样本取每个 query 在 embedding 空间的近似最近邻,是全局意义上几何最难的负样本。
- GOOBS:在 Baseline 基础上引入从维护的物品池实时采出的随机 OOB 样本,预加载物品池保证从训练一开始就有高 OOB 命中率。
- Cluster GOOBS:不是随机 OOB,而是从与正样本同一语义簇采负样本;随机 OOB 与簇 OOB 的比例为 MovieLens-1M 上 1:15、Amazon Reviews 上 1:31。
主要实验结果¶
公开数据集结果¶
表 1 报告四个数据集上的 HR@50 与 HR@100(括号内为相对 in-batch Baseline 的提升,粗体为最优):
| 数据集 | 指标 | Baseline (In-batch) | DNS | CBNS | ANCE | GOOBS | Cluster GOOBS |
|---|---|---|---|---|---|---|---|
| Movielens-1M | HR@50 | 0.2253 | 0.2298 (+2.0%) | 0.2331 (+3.5%) | 0.2380 (+5.6%) | 0.2346 (+4.2%) | 0.2415 (+7.2%) |
| Movielens-1M | HR@100 | 0.3588 | 0.3618 (+0.8%) | 0.3608 (+0.6%) | 0.3661 (+2.0%) | 0.3611 (+0.7%) | 0.3682 (+2.7%) |
| Amazon-Grocery | HR@50 | 0.0254 | 0.0261 (+2.8%) | 0.0271 (+6.7%) | 0.0288 (+13.4%) | 0.0279 (+10.1%) | 0.0301 (+18.5%) |
| Amazon-Grocery | HR@100 | 0.0406 | 0.0419 (+3.2%) | 0.0432 (+6.4%) | 0.0451 (+11.1%) | 0.0440 (+8.3%) | 0.0470 (+15.7%) |
| Amazon-Electronics | HR@50 | 0.0084 | 0.0090 (+7.1%) | 0.0099 (+17.9%) | 0.0108 (+28.6%) | 0.0110 (+30.9%) | 0.0131 (+55.6%) |
| Amazon-Electronics | HR@100 | 0.0154 | 0.0163 (+5.8%) | 0.0176 (+14.3%) | 0.0186 (+20.8%) | 0.0190 (+23.5%) | 0.0201 (+30.2%) |
| Amazon-Home | HR@50 | 0.0050 | 0.0054 (+8.0%) | 0.0061 (+22.0%) | 0.0065 (+30.0%) | 0.0067 (+34.2%) | 0.0074 (+47.3%) |
| Amazon-Home | HR@100 | 0.0082 | 0.0088 (+7.3%) | 0.0094 (+14.6%) | 0.0099 (+20.7%) | 0.0102 (+23.9%) | 0.0118 (+42.3%) |
结论分析。 Cluster GOOBS 在每一个数据集、每一个指标上都取得最优,相对 in-batch 基线的增益从 +7.2%(ML-1M HR@50)到 +55.6%(Amazon-Electronics HR@50)不等,证明基于簇的难负样本在多样推荐领域都能提供一致而可观的训练信号。几条值得注意的趋势:
- OOB 本身就有收益。 仅 GOOBS(随机 OOB)相对 in-batch 基线就有 +4.2%~+34.2% 的 HR@50 提升——说明训练时接触更广的物品池、即使不做难负筛选也能改善泛化。
- 同簇难负显著优于随机 OOB,也优于全局最难的 ANCE。 把随机 OOB 换成同簇 OOB(Cluster GOOBS)一致超越所有基线,包括需要全局 ANN 索引刷新的 ANCE。在更稀疏的 Amazon 上尤为突出:Amazon-Electronics HR@50 上 Cluster GOOBS +55.6% vs ANCE +28.6%,Amazon-Home HR@50 上 +47.3% vs ANCE +30.0%。这说明语义簇成员比「全局几何最近邻」是更有效、且工程上更便宜的难负信号。
- HR@50 的增益普遍大于 HR@100。 说明基于簇的难负样本尤其擅长「把最相关物品排到检索列表最顶端」——而这恰恰是对下游排序阶段最关键的区间。
总体而言,这组结果验证:语义簇成员提供的难负信号比近期性(CBNS)、动态打分选择(DNS)、近似最近邻几何(ANCE)都更有效,同时不需要全局索引、且兼容实时服务。
工业数据集结果¶
为验证工业价值,Cluster GOOBS 被应用到一个大规模工业推荐系统并通过线上 A/B 评测。与公开数据集不同,真实数据更复杂、流行度偏置更严重:例如所用工业数据集约有 1800 万可曝光物品,但排名前 100 的物品贡献了总曝光的 50%——说明现有系统对长尾物品探索不足,用户被局限在有限物品内交互,形成强反馈闭环。
实验设置(§5.2.1)。 对照组与实验组各随机抽取 3% 用户。对照组用「双塔 + GOOBS(随机 OOB)」服务,实验组用「同一双塔架构 + Cluster GOOBS」服务。
簇选择(§5.2.2)。 如 §3.4 所述,真实应用里用基于 LLM 的内容理解模型学习媒体表征并导出簇,共 300 个簇,其中 98% 的簇有 ≥10k 个物品。图 5 展示各簇的物品数量分布——分布高度不均,少数几个簇物品量高达 70 万~80 万,大量簇则在数万到十几万量级。
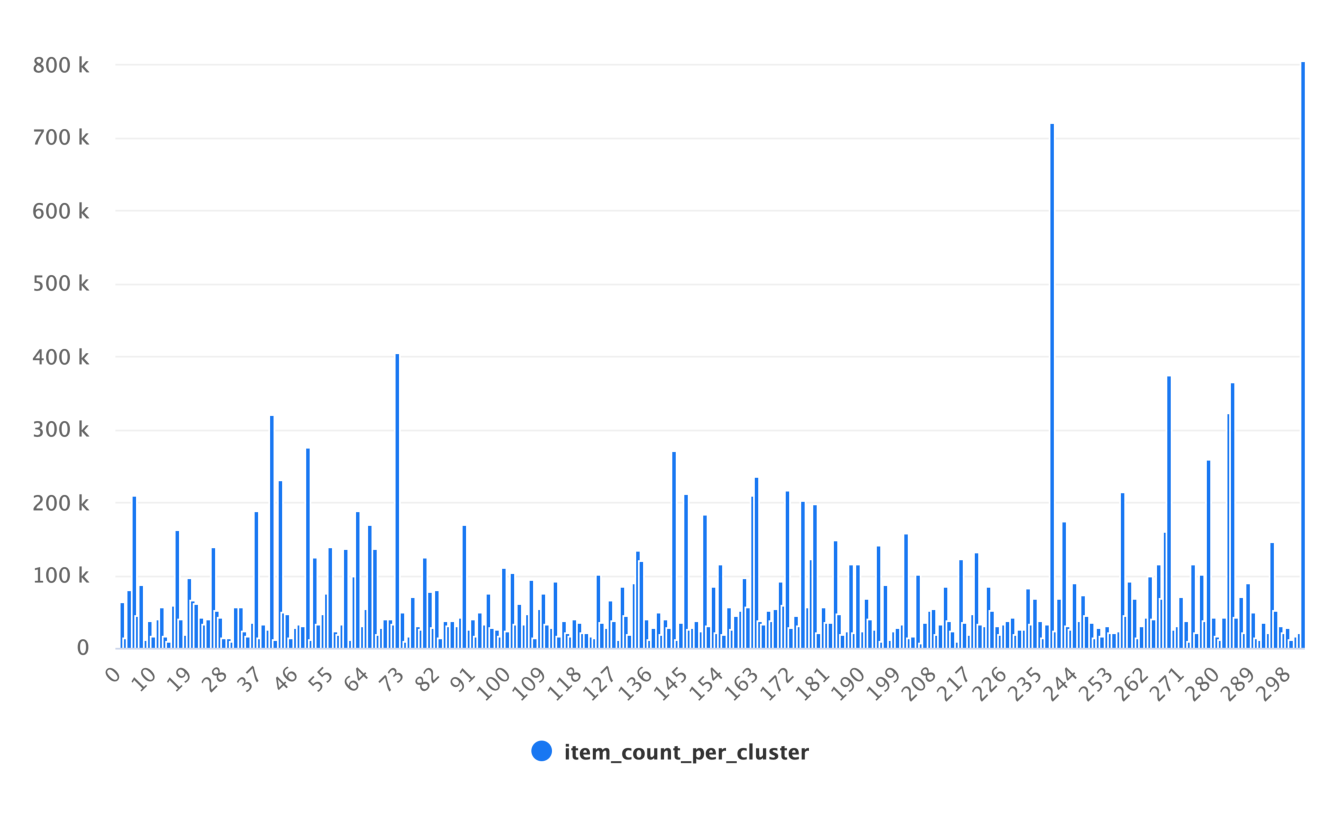
结果(§5.2.3)。 模型优化的是点击等用户参与行为,故用 CTR 衡量线上表现。如表 2,Cluster GOOBS 把 CTR 提升了 53%,同时仅带来 −1.4% 的训练 QPS 回退(推理 QPS 无回退),展现了算法极强的可扩展性与效率、易于生产落地。
表 2 · 线上 CTR 对比(相对提升):
| 模型 | CTR | 训练 QPS |
|---|---|---|
| GOOBS(对照) | 0% | 0% |
| Cluster GOOBS(实验) | +53% | −1.4% |
进一步分析内容分布以度量 Cluster GOOBS 的流行度纠偏效果:把「过去 1 天曝光 ≥1K 次」的物品作为目标物品群组。如表 3,实验组该群组的占比提升约 50%;前 100 物品的曝光贡献从 50% 下降到 32%,表明流行度偏置得到显著改善。
表 3 · 流行度纠偏对比(相对提升):
| 模型 | 曝光桶 ≥1k 占比 | 前 100 物品曝光贡献 |
|---|---|---|
| GOOBS(对照) | 0% | 50% |
| Cluster GOOBS(实验) | +50% | 32% |
结论分析。 这里最关键的是「实验组仅把负采样从随机 OOB 换成同簇 OOB」这一处改动,就同时拿到了「+53% CTR」和「前 100 物品曝光占比从 50% 降到 32%」两个方向的收益。作者的解释是:同簇难负让模型被迫学会簇内细粒度区分,从而更敢于把长尾物品召回上来,直接打破了「热门→更多曝光→更热门」的反馈闭环。−1.4% 的训练 QPS、0 推理 QPS 回退则说明 GOOBS 的哈希物品池设计几乎无额外服务成本——这是它能在工业双塔上「即插即用」的关键。
消融与分析¶
严格意义上本文没有单独的消融章节,但表 1 的方法阶梯本身构成了一组清晰的消融链条,可逐项拆解每个设计的贡献:
- in-batch → GOOBS(+随机 OOB):隔离出「引入 OOB 物品池」的贡献(HR@50 +4.2%~+34.2%),证明扩大负样本来源本身有效;
- GOOBS → Cluster GOOBS(随机 OOB → 同簇 OOB):隔离出「难负筛选(同簇)」相对「随机 OOB」的增量,这是本文核心 insight 的直接证据——在所有数据集上同簇都优于随机;
- Cluster GOOBS vs DNS / CBNS / ANCE:把「同簇难负」与三种代表性难负/OOB 策略(动态打分、近期性缓存、全局 ANN 几何)横向对比,同簇在效果与工程成本上双赢;
- 随机 OOB : 簇 OOB 比例(1:15 / 1:31):一个隐含的关键超参——保留少量随机 OOB 与大量簇 OOB 混合,而非纯簇采样,推测是为了在「难度」与「false negative 风险」之间取平衡(过纯的同簇采样会增大误伤相关物品的概率,与 §3.4 强调的「簇不宜过细」呼应)。
工业侧的表 3 则可视作一次「针对流行度偏置的专项分析」:它不评效果(CTR),而专门测「难负采样是否真的改变了曝光分布」,用「前 100 物品曝光占比 50%→32%」给出了机制层面的正向证据。
核心贡献总结¶
- 方法:提出面向双塔召回的自监督、基于簇的难负采样——从与正样本同簇的物品里采难负样本,并用对比学习梯度分析论证其为何优于随机负采样(同簇负样本相似度更高→梯度幅值更大→逼近决策边界)。
- 系统:提出 GOOBS 实时采样框架,用「簇 id × 簇大小 + 段内偏移」的哈希物品池,把同簇 OOB 采样变成 O(1) 操作,无需全局 ANN 索引,可在十亿级数据上实时供给难负样本、训练/推理 QPS 几乎无损。
- 表征:在工业场景用基于 LLM 的多模态内容 embedding 模型生成语义簇,超越传统类目/流派聚类。
- 实证:公开数据集全面超越 in-batch / OOB / DNS / CBNS / ANCE;工业 A/B 拿到 +53% CTR,并把前 100 物品曝光贡献从 50% 压到 32%,验证了对流行度偏置和反馈闭环的缓解。
与已归档相关工作的对比¶
TAWin TAWin: Objective Shaping with Hard Negatives (USTC & Meta AI & RIT, 2026-04-24)¶
关系:独立并发(本文未引用 TAWin,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文都在攻击同一个 root cause——随机/均匀负采样与「top-$K$ 检索目标」不对齐,必须引入难负样本来锐化检索列表的顶端;更重要的是,两者都不满足于「难负样本信息量更大」这种信息论层面的模糊说辞,而是各自给出了「难负为何有效」的形式化/机制级论证。本文用对比学习梯度分析(同簇负样本相似度高→梯度幅值大→逼近决策边界);TAWin 用排序指标等价关系(证明 GRPO+二值奖励 ≡ 最大化 AUC,而 beam-search 难负把目标 shift 到 One-way Partial AUC,与 top-$K$ 对齐更好)。
- 相近的技术骨架:抽象来看两者方法流程可重合为——「识别随机负样本训练信号弱 → 用难负样本替换 → 从理论上刻画由此改变的优化目标/梯度 → 进一步控制难度分布」。本文用「随机 OOB : 簇 OOB = 1:15 / 1:31」的混合比例来控制难度;TAWin 用一个可调窗口 $[\alpha, \alpha+d]$(WPAUC)+ 可微 soft 重加权来精确控制对齐到目标 $K$ 的强度。
- 本文的差异与推进:范式完全不同。本文是稠密双塔 + softmax 交叉熵,难负来自离线 LLM/多模态聚类、经哈希物品池(GOOBS)实时供给,不需全局 ANN;TAWin 是生成式推荐 + GRPO/RL,难负来自模型自身的 constrained beam search 解码,难度分布随模型动态变化。因此本文的难度是「预定义、可控、静态」的语义簇成员;TAWin 的难度是「模型依赖、动态」的分数分位,再叠加窗口重加权做二次校正。
- 可比的方法/实验差异:本文报告 HR@50/HR@100(ML-1M、Amazon Grocery/Electronics/Home)+ 工业 +53% CTR、前 100 曝光占比 50%→32%,强调工业落地与流行度纠偏;TAWin 报告 Recall@$K$(Toys/Office 等四个公开数据集),纯学术、无线上部署,强项是把「beam-search 难负有效」这一经验现象证明成「隐式优化 OPAUC」的定理。两者互为镜像:一个在双塔稠密召回里用「聚类 + 实时池」把难负工程化落地;另一个在生成式召回的 RL 后训练里把难负的作用理论化并精确调控。若要在双塔场景引入「可调难度」,TAWin 的窗口化思想值得借鉴;反之 TAWin 若要工业化,本文的哈希物品池是现成的低成本供给方案。
讨论与局限性¶
核心价值与可借鉴处。 本文最实用的贡献不是「同簇难负」这个 idea 本身(ANCE/DNS 早已论证过难负的价值),而是 GOOBS 这套把「同簇难负采样」做成 O(1)、零全局索引、几乎零 QPS 回退的工程方案——它让「难负采样」这件长期因计算成本而未在工业界大规模落地的事,第一次以「即插即用、可扩展到十亿级」的形态跑起来。哈希布局 $\text{hashing}(i,c_i)=c_i\cdot S + i \bmod S$ 把「同簇」编码进物品池的连续段,是整套系统能实时化的关键技巧,值得直接迁移到其它双塔召回系统。此外「用 LLM 多模态 embedding 做聚类」把语义簇质量从「类目粒度」提升到「内容理解粒度」,以及「难负采样顺带缓解流行度偏置」的工业分析(前 100 曝光 50%→32%),都是有说服力的落地证据。
局限与争议。
- 方法新颖性偏增量。 「从语义邻域采难负」与 ANCE 的核心思想高度重叠——Cluster GOOBS 可粗略看作「用离线聚类替代在线 ANN 的 ANCE 廉价版」;论文主要的原创性其实在系统工程(GOOBS)而非采样思想本身。
- 关键细节交代过简。 支撑效果的「LLM 多模态内容 embedding 模型」几乎只有一段高层描述,既无该 embedding 模型的训练/评测细节,也无「用它聚类 vs 用类目聚类」的直接对照实验(公开数据集用的是 genre/category id,工业数据集才用 LLM 簇,二者未能在同一设置下 A/B)。理论论证(§3.3)也只有定性推导,没有梯度范数/相似度分布的实证支撑。
- 超参与 false-negative 风险未充分探讨。 「随机 OOB : 簇 OOB = 1:15 / 1:31」这个比例明显重要却几乎没有敏感性分析;§3.4 承认「簇不宜过细以免误伤相关物品」,但全文未量化 false negative 的影响,也没给出簇粒度的选择准则。
- 工业结论的可复现性有限。 +53% CTR 亮眼,但工业数据集、LLM embedding 模型、簇定义都不可公开复现;而公开数据集上的绝对 HR 极低(如 Amazon-Electronics HR@50 从 0.0084 到 0.0131),虽然作者已用「拒绝 k-core + 全局精确排名」的严格评测解释了绝对值低的原因,相对增益在这种极小基数上仍需谨慎看待。
工业落地价值。 尽管有上述局限,这仍是一篇工业价值明确的工作:方法即插即用(不改双塔架构、只换负采样)、系统零全局索引且 QPS 几乎无损、A/B 收益显著(+53% CTR)、且附带缓解流行度偏置这一长期难题。对于任何已在用 in-batch/OOB 负采样的双塔召回系统,GOOBS 都提供了一条低风险、低成本的升级路径。作者展望的未来方向包括加权的基于簇的负采样与基于用户 query 的负采样。