PushDualGen:先出 SID、再出「可跳过」文案的工业 Push 生成式推荐¶
Kuaishou Technology(快手)· arXiv:2608.07989 · 2026-08-08 · Preprint(ACM 模板,会议匿名占位) 作者:Manjia Lin, Da Li, Yan Wang, Yong Jin, Zheming Ding, Wei Yuan, Lei Yan, Yanan Xia, Lu Zhang, Fan Yang, Xuanping Li, Yanan Niu 已上线快手 Push 推荐系统,服务近 10 亿用户、约 100K QPS;15% 流量 / 约 1.5 亿用户的 14 天 A/B 实验。
1. 研究动机与背景¶
Push(推送通知)是与 Feed 完全不同的推荐场景。 Feed 推荐是被动的——用户已经进了 App,一次不合适的曝光成本很低;Push 是主动的,它在用户没有打开 App 时把内容直接推到锁屏上。论文开篇就点明了这个不对称性:“Any misaligned recommendation thus risks directly triggering user dissatisfaction”——任何一次错配的推荐都可能直接触发用户的负反馈(关闭通知权限、卸载),因此 Push 对选品准确性(item selection accuracy)和可追溯性(traceability)同时提出了比 Feed 更严苛的要求。快手的 Push 是主要的用户召回(re-engagement)通道,覆盖近 10 亿用户。
生成式推荐给出了准确性的答案,却带来了可追溯性的新问题。 以 TIGER 为代表的 Semantic ID(SID)生成式检索范式,把推荐重构成「在 SID 词表上的自回归序列生成」;OneRec 系列把这一范式推到了工业规模,端到端学习用户偏好并直接生成目标内容的 SID。但 SID 是量化得到的离散码字,本身不具备人类可读的语义——模型为什么推这条视频,链路上没有任何可解释的中间产物。论文把这一点直接称为 black-box characteristics,并指出它「hindering their deployment」,即在 Push 这种高风险通道里,不可解释本身就是上线阻力。
OneRec-Think 的解法与它的代价。 快手自家的 OneRec-Think 在生成 SID 之前先生成一段自然语言 chain-of-thought(CoT),既提升了效果又顺带给出了推荐理由。但这个设计把解释放在了决策的前面:每一次请求都必须先把整段 CoT 逐 token 解码出来,才能开始生成 SID。论文明确指出,考虑到 Push 的效率与吞吐要求(约 100K QPS),这条路径「difficult to deploy」。这里的结构性矛盾是:当解释位于决策的上游时,解释的代价就是不可跳过的在线代价。
PushDualGen 的核心翻转:把解释挪到决策的下游,并让它可跳过。 本文提出的框架先生成目标视频的 SID(决策),再以 SID 为条件生成一段 push 文案 copy(解释),中间用一个特殊 token $\langle id2text\_sep \rangle$ 分隔。在线服务时,只需要解码到 SID 就可以终止生成、进入 ANN 检索;copy 的那一段是 skippable 的——需要人工排查、需要给运营看推荐逻辑时才解码。这样解释性与推理成本被解耦了。
整套框架分三个阶段:
- Semantic ID-enabled Context Compression:把视频编码成并行 SID,并训练 LLM「认识」这些 SID;
- Personalized SID and Copy Generation:从用户交互历史先生成 SID、再选择性生成 copy;
- Representation Fusion for Online Serving:把 LLM 产出的偏好信号融进在线用户向量,走 ANN 检索。
2. 方法总览¶
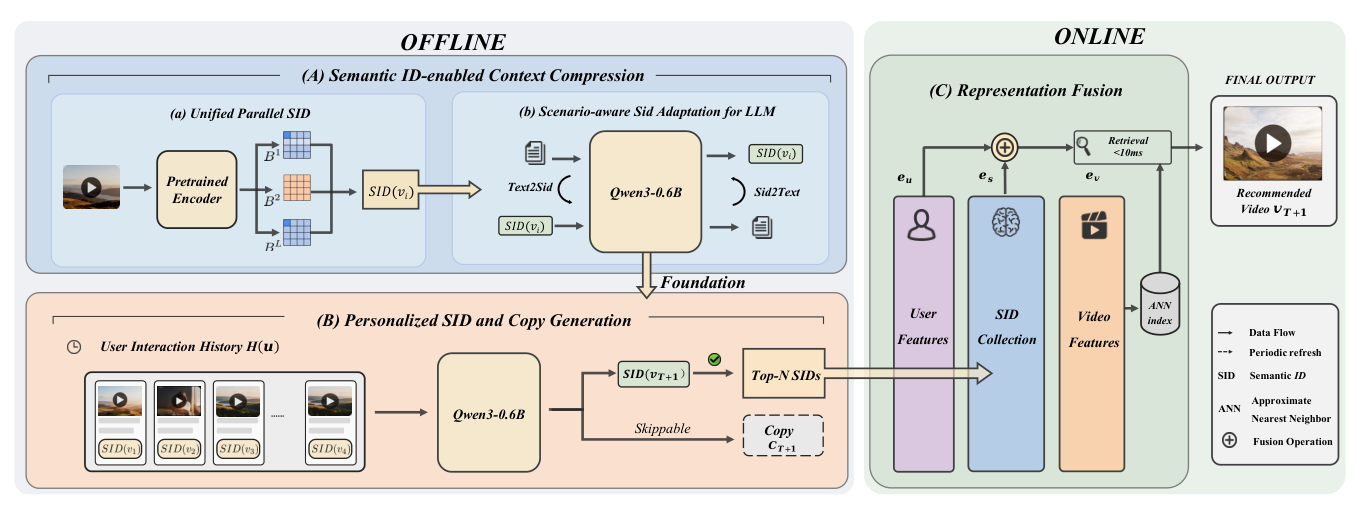
Figure 1 把系统切成 OFFLINE 与 ONLINE 两半。离线侧模块 (A) 有两个子块:(a) Unified Parallel SID——预训练编码器把一条视频映射成多个并行 embedding,再量化成 SID;(b) Scenario-aware SID Adaptation——用 Text2Sid / Sid2Text 这一对对称任务在 Qwen3-0.6B 上做对齐微调。模块 (B) 是主生成器:输入是用户交互历史 $H(u)$(每个历史视频已被替换成它的 SID),输出先是 $SID(v_{T+1})$、再是虚线框标出的 Skippable Copy $c_{T+1}$。在线侧模块 (C) 把 Top-N SIDs 编码成 $e_s$,与用户特征向量 $e_u$ 融合后,在由视频特征 $e_v$ 构成的 ANN 索引里做「小于 10ms」的检索,最终产出推荐视频。注意 Top-N SIDs 到在线侧是周期性刷新(periodic refresh)的虚线数据流,而不是请求级的在线调用——这是这套系统能扛住 100K QPS 的关键工程前提:LLM 的生成不在请求关键路径上。
3. 阶段一:Semantic ID-enabled Context Compression¶
3.1 为什么需要压缩¶
Push 推荐要从交互历史里推断用户偏好,但真实用户的行为序列长度远超 0.6B 级 LLM 的上下文窗口;截断或随机采样这类启发式策略会直接丢弃信号。作者的做法是用 SID 替换原始输入:一条视频原本要占据标题、描述、文案等几十上百个文本 token,替换成 SID 后只占 $M$ 个 token。这样在同样的上下文预算里能塞进多得多的历史交互。这个想法明确写明受 CREM 学到的 parallel embedding 启发。
3.2 Parallel Semantic ID¶
论文对 RQ(Residual Quantization)路线给出了一段清晰的批评:RQ 分层量化 item embedding,每一层只量化上一层的残差,因此越深的 SID token 噪声越大、越不可靠——这就是误差累积(error accumulation)。已有的并行 SID 工作虽然缓解了层次依赖,但它们仍然是从单一 embedding 派生出所有 SID token 的。本文的差异点在于:SID 直接来自一组并行的 embedding 槽位,而不是同一个稠密表示的不同投影。
具体地,每条视频 $v$ 被表示为 $M$ 个 embedding $\{e^{(m)}\}_{m=0}^{M-1}$。对每个 embedding 槽位独立做 K-means 聚类,得到 $M$ 个码本 $\{\mathcal{C}^{(m)}\}_{m=0}^{M-1}$,每个含 $K$ 个质心。槽位 $m$ 的 SID token 由最近质心分配得到:
$$s^{(m)}(v) = \underset{k \in \{0, \ldots, K-1\}}{\arg\min} \big\| e^{(m)}(v) - c^{(m)}_k \big\|_2 \tag{1}$$
其中 $c^{(m)}_k \in \mathcal{C}^{(m)}$ 是第 $m$ 个码本的第 $k$ 个质心。最终 SID 定义为这 $M$ 个 token 的拼接:
$$\mathrm{SID}(v) = \big( s^{(0)}(v), s^{(1)}(v), \ldots, s^{(M-1)}(v) \big) \tag{2}$$
实践中取 $M = 8$、$K = 512$,即每条视频压成 8 个 token、每个 token 从 512 路里选。作者坦承选 K-means 纯粹是因为简单高效,更先进的量化策略留作 future work——这是一处诚实但也说明方法侧投入不深的表态。
3.3 Scenario-Aware SID Adaptation¶
SID 是码本索引,不在 LLM 词表里,模型既读不懂也生不出。对齐分两步:
第一步:把全部 $L \times K$ 个码本索引注册为特殊 token,随机初始化。(注意这里论文的下标从 $M$ 切到了 $L$,二者在文中指的都是 SID 长度 = 8,属于记号不统一。)
第二步:设计一对对称的训练任务。对视频 $v_i$ 及其 push 文案 $c_i$、描述 $d_i$:
$$ \begin{aligned} s^0_i s^1_i \cdots s^{L-1}_i &= \mathcal{G}(c_i, d_i, \texttt{<T2S>}; \theta) \\ c_i d_i &= \mathcal{G}(s^0_i, s^1_i, \ldots, s^{L-1}_i, \texttt{<S2T>}; \theta) \end{aligned} \tag{3} $$
前者(Text2SID,$\texttt{<T2S>}$)用文本预测 SID,作用是把场景相关的信息压进离散 SID——注意这里用的是 push 文案 $c_i$ 而非通用描述,所以叫 scenario-aware;后者(SID2Text,$\texttt{<S2T>}$)反过来用 SID 生成文案与描述,作用是让 LLM 学会使用 SID 里携带的语义。两个任务在 Qwen3-0.6B 上联合优化,都用 next-token prediction:
$$\mathcal{L}_{\mathrm{adapt}} = -\sum_{m=0}^{M-1} \log P(y_m \mid x, y_{<m}) \tag{4}$$
其中 $x$ 是输入、$y_m$ 是第 $m$ 个目标 token。
关键工程细节——Token Freeze:为了训练效率与稳定性,冻结原始词表 embedding,只优化 SID token embedding。这一步在消融里被单独验证。
值得注意的是,式 (3) 的这对双向任务,与 PauseRec 论文里 CPT 阶段的 $\mathcal{L}_{\mathrm{CPT}} = -\mathbb{E}[\log p(s_i \mid d_i) + \log p(d_i \mid s_i)]$ 在形式上几乎完全一致——两个独立团队在「怎么把新造的 SID 符号 grounding 到 LLM 里」这个问题上收敛到了同一个配方(详见后文对比章节)。
4. 阶段二:Personalized SID and Copy Generation¶
4.1 训练目标¶
有了压缩表示和会用 SID 的生成器,就可以在用户 $u$ 的交互历史上微调,让模型生成用户可能感兴趣视频的 SID 与对应文案。输入 $X(u)$ 除交互历史外还包含:任务指令、用户画像、时间新近性标记(temporal recency markers)。
训练目标被 $\langle id2text\_sep \rangle$ 这个特殊 token 一分为二。第一部分是 SID 预测:
$$\mathcal{L}_{SID} = -\sum_{l=1}^{L} \log P\big( s^l_{T+1} \mid X(u),\, s^{<l}_{T+1} \big) \tag{5}$$
第二部分是以已生成的 SID 为条件的文案生成:
$$\mathcal{L}_{Copy} = -\sum_{j=1}^{|c_{T+1}|} \log P\big( t_j \mid X(u),\, \mathrm{SID}(v_{T+1}),\, \langle id2text\_sep \rangle,\, t_{<j} \big) \tag{6}$$
总目标是二者加权和:
$$\mathcal{L}_{gen} = \mathcal{L}_{SID} + \lambda_{Copy}\, \mathcal{L}_{Copy} \tag{7}$$
$\lambda_{Copy}$ 是平衡两个目标的超参(论文未披露取值)。
这个顺序是全文的核心设计。 式 (6) 的条件里显式包含 $\mathrm{SID}(v_{T+1})$:copy 不是推荐理由的「前置推导」,而是对已经做出的决策的事后复述。因此在线推理时可以在 $\langle id2text\_sep \rangle$ 处直接停止解码——被跳过的只是解释,决策本身完全不受影响。这与 CoT-first 的路线形成了一个干净的对偶:CoT-first 里解释是决策的因,PushDualGen 里解释是决策的果。代价也很清楚:copy 是后验重构(post-hoc rationalization),它对 SID 的忠实度只由训练时的联合似然保证,没有任何机制强制它必须是真实的决策依据。
4.2 Multi-Token Binding¶
尽管 SID 已经把视频压得很紧,输入里仍有大量文本(指令、画像、时间标记),计算开销依然高。作者的做法是把高频 token 序列合并成单个 token:来源是高频 $n$-gram($n \in \{2,3,4\}$)以及像 SID 这样语义上原子化的实体。每个新 token 的 embedding 用其组成 token 的均值池化(mean pooling)初始化。这是一个纯粹的序列长度优化,本质上是在既有 tokenizer 上加一层领域自适应的词表扩展。
5. 阶段三:Representation Fusion for Online Serving¶
PushDualGen 是用 click 历史训练的。作者指出 click 虽然是直接的兴趣信号,但只能部分反映偏好——用户兴趣广泛分布在浏览、评论等多种情境中。因此不能让 LLM 的输出直接决定最终结果,而要把它作为一路信号融进在线特征体系。
具体用三个独立编码器分别投影:(1) 用户特征 → $e_u \in \mathbb{R}^d$;(2) 候选视频特征 → $e_v \in \mathbb{R}^d$;(3) PushDualGen 生成的 Top-$N$ SIDs → $e_s \in \mathbb{R}^d$,它概括了生成器捕捉到的偏好信号。实践中 $N = 20$。用户表示通过加权组合融合生成式信号:
$$e'_u = \alpha\, e_u + \beta\, e_s \tag{8}$$
其中 $\alpha, \beta$ 是超参,实际应用中都设为 1(即直接相加,没有调权)。$e'_u$ 随后在由 $e_v$ 构成的集合上做 ANN 检索,取回用户感兴趣的视频。
这个设计说明了 PushDualGen 在快手 Push 里的真实定位:它不是端到端替换级联链路,而是作为一路生成式偏好信号注入既有的向量检索系统。Figure 1(C) 里 ANN 检索标注的「小于 10ms」与 Top-N SIDs 的 periodic refresh 虚线共同印证了这一点。
6. 附录 A:并行嵌入模型与 SID 构造细节¶
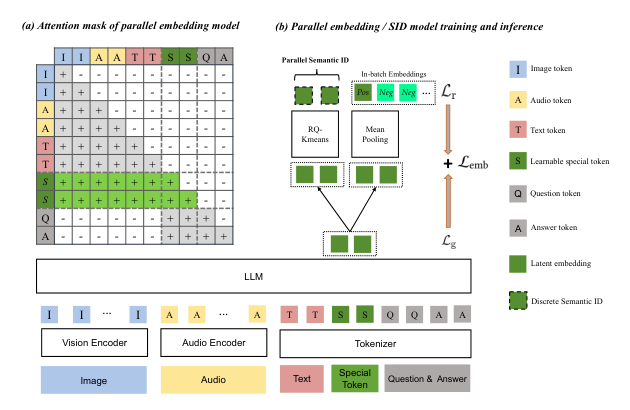
嵌入模型建在 Qwen2.5-Omni 上,遵循 CREM 与 CoMa 的协同表示学习范式,被训练成同时支持视频检索与文案生成,两者共享同一组 embedding。为得到紧凑的隐表示,作者在原始输入序列前前置一组可学习的压缩 token(compression tokens),实现中用 8 个,因此每条视频被编码成 8 个并行 embedding——正好对应 $M = 8$。
注意力掩码(Figure 4a)是这套压缩的硬约束。 掩码矩阵的行列顺序是 Image → Audio → Text → 可学习特殊 token(S)→ Question → Answer。前面的多模态 token 之间按块因果可见,特殊 token S 能看到全部 I/A/T token;而 Question 与 Answer 两行对 I/A/T 列全部为 "−",只对 S、Q、A 列为 "+"。也就是说,问答侧的文本被彻底切断了对原始模态 token 的直接访问,任何关于这条视频的信息都必须经由这 8 个特殊 token 传递。压缩因此不是一个正则项,而是一个信息瓶颈式的结构约束。
训练目标(Figure 4b)是检索与生成的混合。检索侧是 in-batch InfoNCE:
$$\mathcal{L}_r = -\frac{1}{B} \sum_{i=1}^{B} \log \frac{\exp\big(\mathrm{sim}(q_i, p_i)/\tau\big)}{\sum_{j=1}^{B} \exp\big(\mathrm{sim}(q_i, p_j)/\tau\big)} \tag{9}$$
生成侧是标准自回归语言建模损失:
$$\mathcal{L}_g = -\frac{1}{B} \sum_{i=1}^{B} \sum_{t=1}^{T_i} \log P(x_{i,t} \mid x_{i,<t}) \tag{10}$$
二者线性混合:
$$\mathcal{L}_{\mathrm{emb}} = \lambda \mathcal{L}_r + (1 - \lambda) \mathcal{L}_g \tag{11}$$
其中 $B$ 是 batch size,$q_i$ 与 $p_i$ 是匹配的 query–passage 对,$\mathrm{sim}(\cdot,\cdot)$ 是相似度函数,$\tau$ 是温度,$\lambda \in [0,1]$ 平衡两个目标。Figure 4(b) 显示,8 个 latent embedding 一路经 RQ-Kmeans 离散化成 Parallel Semantic ID(供 $\mathcal{L}_r$ 的对比学习用 in-batch 正负例),另一路经 Mean Pooling 汇聚。生成的 SID 随后按 §3.1 的流程离散化,$M = 8$ 槽位、每槽 $K = 512$ 质心。
7. 实验设置¶
训练数据:全部来自快手的 push-click 日志,覆盖近 10 亿用户、数百万候选视频。
- SID-enabled Context Compression 阶段:从内容池采样 400 万+ 视频,对各类视频做过滤以保证内容覆盖度与多样性,最终语料约 0.72B tokens;
- Personalized SID and Copy Generation 阶段:基于用户 click 日志做增量训练,每天约 3.6B tokens。
实现细节:
| 组件 | 骨干 | 关键配置 | 学习率 | Epochs |
|---|---|---|---|---|
| Semantic ID-enabled Context Compression | Qwen2.5-Omni-3B | 8 个可学习压缩 token | $1 \times 10^{-5}$ | 3 |
| Scenario-aware SID Adaptation + SID/Copy Generation | Qwen3-0.6B | $M{=}8$, $K{=}512$, $N{=}20$, $\alpha{=}\beta{=}1$ | $1 \times 10^{-7}$ | 1 |
(论文原文表述为「两部分分别以 $1\times10^{-5}$ 和 $1\times10^{-7}$ 训练 3 epoch 与 1 epoch」。$1\times10^{-7}$ 这个量级对 0.6B 模型的全参微调而言异常低,考虑到该阶段是每天增量训练,这更像是流式增量更新的步长设定。)
评估方案:14 天 A/B 实验,分配平台 15% 流量、覆盖约 1.5 亿用户,PushDualGen 与基于级联链路(cascading pipeline)的线上服务等比例对半。为缓解 hash 分桶带来的实验前不平衡,用 CUPED(Deng et al., WSDM'13)估计处理效应。四个指标分两组:
- Notification(触达吸引力):Click PV、DAU;
- Post-Click(点后满意度):Eff. Play Rate(有效播放率,衡量内容相关性)、Dis. Rate(Dislike Rate,显式负反馈率)。
8. 主要实验结果:在线 A/B¶
Table 1: Online A/B Test Results. M 表示百万,$p < 0.05$ 的显著提升标 ∗。
| 分组 | 指标 | Online Service | PushDualGen |
|---|---|---|---|
| Notification | Click PV ↑ | 82.04M | 82.39M (+0.43%∗) |
| Notification | DAU ↑ | 414.89M | 415.08M (+0.05%∗) |
| Post-Click | Dis. Rate ↓ | 0.053% | 0.033% (−37.70%∗) |
| Post-Click | Eff. Play Rate ↑ | 64.46% | 69.94% (+8.50%∗) |
结论分析。 四个指标全部统计显著,但幅度分布极不对称,这恰恰是最值得读的地方:
- 触达侧提升很小:Click PV +0.43%、DAU +0.05%。这符合 Push 的机制——用户是否点开通知,主要由推送标题的吸引力与用户当下状态决定,换一个召回模型对「点击率」的影响天然有限,何况 DAU 是一个被大盘稀释得极其厉害的指标。
- 点后侧提升巨大:Eff. Play Rate 相对 +8.50%(64.46% → 69.94%,绝对 +5.48pp),Dis. Rate 相对 −37.70%(0.053% → 0.033%,绝对 −0.02pp)。
两组数字合起来讲了一个完整的故事:PushDualGen 并没有更会「骗点击」,而是更会「选对内容」。点击量几乎持平的前提下,点进来之后有效播放率涨了 5.48 个百分点、不满意率砍掉近四成,说明生成式召回带来的收益集中在内容与兴趣的匹配质量上。对 Push 这种「一次错配就可能永久失去通知权限」的通道,Dis. Rate 降 37.70% 的业务价值可能远高于 Click PV 涨 0.43%。这也解释了论文为何把可解释性摆在如此靠前的位置——Push 的核心 KPI 本质是「不惹人烦」。
9. 消融与分析¶
消融不在 A/B 上做(成本过高),而是用 SID 预测这个离线代理任务评估。指标是 Pass@k:独立采样 $k$ 个 SID 中至少有一个命中用户真实感兴趣 item 的 ground-truth SID 的概率。变体通过逐个替换/关闭模块并重新训练构造:
- w/o Parallel SID:把并行 SID 换成 OneRec 使用的(残差量化)SID;
- w/o SID Adaptation:跳过 §3.3 的对齐阶段,直接重训 Qwen3-0.6B 去生成视频对应的 SID 与文本;
- w/o Token Freeze / w/o Multi-token Binding:关掉对应的训练策略;
- Qwen3-0.6B:在 OneRec 的 SID 上训练的原始骨干,作为 floor。
Table 2: Results on SID Prediction. 最优加粗、次优下划线。
| 模型 | Pass@1 | Pass@4 | Pass@20 |
|---|---|---|---|
| PushDualGen | 0.335 | 0.391 | 0.422 |
| w/o Token Freeze | 0.333 | 0.386 | 0.412 |
| w/o Multi-token Binding | 0.332 | 0.384 | 0.416 |
| w/o SID Adaptation | 0.319 | 0.352 | 0.366 |
| w/o Parallel SID | 0.326 | 0.379 | 0.401 |
| Qwen3-0.6B | 0.312 | 0.347 | 0.358 |
逐项分析:
-
SID Adaptation 是第一贡献者(Pass@1 0.335 → 0.319,−4.8%;Pass@20 0.422 → 0.366,−13.3%)。论文给出的解释是:LLM 在此前的训练中从未见过 SID 相关数据,因此必须有一个额外的训练过程让它理解并使用 SID。值得注意的是该组件的贡献随 $k$ 增大而急剧放大——去掉对齐后 Pass@20 几乎退化到 vanilla Qwen3-0.6B 的水平(0.366 vs 0.358)。这说明对齐真正提升的不是「最可能的那一个猜测」,而是整个 SID 生成分布的覆盖质量:没有对齐,模型只能靠死记硬背抓住少数高频 SID,采样 20 次也扩不出新的合理候选。对一个把 Top-20 SIDs 融进用户向量的系统($N=20$)来说,Pass@20 恰恰是最贴近线上收益的那一列。
-
Parallel SID 是第二贡献者(Pass@1 −2.7%、Pass@4 −3.1%、Pass@20 −5.0%)。把并行 SID 换成 OneRec 的残差 SID 后全线下降,且同样是 $k$ 越大差距越明显,与 §3.2 对 RQ 误差累积的论证方向一致:残差路线的深层 token 噪声大,采样多次也难以生成一致有效的完整码字。
-
Token Freeze 与 Multi-token Binding 是训练侧优化,增益轻微。论文自己也这么说:这两者主要优化训练过程,因此性能提升相对轻微(Pass@1 各约 +0.6%、+0.9%)。有意思的是二者在 Pass@20 上出现了排序反转——w/o Token Freeze 的 Pass@20(0.412)反而低于 w/o Multi-token Binding(0.416),说明冻结原始词表对生成分布多样性的保护作用比 Multi-token Binding 更实质,后者更接近纯粹的效率优化。
-
相比 vanilla Qwen3-0.6B,每个模块都是正贡献且可叠加:Pass@1 0.312 → 0.335(+7.4%)、Pass@20 0.358 → 0.422(+17.9%)。
方法论上的一处遗憾:消融里没有 "w/o Copy Generation" 这一项。也就是说,论文没有回答「加上 copy 这个辅助生成目标,对 SID 预测本身是帮助还是损害」——而这恰恰是全文最核心的设计。$\lambda_{Copy}$ 的取值也未披露。读者无法判断 copy 是免费午餐、正则化红利,还是纯粹的可解释性开销。
10. 对内容生态的影响¶
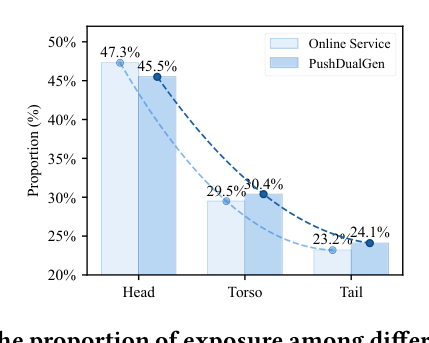
快手平台的视频按内容自动归入 39 个类目,作者按各类目占总曝光的份额分成三组:Head($>5\%$)、Torso($1\%$–$5\%$)、Tail($<1\%$)。
| 分组 | Online Service | PushDualGen | 变化 |
|---|---|---|---|
| Head | 47.3% | 45.5% | −1.8pp |
| Torso | 29.5% | 30.4% | +0.9pp |
| Tail | 23.2% | 24.1% | +0.9pp |
曝光从头部向腰部与长尾各迁移约 0.9 个百分点。论文的解读是:与倾向于历史热门内容的线上服务不同,PushDualGen 生成的 SID 具有更好的泛化能力,在冷启动场景表现更好;长期看这有助于平台吸引更多创作者投稿,形成生态正循环。
从机制上讲这个结论是可信的:SID 是从内容语义(多模态 embedding 量化)而非共现行为导出的,因此对交互稀疏的长尾内容天然不像协同信号那样退化。但需要保持清醒——1.8pp 的头部让渡在统计上不大,论文也没有给出这部分长尾曝光是否伴随消费质量下降的数据(比如按分组拆开的 Eff. Play Rate)。
11. Case Study:copy 到底解释了什么¶
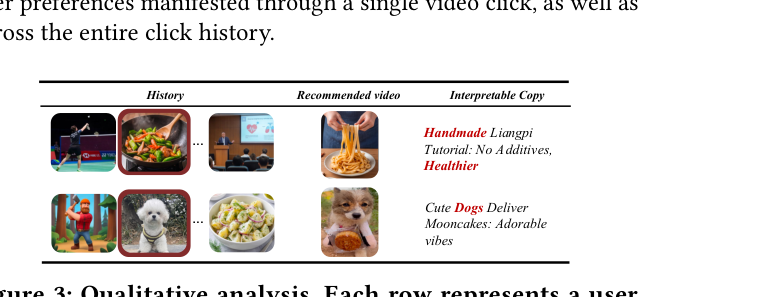
论文强调 PushDualGen「保留了生成 copy 的能力」,这有助于理解 SID 里到底装了什么、以及推荐背后的逻辑。Figure 3 给了两个用户样例(红色标出推荐视频与历史的关联):
- 第一行:历史里有羽毛球、炒菜、会议等视频,其中「炒菜」被红框标出;推荐视频是手工凉皮,生成的 copy 为 "Handmade Liangpi Tutorial: No Additives, Healthier"——红色高亮落在 Handmade / Healthier 上,对应的是从单条美食视频延伸出的「手工、健康」这一细粒度偏好。
- 第二行:历史里有游戏、比熊犬(红框)、食物等;推荐视频是狗送月饼,copy 为 "Cute Dogs Deliver Mooncakes: Adorable vibes"——红色落在 Dogs 上。
作者据此说明:PushDualGen 既能捕捉单条视频点击所体现的偏好,也能兼顾整个点击历史。
如何评价这个 case study:它确实展示了 copy 与历史之间存在可读的语义链接,作为运营排查工具是有价值的——出了 bad case,可以直接看模型「说」它为什么推。但必须强调,这仍是后验解释:copy 是在 SID 已经确定之后生成的,它与真实的决策依据之间只有相关性、没有因果保证。论文没有做任何忠实度(faithfulness)验证,比如「扰动历史后 copy 是否随之改变」「copy 声称的关联是否真的驱动了 SID 选择」。样例数量也只有 2 个。
12. 核心贡献总结¶
- 提出了「决策先于解释」的顺序翻转:相对 OneRec-Think 的 CoT→SID,PushDualGen 是 SID→copy,并用 $\langle id2text\_sep \rangle$ 把两段显式切开,使解释在在线推理时可跳过。这是一个极简却切中工业痛点的设计——把可解释性从在线成本里摘出来。
- 并行 SID + 场景感知双向对齐:以 8 个可学习压缩 token 从 Qwen2.5-Omni-3B 得到 8 个并行 embedding,逐槽独立 K-means($K=512$)避开 RQ 的误差累积;再用 Text2SID / SID2Text 这对对称任务把 SID 装进 Qwen3-0.6B 词表,并冻结原始词表 embedding 保证稳定。
- 真实的工业验证:近 10 亿用户、约 100K QPS、15% 流量 / 1.5 亿用户的 14 天 CUPED 校正 A/B,Eff. Play Rate 相对 +8.50%、Dis. Rate 相对 −37.70%。
- 生态侧的正外部性:头部曝光让渡 1.8pp 给腰尾,长尾内容获得更多曝光。
与已归档相关工作的对比¶
PauseRec PauseRec: Implicit Reasoning for LLM-based Generative Recommendation(University of Virginia × Snap Inc.,2026-06-12)¶
关系:独立并发(本文未引用 PauseRec,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文指向同一个 root cause——在 SID 生成之前插入自然语言 CoT,是一条代价高昂且未必划算的路。PushDualGen 从工业侧给出理由(100K QPS 下逐 token 解码 CoT 不可部署),PauseRec 从方法侧给出理由(CoT SFT 一致劣于朴素 next-item SFT,收益只有在昂贵的 RL 后训练之后才浮现),并进一步诊断出三大根因:世界知识言语化受损、文本–SID 嵌入空间错位、对 rationale 质量的脆弱性。两者都认定「pre-SID 的显式语言推理」是需要被拆掉的结构。
- 相近的技术骨架:(a) 两者都把文本↔SID 双向重构作为对齐 SID 符号的地基——PushDualGen 的 $\texttt{<T2S>}$/$\texttt{<S2T>}$ 对(式 3)与 PauseRec CPT 阶段的 $\mathcal{L}_{\mathrm{CPT}} = -\mathbb{E}[\log p(s_i|d_i) + \log p(d_i|s_i)]$ 在形式上完全同构;(b) 两者都只训练新增 token 的 embedding、冻结原有词表(PushDualGen 的 Token Freeze,PauseRec 的 Stage 1 只训 $e_{\langle pause\rangle}$);(c) 两者都在「历史 → 目标 SID」之间插入一个特殊 token 来切分语义段($\langle id2text\_sep\rangle$ vs $\langle pause\rangle$)。
- 本文的差异与推进:分歧在于语言到底该不该留、留在哪里。PauseRec 的答案是「彻底不要言语化」——用可训练的 latent $\texttt{<pause>}$ token 在 SID 之前做隐式计算,pause 位置 mask 掉 loss,推理时不产出任何文本,代价是放弃了可解释性。PushDualGen 的答案是「言语化要留,但挪到 SID 之后并做成可选项」——保住了运营可读的推荐理由,代价是这个理由变成了后验重构而非真实推理链。同一个问题的两个互补解:一个换效率、一个换可解释性。
- 可比的方法/实验差异:PauseRec 在 Amazon Beauty/Sports/Toys 上离线评测,报告相对 SFT 与 CoT 类方法最高 +6.22%、训练 GPU 时数 −65%、推理约 3.5× 加速;PushDualGen 全部实验在快手内部数据上(Pass@k + 线上 A/B),无公开数据集、无 baseline 对照表,只有内部消融。两者的证据类型正好互补:PauseRec 有可复现的机制诊断但无线上验证,PushDualGen 有 1.5 亿用户的线上验证但方法侧披露极薄($\lambda_{Copy}$ 未给、无 w/o Copy 消融)。
LASAR LASAR: Latent Adaptive Semantic Aligned Reasoning for Generative Recommendation(北航 × Baidu,2026-05-11)¶
关系:独立并发(本文未引用 LASAR)· 已加载对方精读
- 共同关注的问题:LASAR 的开篇判断与 PushDualGen 几乎逐字对应——CoT 在 token 空间逐字生成,「对延迟敏感的推荐系统是致命的」。两者都把推理开销而非推理质量当作生成式推荐落地的第一约束。
- 相近的技术骨架:更深一层的同构在于「推理预算应当是弹性的」这一共识。LASAR 用 Policy Head 按样本预测 latent 步数 $N$,并在 RL 阶段用 REINFORCE 加 step penalty $\lambda N$ 压缩推理深度;PushDualGen 则把整段 copy 做成二值化的 skippable——线上跳过、排查时解码。两者都拒绝了「所有请求付同样推理成本」的固定预算假设,只是一个做了连续可调($N \in [1, 8]$),一个做了 0/1 开关。
- 本文的差异与推进:LASAR 的推理仍在 SID 之前($\texttt{[Prompt] <s> <t>}\times N\,\texttt{<e> [Answer]}$),只是把它搬进了连续 latent 空间以规避解码延迟,并用 stepwise bidirectional KL 把每个 latent 步锚定到对应 explicit CoT 段的 hidden state 以防表征漂移。PushDualGen 更激进也更简单:不做 latent 推理、不做 KL 对齐、不做 RL,直接把整段推理挪到 SID 之后。代价是失去了「推理辅助决策」的可能性——PushDualGen 的 copy 对 SID 预测没有任何前向贡献,而 LASAR 的 latent 步是实打实参与决策的。
- 可比的方法/实验差异:LASAR 报告推理仅多几十毫秒、比生成显式 CoT 文本快约 20×,在 Beauty/Instruments/Sports 上近乎全面 SOTA;但它需要 SFT-then-RL 两阶段 + GRPO + Terminal KL + REINFORCE 四个损失分量协同,工程复杂度远高于 PushDualGen 的「加一个分隔 token」。从工业落地角度看,PushDualGen 用极低的工程复杂度换到了 LASAR 想要的同一件事(把推理挪出关键路径),这本身是对「简单方案上线优先」这一工程价值观的一次背书。
OneRetrieval OneRetrieval: Unifying Multi-Branch E-commerce Retrieval with an Editable Generative Model(Kuaishou,2026-06-11)¶
关系:独立并发(同为快手,本文未引用 OneRetrieval)· 已加载对方精读
- 共同关注的问题:两篇快手论文从不同业务线撞上了同一个 root cause——SID 是不可读的离散码,这件事本身就是工业落地的阻力。OneRetrieval 把它具体化为「可编辑性悖论」:倒排索引分支转化率显著低于均值却动不得,因为它是唯一能让运营在数小时内注入新词的通道;PushDualGen 把它具体化为「黑箱推荐逻辑难以追溯,阻碍在 Push 这种高风险通道部署」。一个要「人能改」,一个要「人能读」,背后是同一句话:生成式推荐要上线,SID 必须对人开一个口子。
- 相近的技术骨架:两者都选择把自然语言绑定到 SID 上,且都用「文本↔SID 的对齐式微调」作为实现手段——OneRetrieval 的四阶段 SFT 中 Stage 0 把每个码本槽锚定到一个具体属性词、Stage 1 对齐 query/item 与 SID,与 PushDualGen 的 Text2SID/SID2Text 在训练形态上高度相似。两者也都保留了 SID→item 的一对多解析(PushDualGen 靠 ANN 检索,OneRetrieval 靠查找索引 $\mathcal{T}$)。
- 本文的差异与推进:分歧在于语言绑定在哪一层。OneRetrieval 是内生式的:通过 Keyword-Aligned Encoding 让 SID 的每一位就等于一个可解释的关键属性词(外加预留槽支持运营当天注入新词),语义在 tokenizer 层就是透明的,代价是必须放弃基于量化 embedding 的通用语义、依赖一部 $1.08 \times 10^6$ 词的生产属性字典。PushDualGen 是外挂式的:SID 本身仍是不可读的 K-means 码字,可读性由一个额外的解码头(copy)事后提供,代价是解释与决策之间没有硬绑定。两条路的取舍很干净——内生式可解释可以做到「可编辑/可干预」,外挂式可解释只能做到「可阅读」,但后者对既有 SID 体系零侵入。
- 可比的方法/实验差异:OneRetrieval 有完整的离线 baseline 对比表、码本设计消融、编码范式对比(KAE vs 量化)以及线上 A/B,方法论披露远比 PushDualGen 充分;PushDualGen 只有一张 6 行的内部消融表。两者都已在快手线上部署(OneRetrieval 在站外搜索,PushDualGen 在 Push),可以视为同一家公司在「让 SID 对人可见」这个问题上的两次独立尝试。
初筛中被剔除的近似候选(记录门槛,防止放水):
- STEPS STEPS(ByteDance):场景完全一致(工业 push notification),但问题指向何时推(自触发式调度循环,模型生成自己下次被唤醒的时间)而非推什么 + 能否解释;解法是 planning agent 的自触发闭环,与 SID 生成/文案解耦没有任何抽象重合。场景同构 ≠ 问题同构。
- OneReason OneReason(Kuaishou):同为快手 OneRec 系的推理工作,问题域重叠,但解法方向相反——它通过四粒度感知预训练 + 三级认知 CoT 让 thinking mode 稳定超过 non-thinking,是在加厚 CoT;PushDualGen 是在拆掉 pre-SID CoT。解法路径反向,不构成孪生。
- SELLER SELLER:同样产出「可解释推荐」文本,但问题是解释的质量与评测(双路编码器 + MoE adapter 注入行为序列),既无 SID 生成、也无在线延迟约束,方法流程图与本文无法抽象重合。
- AIR AIR:同样攻击「LLM 推理在工业服务里太贵」,但解法是把推理整体离线化并缓存为原子行为-意图对、线上只做意图树检索;PushDualGen 是保留在线生成但让解释段可跳过。问题相邻、解法骨架不同。
- SIF SIF / IAT IAT:与本文的 context compression 模块有表面相似(把历史压成 token),但其 root cause 是判别式排序里人工特征的信息瓶颈,而非 LLM 上下文窗口 + SID 语义对齐;且都不涉及生成式解码与可解释性。
讨论与局限性¶
核心贡献的价值。这篇论文最值得借鉴的不是任何一个模块,而是那个顺序翻转本身:当一个「增强项」(可解释性)位于关键路径上游时,它的成本无法被摊薄;把它挪到下游,成本就变成了可选项。这个思路的适用面远超 Push——任何「模型要同时输出决策与理由」的工业系统都可以问一句:理由必须在决策之前吗?OneRec-Think 的答案是「是的,因为理由要帮助决策」;PushDualGen 的答案是「未必,如果理由的主要消费者是人而不是模型」。这是一次典型的需求侧重新定义:把「可解释性」从模型能力问题降级为产品交付问题,从而换到了数量级的成本下降。
工业落地的实质。三处细节透露了真实的部署形态:(1) Top-N SIDs 到在线侧是 periodic refresh 而非请求级调用,说明 LLM 生成是离线/近线跑的;(2) 融合式 $e'_u = \alpha e_u + \beta e_s$ 且 $\alpha = \beta = 1$,说明它是一路增量信号注入既有 ANN 检索,而非端到端替换级联链路;(3) ANN 检索标注「小于 10ms」。把三点连起来,PushDualGen 在快手 Push 里的角色更接近「一个语义化的召回补充源 + 一个运营可读的解释产出器」,而不是 OneRec 那种端到端重构。这是一个务实得多、也保守得多的定位,A/B 收益的分布(点后指标大涨、触达指标微涨)也与之吻合。
局限一:copy 的忠实度完全未经检验。 全文的卖点是 Interpretable Copy,但 copy 是在 SID 确定之后生成的后验重构,论文没有任何忠实度实验(扰动历史后 copy 是否变化、copy 声称的关联是否真的驱动了 SID 选择),可解释性证据只有 Figure 3 的 2 个 case。一个 post-hoc rationalization 头完全可能学会生成「听起来合理但与真实决策无关」的文案——这在可解释性文献里是被反复警告的失败模式。
局限二:最核心的设计缺少消融。 表 2 消融了 Parallel SID、SID Adaptation、Token Freeze、Multi-token Binding 四项,唯独没有 w/o Copy Generation;$\lambda_{Copy}$ 的取值也未披露。读者因此无法判断:加入 copy 这个辅助目标,对 SID 预测本身是正则化红利还是纯粹的能力占用?考虑到这是论文的标题级贡献,这个缺失比较致命。
局限三:与 OneRec-Think 无任何定量对比。 论文的整个动机建立在「OneRec-Think 太贵」之上,却既没有给出两者的延迟/吞吐对比数字,也没有给出效果对比。「CoT 的解码开销 prohibitive」是一句定性断言,缺少哪怕一行 latency 数据支撑。
局限四:评测完全内部化、方法披露偏薄。 无公开数据集、无外部 baseline、无代码。Pass@k 这个离线指标只在内部数据上定义,横向不可比。方法侧承认 K-means 是因为「简单高效」、更好的量化留作 future work,$\lambda_{Copy}$、$\tau$、$\lambda$、batch size、模型并行方案等均未披露。记号也不统一($M$ 与 $L$ 混用指代 SID 长度,式 (4) 的求和上界写成 $M-1$ 但那里指的是目标 token 数)。
与已有工作的差异定位。相对 OneRec 系,PushDualGen 不是新一代端到端系统,而是一个面向特定场景(Push)的轻量分支:换掉了 SID 的构造方式(并行 K-means 而非残差量化)、换掉了推理与解释的相对顺序、缩小了骨干规模(0.6B)、并把自己降级为召回增量信号。相对学术界的 latent-reasoning 路线(PauseRec、LASAR),它走了完全相反的方向——不是把语言藏进 latent 空间,而是把语言留在外面但挪到后面。相对快手自家的 OneRetrieval,它选了外挂式而非内生式的可解释性。
未来工作。论文自述计划扩大 PushDualGen 的模型规模,并把它推广到 Push 之外的场景。从上文的局限看,更迫切的其实是:给 copy 加一层忠实度约束或验证(比如让 copy 反向重构 SID 作为一致性正则),以及补上 w/o Copy 的消融与对 OneRec-Think 的延迟对照。