GloRank:把重排的动作空间从"局部下标"换成"全局标识符"
From Local Indices to Global Identifiers: Generative Reranking for Recommender Systems via Global Action Space 作者:Pengyue Jia*、Xiaobei Wang*、Yingyi Zhang*、Shuchang Liu、Yupeng Hou、Hailan Yang、Xu Gao、Xiaopeng Li、Yejing Wang、Julian McAuley、Xiang Li、Lantao Hu、Yongqi Liu、Kaiqiao Zhan、Han Li、Kun Gai、Xiangyu Zhao 机构:香港城市大学(City University of Hong Kong)、快手科技(Kuaishou Technology)、加州大学圣地亚哥分校(UC San Diego) arXiv:2604.25291v1(2026-04-28,cs.IR,12 页 ACM 双栏模板) 部署:某 4 亿+ DAU 内容平台(据在线指标口径与作者机构判断为快手主 App)重排阶段,7.8% 流量、14 天线上 A/B
一句话:现有 list-wise 重排模型都把"选第 k 个候选"当作动作,于是同一个输出神经元在不同请求里代表不同物品——GloRank 证明这会给输出层梯度引入一项不可消除的 mapping-induced 方差,并把动作空间换成由 RQ Semantic ID 构成的固定全局词表,用"SFT 模仿最优排列 + GRPO 最大化列表效用 + Trie 约束解码"三件套,在两个公开 benchmark、一个工业数据集和线上 A/B 上全面超过 SOTA,且冷启动鲁棒性远优于最强 baseline GoalRank。
一、研究动机与背景
1.1 重排阶段的结构性困难
在现代推荐系统的多阶段流水线(召回 → 排序 → 重排)中,重排是最后一环,直接决定最终曝光的列表。与前面阶段"过滤候选池"的目标不同,重排要优化的是列表的集体效用(collective utility),即必须显式建模 intra-list item dependencies(列表内物品之间的互斥、互补、位置级联效应)。
形式化地,重排是一个组合优化问题:从大小为 $N$ 的候选集中选出并排定 $K$ 个物品,排列空间大小为
$$\frac{N!}{(N-K)!} \tag{1}$$
工业场景里 $N$ 通常是几十到几百,这个阶乘级复杂度在严格延迟约束下完全不可穷举。更糟的是,用户反馈只对唯一那条被展示的列表可观测,相对于底层排列空间而言监督信号极度稀疏。这两点使得重排模型既难训得有效,也难训得稳定。
1.2 两条既有技术路线
- Generator-only(生成器单体):用自回归模型或生成式解码策略直接产出排好序的列表。代表工作 Seq2Slate、PRM、DLCM、GoalRank。优点是端到端简洁。
- Generator-Evaluator(生成器-评估器):基于"判别一条好列表比直接生成一条好列表更容易"的直觉,把过程解耦为两阶段——一个或多个生成器先提出若干候选排列,再由一个独立的 evaluator 用 list-wise 价值函数挑出最优序列,从而显式建模已生成列表里的 inter-item 交互。代表工作 PIER、NAR4Rec、MG-E。近年在工业系统里更流行。
1.3 本文诊断的根因:语义不一致的动作空间
作者指出,无论 Generator-only 还是 Generator-Evaluator,现有架构(PRM、GoalRank、MG-E 等)都运行在一个 position-dependent 的动作空间里:模型学的是"选第 $k$ 个候选",动作由物品在输入列表中的相对下标定义,而不是由物品的内在身份定义。
这造成一个语义不一致的映射:同一个输出神经元(logit)在不同样本里对应完全不同的物品,取决于随机化的输入顺序。
Figure 1: Semantic Inconsistency in Action Spaces. (该 teaser 为首页矢量拼版,图片抽取器未单独切出,此处按原文版面转述)其结构为:Sample 1 与 Sample 2 各自的 User History + Candidates 送进同一个 Model,两者共用同一块 "Action Space / Logits";由于两个样本的候选顺序不同,同一条 logit 在两个样本里指向不同物品,故中间标注 "Semantically Inconsistent Action Space"。
后果是:模型学不到"iPhone 这件商品本身是好的"这种物品内在效用,反而倾向于过拟合下标本身的伪相关模式(例如记住"统计上第 3 个位置更值得选"),泛化性因此很差。
由此作者提出主张:稳健的重排需要一次范式转移——从"选择局部下标"转为"生成全局标识符",动作必须由物品固定的语义身份定义,与它在候选列表里的临时位置无关。
但直接实现这一点并不平凡:工业语料常达百万甚至千万量级物品,一个扁平的全局词表对标准生成模型来说计算上不可承受。于是核心挑战被凝练为一句话:
如何在把重排锚定到一致的全局空间的同时,绕开巨型词表的可扩展性瓶颈?
1.4 GloRank 的答案与贡献
GloRank(Global Action Space Ranker)用 Semantic ID(SID)把百万级物料压缩成一个紧凑的固定全局词表:每个物品被表示为若干离散 token 的序列,重排随之从"选动态局部下标"重述为"生成静态全局标识符"。这不仅让模型学到与物品语义直接挂钩的稳定评估标准,还因为 SID 在召回阶段已被广泛采用(OneRec、TIGER 等),顺带改善了跨阶段建模一致性。
配套设计包括:受大规模推荐模型现代训练框架(GoalRank、OneRec-V2)启发的两阶段优化流水线——监督预训练模仿高质量参考列表,随后基于强化学习的后训练直接优化列表级奖励;以及一个在候选集上维护生成树的约束解码方案,保证输出的物品合法且不重复。
论文自述三条贡献: 1. 识别出语义不一致动作空间是既有重排范式的根本瓶颈,并分析了依赖动态相对下标如何让输出节点的语义随输入顺序改变,阻止模型建立稳定的物品估值标准; 2. 提出 GloRank——一个简洁有效的生成式重排框架,主张从局部下标选择转向全局标识符生成,在固定全局词表上建模输出空间、用两阶段范式训练、用约束解码推理; 3. 在两个公开 benchmark + 一个大规模工业数据集 + 线上 A/B 上验证,全面超过 SOTA,并在冷启动场景取得显著更强的鲁棒性。
二、理论分析:局部索引为何在输出层引入不可消除的方差
这是全文最有分量的一节。作者要证明的是:在 position-dependent 动作空间下,即便目标物品身份固定,某个固定输出参数行收到的监督信号仍然是随机的,这会在输出层梯度里引入一项额外的、不可消除的方差,从而导致训练不稳定。
2.1 List-wise 重排的形式化
令 $\mathcal{V}$ 为全局物品全集。对上下文为 $x$ 的每个请求,重排阶段收到候选集 $\mathcal{C} = \{v_1, \dots, v_N\} \subset \mathcal{V}$,输出有序列表 $R = [r_1, \dots, r_K]$,$K \le N$。考虑一个自回归 list-wise 生成器,其步级分布为 $p_\theta(r_t \mid x, \mathcal{C}, r_{<t})$,通过在目标列表 $R^*$ 上最小化步损失之和(如交叉熵)来训练:
$$\mathcal{L}(\theta) = \sum_{t=1}^{K} \ell\big(\mathbf{z}^{(t)}_\theta,\, y^{(t)}\big) \tag{2}$$
其中 $\mathbf{z}^{(t)}_\theta \in \mathbb{R}^{A}$ 是 $p_\theta$ 的输出 logits,$A$ 是动作空间大小。logits 由隐状态线性投影得到:
$$\mathbf{z}^{(t)}_\theta(\sigma) = \mathbf{W}\,\mathbf{h}^{(t)}_\sigma \tag{3}$$
其中 $\mathbf{h}^{(t)}_\sigma = h^{(t)}_\phi(x, \sigma(\mathcal{C}), r_{<t}) \in \mathbb{R}^d$ 是输出前的隐状态,$\mathbf{W} \in \mathbb{R}^{A \times d}$ 是输出层参数矩阵,$\sigma$ 表示用于构造有序输入 $\sigma(\mathcal{C})$ 的候选列表排列。作者显式允许 $\mathbf{h}^{(t)}_\sigma$ 依赖 $\sigma$(因为有位置嵌入和对有序输入的 attention)。
对交叉熵,关于 $\mathbf{W}$ 的梯度为
$$\nabla_{\mathbf{W}}\, \ell\big(\mathbf{z}^{(t)}(\sigma), y^{(t)}(\sigma)\big) = \big(\mathbf{p}^{(t)}(\sigma) - \mathbf{e}_{y^{(t)}(\sigma)}\big)\big(\mathbf{h}^{(t)}_\sigma\big)^{\top} \tag{4}$$
其中 $\mathbf{p}^{(t)}(\sigma) = \mathrm{softmax}(\mathbf{z}^{(t)}(\sigma))$,$\mathbf{e}_y$ 是 $y$ 的 one-hot 向量。
为了把"动作空间语义"(它决定监督被施加到 $\mathbf{W}$ 的哪一行)带来的不稳定隔离出来,只分析输出层梯度里依赖标签的那一项:
$$\mathbf{G}^{(t)}_{\mathrm{label}}(\sigma) \triangleq -\,\mathbf{e}_{y^{(t)}(\sigma)}\big(\mathbf{h}^{(t)}_\sigma\big)^{\top} \tag{5}$$
随机矩阵 $\mathbf{X}$ 的方差用平方 Frobenius 偏差度量:
$$\mathrm{Var}_\sigma(\mathbf{X}) \triangleq \mathbb{E}_\sigma\big[\lVert \mathbf{X} - \mathbb{E}_\sigma[\mathbf{X}]\rVert_F^2\big] \tag{6}$$
2.2 语义不一致与输出层方差
在 PRM、GoalRank 这类架构里,动作空间定义在局部候选下标上,$A = N$。此时每一维输出的语义依赖输入顺序:同一行 $\mathbf{W}$ 在不同排列下对应不同物品。
固定一个生成步 $t$ 和一个语义目标物品 $r^*_t \in \mathcal{C}$。在排列 $\sigma$ 下,被监督的标签是该物品在置换后列表中的位置:
$$y^{(t)}_{\mathrm{loc}}(\sigma) = \mathrm{pos}_\sigma(r^*_t) \in \{1, \dots, N\} \tag{7}$$
定义"目标物品是否出现在位置 $j$"的指示变量:
$$I^{(t)}_j(\sigma) \triangleq \mathbb{I}\big(y^{(t)}_{\mathrm{loc}}(\sigma) = j\big) \tag{8}$$
当 $\sigma$ 在排列上均匀采样时,$I^{(t)}_j$ 服从伯努利分布:
$$\mathbb{P}\big(I^{(t)}_j = 1\big) = \frac{1}{N} \tag{9}$$
记 $\mathbf{w}^{\top}_j$ 为 $\mathbf{W}$ 的第 $j$ 行。由式 (5),落到 $\mathbf{w}_j$ 上的标签依赖梯度分量为
$$\mathbf{g}^{(t)}_{j,\mathrm{loc}}(\sigma) \triangleq -\,\mathbb{I}\big(y^{(t)}_{\mathrm{loc}}(\sigma) = j\big)\,\mathbf{h}^{(t)}_\sigma = -\,I^{(t)}_j(\sigma)\,\mathbf{h}^{(t)}_\sigma \tag{10}$$
这一项呈"开关(on–off)"形态:行 $\mathbf{w}_j$ 只有在固定目标物品恰好落到位置 $j$ 时才收到监督。
命题 2.1(局部下标下不可消除的 mapping-induced 方差):固定步 $t$ 和目标物品 $r^*_t$,设 $\sigma$ 在排列上均匀分布使 $\mathbb{P}(I^{(t)}_j = 1) = 1/N$。令 $\boldsymbol{\mu}^{(t)}_j \triangleq \mathbb{E}_\sigma[\mathbf{h}^{(t)}_\sigma \mid I^{(t)}_j = 1]$。若 $\boldsymbol{\mu}^{(t)}_j \ne \mathbf{0}$,则落到行 $\mathbf{w}_j$ 的标签依赖梯度具有严格正的方差:
$$\mathrm{Var}_\sigma\big(\mathbf{g}^{(t)}_{j,\mathrm{loc}}\big) \;\ge\; \frac{1}{N}\Big(1 - \frac{1}{N}\Big)\big\lVert \boldsymbol{\mu}^{(t)}_j \big\rVert_2^2 \;>\; 0 \tag{11}$$
证明思路:对 $I^{(t)}_j$ 用全方差公式:
$$\mathrm{Var}_\sigma\big(\mathbf{g}^{(t)}_{j,\mathrm{loc}}\big) = \mathbb{E}_{I^{(t)}_j}\Big[\mathrm{Var}\big(\mathbf{g}^{(t)}_{j,\mathrm{loc}} \mid I^{(t)}_j\big)\Big] + \mathrm{Var}_{I^{(t)}_j}\Big(\mathbb{E}\big[\mathbf{g}^{(t)}_{j,\mathrm{loc}} \mid I^{(t)}_j\big]\Big) \ge \mathrm{Var}_{I^{(t)}_j}\Big(\mathbb{E}\big[\mathbf{g}^{(t)}_{j,\mathrm{loc}} \mid I^{(t)}_j\big]\Big) \tag{12}$$
由式 (10) 有 $\mathbb{E}[\mathbf{g}^{(t)}_{j,\mathrm{loc}} \mid I^{(t)}_j = 0] = \mathbf{0}$、$\mathbb{E}[\mathbf{g}^{(t)}_{j,\mathrm{loc}} \mid I^{(t)}_j = 1] = -\boldsymbol{\mu}^{(t)}_j$。因此 $\mathbb{E}[\mathbf{g}^{(t)}_{j,\mathrm{loc}} \mid I^{(t)}_j]$ 是一个伯努利驱动的随机向量:以概率 $p = 1/N$ 取 $-\boldsymbol{\mu}^{(t)}_j$,以概率 $1-p$ 取 $\mathbf{0}$。这个 mapping-induced 方差恰为
$$\mathrm{Var}_{I^{(t)}_j}\Big(\mathbb{E}\big[\mathbf{g}^{(t)}_{j,\mathrm{loc}} \mid I^{(t)}_j\big]\Big) = \frac{1}{N}\Big(1 - \frac{1}{N}\Big)\big\lVert \boldsymbol{\mu}^{(t)}_j \big\rVert_2^2 > 0 \tag{13}$$
与式 (12) 合并即得式 (11)。$\square$
物理含义:无论目标物品下标固不固定,固定输出行 $\mathbf{w}_j$ 收到的监督信号总是不稳定的,因为"物品 → 输出行"的映射依赖 $\sigma$。而且即使 $\mathbf{h}^{(t)}_\sigma$ 对 $\sigma$ 完全不变,这项方差也不会消失——只要目标物品在排列分布下可能出现在多个位置,它就严格为正。这一点很关键:它说明问题不出在编码器,而出在动作空间的定义方式本身。
2.3 全局物品空间下的稳定性
考虑另一种形式化:动作空间定义在固定的全局物品空间上,每个物品 $v \in \mathcal{V}$ 被赋予唯一标识符 $\mathrm{ID}(v)$,监督标签对 $\mathcal{C}$ 的排列不变:
$$y^{(t)}_{\mathrm{glo}} = \mathrm{ID}(r^*_t) \tag{14}$$
由于 $\mathbf{W}$ 的每一行现在对应一个全局标签,落到目标行的标签依赖梯度是稳定的:
$$\mathbf{g}^{(t)}_{\mathrm{glo}}(\sigma) \triangleq -\,\mathbf{h}^{(t)}_\sigma \tag{15}$$
它与候选列表如何被置换无关。
推论 2.2(全局标签下 mapping-induced 方差为零):在式 (14) 的全局标签下,mapping-induced 方差为零,只剩编码方差:
$$\mathrm{Var}_\sigma\big(\mathbf{g}^{(t)}_{\mathrm{glo}}\big) = \mathrm{Var}_\sigma\big(\mathbf{h}^{(t)}_\sigma\big) \tag{16}$$
理想情况下,若编码器把候选当作无序集合处理、$\mathbf{h}^{(t)}$ 对 $\sigma$ 不敏感,则式 (16) 进一步归零。
讨论:对比式 (11) 与式 (16),局部位置依赖的形式化多出了一项来自"物品-输出行随机指派"的方差。把监督锚定在全局一致的物品空间可以移除这项 mapping-induced 方差,只留下编码器表示本身固有的方差。
这套论证的漂亮之处在于:它把一个看起来像"表示学习偏好"的设计选择(用 SID 而非下标),转化成了一个可证明的优化稳定性命题——下界 $\frac{1}{N}(1-\frac{1}{N})\lVert\boldsymbol{\mu}\rVert^2$ 是显式的,且随 $N$(候选集大小)变化:$N$ 很小时接近 0,$N$ 中等时(工业上几十到几百)这项方差最显著。
三、核心方法:GloRank
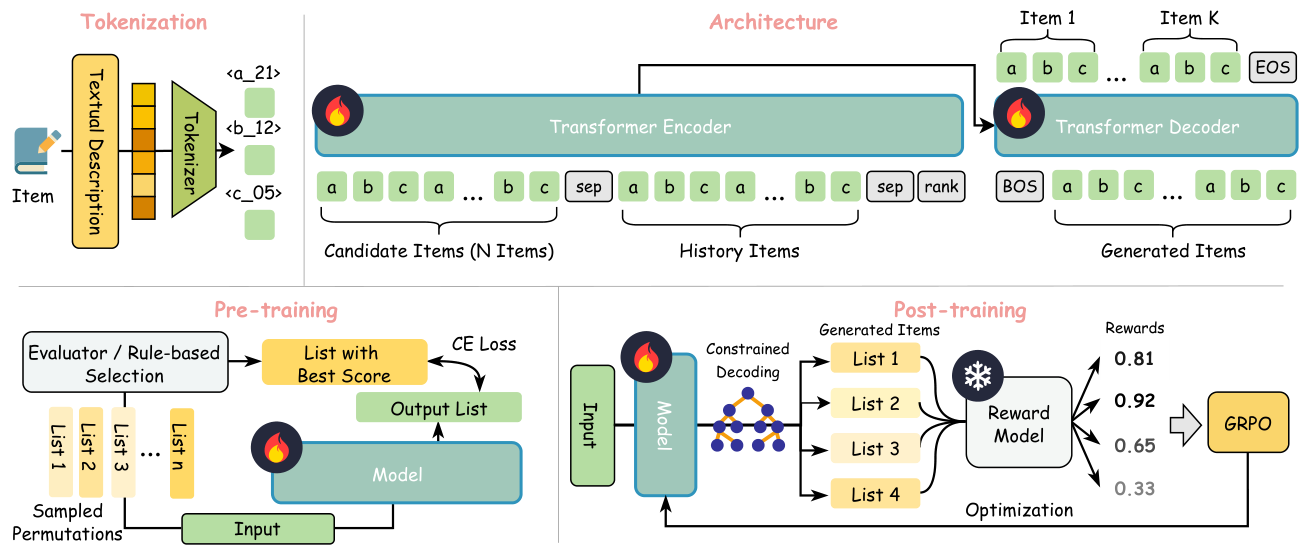
整体框架分四块:3.1 用 SID 高效构造稳定的全局动作空间;3.2 把 list-wise 重排重述为序列生成的骨干架构;3.3 解耦的两阶段优化流水线;3.4 前缀树约束解码,桥接全局动作空间与局部候选集。
3.1 Tokenization:用 RQ Semantic ID 压缩全局词表
要在重排框架里落地"全局物品空间"的概念,需要一种既全局一致、又计算高效的物品表示。传统的 atomic ID(每个物品一个唯一 ID)维度过高、缺乏语义连续性、对冷启 ID 表示学习不足,不适合建模所需的大规模全局词表。作者转而采用基于 RQ 的 Semantic ID,把物品映射进一个紧凑的层次化离散空间。分两步:
3.1.1 语义序列化(Semantic Serialization)。把物品 $v \in \mathcal{V}$ 的文本属性(标题、描述等)按预定义 prompt 模板聚合成统一文本序列 $T_v$,再送进预训练文本编码器(如 Sentence-T5、Qwen3-Embedding)得到稠密语义向量 $\mathbf{h}_v = \mathrm{Encoder}(T_v)$,$\mathbf{h}_v \in \mathbb{R}^D$。
3.1.2 残差量化(Residual Quantization)。用 RQ 技术(RQ-VAE 或 RQ-Kmeans)把连续向量离散化。在第 $m$ 级($1 \le m \le M$,$M$ 为码本数)从学到的码本 $\mathcal{C}_m$ 中选取使上一级残差误差最小的码字。记量化函数为 $Q(\cdot)$:
$$s_v = [c_1, c_2, \dots, c_M] = Q(\mathbf{h}_v;\, \Theta_Q) \tag{17}$$
其中 $s_v$ 是由 $M$ 个离散 token 构成的 SID 序列,$\Theta_Q$ 是码本参数。每个 token $c_m$ 对应第 $m$ 级粒度上的一个语义簇。这样物品 $v$ 被 $s_v$ 唯一标识,物品选择随之被重述为在固定紧凑全局词表 $\mathcal{V}_{\mathrm{token}} = \bigcup_{m=1}^{M}\mathcal{C}_m$ 上的序列生成任务。
规模换算:$M = 4$、码本大小 256 时,全局词表只有 $4 \times 256 = 1024$ 个 token,可表达 $256^4 \approx 4.3 \times 10^9$ 个物品——这正是"绕开扁平巨型词表"的关键。
3.2 架构:Transformer Encoder-Decoder
为了捕捉物品间复杂依赖以及生成列表内部的模式,GloRank 用 transformer encoder-decoder 作骨干,把整个输入编码成一个序列,并在生成过程中捕捉 inter-item 依赖(沿用 TIGER 与 SID 实践手册的做法)。
3.2.1 输入构造。输入是按特定 prompt 模板序列化的 SID 序列。记 $S(\cdot)$ 为把物品集合映射为拼接 SID 序列的序列化函数,给定候选集 $\mathcal{C}$ 与用户交互历史 $\mathcal{H}$,输入序列为
$$X_{\mathrm{input}} = \text{“}S(\mathcal{C})\,\texttt{<sep>}\,S(\mathcal{H})\,\texttt{<sep>}\,\texttt{<rank>}\text{”}$$
其中 <sep> 是区分不同上下文片段的分隔 token,<rank> 是提示模型开始生成重排列表的 prompt token。
3.2.2 全局物品空间上的自回归生成。encoder 先把 $X_{\mathrm{input}}$ 处理成连续隐状态序列,decoder 随后自回归生成输出序列。GloRank 的关键区别在于:生成发生在固定全局词表 $\mathcal{V}_{\mathrm{token}}$ 上,而不是在 $\mathcal{C}$ 里选输入下标。每一步 $t$,decoder 在给定输入与已生成 token 的条件下预测下一 token 分布:
$$P(y_t \mid y_{<t}, X_{\mathrm{input}}) = \mathrm{Softmax}(W_o \cdot h_t) \tag{18}$$
其中 $h_t$ 是 decoder 在第 $t$ 步的隐状态,$W_o$ 把隐状态投影到词表尺寸。生成持续到达到最大列表长度;随后 token 序列被 reshape 回 item 级 SID,通过约束解码形成最终有序列表 $R$。
3.3 优化:解耦的两阶段流水线
3.3.1 预训练(Pre-training)。目标是让模型理解物品语义与基本重排原则。
一个直接做法是训模型去重建日志里曝光给用户的历史列表,但这严重依赖日志曝光列表的质量,而曝光列表未必是最优排列。作者强调:重排模型不同于常规召回模型,它需要关于未见列表的反事实(counterfactual)知识,并学会区分它们。
为缓解这一问题、提供高质量监督,作者采用基于离线评估的目标构造策略。对每个由用户历史 $\mathcal{H}$ 与候选集 $\mathcal{C}$ 构成的训练实例,先从 $\mathcal{C}$ 的排列空间采样出一组候选列表 $\mathcal{P} = \{R_1, R_2, \dots, R_L\}$,再用一个代理打分函数 $E$(可以是 list-wise evaluator,也可以是启发式规则)给每个排列打分,取分数最高的排列作为目标:
$$Y^{*} = \arg\max_{R \in \mathcal{P}} E(R, \mathcal{H})$$
以构造出的目标序列 $Y^* = [y^*_1, y^*_2, \dots, y^*_{|Y^*|}]$(一串离散 token)为监督,用标准 Next Token Prediction 的负对数似然最小化目标优化 GloRank:
$$\mathcal{L}_{\mathrm{pre}} = -\sum_{t=1}^{|Y^*|} \log P\big(y^*_t \mid y^*_{<t}, X_{\mathrm{input}};\, \theta\big) \tag{19}$$
3.3.2 后训练(Post-training)。预训练赋予模型基本语义理解与重排能力,但仍被离线数据的目标标签质量所上界。为突破这一限制、直接最大化生成列表的集体效用,引入基于强化学习的后训练阶段,采用 GRPO(Group Relative Policy Optimization),把模型的全局生成能力与"最大化 list-wise 效用"这一具体目标对齐。
在总体实验中,作者直接用 ground-truth 评估指标(具体是目标指标的算术平均)作为后训练阶段的 reward 信号。
3.4 推理:Trie 约束解码
后训练与推理阶段,GloRank 自回归生成重排列表。为保证生成的物品严格属于当前候选集 $\mathcal{C}$ 且不重复,采用基于 Trie 的约束解码(沿用 MiniOneRec 的做法):
- 对每个请求,用候选物品的 SID 构造一棵前缀树(Trie);
- 每个解码步,把不在 Trie 合法分支上的 token 概率 mask 掉;
- 一旦某个物品被完整生成,就从 Trie 中动态剪掉它对应的路径,防止重复。
由于重排场景下候选集远小于全量物品集($N \ll |\mathcal{V}|$),Trie 构造与 mask 的开销可忽略。
这一步是把"全局动作空间"和"局部候选约束"缝合起来的关键:模型在全局语义空间里做估值,但输出被硬约束回本次请求的候选集合——两全其美。
四、实验设置
论文围绕七个 RQ 组织实验:RQ1 离线标准评测下与 SOTA 的对比;RQ2 反事实评测下生成未见列表的有效性;RQ3 两阶段优化是否必要;RQ4 关键超参影响;RQ5 全局动作空间是否必要;RQ6 冷启动优势;RQ7 真实工业系统部署效果。
4.1 数据集
| Dataset | Users | Items | Interactions | Lists |
|---|---|---|---|---|
| MovieLens-1M | 6,020 | 3,043 | 995,154 | 161,646 |
| Amazon Books | 35,732 | 38,121 | 1,960,674 | 311,386 |
| Industrial Dataset | 200,775 | 17,014 | 5,173,698 | 589,751 |
两个公开 benchmark(Amazon Books、MovieLens-1M)沿用 DNR、GoalRank 的设定作标准可复现测试床;Industrial Dataset 原文描述为"采集自真实电商平台",用于验证生产环境下的有效性与鲁棒性。
⚠️ 口径不一致提示:4.1 节称工业数据集来自 e-commerce platform,但 4.10 节的线上 A/B 是在"a leading content platform"(4 亿+ DAU)上做的,指标为 Watch Time / Effective View / Like / Comment / Forward——这是典型的短视频内容消费口径,与电商不符。结合作者机构(快手),线上部分应为快手主 App;论文对工业数据集来源的措辞疑为笔误或脱敏残留。
4.2 评估指标
采用标准 list-wise 指标:Precision@K、NDCG@K、MAP@K、F1@K,分别从准确性与排序位置等角度评估。沿用 DNR 与 GoalRank 的设定,任务配置为从 50 个候选中生成长度 6 的列表,因此所有指标的截断 $K = 6$。
4.3 Baselines
- Generator-only:DNN(YouTube DNN,Covington et al. 2016)、DLCM(Ai et al. 2018,RNN 建模列表上下文)、PRM(Pei et al. 2019,首次把 transformer self-attention 引入重排)、GoalRank(Zhang et al. 2025,用 group-relative 优化直接最大化列表奖励的 one-stage 方案)。
- Generator-Evaluator:PIER(Shi et al. 2023,SimHash 生成器 + 全向上下文感知评估器)、NAR4Rec(Ren et al. 2024,非自回归生成器 + 对比解码)、MG-E(Yang et al. 2025,多生成器集成扩大搜索空间;报告 3 / 20 / 100 三种生成器数量)。
4.4 实现细节
| 项目 | 配置 |
|---|---|
| 文本字段(Amazon Books) | title、categories、description、price、brand 拼接 |
| 文本字段(MovieLens-1M) | title、genres |
| 文本编码器 | Qwen3-Embedding-4B |
| 量化算法 | RQ-Kmeans,层级深度 $M = 4$,码本大小 256 |
| 骨干 | Transformer Encoder-Decoder,标准 T5 配置 |
| 优化器 | AdamW(两阶段均用) |
| 预训练学习率 | 5e-4,weight decay 0.01 |
| 后训练学习率 | 5e-6 |
| GRPO 采样温度 | $\tau = 1.0$ |
| GRPO group size | 20 |
| 推理 | beam search,beam size 20 |
| 任务配置 | 候选 50 选 6,$K = 6$ |
五、主要实验结果
5.1 总体离线对比(RQ1)
Table 2:总体实验。加粗为最佳,下划线为次佳;Rel. Improvement 为本方法相对最强 baseline 的百分比提升。(原文数值以百分数给出,此处照录;原表为三数据集横向并排的 12 列宽表,此处按数据集拆成三张表以便阅读)
Amazon Books
| 类别 | 方法 | Precision@6 | NDCG@6 | MAP@6 | F1@6 |
|---|---|---|---|---|---|
| Generator-Only | DNN | 60.28 | 69.61 | 58.58 | 62.45 |
| Generator-Only | DLCM | 66.80 | 75.88 | 65.39 | 69.28 |
| Generator-Only | PRM | 67.86 | 76.88 | 66.44 | 70.42 |
| Generator-Only | GoalRank | 80.35 | 84.88 | 77.91 | 83.44 |
| Generator-Evaluator | PIER | 71.14 | 80.22 | 71.62 | 73.74 |
| Generator-Evaluator | NAR4Rec | 70.08 | 79.46 | 70.69 | 72.66 |
| Generator-Evaluator | MG-E-3 | 68.76 | 76.36 | 65.82 | 71.33 |
| Generator-Evaluator | MG-E-20 | 72.99 | 78.68 | 68.66 | 75.72 |
| Generator-Evaluator | MG-E-100 | 77.21 | 82.15 | 73.78 | 80.09 |
| — | GloRank | 83.75 | 90.08 | 85.10 | 86.97 |
| — | Rel. Improvement | ↑4.23% | ↑6.13% | ↑9.23% | ↑4.23% |
MovieLens-1M
| 类别 | 方法 | Precision@6 | NDCG@6 | MAP@6 | F1@6 |
|---|---|---|---|---|---|
| Generator-Only | DNN | 56.86 | 70.30 | 59.28 | 62.16 |
| Generator-Only | DLCM | 62.31 | 73.87 | 63.82 | 67.96 |
| Generator-Only | PRM | 60.09 | 72.85 | 62.21 | 65.51 |
| Generator-Only | GoalRank | 73.56 | 83.43 | 76.16 | 80.15 |
| Generator-Evaluator | PIER | 62.74 | 75.99 | 65.98 | 68.74 |
| Generator-Evaluator | NAR4Rec | 62.81 | 75.01 | 65.42 | 68.31 |
| Generator-Evaluator | MG-E-3 | 55.51 | 67.39 | 55.52 | 55.51 |
| Generator-Evaluator | MG-E-20 | 58.66 | 69.86 | 58.60 | 64.18 |
| Generator-Evaluator | MG-E-100 | 60.64 | 70.97 | 59.93 | 66.29 |
| — | GloRank | 75.79 | 87.56 | 81.19 | 82.57 |
| — | Rel. Improvement | ↑3.03% | ↑4.95% | ↑6.60% | ↑3.02% |
Industrial Dataset
| 类别 | 方法 | Precision@6 | NDCG@6 | MAP@6 | F1@6 |
|---|---|---|---|---|---|
| Generator-Only | DNN | 32.80 | 51.26 | 41.02 | 38.97 |
| Generator-Only | DLCM | 47.86 | 73.03 | 63.16 | 56.89 |
| Generator-Only | PRM | 47.89 | 67.09 | 54.59 | 56.88 |
| Generator-Only | GoalRank | 60.16 | 88.08 | 82.06 | 71.48 |
| Generator-Evaluator | PIER | 56.69 | 80.15 | 70.52 | 67.52 |
| Generator-Evaluator | NAR4Rec | 51.93 | 65.16 | 53.13 | 61.56 |
| Generator-Evaluator | MG-E-3 | 48.53 | 67.38 | 54.89 | 57.67 |
| Generator-Evaluator | MG-E-20 | 51.58 | 69.29 | 57.26 | 61.08 |
| Generator-Evaluator | MG-E-100 | 53.21 | 70.67 | 58.80 | 63.06 |
| — | GloRank | 62.56 | 90.15 | 84.84 | 74.32 |
| — | Rel. Improvement | ↑3.99% | ↑2.35% | ↑3.39% | ↑3.97% |
结论分析:
-
GloRank 在三个数据集、全部四个指标上一致最优,验证了把重排锚定在稳定全局物品空间能学到更鲁棒、更可迁移的估值标准。值得注意的是提升幅度在排序敏感指标上最大——Amazon Books 上 MAP@6 提升 9.23%,远高于 Precision/F1 的 4.23%。这不是巧合:Precision/F1 只关心"选中的集合对不对",MAP/NDCG 还关心"顺序对不对",而顺序恰恰是最受动作空间语义不一致伤害的部分。
-
Generator-Evaluator 方法总体优于传统 Generator-only 方法(PIER/NAR4Rec 优于 DLCM/PRM),支持"解耦生成与评估能更充分探索排列空间"这一主流观点——评估器可以显式建模生成器可能漏掉的 intra-list 相关性。
-
GoalRank 是 Generator-only 阵营里的显著例外。它用与本文后训练阶段相似的 group-relative 优化策略,反超了标准 Generator-Evaluator 方法。这说明先进的策略优化可以有效弥合 Generator-only 与 Generator-Evaluator 之间的差距。但 GloRank 仍然超过 GoalRank——这一点是全文最关键的对照:收益不只来自优化方法(两者都用 group-relative RL),更来自全局空间的形式化本身。
-
MG-E 变体随生成器数量增加而稳定提升(MG-E-3 → MG-E-20 → MG-E-100),确认扩大搜索空间确实提升排序质量。但 GloRank 用单个生成式策略就取得更优结果,绕开了并行跑上百个生成器的巨大计算开销。这是一条重要的工程含义:与其横向堆生成器数量,不如纵向修正动作空间的语义。
5.2 反事实评测(RQ2)
标准离线评测依赖静态历史日志,天然存在选择偏差——只能评估曾被日志策略曝光过的列表。为在更贴近现实的环境中严格评估生成式方案,作者在 MovieLens-1M 上按 KuaiSim 的既有协议做基于仿真器的评测。
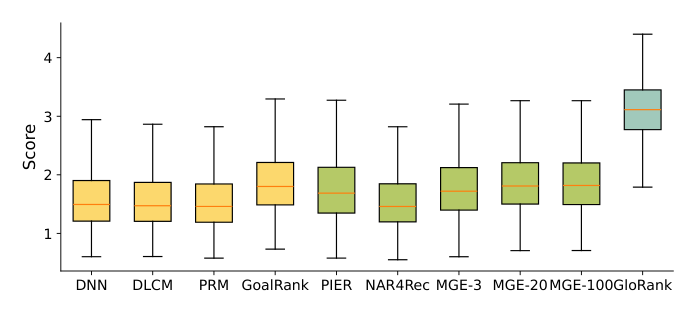
从箱线图可读出:
- GloRank 相对全部 baseline 有显著优势。其得分分布明显更高(中位数约 3.1,箱体约 2.9–3.45,须至约 4.4;而所有 baseline 中位数都在 1.4–1.85 区间),中位数与上四分位数都远超最强 baseline。这说明 GloRank 不只是平均更好,而且优化列表效用的上限更高。
- 结论与离线评测一致:GoalRank 与 MG-E-100 仍是最有竞争力的 baseline,它们的相对强势印证了建模 list-wise 交互的重要性;但两者仍显著不及 GloRank,凸显位置依赖动作空间在探索最优策略上的局限。
值得注意的是,在仿真评测里 GloRank 的分布与 baseline 群体几乎不重叠,这个 gap 比离线表格里的百分比差距要触目得多——说明离线指标可能低估了动作空间修正带来的真实收益。
六、消融与分析
6.1 两阶段优化流水线消融(RQ3)
对比两个变体:
- w/o pre:跳过监督预训练,直接用随机权重初始化后做奖励驱动的后训练;
- w/o post:只做预训练。
Table 3:消融实验
| 方法 | AB Precision@6 | AB NDCG@6 | AB MAP@6 | AB F1@6 | ML Precision@6 | ML NDCG@6 | ML MAP@6 | ML F1@6 |
|---|---|---|---|---|---|---|---|---|
| w/o pre | 20.85 | 24.13 | 14.00 | 21.64 | 18.53 | 24.04 | 14.19 | 20.09 |
| w/o post | 83.44 | 89.15 | 83.68 | 86.63 | 75.51 | 85.94 | 78.85 | 82.28 |
| Ours | 83.75 | 90.08 | 85.10 | 86.97 | 75.79 | 87.56 | 81.19 | 82.57 |
(AB = Amazon Books,ML = MovieLens-1M)
结论分析:
- 两个阶段都有正向贡献,去掉任何一个都会在两个数据集的所有指标上退化,说明"监督学习 + 奖励驱动效用最大化"的组合对有效的重排框架是必要的。
- 预训练是 GloRank 的地基。w/o pre 变体出现灾难性崩塌(Amazon Books 上 NDCG 从 90.08 掉到 24.13,MAP 从 85.10 掉到 14.00,损失 84%)。这说明没有高质量示范上的监督初始化,模型连"物品的基本语义"和"合法排序列表的句法"都学不会——纯 RL 冷启在一个 1024 token 的组合空间里根本找不到有效梯度方向。这也是所有 SID 生成式方案的共性:离散 token 序列的合法性先验必须靠 SFT 灌进去。
- 后训练的增益虽小但集中在排序敏感指标上。MovieLens-1M 上后训练把 MAP 提升 2.34 个点(78.85 → 81.19)、NDCG 提升 1.62 个点(85.94 → 87.56),而 Precision(+0.28)与 F1(+0.29)的增幅小得多。作者归因于两阶段目标的差异:预训练主要激励模型从全局池中区分正样本,可能弱化了列表内部精确的相互顺序;后训练则通过与 reward model 的直接交互,提供关于 list-wise 效用的显式反馈。换句话说,SFT 负责"选对集合",GRPO 负责"排对顺序"。
6.2 超参分析(RQ4)
在 Amazon Books 上分析四个关键超参:后训练阶段的 group size $G$、训练步数、KL 正则系数 $\beta$,以及推理阶段的 beam size $B$。(作者说明 Precision 与 F1 趋势高度一致、MAP 与 NDCG 高度一致,因此只展示 Precision 与 MAP。)
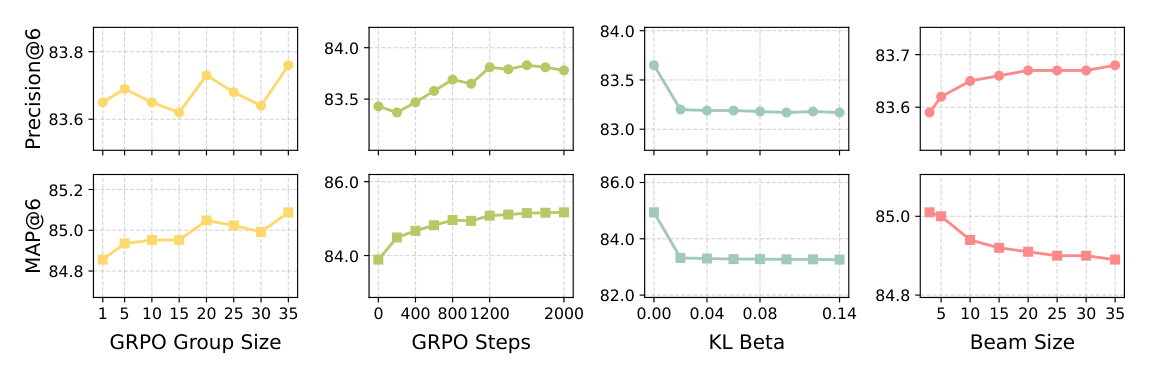
- Group Size $G$:随 $G$ 从 1 增到 35,两个指标都稳定改善(Precision@6 约 83.65 → 83.76,MAP@6 约 84.87 → 85.09)。这与 GRPO 的理论一致:更大 group 提供更多样本估计 group-relative baseline,降低优势估计的方差、稳定策略梯度。
- Training Steps:性能在初期迅速改善,随后进入稳定平台期(MAP@6 从 ~83.95 升至 ~85.1 后走平;Precision@6 从 ~83.45 升至 ~83.8)。说明 GloRank 收敛高效,不出现严重坍塌。
- KL 系数 $\beta$:$\beta = 0$(完全去掉 KL 惩罚)时性能最好(MAP@6 在 $\beta=0$ 时 ~85.25,$\beta \ge 0.02$ 后骤降到 ~83.3 并保持平坦;Precision@6 同样从 83.65 掉到 83.2)。这与 Open-Reasoner-Zero、DAPO、"Understanding R1-Zero-like training" 等近期 RL 工作的结论一致。作者归因:严格贴近预训练参考策略限制了模型探索,去掉约束才能让策略充分为排序效用做优化。
- Beam Size $B$:呈现 set-based 与 rank-based 指标之间的有趣权衡——beam size 增大时 Precision@6 单调改善(83.60 → 83.68),但 MAP@6 反而略微退化(85.01 → 84.85)。作者解释:更大的 beam 找到的是更高概率的序列,其中含有更多相关物品(有利于 Precision),但自回归概率最大化并不严格等价于 MAP 所要求的最优顺序。这是生成式排序里一个容易被忽视的错配:似然最大 ≠ 排序最优。
6.3 全局动作空间是否必要(RQ5)
为验证全局动作空间在现代生成式框架里的根本必要性,作者构造了一个 LAS(Local Action Space)变体:不生成全局 SID,而是被限制在位置依赖的动作空间里,生成局部下标 token(1 到 $N$)来按相对位置选择物品。除动作空间外,其余结构与训练流程保持一致。
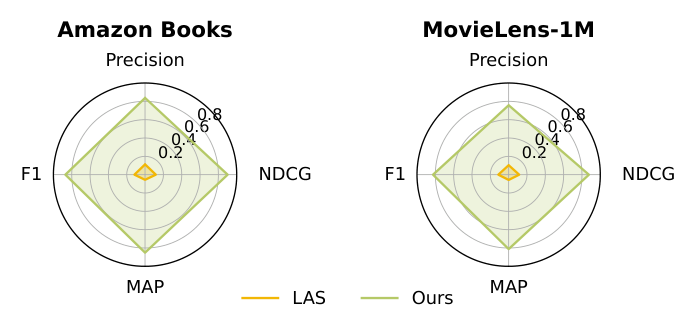
雷达图显示:在两个公开数据集的四个指标上,LAS 变体都出现大幅性能退化——LAS 的四条边全部塌缩在 0.1–0.15 附近,而 GloRank 稳定在 0.8 以上,差距接近一个数量级。
作者的解释是:局部动作空间在训练中引入噪声,阻碍优化、无法稳定收敛;经验分析还发现 LAS 变体倾向于记忆高频下标组合,而不是根据上下文选择合适的物品序列。这正是第二章理论分析("模型会记住第 3 位统计上更好")的直接实证支持。
这条消融是全文最有说服力的一条:它把"SID 带来的语义先验"和"全局动作空间带来的稳定性"两个混淆因素拆开了——LAS 与 GloRank 共享同一个 encoder-decoder 骨干、同一套训练流程,唯一差别是输出词表的定义方式。不过需要注意,LAS 变体仍然把候选集的 SID 作为输入(只是输出换成下标),因此这条对照更准确的解读是"输出侧全局 vs 输出侧局部",而非"用不用 SID"。
6.4 冷启动泛化(RQ6)
模拟冷启动:从 Amazon Books 训练集中随机 mask 掉测试集里 5% 的物品,这些物品在训练阶段被完全移除,但保留在测试集中。对比 GloRank 与最强 baseline GoalRank 在正常与冷启动两种设定下的表现。
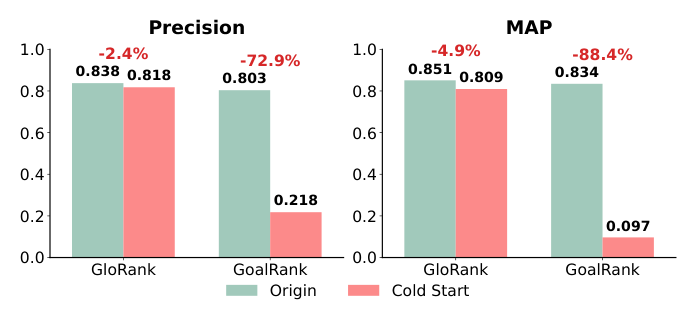
| 指标 | 模型 | Origin | Cold Start | 相对变化 |
|---|---|---|---|---|
| Precision@6 | GloRank | 0.838 | 0.818 | -2.4% |
| Precision@6 | GoalRank | 0.803 | 0.218 | -72.9% |
| MAP@6 | GloRank | 0.851 | 0.809 | -4.9% |
| MAP@6 | GoalRank | 0.834 | 0.097 | -88.4% |
数值口径提示:Figure 6 中 GoalRank 的 MAP Origin 为 0.834,与 Table 2 中 Amazon Books 上 GoalRank MAP@6 = 77.91 不一致(Precision 的 0.803 则与 Table 2 的 80.35 吻合)。原文未解释这一差异,可能是冷启动实验用了不同的训练子集重训。引用时请以对应图表为准。
结论分析:GoalRank 在冷启动下遭遇灾难性崩塌(MAP 下降超过 88.4%),而 GloRank 只有边际下滑。作者给出的机制解释非常清晰,且分两层:
-
表示层:全局物品空间把知识从已见物品有效迁移到未见物品——即便某个物品 ID 是全新的,它的构成语义 token 与已知物品共享,模型可以基于内容而非记忆的身份推断其效用。反观 GoalRank 依赖为 atomic ID 学习独立嵌入,遇到未见物品只能用随机初始化的嵌入,等同于噪声输入。
-
传播层(这一层更重要,也是重排特有的):由于重排是显式建模 inter-item 相关性的 list-wise 任务,这个噪声不会被隔离在未见物品自身。它会通过交互传播出去,污染整个列表的上下文表示,连带损害同一批次里那些已知物品的打分。这就解释了为什么只 mask 5% 的物品,却能让 GoalRank 的 MAP 掉 88%——冷启动物品在重排里是"传染性"的。
这个洞察是本文除理论分析之外最值得借鉴的一点:在 point-wise 排序里冷启动的损害是局部的,在 list-wise 重排里是全局的。
七、线上实验(RQ7)
在一个日活超 4 亿、物料规模数千万的内容平台上做线上 A/B。实验组分配 7.8% 全站流量,对照组同等规模,由当前生产系统中部署的 SOTA baseline GoalRank 服务。实验持续 14 天以覆盖周内波动、保证统计显著性。
Table 4:线上 A/B 结果(全部提升在 student t-test 下 $p < 0.05$ 显著)
| Metric | Watch Time | Effective View | Like | Comment | Forward |
|---|---|---|---|---|---|
| Imp. | +0.095% | +0.111% | +0.286% | +0.462% | +0.447% |
此外还观察到 Active Devices +0.030%。
结论分析:
- 提升在所有监控指标上一致为正。Effective View 与总时长的增长表明 GloRank 生成的重排列表能有效推高那些同时触发点击与持续消费的物品。
- 值得注意的是交互类指标(Like +0.286%、Comment +0.462%、Forward +0.447%)的提升幅度明显高于消费类指标(Watch Time +0.095%、Effective View +0.111%),大约是 3–4 倍。原文没有讨论这一分化,但它与"全局语义标识符让模型建立稳定的物品内在估值"的主张是自洽的:互动行为对物品本身质量的敏感度高于对排列顺序的敏感度。
- Active Devices +0.030% 被作者解读为对用户长期留存与黏性的正向影响——这是重排层改动能触及的最上游指标,能推动它通常意味着体验改善是真实的。
- 对照组是生产环境里已经在跑的 GoalRank,而不是一个弱 baseline。在一个已经用 group-relative RL 优化过的强系统之上还能拿到全指标显著正向,这是本文工业价值的核心证据。
需要指出的局限:论文未报告任何在线延迟、QPS 或部署成本数据。GloRank 是 encoder-decoder 自回归模型,每个物品要解码 $M = 4$ 个 token,长度 6 的列表意味着 24 步解码(加 beam size 20 的搜索)——相比 GoalRank 的单次生成,推理开销的增量本应是一个必须交代的工程问题。
八、核心贡献总结
- 诊断层面:首次把 list-wise 重排的"位置依赖动作空间"提炼成一个可证明的优化问题,而非仅仅是直觉上的表示缺陷。命题 2.1 给出的 mapping-induced 方差下界 $\frac{1}{N}(1-\frac{1}{N})\lVert\boldsymbol{\mu}^{(t)}_j\rVert_2^2$ 说明这项方差与编码器质量无关、无法通过改进 encoder 消除,只能通过改变动作空间的定义来消除。
- 方法层面:用 RQ Semantic ID 把百万级物料压成 $M \times |\mathcal{C}_m| = 4 \times 256$ 的固定词表,让"全局标识符生成"在工业规模上可行;配合 Trie 约束解码,在全局空间估值的同时把输出硬约束回本次请求的候选集。
- 优化层面:预训练不学日志曝光列表,而是采样排列 + 代理评估器打分 + 取 argmax 构造反事实高质量目标,绕开日志策略的次优性;后训练用 GRPO 直接优化列表效用,且实证 $\beta = 0$(无 KL 约束)最优。
- 实证层面:LAS 消融把"全局 vs 局部动作空间"这一单一变量隔离出来,性能差距接近一个数量级;冷启动实验揭示了 list-wise 任务中未见物品的噪声传播效应;线上 A/B 以生产中的 GoalRank 为对照拿到全指标显著正向。
九、与已归档相关工作的对比
NSGR NSGR: Next-Scale Generative Reranking — A Tree-based Generative Rerank Method at Meituan(Meituan,2026-04-07)
关系:独立并发(NSGR 早于本文 21 天投稿,本文正文与参考文献中均未出现 NSGR 或 2604.05314)· 已加载对方精读
- 时序说明:NSGR 投稿于 2026-04-07,GloRank 投稿于 2026-04-28,NSGR 早于本文三周。已用
/usr/bin/grep -a在本文 content.txt 中检索NSGR与2604.05314,命中数均为 0——因此这是一次真正的"更早发表却未被引用"的独立并发,而非时序造成的假象。 - 共同关注的问题:两篇都认为生成式重排的瓶颈不在模型容量而在"决策空间怎么被组织"。GloRank 指出逐位选局部下标使输出神经元语义随输入顺序漂移;NSGR 指出逐位自回归(PRM/GRN)只有前缀视野、one-step(NAR4Rec)缺乏细粒度交互、multi-step(DCDR/NLGR)被初始列表锁死——三种既有 paradigm 都拿不到"全局视野 + 局部精细"。二者都把矛头指向了自回归重排"以单个位置为决策原子"这一默认设定。
- 相近的技术骨架:两者都重构生成过程本身而非堆容量,且都需要一个 list-wise evaluator 把稀疏的列表级效用反向拆成可训练信号(GloRank 用代理评估器挑最优排列做 SFT 目标 + GRPO 的 group-relative 优势;NSGR 用 Multi-Scale Evaluator 给多尺度打分 + Multi-Scale Neighbor Loss 做对比式相对奖励)。两者都在真实工业系统完成部署与线上 A/B。
- 本文的差异与推进:分歧在于换掉哪一个维度。NSGR 换的是决策时间表——用 $\log_2 m$ 步 tree-based 二分("进上半区还是下半区")替代 $m$ 步逐位决策,把粒度从粗到细渐进细化;但它每一步仍然是在当前候选子集内按 $\mathrm{Sim}_j$ 排序做局部相对判断,动作空间依然是位置/下标语义的。GloRank 换的是符号空间——保留逐位自回归,但把动作从"第 $k$ 个候选"换成"全局 SID token"。用 GloRank 的理论框架看,NSGR 并没有消除命题 2.1 的 mapping-induced 方差项;反过来用 NSGR 的框架看,GloRank 的逐位解码仍有前缀视野受限的问题。两者其实正交,原则上可叠加:在 SID 全局词表上做 next-scale 的粗到细生成,是一个双方都未探索的组合。
- 可比的方法/实验差异:NSGR 在美团外卖首页部署(8 周 A/B,CTR +2.89%、GMV +3.15%),场景是本地生活电商、指标是转化侧;GloRank 在 4 亿 DAU 内容平台部署(14 天、7.8% 流量,Watch Time +0.095%、Comment +0.462%),指标是消费与互动侧。NSGR 用 HSTU 抽终身兴趣 + AvgPool 缓存,GloRank 用 Qwen3-Embedding-4B + RQ-Kmeans 离线构 SID——两者的"重计算离线化"思路一致但落点不同。离线 benchmark 无法直接对比:NSGR 未在 Amazon Books / MovieLens-1M 上报告本文使用的 50 选 6 配置。
PSG PSG: Pair-Space Generation for Efficient Generative Reranking(Kuaishou Tech,2026-07-29)
关系:后续工作(PSG 晚于本文 3 个月,本文不可能引用它;但 PSG 也未引用 GloRank——已用 Python 全文扫描归档 content.txt 确认无任何论文提及 GloRank)· 已加载对方精读
- 时序说明:GloRank 2026-04-28,PSG 2026-07-29,PSG 晚 3 个月。因此这不构成"独立并发",而是同一动作空间命题在同一家公司内的后续演化。值得记录的是:两篇都出自快手重排团队(作者列表中 Xiang Li 重合),线上对照组都是同一个生产系统 GoalRank,但 PSG 的相关工作章节只把 GoalRank 列为"最相似的方法",完全没有提及三个月前同组的 GloRank。
- 共同关注的问题:两篇给出的诊断在逻辑形式上高度同构。GloRank:动作空间用局部下标是"输入列表形式化的产物",不是物品效用的性质。PSG:"item 级的动作粒度是自回归抽象的产物(artifact),而不是 reward 结构本身的性质"——因为重排效用的语义单元是 item 之间的成对交互,不是单个 item。两者都在质问同一件事:生成式重排的动作原子究竟应该是什么? 并且都认为默认答案(局部下标 / 单个 item)是形式化残留而非本质。
- 相近的技术骨架:都是 Transformer encoder-decoder 自回归生成器 + list-wise evaluator 提供 reward + GRPO 后训练 + 解码期强制去重的 mask/约束。差别只在词表怎么定义。
- 本文的差异与推进:给出的答案恰好相反。GloRank 把词表做成跨请求固定的全局 SID 空间($4 \times 256 = 1024$ 个 token),追求语义一致性与冷启动迁移;PSG 把词表做成每请求动态的 pair-token 空间($|\mathcal{P}(\mathcal{V})| = n(n-1)$),用现场计算的 pair encoder 绕开静态 $n^2$ 嵌入表,把解码 horizon 从 $L$ 砍到 $L/2$,追求延迟与误差累积。按 GloRank 的理论,PSG 的 pair-token 词表仍然是请求局部的(token 的含义随候选集变化),因此 mapping-induced 方差问题依然存在;按 PSG 的理论,GloRank 的解码 horizon 实际上比 item-space 还长(每个物品要 $M=4$ 个 SID token,$L=6$ 意味着 24 步),误差复合对 horizon 的二次依赖会更严重。这是一组针锋相对、各自都有道理的取舍。
- 可比的方法/实验差异:PSG 报告了 GloRank 完全没有报告的东西——延迟预算(G-E 生成器 $\le 30$ ms)、相对 item-space G-E baseline 的 $1.83\times$ 解码加速、线上人均停留时长 +0.178%(同样 4 亿 DAU、同样对照 GoalRank)。有意思的是 PSG 的停留时长提升(+0.178%)高于 GloRank 的 Watch Time(+0.095%),但两者的实验时间、流量桶配置和评估器版本都不同,不能直接比较。GloRank 独有的是冷启动鲁棒性证据(PSG 未做冷启动实验),而这恰恰是全局 SID 相对 pair-token 的结构性优势。
DIRECTOR DIRECTOR: Dynamic Index-based Recommendation with Transport-Optimized Retrieval(Kuaishou / 中国科学技术大学,2026-07-29)
关系:后续工作(晚于本文 3 个月,未引用本文)· 已加载对方精读
- 时序说明:与 PSG 同日投稿(2026-07-29),晚于 GloRank 3 个月,同为快手重排团队(Chao Feng、Chenghao Zhang、Xiang Li 与 PSG 作者重合)。同样未提及 GloRank。
- 共同关注的问题:都在追问"生成器每一步到底应该输出什么符号"。GloRank 的答案是离散的全局语义标识符;DIRECTOR 的答案是连续的、请求条件化的动态检索索引——每个位置生成一个位置感知的候选 query 向量,再去候选池里做全局硬匹配。DIRECTOR 明确说这既不是"仅依赖静态位置 embedding",也不是"直接表示某个离散 item 标识符"——这句话正好把 GloRank 与它自己划在了同一坐标轴的两端。
- 相近的技术骨架:都必须解决"全局空间估值 + 局部候选合法性"的缝合问题,且都要保证输出不重复。GloRank 用 Trie 前缀树 + 动态剪枝路径;DIRECTOR 用熵正则、带容量约束的最优传输(训练时软耦合)+ 矩形最短增广路求解器(推理时全局硬分配)。两者都把 evaluator 当作只给列表级标量的黑盒插件,都要从中反推更细粒度的训练信号。
- 本文的差异与推进:GloRank 保留逐位自回归(并因 SID 而把 horizon 拉长到 $K \times M$ 步),把赌注押在符号的语义稳定性上;DIRECTOR 彻底取消自回归,一次并行生成 $n$ 个索引,把赌注押在跨位置的全局协调上。DIRECTOR 诊断的根因(前缀剪枝误杀全局更优排列、推理天然串行)与 GloRank 诊断的根因(动作空间语义不一致)完全不同且互不覆盖:DIRECTOR 的连续动态索引每次请求重新生成,语义同样随请求漂移,不解决命题 2.1;GloRank 的逐位解码同样受前缀剪枝之害,不解决 DIRECTOR 的问题。这三篇(GloRank / PSG / DIRECTOR)合起来构成了一个清晰的图景:2026 年快手重排团队在同一个 GoalRank 生产基线上,沿"动作空间该如何重新参数化"这条主线并行推进了三种互不引用的答案——全局离散标识符、请求级 pair token、连续动态索引。
- 可比的方法/实验差异:DIRECTOR 用双 10% 流量桶跑 7 天 A/B(VV 提升 $p < 0.05$),并报告了 serving 压测(相同 QPS 与端到端延迟约束下的效率对比);GloRank 用 7.8% 流量跑 14 天,未报告任何效率数据。DIRECTOR 的离线设定是 $M = 50$ 候选选 $n = 10$,GloRank 是 50 选 6,接近但不完全一致;两者公开数据集也不重合,无法直接对表。
被剔除的近似候选与理由(Step 2.5 初筛通过但深度终判剔除):
- DeGRe DeGRe(浙江大学 / 淘宝闪购,2026-05-25,晚于本文 27 天):同为生成式重排,且与 GloRank 的预训练目标构造高度接近——都用评估器在未曝光排列空间里挖高价值序列作监督(GloRank:采样 $L$ 条排列取 argmax;DeGRe:Lookahead Evaluator + 离线 beam search)。但 DeGRe 诊断的 root cause 是启发式标签偏差 + 信用分配问题(稀疏事后 reward 无法归因到局部决策),解法是稠密 step-wise 蒸馏;它对动作空间的语义定义完全不置一词,仍在 item 空间工作。属于"解决重排训练信号质量"而非"解决动作空间语义",问题 root cause 不同构,剔除。
- DebiasFirst DebiasFirst(阿姆斯特丹大学,2026-04-04,早于本文 24 天):初筛因"位置依赖"字面同构而入选——它研究 LLM listwise reranking 的位置偏差,同样是"模型的输出依赖候选的输入顺序"。但其 root cause 是 LLM prompt 中候选出现位置带来的注意力偏置,解法是 IPS 位置校准 + 位置感知数据增强(在既有动作空间内做去偏),与 GloRank"重新定义动作空间"的路径相反;且场景是文档检索的 LLM reranker,不是推荐 slate。剔除。
- RankUp RankUp(Tencent,2026-04-20,早于本文 8 天):同为工业排序 + 涉及"随机置换",但它做的是判别式排序器(MetaFormer)的 effective rank 提升,问题是表征秩坍塌,解法是多嵌入表 / 全局 token / 任务专属 token 等表征工程,与 list-wise 生成式重排的动作空间无关。仅共享
industrial标签。剔除。 - ResRank ResRank(Alibaba Qwen,2026-04-24,早于本文 4 天):题名含 listwise reranking,且都在处理"重排的输出该是什么"。但 ResRank 的解法方向完全相反——它把自回归解码去掉,改成把 passage 压成单个 embedding 后用余弦相似度打分(zero generated tokens),追求 LLM reranker 的效率;GloRank 则是拥抱生成。且领域是 BEIR/TREC DL 文档检索,无 intra-list 组合优化。剔除。
- SID-Coord SID-Coord(Kuaishou,2026-04-12,早于本文 16 天):同公司、同样把 SID 引入排序阶段,初筛因"SID + ranking + 跨阶段一致性"入选。但它解决的是短视频搜索中 ID-based 排序模型的特征侧 SID 协同(如何把 SID 作为特征喂给判别式排序器以缓解长尾 ID 稀疏),并未改变模型的动作空间或输出形式,也不是 list-wise 组合优化。属于"共享 SID 组件但解法路径不同",剔除。
- SID tokenizer 系列(QuaSID QuaSID、AdaSID AdaSID、FORGE FORGE、CRAB CRAB 等):均与本文共享 RQ-SID 这一组件(FORGE 还被本文引用为 SID 出处 [11]),但它们的问题陈述是码本碰撞 / 码本平衡 / 工业规模 SID 构造质量,服务的是召回侧生成式检索,与"重排动作空间的语义一致性"不同构。本文对 SID 只是拿来即用,未在 tokenizer 上有贡献。全部剔除(结构化对比交由 Step 4 的 DAG 处理)。
十、讨论与局限性
10.1 值得借鉴的设计
- 把表示选择论证成优化性质。"用 SID 代替下标"这件事,如果只说"SID 有语义、泛化好",是一个弱论证;本文把它转化成"输出层梯度有一项不可消除的 mapping-induced 方差",并给出显式下界,论证强度完全不同。这个套路可以推广:任何"输出维度含义随样本变化"的架构(多任务动态头、动态候选集分类、slot filling)都可以套用同一分析。
- 预训练目标不学日志、学反事实最优。作者明确指出重排与召回的区别——召回可以直接学日志,因为日志里的 item 就是正样本;重排学日志等于学一个次优的排列策略。用"采样 $L$ 条排列 + 代理评估器 argmax"构造目标,是把 Generator-Evaluator 的评估能力折叠进 SFT 阶段,而不是留在推理时跑一堆生成器。这也解释了为什么 GloRank 单策略能打过 MG-E-100 的百生成器集成。
- 全局空间 + 局部约束的缝合方式。Trie 约束解码 + 动态路径剪枝是一个很轻的机制(因为 $N \ll |\mathcal{V}|$),却同时解决了合法性与去重两个问题。任何"在大词表上生成但要约束到小候选集"的场景都可以直接复用。
- 冷启动噪声在 list-wise 任务里会传播。这个观察的普适价值超出本文:在任何显式建模 item-item 交互的架构里,少量冷启物品的随机嵌入不是局部噪声而是全局污染源。这为"list-wise 模型必须用内容化 ID"提供了一个远比"泛化性更好"更硬的理由。
10.2 局限与争议
- 完全没有效率数据。GloRank 每个物品要解码 $M = 4$ 个 SID token,$K = 6$ 的列表意味着 24 个解码步,外加 beam size 20 的搜索和每步的 Trie mask。相比 GoalRank 这类一次生成的方案,推理成本增量可能相当可观。论文既未报告线上延迟、QPS,也未报告离线推理耗时——对一篇有线上 A/B 的工业论文,这是一个明显缺口。(对照:同组三个月后的 PSG 与 DIRECTOR 都把效率作为核心卖点,某种程度上反证了这个缺口是真实存在的痛点。)
- 理论与实践之间有一道缝。命题 2.1 假设 $\sigma$ 在排列上均匀分布,但实际系统里候选集的输入顺序通常来自上游排序阶段的打分,是高度非均匀且有信息量的。在有信息的顺序下,"下标携带先验"可能反而是有用的特征,mapping-induced 方差的实际量级也会小于均匀假设下的下界。论文没有讨论这一点,也没有在实验中考察"输入顺序是否 shuffle"对 LAS 变体的影响——而这恰恰是把理论落到实处的关键对照。
- LAS 消融的对照不够干净。LAS 变体的性能塌到 0.1–0.15 附近,几乎等同于随机——这个幅度大到反而令人怀疑。既有的 PRM、GoalRank 就是在局部动作空间里工作的,它们的表现远好于随机(GoalRank 在 Amazon Books 上 NDCG 84.88)。因此 LAS 的崩塌更可能反映的是"把下标当 token 从零训一个 T5 很难收敛"这一实现层面的困难,而不纯粹是动作空间语义本身的代价。一个更公平的对照应当是"在同一骨干上把 LAS 也充分调优",或者直接引用 GoalRank 作为局部动作空间的强代表。
- 数据集来源口径矛盾。4.1 节说工业数据集来自电商平台,4.10 节的线上指标却是短视频消费口径(Watch Time / Effective View / Forward)。两者若为同一系统则描述有误,若为不同系统则论文未加说明。
- 冷启动实验的图表数值与主表不一致。Figure 6 中 GoalRank 的 MAP Origin 为 0.834,Table 2 中同数据集同指标为 77.91,差距 5.5 个点,原文未解释。
- 两阶段流水线本身缺乏新意。"SFT 高质量示范 + GRPO 最大化奖励"是 2025–2026 年生成式推荐的标准配方(OneRec、GoalRank、OneRec-V2 都是这个骨架),本文的贡献集中在动作空间的重新定义上,优化侧基本是沿用。这也是本文虽然诊断漂亮但整体创新增量有限的原因。
- 未与更早的生成式重排工作对比。参考文献里出现了 GReF(Ordered Multi-token Prediction)、NLGR(Neighbor Lists)、DCDR(离散条件扩散重排)等生成式重排方案,但实验表里一个都没有。baseline 集中在 DNN/DLCM/PRM 这类较老的方法与 GoalRank/PIER/NAR4Rec/MG-E,缺少与"同样重构生成过程"一类方法的正面交锋。
10.3 工业落地价值
GloRank 的落地价值主要有三点:
- 对照的是生产中已在跑的强基线。GoalRank 本身就是用 group-relative RL 优化过的 SOTA,在它之上还能拿到 Watch Time +0.095%、Comment +0.462%、Forward +0.447%、Active Devices +0.030% 的全指标显著正向,说明动作空间修正的收益是在优化方法之外叠加的,不是重复计算。
- 跨阶段一致性的额外红利。SID 已经在召回阶段被 OneRec 等系统广泛采用,重排也换成 SID 之后,召回—重排共享同一套物品表示,工程上省掉了一层映射,也让上下游的语义漂移问题变得可控。这一点论文只在引言里提了一句,但在快手这类已经全面 SID 化的系统里,它可能比论文报告的指标提升更有长期价值。
- 冷启动鲁棒性直接对应业务痛点。新物料在内容平台是持续供给的(而非偶发),GoalRank 式的 atomic ID 方案在新物料上的表现塌陷会直接转化为创作者生态问题。GloRank 的 -2.4% / -4.9% 对 -72.9% / -88.4%,量级差距足以构成独立的上线理由。
不过,是否值得为此付出自回归 SID 解码的推理成本,本文没有给出足够的信息让读者判断——这是复现或迁移这套方案时首先要自己测量的东西。