RSLM: Training-Free Vector Quantization for Approximate Nearest Neighbor Search¶
Rastislav Lenhardt, Teodora Dobos, Thomas Vecchiato, Jiří Iša, Igor Ginzburg Google Zurich / Google San Jose(合作方:Technical University of Munich、University of Copenhagen) arXiv:2608.30384 · 2026-08-31 · 开源实现 https://github.com/google-research/google-research/tree/master/rslm
研究动机与背景¶
大规模 ANN 系统的真正瓶颈是 DRAM,不是算力¶
高维 embedding 已经是搜索、推荐、RAG 三条流水线共同的底层表示。要在十亿级向量库里做高吞吐低延迟的检索,工业系统普遍采用 ANN(Approximate Nearest Neighbor) 索引。论文一上来就把问题的约束条件钉死:在现代高吞吐数据库系统里,索引设计根本上是被硬件约束决定的——DRAM 到 CPU 的内存带宽上限,以及 DRAM 的物理容量,而不是被浮点算力决定。
主流架构是基于聚类(IVF)或基于树的空间划分:先把向量空间切成局部的 Voronoi cell 或树节点,在线阶段只对被剪枝后的候选子集算距离。典型的两阶段(实际上是三阶段)流水线是:
- 粗划分筛选(candidate selection):用聚类中心/树路由挑出 $n_{\text{probe}}$ 个分区;
- 近似打分(approximate scoring):在选中的分区里用低比特(1~2 bit)量化码字快速估算距离,把候选集进一步收窄;
- 重打分(rescoring):对 top-k 短名单取出全精度向量或更高保真的量化表示(通常 $\geq 8$ bit/维),重算精确的 MIPS 距离并定序。
向量量化在第 2、3 阶段同时起作用,收益是复合的:既压低 DRAM 占用(让十亿级索引能全内存驻留),又因为减少了 DRAM→CPU 的传输量而直接抬高 QPS、压低端到端延迟。
两条既有路线各自的死结¶
数据相关(data-dependent)量化——以 Product Quantization(PQ)及其在 Faiss、ScaNN 里的工业实现为代表——需要在训练集 $\mathcal{X}$ 上离线跑 k-means 学出数据集专属的码本。这带来三重代价:离线训练的工程复杂度、新数据集/冷启动场景下样本不足、以及分布漂移(OOD)时码本失效。
数据无关(data-oblivious)量化——码本靠解析推导或按向量在线导出——消除了训练环节,但在 3 bit/维以下的激进压缩区间会出现明显的召回退化。为解决这一点,最近冒出一类 rotation-based data-oblivious quantizer:先施加一个随机正交变换把坐标方差均匀化,再用固定码本量化。代表作是 EDEN(随机化 FWHT + 1D 高斯码本)、TurboQuant(稠密 QR 旋转 + 按球面坐标精确 Beta 边缘分布标定的 1D Lloyd–Max 码本 + 1-bit QJL 残差校正)、RaBitQ / E-RaBitQ(把单位向量投到旋转后的超立方体顶点)、BlockQuant(把相邻维度分块,在块球面分布上做连续 k-means)。
本文的三条不满¶
论文的定位(Positioning of Rslm)不是"再造一个更准的通用量化器",而是把通用量化器和 ANN 系统的具体结构耦合起来。它对现有 data-oblivious codec 提出三条具体不满:
- 旋转太贵。TurboQuant、RaBitQ、BlockQuant 用的 Haar 稠密正交矩阵是 $\mathcal{O}(D^2)$ 的,既有巨大的矩阵存储开销,也有查询侧的变换延迟。
- FWHT 受限于 2 的幂。EDEN 用全向量 FWHT 把复杂度降到 $\mathcal{O}(D\log D)$,但全局 FWHT 严格要求维度是 2 的幂。生产中会出现 $D=2049$ 这类"怪"维度(多出来的一维编码领域元数据),此时全局 FWHT 必须零填充到下一个 2 的幂,计算量和内存带宽都陡增。
- 最根本的一条:现有 data-oblivious codec 都被设计成独立的、全向量的编码器,优化目标是逐坐标的重构误差,而不是作为检索系统的一个内嵌组件。 它们不知道 ANN 系统里已经存在一个"粗粒度近似向量",因此白白放弃了对残差编码这个巨大的信息优势。
本文的四条贡献¶
Rslm(Rotated Scaled Lloyd-Max) 是一族 1~4 bit/维的免训练量化 codec,专为 IVF / 树索引的近似打分与重打分设计,既能量化全向量也能量化残差向量。
- 线性旋转复杂度:不用稠密投影,也不用 $\mathcal{O}(D\log D)$ 的全向量 FWHT,而是级联两趟的 Block-FWHT。把 FWHT 限制在固定大小 $B$ 的块内,编码复杂度形式上是 $\mathcal{O}(D\log B)$;由于 $B\leq 128$ 是硬件优化的小常数,$\log B$ 退化成常数因子,实际是 $\mathcal{O}(D)$ 线性复杂度。
- 对最终重建向量做 $L_2$ 范数校正:MIPS 排序对范数误差极其敏感。以往做法只修残差的范数;Rslm 的核心创新是修"近似向量 + 量化残差"这个最终重建向量的范数,用一个简单的重缩放取代了 ScaNN 那套复杂的 anisotropic loss,且不需要任何离线码本训练。
- 零字节隐写元数据:在 4-bit 的
Rslm4Lite变体中,把范数缩放因子藏进量化码字本身的空闲比特位,使每向量元数据开销恰好为 0,从而实现完美的 cache line 对齐与 SIMD 寄存器查表。 - 免训练 codec 简化 ANN 系统:在五个数据集上评测全向量量化与相对量化,并在 glove / openai 上与 Faiss 和 ScaNN 做端到端对比,证明免训练 codec 在近似打分与重打分两个阶段都能追平或超过训练出来的 codec。
论文自陈的限定条件¶
- 只做内积。因为多数现代 embedding 模型输出单位归一化向量,此时内积、余弦相似度、$L_2$ 距离给出的排序在数学上完全一致,而点积计算最快。五个数据集里四个是单位归一化的,剩下的
bigann范数方差极小。 - 只做 IVF/树索引。作者承认在 ann-benchmarks 上 HNSW 这类图索引在单查询延迟上常常更优,但 IVF 在内存占用与批量吞吐上有决定性优势。不过 Rslm 对图索引也有用:非相对 codec 可压缩图遍历时的节点向量;相对 codec 可以像 Milvus 的 HNSW-PRQ 那样,把全精度向量换成"相对粗路由向量的残差量化",得到免训练的高精度重打分。
相关工作与定位¶
量化方法的分类¶
量化把 $x\in\mathbb{R}^D$ 映到码本 $\mathcal{C}=\{c_1,\dots,c_K\}$ 中的离散码,标准目标是最小化重构误差:
$$\mathcal{L}_{\text{MSE}}(x)=\|x-q(x)\|^{2} \tag{1}$$
由于无约束 VQ 的码本规模随 $D$ 指数增长,工业上普遍采用三类结构化松弛:
- 标量量化(SQ):逐坐标独立量化,用从 $\mathcal{X}$ 学到的全局或逐维边界。如 SQ8 = 每维 $2^8$ 个 level,使用跨数据集共享的静态逐维 scale。
- 乘积量化(PQ):把 $D$ 维空间分解成 $M$ 个正交子空间,每个 $D/M$ 维子向量用学出来的子码本 $\mathcal{C}^{(m)}$ 独立量化。OPQ 额外学一个正交旋转来平衡子空间方差;Pyramid-PQ 自适应合并相邻子空间以加速在线距离计算。
- 多码本 / 残差量化(MCQ/RQ):Residual Quantization、Product Residual Quantization、以及 Qinco2 这类隐式神经 codec,级联地编码量化残差。代价是离线训练昂贵、在线解码开销大。
与之相对的 data-oblivious 方法在运行时按向量解析地导出变换参数。SSQ(Scaled Scalar Quantization) 就是逐向量缩放:把一个 scale 因子与打包的低比特坐标一起存。scale 的来源可以是坐标 min/max、向量范数、或为 MSE 优化的标量乘子。本文对比的 SSQ4Lite 是一个 4-bit 标量量化 codec,把 32-bit scale 藏在量化坐标的最低有效位里(要求 $D\geq 64$)。
面向 MIPS 的范数保真¶
标准 VQ 最小化 MSE,隐含地对各方向的重构误差一视同仁;但 MIPS 依赖向量长度。NEQ(Norm-Explicit Quantization) 首先指出:范数上的量化误差对内积排序的破坏远大于方向上的误差,因此把标量范数与归一化方向解耦、分别量化。ScaNN 则用 anisotropic loss 惩罚"平行方向"的量化误差(即沿向量自身方向、直接改变内积值的那部分误差)。这两者都证明了范数保真的必要性,但都依赖离线码本训练。
Table 1:免训练旋转类 ANNS 量化器的分类¶
| Method | Rotation | Rotation Complexity | Overhead-Free |
|---|---|---|---|
| EDEN | Randomized Hadamard | $\mathcal{O}(D\log D)^{\dagger}$ | ✗ |
| RaBitQ | Dense Orthogonal Rotation | $\mathcal{O}(D^{2})$ | ✗ |
| E-RaBitQ | Dense Orthogonal Rotation | $\mathcal{O}(D^{2})$ | ✗ |
| TurboQuant | Dense Orthogonal Rotation | $\mathcal{O}(D^{2})$ | ✗ |
| BlockQuant | Dense Orthogonal Rotation | $\mathcal{O}(D^{2})$ | ✗ |
| Rslm (Ours) | Randomized Block-Hadamard | $\mathbf{\mathcal{O}(D)^{\dagger}}$ | ✗ |
| Rslm4Lite (Ours) | Randomized Block-Hadamard | $\mathbf{\mathcal{O}(D)^{\dagger}}$ | ✓ |
(† 表示 Hadamard 类变换通过 FWHT 计算。)
这张表把 Rslm 的差异化压缩成三个维度:几何预处理算子、投影步的计算复杂度、每向量元数据足迹。Rslm 是唯一走 Block-Hadamard 的,也是(Rslm4Lite)唯一做到零元数据开销的;同时它是唯一被设计成既能量化全向量、也能量化相对 IVF/树分区的残差的 codec——残差是高度集中的误差向量,量化失真天然更小。
论文还顺带梳理了 LLM 侧的量化谱系(SmoothQuant 的 8-bit 缩放、QuIP 证明随机正交预处理能压制通道离群点、QuaRot 的计算不变性推广、CRVQ 的关键通道码本松弛、LiftQuant 的准连续位宽、KIVI 的 2-bit KV cache、PolarQuant 的递归极坐标、HARP 的可学习蝶形正交变换),并明确指出:LLM 量化优化的是矩阵乘吞吐与困惑度,而不是快速的 MIPS 候选重打分——这是两条相邻但目标不同的技术线。
核心方法:Rslm codec family¶
每个 Rslm codec 由三步组成:(1) 高效的预量化变换,使所有坐标方差一致;(2) 把旋转后的坐标映射到为标准正态分布预先算好的最优 Lloyd–Max 码本;(3) 追加一个 2 字节的逐向量 scale,恢复向量长度、防止 MIPS 打分被系统性低估。
预量化变换:为什么必须旋转¶
直接量化原始 embedding 会因为坐标方差不均与离群点导致码本容量利用率低下。正交变换把能量均匀摊到所有坐标上,把变换后的数据整形成接近标准正态的分布,同时(因为正交)严格保证内积距离不变——这一点对 MIPS 是硬约束,也是后文与"可学习变换"路线的分水岭。
Fast Walsh-Hadamard Transform¶
未归一化的 Walsh-Hadamard 矩阵 $\hat{H}_n\in\{-1,+1\}^{n\times n}$($n=2^k$)递归定义为:
$$\hat{H}_{2^{k}}=\begin{bmatrix}\hat{H}_{2^{k-1}} & \hat{H}_{2^{k-1}}\\ \hat{H}_{2^{k-1}} & -\hat{H}_{2^{k-1}}\end{bmatrix},\qquad \hat{H}_{1}=[1] \tag{2}$$
正交归一版本为 $H_n=\frac{1}{\sqrt{n}}\hat{H}_n$。FWHT 利用这个递归结构在 $\mathcal{O}(n\log n)$ 时间内原地完成变换,不需要辅助内存;由于矩阵元素只有 $\pm 1$,整个变换退化为一串加减法,最后统一乘一次 $1/\sqrt{n}$,完全避免乘法。
关键工程决策:把向量切成固定大小 $B=128$ 的块,对每块独立做 FWHT。这把总复杂度限制在 $\mathcal{O}(D\log B)$——对 $D$ 而言是线性的。实现上用 AVX2 SIMD,先把变换的前几级完全在寄存器内做完,再跨寄存器解算剩余级,最大化指令级并行。
处理任意维度的两个补丁:
- 若 $D<128$,动态把块大小缩到能装下的最大 2 的幂;
- 若 $D$ 不是块大小的整数倍,用重叠块:正常分块处理,剩余元素用一个与前一块重叠的同尺寸块兜底。由于块操作不可交换,解压时必须逆序施加才能精确可逆。
符号翻转与维度置换¶
Hadamard 变换是确定性的,对某些与变换轴对齐的输入分布可能均匀化不足。Rslm 用固定的、预先算好的符号翻转表与置换表引入伪随机性——用静态表既保证严格正交,又保证零元数据开销:
- 符号翻转:一张 256 个伪随机 $\pm 1$ 的静态表 $S_1$,在变换前平铺到向量坐标上;
- 维度置换:一个静态的 128 元置换 $P$ 在块内打乱坐标;块小于 128 时改用动态位反转置换。
对 $D>128$ 的向量,还要用 strided transpose 跨块交错坐标以打破局部块边界。设活动块大小 $B=128$、完整块数 $M=\lfloor D/B\rfloor$,则长度 $M\cdot B$ 的前缀按下式置换转置:
$$x'[k\cdot M+b]=x[b\cdot B+P(k)],\quad 0\leq b<M,\ 0\leq k<B \tag{3}$$
尾部残余坐标($i\geq M\cdot B$)保持不变($x'[i]=x[i]$),它们随后由第二趟中覆盖索引区间 $[D-B,\,D)$ 的重叠尾块被旋转、混入全局嵌入空间。这样在任意维度下都能做到严格正交、精确可逆、维度充分均匀化,而不需要零填充或截断——这正是对 EDEN"全局 FWHT 只能吃 2 的幂"这条限制的直接回应。
级联旋转流水线¶
对 4-bit codec(Rslm4 / Rslm4Lite),若 $D\leq 256$ 走单趟优化:只做第一趟符号翻转 + 重叠 FWHT,跳过置换、转置与第二趟,以最大化查询吞吐。对 $D>256$(或 Rslm1/2/3 总是),执行完整的两趟级联:
- 第一趟符号翻转:坐标乘以静态符号序列 $S_1$;
- 第一趟 FWHT:分块 FWHT;
- 维度置换与交错:块内置换 + 跨块 strided transpose;
- 第二趟符号翻转:施加第二个静态符号序列 $S_2$(即 $S_1$ 偏移 127 个元素);
- 第二趟 FWHT:最后一次分块 FWHT。
Lloyd–Max 码本量化与 EVT 初始尺度¶
变换之后坐标近似服从零均值高斯 $N(0,\sigma^2)$。要把它们映到为标准正态 $N(0,1)$ 标定的固定 Lloyd–Max 码本上,需要先缩放。
理论上平均坐标方差是 $\sigma^2=\frac{1}{D}\|x\|^2$,但单个旋转后的向量可能出现重尾的坐标尖峰。若严格按样本方差缩放,极端坐标会在码本边界饱和(clipping),量化精度反而下降。作者引入极值理论(Extreme Value Theory)来算一个逐向量自适应的初始尺度:在旋转坐标近似 i.i.d. 高斯的假设下,$D$ 维标准高斯向量的最大绝对坐标期望 $E_{\max}(D)$ 是一个已知常数,于是
$$s_{\text{initial}}=\frac{\max_{i}|z_{i}|}{E_{\max}(D)} \tag{4}$$
因为 $1/E_{\max}(D)$ 可以预计算,求 $s_{\text{initial}}$ 只需一趟扫描找最大绝对坐标再做一次标量乘。用向量实际的峰值坐标去锚定码本量程,比用方差锚定更能抑制尾部截断误差。
按 $1/s_{\text{initial}}$ 归一化后映射到质心。码本维度与质心数 $K$ 随目标比特率 $b$ 变化:
| $b$ | 码本维度 | $K$ |
|---|---|---|
| 1 | 4D | 16 |
| 2 | 2D | 16 |
| 3 | 1D | 8 |
| 4 | 1D | 16 |
当 $D$ 不是子向量长度($b=1$ 时为 4,$b=2$ 时为 2)的整数倍时,向量先零填充到最近的倍数;查询打分与范数校正时只累加有效的 $D$ 个坐标(把尾部查询项置零),从而在不需要单独 1D 回退码本的前提下保持内积精确。
$K\leq 16$ 是硬性的硬件约束:Rslm 靠 VPSHUFB 字节洗牌指令直接在 CPU 寄存器内查表,而 AVX2 把洗牌限制在 16 字节 lane 内,码本一旦超过 16 个元素性能就会断崖式下跌。
码本本身的获取方式:在对应维度的标准正态分布上采一大批合成样本,用 $K$ 个簇跑 k-means,得到的质心即为在高斯假设下最小化 MSE 的最优量化电平。这些码本与数据无关——这是"training-free"的字面含义:不是不做 k-means,而是 k-means 只在解析已知的合成分布上跑一次,与任何真实数据集无关。
范数校正:本文的核心创新¶
Rslm 在量化码字后追加一个 2 字节的逐向量 scale(Rslm4Lite 除外,见下)。对 embedding $x$ 与其第一阶段量化 $\hat{x}$,重建表示为 $\tilde{x}=s\cdot\hat{x}$,其中
$$s=\frac{\|x\|_{2}}{\|\hat{x}\|_{2}} \tag{5}$$
保证重建向量的 $L_2$ 范数与原向量精确一致。这与两类标准做法形成对照:
- SSQ 会系统性地膨胀范数。把舍入误差建模为步长 $\Delta$ 内的独立均匀噪声,其方差 $\sigma^2=\frac{\Delta^2}{12}$,于是量化向量的期望平方模长为
$$\mathbb{E}\bigl[\|\hat{x}\|_{2}^{2}\bigr]\approx\|x\|_{2}^{2}+D\frac{\Delta^{2}}{12} \tag{6}$$
- PQ 会系统性地收缩范数。PQ 质心是各自 Voronoi cell 的条件均值,按最优向量量化的质心性质,
$$\mathbb{E}\bigl[\|q(x)\|_{2}^{2}\bigr]=\mathbb{E}\bigl[\|x\|_{2}^{2}\bigr]-\text{MSE} \tag{7}$$
而且两者在膨胀/收缩的同时还会在不同向量之间引入范数方差——这对排序是双重打击。高维下这个偏差非常显著:在 1536 维的 openai 数据集上(原向量单位归一化),SSQ4Lite 的平均重建范数膨胀到 1.82($\sigma=0.03$),4-bit PQ 则收缩到 0.72($\sigma=0.01$)。Rslm 通过强制范数对齐把这项失真彻底消除。
Scale 的编码格式¶
Float32(S1E8M23)范围好、召回好,但 4 字节在低维、低比特率场景下太贵。两种标准 16-bit 浮点各有短板:BFloat16(S1E8M7)范围够但掉召回;Float16(S1E5M10)召回接近 Float32 但范围受限。由于 scale 恒非负,符号位是冗余的。参数扫描后作者选定 UE7M9(无符号、7 位指数、9 位尾数、不支持次正规数),用几条简单 ALU 指令转成 Float32。
五个 codec 变体与隐写式 scale¶
| Codec | Bits/Dim | 码本类型 | $K$ | Scale |
|---|---|---|---|---|
| Rslm1 | 1 | 4D | 16 | 后缀 2 字节 |
| Rslm2 | 2 | 2D | 16 | 后缀 2 字节 |
| Rslm3 | 3 | 1D | 8 | 后缀 2 字节 |
| Rslm4 | 4 | 1D | 16 | 后缀 2 字节 |
| Rslm4Lite | 4 | 1D | 16 / 8 | 嵌入码字内 |
统一的压缩流水线是:(1) 两趟级联正交变换 → (2) 估初始尺度并量化归一化向量 → (3) 算精修尺度以保持 $L_2$ 范数 → (4) 打包码字与尺度。
Rslm4Lite 的隐写技巧:面向 $D\geq 64$ 的 embedding。它对前 16 维改用 $K=8$(3 bit)的质心,于是这 16 维每维的最高位就空了出来;把一个 16-bit 的 UE7M9 scale 写进这 16 个空闲比特,最终打包尺寸恰好是 $\lceil D/2\rceil$ 字节。实际意义是:对 256 维 embedding,内存带宽受限的系统预取一个向量只需要两条 cache line 而不是三条。论文注明这个设计来自他们用 AlphaEvolve 跑的一次优化搜索。
相对(残差)量化¶
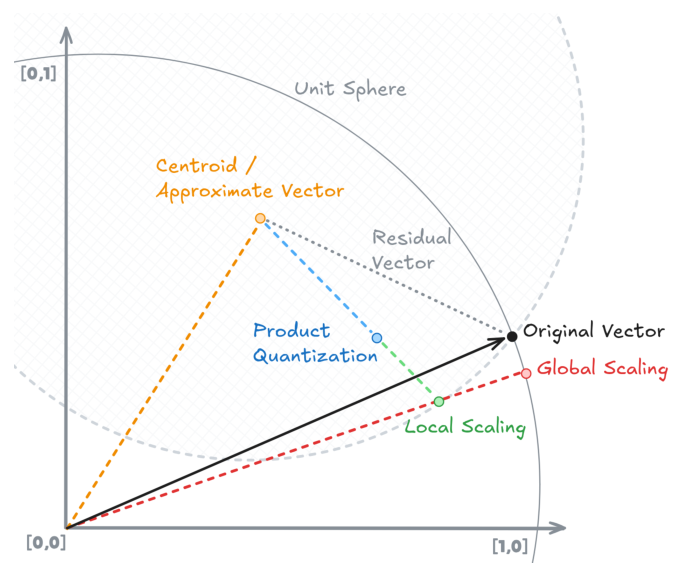
Rslm codec 既可以量化全向量,也可以做相对量化:量化残差 $r=x-a$,其中 $a$ 是初始量化阶段给出的近似向量(IVF 分区中心 + 一阶残差的解码值)。图 1 画出了这个几何:原向量指向单位球面上一点,质心/近似向量偏离它,残差向量是二者之差;PQ 的重建点落在球内(范数收缩),局部缩放只把残差本身的长度修回去,全局缩放则把"近似向量 + 量化残差"这个合成向量的长度修回原向量的长度。
局部缩放(RelApprox):残差 $r$ 独立量化成 $\tilde r$,用自己的局部 scale 保持自身范数。排序时的点积可以复用已经算过的 $\langle q,a\rangle$:
$$\langle q,(a+\tilde{r})\rangle=\langle q,a\rangle+\langle q,\tilde{r}\rangle \tag{8}$$
每向量存一个 2 字节 UE7M9 scale(Rslm4Lite 为零开销)。
全局缩放(RelApproxGlobal):为了校正跨所有阶段累积的量化误差,编码时算
$$s=\frac{\|x\|_{2}}{\|a+\tilde{r}\|_{2}} \tag{9}$$
并作为第二个 2 字节浮点存下(因此每向量两个 2 字节标量)。由于全局 scale 非常接近 1.0,不需要那么大的动态范围,于是改用 UE4M12——把更多位留给尾数以提升召回。打分时最终点积为
$$s\bigl(\langle q,a\rangle+\langle q,\tilde{r}\rangle\bigr) \tag{10}$$
对 RelApproxGlobal-Rslm4Lite,可以把两个标量都藏进前 32 维,再次做到零元数据开销。
这一条就是全文的核心主张:以往(如 NEQ)修的是残差的范数,Rslm 修的是最终重建向量的范数。
实验设置¶
评价指标:为什么用 Recall@20@30¶
传统 VQ 文献用 MSE 评价,但数据库检索里用户满意度和下游排序模型依赖的是排序准确度而非坐标保真度。本文全程用 Recall@X@Y(穷举搜索 ground truth 的 top-$X$ 中,有多少落进量化打分返回的前 $Y$ 位)。评测四个变体:Recall@20@30(默认)、Recall@20@40(更宽松,适合有下游后处理的场景)、Recall@20@20(传统严格召回)、1%-Tolerant Recall@20。
选 Recall@20@30 作默认的理由(Table 3)是它能吸收良性的数学噪声而只惩罚真正的质量失败:
| 检索场景 | 是有效损失吗 | R@20@20 | R@20@30 | Tolerant R@20 |
|---|---|---|---|---|
| 漏掉 top ground-truth | 是 | Loss | Loss | Loss |
| 相邻项互换 | 否 | Loss | Ignored | Ignored |
| 微小打分伪影 | 否 | Loss | Ignored | Ignored |
| 动态索引位移 | 否 | Loss | Ignored | Ignored |
| 等距噪声洗牌 | 否 | Loss | Mitigated | Ignored |
1%-Tolerant Recall 概念上目标一致,但 Recall@20@30 在分布式数据库引擎里更容易可靠测量——只需要返回候选文档 ID,不需要返回精确的未压缩浮点分数。
数据集与穷举评测协议¶
| 数据集 | 维度 | 规模 | 说明 |
|---|---|---|---|
| glove | 100 | 1 M | 词向量 |
| bigann | 128 | 100 M | SIFT 图像描述子;坐标严格非负、维间强相关、未单位归一化 |
| openai | 1536 | 2 M | OpenAI 文本 embedding |
| wiki_full | 3072 | 2 M | 维基百科的 Gemini embedding(内部数据) |
| wiki_pca | 384 | 2 M | 对 wiki_full 做 PCA + 随机旋转 |
为了把量化损失与索引划分误差解耦,质量评测走穷举路线:每个数据集 500 条 query,对每条 query 取出 ground-truth top-500 最近邻,直接在这个候选池上算排序指标。作者论证:既然关注的是量化误差有限的 codec,top-500 之外的候选几乎不可能挤进 top 20/30;他们在 openai、bigann、glove 上用"量化全部文档"做了验证,唯一统计显著的差异出现在非相对的 Rslm1(全部数据集)与 bigann 上的 Rslm2,即召回本来就已经很低的情形。
对比 codec¶
SQ8(ScaNN 默认的重打分 codec)、SSQ4Lite(不需要码本的简单 4-bit 标量量化)、以及 4-bit TurboQuant。作者明确说明:TurboQuant 在这里是 EDEN / TurboQuant / BlockQuant 这一整族的参照点(Rslm 正是建立在这些思想之上),选它是因为他们手上有优化过的 C++ 实现。此外还有一个消融 codec Slm4(Scaled Lloyd-Max)——与 Rslm4 相同但去掉旋转。
主要实验结果¶
全向量量化(Table 5,Recall@20@30,95% 置信区间)¶
| Codec | Bits/Dim | wiki_full (3072) | wiki_pca (384) | bigann (128) | glove (100) | openai (1536) |
|---|---|---|---|---|---|---|
| SQ8 | 8 | 100.0% | 100.0% | 98.8% | 100.0% | 99.6% |
| TurboQuant | 4+s | 100.0% | 99.3% | 92.2% | 96.9% | 99.3% |
| Rslm4 | 4+s | 99.9% | 99.2% | 92.3% | 97.3% | 98.9% |
| Rslm4Lite | 4 | 100.0% | 99.2% | 89.5% | 95.5% | 99.0% |
| Slm4(无旋转) | 4+s | 79.1% | 98.6% | 60.9% | 93.6% | 57.5% |
| SSQ4Lite | 4 | 89.8% | 98.1% | 60.2% | 93.3% | 60.6% |
| Rslm3 | 3+s | 99.0% | 94.6% | 75.3% | 87.2% | 94.7% |
| Rslm2 | 2+s | 94.2% | 82.2% | 49.7% | 67.9% | 82.2% |
| Rslm1 | 1+s | 79.2% | 56.2% | 25.4% | 39.2% | 61.0% |
("+s" 表示每向量额外存一个 scale。)
三条结论:
- 旋转的作用。不旋转的
Slm4与SSQ4Lite在 wiki_full(79.1% / 89.8%)、bigann(60.9% / 60.2%)、openai(57.5% / 60.6%)上出现灾难性掉点,原因是坐标均值非零与方差偏斜。而Rslm4与TurboQuant靠预先均匀化方差,在 wiki_full 与 openai 上 >99%、bigann 上 >92%。反例很有说服力:wiki_pca在 PCA 的最后一步已经施加过完整随机旋转,因此Slm4与SSQ4Lite在它上面表现正常(98.6% / 98.1%)——这等于是一个天然的对照实验,把"旋转"这个变量单独隔离出来了。 - 维度对量化噪声有保护作用。wiki_full($D=3072$)上连 3-bit 和 2-bit 都有 99% / 94% 的召回。理论解释是:真实内积信号功率随维度二次增长,而不相关零均值量化噪声的方差只线性增长,因此内积估计的信噪比按 $D\cdot 2^{2b}$ 缩放。推论:维度翻两番,平均可以少用 1 bit/维而不损害内积估计的统计可靠性。
- Lite vs 标准 4-bit。隐写 scale 省掉了每向量存储开销并换来 cache line 对齐;代价在低维数据集上更明显(16 个被牺牲精度的维度占比更大:glove 上 97.3%→95.5%,bigann 上 92.3%→89.5%),但高维下几乎无影响(openai 98.9%→99.0%,wiki_full 99.9%→100.0%),因此
Rslm4Lite是高维负载的最优选择。
残差(相对)量化(Table 6,Recall@20@30)¶
近似向量的构造:先把数据集划分成每分区约 100 个向量(bigann 因为太大用两级层次划分树),每个向量分到最近的粗分区中心;一阶残差用 ScaNN 的 Asymmetric Hashing(即 PQ)以 1 bit/维量化。把分区中心与解码残差相加得到近似文档向量 $a$,RelApprox* 变体量化的是二阶残差。
| Codec | Bits/Dim | wiki_full | wiki_pca | bigann | glove | openai |
|---|---|---|---|---|---|---|
| RelApprox-SQ8 | 8 | 100.0% | 100.0% | 99.9% | 100.0% | 100.0% |
| RelApproxGlobal-Rslm4 | 4+s | 100.0% | 100.0% | 100.0% | 100.0% | 100.0% |
| RelApproxGlobal-Rslm4Lite | 4 | 100.0% | 100.0% | 99.9% | 99.8% | 100.0% |
| RelApprox-Rslm4 | 4+s | 100.0% | 100.0% | 99.0% | 99.8% | 100.0% |
| RelApprox-TurboQuant | 4+s | 100.0% | 100.0% | 98.8% | 99.8% | 100.0% |
| RelApprox-Slm4 | 4+s | 100.0% | 100.0% | 97.1% | 99.5% | 98.2% |
| RelApprox-Rslm4Lite | 4 | 100.0% | 100.0% | 98.1% | 99.6% | 100.0% |
| RelApprox-SSQ4Lite | 4 | 100.0% | 99.9% | 94.8% | 99.2% | 99.9% |
| RelApproxGlobal-Rslm3 | 3+s | 100.0% | 99.6% | 99.6% | 98.9% | 100.0% |
| RelApprox-Rslm3 | 3+s | 100.0% | 99.4% | 94.0% | 98.2% | 99.7% |
| RelApproxGlobal-Rslm2 | 2+s | 100.0% | 97.2% | 97.2% | 94.2% | 99.7% |
| RelApprox-Rslm2 | 2+s | 100.0% | 96.5% | 80.9% | 91.7% | 97.4% |
| RelApproxGlobal-Rslm1 | 1+s | 99.5% | 86.9% | 87.7% | 82.1% | 97.3% |
| RelApprox-Rslm1 | 1+s | 99.2% | 85.1% | 57.6% | 76.0% | 88.6% |
Table 7 补充了两个低比特配置的 Recall@20@40:
| Codec | Bits/Dim | wiki_full | wiki_pca | bigann | glove | openai |
|---|---|---|---|---|---|---|
| RelApproxGlobal-Rslm2 | 2+s | 100.0% | 99.4% | 99.3% | 97.7% | 100.0% |
| RelApproxGlobal-Rslm1 | 1+s | 100.0% | 93.1% | 93.5% | 88.2% | 99.4% |
三条结论:
- 相对编码全面碾压非相对编码。有了近似向量这条额外信息,召回损失被大幅压缩。4-bit 相对 Rslm 编码在所有数据集上都是 100%,3-bit 相对编码 $\geq 98.9\%$。对照 Table 5 的
Rslm4在 bigann 上只有 92.3%,RelApproxGlobal-Rslm4直接到 100%。 - RAG 场景下的极端带宽效率。用 Recall@20@40 看,2-bit 相对编码在五个数据集里四个 $\geq 99.3\%$(只有 100 维的 glove 是 97.7%);高维上 1-bit 相对编码在 3072 维 wiki_full 上 100%、1536 维 openai 上 99.4%。这意味着重打分向量的 DRAM 足迹与带宽可以砍到 1/4 ~ 1/8(对比 ScaNN 默认的 8 bit)。
- 修范数是关键。
RelApproxGlobal全面优于RelApprox(bigann 上 2-bit 从 80.9%→97.2%、1-bit 从 57.6%→87.7%),实验层面直接确认了"修的必须是完整重建向量(近似 + 残差)的范数,而不是残差自己的范数"——这正是论文自称的 major innovation。
其它召回指标(Table 8)¶
| Codec | Metric | openai | glove | bigann |
|---|---|---|---|---|
| SQ8 | R@20@20 / @30 / @40 / Tolerant | 91.4% / 99.6% / 100.0% / 100.0% | 98.0% / 100.0% / 100.0% / 100.0% | 92.4% / 98.8% / 99.4% / 100.0% |
| SSQ4Lite | R@20@20 / @30 / @40 / Tolerant | 49.9% / 60.6% / 68.0% / 82.5% | 81.0% / 93.3% / 97.3% / 87.4% | 49.4% / 60.2% / 67.6% / 81.1% |
| Rslm4 | R@20@20 / @30 / @40 / Tolerant | 90.5% / 98.9% / 99.9% / 100.0% | 86.8% / 97.3% / 99.3% / 92.7% | 79.6% / 92.3% / 96.6% / 99.6% |
| RelApproxGlobal-Rslm4 | R@20@20 / @30 / @40 / Tolerant | 97.5% / 100.0% / 100.0% / 100.0% | 94.9% / 100.0% / 100.0% / 99.3% | 95.5% / 100.0% / 100.0% / 100.0% |
| RelApproxGlobal-Rslm2 | R@20@20 / @30 / @40 / Tolerant | 92.9% / 99.7% / 100.0% / 100.0% | 82.9% / 94.2% / 97.7% / 89.0% | 86.4% / 97.2% / 99.3% / 99.8% |
趋势符合预期,唯一的异常是 bigann 的 1%-Tolerant Recall@20 明显高于其 Recall@20@X。作者的解释是 bigann 里存在大量向量高度相似的文档簇(被"每维离散化成 0~255 的整数"这一点进一步放大),所以"换了个几乎等价的邻居"这种交换被 Tolerant 指标忽略、却被 R@20@X 惩罚。
吞吐与内存节省¶
在 AMD Milan(AVX2)与 Intel Cascade Lake(AVX-512)两个服务器平台上跑微基准,覆盖不同的 L1/L2/L3 cache 容量与占用情况。主要测的是 OneToMany 点积:一条 query 与大量文档向量算点积。
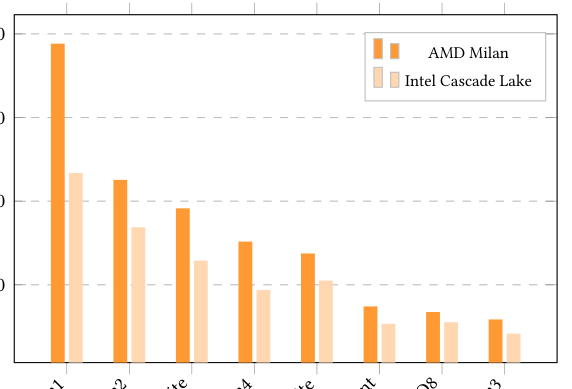
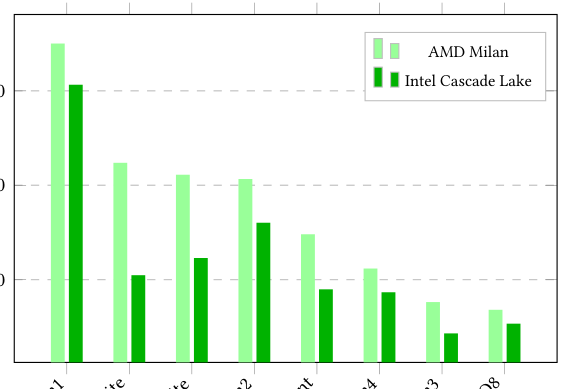
- 内存足迹变小不只省 RAM 成本,还因为吞吐提高而显著改善端到端系统性能——这是把量化的收益从"存储"扩展到"带宽"的关键论点。
- cache line 优化过的
Rslm4Lite在 LargePool 基准上明显超过Rslm4(在 Contiguous 场景里两者差距小得多,说明收益确实来自预取/带宽而非计算)。 - 即使
Rslm4Lite要查固定 Lloyd–Max 码本、而SSQ4Lite完全没有码本,靠高度优化的 SIMD 指令前者仍能在吞吐上与后者竞争。
任意维度的旋转成本:Compress 只在建索引时对每个向量做一次,但仍是可观的成本;更关键的是这个旋转在服务时也要对每条 query 做一次(这样就能直接在旋转空间里算点积,而不必在线解压所有文档向量)。作者给出的对照非常直白:在 $D=256$ 时 TurboQuant 与 Rslm4 性能相当,但在 $D=2049$ 时 TurboQuant 因为依赖全维度稠密旋转严重变慢——AMD Milan 上 TurboQuant 只能压缩 3.5k items/s,而 Rslm4 是 128k items/s(36×)。这就是论文说"即使 Rslm4 与 4-bit TurboQuant 很相似,我们仍然要造 Rslm4"的理由。
与 Faiss / ScaNN 的端到端对比¶
前面的评测聚焦重打分阶段(相对近似向量编码);这一节展示近似打分阶段(相对分区中心编码)的收益,在完整的 glove 与 openai 数据集上跑 500 条 query。
流水线三步:数据集划分 → 残差量化(量化"向量 − 所属分区质心")→ 查询路由与扫描(按与质心的点积挑出最近的 $n_{\text{probe}}$ 个分区,扫描其中的量化残差取 top-$k$)。
划分配置力求公平:Faiss 用 IVF4096 Flat 索引、ScaNN 用单层 k-means 树,glove 划 4096 个分区、openai 划 8192 个(即 $4\sqrt{N}$ 上取整到 2 的幂);两个划分器都用相同参数(25 次 k-means 迭代、glove 1,048,576 / openai 2,097,152 的训练样本量即平均每质心 256 点、随机初始化)。为让每个 baseline 跑在自己的最优设置上,Faiss 与 ScaNN 的 codec 各自跑在它们原生的默认划分上(Faiss 球面 k-means、ScaNN 标准欧氏 k-means),而本文 codec 一律在 ScaNN 的划分上评测。
对比的 codec:Faiss SQ(默认逐维独立量程的非均匀版,以及所有维共享一个量程的 uniform 版)、Faiss PQ(如 FaissPQ50x4 = 把 100 维 GloVe 切成 50 个 2 维子向量、每个用 4-bit/$K=16$ 码本,整体 2 bit/维)、ScaNN 的 Asymmetric Hashing(训练版 PQ,编码可选 MSE 或 anisotropic loss)。Faiss 与 ScaNN 也支持在量化前施加随机正交投影矩阵(记作 "Faiss Rotated" / "ScaNN Rotated"),目标与 Rslm 的 FWHT 流水线相同,但需要稠密的 $\mathcal{O}(D^2)$ 矩阵乘。
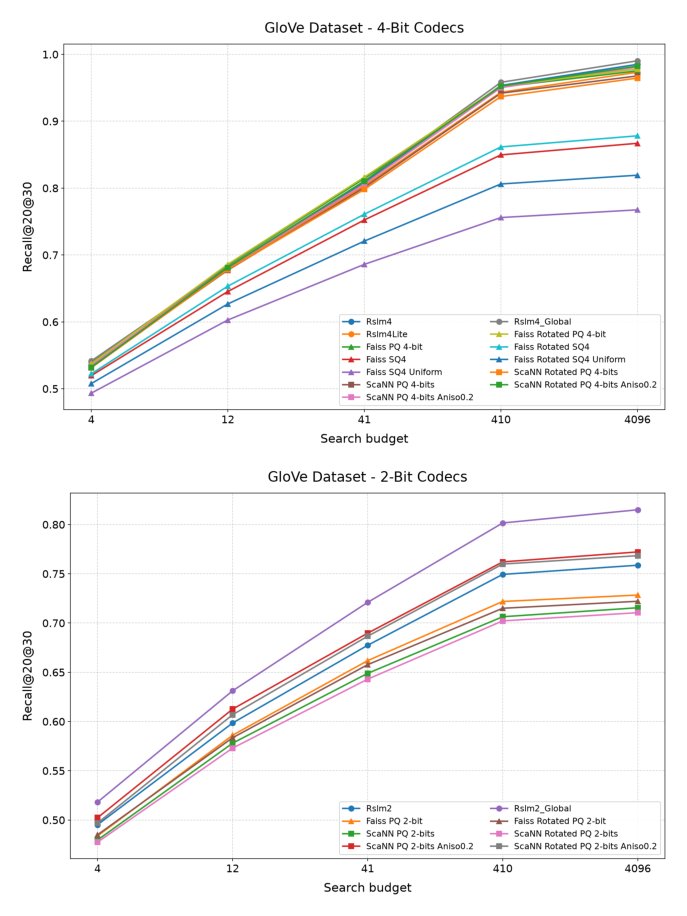
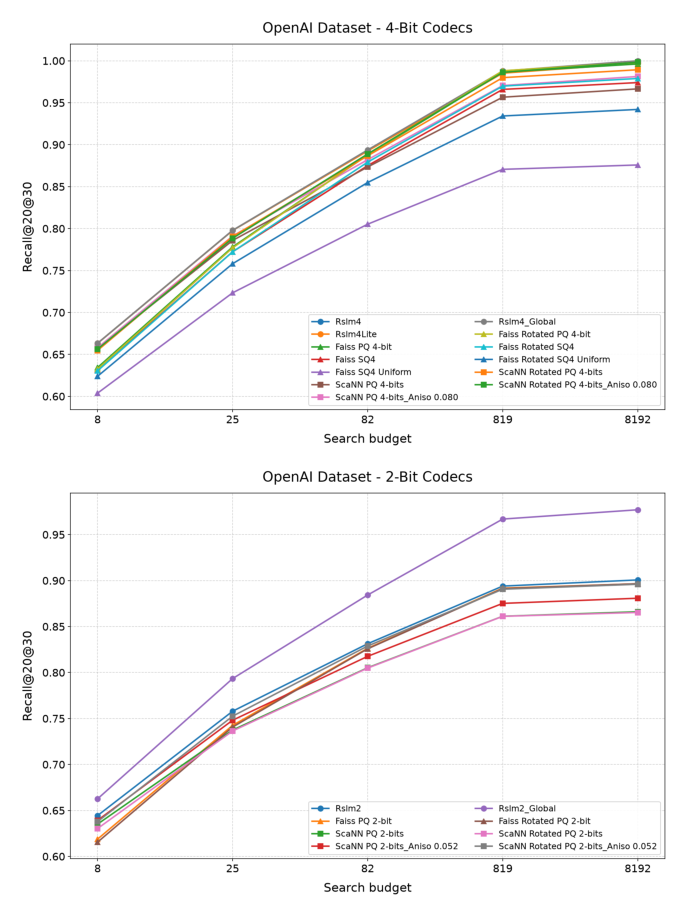
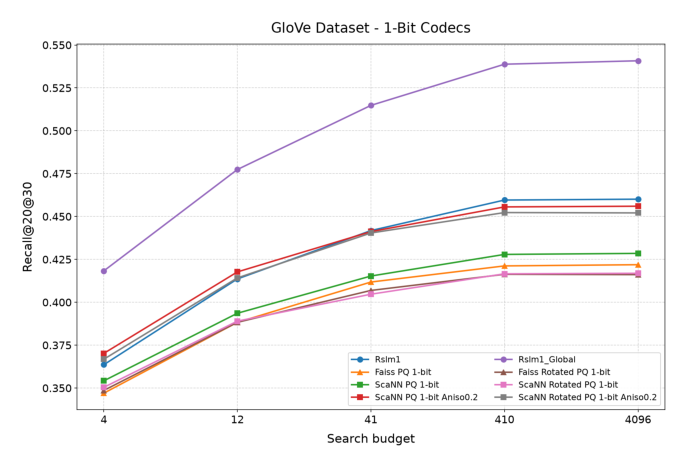
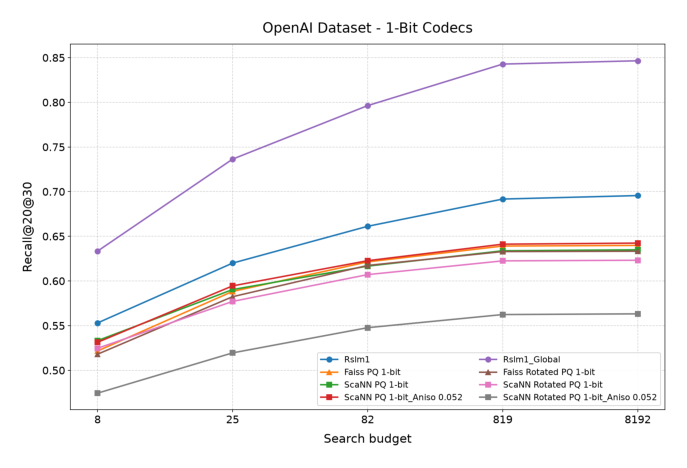
搜索预算取总分区数的 0.1% / 0.3% / 1% / 10% / 100%(glove 为 $n_{\text{probe}}\in\{4,12,41,410,4096\}$,openai 为 $\{8,25,82,819,8192\}$)。ScaNN 的 anisotropic 版本标注为 "Aniso $t$",glove 上扫了 $t\in\{0.1,0.2,0.3\}$ 取最优。
关于 anisotropic loss 的一个重要观察:同样的阈值搬到 openai 上,ScaNN AVQ 在 2-bit、尤其 1-bit 下远差于标准 ScaNN PQ($n_{\text{probe}}=82$、1-bit 时 ScaNN PQ Aniso0.2 只有 18.7% recall@20@30,而 ScaNN PQ 有 61.66%)。原因是 anisotropic loss 里惩罚平行误差的参数同时依赖阈值与维度:
$$\eta=\frac{t^{2}(D-1)}{1-t^{2}},\qquad \mathcal{L}=\eta\|e_{\parallel}\|^{2}+\|e_{\perp}\|^{2} \tag{11}$$
因此 ScaNN AVQ 的 $t$ 必须逐数据集调参。这正是 Rslm 用"强制范数保持"取代它的动机。
结果分析:
- 误差来源随比特率切换。高比特率(4-bit)下量化误差可忽略,检索质量主要由划分误差决定,加大搜索预算收益巨大(
Rslm4_Global从 $n_{\text{probe}}=4$ 的 54.1% 涨到 $n_{\text{probe}}=410$ 的 95.8%);低比特率下量化噪声成为主要瓶颈,即使扫全库召回也会被封顶(Rslm1_Global在 $n_{\text{probe}}=4096$ 只有 54.0%)。 - 免训练也能拿到同等召回。Rslm 在所有比特级别上都追平或超过训练出来的 Faiss / ScaNN 配置。省掉 k-means 训练意味着可以在新数据集(样本不足以训练码本)上快速上线,并显著降低建索引的复杂度。
- 低比特率下 Rslm 明显领先。在 1-bit 与 2-bit(也正是 ScaNN 的默认设置)下,
Rslm_Global显著超过 ScaNN 与 Faiss。glove、$n_{\text{probe}}=4096$ 时Rslm1_Global达到 54.0%,对比 ScaNN AVQ 的 45.6%、Faiss PQ 的 42.1%;2-bit 下Rslm2_Global比 ScaNN 最佳变体高 4.3%、比 Faiss 高 8.7%。作者把原因归到范数保持:ScaNN AVQ 虽然比朴素 ScaNN PQ 好,但要调参;Rslm 用严格的范数保持达到类似效果,代价只是每向量多存一个标量。 - 作者主动承认的不公平:额外标量在低维数据集上占比不小。glove 1-bit 时 Faiss PQ 每向量 13 字节而 Rslm1 要 15 字节(+15%),存两个标量则是 +31%;但在高维的 openai 上只是 192 vs 194 字节(+1%),存两个标量也只 +2%。
- Faiss 与 ScaNN 的 PQ 差异来自码本初始化:ScaNN 用 k-means++,Faiss 用标准随机初始化,因此结构等价的 PQ 配置结果接近但不相同($n_{\text{probe}}=41$、4-bit 时 Faiss PQ 81.4% vs ScaNN PQ 80.1%;2-bit 时 66.1% vs 64.8%;1-bit 时 41.5%(ScaNN)vs 41.1%(Faiss))。
- 随机正交旋转能改善 SQ 但一般不改善 PQ:旋转把方差摊匀,帮助 SQ 那种刚性的逐坐标量程避免截断高方差坐标;而 PQ 本来就是在子向量上做多维聚类,已经隐式处理了这件事。
核心贡献总结¶
- 把范数校正从"残差"提升到"最终重建向量"。一个极简的改动(多存一个 2 字节标量、乘一个数),在低比特残差量化上实验性地打败了 ScaNN 的 anisotropic loss,且完全不需要离线训练和逐数据集调参。
- 分块级联 FWHT:用 $\mathcal{O}(D)$ 的线性复杂度近似稠密全局旋转,且对任意维度(包括 $D=2049$ 这种生产中真实出现的奇怪维度)都不需要零填充;在 Compress / Precompute-Query 上比 TurboQuant 的全维稠密旋转快 36×。
- 把码本规模钉死在 $\leq 16$ 以吃满 AVX
VPSHUFB的寄存器内查表,并用Rslm4Lite的隐写 scale 实现完美 cache line 对齐——把"编码格式"与"SIMD 执行模型"绑定设计。 - 系统性证明免训练 codec 可以取代数据相关的工业标准(Faiss PQ、ScaNN AH),并且在近似打分与重打分两个阶段同时成立,为简化、低成本的生产向量数据库架构提供了完整的一条路径。论文还指出省下的内存可以"改投"给别的优化,例如需要额外内存但能大幅减少待搜分区数的 SOAR。
与已归档相关工作的对比¶
RotaryQuant RotaryQuant / IsoQuant: Fitting 120B MoE Models on Consumer Hardware(Cognizant AI & Analytics, 2026-08-08)¶
关系:独立并发(本文未引用 RotaryQuant,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇指向同一个 root cause——TurboQuant 这一族 data-oblivious 量化器的稠密 Haar 旋转是 $\mathcal{O}(d^2)$ 的,计算与参数存储双重昂贵,而真正的瓶颈是服务侧的内存带宽而非精度。两者都不重训模型、不改动被量化对象的语义,只在表示层动刀;两者都把 TurboQuant 当作要超越的直接对象,都强调"通用量化器被设计成独立编码器"这件事本身就是问题。
- 相近的技术骨架:两条流水线可以抽象成同一张图——归一化并把范数单独存成标量 → 用 Hadamard/WHT 为主的结构化正交变换把能量各向同性地摊开(替代稠密旋转)→ 用按旋转后边缘分布离线标定一次的固定 Lloyd–Max 码本做低比特标量量化 → 位打包。IsoQuant 是 $H_d$($d\times d$ 归一化 Walsh–Hadamard)后接逐 4 维块的 $SO(4)$ 四元数旋转;Rslm 是分块 FWHT($B\leq 128$)后接静态符号翻转与块内置换 + 跨块 strided transpose,再来一趟。连"码本必须小到能塞进 SIMD 寄存器查表"这条硬件推导两篇都做了(IsoQuant 64 个码本条目 / Rslm $K\leq 16$ 以适配
VPSHUFB)。 - 本文的差异与推进:把归档里已有的框架接着往下推一格。RotaryQuant 的精读已经指出"同一模板有两个正交的设计变量:旋转怎么选、码本怎么选"——BlockQuant 拧码本那一格,RotaryQuant 拧旋转那一格。Rslm 与 RotaryQuant 拧的是同一格(都把稠密旋转换成 Hadamard 结构化旋转),但 Rslm 额外拧了第三格:解码端的输出缩放。IsoQuant 存的是原向量范数 $s=\|x\|_2$ 用于重建,属于常规做法;Rslm 存的是 $s=\|x\|_2/\|a+\tilde r\|_2$——校正的是"粗近似向量 + 量化残差"这个合成向量的范数,这是 RotaryQuant 的场景里根本不存在的对象(LLM KV cache 没有 IVF 分区中心那样的粗近似)。另一处关键分歧是训练性:IsoQuant 的 $SO(4)$ 块由 192 个可学参数参数化(每 head 存 256 个浮点),严格说不是完全免训练;Rslm 的符号翻转表与置换表是静态预计算的,因此参数存储恰好为零,这也是 Rslm 能声称 "training-free" 的边界所在。反过来,IsoQuant 拿到了 Rslm 没有的东西:因为逐坐标标量量化天生可位打包,它做出了"直接在打包 3-bit 数据上算注意力、完全不物化张量"的融合 kernel。
- 可比的方法 / 实验差异:应用域不重叠,指标口径无法换算——RotaryQuant 报 3-bit 下 $\Delta$PPL $\leq +0.0012$ 与 32K NIAH 100%(Apple M4 Max,9–19 tok/s),Rslm 报五个 ANN 数据集上的 Recall@20@30 与 AMD Milan / Intel Cascade Lake 上的点积吞吐。但两者的旋转成本论证可以直接对照:IsoQuant 在 $d=128$ 上是 1,408 FMA / 256 参数 vs 稠密的 16,384 / 16,384;Rslm 在 $D=2049$ 上是 128k items/s vs TurboQuant 的 3.5k items/s。两篇都在 2026 年 8 月、互不知情地得出了同一个结论:rotation-based 免训练量化的下一步不在失真界上,而在把旋转做成能写进 kernel 的结构化形式。
BlockQuant BlockQuant: Block-Sphere Vector Quantization(Seoul National University, 2026-05-19)¶
关系:显式引用但原文未展开对比(仅在 §2.2 related work 一句带过 + Table 1 分类表一行)· 已加载对方精读
- 共同关注的问题:两篇都在做 rotation-based、data-oblivious 的低比特向量量化,都明确以"内积估计精度而非坐标重构 MSE"为最终目标(BlockQuant 把 $\mathcal{D}_{IP}$ 单列为独立准则并证明它才对应检索召回;Rslm 干脆放弃 MSE,全程只报 Recall@X@Y),也都以 EDEN / TurboQuant / RaBitQ 这条谱系为共同起点。
- 相近的技术骨架:模板一致——随机正交变换 → 在解析已知的旋转后分布上离线构造一次固定码本(不从数据学)→ 编码 → 解码时反变换 + 标量重缩放。连重缩放的三种取法都对得上:BlockQuant 的
BSM(最小 MSE 的 best scalar)/UB(无偏内积)/MSE(不存 alignment 的裸重构),与 Rslm 的"局部 scale / 全局 scale / 不修范数(Slm4消融)"是同一族选择。 - 本文的差异与推进:两篇拧的是同一模板里正交的两格。BlockQuant 保持 Haar 稠密旋转不动,把码本从逐坐标 1D 标量推广到 $p$ 维 block-on-sphere($2^{bp}$ 个 centroid,按"半径 $r_j^2\sim\mathrm{Beta}(p/2,(d-p)/2)$、方向在 $\mathbb{S}^{p-1}$ 上均匀"的精确块边缘分布优化),把 MSE 上界的领先常数从 EDEN 的 2.721 压到 $p=3$ 的 1.770,$p=d$ 时匹配修正后的 Shannon 下界。Rslm 恰好相反:码本退回最朴素的 1D/2D/4D Lloyd–Max($K\leq 16$),把全部设计预算投在"旋转要便宜且不挑维度"与"最终重建向量的范数要精确"上。这个取舍是被硬件反推出来的——Rslm 的精读价值恰恰在于它给出了 BlockQuant 那条路线的实现代价:BlockQuant 在 $p=3,b=4$ 时 $K=4096$,编码要在 4096 个 centroid 里搜最近邻(其原文自己承认必须上 lookup-table 近似),而这与
VPSHUFB的 16 元素 lane 限制正面冲突,也就吃不到 Rslm 的寄存器内查表吞吐。另一条 Rslm 独有的推进是残差化:BlockQuant 假设输入是独立的单位球面向量,Rslm 则利用 ANN 系统里已经存在的粗近似向量,把待编码对象换成高度集中的二阶残差——Table 5 与 Table 6 的对照(bigann 上Rslm249.7% →RelApproxGlobal-Rslm297.2%)说明这个"系统结构红利"比码本几何的精细化收益大得多。 - 可比的方法 / 实验差异:没有任何可直接对比的数字,这是本文评测的一处明确短板。Rslm 在 §4.3 里写明"用 4-bit TurboQuant 作为 EDEN、TurboQuant 和 BlockQuant 这一族的参照点",理由是"我们手上有优化过的 TurboQuant C++ 实现"——即 BlockQuant 从未被真正跑过。这个代理是有风险的:BlockQuant 自己的实验显示它在 GloVe、OpenAI3、DBpedia 的 Recall@1@k 上(尤其低 bit、低 $k$ 区间,GloVe 2-bit 从 0.55 提到 0.7+)明显超过 TurboQuant,且在 LongBench-E 上 BlockQuant 44.03 / EDEN 43.87 / RabitQ 43.52 / TurboQuant 43.20——TurboQuant 恰恰是这一族里内积失真最差的那个(理论上其 $\mathcal{D}_{IP}$ 约为 EDEN/RaBitQ 的 4 倍)。因此 Table 5 中
Rslm4与TurboQuant的平手(bigann 92.3% vs 92.2%、glove 97.3% vs 96.9%)不足以支撑"Rslm 追平整个 rotation-based 家族"这个更强的结论;两者共用的 GloVe/OpenAI 数据集本来提供了直接对比的机会,却因为口径不同(Recall@1@k vs Recall@20@30)与未复现而错过。
Tlow Tlow: Flow-based Item Tokenizer for Recommendation(清华大学 + 腾讯, 2026-08-25)¶
关系:独立并发(本文未引用 Tlow,两者在"先把分布掰成标准正态、再用朴素固定量化器"这一条上殊途同归;但下游目标不同源,因此只在这一条轴上构成对照)· 已加载对方精读
- 共同关注的问题:两篇在同一条轴上给出了同一个诊断——低比特量化失效的病根在"被量化的表示空间本身",而不在量化算法不够聪明。Rslm 的表述是"直接量化原始 embedding 会因坐标方差不均与离群点导致码本容量利用率低下",Tlow 的表述是"语义嵌入高度各向异性、占据锥形区域且维度相关,独立量化在复杂偏斜流形上强加网格状结构"。两篇的关键消融也指向同一件事:Rslm 的
Slm4(去掉旋转)在 openai 上从 98.9% 掉到 57.5%、bigann 上从 92.3% 掉到 60.9%;Tlow 则用"RPG(独立 tokenizer)并未一致优于 TIGER(残差式串行 tokenizer)"证明独立量化在未整形的空间里根本不成立。两篇都把"变换 → 各向同性化 → 用朴素量化器"当成解法,而不是"设计更强的量化器"。 - 相近的技术骨架:抽象流程图重合——$x \to$ 可逆变换 $\to$ 近似 $\mathcal{N}(0,I)$ 的潜空间 $\to$ 切分 $\to$ 每段用简单固定码本独立量化 $\to$ 并行/逐坐标解码。Tlow 用 Glow 式多尺度 normalizing flow(ActNorm + PLU 分解可逆线性 + affine coupling,$N=4$ blocks × $M=4$ steps);Rslm 用两趟级联的分块 FWHT + 静态符号翻转 + 置换。两者都在推理"变换之后每段服从什么边缘分布",并据此选码本——Rslm 因为知道是 $N(0,1)$ 才敢把 Lloyd–Max 码本预计算成常量。
- 本文的差异与推进:分歧点恰好在"变换是否必须保距、是否必须训练",而这是被下游目标逼出来的。 Rslm 的下游是 MIPS 排序,内积必须被严格保持,因此变换只能是正交的,也因此只能是免训练的(正交变换的自由度里没有可以从数据学的东西,除非做 OPQ 那样的学习旋转,而那又要训练)。Tlow 的下游是自回归/并行解码出 token ID 再喂给推荐模型,不需要保内积,因此它可以用一个非等距的、逐数据集训练的非线性可逆映射,换来远超单个正交矩阵的表达力(Tlow 精读里明确点出这一点:OPQ 只做到子空间级解耦,子空间内维度仍相关,而 flow 是 $N\times M$ 层非线性可逆变换)。"training-free"在 Rslm 这里不是一个效率选择,而是 MIPS 保距约束的推论——这一点与归档里 Tlow / PRQ-KMeans / Dynamic PV-S2 那批"码本必须训练"的 SID 工作构成了一个真实但边界清晰的对立:它们互斥的不是结论,而是问题设定。此外 Tlow 与 Rslm 都走到了"最后用朴素量化器"这一步(Tlow 退回并行 PQ、Rslm 用固定 Lloyd–Max),但 Tlow 的 PQ 子码本仍然是在数据上跑 K-means 学出来的,Rslm 的码本则是在合成高斯样本上跑一次 K-means、与任何真实数据无关。
- 可比的方法 / 实验差异:数据集与指标完全不重叠(Tlow 用 Amazon Sports/Beauty/Toys/CDs 的 Recall/NDCG 与微信线上 CTR A/B,Rslm 用 glove/bigann/openai 的 Recall@20@30),没有任何可直接对比的数字,两者也不解决同一个业务问题(Tlow 关心 semantic ID 的语义纯度与冷启动,Rslm 关心 DRAM 带宽与 MIPS 召回)。必须说清的边界:Rslm 的另一半贡献(最终重建向量的范数校正、残差化、cache line 对齐、SIMD 码本尺寸约束)在 SID 那条线里完全没有对应物,反之 Tlow 关心的码本坍缩、碰撞、token 语义可解码性在 Rslm 里也完全不存在。因此这里成立的对照仅限于"表示整形优先于量化器设计"这一条方法论,不构成整篇论文层面的孪生。
被剔除的近似候选与理由(防止门槛放水):
| 候选 | 剔除理由 |
|---|---|
| PRQ-KMeans PRQ-KMeans(Kuaishou, 2026-08-25) | 表面上同为"残差量化 + 修正残差传递",但 root cause 不同源:PRQ 的病根是层级码本之间的残差携带导致后级重复编码已编码的变化(码本容量利用率问题),解法是用正交约束投影残差替代整码字减法;Rslm 的残差是 IVF 分区中心的一阶残差,它不改减法,改的是最终重建向量的范数(MIPS 排序保真问题)。且 PRQ 的码本必须在工业数据上 K-means 训练,与 Rslm 的免训练前提正相反。 |
| Dynamic PV-S2 Dynamic PV-S2(Kuaishou, 2026-08-21) | 问题是 SID 层级的条件稀疏与自回归解码步数(三步降两步),解法是砍一层换单级大码本 + 稳定哈希消歧。Rslm 没有自回归解码,也没有"层数"这个设计变量;两者只共享"量化"这个词。 |
| AMBER AMBER(AI at Meta, 2026-08-26) | 押的是"富表征下 SID 冗余、不需要码本",解法是用双向 Transformer Event Tokenizer 把事件压成连续 embedding。它离散化都不做,与 Rslm 的比特率-召回权衡没有交集。 |
| DRQ DRQ(Shopee, 2026-06-01) | 骨架上是"先用 VAE 连续重塑分布、再做事后层级 K-Means",与"整形优先"的抽象一致,但其诊断(Distribution Penalty + Geometry Penalty 导致 SID 失效)与评价(碰撞率、推荐指标)完全绑定在 semantic ID 语义可解码性上,且重塑器必须训练。与 Tlow 相比它离 Rslm 更远,为控制在 ≤3 篇而剔除。 |
| CCD-Level and Load-Aware Thread Orchestration for In-Memory Vector ANNS on Multi-Core CPUs CCD-Level and Load-Aware Thread Orchestration for In-Memory Vector ANNS(ECNU, 2026-05-11) | 同为 ANN 系统、同为内存瓶颈,但 root cause 是多 chiplet CPU 上的线程—CCD 映射与负载不均,解法是冷热均衡的任务映射 + 亲和性 work stealing。它完全不碰表示精度,与 Rslm 在"降低每向量比特数"这条轴上零交集——典型的"同一系统、不同瓶颈"。 |
| SA-RSQ SA-RSQ(天津大学, 2026-08-24) | 同为残差量化压缩,但改的是分配机制(Top-K masked-softmax 稀疏路由替代 arg min),目标是多模态推荐的稀疏表示与可导性,需要训练。与 Rslm 的"变换 + 固定码本 + 范数校正"骨架不重合。 |
| AIR-MoE AIR-MoE(MPI-IS, 2026-05-06) | 把 IVF 倒排索引的配方搬到 MoE 专家路由(无梯度自适应球面 k-means 学码本粗筛专家)。"IVF 式粗筛 + 精排"这个骨架确实与 Rslm 的两阶段 ANN 流水线同形,但它优化的是路由质量而非向量重构/内积保真,码本也是学出来的。问题面差异显著。 |
讨论与局限性¶
核心贡献与值得借鉴的设计。 本文最值得借鉴的不是某个算子,而是"不要把量化器当独立组件设计"这个方法论。同样的比特预算下,Rslm 拿到的最大收益不来自更聪明的码本几何(那是 BlockQuant 的路线,收益是 MSE 领先常数从 2.721 降到 1.770,约 35%),而来自换了被量化的对象:从全向量换成"相对 IVF 粗近似的二阶残差",bigann 上 2-bit 召回从 49.7% 跳到 97.2%。这个对比很能说明问题——系统结构提供的信息红利,量级上压过了算法层的精细化。第二个可迁移的设计是把范数校正推到最终重建向量:它揭示了一个容易被忽略的事实,即多阶段量化流水线里每一级各自"范数无偏"并不蕴含合成结果范数无偏(PQ 收缩、SSQ 膨胀,误差还会跨级累积),而 MIPS 排序恰恰对这个合成范数最敏感。第三是把编码格式与 SIMD 执行模型绑定设计($K\leq 16$ 迁就 VPSHUFB、隐写 scale 换 cache line 对齐),这类"为了让 kernel 写得出来"倒推回算法层的决策,与 RotaryQuant 的融合 kernel 是同一种工程哲学。
局限与争议。
- baseline 覆盖不足,且用了一个偏弱的代理。整篇论文的 rotation-based 对照只有 4-bit TurboQuant 一个点,EDEN、RaBitQ、E-RaBitQ、BlockQuant 全部被"TurboQuant 代表这一族"一句带过,理由是工程可得性。但按 BlockQuant 的统一分析,TurboQuant 恰是这一族里内积失真最差的(其 $\mathcal{D}_{IP}$ 领先常数 17.09/$d$,而 EDEN_UB 是 2.721/$(d-1)$)。因此"Rslm4 ≈ TurboQuant"这个结果不足以推出"Rslm 追平 rotation-based 家族"。更遗憾的是 GloVe 与 OpenAI 是两篇共用的数据集,本来存在直接复现的条件。
- 没有逐组件消融。流水线里有符号翻转、块内置换、跨块 strided transpose、两趟级联、EVT 初始尺度、UE7M9/UE4M12 格式选择等至少六个设计点,论文只提供了
Slm4(整体去掉旋转)这一个粗粒度消融。"单趟 vs 两趟"、"有没有 transpose"、"EVT 尺度 vs 样本方差尺度"各自贡献多少,读者无从判断。作者对格式的说明只有"a parameter sweep showed UE7M9 offering a good middle ground",没有给扫描结果。 - 额外标量的公平性问题(作者已自陈)。低维、低比特时额外 scale 的相对开销不可忽略(glove 1-bit 时 +15%,双标量 +31%)。论文承认这让 glove 上的对比"略微不公平",但没有给出"等字节预算"下的对照曲线(例如让 Faiss PQ 也多用 2 字节),因此低维场景下 1-bit 的领先幅度存在被高估的可能。
- Table 5 与 Table 6 之间口径不完全对齐。相对量化的一阶残差用的是 ScaNN 的 1-bit PQ(训练出来的 AH),也就是说
RelApprox*结果里其实混入了一个训练过的组件。论文在脚注里说"我们也可以像 §5.5 那样用免训练 codec 做近似打分",但 Table 6 并没有跑这个纯免训练的版本。严格说,"端到端完全免训练"只在 §5.5 里被验证过,而 §5.2 那些 100% 的漂亮数字并不是纯免训练配置。 - 两个数据集不可复现。
wiki_full与wiki_pca是 Google 内部的 Gemini 维基百科 embedding,占五个数据集的两席,而且恰恰是维度最高(3072 / 384)、Rslm 表现最好的两个。开源的 Colab 只复现 glove。 - 穷举评测协议的近似。质量评测在 ground-truth top-500 候选池上做,作者验证了这个近似在多数情形下无偏,但自己承认非相对
Rslm1(全部数据集)与 bigann 上的Rslm2存在统计显著的差异——也就是说 Table 5 里最低比特那几行的绝对数值本身带有协议偏差。 - 只覆盖 IVF / 树索引。对 HNSW 等图索引的适用性只有定性论证(可以压节点向量、可以做 HNSW-PRQ 式的残差重打分),没有实验。
- 没有部署证据。这是判定为 academic 的关键。论文出自 Google Zurich / San Jose,实现开源在 google-research 仓库,但全部实验都是公开 ANN 基准 + 内部数据集上的离线评测,没有任何线上 A/B、生产系统指标或"已上线"的声明。文中三处工业气息($D=2049$ 这种"生产中出现的非标准维度"、
Rslm4Lite的设计"来自我们用 AlphaEvolve 跑的优化"、以及"手上有优化过的 TurboQuant C++ 实现")只说明作者具备生产环境的经验与内部工具,不构成部署证据;结论段的"paves the way for ... production vector database architectures"是前瞻表述而非既成事实。
方法论可扩展性。 Rslm 是 codec 而非可学模型,不存在"参数量 scaling 时表征能力与序列建模能力能否同步增长"这个问题;相反,免训练在架构上是干净的——没有码本固化后限制下游表征空间的隐患,也不会因分布漂移而需要重训(这正是 data-oblivious 相对 PQ 的结构性优势)。它真正的天花板在别处:data-oblivious 意味着彻底放弃数据自适应能力,在非相对、极低比特(1-bit)区间召回只有 25%~61%,必须靠"残差化"这个系统级红利才能救回来。也就是说 Rslm 的有效性条件是"ANN 系统里必须已经存在一个足够好的粗近似向量"——一旦脱离 IVF/树这种带粗划分的架构(例如纯图索引的节点向量压缩),它就退化回 Table 5 那一列偏弱的数字。