RotaryQuant: Fitting 120B MoE Models on Consumer Hardware via Fused Compressed-Space Attention 精读¶
A. Lui, M. Elsaied, N. P. Savani(Cognizant AI & Analytics / Cognizant AI Lab / SMU / UMBC) arXiv:2608.08081 · 2026-08-08 · Preprint(NeurIPS 格式,含 checklist)
研究动机与背景¶
把 26B–120B 规模的 MoE 语言模型塞进消费级设备(16–32 GB 统一内存)的困难,不是单一瓶颈,而是三股同时施加的内存压力:
- 常驻权重矩阵:一个 30B 的 MoE 即使按 4-bit 存储,光权重就要约 15 GB;
- KV cache 状态:随上下文长度线性膨胀,8K 上下文再吃掉 4–8 GB;
- 专家子层:几十个 routed expert 必须按需换页,常驻不下。
论文强调这三者必须被同时解决——只压权重不压 KV,或只压 KV 不管专家常驻,都会在某一维上先撞墙。作者进一步给出了"为什么一定要本地推理"的动机链条:每一次 prompt 离开设备都构成隐私暴露;订阅式 API 把低收入群体和低带宽地区的用户排除在外;数据中心的能耗与水耗增长速度快于单芯片能效改善(引 IEA 2024、Uptime Institute 2023)。隐私、可及性、环境成本这三条把"本地推理"抬升为一等公民级的部署目标,而不只是一个降本手段。
真正的技术靶子在于既有 KV cache 压缩工作的执行模型。KIVI、KVQuant、QJL、TurboQuant 这条线都在做量化,但无一例外遵循 reconstruct-then-compute(先重建再计算) 范式:压缩后的 KV 条目在进入标准 GEMM 注意力之前,必须先被解压回全精度张量。这一步"物化(materialization)"把压缩换来的内存节省在计算阶段又吐了回去,并且引入了与序列长度成正比的带宽开销。
论文提出的替代范式是 compute-in-compressed-space(在压缩空间里直接计算):不物化 FP16 张量,融合的 Metal kernel 直接在 3-bit 打包数据上做 QK 点积和 value 累加。作者反复强调这"是一种不同的执行模型,而不只是又一个量化方案"。
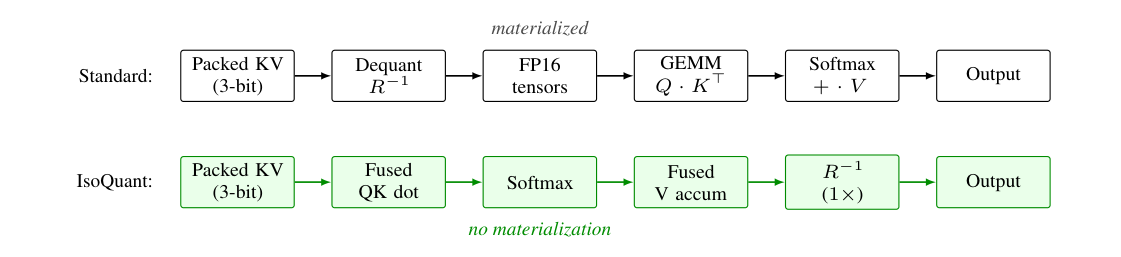
图 1 上半条是标准路径:Packed KV (3-bit) → Dequant $R^{-1}$ → FP16 tensors → GEMM $Q\cdot K^\top$ → Softmax $+\cdot V$ → Output,中间"materialized"是被攻击的对象。下半条是 IsoQuant:Packed KV (3-bit) → Fused QK dot → Softmax → Fused V accum → $R^{-1}$(只做一次)→ Output,全程"no materialization"。注意反旋转 $R^{-1}$ 的位置从"每个 token 解压时"挪到了"聚合输出之后一次性执行"——这是整个设计能成立的关键位移。
使这一位移成为可能的核心组件是 IsoQuant:一个结构化旋转,在量化前把 KV 向量的能量各向同性地摊开到各个维度上。它用 Walsh–Hadamard 变换(WHT)复合分块 SO(4) 旋转,把旋转代价压到 $O(d\log d)$、每个 head 只存 256 个参数;而稠密旋转方法(TurboQuant、SpinQuant)需要 $O(d^2)$ 代价和 16,384 个参数。
论文的四条贡献:
- IsoQuant 旋转:WHT + SO(4) 结构化旋转,达到各向同性能量摊开,复杂度 $O(d\log d)$,存储参数比稠密方案少 64×(§3.2);
- 融合压缩空间解码:四 kernel 的 Metal 流水线,直接在打包 3-bit KV 上算注意力,自回归解码期间彻底消除张量物化(§3.4);
- RotaryQuant 三轴内存系统:权重量化、KV 压缩(IsoQuant)、LRU 专家 offloading 的有原则组合,使 120B MoE 在 32 GB Apple M4 Max 上峰值 17.2 GB 即可推理(§3.1);
- 完整评测:三个架构迥异的模型上近零质量退化($\Delta$PPL < 0.002),并用解码剖面量化了"KV 压缩什么时候有用、什么时候没用"(§4)。
核心方法:RotaryQuant 的三条压缩轴¶
三轴组合与非交换性¶
消费级 MoE 推理要同时对付三类内存消费者:权重矩阵 $W$、KV cache 状态 $(k_j, v_j)_{j=1}^{T}$、专家常驻。RotaryQuant 按规范顺序组合三种独立压缩机制:
$$ \mathcal{M}_{\text{total}} = \mathcal{O}_E \circ \mathcal{C}_{KV} \circ \mathcal{Q}_W \tag{1} $$
其中 $\mathcal{Q}_W$ 是权重量化,$\mathcal{C}_{KV}$ 是 KV cache 压缩,$\mathcal{O}_E$ 是专家 offloading。论文特别指出这个组合是非交换的:权重量化决定了 KV 压缩必须应对的激活分布;而专家 offloading 又依赖于前两步压缩之后剩下的内存预算。也就是说三轴不是三个可以任意排列的独立开关,顺序本身携带语义。
轴一:按架构角色分配位宽的混合精度权重量化¶
权重量化不是全模型一刀切,而是按架构角色分配位宽:
- Dense 层:4-bit(GPTQ / AWQ 路线);
- Routed MoE 专家:2-bit——专家数量多、每个专家被激活的频率低,是最能吃激进压缩的部分;
- Shared expert:Q8_0(8-bit)——因为其激活峰度极高,实测 $\kappa = 10.10$,而 specialist expert 只有 $0.41$。高峰度意味着分布重尾、离群值多,激进量化会造成灾难性误差。
这一条是全文里最"便宜"但也最有工程说服力的设计:用一个可测量的统计量(峰度)来决定哪一部分不能压。
轴二:LRU 专家 offloading¶
非常驻专家按 LRU 策略被换出到磁盘,按需加载,用延迟换内存。论文明确限定:只在真正存在内存压力时才有益(详见 §4.4 的消融,无压力时它带来约 100× 的吞吐惩罚)。
轴三:IsoQuant KV cache 压缩(本文的新轴)¶
这是论文的核心贡献,下一节展开。
关键技术细节:IsoQuant¶
四步压缩流水线¶
每个 key 或 value 向量 $x \in \mathbb{R}^d$(标准注意力头 $d = 128$)经过四个阶段:
Step 1:归一化。 映射到单位球面,把范数单独存成一个标量 scale:
$$ \hat{x} = \frac{x}{\|x\|_2}, \qquad s = \|x\|_2 \tag{2} $$
Step 2:结构化旋转。 施加复合旋转 $R = R_{SO(4)} \circ H_d$:
$$ \tilde{x} = R_{SO(4)}\bigl(H_d \cdot \hat{x}\bigr) \tag{3} $$
其中 $H_d$ 是 $d \times d$ 归一化 Walsh–Hadamard 矩阵,$R_{SO(4)}$ 对每个连续的 4 维块独立施加一次 SO(4) 旋转。每块的旋转由一对单位四元数 $(q_L^{(i)}, q_R^{(i)})$ 参数化,作用为:
$$ \tilde{x}_{4i:4i+4} \;\leftarrow\; q_L^{(i)} \cdot \tilde{x}_{4i:4i+4} \cdot \bar{q}_R^{(i)} \tag{4} $$
Step 3:标量量化。 $\tilde{x}$ 的每个坐标用 Lloyd–Max 最优码本量化到 $b$ bit,码本按旋转后的边缘分布最小化期望失真而构造。
Step 4:位打包。 在 $b = 3$ 时,$d = 128$ 维打包成 48 字节,相对 FP16 的 256 字节达到约 $5.3\times$ 压缩。
完整算法(论文 Algorithm 1):
Algorithm 1  IsoQuant KV Compression
Require: KV 向量 x ∈ R^d, WHT 矩阵 H_d, SO(4) 四元数对 {(q_L^(i), q_R^(i))}_{i=1}^{d/4}, 码本 C_b
Ensure:  打包表示 x̄, 尺度 s
 1: s ← ||x||_2 ;  x̂ ← x / s                      ▷ 归一化到单位球面
 2: x̃ ← H_d · x̂                                    ▷ WHT 全局混合: O(d log d)
 3: for i = 1 to d/4 do
 4:     x̃[4i:4i+4] ← q_L^(i) · x̃[4i:4i+4] · q̄_R^(i)  ▷ SO(4) 分块旋转
 5: end for
 6: x̄ ← BITPACK_b( LLOYDMAX(x̃, C_b) )              ▷ 量化 + 打包到 b bit
 7: return x̄, s
为什么结构化旋转有效¶
WHT 通过其蝶形结构提供 $O(d\log d)$ 代价的全局混合,把可能集中在少数几个维度上的能量摊开;随后的 SO(4) 分块旋转在每个 4 元素组内做细粒度对齐。
论文给出的机制解释是:由正交性,$H_d\hat{x}$ 的每个坐标方差为 $1/d$。这种各向同性是关键——如果没有它,携带集中能量的维度会承受不成比例的量化误差(因为标量码本是按同一个边缘分布设计的)。SO(4) 块随后微调旋转,最小化块内残余相关性,只需要 $(d/4) \times 6 = 192$ 个可学参数(每个 SO(4) 元素 6 个自由度)外加 64 个码本条目。
旋转代价分析¶
- WHT:$d\log_2 d = 128 \times 7 = 896$ 次 FMA;
- SO(4):每块 16 次 FMA(四元数双覆盖 $v \mapsto q_L v \bar{q}_R$),共 $(d/4) \times 16 = 32 \times 16 = 512$ 次;
- 合计 1,408 次 FMA,对比稠密 $128 \times 128$ 旋转的 16,384 次,即 11.6× 缩减。
存储侧:每 head 32 个块 × 2 个四元数 × 4 个分量 = 256 个浮点数,对比稠密旋转的 16,384,即 64× 缩减。
数学基础¶
内积保持。 由于 $R$ 正交:
$$ \langle Rx, Ry\rangle = x^\top R^\top R y = \langle x, y\rangle,\quad \forall x, y \tag{5} $$
量化误差界(完整推导见原文 Appendix A):
$$ \mathbb{E}\Bigl[\bigl|q^\top k - \widehat{q^\top k}\bigr|^2\Bigr] \;\le\; d_k\,\sigma_q^2\,\|q\|_2^2 \tag{6} $$
其中 $\sigma_q^2$ 是每坐标量化方差,$\widehat{q^\top k}$ 表示在量化向量上计算的内积。
Hanson–Wright 保证的各向同性。 对 $u \in \mathbb{S}^{d-1}$ 与正交 $H_d$,Hanson–Wright 不等式给出二次型的指数集中:
$$ \Pr\Bigl[\bigl|Z - \tfrac{1}{d}\mathrm{tr}(A)\bigr| > t\Bigr] \;\le\; 2\exp\Bigl(-c\min\Bigl(\frac{d^2t^2}{\|A\|_F^2},\; \frac{dt}{\|A\|_{op}}\Bigr)\Bigr) \tag{7} $$
这保证了 WHT 之后的坐标近似等分布,从而最小化跨维度的最坏情况量化失真。这一步是"各向同性"从直觉变成定理的地方。
SO(4) 参数化。 SO(4) 的每个元素都能写成一对单位四元数的作用:
$$ T_{q_L, q_R}(v) = q_L\, v\, \bar{q}_R,\qquad q_L, q_R \in \mathbb{S}^3 \tag{8} $$
每个四元数贡献 3 个自由度(4 个分量减 1 个范数约束),共 6 个自由度,恰好等于 $\dim SO(4) = 6$。论文强调:单四元数共轭 $v \mapsto q v \bar{q}$ 只张成 SO(3),是一个 3 维子群,无法独立控制 $\mathbb{R}^4$ 的两个旋转平面(Appendix B)——这正是设计 v1 失败的根因,后面消融会验证。
与其他旋转类方法的对比(Table 1)¶
| Method | Rotation Type | KV Materialized | Decode FMAs | Stored Params |
|---|---|---|---|---|
| TurboQuant (Zandieh et al., 2026) | Dense random | Yes | $O(d^2)$ | 16,384 |
| SpinQuant (Liu et al., 2024a) | Learned dense | Yes | $O(d^2)$ | 16,384 |
| QuaRot (Ashkboos et al., 2024) | Hadamard | Yes | $O(d\log d)$ | 0 |
| IsoQuant (ours) | WHT + SO(4) | No | $O(d\log d)$ | 256 |
结论分析:QuaRot 同样是 $O(d\log d)$ 且零存储,但纯 Hadamard 缺少块内细粒度对齐,且仍然物化 KV;TurboQuant / SpinQuant 用稠密旋转换来更强的能量摊开,代价是 $O(d^2)$ 与 16,384 参数。IsoQuant 在"$O(d\log d)$ 代价"和"稠密级对齐质量"之间取了中间点——只用 256 个参数买回了 QuaRot 缺的那部分自由度,同时是唯一一个 KV 不物化的方案。这一列(KV Materialized = No)才是论文真正的差异化,前三列只是使这一列成为可能的条件。
融合 Metal 解码流水线(Table 2)¶
标准 KV cache 解码是:解压 → 物化 FP16 → GEMM → 注意力。本文用四个直接在打包 3-bit 数据上操作的 kernel 替换它:
| Kernel | Operation | Replaces | Domain |
|---|---|---|---|
| A: fused_qk_dot | QK scores on packed K | Dequant + matmul | Compressed |
| B: softmax | Standard softmax | Unchanged | FP16 |
| C: fused_value_accum | Weighted V sum on packed V | Dequant + matmul | Compressed |
| D: rotate_inverse | WHT butterfly + $SO(4)^\top$ | Dense $R^{-1}$ | Structured |
反旋转(Kernel D)只对聚合后的输出施加一次,而不是每 token 一次。由于 $R$ 正交,$R^{-1} = R^\top$,其结构化形式允许用同样的蝶形 + 块转置操作在 $O(d\log d)$ 内完成。
正确性依据(Appendix A):融合流水线把 query 正向旋转 $\tilde{q} = Rq$,对旋转后的 key 算分数 $\tilde{k}_j = Rk_j$,聚合旋转后的 value $\tilde{v}_j = Rv_j$,则聚合输出满足
$$ \tilde{o} = \sum_j \alpha_j \tilde{v}_j = R\sum_j \alpha_j v_j = R\cdot o \tag{9} $$
其中 $\alpha_j = \mathrm{softmax}(\tilde{q}^\top\tilde{k}_j/\sqrt{d_k})_j = \mathrm{softmax}(q^\top k_j/\sqrt{d_k})_j$,由内积保持性成立。所以单次施加 $R^{-1} = R^\top$ 就能精确恢复量化前的输出 $o = R^\top\tilde{o}$。量化噪声部分,设每坐标噪声 $\epsilon_i$ 独立、方差 $\sigma_q^2$:
$$ \mathbb{E}\Bigl[\bigl|\tilde{q}^\top\tilde{k} - \tilde{q}^\top(\tilde{k}+\epsilon)\bigr|^2\Bigr] = \mathbb{E}\bigl[|\tilde{q}^\top\epsilon|^2\bigr] = \sum_{i=1}^{d}\tilde{q}_i^2\sigma_q^2 = \sigma_q^2\|\tilde{q}\|^2 = \sigma_q^2\|q\|^2 \tag{10} $$
跨 $d_k$ 维累计即得 (6) 式的 $d_k\sigma_q^2\|q\|_2^2$。
摊销解码代价¶
每个解码步,标准注意力要读全部 $T$ 条缓存 KV。IsoQuant 的每步总代价是:
$$ \underbrace{O(T\cdot d_k)}_{\text{packed QK + V accum}} \;+\; \underbrace{O(d_k\log d_k)}_{\text{inverse rotation (once)}} \tag{11} $$
对比稠密旋转方法必须把 $R^{-1}$ 作为完整矩阵乘施加,其代价是 $O(T\cdot d_k + d_k^2)$。节省随 $T$ 增长:在 $T = 2{,}048$、$d_k = 128$ 时,反旋转占总解码 FMA 的 < 0.5%。这解释了为什么"把反旋转挪到输出端"在长上下文下几乎是免费的。
Deferred prefill(延迟压缩)¶
prefill 阶段 KV 向量仍以 FP16 存储,以避免量化误差在 prompt 各位置之间复合累积(如果 prefill 期间逐位置压缩,每个新压缩条目都会通过注意力与此前已压缩条目交互,误差层层放大)。批量压缩发生在 prefill→decode 的边界上。瞬态 FP16 buffer 的代价为:
$$ M_{\text{transient}} = 2 \times L \times H_{kv} \times d \times T \times 2\ \text{bytes} \tag{12} $$
代入 $L = 28$ 层、$H_{kv} = 8$ 个 KV head、$d = 128$、$T = 2{,}048$:$M_{\text{transient}} = 2\times28\times8\times128\times2048\times2 \approx 230$ MB。这是一笔要显式记账的临时开销。
Kernel C 瓶颈¶
剖面显示 value 累加(Kernel C)主导解码时间,约 0.79 ms,比 A、B、D 三者之和还多。原因是 value 累加必须读全部 $T$ 条打包条目并做加权求和,而 QK 打分能借因果掩码提前终止。论文的应对是双策略 kernel:$T < 512$ 用 word-parallel dispatch,$T \ge 512$ 用 dimension-parallel dispatch。
实验设置¶
- 模型(四个架构迥异的模型):Gemma 4-26B-A4B(dense MoE,4B 激活)、Qwen3-30B-A3B(sparse MoE,3B 激活)、Qwen3.6-35B-A3B(sparse MoE,3B 激活)、Nemotron-H 120B(Mamba + MoE 混合架构)。
- 分工:KV 保真度实验(Table 3)用 Qwen3-30B-A3B;端到端基准(Table 4)用更新的 Qwen3.6-35B-A3B。
- 硬件:单台 Apple M4 Max,128 GB 统一内存。作者说明 128 GB 只是实验平台,目标部署场景是 16–32 GB 消费设备,靠 Table 4 的峰值内存测量来验证可行性。
- 量化配置:KV 3-bit;权重 4-bit(dense)/ 2-bit(routed expert)/ Q8_0(shared expert);码本用 Lloyd–Max 构造;主评测上下文 2,048 token。
- Quality gate:12 prompt 自动评测(5 个 default suite + 7 个 coding suite),全部贪心解码(temperature = 0、seed = 42、max tokens = 500),判据包括响应长度、期望子串出现、重复率(strict 模式 $\le 0.22$)、代码块围栏配平。
- Soak test:2 小时连续生成稳定性测试。
- 无训练:全部使用预训练 checkpoint,不做任何训练。
主要实验结果¶
KV cache 保真度(Table 3)¶
2,048-token 上下文下相对未压缩 FP16 KV cache 的困惑度退化 $\Delta$PPL,越低越好:
| Model | Default PPL | TurboQuant $\Delta$ | IsoQuant $\Delta$ |
|---|---|---|---|
| Qwen3-30B-A3B | 1.0844 | +0.0405 | +0.0009 |
| Gemma 4-26B-A4B† | 1.3483 | +0.0622 | +0.0000 |
| Nemotron-H 120B | 1.0866 | +0.0039 | +0.0012 |
†Gemma 4 采用 local/global 注意力模式,30 层中只有 5 层是 global attention 并因此启用 KV 压缩器;近零 $\Delta$PPL 反映的是这种部分覆盖。
结论分析:在 Qwen3 上 IsoQuant 的 $\Delta$PPL 比 TurboQuant 低 45×(+0.0009 vs +0.0405)。作者对此的解释是结构化旋转的各向同性质量并不输给稠密随机旋转——WHT 保证了全局能量摊开(每坐标方差 $1/d$),SO(4) 补上了块内对齐,二者合起来在 3-bit 这种极低位宽下比"随机稠密旋转 + 在线 VQ"更贴合 Lloyd–Max 码本的假设分布。Gemma 4 的 +0.0000 需要谨慎解读:论文自己指出这是因为只有 1/6 的层参与压缩,所以是"每层保真度高 × 覆盖面小"的合成结果,不能直接和另外两行横向比较。Nemotron-H 上 TurboQuant 本来就只有 +0.0039,差距缩小到约 3×,因为其 SSM 层根本不走 KV cache。
端到端推理(Table 4)¶
Apple M4 Max(128 GB)上的端到端结果。Quality gate 为 12-prompt 自动评测(含重复检测),Soak 为连续生成稳定性测试,峰值内存用于验证是否落在目标消费级预算内:
| Model | tok/s | Peak Mem | Target Budget | Quality | Soak |
|---|---|---|---|---|---|
| Gemma 4-26B-A4B | 12.85 | 5.4 GB | 16 GB | 12/12 | 2h pass |
| Nemotron-H 120B | 14.85 | 17.2 GB | 32 GB | 12/12 | 2h pass |
| Qwen3.6-35B-A3B | 15.6 | 6.8 GB | 16 GB | 12/12 | ‡ |
‡Qwen3.6-35B-A3B 的 soak test 尚未完成;该模型在初始 soak 测试轮次之后才发布。
结论分析:最有分量的一行是 Nemotron-H 120B——1200 亿参数模型在 17.2 GB 峰值内存下以 14.85 tok/s 交互式运行,落在 32 GB 预算内。三个模型全部通过 12/12 的质量门,说明三轴压缩没有以可观测的生成质量为代价。值得注意的是 tok/s 与模型规模并不单调:120B 的 Nemotron-H(14.85)反而快于 26B 的 Gemma 4(12.85),这与 §4.3 的解码剖面一致——Nemotron-H 的 SSM 层绕过 KV cache,注意力开销天然更小。
消融与分析¶
解码时间归因(Table 5)¶
| Component | Gemma 4 | Qwen3 | Nemotron-H 120B |
|---|---|---|---|
| KV attention | 51% | 54% | 14% |
| Routed experts | 37% | 45% | 60% |
| Other (SSM, etc.) | 12% | 1% | 26% |
结论分析:在标准 MoE 模型上 KV 注意力占解码时间 > 50%,因此 IsoQuant 是高影响的;而在 Nemotron-H 的 Mamba + MoE 混合架构上,KV 注意力降到 14%,因为 SSM 层完全绕过 KV cache。作者据此给出一条可操作的部署判据:当 KV 注意力超过约 20% 的解码时间时,IsoQuant 才最有价值。这类"给出自身方法的适用边界"的分析在系统论文里并不常见,是本文诚实度较高的地方。
专家 offload × KV 压缩交叉消融(Table 6,Gemma 4-26B-A4B)¶
| Expert Offload | KV Mode | tok/s | Peak MB |
|---|---|---|---|
| No | Default (FP16) | 109.8 | 10,649 |
| No | IsoQuant (3-bit) | 20.6 | 10,748 |
| Yes | Default (FP16) | 1.01 | 2,445 |
| Yes | IsoQuant (3-bit) | 1.05 | 2,804 |
结论分析:这是全文最"反宣传"的一张表,也是最有价值的一张。当模型本来就装得下时(No offload),IsoQuant 相对未压缩 KV 带来 5.3× 的吞吐损失(109.8 → 20.6 tok/s),原因是打包数据算术本身的开销;而峰值内存几乎没降(10,649 → 10,748 MB,甚至略升)——因为此时瓶颈在权重不在 KV。专家 offloading 则无论 KV 模式如何都带来约 100× 的惩罚(109.8 → 1.01),完全由磁盘 I/O 延迟主导,代价是把峰值内存从 10.6 GB 压到 2.4 GB。作者的结论毫不含糊:三轴系统不是通用加速器,而是内存压力缓解机制,它用吞吐换取"能不能跑起来"这个 0/1 属性。
跑间方差(Table 7,Gemma 4-26B-A4B + 专家 offloading,3 次独立试验含完整模型重载)¶
| KV Mode | Mean tok/s | Std Dev | CV (%) |
|---|---|---|---|
| Default (FP16) | 1.01 | 0.055 | 5.4 |
| IsoQuant (3-bit) | 1.05 | 0.003 | 0.3 |
结论分析:IsoQuant 的变异系数(0.3%)比默认路径(5.4%)低 18×。作者推测打包数据算术路径对内存子系统的波动更不敏感——它的访存量小且规整,不像 FP16 注意力那样在统一内存带宽争用下抖动。另一面是诚实的负面记录:在 offload 区间 IsoQuant 多吃约 359 MB 峰值内存(2,445 → 2,804 MB)且没有吞吐优势(1.01 → 1.05,在方差范围边缘)。
旋转设计消融(Table 8,5-prompt 质量门)¶
| Design | Rotation | Quality Gate | Failure Mode |
|---|---|---|---|
| v1: Single quaternion | $v \mapsto q v \bar{q}$ (SO(3)) | 0/5 | 25% dims unmixed |
| v2: Block SO(4) only | Block $R_{SO(4)}$ | 1/5 | No global correlations |
| v3: WHT + SO(4) | $R_{SO(4)} \circ H_d$ | 5/5 | — |
结论分析:这张表逐项验证了 §3.3 的理论论断。v1 用单四元数共轭,只张成 $SO(3) \subset SO(4)$,每个 4 维块里留下一个不变方向,导致 25% 的坐标完全没有被混合——直接 0/5 全灭。v2 加上了配对四元数的完整 SO(4) 表示,但缺 WHT 预混合,因此捕捉不到块间相关性,只过 1/5。只有 v3 同时具备全局混合(WHT)与块内细粒度对齐(SO(4))才 5/5 通过。这条消融链很干净地说明两个组件不可互相替代:SO(4) 补的是块内自由度,WHT 补的是跨块能量摊开。
跨框架可移植性:llama.cpp(Table 9)¶
作者把 IsoQuant 作为新的 KV 类型 GGML_TYPE_ISOQUANT3_0 集成进 llama.cpp,以验证其可移植性不局限于 MLX / Metal 生态:
| Configuration | Prompt (t/s) | Generation (t/s) |
|---|---|---|
| TurboQuant 3-bit (baseline) | 4,114.6 | 100.15 |
| IsoQuant 3-bit (fused) | 4,093.8 (−0.5%) | 96.98 (−3.2%) |
| IsoQuant 3-bit (unfused) | 2,306.2 (−44%) | 81.92 (−18%) |
结论分析:融合路径几乎与 TurboQuant baseline 持平(生成 −3.2%、prompt −0.5%),但消除了张量物化;而未融合路径的崩塌(生成 −18%、prompt −44%)证明 kernel 融合是必需的而非锦上添花——融合版本相比未融合少了 280 次额外的 dispatch launch。这条对照把"compute-in-compressed-space"从一个理念坐实为一个必须由 kernel 层兑现的工程契约:只做量化不做融合,反而比不压缩更慢。
运行时插桩(Table 10,Gemma 4-26B-A4B + 专家 offloading,3,612 个解码步)¶
| Counter | Value |
|---|---|
| fused_metal_success_rate | 1.000 |
| decompress_calls | 0 |
| read_keys_calls | 0 |
| packed_cache_hit_rate | 0.000 |
| fallback_invocations | 0 |
| total_decode_steps | 3,612 |
结论分析:零解压调用、零 read-keys 调用、零 fallback 证实融合流水线全程在压缩空间内运行,从不回落到物化张量——这是对"不物化"这一核心声明的直接可证伪检验,比任何吞吐数字都更有说服力。packed_cache_hit_rate = 0.0 是设计使然:打包缓冲在每次写入后即失效,并从量化表示重建。
长上下文验证(Appendix F)¶
- 32K 困惑度:Qwen3.6-35B-A3B 上(nvfp4 权重量化 + IsoQuant 3-bit KV),WikiText-103 在 32,768 token 下 PPL = 5.624,对比默认 KV baseline 的 5.625,偏离 0.024%(通过阈值 5%)。
- NIAH 检索:多 key 检索测试,在 50% 深度嵌入 4 个随机数字 needle,上下文长度 4K/8K/16K/32K。3-bit 压缩下检索准确率全部 100%,与未压缩 baseline 持平。这说明结构化旋转即使在长上下文下也保住了细粒度的位置信息。
反旋转的必要性¶
作者验证:跳过反旋转会让困惑度从 7.05 爆炸到 15,369。这坐实了解码输出必须从旋转域映射回原域——(9) 式中的 $R^{-1}$ 不是可选优化。
负面结果:AttnRes 跨层专家预取¶
作者实现了一个 attention-residual(AttnRes)预测器用于跨层专家预取。对第 $l$ 层,块注意力残差聚合此前所有层的贡献:
$$ h_l = \sum_{n=1}^{l-1} \alpha_{n\to l}\cdot B_n \tag{13} $$
其中 $B_n$ 是第 $n$ 层的注意力输出,$\alpha_{n\to l} = \mathrm{softmax}(\mathrm{sim}(h_{l-1}, B_n))$ 按深度维上的相似度加权。$h_l$ 在第 $l$ 层 MoE router 触发之前算出,因而是"哪些专家将被需要"的因果预测器;原则上可驱动预取、驱逐与精度分配三件事。
实际结果:吞吐回归 −10.6% 至 −11.2%,相对朴素 LRU 基线的命中率提升为 0%。作者的归因值得记下:失败模式不是算法性的而是架构性的——在 Apple Silicon 的统一内存上,CPU 与 GPU 共享带宽,预测器的 CPU 侧访存与 GPU 的 kernel dispatch 争用 command buffer。任务感知的专家 pinning 同样无收益。作者明确表示报告这些是为了让其他研究者少走死胡同。
核心贡献总结¶
- 执行模型层面的位移:把 KV cache 压缩从 reconstruct-then-compute 改成 compute-in-compressed-space,反旋转从"每 token 解压"挪到"聚合输出后一次",由 (9) 式的正交性保证等价性。
- IsoQuant 结构化旋转:WHT(全局混合,$O(d\log d)$、896 FMA)+ 分块 SO(4)(块内对齐,512 FMA、192 DOF),合计 1,408 FMA / 256 存储参数,相对稠密旋转 11.6× 计算缩减与 64× 存储缩减,$\Delta$PPL 反而比 TurboQuant 低 45×。
- 按架构角色分配位宽:用激活峰度(shared expert $\kappa=10.10$ vs specialist $0.41$)这一可测量统计量决定 4/2/8-bit 的分配,而非全模型统一位宽。
- 可证伪的工程验证:3,612 步零解压调用的插桩、融合 vs 未融合的对照、以及"KV 注意力 > 20% 才值得用"的部署判据。
- 诚实的负面结果:无内存压力时 5.3× 吞吐损失、offload 的 100× 惩罚、AttnRes 预取的架构性失败——都被明确写入正文而非藏在附录。
与已归档相关工作的对比¶
BlockQuant BlockQuant: Block-Sphere Vector Quantization(Seoul National University, 2026-05-19)¶
关系:独立并发(本文未引用 BlockQuant,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在攻同一个 root cause——rotation-based 量化器在 3-bit 附近的失真-代价权衡,都把 TurboQuant 当作要超越的直接对象,都以 LLM KV cache 作为落地负载。两者都不改动模型权重、不重训,只在 KV 表示层动刀。
- 相近的技术骨架:两者的方法流程图可以抽象重合为同一个模板——"单位球归一化(范数单独存标量)→ 正交旋转 $R$ → 在旋转后的解析分布上离线构造一次码本、全部向量共用 → 编码 → 解码时反旋转 + 重缩放"。两篇都用 Lloyd–Max / K-means 在推导出的边缘分布(而不是数据聚类)上求码本,都强调码本是离线一次性构建。
- 本文的差异与推进:同一模板有两个正交的设计变量——旋转怎么选 和 码本怎么选——两篇论文各拧了一个。BlockQuant 保持 Haar 稠密旋转不动,把码本从 coordinate-wise 标量推广到 $p$ 维 block-on-sphere($2^{bp}$ 个 centroid,按"半径服从 $\mathrm{Beta}(p/2,(d-p)/2)$、方向均匀"的精确块边缘分布优化),走"码本更贴合球面几何"这条轴,把 MSE 上界的领先常数从 EDEN 的 2.721 压到 $p=2$ 的 2.015、$p=3$ 的 1.770,$p=d$ 时匹配 Shannon 下界。RotaryQuant 反过来保持 coordinate-wise Lloyd–Max 标量码本,把旋转从 $O(d^2)$ 稠密改成 WHT + 分块 SO(4) 的 $O(d\log d)$ 结构化旋转(1,408 FMA / 256 参数 vs 16,384 / 16,384),走"旋转更便宜、且能被写进 kernel"这条轴。
- 可比的方法/实验差异:指标口径不同——BlockQuant 报 Llama-3.1-8B 在 3.5-bit 下 LongBench-E 平均 44.03 vs full cache 44.15(下游任务分),RotaryQuant 报 3-bit 下 $\Delta$PPL $\le$ +0.0012 与 32K NIAH 100%(困惑度 + 检索),两者无法直接换算。更本质的差异在可执行性:BlockQuant 的编码需要在 $2^{bp}$ 个 centroid 中做最近邻搜索(其精读中作者自己承认要用近似最近邻),这使得"直接在打包数据上算注意力"很难做;IsoQuant 的逐坐标标量量化天生可位打包,才使 Table 2 的四 kernel 融合流水线成为可能——这正是 RotaryQuant 拿到"零物化"的前提,也是 BlockQuant 路线较难吃到的收益。反过来,BlockQuant 有严格的 MSE / 内积失真上界并与修正后的 Shannon 下界匹配,RotaryQuant 只给了 (6) 这样一个较松的期望误差界,理论深度明显不及。一个自然的后续问题是:把 BlockQuant 的块球面码本装到 IsoQuant 的结构化旋转上,能否在保持融合 kernel 可行性的前提下再降一档失真。
MobileMoE MobileMoE: Scaling On-Device Mixture of Experts(Meta AI, 2026-05-26)¶
关系:独立并发(本文未引用 MobileMoE,两者殊途同归)· 已加载对方精读
- 共同关注的问题:同一个 root cause——MoE 的总参数 footprint 与激活算力共同超出消费级/端侧设备的联合预算。两篇都明确把"内存预算"而非"精度上限"当成第一约束,都把专家层认定为主要压力源,都在真实消费级硅片(M4 Max / Galaxy S25 + iPhone 16 Pro)上而非数据中心 GPU 上做终评。
- 相近的技术骨架:抽象后两者的部署配方高度重合——"低比特权重量化(MobileMoE 的 INT4 QAT vs RotaryQuant 的 4/2/8-bit 混合 PTQ,且都对 shared expert 做特殊处理)→ 自定义 fused kernel(MobileMoE 在 ExecuTorch 上的 fused MoE kernel vs RotaryQuant 在 Metal 上的四 kernel 注意力流水线)→ 在消费设备上量 tok/s、峰值内存、精度不退化"。两篇都发现通用推理栈的 kernel 是端侧 MoE 的实际瓶颈,都靠手写融合算子把理论收益兑现。
- 本文的差异与推进:分歧在于两条对立路线。MobileMoE 是 train-small:从一条联合内存 + 算力约束的端侧 MoE 扩展律出发,直接训练激活 0.3–0.9B、总参 1.3–5.3B 的模型族(适中稀疏度 + 细粒度专家 + 共享专家),INT4 footprint < 3 GB,专家全部常驻。RotaryQuant 是 compress-big:完全不训练,只对现成的 26B–120B checkpoint 做后处理,并额外引入 MobileMoE 不需要的第三轴——LRU 专家换页到磁盘。两者的取舍点很清楚:MobileMoE 的模型天生装得下但能力上限受限于 sub-billion 激活;RotaryQuant 能跑 120B 级能力,但一旦真的触发 offload 就要付约 100× 的吞吐代价(Table 6)。
- 可比的方法/实验差异:MobileMoE 在同等 INT4 权重内存下相对稠密 baseline MobileLLM-Pro 取得 1.8–3.8× prefill / 2.2–3.4× decode 加速,评测口径是 14 个 benchmark 的平均精度;RotaryQuant 的口径是 $\Delta$PPL + 12-prompt 质量门 + 峰值内存,在 M4 Max 上 9–19 tok/s。两篇都没有工业线上验证,也都止步于单一硬件生态(ExecuTorch/手机 vs MLX/Apple Silicon)。值得注意的是 MobileMoE 用 QAT(量化感知训练)拿到 INT4 的近无损,而 RotaryQuant 因为不能重训只能用 PTQ + 旋转来补偿——IsoQuant 的结构化旋转某种意义上就是"没有 QAT 预算时的替代品"。
讨论与局限性¶
核心贡献与值得借鉴的设计。 本文最值得借鉴的不是某个具体算子,而是把"压缩格式"和"执行模型"绑定设计的思路:绝大多数量化论文只回答"用多少 bit 存",本文追问"存成这样之后还能不能直接算"。由此推出的两个连锁设计——反旋转从 per-token 挪到 per-output(靠 (5)(9) 的正交性),以及用结构化旋转换取 kernel 内可展开的蝶形运算——都是"为了让 kernel 写得出来"倒推回算法层的决策。Table 9 的融合 vs 未融合对照(−3.2% vs −18%)则说明这个绑定不是可选项。另一个可迁移的小设计是用激活峰度决定位宽:把"哪些张量不能压"从经验判断变成可测量指标。
明确的局限。
- MLA/RoPE 硬阻塞:使用 Multi-Head Latent Attention 的模型(如 DeepSeek-V2)把 KV 拆成 content 与 positional(RoPE)子空间,RoPE 维度以旋转编码位置相位,不能再被旋转或量化——否则会把位置编码涂抹进内容坐标。IsoQuant 目前没有实现所需的子块切分,这类架构完全无法使用。考虑到 MLA 已是主流大模型的默认选择,这是本文最实质的适用面缺口。
- 上下文长度验证不足:主困惑度测量只在 2K token 上完成。虽然 Appendix F 给出了 32K 的初步结果($\Delta$PPL +0.001、NIAH 100%),但那只覆盖 Qwen3.6-35B-A3B 一个模型,跨全部模型的 > 2K 困惑度扫描"仍在进行中"。
- 无内存压力时是负收益:Table 6 的 5.3× 吞吐损失是硬伤,作者也据此把建议限定为"只在不用就装不下时才用"。
- 服务层不可扩展:基于 MLX 的推理服务器(Python
ThreadingHTTPServer)在并发下严重退化——8 个并发客户端时 4/8 的响应返回空 body 却带 HTTP 200,吞吐在 4 客户端就见顶、并行效率仅 34%。作者承认生产化需要专门的推理服务器。这条其实说明"消费级本地推理"目前只验证了单用户交互场景。 - 平台单一:全部结果在 Apple Silicon(MLX / Metal)上取得,只有 llama.cpp 集成一条跨框架验证;作者把 Mojo kernel 原型列为未来工作。
- 评测口径偏弱:质量验证依赖 12-prompt 的自动 quality gate(长度、子串、重复率、代码块配平)而非标准 benchmark 套件(MMLU/GSM8K 之类),"12/12 通过"的信息量有限,不能排除更细粒度的能力退化。
与已有工作的差异。 相对 KIVI / KVQuant / QJL / TurboQuant 这条 KV 量化线,差异不在压缩率而在执行模型(唯一不物化);相对 QuaRot / SpinQuant 这条旋转线,差异在于用 256 个参数在"零参数 Hadamard"和"16,384 参数稠密旋转"之间找到了中间点;相对 FlashAttention,作者自陈其融合 kernel 可视为"压缩域的类比物",用精确 GEMM 换取直接的打包数据算术;相对 FlexGen 的 offloading,本文把它特化为 MoE 专家粒度的 LRU 换页并与 KV 压缩正交组合。
工业落地价值。 本文没有线上 A/B 或生产部署数据,工业价值主要体现在可复现的工程细节上:Metal 四 kernel 的职责划分(Table 2)、deferred prefill 的 230 MB 瞬态账((12) 式)、Kernel C 的双 dispatch 策略($T<512$ word-parallel / $T\ge512$ dimension-parallel)、llama.cpp 的 GGML_TYPE_ISOQUANT3_0 集成路径、以及 3,612 步的运行时插桩计数器。对想在端侧做长上下文推理的团队,这些比论文的 $\Delta$PPL 数字更有直接复用价值。反过来,Table 6 那条"无压力时别用"的结论也应当被同样认真地采纳——它把这套系统的定位从"加速器"精确地校准成了"可行性开关"。