KITE: KV-Invariant Transformer Expansion for Efficient Agentic LLM Scaling¶
作者:Zhiheng Hu, Yixun Wei, Jian Zhou, Yizhuang Zhou, Ji Li, Xing Chen, Yang Li, Bojun Wang, Yibo Zhu, Xiangyu Zhang, Daxin Jiang 机构:StepFun arXiv:2609.27294(2026-09-23,cs.LG,13 页)
一句话概括¶
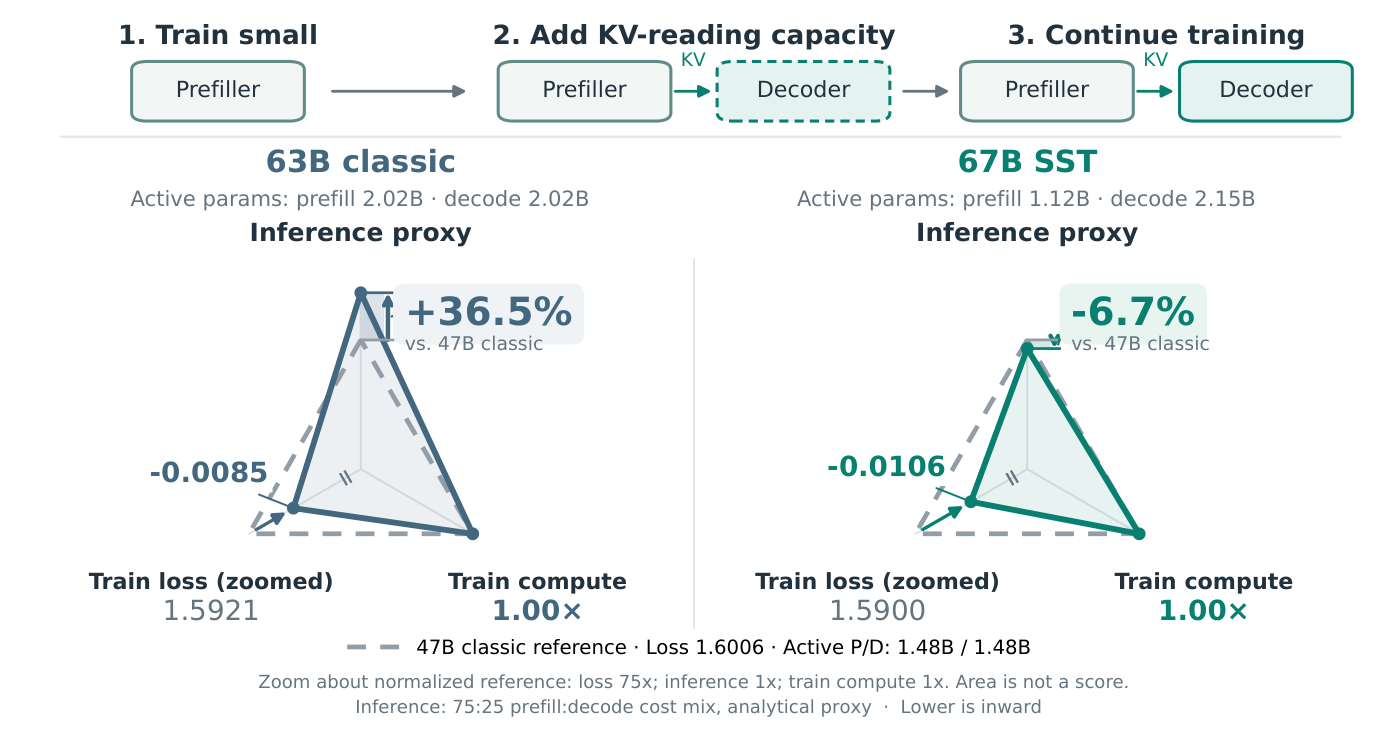
KITE 提出一种「扩参范式」:先训一个小模型,训练中途把它扩成两塔结构——原模型保留为只负责产出 KV 的 Prefiller,再复制出一座只读 Prefiller KV、自己不产 KV 的 Decoder,两塔继续联合训练。这样新增的参数既享受「中途生长」的训练折扣,又不进入 prompt 预填充(bulk prefill)路径。其具体实例 SST(Step Scale Transformer) 把 33.8B MoE 扩成 67B MoE,在与 47B / 63B 从头训练 MoE Transformer 理论训练 FLOPs 相同时,训练 loss 更低(1.5900 vs 1.6006 / 1.5921)。在 75:25 的 prefill:decode 权重下,基于激活参数量的解析推理代价代理比 47B 低 6.7%、比 63B 低 31.6%。作者明确声明这些都不是实测的 serving 加速。
1. 研究动机与背景¶
1.1 训练成本与推理成本要「同时」下降¶
LLM 的 scaling 性质既是福音也是诅咒:更大的模型更强,但训练和推理的计算量都随之上涨。作者把「以更低的算力代价 scale 模型」作为核心问题,并指出 MoE 之所以成功,一个容易被忽视的原因是它同时降低了训练和推理的计算量:在固定参数量下省算力,或者说在固定算力下长容量。
作者指出,只在一侧省算力的方案往往被另一侧抵消:
- 渐进式 upcycling / 模型生长(Net2Net、SPARKLING 等):先训小模型,训练中途长成目标模型,大量 token 在更便宜的计算图上跑完,省了训练。但业界普遍认为 upcycled 模型打不过同尺寸从头训练的模型,于是训练省下的算力在推理时被还回去:serve 的是完整的目标模型,拿到的却不是完整目标模型的质量。
- KV 复用(YOCO 家族、DeepSeek-V4.1-Flash、WeChat 的 KV-Mirror 等):深层复用浅层算出的 K/V,模型变大时 prefill 仍然便宜,省了推理。但删掉产 KV 的层会损失质量,要补回来就得更大的模型或更长的训练,等价于训练成本损失。
因此作者主张把两种成本联合起来看,追求一个让「模型质量、训练成本、推理成本」三者都朝有利方向移动的 scaling 范式。
1.2 Agentic 负载是 prefill 主导的¶
KITE 押注的负载特征是:agentic 场景中模型被反复调用,每次都要处理累积的上下文和新的工具输出(引用 SWE-agent、ReAct)。即使有 prompt caching,仍然有大量未命中缓存的输入。作者用 OpenRouter 公开流量佐证(Table 1):六个模型中未缓存输入的 token 量都超过输出,在「未缓存输入 + 输出」计费中也占多数。
Table 1:OpenRouter 选定流量的输入需求(2026-08-22 至 09-20 UTC,按 09-21 基准价估算;Input 含缓存 token,Output 含推理 token;Charge share = 未缓存输入计费 /(未缓存输入 + 输出计费),不含 cache-read 计费)
| 模型 | Input/output tokens | Uncached input/output tokens | Uncached-input charge share |
|---|---|---|---|
| GPT-6 Astra | 106.43× | 14.64× | 74.6% |
| GPT-6 Astra Pro | 63.15× | 14.01× | 73.8% |
| Claude Fable 5 | 63.38× | 16.29× | 76.7% |
| Claude Sonnet 5 | 59.88× | 12.12× | 70.8% |
| Gemini 3.7 Flash | 37.79× | 10.15× | 67.4% |
| Gemini 3.8 Flash | 46.14× | 10.51× | 67.9% |
解读:未缓存输入 token 是输出的 10–16 倍。由于输出单价约为输入的 5 倍,折成计费份额后未缓存输入占 67–77%。这是 KITE 整个推理收益论证的「权重」来源,后面的 75:25 prefill:decode 代价比就取自这里。需要注意,这是价格份额,不是 GPU 计算份额;作者在附录 A 里也写明「这些统计只是说明输入重的推理形态,并不测量 GPU 成本」,而且这批流量没有被单独标记为 agentic 用量。
1.3 KITE 的核心思路¶
在 scale 时把模型划成两个区域:决定 KV 张量的区域和不影响 KV 的区域,只在后者里扩容量。作者给出两层理由:
- 新增容量是训练中途才出现的,而不是从第 0 个 token 开始,所以它买到的质量在训练成本上是划算的(生长的训练折扣);
- 扩容不影响 KV 的计算,所以推理时的 prefill 代价保持不变(KV 复用的推理折扣)。
作者把省下的算力用来适度扩大模型,就像 MoE 那样,并声称 KITE 与 MoE、hybrid attention 正交、互不干扰。作者也坦承:SST 很可能不是最优的 KITE 设计,只是足以展示这一范式的正面效果。
2. 核心方法:KITE 设计原则与 SST 架构¶
2.1 设计原则:Prefiller / Decoder 分解¶
设因果模型由 Prefiller $P$ 和 Decoder $D$ 组成:
$$(M_t, z_t) = P(x_{1:t}; \theta_P), \qquad \ell_t = D(x_t, z_t, M_t; \theta_D) \tag{1}$$
其中 $M_t$ 是可复用的注意力记忆(即 KV),$z_t$ 是位置 $t$ 上可选的 Prefiller 特征,$\ell_t$ 是下一个 token 的 logits。先完成一个小模型训练阶段,然后在中间 checkpoint 上新增或扩大 $D$,同时保留 Prefiller 的计算图和记忆接口,两部分继续训练。
不变量是结构性的:权重和 KV 值都不冻结。约束只有两条:
- Decoder 不得产生未来位置需要的记忆,也就是 Decoder 不产 KV;
- 为了在生成时省掉历史 Decoder 计算,给定 Prefiller 输出后,Decoder 保留的位置必须与被省略的 Decoder 位置相互独立。
有了这两条,预测容量可以增长,而 bulk prefill($P$ 执行的全 prompt KV 构建)不增加。仍然必须计算的是:首个输出 token 在 prompt 边界位置的 readout,以及 decode 阶段 Decoder 的全部工作。
2.2 Step Scale Transformer(SST)¶
SST 用两座 Transformer 塔实例化上述原则:Prefiller(上标 $P$)与 Decoder(上标 $D$),实验中各 18 层。Prefiller 先执行并产出逐层 KV;Decoder 每个 block 计算自己的 query,并从对应层的 Prefiller KV 读取:
$$q^D_{l,t} = Q^D_l\big(h^D_{l-1,t}\big), \qquad a^D_{l,t} = \mathrm{Attn}\Big(q^D_{l,t},\ K^P_l[I_l(t)],\ V^P_l[I_l(t)]\Big) \tag{2}$$
- $Q^D_l$ 包含 query 投影和归一化(Decoder 有自己的 Q 投影和 Q norm,没有 K/V 投影);
- $I_l(t)$ 是原因果 full / sliding 注意力掩码允许的位置集合,即 Decoder 第 $l$ 层沿用 Prefiller 第 $l$ 层的注意力模式(full 或 sliding window);
- 两塔保留源模型的 position ID;
- Decoder 有独立的 block 参数,残差和 FFN/MoE 运算都是 token-local 的。
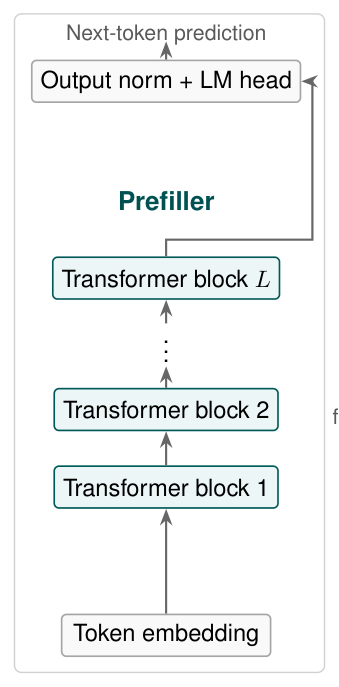
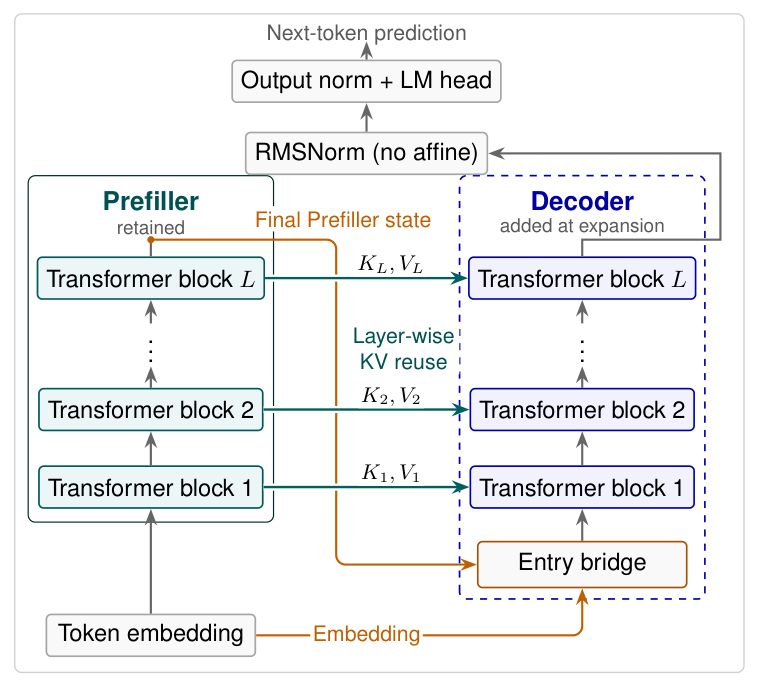
为什么 Decoder 的历史位置可以省略:Decoder 在位置 $t$ 的计算只依赖 (a) 同位置的 token-local 运算和 (b) Prefiller 在 $\le t$ 位置产出的 KV。Decoder 自己的历史 hidden state 不会被未来位置读到,所以「给定 Prefiller 输出,每个 Decoder 位置都独立于更早的 Decoder 状态」。梯度则通过两条路径流回 Prefiller:entry bridge 和被复用的 KV。
2.3 训练与推理的执行方式¶
- 训练:扩展后两塔联合训练。Prefiller 处理全序列,Decoder 计算每一个被监督的位置,梯度穿过复用的 KV 流入 Prefiller。注意:训练时 Decoder 要跑满全序列,所以训练阶段的每 token 前向 FLOPs 并不省,SST 甚至比 63B 还高(见 §3.3)。
- Prefill:Prefiller 处理完整 prompt $x_{1:n}$,产出逐层 KV cache。Decoder 只需计算最后一个 prompt 位置 $n$(attend 到 Prefiller 的 KV),用于预测第一个输出 token。更早的 Decoder 位置都可以省略,因为 Decoder 的其他运算都是 token-local 的。
- Decode:每个新 token 要穿过两座塔:Prefiller 扩展 KV cache,Decoder 读取这些 KV 并给出下一个 token 的预测。
由此可见 KITE 的推理账是不对称的:bulk prefill 只付源模型尺寸的钱,decode 要付两座塔的钱。
2.4 Decoder 的输入与输出¶
记共享 embedding/stem 为 $e_t$,Prefiller 最终状态为 $h^P_{L,t}$。SST 的 entry bridge 为
$$h^D_{0,t} = \mathrm{RMS}_\epsilon(e_t) + \mathrm{RMS}_\epsilon\big(h^P_{L,t}\big), \qquad \mathrm{RMS}_\epsilon(v) = \frac{v}{\sqrt{\mathrm{mean}(v^2) + \epsilon}} \tag{3}$$
Decoder 的最终状态产出 logits:
$$\ell_t = W_{\text{out}}\, \mathrm{Norm}_{\text{out}}\big(h^D_{L,t}\big) \tag{4}$$
- entry bridge 中的 RMS 运算没有可训练参数,$\epsilon = 10^{-5}$,在 FP32 中累加并返回输入 dtype;
- $\mathrm{Norm}_{\text{out}}$ 是完整的输出归一化:先对 Decoder 最终状态做一次无仿射的 RMS,再接源模型原有的可学习 output norm(附录 D);
- 两塔共享一套 embedding、output norm 和 output head;embedding 与 head 权重不绑定(untied)。
设计动机:式 (3) 把「原始 token 身份」和「Prefiller 已经算好的上下文表示」各自归一化后相加,保证两路信号在进入 Decoder 时量级相当,避免任何一路主导。式 (4) 让预测完全由 Decoder 给出,Prefiller 的最终状态只通过 entry bridge 间接参与预测,其 LM-head 通路在扩展后被弃用。
3. 关键技术细节:模型构建与训练¶
3.1 从源模型到扩展模型¶
SST 把一个 33.819B 参数的源模型扩成 66.959B,源塔保留为 Prefiller(Table 2)。训练路线包含 167.98B 源阶段 token 和 222.55B 续训 token(Figure 3),两个阶段都计入训练预算。
两个对比基线 47B classic 和 63B classic 是同一模型家族 scaling ladder 中 33.8B 源模型之上的下两档,通过加深加宽得到,保留相同的 MoE 设计和注意力模式。47B 作为中间尺度参考,63B 作为与 SST 67B 总参数量接近的参考。
Table 2:模型配置
| Setting | Source | SST | 47B classic | 63B classic |
|---|---|---|---|---|
| Layers | 18 | 18 + 18 | 20 | 22 |
| Hidden width | 2304 | 2304 | 2560 | 2816 |
| MoE layers | 16 | 16 + 16 | 18 | 20 |
| Routed / selected experts | 512 / 8 | 512 / 8 | 512 / 8 | 512 / 8 |
| Attention pattern | SSSF | SSSF | SSSF | SSSF |
| Total parameters (B) | 33.819 | 66.959 | 46.727 | 62.691 |
| Decode active body parameters (B/token) | 1.120 | 2.155 | 1.477 | 2.016 |
注:每座塔都以两层稠密 FFN 开头。SSSF 表示「三层 sliding + 一层 full attention」循环,18 / 22 层时余下的两层为 SF。计数描述的是有效架构。
按这个模式推算(笔者推算,非原文):18 层的 full-attention 层位于第 4/8/12/16/18 层,共 5 层;20 层(47B)也是 5 层;22 层(63B)是 6 层。这一点在后文讨论长上下文 KV 流量时很关键。
Figure 3(训练路线,矢量流程图未提取为位图):Training route to the evaluated SST checkpoint: 13,350 source steps followed by 17,687 continuation steps。内容为:源训练 167.98B token → 在 167.98B 处转换 checkpoint(把权重复制进两座塔)→ Prefiller/Decoder 联合训练 222.55B token,至 390.54B 为最终评估模型,共 31,037 次更新(13,350 源步 + 17,687 续训步)。
3.2 扩展与续训¶
- 扩展方式:把源模型的每一层复制进 Prefiller 和 Decoder 的对应层,也就是 Decoder 的初始权重与源模型逐层相同(对齐初始化)。两塔共享 embedding、output norm 和 output head。
- 优化器:BF16 联合训练,沿用源模型的 Muon 与 Adam 参数组。Prefiller 和共享参数保留优化器状态,Decoder 初始化全新的优化器状态。
- 学习率:所有参数组沿用源模型的 cosine 调度,把剩余衰减拉长到覆盖续训阶段,Decoder 不单独 warmup。
值得注意的是,由于 Decoder 初始化为源模型的逐层拷贝,且 entry bridge 把 embedding 与 Prefiller 最终状态相加后再送进一个「本来只见过 embedding」的第 1 层,扩展后的模型不是函数保持的。Figure 4 中转换点处 loss 从约 1.745 跳升到约 1.90 就是这个原因,随后快速回落。论文 Related work 也明确说「对齐初始化改变了预测计算图,随后依靠联合适应」。
3.3 累计训练算力¶
对源阶段与续训阶段的 token 数 $D_s, D_c$ 和每 token 前向 FLOPs $f_s, f_c$:
$$C_{\text{train}} = 3\,(D_s f_s + D_c f_c) \tag{5}$$
其中因子 3 近似前向加反向。两个训练阶段的完整成本都计入。以最终评估的 47B classic checkpoint 定义 $B_{\text{ref}} \approx 5.16836 \times 10^{21}$ FLOPs,SST 与 63B 的最终点都约用了 100% 的预算。
每 token 前向成本(附录 C):47B classic 约 3.887488B FLOPs/token,63B classic 5.148513B,源模型 3.087252B,SST 5.410678B。SST 保留两座塔的注意力和 FFN/MoE 计算,但只有一套 embedding、output head 和 KV 投影。所有前向系数按序列长度 4096、sliding window 512、padded 训练词表 128,896 计算,乘加计为 2 FLOPs,包含注意力投影与矩阵乘、embedding、output head、FFN/MoE、router 和估计器的激活项;不含归一化、RoPE、残差与 bridge 运算、重计算、优化器、loss/aux loss、转换、通信和 checkpoint I/O。
笔者复核:
- 47B:$3 \times 443.16\text{B} \times 3.887488\text{B} \approx 5.168 \times 10^{21}$;
- 63B:$3 \times 334.62\text{B} \times 5.148513\text{B} \approx 5.168 \times 10^{21}$;
- SST:$3 \times (167.98\text{B} \times 3.087252\text{B} + 222.55\text{B} \times 5.410678\text{B}) \approx 3 \times (5.186 + 12.041) \times 10^{20} \approx 5.168 \times 10^{21}$。
三者确实严格等 FLOPs,源阶段占 $3 \times 5.186\times10^{20} / B_{\text{ref}} \approx 0.301$,与 Figure 4 的 0.301 $B_{\text{ref}}$ 一致。这说明训练账算得很仔细。同时也可以看出,SST 续训阶段每 token 前向(5.41B)比 63B(5.15B)还贵 5%,因为训练时 Decoder 要跑满全序列。KITE 在训练侧的全部折扣都来自前 30% 算力跑在便宜的 3.09B/token 源模型上。
3.4 训练配方与续训调度器(附录 D)¶
- 原生 BF16 参数,Muon + Adam 两组;Muon 用 6 步 Newton–Schulz,packed attention 按 head 切分、GLU 按投影类型切分;Adam $\epsilon = 10^{-15}$;
- 源模型峰值 base 学习率约 $1.03302 \times 10^{-3}$;续训 base weight decay 0.15,沿用参数组乘子;
- token batch:源 / SST / 63B 为 12,582,912,47B 为 14,680,064(47B 的 batch 不同);
- SST 续训:128 张 NVIDIA H800,expert parallelism 8,序列长度 4,096,global batch 3,072 条序列;续训 17,687 步,接在源训练 13,350 步之后,共 31,037 步。
记已消耗续训 token 为 $u$,续训总时域 $U = 222{,}553{,}964{,}544$,源模型在转换时的归一化 cosine 相位为 $q_0$,SST 的调度为
$$q(u) = q_0 + (1 - q_0)\,\min(u/U, 1) \tag{6}$$
$$\eta(u) = \eta_{\min} + (\eta_{\text{anchor}} - \eta_{\min})\,\frac{1 + \cos(\pi q(u))}{1 + \cos(\pi q_0)} \tag{7}$$
源调度在前 12.582912B token 内 warmup,衰减到 335.9605248B token 为止;转换发生在 167.9818752B token 处,所以 $q_0$ 是在 warmup 之后的衰减区间内度量的,而不是用转换位置除以总时域。学习率常数为 $\eta_{\text{anchor}} \approx 5.96548 \times 10^{-4}$、$\eta_{\min} \approx 1.03302 \times 10^{-4}$。
含义:式 (6) 把余下的 cosine 相位 $[q_0, 1]$ 线性摊到整个续训时域上;式 (7) 按比例缩放,使 $u=0$ 时 $\eta = \eta_{\text{anchor}}$(即转换瞬间源调度的学习率),$u=U$ 时衰减到 $\eta_{\min}$,保证续训 LR 曲线在转换点连续、在终点完整退火。
(原文附录 A 的计费公式与推理代价代理放在 §5.3 介绍;本文公式按出现顺序重新编号。)
4. 实验设置¶
- 对比对象:只有两个同家族、从头训练的 MoE Transformer:47B classic(20 层、宽 2560)和 63B classic(22 层、宽 2816)。此外只有作为训练曲线参照的 33.8B 源模型。
- 控制变量:tokenizer、数据配方、训练协议和评测集完全一致;比较点为等理论累计训练 FLOPs(约 $1.0\,B_{\text{ref}}$)。
- 质量指标:
- 训练 LM loss 的 EMA-200(span 200,adjust=False,在绘图抽样前计算并保留最后一个观测;SST 在转换后重启 EMA);
- 7 个下游任务:OpenBookQA(validation + test 合并)、MMLU(test)、GSM8K、MATH(full test)、HumanEval(few-shot)、MBPP(3-shot)、BBH;
-
held-out ARXIV token NLL:三个模型用同一组 1,024 条冻结的 packed-4K 样本。
-
推理指标:基于激活 body 参数量的解析代价代理,按不同 prefill:decode 权重扫描;没有任何实测吞吐或延迟。
- 种子/重复:每个配置单次训练,每个模型只评估一个最终 checkpoint,没有方差估计。
Table 5:详细几何(Source/SST 的维度按每座塔计,均以两层稠密 FFN 开头)
| Setting | Source / SST | 47B classic | 63B classic |
|---|---|---|---|
| Dense FFN width | 4608 | 5120 | 5632 |
| Routed / shared expert width | 576 / 576 | 640 / 640 | 704 / 704 |
| Head dimension | 128 | 128 | 128 |
| Full / sliding RoPE dimension | 64 / 128 | 64 / 128 | 64 / 128 |
| Full / sliding Q heads | 24 / 40 | 24 / 40 | 32 / 48 |
| KV heads | 8 | 8 | 8 |
Table 6:架构参数计数(B,保留三位小数)
| Quantity | SST | 47B classic | 63B classic |
|---|---|---|---|
| Total, including embedding/head | 66.959 | 46.727 | 62.691 |
| Embedding + output head | 0.594 | 0.660 | 0.725 |
| Total body | 66.365 | 46.068 | 61.966 |
| Decode active body | 2.155 | 1.477 | 2.016 |
| Prefiller-only active body | 1.120 | – | – |
激活 body 参数不含 embedding/head,计入每个 MoE 层 Top-8 路由专家、共享专家、router 以及一个 token 所需的其余 body 权重。作者强调这是每 token 参数计数,不是实测执行成本。导出词表 128,815 行(不含训练 padding)。在 SST 的有效架构中,只有 Prefiller 含 K/V 投影和 K 归一化。
Table 7:最终 checkpoint 的训练预算
| Model | Training tokens (B) | Relative training FLOPs |
|---|---|---|
| 47B classic | 443.16 | 1.000 |
| 63B classic | 334.62 | ≈1.000 |
| 67B SST | 390.54 | ≈1.000 |
5. 主要实验结果¶
5.1 训练 loss¶
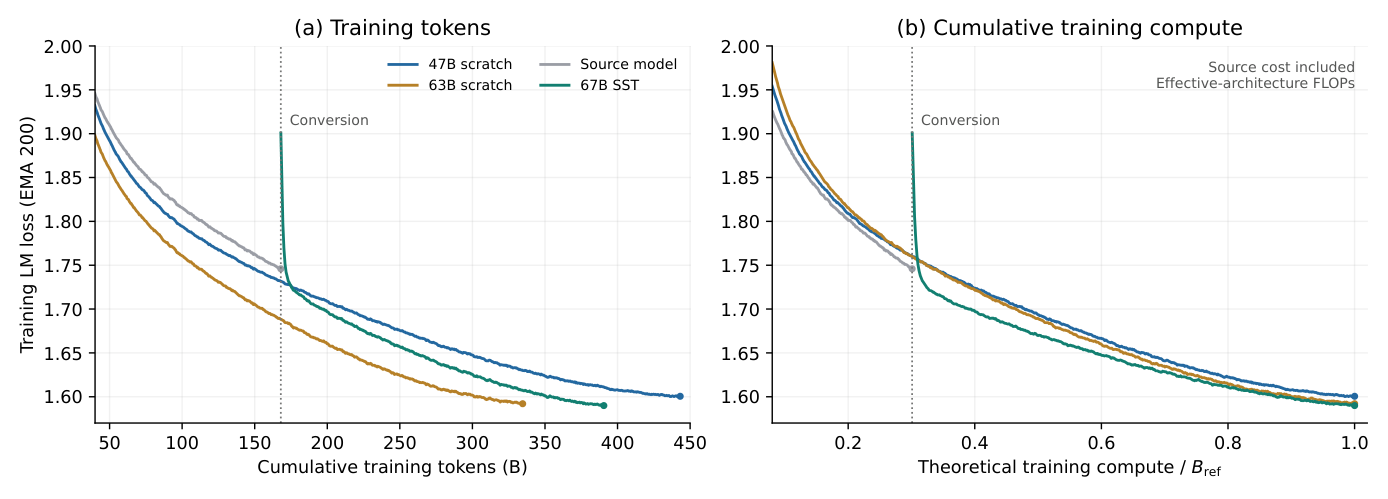
SST 的 loss 在转换点跳升,随后在续训中持续下降。最终 checkpoint 上:
| 模型 | 训练 token | 训练 EMA-200 loss | vs SST |
|---|---|---|---|
| 47B classic | 443.16B | 1.6006 | +0.0106 |
| 63B classic | 334.62B | 1.5921 | +0.0021 |
| 67B SST | 390.54B | 1.5900 | — |
分析:
- Figure 4(b)(按算力对齐)有三个值得注意的细节。第一,转换时(0.301 $B_{\text{ref}}$)源模型的 loss 本来就略低于同算力的 47B / 63B,这符合 Chinchilla 直觉:训练早期小模型每 FLOP 更高效。SST 实际上是从一个「在该算力点上领先」的位置起跳的。第二,转换后 SST 在约 0.35–0.7 $B_{\text{ref}}$ 区间领先较明显。第三,到 1.0 $B_{\text{ref}}$ 时 SST 与 63B 的曲线已经几乎重合,差距收窄到 0.0021。从曲线走势看,差距在收敛而不是拉开;论文没有给出更大预算下的结果,也没有拟合 scaling law,所以无法判断大预算下 SST 是否仍然领先。
- Figure 4(a)(按 token 对齐)上,同 token 数时 SST 介于 47B 和 63B 之间,说明 SST 每 token 的学习效率不如 63B,它的优势来自前 168B token 更便宜。
- 0.0021 的差异来自训练集上的 EMA 训练 loss、单次运行,没有 seed 方差。在 60B 级 MoE 预训练中,这一量级通常处于 run-to-run 噪声和 LR 调度细节(SST 的 cosine 被拉长,63B 在 334.6B 处结束自己的调度)的影响范围内。
5.2 下游任务评测¶
Table 3:七个下游任务得分(%)与 held-out ARXIV token NLL(越低越好),等理论累计训练 FLOPs,SST 含两个训练阶段。
| Task | 47B classic | 63B classic | 67B SST | SST − 63B |
|---|---|---|---|---|
| OpenBookQA | 68.50 | 71.00 | 75.00 | +4.00 |
| MMLU | 58.44 | 59.39 | 60.54 | +1.15 |
| GSM8K | 56.56 | 55.04 | 58.38 | +3.34 |
| MATH | 33.06 | 33.14 | 34.36 | +1.22 |
| HumanEval (few-shot) | 35.98 | 32.93 | 37.80 | +4.87 |
| MBPP (3-shot) | 50.40 | 50.80 | 51.40 | +0.60 |
| BBH | 50.36 | 52.56 | 52.74 | +0.18 |
| ARXIV NLL (↓) | 1.4521 | 1.4424 | 1.4421 | −0.0003 |
分析:
- 作者的结论是「等 FLOPs 训练下 SST 全面最好,最低的训练 loss 确实转化为最好的下游表现」。七项全部领先是一个正面信号。
- 但幅度要分开看:held-out ARXIV NLL 上 SST 与 63B 只差 0.0003,基本打平。这是最干净的泛化指标,它说明 SST 在语言建模质量上与 63B 持平,而不是显著更好。
- 下游差异中较大的几项(OpenBookQA +4.0、HumanEval +4.87、GSM8K +3.34)来自小测试集(OpenBookQA 约 1000 题,HumanEval 164 题,1 题约 0.61 分)。单 checkpoint、单种子的这类差异方差很大;注意 47B 在 HumanEval 和 GSM8K 上反而高于 63B,说明这些基准在该规模下本身就很噪。MBPP +0.6、BBH +0.18 基本属于噪声范围。
- 较稳健的读法是:在等训练 FLOPs 下,SST 与 63B 质量相当或略好,明显好于 47B。
5.3 不同 prefill–decode 配比下的推理代价¶
附录 A 中权重 $w$ 的依据,即 OpenRouter 的未缓存输入计费份额:设 $P$ 为总输入 token,$C$ 为 cache-read token,$U = P - C$ 为未缓存输入,$D$ 为输出(含推理)token;对每个变体 $v$,$a_v$、$o_v$ 为 09-21 的每百万 token 输入/输出基准价,
$$A = 10^{-6}\sum_v U_v a_v, \qquad O = 10^{-6}\sum_v D_v o_v, \qquad s_{\text{uncached}} = \frac{A}{A + O} \tag{8}$$
Standard 与 Batch 分开计费后再求和,cache-read 计费在分子分母中都排除。这些是基准价估算,不是发票;cache-write 溢价、按上下文长度和 provider 定价、历史价格变动与非 token 费用都没有建模。
据此构造推理代价代理:对 prefill 权重 $w$,
$$\text{cost}(w) = w\,p + (1 - w)\,d \tag{9}$$
其中 $p$、$d$ 分别是 bulk-prefill 和 decode 的激活 body 参数量,以 47B classic 为 1 归一化。$w = 0.75$ 即 75:25 的 P:D 代价配比。
Table 4:Table 1 的底层分量(token 单位为 B,计费单位为百万美元)
| Model | U (B) | C (B) | D (B) | A ($M) | O ($M) | |---|---|---|---|---|---| | GPT-6 Astra | 356.199 | 2232.435 | 24.323 | 3.5600 | 1.2135 | | GPT-6 Astra Pro | 45.611 | 159.946 | 3.255 | 0.4554 | 0.1613 | | Claude Fable 5 | 159.115 | 460.103 | 9.770 | 1.5895 | 0.4822 | | Claude Sonnet 5 | 1126.045 | 4434.707 | 92.872 | 2.2514 | 0.9279 | | Gemini 3.7 Flash | 2100.037 | 5722.111 | 207.001 | 1.5666 | 0.7570 | | Gemini 3.8 Flash | 1299.288 | 4405.218 | 123.644 | 0.9714 | 0.4598 |
标准输入/输出价格(每百万 token 美元):Astra、Astra Pro、Fable 5 为 10/50,Sonnet 5 为 2/10,两个 Gemini 为 0.75/3.75;Batch 价格减半。数据覆盖:两个 Astra 变体各 17 个观测日(9/4–9/20),Gemini 3.8 Flash 19 天,其余模型 30 个标准活动日;Claude Fable 5 只有 10 个 Batch 日(8/22–8/31)。
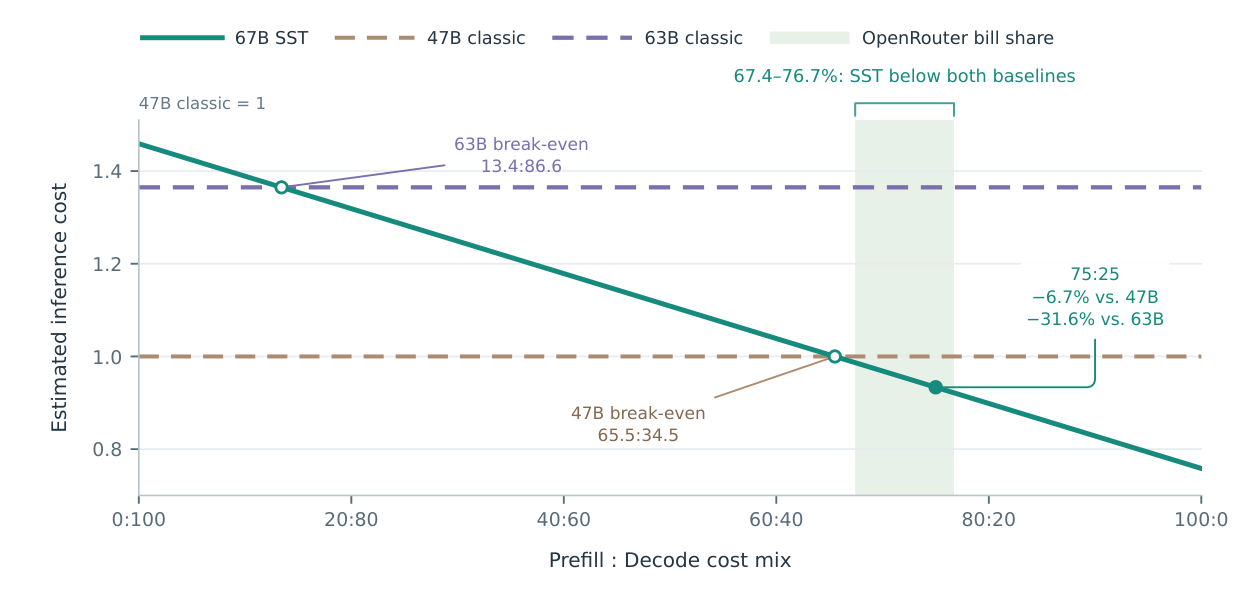
结果:
- 以 47B 为 1:SST 的 $p = 1.120/1.477 = 0.758$,$d = 2.155/1.477 = 1.459$;63B 的 $p = d = 2.016/1.477 = 1.365$。
- 75:25 时 SST $= 0.933$,63B $= 1.365$,即 SST 比 47B 低 6.7%,比 63B 低 31.6%。
- 盈亏平衡点:与 63B 在 13.4:86.6,与 47B 在 65.5:34.5。prefill 份额越高,SST 越便宜。
- 以 OpenRouter 的 67.4–76.7% 为参考 prefill 权重时,SST 在整个区间内都低于两个基线:比 47B 低 1.3–7.9%,比 63B 低 27.7–32.5%。作者原话:「These are analytical cost estimates, not measured serving speedups.」
分析:
- 相对 47B 的优势很薄且依赖假设:SST 的 decode 激活量比 47B 高 46%,只有 prefill 权重超过 65.5% 时才划算。OpenRouter 区间的下沿 67.4% 距盈亏点只有 2 个百分点,对应的优势只有 1.3%。
- 相对 63B 的 31.6% 优势主要来自 prefill 激活参数量少了 44%(1.120 vs 2.016),decode 其实略贵(2.155 vs 2.016,+6.9%)。
- 代理忽略了注意力和 KV 访存(笔者分析):式 (9) 只数权重参数。decode 在实际 serving 中通常是访存瓶颈,长上下文 agentic 负载下 KV 读取往往是大头。SST 的 Decoder 每层都要再读一遍对应 Prefiller 层的 KV,所以 decode 时 full-attention 的 KV 读取次数是 5(Prefiller)+ 5(Decoder)= 10 次/step,而 47B 为 5、63B 为 6。长上下文 decode 下,SST 的 KV 带宽开销约为 47B 的 2 倍。prefill 侧 full-attention 的二次方成本 SST 与 47B 相同(都是 5 个 full 层),省下的主要是 FFN/MoE 与投影部分。
- Prefill 权重本身的依据是价格而非 GPU 成本:75:25 来自 OpenRouter 计费份额,而价格里的输入/输出比(1:5)是 provider 的商业定价,未必等于 prefill 与 decode 的真实算力比。
- 因此,KV-invariance 所声称的 serving 收益在本文中没有任何实测:没有吞吐、没有 TTFT/TPOT、没有 KV cache 显存对比、没有端到端 agent 任务成本。
6. 消融与分析¶
论文没有任何消融实验。以下组件都没有被单独验证:
- entry bridge(式 3)是否必要,或换成只用 embedding / 只用 Prefiller 状态会怎样;
- 对齐层 KV 复用 vs 反向配对 vs 单一 KV 源复用(Figure 6 列出了这些选项,但明确说「未假设它们有相同的成本或质量」,也没有跑);
- Decoder 从源权重复制初始化 vs 随机初始化;
- 转换时点(为什么是 0.301 $B_{\text{ref}}$)和生长倍数;
- 保留/重置优化器状态、LR 调度拉长方式。
作者在结论中坦率写道:这些观察「不建立 scaling law、不建立每个组件的因果收益、也不建立实测的 serving 加速」。
缺失的关键对照¶
对照评审关注点逐项核对:
- 更强的从头训练基线:只有两档同家族 scaling ladder(47B、63B),没有从头训练的 67B SST 两塔结构。因此无法区分 SST 的优势来自「中途生长」还是「两塔 + KV 复用架构」本身。
- 其他生长基线:没有任何生长方法在等算力下对比:没有 Net2Net、SPARKLING、depthwise stacking(直接把 18 层复制成 36 层的普通深模型)、sparse upcycling,也没有 SZP 类的 shrink-perturb。其中最关键的缺失是「把源模型堆叠成 36 层普通 Transformer 再续训」。它与 SST 的训练折扣完全相同,差别只在于新增层是否产出 KV。这个对照才能回答 KV-invariance 的质量代价是多少。SST 只和两个从头训练的模型比,是把「生长带来的训练折扣」和「KV 不变带来的推理折扣」捆在一起报告。
- 其他 KV 复用基线:Introduction 把 YOCO / KV-Mirror / DeepSeek-V4.1-Flash 当作主要的推理侧对手,但没有在等算力下对比任何一个。
- 消融下降 vs 最强基线的 margin:由于没有消融,这一检查无法执行。可以对照的是,相对最强基线(63B)的 margin 只有训练 loss 0.0021、held-out NLL 0.0003,远小于常见的组件消融幅度,也小到很难与单种子噪声区分。
按档案的既定原则:引入新信号 ≠ 收益来源。SST 引入了「KV-invariant 的新增容量」这一结构,但质量收益在实验中无法归因到 KV-invariance。KV-invariance 本身是一个成本约束(对质量是负约束),质量收益更可能来自生长的训练折扣加上等效深度翻倍(decode 时执行 36 层)。论文展示的是「生长 + KV 不变」这个组合在单一配置下与从头训练打平或小胜,没有展示 KV 不变本身带来任何质量收益,也没有量化它的质量代价。
7. 讨论:KITE 的设计空间¶
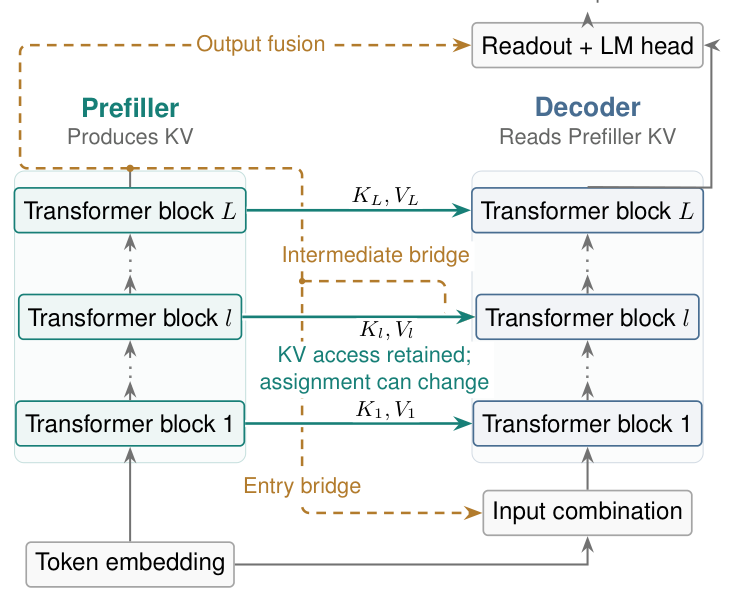
作者强调 SST 只是 KITE 的一种实现,而不是唯一的架构处方。其中对齐的逐层 KV 复用、entry bridge、只用 Decoder 做 readout,都是具体的设计选择。核心要求只有一条:新增容量不能扩展产 KV 的计算,也不能引入需要历史 Decoder 状态的依赖(Figure 6 的边界:未来 KV 的产生不得依赖历史 Decoder 状态)。
可变的自由度包括:
- KV 分配:Prefiller KV 与 Decoder 层之间不必一一对应或保序。可以反序配对(Decoder 第 1 层读 Prefiller 第 L 层),也可以多个 Decoder 层复用同一个 KV 源;
- Hidden-state 连接:Prefiller 表示可以在 Decoder 入口、中间层进入,也可以参与最终 readout(output fusion);
- bridge 算子、两个组件的深度和宽度也都可以变化。
这些选择需要保持因果访问和接口兼容,但计算成本和模型质量未必相同。作者表示实验只探索了设计空间的很小一部分,结果只是确立了所选 SST 配置的性能,而没有找到最优连接模式。
与相关工作的关系(原文 §6)¶
- Net2Net:函数保持的模型生长;SPARKLING(2602.02472):宽度渐进学习中的信号保持与对称性打破。Dense-to-MoE upcycling(Sparse Upcycling、He et al.):用稠密 checkpoint 初始化稀疏专家模型。SST 则是在训练中途给已经稀疏的源模型加 Decoder;其对齐初始化改变了预测图,随后依靠联合适应。
- MQA / GQA 在 query head 间共享 KV head 以减少 KV 存储,Cross-Layer Attention 把共享扩展到相邻层。这些方法减少存储的注意力状态;KITE 的目标则是在不扩展 KV 产出路径的前提下扩容量。
- YOCO:分离产 cache 与消费 cache 的计算,并用于 prefill 早退。SST 把这一执行模式应用到分阶段模型生长上。区别在于 YOCO 的 cross-decoder 共享一份全局 KV 表示,SST 读对齐的逐层 KV,并且通过源到目标的扩展构建。
- Mixture-of-Recursions:递归 KV 共享,后续递归复用第一次递归的 KV。作者认为这种固定 KV 的循环可以看作 KITE 背后家族的参数绑定特例;SST 使用独立的 Prefiller/Decoder 参数,在训练中扩容量而不扩展 KV 产出路径。
核心贡献总结¶
- 提出 KITE 范式:把「生长」(训练侧折扣)和「KV 复用」(推理侧折扣)组合起来,规则是新增容量只放在不产 KV 的区域,从而让 bulk prefill 保持源模型尺寸。
- 给出简洁的实例 SST:两座对齐的 18 层 MoE 塔,Decoder 逐层读 Prefiller KV,通过无参数的 entry bridge(式 3)接入,源权重复制初始化后联合续训。
- 在 67B MoE 规模上做了严格等理论 FLOPs 的对比(笔者复核三者均约为 $5.168 \times 10^{21}$):训练 loss 低于 47B / 63B 从头训练基线,7 个下游任务全部领先,held-out NLL 与 63B 持平。
- 把 agentic 负载的 prefill 主导性量化为推理代价的权重,并给出盈亏平衡分析(与 47B 在 65.5:34.5,与 63B 在 13.4:86.6)。
与已归档相关工作的对比¶
SZP SZP: When Is Warmstarting Effective for Scaling Language Models (University of Freiburg, 2026-05-13)¶
关系:独立并发(本文未引用 SZP,两者都在等 FLOPs 下检验「从小 checkpoint 生长」对从头训练的收益)· 已加载对方精读
- 共同关注的问题:两者都针对同一个结构性问题:从小模型 checkpoint 长成大模型,能否在等训练算力下打败从头训练?KITE 在 Introduction 里把「upcycled 模型一般被认为不如同尺寸从头训练的模型」作为出发点。SZP 则系统研究了这一现象何时成立,并把原因归结为「对函数保持的执念」和「生长倍数上限 $g_{\text{upper}}$ 不明」。
- 相近的技术骨架:两者都是「训练小模型 → 某时刻扩展参数 → 继续训练 → 与 IsoFLOP 从头训练曲线比较」。两者也都放弃了精确函数保持:SZP 用 shrink + zero + perturb,SST 用逐层复制加一个会让 loss 从约 1.745 跳到约 1.90 的 entry bridge。SZP 恰好证明了「函数保持不是有效 warmstart 的必要条件」,为 SST 的非函数保持初始化提供了外部背书。
- 本文的差异与推进:SZP 研究的是同构放大(宽度/深度按原架构放大),不关心推理代价。KITE 的新意在于把新增容量限定在不产 KV 的位置,把生长从「训练技巧」变成「训练 + 推理联合折扣」的架构范式,并在 67B MoE 规模验证,远大于 SZP 的 14M–1.2B。
- 可比的方法 / 实验差异:SZP 的实践准则是 $g=2$、在不超过 20 tokens/param 的预算内 warmstart 才划算,超过交叉点后从头训练会追上。SST 的生长倍数恰好约为 2(33.8B → 67B),源阶段 168B token 相对 33.8B 总参数约 5 tokens/param,处在 SZP 认为 warmstart 有效的区间。但 SZP 的交叉点预测也提示:Figure 4(b) 中 SST 与 63B 的差距在 1.0 $B_{\text{ref}}$ 附近持续收窄,更大预算下 63B 从头训练可能追平甚至反超,而 KITE 没有做更大预算或 scaling law 拟合。SZP 做了完整的 IsoFLOP 和 scaling law,KITE 只有单一预算点。
Untied-Grow Untied-Grow: How Model Growth, Recursion and Boundary Operators Influence Scaling (NYU / Q Labs, 2026-09-16)¶
关系:独立并发(本文未引用,两者的生长骨架几乎同构)· 已加载对方精读
- 共同关注的问题:两者都认为固定深度的模型「从第一步起就在为后期才需要的容量付费」。Untied-Grow 称之为「过早付费」,KITE 称之为「新增容量在中途而非第 0 个 token 出现,所以买到的质量更划算」。两者都主张在训练中途把模型加深,并以等训练算力下的普通 Transformer 为基准。
- 相近的技术骨架:骨架惊人地相似。(1) 生长方式相同:Untied-Grow 把训练好的 core 复制后解绑,属于 depthwise stacking;SST 把 18 层源模型逐层复制成 Decoder,decode 时执行深度从 18 翻倍到 36。(2) 接入算子几乎同形:Untied-Grow 的边界算子是 $\mathrm{BO}(h,e) = \mathrm{Norm}(h) + \alpha e$,即归一化当前状态并重注入 prelude 输出;SST 的 entry bridge 是 $\mathrm{RMS}(e_t) + \mathrm{RMS}(h^P_{L,t})$,即归一化 Prefiller 最终状态并加回归一化的 embedding。两者都靠「归一化 + 重注入输入」让新增的深度段以满权重写入、并以输入为条件。
- 本文的差异与推进:Untied-Grow 的新增 core 是普通的 KV 产出层,推理时 prefill 也要跑完整深度。KITE 的关键推进是让复制出来的那一半只读 KV,从而把深度生长的推理成本从 prefill 中剥离。反过来,Untied-Grow 做了 KITE 缺失的东西:逐架构的算力最优配方、$10^{18}$–$10^{20}$ FLOPs 的 scaling ladder、隔离「生长 / 权重共享 / 边界算子」三轴的对照。Untied-Grow 发现仅边界算子就贡献 1.25× compute multiplier、深度生长贡献到 1.55×。这强烈提示:SST 的质量收益很可能主要来自深度生长 + 类边界算子的 bridge,而不是 KV-invariance,这正是 KITE 缺少「堆叠成 36 层普通 Transformer」对照的代价。
- 可比的方法 / 实验差异:Untied-Grow 是 dense 小模型(最大 7.4B)加 FineWeb 公开数据,单种子,指数差仅 0.003–0.006;KITE 是 67B MoE 私有数据的单点对比。两者都缺多种子。
被剔除的近似候选(未入选):
- Hidden Decoding Hidden Decoding(WeChat AI):同为 100B+ MoE 规模的「非参数维度扩展」,但它把每个 token 展开成 n 条流、各自带独立 KV,方向与 KITE 相反(放大 KV / 序列维度来换质量),问题和解法都不同构。
- KSA KSA(Kuaishou):做 KV cache 的序列级压缩,属于纯推理侧的 KV 瘦身,没有生长 / 训练折扣这条腿。
- Loopie Loopie(IQuest):循环 Transformer 作为算力匹配的 scaling 轴,权重绑定、每次循环都重新产 KV,且不是中途生长。
- Qwen3.8-Flash-Next Qwen3.8-Flash-Next:同样按「loss + 训练/prefill/decode 代价」三轴评估架构改动,但评估的是注意力 / 残差改动,不涉及生长或 KV 不变扩容。
8. 讨论与局限性¶
值得借鉴的设计¶
- 问题框架清晰:「只在一侧省算力的方案会被另一侧抵消」这一观察很有价值,把 upcycling 的质量折损和 KV 复用的质量折损放进了同一张账本。
- KV-invariant 扩容是一个可组合的原则:它与 MoE、GQA、hybrid attention 正交,给「推理时 prefill 主导」的负载提供了一条新的扩参路线。对推荐系统的长序列建模同样有启发:用户长历史的 prefill(或者说 KV 构建)只由一个小塔负责,新增的「预测容量」只在候选/当前位置上计算。这与推荐中「用户序列编码与候选打分解耦」的直觉一致。
- 训练算力核算严谨:两阶段都计入,三者严格等 FLOPs(笔者复核成立),给出了每 token 前向系数和计入/不计入的项目清单。
- 诚实的自我限定:正文与附录多处声明「不是实测 serving 加速」「不建立 scaling law」「不建立各组件的因果收益」「这批流量没有被标记为 agentic」。
局限与争议¶
- 推理收益完全是估算:6.7% / 31.6% 只是激活参数量的加权和,既不含注意力计算,也不含 KV 访存;而长上下文 agentic 负载恰恰是 KV 访存主导的场景。按笔者推算,SST 在 decode 时 full-attention 的 KV 读取量约为 47B 的 2 倍,这可能抵消甚至反转相对 47B 的那 6.7%。
- 相对 47B 的推理优势依赖 prefill 权重 ≥ 65.5%,而这一权重取自价格份额而非 GPU 成本;decode 激活量比 47B 高 46%。在 decode 重的场景(长推理链、低缓存未命中率)SST 反而更贵。
- 只有一个配置、一个预算点、单种子:相对最强基线 63B 的 margin 是训练 loss 0.0021、held-out NLL 0.0003,并且曲线在收敛。没有 scaling law,无法判断更大预算下优势是扩大还是消失(SZP 的交叉点理论提示可能消失)。
- 缺失所有关键对照:没有 36 层堆叠生长基线(隔离 KV-invariance 的质量代价),没有其他生长方法,没有 YOCO/KV-Mirror 等 KV 复用基线,没有从头训练的 SST 结构,也没有任何消融。
- 收益归因不清:按「引入新信号 ≠ 收益来源」原则,KV-invariance 在逻辑上是一个成本约束,质量收益更可能来自生长 + decode 深度翻倍 + 类边界算子的 bridge(Untied-Grow 独立证明了这些都能带来收益)。
- 训练侧的折扣有限:续训阶段 SST 每 token 比 63B 还贵 5%,全部训练折扣来自前 30% 算力的便宜源模型阶段。若源阶段更长,折扣更大但生长后可用的续训预算更少;这种权衡没有被研究。
- 基线设置的细节差异:47B 的 token batch(14.68M)与其他模型(12.58M)不同;SST 的 cosine 调度被拉长到 390B,而 63B 在 334.6B 结束。这些差异都可能影响 0.002 量级的比较。
工业落地价值¶
作者单位为 StepFun,续训使用 128 张 H800,模型规模(67B MoE)属于工业预训练量级。但按「工业署名 ≠ 工业证据」原则:论文没有任何线上部署、serving 实测或产品指标;OpenRouter 数据是第三方公开流量(且与 StepFun 自身模型无关),只用来给代理权重提供依据。因此本文属于「工业团队的架构预训练研究」,而不是工业落地报告。
与已有工作的差异¶
与 YOCO 相比,SST 读对齐的逐层 KV 而非单一全局 KV,并通过生长而非从头构建。与 upcycling/生长相比,新增部分只读 KV。与 MoR 相比,参数不绑定。它的独特之处在于组合,而不是任何单一组件的新颖性。
精读评分¶
6 / 10。KV-invariant 生长是一个清晰、可组合且有实际意义的范式,训练算力核算严谨,67B MoE 规模的等 FLOPs 对比也有说服力。但实验只有单一配置、两个同家族从头训练基线、单种子。相对 63B 的 margin 仅为训练 loss 0.0021 / held-out NLL 0.0003,且曲线在收敛。论文没有生长基线、KV 复用基线和任何消融,因此 KV-invariance 的质量代价与收益来源都无法归因。推理节省仅是忽略注意力与 KV 访存的参数量代理,没有任何实测,相对 47B 的优势还依赖 prefill 权重 ≥ 65.5%。