HF-SID:在量化之前把地理、数值与结构保真度还给 POI 表征¶
Haowen Lin, Jing Li, Zhibin Hao, Fangye Wang, Lihui Su, Song Yang, Xiaojiang Zhou†, Pengjie Wang(AMAP, Alibaba Group 高德地图,另有中国科学技术大学、清华大学在读作者,共同一作,†通讯作者) arXiv:2608.30479v1 · cs.IR · 2026-08-31 已部署于高德首页 POI 推荐链路,一周线上 A/B 平均 PV_CVR +6.74%、UV_CVR +6.03%;随论文释出公开 POI 数据集 AMap-S*。
研究动机与背景¶
生成式检索在 LBS 里的特殊约束¶
生成式检索(Generative Retrieval, GR)把物品召回重述成 seq2seq 任务:模型直接自回归生成物品的结构化标识符 —— Semantic ID(SID)。SID 通常由 RQ-VAE 或层次 K-means 在物品嵌入上量化得到,形成一串由粗到细的码字,相似物品共享前缀,从而支持在十亿级物品空间上做约束 beam search(TIGER、OneRec、OneRec-V2 等工业系统都建立在这条路径上)。
本文的出发点是一句被反复强调的因果陈述:SID 是物品信息到达生成模型的唯一通道,凡是它没能保住的东西,在解码时永远不可恢复("whatever it fails to preserve is irrecoverable at decoding time")。这句话在电商/短视频里也成立,但在 Location-Based Services(LBS) 里被放大到致命:检索结果是否可用,取决于 POI 的细粒度属性,而这些属性恰恰是主流 LLM 感知不精确的部分。
作者据此把 LBS SID 的问题拆成三个必须在"标识符成形之前"解决的挑战:
C1:地理坐标。 在 LBS 检索里 $0.1^{\circ}$ 的差异(约 $10$ km)就已经有实质业务影响,而 LLM 在三个方向上都处理不好坐标:
- 数值编码不连续:tokenizer 把坐标拆成数字子 token,数值上接近的坐标可能落到嵌入空间里彼此遥远的区域;
- 离散网格有硬边界:GeoHash、S2 Cell 这类被一些方法直接当作 SID 前缀的编码,会因为一条网格边界恰好穿过两个地理相邻的 POI,而给它们完全无关的码;
- 坐标是角度量:同样的经度差在赤道跨约 $111$ km,在高纬度则短得多。
C2:动态数值属性。 POI 还带评分、人均价格、收藏数等属性,量纲相差几个数量级,因此"同样大小的差值"含义完全不同:评分(范围 $0$–$5$)差 $0.5$ 足以区分口碑好坏,而到访量(范围 $0$–$120$K)差 $0.5$ 与噪声无异。已有工作(Pro-GEO、LLM-aligned geographic tokenization、GeoGR)把这些属性当作无类型的纯文本序列化,强迫一个共享数值子空间去吸收所有属性。
C3:层级结构。 每个 POI 带一个系统标注的两级 tag(如"Shopping/Consumer Electronics"),并处在商圈这样的地理单元里,二者都无法从表层文本恢复。tag 可能粗粒度一致而细粒度分叉:"Apple Store" 与 "Apple Market" 文本几乎相同、粗 tag 都是 "Shopping",细 tag 却分属 "Consumer Electronics" 与 "Super Market"。更棘手的是地理建模越强,这个问题越严重:同一商圈里的异质店铺被聚得越紧,就越难被区分开。
本文的核心诊断:已有方法"干预得太晚"¶
论文对现有 POI SID 方法的批评非常锋利,且直接决定了它在 SID 路线之争里的站位:
已有方法把离散空间 token(Geohash / S2 Cell ID)当作地理前缀拼上去、在码本量化时注入地理偏移、或用共访对比信号微调嵌入模型 —— 它们全都作用在精度已经丢失的表征上,因为精度在 tokenizer 把坐标切成数字碎片的那一刻就消失了;下游任何网格、旋转或聚类都无法恢复一个从来就不连续的值("no downstream grid, rotation, or clustering can recover a value that was never continuous")。
而且这些方法只处理地理一个维度,把数值属性和结构信息继续留给纯文本;并且要用更长的标识符换取增益,直接抬高自回归解码成本。
因此 LBS 生成式检索的中心问题被重述为:不是如何组织 SID,而是如何让 SID 高保真(how to make them high-fidelity)。
相关工作里的关键判断¶
Related Work 一节给出了本文最核心的一句方法论主张:
一旦施加量化,物品嵌入没能编码的东西就被不可逆地丢弃,所以决定性因素是嵌入保真度,而不是码本设计("embedding fidelity, rather than codebook design, is the decisive factor")。
现有 POI SID 增强被归成三条路线: 1. 离散空间 token 化:S2 Cell 作层级地理前缀、Geohash 派生 Geographic ID 配 trie 约束解码、层级地理 token 化配残差量化; 2. token 级连续注入:GenPOI 的 Geographic Position Embedding、Pro-GEO 的 geo-centroid + Geo-RoPE 框架; 3. 行为驱动对齐:GeoGR 用时空共访对分 EM 式精修 SID,或给 RQ-VAE 加多样性损失对抗语义坍缩。
三条路线的共同弱点:都在坐标已被序列化为文本之后才动手,且都只把地理当作唯一值得建模的结构化信号。至于数值属性,子词 token 化破坏数值连续性,LLM 在量级与比较上不可靠;已有把标量嵌成单个连续单元的专用编码器(GeoNum)只在推理任务上被验证过,从未用于标识符构造。最接近本文的 ReSID 与 HiD-VAE 量化了结构化推荐字段与多粒度语义,但都面向通用推荐,没有正面处理 POI 的异质属性量纲与空间层级。
贡献¶
- 指出已有 POI SID 方法在量化之前就丢失了地理、数值、结构三重保真度,提出 HF-SID 在表征层面同时恢复三者,且不改变 SID 长度;
- 提出统一数值表征:把坐标与动态属性都编码成单个连续单元,结合 3D 笛卡尔变换、数值编码器与逐类型 Type Embedding,并用两阶段 CPT(Geo-CPT 做空间推理、Num-CPT 做量纲感知比较)与 LLM 对齐;
- 设计 Structure-based Contrastive Learning,只作用在最后一层量化前的残差上,分离共址或仅粗 tag 相同但细粒度不同的 POI,从而不干扰粗层已建立的地理信号;
- 开源 AMap-S(大规模真实 POI 与轨迹数据集),并在工业规模离线实验 + 高德生产部署上验证。
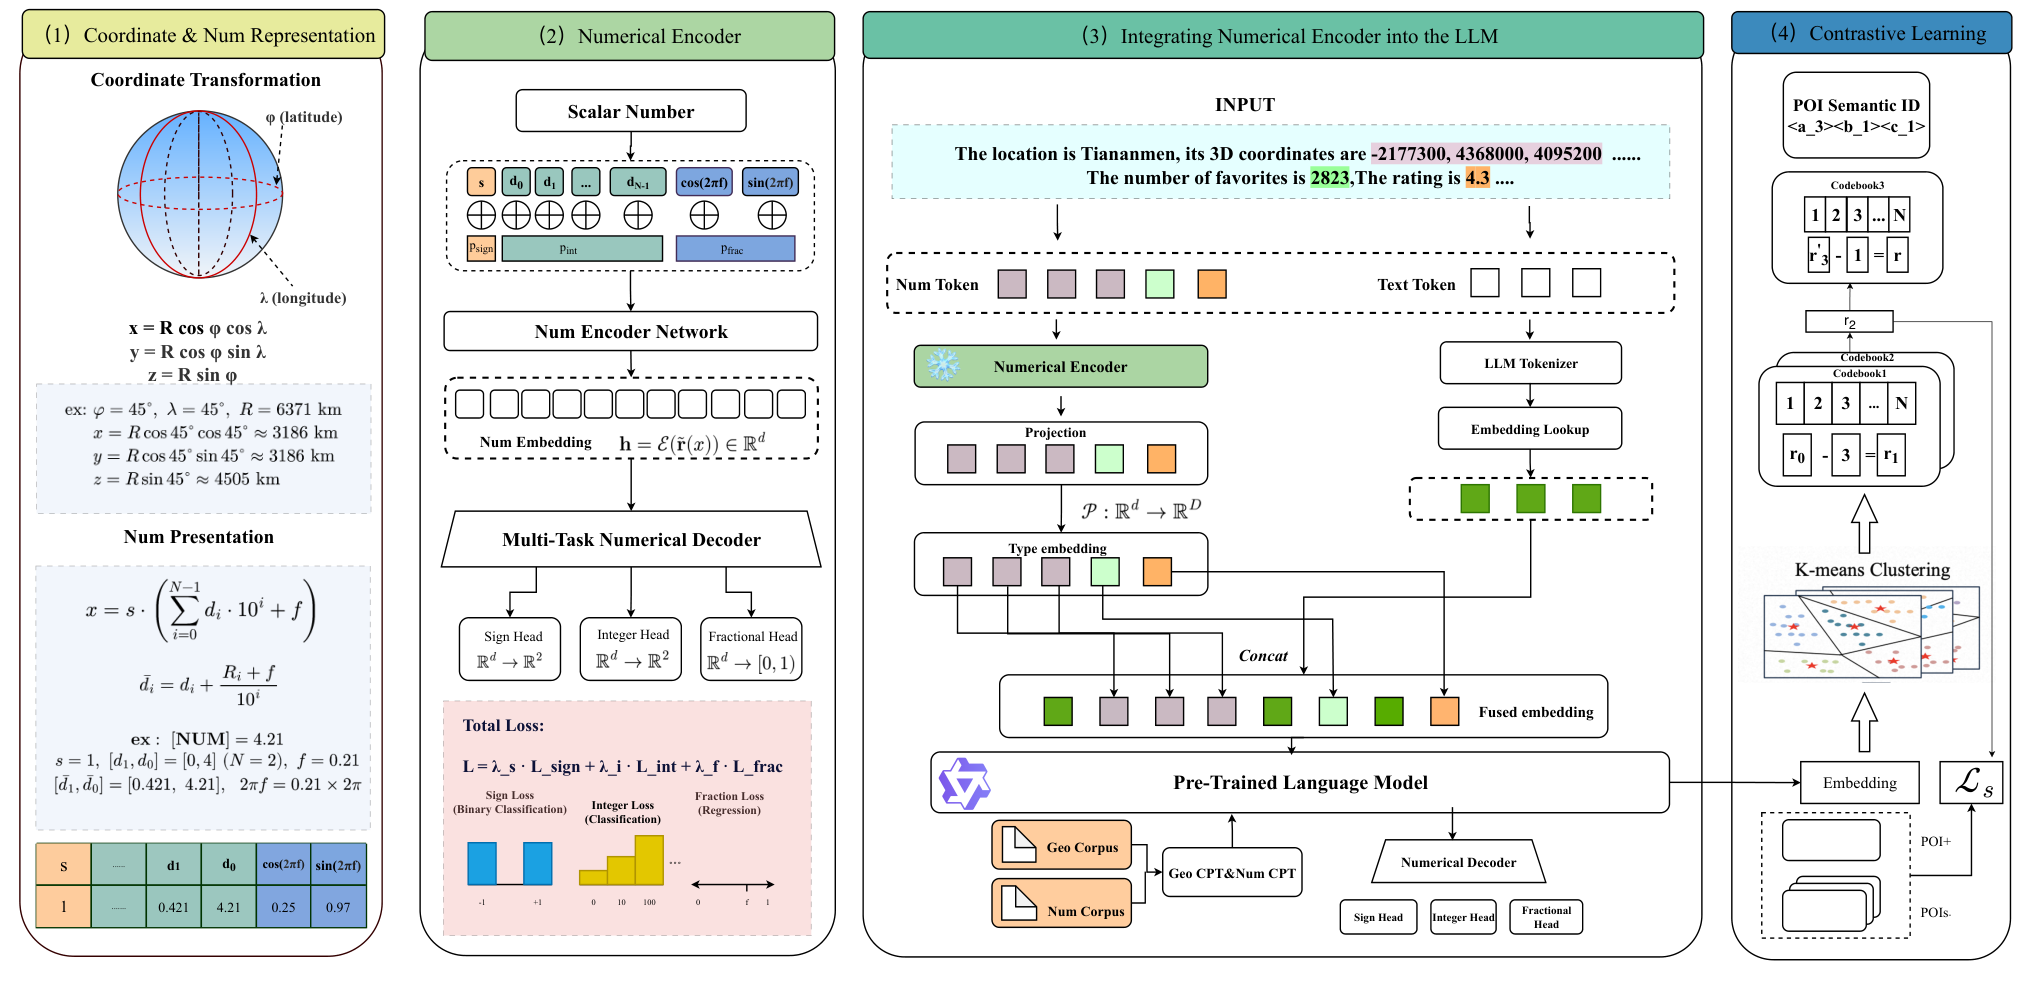
图 2 从左到右正是上述四阶段:(1) 坐标变换与数值极坐标表示;(2) 数值编码器 + 多任务数值解码器(Sign / Integer / Fractional 三个头);(3) 把冻结的数值编码器接进 LLM ——
[NUM]位置走 Numerical Encoder → Projection → Type embedding,文本位置走 LLM Tokenizer → Embedding Lookup,拼成 Fused embedding 后过 LLM,并用 Geo Corpus / Num Corpus 做 Geo-CPT & Num-CPT;(4) 三层 K-means 量化,Codebook1/2 标准残差量化,Codebook3 之前用 $\mathcal{L}_s$ 对二阶残差做结构对比精修,最终得到 $\langle a\_3, b\_1, c\_1\rangle$ 形式的 3-token SID。
核心方法 / 模型架构¶
给定 POI $p$ 及其文本描述,HF-SID 把它编码成 $\mathbf{SID}_p$,遵循单一原则:在量化把 POI 提交给离散码之前,先在表征层面恢复地理、数值与结构保真度。框架分四阶段:
- 坐标与数值表征(§3.1):坐标从球面转 3D 笛卡尔;描述里每个数值(含坐标)被分解为符号、逐位量级与小数部分的角度编码("极坐标表示"),这些位置被标记为数值 token;
- 数值编码器(§3.2):专用编码器把每个极坐标表示映射为连续嵌入,预训练目标是通过三个解码头重建符号、整数位与小数部分,之后冻结并被后续所有阶段复用;
- 把数值编码器接入 LLM(§3.3):数值嵌入投影到 LLM 输入空间,加上给每个属性类型独立子空间的 Type Embedding,替换回原位置与文本 token 嵌入拼成统一序列;再用 Geo-CPT 与 Num-CPT 在混合目标下继续预训练,取最后一个 token 的隐状态作为 POI 表征;
- HF-SID 生成与结构对比学习(§3.4):对 POI 表征做层次量化,前两层在地理与数值语义上聚类、给邻近 POI 共享前缀,Structure-based Contrastive Learning 在第三层之前精修二阶残差,把被粗层聚到一起的 POI 用 tag 在最后一个 token 上分开。
坐标变换¶
坐标先从球面转成笛卡尔形式再进入嵌入:
$$x=R\cos\phi\cos\lambda,\quad y=R\cos\phi\sin\lambda,\quad z=R\sin\phi \tag{1}$$
其中 $\phi,\lambda$ 是纬度与经度,$R$ 是地球平均半径,$x,y,z\in\mathbb{R}$ 以米为单位。两个性质随之而来:
- 跨越 180° 经线连续:$\lambda=+179^{\circ}$ 与 $\lambda=-179^{\circ}$ 现在是相邻点;
- 欧氏距离与真实距离单调:两 POI 的欧氏距离等于弦长 $2R\sin(d/2R)$($d$ 为大圆距离),它是真实距离的严格单调函数,在城市尺度上近似线性,比原始经纬度差好建模得多。
数值的"极坐标"表示¶
对 POI 文本里的每个数值(坐标与动态属性一视同仁),采用统一分解,把标量当作一个单元而非数字串。之所以叫极坐标,是因为小数部分用它在单位圆上的角度表示。
任何标量 $x$ 被分解成符号、$N$ 位整数与小数部分:
$$x=s\cdot\left(\sum\nolimits_{i=0}^{N-1}d_{i}\cdot 10^{i}+f\right) \tag{2}$$
其中 $s\in\{-1,+1\}$,$d_{i}\in\{0,\ldots,9\}$ 是第 $i$ 位整数位,$f\in[0,1)$ 是小数部分。$N$ 取 9,足以覆盖式 (1) 产出的米制坐标与全部动态属性,位数不足时前导补零。
关键设计:不直接喂原始数字 $d_i$,而是给每个整数位附上其后所有低位的量级:
$$\bar{d}_{i}=\left(|x|\,/\,10^{i}\right)\bmod 10 \tag{3}$$
于是 $\bar{d}_{i}\in[d_{i},d_{i}+1)$ 同时携带该位数字与所有低位的分数摘要。这让整数进位变得连续:$399\rightarrow 400$ 时 $\bar{d}_{2}$ 从 $3.99$ 平滑滑到 $4.00$,而不是三位数字同时跳变。对称地,把 $f$ 编成 $(\cos 2\pi f,\sin 2\pi f)$ 使小数进位也连续,因为 $f=0.99$ 与 $f=0.01$ 在单位圆上相邻。
拼接得到极坐标向量:
$$\mathbf{r}(x)=\left[s,\ \bar{d}_{0},\ \bar{d}_{1},\ \ldots,\ \bar{d}_{N-1},\ \cos 2\pi f,\ \sin 2\pi f\right]^{\top}\in\mathbb{R}^{N+3} \tag{4}$$
由于 $\mathbf{r}(x)$ 各分量语义角色不同,每个分量被抬升到 $d_e$ 维并加上可学习的 field embedding:
$$\tilde{\mathbf{r}}_{j}(x)=r_{j}(x)\,\mathbf{w}+\mathbf{b}+\mathbf{e}_{\varphi(j)}\in\mathbb{R}^{d_{e}},\quad j=0,\ldots,N+2 \tag{5}$$
其中 $\mathbf{w},\mathbf{b}\in\mathbb{R}^{d_{e}}$ 是共享可学参数,$\varphi(j)\in\{\mathit{sign},\mathit{int},\mathit{frac}\}$ 返回位置 $j$ 的字段类型。所有整数位共享同一个 $\mathbf{e}_{\mathit{int}}$,因为它们的次序已经被 $\bar{d}_j$ 编码进去了。最终 $\tilde{\mathbf{r}}(x)=\mathrm{vec}([\tilde{\mathbf{r}}_{0}(x),\ldots,\tilde{\mathbf{r}}_{N+2}(x)])\in\mathbb{R}^{(N+3)d_{e}}$。两处进位平滑编码加上 field embedding,共同保证数值上接近的值被映到输入空间里几何相邻的点。
(论文图 2 给出的例子:$[\text{NUM}]=4.21$ 时 $s=1$、$[d_1,d_0]=[0,4]$($N=2$)、$f=0.21$,$[\bar d_1,\bar d_0]=[0.421,\,4.21]$,$\cos 2\pi f=0.25$、$\sin 2\pi f=0.97$。)
数值编码器¶
把 field 增强后的极坐标表示送进数值编码器 $\mathcal{E}(\cdot)$(一个 MLP)得到数值嵌入:
$$\mathbf{h}=\mathcal{E}(\tilde{\mathbf{r}}(x))\in\mathbb{R}^{d} \tag{6}$$
注意 $d$ 远大于 $\tilde{\mathbf{r}}(x)$ 的维度,即 $\mathcal{E}(\cdot)$ 是把一个标量抬升到高维空间,而不是压缩。
为让这个空间具备数值结构,用多任务目标预训练 $\mathcal{E}(\cdot)$,要求分解的每个分量都能从 $\mathbf{h}$ 单独恢复。符号与 $N$ 个整数位由 softmax 分类器预测:
$$\mathbf{p}_{sign}=\text{softmax}(\mathbf{W}_{sign}\mathbf{h}+\mathbf{b}_{sign})\in\mathbb{R}^{2} \tag{7}$$
$$\mathbf{p}_{int}^{(i)}=\text{softmax}(\mathbf{W}_{int}^{(i)}\mathbf{h}+\mathbf{b}_{int}^{(i)})\in\mathbb{R}^{10},\quad i=0,\ldots,N-1 \tag{8}$$
小数部分由 sigmoid 线性层回归:
$$\hat{f}(\mathbf{h})=\sigma(\mathbf{W}_{f}\mathbf{h}+\mathbf{b}_{f})\in(0,1) \tag{9}$$
论文特意解释这不是平凡的重建:因为 $\mathcal{E}(\cdot)$ 升维,不存在信息被丢弃的风险;目标约束的是信息如何排布 —— 单个 $\mathbf{h}$ 必须同时支撑 $N$ 个独立的 10 类分类、一个符号分类与一个小数回归,这迫使 $x$ 的逐位量级结构在嵌入的不同方向上线性可解码。这也正是后面能把同样三个头接到 LLM 输出上的原因:它们定义了什么算合法的数值表征。
单个标量的预训练损失:
$$\ell_{num}(x)=\lambda_{s}\mathcal{L}_{sign}+\lambda_{i}\sum\nolimits_{i=0}^{N-1}\omega_{i}\mathcal{L}_{int}^{(i)}+\lambda_{f}\mathcal{L}_{frac} \tag{10}$$
$\mathcal{L}_{sign}$、$\mathcal{L}_{int}^{(i)}$ 是交叉熵,$\mathcal{L}_{frac}$ 是小数回归的 MSE。位置权重 $\omega_{i}=1+0.2i$ 温和地偏向高位(高位出错造成的数值偏移更大),同时保持低位仍被监督 —— 论文明确指出更陡的加权会让模型忽略尾数,而对评分这类属性,尾数恰恰承载了大部分判别信号。
预训练后 $\mathcal{E}(\cdot)$ 被冻结并在所有下游阶段复用,为地理坐标与异质数值属性提供一个一致的嵌入空间。
Type Embedding 与融合嵌入¶
由于数值编码器被冻结,用两个轻量可训练组件把它桥接到 LLM。先用线性投影对齐 LLM 输入空间:
$$\mathbf{h}^{proj}_{k}=\mathbf{W}_{proj}\mathbf{h}_{k}+\mathbf{b}_{proj} \tag{11}$$
但单个共享投影会把所有属性映到同一个数值子空间,在那里 $0.5$ 究竟是评分还是到访量无从分辨。因此再加一个可学习的 type embedding,从矩阵 $\mathbf{M}_{\mathcal{T}}\in\mathbb{R}^{|\mathcal{T}|\times d_{llm}}$ 中按属性类型 $\tau_{k}$ 取行加到数值嵌入上:
$$\hat{\mathbf{h}}_{k}=\mathbf{h}^{proj}_{k}+\mathbf{M}_{\mathcal{T}}[\tau_{k}] \tag{12}$$
因为偏移在类型内是常量,同一属性内部值之间的量级关系被完全保留,而不同属性被平移到输入空间的不同区域。论文把这个机制类比为 Transformer 的位置编码:同样是注入关于"位置/角色"的先验,而不修改内容本身。
序列化时每个数值被替换成单个占位 token [NUM],一个标量恰好占一个位置,与它有几位数字无关(副作用是缩短了输入序列,多位数字不再展开成多个子 token)。然后在这些位置替换成类型感知的数值嵌入,其余位置保留普通 token 嵌入:
$$\mathbf{E}_{fused}[k]=\begin{cases}\hat{\mathbf{h}}_{k}&k\in\mathcal{I}_{num}\\ \mathrm{Emb}(w_{k})&\text{otherwise}\end{cases}\qquad \mathbf{E}_{out}=\text{LLM}(\mathbf{E}_{fused}) \tag{13}$$
其中 $\mathcal{I}_{num}$ 是输入序列的 [NUM] 位置集合,$\mathbf{E}_{fused},\mathbf{E}_{out}\in\mathbb{R}^{T\times d_{llm}}$。沿用 decoder-based 嵌入模型(Qwen3-Embedding)的常规做法,取最后一个 token 的隐状态作为 POI 表征 $\mathbf{E}_{out}(p)\in\mathbb{R}^{d_{llm}}$。
两阶段持续预训练(Geo-CPT + Num-CPT)¶
训练样本分两类,分别显式监督空间与数值两个维度。所有数值量在输入与目标序列中都以 [NUM] 出现,由冻结的数值编码器编码。
Geo-CPT(地理增强) 构造两类样本:
- 成对距离计算:给定 $p_A,p_B$ 的笛卡尔坐标(以数值 token 提供),模型在目标序列的单个
[NUM]位置预测两者距离,ground truth 是 Haversine 公式算出的大圆距离(公里)。论文特意讨论了这个细节:从笛卡尔输入直接可得的量是弦长 $2R\sin(d/2R)$ 而非 $d$ 本身,但对 $100$ km 以内的 POI 对,两者相差不到 $10^{-3}\%$,因此在 LBS 相关的尺度上这个目标实质就是变换空间里的欧氏距离,同时仍是地理上有意义的量; - 最近对识别:给定 $p_A,p_B,p_C$,模型判断 $(p_A,p_B)$、$(p_A,p_C)$、$(p_B,p_C)$ 中哪一对最近,并以文本 token 输出。这要求同时对三个成对距离做推理,而不是算单个距离。
Num-CPT(数值增强) 构造带多个数值属性的 $p_A,p_B$,问在指定属性 $\tau$ 上谁的值更大,目标以文本 token 给出:
$$y^{(\tau)}=\begin{cases}\mathtt{A}&\text{if }v_{A}^{(\tau)}>v_{B}^{(\tau)}\\ \mathtt{B}&\text{if }v_{A}^{(\tau)}<v_{B}^{(\tau)}\end{cases} \tag{14}$$
$v^{(\tau)}$ 相等的样本被丢弃(平局没有比较信号,还会训出对某个位置的伪偏好),并且两个标签被均衡,使答案无法仅凭位置推断。跨属性实例化后,这个形式迫使模型先定位查询属性所属的那个值,再与同类型的对手比较,即便不同类型量纲相差几个数量级。
混合训练目标。 目标序列同时含离散文本 token 与数值 token,因此在两类位置用不同损失。文本位置用交叉熵:
$$\mathcal{L}_{CE}=-\frac{1}{|\mathcal{I}_{text}|}\sum\nolimits_{k\in\mathcal{I}_{text}}\log P\left(w_{k}\mid\mathbf{E}_{<k}\right) \tag{15}$$
数值位置复用多任务损失,把同样三个解码头接到 LLM 输出表征上:
$$\mathcal{L}_{num}^{NTP}=\frac{1}{|\mathcal{I}_{num}|}\sum\nolimits_{k\in\mathcal{I}_{num}}\ell_{num}(x_{k}) \tag{16}$$
两项各自在自己的位置上平均,使它们的相对权重不随样本的文本/数值比例漂移。每个阶段的总损失为:
$$\mathcal{L}_{NTP}=\mathcal{L}_{CE}+\alpha\cdot\mathcal{L}_{num}^{NTP} \tag{17}$$
顺序是 Geo-CPT 先、Num-CPT 后,理由是地理保真度是 LBS 检索的主导因素,因此值得在未被修改的骨干上先建立。
HF-SID 生成与 Structure-based Contrastive Learning¶
对全语料的 POI 表征做三层 K-means 残差量化。记 $\mathbf{R}_{p}^{(0)}=\mathbf{E}_{out}(p)\in\mathbb{R}^{d_{llm}}$,第 $l$ 层在所有 POI 的 $l$ 阶残差上拟合大小为 $N_c$ 的码本 $\mathcal{C}^{(l)}$,取最近质心并把剩余残差前传:
$$s_{p}^{l}=\arg\min_{j}\big\lVert\mathbf{R}_{p}^{(l-1)}-\mathbf{c}_{j}^{(l)}\big\rVert_{2},\qquad \mathbf{R}_{p}^{(l)}=\mathbf{R}_{p}^{(l-1)}-\mathbf{c}_{s_{p}^{l}}^{(l)} \tag{18}$$
前两层是标准形式,产出编码地理与数值语义的粗 token $s_p^1,s_p^2$。
问题恰恰出在这里:正因为前两层地理紧凑,同一商圈的 POI 会被大量塌缩到同一个前缀 $\langle s_p^1,s_p^2\rangle$,无论它们实际是什么店。因此在最后一次量化之前精修二阶残差 $\mathbf{R}_p^{(2)}$,监督信号是每个 POI 的两级 tag:只有两级 tag 都一致才构成正例对,mini-batch 里其余 POI 全是负例,于是仅粗层一致的 POI 成为 hard negative。残差先线性投影:
$$\mathbf{z}_{p}=\mathbf{W}_{s}\,\mathbf{R}_{p}^{(2)}+\mathbf{b}_{s} \tag{19}$$
再用内积上的 InfoNCE 优化:
$$\mathcal{L}_{s}(p_{i},p_{j})=-\log\frac{\exp\left(\mathbf{z}_{p_{i}}^{\top}\mathbf{z}_{p_{j}}/\gamma\right)}{\exp\left(\mathbf{z}_{p_{i}}^{\top}\mathbf{z}_{p_{j}}/\gamma\right)+\sum_{p_{k}\in\mathcal{B}^{-}}\exp\left(\mathbf{z}_{p_{i}}^{\top}\mathbf{z}_{p_{k}}/\gamma\right)} \tag{20}$$
其中 $\mathbf{W}_{s}\in\mathbb{R}^{d_{z}\times d_{llm}}$、$\mathbf{b}_{s}$ 是这一阶段唯一被更新的参数,$\mathcal{B}^{-}$ 收集 batch 内 tag 在任一层与 $p_i$ 不同的 POI,$\gamma$ 是温度,损失在 batch 内全部正例对上平均。由于 LLM 与前两个码本保持冻结,$\mathbf{R}_p^{(2)}$ 是常量输入,精修永远不会使粗 token 失效。
精修后的残差被第三层 K-means 量化成 $s_p^3$:
$$\mathbf{HF\text{-}SID}_{p}=\left\langle s_{p}^{1},\ s_{p}^{2},\ s_{p}^{3}\right\rangle \tag{21}$$
论文对这个设计做了一个非常关键、也很少见的坦白:最后一层是在投影空间 $\mathbb{R}^{d_z}$ 而非 $\mathbb{R}^{d_{llm}}$ 上操作的,因此严格意义上它已经不再重建 $\mathbf{R}_p^{(2)}$、不是标准残差量化。这是故意的:
SID 只是一个供自回归生成的标识符,从来不用来重建 POI 表征,所以最后一层可以拿重建误差换判别力。
把投影限制在最后一层,正是保住 $\langle s_p^1,s_p^2\rangle$ 地理与数值保真度的原因。最终序列仍保留残差量化的前缀共享性质,可以用约束在合法 SID 前缀树上的 beam search 做候选生成。
实验设置¶
数据集。 两个来自高德平台的工业数据集 + 两个公开 Foursquare 签到数据集(NYC、TKY)。AMap-L 由完整一天的匿名用户交互日志构建,剔除无交互序列的 POI 与无认证用户标识的会话;AMap-S 是同平台释出的公开子集,规模更小但保留同样的属性,作为未来工作的标准化基准。
| Dataset | #Users | #POIs | #Inter. | Avg.Len |
|---|---|---|---|---|
| NYC | 1,083 | 5,135 | 104,074 | 136 |
| TKY | 2,293 | 7,873 | 361,430 | 195 |
| AMap-L | 11.0M | 48.1M | 16.3M | 305 |
| AMap-S | 0.90M | 4.58M | 0.97M | 453 |
Baselines(7 个 SID 构造方法):RQ-KMeans(QARM)、RQ-OPQ(OneSearch)、GNPR-SID、Cosine-RQ(HyMiRec)、Pro-GEO、GenPOI、GeoGR。为公平比较,全部在同一配置下重实现:码本深度 $L=3$、每层码本大小 AMap-L 上 $N_c=4096$ / AMap-S 上 $N_c=512$、数据切分完全一致。
评估指标。
- SID 量化指标(沿用 Pro-GEO 的四个):ICR(Independent Codeword Rate,↑)衡量码字被唯一分配的程度;Avg.Dist(↓)是每个 POI 位置到其 SID 质心的平均欧氏距离,即簇内空间紧凑度;p90 / p95 Dist(↓)是前 90% / 95% POI 到 SID 质心的最大距离;
- 离线推荐指标:Hit@200 / Hit@300(↑),ground-truth 目标 POI 出现在 top-200 / top-300 生成候选中的比例;
- 线上指标:WinRate(按点击、路线导航、预订等策略动作价值加权的综合指标)、PV_CTR / UV_CTR、PV_CVR / UV_CVR。
实现细节。 数值编码器按 GeoNum 实现。嵌入模型骨干用 Qwen3-0.6B(做 POI 表征学习与 SID 生成),下游 next-POI 预测用 Qwen3-4B 全参数 SFT。Beam search 宽度 300。持续预训练 1 epoch,AdamW,学习率 $1\times 10^{-3}$;SFT 也是 1 epoch,cosine 调度,学习率 $2\times 10^{-5}$,per-device batch size 8,梯度累积 4 步,DeepSpeed ZeRO-2 + bf16。RQ-KMeans 设 $L=3$,与 OneRec 一致。全部实验跑在 64 张 A100 上。
主要实验结果¶
Table 2:AMap-L / AMap-S 全面对比¶
| Dataset | Method | SID 长度 | ICR↑ | Avg.Dist↓ | p90 Dist↓ | p95 Dist↓ | Hit@200↑ | Hit@300↑ |
|---|---|---|---|---|---|---|---|---|
| AMap-L | RQ-KMeans | 3 | 80.92% | 6.07 km | 2.66 km | 15.21 km | 54.47% | 56.02% |
| RQ-OPQ | 3 | 98.93% | 7.27 km | 5.03 km | 23.78 km | 54.88% | 55.31% | |
| GNPR-SID | 3 | 77.57% | 10.67 km | 5.08 km | 16.27 km | 58.38% | 67.65% | |
| Cosine-RQ | 3 | 82.63% | 5.26 km | 2.33 km | 13.32 km | 55.62% | 58.83% | |
| Pro-GEO | 3 | 81.18% | 7.02 km | 4.84 km | 23.33 km | 65.69% | 70.51% | |
| GeoGR | 3 | 54.69% | 0.49 km | 0.74 km | 1.19 km | 77.58% | 80.42% | |
| GenPOI | 6 (3+3) | 83.80% | 0.97 km | 0.55 km | 5.53 km | 70.61% | 73.82% | |
| HF-SID | 3 | 84.22% | 0.25 km | 0.12 km | 0.69 km | 81.24% | 83.36% | |
| AMap-S | RQ-KMeans | 3 | 61.34% | 37.91 km | 88.48 km | 207.85 km | 27.36% | 33.07% |
| RQ-OPQ | 3 | 98.71% | 41.20 km | 96.94 km | 226.36 km | 26.26% | 26.71% | |
| GNPR-SID | 3 | 47.52% | 77.82 km | 229.70 km | 485.91 km | 29.64% | 36.83% | |
| Cosine-RQ | 3 | 63.68% | 36.32 km | 74.59 km | 197.81 km | 28.95% | 33.78% | |
| Pro-GEO | 3 | 64.64% | 24.25 km | 49.54 km | 132.85 km | 34.54% | 38.39% | |
| GeoGR | 3 | 37.83% | 8.94 km | 14.07 km | 46.15 km | 35.02% | 40.50% | |
| GenPOI | 5 (2+3) | 62.12% | 4.84 km | 15.71 km | 25.14 km | 38.04% | 43.29% | |
| GenPOI | 6 (3+3) | 65.97% | 3.22 km | 11.30 km | 18.19 km | 42.20% | 46.91% | |
| HF-SID | 3 | 59.79% | 3.99 km | 5.49 km | 11.12 km | 48.98% | 57.92% |
SID 质量结论。 两个数据集上,SID 空间的紧凑度随"地理在流水线里进入得多早"单调改善,而 HF-SID 介入最早、也最紧凑:
- 只量化纯文本嵌入的方法停在 AMap-L 的 $5.26$–$10.67$ km、AMap-S 的 $36.32$–$77.82$ km,无论码本怎么精修都无济于事 —— 正交乘积量化(RQ-OPQ)、码字多样性损失(GNPR-SID)、更强的文本表征(Cosine-RQ)都几乎没有动地理误差,因为它们从一开始就没把地理信息放进嵌入;
- 事后注入地理有帮助(Pro-GEO $7.02$ km、6-token GenPOI $0.97$ km),用行为监督重塑嵌入空间帮助更大(GeoGR $0.49$ km),但 HF-SID 到 $0.25$ km 与 $3.99$ km,相对朴素 RQ-KMeans 分别削减 95.9% 与 89.5%,相对 GeoGR 再削减 48.98% 与 55.4%;
- 优势在尾部最大(尾部正是产生"看得见的错误候选"的区间):p90 Dist 降 83.8% / 61.0%、p95 Dist 降 42.0% / 75.9%。特别地,AMap-S 上 HF-SID 用一半的标识符长度把 6-token GenPOI 的 p90 Dist 砍半($11.30\rightarrow 5.49$ km)、p95 Dist 降 38.9%($18.19\rightarrow 11.12$ km),尽管 GenPOI 在翻倍 token 预算下保住了略低的均值 $3.22$ km。
两个反例说明"码字唯一性本身不是有意义的目标"。 RQ-OPQ 的 ICR 近乎饱和($98.93\%$ / $98.71\%$),但它的 Avg.Dist 在两个数据集上都比朴素 RQ-KMeans 更差,Hit@300 更是两个数据集上的最低($55.31\%$ / $26.71\%$)—— 把物品均匀铺满码本,完全没说明这个码是否承载可用结构。GeoGR 则在相反方向失败:它用全表最低的 ICR($54.69\%$ / $37.83\%$)买来地理紧凑度,因为在共访对上做对比微调会把行为相似的 POI 坍缩到共享码字上。HF-SID 避开了两种失效模式,因为它编码的是坐标本身而不是坐标的代理;在 Avg.Dist 低于 $1$ km 的所有方法中,它以 $84.22\%$ 的 ICR 抗碰撞能力最强。
检索性能结论。 SID 质量的增益完整传导到下游检索,各方法按 Hit 的排序几乎与按 SID 紧凑度的排序完全一致(所有方法在相同设置下微调,只有 SID 不同)。HF-SID 的 Hit@200 为 $81.24\%$ / $48.98\%$、Hit@300 为 $83.36\%$ / $57.92\%$,比各自最强 baseline 高 3.66 / 6.78 个点(Hit@200)与 2.94 / 11.01 个点(Hit@300),后者在 AMap-S 上相当于 23.48% 的相对提升,而且只用了被它超越的 6-token GenPOI 一半的 token。AMap-L 上八个系统的 Hit@200 从四个纯文本方法的 $54$–$58\%$ 区间,跳到事后注入地理后的 $65.69\%$ / $70.61\%$,再跳到嵌入本身地理感知后的 $77.58\%$ / $81.24\%$。
论文把"两个排序重合"称为全文的中心证据:检索增益不是某种特定码本设计的产物,而是多少地理与数值保真度活着进入了标识符的直接后果。
消融与分析¶
Table 3:AMap-L 上的留一消融¶
| Method | Hit@200↑ | ΔHit@200 | Hit@300↑ | ΔHit@300 |
|---|---|---|---|---|
| HF-SID (Full) | 81.24% | – | 83.36% | – |
| w/o Num | 77.73% | −4.32% | 80.65% | −3.25% |
| w/o Struct | 71.88% | −11.52% | 78.35% | −6.01% |
| w/o Geo | 68.34% | −15.88% | 71.11% | −14.69% |
| w/o All (Baseline) | 54.47% | −32.95% | 56.02% | −32.79% |
消融设计有一个很讲究的地方:没有任何变体删除信息 —— 组件被关掉时,对应属性仍以纯文本留在 POI 描述里。w/o Geo 去掉笛卡尔变换、坐标上的数值编码器与 Geo-CPT;w/o Num 去掉动态属性上的数值编码器、Type Embedding 与 Num-CPT;w/o Struct 去掉对比精修、让第三层直接量化 $\mathbf{R}_p^{(2)}$;w/o All 退化为朴素 RQ-KMeans。因此所有变体看到的内容完全相同,差别只在于表征得多忠实,下降幅度度量的是表征保真度的价值而非信息可得性的价值。
每个组件都有贡献,且贡献大小与它作用在 SID 层级的哪一层相符:
- 去掉地理通路代价最大(Hit@200 $81.24\%\rightarrow 68.34\%$,$-15.88\%$;Hit@300 $-14.69\%$):地理保真度在量化前建立,因而塑造了前两层码本 —— 也就是生成被约束在其上的整棵前缀树,破坏它会污染之后每一个解码决策;
- Structure-based Contrastive Learning 只作用于三个 token 中的一个,其代价相应地从 Hit@200 的 $-11.52\%$ 减半到 Hit@300 的 $-6.01\%$,说明 tag 纯度主要影响"把正确 POI 排得够前",而不是"能否够到它";
- 数值通路最小($-4.32\%$ / $-3.25\%$):评分与到访量是在已经合理的候选之间细化排序,而不是决定去探索标识符空间的哪个区域。
最重要的结论:与 baseline 的全部差距都可归因于表征本身。三个组件全关就回到朴素 RQ-KMeans 的 $54.47\%$ / $56.02\%$,因此 HF-SID 在 Hit@200 上 26.77 个点的增益,是在不改变量化算法、不改变码本大小、不改变标识符长度的前提下取得的 —— Table 2 里排名最后的那套流程,在它所量化的表征变得地理与数值感知之后,排名第一。
地理信息可视化(§4.4.1)¶
采样 $1{,}554$ 个 POI,按省 / 市 / 区三个行政层级着色做 t-SNE,报告 Geo-CPT 前后的 NMI。baseline 嵌入在每个粒度上都严重重叠,而 HF-SID 形成紧致且清晰分离的簇,NMI 从 $0.1993$ 升到 $0.7454$(省)、$0.2615\rightarrow 0.9796$(市)、$0.3972\rightarrow 0.9399$(区)。论文强调:这个嵌入空间几何正是 Table 2 中 SID 空间紧凑度的来源 —— 在表征里建立的保真度活着进入了码。
Table 4:SID 内数值属性离散度(§4.4.2)¶
对每个含多于一个 POI 的 HF-SID 簇,计算五个异质属性的标准差(Std)、变异系数(CV)与平均绝对偏差(MAD),再取宏平均,越低表示数值一致性越强。
| Method | Rating Std / CV / MAD | POI Visited Std / CV / MAD | POI Index Std / CV / MAD | Collect UV Std / CV / MAD | Week View UV Std / CV / MAD |
|---|---|---|---|---|---|
| GeoGR | 0.2474 / 0.1001 / 0.2880 | $1.92\times 10^{11}$ / 1.2474 / $1.92\times 10^{11}$ | 0.6121 / 0.4063 / 0.5695 | 24.953 / 0.4537 / 24.897 | 7.631 / 0.7137 / 7.196 |
| Pro-GEO | 0.1831 / 0.0918 / 0.2610 | $4.39\times 10^{11}$ / 1.0661 / $4.39\times 10^{11}$ | 0.4894 / 0.3381 / 0.4696 | 30.018 / 0.3716 / 33.077 | 7.924 / 0.6292 / 7.830 |
| GenPOI | 0.2027 / 0.0947 / 0.2731 | 253.178 / 1.0600 / 236.968 | 0.5133 / 0.3462 / 0.4951 | 30.554 / 0.3701 / 33.572 | 8.188 / 0.6244 / 8.166 |
| RQ-KMeans | 0.2138 / 0.0982 / 0.2808 | 222.486 / 1.0753 / 208.249 | 0.5124 / 0.3554 / 0.4934 | 27.755 / 0.3697 / 30.237 | 7.573 / 0.6307 / 7.515 |
| HF-SID | 0.1817 / 0.0916 / 0.2608 | 49.955 / 1.0297 / 48.180 | 0.4438 / 0.3138 / 0.4251 | 15.426 / 0.3650 / 17.545 | 4.366 / 0.5962 / 4.451 |
HF-SID 在全部五个属性上都取得最优,且优势随属性的"苛刻程度"放大:在被限制在 $0$–$5$ 窄区间的 Rating 上,相对次优的 Pro-GEO 提升小但一致(Std $0.1831\rightarrow0.1817$、CV $0.0918\rightarrow0.0916$、MAD $0.2610\rightarrow0.2608$);到了跨几个数量级的重尾属性上优势急剧扩大 —— POI Visited 上相对各指标次优 baseline,Std 降 77.5%($222.486\rightarrow49.955$)、MAD 降 76.9%($208.249\rightarrow48.180$),CV 也从 $1.0600$ 降到 $1.0297$,说明即便在极端尺度下相对离散度也被压低。POI Index 上相对 Pro-GEO Std −9.3% / CV −7.2% / MAD −9.5%,Collect UV 与 Week View UV 上 Std 分别 −38.2% / −42.4%、MAD 分别 −29.5% / −38.2%。一个冻结的编码器同时处理五种分布,这一点被论文用来论证数值通路是跨尺度泛化的,而非拟合某一个属性。
(附带值得注意:GeoGR 与 Pro-GEO 在 POI Visited 上的 Std/MAD 达到 $10^{11}$ 量级,说明纯文本序列化的重尾属性在 SID 簇内基本失控。)
结构感知可视化(§4.4.3)¶
每个 POI 的结构是形如 "parent/child" 的两级 tag(如 "Food/Chinese Food")。对比 HF-SID 与 RQ-KMeans 在长度递增的前缀 $(a,*)$、$(a,b,*)$、$(a,b,c)$ 下诱导出的 tag / 区域 / 评分分布:HF-SID 在三个前缀长度上都有更好的地理与评分组织,而结构优势明确出现在第三个 token 上 —— 在共享父前缀 $(3443,2290,*)$ 之下,它的 L3 子节点几乎 tag 纯净,各自对应一个不同的细粒度餐饮类目。
论文对此的解释直接构成了对"该把结构信号放在哪一层"的判断:这是设计使然,因为对比学习只作用在第三级残差上。前两级留给地理、数值与语义信息,地理尤其优先;把对比目标放到那里会与主导检索的地理信号竞争 —— 这正是"仅最后一层"设计所规避的失效模式。
公开数据集实验(Table 5)¶
NYC 与 TKY 只提供坐标与签到记录,没有 Num-CPT 与 Structure-based Contrastive Learning 所依赖的丰富动态数值属性与细粒度类目结构,因此只施加 Geo-CPT。
| Dataset | Method | ICR↑ | Avg.Dist↓ | Hit@5↑ |
|---|---|---|---|---|
| NYC | RQ-KMeans | 52.13% | 6.96 km | 41.23% |
| GNPR-SID | 19.74% | 5.52 km | 44.34% | |
| Cosine-RQ | 16.57% | 4.61 km | 42.87% | |
| Pro-GEO | 55.29% | 6.10 km | 53.00% | |
| HF-SID | 56.12% | 3.99 km | 59.83% | |
| TKY | RQ-KMeans | 49.12% | 7.21 km | 30.00% |
| GNPR-SID | 18.50% | 5.67 km | 33.68% | |
| Cosine-RQ | 13.69% | 5.66 km | 35.27% | |
| Pro-GEO | 45.60% | 6.19 km | 49.27% | |
| HF-SID | 54.46% | 4.41 km | 57.37% |
Avg.Dist 在 NYC 上从 $6.96$ 降到 $3.99$ km(−42.7%)、TKY 上从 $7.21$ 降到 $4.41$ km(−38.8%),同时 ICR 升到 $56.12\%$ / $54.46\%$,两项都是全表最高。值得注意的是 GNPR-SID 与 Cosine-RQ 在 NYC 上 Avg.Dist 比 RQ-KMeans 好($5.52$ / $4.61$ km),但 ICR 崩到 20% 以下,即以严重码字碰撞为代价换地理一致性;HF-SID 是唯一同时改善两项的方法。Hit@5 上相对最强 baseline Pro-GEO 高 6.83 与 8.10 个点。
论文诚实地解释了为什么相对 Avg.Dist 降幅远小于 AMap-L(−42.7% vs −95.9%):公开数据集 POI 数少得多,每个码本簇覆盖的 POI 集合更大也更分散,细粒度空间聚合本身就更难。即便如此,两座独立城市上的一致增益说明 Geo-CPT 的笛卡尔坐标编码是稳健且平台无关的。
线上 A/B 实验(Table 6)¶
HF-SID 已部署在高德首页 POI 推荐链路,替换的是一个本身已经把地理信息编进 SID 的、先前上线的生成式检索方法(按作者列表与引用推断即 GeoGR)。推理链路完全不变:prompt 由个性化偏好、历史行为轨迹与实时上下文(当前位置、时间戳、搜索 query)拼装,候选通过 beam search 自回归生成后交给下游精排与重排。两个系统只有 SID 生成模型不同,因此比较隔离出了 HF-SID 本身的贡献。 一周 A/B,覆盖餐饮、生活服务、景点三个代表性场景。
| Online Metrics | WinRate | PV_CTR | UV_CTR | PV_CVR | UV_CVR |
|---|---|---|---|---|---|
| Restaurant | +0.35% | +0.24% | +0.14% | +5.89% | +5.63% |
| Life Services | +1.54% | +0.79% | +0.23% | +2.81% | +2.68% |
| Tourist Attraction | +0.87% | +0.97% | +0.50% | +11.51% | +9.79% |
| Ave. Imp. | +0.92% | +0.67% | +0.29% | +6.74% | +6.03% |
每个场景的每个指标都为正,且增益集中在保真度起决定作用的地方:三场景平均 PV_CVR +6.74%、UV_CVR +6.03%,比对应的 CTR 增益(+0.67% / +0.29%)高一个数量级。论文对这个不对称给出的解释很有说服力:点击主要由 POI 标题、封面图这类表层内容驱动,而转化取决于这个 POI 是否真的可达、是否真的属于用户想要的类目 —— 而这恰恰是高保真标识符所保住的东西。景点场景收益最大(PV_CVR +11.51%),因为它同时具备最宽的候选地理跨度与单个景区内密集共址的 POI。作者特别强调:这些增益是在一个本来就已经地理感知的生产系统之上取得的。
Case Study(附录 A.1)¶
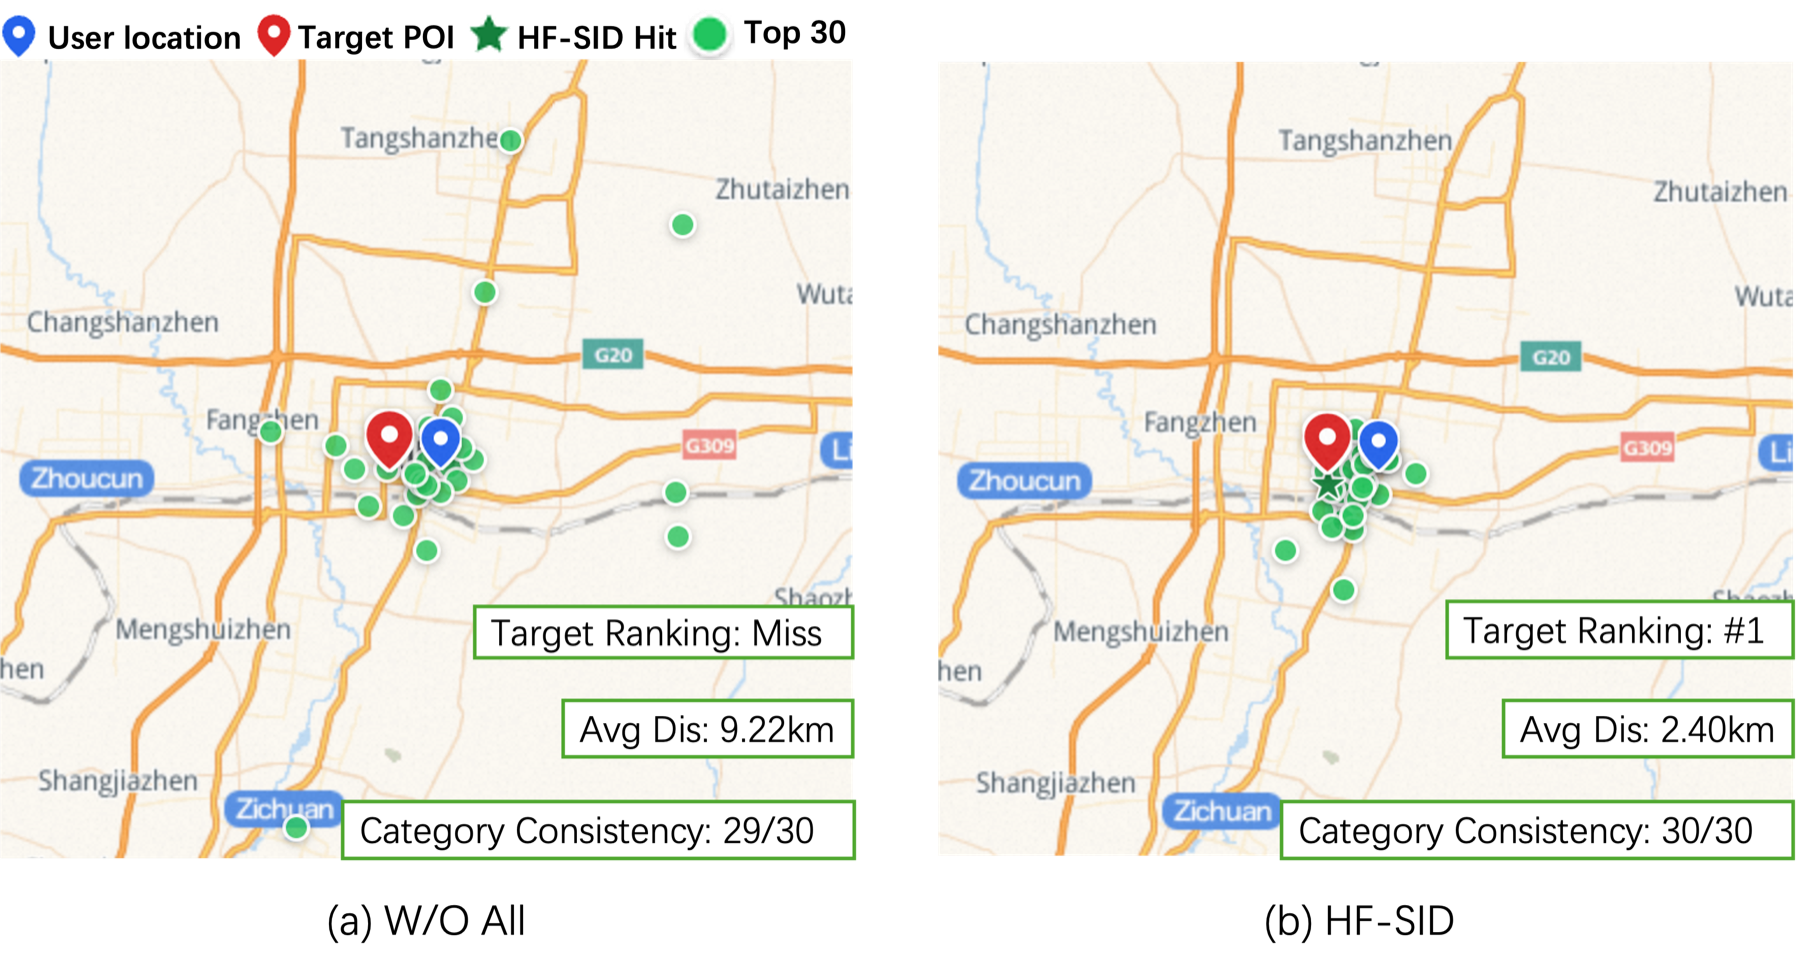
同一用户上下文下对比 baseline 与 HF-SID 生成的候选:baseline 的候选类目部分一致但地理上四散 —— top-30 中有 29 个与目标同类目,但与目标的平均距离达到 9.22 km,且漏掉了 ground-truth 目标;HF-SID 把候选集中在目标区域,平均距离降到 2.40 km,类目一致性提升到 30/30,并把目标 POI 排在第一位。
核心贡献总结¶
- 把 SID 的失效点从"码本设计"重新定位到"嵌入保真度",并给出可证伪的实验形式:三个组件全关就退化成朴素 RQ-KMeans,26.77 个点的 Hit@200 差距全部来自表征。
- 统一数值表征:进位连续的极坐标分解(式 2–4)+ field embedding + 升维数值编码器 + 多任务可解码性约束(式 7–10),把一个标量变成 LLM 输入空间里的一个 token,同时解决坐标与异质属性两类问题。
- 3D 笛卡尔坐标变换:用一个几何上正确的连续空间替换硬网格边界,使欧氏距离在真实距离上单调、在城市尺度近似线性,并顺带解决 180° 经线断裂。
- Type Embedding:常量类型偏移在保留类内量级关系的同时把不同属性平移到不同区域,这是"同一个 0.5 在评分和到访量上意义不同"的最小可行解。
- 只在最后一层做结构对比:显式承认最后一层不再是严格残差量化,用重建误差换判别力;同时保证粗层地理信号不被污染 —— 这是全文最有迁移价值的工程判断之一。
- 零解码成本增益:3-token SID,相对朴素量化 baseline 不增加任何解码步数,却击败了 6-token 的 GenPOI。
- 真部署 + 数据集释出:高德首页 POI 推荐上线,三场景一周 A/B 平均 PV_CVR +6.74%;释出 AMap-S。
与已归档相关工作的对比¶
Pro-GEO Pro-GEO: Birds of a Feather Cluster Nearby(2026-04-25)¶
关系:显式引用,作为 Table 2 / Table 5 baseline 给出完整指标,但机制层仅一句带过("the geo-centroid Geo-RoPE frame of Pro-GEO")· 已加载对方精读
- 共同关注的问题:两篇诊断的现象完全一致 —— 纯文本驱动的 SID 会把"语义相似但地理遥远"的 POI 编到同一个码上。Pro-GEO 在某本地生活平台上量化出"超过 50% 的 POI 与同 SID 下其他 POI 相距 >40 km",HF-SID 在 AMap-L 上量化出朴素 RQ-KMeans 的 Avg.Dist 6.07 km、p95 达 15.21 km。两者都把这归因为语义信号维度高、方差大,几何信号被淹没,而非模型容量不足。
- 相近的技术骨架:两者都保持 TIGER / RQ-Kmeans 式的三层 SID 结构不变,都只改造某一层的残差来承载额外信号,都不引入新的量化算法。Pro-GEO 用余弦相似度聚类 + 正交投影去冗余得到前两层,然后把二阶残差 $\mathbf{r}_p^{(2)}$ 经 geo-centroid 局部极坐标 $(d_p,\sigma_p)$ 与 Geo-RoPE 前向/反向旋转变换后再做 K-means 得第三层;HF-SID 同样把二阶残差 $\mathbf{R}_p^{(2)}$ 做线性投影后再量化第三层。
- 本文的差异与推进(关键的镜像对称):两者在"第三层该装什么"上给出了完全相反的答案。 Pro-GEO 把地理放进第三层(事后注入,前两层留给语义);HF-SID 把地理放进前两层(经由表征,量化前就已具备),把结构 tag 放进第三层,并明确论证"把对比目标放到粗层会与主导检索的地理信号竞争"。这个对调的直接后果是可度量的:Pro-GEO 的地理信号只能影响三个 token 中最细的一个,无法塑造 beam search 所遍历的前缀树;HF-SID 的地理信号塑造了整棵前缀树 —— 消融里 w/o Geo 掉 15.88% 正是这一点的代价。数字上,AMap-L 上 Pro-GEO Avg.Dist 7.02 km / Hit@200 65.69%,HF-SID 0.25 km / 81.24%。
- 可比的方法 / 实验差异:Pro-GEO 的 Geo-RoPE 有一个 HF-SID 没有的精巧性质 —— 余弦距离变化 $\Delta D_{\cos}\propto\sin^2(\Delta\sigma/2)\times\text{语义相似度}$ 是乘积形式,因此语义不相似的 POI 不会被地理信号污染;HF-SID 走的是相反策略,让地理主导粗层,靠"只在最后一层做对比"来隔离结构信号。另外,公开数据集上 HF-SID 报告的 Pro-GEO 与 RQ-KMeans 的 Hit@5(NYC 53.00% / 41.23%,TKY 49.27% / 30.00%)与本库中 Pro-GEO 原文的记录完全一致,说明这部分是转录而非重跑,交叉可信度较高;而 AMap-L / AMap-S 上的 Pro-GEO 数字则是 HF-SID 团队重实现的。
ChronoID ChronoID: Infusing Explicit Temporal Signals into Semantic IDs(2026-06-12,University of Rochester / Meta MRS / MBZUAI)¶
关系:独立并发(HF-SID 未引用 ChronoID,两者殊途同归又正面撞车)· 已加载对方精读
- 共同关注的问题:两篇的 root cause 陈述可以互换 —— SID 对某一类"非文本的连续信号"是盲的,而这个盲区在量化那一刻被永久固化。ChronoID 说 SID 是 time-agnostic 的:时间只在数据采样与序列位置层面被用到,"被建模在序列和优化层面,却被排除在语义抽象本身之外";HF-SID 说 SID 是 geo-/numeracy-agnostic 的:坐标与量纲只在文本序列化层面出现,在嵌入里已被 tokenizer 切碎。两者都把这个盲区上升为"标识符成形之前"的问题。
- 相近的技术骨架:流程图可以完全叠合 —— 专用编码器编码额外信号 → 与 item 表征融合 → 量化成 SID。ChronoID 用正弦位置编码把时间戳编成 $\mathbf{h}_t$,HF-SID 用极坐标分解 + MLP 把标量编成 $\mathbf{h}$;两者都把"在哪一步融合"当成核心设计轴来正面研究(ChronoID 用 early/late fusion 与 residual/parallel quantization 两个正交维度做网格实验,HF-SID 用 w/o Geo / w/o Num / w/o Struct 的留一消融)。
- 本文的差异与推进(结论正面相反):在同一根轴上,两篇给出了相反的经验答案。 ChronoID 的实证结论是晚融合优于早融合(时间单独走 VQ-VAE,量化后在 SID 层面拼一个 [ID4])且并行量化优于残差量化;HF-SID 则把融合推到尽可能早(在 LLM 输入嵌入层替换
[NUM]位置,再经 CPT 内化),并保留三层残差量化、明确依赖层级分工,还专门批评"追加 token 拉长标识符"的做法抬高自回归解码成本 —— 而 ChronoID 的晚融合恰恰要多一个 token。 - 可比的方法 / 实验差异(一个可检验的调和假设):两者被注入的信号性质不同,很可能各自都对。ChronoID 的时间是逐次交互变化的外生量(同一 item 在不同时间应当有不同 SID),把它塞进共享的语义残差里必然与 item 身份互相干扰,因此分开量化更合理;HF-SID 的地理与数值属性是 item 固有的静态属性,与"这个 POI 是什么"同生命周期,且地理在 LBS 是主导排序信号,必须占据粗层前缀树。判据可以概括为:被注入的信号是否与 item 身份同生命周期 —— 是则早融合并进粗层,否则晚融合另起码本。 此外规模差异巨大:ChronoID 在 Amazon Industrial / Office、Mercari 上(学术规模,且其 arXiv 版本缺附录,多条结论无法核验),HF-SID 在 48.1M POI 的工业数据集与线上 A/B 上。
AMBER AMBER: An Event is Worth One Token(2026-08-26,AI at Meta)¶
关系:独立并发(相隔 5 天,互不引用)· 已加载对方精读
- 共同关注的问题:两篇给出了几乎逐字相同的 root cause。AMBER:不是模型容量不够,而是输入表征里根本没有那些信息,模型 scaling 无法恢复输入表征中缺失的信息;HF-SID:SID 是唯一通道,它没能保住的东西在解码时不可恢复,"下游任何网格、旋转或聚类都无法恢复一个从来就不连续的值"。两者都进一步指出这种损失会沿流水线复合放大(AMBER:每个位置都是下一个位置的上下文;HF-SID:前两层塑造整棵前缀树,粗层坏了之后每个解码决策都被污染)。
- 相近的技术骨架:都用一个专用编码器把异构非文本信号打包成语言模型输入空间里的一个稠密 token,绕开文本序列化,并且都坚持不加长序列 / 不加长标识符。AMBER 的打包单位是"一个事件"(数百个 user/item/context/outcome 特征 → 1 个 Event Token);HF-SID 的打包单位是"一个标量"(一个数值无论几位数字都只占一个
[NUM]位置,多位数字不再展开成多个子 token)。 - 本文的差异与推进(赌注完全相反):AMBER 押注根本不需要码本,HF-SID 押注码本必须留下、缺的是保真度。 AMBER 的 Table 4 直接判 SID 冗余 —— 从完整 AMBER 中单独去掉 SID 是中性的,只留 SID + outcome 则与完整 AMBER 差 2.40% NE,说明 SID 携带的信息几乎已被学到的 item 嵌入覆盖;它因此用连续稠密 token 对齐下游,代价是引入表征漂移(需要跨检查点的对抗稳定)与缓存存储。HF-SID 则把"SID 是唯一通道"当作不可动摇的前提,在 3-token 离散标识符内部把保真度补回来。
- 可比的方法 / 实验差异(分歧的真正来源是召回方式,不是谁对谁错):AMBER 的召回是嵌入 + ANN,本来就不需要可自回归解码的离散 ID;HF-SID 的召回是前缀树约束 beam search,离散标识符是架构前提而非选择。因此"SID 是否冗余"这个问题在两篇里根本不是同一个问题。另外两者优化的成本项也不同:AMBER 攻的是 serving 侧特征物化的 CPU 成本(把 tokenization 异步化 + 缓存),HF-SID 攻的是自回归解码步数(3 token 打赢 6 token 的 GenPOI),彼此正交。最后,两者都没有共同数据点 —— AMBER 全部指标来自 Meta 内部 PB 级日志(NE / Soft Recall),HF-SID 来自高德 AMap-L/S 与 Foursquare(Hit@K)。
讨论与局限性¶
在这轮 Semantic ID 路线之争里,HF-SID 站在哪¶
把 2026 年 8 月下旬这批 SID 论文放在一起,可以看到一个非常清晰的"病根定位"分歧谱系,而 HF-SID(08-31)是最晚出场、也是唯一一个把病根定在量化器之外的:
| 论文 | 日期 | 病根定在哪 | 处方 | 与 HF-SID 的关系 |
|---|---|---|---|---|
| Dynamic PV-S2 Dynamic PV-S2(快手) | 08-21 | 层级结构本身:SID2 条件利用率仅 2.48%,深度换容量是结构性浪费 | 砍掉一层语义码,换单级大码本 | 互斥(HF-SID 主动依赖层级分工) |
| Tlow Tlow(清华+腾讯) | 08-25 | 嵌入而非量化器:语义嵌入维度相关、各向异性锥形 | 可逆流把嵌入掰成标准正态,离开残差量化改并行 PQ | 半同构、处方互斥 |
| PRQ-KMeans PRQ-KMeans(快手) | 08-25 | 层间传递算子:全码字相减留下 residual carryover(L1/L2 各 9.89%/10.17%) | 正交约束投影残差,留在层级里修 | 互斥(HF-SID 一行量化代码都没改) |
| AMBER AMBER(Meta) | 08-26 | 输入表征的信息密度被 serving 成本压死 | 放弃码本,改用连续稠密 Event Token | 同诊断、反赌注(见上节) |
| HF-SID(高德) | 08-31 | 送进量化器的那个嵌入:tokenizer 把坐标切碎、异质量纲共享一个数值子空间、层级关系不在表层文本里 | 不动量化算法,在表征层面恢复三重保真度 | — |
HF-SID 的诊断可以用一句话概括:病根既不在码本构造,也不在层间算子,更不在层级结构,而在文本序列化那一步 —— 信息在进入嵌入之前就已经丢了。 它的处方是唯一一个"量化器零改动"的:三层 K-means 残差量化、码本大小、SID 长度全部与朴素 baseline 相同,Table 3 的 w/o All 就是朴素 RQ-KMeans,54.47% → 81.24% 的 26.77 个点全部由表征贡献。
逐一核对互斥性:
- 与 PRQ-KMeans 直接互斥。PRQ 把 root cause 定在残差传递算子上并去换算子;HF-SID 的实验是对这个定位的一个反例 —— 在算子完全不变的前提下,把表征换掉就能取得远大于算子改进的收益。但要诚实地反过来说:HF-SID 从未做过"表征固定、只换算子"的实验,两者测的是不同的边际,严格说并未互相证伪,只是把有限的工程预算指向了相反的方向。
- 与 Dynamic PV-S2 直接互斥。PV-S2 认为层级是原罪(条件稀疏),砍层换单级大码本;HF-SID 反而把层级当资产:L1–L2 承载地理与数值语义、L3 承载细粒度 tag,并明确论证"把对比目标放到粗层会与地理信号竞争"。可调和之处在于前提不同:PV-S2 的条件稀疏统计来自快手短视频的纯语义码本,那里不存在一个外生的真实层级可以往上挂;LBS 天然有"地理 → 商圈 → 两级 tag"这条外生层级链。层级是资产还是负债,取决于有没有一个真实的层级结构可编码 —— 这是本文与 PV-S2 之间最有价值的可检验分歧。
- 与 Tlow 是"同诊断、不同上游"。Tlow 的元判断与 HF-SID 完全一致(病在嵌入不在量化器),但 Tlow 的"上游"是嵌入的分布,处方是对给定嵌入做保信息的可逆流变换;HF-SID 的"上游"是嵌入的输入,处方是往嵌入里塞进原本不存在的信息。按 HF-SID 的逻辑,流变换救不了 LBS:可逆双射不增加信息,坐标精度在 tokenizer 切词那一刻就不在嵌入里了,把分布掰成各向同性也变不出来。反过来 Tlow 会指出 HF-SID 仍绑定串行解码(3 步自回归),拿不到并行 PQ 的解码收益。两者的赌注可以并存,但不可能同时是"主要矛盾"。
- 与 AMBER 是"同诊断、反赌注",且分歧的真正来源是召回方式(ANN vs 前缀树 beam search),详见上一节。
LBS 场景的不可迁移边界¶
必须如实标注:HF-SID 最赚钱的那部分结论大概率不能迁移到电商 / 短视频。
- 地理是一个在 LBS 里外生、连续、可度量、且与业务转化直接因果相关的信号 —— 一个 35 km 外的餐厅不是"排序靠后",而是"根本不可用"。电商与短视频里没有任何一个属性具备这四条性质的组合。HF-SID 的核心增益(Avg.Dist −95.9%、CVR +6.74%)全部锚定在地理可达性上,消融里地理通路也是最大项(−15.88%)。
- 可迁移的部分是数值通路与结构通路:电商有价格 / 销量 / 评分,平台通常也维护多级类目体系,因此极坐标数值表示 + Type Embedding + 最后一层结构对比这套是可以搬的。但这两项在 AMap-L 上的贡献是 −4.32% 与 −11.52%,与地理的 −15.88% 相比量级不同,搬过去之后剩下的天花板要低得多。
- 论文自己的公开数据集实验反向印证了这一点:NYC / TKY 只有坐标、只能跑 Geo-CPT,Avg.Dist 降幅就从 −95.9% 缩到 −42.7%,作者归因为 POI 数量少导致簇内空间跨度更大。同理,一个没有强地理约束的场景,能被"保真度"回收的空间会小得多。
- 另一个隐含前提:AMap 拥有平台标注的两级 tag 体系与商圈划分。Structure-based Contrastive Learning 的正例定义完全依赖这份标注资产,公开数据集上直接跳过了该组件,因此它 −11.52% 的贡献目前只有单一数据源的自报证据。
值得借鉴的设计¶
- "一个标量一个 token":
[NUM]占位 + 冻结数值编码器 + 类型偏移,是解决"LLM 读不准数字"这个通用痛点的一个干净的最小方案,与推荐无关也可复用。 - 进位连续的数值编码:$\bar d_i=(|x|/10^i)\bmod 10$ 让整数进位连续、$(\cos 2\pi f,\sin 2\pi f)$ 让小数进位连续 —— 两个很小的技巧,却是"数值邻近 ⇒ 几何邻近"的关键。
- 升维重建作为表征约束:编码器升维,所以重建不是压缩瓶颈,而是强制信息按方向线性可解码的排布约束;同一组解码头之后能直接接到 LLM 输出上,形成闭环。
- 常量类型偏移:既保类内序,又分离类间空间,是"同一个 0.5 意义不同"的最小可行解,比给每个属性单独训一个投影便宜得多。
- 最后一层可以不是严格残差量化:论文明确承认第三层在投影空间操作、不再重建 $\mathbf{R}_p^{(2)}$,理由是"SID 只用于生成、从不用于重建,所以可以拿重建误差换判别力"。这是一条对整个 SID 领域都适用的松绑,很多方法还在为重建误差做无谓的妥协。
- 把"零解码成本"当作硬约束:所有机制都必须落在表征侧,不许加 token。这条自我约束直接决定了它与 GenPOI(6 token)、ChronoID(晚融合多一个 token)的路线分野。
局限与存疑¶
- AMap-S 上 ICR 反而不如多数 baseline(59.79%,低于 RQ-KMeans 61.34%、Cosine-RQ 63.68%、Pro-GEO 64.64%、GenPOI 65.97%),而论文只在 AMap-L 上宣称"在 Avg.Dist < 1 km 的方法中 ICR 最高",对 AMap-S 上的 ICR 退步只字未提。这意味着在小数据集上,HF-SID 同样落入了它用来批评 GeoGR 的那个张力:地理紧凑度与码字唯一性此消彼长。
- p90 < Avg.Dist 的口径问题:AMap-L 上 RQ-KMeans 的 Avg.Dist 6.07 km 但 p90 只有 2.66 km(HF-SID 0.25 vs 0.12 km),说明分布极端重尾。论文把 p90/p95 描述为"top 90%/95% POI 到 SID 质心的最大距离",但未说明是在 POI 层面还是簇层面聚合,读者难以复现该口径。
- 消融并不正交:w/o Geo 同时移除笛卡尔变换、坐标上的数值编码器与 Geo-CPT 三件事,因此 −15.88% 无法拆分成"表示"与"CPT 对齐"各自的贡献;w/o Num 同样捆绑三件事。论文既没有单独消融 Type Embedding,也没有验证被明确论证过的 "Geo-CPT 先、Num-CPT 后" 这个顺序。
- 冻结数值编码器的代价未评估:$\mathcal{E}(\cdot)$ 预训练后冻结,其预训练分布与 POI 属性真实分布是否匹配没有讨论;$N=9$ 位整数只能覆盖到 $10^9$ 量级,米制笛卡尔坐标(最大约 $6.4\times10^6$ 米)没问题,但 Table 4 里 baseline 出现过 $10^{11}$ 量级的属性 Std,若真实属性值超过 $10^9$ 就会溢出表示。
- AMap-S 上的 baseline 全部由本文重实现,是自报对比且尚无第三方复现;相对可信的是 NYC/TKY,那里 Pro-GEO 与 RQ-KMeans 的 Hit@5 与本库中 Pro-GEO 原文记录完全一致(转录而非重跑),但公开数据集上只覆盖了 4 个 baseline,且 GeoGR / GenPOI 缺席。
- 线上 A/B 的对照组未点名:只说"一个先前部署的、已经把地理编进 SID 的生成式检索方法";从作者列表与引用推断是 GeoGR(同团队),但这是推断而非论文明述。
- 工程细节缺失:未报告完整 SID 的碰撞率与冲突处理策略、POI 增删频繁场景下的增量 SID 分配(LBS 的 POI 生命周期比电商 item 更动荡)、以及 CPT 的实际算力开销(只说 1 epoch / 64×A100)。
- AMap-S 的公开性尚待验证:论文声称释出,但正文未给下载地址或许可协议说明,只在脚注给出 amap.com。
工业落地价值¶
- 部署位置:高德首页 POI 推荐的生成式召回链路,替换已上线的地理感知生成式检索系统;prompt 组装、beam search、下游精排/重排全部不变,只换 SID 生成模型,因此 A/B 严格隔离了 SID 本身的贡献。
- 成本:3-token SID,相对朴素量化 baseline 零额外解码步数,相对被它超越的 6-token GenPOI 是解码步数减半。保真度的代价被完全吸收到离线侧(数值编码器预训练 + 两阶段 CPT + 一次对比精修),线上一分不多花 —— 这是对工业界最直接的卖点。
- 收益:一周三场景 A/B,WinRate +0.92%、PV_CTR +0.67%、UV_CTR +0.29%、PV_CVR +6.74%、UV_CVR +6.03%;景点场景 PV_CVR 达 +11.51%。CVR 与 CTR 之间一个数量级的落差本身就是"保真度假说"的一次自然实验:表层内容驱动点击,可达性与类目正确性驱动转化。