DuELRec:用「域门控双专家」把 item 级协同信号灌回 LLM,治跨域序列推荐的负迁移¶
A Dual-Expert Strategy Integrating LLMs to Mitigate Negative Transfer in Cross-Domain Sequential Recommendation Hyeongjun Yun(SK Telecom, KAIST)、Kihyuk Song(SK Telecom)、Jaegul Choo(KAIST)、Chung Park*(SK Telecom,通讯作者) CIKM '26 · arXiv:2608.23131v1 · 2026-08-24 · 代码与附录:https://github.com/cpark88/DuELRec
一句话:论文发现 LLM-based 推荐器(LLMRec)在跨域序列推荐(CDSR)里比 ID-based 推荐器(IDRec)负迁移更严重,根因是 LLM 只建模 item 文本的 subtoken 级自回归模式、丢掉了 item 级协同信号;DuELRec 在冻结 LLM 骨干之上挂两个 transformer 专家(同域 / 跨域两种块级因果掩码),用 item 级门控自适应融合,并配一个单域+跨域双池负采样的 token-to-item 对比学习目标,把协同信号灌回 LLM。十个域、26 个 baseline 全面验证,并在 SK Telecom 个人助手 App 上线,CTR 0.90% → 1.33%(相对 +47.6%,$p<0.01$)。
研究动机与背景¶
CDSR 的两条技术路线¶
真实推荐系统里,不同业务域(电商、短视频、通话、导航……)需要对用户的多样兴趣做差异化理解。Cross-Domain Sequential Recommendation(CDSR) 用用户跨多个域的历史交互序列预测下一个交互 item,让一个模型就能泛化到用户的多种上下文,避免为每个域各建一个 SDSR(Single-Domain Sequential Recommendation)模型。
CDSR 有两类代表性做法:
- IDRec:把 item 转成整数 ID 并建 embedding 表(CGRec、SyNCRec 等)。ID 只是索引,不含语义信息;新域/新 item 通常需要从头重训。
- LLMRec:把 item 转成文本表示喂进 LLM,生成或检索推荐 item 的文本描述(UniSRec、RecFormer、Lite-LLMRec 等)。LLMRec 能吸收 item 文本特征与 LLM 的开放世界知识,天然可扩展到新域,在冷启动和跨域场景表现有潜力。
论文指认的结构性瓶颈¶
论文把 LLMRec 在 CDSR 上的失败拆成两层:
- LLMRec 抓不住 item 级协同信号——即跨域序列中 item 与 item、user 与 item 之间的共现模式。这类模型优先建模 item 标题/描述中 subtoken 的自回归模式,重度依赖文本信息,而不像 IDRec 那样直接建模序列化的 item 模式。
- 错位信号的迁移在 CDSR 中格外有害。CDSR 天生鼓励域间知识交换,于是"未能准确反映 item 级协同信号的自回归 subtoken 模式"会跨域产生有害干扰,导致所有域的性能一起退化——这就是 negative transfer(负迁移)。用论文自己的话说:负迁移是这种有害干扰的直接后果。
一张图坐实的实证证据¶
作者做了一个干净的对照实验:在 Amazon 上比较「只用 Books 训练」与「Books + 另一个域联合训练」的性能差。
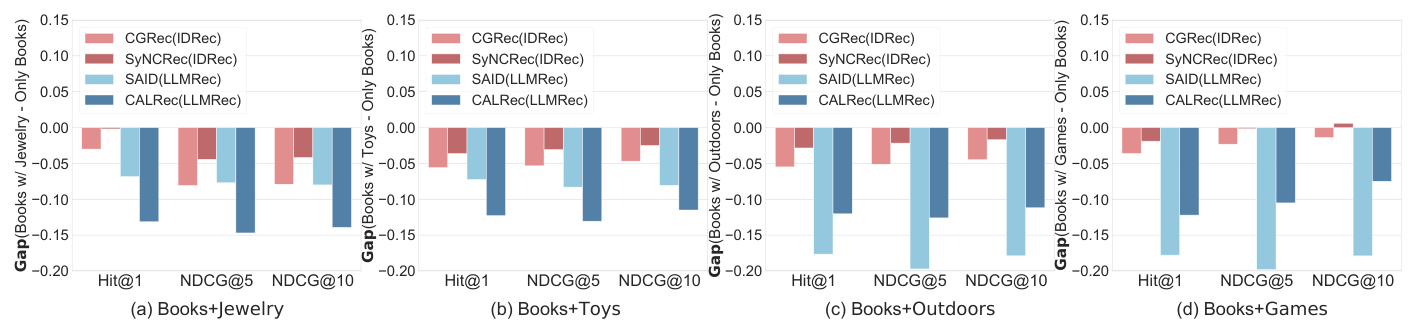
四个配对(Books+Jewelry / +Toys / +Outdoors / +Games)、三个指标(Hit@1、NDCG@5、NDCG@10)上,LLMRec(SAID、CALRec)的退化幅度明显大于 IDRec(CGRec、SyNCRec)。这直接支撑了论文的核心论断:LLMRec 因为无法准确捕捉 item 级协同信号,在跨域联合训练时迁移的是"错位的知识"。
论文自陈的定位¶
作者声称 DuELRec 是第一个纯文本、ID-free、且能同时处理三个以上域的 LLM-based CDSR:既往工作通常同时用 ID 和文本特征,且局限在两两配对的双域设定。因此 DuELRec 不需要为每个域各配一套 ID 编码查找表和域专属模型,单模型即可服务跨域应用。
问题定义与符号¶
Definition 1(Cross-Domain):域集合 $\mathcal{D} = \{A, B, C, \dots\}$,且 $|\mathcal{D}| \ge 3$。域 $d \in \mathcal{D}$ 内的 item 集合记为 $\mathcal{V}_d$,全域 item 集合 $\mathcal{V} = \cup_{d \in \mathcal{D}} \mathcal{V}_d$。因为本方法是在预定义候选集 $\mathcal{V}$ 上按相似度检索,所以规避了生成式 LLM 推荐常见的幻觉问题(附录 H 有专门讨论)。
Definition 2(Cross-Domain Sequence):按时间序排列的跨域序列 $X = \{x_1^C, x_2^A, \dots, x_n^B\}$,$n$ 为序列长度。每个 item $x$ 有 title、description、域名等属性,把这些描述文本拼接起来作为 $x$ 的文本表示(例如 iron man - action movie)。
Problem Statement:给定截至时刻 $t$ 的历史跨域序列 $X_{1:t}$,预测下一个 item $x_{t+1}^d$:
$$\arg\max_{x_{t+1}^d \in \mathcal{V}_d} P\left(x_{t+1}^d \mid X_{1:t}\right) \tag{1}$$
其中 $P(x_{t+1}^d \mid X_{1:t})$ 表示在给定 item 序列 $X_{1:t}$ 下,域 $d$ 内目标 item $x_{t+1}^d$ 被交互的似然。
核心方法:DuELRec¶
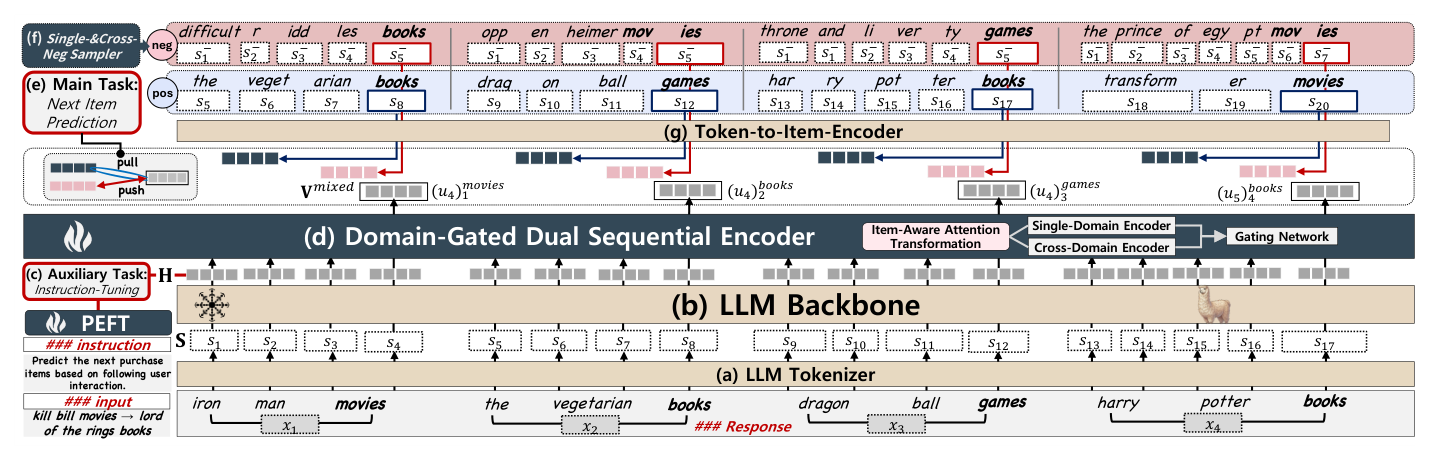
整体由七块组成:(a) LLM Tokenizer、(b) LLM Backbone、(c) 辅助任务 Instruction-Tuning、(d) Domain-Gated Dual Sequential Encoder、(e) 主任务 Next Item Prediction、(f) 单域&跨域负采样器、(g) Token-to-Item Encoder。
1. LLM Tokenizer(Fig. 2a)¶
模型输入是跨域用户序列 $X$ 的文本表示,喂进 tokenizer $\mathcal{I}$ 得到 subtoken 级序列:
$$S = \mathcal{I}(X) = \{(s_1, \dots, s_{l_{x_1}})_1^C, (s_1, \dots, s_{l_{x_2}})_2^A, \dots, (s_1, \dots, s_{l_{x_n}})_n^B\} \tag{2}$$
其中 $l_x$ 是 item $x$ 被切出的 subtoken 数,subtoken 序列总长 $L = \sum_{i=1}^{n} l_{x_i}$。再过 embedding 层得到 $\mathbf{E} \in \mathbb{R}^{L \times m}$:
$$\mathbf{E} = \mathrm{emb}(S) = \{(e_1, \dots, e_{l_{x_1}})_1^C, \dots, (e_1, \dots, e_{l_{x_n}})_n^B\} \tag{3}$$
$m$ 是 embedding 维度。Fig. 2 的例子里,4 个 item(iron man movies / vegetarian books / the dragon ball games / harry potter books)被切成 $L=17$ 个 subtoken——这个 17 : 4 的比例正是问题的量化形态:LLM 在 17 个 subtoken 上做自回归,而推荐目标定义在 4 个 item 上。
2. LLM Backbone(Fig. 2b)¶
$$\mathbf{H} = \mathrm{LLM}(\mathbf{E}) = \{(h_1, \dots, h_{l_{x_1}})_1^C, \dots, (h_1, \dots, h_{l_{x_n}})_n^B\} \tag{4}$$
$\mathrm{LLM}$ 指输出投影层(LM head)之前的骨干,$\mathbf{H} \in \mathbb{R}^{L \times m}$。
3. Instruction-Tuning(辅助任务,Fig. 2c)¶
这一步的目标不是让 LLM 生成推荐 item,而是让 LLM 的表征空间围绕 user-item 交互模式重新组织。用 Alpaca 模板 + PEFT(LoRA)做指令微调:
$$\mathcal{L}_{inst}(\theta, \Phi) = -\frac{1}{L} \sum_{i=1}^{L} \log P_{\theta, \Phi}(s_{i+1} \mid s_{<i+1}), \quad P_{\theta,\Phi}(s_{i+1} \mid s_{<i+1}) = \mathrm{softmax}\,\mathrm{LM\ head}(h_{i+1}) \tag{5}$$
$\theta$ 是被冻结的骨干参数,$\Phi$ 是 PEFT 引入的参数(如 LoRA 的低秩矩阵)。指令模板形如「### instruction: Predict the next purchase items based on following user interaction. ### input: kill bill movies → lord of the rings books ### Response: …」。作者强调:指令微调后的 LLM 不只是文本编码器,而是一个任务适配过的组件,对最终推荐性能有实质贡献(§5.7 验证)。
4. Domain-Gated Dual Experts(Fig. 2d)——本文核心¶
作者的出发点:像既往 LLMRec 那样只让 LLM 学 subtoken 级序列模式,不足以捕捉 item 级共现。于是在 LLM 骨干之上加一个 transformer-based 专家模块。
4.1 Item-Aware Attention Transformation¶
关键洞察对齐了两种协同信号的性质差异:
- 单域序列的协同信号反映该域的纯粹特性,不受其他域干扰,因此不会经历负迁移——但也放弃了跨域正迁移的潜在收益;
- 跨域序列的协同信号同时被正迁移和负迁移影响。
所以最优用法是同时利用两种信号。为此构造两个 transformer 专家,各自施加不同的 item-aware attention transformation:
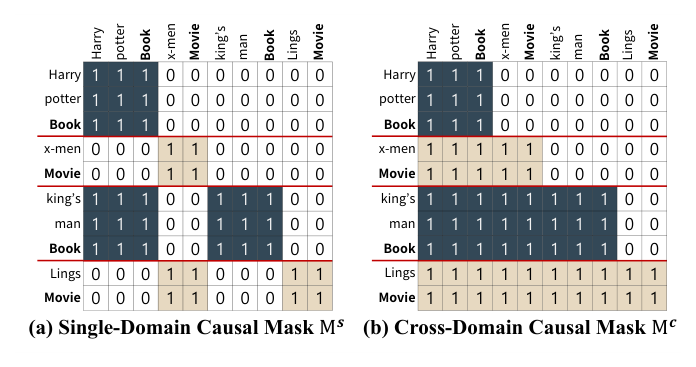
- 单域因果掩码 $\mathbf{M}_s$(Fig. 3a):item 级注意力只在同域 item 之间做因果连接;item 内部所有 subtoken 之间全连接(每个 subtoken 可以 attend 到同 item 的任意 subtoken)。
- 跨域因果掩码 $\mathbf{M}_c$(Fig. 3b):注意力施加到所有 item,但仍是 item 级因果,保证跨域的时序依赖被保留。
Fig. 3 的例子(Harry potter/Book → x-men/Movie → king's man/Book → Lings/Movie)清楚展示了两个掩码的差别:$\mathbf{M}_s$ 里 x-men 只能看到 Movie 域的历史,$\mathbf{M}_c$ 里它能看到所有更早的 item。这里的设计要点是:掩码是"块级(block-level)"的,块的边界由 item 而非 token 决定——这就是把 LLM 的注意力范围从 token 粒度强行对齐到推荐目标的 item 粒度。
两个专家分别吃 $\mathbf{H}$ 和对应掩码:
$$ \begin{aligned} \mathbf{U}_s &= \mathrm{EXPERT}_s(\mathbf{H}, \mathbf{M}_s) = \{(u_1, \dots, u_{l_{x_1}})_1^C, \dots, (u_1, \dots, u_{l_{x_n}})_n^B\}_s \\ \mathbf{U}_c &= \mathrm{EXPERT}_c(\mathbf{H}, \mathbf{M}_c) = \{(u_1, \dots, u_{l_{x_1}})_1^C, \dots, (u_1, \dots, u_{l_{x_n}})_n^B\}_c \end{aligned} \tag{6} $$
$\mathbf{U}_s, \mathbf{U}_c \in \mathbb{R}^{L \times m}$。取每个 item 的最后一个 subtoken 表征作为该 item 的 item 级表征(它同时携带了该 item 的语义信息与协同信号),得到 $\mathbf{V}_s, \mathbf{V}_c \in \mathbb{R}^{n \times m}$:
$$ \begin{aligned} \mathbf{V}_s &= \{(u_{l_{x_1}})_1^C, (u_{l_{x_2}})_2^A, \dots, (u_{l_{x_n}})_n^B\}_s \\ \mathbf{V}_c &= \{(u_{l_{x_1}})_1^C, (u_{l_{x_2}})_2^A, \dots, (u_{l_{x_n}})_n^B\}_c \end{aligned} \tag{7} $$
序列长度在这一步从 $L$ 降到 $n$——这个降维后面在时间复杂度分析里成为效率优势的来源之一。
4.2 Item-Wise Gating Network¶
门控网络 $g$ 在 item 粒度上计算 $\mathbf{V}_s$ 与 $\mathbf{V}_c$ 的最优加权,让模型用单域信号去调节、抑制跨域交互带来的负迁移:
$$ \begin{aligned} \mathbf{V}_{mixed} &= g([\mathbf{V}_s + \mathbf{V}_c])[:, 0]\,\mathbf{V}_s + g([\mathbf{V}_s + \mathbf{V}_c])[:, 1]\,\mathbf{V}_c \\ &= \{(u_{l_{x_1}})_1^C, (u_{l_{x_2}})_2^A, \dots, (u_{l_{x_n}})_n^B\}_{mixed} \\ g(\mathbf{Y}) &= \mathrm{softmax}\,W_1\mathbf{Y} + \left(\mathrm{StdNorm} * \mathrm{SoftPlus}(W_2\mathbf{Y})\right) \end{aligned} \tag{8} $$
其中 $\mathrm{StdNorm}$ 是标准正态噪声(沿用 Shazeer 等的 sparsely-gated MoE 里的 noisy gating),$\mathrm{SoftPlus}$ 是激活函数,$W_1, W_2 \in \mathbb{R}^{m \times 2}$ 是可训练全连接层。门控输出形状为 $\mathbb{R}^{n \times 2}$,逐 item 平衡 $\mathbf{V}_s$ 与 $\mathbf{V}_c$。
4.3 门控为什么能压住负迁移:偏差-方差分解¶
论文给了一个简短但完整的理论论证。设 $\mathbf{s}_i$ 为 item 的真实表征:
- 单域专家给出无偏估计 $\mathbf{v}_i^s = \mathbf{s}_i + \boldsymbol{\varepsilon}_i^s$,方差 $\sigma_s^2$;
- 跨域专家的输出受负迁移影响,$\mathbf{v}_i^c = \mathbf{s}_i + \mathbf{b}_i + \boldsymbol{\varepsilon}_i^c$,其中 $\mathbf{b}_i$ 是跨域干扰项(bias),噪声方差 $\sigma_c^2$。
混合表征 $\mathbf{v}_i^{mixed} = g_i \mathbf{v}_i^s + (1-g_i)\mathbf{v}_i^c$ 的期望平方误差:
$$\mathbb{E}\left[\|\mathbf{v}_i^{mixed} - \mathbf{s}_i\|^2\right] = g_i^2\sigma_s^2 + (1-g_i)^2\left(\|\mathbf{b}_i\|^2 + \sigma_c^2\right) \tag{9}$$
令 $A_i := \|\mathbf{b}_i\|^2 + \sigma_c^2$,$f(g_i) := g_i^2\sigma_s^2 + (1-g_i)^2 A_i$。由 $\frac{d^2 f}{d g_i^2} = 2(\sigma_s^2 + A_i) > 0$,$f$ 严格凸,唯一极小点:
$$g_i^\star = \frac{\|\mathbf{b}_i\|^2 + \sigma_c^2}{\sigma_s^2 + \|\mathbf{b}_i\|^2 + \sigma_c^2} \tag{10}$$
$$g_i^\star \begin{cases} < 0.5, & \text{若 } \|\mathbf{b}_i\|^2 + \sigma_c^2 < \sigma_s^2 \quad (\text{偏好跨域专家}) \\ > 0.5, & \text{若 } \|\mathbf{b}_i\|^2 + \sigma_c^2 > \sigma_s^2 \quad (\text{偏好单域专家}) \end{cases} \tag{11}$$
物理含义:门控自动依据"跨域干扰的偏差 + 噪声"相对"单域方差"的大小,把权重挪向更可靠的那个专家。当跨域专家的偏差-方差组合过大(负迁移严重)时,最优权重自然偏向单域专家。这个结论后面被 Fig. 4 的实测门控权重直接验证。
5. Dual-Sampling Token-to-Item Contrastive Learning(主任务,Fig. 2e)¶
除了识别相似 item 之间的关联,还要建模不相似 item 之间的对比。作者用 pairwise ranking loss(BPR 式)在跨域序列 $X_{1:n}$ 及其期望的下一个 item $x_{n+1}^d$ 上优化:
$$q_t = \log\sigma\left(P(x_{t+1}^d = x^+ \mid X_{1:t}) - P(x_{t+1}^d = x^- \mid X_{1:t})\right), \quad \mathcal{L}_{nip} = \sum_{t=1}^{n} q_t \tag{12}$$
$\sigma$ 是 sigmoid,$x^+$ 是 ground-truth item,$x^-$ 是从 item 词表中采的负样本。
5.1 Token-to-Item Embedding Encoder(Fig. 2g)¶
$$P(x_{t+1}^d = x \mid X_{1:t}) = \sigma\left(u_{l_{x_t}}^{\mathsf{T}} \cdot \mathrm{ItemEmb}(x)\right) \tag{13}$$
其中 $u_{l_{x_t}}$ 是截至 $t$ 时刻的序列表征(式 8 的输出),$\mathrm{ItemEmb}(x)$ 是 item 级 embedding,取 LLM 骨干对该 item subtoken 序列的最后一个表征:
$$\mathrm{ItemEmb}(x) = \mathrm{LLM}([s_1, \dots, s_{l_x}])_{l_x} \tag{14}$$
它可以与 §2 的 LLM 共享;也可以换成一个独立的可训练层(如全连接层)。这一步是"token-to-item"的字面含义:把 token 级的 item 文本编码压成 item 级向量,让对比学习的对象从 token 变成 item。
5.2 Stochastic Single- and Cross-Domain Negative Sampler(Fig. 2f)¶
既往 CDSR 工作(C2DSR、BERT4Rec 等)通常只从 ground-truth item 所在的同一个域随机采负样本。作者把采样范围扩展到跨域:
$$x^- \sim \begin{cases} \mathcal{U}(\mathcal{V}_d), & \text{若 } \alpha > p \\ \mathcal{U}(\mathcal{V} \setminus \mathcal{V}_d), & \text{若 } \alpha \le p \end{cases} \tag{15}$$
$\mathcal{U}(S)$ 表示集合 $S$ 上的均匀分布,$p$ 是控制跨域采样比例的超参,$\alpha$ 是均匀随机数。$p$ 越大跨域负样本越多。既往研究相当于 $p = 0$ 的特例,而实测这一设定性能最差。这个设计让模型不仅学到域内协同信号,还学会在表征空间里区分"同域 item"与"跨域 item"。
6. 训练与推理¶
总损失是两个任务的调和:
$$\mathcal{L} = \eta\,\mathcal{L}_{inst} + (1 - \eta)\,\mathcal{L}_{nip} \tag{16}$$
$\eta$ 是调和因子。推理时只用序列的最后一个表征 $u_{l_{x_n}}^{mixed}$,在目标域 item 集合内取分数最高者:
$$\arg\max_{x^d \in \mathcal{V}_d} \left(u_{l_{x_n}}^{mixed}\right)^{\mathsf{T}} \cdot \mathrm{ItemEmb}(x^d) \tag{17}$$
线上推理与部署流程(附录 C,Fig. 9):
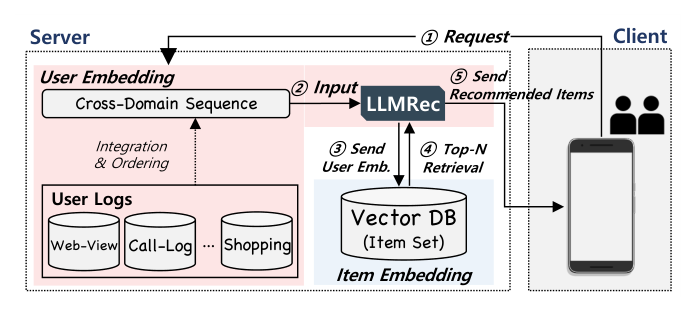
① 客户端带 user_id 等变量向服务端发请求 → ② 服务端把该用户的跨域序列数据喂进模型生成 user embedding → ③ user embedding 取自模型输出序列的最后一个 embedding → ④ 与预先计算好并存入向量数据库的 item embedding 集合(由 LLM 骨干按式 14 算出)做相似度计算,取 top-$N$ → ⑤ 推荐结果回传客户端。item embedding 离线预计算 + 向量库检索是这套方案能满足线上时延约束的关键工程选择。
实验设置¶
数据集¶
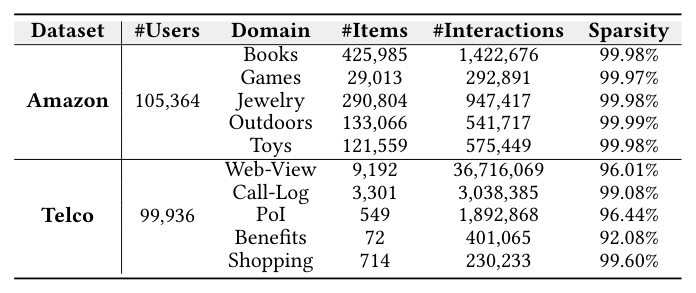
| 数据集 | #Users | 域 | #Items | #Interactions | Sparsity |
|---|---|---|---|---|---|
| Amazon | 105,364 | Books | 425,985 | 1,422,676 | 99.98% |
| Games | 29,013 | 292,891 | 99.97% | ||
| Jewelry | 290,804 | 947,417 | 99.98% | ||
| Outdoors | 133,066 | 541,717 | 99.99% | ||
| Toys | 121,559 | 575,449 | 99.98% | ||
| Telco | 99,936 | Web-View | 9,192 | 36,716,069 | 96.01% |
| Call-Log | 3,301 | 3,038,385 | 99.08% | ||
| PoI | 549 | 1,892,868 | 96.44% | ||
| Benefits | 72 | 401,065 | 92.08% | ||
| Shopping | 714 | 230,233 | 99.60% |
- Amazon Review Dataset:五个域——Books、Video and Games(Games)、Clothing Shoes and Jewelry(Jewelry)、Sports and Outdoors(Outdoors)、Toys and Games(Toys)。
- Telco Behavior Dataset:自有数据集,来自一家全球领先电信公司管理的多个真实 App 的用户日志(仅包含同意采集与分析的客户),五个域——网页浏览历史(Web-View)、通话记录(Call-Log)、导航 PoI 搜索历史(PoI)、订户权益计划(Benefits)、电商购买历史(Shopping)。
两个数据集的域特性差异极大:Amazon 极稀疏(≥99.97%)且 item 量大,Telco 相对稠密(92%–99.6%)但 item 量小(Benefits 只有 72 个 item)。
Baseline(26 个)¶
分三类:
- IDRec-SDSR(9 个):GRU4Rec、SASRec、BERT4Rec、S3Rec、NextItNet、SINE、STAMP、TransRec、LightSANs
- IDRec-CDR/CDSR(8 个):BiTGCF、DTCDR、CMF、CLFM、DeepAPF、MoSE、CGRec、SyNCRec
- LLMRec(9 个):UniSRec、E4SRec、HLLM、RecFormer、SAID、CALRec、ReLLa、Lite-LLMRec、LLMEmb
其中 CGRec 与 SyNCRec 是能同时学三个及以上域的 all-in-one CDSR 先驱(也正是本文通讯作者 Chung Park 此前的工作);MAN、C2DSR、$\pi$-Net、MIFN 只能处理两两配对,因此单列在附录 Table 7/8。成对型 CDR/CDSR baseline(BiTGCF、CMF、DTCDR、DeepAPF)在主表中报告的是「该目标域与其余四个域两两配对后的平均性能」。
评估协议¶
leave-one-out:每条用户序列的最后一个 item 作测试、倒数第二个作验证、其余作训练;按测试 item 所属域分别评估。由于 item 量大,采用常见做法——把 ground-truth item 与 99 个用户从未交互过的随机负样本配成候选集。指标为 HR、NDCG、MRR。
实现细节¶
- LLM 骨干:TinyLlama-1.1B(论文明确说是为了满足大规模真实推荐服务的严格效率要求)。hidden size 2048、context length 4096、32 heads、22 层、词表 32000。
- 双专家:hidden size 2048、16 heads、2 层(相比 22 层骨干非常轻)。
- 超参:$p = 0.4$,$\eta = 0.5$。
- 训练:AdamW,batch size 4,25 epochs,4× NVIDIA A100 40GB。
- 公平性:所有 LLMRec baseline 都用同一个 TinyLlama-1.1B 骨干,context length / batch size / optimizer 全部对齐。
主要实验结果(RQ1)¶
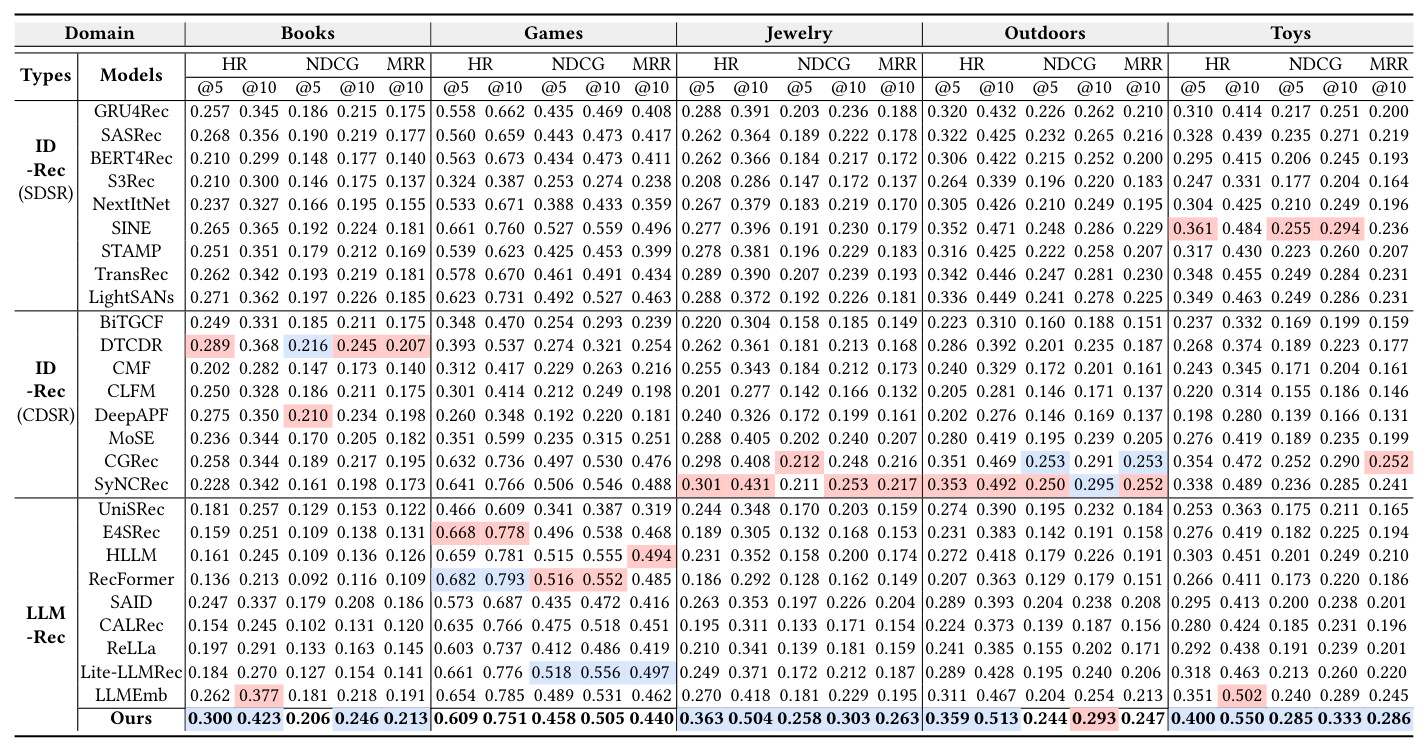
Amazon(Table 2)¶
HR@5
| Type | Model | Books | Games | Jewelry | Outdoors | Toys |
|---|---|---|---|---|---|---|
| ID-SDSR | GRU4Rec | 0.257 | 0.558 | 0.288 | 0.320 | 0.310 |
| ID-SDSR | SASRec | 0.268 | 0.560 | 0.262 | 0.322 | 0.328 |
| ID-SDSR | BERT4Rec | 0.210 | 0.563 | 0.262 | 0.306 | 0.295 |
| ID-SDSR | S3Rec | 0.210 | 0.324 | 0.208 | 0.264 | 0.247 |
| ID-SDSR | NextItNet | 0.237 | 0.533 | 0.267 | 0.305 | 0.304 |
| ID-SDSR | SINE | 0.265 | 0.661 | 0.277 | 0.352 | 0.361 |
| ID-SDSR | STAMP | 0.251 | 0.539 | 0.278 | 0.316 | 0.317 |
| ID-SDSR | TransRec | 0.262 | 0.578 | 0.289 | 0.342 | 0.348 |
| ID-SDSR | LightSANs | 0.271 | 0.623 | 0.288 | 0.336 | 0.349 |
| ID-CDSR | BiTGCF | 0.249 | 0.348 | 0.220 | 0.223 | 0.237 |
| ID-CDSR | DTCDR | 0.289 | 0.393 | 0.262 | 0.286 | 0.268 |
| ID-CDSR | CMF | 0.202 | 0.312 | 0.255 | 0.240 | 0.243 |
| ID-CDSR | CLFM | 0.250 | 0.301 | 0.201 | 0.205 | 0.220 |
| ID-CDSR | DeepAPF | 0.275 | 0.260 | 0.240 | 0.202 | 0.198 |
| ID-CDSR | MoSE | 0.236 | 0.351 | 0.288 | 0.280 | 0.276 |
| ID-CDSR | CGRec | 0.258 | 0.632 | 0.298 | 0.351 | 0.354 |
| ID-CDSR | SyNCRec | 0.228 | 0.641 | 0.301 | 0.353 | 0.338 |
| LLMRec | UniSRec | 0.181 | 0.466 | 0.244 | 0.274 | 0.253 |
| LLMRec | E4SRec | 0.159 | 0.668 | 0.189 | 0.231 | 0.276 |
| LLMRec | HLLM | 0.161 | 0.659 | 0.231 | 0.272 | 0.303 |
| LLMRec | RecFormer | 0.136 | 0.682 | 0.186 | 0.207 | 0.266 |
| LLMRec | SAID | 0.247 | 0.573 | 0.263 | 0.289 | 0.295 |
| LLMRec | CALRec | 0.154 | 0.635 | 0.195 | 0.224 | 0.280 |
| LLMRec | ReLLa | 0.197 | 0.603 | 0.210 | 0.241 | 0.292 |
| LLMRec | Lite-LLMRec | 0.184 | 0.661 | 0.249 | 0.289 | 0.318 |
| LLMRec | LLMEmb | 0.262 | 0.654 | 0.270 | 0.311 | 0.351 |
| LLMRec | Ours (DuELRec) | 0.300 | 0.609 | 0.363 | 0.359 | 0.400 |
NDCG@10
| Model | Books | Games | Jewelry | Outdoors | Toys |
|---|---|---|---|---|---|
| GRU4Rec | 0.215 | 0.469 | 0.236 | 0.262 | 0.251 |
| SASRec | 0.219 | 0.473 | 0.222 | 0.265 | 0.271 |
| BERT4Rec | 0.177 | 0.473 | 0.217 | 0.252 | 0.245 |
| S3Rec | 0.175 | 0.274 | 0.172 | 0.220 | 0.204 |
| NextItNet | 0.195 | 0.433 | 0.219 | 0.249 | 0.249 |
| SINE | 0.224 | 0.559 | 0.230 | 0.286 | 0.294 |
| STAMP | 0.212 | 0.453 | 0.229 | 0.258 | 0.260 |
| TransRec | 0.219 | 0.491 | 0.239 | 0.281 | 0.284 |
| LightSANs | 0.226 | 0.527 | 0.226 | 0.278 | 0.286 |
| BiTGCF | 0.211 | 0.293 | 0.185 | 0.188 | 0.199 |
| DTCDR | 0.245 | 0.321 | 0.213 | 0.235 | 0.223 |
| CMF | 0.173 | 0.263 | 0.212 | 0.201 | 0.204 |
| CLFM | 0.211 | 0.249 | 0.166 | 0.171 | 0.186 |
| DeepAPF | 0.234 | 0.220 | 0.199 | 0.169 | 0.166 |
| MoSE | 0.205 | 0.315 | 0.240 | 0.239 | 0.235 |
| CGRec | 0.217 | 0.530 | 0.248 | 0.291 | 0.290 |
| SyNCRec | 0.198 | 0.546 | 0.253 | 0.295 | 0.285 |
| UniSRec | 0.153 | 0.387 | 0.203 | 0.232 | 0.211 |
| E4SRec | 0.138 | 0.538 | 0.168 | 0.191 | 0.225 |
| HLLM | 0.136 | 0.555 | 0.200 | 0.226 | 0.249 |
| RecFormer | 0.116 | 0.552 | 0.162 | 0.179 | 0.220 |
| SAID | 0.208 | 0.472 | 0.226 | 0.238 | 0.238 |
| CALRec | 0.131 | 0.518 | 0.171 | 0.187 | 0.231 |
| ReLLa | 0.163 | 0.486 | 0.181 | 0.202 | 0.239 |
| Lite-LLMRec | 0.154 | 0.556 | 0.212 | 0.240 | 0.260 |
| LLMEmb | 0.218 | 0.531 | 0.229 | 0.254 | 0.289 |
| Ours (DuELRec) | 0.246 | 0.505 | 0.303 | 0.293 | 0.333 |
MRR@10
| Model | Books | Games | Jewelry | Outdoors | Toys |
|---|---|---|---|---|---|
| GRU4Rec | 0.175 | 0.408 | 0.188 | 0.210 | 0.200 |
| SASRec | 0.177 | 0.417 | 0.178 | 0.216 | 0.219 |
| BERT4Rec | 0.140 | 0.411 | 0.172 | 0.200 | 0.193 |
| S3Rec | 0.137 | 0.238 | 0.137 | 0.183 | 0.164 |
| NextItNet | 0.155 | 0.359 | 0.170 | 0.195 | 0.196 |
| SINE | 0.181 | 0.496 | 0.179 | 0.229 | 0.236 |
| STAMP | 0.169 | 0.399 | 0.183 | 0.207 | 0.207 |
| TransRec | 0.181 | 0.434 | 0.193 | 0.230 | 0.231 |
| LightSANs | 0.185 | 0.463 | 0.181 | 0.225 | 0.231 |
| BiTGCF | 0.175 | 0.239 | 0.149 | 0.151 | 0.159 |
| DTCDR | 0.207 | 0.254 | 0.168 | 0.187 | 0.177 |
| CMF | 0.140 | 0.216 | 0.173 | 0.161 | 0.161 |
| CLFM | 0.175 | 0.198 | 0.132 | 0.137 | 0.146 |
| DeepAPF | 0.198 | 0.181 | 0.161 | 0.137 | 0.131 |
| MoSE | 0.182 | 0.251 | 0.207 | 0.205 | 0.199 |
| CGRec | 0.195 | 0.476 | 0.216 | 0.253 | 0.252 |
| SyNCRec | 0.173 | 0.488 | 0.217 | 0.252 | 0.241 |
| UniSRec | 0.122 | 0.319 | 0.159 | 0.184 | 0.165 |
| E4SRec | 0.131 | 0.468 | 0.153 | 0.158 | 0.194 |
| HLLM | 0.126 | 0.494 | 0.174 | 0.191 | 0.210 |
| RecFormer | 0.109 | 0.485 | 0.149 | 0.151 | 0.186 |
| SAID | 0.186 | 0.416 | 0.204 | 0.208 | 0.201 |
| CALRec | 0.120 | 0.451 | 0.154 | 0.156 | 0.196 |
| ReLLa | 0.145 | 0.419 | 0.159 | 0.171 | 0.201 |
| Lite-LLMRec | 0.141 | 0.497 | 0.187 | 0.206 | 0.220 |
| LLMEmb | 0.191 | 0.462 | 0.195 | 0.213 | 0.245 |
| Ours (DuELRec) | 0.213 | 0.440 | 0.263 | 0.247 | 0.286 |
HR@10 与 NDCG@5 两列因表宽省略,完整数值已录入 benchmark 记录,并可对照 Table 2 原图。
结论分析(why):DuELRec 在 HR@5 上相对次优 baseline的提升为 Books +3.81%、Jewelry +20.6%、Outdoors +1.70%、Toys +10.8%。提升最大的两个域(Jewelry +20.6%、Toys +10.8%)恰好是 Fig. 1 里负迁移最严重、且 item 量最大/最稀疏的域——这与「门控在负迁移严重的域上把权重挪向单域专家」的机制解释一致。
唯一的失手在 Games 域:RecFormer 以 HR@5 0.682 领先,DuELRec 只有 0.609,甚至落后于 E4SRec(0.668)、Lite-LLMRec(0.661)、SINE(0.661)、LLMEmb(0.654)。论文对此的解释是"虽在 Games 未超过最优 baseline,但跨大多数域一致更优"。值得注意的是,Games 是 Amazon 五个域中 item 数最少(29,013)、稠密度最高的域——在这种域上跨域信息的边际价值最低,而 DuELRec 的门控为了压制负迁移会牺牲一部分跨域收益。反过来看,RecFormer、E4SRec 这些在 Games 上领先的 LLMRec,在 Books 上分别只有 0.136 和 0.159(远低于最简单的 GRU4Rec 的 0.257)——这些 baseline 是"在某些域极强、在另一些域崩塌",而 DuELRec 是"跨域一致稳"。论文明确把这一点当作核心卖点。
Telco(Table 3)¶
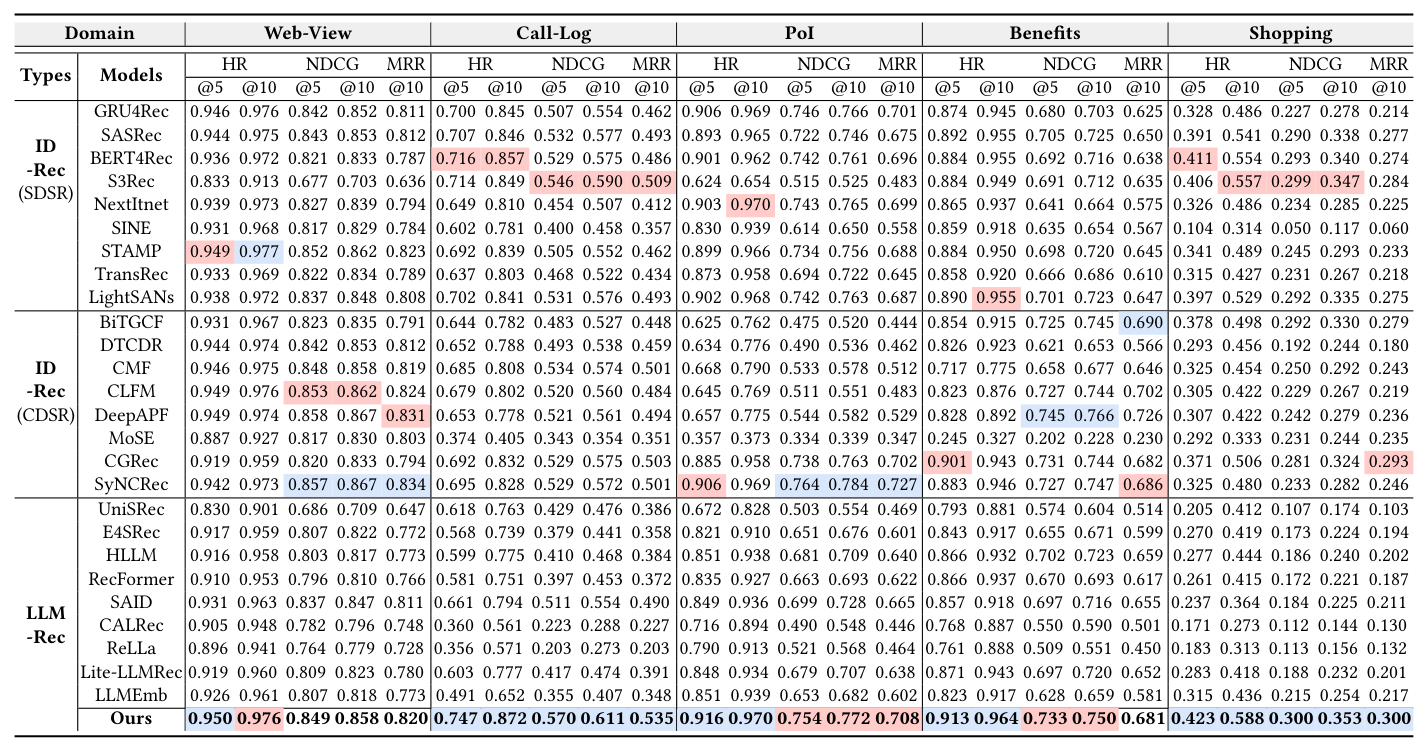
HR@5
| Type | Model | Web-View | Call-Log | PoI | Benefits | Shopping |
|---|---|---|---|---|---|---|
| ID-SDSR | GRU4Rec | 0.946 | 0.700 | 0.906 | 0.874 | 0.328 |
| ID-SDSR | SASRec | 0.944 | 0.707 | 0.893 | 0.892 | 0.391 |
| ID-SDSR | BERT4Rec | 0.936 | 0.716 | 0.901 | 0.884 | 0.411 |
| ID-SDSR | S3Rec | 0.833 | 0.714 | 0.624 | 0.884 | 0.406 |
| ID-SDSR | NextItNet | 0.939 | 0.649 | 0.903 | 0.865 | 0.326 |
| ID-SDSR | SINE | 0.931 | 0.602 | 0.830 | 0.859 | 0.104 |
| ID-SDSR | STAMP | 0.949 | 0.692 | 0.899 | 0.884 | 0.341 |
| ID-SDSR | TransRec | 0.933 | 0.637 | 0.873 | 0.858 | 0.315 |
| ID-SDSR | LightSANs | 0.938 | 0.702 | 0.902 | 0.890 | 0.397 |
| ID-CDSR | BiTGCF | 0.931 | 0.644 | 0.625 | 0.854 | 0.378 |
| ID-CDSR | DTCDR | 0.944 | 0.652 | 0.634 | 0.826 | 0.293 |
| ID-CDSR | CMF | 0.946 | 0.685 | 0.668 | 0.717 | 0.325 |
| ID-CDSR | CLFM | 0.949 | 0.679 | 0.645 | 0.823 | 0.305 |
| ID-CDSR | DeepAPF | 0.949 | 0.653 | 0.657 | 0.828 | 0.307 |
| ID-CDSR | MoSE | 0.887 | 0.374 | 0.357 | 0.245 | 0.292 |
| ID-CDSR | CGRec | 0.919 | 0.692 | 0.885 | 0.901 | 0.371 |
| ID-CDSR | SyNCRec | 0.942 | 0.695 | 0.906 | 0.883 | 0.325 |
| LLMRec | UniSRec | 0.830 | 0.618 | 0.672 | 0.793 | 0.205 |
| LLMRec | E4SRec | 0.917 | 0.568 | 0.821 | 0.843 | 0.270 |
| LLMRec | HLLM | 0.916 | 0.599 | 0.851 | 0.866 | 0.277 |
| LLMRec | RecFormer | 0.910 | 0.581 | 0.835 | 0.866 | 0.261 |
| LLMRec | SAID | 0.931 | 0.661 | 0.849 | 0.857 | 0.237 |
| LLMRec | CALRec | 0.905 | 0.360 | 0.716 | 0.768 | 0.171 |
| LLMRec | ReLLa | 0.896 | 0.356 | 0.790 | 0.761 | 0.183 |
| LLMRec | Lite-LLMRec | 0.919 | 0.603 | 0.848 | 0.871 | 0.283 |
| LLMRec | LLMEmb | 0.926 | 0.491 | 0.851 | 0.823 | 0.315 |
| LLMRec | Ours (DuELRec) | 0.950 | 0.747 | 0.916 | 0.913 | 0.423 |
NDCG@10
| Model | Web-View | Call-Log | PoI | Benefits | Shopping |
|---|---|---|---|---|---|
| GRU4Rec | 0.852 | 0.554 | 0.766 | 0.703 | 0.278 |
| SASRec | 0.853 | 0.577 | 0.746 | 0.725 | 0.338 |
| BERT4Rec | 0.833 | 0.575 | 0.761 | 0.716 | 0.340 |
| S3Rec | 0.703 | 0.590 | 0.525 | 0.712 | 0.347 |
| NextItNet | 0.839 | 0.507 | 0.765 | 0.664 | 0.285 |
| SINE | 0.829 | 0.458 | 0.650 | 0.654 | 0.117 |
| STAMP | 0.862 | 0.552 | 0.756 | 0.720 | 0.293 |
| TransRec | 0.834 | 0.522 | 0.722 | 0.686 | 0.267 |
| LightSANs | 0.848 | 0.576 | 0.763 | 0.723 | 0.335 |
| BiTGCF | 0.835 | 0.527 | 0.520 | 0.745 | 0.330 |
| DTCDR | 0.853 | 0.538 | 0.536 | 0.653 | 0.244 |
| CMF | 0.858 | 0.574 | 0.578 | 0.677 | 0.292 |
| CLFM | 0.862 | 0.560 | 0.551 | 0.744 | 0.267 |
| DeepAPF | 0.867 | 0.561 | 0.582 | 0.766 | 0.279 |
| MoSE | 0.830 | 0.354 | 0.339 | 0.228 | 0.244 |
| CGRec | 0.833 | 0.575 | 0.763 | 0.744 | 0.324 |
| SyNCRec | 0.867 | 0.572 | 0.784 | 0.747 | 0.282 |
| UniSRec | 0.709 | 0.476 | 0.554 | 0.604 | 0.174 |
| E4SRec | 0.822 | 0.441 | 0.676 | 0.671 | 0.224 |
| HLLM | 0.817 | 0.468 | 0.709 | 0.723 | 0.240 |
| RecFormer | 0.810 | 0.453 | 0.693 | 0.693 | 0.221 |
| SAID | 0.847 | 0.554 | 0.728 | 0.716 | 0.225 |
| CALRec | 0.796 | 0.288 | 0.548 | 0.590 | 0.144 |
| ReLLa | 0.779 | 0.273 | 0.568 | 0.551 | 0.156 |
| Lite-LLMRec | 0.823 | 0.474 | 0.707 | 0.720 | 0.232 |
| LLMEmb | 0.818 | 0.407 | 0.682 | 0.659 | 0.254 |
| Ours (DuELRec) | 0.858 | 0.611 | 0.772 | 0.750 | 0.353 |
MRR@10
| Model | Web-View | Call-Log | PoI | Benefits | Shopping |
|---|---|---|---|---|---|
| GRU4Rec | 0.811 | 0.462 | 0.701 | 0.625 | 0.214 |
| SASRec | 0.812 | 0.493 | 0.675 | 0.650 | 0.277 |
| BERT4Rec | 0.787 | 0.486 | 0.696 | 0.638 | 0.274 |
| S3Rec | 0.636 | 0.509 | 0.483 | 0.635 | 0.284 |
| NextItNet | 0.794 | 0.412 | 0.699 | 0.575 | 0.225 |
| SINE | 0.784 | 0.357 | 0.558 | 0.567 | 0.060 |
| STAMP | 0.823 | 0.462 | 0.688 | 0.645 | 0.233 |
| TransRec | 0.789 | 0.434 | 0.645 | 0.610 | 0.218 |
| LightSANs | 0.808 | 0.493 | 0.687 | 0.647 | 0.275 |
| BiTGCF | 0.791 | 0.448 | 0.444 | 0.690 | 0.279 |
| DTCDR | 0.812 | 0.459 | 0.462 | 0.566 | 0.180 |
| CMF | 0.819 | 0.501 | 0.512 | 0.646 | 0.243 |
| CLFM | 0.824 | 0.484 | 0.483 | 0.702 | 0.219 |
| DeepAPF | 0.831 | 0.494 | 0.529 | 0.726 | 0.236 |
| MoSE | 0.803 | 0.351 | 0.347 | 0.230 | 0.235 |
| CGRec | 0.794 | 0.503 | 0.702 | 0.682 | 0.293 |
| SyNCRec | 0.834 | 0.501 | 0.727 | 0.686 | 0.246 |
| UniSRec | 0.647 | 0.386 | 0.469 | 0.514 | 0.103 |
| E4SRec | 0.772 | 0.358 | 0.601 | 0.599 | 0.194 |
| HLLM | 0.773 | 0.384 | 0.640 | 0.659 | 0.202 |
| RecFormer | 0.766 | 0.372 | 0.622 | 0.617 | 0.187 |
| SAID | 0.811 | 0.490 | 0.665 | 0.655 | 0.211 |
| CALRec | 0.748 | 0.227 | 0.446 | 0.501 | 0.130 |
| ReLLa | 0.728 | 0.203 | 0.464 | 0.450 | 0.132 |
| Lite-LLMRec | 0.780 | 0.391 | 0.638 | 0.652 | 0.201 |
| LLMEmb | 0.773 | 0.348 | 0.602 | 0.581 | 0.217 |
| Ours (DuELRec) | 0.820 | 0.535 | 0.708 | 0.681 | 0.300 |
结论分析(why):Telco 上 HR@5 相对次优 baseline 的提升是 Web-View +0.11%、Call-Log +4.33%、PoI +1.10%、Benefits +1.33%、Shopping +2.92%。Web-View 的 +0.11% 几乎等于打平——这个域最稠密(96.01% 稀疏度,3670 万交互),HR@5 已经被所有强 baseline 顶到 0.94~0.95 的天花板,几乎没有提升空间。真正拉开差距的是 Call-Log(+4.33%)与 Shopping(+2.92%)这两个稀疏、且从 Table 4 看负迁移最严重的域。
一个诚实的观察:在 NDCG@10 / MRR@10 上,DuELRec 在 Web-View 与 Benefits 两个域并非最优(Web-View NDCG@10 0.858 < SyNCRec/DeepAPF 的 0.867;Benefits MRR@10 0.681 < DeepAPF 的 0.726、CLFM 的 0.702)。也就是说"全面超越 26 个 baseline"这个宣称在指标粒度上并不严格成立,更准确的说法是"在 HR@5 上全域最优,在 NDCG/MRR 上多数域最优"。
负迁移的定量分析(RQ2)¶
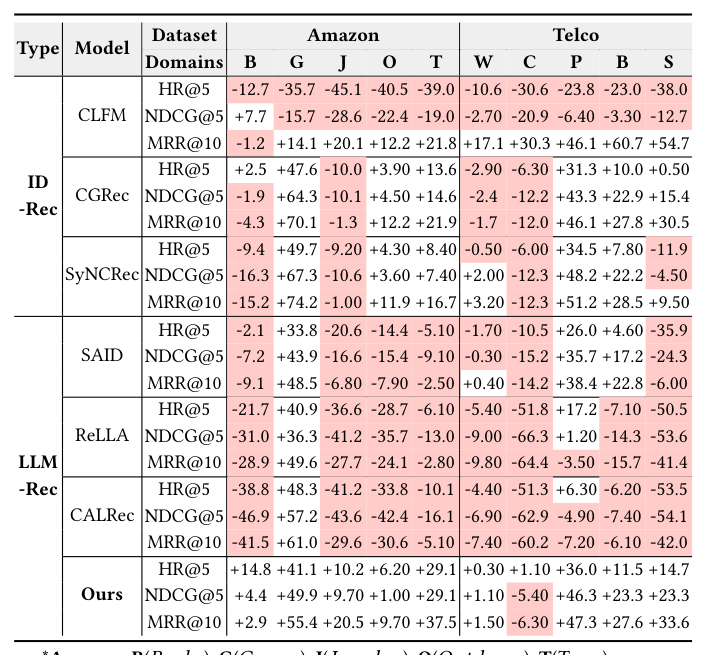
作者定义负迁移的度量方式是:② 用跨域序列训练的 CDSR 模型 − ① 只用单域序列训练的 SDSR 模型(SASRec),若差值为负说明"跨域训练反而伤害了该域"。
Table 4:CDSR 模型相对单域 SASRec 的性能增益(%)(Amazon: B=Books, G=Games, J=Jewelry, O=Outdoors, T=Toys;Telco: W=Web-View, C=Call-Log, P=PoI, B=Benefits, S=Shopping)
| Type | Model | 指标 | B | G | J | O | T | W | C | P | B | S |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| ID | CLFM | HR@5 | −12.7 | −35.7 | −45.1 | −40.5 | −39.0 | −10.6 | −30.6 | −23.8 | −23.0 | −38.0 |
| NDCG@5 | +7.7 | −15.7 | −28.6 | −22.4 | −19.0 | −2.70 | −20.9 | −6.40 | −3.30 | −12.7 | ||
| MRR@10 | −1.2 | +14.1 | +20.1 | +12.2 | +21.8 | +17.1 | +30.3 | +46.1 | +60.7 | +54.7 | ||
| ID | CGRec | HR@5 | +2.5 | +47.6 | −10.0 | +3.90 | +13.6 | −2.90 | −6.30 | +31.3 | +10.0 | +0.50 |
| NDCG@5 | −1.9 | +64.3 | −10.1 | +4.50 | +14.6 | −2.4 | −12.2 | +43.3 | +22.9 | +15.4 | ||
| MRR@10 | −4.3 | +70.1 | −1.3 | +12.2 | +21.9 | −1.7 | −12.0 | +46.1 | +27.8 | +30.5 | ||
| ID | SyNCRec | HR@5 | −9.4 | +49.7 | −9.20 | +4.30 | +8.40 | −0.50 | −6.00 | +34.5 | +7.80 | −11.9 |
| NDCG@5 | −16.3 | +67.3 | −10.6 | +3.60 | +7.40 | +2.00 | −12.3 | +48.2 | +22.2 | −4.50 | ||
| MRR@10 | −15.2 | +74.2 | −1.00 | +11.9 | +16.7 | +3.20 | −12.3 | +51.2 | +28.5 | +9.50 | ||
| LLM | SAID | HR@5 | −2.1 | +33.8 | −20.6 | −14.4 | −5.10 | −1.70 | −10.5 | +26.0 | +4.60 | −35.9 |
| NDCG@5 | −7.2 | +43.9 | −16.6 | −15.4 | −9.10 | −0.30 | −15.2 | +35.7 | +17.2 | −24.3 | ||
| MRR@10 | −9.1 | +48.5 | −6.80 | −7.90 | −2.50 | +0.40 | −14.2 | +38.4 | +22.8 | −6.00 | ||
| LLM | ReLLa | HR@5 | −21.7 | +40.9 | −36.6 | −28.7 | −6.10 | −5.40 | −51.8 | +17.2 | −7.10 | −50.5 |
| NDCG@5 | −31.0 | +36.3 | −41.2 | −35.7 | −13.0 | −9.00 | −66.3 | +1.20 | −14.3 | −53.6 | ||
| MRR@10 | −28.9 | +49.6 | −27.7 | −24.1 | −2.80 | −9.80 | −64.4 | −3.50 | −15.7 | −41.4 | ||
| LLM | CALRec | HR@5 | −38.8 | +48.3 | −41.2 | −33.8 | −10.1 | −4.40 | −51.3 | +6.30 | −6.20 | −53.5 |
| NDCG@5 | −46.9 | +57.2 | −43.6 | −42.4 | −16.1 | −6.90 | −62.9 | −4.90 | −7.40 | −54.1 | ||
| MRR@10 | −41.5 | +61.0 | −29.6 | −30.6 | −5.10 | −7.40 | −60.2 | −7.20 | −6.10 | −42.0 | ||
| LLM | Ours | HR@5 | +14.8 | +41.1 | +10.2 | +6.20 | +29.1 | +0.30 | +1.10 | +36.0 | +11.5 | +14.7 |
| NDCG@5 | +4.4 | +49.9 | +9.70 | +1.00 | +29.1 | +1.10 | −5.40 | +46.3 | +23.3 | +23.3 | ||
| MRR@10 | +2.9 | +55.4 | +20.5 | +9.70 | +37.5 | +1.50 | −6.30 | +47.3 | +27.6 | +33.6 |
结论分析(why):
- 除本文外的所有 IDRec 和 LLMRec 在大多数域上都跑输单域 SASRec——这是负迁移的直接证据,也说明"多域联合训练"在 CDSR 里绝不是免费午餐。
- LLMRec 的负迁移比 IDRec 更剧烈:ReLLa 在 Call-Log 上 HR@5 掉 51.8%、NDCG@5 掉 66.3%;CALRec 在 Books 上 HR@5 掉 38.8%、Shopping 掉 53.5%。相比之下 CGRec/SyNCRec 这类专门设计过负迁移抑制的 IDRec 退化温和得多。
- DuELRec 在 HR@5 上十个域全部为正,且在其他模型翻车最严重的 Jewelry(+10.2%)、Call-Log(+1.10%)、Shopping(+14.7%)上都实现了逆转。论文特意点名:Jewelry 与 Call-Log 上有六个 baseline HR@5 为负,Shopping 上有五个。
- 一个论文没有明说的例外:DuELRec 在 Call-Log 的 NDCG@5(−5.40%)与 MRR@10(−6.30%)仍为负。也就是"in all domains 都缓解了负迁移"的措辞只在 HR@5 口径下严格成立;在排序质量口径下,Call-Log 域的负迁移只是被大幅缩小(ReLLa −66.3% → 本文 −5.40%)而非消除。
门控权重的实测行为¶
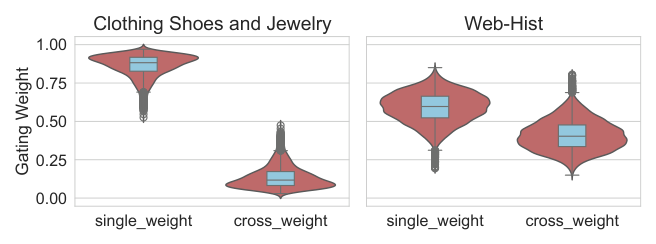
Fig. 4 展示了训练好的模型在测试集上预测两个代表性域的 item 时,如何在单域/跨域专家之间分配门控权重:
- Jewelry(负迁移显著的域):模型强烈偏向单域专家;
- Web-Hist(Web-View):模型分配了相当大的权重给跨域专家,说明它有效利用了跨域知识。
这正是式 (10)(11) 理论预测的行为落地:跨域干扰大 → $g^\star > 0.5$ 偏单域;跨域干扰小 → 偏跨域。这是全文最有说服力的一处"理论—机制—实证"闭环。
冷启动场景(RQ3)¶
冷/热 item¶
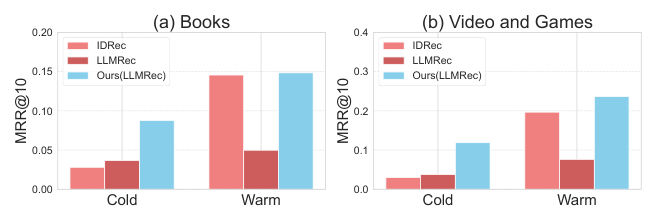
沿用 Kim 等(A-LLMRec)的定义:cold item = 交互频次最低的 10%(Amazon)或 30%(Telco),其余为 warm item;按 ground-truth item 是冷是热分别评估。
观察到的普遍规律是:LLMRec 在 warm item 上不如 IDRec,在 cold item 上强于 IDRec——因为 warm 场景下交互丰富,传统协同过滤(IDRec)更占优,而 LLMRec 过度依赖文本信息。
而 DuELRec 在 cold item 与 warm item 上都超过 IDRec。论文把这归因于模型成功捕捉了 item 级协同信号,从而弥补了 LLMRec 在 warm 场景的固有短板。这一点意义重大:它意味着 LLMRec 路线不必在"冷启动能力"和"热门场景精度"之间二选一。全域结果见附录 F(Fig. 11)。
冷用户¶
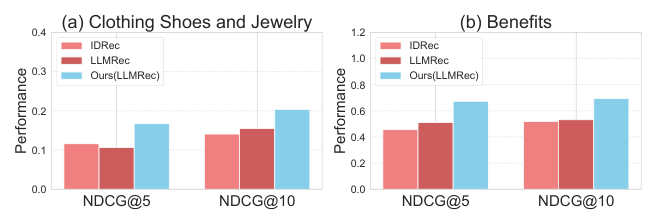
cold user = 全体用户交互长度分布最低的 1%;模型只在其余用户上训练,在冷用户子集上评估。DuELRec 跨域一致优于 IDRec,在协同知识稀疏、冷用户表现受限的域上增益尤其明显。原因是 LLM 能捕捉语义层面的用户特征,在协同信号不足时仍可给出有效表征。全域结果见附录 F(Fig. 12)。
消融与分析(RQ4)¶
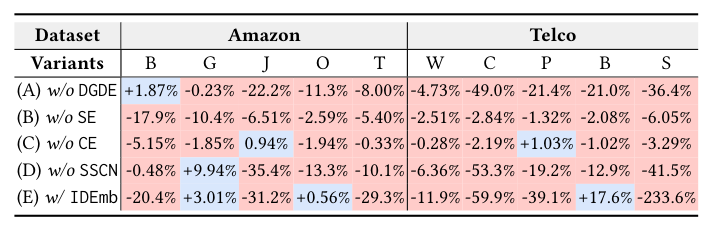
Table 5:各变体相对完整模型的 MRR 变化(%)
| Variants | B | G | J | O | T | W | C | P | B | S |
|---|---|---|---|---|---|---|---|---|---|---|
| (A) w/o DGDE | +1.87% | −0.23% | −22.2% | −11.3% | −8.00% | −4.73% | −49.0% | −21.4% | −21.0% | −36.4% |
| (B) w/o SE | −17.9% | −10.4% | −6.51% | −2.59% | −5.40% | −2.51% | −2.84% | −1.32% | −2.08% | −6.05% |
| (C) w/o CE | −5.15% | −1.85% | +0.94% | −1.94% | −0.33% | −0.28% | −2.19% | +1.03% | −1.02% | −3.29% |
| (D) w/o SSCN | −0.48% | +9.94% | −35.4% | −13.3% | −10.1% | −6.36% | −53.3% | −19.2% | −12.9% | −41.5% |
| (E) w/ IDEmb | −20.4% | +3.01% | −31.2% | +0.56% | −29.3% | −11.9% | −59.9% | −39.1% | +17.6% | −233.6% |
五个变体的定义:
- (A) w/o Dual-Expert(DGDE):把 Domain-Gated Dual Sequential Experts 换成普通 transformer。缺了 DGDE 意味着 LLM 无法捕捉 item 级协同信号。
- (B) w/o Single-Expert(SE):DGDE 里只保留跨域专家,模型被迫只靠跨域信息,无法捕捉域专属序列模式。
- (C) w/o Cross-Expert(CE):只保留单域专家,能捕捉域专属模式但无法利用跨域信息。
- (D) w/o SSCN:把单/跨域随机负采样器换成普通均匀分布负采样器。
- (E) w/ IDEmb:去掉 LLM 骨干,把文本输入换成 ID 输入。
结论分析(why):
- (A) 与 (D) 的退化最剧烈(Call-Log −49.0% / −53.3%,Shopping −36.4% / −41.5%,Jewelry −22.2% / −35.4%),说明 DGDE 与 SSCN 是两根真正的支柱。二者的退化模式高度重合(都在 Jewelry/Call-Log/Shopping 上最惨),而这三个域恰是 Table 4 里负迁移最严重的域——这从侧面印证:这两个模块的作用机制确实是"抑制负迁移",而不是泛泛地提升表达力。
- (B) vs (C) 的不对称非常有信息量:去掉单域专家(B)平均掉 5.7%,去掉跨域专家(C)平均只掉 1.3%,且在 Jewelry(+0.94%)和 PoI(+1.03%)上甚至微涨。这说明单域专家是主力、跨域专家是增益项——与论文"用单域信号调节跨域噪声"的叙事一致,但也暴露了一个事实:跨域信息本身贡献有限,DuELRec 的收益更多来自"把 item 级协同信号找回来"而不是"更好地做跨域迁移"。
- (E) w/ IDEmb 在少数域反而更好(Games +3.01%、Outdoors +0.56%、Benefits +17.6%),但在 Shopping 上崩到 −233.6%。论文的结论是:尽管个别域有边际收益,整体明显更差,从而支持 ID-free 设计在性能、冷启动处理与部署简洁性上的优势。(Benefits 域只有 72 个 item,ID embedding 在这种极小 item 空间上表现好是可预期的。)
Instruction-Tuning 的作用¶
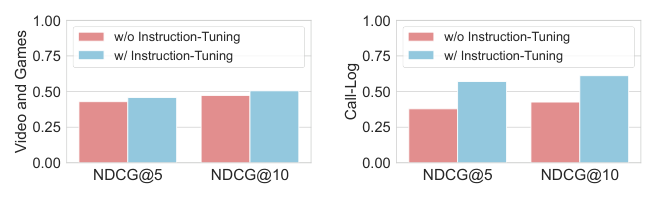
对比有无辅助任务 $\mathcal{L}_{inst}$,PEFT 指令微调在 Games 与 Call-Log 上都带来显著提升,说明让 LLM 从用户行为日志里学习确实能提高推荐性能。全域结果见附录 G(Fig. 13)。
敏感性分析(RQ5)¶
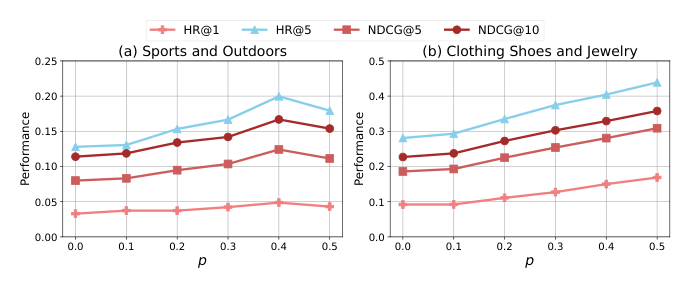
$p$ 控制对比学习中跨域负样本的比例,以 0.1 为步长从 0 扫到 0.5:
- $p = 0$(负样本全部同域,即既往研究的常规设定)性能明显最低;
- 引入跨域负样本($p > 0$)一致提升精度与鲁棒性,且增益随 $p$ 增大更加明显。
论文的解释是:模型有效压制了负迁移,转而利用跨域曝光去放大正迁移。附录 E(Fig. 10)给出全域结果,并诚实地指出 Call-Log 与 Shopping 两个域没有呈现清晰的上升趋势,其余域则是稳健的上升模式。注意扫描上界只到 0.5,没有探到拐点,最终部署取 $p = 0.4$。
时间复杂度分析(RQ6)¶
理论分析¶
记 $L$ 为 subtoken 序列长度、$n$ 为 item 级序列长度、$d$ 为隐藏维度、$H_{\text{LLM}}$ 与 $H_{\text{EXP}}$ 分别为 LLM 骨干与每个专家的层数、$K$ 为训练期负样本数、$N$ 为推理期候选 item 数。
- 训练:冻结 LLM 骨干处理长度 $L$ 的序列 $O(H_{\text{LLM}}L^2 d)$ + 两个浅专家 $O(2H_{\text{EXP}}L^2 d)$ + 门控 $O(nd)$ + 对比损失 $O(Kd)$,合计 $O\!\left(L^2 d(H_{\text{LLM}} + 2H_{\text{EXP}}) + Kd\right)$。
- 推理:对比步换成 $N$ 个候选上的相似度计算 $O(Nd)$,合计 $O\!\left(L^2 d(H_{\text{LLM}} + 2H_{\text{EXP}}) + Nd\right)$。
实测¶
- 对比 ID-based 模型(如 SyNCRec):训练慢 1.67×、推理慢 2.29×;但换来的是新 item 无需重训与更优的跨域性能。
- 对比 LLM-based 模型(如 RecFormer):训练快 1.16×、推理快 3.19×。
效率优势来自三个设计选择:
- 无论多少个域都只用两个专家——不像 SyNCRec 每域一个专家,也不像 BiTGCF/CMF 需要建模全部 $\binom{|\mathcal{D}|}{2}$ 个域对;
- LLM 骨干之后序列长度从 $L$ 降到 $n$,使对比学习比直接在 $L$ 上操作的 LLMRec 更高效;
- 单阶段训练流水线,不像 RecFormer 和 SAID 需要 pre-training + finetuning 两阶段。
第 1 点尤其关键:它是 DuELRec 能声称"支持三个以上域"的结构性理由——专家数与域数解耦。
线上 A/B 实验(RQ7)——工业落地¶
模型部署在一家主要电信公司的个人助手 App(结合致谢与作者单位可确认为 SK Telecom),通过大规模线上 A/B 测试评估,时间跨度为 2025 年 1 月至 3 月。
工程适配:为满足时延容忍度等业务约束,实现了一个裁剪定制版的模型,训练数据为约 500 万用户、跨 14 个域(含 App 的目标域)的序列交互日志。任务是基于每个用户的完整跨域交互历史,在目标域内推荐 Top-1 的下一个 item。
流量在整个评估期内按固定 45 : 35 : 20 随机切分给三个桶:popularity 基线、SASRec 变体、本文模型。主指标为 CTR(点击数 / 曝光数)。
Table 6:线上 A/B 结果
| Model | # Impression | # Clicks | CTR | Inference Latency |
|---|---|---|---|---|
| Popularity | 16.31M | 103K | 0.63% | 50 ms/call |
| SASRec Variant | 13.95M | 126K | 0.90% | 105 ms/call |
| Ours (DuELRec) | 5.66M | 75K | 1.33% | 242 ms/call |
双尾双比例 z 检验确认两处提升均高度显著($p < 0.01$)。相对 SASRec 变体的 CTR 相对提升为 (1.33−0.90)/0.90 = +47.6%,相对 popularity 基线为 +111%。
结论分析(why):
- 这是真实生产部署而非"公司署名的离线实验":三桶流量分配、3 个月周期、3500 万+ 曝光量、显著性检验、以及逐调用时延都被披露。
- 时延代价是诚实的:242 ms/call 是 SASRec 变体(105 ms)的 2.3×、popularity(50 ms)的 4.8×。论文声称该时延"适合生产环境"——这只有在 item embedding 离线预计算 + 向量库检索(附录 C)的架构下才成立。
- 一处需要留意的不一致:宣称流量按 45 : 35 : 20 切分,但实际曝光量比例是 16.31 : 13.95 : 5.66 ≈ 45.6 : 39.0 : 15.8。曝光量不等于流量份额(不同模型的曝光频次可能不同),论文没有解释这个偏差。此外本文桶的曝光量最小(5.66M),统计功效相对较弱,尽管 75K 点击量已足以支撑 $p<0.01$。
附录中的补充实验¶
两两配对 baseline 的完整结果(附录 D)¶
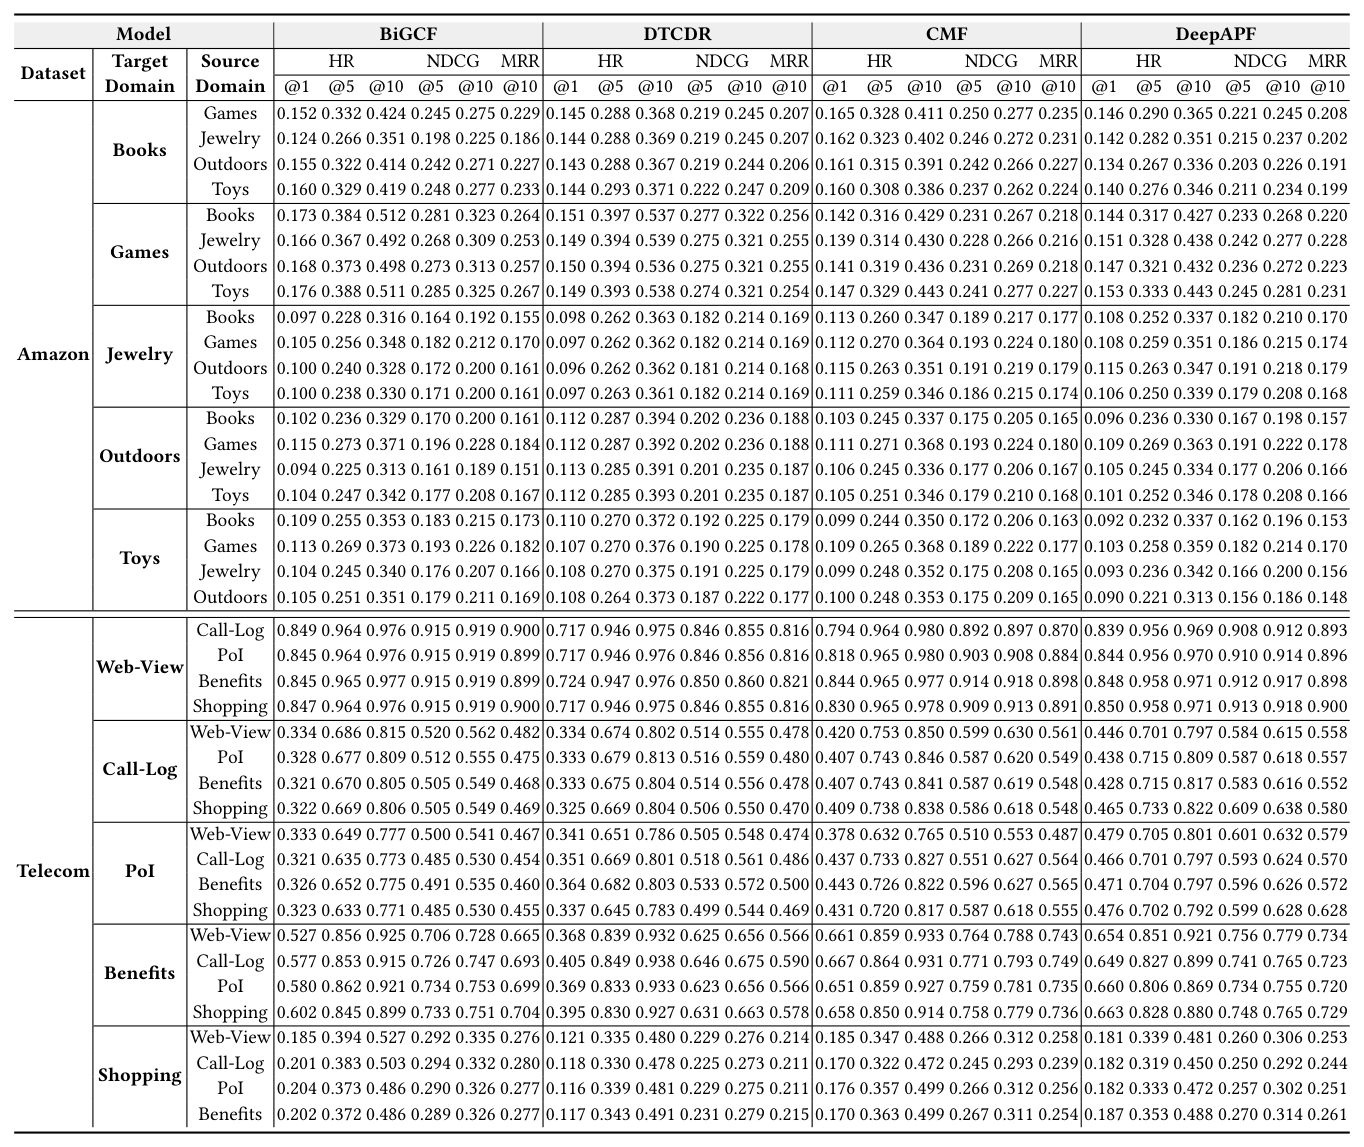
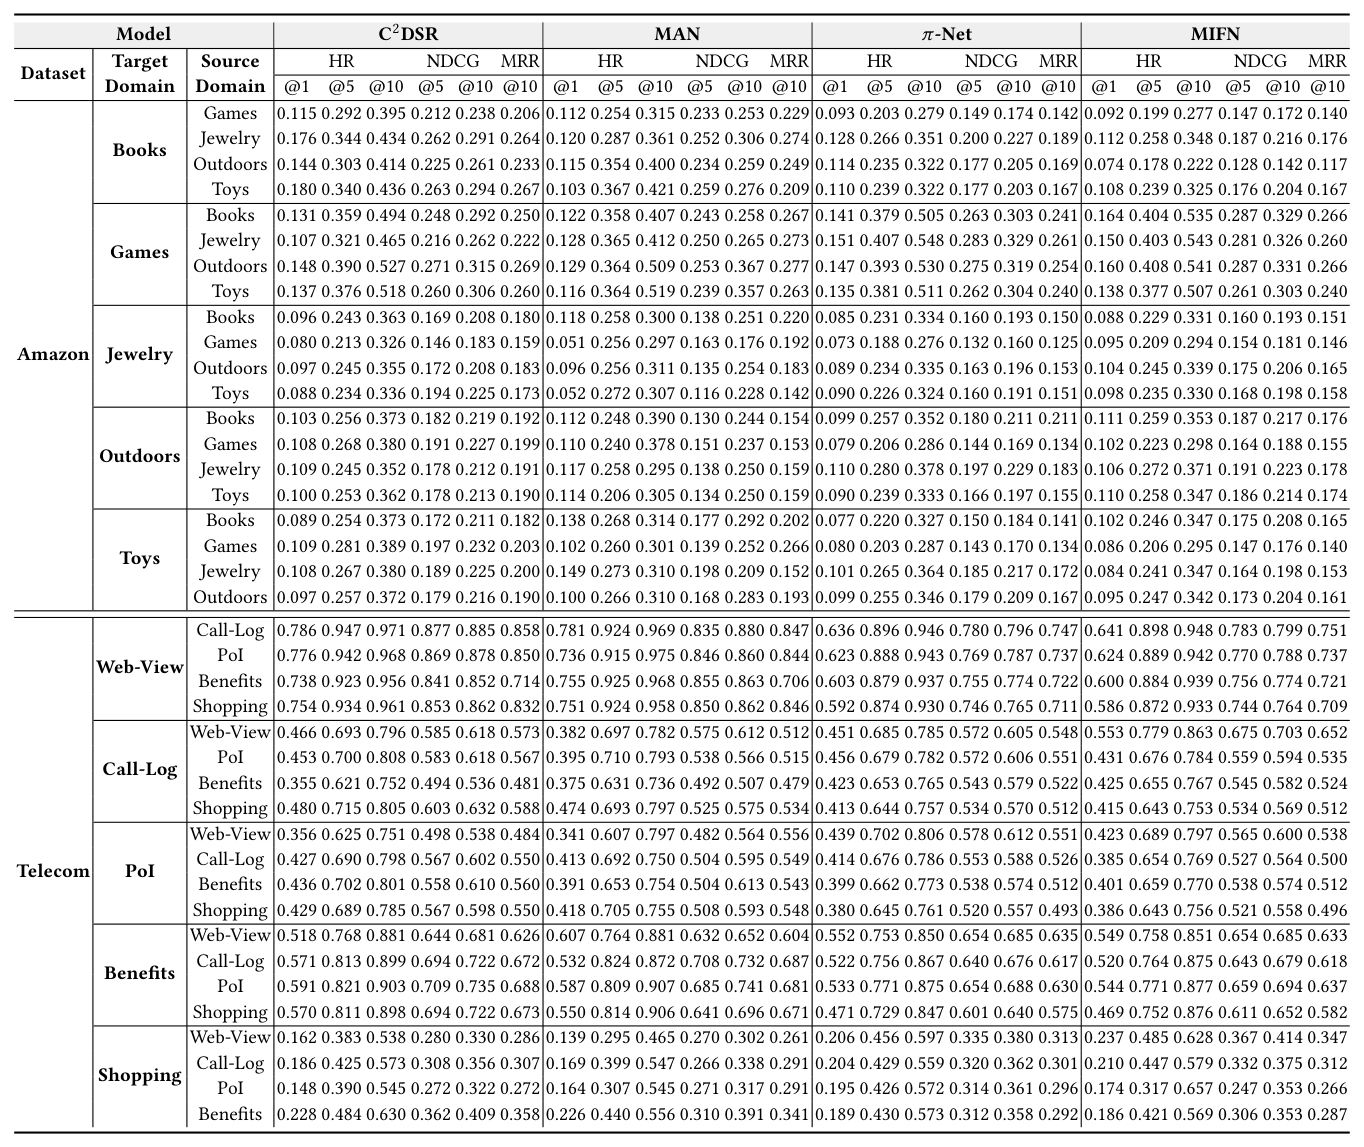
Table 7/8 给出主表中被平均掉的每个域对的明细。主要观察:
- CDR baseline:Amazon 上以 Games 为源域普遍能提升 Books 目标域;Toys→Games、Games→Outdoors 也是好组合。Telco 上 Web-View↔Benefits、Benefits↔Shopping 组合最优。
- CDSR baseline:Amazon 上 Books←Jewelry、Outdoors←Jewelry 一致产出高性能;Telco 上 Web-View←Call-Log、Benefits←Web-View 表现强劲。
这组结果的价值在于:它显式说明了域对之间的迁移关系是高度不对称、且强依赖具体组合的——这恰是"用固定的两两配对模型做多域推荐"不可扩展的原因,也是 DuELRec 用一套门控自适应处理所有域的动机。
检索式 vs 生成式(附录 H)¶
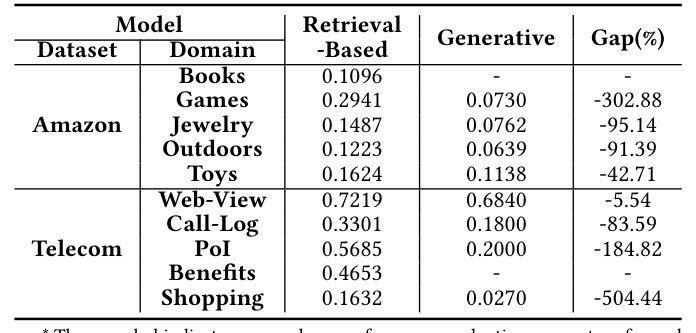
LLMRec 有两条路线:(1) 检索式——从预定义 item 集合中推荐,天然免疫幻觉,适合大规模 item 池;(2) 生成式——LLM 直接生成推荐 item 的标题/描述,候选集通常较小(约 100 个)并显式写进 prompt,有幻觉风险但对构建个性化推荐 agent 有吸引力。本文及全部 baseline 都是检索式。
作者拿代表性生成式模型 A-LLMRec 做了对照(同样是 1 正 + 99 负的候选集):
| Dataset | Domain | Retrieval-Based (Ours) | Generative (A-LLMRec) | Gap(%) |
|---|---|---|---|---|
| Amazon | Books | 0.1096 | — | — |
| Games | 0.2941 | 0.0730 | −302.88 | |
| Jewelry | 0.1487 | 0.0762 | −95.14 | |
| Outdoors | 0.1223 | 0.0639 | −91.39 | |
| Toys | 0.1624 | 0.1138 | −42.71 | |
| Telecom | Web-View | 0.7219 | 0.6840 | −5.54 |
| Call-Log | 0.3301 | 0.1800 | −83.59 | |
| PoI | 0.5685 | 0.2000 | −184.82 | |
| Benefits | 0.4653 | — | — | |
| Shopping | 0.1632 | 0.0270 | −504.44 |
(— 表示因算力受限未评估,或因生成式 LLMRec 的幻觉等问题性能过低。)
生成式路线全面落后,但作者认为它"在带有幻觉风险的前提下仍展现了合理的有效性",并把它列为未来工作方向。
核心贡献总结¶
- 诊断:首次用受控实验证明 LLMRec 在 CDSR 上的负迁移比 IDRec 更严重,并把根因定位到 token 级自回归模式压过 item 级协同信号这一粒度错位,而不是笼统归咎于"域间分布差异"。
- Item-Aware Attention Transformation:把 LLM 的注意力掩码从 token 级重构为 item 级块状因果掩码,并派生出单域/跨域两种注意力范围。这是一个非常轻的改动(只改 mask,不改骨干),却把"LLM 的建模粒度"与"推荐任务的目标粒度"对齐了。
- 域门控双专家 + 偏差-方差理论:用一个 item 级门控在两个专家间自适应加权,并给出严格凸优化下的最优门控闭式解 (10),把"何时该信跨域信号"从启发式变成有理论刻画的量。Fig. 4 的实测权重与理论预测吻合。
- 双采样 token-to-item 对比学习:把负采样从单域池扩展到跨域池(超参 $p$),让模型在表征空间里学会区分同域与跨域 item。消融显示这是与双专家并列的第二根支柱。
- ID-free 且专家数与域数解耦:单模型服务十个域(线上版本 14 个域),无需为每个域维护 ID embedding 表,也无需建模 $O(|\mathcal{D}|^2)$ 个域对。
- 真实工业验证:SK Telecom 个人助手 App 上 3 个月线上 A/B,CTR +47.6%($p<0.01$),并披露了裁剪部署方案与逐调用时延。
与已归档相关工作的对比¶
RGCD-Rep RGCD-Rep: Reasoning-Guided Cross-Domain Representation Learning(Kuaishou, 2026-06-03)¶
关系:独立并发(本文未引用 RGCD-Rep,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文对负迁移的根因判断几乎逐字相同。RGCD-Rep 的 Ch3 写道"CDR 中跨域兴趣并不总是一致,直接聚合两个域的领域特有信息会导致负迁移";DuELRec 则说"跨域序列的协同信号同时被正/负迁移影响,单域序列的信号则不受干扰"。两者都拒绝"把跨域信号无差别混进来"这一默认做法,并且都把 LLM/MLLM 引入跨域推荐后语义信号与协同/行为信号之间的错配当作首要矛盾。
- 相近的技术骨架:两者都把表征显式拆成"可安全共享的部分"与"会带来干扰的部分",再用一个学出来的加权装置决定二者的混合比例。RGCD-Rep 的 transferable-residual query-aware aggregation 把 item 表征解耦为可迁移分量与领域残差分量,用 transferable routing + routing loss 建模 pair 级迁移强度;DuELRec 把序列建模解耦为单域专家(纯净、无跨域干扰)与跨域专家(携带迁移信号),用 item 级 gating network 逐 item 加权。抽象成流程图,两者都是"双分支解耦 → 学习式路由/门控 → 隔离引发负迁移的域特有信息"。
- 本文的差异与推进:切入层次不同。RGCD-Rep 在 item 内容表征层面做解耦(靠 MLLM 对多模态内容的推理来判断可迁移性),DuELRec 在 序列注意力范围层面做解耦(靠块级因果掩码限定 attend 的域范围)。因此 DuELRec 的解耦是结构性的、零额外语义标注成本,而 RGCD-Rep 需要一个冻结教师 MLLM 生成结构化推理再蒸馏。另一处推进是域数:RGCD-Rep 是标准的源域→目标域二元设定(短视频→直播),DuELRec 明确要求 $|\mathcal{D}| \ge 3$ 并实测十个域,且专家数不随域数增长。反过来 RGCD-Rep 更强的地方是它给出了"为什么这两个 item 可迁移"的可解释推理,DuELRec 的门控只是一个标量权重。
- 可比的方法/实验差异:RGCD-Rep 全量部署在快手 + 快手极速版直播召回,服务 4 亿+ DAU;DuELRec 部署在 SK Telecom 个人助手 App,CTR 0.90%→1.33%。两者都无法在公开数据集上完整复现工业结论(RGCD-Rep 只有工业数据集,DuELRec 的 Telco 数据集不公开),但 DuELRec 额外提供了 Amazon 五域的全公开对比,可复现性更好。
HA-MoE HA-MoE: Heterogeneous Ranking in Industrial-Scale Recommender Systems(Google LLC, 2026-07-30)¶
关系:独立并发(本文未引用 HA-MoE,两者殊途同归)· 已加载对方精读
- 共同关注的问题:HA-MoE 把 Google Discover 统一排序器的困境总结为"共享表征架构强制单一 latent 表征服务所有内容类型,因而高度易受冲突目标间的负迁移与 minority-type collapse 影响"。这与 DuELRec 的诊断结构完全同构:只不过 DuELRec 的"异构段"是业务域,HA-MoE 的是内容类型 / 任务。两者都不是"某个模型不够强",而是"一个被迫共享的表征吞掉了段间差异"。
- 相近的技术骨架:两者的解法可以抽象成同一张流程图——取一个显式的段身份信号 → 用它驱动一个门控 → 在多个专家之上做自适应加权 / 调制。HA-MoE 把显式异构信号 $h$(content_type、followed-creator status 等)注入 multi-gate 的门控输入(HA-Gating,式 $g_t(x,h) = \mathrm{Softmax}(W_t\Phi(x,h)+b_t)$),再用 FiLM 式仿射调制专家输出(HDLM,$\tilde{E}_n = \gamma_n(h)\odot E_n(x)+\beta_n(h)$);DuELRec 用域身份决定注意力掩码的形状,再用 item 级门控在两个专家间加权。两者甚至都刻意把方案设计得很轻:HA-MoE 受"<5% 模型体积、<0.5% 时延"的硬预算约束、只在最后一层做调制,DuELRec 的专家只有 2 层(骨干 22 层)。
- 本文的差异与推进:条件信号作用的位置根本不同。HA-MoE 的异构信号只改变特征向量(门控输入 + 仿射调制),专家本身看到的输入序列是一样的;DuELRec 的域信号改变的是注意力可见性——单域专家在结构上被禁止看到其他域的 item。这是一种更强的先验:它保证了单域专家的输出在构造上就是无偏的,从而使式 (9)(10) 的偏差-方差分解成立。反过来 HA-MoE 更强的是可观测性:它配了 LENS 框架来定量追踪专家特化随时间的演化,而 DuELRec 对门控行为的检查只有 Fig. 4 的两个域可视化。
- 可比的方法/实验差异:两者都是"固定预算下做异构特化"的工业实践,且都用门控激活的分布作为机制成立的证据(HA-MoE 的 activation slicing 按 content type 行归一化后看每个专家的比例贡献;DuELRec 的 Fig. 4 看 Jewelry vs Web-Hist 的单域/跨域权重)。HA-MoE 完全依赖内部数据集(论文明说公开数据集缺乏所需的内容异构性),无公开可比数字;DuELRec 至少在 Amazon 五域上给了 26 个 baseline 的完整对比,这一点上可复现性明显更好。
OneModel OneModel: A Unified Foundation for Platform-Scale Multi-Scenario Ranking(Xiaohongshu, 2026-08-19)¶
关系:独立并发(本文未引用 OneModel;两篇仅相隔 5 天)· 已加载对方精读
- 共同关注的问题:OneModel 把统一多流建模的四条障碍中的第二条写为"朴素参数共享会引入跨业务干扰:目标相关但冲突,直接共享底座会产生负迁移",第三条是"统一模型仍需支持业务特化,但又不能退化成完全分离的多塔"。这与 DuELRec 面临的张力是同一个:既要跨域共享(否则失去 CDSR 的意义),又要域内纯净(否则负迁移)。两者都拒绝"每个域各建一个模型"的退化解,也都拒绝"完全共享"的朴素解。
- 相近的技术骨架:两者都在共享骨干内部插入一个由段身份驱动的门控,用来在"共享"与"特化"之间连续调节。OneModel 的 SAIM(Scenario-aware Information Modulation) 是一个由 scenario-ID embedding 驱动的 sigmoid 逐通道门,在保持单一共享计算图的前提下买到流级特化;DuELRec 的 item-wise gating 由 $\mathbf{V}_s + \mathbf{V}_c$ 驱动,在两个专家间做 softmax 加权。两者也都把"门控确实学到了段依赖的分工"当作机制成立的关键证据。
- 本文的差异与推进:门控的操作对象与粒度不同。SAIM 是通道级的、且条件只来自场景 ID(一个静态的段标识),它调制的是同一条计算路径的激活;DuELRec 的门控是 item 级的、条件来自两条结构上不同的计算路径的输出,因此它能对同一个域内的不同 item 给出不同权重(Fig. 4 显示的是域级平均,但机制是逐 item 的)。另一个差异是理论支撑:DuELRec 给出了最优门控的闭式解 (10) 并据此解释权重走向,OneModel 只报告了门控均值。反过来 OneModel 覆盖的工程面更宽(分层用户表示、增量状态缓存、梯度隔离、解耦服务),而 DuELRec 的部署描述停在"离线算 item embedding + 向量库检索"。
- 可比的方法/实验差异:一个有趣的可直接对照的数据点——OneModel 报告三条流的 SAIM 平均门控激活为 Rec 0.61 / Ads 0.54 / Merchant 0.58,并坦承"三个不同的均值也可能只反映整体尺度差异",属于必要非充分证据;DuELRec 的 Fig. 4 给的是同一类证据(Jewelry 偏单域、Web-Hist 偏跨域),但因为有式 (11) 的理论预测作为对照,且门控方向与 Table 4 中各域负迁移的严重程度独立可验证地一致,证据链比 OneModel 更闭合。消融幅度上,OneModel 去掉 SAIM 只掉 1.1‰ Click AUC,DuELRec 去掉整个 DGDE 在 Call-Log 上掉 49.0% MRR——量级差异反映了两者在各自系统里的地位:SAIM 是锦上添花,DGDE 是承重墙。
讨论与局限性¶
值得借鉴的设计¶
- "改 mask 不改骨干"是一个极高性价比的粒度对齐手段。当 LLM 的自回归粒度(token)与下游任务的目标粒度(item / 事件 / 会话)不一致时,用块级掩码把 attention 的可见性边界定义在任务粒度上,比改 tokenizer、加 special token、或做两阶段压缩都要轻。DuELRec 只在 22 层骨干之上加 2 层专家就完成了这件事。
- 把"要不要跨域"变成一个可学的逐样本变量,而不是一个全局超参。式 (9)–(11) 的偏差-方差分解给出了这个变量的最优值应该是什么,并且这个理论预测在 Fig. 4 上被观察到了。这套"给门控一个闭式最优解作为解释锚点"的做法,比单纯堆一个 MoE 有说服力得多。
- 负采样池的域范围本身是一个被长期忽略的超参。既往 CDSR 默认 $p=0$(同域采负),而本文实测这是最差设定。这个改动的实现成本近乎为零,但消融显示它与整个双专家模块同等重要。
- 专家数与域数解耦是可扩展性的关键。SyNCRec 每域一个专家、成对 CDR 需要 $O(|\mathcal{D}|^2)$ 个模型,都无法上到十几个域;DuELRec 恒定两个专家,因此线上能直接扩到 14 个域。
局限与争议¶
- "缓解了所有域的负迁移"的措辞过强。Table 4 中 DuELRec 在 Call-Log 的 NDCG@5(−5.40%)与 MRR@10(−6.30%)仍为负;Table 3 中 Web-View 与 Benefits 的 NDCG@10 / MRR@10 也未做到最优。准确的表述应是"HR@5 口径下全域正增益,排序质量口径下大幅缩小但未消除"。
- Games 域的失手没有被真正解释。论文只说"虽未超过 RecFormer 但整体一致更优"。考虑到 Games 是最稠密、item 最少的域,一个自然的假设是门控在这类域上过度保守,但论文没有给 Games 的门控权重分布来验证或证伪。
- 跨域专家的贡献比叙事暗示的要小。消融 (C) w/o CE 平均只掉 1.3%,在两个域上甚至微涨。这意味着 DuELRec 的主要收益来自"item-aware attention 把协同信号找回来",而"跨域迁移"本身贡献有限——但论文的标题与叙事重心都落在跨域上。
- 只测了一个 1.1B 骨干,没有 scaling 证据。TinyLlama-1.1B 的选择被解释为服务效率要求,合理,但整篇没有回答"骨干换成 7B / 更大之后,双专家还是不是必要的"这个关键问题——有可能更大的 LLM 自己就能学到 item 级协同信号,从而稀释本方法的价值。
- 方法论可扩展性存在一处隐患:item embedding 由 LLM 骨干离线预计算并写入向量库(附录 C),这使得 item 表征与序列建模在服务期是解耦的。这带来了时延可控性,但也意味着 item 侧表征无法随用户侧序列上下文动态调整;当参数量 scaling 时,"如何表征 item"与"如何建模序列"这两条路径不能完全同步增长。这与 SIF / IAT 那类"先离线压缩再在线建模"的范式共享同一类长期上限风险,尽管 DuELRec 的训练阶段是端到端的(ItemEmb 与骨干共享参数),程度要轻得多。
- 线上实验的流量分配披露与曝光数据不一致(宣称 45:35:20,实际曝光比 ≈45.6:39.0:15.8),且本文桶曝光量最小。这不影响 $p<0.01$ 的结论,但削弱了对照的严格性。
- Telco 数据集不公开,五个工业域的结论无法被外部验证;Amazon 部分则完全可复现(代码已开源)。