OneModel: A Unified Foundation for Platform-Scale Multi-Scenario Ranking¶
研究动机与背景¶
工业排序的技术主线在过去几年经历了一次明显的位移:从以特征交叉为核心的判别式效用估计(Wide&Deep、DeepFM、DCN、xDeepFM 等),转向以 HSTU、GenRank、MTGR 为代表的大规模序列排序系统。后者把重心放在动作感知的长上下文行为序列上,并因此展现出一条更清晰的 scaling 路径——更多数据、更长上下文、更大模型容量都能持续换来收益。
但论文指出,这条 scaling 路径依赖一组"重型能力":长历史记忆、更强的内容理解、大规模 embedding、多模态建模。这些能力训练贵、服务贵、迭代也贵,会吃掉大量算力、存储与工程资源。于是一个很自然的工业问题浮出水面:这些重型能力应该被跨业务复用,而不是在每条业务线上各建一套。
在小红书这样的复合平台上,用户在一次连续的使用旅程里会同时穿过三条业务流——自然推荐(organic recommendation)、广告(advertising)、商家服务(merchant services),论文统称为 multi-stream behaviors。
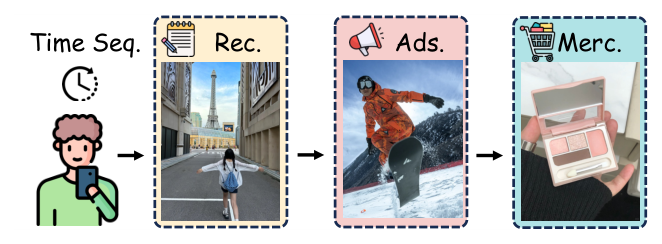
这三条流共享同一批用户、同一批内容、同一批意图信号:内容消费常常泄露购买意图,广告响应反映商业化偏好,商家侧行为则为通用兴趣建模提供了高价值监督。一个统一的多流模型既能复用这些跨流信息换取效果,又能用一套共享底座替换掉多套孤立的长序列模型、embedding 系统与内容理解流水线。
统一并不轻松。论文把障碍拆成四条:
- 特征 schema 与价值信号异构:推荐看兴趣匹配,广告看 ROI,商家看转化与 GMV,三者的特征空间与优化目标都不同;
- 朴素参数共享会引入跨业务干扰:目标相关但冲突,直接共享底座会产生负迁移;
- 统一模型仍需支持业务特化,但又不能退化成完全分离的多塔(否则统一就失去意义);
- 共享底座必须满足严苛的工业服务约束——长上下文建模不可能对每个请求重算一遍。
对应地,OneModel 给出四件事:把多流行为映射进共享事件序列(应对 1)、用 action-oriented 长上下文骨干复用重型能力(应对可 scaling 的部分)、引入 Scenario-aware Information Modulation (SAIM) 与模块化多目标优化(应对 2、3)、以及分层用户表示 + 增量用户状态缓存 + 向量化候选打分的解耦服务方案(应对 4)。
论文自陈的三点贡献:提出平台级多流统一精排框架并把可复用的用户/内容理解沉淀为共享底座;设计了统一跨流表示、action-oriented 长上下文骨干、SAIM、分层用户建模、模块化多目标优化与解耦在线服务这一整套组件;在小红书真实生产系统落地并跑通三条业务流的线上 A/B。
问题形式化¶
论文在用户集 $\mathcal{U}$、物品集 $\mathcal{I}$ 与业务流集合 $\mathcal{S} = \{\text{recommendation}, \text{advertising}, \text{merchant}\}$ 上定义平台级多流排序。每个物品 $i \in \mathcal{I}$ 带一个流来源 $s_i \in \mathcal{S}$ 与异构特征 $\mathbf{x}_i$。对用户 $u$,跨流行为历史被表示为按时间排序的序列
$$\mathcal{H}_u = \{e_1, e_2, \ldots, e_L\}$$
其中每个事件 $e_j = (i_j, s_j, a_j, t_j)$ 记录了交互物品、所属业务流、动作类型与时间戳,且 $t_1 < t_2 < \cdots < t_L$。
OneModel 学习统一函数 $f_\theta$ 把 $\mathcal{H}_u$ 映射为用户表示 $\mathbf{u}$,并同时支持两个相关目标:
- 生成式检索(generative retrieval):从统一物品池中预测下一个交互物品,即建模 $P(i_{L+1} \mid \mathcal{H}_u)$;
- 流特定排序(stream-specific ranking):估计候选物品 $i$ 在业务流 $s$ 下的目标动作概率 $\hat{y} = g(\mathbf{u}, \mathbf{x}_i, s)$。
这个设定要求统一模型同时处理异构特征空间、抑制跨流负迁移、并满足实时服务约束。
核心方法 / 模型架构¶
1. 统一跨场景表示学习¶
为把异构输入统一起来,OneModel 把场景特有的物品特征与行为上下文映射进一个共享的 event-token 空间。该模块分两步:scenario-aware feature projection 与 structural context integration。
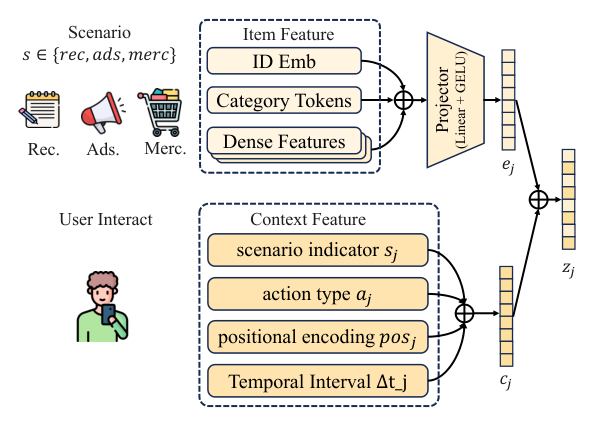
Scenario-aware Feature Projection. 给定来自业务流 $s \in \mathcal{S}$ 的物品 $i$,先把它的异构原始特征——ID embedding、类目 token、归一化稠密特征——拼接为 $\mathbf{x}^{(s)}_i$。为在映射进统一空间的同时保留流特有的特征结构,施加一个轻量的场景专属投影:
$$\mathbf{e}_i = \phi\left(\mathbf{W}^{(s)} \mathbf{x}^{(s)}_i + \mathbf{b}^{(s)}\right) \tag{1}$$
其中 $\mathbf{W}^{(s)}$ 与 $\mathbf{b}^{(s)}$ 是场景专属参数,$\phi(\cdot)$ 是激活函数(实现上为 Linear + GELU)。得到的 $\mathbf{e}_i$ 提供了跨场景可比的物品表示。这里的设计取舍值得注意:投影矩阵按场景私有,因此每条流可以有完全不同的输入 schema 和维度;而输出被强制到同一空间,因此下游骨干只需要一套参数。
Structural Context Integration. 为把每次用户交互编码成结构化的 event token,模型把场景、动作、时序与位置上下文注入物品表示:
$$\mathbf{z}_j = \mathbf{e}_{i_j} + \underbrace{\text{Embed}(s_j, a_j, \Delta t_j, pos_j)}_{\text{Context Embedding } \mathbf{c}_j} \tag{2}$$
其中 $s_j$ 是场景指示符,$a_j$ 是动作类型,$pos_j$ 是位置,$\Delta t_j = t_j - t_{j-1}$ 是时间间隔。$\Delta t_j$ 用多频正弦嵌入编码,场景与动作类型这类离散属性用可学习嵌入。这些结构化 token 给长序列骨干提供跨场景可比的输入,同时保留了 recency、动作意图、场景身份等行为语义。
2. 分层跨场景序列建模¶
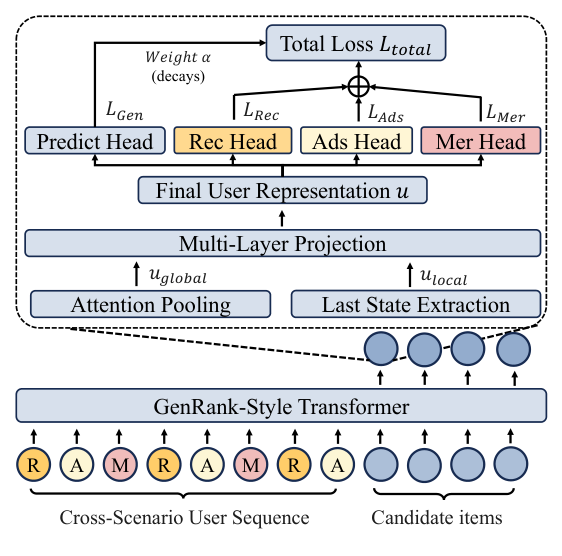
序列模块建立在 GenRank 风格的 action-oriented 骨干上,包含四项设计:动作导向的 tokenization(压缩有效序列长度)、序列编码前的显式 item-context 交互、带候选掩码的统一因果解码器、场景感知信息调制与分层用户表示。
Action-oriented organization. 沿用 GenRank 的做法,OneModel 把动作当作预测目标、把物品当作上下文信号,从而避免了显式交错 item token 与 action token 所带来的序列长度翻倍。与 HSTU 式 tokenization(保留分离的 item 与 action token,能保留更细粒度的交互语义)相比,这种组织方式显著缩短了有效序列长度并改善服务效率。另一处与既有做法的差异是:OneModel 并不直接把 item-context 特征压进序列 token,而是先做显式的 item-context 交互再进序列编码,这样在保持骨干紧凑的同时强化了候选侧的特征交叉。
给定历史交互 $\{(x_i, a_i, t_i)\}_{i=1}^{N}$,模型建模
$$p(a_k \mid x_1, a_1, \ldots, x_k) \tag{3}$$
每个历史 token 表示为
$$\mathbf{e}_i = \phi(x_i) + \varphi(a_i) + \mathbf{c}_i \tag{4}$$
其中 $\phi(\cdot)$ 是统一物品表示,$\varphi(\cdot)$ 是动作嵌入,$\mathbf{c}_i$ 承载结构上下文。对候选物品 $\{x_j\}$,使用一个掩码动作嵌入 $\mathbf{m}$ 来防止目标动作泄漏:
$$\mathbf{e}^{\text{cand}}_j = \phi(x_j) + \mathbf{m} + \mathbf{c}^{\text{cand}}_j \tag{5}$$
统一跨场景解码器. 把 token 序列 $\mathbf{E} = [\mathbf{e}_1, \ldots, \mathbf{e}_N, \mathbf{e}^{\text{cand}}_1, \ldots, \mathbf{e}^{\text{cand}}_M]$ 送入共享的因果 Transformer 解码器,同时施加因果掩码与候选掩码:前者保持时序,后者阻断同一请求内候选之间的注意力(否则候选集组成会泄漏进单个候选的打分,破坏 pointwise 打分的独立性):
$$\mathbf{X}^{(l)} = \mathbf{H}^{(l-1)} + \text{Attn}\left(\text{Norm}(\mathbf{H}^{(l-1)}); \mathbf{M}_{\text{causal}}, \mathbf{M}_{\text{cand}}\right) \tag{6}$$
$$\mathbf{H}^{(l)} = \mathbf{X}^{(l)} + \text{FFN}\left(\text{Norm}(\mathbf{X}^{(l)})\right) \tag{7}$$
为高效编码位置与时间,结构上下文定义为
$$\mathbf{c}_i = \mathbf{E}^{pe}_i + \mathbf{E}^{ri}_i + \mathbf{E}^{rt}_i + \text{Embed}(s_i) \tag{8}$$
其中 $\mathbf{E}^{pe}_i$、$\mathbf{E}^{ri}_i$、$\mathbf{E}^{rt}_i$ 分别编码交互位置、请求索引(request index)与分桶后的请求前时间间隔。额外还用了 ALiBi 式线性偏置提供相对时序归纳偏置,避免二次规模的 bias table 开销。注意"请求索引"这个字段是工业场景特有的:同一次请求下发的多个曝光在时间戳上几乎相同,只有请求粒度的编号才能把"同一屏"与"跨屏"区分开。
Scenario-aware Information Modulation (SAIM). 为降低混合流 token 之间的干扰,模型在 FFN 里插入一个轻量的场景条件门控。
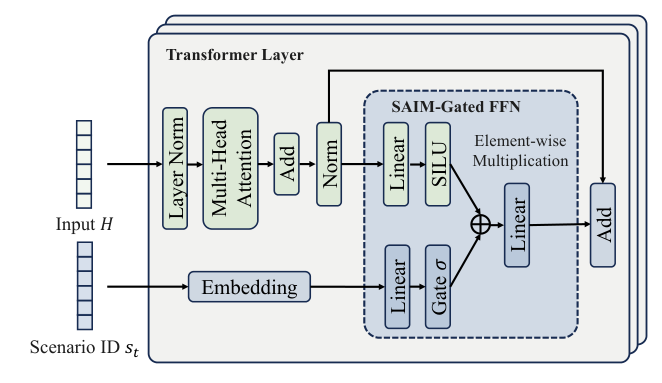
对场景为 $s_t$ 的 token $t$,门控为
$$\mathbf{g}_t = \sigma(\mathbf{W}_g \mathbf{e}_{s_t} + \mathbf{b}_g), \qquad \mathbf{g}_t \in (0,1)^{d_f} \tag{9}$$
FFN 输出变为
$$\text{FFN}^{(s_t)}(\mathbf{h}_t) = \left(\text{SiLU}(\mathbf{W}_1 \mathbf{h}_t) \odot \mathbf{g}_t\right) \mathbf{W}_2 + \mathbf{b}_2 \tag{10}$$
这个设计的关键在于:它保持了一张共享计算图,同时允许逐通道的流依赖调制。门控只由场景 ID 的嵌入决定(与 token 内容无关),因此它学到的是"哪些 FFN 通道对该业务流有用"这种静态的通道分工,而不是逐样本的动态路由。这比 MoE 式的稀疏路由便宜得多——没有额外专家参数、没有路由负载均衡问题、也不破坏算子融合——代价是表达力更弱。
Stratified user representation. 为同时捕捉长期偏好与短期意图,模型把全局注意力池化与最终局部状态组合起来:
$$\mathbf{u}_{global} = \sum_{t=1}^{L} \alpha_t \mathbf{h}^{(L)}_t, \qquad \alpha_t = \text{Softmax}\left(\mathbf{v}^\top \tanh(\mathbf{W}_a \mathbf{h}^{(L)}_t)\right) \tag{11}$$
$$\mathbf{u} = \text{MLP}\left(\left[\mathbf{u}_{global} \,\|\, \mathbf{u}_{local}\right]\right) \tag{12}$$
其中 $\mathbf{u}_{local} = \mathbf{h}^{(L)}_L$ 即序列最后一个位置的隐状态。下游多任务预测头消费融合后的 $\mathbf{u}$。这条设计的动机是:因果解码器的最后状态天然偏向近期行为,若只用它则长期偏好被稀释;而只用注意力池化又会抹平"刚刚在看什么"这一强信号。
3. 端到端多场景优化¶
OneModel 用一个统一的多目标 loss 端到端联训所有组件,把自监督的 next-item 预测、有监督的流特定预测与参数正则组合起来:
$$\mathcal{L} = \alpha \cdot \mathbb{E}_u\left[-\sum_{j=1}^{L-1} \log P(i_{j+1} \mid \mathcal{S}_{\le j})\right] + \beta \sum_{k=1}^{K} \lambda_k \cdot \mathbb{E}_{(u,i)\sim\mathcal{D}_k}\left[\ell_k(\hat{y}^{(k)}, y^{(k)})\right] + \gamma \|\Theta\|_2^2 \tag{13}$$
第一项从混合历史中学通用序列偏好,第二项把表示对齐到 $K$ 个流特定目标,第三项正则化参数。
三条调度细节值得记:
- $\alpha$ 衰减、$\beta$ 增长:训练早期偏重表示学习(自监督),后期偏重任务对齐。这与 Figure 3 里标注的 "Weight $\alpha$ (decays)" 一致。
- $\lambda_k$ 与流 $k$ 的验证集 AUC 成反比:越难的流权重越大,避免模型只在容易的流上刷分。
- 交叉流批采样(cross-stream batch sampling):防止高频流(Rec 流量是 Ads 的 5 倍、Merchant 的约 6.7 倍)主导共享骨干。
此外还有两项稳定性/效率手段:
- 早期梯度隔离(early-stage gradient isolation):warm-up 阶段暂时把骨干梯度与流特定塔断开,减少噪声更新污染共享表示。直觉是:随机初始化的任务塔在早期会产生互相冲突的噪声梯度,先让塔"热起来"再让它们回传到骨干。
- 选择性反向传播(selective backpropagation):主要在高困惑度(high-perplexity)步上计算梯度,跳过容易的位置,以削减超长序列的训练成本。
4. 在线服务策略¶
为支撑实时排序,OneModel 把长上下文用户编码与请求时候选打分解耦。用户状态
$$\mathbf{z}_u = f_\theta(\mathcal{H}_u)$$
在新交互发生后增量更新并缓存在低延迟 KV 存储中,从而避免每个请求都重跑一遍 Transformer 推理。排序时,候选特征被堆叠成 $\mathbf{V} \in \mathbb{R}^{N \times d_v}$ 并通过向量化计算打分:
$$\mathbf{s} = G_\Phi(\mathbf{z}_u, \mathbf{V}) \tag{14}$$
其中 $G_\Phi$ 是任务特定打分函数。在此之上还叠了四项系统级优化:特征分解(feature decomposition)把可复用的用户侧计算与请求时候选打分分开;用户特征预取(user feature prefetching)把部分特征拉取成本挪到排序请求之前;共享用户塔计算(shared user-tower computation)避免对不同候选重复编码同一用户状态;图级推理优化(graph-level inference optimization)消除在线推理中的冗余算子。
实验设置¶
数据集. 在小红书生产平台的匿名化 10% 流量切片上评测,覆盖三条业务流,相对流量比约为 recommendation : advertising : merchant = 1 : 0.2 : 0.15。用户、物品、上下文与交互特征被组织成按时间戳排序的多流行为序列。出于数据保密,论文只报告相对流量比与聚合评测结果,不报告绝对的用户数、物品数或交互数。
指标. 离线用按时间戳切分的测试集上的 AUC 与 LogLoss;主实验覆盖 Click、Collect、Comment、PageTime、Follow、Hide、Like 七个预测目标的多目标 AUC。消融与 scaling 分析报告 AUC 或相对 AUC 变化。线上报告生产业务指标与服务效率(用户互动、广告价值、商家转化、延迟、吞吐、归一化 GPU 成本)。
实现. PyTorch 实现,TFRecord 数据上用分布式 NCCL 训练。默认配置:序列长度 500、物品 embedding 维度 768、3 个 Transformer block、8 个注意力头、FFN 宽度 768、dropout 0.2。使用 bf16 混合精度、flash-attention、gradient checkpointing,以及带 in-batch 负样本的 sampled softmax。附录补充:温度 0.05、学习率 1e-4、weight decay 为 0;按时间戳切分训练/验证/测试以避免未来信息泄漏;统一训练下 Rec/Ads/Merchant 的 batch 共享同一骨干但保留各自的流特定预测目标。特征侧包括用户侧(人口属性、长期兴趣画像、活跃度统计)、物品侧(内容元数据、可得时的多模态表示)、上下文(时间、设备、入口、页面上下文)与交互特征(点击、点赞、浏览、停留时长、转化)。
Baseline. 对比两个代表性长序列排序骨干:HSTU(长 item-action 序列设计)与 GenRank(action-oriented 组织,作为紧凑高效导向的 baseline)。两者都在单场景与跨场景设定下评测。
论文用六个 RQ 组织实验:RQ1 效果、RQ2 组件贡献、RQ3 scaling、RQ4 多流优化稳定性、RQ5 线上收益、RQ6 服务效率。
主要实验结果(RQ1)¶
Table 1:单流与多流设定下的主结果(列为不同预测目标的 AUC,"PageTime" 指页面停留时长预测)
| Business Stream | Setting | Model | Click | Collect | Comment | PageTime | Follow | Hide | Like |
|---|---|---|---|---|---|---|---|---|---|
| 单流设定:仅用广告流训练与评测 | |||||||||
| Advertising | Single | HSTU | 0.7644 | 0.8991 | 0.9006 | 0.6736 | 0.9156 | 0.8782 | 0.8814 |
| Advertising | Single | GenRank | 0.7648 | 0.8995 | 0.9010 | 0.6740 | 0.9160 | 0.8786 | 0.8818 |
| Advertising | Single | OneModel | 0.7682 | 0.9032 | 0.9047 | 0.6786 | 0.9193 | 0.8822 | 0.8858 |
| 多流设定:在全部业务流上统一训练 | |||||||||
| Advertising | Unified | OneModel | 0.7712 | 0.9072 | 0.9082 | 0.6836 | 0.9221 | 0.8864 | 0.8908 |
| Recommendation | Unified | OneModel | 0.7905 | 0.9754 | 0.9609 | 0.7939 | 0.9769 | 0.9353 | 0.9616 |
| Merchant | Unified | OneModel | 0.7819 | 0.9433 | 0.9323 | 0.7261 | 0.9298 | 0.8702 | 0.9358 |
结论分析:
- 在广告单流设定下,GenRank 在所有七个目标上都略优于 HSTU(Click 0.7648 vs 0.7644,其余目标各高 0.4‰ 左右)。作者的解释是:在只有广告流的设定下,action-oriented 组织提供了更好的精度–效率权衡。这个结论对工业选型有价值——它说明"保留细粒度 item/action 分离 token"带来的语义收益,未必能抵消序列长度翻倍的代价。
- OneModel 在单流设定下就已超过两个 baseline,Click AUC 从 GenRank 的 0.7648 提升到 0.7682,即 +3.4‰。这部分收益不来自跨流数据(此时还没有),只来自"显式 item-context 交互 + 紧凑序列编码"的组合。
- 统一训练把差距拉大到 +6.4‰(0.7712 vs 0.7648)。多出来的 3.0‰ 正是跨流信息复用的净收益。
- 统一训练下,OneModel 在 Rec / Ads / Merchant 三条流上都维持了强性能,说明一个共享模型确实能同时支撑异构业务目标——这是全文最核心的可行性论证。
值得注意的是三条流的绝对 AUC 差异:Rec 流在 Collect/Follow/Like 上都超过 0.96,而广告流的对应目标只有 0.90 左右,PageTime 更是只有 0.68。这与流量比一致——高流量流的样本更充分、行为模式也更规整。
消融与分析(RQ2)¶
论文从训练策略、输入序列、模型组件三个层面做消融,为清晰起见统一报告 Click AUC。
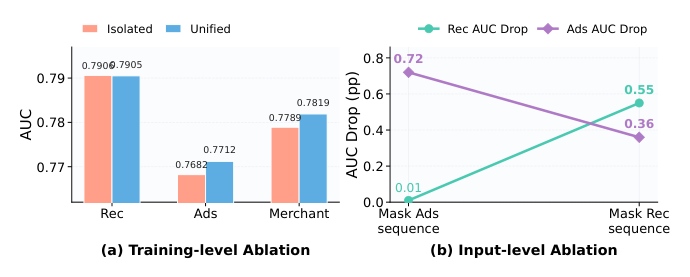
训练层消融¶
| Stream | Isolated | Unified | Δ |
|---|---|---|---|
| Rec | 0.7906 | 0.7905 | −0.1‰ |
| Ads | 0.7682 | 0.7712 | +3.0‰ |
| Merchant | 0.7789 | 0.7819 | +3.0‰ |
结论分析:统一训练把 Ads 从 0.7682 拉到 0.7712、Merchant 从 0.7789 拉到 0.7819,各 +3.0‰;而 Rec 基本不动(0.7906 → 0.7905)。这说明两条低资源流从共享骨干中受益,而占主导的 Rec 流没有遭受有意义的负迁移。这条结果是全文最重要的证据:它把"统一是否值得"这个问题拆成了"弱流拿到多少 / 强流赔掉多少",答案是 +3.0‰ / −0.1‰。反过来说,这也隐含了一个不那么讨喜的推论——主流量场景从统一里几乎拿不到效果收益,它的收益主要在工程侧(省掉一套系统)。
输入层消融¶
在推理时掩掉不同子序列,检验跨场景历史是否真的提供了有用证据。注意 y 轴单位是 pp(percentage point,即绝对 AUC × 100),比其他实验的 ‰ 大一个数量级。
| 掩码操作 | Rec AUC Drop (pp) | Ads AUC Drop (pp) |
|---|---|---|
| Mask Ads sequence | 0.01 | 0.72 |
| Mask Rec sequence | 0.55 | 0.36 |
结论分析:
- 对 Ads 预测而言,掩掉它自己的广告历史造成最大跌幅(0.72 pp)——这是意料之中的自洽性检查;
- 但掩掉 Rec 子序列也让 Ads AUC 掉了 0.36 pp,约为自身历史贡献的一半。这是"内容消费行为为广告排序提供辅助意图信号"这一论断最直接的量化证据,也是整篇论文跨流迁移主张的核心支撑。
- 反过来,Rec 预测在移除 Ads 历史后几乎不受影响(0.01 pp),与 Rec 是最高资源流这一事实一致。
这组不对称性很有意思:信息流动是单向的——低资源流吃高资源流的红利,反之则几乎没有。这也解释了训练层消融里 Rec 为什么纹丝不动。
组件层消融¶
Table 2:统一多流训练下 OneModel 在广告流上的模块消融(Δ 为相对完整 OneModel 的 Click AUC 绝对下降,单位 ‰)
| Variant | Click AUC | Δ (‰) |
|---|---|---|
| Full OneModel | 0.7712 | – |
| w/o Unified Rep. | 0.7698 | 1.4 |
| w/o SAIM | 0.7701 | 1.1 |
| w/o Stratified Rep. | 0.7704 | 0.8 |
结论分析:移除统一表示、SAIM、分层用户表示分别带来 1.4‰、1.1‰、0.8‰ 的一致下降,三者合计 3.3‰,与统一训练相对孤立训练的总收益(3.0‰)量级吻合。贡献排序也符合直觉:表示对齐 > 场景调制 > 多时间尺度用户建模——先要让不同流的 token 可比,调制才有意义。需要指出的是,这三项都是单项移除(非累积),论文没有给出组合消融,因此无法判断三者是否存在冗余。
Scaling 分析(RQ3)¶
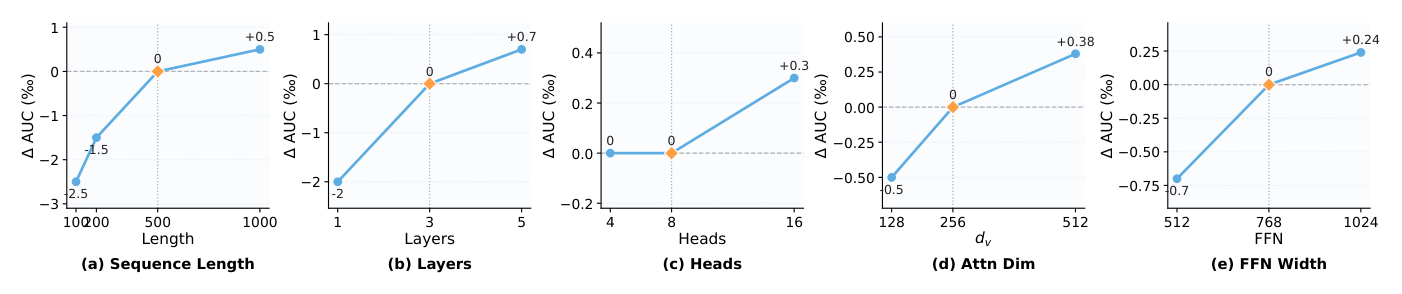
基准配置为 3 层、8 头、$d_v = 256$、FFN 宽度 768,序列长度 500;每次只变一个维度。
| 维度 | 取值 → ΔAUC (‰) |
|---|---|
| 序列长度 | 100 → −2.5;200 → −1.5;500 → 0(部署配置);1000 → +0.5 |
| 层数 | 1 → −2.0;3 → 0;5 → +0.7 |
| 注意力头数 | 4 → 0;8 → 0;16 → +0.3 |
| 注意力维度 $d_v$ | 128 → −0.5;256 → 0;512 → +0.38 |
| FFN 宽度 | 512 → −0.7;768 → 0;1024 → +0.24 |
结论分析:
- 序列长度:短历史明显伤害性能(100 掉 2.5‰、200 掉 1.5‰),但从 500 拉到 1000 只换来 +0.5‰。收益曲线在 500 附近已明显走平,因此部署配置选 500 以平衡精度与服务成本。
- 深度是最敏感的维度:3 层降到 1 层掉 2.0‰,扩到 5 层涨 0.7‰。这与"深度提供更多次的跨 token 信息混合"的直觉一致,也提示继续加深是最有性价比的 scaling 方向。
- 头数影响最弱:8 降到 4 几乎无变化,扩到 16 只涨 0.3‰。
- 注意力维度居中:128 掉 0.5‰,512 涨 0.38‰。
- FFN 宽度趋势类似但更弱:512 掉 0.7‰,1024 涨 0.24‰。
综合看,五个维度的"上扩收益"都在 +0.24‰ 到 +0.7‰ 之间,而"下调损失"要大得多(最多 −2.5‰)。这说明当前配置已经站在收益递减区的拐点右侧——论文的 scaling 主张更准确的表述是"不会饱和/不会退化",而非"持续显著增长"。这是本文相对 HSTU / RankMixer 那类以 scaling law 为核心卖点的工作的一处明显弱项:它没有给出跨数量级的 scaling 曲线,只做了单点邻域的敏感性分析。
训练稳定性分析(RQ4)¶
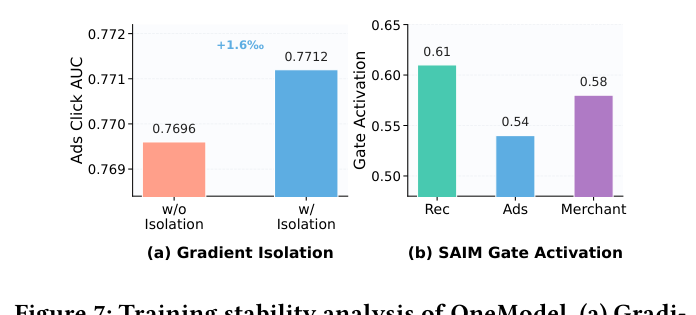
梯度隔离的效果:移除梯度隔离后 Ads Click AUC 从 0.7712 掉到 0.7696,即隔离带来 +1.6‰。这证实了当多个流特定 loss 同时更新共享骨干时,优化稳定化是有用的——早期任务塔会产生噪声或冲突梯度,梯度隔离让任务塔先 warm up 再完整影响共享表示。注意 +1.6‰ 这个数字比 SAIM 本身的贡献(1.1‰)还大,说明在多流统一训练里,"怎么训"的重要性不亚于"架构怎么设计"。
SAIM 门控行为分析:三条流的平均门控激活值分别为 Rec 0.61、Ads 0.54、Merchant 0.58。这说明 SAIM 并没有对所有流施加同一变换,而是学到了流依赖的逐通道调制,在共享建模与流特定特化之间取得平衡。不过这个证据偏弱——论文只报告了标量均值,没有给出通道级激活分布或专家特化的可视化,因此"确实学到了有意义的分工"这一结论只能算是必要条件而非充分条件(三个不同的均值也可能只反映了三条流的整体尺度差异)。
线上效果评估(RQ5)¶
在 Explore Feed、Feed Advertising、Merchant Recommendation 三个场景对现有生产排序系统做 A/B,用户随机分配到对照组与实验组。作为离线 sanity check,OneModel 相对生产 ranker 在 Click 上 AUC +0.3%、Like 上 +0.04%,与线上结果一致。
Table 3:线上 A/B 测试结果(指标为相对对照组的相对变化)
| Metric | Description | Rel. Change |
|---|---|---|
| Explore Feed | ||
| Time Spent | 用户消费时长 | +0.33% |
| Reads | 内容阅读行为 | +0.63% |
| Engagement | 用户互动 | +1.25% |
| LT7 | 长期用户价值 | +0.15% |
| Feed Advertising | ||
| ADVV | 广告价值 | +3.43% |
| CTR | 点击率 | +8.18% |
| Impressions | 曝光量 | −1.07% |
| CPM | 千次曝光成本 | +0.90% |
| Merchant Recommendation | ||
| PV | 曝光量 | −0.9513% |
| DGMV | 直接 GMV | +1.1867% |
| DAB | 曝光到购买转化率 | +1.8009% |
| GPM | 千次曝光 GMV | +2.1585% |
| OPM | 千次曝光购买数 | +2.8118% |
结论分析:
- Explore Feed:互动 +1.25% 是最大的收益点,时长 +0.33%、阅读 +0.63%,且 LT7(7 日长期价值)也 +0.15%,说明收益不是靠短期诱导换来的。
- Feed Advertising:CTR +8.18% 是全表最大的相对提升,但需要放在上下文里读——曝光量 −1.07%,也就是说系统在更少的广告曝光上拿到了更高的点击率与 +3.43% 的广告价值。CPM +0.90% 与之一致。这是典型的"效率提升而非流量堆量"的形态。
- Merchant Recommendation:PV −0.9513% 但 DGMV +1.1867%、DAB +1.8009%、GPM +2.1585%、OPM +2.8118%。论文明确指出这表明"在更少曝光下取得了更高的业务效率"。GPM/OPM 这类"每千次曝光"口径的指标涨幅(2.16% / 2.81%)远大于总量指标(DGMV 1.19%),正是因为分母缩了。
需要留一句批注:三个场景的曝光量都是持平或下降的,这意味着收益全部来自排序质量而非流量分配变化,从实验干净度上讲是加分项;但同时也说明这套线上收益是在"同等或更少展位"的约束下取得的,不能简单外推到扩量场景。
线上成本效益评估(RQ6)¶
Table 4:生产 baseline 与 OneModel 的线上成本对比
| Metric | Baseline | OneModel | Rel. Change |
|---|---|---|---|
| Dense Params | 173M | 230M | +32.9% |
| Latency | 270ms | 90ms | −66.7% |
结论分析:稠密参数从 173M 涨到 230M(+32.9%),在线延迟却从 270ms 降到 90ms(−66.7%)。这个反直觉的结果完全来自四项系统级优化:
- 特征分解把可复用的用户侧计算与请求时候选打分分离;
- 用户特征预取把部分特征拉取成本前移到排序请求之前;
- 共享用户塔计算避免为不同候选重复编码同一用户状态;
- 图级优化削减在线推理中的冗余算子。
其中第 1、3 项与 §4.4 的用户状态增量缓存是同一件事的两面:长上下文编码 $O(L^2)$ 的成本被摊到用户维度、并跨请求复用,而请求时只剩 $O(N \cdot d)$ 的候选打分。这也解释了为什么参数量上去了延迟反而下来——baseline 的 270ms 里应该有相当比例是每请求重算序列的开销。这是全文工程上最有说服力的一段:它把"统一带来的算力开销"这一最常见的反对意见直接证否了。
核心贡献总结¶
- 把"业务流"提升为一等建模维度:不是把多场景当作多任务的一个变体,而是把跨流行为当作一条连续的用户轨迹建模,事件 token 显式携带 scenario indicator。
- 统一跨场景表示(式 1-2):场景私有投影 + 共享输出空间,让异构 schema 在不牺牲各自结构的前提下变得可比;配 sinusoidal 时间间隔编码与 request-index 编码这类工业细节。
- SAIM(式 9-10):一个极简的场景条件 FFN 门控,用单张共享计算图换取逐通道的流特化,避免了 MoE 的参数与路由开销。
- 多流训练配方:$\alpha$ 衰减 / $\beta$ 增长的两阶段目标调度、$\lambda_k$ 反比于验证 AUC、交叉流批采样、早期梯度隔离、高困惑度选择性反传——这套组合拳的实测收益(梯度隔离单项 +1.6‰)不亚于架构改动。
- 解耦服务方案:用户状态增量缓存 + 向量化候选打分 + 四项系统优化,在参数 +32.9% 的同时把延迟砍到 1/3。
- 三条业务流的完整线上 A/B:Explore Feed 互动 +1.25%、Feed Advertising ADVV +3.43% / CTR +8.18%、Merchant GPM +2.1585%。
与已归档相关工作的对比¶
MBGR MBGR: Multi-Business Prediction for Generative Recommendation at Meituan(Meituan, 2026-04-03)¶
关系:显式引用但原文未展开对比(仅在 related work 中与 [2, 22, 28, 29] 一并被概括为"聚焦 semantic-ID 生成 / list-level 重排 / 多目标排序 / 单一广告场景")· 已加载对方精读
- 共同关注的问题:两篇的 root cause 完全一致——大平台上用户行为横跨多条业务线(美团是外卖/团购/娱乐/医疗,小红书是自然推荐/广告/商家),为每条业务独立部署一套模型导致训练与维护成本高、且无法利用跨业务用户数据;统一之后又立刻撞上跷跷板效应 / 负迁移与表征混淆。MBGR 明确把这两条列为核心挑战,OneModel 则表述为"朴素参数共享风险跨业务干扰"与"仍需支持业务特化但不能退化成分离多塔"。
- 相近的技术骨架:两者都走"跨业务混合序列 + 共享骨干 + 业务嵌入条件化的门控调制"这条路。MBGR 的 BID 模块用 $\mathbf{g}^{enc}_i = \sigma(\text{FFN}^{enc}_{gate}([\mathbf{e}^{enc}_i, \mathbf{b}_i]))$ 后逐元素相乘(其式 4-5),MBP 模块用 $\mathbf{g}^b = \text{SiLU}(\text{FFN}_{gate}(\mathbf{z}^b))$ 加权聚合 $K$ 个专家(其式 10-11);OneModel 的 SAIM 用 $\mathbf{g}_t = \sigma(\mathbf{W}_g \mathbf{e}_{s_t} + \mathbf{b}_g)$ 在 FFN 内部逐通道相乘(本文式 9-10)。同一套"业务/场景嵌入 → sigmoid 门 → 逐元素调制"的机制,被两个团队分别放在了自编码器、专家聚合与 FFN 三个不同的位置。
- 本文的差异与推进:(a) 任务形态不同——MBGR 是生成式召回(预测下一个 item 的 Semantic ID,指标 Hit@10 与下游 CTCVR GAUC),OneModel 是最终精排(直接输出 AUC,生成式检索只作为式 13 第一项的辅助自监督);(b) 异构性处理位置不同——MBGR 把异构性收敛到共享 SID 空间并靠 business-aware 编解码器缓解表征混淆,OneModel 则根本不引入 SID,直接用场景私有线性投影把原始异构特征打到共享 event-token 空间,绕开了码本固化这一瓶颈;(c) 标签稀疏问题——MBGR 的 LDR 模块专门处理"某业务在位置 $t$ 之后无交互"的稀疏多业务标签,OneModel 没有对应机制,它的多流样本天然来自各流自己的曝光日志;(d) OneModel 额外给了完整的服务侧方案(延迟 270→90ms),MBGR 的系统部署章节更简略。
- 可比的方法 / 实验差异:两篇都只有工业内部数据,无公开数据集可比。MBGR 报告线上 CTCVR +3.98%,OneModel 报告三场景 A/B(Engagement +1.25% / ADVV +3.43% / GPM +2.1585%)。消融口径也不同:MBGR 逐个移除 BID/MBP/LDR 看 Hit@10,OneModel 逐个移除统一表示/SAIM/分层表示看 Ads Click AUC(1.4‰ / 1.1‰ / 0.8‰)。OneModel 多做了一组 MBGR 没有的输入层掩码消融(掩掉 Rec 子序列让 Ads AUC 掉 0.36 pp),这是对"跨业务信息真的有用"最直接的证据,比单纯的端到端指标提升更有说服力。
HA-MoE HA-MoE: Heterogeneous Ranking in Industrial-Scale Recommender Systems(Google, 2026-07-30)¶
关系:独立并发(本文未引用 HA-MoE,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都在解决"单一排序模型服务高度异构的内容/业务分段时的负迁移"。HA-MoE 的场景是 Google Discover 用一个统一 ranker 排开放网络的 web articles / 长短视频 / UGC posts / sports cards / AI 摘要卡;OneModel 的场景是一个统一精排排自然推荐 / 广告 / 商家三条流的候选。两者的 root cause 表述几乎重合:共享表征架构会被"特征更丰富、流量更高"的主导分段主导,HA-MoE 称之为 minority-type collapse 与 seesaw 现象,OneModel 称之为跨流负迁移;而两者又都拒绝退回"分离模型 + late-stage 合并"的老路。
- 相近的技术骨架:解法骨架高度抽象重合——把一个显式的"分段身份信号"喂进网络,让它去调制中间表征,从而在一张共享计算图内实现条件特化。HA-MoE 的 HDLM 受 FiLM 启发,从异构信号 $h$ 算出缩放与平移向量并作用在专家输出上:$\tilde{E}_n(x,h) = \gamma_n(h) \odot E_n(x) + \beta_n(h)$(其式 3-4);OneModel 的 SAIM 从场景嵌入 $\mathbf{e}_{s_t}$ 算出 sigmoid 门并作用在 FFN 中间激活上:$(\text{SiLU}(\mathbf{W}_1\mathbf{h}_t) \odot \mathbf{g}_t)\mathbf{W}_2 + \mathbf{b}_2$(本文式 9-10)。两者都是"条件仿射/门控调制"这一家族,且都刻意只加了极轻的一层,理由也一样:必须守住训练速度与 serving latency 的硬预算。
- 本文的差异与推进:(a) 调制形式——HA-MoE 是完整仿射(scale + shift),OneModel 只有 scale(乘性门),表达力更弱但更省;(b) 条件信号来源——HA-MoE 的 $h$ 是丰富的结构化上下文(content_type、followed-creator status、shoppable、AI-enhanced card 等一大批元数据),OneModel 的条件只有场景 ID 一个离散量,因此 SAIM 学到的是每条流一组静态通道权重(Rec 0.61 / Ads 0.54 / Merchant 0.58),而 HDLM 可以做到逐样本调制;(c) 骨干形态——HA-MoE 的底座是共享 MLP + multi-gate MoE + 11 个任务头(无长序列),OneModel 的底座是长上下文因果 Transformer(序列长度 500),因此 OneModel 还额外要处理"跨流事件如何统一成一条时序 token 流"这个 HA-MoE 不存在的问题;(d) 异构的维度不同——HA-MoE 的异构是内容类型(同一个 feed 里的不同 item 形态),OneModel 的异构是业务流(不同的商业目标与特征 schema)。后者的目标冲突更硬(兴趣匹配 vs ROI vs GMV)。
- 可比的方法 / 实验差异:HA-MoE 把跨类型 xAUC gap 从 0.141 收窄到 0.060,线上 DAU +0.22% / Diverse Engagement Rate +0.54%;OneModel 的 SAIM 消融是 Ads Click AUC −1.1‰,线上三场景全面正向。HA-MoE 额外贡献了 DL-AUC 这一抗 gaming 的异构感知评估指标与 LENS/PIEM 专家特化诊断框架——这正是 OneModel 明显缺失的一块:OneModel 只用三个标量门控均值来论证"SAIM 学到了流依赖调制",若借用 PIEM 式的置换不变诊断,这个论证会扎实得多。反过来,HA-MoE 完全没有长序列与服务侧的故事,OneModel 的用户状态缓存 + 延迟 270→90ms 是它没有的维度。
SAGA SAGA: Structure-Attended Generative Action Embedding Model(PayPal, 2026-08-15)¶
关系:独立并发(发表仅早于本文 4 天,双方互不引用)· 已加载对方精读
- 共同关注的问题:SAGA 的动机第二层与 OneModel 的开篇几乎是同一段话——大型组织会为每个推荐问题各自孤立地建一套系统(PayPal 是 App / Email / Push / 结账 / P2P / 账户管理等触点,小红书是推荐 / 广告 / 商家三条流),这些独立推荐器之间缺乏协同、无法保持一致性,其他 surface 的数据最多被特征工程加工成单向的特征,留不下任何可复用的骨干(shareable backbone)。SAGA 还明确点出:"这些模型通常只在单一平台或相对同构的动作空间内运作,跨异构行为域的学习基本还是空白"——这正是 OneModel 要填的坑。两者也都指认了统一之后的负迁移风险。
- 相近的技术骨架:核心第一步完全同构——把多个 surface / 业务流的异构动作规范化成一套统一的结构化事件 schema,再当成一条时序 token 序列送进 decoder-only Transformer 自回归建模。SAGA 把每个事件变换成六个标准化属性(surface / parent product / product / action intent / interaction / mcc),OneModel 把每个事件定义为 $(i_j, s_j, a_j, t_j)$ 并注入 scenario / action / Δt / position 上下文(本文式 2)。两者都把"来源 surface / scenario"作为 schema 里的一等字段显式保留,而不是靠隐式区分。
- 本文的差异与推进:(a) tokenization 粒度相反——SAGA 用 round-robin 把每个事件展开成 $K=7$ 个字段级 token 以恢复字段间的细粒度注意力(代价是序列长 7 倍,1024 token 只装得下约 146 个事件);OneModel 反其道而行,沿用 GenRank 的 action-oriented 组织把事件压得更紧以缩短有效长度、换取 500 长度的服务可行性。这是同一个问题上的两个相反取舍:SAGA 买表达力,OneModel 买效率。(b) 范式不同——SAGA 是两阶段:预训练后冻结权重、抽末层隐状态作为通用用户嵌入喂给下游 DCN-v2 + ESMM ranker,明确把 fine-tuning 排除在范围外;OneModel 是端到端:骨干与三条流的预测头联合训练(式 13)。按精读评分标准里"显式多阶段解耦"的扩展性隐患看,OneModel 的路线上限更高,但 SAGA 的冻结嵌入更容易被多个既有下游系统复用。(c) 特化机制——SAGA 完全依赖 schema 统一本身来消化异构性,没有任何场景条件调制;OneModel 额外加了 SAIM。SAGA 的消融显示多 surface 数据富集确实带来互补而非冲突,但它没有回答"若某个 surface 流量占绝对主导会怎样"——而这正是 OneModel 训练层消融给出答案的地方(Rec −0.1‰,Ads/Merchant +3.0‰)。(d) SAGA 刻意把 item ID 移出词表(总词表仅 378 token、模型仅 37M 参数),OneModel 则保留 ID embedding 并用到 768 维、230M 稠密参数。
- 可比的方法 / 实验差异:两篇都只有内部工业数据。SAGA 报告在等 token 预算下用 7 倍更少的事件即可匹配或超过 PinFM 式融合($K=1$)与 HSTU 式交错($K=2$)的 tokenization,线上在 TP-B 场景取得 +12.75%;OneModel 报告相对 GenRank +6.4‰ Ads Click AUC 与三场景线上正向。两者的 tokenization 对比结论表面冲突但实际互补:SAGA 证明在 token 预算固定时展开字段更划算,OneModel 证明在序列长度受服务约束时压缩事件更划算——差别在于约束是"token 预算"还是"端到端延迟"。
讨论与局限性¶
核心贡献与值得借鉴的设计¶
这篇论文最值得借鉴的地方不在于某个单点技术新颖性——SAIM 说到底是一个场景条件的乘性门控,这类机制在多场景推荐里已被反复使用——而在于它把"多业务流统一精排"这件事完整地跑通并量化了。三处细节特别有参考价值:
- 训练层消融的拆解方式。把"统一是否值得"拆成"弱流拿到多少 / 强流赔掉多少"(+3.0‰ / −0.1‰),比笼统地报一个端到端提升信息量大得多。任何想做类似统一的团队,第一个该跑的就是这个实验。
- 输入层掩码消融。掩掉 Rec 子序列让 Ads AUC 掉 0.36 pp,这是"跨流信息真的在起作用"的因果性证据,而不是相关性证据。它同时揭示了信息流动的不对称性——高资源流向低资源流单向输血。
- 参数 +32.9% 而延迟 −66.7%。这条结果直接反驳了"统一模型必然更贵"的直觉。关键在于把长上下文编码从"每请求"降维到"每用户 × 增量",使得 Transformer 的成本与候选数解耦。这个思路对任何想上长序列的工业系统都适用。
局限与争议¶
- 可复现性为零。全部实验都在小红书内部 10% 流量切片上,连绝对的用户数、物品数、交互数都因保密未披露,也没有任何公开学术数据集结果。外部读者无法验证任何数字,也无法把 OneModel 与其他工作放在同一标尺上比。
- Scaling 主张与证据不匹配。摘要称"scales favorably with context length and model capacity",但 Figure 6 实际是单点邻域的敏感性分析,不是跨数量级的 scaling 曲线:所有上扩方向的收益都在 +0.24‰ 到 +0.7‰ 之间,序列长度从 500 到 1000 只有 +0.5‰。更诚实的表述应是"当前配置位于收益递减区,继续扩容不会退化"。相比 HSTU、RankMixer、TokenMixer-Large 那类以 scaling law 为核心卖点的工作,这一块明显薄弱。
- SAIM 的有效性论证偏弱。1.1‰ 的消融跌幅本身不小,但"学到了流依赖调制"这一机制性结论只靠三个标量门控均值(0.61 / 0.54 / 0.58)支撑。三个不同的均值也可能只反映了三条流的整体激活尺度差异,而非有意义的通道分工。若能给出通道级激活分布、或跨流的门控相似度矩阵,说服力会强得多(对照组见 HA-MoE 的 LENS/PIEM 诊断框架)。
- 主流量场景的收益近乎为零。Rec 流在统一训练下 AUC 从 0.7906 变成 0.7905。论文把这解读为"没有负迁移",是对的;但也必须承认,对占 5/6.35 流量的主场景而言,统一的价值几乎完全是工程性的(省掉多套系统),而非效果性的。这会直接影响该方案在其他平台的 ROI 判断——如果一个平台的次要业务流量占比更小,统一的收益可能撑不起迁移成本。
- 多流之间只有三条流,且都在同一 App 内。这三条流共享用户、内容与页面上下文,异构性其实是有限的(都是信息流形态的短内容消费)。论文未验证方案在异构性更强的组合(如短视频 + 搜索 + 本地生活)上的表现。
- 组件消融只有单项移除,无累积消融,无法判断统一表示、SAIM、分层表示三者是否互相冗余(三者单项之和 3.3‰ 与统一训练总收益 3.0‰ 接近,暗示可能存在重叠)。
- 候选掩码的必要性未被消融。式 6 的 $\mathbf{M}_{\text{cand}}$ 阻断同请求内候选间注意力,这是把生成式骨干改造成 pointwise 打分器的关键一步,但论文没有给出移除它的对照实验。
- 两个目标的平衡缺乏证据。式 13 中生成式检索项(第一项)的权重 $\alpha$ 会衰减,但论文既没有报告生成式检索目标本身的任何指标(如 Recall@K),也没有做"完全移除自监督项"的消融,因此这一项的实际贡献不明。
- 论文自身状态:模板仍是 ACM 占位符("Conference acronym 'XX, Woodstock, NY"、"Received 20 February 2007"),DOI 为 XXXXXXX,且正文引用列表里存在残留的
[30, 31, 42? ]未解析引用。这是一份未经会议评审的工业预印本。
工业落地价值¶
抛开学术层面的短板,这篇论文的工业落地价值是明确且可观的:
- 部署形态:小红书生产系统,Explore Feed / Feed Advertising / Merchant Recommendation 三个场景全量 A/B。
- 业务收益:Explore Feed 互动 +1.25%、时长 +0.33%、LT7 +0.15%;Feed Advertising ADVV +3.43%、CTR +8.18%(曝光 −1.07%);Merchant DGMV +1.1867%、GPM +2.1585%、OPM +2.8118%(PV −0.9513%)。三个场景的曝光都是持平或下降,收益纯粹来自排序质量。
- 服务成本:稠密参数 173M → 230M,延迟 270ms → 90ms。四项系统优化(特征分解、用户特征预取、共享用户塔计算、图级推理优化)配合用户状态增量缓存,把长上下文编码的成本从"每请求"摊到"每用户增量"。
- 组织收益(论文强调但未量化):一套共享底座替换掉三套孤立的长序列模型、embedding 系统与内容理解流水线。对于正在为每条业务线重复建设重型能力的团队,这条路径的工程 ROI 可能比 AUC 数字更重要。
对想复用这套思路的团队,最可操作的建议是:先跑训练层消融确认"弱流受益 / 强流不亏",再跑输入层掩码确认跨流信息确实有效,最后才是 SAIM 这类调制机制的调优——因为前两步决定了统一这件事值不值得做,第三步只决定能多榨出 1‰。