SAGA:把多触点用户行为按「字段」拆成 token 的生成式用户嵌入模型¶
来自 PayPal AI(Tsz Fung Pang、Po Jen Chen、Nimish Ronghe、Farhad Farahani、Bo Zhang,全部 San Jose, CA),2026-08-15 挂 arXiv(2608.15429v1,cs.LG)。
核心主张:一家金融服务(Financial Service, FS)公司的用户行为散落在品牌结账(Branded Checkout)、P2P 转账、App 内互动、推送通知、邮件、账户操作等多个彼此异构的行为域(surface)上,而现有的序列推荐嵌入模型几乎都工作在同构动作空间里,无法捕捉跨 surface 的行为信号。SAGA 把所有 surface 的动作事件规整成一套统一的六属性 schema,再用 round-robin(轮转)per-field tokenization 把每个事件展开成 $K=7$ 个字段级 token(6 个属性 + 1 个分隔符),使 Transformer 能做字段级注意力与逐字段训练目标——这是"一个事件融成一个 token"的做法在结构上做不到的。模型采用双头目标:逐位置的自回归 LM 头(NTL + MTL)加上只在事件边界触发的对比头(InfoNCE,目标向量带 stop-gradient)。冻结的末层隐状态作为通用用户表征喂给下游 ranker,在三个 App 触点上取得整体最强的点击/转化提升,并在两个触点上线 A/B。
研究动机与背景¶
论文的出发点有两层。
第一层是范式层面的。 随着大语言模型的发展,生成式推荐正在成为传统深度学习推荐系统的替代路线。传统流水线由召回、排序等多个阶段级联而成,每一阶段训练一个判别式神经网络去预测点击、转化、观看时长这类任务特定的响应概率;生成式推荐则把问题重述成序列生成——预测下一个动作或下一个 item,而不是直接估计某个任务的响应概率。作者期待这一范式能简化级联流水线、更好地利用序列型行为数据,并享受 LLM 中观察到的 scaling 性质。
第二层——也是本文真正的痛点——是组织层面的。 大型组织会随着业务扩张,为每个推荐问题各自孤立地建一套专门的推荐系统。一家 FS 公司需要在 App、Email、Push Notification 等多个营销触点上做个性化;电商与 FinTech 公司还需要基于用户即将到来的意图去优化结账体验。但这些独立建成的推荐器之间缺乏协同,也无法保持推荐输出的一致性。最好的情况下,其他 surface 的数据可以被特征工程加工、聚合后当作某个独立推荐器的特征——但这种开发方式是一次性且单向的:每当为一个新 surface 开发推荐系统时,就要重复大量特征工程,而产出的模型只适用于它自己那个专门问题和 surface,留不下任何可复用的骨干(shareable backbone)——这与自然语言、计算机视觉领域的基座模型形成鲜明对照。
序列推荐的基座模型近年在工业界确实获得了关注,它们在大规模动作序列上预训练、学习可复用的用户表征。但作者指出:这些模型通常只在单一平台或相对同构的动作空间内运作,跨异构行为域的学习基本还是空白。
于是本文提出 SAGA(Structure-Attended Generative Action Model),把用户在多个 surface 上的历史动作序列在结构化属性层面编码成一个通用用户表征。要让这个表征能撑起多种下游任务,就必须用分布各异的多 surface 数据预训练,而这会带来负迁移与联合优化的挑战。SAGA 的应对方式是:把异构分布的多 surface 动作数据聚合成一套统一结构化 schema 的序列。
三条核心贡献:
- Round-robin tokenization 策略:让注意力可以跨异构动作属性在字段级展开;
- 双头训练目标:把自回归的逐字段预测与事件边界的对比学习结合,从而真正利用起 per-field 结构;
- 实验证明 SAGA 释放了跨 surface 预训练的价值——多样的数据源变成互补而非互相冲突的关系。
Figure 1 给出了核心直觉的图示:左边是融合 tokenization($K=1$),每个事件是一个不透明的 token,注意力只能在事件粒度上展开,"到底是哪个字段驱动了这次交互"这个问题无法回答,因为字段已被融合;右边是 structure-attended($K=7$),事件 $i+k$ 的字段 $f_1$ 可以同时对事件 $i$ 的同字段($f_1$)和跨字段($f_2, f_3, f_4$)做注意力,恢复了被融合掉的细粒度依赖。
相关工作定位¶
作者把自己放在三条文献线的交汇处。
生成式推荐¶
已有工作大致可分三类:
- 直接对用户行为序列做 next-token / next-action 预测:代表是 HSTU 与 OneRec,证明了序列型架构在大规模推荐上的有效性;
- 把序列特征与非序列特征统一进一个模型:结合序列建模能力与丰富的上下文、用户级、物品级特征(Kunlun、InterFormer、OneTrans);
- 把基座模型与下游任务模型分离:PinFM 与 Spotify 的通用化基座模型从大规模用户行为数据中学习可复用表征,再应用到多个推荐任务上,比为每个下游目标各训一个大模型更灵活、更省成本。
SAGA 属于第三条路线。与前人的关键差别在于:SAGA 面对的是更异构的多 surface 场景。既有模型多聚焦于相对同构的动作空间或单一平台,其设计对一致的动作空间有效,但不太适用于「结账事件、P2P 支付、App 会话、网页访问、邮件、推送通知各自含义与特征结构都不同」的场景。ActionPiece 把用户动作表示成上下文特征 token 的集合,SAGA 在这个思路上再进一步,用统一事件 schema 在共享序列中建模所有动作,同时保留 surface 特有信息。
论文还专门与 CL4SRec 做了机制层的区分:CL4SRec 把对比学习与 next-item 预测结合,其对比学习通过对同一历史做随机裁剪、掩码、重排产生的增强序列之间比较表征,动机是"增强后视图的一致性"。SAGA 的构造与动机都不同:SAGA 的对比头是为泛化下一个事件的预测而调的,而模型的 next-token 预测操作在事件字段层面;对比目标构造成正负事件嵌入之间的 in-batch 比较。
金融基座模型¶
近期研究表明大规模金融历史可以用来学习可迁移表征:PRAGMA(Revolut)用 key-value-time tokenization 与掩码建模来刻画多源银行历史,服务于信用评分、欺诈检测、LTV 预测、参与度预测与推荐;TransactionGPT 用 3D Transformer 研究消费者支付轨迹;nuFormer(Nubank)从文本、数值、类别属性学交易嵌入;Open Banking Foundational Model 表明把结构化交易属性与文本描述结合能改善跨机构与数据稀缺场景的泛化。
SAGA 的范围更宽、目标也不同:前述模型主要聚焦银行历史、支付轨迹或交易级表征学习,SAGA 则同时建模金融与非金融的客户活动(checkout、P2P、App、Web、Email、Push),从而能够评估「多样的数字与通信信号如何补充金融行为」。
动作事件 Tokenization¶
这是本文最锋利的一节,作者把已有做法排成一个谱系:
| 方法 | 每事件 token 数 | 做法 | 局限 |
|---|---|---|---|
| PinFM | $K=1$ | 把事件所有字段融成一个 embedding | 字段身份丢失 |
| HSTU | $K=2$ | 每事件切成 product、interaction 两个 token | 硬性特征选择,其余属性被永久丢弃 |
| ActionPiece | 变长 | 用 BPE 对物品属性做上下文相关的 split-and-merge | 面向无序变长属性,正交方向 |
| PRAGMA | per-attribute | 保留字段身份 | encoder 架构,无法做因果生成 |
| SAGA | $K=7$ | 6 个事件属性 + 分隔符,确定性 round-robin 顺序 | —— |
结论句是:"没有任何先前工作把 per-field tokenization 与自回归建模结合在一个确定性的 token 顺序里,从而同时获得字段级注意力与受约束的、surface 条件化的生成能力。"
作者也诚实地列出了自回归建模的三条理论收益及其兑现程度:
- (a) 下一事件的字段特定词表预测 —— 由 per-field LM 头实现(§3.3,本文已兑现);
- (b) 结构化的事件分解(而非隐式地学事件字段联合分布)—— 理论性质,本文未评估;
- (c) 条件于特定 surface 的受约束生成 —— 理论性质,本文未评估,留给后续工作。
核心方法 / 模型架构¶
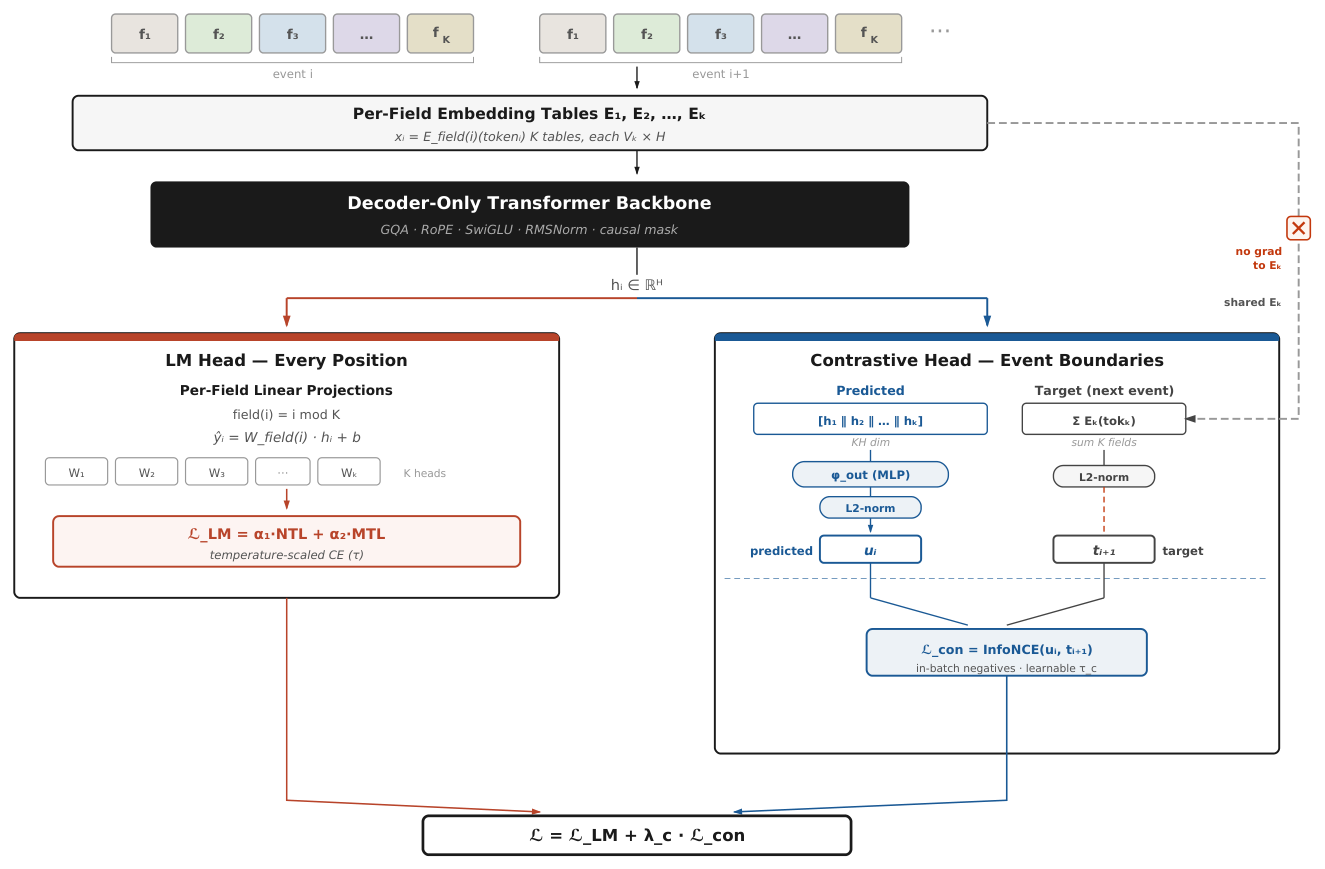
整体流程(对应 Figure 2):round-robin tokenized 序列 → 每字段独立的嵌入表 $E_1,\dots,E_K$ → decoder-only Transformer 骨干(GQA · RoPE · SwiGLU · RMSNorm · causal mask)→ 两条并行路径:左侧 LM 头(每个位置都触发,per-field 线性投影 $W_{\text{field}(i)}$,$K$ 个头)、右侧 对比头(只在事件边界触发,把 $K$ 个隐状态拼接后过 MLP 投影 + L2 归一化得到预测事件嵌入,与"下一事件 $K$ 个字段嵌入求和 + L2 归一化"的目标做 InfoNCE,目标侧 stop-gradient)。最终损失 $\mathcal{L} = \mathcal{L}_{\text{LM}} + \lambda_c \cdot \mathcal{L}_{\text{con}}$。
论文的符号定义(Table 1):
| 符号 | 含义 |
|---|---|
| $x_{1:T}$ | 长度 $T$ 的输入 token 序列 |
| $m$ | 训练序列的 token 数 |
| $K$ | 每事件的字段数($=7$) |
| $s$ | 多 token 预测的步长(round-robin 模式下 $s=K$) |
| $\mathbf{h}_i$ | 骨干在位置 $i$ 的隐状态 |
| $\hat{\mathbf{y}}_i$ | LM 头在位置 $i$ 产出的 logit 向量 |
| $z_i$ | 位置 $i$ 的真值标签 |
| $\ell(\cdot,\cdot)$ | 逐位置损失(SoftCE 或 CrossEntropy),作用在 logits 上 |
| $\tau$ | SoftCE 的温度(默认 0.07) |
| $\tau_c$ | 对比头的可学习温度(初始 0.07) |
| $\lambda_c$ | 对比损失权重(默认 0.5) |
| $\alpha_{\text{ntl}}, \alpha_{\text{mtl}}$ | LM 损失分量权重(默认 1.0、1.0) |
方法整体是"先预训练、再冻结抽表征"的范式:作者预训练嵌入模型,抽取末层隐状态作为冻结的用户嵌入给下游模型用;本文明确把 fine-tuning 排除在范围之外,专注评估设计选择对表征质量的影响。
事件属性即 token¶
数据构造。 作者构造了一个专有的金融服务数据集,把品牌结账交易、P2P 交易、与 App / 推送 / 邮件的互动、账户管理等来源的用户动作聚合在一起。每个来自不同 surface 的用户动作都被特征化成一套统一结构化 schema,使用户动作序列由同一 schema 的事件集合构成,事件按时间顺序排列成序列。
统一事件 schema。 每个动作事件被变换成六个标准化属性(变换通过预先设定的查表方式完成):
- surface:动作事件的来源,指示结账交易的设备或用户交互的 App 触点;
- parent product(父产品)与 3. product(产品):FS 公司所提供金融产品的两级层次类目,典型例子如品牌结账与信用卡;
- action intent(动作意图):某个动作对应的细粒度用户意图,如跨境购买、信用卡开卡;
- interaction(交互):用户交互的深度,把曝光、点击、转化分入不同的桶;交易型数据则按交易金额分桶;
- merchant category code (mcc)(商户类目码):交易型数据独有的属性,其背后的假设是——需要金融承诺的交易活动携带了对用户表征最强的信号。
词表构造。 每个特征建一份独立的词表,各由专用 tokenizer 支撑。为了用一个小尺寸 Transformer 就能编码用户表征,作者刻意把 item ID 从属性与 tokenizer 集合中移除,只保留其映射后的属性。每字段词表规模在 9 到 239 个 token 之间,合计 378 个 token。尽管词表如此紧凑,round-robin 组合产生的理论事件空间超过 $10^9$——表达力来自组合式构造而非词表规模。
Round-robin Tokenization¶
机制。 每个事件被展开成七个 token,在整条序列上按 round-robin 顺序排列:六个属性 + 一个前置分隔符(记作 BOS)。即每个事件 tokenize 成 $K=7$ 个轮转字段:(BOS, surf, pprod, prod, act, int, mcc)。七字段结构是对 HSTU 两字段交错序列构造的扩展,与 PinFM 的"每事件单个融合嵌入"形成对照。
解码同样遵循 round-robin 顺序,逐个预测下一个事件的下一个字段,各自查询自己的词表。实现上,softmax 层里词表外的 logits 被掩成负无穷,使模型只能按当前轮转顺序从给定字段中取 token。位置编码采用标准 RoPE。
动机。 主要好处是使能字段级注意力与受约束生成:
- 预测下一个事件时,Transformer 可以对先前所有事件的全部属性嵌入做注意力;而事件级融合嵌入在把一个事件聚合成单个 embedding 时就丢掉了信息,无法在各属性之间做细粒度注意力。
- 由于嵌入模型要服务多个 surface,七字段设计使得可以把下一动作事件的生成约束并条件化到某个特定 surface(如品牌结账),从而让 Transformer 预测该 surface 上最可能被服务的用户事件——这支持了 surface 条件化的用户嵌入生成,也支持生成式推荐。
双头目标¶
LM 头:自回归预测¶
第一个头是语言模型里标准的自回归 next-token 预测头,带因果掩码。损失由两部分构成:NTL(next-token loss) 与 MTL(multi-token loss)——后者把 softmax 损失扩展到选定视野内的一个真值 token 窗口,思路取自 PinFM。作者给出的动机是:用户动作的顺序比语言的方差更大,所以加入 MTL 来适配生成式动作模型的这一天性。按 round-robin 顺序,六个字段(不含分隔符)各自贡献 softmax 损失,比较"该字段专属的有效 token 的 logits"与"下一个真值 token"。
逐位置的 softmax 损失(温度缩放的交叉熵)为:
$$\ell(\hat{\mathbf{y}}_i, z_j) = -\log \frac{\exp\big(\hat{y}_{i,z_j}/\tau\big)}{\sum_{v \in \mathcal{V}_f} \exp\big(\hat{y}_{i,v}/\tau\big)} \tag{1}$$
其中 $\hat{y}_i$ 是位置 $i$ 的 logit,$\tau = 0.07$,$\mathcal{V}_f$ 是字段 $f$ 自己的词表(这正是"字段特定词表预测"的落点)。
NTL 形式化为:
$$\mathcal{L}_{\text{NTL}} = \frac{1}{m-1}\sum_{i=1}^{m-1} \ell(\hat{\mathbf{y}}_i, z_{i+1}) \tag{2}$$
即 LM 头产出的 logit $\hat{y}_i$ 直接与真值下一个 token $z_{i+1}$ 比较。
MTL 则针对 round-robin tokenization 做了适配——每个预测 logit 与「接下来 $k$ 个事件中同一字段」的真值 token 比较:
$$\mathcal{L}_{\text{MTL}} = \frac{1}{|\mathcal{S}|}\sum_{i=1}^{m-1}\sum_{k=1}^{L'} \mathbb{1}\big[i + k\cdot s \le m\big]\, \ell(\hat{\mathbf{y}}_i, z_{i+k\cdot s}) \tag{3}$$
其中 $s = K = 7$ 是 round-robin 模式下的步长(预测 $k$ 个事件之后出现的同一字段),$L'$ 是多 token 预测视野,$|\mathcal{S}|$ 是满足 $i + k\cdot s \le m$ 的有效 $(i,k)$ 对数。
这一步是 round-robin 设计的一个巧妙副产品:因为字段在序列中的位置是周期性确定的,"跳 7 步"天然对应"同一字段、下一个事件",多 token 预测因此从"预测未来若干 token"升级为"预测同一语义槽位的未来取值"。
事件级对比头¶
作者的理论假设是:在事件级嵌入上做对比训练,会改善以动作为中心的用户表征。做法是在事件边界处构造事件级嵌入预测:把前一个事件的全部 $K$ 个隐状态经 MLP 投影层聚合成一个事件嵌入:
$$\mathbf{u}_i = \phi_{\text{out}}\Big(\mathbf{h}^{(1)}_{iK} \,\|\, \mathbf{h}^{(2)}_{iK+1} \,\|\, \cdots \,\|\, \mathbf{h}^{(K)}_{iK+K-1}\Big) \tag{4}$$
其中 $\phi_{\text{out}}: \mathbb{R}^{KH} \to \mathbb{R}^{H}$ 是 post-norm 的两层 MLP 投影,此处 $i$ 索引的是事件。
目标事件嵌入由下一个位置真值事件的 7 个字段嵌入按元素相加构成:
$$\mathbf{t}_{i+1} = \text{normalize}\Bigg(\text{sg}\bigg(\sum_{f=1}^{K} \mathbf{e}_f\big(x_{(i+1)K+f-1}\big)\bigg)\Bigg) \tag{5}$$
其中 $\mathbf{e}_f(\cdot)$ 是字段 $f$ 的嵌入查表,$\text{sg}$ 是 stop-gradient。stop-gradient 加在目标嵌入的构造上,使损失只经由「预测事件嵌入 + Transformer 架构」反传回嵌入查表层,从而防止表征坍缩。
InfoNCE 在 in-batch 负样本与构造出的真值目标嵌入之间计算:
$$\mathcal{L}_{\text{con}} = -\frac{1}{|\mathcal{P}|}\sum_{i \in \mathcal{P}} \log \frac{\exp\big(\mathbf{u}_i^\top \mathbf{t}_{i+1}/\tau_c\big)}{\sum_{j=1}^{N} \exp\big(\mathbf{u}_i^\top \mathbf{t}_j / \tau_c\big)} \tag{6}$$
其中 $\mathcal{P}$ 是正交互事件的集合,$N$ 是 in-batch 负样本数量。该损失在事件边界触发,即每 7 个 token 一次。
组合目标¶
最终训练目标是 NTL、MTL 与对比损失的加权和:
$$\mathcal{L}_{\text{total}} = \underbrace{\alpha_{\text{ntl}} \cdot \mathcal{L}_{\text{NTL}} + \alpha_{\text{mtl}} \cdot \mathcal{L}_{\text{MTL}}}_{\mathcal{L}_{\text{LM}}} + \lambda_c \cdot \mathcal{L}_{\text{con}} \tag{7}$$
其中 $\alpha_{\text{ntl}} = \alpha_{\text{mtl}} = 1$,$\lambda_c = 0.5$。
结构节拍(Figure 3)¶
Figure 3 用两个连续事件展示了双头的"触发节拍"。以 $K=7$ 的 round-robin 为例:
| pos | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| $x_i$ | BOS | surf | pprod | prod | act | int | mcc | BOS | surf | pprod | prod | act | int | mcc |
| $\mathcal{L}_{\text{LM}}$ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| $\mathcal{L}_{\text{con}}$ | — | — | — | — | — | — | ✓ | — | — | — | — | — | — | ✓ |
| $\hat{y}_i$ (target) | surf | pprod | prod | act | int | mcc | BOS | surf | pprod | prod | act | int | mcc | BOS |
即:LM 头每事件触发 7 次梯度更新(每个位置都算),对比头每事件只在 mcc 这个事件边界 token 上触发 1 次。最后一行是 LM 头移位后的预测目标。
模型设计选择¶
模型架构。 骨干采用 decoder-only Transformer:12 层、隐藏维度 $H=512$、8 个注意力头、4 个 key-value 头。选择理由有二:第一,既然 PinFM 观察到 GPT-2 与 HSTU 架构在推荐任务上表现相近,作者就固定 Transformer 架构,把研究聚焦在 tokenization 与训练目标上;第二,这样可以采用 GQA、SwiGLU、RMSNorm 等计算高效模块——这些在 HSTU 架构里是没有的。上下文窗口为 1024 token,在 round-robin tokenization(每事件 7 token)下对应约 146 个事件。模型约 3700 万参数。
训练数据。 所有实验变体都用同一批跨越 2 年的用户数据训练。用户动作事件序列被切成互不重叠的 chunk;对于每序列事件数不同的变体,序列被切成不同长度的 chunk,但所有模型变体仍然用所选用户的全部 chunk 训练。
嵌入抽取。 输入整条用户序列后,抽取末层隐状态作为用户嵌入。本文范围内 SAGA 权重被冻结,用户嵌入作为下游模型的输入,下游模型基于冻结 SAGA 产出的用户嵌入训练与评估。
实验设置¶
作者在一个需要对 App 内产品推荐做排序的下游任务上实施离线消融研究,包含三组对照:
- 训练目标:LM-only、contrastive-only、dual-head 的比较;
- Tokenization 粒度:round-robin($K=7$)对 PinFM 式 fused-key 事件嵌入($K=1$)与 HSTU 式交错 tokenization($K=2$);
- 训练数据范围:单 surface、少数 surface、全 surface 的贡献。
Table 2:消融变体设计。 SAGA(本文提出的模型)使用 $K=7$、双头预训练($\mathcal{L}_{\text{NTL}} + \mathcal{L}_{\text{MTL}} + \lambda_c\mathcal{L}_{\text{con}}$)、全部交互 surface。每一行只改动恰好一个维度,其余设置全部保持不变。Set A 固定事件数,Set B 固定 token 预算。
| 组 | ID | 改动的变量 | $K$ | 训练数据 |
|---|---|---|---|---|
| Objective | A1 | 仅 LM 头($\lambda_c=0$) | 7 | All |
| Objective | A2 | 仅对比头($\alpha_{\text{ntl}}=\alpha_{\text{mtl}}=0$) | 7 | All |
| Objective | A3 | SAGA(双头) | 7 | All |
| Tok (A) | B1A | Fused-key,146 事件 | 1 | All |
| Tok (A) | B2A | Interleaved,146 事件 | 2 | All |
| Tok (A) | B3A | SAGA,146 事件 | 7 | All |
| Tok (B) | B1B | Fused-key,1024 token | 1 | All |
| Tok (B) | B2B | Interleaved,1024 token | 2 | All |
| Tok (B) | B3B | SAGA,1022 token | 7 | All |
| Data | C1 | — | 7 | Engagement |
| Data | C2 | — | 7 | + Transactions |
| Data | C3 | SAGA | 7 | All surfaces |
下游模型。 抽取所有变体的冻结嵌入,去训练 App 内营销消息排序任务的 ranker。下游模型以 ESMM 目标构建、采用 DCN-v2 架构,输入为生产特征加上可选的冻结嵌入作为额外输入。无嵌入 baseline 只使用生产特征。所有下游模型在各变体间使用完全相同的架构与超参数。
评估口径。 在 App 的三个不同触点(TP-A / TP-B / TP-C)上报告结果。指标是离线 NDCG@3,其中正标签表示点击与转化。所有数值都是相对无嵌入 baseline 模型的相对百分比提升。
关于 TP-C 的重要说明。 touchpoint-C 是一个低参与度触点,正信号稀疏、信噪比本就很低;因转化量不足,未报告转化提升。带 SAGA 各变体嵌入的 ranker 在 TP-C 上全部相对无嵌入 baseline 产生负的点击提升,因此作者把负得最少的结果加粗,视为干扰最小。作者的理论解释是:SAGA 编码的是用户的一般交互模式,这种行为嵌入容易与该触点上本就微弱的信号发生干扰;能持续辐射最少噪声的变体应当胜出。
主要实验结果¶
双头 vs 单头¶
Table 3:训练目标消融(数值为相对无嵌入 baseline 的 NDCG@3 相对百分比提升)
| ID | Objective | TP-A Clk | TP-A Conv | TP-B Clk | TP-B Conv | TP-C Clk | TP-C Conv |
|---|---|---|---|---|---|---|---|
| A3 | SAGA(dual-head) | +6.5 | +3.3 | +1.7 | +0.6 | -1.4 | — |
| A1 | LM only($\lambda_c=0$) | +3.5 | +1.6 | +0.4 | +0.3 | -4.2 | — |
| A2 | Contr. only($\alpha_{\text{ntl}}=\alpha_{\text{mtl}}=0$) | +5.8 | +3.9 | +0.5 | +0.4 | -8.6 | — |
结论分析。 双头 SAGA 在总体上在点击与转化两方面都优于单头变体,并且在 touchpoint-C 上噪声干扰最小。contrastive-only 变体在 TP-A 的转化上取得了更大的提升(+3.9 vs +3.3),但它在 TP-C 上退化最严重(-8.6)——即"某个触点上更强"与"跨触点普适"是两回事。这一结果验证了:双头训练目标产生的用户表征,能把收益最广泛地迁移到多样的下游任务上。
作者给出的机制解释是:双头目标创造了互补的学习信号——LM 头学习细粒度的字段级转移动力学,对比头学习可区分的事件级表征;任何单一目标都无法同时捕捉这两个粒度。
动作事件 Tokenization¶
Table 4:Tokenization 粒度消融(Set A 固定 146 个事件;Set B 固定 1024 token 预算)
| ID | Tokenization | $K$ | TP-A Clk | TP-A Conv | TP-B Clk | TP-B Conv | TP-C Clk | TP-C Conv |
|---|---|---|---|---|---|---|---|---|
| Set A — 固定 146 事件 | ||||||||
| B3A | SAGA(round-robin) | 7 | +6.5 | +3.3 | +1.7 | +0.6 | -1.4 | — |
| B1A | Fused(PinFM) | 1 | +7.3 | +4.5 | +0.6 | +0.4 | -3.9 | — |
| B2A | Interleaved(HSTU) | 2 | +3.7 | +2.9 | -1.8 | -0.7 | -12.6 | — |
| Set B — 固定 1024 token 预算 | ||||||||
| B3B | SAGA,146 事件 | 7 | +6.5 | +3.3 | +1.7 | +0.6 | -1.4 | — |
| B1B | Fused,1024 事件 | 1 | +6.4 | +3.0 | +0.9 | +0.5 | -16.0 | — |
| B2B | Interleaved,512 事件 | 2 | +5.6 | +3.1 | -1.3 | -0.5 | -10.5 | — |
结论分析(作者原文的解释链条):
- SAGA 在两组设置的大多数触点上都取得最高增益,但 fused-key 在 Set A 的 touchpoint-A 上更强(+7.3 vs +6.5;+4.5 vs +3.3)。作者对此的解释是:在 Set A 里 fused-key 受益于更紧凑的序列(146 token vs SAGA 的 1022 token),把模型的注意力预算集中到事件级时序模式上,其压缩后的事件级表征在高信号触点上抓住了用户动态。
- 但这个优势不迁移:fused-key 在 TP-B 上掉到 +0.6 / +0.4,在 TP-C 上是 -3.9,跨触点方差显著大于 SAGA。SAGA 作为一个应当产出普适可复用表征的嵌入模型胜出。作者把这归因于融合 tokenization 的信息瓶颈——把事件属性压进单个嵌入的过程会优先保留主导信号,牺牲多样下游任务所需的细粒度字段级细节。
- Set B 是本文实验设计最有价值的一处:把 token 预算拉平之后,SAGA 用 146 个事件就匹配或超过了 fused-key 的 1024 个事件与 interleaved 的 512 个事件——用 7 倍更少的事件填满同一个上下文窗口。fused-key 在 TP-A 上对 SAGA 的优势蒸发(6.4 vs 6.5;3.0 vs 3.3),同时在 TP-C 上严重恶化到 -16.0。这强化了"per-field tokenization 产出更普适可迁移表征"的假设,也说明:在同等 token 预算下,更丰富的逐事件 tokenization 比"更长上下文 + 更粗事件 token"更有效。作者的解释是近期事件对预测即将发生的行为携带更强信号——编码更少的近期事件的细粒度属性,比聚合更多远期事件的压缩表征更有信息量。
- 一个反直觉的观察:interleaved($K=2$)表现低于 fused-key($K=1$)。 作者的假设是:尽管 fused-key 把细粒度事件字段融进了一个嵌入,它学到的 sum-pooling 隐式地对字段贡献做了重加权,近似于事件内字段上的一种软注意力,因而部分恢复了字段级信号;而 interleaved tokenization 是硬选择——只保留 product 与 interaction,永久丢弃 surface、action intent、parent product 与 MCC。这种属性级信息的损失即使用更长序列也无法弥补。
这条解释很值得记:token 数不是越少越好,也不是越多越好;关键是信息是否被不可逆地丢弃。软压缩(sum-pooling)留了后路,硬截断(feature selection)没有。
多 surface 数据富集¶
Table 5:训练数据构成消融(所有变体均用 SAGA,$K=7$、双头)
| ID | 训练 surfaces | TP-A Clk | TP-A Conv | TP-B Clk | TP-B Conv | TP-C Clk | TP-C Conv |
|---|---|---|---|---|---|---|---|
| C3 | SAGA(全部 surfaces) | +6.5 | +3.3 | +1.7 | +0.6 | -1.4 | — |
| C2 | Engagement + Transactions | +2.5 | +0.7 | -1.7 | -0.7 | -4.7 | — |
| C1 | 仅 Engagement | +3.1 | +1.4 | -0.9 | -0.3 | -5.6 | — |
结论分析。 用全部 surface 数据训练的 SAGA 在所有触点的点击与转化上都取得最大提升。但收益并非单调:只加入交易数据反而在多数触点上恶化了表现(C2 在 TP-A 上 +2.5,反而低于只用 engagement 的 C1 的 +3.1)。作者的解释是:
- 交易数据是低频、强信号,engagement 数据是高频、弱信号;
- 只加交易数据会造出一个模型无法调和的双峰分布(bimodal distribution);
- 加入全部 surface 才提供了足够的分布多样性去学习跨域迁移。
作者把这一结果诠释为跨域信号增益与来自其他域的负迁移之间的抵消效应:只有用全部 surface 数据训练的 SAGA 才达到了足以抵消混合数据带来的噪声与干扰的跨域学习程度,而只用 engagement + transactions 两个域的变体则受制于两域混合的负迁移。
线上 A/B 测试结果¶
作者把 SAGA 部署到 touchpoint-B 与 touchpoint-C 的生产 A/B 测试中。实验组收到的推荐由「以 SAGA 冻结嵌入作为输入特征的下游模型」产出;对照组收到的推荐来自先前的深度学习 ranker——该 ranker 使用的用户序列仅由 engagement 事件构成,其他 surface 只以用户级聚合数据的形式进入,且不使用任何预训练嵌入。
Table 6:线上 A/B 结果(相对对照组的相对百分比提升)
| Touchpoint | Metric A | Metric B |
|---|---|---|
| TP-B | +12.75% | +8.80% |
| TP-C | −1.56% | +11.20% |
结论分析。 在 touchpoint-B 上,SAGA 带来了统计显著的 +12.75% Metric A 提升与 +8.8% Metric B 提升。在 touchpoint-C 上,实验组观察到 Metric A 下降 1.56%,但该结果尚未达到统计显著——这与离线实验(§4)中的噪声敏感性分析一致;尽管如此,SAGA 在该触点上仍取得了 Metric B +11.2% 的提升。作者据此认为:用 structure-attended 架构从多 surface 预训练学到的冻结嵌入,无需 fine-tuning 就能迁移到生产环境的排序质量上。
需要注意:两个业务指标被匿名化为 "Metric A" 与 "Metric B",触点也匿名化,且未披露流量规模、实验时长与显著性检验细节。这是本文实证证据链上最弱的一环。
核心贡献总结¶
- Round-robin per-field tokenization:把每个动作事件按确定性轮转顺序展开成 $K=7$ 个字段 token(6 属性 + BOS 分隔符),每字段一份独立词表与独立嵌入表,softmax 层做词表外掩码——这是首个把 per-field tokenization 与自回归建模结合、并因此同时获得字段级注意力与受约束的 surface 条件化生成的推荐系统工作。
- 统一多 surface 事件 schema:把结账、P2P、App、Push、Email、账户管理等分布迥异的行为,用预设查表变换成同一套六属性 schema,使异构 surface 能进入同一条序列而不是被拆成独立模型。
- 双头训练目标:逐位置触发的 per-field LM 头(NTL + round-robin 步长适配的 MTL)+ 每事件触发一次的事件边界对比头(InfoNCE,目标由 $K$ 个字段嵌入按元素求和构造并做 stop-gradient 防坍缩)。消融证明二者互补,任何单头都不如组合。
- 等 token 预算的 tokenization 对照实验设计(Set A / Set B):这是本文方法论上最扎实的部分——在固定事件数与固定 token 预算两种口径下分别对照 $K=1/2/7$,得出"同等 token 预算下更丰富的逐事件 tokenization 优于更长上下文 + 更粗事件 token"的结论。
- 跨 surface 预训练价值的实证:数据构成消融揭示了增益的非单调性,指出"只加一个新域"可能因双峰分布而恶化,只有足够的分布多样性才能让跨域增益压过负迁移。
与已归档相关工作的对比¶
DUET DUET: Dual User Embedding Transformers for Offsite Conversion(Meta,2026-06-08)¶
关系:独立并发(本文未引用 DUET,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇论文攻击的是同一个 root cause——把统计性质迥异的多源行为流一起灌进一个上游用户嵌入模型时,强势的稠密流会主导优化、压制稀疏流,导致产出的表征在下游"顾此失彼"。DUET 把这称作"信号主导下的机制错配(signal dominance under regime mismatch)"与"架构同质性";SAGA 则在 Table 5 的数据构成消融里用实验把同一现象量化出来——低频强信号的交易数据与高频弱信号的 engagement 数据混合会产生"模型无法调和的双峰分布",只加交易反而使 TP-A 点击提升从 +3.1 掉到 +2.5。
- 相近的技术骨架:两者的系统拓扑几乎完全一致——离线预训练一个上游用户编码器 → 冻结产出的用户嵌入 → 下游 ranker 把它当作一个普通输入特征与生产特征并列消费(不改下游架构、梯度不回传)→ 用下游排序指标衡量嵌入质量 + 线上 A/B。连下游骨干都相近:DUET 是 DLRM + DCN 用户摘要模块,SAGA 是 ESMM + DCN-v2。两者也都强调"上游与下游可按各自节奏独立重训"。
- 本文的差异与推进:分歧点在在哪一层处理异构性。DUET 的答案是数据层与架构层分流——按标签语义与归因时长把数据路由成点击流与转化流,各配一个归纳偏置匹配的编码器(稠密流堆自注意力、稀疏流交错交叉/自注意力),产出 ClickAUE 与 ConvAUE 两个嵌入。SAGA 的答案则相反:不分流,而是把所有 surface 压进同一套 schema 的同一条序列,把异构性下沉到 token 结构里——用 $K=7$ 的字段级 token 让不同 surface 的差异以"字段取值不同"而非"模型不同"的形式被表达,再靠字段级注意力自行学出跨域关系。SAGA 因此只产出一个通用嵌入,而 DUET 产出两个专用嵌入。
- 可比的方法/实验差异:DUET 的对比学习不存在,其上游目标是多任务 BCE(有明确的 CTR/CVR 标签监督);SAGA 的上游是纯自监督(next-field 预测 + 事件级 InfoNCE),完全不依赖下游标签——这让 SAGA 的表征原则上更通用,但也失去了 DUET 那种"上游目标与下游任务对齐"的直接收益。评估口径上 DUET 用 NE(越低越好,最多 0.38% 下降),SAGA 用相对无嵌入 baseline 的 NDCG@3 相对提升(最高 +6.5%),两者不可直接比较。值得注意的是,两篇都承认自己在稀疏/低信号场景上更脆弱:DUET 靠合成无归因转化数据补数据量,SAGA 则在 TP-C 上干脆全部为负、只能比"谁的负值更小"。
Mosaic Mosaic: A Fleet of User Embedding Specialists(Meta,2026-07-27)¶
关系:独立并发(本文未引用 Mosaic,且两者对同一问题给出了相反的答案)· 已加载对方精读
- 共同关注的问题:Mosaic 与 SAGA 都在问同一个组织级问题——工业推荐系统的用户表征层应该怎么组织,才能让一份预训练产物同时服务多个下游 surface? Mosaic 的问题陈述是"已有方法几乎都把用户表征围绕单一用户侧架构或单一共享骨干来组织,因而无法完整蒸馏跨 surface 的用户行为";SAGA 的问题陈述是"各 surface 各自建推荐器、重复特征工程、留不下可复用骨干,而已有基座模型只在同构动作空间内运作"。两者也都明确把冷启/弱信号人群覆盖不均、跨 surface 信号互补作为核心论据。
- 相近的技术骨架:同样是专用上游用户嵌入模型 → 冻结 → 下游多消费者复用这一拓扑,并且两者都特意论证了"上游专用模型不等于给下游多喂几个用户特征":Mosaic 列了三条(摊薄用户侧建模容量、可用下游拿不到的监督、嵌入可被多消费者复用),SAGA 则强调"留下 shareable backbone、终结一次性单向的特征工程"。评估方式也同构:都以下游 ranker 的指标(Mosaic 用 NE + FI,SAGA 用 NDCG@3 相对提升)而非上游指标作为嵌入质量的主要度量。
- 本文的差异与推进:两篇给出的是针锋相对的答案。 Mosaic 明确拒绝"单一通才",选择架构异构的专家舰队——memorization-driven / dense-heavy / sequential / CoTrain 四个专家各自独立训练、独立服务,并用 MRM + CRL 最大化每个新专家的边际信息增量;其理由是主导性用户信号族具有不同的统计结构与服务需求,单一通才必须在异质目标之间共享容量与优化。Mosaic 甚至报告:在数据与算力匹配的原型对比中,专家舰队产出了比一个大通才模型更强的嵌入质量。SAGA 恰恰是那个"大通才"——它主张异构性不必靠"多个模型"来承载,只要 tokenization 保留了字段级结构,一个 37M 的 decoder 就能把六个 surface 装进同一条序列并学出互补性。这条分歧非常值得后续跟踪:SAGA 的证据来自单一下游任务族(App 内营销消息排序的三个触点),而 Mosaic 的证据横跨 6 个下游 surface,样本面更宽。
- 可比的方法/实验差异:Mosaic 的专家用下游参与度任务的多任务梯度监督 user tower(有标签),SAGA 是纯自监督生成式预训练;Mosaic 的 sequential 专家用 HSTU 骨干 + MoE 路由,SAGA 用 GQA/RoPE/SwiGLU/RMSNorm 的现代 decoder;Mosaic 花了大量篇幅在服务栈(混合 CPU/GPU、在线 + 离线双路径)与免打点评估(CoEval、User Tower Zero-Out,迭代提速 3–5×)上,SAGA 则完全没有讨论嵌入的刷新节奏与服务成本——考虑到 SAGA 需要输入整条 1024-token 用户序列才能取到末层隐状态,这块缺失是它工程完整度上的明显短板。另外 Mosaic 的"舰队"范式还有两条 SAGA 无法提供的组织性收益:开发速度(专家可独立开发验证)与故障隔离(回归被限制在单个专家内)。
讨论与局限性¶
核心贡献与值得借鉴的设计¶
最值得借鉴的是「等 token 预算对照」这个实验设计。 在比较 tokenization 方案时,"每事件几个 token"与"上下文能装几个事件"是被同一个上下文窗口耦合在一起的两个变量。绝大多数论文只报固定事件数的对照(Set A),而 Set A 恰恰是对 fused-key 有利的口径(它此时序列更短、注意力预算更集中,也确实在 TP-A 上赢了 SAGA)。作者补上 Set B——把 token 预算拉平、让 fused-key 用满 1024 个事件、interleaved 用满 512 个事件——才让"per-field 展开是否值回 7 倍 token 成本"这个问题变得可回答。这个对照范式可以直接迁移到任何"改变序列 token 粒度"的工作上。
第二个值得借鉴的是 round-robin 顺序带来的结构红利。 因为字段位置是周期性确定的,(a) MTL 的步长 $s=K$ 天然对应"同一字段的下一个事件取值",多 token 预测从"预测未来若干 token"升级为"预测同一语义槽位的未来值";(b) 词表外 logits 掩负无穷使解码天然受约束、不可能生成非法字段值;(c) 事件边界(mcc)是一个确定性位置,对比头的触发时机不需要额外的边界预测。确定性结构换来了三处免费的归纳偏置,这是把"结构"当作一等公民设计的典型收益。
第三个是 stop-gradient 目标构造。 目标事件嵌入由下一事件 $K$ 个字段嵌入按元素相加得到,天然是"组合式"的(compositional),与 round-robin 的字段分解形成对偶;stop-gradient 只让梯度经预测侧回流,避免了 InfoNCE 在共享嵌入表上的平凡解坍缩。
局限与争议¶
- 实证证据全部是相对百分比,且指标匿名。 论文没有任何绝对指标值:离线全部是"相对无嵌入 baseline 的 NDCG@3 相对提升",线上 A/B 的两个业务指标直接匿名为 Metric A / Metric B,三个触点也匿名为 TP-A/B/C。既没有公开数据集实验,也没有披露数据规模(用户数、事件数、序列长度分布)、流量规模、实验时长与显著性检验细节。这意味着本文的所有结论都无法被外部复现或横向比较,也是它无法进入任何 benchmark 榜单的原因。
- "baseline" 并不是真正的 PinFM 与 HSTU。 Table 4 中的 "Fused (PinFM)" 与 "Interleaved (HSTU)" 是在 SAGA 自己的 decoder 骨干上重实现的 tokenization 方案,而非这两个系统本身。这个设计对隔离 tokenization 变量是正确的,但它同时意味着论文没有与任何真实的既有基座模型(PinFM、PRAGMA、TransactionGPT、FinTRec)做过端到端比较——尤其 PRAGMA 是作者自己指认的最近邻工作(同为 per-attribute tokenization,只是 encoder 架构),却完全没有实验对照。
- 核心卖点有一半没被评估。 作者自己在 §2.3 承认,自回归建模的三条理论收益里只有 (a) 字段特定词表预测被 per-field LM 头兑现,(b) 结构化事件分解与 (c) surface 条件化的受约束生成都只是理论性质,"留给未来评估"。而 (c) —— surface 条件化的生成式推荐 —— 恰恰是论文用来论证"为什么必须用 $K=7$ 而不是别的粒度"的主要动机之一。整篇论文实际验证的,只有"字段级注意力让冻结嵌入更普适"这一条。
- 表征容量存在硬上限,scaling 前景存疑。 为了用小模型编码用户表征,作者刻意把 item ID 从属性集合中移除,全部词表合计只有 378 个 token,模型只有 37M 参数、上下文只有 146 个事件。作者用"组合式表达力"(理论事件空间 $>10^9$)来辩护,但这是输入空间的大小,不是模型可分辨的表征容量。在这样的词表下继续扩参数量,很难同步扩充"如何表征历史"这条路径——加宽加深只能提升序列建模能力,而事件表征的分辨率被 6 个查表属性的粒度锁死了。作者在 Future Work 里也承认"固定了模型规模与骨干,需要进一步验证 structure-attended 生成式动作模型的 scaling law"。
- 只在一个下游任务族上验证。 所有离线结果都来自"App 内营销消息排序"这一个任务的三个触点,而论文的核心主张是"通用的、可服务多种下游任务与 surface 的用户表征"。结账意图预估、P2P 推荐等作者在动机里点名的场景,一个都没有被评估。
- TP-C 的"least negative wins"是个尴尬的裁判规则。 在 TP-C 上所有 SAGA 变体相对无嵌入 baseline 都是负增益,作者把"负得最少"当作胜出标准,并解释为"辐射的噪声最少"。这个解释是自洽的,但它同时也意味着:在低参与度触点上,加入 SAGA 嵌入是有害的。线上 A/B 中 TP-C 的 Metric A 同样是 -1.56%(未显著)。论文没有讨论"什么时候不该用这个嵌入",也没有给出门控或按触点选择性接入的方案。
- fine-tuning 被排除在外。 作者援引 PinFM 的发现承认 fine-tuning 会优化基座模型对下游任务的贡献,但本文全程冻结权重。这使得所有 tokenization 与目标函数的比较结论,严格来说只在"冻结线性探测"这一口径下成立——解冻之后不同 tokenization 的排序是否保持,是未知的。
工业落地价值¶
抛开上述局限,SAGA 的工程叙事对中等体量的多业务线公司有直接的参考价值。它证明了一件很实用的事:不需要十亿参数、不需要 item ID 词表、不需要 fine-tuning,一个 37M 参数、378 token 词表、上下文 146 个事件的 decoder,只要把多触点行为规整成统一 schema 并保留字段结构,产出的冻结嵌入就能给现成的 DCN-v2 + ESMM ranker 带来 TP-B 上 +12.75% 的线上业务指标。对比组是"只用 engagement 序列 + 其他 surface 的用户级聚合特征"的传统 ranker——这正是绝大多数公司当下的现状,因此这个对照的实际参考意义很强。
部署形态上,SAGA 走的是最低侵入性的路线:上游模型冻结、下游 ranker 架构与超参完全不变、嵌入只作为额外输入特征接入。这让它可以在不重构现有推荐栈的前提下增量上线,也让上下游能按各自节奏迭代。论文最后给出的结论句也正是这个意思:金融服务组织可以跨异构客户触点建立单一嵌入模型,取代当前"每个 surface 各建一套模型"的开发实践。