X-Rec Technical Report:在连续物品向量空间用黎曼流匹配做生成式召回¶
ByteDance(TikTok-Data-Content Intelligence & TikTok-Data-Feed Quality)· arXiv 2609.29180(2026-09-24) 通讯作者:Kun Xu;项目负责人:Zhiwei Wang;核心贡献者 18 人、贡献者 30+ 人(技术报告格式,按角色字母序署名)
一、研究动机与背景¶
1.1 召回的两条主流范式及其缺陷¶
论文把推荐形式化为下一物品生成:建模条件推荐分布 $p(x\mid c)$,其中 $x$ 是下一物品,用户上下文 $c$ 包含历史交互序列 $s$ 与期望目标属性 $f$(例如希望建模的目标行为)。作者把现有召回方法归为两类,并各自指出结构性缺陷:
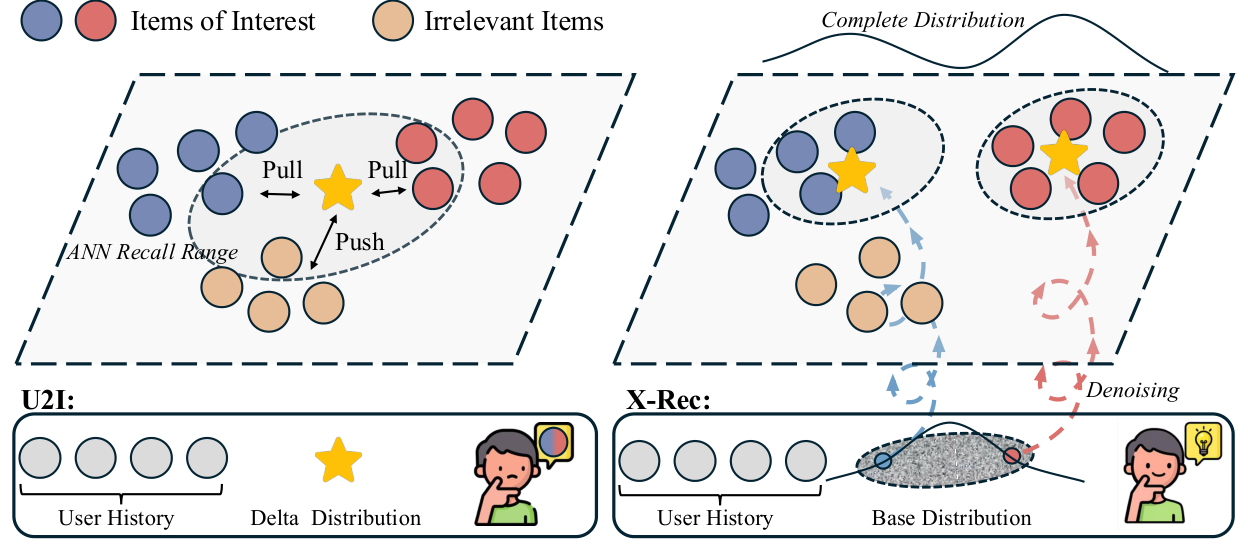
- 双塔 U2I 召回(ComiRec、HLLM、NoteLLM 等):物品表示为连续向量,用户上下文编码成一个或少数几个确定性向量,然后做 ANN。作者的核心论点是 U2I 在推理时把 $p(x\mid c)$ 退化为一个 delta 分布,所有概率质量集中在一个召回点上,表达力不足以刻画多峰兴趣。多兴趣 U2I(ComiRec)只是增加了确定性召回点的个数,分布形式没有改变,而且兴趣个数是预设超参,无法自适应用户兴趣的真实峰数。
- SID 自回归生成(SID-AR)(TIGER、OneRec、OneRec-V2):把物品向量量化成 semantic ID,把推荐变成 next-token 预测。表达力比 delta 分布强得多,但有两个问题:
- 「有缺陷的 SID」(flawed SIDs):一是量化误差带来的信息损失;二是 SID 理想情况下应和物品 ID 近似一一对应,工业规模下很难满足(常见做法是在 SID 末尾拼一个无语义的 hash token 去重,但这削弱了码本自身的语义结构)。
- 低吞吐:SID token 必须逐个解码并维护 KV cache,大规模召回场景下吞吐是瓶颈。
1.2 X-Rec 的定位¶
X-Rec 的名字强调「回到 $x$ 本身」:每个物品就用它的向量表示,直接用flow matching(FM)扩散在连续物品向量空间里建模 $p(x\mid c)$,采样出多个向量触发器(trigger),再各自去 ANN 召回。这样做同时回应三点:
- 相对 U2I:FM 能表达任意连续分布,多次采样天然产生覆盖不同兴趣峰的多个触发器;
- 相对 SID-AR:直接在物品向量上操作,不引入量化误差,也不需要维护 SID↔物品 ID 的一一对应;
- 相对 SID-AR 的吞吐:一次扩散生成一个完整向量,而非自回归生成多个 SID token。
为让这个设定在工业规模上既有效又高效,X-Rec 在 DiT(Diffusion Transformer)之上做了三项关键设计:
- 锚点条件(anchor conditioning):先预测目标向量所在的簇中心索引(anchor),再以 anchor 为条件生成细粒度向量,把生成拆成「粗粒度语义区域选择 + 细粒度精修」。论文报告 Recall@20 +2.05pp。
- 黎曼流匹配(RFM):物品向量经对比学习 + $\ell_2$ 归一化后落在超球面上,生成轨迹沿球面测地线演化。相对欧氏 rectified FM,Recall@20 +1.78pp。
- Late-interaction DiT:每个去噪步只用最后一层 Transformer 估计速度场。相对全层去噪 Recall@20 只降 1.05pp,生成吞吐提升约 8.28×。
二、三种范式的形式化与复杂度对比¶
设物品集为 $\mathcal{X}$,上下文 $c$ 包含按时间排序的历史交互序列 $s$ 与期望目标属性 $f=(f_1,\dots,f_F)\in\mathcal{F}$(论文不区分物品特征与用户-物品交互特征,都算属性)。行为序列由交互元组组成:
$$s=(i_1,i_2,\cdots,i_N),\qquad i_n=(x_n,f_n) \tag{1}$$
其中 $f_n=(f_n^1,\dots,f_n^F)$ 是物品 $x_n$ 的属性向量。推理时从 $p_\theta(x\mid c)$ 生成 $K$ 个召回触发器 $\tilde{x}_{1:K}$ 去召回候选。复杂度分析统一假设 $L$ 层、隐维 $d$ 的 Transformer,条件长度 $N$,触发器个数 $K$,SID 长度 $M$。
| 范式 | $x$ 的表示 | $p(x\mid c)$ 的形式 | 时间复杂度 | 空间复杂度 |
|---|---|---|---|---|
| U2I | 向量 | 训练:采样类别分布;测试:delta | $O(N^2)$ | $O(1)$ |
| SID-AR | SID | 离散类别分布 | $O(N(N+KM))$ | $O(LN)$ |
| X-Rec | 向量 | 连续分布 | $O(N(N+M))$ | $O(N)$ |
表 1:不同生成式召回范式的形式化与复杂度(原文 Table 1 照录;注意 X-Rec 行的 $O(N(N+M))$ 与正文式 (12) 推出的 $O(N(N+K))$ 不一致,疑为表格笔误)。
2.1 U2I¶
U2I 用向量 $x^{(e)}$ 表示物品,训练时通常用 InfoNCE,可理解为建模一个采样类别分布:
$$p^{\text{u2i-train}}_\theta(x\mid c)=\frac{\exp\!\big(e_\theta(c)^\top x^{(e)}/\tau\big)}{\exp\!\big(e_\theta(c)^\top x^{(e)}/\tau\big)+\sum_{x'\in\mathcal{X}_{\text{neg}}}\exp\!\big(e_\theta(c)^\top x'^{(e)}/\tau\big)} \tag{2}$$
$\tau$ 为温度,$\mathcal{X}_{\text{neg}}$ 是负样本集合(如 in-batch negatives)。分母只在负样本上归一化,因此这是全库 softmax 的有偏采样近似。推理时 U2I 退化为 delta 分布:
$$p^{\text{u2i-test}}_\theta(x\mid c)=\begin{cases}1,& x^{(e)}=e_\theta(c)\\ 0,&\text{otherwise}\end{cases} \tag{3}$$
召回触发器只有一个选择:
$$\tilde{x}^{(e)}=e_\theta(c) \tag{4}$$
U2I 只有编码器,推理成本来自条件 token 的 FFN 与自注意力:
$$C^{\text{time}}_{\text{U2I}}=\underbrace{O(Ld^2N)}_{\text{条件 token 的 FFN}}+\underbrace{O(LdN^2)}_{\text{条件 token 的注意力}}\sim O(N^2) \tag{5}$$
U2I 不需要为后续计算保留 KV cache:
$$C^{\text{space}}_{\text{U2I}}=O(1) \tag{6}$$
2.2 SID-AR¶
SID-AR 把物品表示为 SID 序列 $x^{(s)}_{1:M}$,把推荐分布分解为自回归序列模型:
$$p^{\text{SID-AR}}_\theta(x\mid c)=\prod_{m=1}^{M}p_\theta\big(x^{(s)}_m\mid c,x^{(s)}_{1:m-1}\big) \tag{7}$$
推理时用 beam search 得到召回触发器:
$$\tilde{x}^{(s)}_{1:K}=\text{Beamsearch}_K\big(p^{\text{SID-AR}}_\theta(x\mid c)\big) \tag{8}$$
其复杂度多出生成 token 的 FFN 与注意力,以及 KV cache:
$$C^{\text{time}}_{\text{SID-AR}}=\underbrace{O(Ld^2N)}_{\text{条件 FFN}}+\underbrace{O(LdN^2)}_{\text{条件注意力}}+\underbrace{O\big(Ld^2K(M-1)\big)}_{\text{生成 token 的 FFN}}+\underbrace{O\Big(\tfrac{LdK(2N+M-2)(M-1)}{2}\Big)}_{\text{生成 token 的注意力}}\sim O\big(N(N+KM)\big),\qquad C^{\text{space}}_{\text{SID-AR}}=O\big(L(N+M)\big) \tag{9}$$
2.3 X-Rec¶
X-Rec 用连续向量 $x^{(e)}$ 表示物品,FM 学一个时间相关的速度场 $v^t_\theta(\cdot\mid c)$,把噪声 $\epsilon\sim r(\epsilon)$ 输运到目标物品向量。推理时逐步去噪,相当于从学到的推荐分布采样:
$$\tilde{x}^{(e)}_{1:K}\sim p^{\text{X-Rec}}_\theta(x\mid c) \tag{10}$$
脚注给出该分布由速度场隐式定义:$p^{\text{X-Rec}}_\theta(x\mid c)=r(\epsilon)\exp\!\big(-\int_0^1\nabla\cdot v^t_\theta(\phi^t_\theta(\epsilon\mid c)\mid c)\,dt\big)$,其中 $\frac{d\phi^t_\theta(\cdot\mid c)}{dt}=v^t_\theta(\phi^t_\theta(\cdot\mid c)\mid c)$。另一条脚注从决策边界角度论证多触发器的表达力:用 $K$ 个触发器召回等价于选出满足 $\max_{k\in[K]}\tilde{x}^{(e)\top}_k x^{(e)}>\tau$ 的候选,正召回区域是 $K$ 个半空间的并,这一函数类的 VC 维为 $\Theta(dK\log K)$,所以触发器越多,可表示的决策边界越复杂。
X-Rec 的一般时间复杂度为:
$$C^{\text{time}}_{\text{X-Rec}}=\underbrace{O(Ld^2N)}_{\text{条件 FFN}}+\underbrace{O(LdN^2)}_{\text{条件注意力}}+\underbrace{O(L'Td^2K)}_{\text{生成向量的 FFN}}+\underbrace{O(L'TdKN)}_{\text{生成向量的注意力}} \tag{11}$$
$L'$ 是每次速度场评估用到的层数,$T$ 是去噪步数。实验发现 $L'=1$(只用最后一层)、$T=L$ 时质量与效率的折中较好,此时:
$$C^{\text{time}}_{\text{X-Rec}}=O(Ld^2N)+O(LdN^2)+O(Ld^2K)+O(LdKN)\sim O\big(N(N+K)\big) \tag{12}$$
只需存最后一层条件 token 的 KV cache:
$$C^{\text{space}}_{\text{X-Rec}}=O(N) \tag{13}$$
因此 X-Rec 的复杂度介于 U2I 与 SID-AR 之间。需要注意:这里所有复杂度都只计入触发器生成,不含 ANN 检索。X-Rec 与 U2I 都依赖 ANN 索引,而原生 SID-AR 可以直接用 SID 查表定位物品,不一定需要 ANN。这一点在后面讨论吞吐时很关键。
三、核心方法:X-Rec 框架¶
3.1 预备知识:Flow Matching¶
给定推荐上下文 $\hat{c}$,$\hat{x}^{(e)}\in\mathcal{X}^{(e)}$ 为从经验分布 $p_{\text{data}}(x\mid\hat{c})$ 采得的真实物品向量(论文约定 $\hat{\cdot}$ 为经验样本,$\tilde{\cdot}$ 为模型估计)。FM 学一个流函数 $\phi^t_\theta(\cdot\mid\hat{c})$,$t\in[0,1]$,满足:
$$\phi^0_\theta(\epsilon\mid\hat{c})=\epsilon\sim r(\epsilon),\qquad \phi^1_\theta(\epsilon\mid\hat{c})\sim p_{\text{data}}(x^{(e)}\mid\hat{c}) \tag{14}$$
直接构造这样的流很难,但给定目标向量时可以定义条件流:
$$\phi_0(\epsilon\mid\hat{x}^{(e)},\hat{c})=\epsilon\sim r(\epsilon),\qquad \phi_1(\epsilon\mid\hat{x}^{(e)},\hat{c})=\hat{x}^{(e)} \tag{15}$$
例如欧氏 FM 用线性插值 $\phi_t=(1-t)\epsilon+t\hat{x}^{(e)}$。记 $\bar{x}^{(e)}_t=\phi_t(\epsilon\mid\hat{x}^{(e)},\hat{c})$,条件速度场为:
$$v_t\big(\bar{x}^{(e)}_t\mid\hat{x}^{(e)},\hat{c}\big)=\frac{d}{dt}\bar{x}^{(e)}_t \tag{16}$$
FM 目标把神经速度场回归到条件速度:
$$\mathcal{L}_{\text{FM}}=\mathbb{E}_{\hat{c},\hat{x}^{(e)}\sim p_{\text{data}},\,\epsilon\sim r,\,t\sim\mathcal{U}(0,1)}\Big[\big\|v^t_\theta(\bar{x}^{(e)}_t\mid\hat{c})-\tfrac{d}{dt}\bar{x}^{(e)}_t\big\|^2_{\mathcal{X}^{(e)}}\Big] \tag{17}$$
Lipman 等证明最优速度场诱导的流满足式 (14),即以下 ODE 的解:
$$\frac{d}{dt}\tilde{x}^{(e)}_t=v^t_{\theta^\star}\big(\tilde{x}^{(e)}_t\mid\hat{c}\big),\qquad \tilde{x}^{(e)}_0=\epsilon\sim r(\epsilon) \tag{18}$$
推理时用 Euler 离散化数值积分。
3.2 训练算法¶
Anchor Loss(锚点损失)。 直接生成细粒度物品向量很难,因为物品表示空间复杂且多峰。X-Rec 先预测目标物品的粗语义区域,即目标向量 $\hat{x}^{(e)}$ 的聚类中心索引 $\hat{x}^{(a)}\in\mathcal{A}$(称为 anchor),再以它为条件生成触发器向量。锚点预测用交叉熵:
$$\mathcal{L}_{\text{anchor}}=-\mathbb{E}_{(\hat{c},\hat{x}^{(a)})\sim p_{\text{data}}}\big[\log p_\theta(\hat{x}^{(a)}\mid\hat{c})\big] \tag{19}$$
这里值得点破:anchor 本质上就是一个单层离散码。实现上 SID 由 4 层 × 4096 的 K-means 残差量化得到,anchor 是否直接复用第一层码本论文没有明说,但 Table 2 就是用「第一位 SID」来评估 anchor 的作用。所以 X-Rec 最终形态其实是「离散粗分类 + 连续精修」的混合,而不是纯连续。
RFM Loss。 物品向量经对比学习 + $\ell_2$ 归一化,落在单位超球面 $\mathcal{X}^{(e)}=\mathbb{S}^{d_e-1}$ 上。欧氏 FM 的线性插值与加性去噪会让中间态和生成态偏离球面,与归一化物品向量不对齐。因此用 RFM 构造测地线插值:
$$\bar{x}^{(e)}_t=\frac{\sin((1-t)\omega)}{\sin\omega}\epsilon+\frac{\sin(t\omega)}{\sin\omega}\hat{x}^{(e)},\qquad \omega=\arccos(\epsilon^\top\hat{x}^{(e)}) \tag{20}$$
$\epsilon$ 从球面上的基分布采样,$\omega$ 是 $\epsilon$ 与 $\hat{x}^{(e)}$ 的测地距离。对 $t$ 求导得条件速度:
$$\frac{d}{dt}\bar{x}^{(e)}_t=\frac{\omega}{\sin\omega}\Big(\cos(t\omega)\hat{x}^{(e)}-\cos((1-t)\omega)\epsilon\Big) \tag{21}$$
代入式 (17),得到 RFM 损失(条件同时包含上下文与 anchor):
$$\mathcal{L}_{\text{RFM}}=\mathbb{E}_{(\hat{c},\hat{x}^{(a)},\hat{x}^{(e)})\sim p_{\text{data}},\,\epsilon\sim r(\epsilon),\,t\sim\mathcal{U}(0,1)}\left[\left\|v^t_\theta\!\Big(\tfrac{\sin((1-t)\omega)}{\sin\omega}\epsilon+\tfrac{\sin(t\omega)}{\sin\omega}\hat{x}^{(e)}\,\Big|\,\hat{c},\hat{x}^{(a)}\Big)-\tfrac{\omega}{\sin\omega}\Big(\cos(t\omega)\hat{x}^{(e)}-\cos((1-t)\omega)\epsilon\Big)\right\|^2\right],\quad \omega=\arccos(\epsilon^\top\hat{x}^{(e)}) \tag{22}$$
总损失。 每个训练样本采多组噪声与时间步估计 RFM 期望,总目标为加权和:
$$\mathcal{L}=\alpha\mathcal{L}_{\text{anchor}}+\beta\mathcal{L}_{\text{RFM}} \tag{23}$$
实验中 $\alpha=0.1,\beta=1$。
3.3 推理算法¶
推理时先采样 anchor $\tilde{x}^{(a)}\sim p_\theta(x^{(a)}\mid\hat{c})$(温度 1.4),再从球面均匀分布 $\tilde{x}^{(e)}_0\sim U_{\mathbb{S}^{d_e-1}}(\epsilon)$ 初始化,用黎曼 Euler 积分逐步去噪(步长 $\Delta t$),即沿切向速度方向走指数映射:
$$\tilde{x}^{(e)}_{t+\Delta t}=\cos\!\Big(\big\|v^t_\theta(\tilde{x}^{(e)}_t\mid\hat{c},\tilde{x}^{(a)})\big\|\Delta t\Big)\tilde{x}^{(e)}_t+\sin\!\Big(\big\|v^t_\theta(\tilde{x}^{(e)}_t\mid\hat{c},\tilde{x}^{(a)})\big\|\Delta t\Big)\frac{v^t_\theta(\tilde{x}^{(e)}_t\mid\hat{c},\tilde{x}^{(a)})}{\big\|v^t_\theta(\tilde{x}^{(e)}_t\mid\hat{c},\tilde{x}^{(a)})\big\|} \tag{24}$$
$t$ 到 1 时的终态 $\tilde{x}^{(e)}_1$ 即为召回触发器。默认 30 步去噪,全程 CFG guidance scale = 3.0。每个请求生成 $K=20$ 个触发器,每个触发器取 ANN 最近的 1 个物品(20×1)。
推理步骤化描述: 1. Prefill:历史序列经 $L$ 层因果 Transformer 编码一次,缓存最后一层(第 $L$ 层输入)的 KV; 2. 用 $i^{(h_L)}_N+f^{(m)}$ 经 softmax 分类器按温度 1.4 采样 $K$ 个 anchor; 3. 对每个 anchor,在球面上采样初始噪声,重复 30 次:去噪 token 只过最后一层(复用 KV cache)→ 投影到切空间 → 按式 (24) 更新(含 CFG 的条件/无条件两路速度估计); 4. 得到 $K$ 个触发器,分别去 ANN 索引召回 top-$R$,取并集。
3.4 模型架构¶
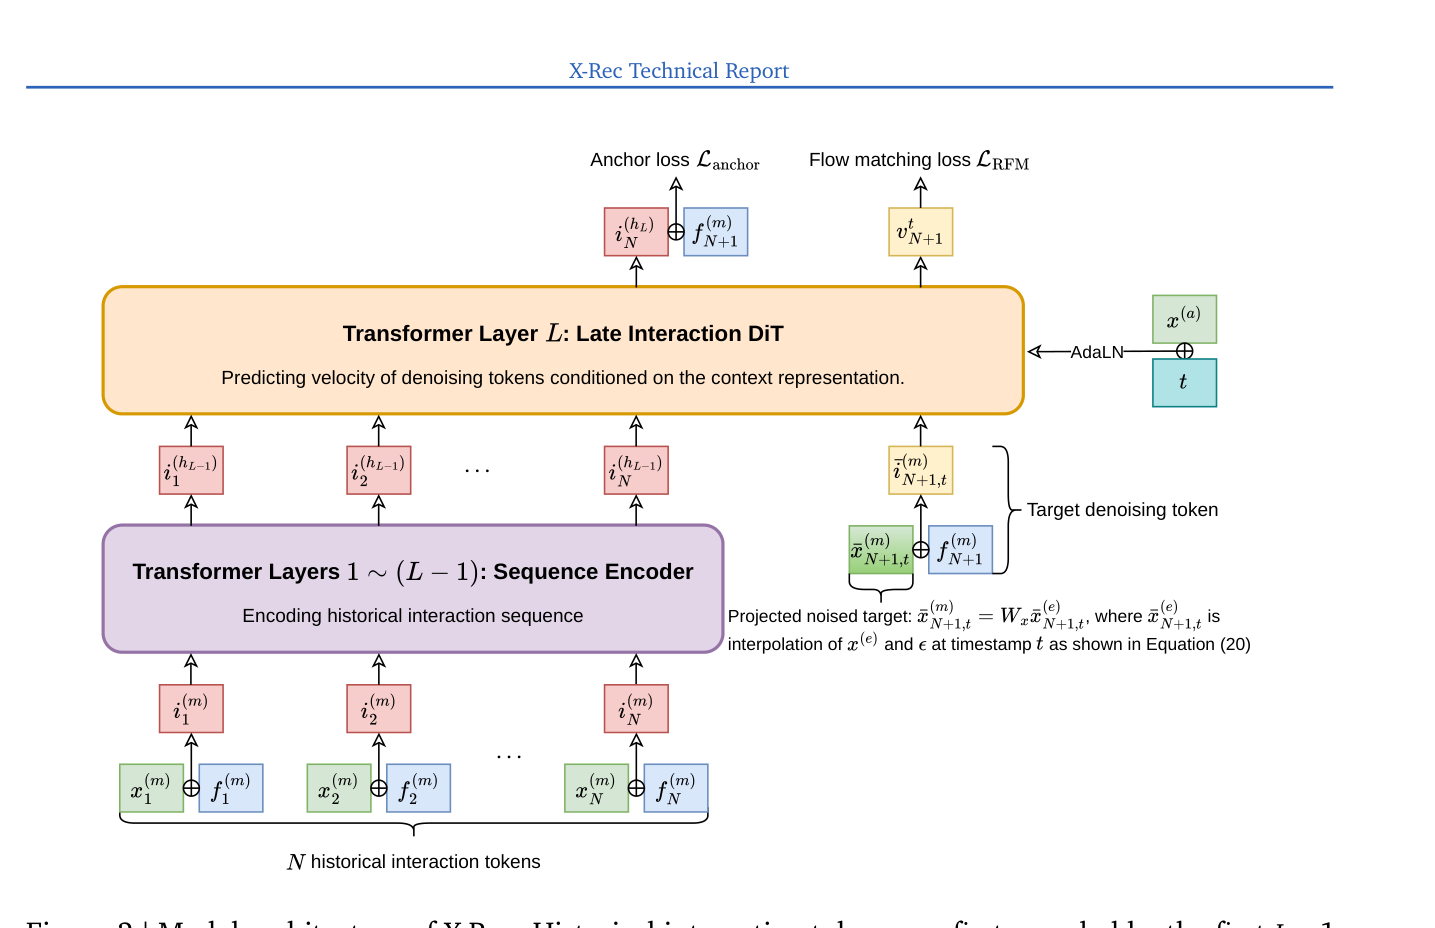
特征编码。 目标属性由各子属性向量拼接后投影到模型维度 $d_m$:
$$f^{(m)}=W_f f^{(e)}=W_f[f^{1(e)};f^{2(e)};\cdots;f^{F(e)}]\in\mathbb{R}^{d_m} \tag{25}$$
历史序列中的每个交互 $i=(x,f)$ 把物品与属性信息相加融合:
$$i^{(m)}=x^{(m)}+f^{(m)}=W_x x^{(e)}+W_f f^{(e)}\in\mathbb{R}^{d_m} \tag{26}$$
历史序列表示为交互 token 序列:
$$s^{(m)}=\big(i^{(m)}_1,i^{(m)}_2,\cdots,i^{(m)}_N\big)\in\mathbb{R}^{d_m\times N} \tag{27}$$
送入 $L$ 层 Transformer 得到多层上下文化表示:
$$s^{(h_l)}=\text{TransformerLayer}_l\big(s^{(h_{l-1})}\big)=\big(i^{(h_l)}_1,\cdots,i^{(h_l)}_N\big)\in\mathbb{R}^{d_m\times N},\quad l=1,\dots,L,\ s^{(h_0)}=s^{(m)} \tag{28}$$
骨干是 Qwen3 风格 Transformer(RoPE + QK-Norm)。用户序列用因果 mask 编码,所以 $i^{(h_L)}_N$ 是整个历史的有效上下文表示,且 KV cache 可在后续速度预测阶段复用。
Anchor 预测器。 anchor 离散,用 softmax 分类器:
$$p_\theta(x^{(a)}\mid c)=\frac{\exp\big(w_a^\top(i^{(h_L)}_N+f^{(m)})\big)}{\sum_{a'\in\mathcal{A}}\exp\big(w_{a'}^\top(i^{(h_L)}_N+f^{(m)})\big)},\qquad w_a\in\mathbb{R}^{d_m} \tag{29}$$
速度预测器:Late-Interaction DiT。 基本沿用 DiT,关键改动是借鉴 ColBERT 的 late interaction。先把目标属性信息以和交互 token 相同的方式融入当前去噪态:
$$\tilde{i}^{(m)}_t=\tilde{x}^{(m)}_t+f^{(m)}=W_x\tilde{x}^{(e)}_t+W_f f^{(e)}\in\mathbb{R}^{d_m} \tag{30}$$
去噪 token 只插入最后一层,复用 prefill 阶段算好的前 $L-1$ 层上下文表示;最后一层输出投影为速度,再去掉径向分量投影到球面切空间:
$$\big[s^{(h_L)};\tilde{i}^{(h_L)}_t\big]=\text{TransformerLayer}_L\Big(\big[s^{(h_{L-1})};\tilde{i}^{(m)}_t\big],t,x^{(a)}\Big),\quad v'^t_\theta=W_v\tilde{i}^{(h_L)}_t\in\mathbb{R}^{d_e},\quad v^t_\theta=v'^t_\theta-\big(v'^{t\top}_\theta\tilde{x}^{(e)}_t\big)\tilde{x}^{(e)}_t\in T_{\tilde{x}^{(e)}_t}\mathbb{S}^{d_e-1} \tag{31}$$
其中 $T_{\tilde{x}^{(e)}_t}\mathbb{S}^{d_e-1}=\{u\in\mathbb{R}^{d_e}:u^\top\tilde{x}^{(e)}_t=0\}$ 是超球面在当前点的切空间。flow 时间步 $t$ 与 anchor $x^{(a)}$ 的 embedding 相加后,通过 AdaLN 调制最后一层的注意力与 MLP 块。
设计动机:全层 DiT 每个去噪步都要重跑 $L$ 层,30 步就是 30 倍全模型计算;late interaction 让每步只付一层的代价,上下文编码只做一次。代价是速度场的「深度」只有一层,表达力受限(见 §5.3 的质量-吞吐曲线)。
3.5 训练流程:预训练 + SFT¶
预训练。 对时间有序的交互序列 $s=(i_1,\dots,i_N)$,建模自回归分解:
$$\prod_{n=1}^{N}p_\theta(x_n\mid i_{1:n-1},f_n) \tag{32}$$
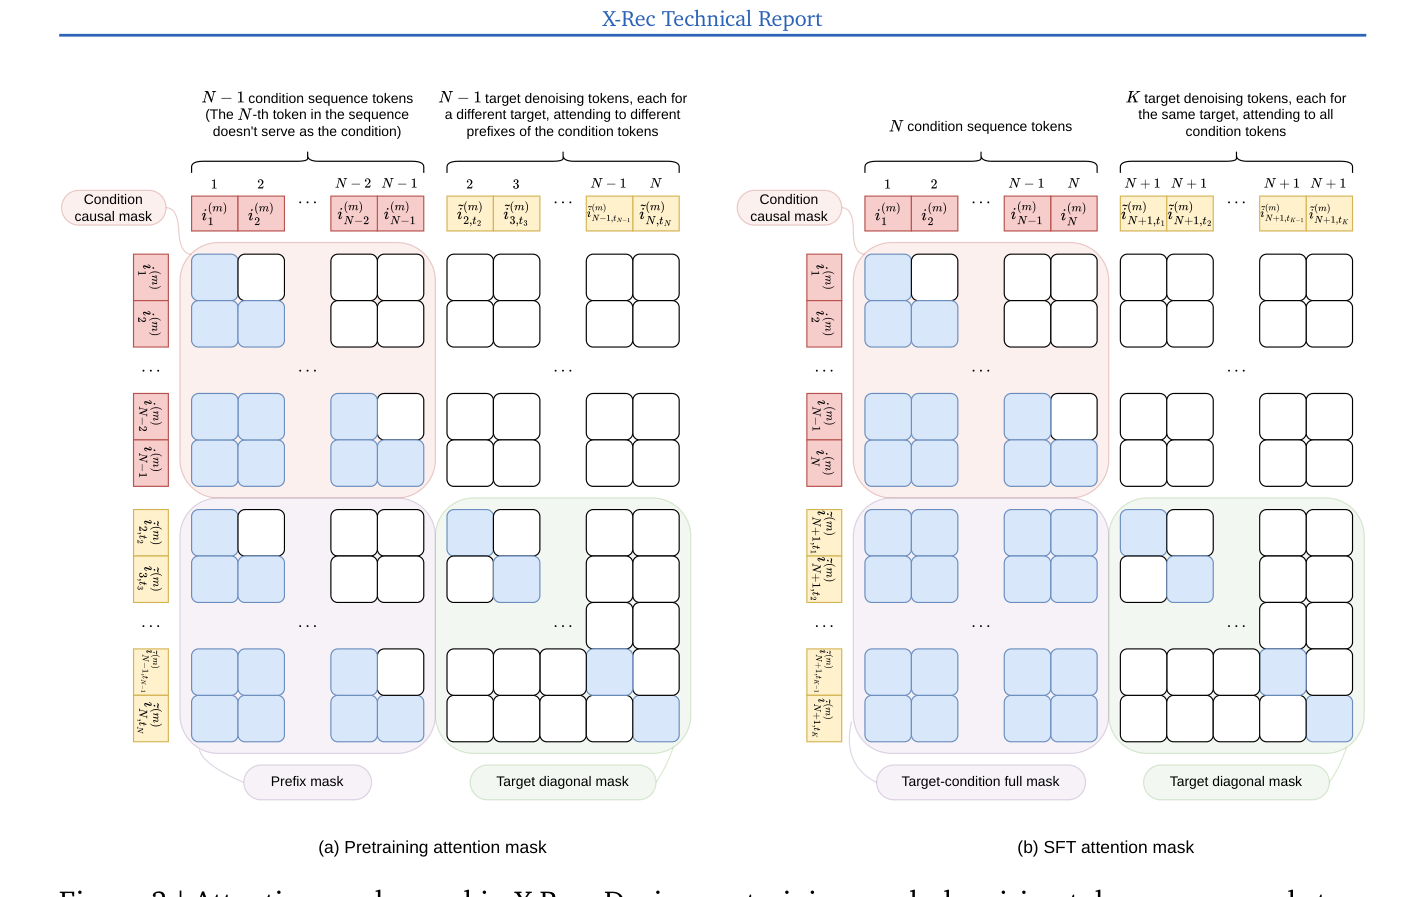
每个因子都用式 (23) 的 X-Rec 损失优化,一条序列产出 $N$ 个 next-item 预测对。为了在一次 prefill 中并行算完所有位置的损失,设计了专门的注意力 mask(图 3a):条件 token 间因果;每个目标去噪 token 只注意自己对应的历史前缀(prefix mask)和自身(target diagonal mask),去噪 token 之间互相隔离。这样既不改变序列预训练的语义,又把训练效率拉满。
SFT。 把预训练的转移模型适配到下游服务的召回事件。对每个合格目标物品 $x$ 及属性 $f$,其序列 $s$ 由两部分按时间拼接:历史正向序列(用户有过有意义互动的物品,反映稳定偏好)与近期交互序列(目标事件前的最新行为,反映即时意图)。每个目标抽 8 组独立噪声与时间步估计 RFM 目标,mask 见图 3b:每个去噪 token 注意完整历史与同一目标属性,不同加噪副本互相隔离,避免信息泄漏。
四、实验设置¶
4.1 数据¶
全部实验都在TikTok 内部流式 benchmark上,没有任何公开数据集。预训练和流式数据中,属性集 $f$ 只包含用户行为,所以任务是基于历史交互序列生成与用户已展示兴趣对齐的物品。
- 预训练数据:平台大规模用户-物品交互日志,按最多 200 次交互切块。
- 流式评估 benchmark:47 个连续分区,每个分区 2.6M 采样训练样本 + 10K 测试样本;每个样本含长度有上限的历史正向序列与近期交互序列。每个分区的目标物品集合构成对应的 ANN 召回池(注意:召回池只由测试目标组成,远小于真实全库,这让 Recall 数值偏乐观)。模型按分区顺序训练和评估,上一分区的最终 checkpoint 初始化下一分区,模拟生产环境的持续更新。
4.2 评估指标¶
每个测试样本 $(c,x)$ 生成 $K$ 个向量触发器 $t_{1:K}$,每个触发器从 ANN 取 top-$R$,定义:
$$\text{Recall}@(K\times R)=\frac{1}{|\mathcal{D}|}\sum_{(c,x)\in\mathcal{D}}\mathbb{I}\left[x\in\bigcup_{k=1}^{K}\text{ANN}_R(t_k)\right] \tag{33}$$
即真实物品落在所有触发器召回并集中的样本比例。默认报 Recall@20×1,简称 Recall@20。
吞吐:单张生产级 GPU 上的每秒请求数(QPS),每请求生成 $K=20$ 个触发器,只计触发器生成,不含 ANN 查找。
4.3 Baseline¶
- U2I:SASRec、LRURec、DreamRec(DreamRec 虽基于扩散,但原实现只生成单个向量,所以归为 U2I);
- SID 生成式:TIGER、EAGER、LATTE、LLaDARec(离散扩散并行生成 SID);
- 受控变体(与 X-Rec 同上下文编码器):X-Rec-U2I(对比学习目标,产出单个触发器)、X-Rec-AR(decoder-only 自回归生成 4 位 SID,beam search 后用 RQ 码本重建为向量触发器)、X-Rec-U2I-K(在同骨干上接 ComiRec-SA 多兴趣抽取)。
评估协议:U2I 用 1×20,SID 方法与 X-Rec 用 20×1。所有 SID 方法生成的 SID 都先经各自的 RQ 码本解码为向量,再作为触发器做 ANN 检索。这是统一口径,但也意味着 SID 方法不能用原生的「SID 直接定位物品」,而是要带着量化重建误差(重建余弦 0.94)去做 20×1 的最近邻匹配。§5.4 恰好显示 20×1 是重建误差伤害最大的配置,所以这个口径对 SID 方法偏不利。
4.4 实现细节¶
| 项目 | 设置 |
|---|---|
| 骨干 | Qwen3-0.6B,去掉 token embedding 层后约 0.46B 参数,$L=28$ 层 |
| 物品表示 | 每个物品是一条视频,128 维多模态向量,归一化到单位超球面 |
| SID | K-means 残差量化,4 个码本 × 4096,平均重建余弦相似度 0.94 |
| 预训练 | 1 epoch(200K 步),AdamW,batch 4096;前 2K 步线性 warmup 到 5e-4,余弦衰减到 1e-4 |
| 流式 SFT | 每分区 3 epoch,AdamW,恒定 lr 1e-4,batch 512 |
| 最大历史长度 | 200(两阶段相同) |
| 损失权重 | $\alpha=0.1$,$\beta=1$ |
| CFG | 训练时以 5% 概率丢弃条件上下文;推理 guidance scale 3.0 |
| 推理 | anchor 采样温度 1.4,30 步去噪,每请求 20 个触发器 |
五、主要实验结果¶
5.1 整体性能¶
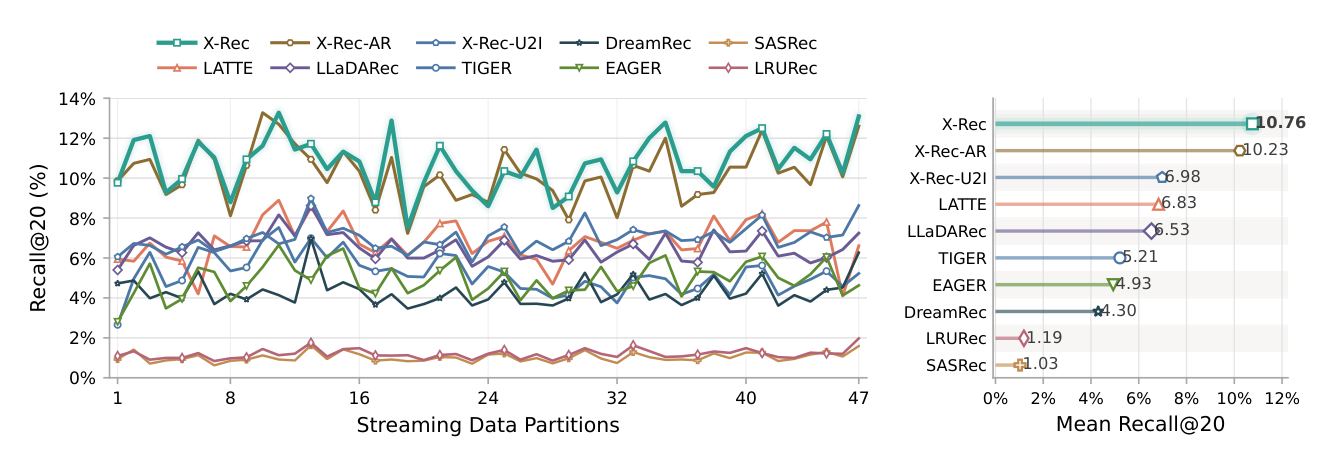
平均 Recall@20(图 4;Recall@50 均值由我根据附录 Table 5 逐分区数据计算):
| 模型 | 类别 | 平均 Recall@20 (%) | 平均 Recall@50 (%)(由 Table 5 计算) |
|---|---|---|---|
| X-Rec | 连续 FM | 10.76 | 12.70 |
| X-Rec-AR | SID-AR(受控) | 10.23 | 13.29 |
| X-Rec-U2I | U2I(受控) | 6.98 | 9.68 |
| LATTE | SID | 6.83 | 8.64 |
| LLaDARec | SID(离散扩散) | 6.53 | 7.73 |
| TIGER | SID | 5.21 | 7.00 |
| EAGER | SID | 4.93 | 6.84 |
| DreamRec | U2I(扩散单向量) | 4.30 | 4.53 |
| LRURec | U2I | 1.19 | 2.18 |
| SASRec | U2I | 1.03 | 1.90 |
论文的两点主要观察:
- X-Rec 略优于 X-Rec-AR:正文写 X-Rec 均值 10.65%、领先 0.53pp,47 个分区中 38 胜 1 平。(数值不一致:图 4、图 6 与附录 Table 4 的均值都是 10.76%,10.76−10.23=0.53 与之吻合,所以 10.65 应是笔误;我按 Table 4 逐分区统计是 39 胜 0 平。)作者据此认为 FM 与 SID-AR 的分布建模能力相当,而 X-Rec 吞吐高得多。
- X-Rec 明显优于 X-Rec-U2I:领先 3.67pp(按 10.76 算是 3.78pp),说明多峰兴趣建模很重要;而且 X-Rec 只生成 1 个触发器(1×20)时也有 8.28%,仍高于 X-Rec-U2I 的 6.98%。
我的补充分析(论文没提):
- Recall@50 上 X-Rec 反输 X-Rec-AR(12.70 vs 13.29,−0.59pp),逐分区只赢 14/47。也就是说「X-Rec 质量 ≥ SID-AR」只在 20×1 这一个口径成立;触发器增加到 50 个后,SID-AR 的 beam search 取出的候选更互补,X-Rec 独立采样的触发器冗余更高(X-Rec 从 R@20 到 R@50 只涨 1.94pp,X-Rec-AR 涨 3.06pp)。摘要里的「matches」措辞是准确的,正文「outperforms both」则言过其实。
- 外部 baseline 偏弱:同属 U2I 的 SASRec 只有 1.03%,而同骨干的 X-Rec-U2I 有 6.98%。差距主要来自 0.46B 预训练骨干,不来自范式。所以真正有信息量的对照只有两个受控变体 X-Rec-AR 和 X-Rec-U2I,外部 baseline 只起背景作用。
5.2 在线 A/B¶
X-Rec 作为 TikTok 某垂类内容推荐的新增召回源上线,分两次:
- V1:X-Rec w/o anchor conditioning(含 RFM + late interaction);
- V2:在 V1 基础上加入 anchor conditioning。
| 指标 | V1 | V2 | 合计 |
|---|---|---|---|
| 垂类互动(Vertical Engagement) | +2.3779% | +1.7705% | +4.1484% |
| 大盘互动(General Engagement) | 不显著 | +0.0111% | +0.0111% |
Table 3:在线 A/B 结果。V1 是 V2 的对照组,所以两次增益可叠加估计总提升。除标注「不显著」外均统计显著。
分析:
- 对照组是什么:V1 的对照是没有 X-Rec 这路召回的现网系统(新增召回源),V2 的对照是 V1。整个在线实验没有和 SID 生成式召回做对比,所以「连续 FM 优于 SID-AR」完全没有线上证据;+4.15% 里有多少来自「多一路召回带来的增量候选/多样性」,又有多少来自 FM 范式本身,无法拆分。
- 大盘收益很小:大盘互动只有 V2 的 +0.0111%,V1 不显著。垂类 +4% 很可观,但作用范围限于一个垂类。
- V2 的 +1.77% 相当于 anchor 的线上消融,与离线 AC 消融(+2.05pp)方向一致。这是全文唯一一个组件级的线上归因,而且是 anchor(离散粗分类),不是 FM 本身。
- 没有公布线上延迟、GPU 成本、触发器数量、ANN 配置,也没有与已有召回源的重叠率。
六、消融与分析¶
6.1 组件消融¶
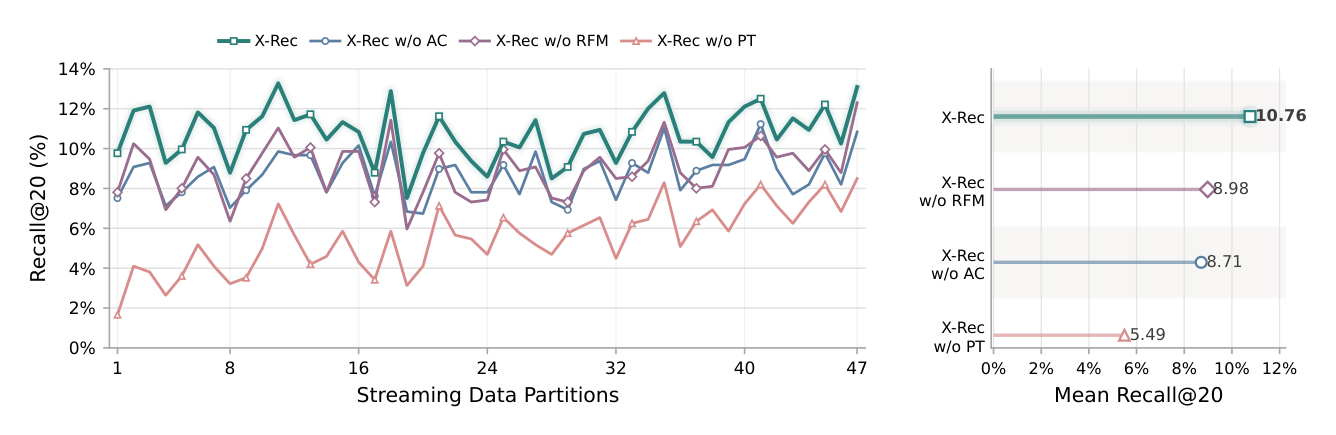
| 变体 | 平均 Recall@20 (%) | 相对 X-Rec | 逐分区 |
|---|---|---|---|
| X-Rec | 10.76 | — | — |
| w/o RFM(换成欧氏 rectified FM) | 8.98 | −1.78pp | 47/47 分区更差 |
| w/o AC(去掉锚点条件) | 8.71 | −2.05pp | 47/47 分区更差 |
| w/o PT(不预训练,流式从零训) | 5.49 | −5.27pp | 47/47 分区更差 |
锚点条件:为理解 AC 的作用,作者把生成的触发器量化回 SID,看第一位 SID 是否与真实物品一致:
| 模型 | 首位 SID Recall@20 (%) | 首位 SID Recall@50 (%) |
|---|---|---|
| X-Rec w/o AC | 28.57 | 35.77 |
| X-Rec | 41.37 | 53.55 |
Table 2:所有流式分区上首位 SID 的平均召回。
AC 让首位 SID 命中率提升 12.80pp / 17.78pp,说明 AC 大幅提高了找到正确粗语义区域的能力,进而提升端到端召回,且额外计算可忽略。
RFM:作者的解释是,欧氏 FM 下速度场要同时「朝目标移动」和「纠正偏离球面」,两个目标耦合;RFM 用测地线和切空间投影把球面约束写进动力学,模型容量全部用于在流形内的有意义移动。
预训练:去掉预训练掉 5.27pp,且在全部 47 个分区持续落后,流式 SFT 追不回来。
消融幅度与领先幅度的比较(按归档规则核查):
- X-Rec 对最强对照 X-Rec-AR 的领先只有 0.53pp,而去掉 AC(−2.05)或去掉 RFM(−1.78)中任何一个,X-Rec 都会跌到 X-Rec-AR 之下(8.71 / 8.98 < 10.23)。所以「连续 FM 追平 SID-AR」这个结论依赖两个组件同时存在,不是「在连续空间做 FM」本身带来的。
- 其中 AC 本质上是一个单层离散码分类(Table 2 就用首位 SID 来刻画它)。贡献最大的结构组件恰恰是把离散码重新引入,这让「完全绕开 SID 量化」的叙事打了折扣。更准确的说法是:连续 FM 负责码内精修,粗定位仍然靠离散分类。
- 对最强外部 baseline LATTE 的领先是 3.93pp,AC / RFM 单项消融都没超过这个量级(w/o AC 的 8.71 仍高于 LATTE),但前面说过外部 baseline 本身偏弱。
- 预训练的 −5.27pp 大于任何结构组件,也大于 X-Rec 对 X-Rec-U2I 的领先(3.78pp)。这说明「预训练 0.46B 序列模型」才是相对外部 baseline 最大的收益来源,不能记在 FM 范式头上。
6.2 Late-Interaction 的质量-吞吐权衡¶
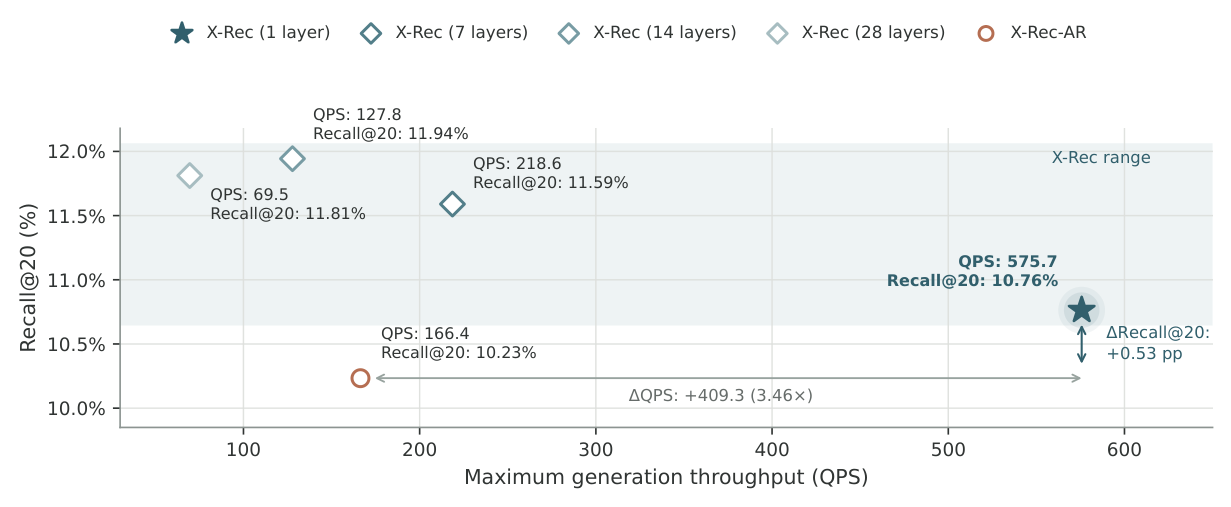
设定:速度场评估层数 $L'\in\{1,7,14,28\}$,去噪步数固定 30;单张生产级 GPU,BF16;每请求条件序列长 199、生成 20 个触发器;吞吐取各 batch size 下的最大值。
| 配置 | 最大 QPS | 平均 Recall@20 (%) | 相对 1 层的吞吐倍数 |
|---|---|---|---|
| X-Rec(1 层) | 575.7 | 10.76 | 1× |
| X-Rec(7 层) | 218.6 | 11.59 | 1/2.63 |
| X-Rec(14 层) | 127.8 | 11.94 | 1/4.50 |
| X-Rec(28 层,全层) | 69.5 | 11.81 | 1/8.28 |
| X-Rec-AR | 166.4 | 10.23 | 1/3.46 |
结论:$L'$ 从 1 增加时召回先升后降,14 层最好(11.94%),28 层反而略降。正文说 14 层「只比 1 层高 1.05pp」,但实际差 1.18pp;1.05pp 是 28 层与 1 层之差(引言用的是这个口径)。1 层版本吞吐分别是 7/14/28 层的 2.63×/4.50×/8.28×,且质量和吞吐都优于 X-Rec-AR(+0.53pp,3.46×)。
关于 3.46× 的核查:
- 是实测数字,但只是离线的触发器生成吞吐:单卡最大 QPS,不含 ANN 查找,不是线上端到端延迟或成本。X-Rec 每请求要做 20 次 ANN,原生 SID-AR 可以查表直接得到物品,两者的 ANN 负担其实不对等,把 ANN 排除在外对 X-Rec 有利。
- 质量口径在 R@20 上是对齐的(X-Rec 10.76 ≥ AR 10.23),但如 §5.1 所述,在 R@50 上 AR 更好,而吞吐只在 $K=20$ 下测过。
- X-Rec-AR 的解码配置没有披露(beam 宽、是否用了 vLLM 类的 serving 优化、是否做了 CFG 等),X-Rec 这边则是 30 步 + CFG 3.0(CFG 意味着每步两路前向)。基线的推理优化程度未知,3.46× 应看作「同骨干、作者自己实现」下的相对值。
- 更有说服力的一点:7 层版本(218.6 QPS,11.59%)同样在两个维度上都优于 X-Rec-AR(1.31× 吞吐,+1.36pp)。说明 X-Rec 在 Pareto 前沿上整体压过 AR 这个点,并不只靠挑选 1 层配置。
6.3 召回广度 vs 深度¶
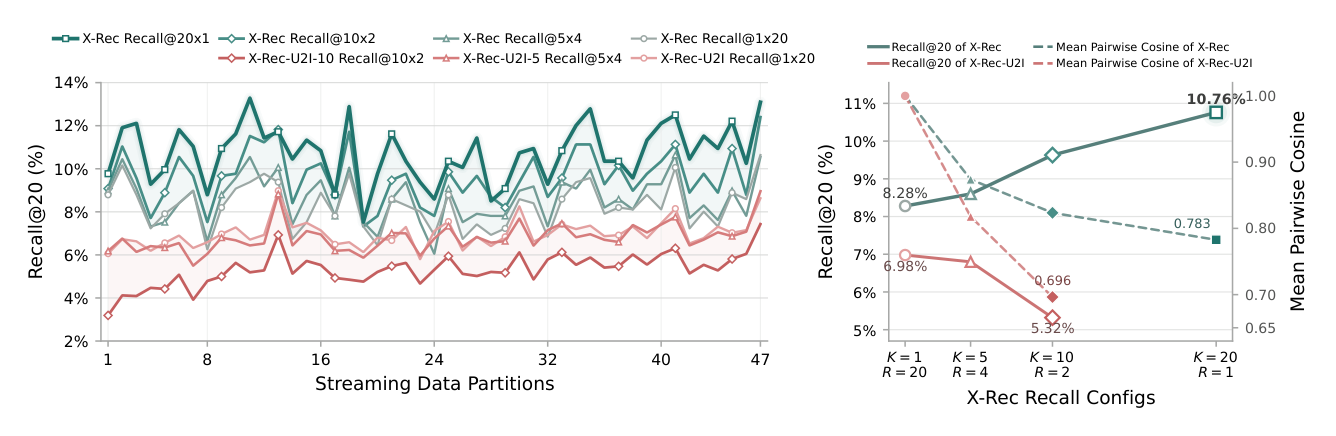
固定 20 个候选的预算,比较 $K\times R$ 四种分配:
| 配置 | X-Rec Recall@20 (%) | X-Rec-U2I-K Recall@20 (%) |
|---|---|---|
| 1×20 | 8.28 | 6.98(X-Rec-U2I) |
| 5×4 | 8.60 | — |
| 10×2 | 9.63 | 5.32 |
| 20×1 | 10.76 | — |
- X-Rec 的召回随 $K$ 单调上升,从 1×20 到 20×1 共 +2.48pp;20×1 在每个分区都优于 1×20,在 45/47 个分区最好或并列最好。触发器平均两两余弦随 $K$ 增大而下降,说明覆盖更广。结论是固定预算下「拓宽兴趣覆盖」比「在少数触发器周围挖深」更有效。
- X-Rec-U2I-K(同骨干 + ComiRec-SA,并且作者改进了训练:每个候选物品都分配给最近的兴趣向量来算对比损失,让所有兴趣向量都拿到梯度,原版只更新获胜向量,训练很不稳定)随 $K$ 增大反而掉点:6.98 → 5.32(10×2)。10×2 下它的触发器两两余弦更低(0.696 vs X-Rec 的 0.823),召回却低得多(5.32 vs 9.63)。作者解释为 U2I-K 的「广度」是表面的:向量分散了,却没有覆盖真实兴趣;每个兴趣向量只在被选中时得到监督,$K$ 越大监督越稀疏。
6.4 用 anchor 温度调节多样性¶
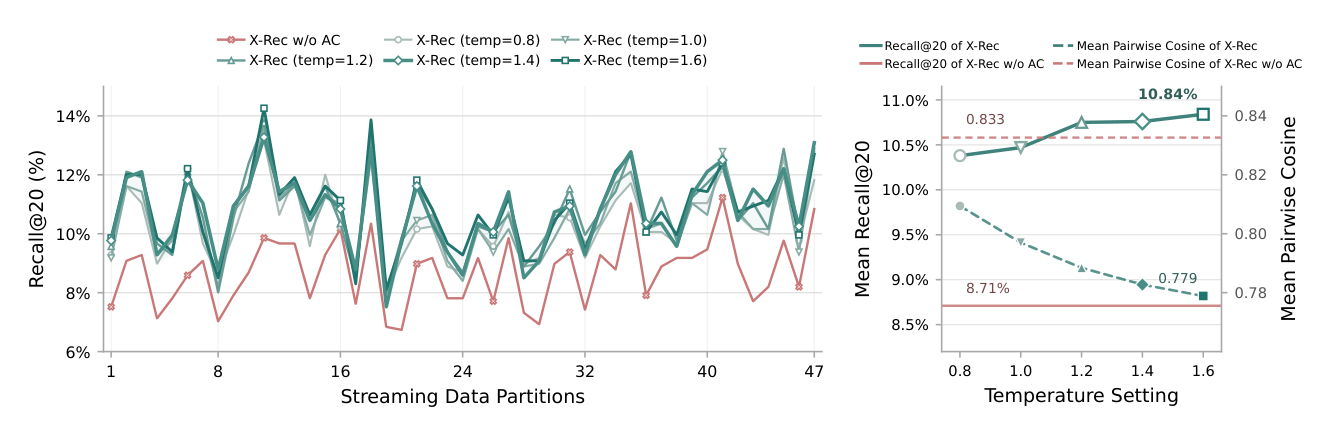
温度趋于 0 时 anchor 分布退化为 delta,所有触发器集中在一个语义区域;温度趋于无穷时趋近均匀,触发器分散到各区域。
| 设置 | 平均 Recall@20 (%) | 平均两两余弦 |
|---|---|---|
| X-Rec w/o AC | 8.71 | 0.833 |
| X-Rec (temp=0.8) | 10.38 | 0.809 |
| X-Rec (temp=1.2) | 10.75 | — |
| X-Rec (temp=1.4,默认) | 10.76 | — |
| X-Rec (temp=1.6) | 10.84 | 0.779 |
即使温度只有 0.8,AC 也同时提升了召回和多样性。温度从 0.8 到 1.6,余弦单调下降、召回单调上升,增益主要在 0.8→1.2,之后趋于饱和,默认 1.4 接近饱和点。anchor 温度是一个显式、可解释的多样性旋钮,工程上很实用,而纯连续 FM 做不到这一点(只能靠 CFG scale 或噪声间接调)。
6.5 用 SID 重建目标暴露表示损失¶
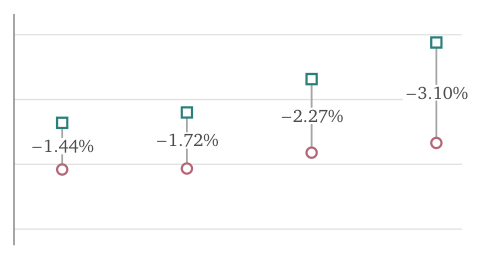
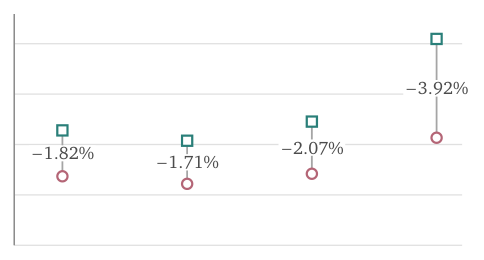
做法:不用原始连续向量监督 X-Rec,而是把每个目标物品先映射成 SID,再经 RQ 码本解码为重建向量,用它作 SFT 目标。
| 配置 | Recall@20 下降 (pp) | 配置 | Recall@50 下降 (pp) |
|---|---|---|---|
| 1×20 | −1.44 | 1×50 | −1.82 |
| 5×4 | −1.72 | 5×10 | −1.71 |
| 10×2 | −2.27 | 10×5 | −2.07 |
| 20×1 | −3.10 | 50×1 | −3.92 |
| 平均 | −2.13 | 平均 | −2.38 |
在 20×1 / 50×1(每个触发器只取最近邻)时下降最大,因为目标表示的微小偏移就会改变最近邻结果。结论:SID 重建扭曲了原始嵌入空间的细粒度邻域,带来不可忽略的信息损失。
这个实验设计得很干净:同一个 X-Rec 模型只换监督目标,直接量化了「量化误差」的代价(约 2pp),是全文对 SID 路线最有力的论据。但它同时说明:X-Rec-AR 在 20×1 口径下天然要承受这约 3pp 的重建损失,在这种情况下 X-Rec 仍然只领先 0.53pp,反过来说明 AR 的分布建模能力其实不弱。
6.6 案例研究¶
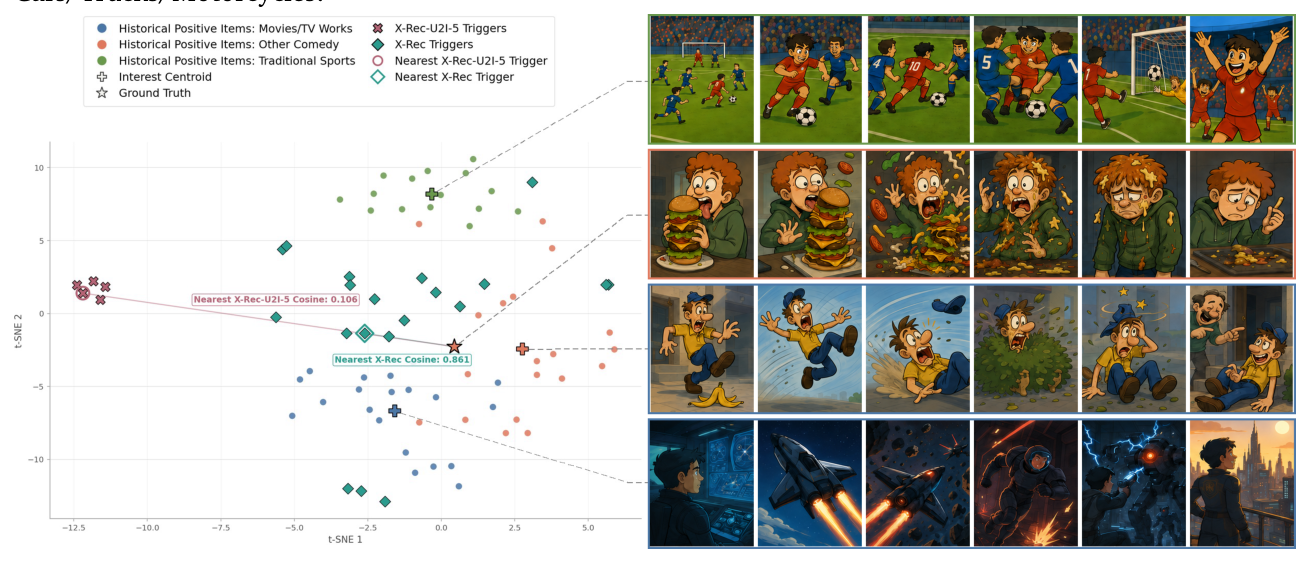
在图 10a 中,用户历史正向物品分成「汽车/卡车/摩托」与「烹饪」两个峰,真实下一物品属于汽车类。X-Rec 的触发器流形与历史正向物品对齐,最近触发器与真实物品的余弦达 0.942;X-Rec-U2I-5 虽有 5 个触发器,却坍缩到两峰之间的「山谷」,最近余弦只有 0.199。附录 A.3 的更多案例(图 11–14)显示把 U2I 触发器数增加到 10 也不改变这种集中模式。可视化有说服力,但属于挑选的案例,t-SNE 距离也不能直接当作余弦距离来解读。
七、核心贡献总结¶
- 把生成式召回的输出空间从离散 SID 换回连续物品向量,用球面上的黎曼 FM 直接建模 $p(x\mid c)$,采样多触发器后接 ANN;给出与 U2I、SID-AR 的统一形式化与复杂度对比。
- 三个工程上可复用的设计:anchor 条件(离散粗定位 + 连续精修,同时是可调多样性的旋钮);RFM(切空间投影 + 指数映射 Euler,把球面几何写进动力学);late-interaction DiT(去噪只过最后一层,复用 prefill KV cache,吞吐 8.28×)。
- 预训练用 prefix mask + target diagonal mask,一次 prefill 并行训练所有位置的 next-item FM 损失;SFT 用同目标多噪声副本对角 mask。这是把扩散目标高效嫁接到序列模型上的训练范式。
- 受控对照设计:同骨干的 X-Rec-AR / X-Rec-U2I / X-Rec-U2I-K 隔离了「范式」这一变量;「SID 重建目标」实验单独量化了量化误差的代价。
- TikTok 垂类真实上线两次,垂类互动累计 +4.15%,大盘 +0.011%。
八、与已归档相关工作的对比¶
MO-DiT+HPPO MO-DiT+HPPO: Generative Retrieval via Diffusion Transformer with Metric-Ordered Sequence Training (2026-06-25)¶
关系:同团队前作,本文未引用(作者高度重叠:Chenghao Liu、Yu Zhang、Zhongtao Jiang、Kun Xu、Zhenwei An、Zhao Wang、Yuxiao Zhang 同时出现在两篇的作者名单里,归档中该篇机构记为 Peking University)· 已加载对方精读
- 共同关注的问题:两者都认为离散 SID 生成式检索有量化与解码串行的问题,都选择在冻结的、$L_2$ 归一化的多模态物品向量空间里直接生成连续 query 向量,再交给 ANN 检索,从而绕开码本设计与标识符解码。
- 相近的技术骨架:几乎是同一套底座。单个 DiT 联合处理条件 token 与加噪目标 token;球面(黎曼)flow matching;timestep 经 AdaLN 注入;CFG 通过条件 dropout 实现,上线 guidance scale 都是 3.0;结构化 mask 同样是「条件因果 + 条件不看目标(可缓存 KV)+ 目标只看前缀 + 目标之间对角可见」。MO-DiT 的 CPT 阶段 dense prefix 监督与 X-Rec 预训练的 prefix mask 并行训练是同一个思路。
- 本文的差异与推进:(1) 任务从「内容审核的模式保持属性检索」换成了用户兴趣召回,条件从种子物品集换成用户行为序列 + 目标属性;(2) 新增 anchor 条件(离散粗定位)和 late interaction(去噪只过最后一层),后者是 X-Rec 能上线的关键效率设计,MO-DiT 是全层联合处理;(3) MO-DiT 有 HPPO 偏好对齐(用在线指标 Joint@K 做 DPO 式后训练),X-Rec 没有后训练,只在 future work 里提到 RL;(4) X-Rec 与 SID-AR 做了同骨干的受控对照,并有 TikTok 线上 A/B。
- 可比的方法 / 实验差异:两者的数据与指标完全不同(Joint@K on 4 个内部审核域 vs Recall@20 on 流式推荐 benchmark),数值不能直接比。值得注意的是,X-Rec 把这套连续生成底座包装成「新范式」,却没有引用同团队已公开的前作。读者应把两篇看作同一技术路线在两个场景的实例化:MO-DiT 证明了底座,X-Rec 补上了推荐场景、效率改造和上线。
FAVE FAVE: Flow-based Average Velocity Establishment for Sequential Recommendation (UESTC, 2026-04-06)¶
关系:独立并发(本文未引用 FAVE)· 已加载对方精读
- 共同关注的问题:都在连续物品向量空间用 flow matching 建模下一物品分布,也都把「从无信息高斯噪声直接生成结构化偏好向量太难 / 太慢」视为核心障碍。
- 相近的技术骨架:两者都引入了一种「锚点」来降低生成难度。FAVE 的「语义锚点先验」是把用户历史中随机一个物品的向量(经 Bernoulli mask 扰动)作为 flow 的起点,替换高斯先验;X-Rec 的 anchor 是先分类出目标所在的簇,作为 AdaLN 条件,起点仍是球面均匀噪声。
- 本文的差异与推进:FAVE 攻「步数」:用平均速度场 + JVP 曲率惩罚做单步生成;X-Rec 攻「每步成本」:步数保持 30,但每步只过一层 Transformer。FAVE 是欧氏线性插值,X-Rec 是球面测地线。FAVE 每次只生成单个向量(更接近 U2I 的单点召回),X-Rec 的重点是多触发器覆盖多峰兴趣,并用 anchor 温度显式控制多样性。
- 可比的方法 / 实验差异:FAVE 在 ML-100k / Beauty / Steam 等小型公开数据集上验证,比较对象是 DreamRec / FMRec 等扩散与 FM 方法;X-Rec 只在工业流式 benchmark 上验证,并有线上部署。两种加速路线正交,理论上可以叠加(把 FAVE 的少步/单步蒸馏用到 X-Rec 的 late-interaction 头上,这也正是 X-Rec future work 第一条提到的方向)。
九、讨论与局限性¶
9.1 值得借鉴的设计¶
- Late-interaction DiT 是这篇最值得工程借鉴的点:把扩散头限制在最后一层并复用 prefill KV cache,使扩散式生成的边际成本从「$T$ 次全模型」降到「$T$ 次单层」。任何「序列编码 + 迭代生成头」的推荐模型都能用这个思路,包括连续 token 版的 SID 生成。
- anchor 温度作为多样性旋钮,在工业召回里非常实用,而且可解释。
- SID 重建目标实验是一个干净的「量化误差定价」方法,可以直接复用来评估任何 tokenizer。
- 一次 prefill 并行训练所有位置的扩散目标的 mask 设计,是把扩散损失嫁接到自回归序列预训练上的通用做法。
9.2 局限与争议¶
- 「无量化」叙事被 anchor 部分抵消:贡献最大的结构组件 AC(−2.05pp)本质是单层离散码分类;没有 AC 或没有 RFM,X-Rec 都会跌到 X-Rec-AR 之下。所以真正追平 SID-AR 的是「离散粗分类 + 连续精修」的混合体。这和 SID 路线用残差码逐层细化其实相互靠拢,不能简单说「连续胜过离散」。
- Recall@50 上反输 SID-AR(12.70 vs 13.29,只赢 14/47 个分区),论文没有提。独立采样的多触发器在触发器变多时冗余上升,这正是 beam search 的强项。这对「多峰覆盖」这一核心卖点构成反例,需要去重或多样性采样策略来补足。
- 3.46× 是离线的触发器生成 QPS,不含 ANN;X-Rec 每请求要做 20 次 ANN,而 SID-AR 可以查表,端到端差距会被压缩。AR 基线的解码优化配置没有披露。
- ANN 索引被重新引入:X-Rec 的「生成」产物是 query 向量,最终仍靠 ANN 取物品,本质上是「生成式触发器 + 传统向量召回」。它继承了 ANN 的近似误差和索引维护成本,论文完全没有核算这部分,而这恰恰是 SID 生成式召回想摆脱的东西。不过训练和推理是一致的(训练生成向量,推理生成向量再检索),没有「训练侧亮点在推理侧退回」的问题。
- 在线对照是没有这路召回的旧系统(新增召回源),没有与 SID 生成式召回在线对比;大盘收益只有 +0.011%;作用于单一垂类;没有披露延迟与算力成本。工业证据是真实的,但证明的是「多一路好召回有用」,而不是「FM 优于 SID-AR」。
- 评估口径:召回池只由各分区的测试目标构成(远小于全库),SID 基线被强制走「重建向量 + ANN」而非原生 SID 查表(20×1 下约有 3pp 重建损失,见 §6.5);外部 baseline 在工业数据上明显欠调(SASRec 1.03%);没有公开数据集,无法复现。
- 文本数值不一致:X-Rec 均值正文写 10.65、图表为 10.76;14 层与 1 层的差距写成 1.05pp(实为 1.18pp);Table 1 中 X-Rec 复杂度写 $O(N(N+M))$,与式 (12) 不符。
- 未引用同团队前作 MO-DiT+HPPO,后者已经公开了几乎相同的球面 FM + DiT + mask + CFG 底座,削弱了 X-Rec「新范式」的首创性。
- 可扩展性:late interaction 的速度场只有一层深,论文自己也承认它的 scaling 有待验证(14 层最好、28 层反降,说明深度与步数的配比还没摸清);物品向量是冻结的外部多模态向量,表征能力无法随召回模型一起 scaling(这是「先表征、再建模」的两阶段解耦)。
9.3 工业落地价值¶
对已有 ANN 基础设施、又想引入生成式召回的团队,X-Rec 提供了一条不必重建 SID 体系、复用现有向量索引的低成本路径:换掉 U2I 的用户塔,换成「预训练序列模型 + 单层扩散头」,就能得到多峰触发器。上线路径(先上 RFM + late interaction,再加 anchor)和两次 A/B 的增量结构也可以参考。主要风险在于 GPU 生成成本(30 步 + CFG)与 20 路 ANN 的额外开销,论文没有给出数字。
9.4 与已有工作的差异¶
- 相对 DreamRec / FAVE 等学术 FM/扩散序列推荐:X-Rec 是第一批把连续 FM 召回做成多触发器、球面几何、工业规模并上线的工作;
- 相对 TIGER / OneRec / LATTE 等 SID 生成:保留了生成式的多峰表达,放弃码本,但又通过 anchor 部分引回了离散结构;
- 相对 ComiRec / SetMIR 等多兴趣 U2I:触发器数量和位置来自采样,而不是固定查询槽,实验上的「广度 vs 召回」反差(U2I-K 的余弦更低、召回却更差)是一个有说服力的对照。