Generative Retrieval via Diffusion Transformer with Metric-Ordered Sequence Training and Hybrid-Policy Preference Optimization(MO-DiT+HPPO)¶
Peking University · arXiv 2606.26899(2026-06-25) 作者:Chenghao Liu*, Yu Zhang*, Zhongtao Jiang, Kun Xu, Zhenwei An, Renzhi Wang, Zhao Wang, Jiachen Zhang, Yuxiao Zhang, Kun Xu†, Songfang Huang†(* 共同一作,† 通讯)
一、研究动机与背景¶
1.1 一个被两个标准工具夹在中间的检索任务¶
基于 embedding 的检索(embedding-based retrieval)按 query 与 item 在共享向量空间中的相似度排序,通常返回相似度最高的 top-K item。但在很多生产场景中,"分数最高"并不是真正想要的结果。论文给出的典型操作场景是内容审核 / 内容发现:审核员发现了一小批属于某个新出现的违规变体(一种特定的格式、模板或手法)的 item,现在需要把"属于完全同一变体"的更多 item 捞出来,用于度量与处置。
这里有两个互相牵扯的目标:
- 属性正确(attribute-positive):item 要满足某个目标属性 —— 质量、安全、合规、原创性或完整性标准。这一信号由一个生产级的 属性打分器(attribute scorer) $a_y(i)\in\{0,1\}$ 给出。
- 模式保持(pattern-preserving):item 不仅要属性为正,还要落在与种子集相同的细粒度模式(fine-grained pattern)里 —— 同一种主题、视觉风格、失败模式或检索意图。
这两个目标天然对抗。论文把它形式化为 pattern-preserving attribute retrieval(模式保持的属性检索),并指出两种标准工具各自的失败模式:
- 对种子求平均(average pooling):把种子 embedding 取均值作为 query。它能很好地保持模式(停留在种子模式内部),但平均向量落在低属性密度区域,召回的多是该模式里最普通、属性命中率低的 item。
- 只优化属性(attribute-only retrieval):朝目标属性方向走。全局属性分类器会返回每一种变体的正样本,把审核队列淹没在大量"属性对但模式不对"的无关 item 里。
理想的 query 应当从种子模式出发,朝着同一模式内部一个邻近的高密度区域移动 —— 既提高属性密度,又守住种子模式(图 1)。
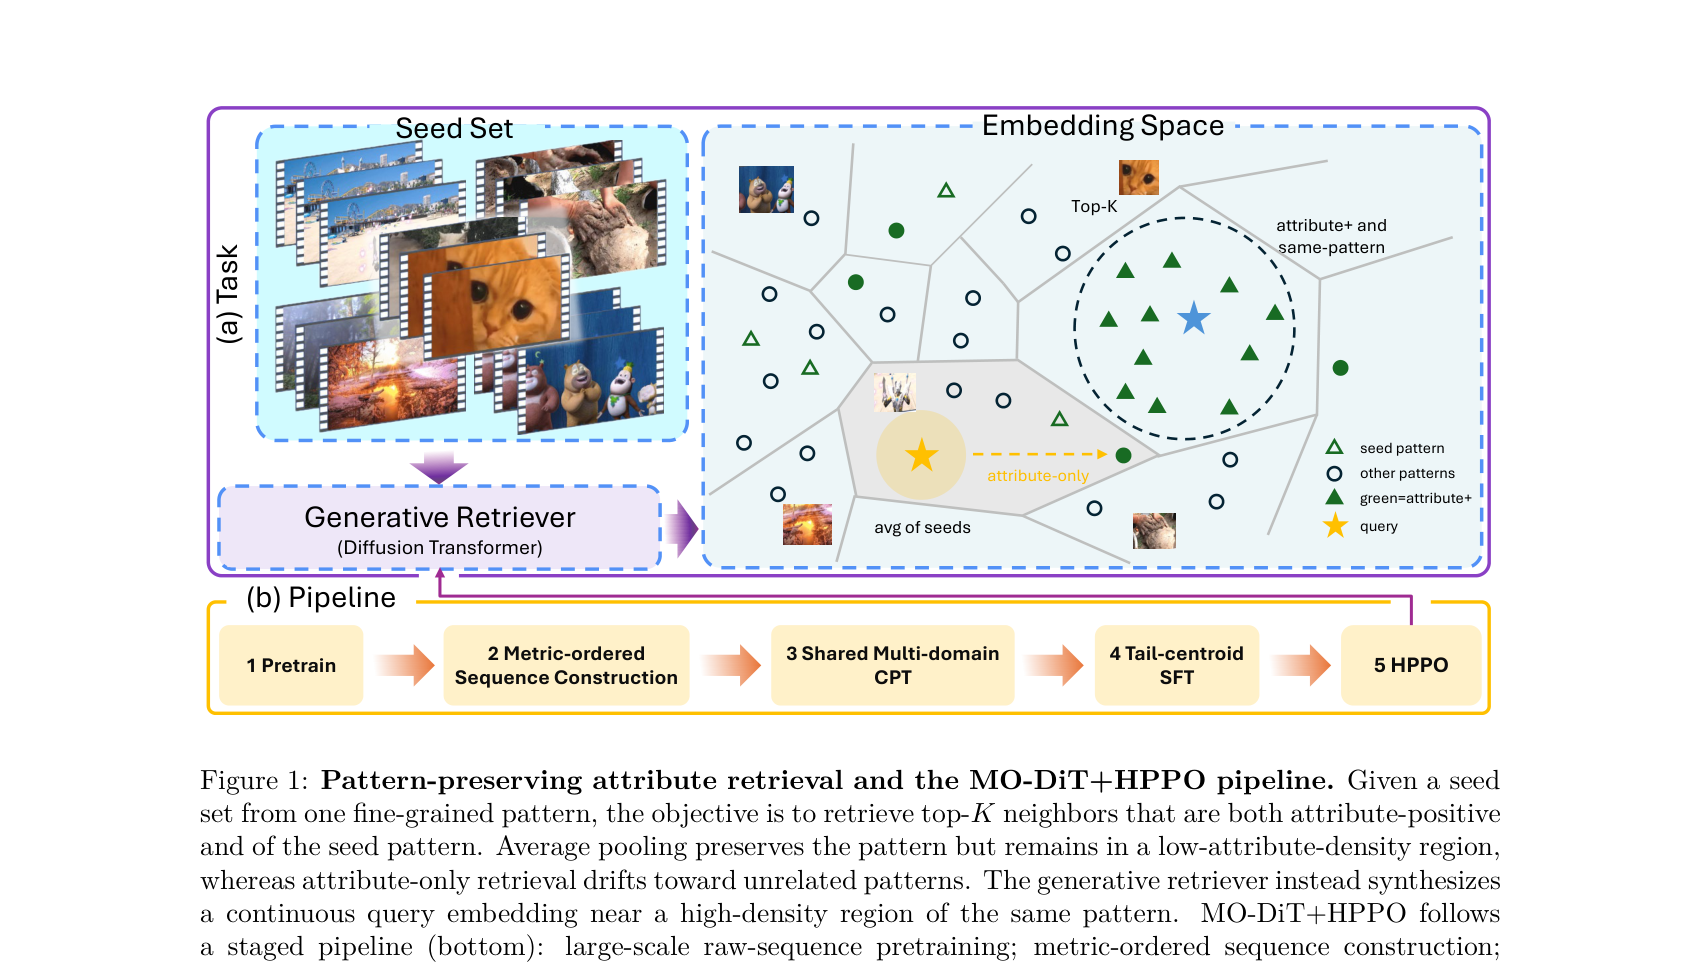
1.2 为什么用"连续生成式检索"¶
论文在连续生成式检索(continuous generative retrieval)框架下研究这个问题。每个 item 有一个冻结的多模态 embedding,一个生成式检索器读入一段 item embedding 序列,生成一个或多个 query embedding,再用该 query 做近似最近邻(ANN)检索。
连续生成的吸引力在于:输出 query 不被限制为某个已有 item,也不是输入的固定平均 —— 它可以合成一个"落在被观测 item 之间"的新向量。但这也带来一个核心的监督难题:
用什么样的目标,能教会模型在保持模式的同时朝更高密度的样本移动?
这正是本文要回答的问题。论文与两类相关工作明确划清界限:
- 离散生成式检索(discrete generative retrieval):TIGER、DSI、autoregressive entity retrieval 等把检索重构为"解码离散标识符(semantic ID / docid)"。它们本质串行,且可能幻觉出不对应任何真实 item 的非法 code 序列。本文生成的是连续 query embedding,由下游最近邻检索消费,绕开离散解码与码本设计。
- 多步扩散推荐:DiffuRec / DreamRec / Diffusion Recommender Model(Wang et al. 2023)等用多步去噪从噪声还原偏好向量。本文用单条 ODE 积分(少数 Euler 步)直接生成 query。
1.3 核心贡献¶
- 形式化 pattern-preserving attribute retrieval,并定义一个同时惩罚"属性失败"与"模式漂移"的交集指标 $\texttt{Joint@K}$。
- Metric-ordered sequence construction(度量有序序列构造):把稀疏的在线检索标签变成大规模的"同模式内、从低到高属性密度"训练轨迹。
- 证明共享多域 metric-ordered 续训(CPT)+ 域内 tail-centroid 监督微调(SFT)能在四个大规模域上提升同模式属性检索。
- 提出 HPPO(Hybrid-Policy Preference Optimization):把参考锚定的成对偏好优化适配到连续扩散检索器 —— 用 flow-matching loss 作隐式打分,不需要任何 token/轨迹的对数概率;候选由静态高度量构造 + 策略 guidance-scale 扇形采样组成的混合候选池给出,并用真实在线交集指标 Joint@K 打标。
- 提出 tradeoff-aware Pareto pair filter:只保留"纯度不下降"的 winner-loser 对,让偏好优化把属性-模式前沿向外推,而不是沿前沿滑动。
- 提供一套实用评估协议:严格的 item-/pattern-holdout 划分、配对自助显著性,以及完整消融套件。
二、任务形式化与评估指标¶
2.1 Item、embedding 与生成式检索器¶
每个 item 是一段多模态内容(视频、图像、文本、视频-文本、图像-文本)。一个冻结的多模态 embedding 模型把 item $i$ 映射到 $e_i\in\mathbb{R}^d$,这些 embedding 在全程冻结并定义检索空间。生成式检索器读入一段 item embedding 序列产生 query:
$$q = f_\theta(e_{i_1},\dots,e_{i_m}),\qquad q\in\mathbb{R}^d \tag{1}$$
query 在与 item embedding 相同的向量索引中检索。
2.2 属性与模式¶
每个域 $y$ 暴露两类信号:
- 属性(attribute):生产打分器给出二值标签 $a_y(i)\in\{0,1\}$。它在自己的粒度上可靠但粗 —— 不区分同一属性下的众多细分子类型。
- 模式(pattern):为了恢复更细的结构,论文在 embedding 空间对属性正样本做聚类,用簇索引 $c_y(i)\in\{1,\dots,C\}$ 作为模式代理(pattern proxy) —— 属性内部的细粒度子类型。细粒度模式没有封闭词表、数量极大,逐 item 人工标注代价过高;embedding 聚类是一个可扩展、无标签的近似(论文在抽样集上与人工模式判断比对,确认一致)。
关键:属性与模式两个信号只用于定义评估指标和训练 reward;推理时生成式检索器既不调用属性打分器也不调用聚类。
2.3 任务¶
种子序列 $X=(e_{i_1},\dots,e_{i_m})$ 抽自单一模式 $c$,所有种子共享该模式。目标是生成一个 query,使其 top-K 邻居密集地落在既属性为正、又属于种子模式的 item 上。
2.4 评估指标(都是 top-K 检索集 $\mathcal{R}_K(q)$ 上的密度)¶
原始属性密度(报告为 Attr@K):
$$D_y(q) = \frac{1}{K}\sum_{j\in\mathcal{R}_K(q)} a_y(j) \tag{2}$$
它单独不够 —— 即使 query 漂移到别的模式,只要属性命中也会被奖励。
交集密度(主指标,报告为 Joint@K):
$$J_y(q,c) = \frac{1}{K}\sum_{j\in\mathcal{R}_K(q)} a_y(j)\,\mathbb{I}[c_y(j)=c] \tag{3}$$
它要求属性正确 AND 模式保持同时满足。
属性正样本里的同模式纯度(报告为 Cond@K):
$$P_y(q,c) = \frac{\sum_{j\in\mathcal{R}_K(q)} a_y(j)\,\mathbb{I}[c_y(j)=c]}{\max\big(\sum_{j\in\mathcal{R}_K(q)} a_y(j),\,1\big)} \tag{4}$$
同模式占比(报告为 Same@K):
$$S_y(q,c) = \frac{1}{K}\sum_{j\in\mathcal{R}_K(q)} \mathbb{I}[c_y(j)=c] \tag{5}$$
即不管属性、落在种子模式里的 item 比例。这四个指标里 $\texttt{Joint@K}$ 是优化目标,$\texttt{Same@K}$ 是"模式纯度"的护栏,$\texttt{Attr@K}$ 是"属性贪婪"的度量。此外还报告一个 AUC 列:衡量生成 query 在模式内沿"度量方向"的判别力(正样本为留出的高度量尾部 item,负样本为同簇的输入 item);停在输入质心(如平均池化)的 query AUC ≈ 0.5。
三、核心方法:MO-DiT+HPPO 总览¶
MO-DiT+HPPO 是一个分阶段框架,四个阶段复用同一个 diffusion-transformer 骨干和同一个 flow-matching 目标,只在训练数据与监督目标上不同:
- 大规模原始序列预训练:在自然有序的 item 序列(会话序列、用户行为序列、时间有序 item 流)上做 raw-sequence 预训练,给扩散 transformer 一个通用的连续检索先验。非 metric-ordered。
- 共享多域 metric-ordered 续训(CPT):在构造的"低→高度量"有序序列上做 dense prefix 监督,把"度量改进方向"内化为一种跨域的通用能力。四个域的有序序列混进一个池子,单一共享模型训练。
- 域内 tail-centroid 监督微调(SFT):把有序序列的输入前缀映射到其高度量尾部的质心,得到一个稳定的、保持模式的生成器。
- HPPO(Hybrid-Policy Preference Optimization):用最终在线交集指标 $\texttt{Joint@K}$ 给候选 query 打标,做迭代的、参考锚定的偏好优化,并用 Pareto pair filter 防止"用模式漂移换属性增益"。
这与"后训练对齐"的角色一一对应:CPT 与 SFT 提供一个稳定、保持模式的生成器,HPPO 把最终 query 分布与真实在线目标对齐。
四、连续生成式检索器架构(§4.1)¶
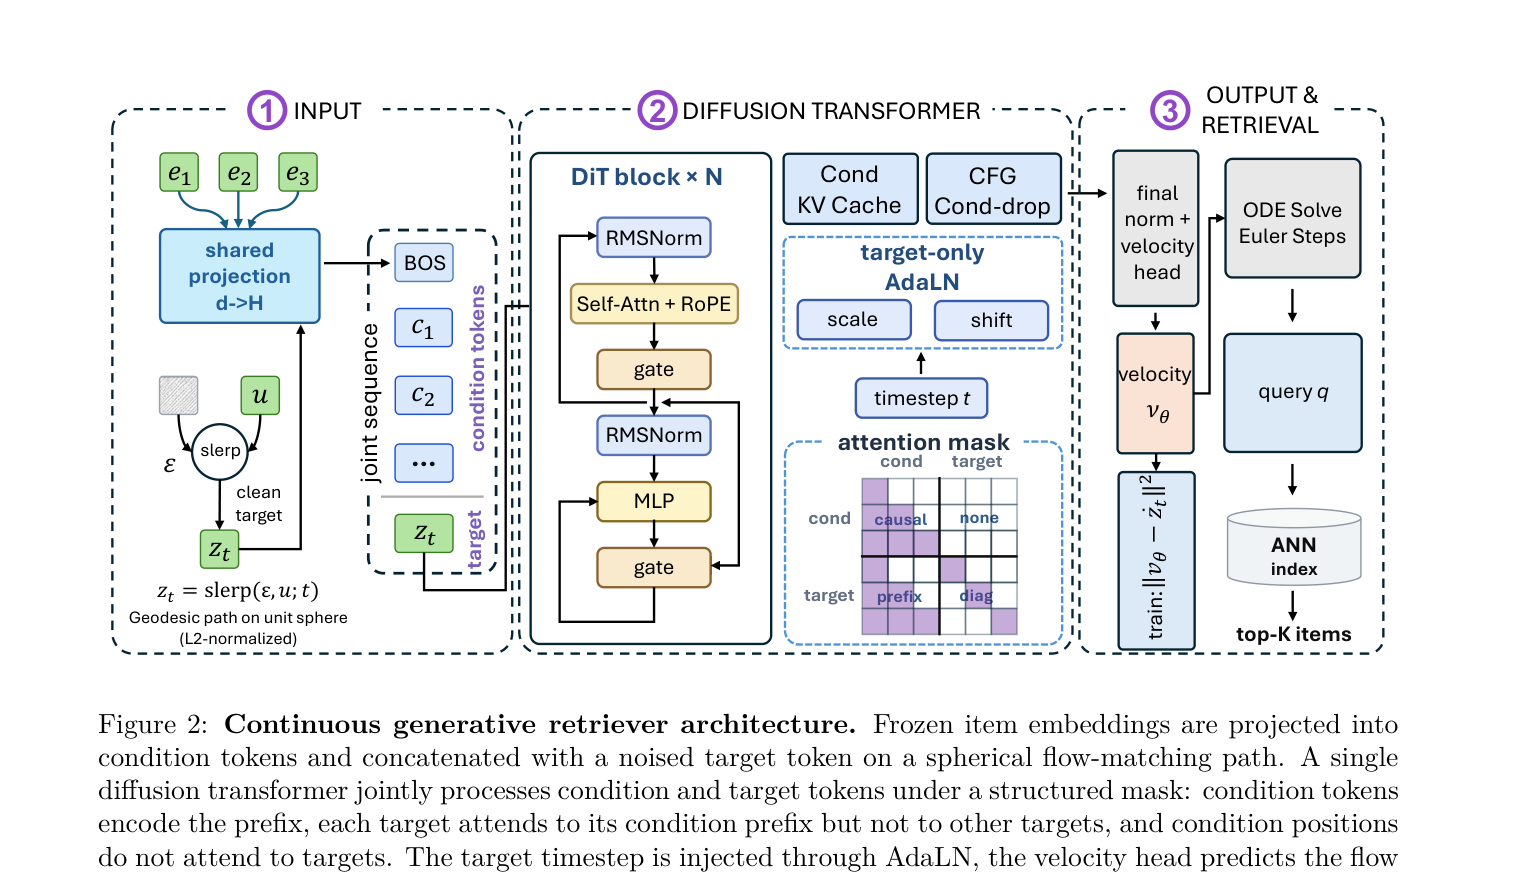
4.1 骨干与联合序列¶
模型是单个扩散 transformer 骨干(Vaswani et al. 2017;Peebles & Xie 2023),用 flow-matching 目标训练。它联合处理 condition token 与加噪的 target token,而不是把 condition 压成一个向量喂给单独的生成头。每个 condition 位置把 item embedding 投到 transformer 宽度,加位置编码和一个区分 condition/target 的角色标记;一个二值 condition mask 标记有效位置(便于批内不同有效 prompt 长度)。
每个 target 位置持有一个加噪的 target token —— 高斯噪声与干净 target 之间 flow-matching 路径上、采样时刻 $t$ 的一个点。condition token 与加噪 target token 拼成一个序列,在结构化注意力 mask 下通过 transformer。
4.2 结构化注意力 mask(四块,附录 A)¶
- condition–condition:因果(下三角),condition 前缀自回归。
- condition–target:空 —— condition 永不注意 target,故 condition 可以编码一次并缓存(KV cache)。
- target–condition:前缀可见 —— 每个 target 注意到它自己位置为止的 condition 前缀。
- target–target:对角 —— 每个 target 只注意自己,于是多个 target 可在一次前向里独立去噪/生成(CPT 的 dense 目标用到;SFT 只用单个 target)。
因为每个 target 注意完整 condition 序列而非一个池化摘要,模型保留了种子 item 的细粒度信息 —— 这是与"轻量单向量条件生成头"的关键区别。
4.3 球面 flow matching、归一化与引导¶
因为检索 embedding 是 $L_2$ 归一化的、落在单位超球面上,论文用球面(Riemannian)flow matching 实例化(Chen & Lipman 2024),用测地线路径而非直线 rectified flow,并在 velocity loss 上加一个 Jacobian 曲率加权。扩散时间步通过 AdaLN(adaptive layer normalization)在 target 位置注入。Classifier-free guidance(CFG)通过训练时的 condition dropout 实现;上线 guidance scale 为 3.0(附录 D 验证近最优)。推理时做球面 ODE 积分 + condition 前缀的 KV 缓存,再做 ANN 检索,无量化、无标识符解码。
五、从稀疏度量标签到有序序列(§4.2)¶
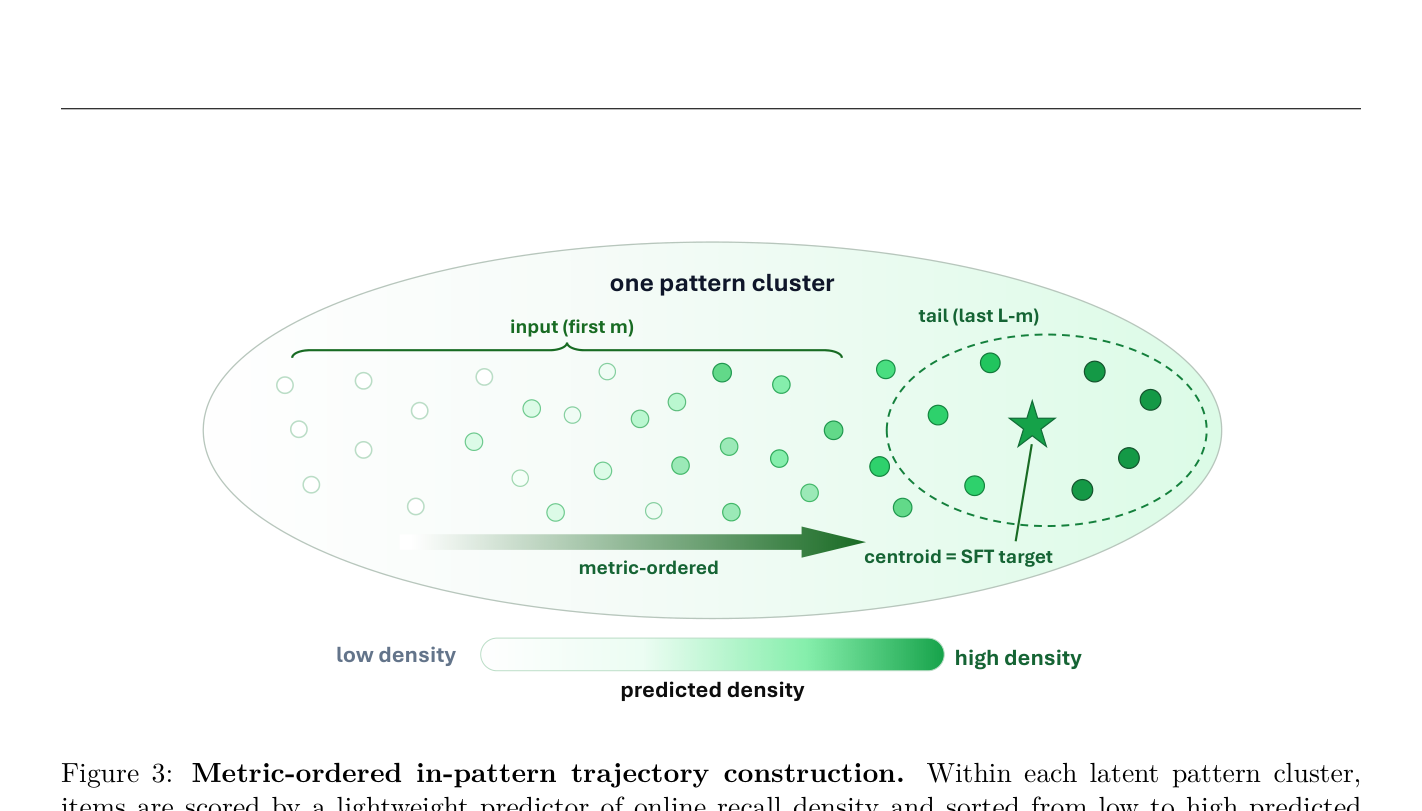
训练的核心难点是拿到能把 query 推向正确方向的训练目标。流程:
- 对每个域 $y$,先收集域打分器下的属性正样本,把它们的冻结 embedding 用 k-means 聚成 $C$ 个簇。这些簇不假设是人类语义类,只是可扩展的 latent 模式代理。
- 估计高密度区域在每个模式内部的位置:对一个抽样的 anchor embedding 集合,用 anchor 做 query 在生产级向量索引里检索 top-K,再对召回的 item 跑属性打分器,得到"在线召回密度"。这是真正"用这个 anchor 当 query 的检索后果"。
- 在线密度标注昂贵(需要检索、item 查找、打分器访问),所以只在线标注一个子集。
- 用一个轻量密度预测器 $\hat{D}_y(e)$(ridge 回归,从冻结 embedding 到在线召回密度)把稀疏标签扩展到全 item 池。该预测值只用于排序,绝不作为检索结果上报,最终指标都在真实 top-K 检索后计算。
Algorithm 1(MO-DiT Sequence Construction):
输入:正样本池 P_y,可选普通样本池 N,簇 c_y,预测器 D̂_y
for 每个簇 c:
    收集簇内正样本 P_{y,c} = {i ∈ P_y : c_y(i)=c}
    从 P_{y,c} 和聚合普通池采样候选组
    用 D̂_y(e_i) 给每个 item 打分
    按预测密度从低到高排序
    发射长度 L 的序列
输出:长度 L 的 metric-ordered 训练序列
每条序列定长 $L$。普通(非属性正)item 可以按固定比例混进训练池,但不强制每条序列都含。关键设计:每条序列里,靠前位置是同模式的低密度样本,靠后位置是高密度样本 —— 序列顺序就编码了"度量改进方向"。论文在 item-hash / pattern-out / super-pattern-out 三种划分下验证了预测器(附录 E,见后文表 16),pattern-out / super-pattern-out 测试 embedding 几何本身能否在未见模式上预测密度,而非只记住已见簇的均值。
六、度量有序训练目标(§4.3)¶
6.1 Flow-matching 损失¶
因为 retrieval embedding $L_2$ 归一化、落在单位超球面,用球面 flow matching:对条件序列 $X$ 和 target embedding $u$,采样高斯噪声 $\epsilon\sim\mathcal{N}(0,I)$ 投影到球面,从 logit-normal schedule(Esser et al. 2024,$t=\sigma(\xi),\ \xi\sim\mathcal{N}(0,1)$,$\sigma$ 为 logistic 函数)采样时刻 $t$,构造从 $\epsilon$ 到 $u$ 的测地线路径 $z_t$,把网络速度回归到路径速度 $\dot z_t$:
$$\mathcal{L}_{\mathrm{FM}}(X,u) = \mathbb{E}_{t,\epsilon}\Big[\big\|v_\theta(z_t,t,X) - \dot z_t\big\|_2^2\Big] \tag{6}$$
其中 $v_\theta$ 是 transformer 速度场。推理时从 $z_0=\epsilon$ 积分 $\dot z = v_\theta$ 得到 query。这个 per-target 生成损失在每个阶段都被复用。
6.2 续训(CPT):稠密 prefix 监督¶
给一条 metric-ordered 序列 $S=(i_1,\dots,i_L)$,每个 target 位置从它前面的前缀预测自己的 item embedding,沿低→高度量轨迹做稠密 prefix 监督:
$$\mathcal{L}_{\mathrm{CPT}} = \sum_{r\in\mathcal{I}} \mathcal{L}_{\mathrm{FM}}\big((e_{i_1},\dots,e_{i_{r-1}}),\, e_{i_r}\big) \tag{7}$$
其中 $\mathcal{I}$ 是被监督的 target 位置集合(稠密监督覆盖每个有前缀的位置);对角的 target-target mask 让所有位置在一次前向里同时被监督。CPT 让模型在最终任务前就学到"度量改进的几何"。多域的有序序列混进一个 shuffle 池,带 per-domain 重复权重(小域不被淹没),单一共享模型在池上训练,后续 SFT 与偏好阶段都从这个共享 checkpoint 域内特化。
6.3 监督微调(SFT):tail-centroid 目标¶
第二个 metric-ordered 阶段把每条有序序列转成一个输入-目标对。输入是前 $m$ 个 embedding:
$$X = (e_{i_1},\dots,e_{i_m}) \tag{8}$$
目标是末 $L-m$ 个 embedding 的质心:
$$t_{\mathrm{tail}} = \frac{1}{L-m}\sum_{r=m+1}^{L} e_{i_r} \tag{9}$$
SFT 损失:
$$\mathcal{L}_{\mathrm{SFT}} = \mathcal{L}_{\mathrm{FM}}\big((e_{i_1},\dots,e_{i_m}),\, t_{\mathrm{tail}}\big) \tag{10}$$
为什么用质心而不是最高度量的单个 item:质心是多个高度量同模式样本的稳定汇总 —— 比单个 top item 噪声小、比小 top-k 目标更宽。一个 top item 可能是离群点,而 tail 质心代表一个局部高度量区域。
三个阶段各只换一个组件:预训练用 per-position $\mathcal{L}_{\mathrm{FM}}$ 在 raw 非有序序列上;CPT 保留该目标但换成 metric-ordered 数据;SFT 保留有序数据但把监督换成单个质心目标 $t_{\mathrm{tail}}$。随后的偏好阶段则换的是学习信号本身(换成真实在线指标)。
七、混合策略偏好优化 HPPO(§4.4)¶
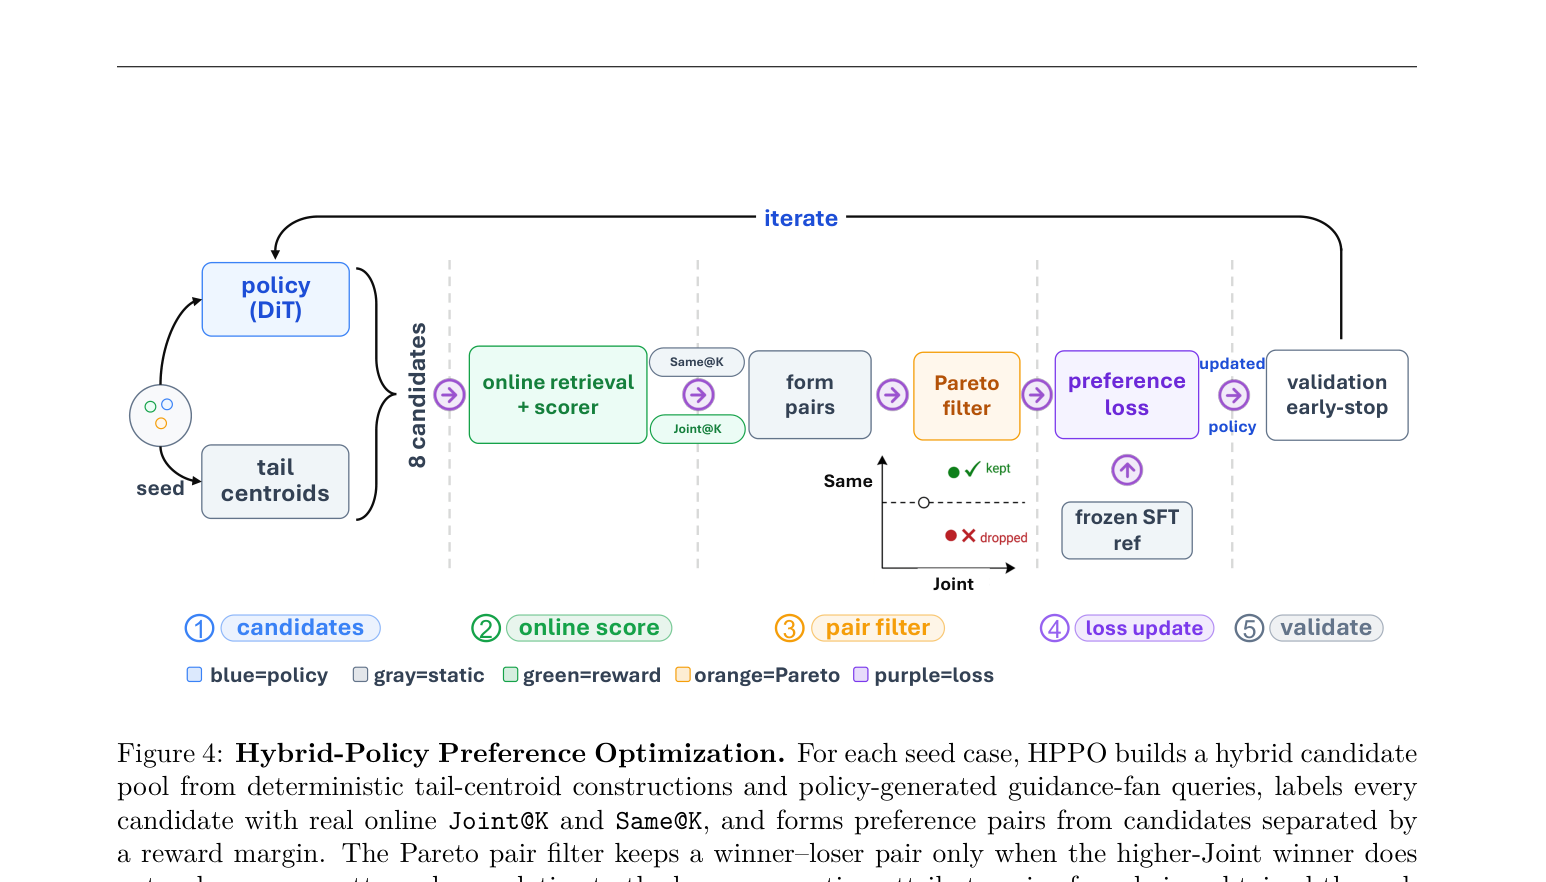
CPT 与 SFT 用的是按代理指标排序的构造目标,而非最终在线交集指标本身。HPPO 直接优化在线 $\texttt{Joint@K}$ 来弥合这道缝。
7.1 混合候选池¶
对每个训练 case,HPPO 从一个混合策略取 query embedding 候选:
- 确定性、基于度量的部分:有序序列的 tail top-k 质心(对一个小集合 $\mathcal{K}$ 里每个深度 $k$ 取 top-k item 平均),是强的保持模式构造。
- 策略生成部分:从当前生成式检索器采样的 query。但因为 point-target tail-centroid SFT 让条件生成器近乎确定性,独立采样的策略 query 会塌缩到几乎同一个 embedding;所以论文用 guidance-scale fan:在若干 CFG 引导尺度 $\mathcal{S}$ 上生成策略候选。低尺度更贴种子模式,高尺度更朝属性方向推,扇形跨出"模式 vs 属性"权衡的一小段谱。
每个候选都在真实向量索引里检索,并用主指标 $J_y(q,c)$ 打标 —— 偏好信号是真实在线目标而非代理 reward。
7.2 偏好损失(DPO 式,flow-matching loss 作隐式分数)¶
给两个候选 $q^+,q^-$,其在线 reward 至少差 margin $\delta$,用候选的负 flow-matching 损失 $s_\theta(X,q)=-\mathcal{L}_{\mathrm{FM}}(X,q)$ 作为策略对数似然的可处理替身(Diffusion-DPO 精神,Wallace et al. 2024),并用冻结的 SFT reference 模型避免无约束漂移:
$$\mathcal{L}_{\mathrm{pref}} = -\log\sigma\Big(\beta\big[s_\theta(X,q^+) - s_\theta(X,q^-) - s_{\mathrm{ref}}(X,q^+) + s_{\mathrm{ref}}(X,q^-)\big]\Big) \tag{11}$$
$\beta$ 是偏好温度。直觉上 $-\mathcal{L}_{\mathrm{FM}}(X,q)$ 衡量当前流模型从种子 $X$ 重构 $q$ 的容易程度 —— 当生成器在 $q$ 附近良好校准时是策略似然的可处理替身,但不是精确对数似然,对分布外候选可能不可靠(reward margin 与冻结 reference 共同把更新锚到在线指标而非这个替身本身)。
7.3 Tradeoff-aware Pareto pair filter(核心配料)¶
天真地优化交集指标仍存在一个退化捷径:一个 winner 可以通过漂移到别的模式、召回更多属性正样本来抬高 $J_y$,只要原始属性增益盖过纯度损失 —— 这恰好是任务要避免的失败模式。论文给 pair 构造加一个 Pareto 支配约束:在满足 margin 的对里,只有当
$$S_y(q^+,c) \ge S_y(q^-,c) - \varepsilon \tag{12}$$
(即高 reward 的 winner 相对 loser 不损失 same-pattern share,容差 $\varepsilon$,$\varepsilon=0$ 为严格设定)时才保留该对进偏好损失。这个 filter 是免费的:$S_y$ 在在线打标时已算好,无需额外检索。它把"牺牲纯度"的对从梯度里剔掉,只留下"高 reward 来自 Pareto 改进"的对,于是 HPPO 被引导去把属性-模式前沿向外推,而不是沿前沿滑动。
7.4 完整目标与迭代过程¶
一个小 anchor loss 把偏好更新拉近保持模式的 SFT 解,复用其 tail-centroid 目标 $t_{\mathrm{tail}}$:
$$\mathcal{L}_{\mathrm{anchor}} = \mathcal{L}_{\mathrm{FM}}(X, t_{\mathrm{tail}}) \tag{13}$$
完整 HPPO 目标在保留对上平均偏好损失并加 anchor:
$$\mathcal{L} = \frac{1}{|\mathcal{P}|}\sum_{(q^+,q^-)\in\mathcal{P}} \mathcal{L}_{\mathrm{pref}}(q^+,q^-) + \lambda\,\mathcal{L}_{\mathrm{anchor}} \tag{14}$$
$\mathcal{P}$ 是同时通过 reward margin $\delta$ 与 Pareto filter 的 (winner, loser) 对集,$\lambda$ 是 anchor 权重。
Algorithm 2(Iterated Pareto-Filtered HPPO)要点:从 SFT 策略 $\theta_0$ 起,冻结 reference $\theta_{\mathrm{ref}}=\theta_0$;先一次性给静态候选(top-k 质心)在线打标。每轮 $r$:从当前 $\theta$ 在各 guidance scale 生成策略候选并在线打标;当 case 的 top1/top2 reward 差 $\ge\delta$ 时取 $q^+=\arg\max J_y$,对每个 $J_y(q^+)-J_y(q^-)\ge\delta$ 的 $q^-$,若通过 Pareto filter $(S_y(q^+)\ge S_y(q^-)-\varepsilon)$ 则加入 $\mathcal{P}$;在 $\mathcal{P}$ 上训练约一个 epoch(偏好损失 + $\lambda$ anchor,对参考 $\theta_{\mathrm{ref}}$);在留出验证片 $\mathcal{V}$ 上用真实在线 $\texttt{Joint@K}$(在上线 guidance scale)评估,验证不再改进就早停。
论文区分两个 regime:off-policy(候选一次性从冻结 SFT 策略 + 静态构造采集)与 on-policy / hybrid(迭代)(每轮从当前策略重新生成 guidance-fan 候选并重新在线打标,静态候选与冻结 SFT reference 不变)。两个 hybrid 变体:adaptive(迭代 on-policy,无 pair filter)与 Pareto(迭代 on-policy + tradeoff-aware filter)。验证选择比测试选择更严,所以报告的 Pareto-over-off-policy 增益是保守的。
计算开销很轻:一个域约 50,000 case × 8 候选 = 400,000 候选 query,单机真实检索打标 < 1 小时(约 127 query/s,瓶颈是向量召回)。margin filter 留下约 12% 的 case,一轮偏好训练在 8 卡上几分钟。昂贵的是离线预训练阶段,在线对齐很便宜 —— 使逐域刷新实际可行。
7.5 推理(§4.5)¶
推理时模型条件于一组同模式 item embedding,生成一个 query embedding:从投到单位球的高斯噪声出发,用少数 Euler 步积分学到的速度场(每步后重新归一化到球面,是训练时流的球面对应),施加上线 guidance scale。因为 condition 前缀不注意 target,它预填一次并跨所有积分步复用 KV cache,只有 target token 迭代;上线开销 ≈ 一次短 ODE 积分 + 一次 ANN 检索。上线用单个生成 query;抽多个噪声样本则得到多 query(HPPO 用、也可做推理时 rerank)。
八、实验设置(§5.1)¶
8.1 四个域与数据规模¶
在四个匿名的属性域 D1–D4(来自内部数据)上评估,每个域有不同的属性定义(内容质量、政策合规、原创性、行为完整性等)与不同数据规模;标签到标准的映射保密。D1 是验证 metric-ordered 训练的第一个域;D2/D3 是更大的跟进域;D4 是较小、有严格 held-out-cluster 协议的域。
默认常量:检索深度 $K=100$,embedding 维 $d=1536$,metric-ordered 序列长 $L=200$,输入前缀 $m=150$(高度量尾部 $L-m=50$ 个 item)。
表 1:严格划分的数据规模(序列行数,非 distinct item 数)
| Domain | Train | Eval-I | Eval-P | Normal | Clusters |
|---|---|---|---|---|---|
| D1 | 1.54M | 156K | 7.8K | 10% | 50/1000 |
| D2 | 5.95M | 163K | 32.8K | 20% | 50/1000 |
| D3 | 9.22M | 163K | 48.7K | 20% | 50/1000 |
| D4 | 478K | 36K | 1.8K | 20% | 25/500 |
Eval-I / Eval-P 是 item-holdout 与 pattern-holdout 评估划分;Clusters 列是留出簇/总簇。训练行排除留出簇。
8.2 Baseline 与变体¶
- Pretrained GR(Pre. GR):共享预训练连续检索器。
- Average pooling(Avg.):输入 embedding 均值直接作 query。
- MO-DiT(CPT+SFT):共享多域 metric-ordered CPT + 域内 tail-centroid SFT —— 主流水线。其中间阶段 CPT only 见 stage-wise 表 4。
- Single-domain CPT+SFT:同流水线但用 per-domain CPT(用于 order 消融,表 5)。
- HPPO 变体:off-policy(单轮)、adaptive(迭代、无 filter)、Pareto(迭代 + filter);主表 HPPO 行取每域最佳变体。
8.3 评估协议¶
每条评估序列生成一个 query 取 top-K 邻居,报告 Attr/Same/Joint/Cond 四个密度 + 一个 within-pattern 方向判别 AUC(最多 1,000 case/split)。严格协议(主结果)用 hardened 配置:500 簇分层 case/split,所有模型在同一份确定性抽样的 case 集上打分,故指标 paired、可直接比较。主对比的显著性用配对自助($B=10{,}000$)。order 消融用更轻的 50 density case/split 配置(表内可比,跨表不可比,约 1pp 内视为评估噪声)。偏好行的 checkpoint 选择不碰测试集:迭代变体在留出验证片上用真实在线 $\texttt{Joint@K}$ 选轮/checkpoint。
九、主要实验结果(§5.2)¶
9.1 主对比(表 2)¶
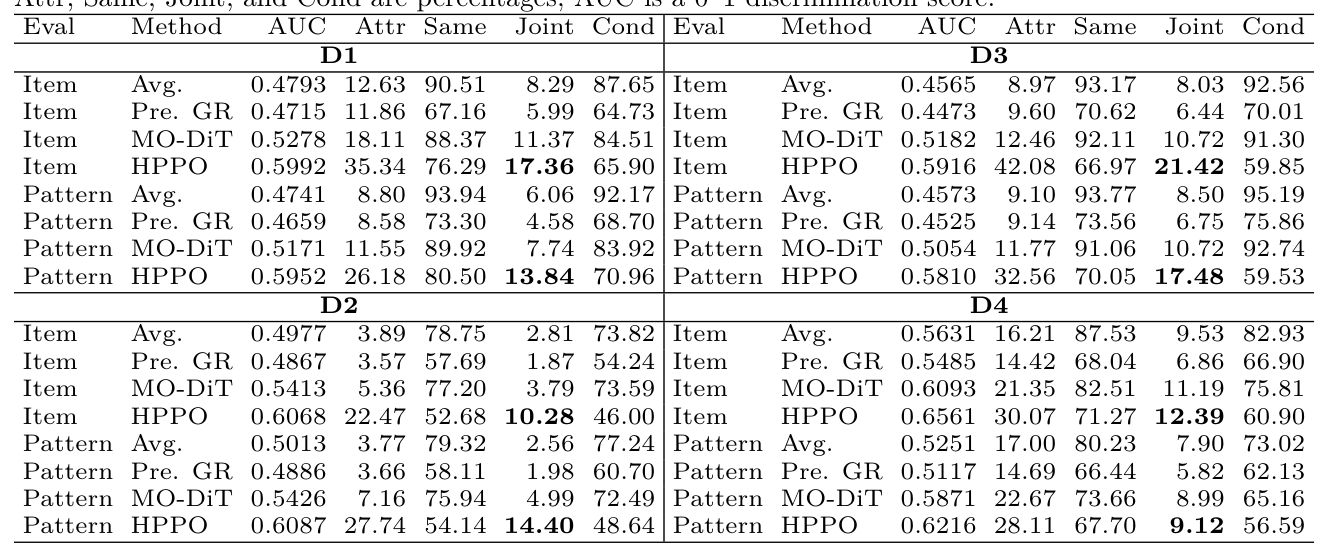
下表重排表 2 的全部数值(百分数;粗体为该 cell 的 $\texttt{Joint@K}$ 最优):
D1
| Eval | Method | AUC | Attr | Same | Joint | Cond |
|---|---|---|---|---|---|---|
| Item | Avg. | 0.4793 | 12.63 | 90.51 | 8.29 | 87.65 |
| Item | Pre. GR | 0.4715 | 11.86 | 67.16 | 5.99 | 64.73 |
| Item | MO-DiT | 0.5278 | 18.11 | 88.37 | 11.37 | 84.51 |
| Item | HPPO | 0.5992 | 35.34 | 76.29 | 17.36 | 65.90 |
| Pattern | Avg. | 0.4741 | 8.80 | 93.94 | 6.06 | 92.17 |
| Pattern | Pre. GR | 0.4659 | 8.58 | 73.30 | 4.58 | 68.70 |
| Pattern | MO-DiT | 0.5171 | 11.55 | 89.92 | 7.74 | 83.92 |
| Pattern | HPPO | 0.5952 | 26.18 | 80.50 | 13.84 | 70.96 |
D2
| Eval | Method | AUC | Attr | Same | Joint | Cond |
|---|---|---|---|---|---|---|
| Item | Avg. | 0.4977 | 3.89 | 78.75 | 2.81 | 73.82 |
| Item | Pre. GR | 0.4867 | 3.57 | 57.69 | 1.87 | 54.24 |
| Item | MO-DiT | 0.5413 | 5.36 | 77.20 | 3.79 | 73.59 |
| Item | HPPO | 0.6068 | 22.47 | 52.68 | 10.28 | 46.00 |
| Pattern | Avg. | 0.5013 | 3.77 | 79.32 | 2.56 | 77.24 |
| Pattern | Pre. GR | 0.4886 | 3.66 | 58.11 | 1.98 | 60.70 |
| Pattern | MO-DiT | 0.5426 | 7.16 | 75.94 | 4.99 | 72.49 |
| Pattern | HPPO | 0.6087 | 27.74 | 54.14 | 14.40 | 48.64 |
D3
| Eval | Method | AUC | Attr | Same | Joint | Cond |
|---|---|---|---|---|---|---|
| Item | Avg. | 0.4565 | 8.97 | 93.17 | 8.03 | 92.56 |
| Item | Pre. GR | 0.4473 | 9.60 | 70.62 | 6.44 | 70.01 |
| Item | MO-DiT | 0.5182 | 12.46 | 92.11 | 10.72 | 91.30 |
| Item | HPPO | 0.5916 | 42.08 | 66.97 | 21.42 | 59.85 |
| Pattern | Avg. | 0.4573 | 9.10 | 93.77 | 8.50 | 95.19 |
| Pattern | Pre. GR | 0.4525 | 9.14 | 73.56 | 6.75 | 75.86 |
| Pattern | MO-DiT | 0.5054 | 11.77 | 91.06 | 10.72 | 92.74 |
| Pattern | HPPO | 0.5810 | 32.56 | 70.05 | 17.48 | 59.53 |
D4
| Eval | Method | AUC | Attr | Same | Joint | Cond |
|---|---|---|---|---|---|---|
| Item | Avg. | 0.5631 | 16.21 | 87.53 | 9.53 | 82.93 |
| Item | Pre. GR | 0.5485 | 14.42 | 68.04 | 6.86 | 66.90 |
| Item | MO-DiT | 0.6093 | 21.35 | 82.51 | 11.19 | 75.81 |
| Item | HPPO | 0.6561 | 30.07 | 71.27 | 12.39 | 60.90 |
| Pattern | Avg. | 0.5251 | 17.00 | 80.23 | 7.90 | 73.02 |
| Pattern | Pre. GR | 0.5117 | 14.69 | 66.44 | 5.82 | 62.13 |
| Pattern | MO-DiT | 0.5871 | 22.67 | 73.66 | 8.99 | 65.16 |
| Pattern | HPPO | 0.6216 | 28.11 | 67.70 | 9.12 | 56.59 |
结论分析:
- 平均池化的行为完全印证动机:它保持最高的 same-pattern share(D1 item Same 90.51,D3 item 93.17),但停在低属性密度区,于是 $\texttt{Joint@K}$ 被压住。
- MO-DiT 在每个域每个划分上都改进 $\texttt{Joint@K}$(超过预训练检索器与平均池化)。
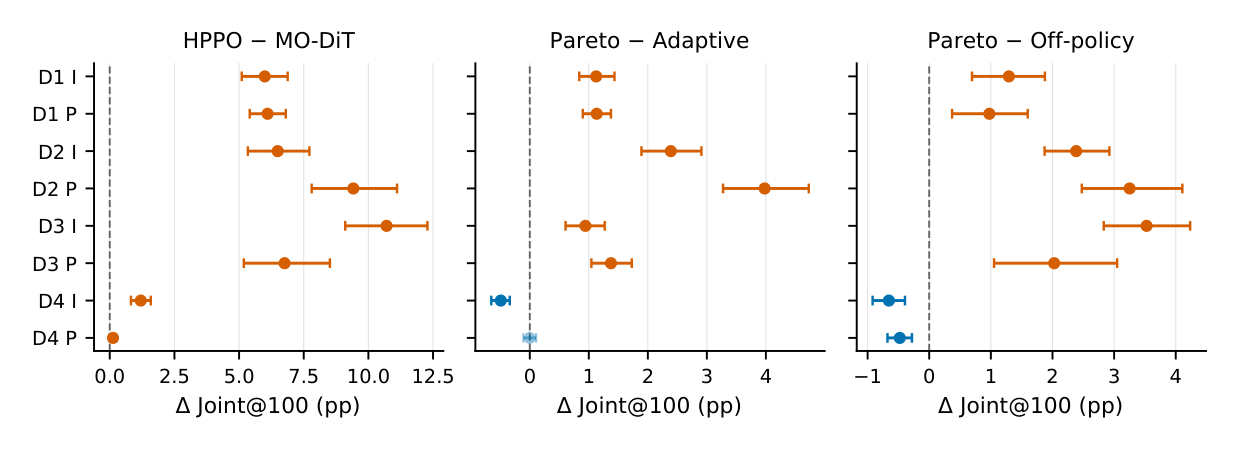
- HPPO 在全部 8 个 domain-split cell 上进一步改进 $\texttt{Joint@K}$,其中 7 个 cell 配对自助显著、margin 舒适;唯一例外是 D4 pattern-holdout(增益 +0.12pp,95% CI [+0.01,+0.24] 只勉强排除零,应读作近似打平,因为 D4 是最小域、给偏好阶段的交集空间最少)。
- 详列各列暴露机制:HPPO 大幅抬高原始属性密度(Attr:D3 item 12.46→42.08),让出一部分 same-pattern share 与 conditional purity,净的交集效应为正。
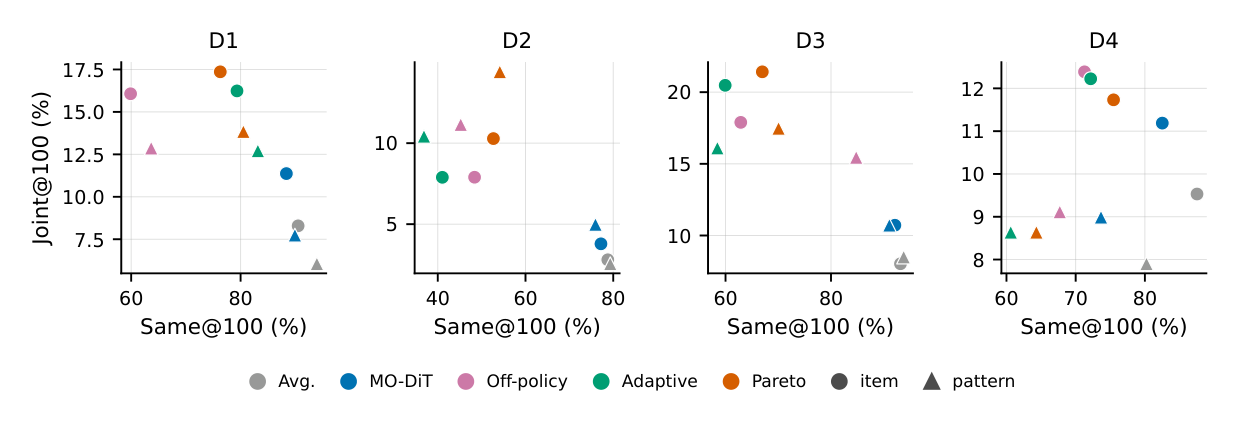
- D1/D2/D3 多数 cell 上,Pareto-filtered 变体在 $\texttt{Joint@K}$ 更高的同时保持 same-pattern share 高于无约束 off-policy —— 即"把前沿向外推"(图 5 Pareto 点位于 off-policy 右上方)。例外是 D3 pattern-holdout,更高的 $\texttt{Joint@K}$ 伴随 same-pattern share 的代价(见附录表 12)。
9.2 显著性(§5.2.2)¶
因为所有模型在同一份簇分层 case 集上评估(确定性抽样、验证 100% case-id 重合)且 per-query 交集值被存下来,对比是配对的。重采样共享 case($B=10{,}000$)报告每个 per-case 均差的自助分布。HPPO over MO-DiT 的头条增益在除 D4 pattern-holdout 外的每个 cell 显著。Pareto pair filter 相对 iteration-only(adaptive)与 single-round(off-policy)在全部 6 个 D1/D2/D3 cell 显著;D4 上 filter 不帮忙,主表报告 off-policy。配对检验是解析这些接近对比的关键:例如 D1 item,Pareto 与 adaptive 的 $\texttt{Joint@K}$ 区间重叠(17.4[15.8,18.9] vs 16.2[14.7,17.7]),但配对差 +1.1[+0.8,+1.4]pp 排除零(case 难度方差抵消)。
种子鲁棒性(表 3):用 3 个随机种子重训迭代-Pareto 偏好阶段(各自重采样训练 case、重生成候选、重优化,评估集固定),D1–D3 每个 cell 都稳定高于 MO-DiT;D4 边际。例如 D1 item 三种子 17.36 / 17.99 / 16.66(均值 17.34,MO-DiT 11.37)。
9.3 阶段递进(表 4)¶
表 4:主指标 $\texttt{Joint@K}$ 在四个训练阶段的递进(统一 hardened 协议,百分数)
| Eval | Dom | Base | Pre. | CPT | SFT | HPPO |
|---|---|---|---|---|---|---|
| Item | D1 | 0.00 | 5.99 | 7.52 | 11.37 | 17.36 |
| Item | D2 | 0.00 | 1.87 | 2.26 | 3.79 | 10.28 |
| Item | D3 | 0.02 | 6.44 | 7.47 | 10.72 | 21.42 |
| Item | D4 | 0.00 | 6.86 | 7.30 | 11.19 | 12.39 |
| Pattern | D1 | 0.00 | 4.58 | 5.03 | 7.74 | 13.84 |
| Pattern | D2 | 0.00 | 1.98 | 3.09 | 4.99 | 14.40 |
| Pattern | D3 | 0.01 | 6.75 | 7.61 | 10.72 | 17.48 |
| Pattern | D4 | 0.00 | 5.82 | 5.32 | 8.99 | 9.12 |
Base 初始化几乎召回不到同模式正样本;raw-sequence 预训练建立可用检索先验;共享 metric-ordered CPT 在预训练上加一致增量(唯一例外是 D4 pattern 的小幅回落,在评估噪声内);域内 tail-centroid SFT 是主监督跳变;HPPO 在每个 cell 再改进。8 个 cell 里有 7 个四阶段单调递增,唯一非单调是 D4 pattern 在 CPT 处的小回落(5.82→5.32,噪声内),SFT 又补回。
十、消融与分析(§5.3)¶
10.1 Metric ordering(表 5,单域配置)¶
中心假设是"按代理指标给同模式序列排序教会一种方向性变换"。控制 order 消融(相同数据规模/划分/初始化/训练配置,只变序列顺序):升序密度 vs 随机 vs 降序。
表 5:匹配的 order 消融(单域配置,$\texttt{Joint@K}$ 百分数)
| Eval | Dom | Base | Pre. | CPT | Desc | Rand | Asc |
|---|---|---|---|---|---|---|---|
| Item | D1 | 0.00 | 5.40 | 6.28 | 7.37 | 7.87 | 9.25 |
| Item | D2 | 0.00 | 2.71 | 3.03 | 3.89 | 3.52 | 4.11 |
| Item | D3 | 0.00 | 6.07 | 7.36 | 7.22 | 7.19 | 11.06 |
| Item | D4 | 0.00 | 6.73 | 6.91 | 6.91 | 7.88 | 11.40 |
| Pattern | D1 | 0.01 | 4.39 | 4.81 | 4.94 | 5.96 | 7.07 |
| Pattern | D2 | 0.00 | 1.54 | 2.16 | 1.74 | 1.46 | 2.40 |
| Pattern | D3 | 0.01 | 6.79 | 6.91 | 8.25 | 8.53 | 9.80 |
| Pattern | D4 | 0.00 | 6.14 | 5.98 | 5.42 | 5.70 | 9.32 |
升序(低→高密度)在每个域每个划分都是最优行,且超过 base 初始化、共享预训练、以及没有 SFT 的续训。这直接支持"序列顺序就是监督信号"的假设 —— 顺序编码的是检索方向(同模式内低→高属性密度),而非课程学习里的"难度"。
10.2 HPPO 消融¶
偏好变体(表 6):隔离 off-policy vs on-policy(hybrid) 候选生成、以及 Pareto pair filter(有/无)。
| Eval | Dom | SFT | Off-pol | Hyb-adapt | Hyb-pareto |
|---|---|---|---|---|---|
| Item | D1 | 11.37 | 16.07 | 16.24 | 17.36 |
| Item | D2 | 3.79 | 7.90 | 7.89 | 10.28 |
| Item | D3 | 10.72 | 17.89 | 20.48 | 21.42 |
| Item | D4 | 11.19 | 12.39 | 12.22 | 11.73 |
| Pattern | D1 | 7.74 | 12.87 | 12.71 | 13.84 |
| Pattern | D2 | 4.99 | 11.15 | 10.42 | 14.40 |
| Pattern | D3 | 10.72 | 15.45 | 16.10 | 17.48 |
| Pattern | D4 | 8.99 | 9.12 | 8.64 | 8.64 |
三点结论(D1/D2/D3):(1) 即便单轮 off-policy 也在每个 cell 改进 SFT;(2) 迭代 hybrid(adaptive)多数 cell 再加增益,确认 guidance fan 恢复候选多样性后"从改进中的策略重生成候选"有价值;(3) Pareto pair filter 是最大且最一致的贡献者,在全部 6 个 D1/D2/D3 cell 显著高于 off-policy 与 adaptive,且在多数 cell 抬 $\texttt{Joint@K}$ 的同时保持 same-pattern share 高(D1 pattern Same@K:Pareto 80.5% vs off-policy 63.7%)。D4 是例外 —— filter 不帮不害、报告更简单的 off-policy —— 因为 D4 留给任何变体的交集空间太小。
候选互补性(表 7,D1 off-policy):
| Candidate pool | Item | Pattern |
|---|---|---|
| Static-only(4 tail 质心) | 14.68 | 11.05 |
| Policy-only(4 fan 样本) | 13.40 | 10.08 |
| Hybrid(static + policy) | 16.07 | 12.87 |
两个候选家族都贡献,混合最优 —— 验证混合设计的合理性。这个消融也解释了 guidance fan 的必要性:point-target SFT 后条件生成器近确定,独立采样的策略 query 会塌缩到一个有效候选;对当前策略的 guidance scale 做扇形,恢复了让迭代与 pair filter 有效的多样性。
固定算力下的 on-policy 迭代(表 8,D1):固定总偏好预算 100 步,只变 on-policy 轮数。
| Schedule(轮×步) | Item | Pattern |
|---|---|---|
| 1×100(单轮,即 off-policy) | 12.96 | 9.14 |
| 2×50 | 13.37 | 9.57 |
| 4×25 | 13.74 | 10.02 |
$\texttt{Joint@K}$ 随轮数单调上升(相同数据、相同总步数),增益来自 on-policy 候选重生成而非更多优化。
Best-of-N oracle:生成 vs 选择(表 9,1,000 held-out case/split):对固定策略,按训练用的 8 候选(4 静态 tail 质心 + 4 guidance-fan 策略样本)各算真实在线 $\texttt{Joint@K}$,把策略上线的单个 query 与"事后挑最优候选"的 per-case oracle 比。
| Eval | Dom | SFT-oracle | HPPO-single | HPPO-oracle |
|---|---|---|---|---|
| Item | D1 | 10.20 | 12.60 | 15.70 |
| Item | D2 | 1.90 | 5.60 | 6.80 |
| Item | D3 | 9.70 | 15.70 | 19.10 |
| Item | D4 | 11.90 | 12.60 | 13.70 |
| Pattern | D1 | 10.50 | 13.50 | 17.10 |
| Pattern | D2 | 1.70 | 8.00 | 9.20 |
| Pattern | D3 | 8.00 | 12.80 | 15.90 |
| Pattern | D4 | 8.20 | 7.20 | 8.60 |
D1/D2/D3 上 HPPO 的单个生成 query 已超过 SFT 策略的全 8 候选 oracle —— 说明 HPPO 是把生成器本身挪动了,不只是改进了"从初始化的菜单里选"。效果在 D2 最显著(静态质心几乎没用,$\texttt{Joint@K}\le 2\%$,而 HPPO 单 query 达 5.6%/8.0%)。HPPO 自己的 8 候选 oracle 再加 15–27% 相对增益 —— 暗示一个未来推理时 reranker 有真实空间。D4 又是例外(生成与选择接近)。
10.3 Off-policy 漂移与 guidance 校准¶
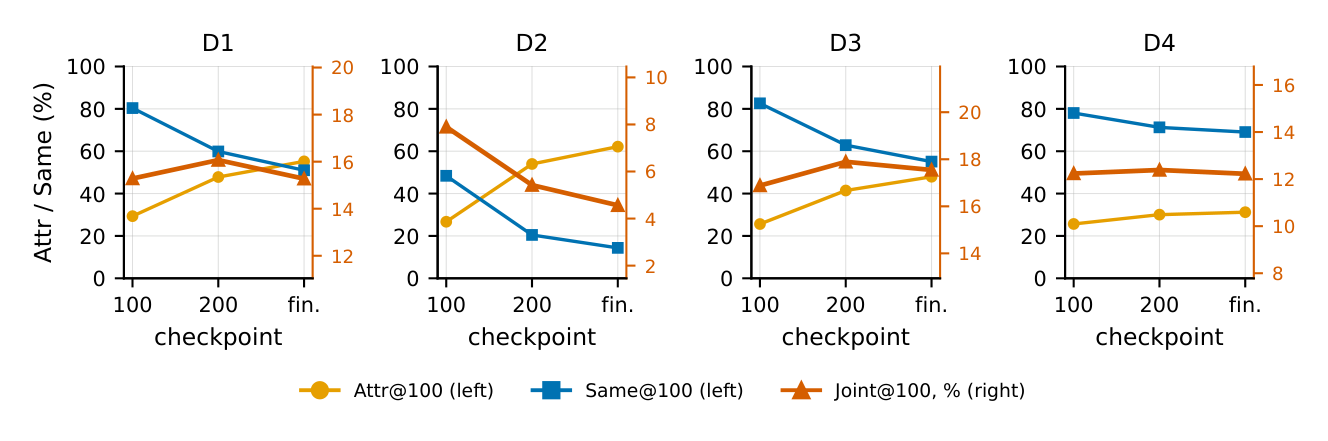
无约束 off-policy 偏好训练表现出特征性漂移:原始属性密度持续涨、same-pattern share 持续掉、$\texttt{Joint@K}$ 早见顶后下降(图 7,附录表 10/11/12/13 的 off-policy 行)。这就是偏好行用早期、验证选出的 checkpoint 的原因 —— 早选是协议的一部分而非调参技巧。
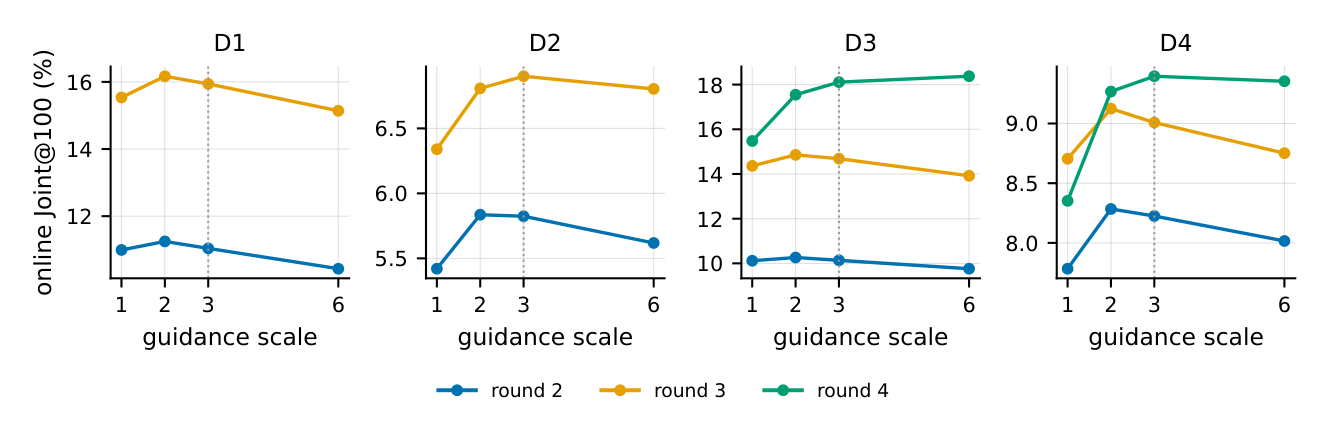
Guidance-scale 校准(图 8):scale 2–3 一致最优、scale 1 最差;漂移的后期轮里更高尺度有帮助(same-pattern share 随尺度回升)。上线默认 3.0 近最优。
10.4 其它分析¶
- 超参敏感性(表 15,D1):reward margin $\delta\in\{0.01,0.03,0.05\}$ 与偏好温度 $\beta\in\{0.025,0.05,0.10\}$ 在两个旋钮上都稳定(约 1pp 内),默认($\delta=0.03,\beta=0.05$)位于或近最优 —— 报告的增益不依赖调参。
- 度量预测器验证(表 16):在 item-hash / pattern-out / super-pattern-out 划分下,预测器都强(D1 item-hash AUC20/80=0.959、Spearman 0.663;pattern-out AUC 0.929)—— 冻结 embedding 携带的密度排序信号超出"记住簇身份",不是只记了 per-cluster 均值。
- 附录 F(早期 full-protocol 单域结果):metric-ordered CPT+SFT 在四个域上都改进预训练检索器(D1 5.07→10.57、D2 4.90→7.18、D3 6.37→12.05、D4 6.49→9.41,+44.9% 到 +108.4% 相对)。target 设计验证:oracle tail centroid 的 $\texttt{Joint@K}$(9.98,conditional purity 95.53)高于 oracle top-1/top-5(6.34/6.94,purity 70.59/72.96)—— 更尖的 top-k 目标会把交集换掉,证明 tail 质心是正确的监督目标。
- 附录 G(负结果与诊断):(1) 没有 Pareto filter、训练更久的无约束 off-policy 套件 $\texttt{Joint@K}$ 反低于 SFT 初始化(reward hacking 朝全局属性检索、conditional purity 崩塌)—— 促成验证早停、冻结 reference、Pareto filter;(2) 纯 listwise 训练对局部近似检索 bank / 选 case 代理 bank 不可靠,真实在线 $\texttt{Joint@K}$ 标签是必需的;(3) 用重复策略样本(无多样性)替换 guidance fan 时,Pareto filter 下验证分低于 baseline、在 SFT 处早停 —— fan 的候选多样性是 pair filter 有效的前提;(4) $\varepsilon$ 旋钮不是干净曲线(每个 run 在不同轮早停,$\varepsilon$ 与训练量纠缠),所以只报告 $\varepsilon=0$(Pareto)与 $\varepsilon=0.02$(Pareto-$\varepsilon$)两点,而非一条前沿。
十一、核心贡献总结¶
- 问题层面:把"既要属性、又要保模式"的工业检索痛点形式化为 pattern-preserving attribute retrieval,并设计了一个同时惩罚属性失败与模式漂移的主指标 $\texttt{Joint@K}$,配 $\texttt{Same@K}$ / $\texttt{Cond@K}$ / $\texttt{Attr@K}$ 做机制诊断。
- 监督层面:metric-ordered sequence construction 把"昂贵、稀疏的在线检索标签"通过一个轻量密度预测器扩展成"大规模、稠密的同模式低→高密度轨迹",让 CPT/SFT 学到"度量改进方向"这一可迁移能力。order 消融证明顺序本身即信号(升序最优)。
- 架构层面:球面 flow-matching 的单扩散 transformer,用结构化注意力 mask 让 condition 编码一次复用、多 target 一次前向独立生成,保留种子细粒度信息,输出连续 query 直接进 ANN —— 绕开离散标识符解码与码本设计。
- 对齐层面:HPPO 把 Diffusion-DPO 式参考锚定偏好优化适配到连续检索器(flow-matching loss 作隐式分数、真实在线 $\texttt{Joint@K}$ 作 reward、混合候选池),并以 tradeoff-aware Pareto pair filter 在 pair 构造层面强制"纯度不下降",把属性-模式前沿向外推、抵抗 reward over-optimization —— 这是把增益留在权衡有利一侧的关键配料。
- 工程层面:在线对齐很便宜(单机 < 1 小时打标、8 卡几分钟一轮),昂贵的是离线预训练,使逐域刷新可行;并给出严格的 item-/pattern-holdout + 配对自助 + 多种子 + 负结果的完整评估方法论。
十二、与已归档相关工作的对比¶
FAVE FAVE: Flow-based Average Velocity Establishment for Sequential Recommendation(UESTC, 2026-04-06)¶
关系:独立并发(本文未引用 FAVE,两者殊途同归)· 已加载对方精读
- 共同关注的问题:两篇都站在"用连续生成模型(而非解码离散 token)在冻结/连续 embedding 空间里合成一个目标向量、再用最近邻检索消费"这条相对小众的路线上,且都明确反对两类前作 —— 离散 semantic-ID 生成式检索、以及需要多步去噪的扩散推荐。FAVE 的痛点是"Noise-to-Data 范式的先验不匹配 + 多步推理成本",本文的痛点是"属性-模式权衡 + 在线标签稀疏";表层任务不同(FAVE 是 next-item 序列推荐,本文是 pattern-preserving 属性检索),但抽象到方法骨架,两者都在解决"如何把一个 flow-matching 生成器从历史/种子序列引导到 embedding 流形上一个高价值区域"。
- 相近的技术骨架:(a) 都用 flow matching / rectified flow 学速度场,把条件序列映射到一个连续目标 embedding;(b) 都把目标 item embedding 当作 flow 的 data 端、用条件序列编码作条件;(c) 都注意到"直接预测目标比预测速度更稳"的重参数化思想(FAVE 的 recovery loss $\mathcal{L}_{rec}=\|f_\theta(x_t,t,1)-x_1\|^2$;本文用 tail-centroid 作 point target 的 SFT)。
- 本文的差异与推进:(1) 条件注入方式不同 —— FAVE 把"扰动后的历史 embedding"直接当 flow 起点 $x_0$(history-informed prior)以缩短轨迹、追求单步;本文仍从球面高斯噪声出发、把种子序列作为独立的 condition token 经结构化 mask 注入,走少数 Euler 步。(2) 优化重心不同 —— FAVE 的创新在"平均速度场 + JVP 曲率约束"实现单步推理加速;本文不追求单步,而是在 SFT 之上叠加一个偏好对齐阶段(HPPO),把生成分布对齐到真实在线检索指标,FAVE 完全没有对齐/偏好环节。(3) 监督信号来源不同 —— 本文最大的独立贡献是把稀疏在线检索标签转成 metric-ordered 轨迹 + 用在线 $\texttt{Joint@K}$ 做 DPO 式 reward,这套"online-metric-in-the-loop"在 FAVE 里不存在(FAVE 用标准 next-item 交叉熵 + flow 重构)。
- 可比的方法/实验差异:FAVE 在 ML-100k / Amazon-Beauty / Steam 等公开数据上报告 H@10 +7.48% / N@20 +9.90% 且推理比 FMRec 快一个量级;本文只在四个匿名内部域上用 $\texttt{Joint@K}$ 评估、无公开 benchmark,两者数据不可直接对齐。可对照的洞见是:FAVE 把"历史先验"用于缩短生成轨迹,本文把"历史/种子条件"用于约束生成落点的模式归属 —— 同一条 flow-matching-for-retrieval 主线上的两种正交用法。
被剔除的近似候选(终端已记录):FlowTime(FlowTime,Fudan) —— 同样是 flow-based 连续生成(一步 VAE + flow prior),但问题是 watch-time 回归(warp 高斯到多峰分布预测播放时长),不是向量索引检索,解法落点(标量/分布目标 vs ANN query embedding)实质偏离;Mult-DPO(Mult-DPO,UVA) —— 与 HPPO 共享"DPO 用于推荐"的思路,但作用在离散 set-wise 排序偏好(Plackett-Luce 替身),无扩散/连续生成,问题+解法非双同构;离散 semantic-ID + GRPO 的生成式推荐簇(如 AuthGR 的 CPT-SFT-GRPO、GenRec、AdaGRPO)共享"SFT 后用 RL/偏好对齐到在线/业务 reward"的流水线形状,但生成机制是离散 token 解码而非连续扩散,核心骨架不同,交由 DAG/标签兜底。
十三、讨论与局限性¶
核心贡献与值得借鉴的设计:
- "把稀疏昂贵的在线 reward 变成稠密离线监督"是可迁移的范式。metric-ordered sequence construction 用一个只服务于排序、绝不进入最终评估的轻量预测器,把"昂贵在线检索标签"放大成大规模轨迹监督 —— 这套"用便宜代理排序、用真实在线指标做最终评估与对齐"的两层结构,在任何"在线 reward 昂贵但可抽样"的检索/推荐对齐场景都值得借鉴。
- Pareto pair filter 是一个极简却关键的反 reward-hacking 机制。它不引入额外 reward 模型、不做多目标标量化,而是在pair 构造层面强制次目标(模式纯度)不退化,把多目标对齐降维成"单目标偏好 + 一个免费的支配约束"。附录 G 的负结果显示:去掉它,无约束 off-policy 会朝全局属性检索 reward-hack、purity 崩塌、$\texttt{Joint@K}$ 反低于 SFT —— 这个对照让 filter 的价值非常有说服力。
- 把 Diffusion-DPO 适配到检索:用 flow-matching loss 的负值作隐式策略分数,绕开连续扩散里没有 token 对数概率的难题,是 DPO 思想迁移到连续生成式检索的干净示范。
局限与争议:
- 可复现性弱:全部实验只在四个匿名内部域上,无任何公开 benchmark、无开源数据,外部无法独立验证;baseline 也偏薄(主要是 Average pooling 与 Pretrained GR 两个泛化构造,缺与离散 semantic-ID 检索、扩散推荐等强外部方法在同一任务上的直接对比)。
- 无真实线上 A/B:论文给了 feasibility 估算(打标 < 1 小时、几分钟一轮)和"内容审核/发现"的应用叙事,但没有报告任何真实业务部署的收益数字 —— 工业价值停留在"production-like 离线"层面。
- 任务偏窄 + 依赖外部组件:方法依赖一个冻结的 item-embedding 空间 + 一个生产属性打分器,且"模式"是 embedding 聚类的近似(非人工标注),其质量天花板受聚类质量与属性打分器粒度限制;若属性打分器本身有偏,方法会放大它(broader impact 一节也承认,建议配 scorer 审计、人工复核、漂移监控)。
- D4 始终是例外:最小、复用最重的域上,所有偏好变体落在一个窄 $\texttt{Joint@K}$ 带里、Pareto filter 不帮不害、pattern 划分增益只是边际打平 —— 说明方法的增益依赖"该域里属性密度还能在模式内被推多远"的内在可分性,并非普适。
- $\varepsilon$ 前沿不可控:纯度容差 $\varepsilon$ 与训练量纠缠、不能描出干净的属性-纯度前沿,论文只能报两个离散点,承认"一个 tradeoff-参数条件化的策略才是可控前沿的正路",留作未来工作。
方法论可扩展性:四个阶段共享同一个扩散 transformer 骨干、同一个 flow-matching 目标,没有离散码本/量化这类一旦固化即限制下游表征的瓶颈;密度预测器是离线的、只排序数据,不进模型梯度,也不是端到端瓶颈。整体是一个偏 clean 的"参数量 scaling 时表征与序列建模可一起增长"的路线,主要的工程复杂度在多阶段流水线编排与在线打标基础设施上,而非架构性死锁。