UniRec:用 Chain-of-Attribute 弥合生成式与判别式推荐之间的表达力鸿沟¶
作者:Ziliang Wang†, Gaoyun Lin†, Xuesi Wang, Shaoqiang Liang, Yili Huang, Weijie Bian*, Li Zhang, Mingchen Cai, Jian Dong, Guanxing Zhang(†共同一作,*通讯作者 [email protected])
机构:Shopee(全部作者同一机构)
ArXiv:2604.12234(v1 投稿 2026-04-14;本次精读基于 v4,2026-04-30)
一、研究动机与背景¶
1.1 多阶段判别式流水线的三个痼疾¶
工业推荐系统长期采用 Retrieval → Pre-ranking → Ranking → Reranking 的多阶段判别式漏斗。论文开篇把它的问题归纳为三条:
- 各阶段目标不一致(inconsistent objectives across stages):每个阶段只优化自己的局部目标;
- 样本选择偏差(sample selection bias):排序模型只在曝光空间上训练,无法泛化到全量候选集;
- 误差沿漏斗累积且不可纠正(compounding error propagation):上游丢掉的候选,下游没有任何机会补救。
受 LLM(GPT-4、DeepSeek-V3、LLaMA)成功的启发,生成式推荐(Generative Recommendation, GR)把这件事重构为在 Semantic ID(SID)上的自回归解码,把召回与排序统一进单个模型,从架构上消除了阶段间的错配。
1.2 真正的问题:表达力鸿沟¶
但论文指出,GR 拿到架构优势的同时,付出了一个结构性的信息代价:
- 判别式模型估计 $p(y \mid \mathbf{f}, u)$,直接拿到 item 的特征向量 $\mathbf{f}$,可以做显式的 user–item 特征交叉;
- 生成式模型在紧凑的 SID token 上解码 $\prod_{l} p(s_l \mid s_{<l}, u)$,在看到任何 item 侧信号之前就必须承诺一条生成路径。
作者强调这不是工程实现的疏漏,而是解码时刻可用信息的结构性不对称(structural asymmetry in the information available at decoding time)。
雪上加霜的是推荐任务天然是一对多映射:语言建模里给定上文基本能确定下一个 token,而同一条用户行为序列可能对应多个合法目标 item,这会放大生成不确定性、制造训练冲突——而这些冲突恰恰是判别式模型靠显式特征交互解决的。
于是论文提出核心问题:生成式推荐能否达到判别式的表达力?如果能,在什么条件下?
二、理论刻画:贝叶斯视角下的表达力上界¶
论文用一个非常干净的贝叶斯论证给出肯定回答。记 $\mathbf{f} = (f_1, \dots, f_n)$ 为 item 的特征表示,$u$ 为用户上下文,$y$ 为互动标签。由贝叶斯定理:
$$p(y \mid \mathbf{f}, u) \propto p(\mathbf{f} \mid y, u)\, p(y \mid u) \tag{1}$$
由于 $p(y \mid u)$ 与 $\mathbf{f}$ 无关(对同一次请求下的所有候选是同一个常数),按判别式分数排序等价于按生成式后验 $p(\mathbf{f} \mid y, u)$ 排序。再用链式法则展开:
$$p(\mathbf{f} \mid y, u) = \prod_{k=1}^{n} p(f_k \mid f_{<k}, y, u) \tag{2}$$
这恰好就是在 item 特征上做自回归解码的形式。结论:
一个拥有完整 item 特征访问权的生成式模型,与它的判别式对应物在表达力上等价;任何实际存在的差距,都只来自近似能力或特征覆盖,而非建模范式的固有不对称。
这个论证的杀伤力在于把"生成式天花板更低"这个长期直觉,重新归因到一个可工程化解决的变量上:SID 编码在把丰富的 item 语义压成紧凑离散码时,不可避免地丢掉了判别式模型靠显式交叉利用的结构化属性——类目(taxonomy)、店铺(seller)、品牌(brand)。把这些丢失的信号在生成轨迹内部重新找回来,既是必要的也是充分的。
需要注意的是:这里的"证明"本质上是贝叶斯公式的一次改写,它给出的是一个存在性上界,并没有刻画有限容量模型逼近该上界的难度,这一点在后文局限性中再讨论。
三、核心方法:UniRec 总览¶
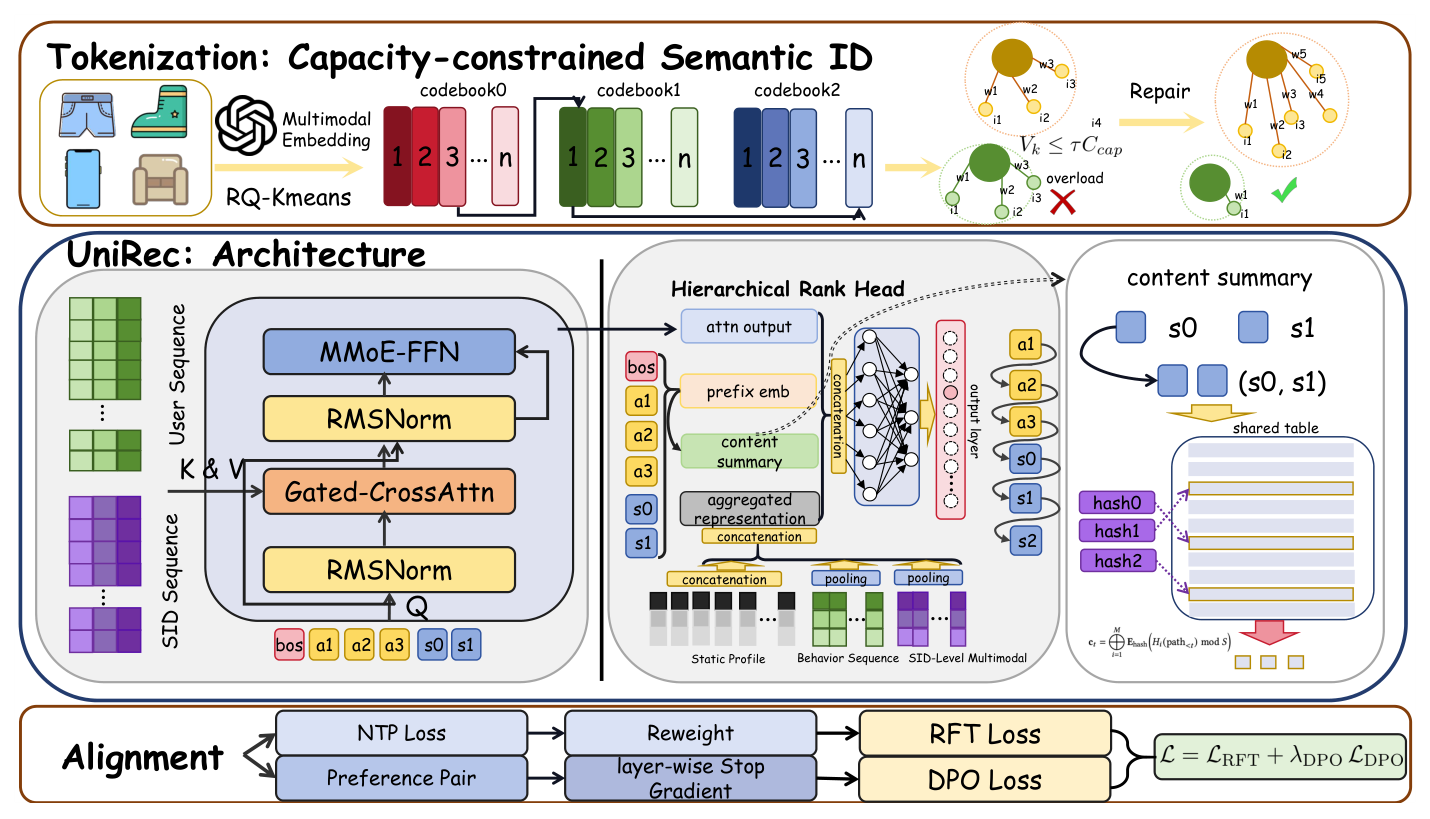
UniRec 把候选生成与排序整合进一个统一的自回归解码框架,每个 item 由多层语义 token 表示。四个组成部分:
- Capacity-constrained SID(§3.2):缓解层次表示中的遗传式马太效应,强制各层 token 分布均衡;
- Chain-of-Attribute, CoA(§3.3):在 SID token 之前先"投机性地"生成 item 属性;
- Conditional Decoding Context, CDC(§3.4):把任务条件与组合特征交互注入解码过程;
- 生成骨干 + 对齐(§3.5–3.6):Decoder-Only 骨干 + 对用户行为序列的 Cross-Attention,每步一个 Rank Head 出 token 分布;再用 RFT 与 DPO 做业务目标对齐。
四、Capacity-constrained Semantic ID¶
4.1 曝光集中的量化:2.6 倍放大¶
论文基于 RQ-KMeans 把 item 映射为离散 token 序列。已有的"平衡量化"(OneRec 的做法)在聚类时强制每个簇 item 数量均等。但作者指出这个约束抓错了变量:item 热度服从长尾分布,即使每簇 item 数相同,少量高流量 item 也会独占其所属码本条目的曝光负载。
结果是一种遗传式马太效应(hereditary Matthew effect):高流量 token 组合在训练数据中累积了不成比例的曝光,模型在 beam search 时反复生成同一小撮 token 路径,绝大多数码本条目被边缘化。
作者用生产流量数据量化了这一现象。度量方式是分层的:对第一层 $s_0$,统计每个 token 在曝光中出现的次数并按量排序;对更深层则在联合组合层面度量——$s_1$ 用 $(s_0, s_1)$ 对,$s_2$ 用 $(s_0, s_1, s_2)$ 三元组,计算 top-$k\%$ 组合的累计曝光占比。
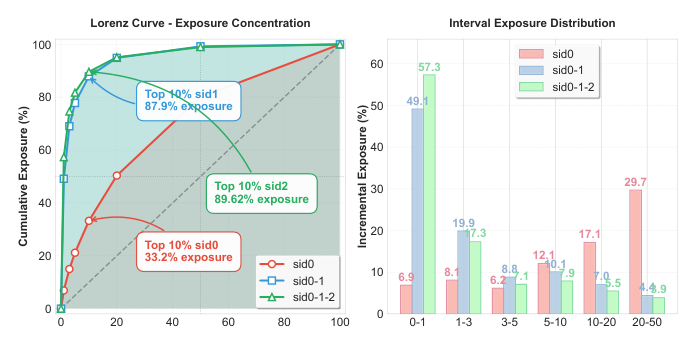
| 层级 | top 10% 累计曝光占比 |
|---|---|
| $s_0$ | 33.24% |
| $(s_0, s_1)$ | 87.90% |
| $(s_0, s_1, s_2)$ | 89.62% |
从 $s_0$ 到 $s_1$ 是 2.6 倍放大——温和的 item 数量不均衡被组合层级转化成了极端的流量集中。Figure 2 右侧的分区间曝光分布进一步显示:在 $(s_0,s_1,s_2)$ 上,0–1% 区间独占 57.3%,而 20–50% 区间只剩 3.9%。
4.2 带容量约束的残差量化¶
设第 $l$ 层的聚类样本为 $\{x_i\}_{i=1}^{N}$($N$ 为 item 数),每个样本带曝光权重 $w_i > 0$(如历史曝光计数),$z_i \in \{1,\dots,K\}$ 为簇分配,$\boldsymbol{\mu}_k \in \mathbb{R}^{d_{\text{emb}}}$ 为第 $k$ 个簇中心。定义第 $k$ 簇的曝光负载(volume):
$$V_k = \sum_{i: z_i = k} w_i \tag{3}$$
给定容量上限 $C_{cap} > 0$ 与容忍度 $\tau \ge 1$,约束聚类问题为:
$$\min_{\{z_i\},\{\boldsymbol{\mu}_k\}} \sum_{i=1}^{N} \lVert x_i - \boldsymbol{\mu}_{z_i} \rVert_2^2, \quad \text{s.t.}\ \ V_k \le \tau C_{cap},\ \forall k \in \{1,\dots,K\} \tag{4}$$
容量基准取平均曝光负载 $C_{cap} = \frac{1}{K}\sum_{i=1}^{N} w_i$。
这个硬约束问题一般是 NP-hard 的,作者采用两阶段贪心:先把每个样本分到最近的簇心以最小化重构误差,再对超载簇做修复——把超出的样本重新分配到最近的未满簇。
算法 1:Capacity-Constrained Residual Quantization
输入: item embedding {e(x_i)}, 曝光权重 {w_i}, 层数 L, 簇数 K, 容忍度 τ
输出: Semantic ID {s_0(x_i), ..., s_{L-1}(x_i)}

for l = 0 to L-1:
    r_i ← e(x_i) - Σ_{j<l} μ_{j, s_j(x_i)}        # 残差;l=0 时 r_i = e(x_i)
    用 K-Means++ 初始化 {μ_k};设 C_cap ← (1/K) Σ_i w_i
    repeat
        z_i ← argmin_k ||r_i - μ_k||_2  (对所有 i);计算 V_k ← Σ_{i:z_i=k} w_i
        for 每个满足 V_k > τ·C_cap 的 k:                # 修复超载簇
            for 每个 z_i = k 的 i:
                z_i ← argmin_{k': V_{k'}+w_i ≤ τ·C_cap} ||r_i - μ_{k'}||_2
                V_k ← V_k - w_i ;  V_{k'} ← V_{k'} + w_i
        μ_k ← mean{r_i : z_i = k} ;  J ← (1/N) Σ_i ||r_i - μ_{z_i}||_2
    until |ΔJ| < ε
    s_l(x_i) ← z_i ,  μ_{l,k} ← μ_k
实验中取 3 层、每层码本 $K = 4000$、容忍度 $\tau = 1.05$(即允许单簇负载最多超均值 5%)。
五、Chain-of-Attribute(CoA)¶
5.1 从理论上界到工程近似¶
按 §2 的结论,把全部 item 特征逐个自回归解码就能达到判别式上界,但在推荐规模下延迟不可接受。GR 系统正是因此才用分层 SID 把丰富语义压成紧凑码,用 $\prod_{l=0}^{L-1} p(s_l \mid s_{<l}, u)$ 替代式 (2) 的完整分解。这个压缩天然有损:类目、店铺、品牌等结构化属性被折进 SID 码里,在解码时变成隐变量。
CoA 的做法是:在 SID 序列前面前缀 $m$ 个粗粒度属性 token $\mathbf{a} = [\text{attr}_1, \dots, \text{attr}_m]$,得到分解:
$$p(\mathbf{s} \mid u) = p(\mathbf{a} \mid u) \cdot \prod_{l=0}^{L-1} p(s_l \mid \mathbf{a}, s_{<l}, u) \tag{5}$$
作者明确把 CoA 定位为对式 (2) 理论上界的一个实用近似:不解码完整特征向量,而是选择性地找回被 SID 压缩丢弃最多的粗粒度属性,代价是固定的 $m$ 步额外自回归延迟。这个近似缩小特征覆盖鸿沟的程度,由属性与 SID token 之间的条件互信息 $I(\mathbf{a}; s_l \mid s_{<l}, u)$ 刻画——互信息越大,解码不确定性下降越多。
这就是论文所谓的 speculate-then-refine(先投机再细化)生成范式。
5.2 两个互补的收益¶
收益一:可度量的生成不确定性下降。 第 $l$ 层的熵差为:
$$\Delta H_l = H(s_l \mid s_{<l}, u) - H(s_l \mid \mathbf{a}, s_{<l}, u) = I(\mathbf{a}; s_l \mid s_{<l}, u) \ge 0 \tag{6}$$
只要 $\mathbf{a}$ 与 $s_l$ 不条件独立,该值严格为正。而这个条件在实践中恒成立,因为同类目的 item 在 SID 语义空间中本就占据相邻区域,其 token 序列按构造就与粗粒度属性结构相关。
累计的 $\sum_l \Delta H_l$ 稳定了 beam search 轨迹。更进一步,条件化在 $\mathbf{a}$ 上把每层 token 错误率从 $\epsilon_l$ 降到 $\epsilon'_l < \epsilon_l$,级联失败概率满足:
$$P'(\text{error}) = 1 - \prod_l (1 - \epsilon'_l) < 1 - \prod_l (1 - \epsilon_l) = P(\text{error})$$
即端到端误差衰减(end-to-end error attenuation)。
收益二:与 Cross-Attention 正交互补。 Cross-Attention 在表征层捕捉 user–item 交互(把用户偏好上下文编码进解码器隐状态);CoA 在解码层运作(每一步提供显式的 item 侧语义上下文)。二者一起把"用户是谁"和"正在生成什么样的 item"注入同一条生成轨迹。
论文自评这是首个对 GR 解码不确定性的信息论刻画。
六、Conditional Decoding Context(CDC)¶
CDC 用两个互补机制增强解码:Task-Conditioned BOS 告诉模型在解什么任务,Content Summary 提供已解码 token 的紧凑组合交互特征。
6.1 Task-Conditioned BOS¶
统一的 GR 模型往往要同时处理多个目标:点击预测重即时互动、购买预测重转化意图;主 feed 场景强调广泛兴趣探索、搜索场景要求 query 条件下的相关性;国内市场偏本地品牌、跨境市场需要跨境商品发现。为每个场景单独训一个模型代价高昂,而不加显式条件地共享参数会导致目标干扰,表现为预测不稳与效果退化。
做法是把固定的 BOS token 替换为一个可学习的、以任务上下文 $c_{\text{task}}$ 为条件的 embedding,$c_{\text{task}}$ 联合编码行为目标与推荐场景:
$$c_{\text{task}} \in \underbrace{\{\text{click},\ \text{purchase},\ \text{cart},\ \text{cross-border},\dots\}}_{\text{行为目标}} \times \underbrace{\{\text{main feed},\ \text{search},\ \text{similar items},\ \text{flash sale},\dots\}}_{\text{推荐场景}}$$
在初始状态注入任务信号,就能操纵整条生成轨迹:把 token 分布偏置到上下文相关的语义区域、在整条解码链上维持一致的意图、并让模型按场景动态调整生成策略——且不改变解码架构本身。
6.2 Content Summary¶
分层解码中模型能看到自回归前缀,但单个 token 的 embedding 无法表达它们的联合组合语义。论文的论证是:解码路径上 token 之间的关系不是一一对应的——同一个 SID token 与不同属性或父 token 配对时可能携带不同的语义,而有意义的 item 模式往往从特定组合而非单个 token 中涌现。已有 GR 方法依赖自注意力隐式学习 token 交互,对显式组合模式的表达力有限。
直接存下所有 token 对组合会导致参数爆炸(两个 4000 词表的层就有 $4000^2 \approx 1600$ 万条目)。作者改用受 Bloom filter 启发的哈希投影:多个哈希函数共享同一张 embedding 表。第 $t$ 个解码步的 content summary $\mathbf{c}_t$ 为:
$$\mathbf{c}_t = \bigoplus_{i=1}^{M} \mathbf{E}_{\text{hash}}\Big( H_i(\text{path}_{<t}) \bmod S \Big) \tag{7}$$
其中 $\bigoplus$ 表示拼接,$\text{path}_{<t}$ 是第 $t$ 步之前解码出的所有 token,$\{H_i\}_{i=1}^{M}$ 是 $M$ 个采用不同组合策略的哈希函数,$\mathbf{E}_{\text{hash}} \in \mathbb{R}^{S \times d_{\text{hash}}}$ 是共享 embedding 表,哈希表大小对 $n$ 元笛卡尔积(词表 $\{V_i\}$)由下式确定:
$$S = \Big\lfloor \big(\textstyle\prod_{i=1}^{n} V_i\big)^{2/(n+1)} \Big\rfloor$$
用多个不同组合策略的哈希函数打到共享表上,具有相似"属性–SID 模式"的 item 会自然产生重叠的哈希签名,从而让模型在相关 item 组合之间泛化。参数量为 $M \times S \times d_{\text{hash}}$,可控。
实验中 $M = 3$,对特征索引对 $(x,y)$ 分别取 $H_1(x,y) = x + y$、$H_2(x,y) = x \cdot y$、$H_3(x,y) = p_1 x + p_2 y$($p_1, p_2$ 为质数),$d_{\text{hash}} = 64$;参与笛卡尔积的组合为 (L2, $s_0$)、(L2, $s_1$)、(L3, $s_0$)、(L3, $s_1$)、($s_0$, $s_1$)。
七、生成模型与训练¶
UniRec 用 Decoder-Only 骨干 + 对用户行为序列的 Cross-Attention + 每步一个 Rank Head。
7.1 输入特征建模¶
模型输入由三部分组成。
静态画像特征:稀疏字段(用户 ID、人口属性、上下文特征)embedding 后处理为
$$\mathbf{h}_{\text{static}} = \text{RMSNorm}\big([\mathbf{e}_{\text{uid}} \oplus \mathbf{e}_{\text{ctx}} \oplus \cdots]\big) \in \mathbb{R}^{d_{\text{static}}} \tag{8}$$
行为序列特征:用户点击行为按时序组织,每个行为的 item 侧属性(item、shop、category 等)处理为
$$\mathbf{h}_i = \text{Linear}\big(\text{RMSNorm}([\mathbf{e}_{\text{item}_i} \oplus \mathbf{e}_{\text{shop}_i} \oplus \mathbf{e}_{\text{cate}_i} \oplus \cdots])\big) \in \mathbb{R}^{d_{\text{model}}} \tag{9}$$
构成行为序列 $\mathbf{H}_{\text{seq}} = \{\mathbf{h}_1,\dots,\mathbf{h}_T\} \in \mathbb{R}^{T \times d_{\text{model}}}$。
SID 级多模态特征:由多模态内容对齐导出的多层 SID $\{s_0, s_1, s_2\}$ 被 embedding 后与对应 item embedding 融合再投影,以保证与行为序列的时序对齐:
$$\mathbf{H}_{\text{mm}} = \{\mathbf{h}^{\text{mm}}_1, \dots, \mathbf{h}^{\text{mm}}_{L_{\text{mm}}}\} \in \mathbb{R}^{L_{\text{mm}} \times d_{\text{model}}},\quad \mathbf{h}^{\text{mm}}_j = \text{RMSNorm}\big(\text{Linear}([\mathbf{e}^{(0)}_j \oplus \mathbf{e}^{(1)}_j \oplus \mathbf{e}^{(2)}_j])\big) \tag{10}$$
拼接进序列:$\mathbf{H}_{\text{seq}} \leftarrow [\mathbf{H}_{\text{seq}}; \mathbf{H}_{\text{mm}}] \in \mathbb{R}^{(T+L_{\text{mm}}) \times d_{\text{model}}}$。
聚合表示:
$$\mathbf{h}_{\text{agg}} = \text{RMSNorm}\big([\mathbf{h}_{\text{static}} \oplus \text{Pool}(\mathbf{H}_{\text{seq}})]\big) \in \mathbb{R}^{d_{\text{agg}}} \tag{11}$$
7.2 Cross-Attention 条件化¶
Cross-Attention 把用户行为上下文与 token 解码过程解耦:行为序列 $\mathbf{H}_{\text{seq}}$ 作为静态的 Key-Value,解码侧序列(任务 prompt + 属性 + SID token)作为 Query。
$$\mathbf{Q}^{(0)} = \text{PosEncoding}\big([\mathbf{e}_{\text{BOS}} \oplus \mathbf{e}_{\text{attr}} \oplus \mathbf{e}_0 \oplus \mathbf{e}_1 \oplus \mathbf{e}_2]\big) \in \mathbb{R}^{(1+m+L) \times d_{\text{model}}} \tag{12}$$
$$\mathbf{K} = \mathbf{V} = \text{PosEncoding}(\mathbf{H}_{\text{seq}}) \in \mathbb{R}^{(T+L_{\text{mm}}) \times d_{\text{model}}} \tag{13}$$
Query 序列过 $D$ 层 cross-attention,每层用 Pre-Norm + 残差:
$$\mathbf{Q}^{(d)}_{\text{mid}} = \mathbf{Q}^{(d-1)} + \text{GatedCrossAttn}\big(\text{RMSNorm}(\mathbf{Q}^{(d-1)}), \mathbf{K}, \mathbf{V}\big) \tag{14}$$
$$\mathbf{Q}^{(d)} = \mathbf{Q}^{(d)}_{\text{mid}} + \text{MMoE-FFN}\big(\text{RMSNorm}(\mathbf{Q}^{(d)}_{\text{mid}})\big) \tag{15}$$
其中 GatedCrossAttn 用一个可学习门控参数 $\gamma$ 调制行为上下文的贡献:
$$\text{GatedCrossAttn}(\mathbf{Q},\mathbf{K},\mathbf{V}) = \gamma \cdot \text{Softmax}\left(\frac{\mathbf{Q}\mathbf{K}^\top}{\sqrt{d_{\text{model}}}}\right)\mathbf{V} \tag{16}$$
MMoE-FFN 的每个专家用 SwiGLU 激活以捕捉任务特定模式。最终输出归一化:
$$\mathbf{Q}_{\text{out}} = \text{RMSNorm}(\mathbf{Q}^{(D)}) \in \mathbb{R}^{(1+m+L) \times d_{\text{model}}} \tag{17}$$
7.3 分层 Rank Head¶
每个解码步 $t \in \{1,\dots,m+L\}$ 用一个专属的 Rank Head。输入 $\mathbf{x}_t$ 拼接四路信号:(1) cross-attention 输出 $\mathbf{q}_t = \mathbf{Q}_{\text{out}}[t,:]$;(2) 第 $t$ 步之前已解码 token 的前缀 embedding $\mathbf{e}_{\text{prefix}}$;(3) 式 (7) 的 Content Summary $\mathbf{c}_t$;(4) 聚合表示 $\mathbf{h}_{\text{agg}}$。
$\mathbf{x}_t = [\mathbf{q}_t \oplus \mathbf{e}_{\text{prefix}} \oplus \mathbf{c}_t \oplus \mathbf{h}_{\text{agg}}]$ 经 SENet 与 MaskNet 处理后输出:
$$p(s_t \mid s_{<t}, u, c_{\text{task}}) = \text{Softmax}\big(g^{(t)}(\mathbf{x}_t)\big) \tag{18}$$
输出词表是任务特定的:$t \le m$ 时是属性域,$t > m$ 时是 SID 第 $\mathcal{V}_{t-m-1}$ 层。
7.4 训练目标¶
生成模块用 teacher forcing 的 NTP 训练。目标 item 表示为 $\mathbf{s}^\star = (a^\star_1,\dots,a^\star_m, s^\star_0,\dots,s^\star_{L-1})$:
$$\mathcal{L}_{\text{NTP}} = -\sum_{t=1}^{m+L} \alpha_i \cdot \log p_\theta\big(s^\star_t \mid \mathbf{s}^\star_{<t}, u, c_{\text{task}}\big) \tag{19}$$
其中 $\alpha_i$ 按互动类型(点击、转化)加权样本。优化器为 AdamW。
八、业务目标与用户偏好对齐¶
NTP 训练的是曝光分布匹配,而非业务目标。论文用一个统一框架桥接:RFT 按连续业务价值估计重加权样本,DPO 通过对比对注入离散行为偏好信号。二者在单个训练步内联合优化:
$$\mathcal{L} = \mathcal{L}_{\text{RFT}} + \lambda_{\text{DPO}} \mathcal{L}_{\text{DPO}} \tag{20}$$
8.1 Reward-Driven Fine-tuning(RFT)¶
对每个训练样本 $(u_i, x_i)$ 定义复合奖励:
$$R(u_i, x_i) = \mathcal{F}\big(\{\hat{y}_k(u_i,x_i)\}_{k=1}^{N_{\text{obj}}}\big) \tag{21}$$
其中 $\{\hat{y}_k\}$ 是预测的互动指标(如观看时长、转化概率),$\mathcal{F}$ 按业务优先级聚合。在 batch $\mathcal{B}$ 内归一化样本优势以稳定梯度:
$$A_i = R(u_i,x_i) - \frac{1}{|\mathcal{B}|}\sum_{j \in \mathcal{B}} R(u_j, x_j) \tag{22}$$
$$\hat{A}_i = \frac{A_i}{\sigma_A + \epsilon}, \qquad \tilde{A}_i = \text{clip}(\hat{A}_i, -c_{\text{clip}}, c_{\text{clip}}) \tag{23}$$
其中 $\sigma_A = \sqrt{\frac{1}{|\mathcal{B}|}\sum_{j\in\mathcal{B}} A_j^2}$ 是 batch 均方根,$\epsilon$ 防止除零,$c_{\text{clip}}$ 抑制离群值。重加权后的目标:
$$\mathcal{L}_{\text{RFT}} = -\sum_{i \in \mathcal{B}} \sum_{t=1}^{m+L} (1 + \lambda \tilde{A}_i) \cdot \alpha_i \cdot \log p_\theta\big(s^\star_{i,t} \mid \mathbf{s}^\star_{i,<t}, u_i, c_{\text{task}}\big) \tag{24}$$
$\lambda > 0$ 控制重加权强度,$\alpha_i$ 正比于互动 item 的 GMV 价值,使高价值交易对训练信号贡献更强。$\tilde{A}_i > 0$ 时放大高回报样本的学习,$\tilde{A}_i < 0$ 时抑制低效模式。
8.2 DPO 偏好对齐¶
DPO 直接按观测到的行为结果对比 item 对。对请求上下文 $u$ 下曝光的 item $x$,定义行为偏好级别:
$$\mathcal{R}(x) = \begin{cases} 2 & x \text{ 被购买} \\ 1 & x \text{ 被点击} \\ 0 & x \text{ 仅曝光} \end{cases} \tag{25}$$
$\mathcal{R}(x_i) > \mathcal{R}(x_j)$ 时 $x_i \succ x_j$;行为相同时按曝光位次排序。偏好对按请求组织:batch 内把同一请求上下文 $u$ 下曝光的所有 item 分组,在组内采样满足 $x_i \succ x_j$ 的对:
$$\mathcal{D} = \{(u, x_i, x_j) \mid x_i \succ x_j,\ x_i, x_j \in \mathcal{E}_u\} \tag{26}$$
$$\mathcal{L}_{\text{DPO}} = -\mathbb{E}_{(u,y_w,y_l)\sim\mathcal{D}}\left[\log \sigma\left(\beta\left(\log\frac{\pi_\theta(y_w \mid u)}{\pi_{\text{ref}}(y_w \mid u)} - \log\frac{\pi_\theta(y_l \mid u)}{\pi_{\text{ref}}(y_l \mid u)}\right)\right)\right] \tag{27}$$
其中 $\pi_{\text{ref}}$ 是参考模型,$\beta = 0.1$ 控制偏好边际的锐度。
层级停梯度(Layer-wise Stop Gradient):前缀预测同时充当后续生成的条件上下文,若被 DPO 直接改写会破坏其稳定性。作者对除最后一层 SID 外的所有解码步施加 stop-gradient:
$$\log \pi_\theta(y \mid u) = \sum_{t=1}^{L-1} \underbrace{\text{sg}\big[\log p_\theta(s^\star_t \mid s^\star_{<t}, u)\big]}_{\text{冻结前缀}} + \underbrace{\log p_\theta(s^\star_L \mid s^\star_{<L}, u)}_{\text{DPO 目标层}} \tag{28}$$
这保证 DPO 只更新最后一层的 Rank Head,而所有前缀预测保持不变。这个设计与 CoA 的逻辑一致:前缀的稳定性是整条生成链正确性的前提。
九、实验设置¶
数据集:Shopee 电商平台主 feed 场景(用户垂直滚动浏览商品)真实生产日志,连续 9 天,包含数十亿条用户互动记录,覆盖曝光、点击、加购、购买转化等多种行为。全部为内部工业数据,无公开学术数据集实验。
评估指标:
- Token Hit Ratio@3:teacher-forcing 训练中,每个解码步 ground-truth token 落在模型 top-3 预测内的比例,反映 token 分布的学习质量;
- BS Hit Ratio@K:推理时做 beam search,目标 item 是否出现在 top-$K$ 生成候选中,$K \in \{50, 100, 200\}$。由于购买转化在电商中最有价值,额外单独报告订单样本(成功购买对应的样本子集)上的 BS Hit Ratio@K。
模型配置:
| 项目 | 取值 |
|---|---|
| SID 层数 / 码本大小 / 容忍度 | 3 层 / $K = 4000$ / $\tau = 1.05$ |
| CoA 属性链 | 类目层级 L2 → L3(L1 ⊃ L2 ⊃ L3 逐级细化) |
| Content Summary | $M = 3$ 哈希函数,$d_{\text{hash}} = 64$ |
| 笛卡尔积组合 | (L2,$s_0$), (L2,$s_1$), (L3,$s_0$), (L3,$s_1$), ($s_0$,$s_1$) |
| $d_{\text{model}}$ | 256 |
| 行为序列长度 $T$ / 多模态 SID 序列长度 $L_{\text{mm}}$ | 200 / 100 |
| Cross-Attention | 3 层,每层 8 头 |
| MMoE-FFN | 4 专家,SwiGLU,隐层 $4 d_{\text{model}}$ |
| 对齐 | RFT 奖励信号 = GMV;$\lambda_{\text{RFT}} : \lambda_{\text{DPO}} = 20 : 3$;$\beta = 0.1$ |
| 优化器 / 学习率 | AdamW / $3 \times 10^{-4}$ |
Baseline:
- SASRec:基于自注意力的序列推荐,作为强判别式召回 baseline;作者将其适配到 SID 评估体系——用它学到的表示在 SID 码本上做最近邻检索;
- TIGER:Encoder-Decoder 生成式检索,encoder 处理用户行为序列,decoder 自回归生成 item 标识符;
- OneRec-V2:Decoder-Only 生成式检索,带对用户行为序列的 cross-attention。
三个 baseline 与 UniRec 均在 0.05B 参数规模上对齐比较。
十、主要实验结果¶
Table 1:全样本与订单(购买)样本上的 Hit Ratio
| Method | HR@50 | HR@100 | HR@200 | 订单 HR@50 | 订单 HR@100 | 订单 HR@200 |
|---|---|---|---|---|---|---|
| SASRec | 0.421 | 0.489 | 0.556 | 0.548 | 0.631 | 0.709 |
| TIGER (0.05B) | 0.437 | 0.508 | 0.578 | 0.567 | 0.652 | 0.731 |
| OneRec-V2 (0.05B) | 0.438 | 0.523 | 0.587 | 0.582 | 0.671 | 0.752 |
| UniRec (0.05B) | 0.537 | 0.618 | 0.688 | 0.672 | 0.774 | 0.867 |
结论分析:
- 相对最强生成式 baseline OneRec-V2,UniRec 在 HR@50 上 +9.9 个百分点(+22.6% 相对),HR@100 +9.5 点(+18.2%),HR@200 +10.1 点(+17.2%)。
- 值得注意的是三个 baseline 之间差距很小(HR@50 分别 0.421 / 0.437 / 0.438),而 UniRec 一步拉开近 10 个点。这意味着增益不来自"更好的骨干",而来自 CoA + Capacity-SID + CDC 这套信息注入组合——与论文的理论叙事一致。
- 订单样本上增益更强:HR@50 +9.0 点(+15.5% 相对)、HR@100 +10.3 点、HR@200 +11.5 点。作者归因于两点:Task-Conditioned BOS 使模型能区分点击/加购/购买/跨境等不同行为目标;RFT 按实际 GMV 重加权样本,把学习容量倾斜到高价值交易上。
- 一个可注意的现象:订单样本的绝对 HR 高于全样本(0.672 vs 0.537)。这说明有购买意图的用户其行为序列的可预测性本身就更强,而非模型对订单样本做了特殊处理。
十一、消融与分析¶
11.1 CoA 属性链的配置消融(Table 2)¶
这是全文最关键的消融,直接验证 CoA 的核心主张。表中 L1@3 / L2@3 / L3@3 / $s_0$@3 / $s_1$@3 / $s_2$@3 均为 Token Hit Ratio@3。
| Attribute Chain | L1@3 | L2@3 | L3@3 | $s_0$@3 | $s_1$@3 | $s_2$@3 | HR@50 | HR@100 | HR@200 |
|---|---|---|---|---|---|---|---|---|---|
| Direct SID(无属性) | — | — | — | 0.314 | 0.752 | 0.952 | 0.458 | 0.532 | 0.595 |
| L1 → SID | 0.899 | — | — | 0.488 | 0.776 | 0.961 | 0.471 | 0.569 | 0.622 |
| L2 → SID | — | 0.755 | — | 0.591 | 0.789 | 0.963 | 0.515 | 0.597 | 0.664 |
| L3 → SID | — | — | 0.694 | 0.654 | 0.801 | 0.967 | 0.517 | 0.601 | 0.670 |
| L2 → L3 → SID | — | 0.757 | 0.962 | 0.682 | 0.821 | 0.971 | 0.537 | 0.618 | 0.688 |
结论分析:
- $s_0$@3 是 CoA 效果的直接读数:无属性时仅 0.314,加 L1 前缀升到 0.488,L2 升到 0.591,L3 升到 0.654,L2→L3 双属性链达到 0.682——相对无属性提升 117%。这正是式 (6) 中 $\Delta H_0 = I(\mathbf{a}; s_0 \mid u)$ 的经验体现:属性条件化把第一层 SID 的解码不确定性大幅压低。
- 收益沿解码链衰减:$s_1$@3 从 0.752 到 0.821(+9%),$s_2$@3 从 0.952 到 0.971(+2%)。合理——深层 token 已被前缀强约束,属性的边际互信息自然递减。这也说明 CoA 的价值集中在最容易出错、且错误代价最大的第一层。
- 属性越细粒度单步越难,但对 SID 越有用:L1@3 = 0.899(粗类目好预测)、L2@3 = 0.755、L3@3 = 0.694(细类目难预测),但下游 $s_0$@3 恰好反向排序(0.488 < 0.591 < 0.654)。这是 speculate-then-refine 的核心张力:投机步本身越难,细化步获得的信息量越大。
- 链式分解化解了这个张力:L2→L3 链条下,L3@3 从单独预测的 0.694 跃升到 0.962——因为它现在条件在已生成的 L2 上。即先解一个较易的粗类目,再在其约束下解细类目,两步都准,最终 $s_0$@3 达到最高的 0.682。这为"多步属性链优于单步属性"提供了机制层解释。
11.2 SID 构造与 CDC 组件消融(Table 3)¶
| Configuration | HR@50 | HR@100 | HR@200 |
|---|---|---|---|
| UniRec (Full Model) | 0.537 | 0.618 | 0.688 |
| (a) SID 构造 | |||
| RQ-KMeans | 0.481 | 0.558 | 0.627 |
| (b) Conditional Decoding Context | |||
| w/o Task-Cond. BOS | 0.493 | 0.570 | 0.638 |
| w/o Content Summary | 0.485 | 0.565 | 0.637 |
| (c) 模型规模 ($d_{\text{model}}$) | |||
| 64 | 0.397 | 0.459 | 0.514 |
| 128 | 0.477 | 0.551 | 0.615 |
| 256† (默认) | 0.537 | 0.618 | 0.688 |
| 512 | 0.557 | 0.639 | 0.712 |
(a) Capacity-Constrained SID:换回标准 RQ-KMeans 后全指标一致退化,HR@50 从 0.537 掉到 0.481、HR@100 从 0.618 掉到 0.558。
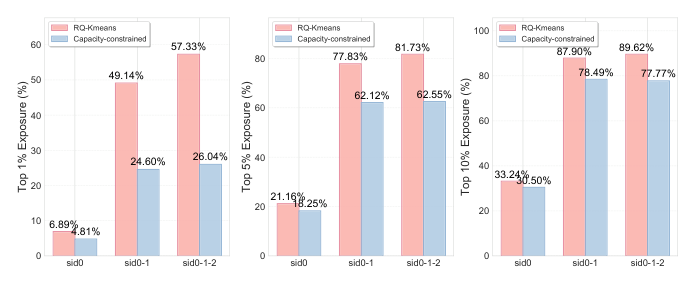
Figure 3 给出了机制层的解释——码本利用率的对比:
| 层级 | Top-1% 曝光占比 | Top-5% 曝光占比 | Top-10% 曝光占比 |
|---|---|---|---|
| RQ-KMeans → Capacity | RQ-KMeans → Capacity | RQ-KMeans → Capacity | |
| sid0 | 6.89% → 4.81% | 21.16% → 18.25% | 33.24% → 30.50% |
| sid0-1 | 49.14% → 24.60% | 77.83% → 62.12% | 87.90% → 78.49% |
| sid0-1-2 | 57.33% → 26.04% | 81.73% → 62.55% | 89.62% → 77.77% |
关键读数:在完整三层层级上,top-1% token 的曝光占比从 57.33% 腰斩到 26.04%。RQ-KMeans 的不均衡分布迫使解码器把概率质量不成比例地分配给一小撮过度表示的码,损害了对长尾 item 的泛化;容量约束通过占用容忍度 $\tau$ 强制码本近似均匀负载,为电商普遍的长尾 item 分布提供了更忠实的离散表示。注意 sid0 层的改善很小(6.89% → 4.81%),说明问题确实主要出在组合层级,与 §4.1 的 2.6 倍放大诊断一致。
(b) CDC 两个组件:
- 去掉 Task-Conditioned BOS:HR@100 相对下降 7.8%(0.618 → 0.570),模型失去区分任务特定目标的能力;
- 去掉 Content Summary:HR@100 相对下降更大的 8.6%(0.618 → 0.565),说明沿解码路径显式建模笛卡尔积特征交互,对捕捉序列建模本身无法高效表示的组合信号是关键的。每个哈希函数 $H_i$ 把特征索引对 $(x,y)$ 映射到共享 embedding 表,让模型能把跨特征相关性(如 类目 × SID token)编码成注入 prompt 层的轻量归纳偏置。
两者全开的完整模型效果最好,证实任务条件化与组合特征交叉解决的是正交的挑战。
(c) 模型 scaling:固定其他超参只缩放 $d_{\text{model}}$,HR@50/100/200 随 64 → 512 单调提升(HR@50: 0.397 → 0.477 → 0.537 → 0.557)。趋势表明 UniRec 能从更大容量中获益,还有进一步扩展空间。不过增益的边际递减也很明显:128→256 涨 6.0 点,256→512 只涨 2.0 点。
11.3 多场景下的 Task-Conditioned BOS(Table 4)¶
为进一步验证多场景设置下的收益,作者在三个生产场景的联合样本池上训练,比较三种条件:
| Configuration | HR@50 | HR@100 | HR@200 |
|---|---|---|---|
| Single-scene(每场景独立模型) | 0.386 | 0.470 | 0.540 |
| Multi-scene(联合训练,无场景区分 prompt) | 0.395 | 0.486 | 0.570 |
| Multi-scene + Task-Cond. BOS | 0.400 | 0.510 | 0.590 |
结论分析:多场景联合训练本身已优于单场景模型(HR@50/100/200 分别 +0.9/+1.6/+3.0 点),证明了跨场景知识迁移的价值;引入 Task-Conditioned BOS 在所有截断位上再获一致增益(+0.5/+2.4/+2.0 点),确认在混合数据上训练时,场景特定条件化对化解异构行为分布之间的冲突是必要的。值得注意的是 Task-Cond. BOS 的增益在 HR@100 上最大(+2.4 点),暗示条件化主要作用在中长尾候选的区分上。
十二、在线 A/B 实验¶
UniRec 部署在 Shopee 电商平台生产环境,日服务数千万用户。
实验设置:A/B 覆盖主 feed 与落地页(landing page)两个场景。对照组使用基线的判别式多阶段推荐系统,实验组部署 UniRec。每桶分配 20% 用户流量以保证统计显著性。
Table 5:在线 A/B 结果
| Metric | Overall | Feed | Landing |
|---|---|---|---|
| Total Orders | +4.76% | +4.27% | +5.78% |
| GMV | +5.60% | +5.42% | +6.19% |
| Page-view CTR | +5.37% | +5.37% | — |
关键观察:
- UniRec 在 PVCTR 与互动类指标上的相对增益强于转化类指标,说明内容相关性与用户满意度得到改善;
- 延迟:系统端到端 110ms,与单个排序模型相当,而传统流水线需要 266ms——端到端优化带来了 2.4 倍的延迟优势。这是把四阶段漏斗折叠成单模型的直接红利,也是 CoA 那 $m$ 步额外自回归开销能被接受的前提。
落地页场景的增益(订单 +5.78%、GMV +6.19%)高于主 feed(+4.27% / +5.42%),一个可能的解释是落地页的上下文更聚焦、任务条件更明确,Task-Conditioned BOS 的收益更容易兑现。
十三、核心贡献总结¶
- 表达力鸿沟的理论刻画:首个信息论分析,论证生成式与判别式推荐之间的表达力差距源于特征覆盖而非建模不对称;经由贝叶斯定理建立理论上界,说明拥有完整特征访问的生成式模型可以匹配判别式排序。
- Chain-of-Attribute:由上述分析驱动的机制。通过在 SID 解码前预生成结构化 item 属性,CoA 在生成轨迹内部找回 item 侧特征交叉,产生可度量的每步熵下降 $H(s_k \mid s_{<k}, \mathbf{a}) < H(s_k \mid s_{<k})$ 与端到端误差衰减。
- Capacity-constrained SID 与 CDC:用曝光加权残差量化解决 SID 分布坍塌,用 Task-Conditioned BOS 与组合式 Content Summary 解决多场景误差累积——两项大规模部署所必需的系统级贡献。
- 完整的经验验证:离线相对最强 baseline HR@50 +22.6%、订单样本 +15.5%;Shopee 线上 A/B 确认 PVCTR +5.37%、订单 +4.76%、GMV +5.60%。
十四、与已归档相关工作的对比¶
Latte Latte: Expressiveness Limits of Autoregressive Semantic ID Generation(UCSD + Snap Inc.,2026-05-07)¶
关系:独立提出的孪生工作,但本文更早(UniRec v1 2026-04-14,Latte 2026-05-07,相隔 3 周);两者互不引用 · 已加载对方精读
时序说明:UniRec 早于 Latte 三周,因此本文不可能引用 Latte;而 Latte 也未引用 UniRec。二者是在几乎同一时间窗内、从两条独立路径逼近同一个命题的工作,这里的对比属于事后并置,不构成任何一方"忽略"了对方。
- 共同关注的问题:两篇论文都把矛头指向自回归 SID 解码过程本身,而不是主流的 tokenizer 优化。Latte 明确指出"绝大多数研究焦点是如何更好地 tokenize,但自回归生成过程本身对表达力的影响被长期忽视";UniRec 的表述是"这不仅是工程限制,而是解码时刻可用信息的结构性不对称"。两者都在追问同一个 root cause:AR-over-SID 这个解码形式给 GR 的表达力设了什么上限。UniRec 的标题就是 "Expressive Gap",Latte 的标题就是 "Expressiveness Limits"。
- 相近的技术骨架:两者的补救方案在方法流程图上几乎重合——在目标 SID 序列前预置一个/一段 prefix token,推理时先自回归生成 prefix 再生成 SID,等价于把原来的单棵解码树替换成一族条件化子树。Latte 从大小为 $M'$ 的 latent token 词表中均匀采样一个 $\ell$,构造 $(\ell, c^{(1)},\dots,c^{(m)})$;UniRec 前缀 $m$ 个属性 token 构造 $(\mathbf{a}, s_0,\dots,s_{L-1})$,对应式 (5) 的分解 $p(\mathbf{s}\mid u) = p(\mathbf{a}\mid u)\prod_l p(s_l \mid \mathbf{a}, s_{<l}, u)$。
- 本文的差异与推进:两者的信息论方向恰好相反。Latte 的诊断是解码树把共享长前缀的 item 强制耦合(rank reversal 与 forced transitivity 无法表达),因此 prefix token 必须是内容无关的随机 latent,目的是增大有效树距离、解耦结构相邻的 item;UniRec 的诊断是 SID 压缩丢掉了 item 侧属性,因此 prefix 必须是语义锚定的真实属性(类目 L2→L3),目的是降低每步条件熵 $\Delta H_l = I(\mathbf{a}; s_l \mid s_{<l}, u) \ge 0$。一个求解耦,一个求耦合——同一个机械装置被用于两个相反的目标,且双方都报告了正向收益,这本身值得注意:说明"在 SID 前加 prefix token"这个操作的收益可能部分来自额外的解码步数/容量,而不全来自各自声称的机制。
- 可比的方法/实验差异:Latte 在 Amazon Reviews 2023 三个公开类目上评测,相对 TIGER / LETTER / ActionPiece / PSID 等 SID 系 baseline 平均 NDCG@10 +3.45%,并且强调 Latte 与 OPQ / RQ-VAE / RQ-KMeans 三种 tokenizer 都兼容;UniRec 只在 Shopee 内部数据上评测,HR@50 相对 OneRec-V2 +22.6%,但这是一个包含 CoA + Capacity-SID + CDC + RFT/DPO 的完整系统的增益,Table 2 的 CoA 单项消融(Direct SID 0.458 → L2→L3→SID 0.537,HR@50 相对 +17.2%)才是可与 Latte 的 +3.45% 并置的数字——量级差异大部分应归因于评测体系(工业十亿级 vs 公开数据集)而非机制强弱。另外 Latte 提供了 ultrametric 不等式等严格的表达力证明,而 UniRec 的"理论上界"只是贝叶斯公式的改写,理论严格性上 Latte 更强。
CRAB CRAB: Codebook Rebalancing for Bias Mitigation in Generative Recommendation(Walmart Global Tech,2026-04-06)¶
关系:真正的独立并发(CRAB 早于本文 8 天,本文未引用;正文中 "Walmart"/"CRAB" 均零命中)· 已加载对方精读
- 共同关注的问题:两篇论文对 SID 码本的诊断几乎逐字一致。CRAB 指出"RQ-KMeans / RQ-VAE 在聚类时不考虑频率平衡,热门 item 对应的 token 承载了远高于其它 token 的训练样本,造成 token 频率严重不平衡",并量化出 MOR 中过热门 token 的 Group Unfairness 达 SASRec 的 1.8 倍;UniRec 指出"即使每簇 item 数相同,少量高流量 item 也会独占其码本条目的曝光负载",并量化出 top-10% 的 $(s_0,s_1)$ 组合独占 87.9% 曝光。同一个 root cause:码本构造阶段不平衡 → 自回归解码阶段被放大成恶性循环。
- 相近的技术骨架:两者都在残差量化的 K-means 目标函数里加一个热度/负载平衡项,且都用历史交互频率作权重(CRAB 的 token popularity $P(c_k^l) = \sum_{i \in \mathcal{I}_{c_k^l}} f_i$,UniRec 的曝光负载 $V_k = \sum_{i: z_i=k} w_i$,$w_i$ 为历史曝光计数),并都刻意保留层次语义结构而非粗暴等分。
- 本文的差异与推进:(1) 时机不同——CRAB 是训练完成后的 post-hoc 后处理(在已训练好的 GeneRec 上改 tokenizer 并微调 LLM token embedding),UniRec 是构造时的硬约束(式 (4) 的 $V_k \le \tau C_{cap}$ 直接进聚类);(2) 手段不同——CRAB 拆分过热门 token(把 $\mathrm{Ch}(c_k^l)$ 重聚成 $M$ 个新父 token,码本会变大),并配一个层次语义对齐正则器初始化新 embedding;UniRec 不改码本大小,用两阶段贪心(就近分配 + 超载修复)把样本挤到未满簇;(3) 目标不同——CRAB 优化的是流行度偏差/公平性(DGU@10 相对降低 16.5%,同时"保持具有竞争力"的推荐效果),UniRec 优化的是检索准确率(HR@50 0.481 → 0.537)。两者恰好构成互补证据:同一个码本失衡问题,从公平性侧和准确率侧分别验证了修复的价值。
- 可比的方法/实验差异:一个耐人寻味的交叉点是,CRAB 批评已有均衡码本方法"严格限制每个 token 最多被分配的 item 数,导致语义一致性被破坏",而 UniRec 批评的正是同一类做法(OneRec 的等 item 数平衡量化),但理由是"item 数均等 ≠ 曝光负载均等"。两篇论文从不同角度否定了同一个 baseline,且都给出了替代方案,这比任何一方单独的论证都更有说服力。实验上 CRAB 用 Office 公开数据集 + 工业数据集,UniRec 纯工业数据,无法直接比数字。
PrefixMem PrefixMem: LLMs Need Encoders for Semantic IDs Too(Pinterest,2026-05-29)¶
关系:机制近乎同构但本文早 6 周(UniRec 2026-04-14,PrefixMem 2026-05-29);两者互不引用 · 已加载对方精读
时序说明:PrefixMem 晚于 UniRec 六周,本文当然无从引用;PrefixMem 也未引用 UniRec。这里对比的价值不在"殊途同归",而在于两支工业团队在同一时期各自把同一个机制推到了生产规模,可用来交叉验证该机制的普适性。
- 共同关注的问题:UniRec 对 Content Summary 的动机陈述是"同一个 SID token 与不同属性或父 token 配对时可能携带不同的语义,有意义的 item 模式往往从特定组合而非单个 token 中涌现";PrefixMem 的核心主张是"一个码的含义取决于它的前缀——前缀 1273 之后的码 505 索引运动鞋,前缀 974 之后的同一个 505 索引复古艺术品"。同一个 root cause:扁平词表 embedding 让同一码在所有前缀下共享同一向量,模型必须靠 attention 隐式重建前缀依赖语义。
- 相近的技术骨架:两者的解法是同一族——对已解码前缀做哈希,从共享 embedding 表中 $O(1)$ 取回前缀条件向量,注入 SID token 位置。UniRec 式 (7):$M=3$ 个哈希函数($x+y$、$x\cdot y$、$p_1x + p_2y$)打到共享表 $\mathbf{E}_{\text{hash}} \in \mathbb{R}^{S \times 64}$ 后拼接;PrefixMem:$H=4$ 个哈希头对递增长度的前缀 n-gram 做 $\big(\bigoplus_i (c_i \times p_{i,h})\big) \bmod T$,跨头拼接、跨 n-gram 阶求和后投影。连"用质数常量构造哈希"这个细节都撞上了。
- 本文的差异与推进:(1) 注入位置——UniRec 把 $\mathbf{c}_t$ 拼进第 $t$ 步 Rank Head 的输入 $\mathbf{x}_t$(与 $\mathbf{q}_t$、$\mathbf{e}_{\text{prefix}}$、$\mathbf{h}_{\text{agg}}$ 并列,过 SENet/MaskNet),PrefixMem 把 $\mathbf{m}_\ell$ 相加到 $c_\ell$ 的输入 embedding 上(在进 transformer 之前);(2) 前缀内容——UniRec 的哈希对象是属性 × SID 的笛卡尔积((L2,$s_0$)、(L3,$s_1$) 等),跨越了 CoA 引入的属性 token,PrefixMem 只哈希 SID 内部的码前缀;(3) 可迁移性——PrefixMem 明确把编码器设计成可独立预训练、跨 LLM 家族迁移的模块(并给出分类头 / 生成式检索 / 小 LLM 三级预训练阶梯),UniRec 的 Content Summary 与自家 Rank Head 耦合,未讨论迁移;(4) 定位——PrefixMem 把 SID 类比为图像/音频那样的"非语言模态",主张配专用编码器,这是一个比 UniRec 的"轻量归纳偏置"更强的方法论主张。
- 可比的方法/实验差异:PrefixMem 在 Pinterest 十亿级目录、跨 Qwen3 0.6B/1.7B/4B、Llama 3.2 1B、Gemma 3 1B 上验证,最深层 SID 准确率相对提升最高 46%、全 SID 检索召回相对最高 +22%,且收益高度集中在"贪心解码失败的硬样本"(最高 +77%);UniRec 的 Content Summary 消融是 HR@100 相对 -8.6%(去掉后)。两者数量级不可直接比(PrefixMem 是 LLM 骨干、5 层 2048 码本;UniRec 是 0.05B 定制骨干、3 层 4000 码本),但方向与幅度都支持"前缀哈希记忆是 SID 解码的高性价比补丁"这一结论。PrefixMem 额外提供了一个 UniRec 没做的关键消融:与 4 层因果 transformer 编码器(SID-Transformer)对比,证明哈希表方案在算力匹配下更优。
十五、讨论与局限性¶
15.1 值得借鉴的设计¶
- 把"表达力差距"重新归因为可工程化的变量。这是全文最有价值的一步。在此之前,"生成式推荐天花板更低"是一个模糊的直觉;论文用两行贝叶斯把它变成"特征覆盖不足",从而立刻推出"补回被丢弃的属性"这个可执行的动作。方法论上,这是把一个范式级争论降维成一个特征工程问题。
- CoA 的延迟预算是显式的。论文没有说"解码全部特征",而是明确"选择性地找回被 SID 压缩丢弃最多的粗粒度属性,代价是固定的 $m$ 步额外自回归延迟"。配合 110ms vs 266ms 的线上延迟数据,这个 trade-off 是被量化过的,不是口号。
- 区分 item 数量均衡与曝光负载均衡。这个诊断很锐利,并且被 2.6 倍放大的数据坐实。任何做 SID 码本的团队都应该按曝光而非 item 数来做平衡约束。
- DPO 的层级停梯度。式 (28) 只让最后一层 SID 的梯度流动,前缀全部 stop-gradient。这与 CoA 的逻辑自洽——既然整套设计都建立在"前缀稳定则后续解码可靠"之上,就不该让偏好优化去扰动前缀。这是一个容易被忽略但很重要的工程细节。
15.2 局限与争议¶
- "理论上界"名不副实。式 (1)-(2) 只是贝叶斯定理 + 链式法则的直接改写,证明的是"若生成式模型能建模 $p(\mathbf{f} \mid y, u)$ 则与判别式等价"。这是一个表示层的存在性陈述,完全没有涉及有限容量模型能否学到该分解、需要多少数据、优化是否可行。论文自称"first information-theoretic analysis"与"prove",措辞明显强于实际内容。相比之下 Latte Latte 给出的 ultrametric 不等式与 rank reversal 不可表达性证明才是真正意义上的表达力分析。
- 熵下降只有理论式子,没有实测数字。论文在贡献列表和结论里都写了"validated empirically through measurable per-step entropy reduction",但全文没有任何一张表/图报告 $\Delta H_l$ 或 $I(\mathbf{a}; s_l \mid s_{<l}, u)$ 的实际数值。Table 2 报告的是 Token Hit Ratio@3,这是熵的代理指标而非熵本身。既然式 (6) 是全文的理论支点,缺这组测量是明显的短板。
- 完全没有公开数据集实验。全部离线实验在 Shopee 内部 9 天生产日志上完成,三个 baseline(SASRec / TIGER / OneRec-V2)都是作者自行复现并适配到 SID 评估体系的(SASRec 甚至被改造成"用其表示在 SID 码本上做最近邻检索",这个适配本身就可能低估了 SASRec)。结果完全不可复现,也无法与社区数字横向比较。
- 最直接的相关工作只做了文字辨析,没做实验对比。论文在 Related Work 中承认 GRACE(Walmart, RecSys 2025)已经"在语义 token 前预置显式商品知识图谱属性",与 CoA 共享同一高层直觉,并辩称差异在于"GRACE 把属性前置当作经验设计选择、无理论依据,而 CoA 有信息论基础"。但没有任何一组 GRACE vs CoA 的实验数字。既然核心机制撞车,只用"我们有理论"来区分是不够的——尤其是在第 1 点已经指出该理论较弱的前提下。
- 多个组件的收益边界不清。Table 3 只消融了 Capacity-SID、Task-Cond. BOS、Content Summary 三项,RFT 与 DPO 没有任何消融。但论文把订单样本上的更强增益(+15.5%)同时归因于 Task-Cond. BOS 和 RFT 的 GMV 重加权,读者无法判断这两者各自贡献多少。$\lambda_{\text{RFT}} : \lambda_{\text{DPO}} = 20:3$ 这个比例也没有敏感性分析。
- 方法论可扩展性有隐忧。Table 3(c) 显示 $d_{\text{model}}$ 从 256 到 512 只涨 2.0 点(128→256 涨 6.0 点),边际收益已明显递减,而所有实验都停在 0.05B 规模,与 OneRec-V2 / OneMall 等动辄更大的工业 GR 相比属于小模型。更结构性的问题是:属性链的长度 $m$ 与 SID 层数 $L$ 都是固定的,属性词表(类目 L2/L3)由业务分类体系外生给定,参数量 scaling 时无法同步扩充"用什么属性来条件化"这条路径——CoA 的信息注入量存在一个由分类体系决定的天花板。类似地 Capacity-constrained SID 是离线一次性构造的,码本一旦固化就限定了下游表征空间,与生成模型无法端到端联合优化。
- CoA 的 $m$ 步延迟在更长属性链下会失控。当前只用了 L2→L3 两步,Table 2 已显示两步优于一步。但若要继续逼近式 (2) 的完整特征分解(加 seller、brand),每加一个属性就是一次额外的自回归步 + 一次 beam 展开,110ms 的延迟优势会被迅速吃掉。论文没有讨论这个 scaling 曲线的拐点在哪。
- 摘要与正文的属性列表不一致。摘要与 §1 反复声称 CoA 前缀的是 "category, seller, brand" 三类属性,但 §4.1.1 的模型配置里实际只用了类目层级 L2 → L3,Table 2 的消融也只覆盖 L1/L2/L3。seller 与 brand 从未真正进入实验。这是一个应当被指出的表述问题。
15.3 工业落地价值¶
论文的工程落地部分是扎实的:Shopee 主 feed + 落地页两个场景、20% 流量分桶、日服务数千万用户、PVCTR +5.37% / 订单 +4.76% / GMV +5.60%,且端到端延迟 110ms 对比传统流水线 266ms。对于正在评估"是否要把多阶段漏斗换成端到端 GR"的团队,这组延迟数字(2.4 倍下降,且与单个排序模型相当)可能比准确率数字更有决策价值——它说明 GR 的额外自回归开销(含 CoA 的 $m$ 步)完全可以被砍掉三个阶段的收益覆盖。
另一个可直接迁移的实践是 §4 的曝光负载诊断方法:按 $(s_0)$、$(s_0,s_1)$、$(s_0,s_1,s_2)$ 分层统计 top-$k\%$ 组合的累计曝光份额。这个诊断只需要生产日志,不需要训练任何模型,任何已经上了 SID 的团队都可以立刻跑一遍,看看自己的码本是不是也在 $s_1$ 层被放大了 2.6 倍。